


llama.cpp 源码完全拆解(二十二):ggml-cpu 的非 GEMM 算子——注意力、RoPE 与 RMSNorm 如何共用一条线程池节拍
从 mul_mat 往上一层
上一篇文章(llama.cpp 源码完全拆解(十三):ggml-cpu 的一次 mul_mat)把 CPU 推理里最重的那个算子拆到了底:量化块的位级布局、整数点积内核、mul_mat 的 16×16 任务切分,以及线程池在节点之间的 seq_cst barrier。那一篇的结论可以概括成一句话——解码阶段的瓶颈不是乘加,而是乘加周围那一圈簿记。
这一篇顺着那句话往上走一步,看 mul_mat 之外的算子:注意力、RoPE、RMSNorm、以及写 KV Cache 的那一次 set_rows。它们单看计算量都不大,但在一次 decode step 里出现的次数非常多(32 层 × 每层若干个),而且每一个都要在同一套线程池节拍里完成「分活 → 计算 → 汇合」的全过程。把这些算子的并行策略拼起来,才能看清 CPU 推理的时间到底花在哪。
先说清楚范围。本篇讨论的是 ggml/src/ggml-cpu/ 下三个文件:
ops.cpp:注意力的三条实现路径(逐行标量版、tiled 版、split-KV 版),以及 RoPE、RMSNorm 的线程切分;ggml-cpu.c:每个算子给出n_tasks的规则、work_size的估算、以及节点融合的入口ggml_cpu_try_fuse_ops;vec.cpp/vec.h:注意力内核依赖的ggml_vec_dot_f32等基础向量函数。
KV Cache 的分配与索引已经在llama.cpp 源码完全拆解(四):llama_context 与记忆系统里讲过;图是怎么把注意力建成 ggml_flash_attn_ext 节点的,在llama.cpp 源码完全拆解(六):图构建与注意力里讲过。本篇不重复建图与分配,只讨论这些节点被建出来之后、在 CPU 线程池上怎么被执行。
先建立数量级:decode step 里到底有多少个节点
把一次 decode step 的节点数算清楚,后面所有的讨论才有参照。
以一个 32 层、隐藏维 4096、32 个 query head、8 个 KV head(GQA)、head 维 128 的模型为例,每层大致包含:
| 节点 | 每层数量 | 说明 |
|---|---|---|
RMS_NORM | 2 | 注意力前与 FFN 前各一次 |
MUL(norm 权重) | 2–3 | 紧跟在 norm 之后,门控型 FFN 还会多一次 MUL |
ROPE | 2 | 分别作用在 Q 与 K 上,具体数量随模型架构略有差异 |
SET_ROWS(写 K) | 1 | 把本 token 的 K 写进 KV cache |
SET_ROWS(写 V) | 1 | 同上,写 V |
FLASH_ATTN_EXT | 1 | 本篇的主角 |
MUL_MAT | 5–7 | QKV 投影、注意力输出投影、FFN 三块 |
| 其余(ADD、SILU 等) | 3–6 | 残差、FFN 门控 |
按每层 20 个节点、32 层计,一次 decode step 约有 640 个节点。上一篇文章已经说明:每个节点之间都要过一次全线程 barrier。mul_mat 只占其中不到三分之一,剩下四百多个节点是 norm、rope、copy 这类「小算子」。
这就引出本篇的第一个问题:这些小算子在多线程上是怎么切的?切完之后,并行效率还剩多少?
n_tasks:每个算子被允许多少线程
在 ggml_graph_plan 阶段,规划器会遍历整张图,为每个节点调用 ggml_get_n_tasks(node, n_threads),然后取全图的最大值作为这张图要拉起的线程数:
const int n_tasks = ggml_get_n_tasks(node, n_threads);max_tasks = MAX(max_tasks, n_tasks);...cplan.n_threads = MIN(max_tasks, n_threads);注意 cplan.n_threads 是整张图一个值,而不是每个节点各拉一组线程。n_tasks 在运行时并不会让某个节点少用线程——执行时每个节点看到的是 params->nth = cplan.n_threads。n_tasks 真正的作用有两个:给该节点的 work_size(工作缓冲)定尺寸,以及决定这张图最少需要多少线程才能让所有节点都有活可分。
对注意力来说,n_tasks 的取值很直接:
case GGML_OP_FLASH_ATTN_EXT:case GGML_OP_FLASH_ATTN_BACK: n_tasks = n_threads;它被假定「总能切开」,后面会看到这个假定在 decode 早期并不总成立。RMSNorm、RoPE、SET_ROWS 同样是 n_tasks = n_threads:
case GGML_OP_NORM:case GGML_OP_RMS_NORM:case GGML_OP_ROPE:...case GGML_OP_SET_ROWS: n_tasks = n_threads;而少数一元算子(如 RELU、SIGMOID)以及归约类(SUM、ARGMAX)被标成 n_tasks = 1,意思是它们的实现里只有单线程路径或必须跨全部元素合并。CPU 推理的一个常见误解是「线程越多越快」;实际上图里只要有若干节点只能单线程跑,整张图的加速比就被这些节点封顶。
注意力:同一份 Softmax 的三条执行路径
注意力在 ggml 里是一个节点 ggml_flash_attn_ext,语义是:
其中 、, 是本次 ubatch 的 query 行数, 是 KV 长度。这个节点的执行入口是 ggml_compute_forward_flash_attn_ext,它按 op_params[3] 指定的精度选择实现,然后进入 ggml_compute_forward_flash_attn_ext_f16,在这里做三条路径的分流。
三条路径分别是什么
| 路径 | 切分维度 | 触发条件 | 典型场景 |
|---|---|---|---|
| one_chunk(逐行标量) | Q 行 | 默认 | 小 D、非 SIMD 平台、use_ref |
| tiled(分块) | Q 行,块内按 KV 分块 | q 为 F32、KV 为 F32/F16、neq1 ≥ Q_TILE_SZ | x86/ARM 预填充 |
| split-KV(序列维并行) | KV 段 | neq1 == 1 && neq3 == 1、KV 为 F32/F16、Q 为 F32、nek1 ≥ 512 | 单 token 解码、长上下文 |
三者的选择逻辑在源码里是这样的:
const bool kv_is_f32_or_f16 = (k->type == GGML_TYPE_F32 || k->type == GGML_TYPE_F16);const bool use_split_kv_path = !use_ref && (neq1 == 1 && neq3 == 1) && kv_is_f32_or_f16 && (k->type == v->type) && q->type == GGML_TYPE_F32 && nek1 >= 512;先说清楚为什么 decode 需要一条单独的路径。解码时 ,按 Q 行切能得到的任务数是 (通常 32),对 16 线程的机器来说并行宽度并不是问题。真正的问题是访存:逐行版里每个任务只服务一个 query head,却要把整段 KV 扫一遍;32 个任务并发时,同一份 KV 被 32 个 head 各读一次,单份 KV 的字节数(,、 时约 1 MB)超出 L1,多个 head 之间只能靠 L2/L3 复用。KV 的逻辑读取字节数被 head 数放大。
split-KV 把循环次序倒过来:每个线程先占住一段 KV,再让所有 query head 复用这一段。只要这段 KV 能留在 L1(16 线程、 时每段 32 个 key,约 8 KB),一次读入就能服务 32 个 head,KV 的实际访存从「每 head 一遍」降到「整段一遍」。这是它与 GPU 上 FlashDecoding 共享的核心思路——沿序列维切开、再用 partial 合并;站内 FlashAttention 完全拆解(二):序列维并行讨论过 GPU 版本的做法,这里看 CPU 版本如何实现。
预填充:按 Q 行切,再加一档 4 × nth
非 split-KV 路径的切分代码很简短:
const int64_t nr = neq1*neq2*neq3; // 所有 query 行(含 head 与 stream 维)
const bool disable_chunking = ggml_is_numa();
// 4x chunks per threadint nth_scaled = nth * 4;int64_t chunk_size = (nr + nth_scaled - 1) / nth_scaled;int64_t nchunk = (nr + chunk_size - 1) / chunk_size;
if (nth == 1 || nchunk < nth || disable_chunking) { nchunk = nth;}...const int64_t dr = (nr + nchunk - 1) / nchunk;
int current_chunk = ith;while (current_chunk < nchunk) { const int64_t ir0 = dr * current_chunk; const int64_t ir1 = MIN(ir0 + dr, nr); if (use_tiled) ggml_compute_forward_flash_attn_ext_tiled(params, dst, ir0, ir1); else ggml_compute_forward_flash_attn_ext_f16_one_chunk(params, dst, ir0, ir1, 0, nek1, nullptr, 0); current_chunk = ggml_threadpool_chunk_add(params->threadpool, 1);}这段代码和 mul_mat 的任务派发几乎同构,值得对照着看:
- 任务数取线程数的 4 倍。每个任务里只有一个 query 行、要扫一遍全部 KV,工作量差异很大(causal mask 下靠后的行扫得更多),4 倍是为了让动态领取有机会抹平负载差异;
- NUMA 时退回一维静态切分。
ggml_is_numa()为真时直接把nchunk设成nth,每个线程固定一段行。理由和mul_mat里那段 NUMA 兜底一样:任务窃取会打乱「线程只碰自己的内存」的局部性,跨节点访存代价超过负载均衡收益; nchunk < nth时退化为nchunk = nth。这时任务数等于线程数,部分线程会拿到空区间(ir0 >= ir1),进函数后循环体一次都不执行,但依然要去 barrier 汇合。
ggml_threadpool_chunk_add 是 mul_mat 里那个原子计数器的复用:同一个线程池字段 current_chunk,同一个 barrier 重置点。也就是说,注意力和矩阵乘共享同一套动态派发机制,只是任务块的含义从「行 × 列」变成了「一组 query 行」。
tiled:把 FlashAttention 的分块算法搬到 CPU
在 x86/ARM 上,预填充的注意力走 ggml_compute_forward_flash_attn_ext_tiled,它是 FlashAttention 算法的 CPU 版本。FlashAttention 的出发点是 GPU 的显存层次:把 的注意力矩阵切块,避免中间矩阵落到 HBM 上。CPU 这边的动机略有不同——L1/L2 容量远小于 GPU 的 SRAM,但同样存在「中间矩阵一旦落到内存就变成带宽问题」的困境。
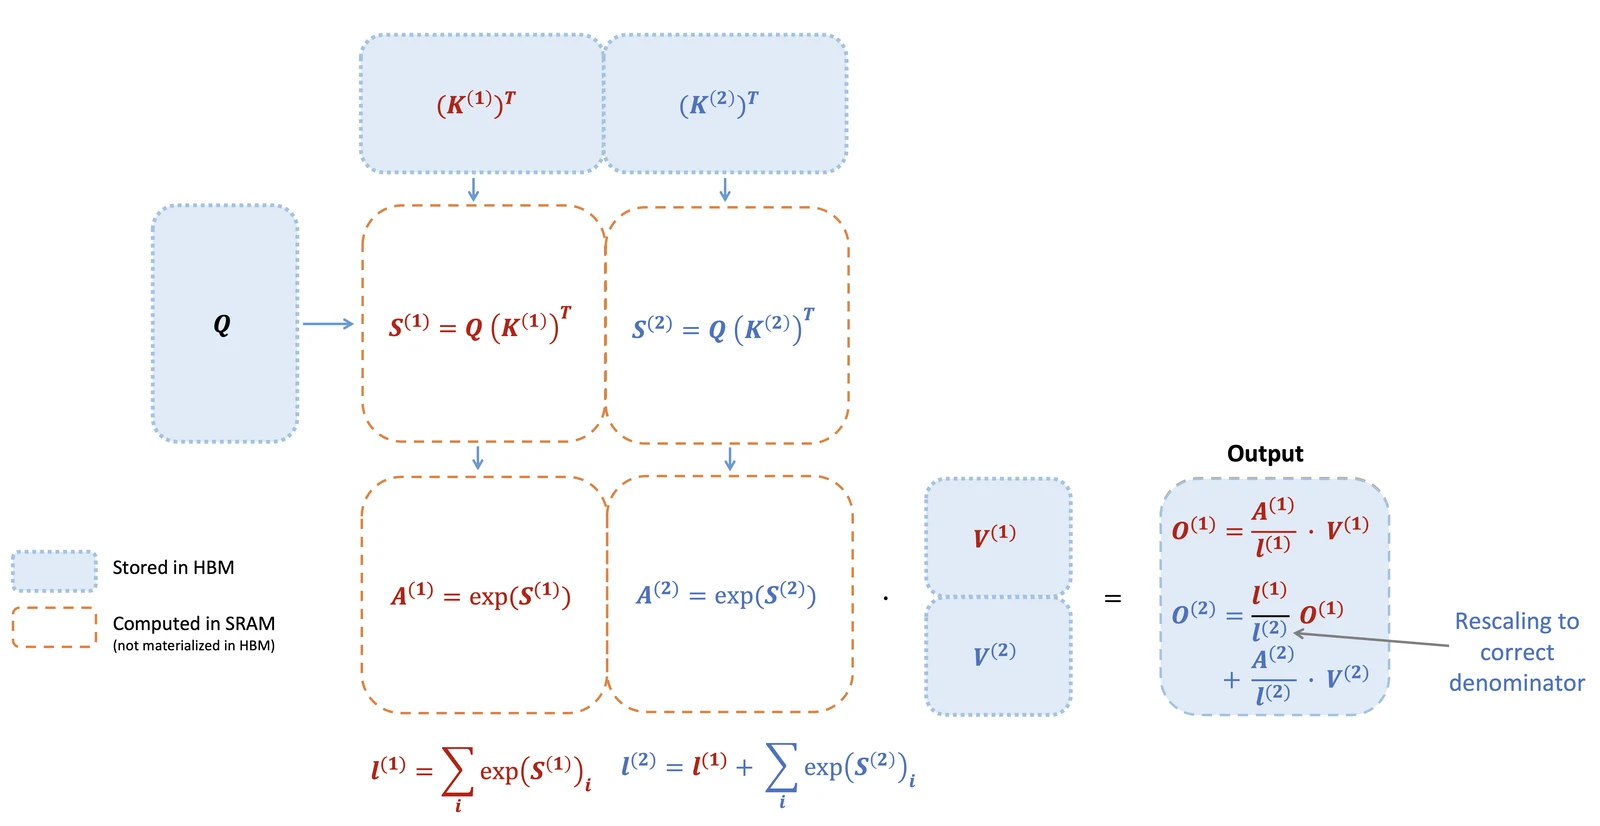
上图展示了分块注意力的核心循环:外层遍历 K/V 块,内层对每个块计算局部 softmax,再用重缩放把结果合并。数学上保证正确的关键是在线 softmax:维护已见元素的当前最大值 与指数和 ,每遇到更大的值就把已累积的输出乘以 。
CPU 实现里把这些状态都放在线程私有的工作缓冲里,布局是(tile 尺寸定义在 common.h,GGML_FA_TILE_Q = 64、GGML_FA_TILE_KV = 64):
// Q_q: Q_TILE_SZ * DK 已转成计算类型的 Q tile// KQ: Q_TILE_SZ * KV_TILE_SZ 注意力分数// mask: Q_TILE_SZ * KV_TILE_SZ 掩码// VKQ32: Q_TILE_SZ * DV 输出累加器// V32: KV_TILE_SZ * DV V tile 的 F32 缓冲// K_f32: KV_TILE_SZ * DK K tile(GEMM 路径)float * base = (float *) params->wdata + ith*(Q_TILE_SZ*DK + 2*Q_TILE_SZ*KV_TILE_SZ + Q_TILE_SZ*DV + KV_TILE_SZ*DV + KV_TILE_SZ*DK + CACHE_LINE_SIZE_F32);这块 scratch 的字节数就是 work_size 估算里 prefill 那一项的来源:
size_t prefill = sizeof(float)*(GGML_FA_TILE_Q*DK + 2*GGML_FA_TILE_Q*GGML_FA_TILE_KV + GGML_FA_TILE_Q*DV + GGML_FA_TILE_KV*DV + GGML_FA_TILE_KV*DK)*n_tasks;cur += MAX(prefill, decode);注意 work_size 对 prefill 与 decode 取 MAX 而不是相加:同一个节点只可能走其中一条路径,规划器按两者中更大的那个预留。也注意这里乘了 n_tasks——每个线程一份 scratch,这是工作缓冲与 n_tasks 成正比的最典型例子。
tiled 路径里有一个容易被忽略的优化:整块掩码全为 时直接跳过。
if (mask) { bool can_skip = true; for (int tq = 0; tq < tile_rows; tq++) { for (int tk = 0; tk < kv_tile; tk++) { mask32[tq * KV_TILE_SZ + tk] = slope * GGML_CPU_FP16_TO_FP32(mp_row[ic + tk]); if (mask32[tq * KV_TILE_SZ + tk] != -INFINITY) can_skip = false; } } if (can_skip) continue;}因果掩码下,靠前的 query 行对应的 KV 块里大部分都是「未来」的位置。不做这个检查,每个空块照样要算一遍 、过一遍 softmax、再累加一遍 ——全都是无效工作。跳过之后,一个 tile 的实际计算量与它覆盖的因果范围成正比,而不再是全 KV 长度。这个检查的代价是读一遍 64×64 的掩码,相比被省掉的几百次点积几乎可以忽略。
还有一处值得说的数据摆放:
// Pack K tile transposed: K_f32[dk][kv] so KV_TILE is contiguous (SIMD dim)K 块被转置成 的布局,原因是后面按列算点积时, 需要 K 在连续维度上。与 mul_mat 里「激活先转成 Q8_K」的思路一致:数据摆放服从内核的访存模式,而不是让内核去迁就原始布局。
split-KV:把 KV 切成段,各算各的,再合并
这是本篇最值得细看的一条路径,因为它是 CPU 上「序列维并行」的完整实现。
当 neq1 == 1 && neq3 == 1(单 token、单 stream)且 nek1 >= 512 时,注意力改按 KV 切:
const int64_t chunk_size = (nek1 + nth - 1) / nth;// Partials buffer layout: [q_head][kv_chunk][M, S, VKQ]const int64_t partial_size = 2 + DV;float * partials_base = (float *) params->wdata + nth * (DK + 2*DV + CACHE_LINE_SIZE_F32);
const int64_t ic_start = ith * chunk_size;const int64_t ic_end = std::min(ic_start + chunk_size, nek1);
const int64_t partial_stride = nth * partial_size;float * chunk_partials = partials_base + ith * partial_size;
if (ic_start < nek1) { for (int64_t q_head = 0; q_head < neq2; q_head++) { ggml_compute_forward_flash_attn_ext_f16_one_chunk( params, dst, q_head, q_head + 1, ic_start, ic_end, chunk_partials, partial_stride); }} else { for (int64_t q_head = 0; q_head < neq2; q_head++) { float * q_partials = chunk_partials + q_head * partial_stride; q_partials[0] = -INFINITY; // M q_partials[1] = 0.0f; // S }}ggml_barrier(params->threadpool);ggml_flash_attn_ext_reduce_partials(params, dst, nth, chunk_size);结构是「先分、再 barrier、后合」:每个线程负责一段 KV,为所有 head 各算一遍,得到该段上的局部 三元组;全部算完后,全线程在节点内的 barrier 上汇合,再由一部分线程做合并。
几个设计细节:
第一,分的是 KV,不是 query head。 query head 数量通常有 32,本身就是可切的维度,逐行版正是按它切;但按 head 切不能改变「每个 head 读一遍 KV」这个事实。按 KV 切之后,每段 KV 在线程的私有 scratch 里只出现一次,被 32 个 head 轮着用。切分维度变了,访存强度也随之变了——这是 split-KV 与逐行版的本质区别,而不只是并行度。
第二,每个线程还要串行处理所有 query head。 32 个 head 意味着每个线程内部是一个 32 次循环,每次处理一个 head 的一段 KV。head 之间的 scratch 共用,所以 partial_stride = nth * partial_size:同一个线程的不同 head 写到相隔 nth 步的位置,不同线程的同一 head 则是连续的一段。这个布局让合并阶段可以按 (q_head, chunk) 二维索引。
第三,ic_start >= nek1 的线程仍要写合法值。 当 nth * chunk_size 大于 nek1 时末端几个线程负责的区间是空的。它们不能什么都不写,否则合并阶段会读到未初始化的内存;所以显式写入 、,让合并逻辑通过 if (S_chunk == 0.0f) continue; 跳过。
合并:再一次在线 softmax
ggml_flash_attn_ext_reduce_partials 做的事情,是把各段的局部结果用一个统一的在线 softmax 合成完整结果:
for (int64_t q_head = ith; q_head < n_q_heads; q_head += nth) { float M_final = -INFINITY, S_final = 0.0f; float * VKQ_final = thread_wdata; memset(VKQ_final, 0, DV * sizeof(float));
for (int64_t chunk_idx = 0; chunk_idx < n_chunks; ++chunk_idx) { const float * partial = partials_base + (q_head * n_chunks + chunk_idx) * partial_size; const float M_chunk = partial[0], S_chunk = partial[1]; const float * VKQ_chunk = partial + 2; if (S_chunk == 0.0f) continue;
const float M_new = fmaxf(M_final, M_chunk); const float scale_old = expf(M_final - M_new); const float scale_new = expf(M_chunk - M_new); for (int64_t d = 0; d < DV; ++d) VKQ_final[d] = VKQ_final[d] * scale_old + VKQ_chunk[d] * scale_new; S_final = S_final * scale_old + S_chunk * scale_new; M_final = M_new; } if (S_final != 0.0f) ggml_vec_scale_f32(DV, VKQ_final, 1.0f / S_final); memcpy((char *) dst->data + q_head*nb1 + 0*ne1*nb1, VKQ_final, nb1);}这里用的是双状态在线 softmax:与单个线程内部「维护 和 」不同,合并时两个状态的贡献要分开缩放——局部 VKQ 存的是「未归一化的加权和」(相当于 ),所以合并时既要按 缩放向量,也要按同样比例缩放 。最后统一除以 。这是 FlashDecoding 的标准做法,站内 FlashAttention 完全拆解(二)有更完整的推导。
为什么必须先减最大值
合并公式里每一步都先取 M_new = fmaxf(M_final, M_chunk),再算 expf(M - M_new)。如果跳过这一步,直接累加 ,在 较大时(例如 attention logits 落在 20–30 的范围) 会迅速超出 FP32 的表示范围( 附近就溢出),后面的除法变成 。减去当前最大值之后,所有指数都落在 ,,不会上溢;代价是每遇到新的最大值要把已累积的向量整体缩放一次。
这个「先减最大值」的操作在单线程版里表现为 ggml_vec_scale_f32(DV, VKQ32, ms),在合并版里表现为对 VKQ_final 的逐元素乘加。两者都是 ,在 DV=128 时不过一百多次乘加。代价不在算术量,而在于它是串行的:合并阶段每个 head 的这段循环只能由一个线程完成,且必须按 chunk 顺序推进。
还有一个边界情况:所有 KV 都被掩码挡住(例如一个完全空的序列,或在某些受限解码场景)。此时每个 chunk 的 ,合并循环通过 if (S_chunk == 0.0f) continue; 跳过,最终 S_final 仍为 0,输出通过 S_final != 0.0f 的判断直接保持 memset 的零值,不会出现 0/0。这类边界在正常对话里罕见,但在测试和投机解码的拒绝分支里会出现。
合并阶段本身又做了一次并行:for (q_head = ith; q_head < n_q_heads; q_head += nth) 按 head 做轮转分配。解码时 head 数是 32、线程数可能是 16 或 32,每个线程负责 1–2 个 head,每个 head 要扫过 nth 个分段(例如 16 段,每段 DV=128 个 float)。合并的算术量是 次乘加,对 32 head、16 段、128 维是约 6.5 万次乘加——相对整层的乘加量很小,但它是单线程宽度的:每个 head 的合并由一个线程独立完成,没有进一步的并行。
为什么 split-KV 的门槛是 512
nek1 >= 512 这个条件不是随手定的。拆开来看,split-KV 相比逐行版增加的开销有三块:
- partials 缓冲的读写:每个线程要写 个 float,合并时要全部读回。以 32 head、、16 线程为例,partials 是 ,已经超出 L2 的舒适范围;
- 一次节点内的 barrier;
- 合并阶段的串行等待:合并由部分线程完成,其余线程在合并期间空闲——它们在
ggml_flash_attn_ext_reduce_partials里按 head 轮转,head 数少于线程数时确实有闲置。
这些开销大致是常数级的,而 split-KV 带来的收益有两部分:并行度从 min(线程数, head 数) 变成线程数(head 数少于线程数时才成为瓶颈),以及 KV 访存被 head 数摊薄。后者只有在「每段 KV 真的能留在缓存里」时才成立。门槛 512 本质上是一个经验交点:、16 线程时每段只有 32 个 key,,仍在 L1/L2 的舒适范围内;若门槛降到 128,每段只有 8 个 key,partials 的固定成本占比会迅速上升,而缓存复用的收益反而不明显。源码把阈值写成常量,是承认这个交点需要按典型硬件标定,而不是从公式推导出来的。
还要注意一个不那么明显的结果:split-KV 路径里 dr 意义上的负载均衡几乎不存在。每个线程固定一段长度相等的 KV,causal mask 对单 token query 不起作用(它只与历史 token 相关,全部可见),所以各段工作量确实均匀。这也是这条路径敢用静态切分的原因——它的并行度来自 KV 长度而不是任务数。
把字节账算出来
用一组具体数字比较逐行版与 split-KV 的访存。取 32 个 query head、8 个 KV head(每 4 个 query head 共享 1 个 KV head)、head 维 128、KV 长度 4096、KV 类型 F16、单层:
- 每个 KV head 的 K 是 ,V 同样 1 MB;8 个 KV head 合计 16 MB/层;
- 逐行版:每个 query head 处理一行,读取它对应的 KV head 的 K 与 V。32 个 head 合计 的逻辑读取。如果 L2/L3 能把这些数据留住,物理 DRAM 流量可能接近 16 MB;但在 32 层连续执行、每层 16 MB 的工作集下,跨层复用几乎不可能,层内能否复用取决于 L3 容量;
- split-KV 版:每个线程拿到一段 KV(16 线程、4096 长度时每段 256 个 key),在段内轮询 32 个 query head。同一段 K/V 在 L1 里被读入一次、复用 4 次(每个 KV head 对应 4 个 query head),理论上每层的唯一 KV 读取量就是 16 MB;
- 额外的 partials 流量:,约占 16 MB 的 1.7%。写 partials 时是每个线程写自己的 32 个 head 结果,读 partials 时按 head 轮转——两次都是顺序访问,对带宽友好。
这组数字说明了一件反直觉的事:split-KV 的主要收益不是「并行度变高」,而是「同样的 KV 只读一遍」。对 32 head 的模型,逐行版与 split 版的并行宽度都可以是 16,差别在于每个线程的 KV 工作集是「整段 1 MB」还是「一段 8–64 KB」。后者能进 L1/L2,前者不能。门槛 512 也就可以从缓存角度理解:只有当每段足够小、整段 KV 又能被所有 head 复用时,改写循环次序才有意义。
当然,实际硬件上逐行版并非一定读 64 MB:多线程并发时 L3 可能替它兜住一部分重复读取。这也是为什么 split-KV 的收益在不同 CPU 上差异很大——L3 越大的服务器,逐行版被缓存救得越多,split 的相对优势越小;L3 较小的桌面/边缘设备,split 的收益更明显。源码把选择条件写成「KV 长度 ≥ 512」再加类型限制,是一个对多种硬件都成立的保守门槛,而不是针对某一台机器调出的最优值。
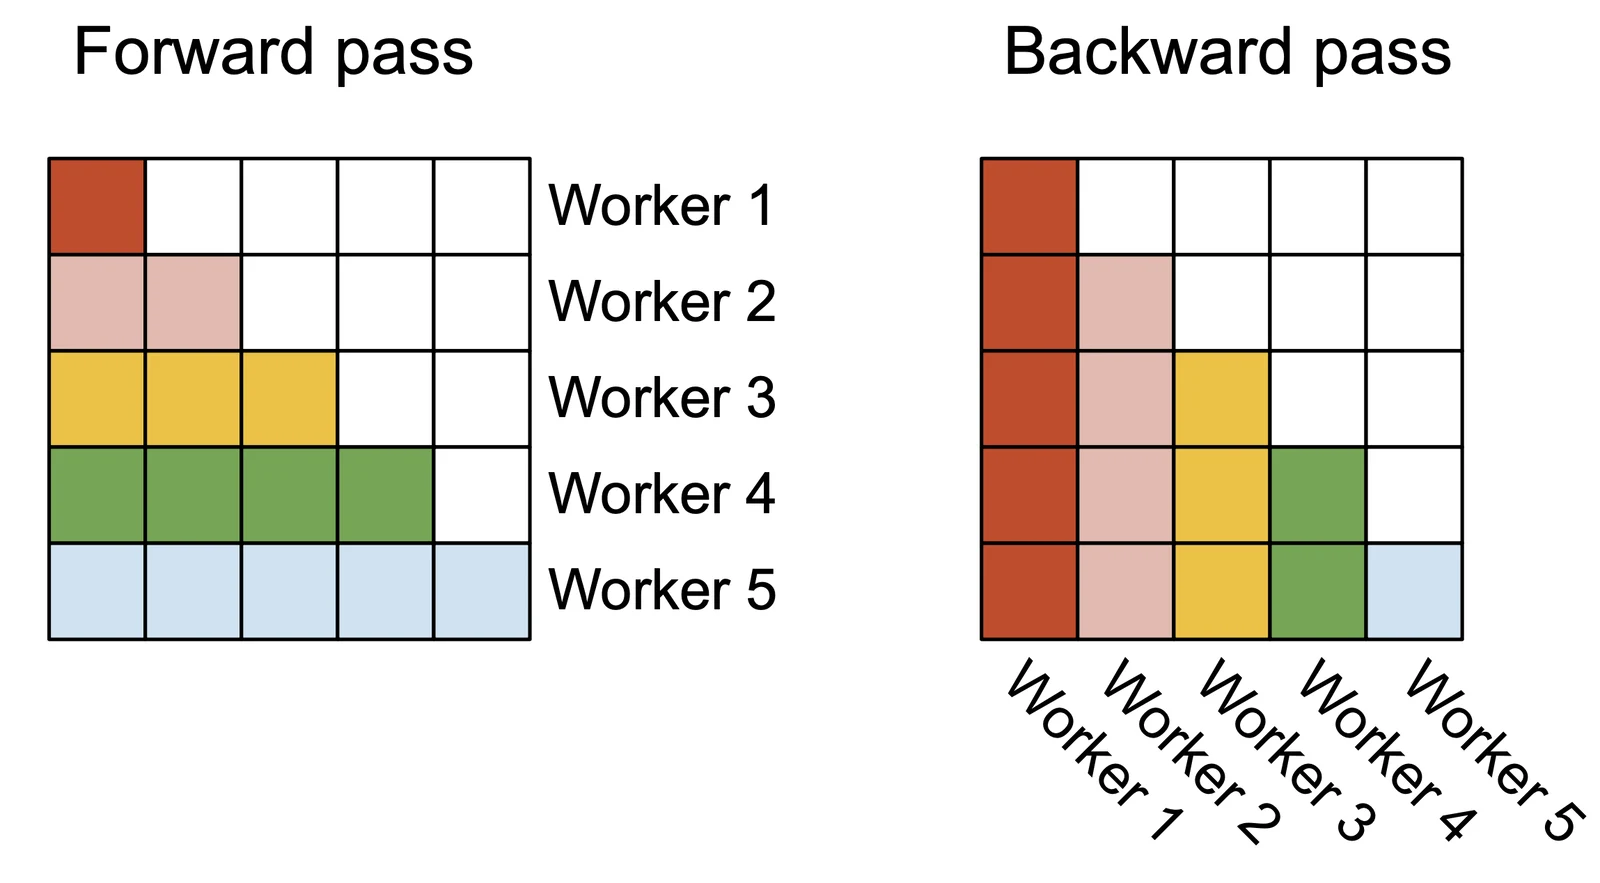
上图是 FlashAttention-2 论文里关于线程块划分的示意。CPU 版的 split-KV 和 GPU 版的 FlashDecoding 在形式上是一致的:都沿着序列维切开,都靠 partial 三元组合并。差别在于 CPU 版的「线程块」只有几十个,每个线程的 scratch 是普通的工作缓冲而非共享内存;GPU 版能同时跑成百上千个 block,因此更频繁地走这条路径。
逐行版:最朴素、也最不容易出错的那条路
当 tiled 与 split-KV 都不适用时(小 D、非 SIMD 平台、use_ref 参考模式),走的是 ggml_compute_forward_flash_attn_ext_f16_one_chunk。它每次处理一个 query 行、一个 head,对整段 KV 做逐元素的在线 softmax:
const ggml_type k_vec_dot_type = ggml_get_type_traits_cpu(k->type)->vec_dot_type;ggml_from_float_t const q_to_vec_dot = ggml_get_type_traits_cpu(k_vec_dot_type)->from_float;ggml_vec_dot_t const kq_vec_dot = ggml_get_type_traits_cpu(k->type)->vec_dot;...q_to_vec_dot(pq, Q_q, DK);
for (int64_t ic = ic_start; ic < ic_end; ++ic) { const float mv = mp ? slope*GGML_CPU_FP16_TO_FP32(mp[ic]) : 0.0f; if (mv == -INFINITY) continue;
float s; kq_vec_dot(DK, &s, 0, k_data, 0, Q_q, 0, 1); s = s*scale; if (logit_softcap != 0.0f) s = logit_softcap*tanhf(s); s += mv;
const float Mold = M; float ms = 1.0f, vs = 1.0f; if (s > M) { M = s; ms = expf(Mold - M); ggml_vec_scale_f32(DV, VKQ32, ms); } else { vs = expf(s - M); } ggml_vec_mad_f32(DV, VKQ32, v_row, vs); S = S*ms + vs;}const float S_inv = S == 0.0f ? 0.0f : 1.0f/S;ggml_vec_scale_f32(DV, VKQ32, S_inv);这段代码信息量很大,逐点说明:
q_to_vec_dot把 Q 转成 K 的vec_dot_type。当 K 是量化类型时,点积内核是「量化矩阵 × Q8 激活」那一套,所以 Q 必须先量化;当 K 是 F16 时,Q 转成 F16。这解释了为什么work_size里要预留DK个 float 给 Q。vec_dot_type/from_float/vec_dot三元组与mul_mat完全同构。注意力的 K 点积复用了矩阵乘的点积内核——同一个vec_dot函数指针,既是mul_mat的最内层,也是注意力的最内层。这是上一篇文章里「契约只有一个」那句话在注意力上的延续。- 掩码值
mv以加数形式并入 ,而不是单独存一个掩码数组。因果掩码下mv = -INFINITY时直接continue,连点积都省了。 - 每遇到新的最大值,都要把已累积的
VKQ32整体缩放一次。这是在线 softmax 的单线程实现:与图里那种「分块后重缩放」在数学上相同,但代价是ggml_vec_scale_f32(DV, ...)在一个循环里被调用了许多次。对DV = 128来说每次是 128 个 float 的乘,而在一条 4096 长的 KV 上,缩放次数大致等于「新的最大值出现次数」——长尾分布下并不少。
这条路径是三条里最慢的,但也是最容易验证的:数学直接对应公式,没有分块、没有合并。use_ref 参考模式强制走它,用意正是在测试里提供一个正确性基准。
注意力的访存:KV Cache、掩码与 wdata
三条路径都读同一份 KV Cache,但读法不同:
| 张量 | 形状与类型 | 访问量 | 三条路径的差别 |
|---|---|---|---|
k | ,常见 F16/量化 | 每 query 行读全段 | split-KV 每个线程只读自己那段 |
v | ,F32 或 F16 | 同上 | 同上 |
mask | FP16, 左右 | 每 token 每行 2 字节 | tiled 一次读 64×64 一块 |
wdata | 线程私有 scratch | 见 work_size | split-KV 还多一块 partials |
值得单说的是掩码的体积。build_attn_inp_kq_mask 分配的形状是 [n_kv, n_tokens/n_stream, 1, n_stream],类型在启用 FlashAttention 时是 F16。也就是说掩码在 head 维上是广播的,不按 head 复制;但它在 上是满的。解码时 ,128K 上下文对应约 256 KB 的掩码;预填充时 若是 512,128K 上下文下就是 。它由 set_input_kq_mask 在每次 ubatch 前生成,这一步本身也是按行切分的写入,而不是计算节点。超长上下文预填充时,掩码生成会成为一个显著的内存写入项——这是 CPU 推理里不太被讨论、但确实存在的成本。
KV Cache 本身在 CPU 上一般是 F16,也可以用 -ctk / -ctv 指定为量化类型。量化 KV 的好处是带宽减半,代价是注意力的 K 点积要换走量化点积路径。站内 llama.cpp 源码完全拆解(四):llama_context 与记忆系统讲过 KV 的分配,这里只需记住:注意力的访存量基本等于 KV Cache 的字节数乘以 query 行数,这是 decode 阶段另一个带宽来源,只是它随层数分布在数十个注意力节点上,而不是像 mul_mat 那样集中。
写 KV:SET_ROWS 与它背后的槽位
在一次 decode step 里,每层在注意力之前都要把本 token 的 K、V 写进缓存,在图上是两个 SET_ROWS 节点。建图侧的代码是:
ggml_build_forward_expand(gf, mctx_cur->cpy_k(ctx0, k_cur, k_idxs, il));ggml_build_forward_expand(gf, mctx_cur->cpy_v(ctx0, v_cur, v_idxs, il));而 cpy_k 本身非常短:
const int64_t n_embd_gqa = n_embd_head*n_head;k_cur = ggml_view_2d(ctx, k_cur, n_embd_gqa, n_tokens, k_cur->nb[2], 0);if (n_stream > 1) k = ggml_reshape_2d(ctx, k, n_embd_gqa, kv_size*n_stream);return ggml_set_rows(ctx, k, k_cur, k_idxs);三个要点:
- head 维与特征维先合并成一维。原本的
k_cur是 ,这里 view 成 ,也就是一行就是一个 token 的全部 K。这是一次零拷贝的元数据改写; - 多 stream 时把整个 KV 缓冲摊平成二维,因为槽位索引是全局的(跨 stream 统一编号);
- 写入是
set_rows,不是cpy。槽位索引k_idxs告诉每个 token 应该写到哪一行——这些槽位由 KV Cache 在 ubatch 准备阶段分配,可能不连续(前缀缓存命中、碎片化)。
SET_ROWS 在 CPU 侧的切分按源行:
const int64_t dr = (nr + nth - 1)/nth;const int64_t ir0 = dr*ith, ir1 = std::min(ir0 + dr, nr);...from_float(src_row, dst_row, nc);也就是说,每个线程负责若干个 token 的整行写入。这个切分只对预填充有意义:decode 时 n_tokens = 1,只有线程 0 干活,其余线程照样去 barrier 汇合。
有一个细节容易被忽略:from_float 说明写入路径会自动完成类型转换。当 KV Cache 用 F16 或量化类型时,图的输出 K 是 F32,写入时逐行转成缓存类型。这条转换在每层每 token 都要做一次,32 层就是 32 次转换加 32 次写。它的计算量可以忽略,但它把「一次节点计算 + 一次 barrier」的固定成本叠加了 32 次。
与 RoPE 的位置关系
大多数模型在写入缓存之前完成 K 的旋转:建图时为 K 建一个 ROPE 节点,旋转后的张量再交给 cpy_k。llama.cpp 新版本里更进一步:当 K/V 是量化类型且 head 维是 64 的倍数时,会在缓存上启用一层注意力旋转(Hadamard rotation),参数在缓存构造时决定:
bool attn_rot_k = !attn_rot_disable && n_embd_head_k_all > 0 && ggml_is_quantized(type_k) && hparams.n_embd_head_k() % 64 == 0;它的动机与量化 KV 有关:先旋转再量化可以让量化的误差在 head 维上更均匀,和站内 vLLM 源码完全拆解(十九):TurboQuant KV Cache 量化讨论的 Hadamard 旋转是同一类手段。这一段代码只决定是否启用以及旋转维度 n_rot_k(从 64 起倍增到不超过 head 维的一半)。旋转本身不是 set_rows 内部完成的:建图时会在 K/V 投影之后、写缓存之前插入一个 llama_mul_mat_hadamard 节点,cpy_k 拿到的已经是旋转后的张量。这多出来的一对 MUL_MAT 节点(K 与 V 各一次)也计入前面那张节点表之外的额外开销,量化 KV 的收益要扣掉这部分。本篇不展开旋转的数学,后文讲融合时会再次遇到它。
RoPE:按行切,但隐藏了三个「每线程私有的缓存」
RoPE(Rotary Position Embedding)在 ggml 版 llama.cpp 里的节点参数很多:n_dims、mode(NORMAL / NEOX / MROPE / VISION)、n_ctx_orig、freq_base、freq_scale、yarn 的 ext_factor / beta_fast / beta_slow、mrope 的 sections 等。节点执行时的切分却是按行:
const int nr = ggml_nrows(dst);const int dr = (nr + nth - 1)/nth;const int ir0 = dr*ith;const int ir1 = MIN(ir0 + dr, nr);int ir = 0;...for (int64_t i3 = 0; i3 < ne3; i3++) // batchfor (int64_t i2 = 0; i2 < ne2; i2++) // seq-lenfor (int64_t i1 = 0; i1 < ne1; i1++) { // attn-heads if (ir++ < ir0) continue; if (ir > ir1) break; ...}三处值得展开:
第一,每个线程有一份 cos/sin 缓存。缓存位置在:
float * cache = (float *) params->wdata + (ne0 + CACHE_LINE_SIZE_F32)*ith;即每个线程从 wdata 里切出 ne0 + 16 个 float(CACHE_LINE_SIZE_F32 是 16)。ne0 是 head 维,缓存里存的是本 token 位置对应的 cos 与 sin。+ CACHE_LINE_SIZE_F32 的偏移是为了让相邻线程的缓存不落在同一个缓存行上——这是典型的伪共享规避,和 mul_mat 里 partials 缓冲的做法一致。
第二,缓存按位置键控,只在位置变化时重算。循环里用 last_i2 记录上次计算缓存时的位置:
if (last_i2 != i2) { const int64_t p = pos[i2]; ggml_rope_cache_init(p, freq_scale, freq_factors, corr_dims, ne0, ext_factor, attn_factor, cache, sin_sign, theta_scale); last_i2 = i2;}原因很简单:同一位置的多个 head 共享同一组 cos/sin。32 个 head 的顺序遍历中,位置只变化一次,所以缓存只算一次,其余 31 次都是直接读。如果没有这个缓存,每个 head 都要重算一遍 powf 与 expf——在 freq_base 为 10000、维度 128 的时候,这会是明显可测的开销。
第三,mrope 的缓存一次要算四个位置。多模态位置编码用 四个坐标,每段维度使用不同坐标对应的频率:
const int64_t p_t = pos[i2];const int64_t p_h = pos[i2 + ne2];const int64_t p_w = pos[i2 + ne2*2];const int64_t p_e = pos[i2 + ne2*3];ggml_mrope_cache_init(p_t, p_h, p_w, p_e, sections, is_imrope, is_vision, ...);pos 张量的长度是 4*ne2,四个坐标按段拼接。这解释了为什么 mrope_used 时缓存计算的成本是普通 RoPE 的四倍左右。
旋转的配对方式:NORMAL 与 NEOX 差在哪
RoPE 的数学形式是「把 head 维的每两个分量看成一对,按位置旋转一个角度」。但哪两个分量算一对,不同模型并不一样。ggml 用 mode 参数区分:
switch (mode) { case GGML_ROPE_TYPE_NORMAL: rotate_pairs<T>(n_dims, 1, cache, src + n_offs, dst_data + n_offs, 1); break; case GGML_ROPE_TYPE_NEOX: case GGML_ROPE_TYPE_MROPE: case GGML_ROPE_TYPE_IMROPE: rotate_pairs<T>(n_dims, n_dims/2, cache, src + n_offs, dst_data + n_offs); break; case GGML_ROPE_TYPE_VISION: rotate_pairs<T>(ne0, n_dims, cache, src, dst_data); break;}rotate_pairs 的参数是「参与旋转的维数、配对步长、cos/sin 缓存、源指针、目标指针」。两种主要模式的配对规则:
- NORMAL:相邻分量配对, 使用第 组频率。这是原始 RoPE 论文的排布,也是 GPT-NeoX 之前多数模型的写法;
- NEOX:前后两半配对, 使用第 组频率。GPT-NeoX、LLaMA 系列采用这种排布,好处是与 Q/K 投影权重的列顺序更自然地对齐,也让向量化的旋转实现更容易;
- VISION:视觉编码器的二维 RoPE,配对步长等于
n_dims,每个位置有独立的频率组。
n_offs 是旋转的起始偏移,允许只旋转 head 维的一段(例如某些模型只旋转前 64 维,剩下的是 NoPE)。源码里旋转完成后还有一段「把未旋转的通道从源拷贝到目标」的循环:
if (!is_vision) { for (int64_t i0 = 0; i0 < ne0; i0 += 2) { if (i0 == n_offs) { i0 += n_dims - 2; continue; } dst_data[0] = src[0]; dst_data[1] = src[1]; }}这段循环的存在说明:ROPE 节点的输出并不只是「旋转过的部分」,而是整个 head 维。未旋转的通道必须原样搬运,否则下游注意力会读到未初始化数据。这也意味着即使 n_dims 只有 64、head 维是 128,RoPE 依然要读写完整的 128 维——一半的带宽花在拷贝上。某些架构因此把 NoPE 部分单独切出来,避免这次无谓的拷贝;这是模型层面的优化,不是 ROPE 算子本身的。
理解配对规则对读后面的代码有直接帮助:rotate_pairs 的第二个参数决定了 src 与 dst 的索引步长,也决定了每行的工作量是 次旋转(NORMAL)还是 次跨半区旋转(NEOX)。两者计算量相同,但访存模式不同:NORMAL 是顺序读相邻两元素,NEOX 是一前一后两个相距 n_dims/2 的元素。对 CPU 缓存来说,NORMAL 更友好;这也是部分模型在转换到 ggml 时需要重排权重的原因之一。
行切分的实际并行度
RoPE 的行数是 。decode 时 ,行数就是 head 数(32)。如果线程数超过 32,dr = 1,前 32 个线程各处理一行,后面的线程拿到 ir0 >= ir1 的空区间。注意力里 head 是 32,RoPE 这里也是 32,但 RoPE 没有像注意力那样按 KV 切——因为 RoPE 的计算量与 KV 长度无关,只有 head 维的 组旋转对,每行的工作量固定且很小。
这一点决定了 RoPE 在 decode 阶段是一个「并行度有限的小节点」:即使线程很多,它也只能用满 min(nth, 32) 个线程,其余线程在 barrier 处等待。单次 RoPE 的时间可能只有几微秒,但它连同 barrier 一起,在 32 层里重复出现——barrier 的数量不随 RoPE 变快而减少。
RMSNorm:按行切,但每行是一个串行归约
RMSNorm 的实现比 RoPE 更短:
for (int64_t i03 = 0; i03 < ne03; i03++)for (int64_t i02 = 0; i02 < ne02; i02++)for (int64_t i01 = ith; i01 < ne01; i01 += nth) { const float * x = (float *) ((char *) src0->data + i01*nb01 + i02*nb02 + i03*nb03); ggml_float sum = 0.0; for (int64_t i00 = 0; i00 < ne00; i00++) sum += (ggml_float)(x[i00] * x[i00]); const float mean = sum/ne00; const float scale = 1.0f/sqrtf(mean + eps); float * y = (float *) ((char *) dst->data + i01*nb1 + i02*nb2 + i03*nb3); memcpy(y, x, ne00 * sizeof(float)); ggml_vec_scale_f32(ne00, y, scale);}三处取舍:
第一,按 stride 轮转而不是按区间切。 i01 = ith; i01 < ne01; i01 += nth 是轮转式切分,而不是 ir0/ir1 区间式。两种写法对负载均衡等价,但轮转式让相邻线程处理相邻行。RMSNorm 的每一行是一个 token、行宽是隐藏维(ne00),行内连续、行间也连续,所以相邻线程读的是相邻行,恰好构成顺序访存,对硬件预取友好。这也是它和 mul_mat 那种「区间切分」不同的原因之一。
第二, 的归约在单线程内完成。 每行一次平方和、一次缩放, 的元素在 AVX2 上是 128 个 float 归约,ggml_vec_dot_f32 里是「8 路累加器 + 尾部处理」的典型写法。归约本身不跨线程——RMSNorm 的并行粒度是行,行内是串行的。解码时行数是 1(只有一个 token),所以整个节点实际只用 1 个线程。
第三,scale 用 1/sqrtf(mean + eps) 而不是 rsqrtf。 这一选择在 x86 上差别很小(两者都是单条指令),在 ARM 上也没有明显收益;写 1/sqrtf 更像是为了与浮点语义保持一致,避免 rsqrt 近似带来的精度差异。
解码阶段 RMSNorm 每层两次、每次单线程、每次几微秒。它的时间占比不高,但它和 RoPE 一样是「barrier 贡献者」:两个节点、两次全线程同步。
节点融合:把「几次 barrier」变成「一次」
既然这些小节点的计算量都很小、barrier 却不少,最自然的优化就是把几个节点合成一个节点执行。llama.cpp 的 CPU 后端为此留了一个入口:
static int ggml_cpu_try_fuse_ops(cgraph, node_n, params, cplan) { if (ggml_cpu_disable_fusion || cplan->use_ref) return 0; struct ggml_tensor * node = cgraph->nodes[node_n]; if (node->op == GGML_OP_RMS_NORM) { const enum ggml_op fuse_ops[] = { GGML_OP_RMS_NORM, GGML_OP_MUL }; if (ggml_can_fuse(cgraph, node_n, fuse_ops, 2)) { struct ggml_tensor * mul_node = cgraph->nodes[node_n + 1]; const ggml_tensor * mul_w = (mul_node->src[0] == node) ? mul_node->src[1] : mul_node->src[0]; if (node->src[0]->type == GGML_TYPE_F32 && mul_node->type == GGML_TYPE_F32 && mul_w->type == GGML_TYPE_F32 && mul_w->ne[0] == node->ne[0] && mul_w->nb[0] == sizeof(float)) { ggml_compute_forward_rms_norm_mul_fused(params, node, mul_node); return 1; } } } return 0;}这段代码有几层信息。
判定条件来自 ggml_can_fuse
ggml_can_fuse 定义在 ggml-impl.h,它检查的是三个条件:
- 节点序列的算子类型与期望的
ops数组一致; - 除最后一个外,每个节点只有一个使用者(
ggml_node_has_n_uses(cgraph, idx, 1)),且不是 view、不是用户显式请求的输出; - 后一个节点的
src[0]或src[1]是前一个节点,且形状相同。
为什么这三个条件是必须的?
- 条件 2 的「只有一个使用者」:如果 RMSNorm 的结果还被别的节点使用(例如被残差
ADD用),那么融合执行时就不会写出中间结果,那个节点就拿不到数据。所以只有在「中间结果没人关心」时才能省掉它; - 条件 3 的「形状相同」:融合实现里一个线程处理一行,同时读写两个张量的同一行,形状不同就没法共用同一个行索引。
RMSNorm + MUL 这个模式在 build_norm 里是普遍存在的:
if (mw) { cur = ggml_mul(ctx0, cur, mw);}只要模型带 norm 权重(几乎全部 RMSNorm 模型都带),每层就有两次「RMS_NORM 紧跟 MUL」。融合之后,原来需要「RMSNorm 节点 + barrier + MUL 节点 + barrier」变成「融合节点 + barrier」。
融合实现真的省了什么
看 ggml_compute_forward_rms_norm_f32 的模板参数分支:
if constexpr (FUSE_OP == GGML_RMS_NORM_FUSE_OP_MUL) { src1 = (dst_fused->src[0] == dst_rms_norm) ? dst_fused->src[1] : dst_fused->src[0]; dst = dst_fused;}...if constexpr (FUSE_OP == GGML_RMS_NORM_FUSE_OP_MUL) { const float * w = src1 行指针; for (int64_t i00 = 0; i00 < ne00; i00++) y[i00] = x[i00] * scale * w[i00];} else { memcpy(y, x, ne00 * sizeof(float)); ggml_vec_scale_f32(ne00, y, scale);}原来的两步是:
- RMSNorm 把 的缩放结果写到
y; - 下一个节点 MUL 再从
y读、从权重读,写到最终输出。
融合后是:
- 一次读 、一次读权重 、一次写 。
省下的是:中间张量的一次写 + 一次读(两个 字节的访存),以及一次节点 barrier + 一次节点调度。对每层两次 norm、32 层共 64 次融合,这就是省掉 64 次 barrier、以及 128 次中间张量的读写。在隐藏维 4096、F32 的情况下,每次中间张量是 16 KB;64 层 × 2 × 32 KB(一读一写)= 4 MB 的总流量,相对权重读取可以忽略,但 barrier 的节省是可观的。
但也要看到它还没有融合的部分:RMSNorm 与它前面的 MUL_MAT 之间没有融合,与残差 ADD 也没有融合。源码用一条注释明确了目前的定位:
// TODO: move fused-op detection into ggml_graph_plan so fusion decisions are made once at planning time也就是说,融合判定在每次执行时对每个节点做一遍——虽然每层只有一次判断,但仍然是热路径上的检查。更重要的是,融合的实现目前只有一个组合(RMS_NORM + MUL)。其他后端有更丰富的融合表,例如 CANN 后端在它的调度器里识别 {ADD, RMS_NORM}、{MUL_MAT, ADD} 等组合;CPU 后端没有对应的通用表。这一点从后端自己的代码里能看出来:
// ggml-cann: if (ggml_cann_can_fuse(cgraph, i, { GGML_OP_ADD, GGML_OP_RMS_NORM }))// ggml-et: if (ggml_et_can_fuse(cgraph, i, { GGML_OP_RMS_NORM, GGML_OP_MUL }))// if (ggml_et_can_fuse(cgraph, i, { GGML_OP_MUL_MAT, GGML_OP_ADD }))CPU 后端只在 ggml_cpu_try_fuse_ops 里写死了一个组合。这是一个明确的可扩展点,也是 CPU 推理继续优化的方向之一。
关闭融合的入口
两个开关都能让融合失效:ggml_cpu_disable_fusion(在 ggml_cpu_init() 里读一次环境变量后只读)和 cplan->use_ref。后者是与调试相关的——当用户要求走参考实现时,融合路径不参与,保证输出与参考路径一致。这也间接说明,融合实现是「等价但不同代码路径」的,测试时需要两条路径都覆盖。
把节拍拼起来:一次 decode step 的时间线
把前面的分析串成一条时间线。仍以 32 层为例,一次 decode step(,KV 长度 ,线程数 ):
- RMSNorm + MUL(融合后 1 个节点):行数 1,实际只有 1 个线程在做 元素归约与缩放,其余线程 barrier 等待;
- QKV 投影(
MUL_MAT× 3):mul_mat的完整四层机制,任务按 16×16 切,是这一步里唯一能真正吃满线程的节点; - RoPE:行数 = head 数(32),min(nth, 32) 个线程在用,每线程算一次 cos/sin 缓存、旋转 对;
- 写 K(
SET_ROWS):1 行,1 个线程,带类型转换; - 写 V(
SET_ROWS):同上; - 注意力: 走 split-KV, 个线程各扫 段、每段要跑 32 个头,然后一次节点内 barrier,再按 head 合并;
- 输出投影、残差、第二次 norm、FFN(含 gate/up/down 三块
MUL_MAT与 SiLU); - 32 层重复。
时间线上真正能利用全部线程的节点只有 MUL_MAT 和注意力;其余的 norm、rope、写 KV 都是「1 到 32 行」的小节点。
这件事可以用一个简化模型量化。设 是串行计算时间, 是第 个节点实际能用上的线程数,节点之间 barrier 的固定开销记为 (与线程数近似无关,但每个节点一次),则用 个线程时一次 decode step 的耗时是:
对可以线性加速的节点,;对只能单线程的节点,。代入一个粗略的分布:mul_mat 合计占串行时间 55%,注意力占 25%,其余小节点占 20%,再取真实模型典型的 mul_mat 约占节点数三分之一、barrier 开销约占串行时间的 8%。在这个模型下,8 线程的整机加速比大约落在 2.5–3 倍区间,而不是接近 8。实际在 CPU 上观察到的加速曲线(从 1 线程加到 8 线程通常只有 2–3 倍)与这个估算的量级是吻合的。上一篇文章结尾提到过「CPU 推理的并行效率常常卡在 60%–80%」,这里给出了其中一个原因:小节点的并行度不够,而 barrier 又不会因为它们小就变便宜。
三条路径的实际选择:从源码条件到部署形态
把注意力三条路径的选择条件与真实部署对上:
| 场景 | KV 类型 | 选取的路径 | 并行度 | |
|---|---|---|---|---|
| 桌面/笔记本,F16 KV,短上下文预填充 | 128 | F16 | tiled | min(nth, 行数) 并通过 4×nth 派发 |
| 桌面/笔记本,长度 < 512 的解码 | — | — | one_chunk | min(, query head 数),每个 head 读一遍 KV |
| 服务器,F16 KV,长上下文解码 | — | F16 | split-KV | 段并行,每段 KV 被所有 head 复用 |
量化 KV(-ctk q8_0) | — | 量化 | one_chunk | min(, query head 数),且无法利用 KV 段复用 |
use_ref 调试模式 | — | — | one_chunk | min(, query head 数) |
注意第三行与第四行的对比:长上下文解码只有在 KV 是 F16 时才能用 split-KV。这是 use_split_kv_path 里 kv_is_f32_or_f16 这个条件的直接后果。量化 KV 省了带宽,却失去了序列维并行。这个权衡并不是 llama.cpp 有意设计,更像是一条路径还没有扩展到量化类型——split-KV 当前实现里的 partial 结构是 (M, S, VKQ),与 KV 类型无关,理论上可以扩展,但需要为量化 K 提供对应的点积内核接入。
工程上的几个坑
从源码里能直接读到、但在部署中才真正体会到的几件事:
一、SET_ROWS 在 decode 时只用 1 个线程。 它不像注意力那样有「 就改切 KV」的补救路径,因为写的只有 1 个 token。每个 token 每层两次写,前几次热缓存命中时不明显,但在大模型、多用户、内存带宽已经饱和的情况下,这 64 次「1 线程 + barrier」就是持续存在的固定开销。真正的解法是融合——把 norm、rope、写 KV 合成一个节点,这也是后面 llama.cpp 的融合方向。
二、work_size 被多个节点取最大值而不是累加。 规划阶段会遍历所有节点,取每个节点工作缓冲需求的最大值作为整张图的 work_size。这意味着注意力 tiled 路径的 scratch( 个 float × 线程数)会占住整张图的工作缓冲,即使这一步只跑了 mul_mat。对 128 维 head、16 线程,这块 scratch 约 MB,常驻内存,不算大但也不可忽略。
三、split-KV 的 partials 缓冲可能超出 L2。 前述 266 KB 只是 16 线程的例子,32 线程时翻倍。这块缓冲在每个 attention 节点内部要写一遍、读一遍;如果 L2 容量不足,它就变成内存带宽上的额外开销。长上下文多线程解码时,这条路径的收益会被部分吃掉。这也解释了 512 这个门槛为什么不设得更低:门槛越低,partial 相对计算量的比例就越高。
四、RoPE 缓存与位置跳变。 last_i2 的缓存逻辑假设同一位置的多个 head 是连续遍历的。RoPE 的 dst 形状是 [D, n_head, N],遍历顺序是「batch → 序列位置 → head」,同一位置的 32 个 head 确实连续,所以正常建图时缓存每步只算一次。但如果图里存在跨位置交错的排布(多个 stream 被 reshape 进同一维),缓存会被频繁重算。源码没有显式检查这一点,它依赖建图侧保持形状约定;这也是为什么某些自定义模型架构接入 llama.cpp 时,RoPE 的性能会意外劣化。
另外,build_attn_mha 里在展开 Q/K/V 节点时留了一条注释:「expand k later to enable rope fusion which directly writes into k-v cache」。也就是说建图侧希望把 RoPE 与写 K 缓存合成一个节点,把「RoPE 节点 + barrier + SET_ROWS 节点 + barrier」缩成一个节点。这正是下一阶段 CPU 侧融合的方向,目前 CPU 后端还没有实现对应的融合内核。
五、融合只在 F32 路径发生。 ggml_cpu_try_fuse_ops 里四个类型检查全部要求 GGML_TYPE_F32。大部分模型在激活上是 F32,但混合精度(BF16 激活)模型会绕过融合。BF16 在 CPU 上本身也不常用,这个限制影响不大,但读源码时需要知道它不是「所有模型都受益」。
本篇的范围与本系列的接续
本篇讲了 mul_mat 之外的三类算子——注意力、RoPE/norm、写 KV——如何在同一线程池节拍里执行,以及节点级融合如何减少 barrier 次数。刻意没有展开的部分:
mul_mat_id(专家路由的矩阵乘):MoE 推理在 CPU 上的分组 GEMM,与mul_mat共享vec_dot但任务派发完全不同;- attention 的量化 K/V 路径:
vec_dot_type进入量化点积后,split-KV 无法使用的细节与可行的扩展方式; set_input_kq_mask:掩码张量本身的生成开销,超长上下文下可能成为隐藏瓶颈;- 融合表的扩展:如何把 norm、rope、写 KV 与
mul_mat按依赖关系合并成更大的超级节点——这是 CPU 推理继续提升并行效率最直接的方向。
按依赖关系,下一步是 mul_mat_id:它是在同一个线程池框架下把「按专家分组」加进任务派发的直接扩展,也是 MoE 模型在 CPU 上推理的关键一环。
参考资料
- llama.cpp 官方仓库
- ggml-cpu 算子实现:ops.cpp
- ggml-cpu 线程池与节点调度:ggml-cpu.c
- ggml-cpu 基础向量函数:vec.cpp
- ggml 内部辅助函数与融合判定:ggml-impl.h
- ggml-cpu 分块注意力配置:common.h
- KV Cache 实现:llama-kv-cache.cpp
- FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness(arXiv:2205.14135)
- FlashAttention-2: Faster Attention with Better Parallelism and Work Partitioning(arXiv:2307.08691)
- Self-attention Does Not Need Memory(arXiv:2112.05682)
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



