


TensorRT-LLM 源码完全拆解(三十一):无模型投机解码的控制面——Drafter 的批内闸门、n-gram 池、后缀自动机旁路与验收关闸
TensorRT-LLM 的投机解码在站内已经系统拆过:(十) 讲 one-model 统一 worker、SpecSampler 的验收流水线与被拒草稿 token 的 KV 回滚,(二十二) 讲 EAGLE-3 这一路「草稿头」怎么读目标模型的隐状态、怎么在草稿循环里长出动态树。这两篇都盯着草稿怎么被算出来、怎么被验证。
还有一条完全不同的草稿路线:不训练任何草稿模型,也不加载第二个网络,直接从已经出现过的 token 序列里查下一段。TensorRT-LLM 里这条路线有两个实现——基于 Python 哈希池的 NGram,以及基于 GPU 后缀自动机的 SA(Suffix Automaton,后缀自动机)。再加上一个所有草稿器共享的调度基类 Drafter 和一个验收后的熔断器 SpeculationGate,它们共同构成了一套「无模型投机解码」的控制面。
控制面要回答三个问题,而且每个问题的答案都随 batch 和时间变化:
- 这一轮迭代要不要开投机?验证批是原始批的 倍,batch 一大,验证本身就变成负担。
- 开了之后草稿长度 取多少?固定 在低并发和大并发下不可能是同一个最优值。
- 如果某类请求长期命中不了,还要不要一直为它付验证成本?
下面的拆解按「收益模型 → Drafter 抽象 → 执行时序 → NGram → 后缀自动机 → 关闸」的顺序拆。所有源码以 TensorRT-LLM 截至 2026 年 11 月的主线代码为准,路径集中在 tensorrt_llm/_torch/speculative/ 与 tensorrt_llm/_torch/pyexecutor/。
从一次验证说起:投机解码的收益由什么决定
先把最基本的流程摆出来。目标模型每步本来只生成一个 token;投机解码先用某种方式猜出 个草稿 token,把它们和上一个已确认 token 拼成 个输入,一次前向并行验证。验证结果是一条「接受前缀」:从草稿的第一位开始,连续正确多少位就接受多少位,再额外保留目标模型自己采样出的那一个 token。被拒绝的草稿 token 对应的 KV 必须回滚,这部分在 TensorRT-LLM 源码完全拆解(十):投机解码 里已经拆过。
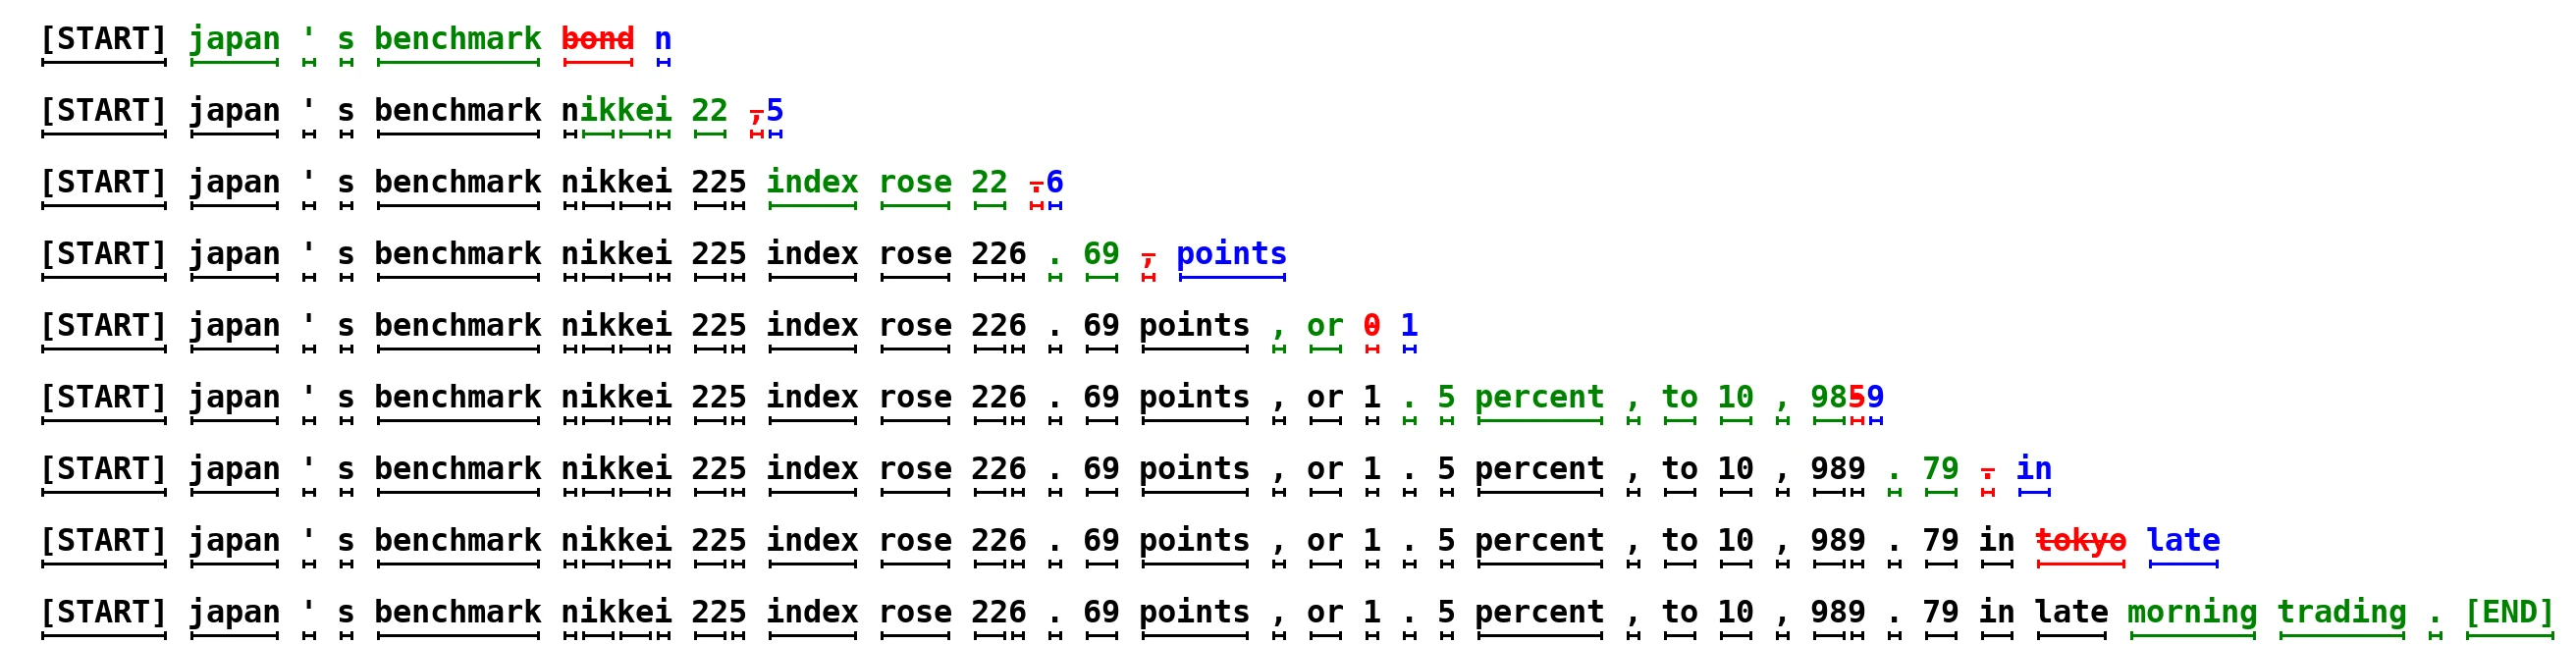
上图出自 Leviathan 等人 2022 年公开、发表于 ICML 2023 的投机解码论文。草稿模型串行生成 个候选,目标模型用一次前向并行打分,接受最长正确前缀。图中的关键不在草稿模型本身,而在「一次前向验证多个位置」这个动作:它把多次串行解码压缩成一次并行计算,代价是这一步的输入变长、KV 读取变多。
设第 个草稿位置的接受概率为 ——这是「前 个位置全部正确」在该位置继续正确的条件概率。那么接受长度 (不含目标模型额外给出的那个 token)的期望是
如果所有位置同分布、接受率都是 ,式子退化成等比数列:
每步最终产出的 token 数是「接受的草稿数 + 1」,那个 1 是目标模型在验证批最后一位上采样出的 bonus token,无论草稿对不对都存在。所以
这个式子里有两个直接结论。第一, 很低时 ,草稿几乎白做; 接近 1 时 接近 ,收益接近线性。第二, 越大,边际收益是 ,衰减得非常快。把 从 4 加到 8,在 时只多出 个 token,却让验证批从 5 行变成 9 行。
验证不是免费的。设 batch 为 、草稿长度为 时,一次前向的相对耗时是 ,其中 是「每多验证一个位置」相对基线一步的成本比例。于是投机解码的加速比近似为
的形状决定了最优 随 batch 怎么变。解码阶段的 batch 很小时,一步的时间主要花在把权重从显存搬到计算单元,矩阵乘的算术强度低,多几行输入几乎不增加权重读取量, 很小;batch 很大时,解码已经变成计算受限,多一个位置就多一份矩阵乘和注意力计算, 接近 1。把 对 求极值,就能得到「低并发用长草稿、大并发用短草稿甚至关闭」的结论。这不是经验口号,而是 随 单调上升的直接结果。
对检索式草稿来说,还有一笔额外成本:查表本身。NGram 的池在 Python 里,查询与更新都是主机侧操作;SA 的匹配在 GPU 上,但状态维护仍有主机到设备的拷贝。设这笔成本为 ,加速比变成
它解释了为什么无模型草稿特别在意「池子不能太大、查询不能退化成线性扫描」—— 一旦随历史长度增长,分子再大也会被分母吃掉。
还有一个容易混淆的点:检索式草稿没有提案分布 。标准投机采样在拒绝时要用 做接受判定,并用残差分布 修正,才能保证输出分布不变。n-gram 和后缀自动机只给出 token id,不给出「这个草稿来自哪个分布」,所以源码在 SuffixAutomatonManager 的注释里明确写了:这两种草稿器不支持 rejection sampling,只做精确匹配验证。这也是它们实现简单、但接受率完全取决于文本重复性的根本原因。
TensorRT-LLM 在 batch 层面统计接受率时,用的是
而不是每个请求接受率的平均。前者按草稿数量加权,长请求、长草稿对统计的影响更大;后者会让一个只投了一次且命中的短请求和一个投了十次全落空的长请求等权。关闸逻辑用的是前者,因为它要回答的是「这一批验证算力花得值不值」,不是「平均每个请求体验如何」。
Drafter 抽象:三个方法、一张时间表
所有「草稿在目标模型之外产生」的模式——NGram、用户自定义 drafter,以及未来可能接入的外部草稿器——都继承同一个抽象类 Drafter。它只有三个核心方法与一个长度查询方法:
class Drafter(ABC): def __init__(self, max_draft_len=None, max_total_draft_tokens=None, max_concurrency=None, draft_len_schedule=None): ...
@abstractmethod def prepare_draft_tokens(self, scheduled_requests, resource_manager=None): ...
@final def should_use_spec_decode(self, requests, max_batch_size, max_num_tokens, max_total_draft_tokens): ...
@final def pad_draft_tokens_for_cuda_graph(self, scheduled_requests, resource_manager=None): ...
def get_draft_len_for_batch_size(self, batch_size): ...prepare_draft_tokens 是唯一需要子类实现的方法:给定本轮调度出的 generation 请求,把 request.py_draft_tokens 填好。should_use_spec_decode 与 pad_draft_tokens_for_cuda_graph 被标成 final,说明框架不希望各草稿器自己发明开关逻辑与补齐逻辑;长度查询是普通方法,子类可以覆盖,但当前只有基类实现。
批内闸门:should_use_spec_decode
这个方法看起来只有几行,却是整个控制面最容易被忽略的一层:
if self.max_concurrency is None: return True
tokens_per_request = 1 + max_total_draft_tokenstoken_cap = max_num_tokens // tokens_per_requestif token_cap <= 0: return False
num_effective_requests = min(len(requests), max_batch_size, token_cap)return num_effective_requests <= self.max_concurrency第一行是默认行为:用户没有配置 max_concurrency,就永远开投机。这不是偷懒,而是把「什么时候该关」交给更上层的批大小调度与关闸逻辑。
后面几行才是真正的批内闸门。max_num_tokens 是整个引擎一次前向的 token 预算;每个投机请求要占 个位置(一个已确认 token 加 个草稿),所以 token_cap 是「按 token 预算最多能装下多少个投机请求」。最终参与判断的请求数是三个上限的最小值:实际请求数、max_batch_size、token_cap。只要这个数超过 max_concurrency,本轮就不开投机。
这里有个细节值得注意:闸门比较的是请求数,不是 token 数。token_cap 已经先把 token 预算折算成请求数,后面再和并发上限比较,等价于同时受两个约束。这样写的好处是语义直观,用户配置的 max_concurrency 就是「最多允许多少个请求同时投机」;坏处是当 很大时,token_cap 可能远小于 max_batch_size,实际关闭点会比用户以为的更早。
max_concurrency 怎么变成一张长度表
DecodingBaseConfig 里还有一个字段 draft_len_schedule,它把「batch 大小 → 草稿长度」写成分段表。两个字段互斥;如果用户只配了 max_concurrency,配置校验器会把它翻译成只有一段的表:
if self.max_concurrency is None: return selfif self.max_draft_len is None or not self.spec_dec_mode.support_dynamic_draft_len(): return self
self.draft_len_schedule = {int(self.max_concurrency): int(self.max_draft_len)}self._translated_from_max_concurrency = True翻译之后,max_concurrency=4, max_draft_len=5 等价于 draft_len_schedule={4: 5}。按最终生效的 utils.get_draft_len_for_batch_size 语义,batch 不超过 4 时用 5 个草稿;超过 4 时二分落到表尾,返回 0,投机关闭。这正是 max_concurrency 的语义,但底层只剩一条查表路径,调度器不用维护两套判断。执行器预调度阶段用的是 Drafter 自己的查表函数,二分方向不同,可能先看到最后一段的 5;调度后的 update_draft_len 会按最终语义把它纠正为 0,所以占位草稿之后还会被清空一次。
用户也可以直接写多段表,例如 {4: 4, 8: 2, 32: 1}:batch 1 到 4 用 4 个草稿,5 到 8 用 2 个,9 到 32 用 1 个,33 及以上关闭(按最终生效的查表语义)。校验器要求最小的 batch 阈值必须对应 max_draft_len,并且表按阈值排序。这里要注意,长度表有两套查表函数,而且二分方向相反。Drafter.get_draft_len_for_batch_size 用 bisect_right,找的是「不大于当前 batch 的最大阈值」,即按分段下界取值;调度步里的 utils.get_draft_len_for_batch_size 则用 bisect_left,找的是「第一个不小于当前 batch 的阈值」,语义是「key 表示允许使用该长度的最大 batch」。对 {4: 4, 8: 2, 32: 1} 来说,两者在 4、8、32 这些边界上的结果相同,中间值也相同,差别只在于边界是归入本段还是上一段;但读源码时如果把两处混为一谈,就会误判 batch=5 时到底用 4 还是 2。真正决定每步草稿长度的是 _handle_dynamic_draft_len 调用的 update_draft_len,它在 prepare_resources 之前同步缓冲区,注释里强调这一步必须早于 KV 分配,否则 KV 会按上一档的草稿长度预留。
这套表还有一个与 CUDA Graph 的联动:DecodeCudaGraphConfig._merge_schedule_keys 会把表里的 batch 阈值合并进 CUDA Graph 的 batch size 列表。原因是图是按 batch 桶捕获的,而草稿长度会改变图里 KV 容量、注意力元数据和缓冲宽度;如果某个阈值没有对应的图桶,运行时就可能落进一个「形状按旧草稿长度捕获」的图。把阈值并进桶列表,等于强制在每个草稿长度档位的边界上都有一张静态图可用;批大小的跨度不同,图里的草稿长度也不同。
补齐到静态长度:pad_draft_tokens_for_cuda_graph
动态草稿长度带来一个 CUDA Graph 难题:这一步实际只投了 2 个草稿,但图是按最大 5 个草稿捕获的。解决办法是先把真实长度记下来,再把缓冲区补到静态最大值:
pad_to = self._static_max_total_draft_tokensfor req in scheduled_requests.generation_requests: num_draft_tokens = get_draft_token_length(req) req.py_draft_tokens_effective_len = num_draft_tokens req.py_draft_tokens.extend(0 for _ in range(pad_to - num_draft_tokens))这里记下的 py_draft_tokens_effective_len 非常关键。补零之后的 py_draft_tokens 长度是静态的 5,但真正提出、真正需要验证的只有 2 个;接受率的分母必须用 2,不能用 5。注释里提到、并在 LlmRequest 中另设了一个 py_num_draft_tokens_verified 字段作为真实分母,那里的注释写得很清楚:py_draft_tokens 本身不能当分母,因为它会被 CUDA Graph padding 拉长,而且在 one-model 流程里,等结果返回时它已经装着下一步的草稿了。
对 NGram 和用户自定义 drafter,还需要在补零之后扩展 KV 容量。原因是它们的采样器用 len(py_draft_tokens) 计算 rewinding 长度,补出来的零也占了 KV 位置;如果只补 token 不补 KV,验证时就会越界。_needs_padding_kv_extension=True 就是给这类 drafter 的标记,pad_draft_tokens_for_cuda_graph 会分别对目标 KV 管理器和草稿 KV 管理器调用 extend_capacity_for_tokens。one-model 的草稿头用 SpecSampler 按 runtime_draft_len 计算 rewind,padding 不影响正确性,所以不需要这个标记。
一次迭代的时序:草稿 token 在调度器之前就要有位置
把上面这些方法放回 PyExecutor 的迭代循环,才能看清它们为什么必须按这个顺序调用。下面按源码中的实际顺序列一遍。
第一步:确定本轮草稿长度。 这一步分两处发生。调度开始前,执行器若发现 drafter 带长度表,会先用 active_requests 的数量查表,更新 max_total_draft_tokens 并同步给 drafter;调度完成后,_handle_dynamic_draft_len 再调用 update_draft_len,按本轮真正调度出的 scheduled_batch 查表,写下 runtime_draft_len,并把各请求的 py_draft_tokens 补齐或截断到统一宽度。前一处用的是活跃请求数,后一处用的是调度后的 batch,二者在抢占、分块预填充之后可能不同;最终生效的是后者,前者只负责让「占位草稿」的大小不要离谱。
第二步:批内闸门。 如果长度表算出 0,直接关闭;如果 speculation_permanently_disabled 已经被关闸逻辑置位,也关闭;否则调用 drafter.should_use_spec_decode。三个条件是短路关系,顺序不能反:长度表是用户显式配置的硬约束,永久关闭是运行时质量判断,批内闸门是容量判断。
第三步:给调度器放占位草稿。 这一步最容易被误解。真正的草稿 token 还没产生,但执行器先把每条 generation 请求的 py_draft_tokens 填成 个 0,并把 py_draft_pages_allocated 设成 :
if self.max_total_draft_tokens > 0 and self.use_spec_decode \ and not req.py_disable_speculative_decoding: req.py_draft_tokens = [0] * self.max_total_draft_tokens req.py_draft_pages_allocated = self.max_total_draft_tokenselse: req.py_draft_tokens = [] req.py_draft_pages_allocated = 0为什么不等草稿产生后再调度?因为 C++ 侧的 micro-batch 调度器在计算每条 generation 请求要占多少 token 预算时,用的是 1 + num_draft_tokens;KV 管理器也要按这个数预留页。如果先调度、后填草稿,调度器会按 1 个 token 预留,等真正验证 个位置时就可能超出 max_num_tokens 或 KV 容量。占位符的作用不是「假装有草稿」,而是提前把资源账做对。
第四步:调度。 此时调度器看到的是「每条请求要跑 个 token」,于是按这个预算选择 batch、分配 KV 页。对 chunked prefill 和 overlap scheduler 来说,这一步尤其重要:预填充块和生成块共享同一份 token 预算,草稿占位会挤占预填充的空间,调度器必须在两者之间做取舍。
第五步:真正生成草稿。 调度完成后,执行器在 execution_stream 上调用 drafter.prepare_draft_tokens,随后立刻调用 pad_draft_tokens_for_cuda_graph,再用 wait_stream 把当前流与执行流对齐:
with torch.cuda.stream(self.execution_stream): self.drafter.prepare_draft_tokens(scheduled_batch, self.resource_manager) self.drafter.pad_draft_tokens_for_cuda_graph( scheduled_batch, self.resource_manager)torch.cuda.current_stream().wait_stream(self.execution_stream)草稿生成放在独立流上,不是为了和本步前向重叠——这里紧接着就等待了,重叠发生在调度器与上一步前向之间。独立流的作用是隔离草稿器内部的临时分配与拷贝,避免污染主流的捕获状态。对 NGram 这种纯 Python 查表,流其实没有 GPU 工作,但统一走这条路径可以让接口保持一致。
第六步:把更新后的草稿重新交给 guided decoder。 如果开了结构化输出,语法掩码需要在草稿产生后重新施加;add_batch 会被再调用一次,并且回滚掉上一轮基于占位符算出的草稿掩码。这样草稿 token 在验证前就已经被语法约束过,减少必然被拒的候选。
第七步:前向与采样。 模型引擎按 max_total_draft_tokens 组装输入;采样器验证草稿,写回 py_num_accepted_draft_tokens 与 py_num_draft_tokens_verified,并把被拒部分的 KV rewind 掉。
第八步:验收关闸。 采样结果落回主机后,执行器调用 _update_batch_acceptance_rate,把本批的真实接受率喂给 SpeculationGate。如果滑动平均跌破阈值,speculation_permanently_disabled 置位,下一轮第二步就会关闭投机,第三步会把所有请求的 py_draft_tokens 清空,调度器不再为草稿预留预算。
这套时序有一个 overlap scheduler 特有的细节:在重叠路径里,本轮的采样结果要等到下一轮才被消费,所以关闸判断会晚一拍。源码注释直接承认了这一点:关闭投机时,重叠路径会多跑一次带投机的迭代。这一拍的代价可以接受,因为关闸是永久性的,晚一轮不会造成反复震荡;但如果把阈值调得很敏感,就会多付一次完整的验证成本。
NGram:一个 Python 池的三笔账
NGram 是 Prompt Lookup Decoding 在 TensorRT-LLM 里的实现。它的想法朴素到近乎粗暴:把历史 token 序列切成 对,key 是长度为 的连续片段,value 是它后面跟着的若干 token;生成时拿当前序列的最后 个 token 去查表,查到什么就抄什么。
TensorRT-LLM 的官方文档已经给 NGram 打上了弃用标记,计划在 2027 年 1 月移除,推荐改用独立的 SA。即便如此,它仍然是理解检索式草稿最好的入口:池结构、匹配顺序、公共池与私有池的取舍,在 SA 里都能找到对应物,只是实现从 Python 搬到了 GPU。
池里存了什么
NGramPoolManager 的核心是一个从模式到候选续写的映射:
# 公共池:pattern -> OrderedSet(match)# 私有池:request_id -> pattern -> OrderedSet(match)pool: dict[tuple[int], OrderedSet[int]] | dict[int, dict[tuple[int], OrderedSet[int]]]start_index: dict[int, int] # 每个请求下次从哪个位置开始扫描一个具体的例子是 ("I", "love") -> [("apple", "because", "it", "is"), ("banana", "and")]。同一个 key 可以对应多个 value,is_keep_all 控制是否全部保留;is_use_oldest 控制命中时取最早还是最新的候选。源码里 is_use_oldest 目前只实现了取最早的分支,注释里留着 TODO,说明更新策略还没有做完。
新请求的初次扫描
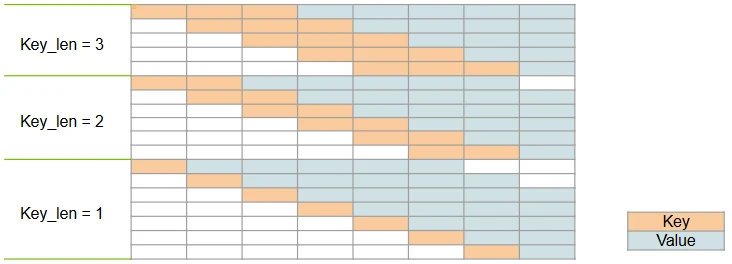
上图出自 TensorRT-LLM 官方技术博客对 NGram 的专题分析:max_matching_ngram_size=3、max_draft_len=5、输入长度为 8 时,初次扫描会往池里加入 18 个键值对。扫描的做法是枚举每个起点、每种 key 长度,把 key 后面的最多 max_draft_len 个 token 作为 value。复杂度大约是「输入长度 × 最大 key 长度」,所以初次扫描的代价与 prompt 长度成正比。
在代码里,这次扫描不是在请求到达时做的,而是延迟到第一次 prepare_draft_tokens:start_index[request_id] 初始为 0,第一次查询时 sequence = prefix[0:],于是整个 prompt 被扫一遍;扫完后 start_index 跳到「当前位置减去 」,后续每步只处理窗口内的新 token。这个 start_index 回退「当前位置减去 」很重要:它保证下一次扫描的起点落在上一轮草稿能覆盖到的最早位置,既不重复扫描已经进池的 token,也不会漏掉「草稿被接受后回填进来」的那几个 token。源码里 start_index 是在查询结束后、而不是在更新结束后写的,顺序不能颠倒——查询要用旧的起点判断是否需要建池,更新要用同一个起点扫描增量,两者共用同一个值。
每步的增量更新
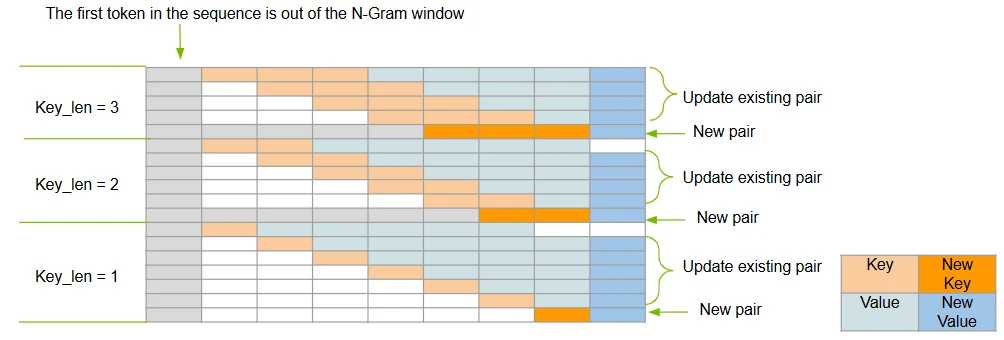
上图展示生成过程中新 token 到来时池子的变化:已有的 key 如果 value 长度还没到上限,就把新 token 追加进 value;同时新 token 也会作为新 key 的结尾,产生新的键值对。每次更新涉及的键值对数量约为 ,对固定的 、 来说是常数,不随历史长度增长。这就是博客里说「每 token 更新近似常数」的依据。
但「常数」不等于「免费」。这些操作全在 Python 解释器里,键是 tuple,值是 OrderedSet,每步要构造切片、做哈希、比较集合。池子大到超出 CPU 缓存后,哈希查找会频繁 miss,主机侧延迟就会显形。博客也明确提醒了这一点:查询理论上是摊还常数,但当字典超过 CPU 最快缓存后,能观察到额外延迟。
查询与生成草稿
get_draft_tokens 的查询顺序是「从最长的 key 往最短试」:
for size in range(min(max_matching_ngram_size, prefix_len - 1), 0, -1): pattern = tuple(prefix[-size:]) if pattern not in pool: continue draft_tokens = pool[pattern][0 if is_use_oldest else -1] return list(draft_tokens)[:max_draft_token_length_this_step]return []先试最长匹配,是为了优先使用信息量最大的上下文。长度为 5 的后缀命中,通常比长度为 1 的后缀命中更可能给出正确的续写;如果先试短的,就会被大量高频短模式淹没。
草稿长度还受两个上限约束:一个是 max_draft_len,另一个是「序列剩余空间」——max_sequence_length - 1 - prefix_len。后者保证草稿不会把序列顶到 max_new_tokens 之外,否则验证批会多出无意义的行。
三笔账:内存、主机时间、命中率
NGram 的实现里还有两个容易被忽略的细节。一是 is_keep_all=False 时,同一 pattern 只保留最长的一个 match,新 match 更长就替换,否则丢弃;这意味着关闭保留全部候选后,池会偏向「最近见过的长续写」,而丢失了「同一个 key 在不同语境下有不同续写」的信息。二是池的更新在处理短候选时有一个 TODO:新 match 进来后会把同 pattern 下更短的 match 删除,而不是保留它们作为回退。这两个行为都让池更紧凑,但也让「命中但续写太短」的情况变得更常见。
NGram 的工程取舍可以归纳成三笔账。
第一笔是内存账。 公共池把所有请求的 pattern 都存进同一个字典,请求完成后也不清理(update_resources 在公共池模式下直接返回)。这意味着池子会随着服务运行时间单调增长,直到进程重启。私有池按请求清理,但每个请求都要维护一份自己的字典,短请求多的时候内存开销反而更大。公共池适合「多轮对话、请求之间共享上下文」的场景,私有池适合「请求彼此无关、内存必须可回收」的场景。
第二笔是主机时间账。 初次扫描 ,每步更新 ,查询最坏 次哈希。对短 prompt、低并发,这些都可以忽略;对长 prompt、高并发,Python 的解释器开销会成为瓶颈。SA 把匹配搬到 GPU,本质上就是在还这笔账。
第三笔是命中率账。 命中率完全由文本重复性决定,和模型能力无关。下面是官方博客在对话数据上的接受长度分布:
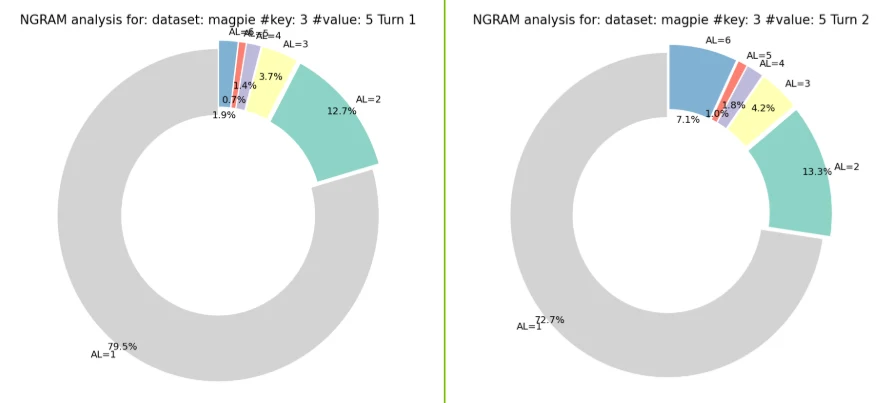
横轴是接受长度,1 表示一个草稿都没接受,6 表示 5 个草稿全接受。分布是双峰的:大量请求落在 1,也有相当一部分落在满接受。这意味着 NGram 的收益高度依赖请求类型,平均值会掩盖这种分化。翻译任务上的分布更极端:
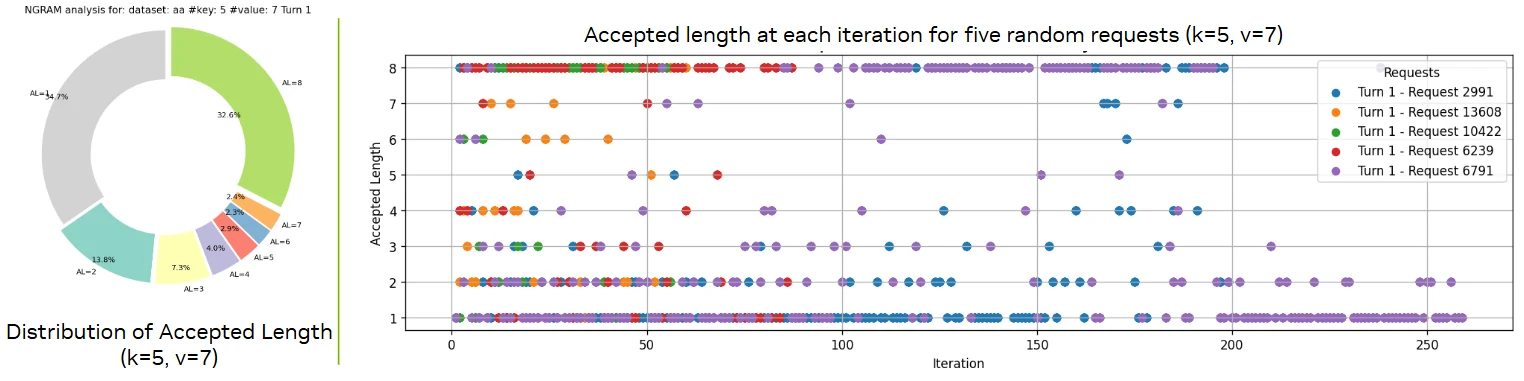
翻译文本里存在大量「原文短语 → 译文短语」的稳定对应,重复片段多,接受长度可以超过 4。博客给出的数字是:对话首轮平均接受长度约 1.37,第二轮约 1.66;翻译任务可以超过 4.0。这些数字不是模型 benchmark 分数,而是「检索式草稿在这类文本上能抄到多长」的直接测量。
NGram 的结构性限制
除了弃用状态,NGram 还有几条硬限制,读源码时应该记住:
- 只支持线性树。
max_total_draft_tokens被强制等于max_draft_len,因为池里每个 key 只对应一条续写序列,无法像 Medusa 那样一次验证多条候选路径。 - 不支持 rejection sampling。 检索式草稿没有 ,只能精确匹配;这一点在收益模型一节已经说明。
- 草稿是主机侧 Python 对象。 它必须走
Drafter的外部草稿路径:先占位、再生成、再补齐、再交给模型引擎。它不能像 SA 那样把匹配塞进目标模型前向的 epilogue。 - 公共池没有淘汰。 这是实现现状,不是设计目标;源码里
update_resources的公共池分支只有一个 TODO。长时间运行的服务需要自己评估内存增长。
也正因为这些限制,官方把 SA 定为替代路线:同样的「查历史续写」思想,但状态在 GPU、匹配在 GPU、并且能直接嵌进 one-model 前向。
为什么 NGram 的初次扫描要延迟到第一次草稿
add_request 在 NGram 里并不存在。请求到达时,执行器不碰池子;直到第一次 prepare_draft_tokens,池才会为这个请求建立 start_index=0 并扫一遍整个前缀。这种「惰性建池」有三个好处。
第一,请求可能在本轮就被抢占或中止,甚至预填充还没跑完。如果到达时立刻扫描整段 prompt,被抢占的请求等于白扫了一次,而这些请求在长 prompt、高并发的服务里并不少见。
第二,预填充是分块进行的。如果第一次调度只给了请求前 2048 个 token,此时扫描到的「前缀」并不是完整输入;等后续块到来,池里已经建立了一批基于残缺前缀的键值对。惰性建池保证首次扫描发生在第一次真正需要草稿的时刻,那时输入至少已经包含一个完整的确认 token。
第三,也是最重要的一点:草稿池的内容与「已经确认的 token」严格对齐。扫描用的 request.get_tokens(0) 返回的是已提交 token 的副本,不包含尚未验证的草稿。如果池子把草稿也当作历史,就会形成「用自己猜的内容去猜自己」的自增强循环,命中率看起来很高,实际验证时大量失败。把扫描起点和 token 提交点绑定,是检索式草稿不跑偏的前提。
公共池与私有池的淘汰账
私有池的释放时机在 update_resources:本轮调度里处于 GENERATION_COMPLETE 的请求,直接从池字典里删除条目,start_index 也一并清掉。它的复杂度是「本轮完成请求数」,与历史长度无关。
公共池则什么都不做,源码分支直接 return。这意味着所有请求的键值对长期共享一个字典,服务运行越久,池越大。好处是跨请求复用:多轮对话里第二轮的问题可能用到第一轮的问答片段;坏处是内存与哈希表容量单调增长,而且旧数据可能以极低的匹配概率仍占着内存。
如果要在一个公共池服务里评估内存,一个粗略的口径是:池中条目数约等于「所有已见 token 数 × 平均 key 长度」,每条目的 value 最多 个 token,键值都按 Python 的 int 对象存储。Python 小整数有缓存,但长序列的 token id 大多超出缓存范围,每个 int 是一个完整的对象。真实占用要乘上解释器开销系数,而不是简单按 4 字节或 8 字节算。
这是 NGram 被弃用的原因之一:它的「共享」是在 Python 层做到的,而 SA 的共享是在 GPU 状态槽里做到的,后者可以显式设定槽位数并做 FIFO 淘汰,内存上界是可控的。
一个具体的 NGram 查表例子
设 max_matching_ngram_size=3、max_draft_len=5,当前序列的末尾是 [..., "retry", "with", "exponential", "backoff"]。查询依次尝试:
- 长度 3 的后缀
("exponential", "backoff")——如果池里有,直接返回后续最多 5 个 token。 - 没有则试长度 2 的
("backoff")之类的最后两个 token 组合。 - 再没有则试长度 1 的最后一个 token。
命中后,返回的 value 就是草稿候选,再按剩余空间截断。可以看到,匹配长度的优先级是硬编码的「从长到短」,没有打分、没有回退到次长匹配。如果长度 3 的 key 命中但 value 只有 1 个 token,草稿就只有 1 个,而不会改试长度 2 的 key 去拿更长的续写。这是 NGram 简单直接的代价:它不优化「草稿长度」,只优化「匹配精确度」。
SA 的 extend_ngram 在这一点上更灵活:max_ngram_size 为正时同样从长到短试,但它是在 GPU 上的一次 kernel 里完成的,且与状态扩展合并;max_ngram_size=-1 时直接取最长后缀匹配,不再受固定长度限制。
后缀自动机:把同一件事搬进 GPU
SA 要解决的是 NGram 的两个痛点:主机侧 Python 开销,以及「每次查询重新构造切片」。它的数据结构是后缀自动机(suffix automaton)——一个能识别一个字符串所有后缀的确定性自动机,状态数是 ,构造也是 。
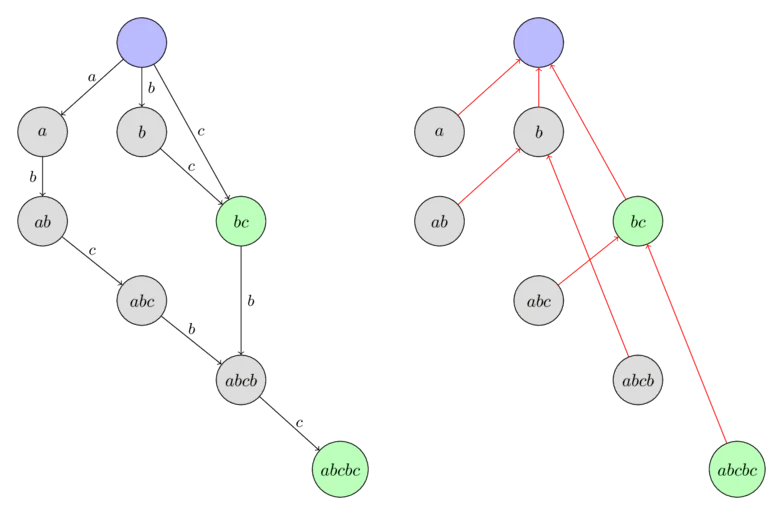
上图是 cp-algorithms 的后缀自动机示意。每个状态代表一组「结束位置集合相同」的子串,状态之间的转移边吃一个 token,后缀链接指向「当前状态代表的最长子串的最长真后缀」所在的状态。所有后缀链接连起来是一棵树,从任意状态沿后缀链接往上走,就能按长度递减枚举所有后缀。对投机解码来说,需要的正是「当前序列的最长后缀,在历史里出现过吗、后面跟着什么」——后缀自动机把这件事从 的扫描变成了沿转移边走一次的匹配。
实现结构:主机建树、GPU 扩展
TensorRT-LLM 的 SA 是一个原生 C++/CUDA 算子,Python 侧只负责资源管理。SuffixAutomatonManager 的关键分工是:
- 请求首次进入上下文阶段时,在主机上构建自动机。
add_request调用_sa_native.build_automaton_host(context_tokens, max_seq_len),把整段 prompt 建成状态机。 - 构建结果拷贝到 GPU 的一个槽位。 每个请求占一个 slot,槽位数组是
allocate_workspace(pool_size + 1, max_seq_len);多出来的那个 slot 是 dummy slot,专门给 CUDA Graph padding 用。 - 生成阶段每步扩展并查询。
extend/extend_ngram/extend_global三个入口都调用原生算子,在 GPU 上把本步接受的 token 追加进自动机,同时返回最长匹配长度与对应草稿。 - 请求结束时释放或保留槽位。 不开全局池时立即清空;开全局池时,已完成的请求可以保留状态供其他请求搜索,直到池满后按 FIFO 淘汰最老的保留项。
这里有一个需要看清的分工:主机建树、GPU 扩展。构建自动机需要逐 token 插入并维护后缀链接,分支多、不规则,放在主机上做一次是合理的;生成阶段的扩展只需要把新 token 接到已有状态后面,规则且批量,适合 GPU。源码注释明确说 extend() 与 extend_ngram() 完全在 GPU 上跑,并且 CUDA Graph 兼容。
prepare() 是每步图外的准备工作:把待拷贝的主机状态复制到 GPU、刷新全局池的 active slot mask、把本批请求映射成 slot 下标与 non-dummy mask,然后用一次 torch.cuda.current_stream().synchronize() 保证后续 kernel 能看到这些更新。这一次同步在 CUDA Graph 捕获之外,属于每步固定的主机开销;它不能省,因为 extend kernel 依赖刚写入的槽位映射。
两种匹配模式
SADecodingConfig.max_matching_ngram_size 决定匹配策略:
-1:最长匹配。 沿自动机找当前序列能匹配的最长后缀,返回它后面的续写。信息量最大,但匹配长度不受控,长匹配可能跨越语义边界。- 正整数 :固定长度 n-gram。 只试长度不超过 的后缀,从长到短。它把匹配长度限制在可控范围,行为更接近 NGram,但每次查询要试多个长度。
enable_global_pool 打开后,每个请求不只看自己的自动机,还会搜索池中所有 active 状态,取全局最长匹配。源码注释给出了两个硬限制:最多 1024 个并发槽位,单请求的后缀匹配最多 64 个 token。前者是 kernel 的并行度上限,后者是防止全局搜索退化成遍历整棵自动机。
全局池的动机是跨请求复用。多轮对话里,第二个用户的提问可能和第一个用户的历史高度相似;翻译任务里,不同请求的原文模板也可能重复。让请求 A 的自动机为请求 B 提供草稿,等于把「前缀缓存」的思想从 KV 层搬到了 token 层。代价是内存与淘汰策略:池子默认大小是 max(64, max_batch_size),已完成请求的状态会保留,池满后 FIFO 淘汰。_allocate_slot 的淘汰顺序是「先取空闲槽,再取保留槽,最后报错」:空闲槽代表从未被使用或已被显式释放的槽位,保留槽代表已完成但仍在提供跨请求搜索的槽位。取保留槽时,会先调用原生算子 clear_slot 把该槽清空,并把 active mask 置 0,再把槽交给新请求。这样避免新请求继承旧请求的后缀自动机状态,导致匹配在语义上完全错位。源码里还有一个「陈旧槽」判断:如果某个请求的 GPU 拷贝尚未落盘就被移除,它的槽位直接释放而不保留,理由是槽里可能是未初始化数据,被别的请求搜到会给出不可用的草稿。它不是无限缓存,长跑服务要按并发和重复度估算所需槽位数。
为什么 SA 不用 Drafter:一条被绕开的通道
读源码时值得把 get_spec_drafter 与 get_spec_worker 并列看:
def get_spec_drafter(model_engine, spec_resource_manager): spec_config = model_engine.spec_config if spec_config is None: return None if spec_config.spec_dec_mode.is_user_provided(): return spec_config.drafter if spec_config.spec_dec_mode.is_ngram(): return NGramDrafter(spec_config, spec_resource_manager) return None外部草稿器只认两种模式:用户自己传进来的实例,以及 NGram。SA 返回 None,然后由 get_spec_worker 在 one-engine 包装类里创建一个 SAWorker。这两条路径的资源生命周期完全不同。
外部草稿器路径下,调度器必须先为草稿预留 token 预算和 KV 页,草稿生成是本步前向之前的独立阶段。草稿 token 追加进目标请求的 KV 区间,验证后按 rewind 裁掉;如果草稿来自独立神经模型,框架还会额外维护一份草稿 KV。one-engine 路径下,草稿在目标模型最后一层之后生成,草稿 token 作为「下一步的输入」直接写进输入缓冲,没有独立的草稿 KV,回滚只涉及目标 KV 的 rewind。
SA 之所以选后者,是因为它的「草稿生成」只是一次后缀匹配,不需要单独的 KV 来容纳草稿上下文:自动机本身就是上下文结构,存在自己的槽位里,不占 KV 页。把它放进外部草稿器路径,反而要凭空创建一套草稿 KV 的账,而草稿里根本不需要写 KV。
这也解释了为什么 SA 的 prepare 要做主机到设备的拷贝。自动机的状态不在 KV 里,也不在 attention 元数据里,只能作为独立的工作区存在;每步扩展前,Python 侧必须把「本批请求映射到哪些槽」和「哪些槽是 dummy」告诉 kernel。NGram 没有这一步,因为它的状态本来就在主机上。
独立 SA:草稿在目标模型前向里完成
SA 和 NGram 最大的结构差异,是它不需要外部的 Drafter。SpeculativeDecodingMode.SA 属于 one-engine 模式:get_spec_drafter 对 SA 返回 None,模型引擎不会创建外部草稿器;取而代之的是 get_spec_worker 创建一个 SAWorker,挂在目标模型的 epilogue 上。目标模型跑完所有解码层后,SAWorker 接手 logits,完成采样、验收、扩展自动机、生成下一步草稿五件事:
# 1. 采样并验证上一步草稿accepted_tokens, num_accepted_tokens = self._sample_and_accept_draft_tokens(...)# 2. 用接受的 token 扩展 SA,查最长匹配,产出下一步草稿next_draft_tokens = self._generate_draft_tokens(...)# 3. 为 overlap scheduler 准备下一步输入next_new_tokens = self._prepare_next_new_tokens(...)这条路径的优点是「零草稿前向」:没有第二个模型、没有额外 KV、没有草稿 token 的外部搬运。草稿完全来自 token 序列本身,生成草稿的算力成本只有几个 GPU kernel 的匹配操作。缺点也很直接:它只能抄历史,遇到全新内容时匹配长度为 0,草稿为空,验证批退化成普通解码。
源码里有一个细节体现了 CUDA Graph 兼容性的考虑:_generate_draft_tokens 在拿到 match_len 与 draft_tokens 后,会用 (match_len > 0) 做一次掩码乘法,把没匹配上的行清零。这样即使某些请求本轮没有草稿,kernel 依然按固定形状输出,图不需要因为「这行有没有草稿」而改变。
SA Enhancer:给神经草稿器加一条旁路
SA 还可以不独立使用,而是作为神经草稿器的增强器。SAEnhancerConfig 可以挂在 EAGLE-3、MTP(Multi-Token Prediction,多 token 预测)、PARD(Parallel Draft,并行草稿)的配置上;此时草稿仍由神经头生成,但 SA 会在后台同时查一份「精确重复」的候选,匹配长度达到阈值时覆盖神经草稿。
SADraftEnhancer 的实现有三个关键设计:
第一,旁路流。 SA 的扩展与查询跑在专用 CUDA 侧流上,extend_and_prepare 先让侧流等待主流,再在侧流上启动 kernel,最后记录一个 event。主流的神经草稿前向不用等 SA,两边真正重叠。
第二,延后覆盖。 maybe_override_all_draft_tokens 要等整个草稿循环结束后才调用,不是在每一层草稿后覆盖。原因是神经草稿是逐层自回归的:第 层的输入依赖第 层的输出。如果在中间层把 token 换成 SA 的结果,后续层的隐状态就和这些 token 不匹配,草稿头的条件分布会错位。等所有层跑完再整体覆盖,神经头始终看到自己生成的 token,SA 只替换最终提交的候选。
第三,阈值门控。 只有当 match_len >= threshold 时才覆盖,默认阈值是 4。阈值越低,SA 越容易接管,命中率可能上升,但也可能用一个「只在字面上重复、语义上不合适」的续写替换掉神经头更合理的草稿;阈值越高,SA 越保守,只在长重复片段上出手。源码模块注释给出的说法是:与 MTP 结合时,SA 最多可以把接受率提升 40%。这个数字是模块作者的测量口径,不是所有模型、所有负载的通用保证。
覆盖的实现是一次向量化的 torch.where:
mask = (self.sa_match_len[:n] >= self.threshold).unsqueeze(1).expand_as(draft_tokens)draft_tokens = torch.where(mask, self.sa_draft_tokens[:n, :K], draft_tokens)它把「哪些请求用 SA、哪些保留神经草稿」变成一次张量选择,不引入主机分支,因此可以留在 CUDA Graph 里。阈值判断在 GPU 上做,还避免了每步把 match_len 拷回主机再决定覆盖范围的同步开销。
SA 的边界
SA 不是万能的,它的收益边界比神经草稿更窄:
- 只对重复文本有效。 匹配长度是硬门槛,没有匹配就没有草稿;对开放式创作、全新推理,命中率会很低。
- 精确匹配,不做概率校正。 和 NGram 一样,它没有提案分布,不能用 rejection sampling;它只保证「抄来的 token 如果被接受,就是目标模型的真实选择」,不保证草稿分布接近目标分布。
- 状态内存与序列长度成正比。 每个 slot 按
max_seq_len分配,默认 262144;池子有pool_size + 1个 slot。开全局池前要按「并发 × 序列上限」估算显存,不要只看默认值。 - 全局池的跨请求匹配有语义风险。 字面重复不代表上下文相同;在需要严格隔离租户数据的场景,公共池不应该开。
验收关闸:SpeculationGate 的滑动窗口
批内闸门解决的是「容量够不够」,长度表解决的是「这一批该投多长」,但它们都不知道「这批请求的内容到底能不能被猜中」。SpeculationGate 补的就是这一层:它持续观察真实接受率,长期不达标就永久关闭投机。
class SpeculationGate: def __init__(self, window: int, threshold: float): self.window = window self.threshold = threshold self.acceptance_rate_history: Deque[float] = deque() self.acceptance_rate_sum: float = 0.0 self.num_recorded_samples = 0 self.disabled = False
def record_acceptance_rate(self, acceptance_rate, sample_id=None): # 原实现按 (window, threshold) 三个条件短路;这里把 window 拆成 # 空值与 <=0 两种情况,避免 0 窗口在后续除零。 if (self.disabled or self.window is None or self.window <= 0 or self.threshold is None): return False, None
if not 0.0 <= acceptance_rate <= 1.0: raise ValueError("acceptance_rate must be in [0, 1]") self.acceptance_rate_history.append(acceptance_rate) self.acceptance_rate_sum += acceptance_rate if len(self.acceptance_rate_history) > self.window: self.acceptance_rate_sum -= self.acceptance_rate_history.popleft() self.num_recorded_samples += 1 if self.num_recorded_samples >= self.window: avg = self.acceptance_rate_sum / len(self.acceptance_rate_history) if avg < self.threshold: self.disabled = True return True, avg return False, avg return False, None这是一个教科书式的滚动平均:deque 保存最近 个样本,acceptance_rate_sum 维护窗口和,每次记录与淘汰都是 ,不需要每轮重新求和。num_recorded_samples 与窗口长度分开计数,是为了保证「至少观察满 轮」才开始判断;否则服务刚启动时窗口里只有一两个样本,很容易误关。
执行器怎么喂它
PyExecutor 在构造时读取 acceptance_rate_window_size 与 acceptance_rate_threshold,两个都有效才创建 gate。采样结果落回主机后,_update_batch_acceptance_rate 做四件事:
- 跳过不该统计的场景。 gate 不存在、已经永久关闭、处于 warmup、或者当前 rank 不是流水线最后一级,都直接返回。最后一级才有完整的采样结果,其他 rank 统计会重复。
- 只统计真正投了草的请求。 遍历本轮 generation 请求,跳过
draft_len <= 0和 dummy 请求,把草稿数与接受数分别累加。 - 算批级比率。
acceptance_rate = total_accepted / total_drafted,然后喂给 gate。 - 处理关闭。 如果本轮触发了关闭,置位
speculation_permanently_disabled,后续迭代直接走关闭分支。
这里有一个读源码时值得留意的口径问题:关闸函数累加的是 request.num_draft_tokens 与 request.py_num_accepted_draft_tokens,而统计管线使用 py_num_draft_tokens_verified 作分母,源码注释明确说后者排除了 CUDA Graph padding。如果 num_draft_tokens 在 padding 之后反映的是静态最大长度,闸门算出的接受率就会比真实值低,关闸会比实际需要更早触发。这个行为是偏保守的:宁可早关,也不要在低命中率上继续烧验证算力。读代码时不要把两个分母混为一谈。
为什么是永久关闭,而不是动态开关
SpeculationGate 的 disabled 标志 一旦置位就不再复位,reset() 只在显式重置时调用。这个设计是有意的:
- 避免震荡。 如果接受率在阈值附近波动,动态开关会让投机在开与关之间反复切换;每次切换都要重新分配草稿 KV、重建调度预算,开销可能比省下的验证成本还大。
- 关闸是负载级判断,不是单请求判断。 一个服务如果在前 100 轮里平均接受率都很低,说明当前流量类型不适合检索式草稿;继续观察的期望收益很低。
- 正确性不依赖投机。 关闭投机只是不再提前猜 token,目标模型的输出分布完全不变。所以「永久关闭」是一个安全的降级,不需要保留恢复路径。
代价是它对负载变化不敏感:如果服务先跑了一段低重复流量,后来又切到高重复流量,gate 不会自动重新打开。需要重新开启时只能重启引擎或显式重置配置。这也是为什么调参时应该先把 window 设得足够大、阈值设得足够低,把 gate 当成兜底,而不是当成主控制手段。
一个门控失效的案例推演
设 window=200、threshold=0.3,一个服务连续跑了 200 轮投机,平均每个请求投 4 个草稿。在这 200 轮里,如果接受率一直稳定在 0.25,那么 gate 在第 200 轮结束时返回「关闭」,此后所有迭代都不再投机。此时端到端的单步成本从「 个 token 摊在 的成本上」变成「每次 1 个 token 摊在 1 的成本上」。
代入前面的模型,、 时,;而验证批是 5 行,若高并发下 ,单步耗时约 个单位。加速比约 ,也就是投机反而慢了将近一倍。gate 在这里关闭投机,把加速比从 0.6 拉回 1 附近,这是它存在的直接理由。
反过来,如果同样的 出现在 batch 1 的流水线上, 可能只有 0.05,单步耗时约 ,加速比约 。此时投机其实有微小正收益,但 gate 看不到 batch 大小,只看到接受率低于阈值,仍会关闭。这是 gate 的一个盲点:它用质量指标代替成本模型。补偿手段是把阈值和窗口调得更保守,或者根本不开 gate,改由 draft_len_schedule 按 batch 控制。
三种控制手段的分工
| 控制手段 | 作用对象 | 判断依据 | 生效范围 |
|---|---|---|---|
should_use_spec_decode | 本轮 batch | 请求数、token 预算、max_concurrency | 单轮,随 batch 变化 |
draft_len_schedule | 本轮草稿长度 | 活跃请求数查表 | 单轮,可分段 |
SpeculationGate | 是否继续投机 | 最近 轮真实接受率 | 永久,直到重置 |
三者是串联关系:长度表先决定 ,批内闸门再判断容量是否允许,gate 最后用质量数据一票否决。任何一层说「不」,投机都不会发生。
三套机制如何一起工作
把源码路径拼起来,一轮迭代的决策可以写成下面这段伪代码:
if draft_len_schedule is not None: K = schedule.lookup(len(active_requests)) # 可能为 0 drafter.update_max_total_draft_tokens(K)if K == 0 or speculation_permanently_disabled: use_spec = Falseelse: use_spec = drafter.should_use_spec_decode( active_requests, max_batch_size, max_num_tokens, K)
for req in active_requests: req.py_draft_tokens = [0] * K if use_spec else [] req.py_draft_pages_allocated = K if use_spec else 0
batch = scheduler.schedule(active_requests) # 按 1+K 预留 KV 与 token 预算if use_spec: drafter.prepare_draft_tokens(batch) # 查表/扩展自动机,产出真实草稿 drafter.pad_draft_tokens_for_cuda_graph(batch) # 补到静态 K,必要时扩 KV guided_decoder.add_batch(batch) # 重新施加语法掩码
outputs = model_engine.forward(batch) # 验证 1+K 个位置acceptance = accepted / drafted # 批级真实接受率if gate is not None: gate.record(acceptance) # 可能永久关闭这段伪代码漏掉了不少工程细节,但把三套机制的关系讲清楚了:长度表是前馈控制,批内闸门是容量约束,关闸是反馈控制。前两者在每轮开始前决定「能投多少」,后者在每轮结束后决定「还值不值得投」。
长度表与批内闸门都只看「结构」不看「内容」,而 SpeculationGate 只看「内容」不看「结构」,两者互补但都不完整。一个完整的控制策略应该同时考虑:当前 batch 让每多验证一个位置贵多少(结构),当前流量里的草稿命中率有多高(内容)。TensorRT-LLM 把前者交给调度层、后者交给验收集,中间没有显式的成本模型,所以调参时需要人为地把两者对齐——例如在 batch 大、重复率低的场景里,提前配置一个单段长度表,比依赖 gate 的事后熔断更及时。
不同模式的接入点也不一样:
- NGram 走外部
Drafter路径:get_spec_drafter返回NGramDrafter,草稿在模型前向之前由 Python 生成;模型引擎只负责验证。 - SA 独立模式 走 one-engine 路径:
get_spec_drafter返回None,get_spec_worker返回SAWorker,草稿在目标模型 epilogue 里生成;没有外部草稿 KV。 - SA 增强模式 走神经草稿器 +
SADraftEnhancer:草稿头正常跑,SA 在侧流上算候选,最后整体覆盖。 - AUTO 不是一种新算法,而是
AutoDecodingConfig在启动时调用suggest_spec_config,按最大 batch 选一组 SA 参数:低并发用max_draft_len=5, max_matching_ngram_size=3,高并发用max_draft_len=3, max_matching_ngram_size=5,并设置max_concurrency=32与enable_global_pool=True。
AUTO 的这组数字值得单独解释。低并发时验证批小,可以承担更长的草稿,所以 ;匹配长度 足够覆盖常见短语,太长反而降低命中率。高并发时验证批的每一行都更贵,草稿要短,;匹配长度提高到 5,是因为短草稿需要更高的单次命中质量来弥补长度不足。这与博客在 8×B200、Llama-4-Scout-17B 上观察到的规律一致:batch 1 与 4 时 最好,batch 32 时 最好。
调参与工程取舍
先选路线,再调参数
路线选择比参数更重要:
- 流量高度重复、延迟敏感、不想加载第二个模型:优先 SA 独立模式。它没有草稿前向,成本最低,参数也最少。
- 已经有 EAGLE-3/MTP/PARD 草稿头,且文本里存在大量精确重复:加
SAEnhancerConfig。神经头负责新内容,SA 负责重复片段,两者互补。 - 只是想让服务默认快一点、不想做模型适配:用
AUTO。它选的是 SA,并且按 batch 自动关小;这也是默认的无草稿模型入口。 - 还在用 NGram:计划迁移。文档已经标注 2027 年 1 月移除;NGram 的 Python 池在高并发下会成为主机瓶颈,SA 是同一思想的 GPU 版本。
参数怎么影响行为
| 参数 | 作用 | 调大的后果 | 调小的后果 |
|---|---|---|---|
max_draft_len / max_total_draft_tokens | 每步草稿数 | 命中时收益更高,验证批更宽,高并发下更亏 | 验证便宜,但边际收益低 |
max_matching_ngram_size | 匹配 key 的最大长度 | 匹配更精确,命中率可能下降,查询更慢 | 命中更多,但草稿更容易跑偏 |
max_concurrency | 超过多少请求关闭投机 | 高并发仍投机,可能拖慢整体 | 早关,低并发收益仍在 |
draft_len_schedule | 按 batch 分段设 | 控制更细,但需要 CUDA Graph 桶配合 | 默认单段,行为简单 |
threshold(SA enhancer) | 多长匹配才覆盖神经草稿 | 更保守,保留神经草稿 | 更激进,重复文本收益更高 |
acceptance_rate_window_size | 关闸观察窗口 | 判断更稳,反应更慢 | 反应快,容易误关 |
acceptance_rate_threshold | 关闸接受率下限 | 更早关闸 | 更宽容,可能长期低收益 |
调参时不要只看平均接受率。更有用的三个量是:迭代延迟(验证带来的单步成本)、接受长度分布(双峰还是单峰)、端到端吞吐(关闸与调度交互后的结果)。官方博客给出的测量方式是固定请求数,对比开/关投机的端到端 runtime,同时记录每轮接受长度;这套方法可以直接复用。
下面这张图是官方在对话第二轮上的端到端加速比。它说明的不是「某个模型有多强」,而是「同一组 在不同 batch 下的收益形状完全不同」:
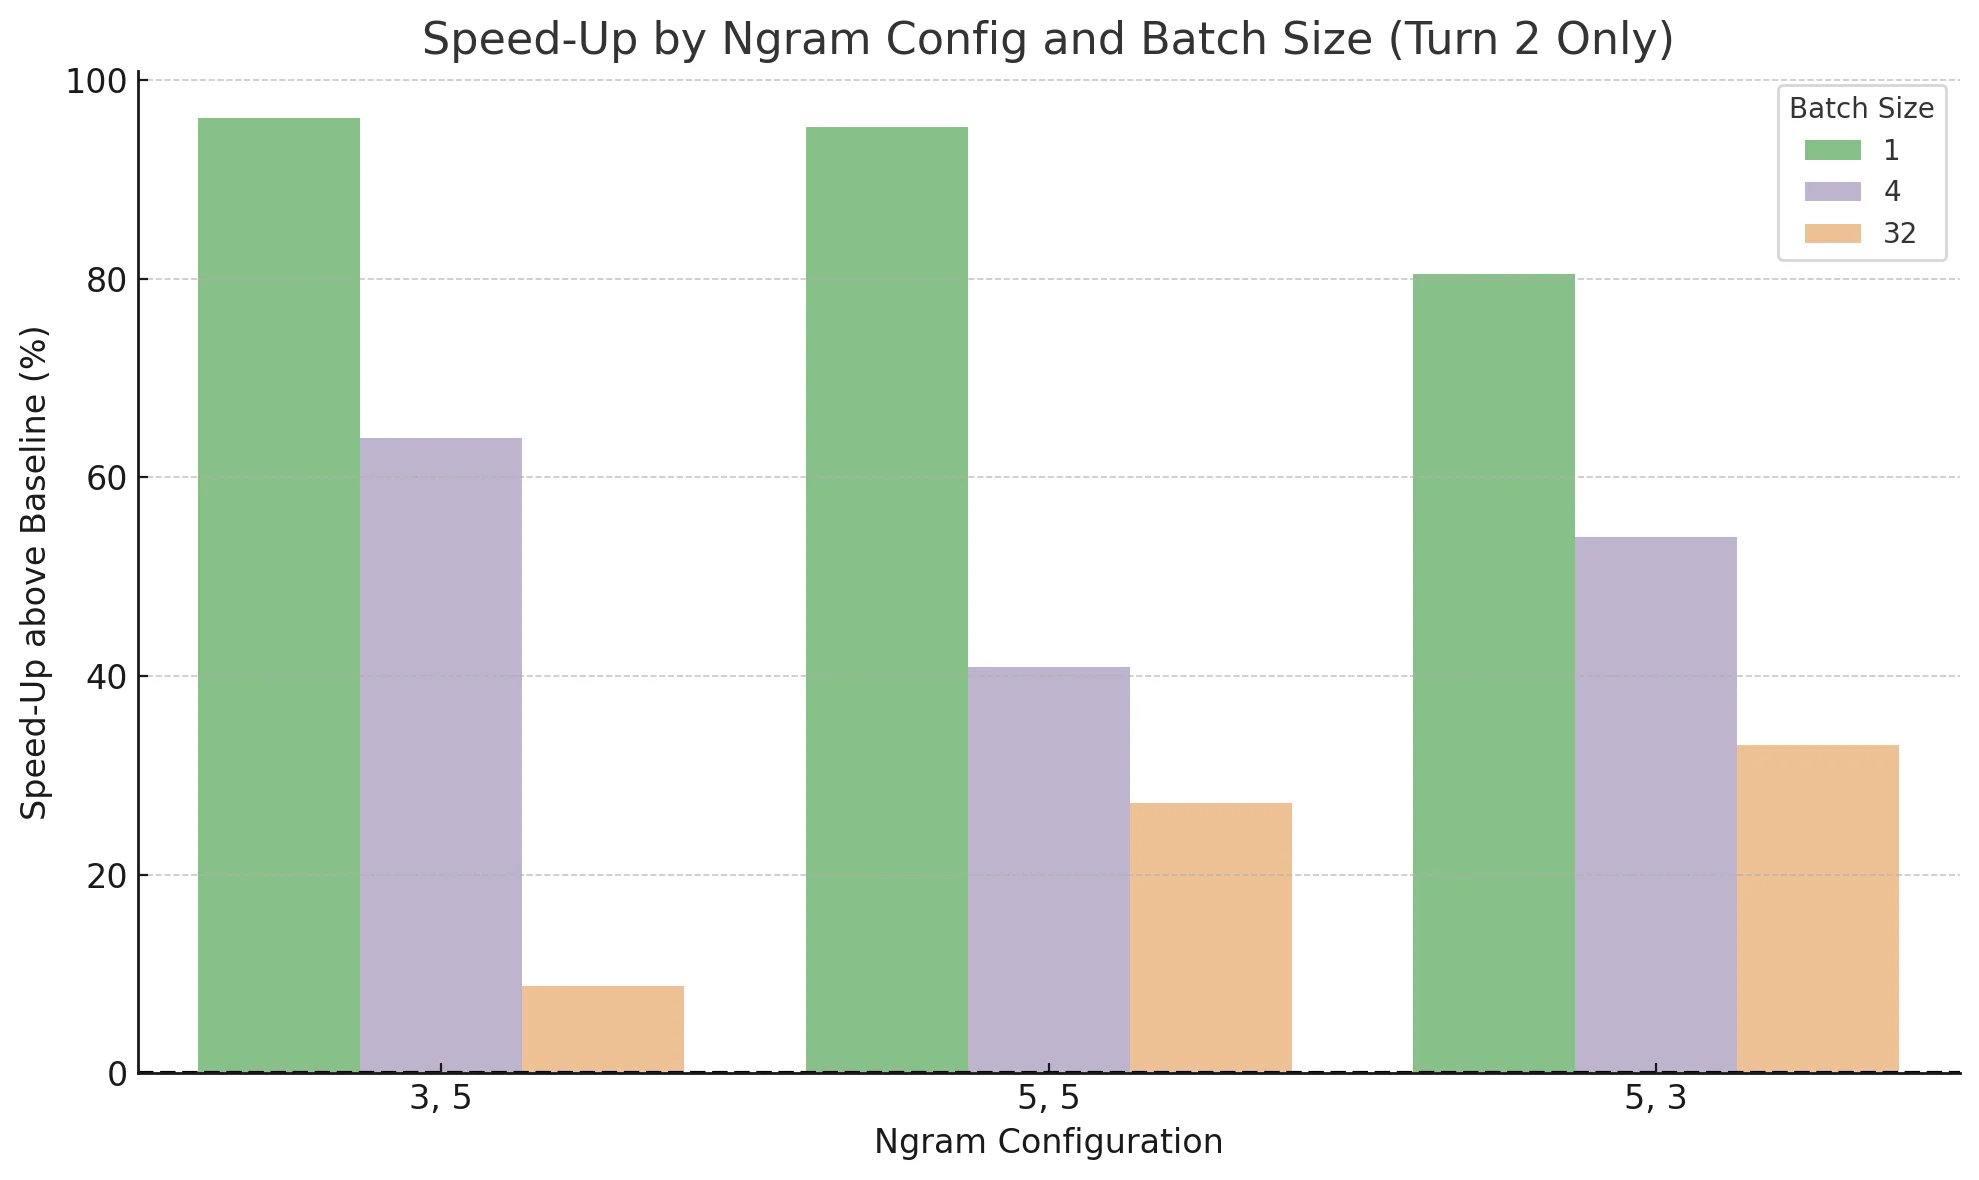
图中 batch 1 的柱子最高,batch 32 明显变矮;这不是实现退化,而是前面 模型的直接体现。调参时如果只在一个 batch 上测出「投机有效」,就把它推广到所有并发,几乎一定会失望。
几个容易踩的坑
第一,占位草稿会挤占预填充预算。 py_draft_pages_allocated 在调度前就设成 ,chunked prefill 的长请求会和草稿抢 token 预算。开启投机后 TTFT(Time To First Token,首 token 延迟)变差,很多时候不是草稿算得慢,而是调度器把预填充块切得更碎了。要同时看 TTFT 和 TPOT(Time Per Output Token,每 token 延迟)。
第二,动态长度表必须和 CUDA Graph 桶一起改。 只改 draft_len_schedule 不改桶列表,运行时可能落进形状不匹配的图。源码已经用 _merge_schedule_keys 自动把阈值并进桶列表,但如果你在外部生成配置文件,仍要确认桶列表覆盖了所有阈值。
第三,公共池的内存是单调的。 NGram 的公共池不清理已完成请求;SA 的全局池虽然有 FIFO 淘汰,但默认大小是 max(64, max_batch_size) 个槽位,每个槽位按 max_seq_len 分配。开之前按最坏情况算一遍显存。
第四,关闸不会重新打开。 长跑服务如果流量类型会切换,不要把 gate 当成自适应开关;它是一次性的熔断器。
第五,SA 的覆盖阈值不是越高越好。 阈值太高,SA 永远不生效,等于白开;阈值太低,SA 会覆盖掉神经头本来正确的草稿。默认 4 是一个保守起点,应该按实际文本的重复长度分布调整。
小结
TensorRT-LLM 的无模型投机解码不是一个「查表函数」,而是一套三层控制:
- 收益模型层:每步产出 个 token,验证成本随 batch 与 增长;最优草稿长度随并发下降,这是所有调度策略的出发点。
- 执行层:
Drafter统一了外部草稿器的生命周期——批内闸门按 token 预算与并发上限决定开不开,长度表按 batch 决定投多长,占位草稿在调度前就把 KV 与 token 预算记好,补零与 KV 扩展保证 CUDA Graph 形状稳定。 - 数据层:NGram 用 Python 哈希池实现「查历史续写」,SA 用 GPU 后缀自动机把同一件事做成 one-engine 算子;前者是理解原理的入口,后者是当前推荐实现。
SpeculationGate用滚动接受率做永久熔断,保证低命中率流量不会长期为验证买单。
下一篇可以从 SA 的原生算子继续,拆 invoke_extend / invoke_global_search 在 GPU 上如何维护状态、如何做跨槽位最长匹配;那部分决定 SA 在高并发下还能不能保持低延迟。
如果要记住一句话:检索式草稿的收益不取决于模型有多聪明,而取决于文本有多重复,以及调度器有多清楚这一点。源码里所有的闸门、长度表、掩码和熔断,都是在把「重复性」这个不可控变量,换算成可控的算力预算。
参考资料
- TensorRT-LLM Drafter 抽象与草稿器调度
- TensorRT-LLM NGram 池与 NGramDrafter
- TensorRT-LLM 后缀自动机管理器
- TensorRT-LLM SAWorker 与 SA 增强器
- TensorRT-LLM SpeculationGate
- TensorRT-LLM PyExecutor 迭代循环
- TensorRT-LLM N-Gram 投机解码性能分析与自动启用
- TensorRT-LLM 投机解码功能文档
- Fast Inference from Transformers via Speculative Decoding
- Accelerating Large Language Model Decoding with Speculative Sampling
- Prompt Lookup Decoding 参考实现
- TensorRT-LLM SA 增强器 SADraftEnhancer
- TensorRT-LLM AUTO 草稿参数启发式
- TensorRT-LLM 草稿器与元数据构造 utils
- cp-algorithms:Suffix Automaton
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



