


TensorRT-LLM 源码完全拆解(二十一):LoRA 服务——adapter 池、批内多适配器与前向替换的完整链路
从 CUDA Graph 继续:一个批次里的多个「模型」
第二十篇把动态批冻进了静态图:为了让一段前向可以被 torch.cuda.graph 捕获,权重指针、缓冲地址、批大小都得在捕获那一刻就固定下来,任何「每轮都会变」的量都必须事先搬进固定缓冲,靠原地改写而不是重新分配来更新。这一篇要拆的 LoRA 服务,正是那个约束最尖锐的场景——同一个 decode 批次里的不同请求,可能要用不同的权重。
LoRA(Low-Rank Adaptation)的出发点是一句很轻的假设:微调一个基座模型时,权重变化量 是低秩的,可以写成两个小矩阵的乘积
原始权重 不动,前向从 变成 。一个 adapter 需要落的盘只有 两个小矩阵,rank 取 8、16 时参数量常常是基座的千分之几。对服务系统来说,这句话翻译过来是:同一份基座权重可以服务成百上千个业务适配器——每个客服场景、每个垂直领域、每个租户的私有微调,都只是一组小小的 。
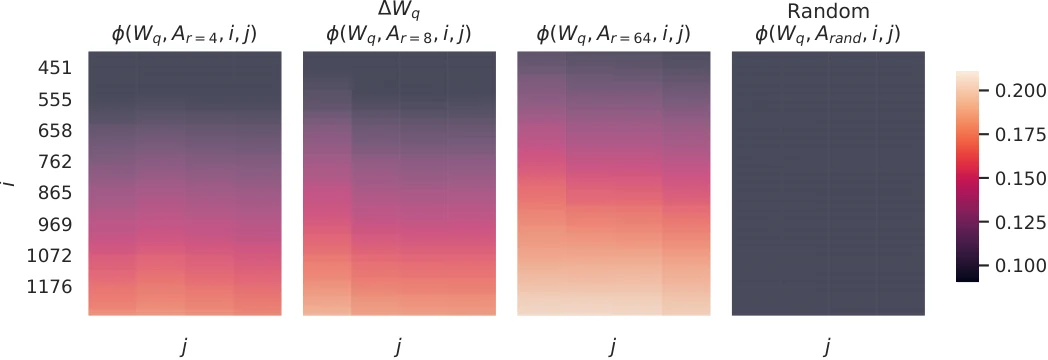
图源:LoRA 原始论文 Figure 2(arXiv:2106.09685)。论文用实测曲线说明了一件事:把 投影到低秩子空间后,它的能量绝大部分落在前几个奇异方向上——这就是「低秩假设」不只是省参数、而且几乎不损精度的地方。
问题在于,朴素做法做不到「一个批次里混跑多个 adapter」。如果批次里一半请求用 adapter 0、一半用 adapter 1,逐请求拆成两次前向等于把批处理的好处全部丢掉;而如果每轮把权重换成当前请求的那一份,一个几十 MB 的 H2D 拷贝就要吃掉大半 decode 预算。TensorRT-LLM(下称 TRT-LLM)在 PyTorch 后端里的答案分成三步:
- 权重常驻 + 固定槽位:所有要用的 adapter 权重一次性放进 GPU 的固定 buffer,槽位数量在启动时定死,前向期间不再搬运(
AdapterSlotManager与 C++ 侧PeftCacheManager); - 批内多适配器路由:把「哪些 token 用哪个 adapter」变成内核里的索引查表,而不是 Python 层的分支(
CudaGraphLoraParams); - 前向替换:用一个低秩算子在前向路径上「就地接上」修正项 ,并与基座计算重叠(
LoraLayer)。
本文的四个问题:
LoraConfig里哪些字段决定了「哪些矩阵可以被替换」,以及LoraManager从 HF 检查点到 GPU 权重的那条流水线做了什么变换;AdapterSlotManager怎样用固定槽位 + LRU 淘汰来管理 adapter 池,槽位与 C++ 缓存如何保持一致;- 一次 decode 批次如何从请求列表变成 slot_ids、
sorted_ids与按槽索引的权重指针表; LoraLayer的三条前向路径(eager、CUDA Graph、split-K 调优)分别做什么,以及 MoE、张量并行、FP8 三处需要额外对齐的口径。
本文沿用系列前文相同的固定提交 41913522c7f9f085c022421fb6183bd7592e076f。SGLang 侧的同题拆解可参考 SGLang 源码完全拆解(十三):多 LoRA 服务——adapter 池、SGMV 内核与批内多适配器共存;两篇对照看,能看到同一套论文思想在两条不同运行时里的两种落地方式。
LoraConfig:哪些矩阵可以被替换
一切从配置开始。tensorrt_llm/_torch/peft/lora/config.py 里的 LoraConfig 决定了 LoRA 的能力边界,字段不多但每一个都对应后续的一处约束:
class LoraConfig(StrictBaseModel): lora_dir: List[str] # adapter 检查点目录列表(HF 或 NeMo 格式) lora_ckpt_source: Literal["hf", "nemo"] = "hf" max_lora_rank: int = 64 # 所有 adapter 的最大秩,用于预分配 workspace lora_target_modules: List[str] # 要在哪些 TRT-LLM 模块上挂 LoRA trtllm_modules_to_hf_modules: Dict[str, str] = {} max_loras: Optional[int] = None # 设备侧同时驻留多少 adapter max_cpu_loras: Optional[int] = None # 主机侧预取缓存多少 adapter swap_gate_up_proj_lora_b_weight: bool = True overlap_lora_and_base: bool = False cuda_graph_specialize_lora: bool = False几个字段值得单独说。
max_lora_rank 默认 64,它的作用不是「限制 adapter 的秩」,而是预分配 workspace 的上界:内核要按最大的秩准备缓冲,所以启动时就得知道上界。这也是 LoRA 服务里最常被低估的一个工程约束——它事后无法放大,只能重启。
lora_target_modules 用的是 TRT-LLM 自己的模块名,与 HF 模块名之间靠 trtllm_modules_to_hf_modules 映射。默认映射表把两边的命名对齐了一遍:
| TRT-LLM 模块名 | HF 模块名 | 语义 |
|---|---|---|
attn_q / attn_k / attn_v | q_proj / k_proj / v_proj | 注意力投影 |
attn_qkv | qkv_proj | 融合后的 QKV 投影 |
attn_dense | o_proj | 注意力输出投影 |
mlp_h_to_4h / mlp_4h_to_h | gate_proj / down_proj | MLP 上下投影 |
mlp_gate / mlp_gate_up | up_proj / gate_up_proj | MLP 门控投影 |
moe_h_to_4h / moe_4h_to_h / moe_gate | w1 / w2 / w3 | 路由专家投影 |
moe_router | gate | MoE 路由门 |
shared_expert_h_to_4h / shared_expert_4h_to_h / shared_expert_gate | shared_expert.gate_proj / shared_expert.down_proj / shared_expert.up_proj | 共享专家 |
mamba_in_proj / mamba_out_proj | in_proj / out_proj | Mamba 状态空间层 |
missing_qkv_modules 是一个只读属性,背后是一个很实际的兼容处理:在当前设计里,q_lora_params、k_lora_params、v_lora_params 必须同时启用或同时禁用——因为内核一次算的就是 QKV 三路。但有些检查点(配置注释里点名了 BART)只带其中两个,于是 TRT-LLM 的策略是:检测到「三缺一」时,记下缺的那个模块,后面用零张量补齐。cross_attn_q/k/v 同理。这样做的好处是内核路径永远只看到「三路齐全」的形态,代价是一个恒等于零的 GEMM 白算一遍——用一点算力换掉一整类分支。
swap_gate_up_proj_lora_b_weight 默认打开,是因为不同来源的检查点对 gate_up_proj 的排列约定不同:HF 的 gate_up_proj 在权重里通常是 [gate; up] 顺序,而 TRT-LLM 的融合路径用的是相反顺序,所以要交换 lora_B 的上下两半。模型如 Phi-4-MM 排列一致,才需要把这个开关关掉。这类「同一份数据两种约定」的分歧在融合算子里非常常见,处理方式也很统一:在装载时一次性改写成自己内部的约定,前向路径上不再做任何判断。
从检查点到 GPU:LoraManager 的加载流水线
tensorrt_llm/_torch/peft/lora/manager.py 里的 LoraManager 负责把磁盘上的 adapter 变成内核对得上账的权重。load_from_hf() 的主循环对每个 adapter 走一遍下面这条流水线:
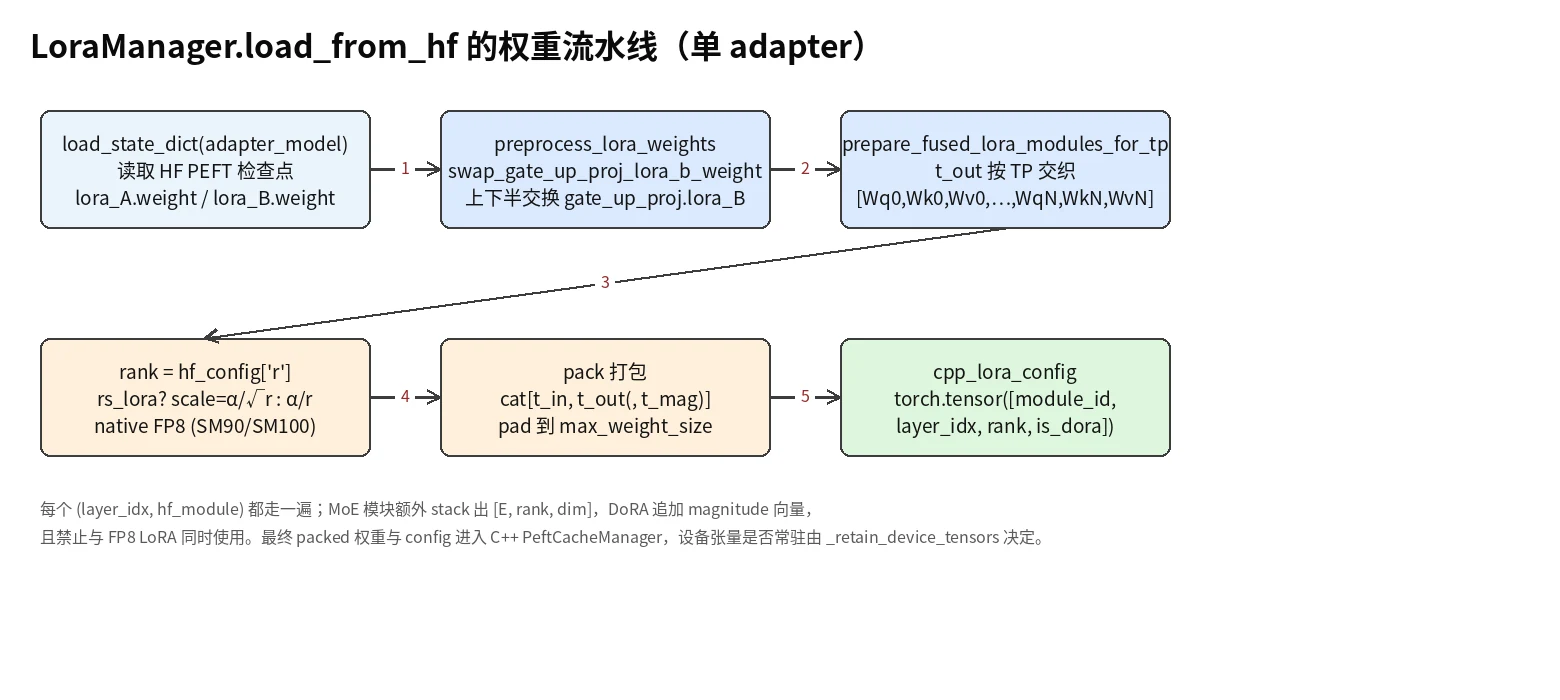
第一步:读检查点。 load_state_dict(get_model_path(model_dir, "adapter_model")) 会把 adapter_model.bin 或 adapter_model.safetensors 读成一张 state dict,键名是 HF 的 ...q_proj.lora_A.weight 这种形态。
第二步:gate/up 交换。 前面说的约定修正就发生在这里:
def preprocess_lora_weights(lora_model, model_config): if getattr(model_config, "swap_gate_up_proj_lora_b_weight", True): for key, value in lora_model.items(): if "gate_up_proj.lora_B.weight" in key: half_split = value.shape[0] // 2 first_half, second_half = value[:half_split], value[half_split:] lora_model[key] = torch.cat((second_half, first_half), dim=0) return lora_model第三步:按 TP 交织。 如果 tp_size > 1,融合模块的 LoRA 权重必须先重排——HF 检查点里 attn_qkv 的 lora_B 是 cat([Wq, Wk, Wv]) 的顺序,而 TP 分片是按「每个 rank 拿一段 q、一段 k、一段 v」切的,所以要把顺序改成 cat([Wq_rank0, Wk_rank0, Wv_rank0, ..., Wq_rankN, Wk_rankN, Wv_rankN]):
assert weight.shape[rank_dim] == sum(part_sizes)weight_parts = [weight.narrow(rank_dim, sum(part_sizes[:i]), part_sizes[i]) for i in range(len(part_sizes))]weight_parts_tp_weights = [ torch.split(part, part.shape[rank_dim] // tp_size, dim=rank_dim) for part in weight_parts]return list(itertools.chain.from_iterable(zip(*weight_parts_tp_weights)))其中 part_sizes 对 attn_qkv 是 [q_size, kv_size, kv_size],q_size = head_size * num_heads * tp_size(乘回 tp_size 是因为 ModelConfig 里的 num_heads 已经被除过一次),对 mlp_gate_up 则是均分的两半。tp_size == 1 时整段直接跳过。交织完之后代码还会 torch.cat 拼回完整权重——注释写得很直白:C++ 实现期望拿到未切分的完整权重,切分这件事留给后续的指针表按 rank 计算偏移。
第四步:定标。 rank 与缩放系数来自 adapter 自己的配置:
rank = int(hf_config["r"])rs_lora = bool(hf_config.get("use_rslora", False))cache_dtypes = {...}if rs_lora: scale = float(hf_config["lora_alpha"]) / np.sqrt(effective_rank)else: scale = float(hf_config["lora_alpha"]) / effective_rank这里有个容易踩的坑:use_rslora 打开时(Rank-Stabilized LoRA),分母是 而不是 。两种口径下同一个 adapter 的有效缩放能差出数倍,如果服务端按普通 LoRA 的口径去读一个 rs-LoRA 检查点,模型不会报错,只是输出质量悄悄变差。
第五步:FP8 特判。 如果基座是量化模型、adapter 权重是原生 FP8,且当前设备支持原生 FP8 LoRA 内核(Hopper SM90 与 Blackwell B200 SM100 支持,SM103/SM107/SM120/SM121 不支持),权重就保持 FP8 不降精度。但 FP8 没有标量乘法,缩放只能在 BF16 里做完再夹回 FP8 值域:
fp8_max = torch.finfo(t_out.dtype).maxt_out = (t_out.to(torch.bfloat16) * scale).clamp(-fp8_max, fp8_max).to(t_out.dtype)同时这里还有两条硬性校验:t_in 与 t_out 必须同 dtype;并且同一个 adapter 的所有模块必须落在同一个 PEFT 缓存 dtype 上——混用「原生 FP8 稠密模块」和「计算 dtype 的路由专家 MoE 模块」会直接抛错,而不是悄悄降级。
第六步:打包成 C++ 侧认识的结构。 每个 (layer_idx, lora_module) 的权重被拍平、拼接、pad 到统一的 max_weight_size,再 stack 成一整块:
cpp_lora_weights.append(torch.cat(weights_to_concat)) # [t_in, t_out(, t_mag)]cpp_lora_config.append(torch.tensor( [self.LORA_MODULE_IDS[lora_module], layer_idx, effective_rank, is_dora], dtype=torch.int32))LORA_MODULE_IDS 是一张 26 项的模块名到整数 id 的映射表(attn_qkv 为 0,moe_latent_fc2 为 25),这份整数 id 就是内核对「这一段权重属于哪个矩阵」的全部认知。is_dora 位也是在这里埋下的:DoRA 会多一个 magnitude 向量,跟着一起打包,但DoRA 与 MoE 的组合被显式拒绝(源码里那句注释「this might work, but I had no MoE DoRA models to test」),理由是 per-expert 布局下 magnitude 的语义没有定义。
装载的最后一步是把打包结果写进 _cpp_lora_weights / _cpp_lora_config,并把低秩表记进 _lora_uid_to_low_ranks[uid]。注意 _retain_device_tensors 这个开关:只有 cpp_peft_cache_manager is None(也就是老的 TRT 后端路径)时才需要 Python 侧常驻 GPU 张量并记录 data_ptr()——PyTorch 后端下,设备侧缓存由 C++ 的 PeftCacheManager 自己管,Python 只留 CPU 侧打包好的权重。
adapter 池:AdapterSlotManager 与两级缓存
权重装载完之后,真正决定「一个批次里能同时跑几个 adapter」的是槽位。tensorrt_llm/_torch/peft/lora/adapter_slot_manager.py 里只有 130 行左右,但它是整条 CUDA Graph 兼容链路的支点:
class AdapterSlotManager: def __init__(self, max_num_adapters: int): self.max_num_adapters = max_num_adapters self.slot2task: List[Optional[int]] = [None] * max_num_adapters self.task2slot: OrderedDict[int, int] = OrderedDict() # LRU 顺序 self.slots_changed = False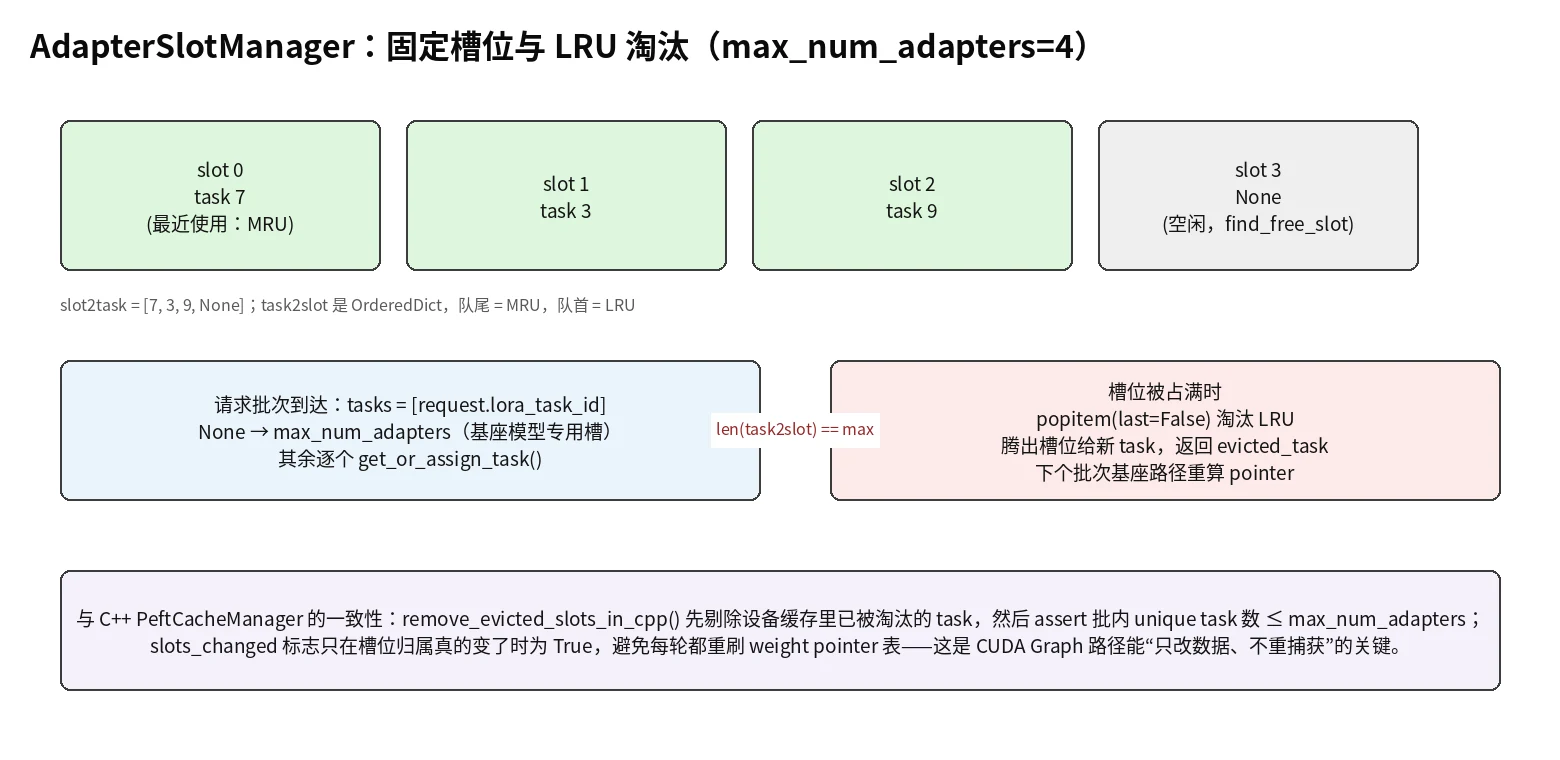
为什么是「固定槽位」而不是字典? 因为 CUDA Graph。捕获一次图之后,内核读的权重指针必须落在捕获时确定的地址上;如果槽位是按需分配的,指针表就得每轮重写地址,图也就白捕获了。TRT-LLM 的做法是:槽位容器固定(slot2task 是一个定长列表),每个槽位的内容按需换入换出,指针表则始终按「槽号」索引而不是按「任务号」索引。这样一来,槽位归属变化时只改指针表的内容(图内允许的原地改写),槽位数量与地址布局都不变。
LRU 的记账方式很直观:task2slot 是一个 OrderedDict,队尾是最近使用的(MRU),队首是最久未用的(LRU)。get_or_assign_task() 返回一对值——分配到的槽号与被淘汰的任务号:
def get_or_assign_task(self, task_id: int) -> tuple[int, Optional[int]]: evicted_task = None if task_id in self.task2slot: self.task2slot.move_to_end(task_id) # 命中:刷新 LRU else: self.slots_changed = True if len(self.task2slot) < self.max_num_adapters: free_slot = self.find_free_slot() # slot2task.index(None) self.slot2task[free_slot] = task_id self.task2slot[task_id] = free_slot else: evicted_task, evicted_slot = self.task2slot.popitem(last=False) self.slot2task[evicted_slot] = task_id self.task2slot[task_id] = evicted_slot return self.task2slot[task_id], evicted_task「基座模型」也占一个槽——但不在这个表里。 update_slots() 把没有 adapter 的请求统一映射成 max_num_adapters 这个哨兵值:
tasks = [request.lora_task_id for request in requests]unique_tasks = {t for t in tasks if t is not None}assert len(unique_tasks) <= self.max_num_adapters, ( f"Batch with more unique LoRA adapters ({len(unique_tasks)}) than " f"max_num_adapters={self.max_num_adapters} is not supported")for i, task in enumerate(tasks): tasks[i] = self.max_num_adapters if task is None else self.get_or_assign_task(task)[0]也就是说,槽号的有效范围是 ,最后一个值是「不挂 LoRA」的专用槽。这个设计让前向路径不需要区分「这个请求有没有 adapter」——它只看见一个槽号,而基座槽对应的 rank 为 0,内核在 rank 为 0 时自然算出零修正项。一条判断从热路径挪到了参数表里。
两级缓存的一致性。 Python 侧的槽位表之外,还有 C++ 侧 PeftCacheManager 管理的设备/主机缓存。两边可能不同步:C++ 侧可能因为容量压力提前淘汰了某个 adapter,而 Python 侧的槽位表还以为它在。所以 update_slots() 的第一件事就是对齐:
def remove_evicted_slots_in_cpp(self, peft_cache_manager): for task_id in self.slot2task: if task_id is not None and not peft_cache_manager.is_task_cached_device(task_id): self.remove_task(task_id)slots_changed 标志是整条链路的性能开关。 它只在「槽位归属真的变了」时置位——新任务进槽、任务出槽都会置位,而命中已有槽位(LRU 刷新)不会。下游 CudaGraphLoraManager 每轮检查这个标志,只有它为真时才重刷整张权重指针表。考虑一个稳态服务:批次里反复出现同样的几个 adapter,槽位归属长期不变,标志几乎一直是假,指针表在捕获期之后就再没被改写过。这正是「固定槽位」这个设计换来的收益。
一次 decode 批次的路由:从请求到 slot_ids
tensorrt_llm/_torch/pyexecutor/engine/lora.py 里的 LoraParamBuilder.build() 是每轮前向之前的入口。它的第一个决策是走哪条路:
use_cuda_graph_mode = cuda_graph_lora_manager is not None and maybe_graphif use_cuda_graph_mode: if not use_lora_graph: cuda_graph_lora_manager.prepare_base_only_batch(peft_cache_manager) return None tokens_per_seq = 1 if enable_spec_decode and runtime_draft_len > 0 and self._spec_config.is_linear_tree: tokens_per_seq = runtime_draft_len + 1 return cuda_graph_lora_manager.prepare_cuda_graph_lora_params( scheduled_requests, attn_metadata, peft_cache_manager, tokens_per_seq)else: if cuda_graph_lora_manager is not None: cuda_graph_lora_manager.adapter_slot_manager.remove_evicted_slots_in_cpp( peft_cache_manager) peft_table = peft_cache_manager.get_and_reset_batch_peft_table() lora_params = peft_table and self._build_eager(...) if lora_params: lora_params["data_type"] = peft_cache_manager.data_type return lora_params两点值得注意。第一,prepare_base_only_batch() 存在的原因是:一个批次可能整体都不需要 LoRA(比如 cuda_graph_specialize_lora 打开时,框架会为「无 LoRA 的批次」单独捕获一张图)。这种批次虽然不跑 LoRA 内核,但仍要维护 PEFT 缓存状态——把 batch_peft_table 消费掉、淘汰失效槽位——否则下一轮真正需要 LoRA 时会读到过期的表。第二,走 CUDA Graph 路径时有一条硬性前提:
assert scheduled_requests.num_context_requests == 0, ( "Context requests are not supported with LoRA CUDA Graph path. " f"Have {scheduled_requests.num_context_requests} context requests")LoRA 的 CUDA Graph 只服务纯 decode 批次(或投机解码的验证批次)。prefill 的 token 数随请求变化,形状不固定,跑不进静态图,只能退回 eager 路径。
CUDA Graph 路径的核心在 CudaGraphLoraManager.prepare_cuda_graph_lora_params() 里,一共四步:
peft_table = peft_cache_manager.get_and_reset_batch_peft_table()request_slot_ids = self.adapter_slot_manager.update_slots(request_list, peft_cache_manager)self.cuda_graph_lora_params.update_sorted_indices(request_slot_ids, tokens_per_seq)slot2task = self.adapter_slot_manager.get_slot_to_task_mapping()if self.adapter_slot_manager.has_slots_changed(): self.cuda_graph_lora_params.update_weight_pointers(peft_table, slot2task) self.adapter_slot_manager.reset_slots_changed()self.cuda_graph_lora_params.update_slots_params(batch_slot_ids=request_slot_ids, tokens_per_seq=tokens_per_seq)第一步:请求 → 槽号。 就是上一节 update_slots() 的产物,一个长度等于批内序列数的 slot_ids 列表。
第二步:按槽号重排。 update_sorted_indices() 把「槽号 → 该槽在本批次里占据的行」变成一张置换表。为什么要重排?因为分组 GEMM 的语义是「连续的一段行共用一个权重」,所以必须先把属于同一个 adapter 的行聚到一起:
sorted_indices = self.get_sorted_indices(slot_ids)if tokens_per_seq > 1: token_sorted_ids = (sorted_indices.unsqueeze(1) * tokens_per_seq + torch.arange(tokens_per_seq, dtype=sorted_indices.dtype)).flatten()else: token_sorted_ids = sorted_indicesnum_tokens = actual_batch_size * tokens_per_seqself.sorted_ids = self.persistent_sorted_ids # 捕获期固定地址self.sorted_ids[:num_tokens].copy_(sorted_ids_host, non_blocking=True)tokens_per_seq > 1 的分支服务于投机解码的线性树验证:每个序列在这一轮前向里贡献不止一个 token(草稿 token 加一个被验证的位置),所以「按槽重排」要先把序列级的置换展开成 token 级的置换。这里所有写入都落在 persistent_sorted_ids 与 pinned host 缓冲上,地址在捕获期就固定——图外的 Python 只做 copy_,不做分配。
同一个函数里还顺手生成了 token_to_slot,这是路由专家 MoE 路径专用的「token → 槽」表。它的 padding 区域在构造时清零一次之后就再不动了,注释解释得很清楚:C++ 算子里的地址算术会读到 num_tokens 之外的位置,那里必须永远是 0,否则会读到上一轮的陈旧槽号,把某个 token 的修正项算到错误的 adapter 上。
第三步:刷新权重指针表(只在必要时)。 update_weight_pointers() 遍历全部槽位,按「槽 → 任务 → PEFT 表」三级查出一组指针。它有三种分支:
for slot_id in range(self.max_lora_size): task_id = slot_to_task_mapping[slot_id] if task_id is None: # 空槽:rank 归零、指针清零 self.slot_ranks_host[slot_id] = 0 zero_out_weight_pointers(slot_id) elif peft_table is None or task_id not in peft_table: continue # 本轮没有为该任务准备新条目:沿用旧指针 else: config = peft_table[task_id][0] # 同槽内所有模块 rank 相同 self.slot_ranks_host[slot_id] = config.adapter_size ...第二条分支是这类「按需刷新」代码的典型形态:「暂时没有新信息」不等于「信息失效」。如果某个 adapter 上一轮已经装好、这一轮没有再出现在 peft_table 里(因为它没被重新准备),那么它现有的 rank 和指针依然有效,直接跳过——重刷一遍不仅浪费,还会因为拿不到新指针而把有效表项清掉。
指针表本身的布局也是为图捕获准备的:每个槽一行,每行三个 int64(A 指针、B 指针、DoRA magnitude 指针),打包成 [max_lora_size, 3] 的整型张量:
assert self.PTR_DTYPE == torch.int64, ( f"PTR_DTYPE must hold a full device address, got {self.PTR_DTYPE}")这条断言看着多余,其实是这类「把地址当数据存在张量里」的设计里最要紧的一道防线:任何比 int64 窄的类型都会静默截断设备地址,而截断后的指针不会报错,只会让 grouped GEMM 读到一片无关显存。同理 LD_DTYPE(leading dimension)也是 int64,SIZES_DTYPE(m,n,k)才是 int32。
MoE 路径还有一套按 (layer_idx, module_id) 展开的槽缓存,也就是每个 MoE 层、每个专家模块各有一份 [max_lora_size] 的 rank 表和 [max_lora_size, 3] 的指针表。之所以要按层展开,是因为一个 adapter 不必覆盖每一层:
# The ranks are the global per-slot ranks masked to the slots this# layer/module actually has pointers for: an adapter need not cover every# MoE layer, and the grouped-GEMM problem builder reads an unmasked# rank > 0 on a null-pointer slot as an active rank-sized GEMM.换句话说,如果某层没有该 adapter 的权重却带着一个非零 rank,问题构造器会认真地为它排一段 GEMM,然后在解引用空指针时崩掉——所以「没有指针」必须显式表达成「rank 为 0」。
第四步:按批次更新 GEMM 尺寸与偏移。 update_slots_params() 根据本轮的 batch_slot_ids 重算每个槽里有多少个 token,并把它变成前缀和形式的槽偏移:
slot_counts = self.get_slot_counts(batch_slot_ids, self.max_lora_size) * tokens_per_seqself.slot_counts_host.copy_(slot_counts)self.get_offset_from_counts(slot_counts, full=True, out=self.slot_offsets_full_host)self.slot_counts.copy_(self.slot_counts_host, non_blocking=True)self.slot_offsets_full.copy_(self.slot_offsets_full_host, non_blocking=True)get_slot_counts() 本身只是一次 torch.bincount(..., minlength=max_lora_size) 再截断到 max_lora_size——统计每个槽在批次里出现几次,用的是计数排序的同一套工具;get_offset_from_counts() 则对计数做 cumsum_,得到每个槽在重排后张量里的起始行。* tokens_per_seq 再一次呼应投机解码:序列级的计数要放大成 token 级的计数,否则偏移会少算。这些写入同样只做 copy_,不重新分配——slot_counts、slot_offsets_full、slot_ranks 三个张量以及它们对应的 pinned host 副本都是构造期一次性分配的,这是「图内只改数据」原则的又一次应用。
slot_offsets_full 的长度是 max_lora_size + 1 而不是 max_lora_size(self.slot_offsets = self.slot_offsets_full[:-1]):前缀和数组天然要比计数多一格,最后那一格是「所有槽的 token 总数」,也就是重排后张量的总行数。这类「多一格」的边界在写内核参数时最容易出错,所以在数据结构层面就把它固定下来,而不是让调用点各自去推断。
前向替换:LoraLayer 的三条路径
前面所有准备都是为了这一刻:模型前向走到某个线性层时,怎么把 LoRA 的修正项接上去。
与基座并行:forward_with_base
LoraLayer.forward_with_base() 是一个静态方法,模型层在调用基座投影的同时把它叫上:
@staticmethoddef forward_with_base(base_forward, lora_layers, x, lora_params, layer_idx): cuda_graph_params = lora_params.get('cuda_graph_params') has_lora_layer = bool(cuda_graph_params) and any( CudaGraphLoraParams.LoraLayerKey(layer_idx=layer_idx, module_ids=tuple(layer.module_types)) in cuda_graph_params.layer_info for layer in lora_layers)
lora_aux_stream = lora_params.get("lora_aux_stream") execute_in_parallel = (has_lora_layer and lora_aux_stream is not None and do_multi_stream() and not torch.compiler.is_compiling()) ... if execute_in_parallel: base_output, lora_outputs = maybe_execute_in_parallel( base_forward, lora_forward, lora_layers[0]._par_events[0], lora_layers[0]._par_events[1], lora_aux_stream, disable_on_compile=True) else: base_output, lora_outputs = base_forward(), lora_forward()
for lora_output in lora_outputs: if not isinstance(lora_output, torch.Tensor): continue base_output = add_lora_result(base_output, lora_output) return base_output三个细节藏着信息量。其一,lora_layers 必须是元组,因为一个层可能同时挂着融合版与非融合版两种 LoRA 形态(例如 attn_qkv 与 attn_q/attn_k/attn_v),两个变体都会被调用,但只有一个会真正跑出结果——另一个返回 None,被 add_lora_result 的 isinstance 检查过滤掉。其二,maybe_execute_in_parallel 走的是 overlap_lora_and_base 开关对应的辅助 CUDA stream:LoRA 的修正项计算与基座投影互不依赖(两者都只读输入 ,末尾才相加),所以可以把 LoRA 放到第二条流上,用两个 event 做同步。对 memory-bound 的 decode 阶段,这一重叠是真的能省时间的。其三,disable_on_compile=True——在 torch.compile 的图里多流会让编译器的依赖分析失效,所以编译期自动退回串行。
合并方式是原地加:
def add_lora_result(output: torch.Tensor, lora_result: Optional[torch.Tensor]) -> torch.Tensor: if lora_result is not None: output.add_(lora_result.to(output.dtype)) return output修正项不是「替换」而是「叠加」——这一点值得强调,因为它决定了很多后续设计:基座权重始终原样参与计算,LoRA 只贡献 ,两者在最末尾相加。因此基座路径不需要知道 LoRA 的存在,adapter 的增删也不会影响基座侧的数值。
三种输入 dtype:forward 的入口检查
LoraLayer.forward() 的开头只有十来行,但处理了一个容易出错的边界——混合精度:
input_dtype = x.dtypedata_type = lora_params.get("data_type")if data_type is not None and input_dtype != data_type: if data_type == torch.float8_e4m3fn and input_dtype in ( torch.float16, torch.bfloat16, torch.float32): fp8_max = torch.finfo(data_type).max x = x.clamp(min=-fp8_max, max=fp8_max).to(data_type) else: raise TypeError(f"LoRA input dtype {input_dtype} must match PEFT cache dtype {data_type}.")当 PEFT 缓存是 FP8、而基座前向的激活是 BF16 时,输入会被夹到 FP8 值域再转换;除此之外的任何 dtype 不匹配都直接报错。「要么能无损夹取,要么就失败」——这类判断放在热路径入口处,比让内核算出垃圾数值再回头排查要省事得多。
路径一:CUDA Graph 模式
_forward_cuda_graph_mode() 负责在静态图里跑 LoRA。它的前半段在判断「这一层该不该干活」:
layer_key = CudaGraphLoraParams.LoraLayerKey(layer_idx=layer_idx, module_ids=tuple(self.lora_module_types))if (not cuda_graph_params or not cuda_graph_params.layer_info or layer_key not in cuda_graph_params.layer_info): return Nonelayer_params = cuda_graph_params.get_layer_params(layer_key)if layer_params is None: return None # 该层没有 LoRA 模块,直通LoraLayerKey 是一个 (layer_idx, module_ids) 的具名元组。它是「一层里的哪些模块走 LoRA」的身份指纹:同一个层索引可能对应多种模块组合(融合的 attn_qkv 与非融合的 attn_q/k/v),两种组合的 GEMM 问题规模完全不同,必须各自捕获、各自有一份参数。返回 None 的语义是「这一层不需要 LoRA 修正」,forward_with_base 会把它过滤掉。
后半段是真正的参数填充与内核调用(_forward_cuda_graph_mode_impl):
batch_size, hidden_size = x.shape[0], x.shape[-1]num_layer_modules = len(self.lora_module_types)total_output_size = sum(self.output_hidden_sizes)if x.dtype == torch.float8_e4m3fn: min_kn = _validate_fp8_lora_cuda_graph_alignment( cuda_graph_params.slot_ranks_host, hidden_size, self.output_hidden_sizes, max_rank)else: min_kn = min(hidden_size, 8, max_rank) # rank 若小于 8 会有对齐问题
output_buffer = torch.empty(batch_size, total_output_size, dtype=x.dtype, device=x.device)intermediate_buffer = torch.empty([num_layer_modules, batch_size, max_rank], ...)min_kn 这个量是给内核的最小 K/N 上界:非 FP8 路径下硬编码取 min(hidden_size, 8, max_rank),注释直说「rank 小于 8 会有对齐误差」——也就是说,内核的 tile 划分假设 K、N 至少是 8,秩很小的 adapter(比如 r=4)要靠 padding 到 8 才能安全走这条路径。FP8 路径下则交给 _validate_fp8_lora_cuda_graph_alignment 按每个槽的实际 rank 重新算,因为 FP8 内核的对齐要求更严。
接下来是最能体现「TRT-LLM 风格」的一段:GEMM 的全部参数——每个问题的 (m, n, k)、A/B/C 的行偏移、leading dimension、split-K 偏移、以及重排后的输入——由一个融合算子一次算完:
torch.ops.trtllm.lora_group_gemm_param_fill_row_reorder_fusion( in_sizes, out_sizes, a_offset, d_offset, d_prime_offset, lda, ldd, ldb_prime, ldd_prime, splitk_offsets, reordered_input, # 输出 input.max_lora_size, input.max_rank, sum_out_sizes, input_hidden_size, bs, input.slot_counts, input.slot_ranks, input.slot_offsets, input.output_hidden_sizes, input.output_sizes_offset, input.b_ptrs, input.b_prime_ptrs, input.x, input.sorted_ids[:bs], input.intermediate_buffer, input.output_buffer, input.x.dtype) # 输入名字里的 row_reorder 说的就是前面 sorted_ids 的用途:内核一边填参数,一边把输入行按槽重排进 reordered_input。「填参数」和「重排输入」融进同一个内核,是为了少读一遍输入、少一次 kernel launch——这类融合在 decode 阶段收益明显,因为此时每次 launch 的固定开销占比很高。
参数就位后调真正的计算:
torch.ops.trtllm.lora_grouped_gemm_cuda_graph( grouped_gemm_params.in_sizes, grouped_gemm_params.out_sizes, grouped_gemm_params.a_offset, layer_params.d_b_ptrs, grouped_gemm_params.d_offset, layer_params.d_b_prime_ptrs, grouped_gemm_params.d_prime_offset, cuda_graph_params.get_problem_count(layer_key), grouped_gemm_params.lda, grouped_gemm_params.ldb, grouped_gemm_params.ldd, grouped_gemm_params.ldb_prime, grouped_gemm_params.ldd_prime, host_max_in_sizes, host_max_out_sizes, grouped_gemm_params.splitk_offsets, grouped_gemm_params.reordered_input.dtype, min_kn, split_k)注意这里出现的是两份指针表:d_b_ptrs 与 d_b_prime_ptrs、ldb 与 ldb_prime、d_offset 与 d_prime_offset。分组 GEMM 的修正项要算两段——先 得到中间结果,再 得到修正项——两段各自需要一份 B 矩阵的指针与形状信息,所以参数是成对出现的,intermediate_buffer 的形状 [num_layer_modules, batch_size, max_rank] 正对应第一段的结果。
输出的还原用 index_copy_ 而不是 index_select:
restored_output = torch.empty_like(output_buffer)restored_output.index_copy_(0, cuda_graph_params.sorted_ids[:batch_size], output_buffer)因为 sorted_ids 是一个置换,index_copy_ 借助置换把「按槽排好序的行」放回「原始请求顺序」。这里还夹着一条 FP8 的绕行:
# PyTorch does not implement index_copy_ for FP8 tensors.if output_buffer.dtype == torch.float8_e4m3fn: output_buffer = output_buffer.to(torch.bfloat16)也就是说 FP8 路径下修正项先落到 BF16 再还原——反正马上要和 BF16 的基座输出相加,提前转出来还省了一次转换。
路径二:split-K 调优
_forward_cuda_graph_mode() 本身还套了一层自动调优。它把「一层 + 一个 token 数档位」当成一个可调对象,用 _LoraGroupedGemmRunner 包起来,交给 AutoTuner 选 split-K:
runner = self._split_k_runner # 每层一个,惰性创建runner.lora_params = runner.copy_lora_params(lora_params)runner_inputs = [x]_, split_k = AutoTuner.get().choose_one( "trtllm::lora_grouped_gemm_cuda_graph", [runner], runner.tuning_config, runner_inputs)return runner(runner_inputs, tactic=split_k)_LoraGroupedGemmRunner 的类注释一句话点明它的粒度:「Tune split-K for one logical LoRA layer and token-count bucket」。为什么 split-K 值得单独调?因为 LoRA GEMM 的形状很特殊:M 是批内序列数(decode 时很小,几十到几百),N 是输出维度(大),K 是秩(很小,几十)。K 小意味着 GEMM 本身的并行度不够,把 K 切开放到更多 SM 上能明显提吞吐——但 split 之后要额外做一次归约,切太细反而亏。最优切分点随 M(也就是批大小)变化,所以按「层 × token 数档位」分别调优、把结果缓存下来,是这里最省的做法。
路径三:eager 模式
当批次是 prefill、或者没有走 CUDA Graph 时,_forward_eager_mode() 走的是老算子。它先从按层索引的 lora_params 里收集本层实际激活的模块:
layer_params = lora_params.get(layer_idx, {})for module_idx in self.lora_module_types: if module_idx in layer_params: active_lora_module_ids.append(module_idx) lora_ranks.append(layer_params[module_idx]['adapter_size']) lora_weight_pointers.append(layer_params[module_idx]['weight_pointers'])if len(active_lora_module_ids) == 0: return Nonelora_outputs = torch.ops.trtllm.lora_grouped_gemm( x, lora_params['host_request_types'][:num_seqs], lora_ranks, lora_weight_pointers, lora_params['prompt_lens_cpu'][:num_seqs], self.output_hidden_sizes, False, True, max([r.max() for r in lora_ranks]), 0, True)这条路径与 CUDA Graph 路径的差别正好体现了图捕获的代价:eager 模式直接读按层索引、按模块索引的嵌套字典(layer_params[module_idx]['weight_pointers']),形状与指针都来自 Python 侧的实时构造;而图模式必须把这些全部压平成定长张量。代价换来的是一致性:两条路径共享同一个 lora_grouped_gemm 算子语义,只是参数组织方式不同。
多模块时还有一个小补丁:如果某个模块本层没有活跃 LoRA,算子不会为它产出输出,框架就补一个同形状的零张量再拼回去,让输出布局与 lora_module_types 的顺序始终对齐。
MoE LoRA:per-expert 布局与 kernel slot 约定
路由专家(routed-expert)LoRA 是这条链路里最绕的一块。layer.py 里有一段「单一事实来源」的注释,把约定写死了:
MOE_LORA_MODULE_NAMES = ("moe_h_to_4h", "moe_4h_to_h", "moe_gate")MOE_LORA_MODULE_TO_KERNEL_SLOT = { LoraModuleType.MOE_H_TO_4H: "fc1", LoraModuleType.MOE_GATE: "gated", LoraModuleType.MOE_4H_TO_H: "fc2",}它解释的是内核为什么需要「slot」而不是「模块名」:MoE 内核把 FC1 的两半打包在一起输出,其中 gate(接 SiLU)那一半与 up(线性)那一半是相邻的。内核约定:「fc1」这个 LoRA 槽作用在 gate 半上,「gated」这个槽作用在 up 半上,「fc2」作用在第二个投影上。而 TRT-LLM 规范的模块命名是 moe_h_to_4h = w1(gate/SiLU)、moe_gate = w3(up/linear)、moe_4h_to_h = w2(down)——三者的对应关系是交叉的(moe_h_to_4h → fc1,moe_gate → gated),不是字面上的顺序对齐。这张映射表被 MoE 工厂、校验器、布局工具与 CUTLASS MoE 后端共享,注释特意点名「keep this the single source of truth」——因为一旦某一处独立推导这套对应关系,就会得到「gate 上的 LoRA 被加到 up 半上」这种数值正确、语义全错的 bug。
布局上,每个专家各有自己的一对 。 moe_layout.py 的注释把寻址方式讲清楚了:
# Each expert gets its own (A, B) low-rank pair; the underlying MoE kernel# offsets both A and B pointers by `expert_index * dim * rank` to read the# per-expert slice.所以在装载时 MoE 模块的权重形状与稠密模块不同:t_in 是 [E, rank, in_dim]、t_out 是 [E, out_dim, rank],rank_dim 从稠密的 0 变成 1(因为多了一个专家维),这也是 prepare_fused_lora_modules_for_tp 需要显式接收 rank_dim 的原因。而前向时,内核靠 token_to_slot 找到每个 token 属于哪个槽,再靠路由结果定位它命中的专家,把指针偏移到对应的专家切片上。
与稠密模块最大的不同是:MoE 的 GEMM 不由 LoraLayer 执行。 layer.py 里有一个 MoeLoraLayer 子类,它的 forward() 直接抛异常:
class MoeLoraLayer(LoraLayer): """Marker LoraLayer for routed-expert MoE modules.
Routed-expert LoRA is *fused* into the MoE kernel (torch.ops.trtllm.fused_moe with LoRA kwargs); the actual GEMMs are not performed by LoraLayer.forward. This subclass exists so that CudaGraphLoraManager._initialize_from_model and the LoRA target-module validator can discover MoE LoRA layers via isinstance(module, LoraLayer) and inspect their lora_module_types / output_hidden_sizes ... """
def forward(self, *args, **kwargs): raise NotImplementedError( "MoeLoraLayer is a discovery marker; routed-expert LoRA is applied " "inside torch.ops.trtllm.fused_moe via the MoE module. " "Do not call MoeLoraLayer.forward directly.")这是一个「空壳子类」,存在的唯一目的是让发现逻辑工作:CudaGraphLoraManager._initialize_from_model() 与目标模块校验器都用 isinstance(module, LoraLayer) 来扫模型,如果 MoE 模块不继承 LoraLayer,它们就会在 layer_info 里漏掉整层 MoE 的 LoRA 参数——而漏掉的后果是图捕获时少了一层的关键字,运行到那层直接 KeyError。让 forward() 抛异常则是另一道防线:MoE 的修正项是在 fused_moe 内部与专家 GEMM 一起算的(同一遍读输入、同一遍写输出),如果谁误以为它和稠密模块一样、在外面单独调一次 LoraLayer.forward,等于把修正项白算两遍,第二遍还会因为缺少 MoE 上下文而算错。用「显式报错」替代「静默多算一遍」,在融合算子边界上是很有必要的。
MoE LoRA 有两条明确的限制,都在装载期就拦下来:其一,原生 FP8 adapter 权重的路由专家 LoRA 不支持(混合 dtype 会触发前面那条 cache_dtypes 校验);其二,DoRA 与 MoE 不组合。
三处口径必须对齐:TP、FP8 与 gate/up
把前面散落的细节收一收,TRT-LLM 的 LoRA 实现里有三处「同一份数据、两套约定」的分歧点,处理方式各不相同但思路一致。
第一处:张量并行的分片口径。 前面讲过,融合模块的 LoRA 权重需要按 TP 交织,且交织完之后还要拼回完整权重交给 C++,由指针表按 rank 计算偏移。这与 S-LoRA 的「把 adapter 也按 TP 维度切开」是两种不同的工程路线:S-LoRA 的目标是让每个 rank 只存自己那一份、从而支持极多的 adapter;TRT-LLM 这里保留完整权重、由指针表做偏移,换来的好处是同一份打包权重在所有 rank 上是同一份数据,不需要为分片再做一次落盘一致性检查。
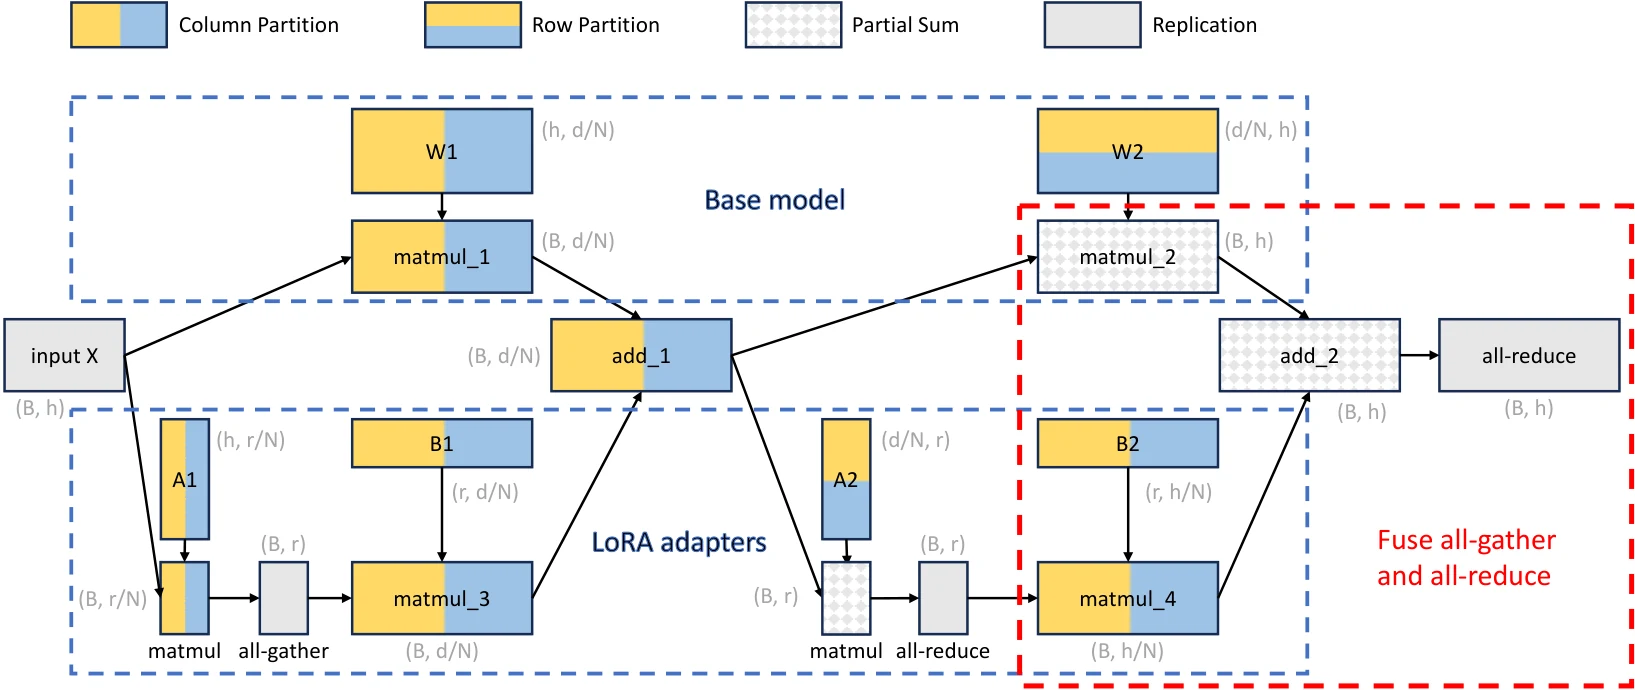
图源:S-LoRA 论文 Figure 3(arXiv:2311.03285)。两条路线对照看很有意思:S-LoRA 选择「切得更多、省显存」,TRT-LLM 选择「不切、靠偏移」,前者适合 adapter 数量极多的多租户场景,后者更适合与既有 fused kernel、CUDA Graph 路径无缝衔接。
第二处:FP8 的值域与缩放。 前面讲过三段:装载时用 BF16 完成缩放再夹回 FP8;前向入口把 BF16 激活夹到 FP8 值域;输出还原时因为 index_copy_ 不支持 FP8 而先转 BF16。三段的共同前提是「基座是 FP8 量化模型、adapter 也是原生 FP8」——如果设备不支持原生 FP8 LoRA 内核(比如 SM120/SM121),adapter 会被转成计算 dtype,链路自动退回普通的 BF16 路径,行为与未量化模型一致。
第三处:gate/up 的排列。 装载期的上下半交换(swap_gate_up_proj_lora_b_weight)与 MoE 的 kernel slot 交叉映射是同一类问题的两个实例:融合算子的内部排列是私有的,外部来源的约定必须在入口处完成一次性改写。 这两种处理都把「翻译」挤在装载阶段,前向路径上没有任何分支——这是能让内核保持扁平的通用手法。
工程取舍与陷阱
max_lora_rank 事后无法放大。 它决定的是 workspace 上界,一旦启动就冻结。上线前把 rank 估小、后面想加一个大秩 adapter,只能改配置重启。稳妥的做法是取「已知最大秩 × 1.5」再向上取整到 16 的倍数。
max_loras 与 max_cpu_loras 是两个容量。 前者是设备侧同时驻留的 adapter 数(也就是槽位数量),后者是主机侧预取缓存的容量。两个数字都偏小时,最常见的行为不是报错而是抖动:adapter 被频繁换入换出,每次都要过一次 H2D,性能掉得毫无规律。压测时如果看到 P99 抖动而 P50 正常,先怀疑这里。
adapter 没有出现在 peft_table 里不代表它失效。 上一节的第二条分支说明过这一点:只有「新的准备条目」才会触发指针刷新,「没有新条目」会沿用旧指针。排查「换了 adapter 但输出没变」这类问题时,要看的不是 peft_table 的内容,而是 slots_changed 是否被正确置位——如果某一轮槽位归属变化却被判成没变,指针表就会停留在旧槽位上。
预填充批次不走 CUDA Graph 路径。 前面那条 assert num_context_requests == 0 就是证据。这意味着长 prompt 的 prefill 阶段 LoRA 走的是 eager 算子;如果业务里 prefill 占比高,调优重点应该在 eager 路径的 lora_grouped_gemm 上,而不是 CUDA Graph 的 split-K。
稀疏的 per-expert 权重必须显式表达成 rank 0。 MoE 那条注释值得再念一遍:rank 大于 0 但指针为空,会被问题构造器当成「有一个活跃的 rank-sized GEMM」,然后在解引用时崩掉。做自定义 adapter 生成工具时,凡是没有权重的层/模块,都要显式写 0,不能留默认值。
小结
这一篇把 TRT-LLM PyTorch 后端的 LoRA 服务链路拆完了,核心结论有五条:
-
LoRA 服务的技术核心不是低秩数学,而是「把动态身份塞进静态数据结构」。 低秩分解只是前提;真正的工程量集中在
AdapterSlotManager的固定槽位、CudaGraphLoraParams的定长张量、persistent_sorted_ids的地址稳定这几件事上。原因很简单:第二十篇所拆的 CUDA Graph 路径要求地址与形状在捕获期固定,而 LoRA 天生是「每轮都可能不同」的东西,两者要对齐,只能把「不同」编码成固定容器里的内容变化。 -
槽位号是整条链路的通用货币。 从
update_slots()产出槽号,到sorted_ids按槽重排,到slot_counts/slot_offsets/slot_ranks按槽索引,到指针表按槽排列——前向路径上的每一层都只认槽号,不认任务号、不认 adapter 名。基座模型也用槽号表达(max_num_adapters哨兵 + rank 0),于是「有没有 LoRA」这件事在热路径上根本不需要判断。 -
权重装载是一次性的翻译层。 gate/up 排列、TP 交织、rs-LoRA 缩放口径、FP8 值域处理,全部挤在
load_from_hf()里完成;前向路径上没有任何「这一步该怎么解释」的分支。这也是_cpp_lora_config里那个[module_id, layer_idx, rank, is_dora]四元组能承载全部语义的原因——内核只需要整数。 -
两级缓存的一致性靠一次显式对齐保证。 Python 侧的槽位表与 C++ 侧的
PeftCacheManager之间可能出现「Python 以为还在、C++ 已经淘汰」的分歧,靠每轮开头的remove_evicted_slots_in_cpp()抹平。缓存不一致在这类系统里的默认表现不是报错,而是数值悄悄错位——这是把「以谁为准」写成一个独立步骤、而不是靠多处防御性检查的原因。 -
代价落在三个地方: 槽位数量(
max_loras)与秩上界(max_lora_rank)都在启动时定死,事后只能重启;prefill 批次退回 eager 路径,长 prompt 场景享受不到静态图;MoE + FP8、MoE + DoRA 两类组合被显式拒绝,adapter 侧要提前避开。
从系列视角看,这一篇补上了「请求身份」这条维度——前面二十篇反复出现的一个主题是「一个批次里有很多不同的请求」,而这一篇增加的是一层「这些请求可能属于不同的模型版本」。下一篇会继续停在服务面:不管选题落在哪一块,主线仍然是同一个问题——怎么把一个批次里并存的多种身份,拆成可以被静态捕获的数据结构。
参考资料
- TensorRT-LLM GitHub 仓库
- TensorRT-LLM LoRA 官方文档(docs/source/features/lora.md,固定提交)
- TensorRT-LLM LoRA 管理器源码(peft/lora/manager.py,固定提交)
- TensorRT-LLM LoRA 前向层源码(peft/lora/layer.py,固定提交)
- TensorRT-LLM LoRA 配置源码(peft/lora/config.py,固定提交)
- TensorRT-LLM adapter 槽位管理源码(peft/lora/adapter_slot_manager.py,固定提交)
- TensorRT-LLM CUDA Graph LoRA 参数源码(peft/lora/cuda_graph_lora_params.py,固定提交)
- TensorRT-LLM CUDA Graph LoRA 管理源码(peft/lora/cuda_graph_lora_manager.py,固定提交)
- TensorRT-LLM adaptor 装载源码(peft/lora/loaders.py,固定提交)
- TensorRT-LLM MoE LoRA 布局工具源码(peft/lora/moe_layout.py,固定提交)
- TensorRT-LLM 每批次 LoRA 参数构造源码(pyexecutor/engine/lora.py,固定提交)
- LoRA 原始论文:Low-Rank Adaptation of Large Language Models(arXiv:2106.09685)
- S-LoRA 论文:Serving Thousands of Concurrent LoRA Adapters(arXiv:2311.03285)
- Punica 论文:Efficient Multi-Tenant LoRA Serving(arXiv:2310.18547)
- TensorRT-LLM 源码完全拆解(二十):CUDA Graph 与编译路径
- TensorRT-LLM 源码完全拆解(十三):MoE 层前向执行——路由、Fused Kernel 与专家并行的三段拼装
- TensorRT-LLM 源码完全拆解(十二):注意力层的张量并行——head 怎么切、MLA 为什么不能照切
- SGLang 源码完全拆解(十三):多 LoRA 服务——adapter 池、SGMV 内核与批内多适配器共存
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



