


vLLM 源码完全拆解(十八):多 LoRA 服务——adapter 槽位、Punica 低秩核与批内多租户路由
问题:一个基座模型,为什么要同时服务几百个「微调人格」
在推理框架系列前十七篇里,基座模型的前向基本是「一份权重、一批请求」:所有请求共用同一套 q_proj、k_proj、o_proj,共享同一份 KV Cache 池,调度器只关心谁先跑、谁该让位。加入多 LoRA 之后,同一批里可能出现五六个不同的「微调人格」,它们共享基座权重,但在每一层 dense 投影上都叠着一个自己的低秩增量 。这一篇要回答的,是 vLLM V1 怎么把这个「人格」从请求一路带到 GPU 内核里。
先把 LoRA 本身摆清楚。LoRA 于 2021 年由微软在 LoRA: Low-Rank Adaptation of Large Language Models 中提出:对冻结的基座权重 ,学习两个低秩矩阵 与 ,推理时的权重是
其中 是秩(常见 8、16、32、64), 是缩放系数, 是 PEFT 约定的缩放因子。r 远小于 ,所以单个 adapter 通常只占基座 0.1% 到 1% 的权重体积。训练成本低,自然就会有很多份:一个基座,几十上百个租户适配。真正困难的部分不在训练,而在服务。
朴素做法为什么不行
假设要同时服务 个 adapter。最直接的做法是「一个 adapter 一份独立模型」:每份模型单独起一个 vLLM 实例,各自加载一份基座。两份 7B 模型的权重要占两份显存,十份就是把 70B 的显存全部用来存十份完全相同的基座——这是纯浪费。换成「动态加载、切换时整模型替换」,单次加载 7B 权重要几秒到十几秒,SLA 根本撑不住。
因此多 LoRA 服务的第一个硬需求是共享基座;第二个硬需求是不同 adapter 的请求要能进同一个 batch。但「进同一个 batch」立刻引出三个新问题:
- kernel 层面:一次 GEMM 里,不同 token 要乘不同的 ,普通 GEMM 做不到「按行选权重」;
- 显存层面:GPU 上要同时放多少份 adapter?谁决定哪些能进 GPU?
- 调度层面:某个 adapter 不在 GPU 上,而对应请求已经被调度进 batch,怎么办?
Punica(Chen 等,2023 年 arXiv 预印,UW 与 Duke 的合作工作)正是为回答这三个问题而设计的。它的核心贡献是 SGMV 内核:把「多个 adapter 的低秩增量」合并成一次 batched 的矩阵-向量乘,并配套了一个在共享集群上按 adapter 把请求归类调度的调度器。论文报告的结论是,在相同规模集群上,多 LoRA 服务的吞吐比现有 LLM 推理系统高 12 倍,而每个 token 只多 2ms 延迟。S-LoRA(Sheng 等,arXiv 2023-11)则从另一侧补足:把所有 adapter 放在主存、按需换入 GPU,用统一的页式内存池管理不同秩的 adapter 与 KV Cache,并设计了一套能覆盖「按秩切分」的张量并行方案,报告吞吐相比 PEFT 与朴素支持 LoRA 的 vLLM 最高提升 4 倍、可服务 adapter 数量提升数个数量级。
vLLM 的 vllm/lora/ 子系统基本上就是这两套思想在 V1 引擎里的工程实现:Punica 的 SGMV 被替换成 Triton 版的 lora_shrink / lora_expand,S-LoRA 的「主存放全量、GPU 放少量槽位」变成了两层 LRU 缓存,S-LoRA 的秩切分变成了 fully_sharded_loras 开关。下面按请求、装载、换层、路由、内核、MoE、服务闭环的顺序把这条链走一遍。
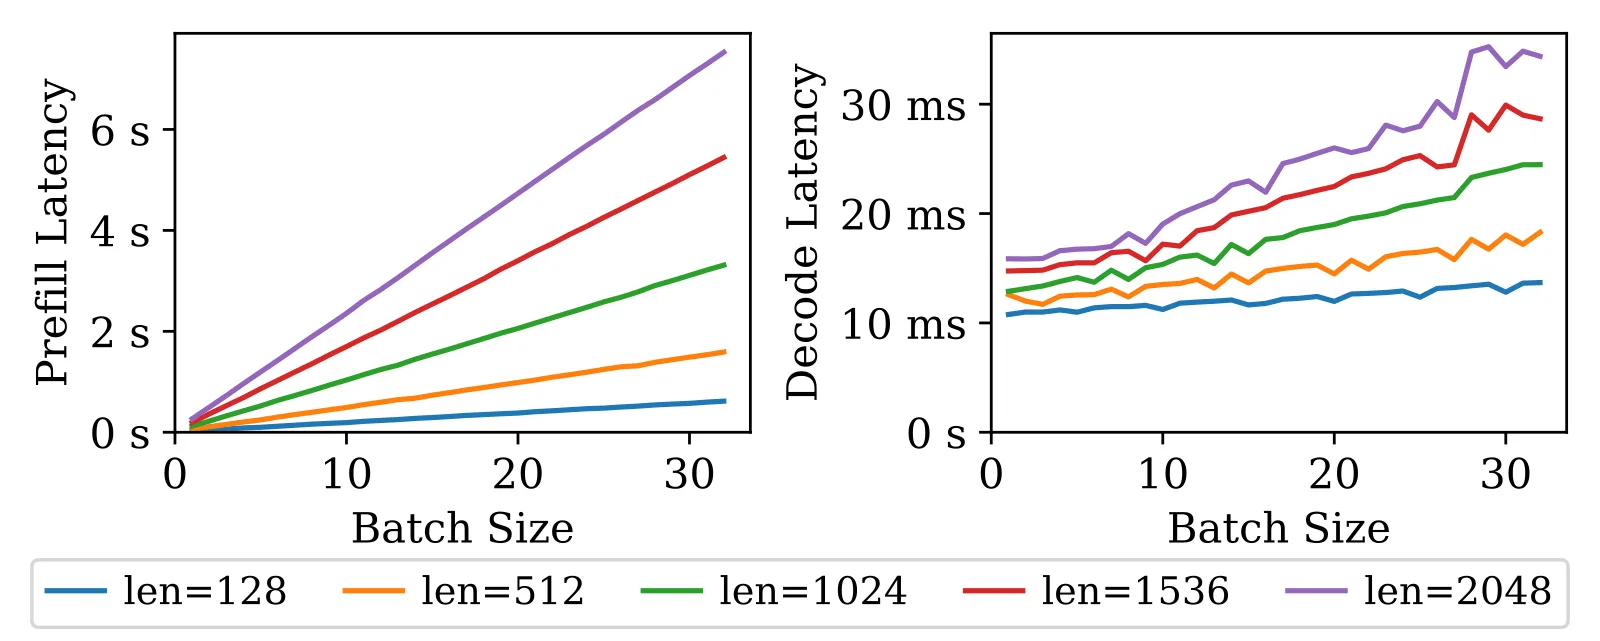
图 1:Punica 论文 Figure 1。Prefill 延迟随批大小线性增长,说明计算被充分利用;decode 阶段把批大小从 1 提到 32,短序列延迟只从 11ms 到 13ms、长序列从 17ms 到 34ms,说明 decode 阶段把多个请求并进同一批几乎不增加开销。多 LoRA 的价值正建立在这个前提上:既然 decode 的 batch 本来就应该做大,那同一批里混入不同 adapter 也不会额外付出多少代价。图片来源:Punica 论文。
总体结构:一条请求里的 LoRA 信息如何走到 GPU
在动手看代码前,先把数据流的骨架立起来。vLLM 的 LoRA 子系统可以粗略分成四层:
请求层 LoRARequest (adapter 名/id/路径) │ InputBatch.add_request → request_lora_mapping[req_index] = lora_int_id调度后 make_lora_inputs → token_lora_mapping (每个 token 的 lora id) │ LoRAMapping → WorkerLoRAManager.set_active_adapters管理层 LRUCacheWorkerLoRAManager → LRUCacheLoRAModelManager │ activate_adapter: adapter 复制进 GPU 槽位, 改写槽位表 lora_index_to_id内核层 PunicaWrapperGPU.update_metadata → LoRAKernelMeta.prepare_tensors │ lora_shrink / lora_expand (Triton)执行层 每个被替换过的层: base_layer(x) + punica_wrapper.add_lora_linear(...)每一层做的事都不多,但层与层之间的「坐标系」在变:请求层用的是用户给的 lora_int_id,管理层把它映射成 GPU 槽位序号(lora_index_to_id 的下标),内核层再把每个 token 的槽位序号整理成「按 adapter 排序后的行号表」。读懂多 LoRA 服务,本质上就是读懂这几次坐标系变换。
一个请求进入 V1 引擎并落进 InputBatch 时,只做了一件很小的事:
# vllm/v1/worker/gpu_input_batch.py (add_request 内)if request.lora_request: lora_id = request.lora_request.lora_int_id self.lora_id_to_request_ids.setdefault(lora_id, set()).add(request.req_id) self.request_lora_mapping[req_index] = lora_id self.lora_id_to_lora_request[lora_id] = request.lora_requestelse: # No LoRA self.request_lora_mapping[req_index] = 0request_lora_mapping 是一个长度 max_num_reqs 的整型数组,第 req_index 个请求用到的 adapter id 就放在这里;0 表示基座模型、不走任何 adapter(LoRARequest 的构造器强制 lora_int_id >= 1,正是为了给「无 LoRA」留出 0)。注意这里记录的是 id 而不是槽位,因为此时 adapter 可能还不在 GPU 上,槽位是后面才分配的。
LoRARequest 本身是个很薄的 msgspec 结构:
class LoRARequest(msgspec.Struct, omit_defaults=True, array_like=True): lora_name: str lora_int_id: int lora_path: str = "" base_model_name: str | None = None load_inplace: bool = False is_3d_lora_weight: bool = False其中 lora_path 可以是本地目录,也可以是 Hugging Face 风格的仓库标识(get_adapter_absolute_path 会负责下载或解析)。load_inplace 是给「热更新 adapter」场景准备的:同一个 id 的适配器已经加载在 GPU 槽位里,但文件变了,需要强制重新读一遍并原地替换。is_3d_lora_weight 只有 MoE 模型在用,讲 MoE 时再展开。
请求、槽位与两个缓存:adapter 的注册与激活
max_loras 与 max_cpu_loras
LoRAConfig 的几个数决定了整个子系统的容量与行为:
class LoRAConfig: max_lora_rank: MaxLoRARanks = 16 # 单个 adapter 的秩上限 max_loras: int = 1 # 一个 batch 内最多同时启用多少个 adapter max_cpu_loras: int | None = None # 主存里最多保留多少个 adapter fully_sharded_loras: bool = False lora_dtype: torch.dtype | LoRADType = "auto"max_loras 不是「一共能服务多少个 adapter」,而是「GPU 上同时存在的 adapter 槽位数」。每个被替换过的层都会按 max_loras 预分配一组堆叠缓冲,max_loras=8 就意味着一层的 lora_a_stacked 有 8 个槽。max_cpu_loras 才是「主存里能登记多少个」,它必须不小于 max_loras,_validate_lora_config 会检查并在默认情况下把 max_cpu_loras 对齐到 max_loras。max_lora_rank 决定缓冲的最后一维,加载时会校验 adapter 自身的秩(包括 rank_pattern 里的分模块秩)不超过它。
lora_dtype="auto" 表示 adapter 权重跟随基座 dtype(典型是 BF16)。这一点在混合精度场景里会引出后续的 fp32 中转缓冲讨论。
两个 LRU 缓存
class LRUCacheLoRAModelManager(LoRAModelManager): def __init__(self, ...): self._registered_adapters: AdapterLRUCache[LoRAModel] = AdapterLRUCache( self.capacity, self.deactivate_adapter) # capacity = max_cpu_loras self._active_adapters: AdapterLRUCache[None] = AdapterLRUCache( self.lora_slots, self._deactivate_adapter) # lora_slots = max_loras_registered_adapters 是「主存层」,最多 max_cpu_loras 份 LoRAModel(权重都躺在 CPU 上,且尽量 pin_memory);_active_adapters 是「GPU 层」,最多 max_loras 份,值是一个空的占位 None,只用来维护 LRU 顺序。两个缓存是独立的淘汰器,通过 _on_remove 回调彼此牵连:主存层淘汰某个 adapter 时调用 deactivate_adapter,把它从 GPU 槽位里腾出来;GPU 层淘汰时调用 _deactivate_adapter,只把 id 从 lora_index_to_id 里抹掉。
lora_index_to_id 是槽位表的唯一真相:
self.lora_index_to_id: list[int | None] = [None] * self.lora_slots第 i 个元素为 None 表示该槽位空闲,为某个 adapter id 表示该槽位当前装的是它。所有后续「id → 槽位」的转换都用它。
set_active_adapters:每一步的激活入口
模型 runner 在每次前向前,都会把「这一批请求用到了哪些 adapter」交给 worker 层。V1 的 LoRAModelRunnerMixin.set_active_loras 负责组织这一步:
def set_active_loras(self, input_batch, num_scheduled_tokens, num_sampled_tokens=None, mapping_type=...): if num_sampled_tokens is None: num_sampled_tokens = np.ones_like(num_scheduled_tokens, dtype=np.int32) prompt_lora_mapping, token_lora_mapping, lora_requests = ( input_batch.make_lora_inputs(num_scheduled_tokens, num_sampled_tokens) ) return self._set_active_loras(prompt_lora_mapping, token_lora_mapping, lora_requests, mapping_type)make_lora_inputs 做的是「请求级映射」到「token 级映射」的广播:
req_lora_mapping = self.request_lora_mapping[: self.num_reqs]token_lora_mapping = tuple(req_lora_mapping.repeat(num_scheduled_tokens))prompt_lora_mapping = tuple(req_lora_mapping.repeat(num_sampled_tokens))这一步之所以要展开到 token 粒度,是因为 chunked prefill 和连续批处理让「请求」与「一次前向」不再是同一回事:一个请求可能这次只调度了 512 个 token,另一个请求这次调度了 1 个解码 token,但它们共享同一趟前向。内核拿到的 token_lora_mapping 就是长度等于本步 token 总数、每个位置写着该 token 所属 adapter id 的数组。prompt_lora_mapping 是采样侧的对应数组:prefill 阶段只对最后一个位置采样,decode 阶段每个请求采一个 token,长度等于本步的采样 token 数。
_set_active_loras 把这两份 tuple 包成 LoRAMapping:
lora_mapping = LoRAMapping( token_lora_mapping, prompt_lora_mapping, is_prefill=True, # CUDA 平台上下同构, 这个字段被忽略 type=mapping_type,)self.lora_manager.set_active_adapters(lora_requests, lora_mapping)WorkerLoRAManager.set_active_adapters 先处理 adapter 的进出(_apply_adapters),再把映射写进内核元数据(_adapter_manager.set_adapter_mapping(mapping))。「adapter 进出」在 LRU 版本里是:
def _apply_adapters(self, lora_requests): loras_map = {r.lora_int_id: r for r in lora_requests if r} if len(loras_map) > self._adapter_manager.lora_slots: raise RuntimeError(...) for lora in loras_map.values(): self.add_adapter(lora) # 已加载则 touch, 未加载则读盘 + activate也就是说,每一步都只保证「本步用到的 adapter 在 GPU 上」,其他的留在主存层,直到被 LRU 挤出去。这就是 S-LoRA「主存放全量、GPU 放当前批」那套内存层次在 vLLM 里的落地。
activate_adapter:把 CPU 上的低秩矩阵搬进 GPU 槽位
def activate_adapter(self, lora_id: int) -> bool: if lora_id in self._active_adapters: return False index = 第一个空闲槽位 # lora_index_to_id 里第一个 None lora_model = self._registered_adapters[lora_id] for module_name, module in self.modules.items(): module_lora = self._get_lora_layer_weights(lora_model, module_name) if not module_lora: module.reset_lora(index) # 这个 adapter 没训该模块: 槽位清零 continue module.set_lora(index, module_lora.lora_a, module_lora.lora_b) self._active_adapters[lora_id] = None self.lora_index_to_id[index] = lora_model.id return True三个细节很关键:
- 槽位是整层复用的:所有被替换的层按同一套
max_loras槽位编号,第index个槽位在所有层上装的是同一个 adapter 的权重。因此「这个 token 属于槽位 3」对所有层都有意义。 - 没训练的模块要清零:很多 adapter 只训了
q_proj、v_proj,没有训gate_proj。对应槽位必须显式reset_lora(index),否则会残留上一个 adapter 的权重。reset_lora在 linear 层里就是把这两个槽的张量.zero_()。 set_lora只写有效范围:缓冲按max_lora_rank分配,实际秩更小的 adapter 只写前r行/列,剩余部分是 0。因此变秩 adapter 的数学结果是对的: 中被写进去的那部分就是真正的低秩乘积,剩下的 0 不贡献。
add_adapter(LRU 版本)负责先确保主存层有它、再确保 GPU 层有它:
def add_adapter(self, lora_request: LoRARequest) -> bool: with gpu_sync_allowed(): if (lora_request.lora_int_id not in self.list_adapters() or lora_request.load_inplace): lora = self._load_adapter(lora_request) # 读盘 → CPU LoRAModel self._adapter_manager.remove_adapter(lora.id) # load_inplace 时先删旧 if len(self._adapter_manager) + 1 > self._adapter_manager.capacity: self._adapter_manager.remove_oldest_adapter() # 主存层 LRU 淘汰 loaded = self._adapter_manager.add_adapter(lora) else: loaded = self._adapter_manager.get_adapter(...) is not None self._adapter_manager.activate_adapter(lora_request.lora_int_id) return loadedremove_oldest_adapter 淘汰主存层最久未用的 adapter 时,AdapterLRUCache._on_remove 会调用 deactivate_adapter(adapter_id),把 GPU 槽位一起腾出来。GPU 层的淘汰则发生在 LRUCacheLoRAModelManager.activate_adapter:
if (lora_id not in self._active_adapters and len(self._active_adapters) >= self.lora_slots): self._active_adapters.remove_oldest()result = super().activate_adapter(lora_id)self._active_adapters.touch(lora_id)顺序值得注意:先淘汰再搬入。如果反过来先搬入,可能出现所有槽位都被占而新的 adapter 没地方放的瞬间。这个顺序在 max_loras=1 时尤其显眼:每次切换到不同 adapter,都要先淘汰旧槽、再清零并拷贝所有被替换层的张量——这也是 S-LoRA 论文强调「高频 adapter 应常驻、少量 adapter 才值得换入换出」的原因之一。
activate_adapter 外面包着 gpu_sync_allowed(),是有意的:这里的 H2D 拷贝、torch.zeros 之类是「一次性」动作,不在这步前向的内核时序里,所以允许隐式同步。而后续每步的元数据准备则尽量不触发同步(见下文 LoRAKernelMeta 里「把标量伪装成 CPU 张量」的技巧)。
权重装载:PEFT 配置、打包模块与按秩复制
PEFTHelper:认清 adapter 文件
_load_adapter 的第一步是读 adapter_config.json:
peft_helper = PEFTHelper.from_local_dir(lora_path, self.max_position_embeddings)peft_helper.validate_legal(self.lora_config)PEFTHelper 的字段基本是 PEFT 那套配置的子集:r、lora_alpha、target_modules,以及 use_rslora、use_dora 等。缩放因子在这里定死:
def _scaling(self, rank, alpha): if self.use_rslora: return alpha / math.sqrt(rank) return alpha / rankrsLoRA 把分母从 换成 ,这样大秩 adapter 的增量不会因为 反而变小。这个值最后作为 scale 参数传给 lora_shrink,在收缩这一步里乘上。
validate_legal 的职责是把「训练侧能做的事、推理侧做不到的事」提前拒掉。vLLM 明确不支持 DoRA、lora_bias、aLoRA、BD-LoRA、QALoRA、layer_replication,以及会改写基座权重的初始化(PiSSA、OLoRA、CorDA、LoftQ)——最后这一类失败方式很隐蔽:如果不管它,加载出来的 adapter 会少一部分「已经折进基座的那部分改动」。另外它会检查 max([r, *rank_pattern.values()]) 不超过 max_lora_rank。target_modules 可以在部署时用 LoRAConfig.target_modules 再收窄一次,只挂 ["o_proj", "qkv_proj"] 这类子集,从而在「质量」与「开销」之间取舍。
从 safetensors 到 LoRAModel
LoRAModel.from_local_checkpoint 支持 adapter_model.safetensors、adapter_model.bin、adapter_model.pt 三种文件。safetensors 走懒加载:
with safetensors.safe_open(lora_tensor_path, framework="pt") as f: check_unexpected_modules(f) for module in f.keys(): if moe_ep_spec is not None and _is_remote_expert_key(module, moe_ep_spec): continue # EP 场景下不读不属于本 rank 的专家 tensors[module] = f.get_tensor(module)check_unexpected_modules 的作用是早失败:如果 adapter 里出现了模型根本不支持的目标模块(拼写错误、训了别人的模型、PEFT 里写了不存在的 target_modules),这里会直接抛 ValueError,而不是被静默忽略掉一半权重。
from_lora_tensors 把名字拆成 <module>.<lora_A/lora_B>.weight:
module_name, is_lora_a = parse_fine_tuned_lora_name(tensor_name, weights_mapper)parse_fine_tuned_lora_name 会去掉 base_model.model. 前缀,并可选经过 WeightsMapper 的名字改写(例如多模态模型里 model. → language_model.model.)。一个 LoRAModel 的结构是:
class LoRAModel: id: int # = lora_int_id rank: int # PEFT 的 r loras: dict[str, LoRALayerWeights] # 模块名 → (lora_a, lora_b) modules_to_save: dict[str, LoRAFullModuleWeights] # 分类头等整模块 is_3d_lora_weight: boolLoRALayerWeights 持有该模块的 A、B 两个张量,以及 PEFT 的缩放;modules_to_save 只有在分类 / 打分任务里才非空,且同一份 adapter 最多支持一个整分类模块。
peft_helper.get_rank_and_scaling(module_name) 支持 rank_pattern / alpha_pattern:不同模块可以有不同秩和缩放。对 MoE adapter,PEFT 把融合专家的低秩参数存成 experts.base_layer 与 experts,匹配模式前要先改回参数名 gate_up_proj / down_proj 再去匹配。
打包模块:把一个线性层里的两个 LoRA 拼到一起
模型里 gate_proj 与 up_proj 在 vLLM 里通常合并成一个 MergedColumnParallelLinear(即 gate_up_proj)。adapter 文件里依然分别叫 gate_proj 与 up_proj。_create_merged_loras_inplace 把这些「packed 子模块」的 LoRA 打包:
for module_name, new_module_names in self.packed_modules.items(): replacement_loras = [self._get_lora_layer_weights(lora_model, r) for r in new_module_names] if module_name.endswith(".experts"): lora_model.loras[module_name] = PackedLoRALayerWeights.pack_moe(...) else: lora_model.loras[module_name] = PackedLoRALayerWeights.pack(replacement_loras) self._pop_lora_weights(lora_model, packed_module_names) # 删掉旧子模块条目打包之后,MergedColumnParallelLinearWithLoRA 上每个 slice 对应一个「子模块的 B」,n_slices = len(output_slices)。optimize() 会在这一步之后把 A 合并(若所有 slice 的 A 相同)或把 B 合并,以减少 kernel 调用次数——具体的合并条件由 LoRALayerWeights 的规约逻辑决定,目的是在「A 相同就共享一次收缩」和「B 相同就共享一次扩张」之间取更省的那条。
_pop_lora_weights 之后还会做一次 pin_memory,注释解释了顺序:MoE adapter 动辄几百个张量,如果加载时立刻逐个 pin,开销很大;而 pack_moe 会把张量重排成新的 packed 结构,pin 必须先做在最终结构上。
层替换:哪些层能挂 LoRA,挂上去以后长什么样
SupportsLoRA 与注册表
vLLM 不是「任意模块都能挂 LoRA」:模型类必须声明 SupportsLoRA,并往往给出 supported_lora_modules 与 packed_modules_mapping。get_supported_lora_modules 在模型实例上枚举所有 LinearBase 与 MoERunner,取它们的后缀名(如 q_proj)作为支持列表,同时收集 embedding_modules。
_create_lora_modules 遍历 model.named_modules(),对每个模块:
- 看后缀是否在
supported_lora_modules里; - 用
from_layer(module, lora_slots, lora_config, packed_modules_list)逐个尝试_all_lora_classes的can_replace_layer; - 命中就把子模块
setattr替换成一个BaseLayerWithLoRA子类实例; - 如果替换对象是
lm_head,额外包一层LogitsProcessorWithLoRA。
can_replace_layer 的匹配是按类做的,这决定了「这层在 TP 下怎么切」。例如 RowParallelLinearWithLoRA.can_replace_layer 要求 type(source_layer) is RowParallelLinear;ColumnParallelLinearWithLoRA 则同时接受 ColumnParallelLinear 与 MergedColumnParallelLinear(后者要求 packed 列表恰好一项)。fully_sharded 变体通过装饰器 _fully_sharded_can_replace / _not_fully_sharded_can_replace 与开关互斥。
还有两类特殊层值得提:Step5FusedQKVIndexerWithLoRA 与 Step5SparseIndexerWWithLoRA 出现在 layers/custom_layer.py 里,前者匹配 Step5FusedQKVIndexerLinear,把 Q、K、V 与 sparse indexer 的 7 个输出段一起切分;后者匹配 Step5SparseIndexerIndexTPLinear。这说明「可挂 LoRA 的模块」不只局限在 dense 投影上,连稀疏索引器这类定制层也可以有自己的 LoRA 切分规则。is_moe_model 发现 MoERunner 时会把对应层替换为 FusedMoEWithLoRA(或 FusedMoE3DWithLoRA),并在日志里提示「MoE 模型,使用融合 MoE LoRA」。
包装层的形态
所有 LoRA 包装层都继承 BaseLayerWithLoRA,核心接口就五个:
create_lora_weights(max_loras, lora_config, model_config) # 预分配堆叠缓冲reset_lora(index) # 槽位清零set_lora(index, lora_a, lora_b) # 写入一个槽位can_replace_layer(source_layer, ...) # 能否替换set_mapping(punica_wrapper) # 共享元数据包装器BaseLayerWithLoRA.__getattr__ 把公开属性转发到基座层,所以 layer.weight、layer.bias 这些代码路径在加上 LoRA 后仍然可用;私有属性(以 _ 开头)不转发,是为了避免框架内部簿记名字混淆。
BaseLinearLayerWithLoRA.create_lora_weights 是线性层缓冲的通用逻辑,按基座类型给出 A 的输出维和 B 的输出维:
if isinstance(self.base_layer, ReplicatedLinear): lora_a_out_size = lora_config.max_lora_rank lora_b_out_size = self.output_sizeelif isinstance(self.base_layer, ColumnParallelLinear): lora_a_out_size = max_lora_rank (or max_lora_rank // tp_size if fully_sharded) lora_b_out_size = self.output_size # 本 rank 上的列分片elif isinstance(self.base_layer, RowParallelLinear): lora_a_out_size = max_lora_rank lora_b_out_size = self.output_size (or output_size // tp_size if fully_sharded)然后:
self.lora_a_stacked = tuple(torch.zeros(max_loras, 1, lora_a_out_size, self.input_size, dtype=lora_dtype, device=...) for _ in range(n_slices))self.lora_b_stacked = tuple(torch.zeros(max_loras, 1, lora_b_out_size, max_lora_rank, dtype=lora_dtype, device=...) for _ in range(n_slices))第二个维度恒为 1,对线性层来说就是一个 adapter 一组矩阵;MoE 层会把它扩展到专家维。n_slices 决定了打包模块需要几组缓冲。
forward 的路径是:基座前向算出 output,然后用 punica_wrapper.add_lora_linear(output, x, lora_a_stacked, lora_b_stacked, 1.0, output_slices) 把低秩增量原地加进去:
def _apply_lora_to_output(self, x, output): if x.ndim == 3 and output.ndim == 3: # transformers 后端的 (1, seq, hidden) output = output.flatten(0, 1); x = x.flatten(0, 1) lora_output = self.punica_wrapper.add_lora_linear( output, x, self.lora_a_stacked, self.lora_b_stacked, 1.0, self.output_slices) if not current_platform.can_update_inplace(): output = lora_output return output这里 scale=1.0 而不是 ,是因为缩放早在加载阶段就被折进去了。LoRALayerWeights 先用 PEFT 的规则算出 scaling:
def __init__(self, module_name, rank, lora_alpha, lora_a, lora_b, scaling=None): ... self.scaling = self.lora_alpha / self.rank if scaling is None else scaling
def optimize(self): """Optimize the LoRA by merging the scaling into lora_b.""" if self.scaling == 1: return self self.lora_b *= self.scaling self.scaling = 1 return self_create_merged_loras_inplace 在打包之后对所有 LoRA 调一次 optimize(),把缩放乘进 B 并把 scaling 置 1。于是 kernel 只需要算 ,不再带一个可变标量——每个 adapter 的缩放可能不同(alpha_pattern),统一乘进 B 是最省事的做法。这也解释了为什么 kernel 侧偶尔还会出现 scaling 参数:那是双流路径与 lora_shrink 通用接口的保留,主路径上它恒为 1。_apply_lora_to_output 里「原地叠加」还是「返回新张量」的分支,是为了适配 XCCL 或 Ascend 这些不支持原地写回的平台。
max_loras=1 且没有 LoRA 时,这套包装层依然会执行 add_lora_linear,只是 token_lora_indices 全是 -1,内核会在 CTA 级提前返回。no_lora 标志与 no_lora 短路(见下文 no_lora_flag_cpu)把这种开销压到极低。
张量并行下的 LoRA:切 A 还是切 B
线性层的分片决定了 LoRA 因子的分片方式,可以用一张表概括:
| 基座层 | 该 rank 持有的 W 分片 | 默认 LoRA 分片 | fully_sharded_loras=True 时 |
|---|---|---|---|
ColumnParallelLinear | 按输出维切:W[o_start:o_end, :] | A 完整,B 按输出维切 | A 按秩维切一半,B 按输出维切 |
RowParallelLinear | 按输入维切:W[:, i_start:i_end] | A 按输入维切,B 完整 | A 按输入维切,B 再按输出维切 |
ReplicatedLinear | 完整 | 完整 | 完整 |
直观理解:前向算的是 。列并行里 按行切,所以 完整、 按行切、 完整,每个 rank 算出自己那一段输出,后面 all-gather;行并行里 按列切,所以 要先切成自己那段、 按列切、 完整,每个 rank 算出一个部分和,后面 all-reduce。LoRA 只额外多了一段 ,而 的乘积形状与 一致,因此分片规则自然一致。
默认方案
class RowParallelLinearWithLoRA(BaseLinearLayerWithLoRA): def slice_lora_a(self, lora_a): shard = self.input_size_per_partition return lora_a[:, self.tp_rank*shard:(self.tp_rank+1)*shard] def slice_lora_b(self, lora_b): return lora_bclass ColumnParallelLinearWithLoRA(BaseLinearLayerWithLoRA): def slice_lora_a(self, lora_a): return lora_a def slice_lora_b(self, lora_b): if self.is_merged_col_linear: # gate/up 这类二段融合层 ... else: start = self.tp_rank * self.output_size return lora_b[start:start + self.output_size, :]对二段融合层,B 的行按「left 子模块的前半块、right 子模块的前半块」交错切:先取 lora_b[rank×shard : (rank+1)×shard] 作为 left,再取 lora_b[offset + rank×shard : offset + (rank+1)×shard] 作为 right(offset = lora_b.shape[0] // 2),两段 cat 在一起。这样打包后每卡的 buffer 里,前半块属于 gate_proj、后半块属于 up_proj,与合并后的 gate_up_proj 基座布局同构。
打包层(gate_up_proj、qkv_proj)的切分更绕,因为 B 的行要按 packed 子模块的顺序交错切。MergedColumnParallelLinearWithLoRA.slice_lora_b 对两个子模块分别切片再拼接:
left_weight = lora_b[self.tp_rank*shard:(self.tp_rank+1)*shard, :]right_weight = lora_b[offset + self.tp_rank*shard: offset + (self.tp_rank+1)*shard, :]return torch.cat([left_weight, right_weight], dim=0)对 QKV 这种三段不等大小的 packed 线性层(qkv_proj 由 、、 三段组成),切片大小因段而异,n_slices = len(output_sizes),每一段单独处理。
S-LoRA 式:把秩也切开
默认方案里,每张卡上都存了一份完整的 (秩维 r)。如果秩很大、TP 也很大,A 的存储就重复了 TP 倍,而收缩这一步 的计算量也重复了 TP 倍。S-LoRA 提出沿秩维 r 再切,使 A 与 B 的存储都比较均匀,并配合在 all-reduce 前先把已经分片的部分和合并,从而把「LoRA 部分的反向通信」压小。vLLM 里对应 fully_sharded_loras=True,RowParallelLinearWithShardedLoRA 的实现是:
def apply(self, x, bias=None): output = self._get_quant_method().apply(self.base_layer, x, bias) buffer = torch.zeros((n_slices, x.shape[0], self.lora_a_stacked[0].shape[2]), dtype=torch.float32, ...) buffer = self.punica_wrapper.add_shrink(buffer, x, self.lora_a_stacked, 1.0) if self.tp_size > 1: buffer = tensor_model_parallel_all_reduce(buffer) # 秩维上的部分和先合并 offset = self.tp_rank * shard_of_b self.punica_wrapper.add_expand(output, buffer, self.lora_b_stacked, self.output_slices, offset_start=offset, add_input=True) return output它先做一次秩维的 all-reduce 把 各分片加起来,再把 乘上去,直接加到本行的部分和 output 的一个偏移段里。最终整个行并行的结果再做一次标准 all-reduce。S-LoRA 论文指出这样可以与 all-gather 融合,在较长序列、较高秩、较大 TP 的情况下收益明显,vLLM 的 LoRAConfig 注释也明确「高序列长度、高秩上限或大 TP 时大概率更快」。
列并行的全分片版本 ColumnParallelLinearWithShardedLoRA(_mcp_apply)路径类似,只是用 all_gather 把秩维分片拼回来:
buffer = torch.empty_strided((n_slices, x.shape[0], local_rank), ..., dtype=torch.float32)self.punica_wrapper.add_shrink(buffer, x, lora_a_stacked, 1.0)buffer = tensor_model_parallel_all_gather(buffer)self.punica_wrapper.add_expand(output, buffer, lora_b_stacked, output_slices, 0, True)注意这里的 empty_strided:注释提到在 torch.compile 下,秩为 1 的全分片路径有时会被降成非连续视图,而 shrink 核会原地写,所以必须保证标准的 [slice, token, rank] 连续 stride 契约。
Punica 路由:token 如何找到自己的 adapter
到了这一层,问题变成了:给定一个 token 数组和每 token 的槽位号,怎么让 kernel「按槽位分组」地做低秩乘。
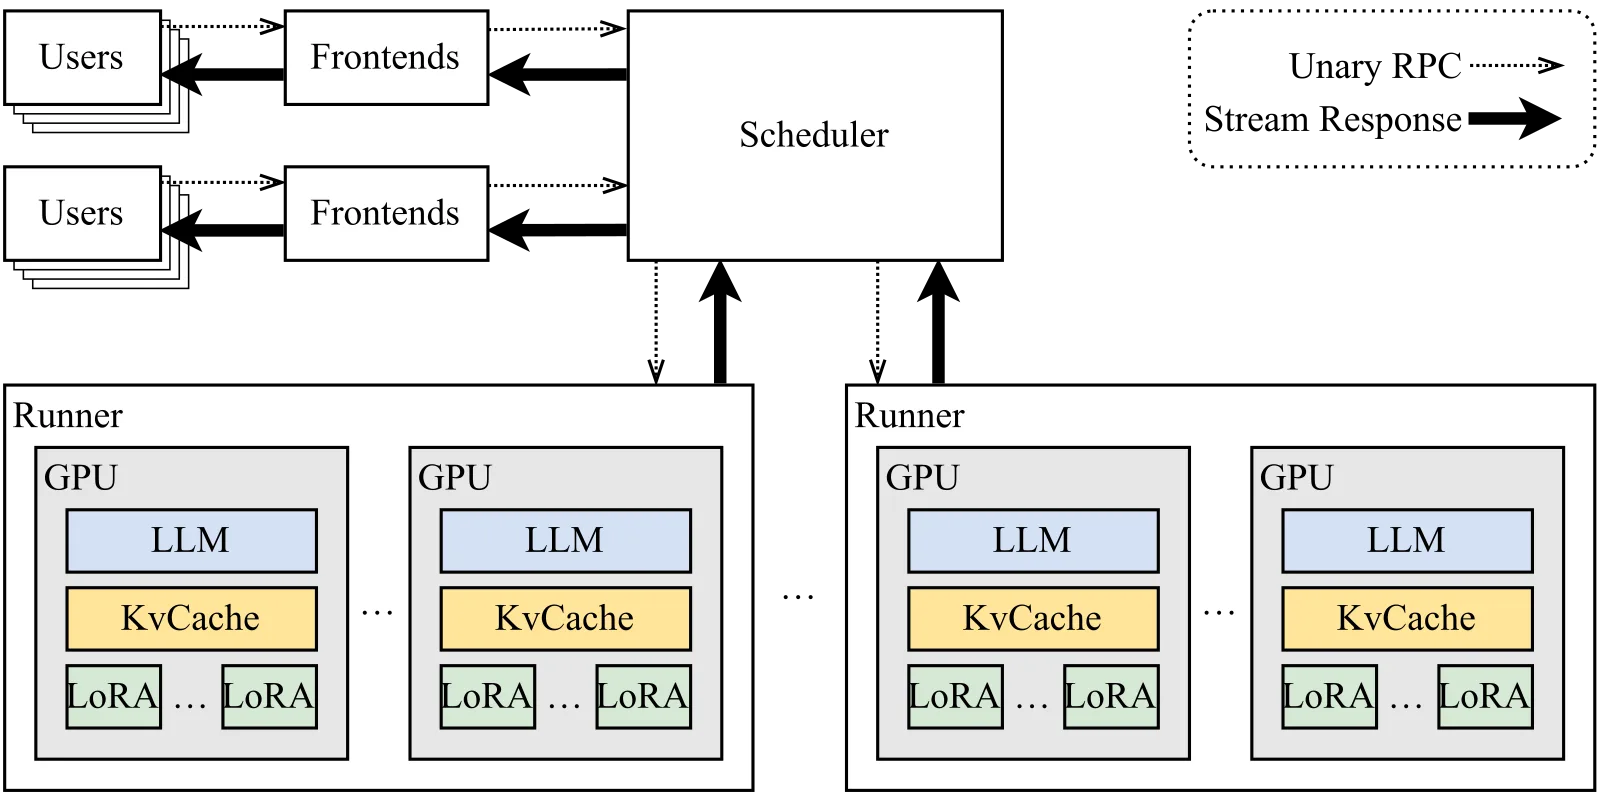
图 2:Punica 论文 Figure 2,系统架构。请求进入调度器后按 adapter 分组;每个 GPU 上只放一份基座和一份 KV Cache 池,adapter 权重作为「低秩增量」与基座分离存放,内核层通过统一的 batched 低秩算子把不同 adapter 的请求合并计算。图片来源:Punica 论文。
SGMV 的语义
Punica 的核心算子叫 SGMV(Segmented Gather Matrix-Vector multiplication),可以理解为「按段分组的矩阵-向量乘」:
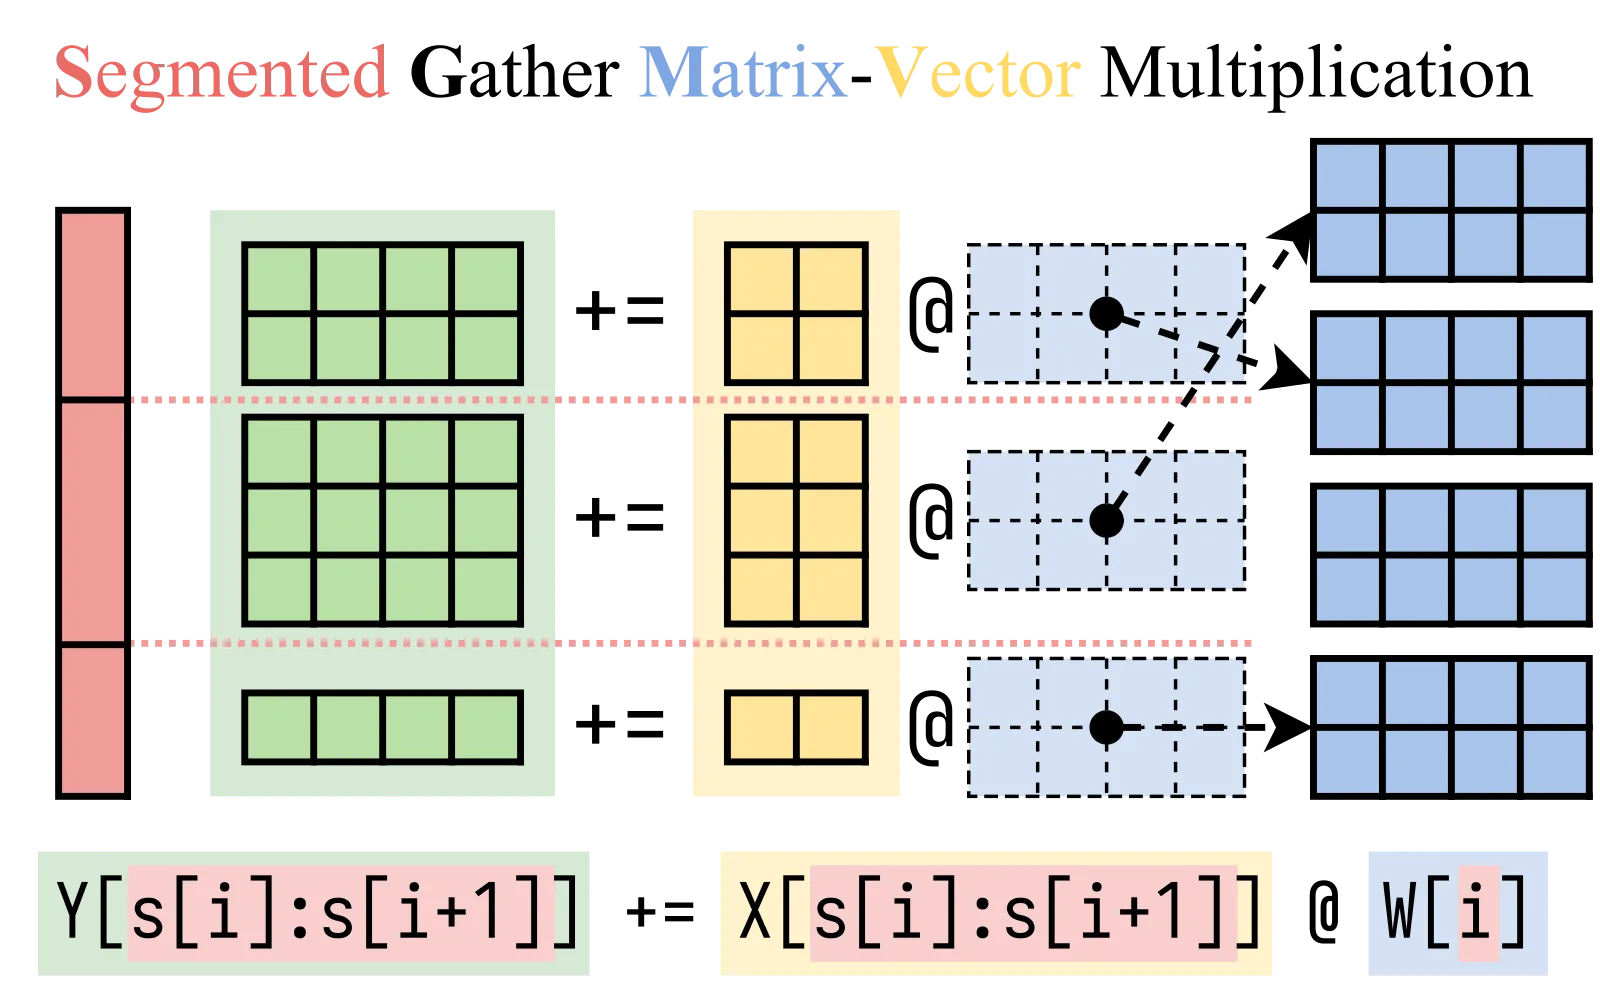
图 3:Punica 论文 Figure 3,SGMV 的语义。输入按 adapter 划分为若干段(segment),每段使用该 adapter 的权重做矩阵-向量乘,输出按原顺序写回。图片来源:Punica 论文。
在 decode 阶段,一批里每个请求一般只有 1 个 token,所以每段是「1 行 × r 维」的向量;在 prefill 阶段,每段可以有多行。vLLM 的 Triton 实现里,这个语义被拆成两步:shrink(每 token 行先乘自己的 A,把 hidden 压到秩 r)与 expand(把秩维结果乘自己的 B,扩回输出维并叠加到基座结果上)。
LoRAKernelMeta:先按槽位排序
内核要高效,第一步是把 token 按槽位排序,使得每段是连续的:
class LoRAKernelMeta: token_lora_mapping # int32[max_tokens], 原顺序的槽位号 token_indices_sorted_by_lora_ids # int32[max_tokens], 排序后每段的原行号 active_lora_ids # int32[max_loras + 1] num_tokens_per_lora # int32[max_loras + 1] lora_token_start_loc # int32[max_loras + 2], 累加和, 首元素恒 0 no_lora_flag_cpu # bool[1], CPU tensor num_active_loras_cpu # int32[1], CPU tensorprepare_tensors 每步做四件事:
no_lora = torch.all(token_lora_mapping == -1)self.no_lora_flag_cpu[0] = no_loraif no_lora: return_, idx_sorted = torch.sort(token_lora_mapping, stable=True) # 按槽位排序, 稳定排序lora_ids, num_tokens_per_lora = torch.unique(token_lora_mapping, sorted=True, return_counts=True)lora_token_start_loc = torch.cumsum(num_tokens_per_lora, dim=0)排序用的是稳定排序,这一点很重要:同一 adapter 的 token 保持它们在原 batch 中的相对顺序,回写的时候依赖这一点。+1 是因为可能有一个「无 LoRA」的段(槽位号 -1),num_tokens_per_lora 用 max_loras + 1 个位置来容纳它;lora_token_start_loc 多留一位,[0] 恒为 0,这样段 的行号范围是 [start_loc[i], start_loc[i] + num_tokens_per_lora[i])。
一个运行例子(论文中的例子)如果 max_loras = 3,active_lora_ids 可能是 [-1, 0, 2, 1],对应每段 token 数 [3, 10, 5, 2],则 lora_token_start_loc 为 [0, 3, 13, 18, 20]。
为什么用「CPU 张量」装标量
no_lora_flag_cpu 与 num_active_loras_cpu 被刻意做成 CPU 上的 1 元素张量,而不是 Python int。注释解释了原因:
- V1 用
torch.compile追踪前向图时,Python 标量会被当作常量写死进图; - 追踪不支持动态控制流;
- 但
torch.ops函数内部不被追踪。
把这几个标志伪装成 CPU tensor 放进 custom op 的参数里,就可以在 op 内部用 .item() 读出来做分支,而图层面把它当普通输入,不需要「为了一个 int 重编译一张图」。num_active_loras 在 specialize_active_lora=False 时恒为 max_loras + 1,保证 kernel grid 形状稳定、CUDA Graph 可复用;specialize_active_lora=True 时用真实的活跃 adapter 数并向上取整到「已捕获的 LoRA 数」列表中的一档,为不同活跃数分别捕获图。
调用链
PunicaWrapperGPU.update_metadata 拿到 LoRAMapping 后调用 convert_mapping,把请求级 id 转成槽位号:
lora_id_to_index = {lora_id: i for i, lora_id in enumerate(lora_index_to_id) if lora_id is not None}lora_indices = [lora_id_to_index[x] if x > 0 else -1 for x in mapping.index_mapping]embedding_indices = [idx if x > 0 else 0 for x, idx in zip(index_mapping, lora_indices)]embeddings_indices = indices[2] * vocab_size # 行偏移, 供 embedding 查表sampler_indices = prompt_mapping → 槽位sampler_indices_padded = where(-1, max_loras-1) * len + arange # 扁平下标, 供 logits 收集这里同时维护了四个索引数组:token_lora_indices(线性层用)、sampler_indices(采样 / logits)、sampler_indices_padded(把 -1 替换成最大槽位并对齐,方便 logits 一次 gather)、embeddings_indices(embedding 表查表的行起点)。convert_mapping 原本用 list.index() 逐个查找,现在先建 lora_id_to_index 字典,把每步 O(adapter 数 × token 数) 的查找降成 O(1)。
之后 add_lora_linear 走标准两步:
r = lora_b_stacked[0].size(-1)buffer = torch.empty((len(output_slices), x.size(0), r), dtype=torch.float32, device=x.device)self.add_shrink(buffer, x, lora_a_stacked, scale)self.add_expand(y, buffer, lora_b_stacked, output_slices, add_inputs=add_inputs)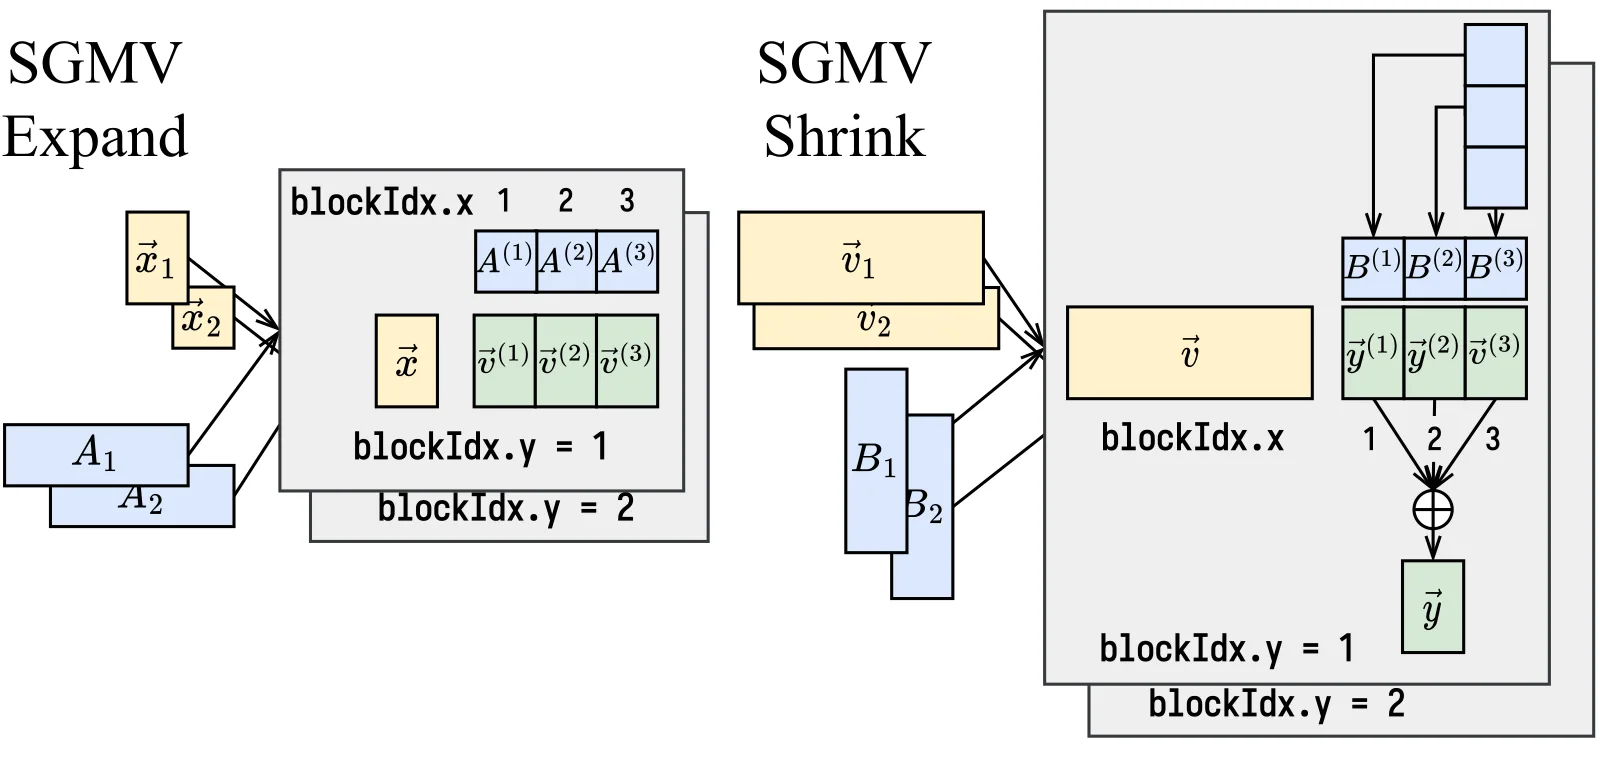
图 4:Punica 论文 Figure 4,expand / shrink 内核的调度。两类核都按 adapter 分段、按 (slice, CTA) 分块,段内连续的行由同一组 CTA 处理。图片来源:Punica 论文。
两个低秩 GEMM:shrink、expand 与 fp32 中转缓冲
为什么用 fp32 中转
buffer 的 dtype 是 torch.float32,与基座的 BF16 不同。原因在注释里给出:Triton 在 BF16 上做 的两段乘法时,若中间结果也用 BF16,会累积较大的舍入误差。中转用 fp32 可以把「收缩」结果保留较高精度的尾数,在「扩张」再一次性转回 BF16。代价是 buffer 的大小是 n_slices × num_tokens × r 个 fp32,对 64 秩、8192 token、2 个 slice 来说约 4MB,可忽略。这在另一个方向也有意义:对于 batch-invariant 推理,中转 buffer 的布局固定,可以让不同 batch 下收缩的 K 维拆分方式保持一致(vLLM 的 _BI_SPLIT_K = 8 就服务于这个目的)。
shrink 核
@triton.jitdef _lora_shrink_kernel(input_ptr, lora_ptr, out_ptr, M, N, K, token_indices_sorted_by_lora_ids, num_tokens_per_lora, lora_token_start_loc, lora_ids, scaling, ...): pid_sk_m_n = tl.program_id(axis=0) slice_id = tl.program_id(axis=1) lora_idx = tl.program_id(axis=2) lora_id = tl.load(lora_ids + lora_idx) if lora_id == -1: return # 无 LoRA 段直接退出 lora_m_size = tl.load(num_tokens_per_lora + lora_idx) cta_m_offset = pid_m * BLOCK_M if cta_m_offset >= lora_m_size: return # 超出本段行数, 空 CTA 提前退出 cta_lora_seq_indices = (token_indices_sorted_by_lora_ids + tl.load(lora_token_start_loc + lora_idx) + cta_m_offset) offset_m = tl.arange(0, BLOCK_M) % cta_m_len ram = tl.load(cta_lora_seq_indices + offset_m) # 本 CTA 负责的原行号grid 形如 (SPLIT_K × ceil(M/BLOCK_M) × ceil(N/BLOCK_N), NUM_SLICES, num_active_loras)。三个轴分别对应:token 的行列分块(含 split-K)、打包子模块的 slice、adapter 段。核里在 do_shrink_kernel 里用 ram 做 gather:
a_ptr = input_ptr + ram[:, None].to(tl.int64) * input_d0_stride + offset_k[None, :] * input_d1_strideb_ptr = cur_lora_ptr + lora_d0_stride * lora_index + rbn[None, :] * lora_d1_stride + offset_k[:, None] * lora_d2_stride注意 ram 转 int64 的注释:长上下文下 token 数过大时,int32 乘 stride 会溢出。这是这类「多段 gather GEMM」内核必须注意的细节。
因为段长不固定,CTA 末尾会把不足 BLOCK_M 的行通过 % cta_m_len 复用,再由 mask 丢弃,避免越界。GRID 公式注释也直言:「这个 grid 在并行度上最大化,但很多 token 不需要 LoRA 时会浪费 CTA」——例如一批 32 个 token,只有 4 个走 LoRA,则 7/8 的 CTA 是空转的。这就是为什么 specialize_active_lora 对「少量活跃 adapter、大量无 LoRA 请求」的场景有价值。
USE_GDC(launch_pdl)只在「双流」时开启(VLLM_LORA_ENABLE_DUAL_STREAM):shrink 核的下游是 expand 核,PDL(programmatic dependent launch)允许 expand 在 shrink 还差最后一小块时提前启动,掩盖 launch 延迟。
expand 核
@triton.jitdef _lora_expand_kernel(...): pid_mn = tl.program_id(axis=0); slice_id = tl.program_id(axis=1); lora_idx = tl.program_id(axis=2) lora_id = tl.load(lora_ids + lora_idx) if lora_id == -1: return if pid_m * BLOCK_M >= lora_m_size: return # 空 CTA curr_N = N if SAME_STRIDE else tl.load(output_hs_ptr + slice_id) # QKV 各段宽度不同 if pid_n * BLOCK_N >= curr_N: return ... do_expand_kernel(..., slice_start_loc, ..., ADD_INPUTS, out_ptr, ...)expand 与 shrink 的差别在于输出维:output_tensor 是基座前向的结果,expand 要把「槽位对应的 B @ buffer」加进 output 的某个切片 [offset_start, offset_start + output_slices[slice_id])。SAME_STRIDE 是一个常量分支:当所有 slice 的输出宽度一致(如 gate/up 两个相同大小的子模块)时,直接 curr_N = N;当不一致时(如 qkv_proj 的 Q、K、V 段),用 output_hs_ptr 读每段宽度。核里对每一段单独做一次「行 gather + 乘 + 累加到输出行」,ADD_INPUTS=False 时只写出 LoRA 结果(双流路径用,之后在主机侧 output.add_(lora_result))。
双流:让 LoRA 与基座前向并行
VLLM_LORA_ENABLE_DUAL_STREAM 时,每个包装层有两个 CUDA 流和一对事件:
def _apply_async_impl(self, x, bias=None): def base_fn(): return self._get_quant_method().apply(self.base_layer, x, bias) def lora_fn(): lora_output = torch.zeros((num_tokens, output_size), device=..., dtype=x.dtype) self.punica_wrapper.add_lora_linear(lora_output, x_2d, ..., 1.0, output_slices, add_inputs=False) return lora_output output, lora_result = maybe_execute_in_parallel(base_fn, lora_fn, self._events[0], self._events[1], self._lora_stream) output.add_(lora_result) return outputlora_fn 里输出必须用 torch.zeros 而不是 empty:注释解释得很清楚——当 lora_id == -1(没有活跃 adapter)时 expand 核会提前退出、不写任何东西,若是 empty 再加到 output 上就会把基座结果污染成随机值。这种「依赖 kernel 会写满输出」的假设在双流模式下不成立,所以这里显式清零。
双流并不总是有收益:基座 GEMM 本身已经打满 Tensor Core 时,LoRA 核只能抢到 SM 间隙,收益有限;在低 batch 的 decode 阶段基座 GEMM 是内存受限的,LoRA 核也是内存受限的,两者并行反而会争带宽。因此这个特性是环境变量开关,而不是默认。
输出侧:embedding、lm_head、logits 与分类头
输出侧的三类模块——词表查表(embedding)、词表投影(lm_head / logits)、分类头(classifier / score)——与中间的 Linear 层有本质差别:它们的「输出维」要么是词表大小,要么由任务决定,与 hidden 维不构成对称的 结构。因此 LoRA 在这里的形状、路由侧用哪套索引、乃至是否需要「整模块替换」都与前文不同。
embedding 的 LoRA 是一个查表增量
VocabParallelEmbeddingWithLoRA 的实现走的是另一条路:embedding 的「基座权重」本身就是词表 × hidden 的矩阵,LoRA 在这里退化为「一个整行偏移」:
self.lora_a_stacked = torch.zeros((max_loras, org_vocab_size, max_lora_rank), ...)self.lora_b_stacked = torch.zeros((max_loras, 1, embedding_dim, max_lora_rank), ...)self.lora_a_stacked_2d = self.lora_a_stacked.view(max_loras * org_vocab_size, max_lora_rank)forward 时用 embeddings_indices = self.punica_wrapper._embeddings_indices[:num_tokens] 计算「本 token 对应槽位的行偏移」:
full_lora_a_embeddings = F.embedding(x + embeddings_indices, lora_a_stacked_2d)也就是说,真实查表的行是「token id + adapter 槽位 × 词表大小」,这样所有 adapter 的 A 矩阵是连续布局中的一段段,一个普通 F.embedding 就能同时查多个 adapter。注释说 lora_a_stacked 是行主序、PEFT 文件是列主序,所以 set_lora 里要转置写入。之后一次 expand 把 维向量扩回 hidden,add_lora_embedding 只做这段增量。
这带来的成本很直观:max_loras × vocab_size × r 个权重只为了「词表大小的偏置」。76800 词表、r=16、max_loras=8 也就 2.5M 个元素,几 MB 的 BF16,不是瓶颈;但当 max_loras 调大、embedding 也训了时,这部分显存要计入预算。
lm_head / logits
lm_head 与 embedding 很像:输出维是词表。区别在于前向的最后一步通常只对「采样行」做 lm_head。LogitsProcessorWithLoRA 是单独一层,add_lora_logits 用 prompt_mapping_meta(而不是 token 映射)来按「本步要采样的行」选 adapter:
buffer = torch.empty((x.size(0), r), dtype=torch.float32, device=...)lora_shrink(x, [lora_a_stacked], buffer.unsqueeze(0), *prompt_mapping_meta.meta_args(...))lora_expand(buffer.unsqueeze(0), [lora_b_stacked], y, *prompt_mapping_meta.meta_args(...))这就是为什么 convert_mapping 里会同时生成 sampler_indices 与 sampler_indices_padded:在 prefill 时只有每个请求的最后一行参与采样,在解码时每个请求一行,长度可能远小于 token 总数;用单独的采样侧映射可以让 lm_head 的 LoRA 开销只与「本步采样行数」成正比而不是 token 数。
分类头:modules_to_save
modules_to_save=["classifier"] 的 adapter 不只是低秩增量,而是要整模块替换基座分类头的权重。这在 reranker / 打分模型里很常见:分类头的输出维度往往与 adapter 的任务相关(例如不同的标签数)。vLLM 的做法是把这些权重复制到每个槽位里,前向时按槽位选出对应那份全量权重:
def _select_full_linear_output(self, y, adapter_y, bias_stacked, module_enabled): indices = self.sampler_indices safe = indices.clamp_min(0) use_full = (indices >= 0) & module_enabled[safe] adapter_y = adapter_y.to(y.dtype) + bias_stacked[safe].to(y.dtype) return torch.where(use_full.unsqueeze(-1), adapter_y, y)apply_lora_full_linear 把「每个槽位一整份分类头」当作堆叠的「全量线性权重」处理,用 shrink 核做一次批量计算,然后按行选出对应槽位的结果。max_lora_cls_labels 是给「不同标签数的分类头」准备的容量上限。分类头的 LoRA 只在 is_pooling_model 时启用,且 PEFTHelper._validate_features 明确限制 modules_to_save 只能是 classifier 或 score。
MoE 的 LoRA:按专家挂载、融合 kernel 与 EP 切片
MoE 模型的 LoRA 是这一篇最复杂的一块。在 dense 模型里,一个线性层的 LoRA 就是一组 /;在 MoE 里,每个专家都有一套自己的 、、,所以 adapter 文件里会出现 experts.<i>.gate_proj.lora_A.weight 这样的键,每份 adapter 要对本 rank 每个本地专家各存一组低秩矩阵。
缓冲布局
FusedMoEWithLoRA 的四组缓冲:
w13_lora_a_stacked: tuple[Tensor, ...] # shape (max_loras, E_local, max_rank, hidden), 每个 w13 slice 一份w2_lora_a_stacked: (Tensor,) # shape (max_loras, E_local, max_rank, inter_per_part)w13_lora_b_stacked: tuple[Tensor, ...] # shape (max_loras, E_local, inter_per_part, max_rank)w2_lora_b_stacked: (Tensor,) # shape (max_loras, E_local, hidden, max_rank)_w13_slices = 2 if is_act_and_mul else 1:门控 MoE 有 gate_proj(w1)与 up_proj(w3)两个并行的专家投影,非门控只有 up_proj。n_slices = E_local × (w13_slices + 1),即每个专家三个(或两个)矩阵。
内存量级值得算一下:以 DeepSeek-V3 风格模型为例,hidden 7168、专家中间维 2048、总专家数 256、8 路 EP 下每 rank 本地专家 32 个、秩 64、max_loras=4。每个本地专家要存 w1/w3 的 A(各 )、w2 的 A()、w1/w3 的 B(各 )、w2 的 B(),合计 个元素;乘以 32 个专家、4 个槽位,约 个元素,BF16 下约 454MB。若不开 EP、每 rank 见全部 256 个专家,同一配置约 3.6GB。这个数说明为什么 MoE LoRA 对 max_loras 与 EP 规模都非常敏感,也说明为什么 vLLM 引入了「共享 A/B」等压缩手段。
enable_moe_shared_loras
当 enable_moe_shared_loras=True 时,w13 的 A 与 w2 的 B 只存一份(专家维塌缩为 1),_w13_a_num_experts 与 _w2_b_num_experts 返回 1。注释解释了原因:某些 adapter 结构里,所有专家共享 gate/up 的 A 与 down 的 B,只让另一半因子因专家而异;此时为每个专家复制同一份 A 纯属浪费。核函数侧会通过 _match_expert_dim 把源张量对齐到缓冲的专家维(src[:1]),核里再用广播读取。按上面的算式,共享布局把每个槽位、每个专家的 w13 A()与 w2 B()折叠成各一份:单槽位从 个元素降到 ,约为原来的 25%,省下约 75%。专家数越多、且 adapter 确实共享因子时,节省越可观;反之若 adapter 的每个专家因子都不同,这个开关不能开。
3D 与 2D 两种磁盘格式
PEFT 对「专家参数」有两种存法:
- 2D 切分:每个专家单独存
gate_proj、up_proj、down_proj的 A/B; - 3D 融合:训练时把整个
gate_up_proj(形状 )与down_proj()作为单个参数,LoRA 直接挂在这个融合参数上,文件里是一份 ()与一份 (),以及一个专家维。
is_3d_moe_weight 标记模型侧使用 3D 权重;LoRARequest.is_3d_lora_weight 标记 adapter 侧是 3D 格式。两者都 3D 时用 FusedMoE3DWithLoRA,两者都 2D 时用 FusedMoEWithLoRA。混用时用 enable_mixed_moe_lora_format:统一走 2D 包装器,3D adapter 通过 _convert_3d_to_2d_moe_lora 拆成 w1/w3/w2 三组,2D adapter 不需要转换。这个开关存在的理由是同一个部署里可能同时有历史 2D adapter 与新训 3D adapter,运维上不希望因此部署两套集群。
融合计算:add_lora_w13 与 add_lora_w2
MoE 的 LoRA 不能简单地「在原输出上叠一次」,因为专家的中间结果要先过激活函数(SiLU/GELU)��再乘 w2。所以 LoRA 必须在w13 之后、激活之前应用一次,在 w2 之后、moe_sum(按 top-k 加权求和)之前再应用一次:
add_lora_w13(y=intermediate_cache1, x=x, ...) # 加在 gate/up 输出上, 在 act 前... activation ...add_lora_w2(y=intermediate_cache3, x=intermediate_cache2, ...) # 加在 down 输出上, 在 moe_sum 前并且因为 MoE 的 token 在物理上按「专家 × 块」排布(sorted_token_ids、expert_ids、num_tokens_post_padded),LoRA 核要在同一套专家排布上工作。add_lora_fused_moe 让两种排布一致:moe_lora_align_block_size 用 CUDA 核一次性按「(adapter, 专家)」重组 token 块:
ops.moe_lora_align_block_size(topk_ids, token_lora_mapping, kernel_num_experts, block_size, max_loras, max_num_tokens_padded, max_num_m_blocks, sorted_ids, expert_ids, num_tokens_post_pad, adapter_enabled, lora_ids, expert_map)expert_ids 初始化为 -1,这样未使用的 (adapter, 专家) 槽位不会把核误导到错误的桶里;expert_map 在 EP 下把全局专家 id 翻成本地专家 id,使输出桶按本地专家编号。add_lora_w13 返回它生成的 sorted_token_ids_lora、expert_ids_lora、num_tokens_post_padded_lora,add_lora_w2 复用这些排布,避免二次重组。
moe_backend 必须支持 LoRA:未量化时选 triton 或 auto(auto 在启用 LoRA 时会选 Triton),量化时对应分专家类要 mixin LoRAExpertsMixin 并消费 _lora_context。__init__ 里还有一条断言:不支持 monolithic kernel,因为 monolithic 会把基座与增量在同一核里写完,LoRA 的独立增量核就无处插入了。
EP 下只装载本地专家的权重
在专家并行下,本 rank 只持有 local_num_experts 个专家。MoEEPLoadSpec 让 loader 在读盘阶段就跳过非本地专家的 key:
local_start = spec.ep_rank * spec.local_num_expertsreturn not (local_start <= expert_idx < local_start + spec.local_num_experts)对 .safetensors 可以直接不调用 get_tensor,省 CPU 内存与 IO;对 .bin/.pt 只能先整份 torch.load,但在 dtype 转换与 pin 之前先 prune 字典,仍然避免后续开销。这一步在 MoE adapter 动辄 GB 级时非常关键。
_slice_moe_lora_ep 在 add 阶段把缓存里的权重裁到 [local_start, local_end)。_slice_w13_a 与 _slice_w2_b 在 fully_sharded 下还按秩维再切,_slice_w13_b、_slice_w2_a 按中间维切。这些切法与 dense 的列 / 行并行规则一致,只是维度换成了「专家中间维」。
一条硬约束:FusedMoE LoRA 不支持 EP + fully_sharded_loras 同时开。原因在注释里:EP 在秩组的「专家维」上切,fully_sharded 在同一个 TP 组上切「秩维」,两者对「哪个 rank 持有哪个专家的哪一秩分片」的假设互相矛盾。工程上只能二选一。
服务闭环:调度、增删、淘汰与 CUDA Graph
把上面的组件串起来,一次前向里 LoRA 的调用顺序大致是:
Scheduler 选出本步请求 → InputBatch.make_lora_inputs: 请求级映射 → token/prompt 级映射 → WorkerLoRAManager.set_active_adapters: _apply_adapters: 确保本步 adapter 都注册, 不在 GPU 的搬进来 _adapter_manager.set_adapter_mapping(lora_mapping) (mapping 或槽位布局变化时才真正 update_metadata) → PunicaWrapperGPU.update_metadata: convert_mapping → token_lora_indices / sampler_indices / embeddings_indices LoRAKernelMeta.prepare_tensors → 排序、分段、no_lora 标志 → 模型前向: 每层 base_apply + add_lora_linear(双流时另起 aux stream) → 采样: LogitsProcessorWithLoRA.add_lora_logits(仅采样行)set_adapter_mapping 的短路
def set_adapter_mapping(self, mapping): slot_layout = tuple(self.lora_index_to_id) if self._last_mapping != mapping or self._last_slot_layout != slot_layout: self._set_adapter_mapping(mapping) self._last_mapping = mapping self._last_slot_layout = slot_layout两个条件缺一不可。只比较 mapping 不够:out-of-band 的 add_lora() 可能在 batch 不变的情况下触发 LRU 淘汰、重排槽位;只比较槽位布局也不够:同样的槽位布局,不同的 token 顺序仍要重新排序。这个短路的意义在 decode 场景:连续解码时,一批请求的 token_lora_mapping 往往是「一堆 1 长度的 [id, id, …]」,若请求集合不变,mapping 也几乎不变,此时可以省掉一次 CPU 端的排序与元数据上传。
请求的移除与统计
InputBatch.remove_request 里维护了「每个 adapter 有多少个在途请求」:
lora_id = self.request_lora_mapping[req_index]if lora_id != 0: lora_req_ids = self.lora_id_to_request_ids[lora_id] lora_req_ids.discard(req_id) if not lora_req_ids: del self.lora_id_to_request_ids[lora_id] del self.lora_id_to_lora_request[lora_id] self.request_lora_mapping[req_index] = 0这样下一次 make_lora_inputs 只会把「还有在途请求的 adapter」送进 lora_requests 集合。adapter 一旦不再被任何请求使用,就自然地从「本步活跃集合」里消失,可以被 LRU 挤出 GPU。这是多 LoRA 服务「按需驻留」的自动回收机制:没有一个显式的「卸载」动作,只有 LRU 的使用痕迹。
InputBatch.swap_states 在重排 batch 行时也同步交换了 request_lora_mapping,否则行号错位会把 A 的 token 算成 B 的增量。
一个完整的走查:两步 decode 里发生了什么
把上面的组件按时间轴串一遍。假设 max_loras = 2,两槽位分别装了 adapter 1(槽 0)与 adapter 2(槽 1);本步有三个请求:R1(adapter 1)、R2(无 LoRA)、R3(adapter 1)。每个请求本步解码一个 token,num_scheduled_tokens = [1, 1, 1],batch 里 token 顺序是 [R1, R2, R3]。
第一步,request_lora_mapping[:3] = [1, 0, 1],make_lora_inputs 广播后得到 token_lora_mapping = (1, 0, 1);sampler_indices 同样长度 3,值 (1, -1, 1)。
第二步,_set_active_loras 里 _apply_adapters 只看到 {adapter 1}——adapter 2 本步没有请求用,但它在 GPU 槽 1 上仍然驻留,只是不会被本步激活,也不会被本步淘汰(_active_adapters 的 LRU 只在需要腾槽时才会淘汰)。
第三步,convert_mapping 把 id 转槽位:token_lora_indices = (0, -1, 0)。LoRAKernelMeta.prepare_tensors 稳定排序后得到 lora_ids = (-1, 0)、num_tokens_per_lora = (1, 2)、token_indices_sorted_by_lora_ids = (1, 0, 2)、lora_token_start_loc = (0, 1, 3)。注意这里无 LoRA 段被稳定排序排到了最前(-1 先于 0),于是 kernel 的第三维只启动 2 个 segment,无 LoRA 的那段在核里 lora_id == -1 立刻返回。
第四步,每层调用 add_lora_linear:buffer 形如 (n_slices, 3, r) fp32;shrink 的 grid 是 (SPLIT_K × ceil(3/BLOCK_M) × ceil(r/BLOCK_N), n_slices, 2);expand 把结果加回基座输出对应切片。
第五步,LogitsProcessorWithLoRA 用 prompt_mapping_meta——sampler_indices = (0, -1, 0)——算每行的 lm_head 增量;无 LoRA 行得到 0 增量。
第六步,采样出新 token,追加到各请求的输出,下一轮调度时 R3 完成、R1 继续、R2 继续;R1/R3 的 request_lora_mapping 不变,R2 恒为 0。整个过程中没有任何一步需要「把整模型切到 adapter 1」——切换粒度是层内的堆叠槽位,这正是 Punica「共享基座」的工程含义。
LoRA 让 CUDA Graph 变得更复杂,原因有三:
- kernel grid 依赖活跃 adapter 数:shrink / expand 的 grid 第三维是
num_active_loras。若不固定,每个不同的活跃数都要一张图; torch.compile对 int 的控制流:用 CPU tensor 伪装的标志解决了「在 op 里读标量」的问题,但specialize_active_lora的向上取整逻辑还需要把实际活跃数对齐到已经捕获的档位;- 输入缓冲的原地更新:capture 时的 token mapping 需要用真实的「已加载 adapter」做 dummy run。
LoRAModelRunnerMixin 的 maybe_setup_dummy_loras / maybe_select_dummy_loras 专门处理第 3 点:
lora_warmup_rank = max_lora_rank if max_lora_rank < 8 else 8lora_warmup_rank = self.lora_manager.get_dummy_lora_warmup_rank(lora_warmup_rank)lora_requests = {LoRARequest(lora_name=f"warmup_{id}", lora_int_id=id, lora_path="/not/a/real/path") for id in range(1, num_loras + 1)}for lr in lora_requests: self.lora_manager.add_dummy_lora(lr, rank=lora_warmup_rank)add_dummy_lora 不走读盘路径,create_dummy_lora 按各层的形状直接生成零张量(或按 max_loras 分配的随机填充),这样捕获阶段可以拿到「有 adapter 参与」的真实 shape。warmup 秩被限制在 8:max_lora_rank ≤ 8 时用满秩,否则用 8,是一个「足够触发真实 kernel 行为、又不至于让 dummy 权重过大」的经验值。MoE 模型的 get_dummy_lora_warmup_rank 还会调 max_loras + 1(可能包含无 LoRA 段)与 ep 对齐。
maybe_select_dummy_loras 里的映射构造会刻意制造「最坏情况」:把 adapter 循环分配到请求上,并在需要时加入 -1 行,使得 prepare_tensors 看到的活跃数与图捕获时的 key 一致。
一个实战上的推论:不要频繁改变 max_loras 与 specialize_active_lora。max_loras 影响所有层的缓冲形状,改一次就得重新捕获所有图;specialize_active_lora=True 会按活跃数的 2 的幂次捕获多张图,启动耗时与显存都明显增加,只有「活跃数长期分布在 1、2、4」这类稀疏模式时才值得。
成本与边界:什么时候多 LoRA 不划算
显存
每层每个槽位的缓冲量约为 个元素。一个 Llama-7B 规模模型(hidden 4096、FFN 11008),7 个线性投影 q/k/v/o/gate/up/down 全部训了 LoRA 时,单 adapter、r=16 约为 元素、BF16 下约 2.5MB。max_loras=16 时,所有层加在一起约 40MB。embedding 与 lm_head 训了时另加 字节 ≈ 39MB(若两者都训)。对 7B 模型和 80GB 卡来说,这些是小数;对 400B+ 的 MoE,max_loras 要更保守,甚至启用 enable_moe_shared_loras、只给部分模块挂 LoRA。
延迟
论文报告「每个 token 多 2ms」。在 vLLM 里,单层 LoRA 的开销来自两个额外 kernel 的 launch 与访存:shrink 读 x(hidden × tokens)与 A;expand 读 buffer 与 B 并写回 output。decode 阶段每个 token 都要扫一遍所有层的 adapter 权重,在 max_loras=1 时相当于每层多一个约 的访问,占基座 的比例约为 (取 ),r=16、d=4096 时约 0.8%。这说明在单 adapter 的情况下,LoRA 的延迟代价几乎可以忽略。
真正的代价来自多 adapter:max_loras 越大,GPU 上占的显存越多,LRU 切换越频繁;活跃 adapter 越多,grid 第三维越大,CTA 越多,调度与尾部效应越明显;max_loras 大且请求分散时,no_lora 的 token 空转 CTA 越多。这也是 specialize_active_lora、双流、共享因子等优化存在的原因。
适配器的「人格」隔离
LoRA 的数学性质决定了同一批里不同 adapter 的 KV Cache 不能混用,但 vLLM 的 KV Cache 是按 token 存的,每个 token 的 KV 只由它自己那一步前向的「实际权重」决定。因此只要在写 KV 之前已经正确应用了对应 adapter,就可以把不同 adapter 的 KV 放进同一个池。这一点在多 LoRA 场景下有一个隐含要求:同一个请求在各步之间不能切换 adapter。LoRARequest 是随请求固定的,调度器也不会在步间改它的 lora_int_id,所以这个不变式自然成立。请求取消、抢占后重新计算时,request_lora_mapping 仍然有效。
反过来,前缀缓存(RadixCache)在多 LoRA 下需要额外注意:两个请求即使前缀 token 相同,如果挂的 adapter 不同,KV 是不同的。因此前缀哈希必须把 adapter id 纳入 key。vLLM 的 generate_block_hash_extra_keys 会把 ("lora", lora_name, lora_path) 作为 extra key 纳入 block hash;adapter path 也参与,避免「同名 adapter 被重指向到不同文件」后复用旧 KV。BlockPool 的 block 事件里同样携带 lora_id 与 lora_name。这一点也解释了为什么多 LoRA 部署开启前缀缓存后命中率会比单 LoRA 低:同一份系统提示在不同 adapter 之间不共享。
与投机解码、量化、P/D 分离的交互
- 投机解码:
LoRAConfig.verify_with_model_config明确写了「draft 模型不跑 LoRA adapter」。草稿模型与目标模型的结构与权重都不同,draft 侧的 LoRA 无意义;因此投机解码的 draft 头只跑基座,验证前向走目标模型时正常应用 LoRA。这也意味着「用 LoRA 微调过的模型 + 投机解码」的接受率会与基座不同,需要在部署时用对应 adapter 的语料实测。 - 量化:
BaseLinearLayerWithLoRA.weight会根据基座类型返回weight/weight_packed/qweight/B,说明包装层能套在 GPTQ、AWQ、Marlin 等量化线性层上。但requires_unquantized_input = True是硬约束:LoRA 的 A 分支必须吃未量化的激活,若基座是 W4A8/V4 量化,那么前向里要保留一份 BF16 输入给 LoRA 分支,或者让 LoRA 分支自己反量化。LoRAConfig.lora_dtype独立于model_config.dtype,允许「基座 FP8 量化、adapter BF16」的组合。 - P/D 分离:prefill 与 decode 是两个不同的引擎实例。P 侧计算出的 KV 由 D 侧复用,而 adapter 的权重在两侧都要存在:调度时两侧都要把本请求的 adapter 搬进各自的槽位。这意味着
max_loras与max_cpu_loras需要在两侧分别配置,且两侧的 LRU 轨迹可能不同步——同一个请求在 P 侧刚被激活,到 D 侧时可能已被挤出,需要再搬一次。工程实践中常见的做法是把高频 adapter 用pin_adapter钉在两侧。
实测部署的三条经验
把上面这些约束换算成运维决策,可以落成三条:
- 按「同时活跃 adapter 数」而不是「注册 adapter 总数」设
max_loras。max_loras决定每层缓冲与 kernel 第三维,直接乘到显存与 CTA 开销;而「注册数」只影响主存层的 LRU,用max_cpu_loras单独放大即可。典型做法是线上--max-loras 4~8、--max-cpu-loras 64~256,让大多数 adapter 躺在主存,只在被调度时换入。 - 高频 adapter 用
pin_adapter钉住。pin_lora会把 adapter 同时钉在主存层与 GPU 层,LRU 不会淘汰它。对「系统提示语 + 固定风格」的常驻流量,钉住一次可以把每次切换的开销从「清零 + 复制所有层」降到零。 fully_sharded_loras是否开启取决于三数:TP、秩、序列长度。TP=1 或小秩(≤16)且请求较短时,默认方案的 A 重复存储与重复计算可忽略;TP≥4、秩≥32、prefill 较长时,S-LoRA 式秩切分的通信收益更明显。这个开关的影响面延伸到 MoE(与 EP 互斥),所以建议在部署前用小流量实测两条路径的 TTFT/TPOT,而不是凭经验切。
不支持的能力与边界
- rsLoRA / DoRA 等训练方法:rsLoRA 可加载(
_scaling用 );DoRA 明确不支持,validate_legal会拒绝。 - 多 adapter 混用:一个请求只能挂一个 adapter(
default_mm_loras的注释也点明「每个 prompt 只支持一个 lora」)。 - tower / connector LoRA:只有
enable_tower_connector_lora且模型支持时才可用,是实验特性。 - Layer replication / aLoRA / BD-LoRA:不支持。
- 分类头多模块:
modules_to_save最多一个整模块。
小结
vLLM 的多 LoRA 子系统可以被总结成一句话:把「一个 adapter 的低秩增量」从一个 Python 对象,变成一张按 token 排序的槽位表,再变成三次 kernel launch(shrink、expand、以及 MoE 的两段插桩)。
LoRARequest→InputBatch.request_lora_mapping→token_lora_mapping→lora_index_to_id的下标,是三次坐标系变换;- 两层 LRU 缓存(主存 + GPU 槽位)支撑「几百 adapter 同时登记、几十个同时驻留」;
LoRAKernelMeta用 CPU 张量伪装标量、用稳定排序生成分段,把torch.compile的动态控制流问题绕开;- Punica 的 SGMV 在 vLLM 里是 Triton 版的 shrink/expand 双核,fp32 中转、
int64行号、空 CTA 早退、SAME_STRIDE分支都是为「多段变长 GEMM」服务的; - TP 下的切分规则由基座层的分片方式决定,
fully_sharded_loras走 S-LoRA 的秩切分; - MoE 的 LoRA 必须发生在激活前、求和前,并依赖「按 (adapter, 专家) 重排 token」的核;EP 下在装载阶段就只读本地专家;
- 前缀缓存、投机解码、量化、P/D 分离都对 LoRA 有额外约束,部署时要逐项确认。
与本系列第二十一篇讨论的 TensorRT-LLM 源码完全拆解(二十一):LoRA 服务——adapter 池、批内多适配器与前向替换的完整链路 对照看会更清楚两家的差异:TensorRT-LLM 的 LoRA 更依赖「权重替换 + 低秩算子注入」,适配器以池化权重的方式参与前向;vLLM 的 LoRA 更偏向「层替换 + 统一低秩核」,对模型的侵入性更均匀,也更容易复用通用的 Linear 分片逻辑。另外,想先了解低秩投影在注意力里的另一个用法,可以回顾本系列的 MLA 完全拆解:DeepSeek 低秩 KV 压缩注意力的原理与全部实现细节;KV Cache 池的共享前提可以参考 PagedAttention 完全拆解。
如果继续沿多租户方向拆,vLLM 的 P/D 分离与 KV Connector 在多 LoRA × 多前缀 × 跨实例这三重耦合下的调度记账会是一个自然的下一步;已有的一篇 vLLM 源码完全拆解(十七):KV Connector 可以作为起点。
参考资料
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



