


SGLang 源码完全拆解(十三):多 LoRA 服务——adapter 池、SGMV 内核与批内多适配器共存
从 P/D 分离继续:一个批次里的多个「模型」
第十二篇把 SGLang 的 Prefill 与 Decode 拆到两台机器上,讨论的是「同一个模型的算力如何分布到多台机器」。这一篇转过来看一个方向相反的问题:如何让同一台机器、同一个批次里同时跑很多个「微调版本」的模型。
这就是 LoRA(Low-Rank Adaptation)服务要解决的问题。LoRA 的核心假设是:微调一个基座模型时,权重的变化量 是低秩的,可以分解成两个小矩阵的乘积:
原始权重 保持不变,前向变成 。这样一来,一个适配器(adapter)只需要存 和 两个小矩阵,参数量通常只有基座模型的百分之几到千分之几。对服务系统而言,这意味着同一份基座权重可以服务成百上千个不同的业务适配器——每个客服场景、每个垂直领域、每个客户的私有数据微调,都只是一组小小的 。
问题在于,朴素做法做不到「一个批次里混跑多个适配器」。如果你用 batch_size=N 同时处理 N 个请求,其中一半用 adapter 0、一半用 adapter 1,你怎么在一个矩阵乘里同时算出两组不同的权重效果?逐请求拆成两个前向等于把批处理的好处全部丢掉。SGLang 的答案来自两篇论文的技术:S-LoRA(Sheng 等人,2023)提出统一内存池与分页管理,Punica(Chen 等人,2023)提出 SGMV(Segmented Gather Matrix-Vector)内核。SGLang 把这两者融入自己的运行时,形成了 src/lora/ 下这套实现。
本文的四个问题:
LoRAMemoryPool怎样用固定大小的 buffer 槽存放任意多个 adapter,槽位不够时如何换入换出;- SGMV 内核如何让一次前向同时服务多个 adapter,为什么它分 shrink 与 expand 两步;
LoRABatchInfo里weight_indices/seg_indptr/permutation三个张量各承担什么职责;- 多 LoRA 与 TP、DP attention、MoE、CUDA Graph 这些此前的模块如何相互作用。
本文沿用系列前文相同的固定提交 d88d5c325ad1cf28f2b804edcd8886e891a8f9b8。
图源:Punica 论文 Figure 2(arXiv:2310.18547)。左侧是请求分组,中间是为不同 adapter 准备权重缓冲,右侧是融合后的批处理内核。这张图解释了多 LoRA 服务的关键取舍:计算可以共享,权重必须各自准备。
背景:为什么「按请求换权重」不可行
先看问题的规模。假设基座是一个 8B 模型,隐藏维度 ,有 32 层,每层要适配 q_proj、k_proj、v_proj、o_proj、gate_proj、up_proj、down_proj 七个线性层。一个 rank 为 16 的 adapter,每层的参数量大约是:
- 注意力投影:
- MLP:
再乘 32 层,一个适配器大约 29M 参数;FP16 存储约 58 MB。相比之下基座 8B 模型 FP16 约 16 GB。58 MB 对 16 GB,这就是 LoRA 服务的杠杆。
但如果每个请求都要把这 58 MB 从 CPU 拷到 GPU、覆盖一遍模型权重,那么一个 58 MB 的 H2D 拷贝(假设 PCIe 有效带宽 20 GB/s)要 3 毫秒,而一次 decode 前向可能只要 5 毫秒——搬运本身吃掉了大半算力预算。更糟的是,如果批次里同时有 4 个 adapter,你要做 4 次覆盖 + 4 次前向,批处理彻底失效。
所以真正的设计目标有两个,缺一不可:
- 权重常驻:所有要用的 adapter 权重一次性放到 GPU 的固定 buffer 里,前向期间不再搬运;
- 一次前向服务多个 adapter:把「哪些 token 用哪个 adapter」变成内核里的一个索引查找,而不是外层的分支。
SGLang 的实现对应这两个目标:LoRAMemoryPool 负责第一点,SGMV 内核负责第二点。
LoRAMemoryPool:固定槽位的权重缓冲
mem_pool.py 里的 LoRAMemoryPool 是整个多 LoRA 服务的核心数据结构。它的思路和操作系统的进程页表很像:不保存内容,只保存「谁占着哪个槽」。
三层映射
lora uid <--> buffer_id (0 .. max_loras_per_batch-1) <--> 物理权重缓冲三个结构维持这个映射:
uid_to_buffer_id: Dict[Optional[str], int]:adapter 名字到槽号;buffer_id_to_uid: List[Union[str, None, EmptySlot]]:槽号到 adapter 名字,空槽用EmptySlot单例占位;A_buffer/B_buffer: Dict[str, List[torch.Tensor]]:按目标模块组织的物理张量。
注意 buffer_id_to_uid 里同时存在三种值:str 是真实 adapter,None 是基座模型(无适配器),EmptySlot 是空槽。源码注释专门解释了为什么用 EmptySlot 而不是 None:
All uids are initialized as
EmptySlotfor empty buffer slots. Here we don’t initialize to None since None is a valid uid.
这是一个很实际的细节。None 在业务上表示「这个请求用基座模型」,所以它必须能占用槽位;如果空槽也用 None 表示,就无法区分「槽里装的是基座」和「槽是空的」。用一个独立的哨兵对象解决歧义。
物理缓冲的形状
A_buffer / B_buffer 是 Dict[str, List[torch.Tensor]],外层键是目标模块名(如 q_proj、down_proj),值是一个列表——列表的第 i 个元素就是第 i 号槽的缓冲区。所以每个模块的所有 adapter 权重挤在一段连续显存里,索引方式就是 A_buffer["q_proj"][buffer_id]。
单个缓冲区的形状取决于模块类型:
标准 LoRA(3D): [num_loras, rank, hidden_dim]MoE LoRA(4D): [num_loras, num_experts, rank, hidden_dim]源码注释直接给出了这两种形状。MoE 多一维是因为 FusedMoE 的权重本来就是按专家分组的,LoRA 修正必须逐专家施加。
还有一个容易被忽略的点:rank 维度按 max_lora_rank 分配,而不是每个 adapter 自己的 rank。源码里 load_lora_weight_tensor 会先断言 buffer_view.shape == weight.shape 再拷贝,而截断逻辑在内核侧由 N = tl.minimum(N, rank * stack_num) 完成。这意味着不同 rank 的 adapter 共用同名槽形状,rank 小的 adapter 右侧留空。这是以空间换通用性:不为每个 adapter 单独分配精确大小的缓冲,从而让槽位可以互换、内核模板可以复用。
并行维度的分片口径
缓冲区形状必须精确匹配基座权重在那一个 rank 上的分片。这里有三套容易混淆的并行度:
| 维度 | 含义 | 影响 |
|---|---|---|
tp_size | 外层的张量并行规模 | 决定 embedding / lm_head 的切分 |
attn_tp_size | 注意力组的 TP 规模(attention DP 下为 tp_size // attn_dp_size) | 决定注意力投影的分片宽度 |
moe_tp_size | 专家权重的 TP 规模(tp_size // ep_size // moe_dp_size) | 决定 MoE 专家的分片宽度 |
源码里有一段很长的注释专门讲这件事,值得完整理解:
Per-expert MoE weights are sharded by
moe_tp_size, NOT the outertp_size:moe_tp_size = tp_size // ep_size // moe_dp_size, so under e.g.--tp 4 --ep 4each rank holds full-width expert weights (moe_tp_size == 1).
也就是说,在 --tp 4 --ep 4 的配置下,每个 rank 持有的是完整宽度的专家权重(因为专家已经被 EP 切开了,不再需要 TP 再切),所以 LoRA buffer 的内维也应该是完整宽度。如果这里用 tp_size 去算,会得到窄四倍的内维,与 adapter 权重的形状对不上,加载时直接形状断言失败。
这类「分片口径」问题是多 LoRA 实现里最容易出错的地方,因为它不报语义错误,只报形状错误,而且只在特定并行组合下出现。
初始化与容量校验
can_support() 在初始化时校验 adapter 是否放得下,validate_lora_batch() 在运行时校验当前批次是否需要超过 max_loras_per_batch 个 adapter。如果超出,SGLang 的选择是直接抛错而不是静默降级:
The global DP-attention batch contains more LoRA adapters than the memory pool can hold这条约束在 DP attention 场景下尤其重要。因为 DP attention 下每个 rank 只看到自己那一份请求,但最终要 all-gather 出一个全局批次,所以校验必须在 gather 之后、全局视图上进行——源码中 active_lora_ids 正是通过 tp_group.all_gather_object(forward_batch.lora_ids) 汇总出来的:
if self.attn_dp_enabled: gathered_lora_ids = get_parallel().tp_group.all_gather_object(forward_batch.lora_ids) active_lora_ids = { lora_id for rank_lora_ids in gathered_lora_ids for lora_id in rank_lora_ids } if not self.validate_lora_batch(active_lora_ids): raise ValueError(...) self.fetch_new_loras(active_lora_ids)注意这里是按集合汇总的。同一时刻全局有多少个不同的 adapter,而不是有多少个请求——因为一个 adapter 可以被多个请求共用,槽位只需要一个。
SGMV:把「多个小矩阵乘」塞进一次内核
缓冲区准备好了,接下来的问题是计算。这一节把 SGMV 的原理讲透。
从朴素公式出发
对某层的一个线性模块,设输入激活为 ( 是批次里所有 token 拼起来的行数),基座权重为 (PyTorch 习惯,nn.Linear 里 的形状是 [out_features, in_features]),LoRA 权重为 、。单个适配器的输出是:
其中 是 LoRA 的缩放系数(通常 ,SGLang 在 LoRAConfig 里读取 lora_alpha 并在加载时算出 scaling)。
现在假设批次里有 个不同的适配器,token 按适配器分成了 个连续的段(segment)。段 有 行,。分段矩阵向量乘(SGMV,有时也叫 SGMM 分组矩阵乘,因为这里实际处理的是矩阵而非向量)要算的是:
下标 表示「用第 个适配器的权重」。基座项对所有段都一样,是一个普通的 GEMM;LoRA 项是 段各用一套不同 的分块 GEMM。
为什么分两步:shrink 与 expand
直接算 当然可以,但有个问题: 和 的形状不同,最优的 tile 划分也不同。
- :形状 ,是「压缩」——把 维输入降到 维。r 通常只有 16 或 32,很小。这个 GEMM 的 K 维很大(k=4096),M 维是 token 数,N 维很小。
- :形状 ,是「展开」——把 维升回 维。这个 GEMM 的 K 维很小(r=16),M 维是 token 数,N 维很大。
两个 GEMM 的瓶颈完全不同。前者受 K 维循环的算术强度支配,后者受 N 维输出的写带宽支配。Punica 的核心洞察就是:把它们当作两个独立的内核来调度,中间结果放在显存里做中转。于是有了 shrink kernel 和 expand kernel。
这与 vLLM 源码完全拆解(八):MoE 层的前向执行 里 grouped GEMM 的拆解思路是同源的——把「每个分组用不同权重」的困难,转化为「一段连续输出里按索引取不同权重」的困难,然后让内核自己去做这个索引。
shrink kernel:_sgemm_lora_a_kernel
SGLang 的 Triton 实现把这一步写成:
@triton.jitdef _sgemm_lora_a_kernel( x, weights, output, N, # stack_num * r K, # input_dim stack_num, x_stride_0, x_stride_1, w_stride_0, w_stride_1, w_stride_2, output_stride_0, output_stride_1, seg_lens, seg_indptr, weight_indices, lora_ranks, sorted_token_ids, SORTED_BY_ADAPTER: tl.constexpr, BLOCK_S: tl.constexpr, BLOCK_N: tl.constexpr, BLOCK_K: tl.constexpr,):逐个参数看过来,几个关键点:
batch_id = tl.program_id(axis=1)—— 每个 program(即一次网格调度)负责一个段。这是 SGMV 与普通 GEMM 在内核组织上的根本区别:网格的第二维是「段」,而不是「批」。w_index = tl.load(weight_indices + batch_id)—— 用段号查表得到适配器槽号。这一条 load 就是「批内多适配器」的全部魔法:内核不需要知道有哪些 adapter,只需要一张seg -> buffer_id的查找表。rank = tl.load(lora_ranks + w_index)—— 再查一次得到该适配器的实际 rank。if rank == 0: return—— rank 为 0 意味着这个请求用基座模型,LoRA 分支的输出应为零,直接跳过整个 program。这是一个干净的处理方式:空操作比特殊分支更符合内核的执行模型。N = tl.minimum(N, rank * stack_num)—— 把输出宽度裁到实际 rank。stack_num是「一次处理多少个适配器分片」的堆叠因子,见下文的 stack 讨论。
内核主体的循环就是标准的分块 GEMM:
s_offset = tl.arange(0, BLOCK_S) + pid_s * BLOCK_S n_offset = tl.arange(0, BLOCK_N) + pid_n * BLOCK_N k_offset = tl.arange(0, BLOCK_K) x_ptrs = x + (s_physical[:, None] * x_stride_0 + k_offset[None, :] * x_stride_1) w_ptrs = (weights + w_index * w_stride_0) + ( k_offset[:, None] * w_stride_2 + n_offset[None, :] * w_stride_1 )注意 x_ptrs 用的是 s_physical 而不是 s_offset。s_physical 由 _resolve_token_positions() 计算,它把逻辑行号映射到物理行号——这就是 permutation 的作用。如果批次里的 token 顺序不是按适配器整理好的,内核需要先做一次重排。
w_ptrs 的基址是 weights + w_index * w_stride_0,即先跳到该适配器的权重块,再按 索引。这里的 weights 就是前面 A_buffer[module_name] 那个列表在显存里拼成的二维视图。
最后:
partial_sum += tl.dot(x_tile, w_tile)tl.dot 用 FP32 累加。这一点和 FlashAttention 完全拆解(一) 里讨论过的在线 softmax 数值考虑一致:低精度输入、高精度累加是这类内核的通用做法。
expand kernel 与累加
expand kernel(_sgemm_lora_b_kernel)把 shrink 的输出 与 相乘,得到最终修正 。它的索引逻辑与 shrink 相同(同样按段查表),区别在 tile 划分:K 维是 而不是 ,N 维是 而不是 ,所以循环次数与 block 配置不一样。源码里的 csgmv_configs 目录按 lora_shrink / lora_expand 分别存放调优好的配置:
lora_expand,K=1024,R=64,S=1,device=NVIDIA_H200.jsonlora_shrink,K=3072,R=64,S=1,device=NVIDIA_H200.json文件名里的 K、R、S 就是内核的三个形状参数(K 维、rank、stack_num),是按实际负载形态预调好的 autotune 结果。
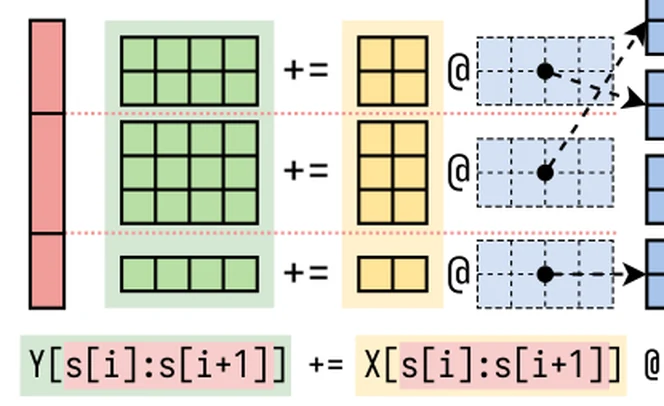
图源:Punica 论文 Figure 3(arXiv:2310.18547)。图中把「一组请求的输入」与「一组适配器权重」按段对齐,输出则是同一个 GEMM 的形状。段的边界由 seg_indptr 给出,段的权重由 weight_indices 给出——这两个张量就是 SGMV 接口的全部输入。
累加落点:为什么修正项要「加」上去
还有一个需要交代的设计点:SGMV 内核的输出是修正项,不是最终结果。基座 GEMM 仍由普通路径算(SGLang 里就是标准 Linear 前向),LoRA 修正以 += 的形式加在结果上。
这带来一个重要的性能含义:如果整个批次都不用 LoRA,那么完全不进入 LoRA 路径。LoRAManager.prepare_lora_batch() 开头就有这个快速返回:
if self.lora_backend.skip_inactive_lora_batches and not any( uid is not None for uid in forward_batch.lora_ids): self.reset_lora_batch() returnskip_inactive_lora_batches 是后端的一个属性,注释说明它是给 UNO 这类「用显式 token 行路由」的内部后端用的。对 Triton 后端而言,即使不跳过,rank == 0 的早退也会让所有段立刻返回,代价只是网格启动本身。
这也解释了 SGLang 文档里那一句提醒:「enabling LoRA on additional modules introduces a minor performance overhead」——每多一个目标模块,就多两次内核启动(shrink + expand)和一段缓冲区,即使批内没有任何请求使用它。
LoRABatchInfo:一次前向的路由元数据
内核需要的那几张查找表从哪来?答案是 LoRABatchInfo。它在 utils.py 里定义,是每个前向批次携带的 LoRA 元数据包。逐字段拆开看:
class LoRABatchInfo: use_cuda_graph: bool # 本次前向走不走 CUDA Graph bs: int # 批大小(请求数) num_segments: int # 段数(Triton 后端等于批大小) seg_indptr: torch.Tensor # (num_segments + 1,) 每段的起始行号 weight_indices: torch.Tensor # (num_segments,) 每段用哪个槽 lora_ranks: torch.Tensor # (lora_num,) 每个槽的 rank scalings: torch.Tensor # (lora_num,) 每个槽的缩放系数 max_len: Optional[int] # 本批次最长段 seg_lens: Optional[torch.Tensor] permutation: Optional[torch.Tensor] has_active_lora: boolseg_indptr:段边界
标准的 CSR(Compressed Sparse Row)式前缀和表示。段 覆盖的行区间是 [seg_indptr[i], seg_indptr[i+1])。这个设计的好处是:段长可以不等——prefill 批次里不同请求的 prompt 长度天差地别,用 indptr 表示比用固定的 seg_len 数组更自然。注意源码注释指明 Triton 后端下 num_segments 恰好等于 bs,即「一个请求一段」。
但 chunked backend(CSGMV)下两者会不相等,源码注释解释了原因:
for csgmv they differ because its segments are chunked across adapters.
也就是说 CSGMV 会把一个段再切块,用更细的粒度换取更好的负载均衡。这就是为什么除了 seg_indptr 之外还有一套 req_seg_indptr:
# Per-request segment indptrs, shape (bs + 1,). Required by MoE virtual # experts which map tokens to requests regardless of the dense-LoRA # backend's internal segmentation. req_seg_indptr: Optional[torch.Tensor] = None req_weight_indices: Optional[torch.Tensor] = None两套索引的存在原因:不同消费者需要不同的分组视图。dense LoRA 内核按「后端自己的分段」工作(可能与请求边界不一致),而 MoE 的虚拟专家机制必须按「请求边界」工作。与其让某一方将就,不如把两套都算出来。
permutation:逻辑行到物理行
这是最容易被误解的字段。它回答的问题是:内核看到的输入行号,与输出张量里的物理行号,是不是同一个顺序?
如果内核把段按请求顺序处理,而输入激活是按调度顺序排列的,两者可能不一致。此时 permutation[i] 给出「第 i 个逻辑行对应哪个物理行」。shrink kernel 里那一行:
s_physical = _resolve_token_positions( sorted_token_ids, seg_start, s_offset, seg_len, SORTED_BY_ADAPTER )就是 permutation 的应用点。当 SORTED_BY_ADAPTER 为真时,token 已经按适配器排好序,位置解析是恒等映射,_resolve_token_positions 直接返回 s_offset;否则需要真查表。
这是一个重要的性能开关:让 token 按适配器排序可以把 gather 变成顺序读,代价是一次重排。SGLang 把它做成 constexpr,说明这是编译期决定的策略,而不是运行时分支。
lora_ranks 与 scalings:按槽索引,不是按段
注意这两个张量的形状是 (lora_num,) 而不是 (num_segments,)——它们按槽号索引:
lora_ranks = [0] * self.max_loras_per_batch scalings = [0] * self.max_loras_per_batch for uid in active_lora_ids: if uid is None: continue weight_index = self.memory_pool.get_buffer_id(uid) lora = self.loras[uid] lora_ranks[weight_index] = lora.config.r scalings[weight_index] = lora.scalingweight_indices 把段映射到槽,lora_ranks / scalings 把槽映射到属性。两次间接寻址,换来的是内核侧只读两张小表,而不是遍历请求列表。
scalings 的默认值是 0——这意味着如果某个槽没有被正确赋值,它的缩放系数是 0,修正项会算出 0 而不是脏值。这是一个保守的初始化选择:宁可少算,不要算错。
weight_indices 的默认值:基座槽
base_weight_index = self.memory_pool.uid_to_buffer_id.get(None, 0) weight_indices = [base_weight_index] * len(forward_batch.lora_ids) for i, uid in enumerate(forward_batch.lora_ids): if uid not in self.memory_pool.uid_to_buffer_id: continue weight_indices[i] = self.memory_pool.get_buffer_id(uid)整个数组先填成「基座模型所在槽」,再逐个替换成实际槽号。注意那个 continue:如果某个 uid 不在池里(理论上不该发生,因为前面已经 fetch 过),它保持基座槽。
uid_to_buffer_id.get(None, 0) 里的默认值 0 也值得注意——None 在初始化时就被放进了映射(占一个槽),所以正常情况下一定命中;默认值只是防御性写法。
has_active_lora:给 Python 侧的一个布尔开关
self.lora_backend.batch_info.has_active_lora = any( lora_ranks[wi] > 0 for wi in weight_indices )注释说明它是「computed from Python lists in prepare_lora_batch to avoid GPU sync」。这是一个纯 CPU 侧的计算,因为 lora_ranks 在构造时还是 Python list。这样 Python 层的后续逻辑(比如要不要给 lm_head 加 LoRA、要不要走特殊分支)可以直接读这个布尔值,不需要把张量同步回 CPU。在推理服务里,任何一次隐式的 .item() 都是一次同步点,代价是整个流水线停一下——所以「用 Python list 算好再转张量」是这类系统的常规手法。
adapter 的生命周期:从磁盘到槽位
前面讲了「槽位怎么用」,这一节讲「槽位怎么换」。分三段:加载、换入、淘汰。
第一段:加载(磁盘 → CPU)
load_lora_adapter() 的日志很能说明问题——它在开始和结束各打一次可用显存:
logger.info( f"LoRA adapter loading starts: {lora_ref}. " f"avail mem={get_available_gpu_memory(self.device.type, self.device.index):.2f} GB")在加载前后记录显存,是为了让运维能立刻看到「加载一个 adapter 到底吃了多少显存」。这类日志在多 LoRA 服务里非常必要,因为 adapter 的内存占用与 max_loras_per_batch、max_lora_rank、目标模块集合三者相乘,不实际测一下很难估准。
加载分两步:先读配置(LoRAConfig),再读权重(load_lora_weights)。配置里最重要的四个字段:
self.target_modules = self.hf_config["target_modules"] # 适配哪些模块self.r = self.hf_config["r"] # 秩self.lora_alpha = self.hf_config["lora_alpha"] # 缩放分子self.use_dora = self.hf_config.get("use_dora", False) # 是否 DoRAtarget_modules 决定这个 adapter 需要往哪些缓冲区写数据;r 和 lora_alpha 决定缩放。
LoRAConfig 里还有一处不显眼但很实用的处理——过滤伪 added tokens:
# Filter fake added tokens: tokens with ID < base_vocab_size are already # part of the base vocabulary and should not be treated as added tokens. # This commonly happens when added_tokens.json is copied from the base # model's tokenizer. if self.added_tokens_config and base_vocab_size is not None: self.added_tokens_config = { token: token_id for token, token_id in self.added_tokens_config.items() if token_id >= base_vocab_size }有些 adapter 的发布包里带了一份从基座模型复制来的 added_tokens.json,里面的 token 全部属于基座词表。如果不加过滤,系统会以为这个 adapter 有自己的新增 token 表,从而在 embedding 层分配多余的缓冲区。
validate_new_adapter() 还会做兼容性校验。源码里有一条与 DP attention 相关的硬约束:
assert not self.attn_dp_enabled or lora_ref.pinned, "DP-attention LoRA requires pinned adapters"DP attention 下必须 pin 住 adapter。原因不难推:DP attention 下每个 rank 只持有自己那部分请求,但全局批次需要所有 rank 对「有哪些 adapter」达成一致;如果 adapter 可以被某个 rank 单方面淘汰,不同 rank 的全局视图就会不一致,all_gather_object 之后的校验也就失去意义。pinned 是一个跨 rank 的一致性保证。
第二段:换入(CPU → GPU 槽位)
fetch_new_loras() 是换入的入口:
def fetch_new_loras( self, new_loras: set[Optional[str]], running_loras: set[Optional[str]] = set() ): cur_uids = new_loras | running_loras assert len(cur_uids) <= self.max_loras_per_batch new_uids = { uid for uid in cur_uids if uid not in self.memory_pool.uid_to_buffer_id } self.memory_pool.prepare_lora_batch( cur_uids=cur_uids, lora_adapters=self.loras, lora_modules=self.lora_modules, lora_refs=self.lora_refs.copy(), lora_embed_tokens_module=self.embed_tokens_module, lora_lm_head_module=self.lm_head_module, )三个要点:
cur_uids = new_loras | running_loras—— 换入的候选集合包含「本批次新出现的」加上「当前正在跑的」。语义是:正在跑的 adapter 不能被换出,否则它的后续 decode 步骤会读到错误的权重。new_uids用差集算出 —— 只有不在池里的才需要真正换入。lora_refs.copy()—— 源码注释解释了原因:copy snapshot of current lora_refs to avoid mutation during the batch preparation。prepare_lora_batch内部会修改池状态,传一份快照避免遍历时被并发修改。这是一个典型的「先快照再修改」防御。
换入之后还要通知各层模块:
def _notify_lora_slots_updated(self, slot_ids: set[int]) -> None: for layer_modules in self.lora_modules: for module in layer_modules.values(): notify = getattr(module, "on_lora_slots_updated", None) if callable(notify): notify(slot_ids)为什么需要通知?因为有些后端会缓存「槽位到权重张量」的映射(比如 CUDA Graph 捕获时把 buffer 的地址固化进了图里)。槽位内容变了,缓存必须失效。用 getattr(..., None) + callable 的鸭子类型检查,是为了兼容不带这个钩子的模块实现。
第三段:淘汰
当槽位不够时,必须有 adapter 被换出。策略在 eviction_policy.py 里,是一个标准的策略模式:
class EvictionPolicy(ABC): @abstractmethod def mark_used(self, uid: Optional[str]) -> None: ... @abstractmethod def select_victim(self, candidates: Set[Optional[str]]) -> Optional[str]: ... @abstractmethod def remove(self, uid: Optional[str]) -> None: ...两个实现:LRUEvictionPolicy 用 OrderedDict 记录访问顺序,FIFOEvictionPolicy 记录插入顺序。select_victim 从 candidates 里挑一个最老的。注意它的兜底逻辑:
# If no tracked UID found in candidates, check if None is available # This happens when the batch consists entirely of LoRA requests # and None (base model) is the only eviction candidate if None in candidates: return None如果候选里只有基座槽,就淘汰基座槽。这对应一个具体的场景:整个批次全是 LoRA 请求,没有任何请求用基座模型,那么基座槽就是唯一可以被腾出来的。此时把基座权重从缓冲区清掉(_clear_buffer_slot_for_base),给新 adapter 让位。
load_lora_weight_tensor 里对应地做了零初始化:
if weight is None: # If the particular weight is not present in the adapter, we initialize the buffer to zero # to avoid contamination from the residual weight of the evicted adapters. buffer_view.zero_()为什么必须清零?因为槽位是复用的。如果新 adapter 没有某个模块的权重(比如它只适配注意力层,不适配 MLP),那块缓冲区里还留着上一个被淘汰的 adapter 的数据。如果不清零,内核会把这个残留当作新 adapter 的修正项加进去——结果是一个静默的、看不出来的错误输出。这是复用缓冲区最危险的失效模式,源码注释专门点了出来。
权重装载的完整路径
load_lora_weight_to_buffer() 是装载的主函数,它做三件事:
(1)预校验权重名与目标模块的匹配
skipped_weight_names: set = set() matched_modules: set = set() ... for name in all_weight_names: try: target_module = get_target_module_name(name, self.target_modules) matched_modules.add(target_module) except ValueError: skipped_weight_names.add(name)源码注释说明了动机:This catches mismatches before any GPU buffers are mutated. 先全量校验、再写入 GPU,避免中途失败留下半写状态。strict_loading 为真时直接抛错,否则只记警告——两种模式对应「生产要严格」和「兼容性优先」两种诉求。
(2)按层组织临时缓冲
temp_A_buffer: Dict[str, Union[torch.Tensor, Dict[int, torch.Tensor]]] = { target_module: None for target_module in self.A_buffer }这里的值类型是 Union[torch.Tensor, Dict[int, torch.Tensor]],因为 MoE 权重是「模块 → 专家 → 张量」的三层结构,而普通模块是「模块 → 张量」两层。源码用 re.search(r"experts\.(\d+)\.", name) 从权重名里抽出专家号:
expert_match = re.search(r"experts\.(\d+)\.", name) is_shared_expert = "shared_experts." in name shared_moe_target = f"{target_module}_shared_moe"共享专家(shared expert)被单独命名成 {module}_shared_moe,与路由专家({module}_moe)分开存放。这与前面拆过的 DeepSeekMoE 完全拆解 里「共享专家恒被激活、路由专家按 Top-K 选择」的结构对应:共享专家的 LoRA 修正对每个 token 都要施加,路由专家只对分到它的 token 施加,两者的索引范围不同,放在同一个缓冲区反而不好索引。
(3)拷入并处理 rank 差异
前面的 copy_weight_into_buffer(buffer_view, weight) 是实际的拷贝,utils.py 里定义。它要处理的核心情形是:adapter 的 rank 小于 max_lora_rank,或者权重的堆叠因子与缓冲区不一致。
与其他模块的耦合:五处必须处理的地方
多 LoRA 不是一个独立模块,它必须与前面十二篇讲过的每一个子系统对齐。这一节梳理其中五处,每一处都对应一个真实的设计决策。
第一处:TP——权重的分片口径
这一点在前面「并行维度的分片口径」已经展开。这里补充 S-LoRA 论文给出的通用分片规则。
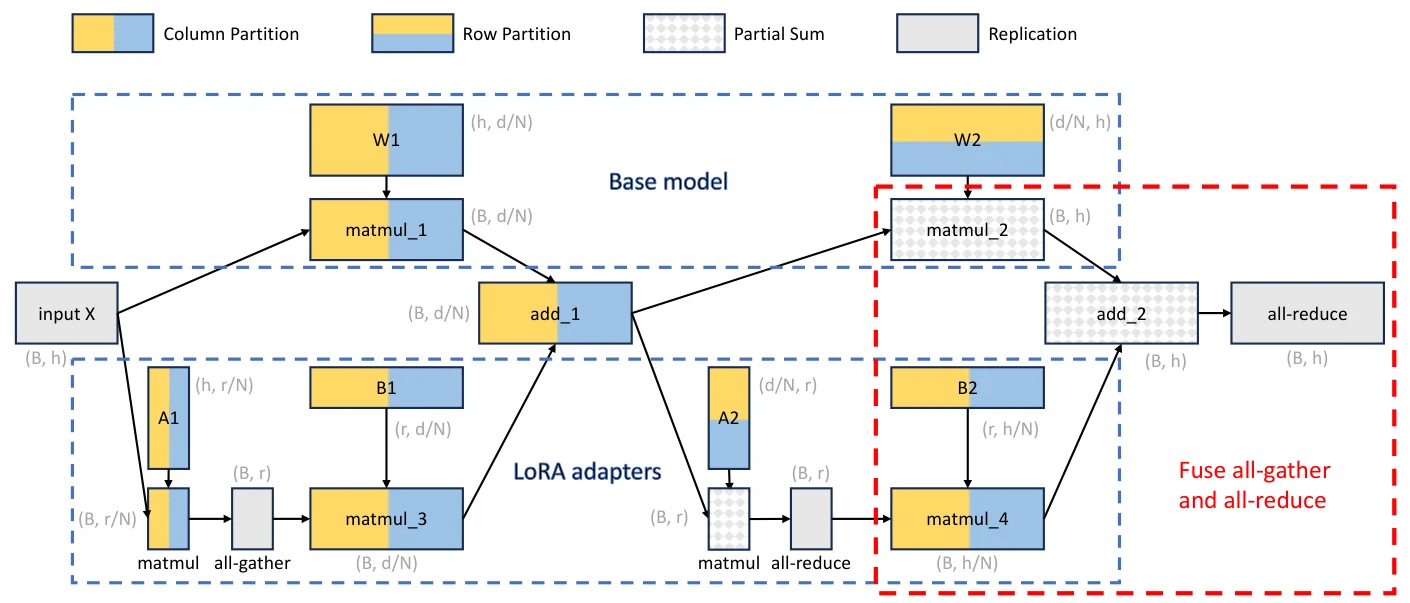
图源:S-LoRA 论文 Figure 4(arXiv:2311.03285)。核心规则是:
- 对列并行层(
q_proj、k_proj、v_proj、gate_proj、up_proj,输出维被切分), 需要在输出维上切分, 保持完整——因为 的输出维就是 ,与权重切分无关;而 的输出维是 ,必须跟着切。 - 对行并行层(
o_proj、down_proj,输入维被切分),情况相反。
SGLang 里对应的实现是 _column_parallel_lora_b_per_rank_dim() 和 get_lora_B_shape() 中的分支。理解这条规则有一个统一的口径:LoRA 修正必须与基座权重在同一 rank 上具有相同的输入/输出维度语义,否则 的加法就对不上。
第二处:前缀缓存——adapter 是命名空间的一部分
这一处最容易被忽略,后果却很严重。看 RadixKey 的字段:
__slots__ = ("token_ids", "extra_key", "cache_salt", "is_bigram", "limit")以及匹配时的断言:
if self.extra_key != other.extra_key: raise ... f"RadixKey operations require matching extra_key"源码注释里写得更明确:
extra_keyvalues are intentionally kept disjoint and never share
extra_key 是哈希键的一部分:
return plain if self.extra_key is None else (self.extra_key, plain)为什么 LoRA 必须进前缀缓存的键? 考虑一个具体场景:两个请求的 prompt 完全相同,但一个用 adapter A、一个用 adapter B。如果前缀缓存只看 token id,第二个请求会命中第一个请求留下的 KV,于是它读到的是 adapter A 算出来的 KV,却在 adapter B 的权重下继续生成。输出会出错,而且错得很隐蔽——因为 KV 看起来「是合法的」。
所以 adapter 身份必须进键。这也意味着:用 adapter A 和 adapter B 处理同一段 prompt,KV 不能复用。这是多 LoRA 服务的一个真实成本:适配器越多、切换越频繁,前缀缓存的收益越低。反过来,如果 workload 是「同一批用户反复用同一个 adapter 处理相似文档」,那么复用率很高。
这也解释了 lora_name 出现在 kv_event_lora_names 里——SGLang 源码完全拆解(五) 拆过的 KV 事件记账,需要知道每个 KV 页属于哪个 adapter。
第三处:CUDA Graph——形状与地址都必须是静态的
LoRABatchInfo.use_cuda_graph 这个字段的存在就说明问题。CUDA Graph 的核心约束是捕获时的一切都固定:指针地址、形状、分支走向。三个具体的冲突点:
(1)槽位地址
如果换入 adapter 时重新分配缓冲区,地址就变了,图失效。所以 A_buffer / B_buffer 在初始化时就按 max_loras_per_batch 一次性分配好,整个生命周期地址不动。换入只是往固定地址写数据。这正是 _notify_lora_slots_updated 存在的意义——地址没变但要通知缓存失效。
(2)批次形状
use_cuda_graph 的分支要在捕获前决定:
def _use_cuda_graph_batch(self, forward_batch: ForwardBatch) -> bool: return ( hasattr(self, "max_bs_in_cuda_graph") and forward_batch.batch_size <= self.max_bs_in_cuda_graph and forward_batch.forward_mode.is_cuda_graph() and (not self.attn_dp_enabled or forward_batch.can_run_decode_cuda_graph) )四个条件同时满足才能走图。其中 max_bs_in_cuda_graph 是预先探测的批次上限——超过就退回 eager。
(3)原地更新而不是重建
注释里写得很清楚:
# Do in-place updates when CUDA graph is enabled and the batch forward mode # could use CUDA graph.以及
# Eligible extend batches refresh the static prefill batch info in # place so captured kernels read current values at replay.「原地刷新静态 batch info」 是关键技术:图的拓扑固定,但填入图里的元数据可以在重放前刷新。这样同一个捕获的图可以服务不同的批次内容——只要形状一致。
第四处:MoE——虚拟专家
前面提到 req_seg_indptr / req_weight_indices 是专为 MoE 准备的。这里展开为什么需要。
MoE 层的计算不是「一个 token 一份权重」,而是「一个 token 选 K 个专家,每个专家一份权重」。如果这个 MoE 层又装了 LoRA,就变成「token × 专家 的每一对,都要施加对应 adapter 在这个专家上的修正」。
SGLang 的解法叫虚拟专家:把「(adapter, expert)」的组合当作一个虚拟的专家来索引。源码注释解释了它与 dense LoRA 分段的差异来源:
# For the triton backend these are identical to seg_indptr/weight_indices; # for csgmv they differ because its segments are chunked across adapters.对 Triton 后端,虚拟专家的索引恰好等于普通分段(一个请求一段);对 CSGMV 后端,因为分段被切得更细,虚拟专家必须回溯到请求粒度。同一个语义,两种实现,所以需要两套索引。
这里还牵出一个并行度细节:moe_use_local_expert_ids。
self.moe_use_local_expert_ids = ( self.moe_ep_size > 1 and not _moe_runner_keeps_global_expert_ids() and num_experts_global % self.moe_ep_size == 0 )注释说明了原因:StandardDispatcher 会在 MoE 内核之前把全局 topk_ids 重映射成本地专家 ID,所以逐专家的 LoRA 缓冲区必须按本地分片来分配和索引。而 FlashInfer 的 CUTLASS / CuteDSL / TRTLLM / MXFP4 路径保持全局 ID,因此必须按全局索引。同一个 EP 配置,不同的 MoE runner,需要不同的专家编号口径——这是读 SGLang MoE 相关源码时最容易踩的坑之一,可参考 vLLM 源码完全拆解(八):MoE 层的前向执行 里对 grouped_topk 与专家编号的拆解对照阅读。
第五处:调度——adapter 饥饿与 drain
多 LoRA 服务有一个特有的调度问题:如果 max_loras_per_batch = 2,而队列里有 10 个不同 adapter 的请求,就只能同时跑 2 个。更糟的情况是:少数几个热门 adapter 的长请求一直占着槽位不放,其他 adapter 的请求永远排不上。
SGLang 的解法是 LoRADrainer,源码里 AdapterStats 记录了每个 adapter 的等待情况:
class AdapterStats: def is_starving(self, drain_wait_threshold: float): ...对应 --lora-drain-wait-threshold 参数(文档原文):
When any LoRA adapter request waits longer than this threshold (in seconds), the scheduler will selectively drain one running adapter to make room. This mitigates extreme tail latency under high or skewed workloads by preventing a small set of adapters from monopolizing batch slots.
_update_draining_loras() 里有一条判断:
running_adapter_ids = {req.lora_id for req in running_reqs} if len(running_adapter_ids) < self.max_loras_per_batch:只在运行中的 adapter 数少于槽位数时才考虑 drain——因为这时有槽位可以腾出来给饥饿的 adapter。如果槽位已经满载且全部在用,drain 也只是换一个受害者,解决不了根本矛盾。
对应地,_update_fully_drained_loras() 在 adapter 的所有请求都退出时释放槽位。注意这里用 running_reqs 而不是「已经完成的请求」,因为一个 adapter 可能在多个运行中请求里被共用;只有它最后一个请求退出,槽位才真正空闲。
这也和前面的 fetch_new_loras 形成闭环:cur_uids = new_loras | running_loras 里的 running_loras 就是「当前还有请求在跑的 adapter」,它们不会被当作换出候选。
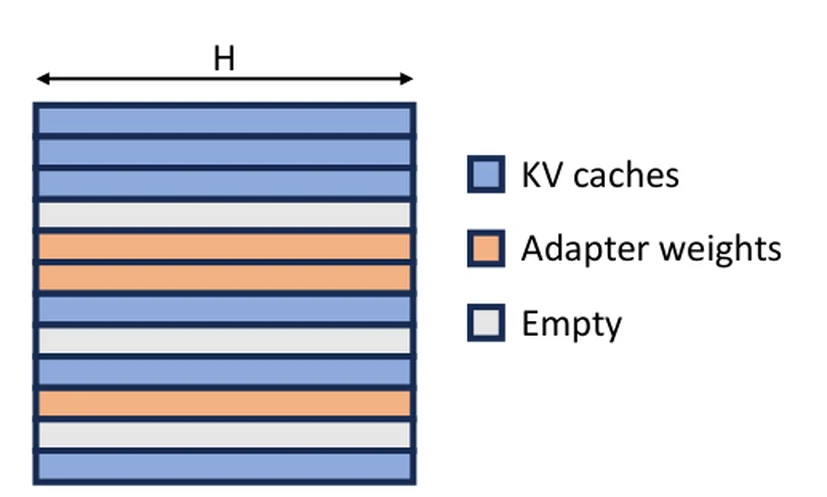
图源:S-LoRA 论文 Figure 3(arXiv:2311.03285)。统一内存池把三样东西放在同一段显存里统一管理:基座权重、adapter 权重(分页存放)、KV 缓存。SGLang 的实现里 adapter 权重所在的 A_buffer / B_buffer 就是图中 adapter 池的对应物,只是它的分页单位是「槽」而不是「页」。
融合层接口:为什么 QKV 要一起做
BaseLoRABackend.run_qkv_lora() 的签名值得细看:
def run_qkv_lora( self, x: torch.Tensor, qkv_lora_a: torch.Tensor, qkv_lora_b: Union[torch.Tensor, Tuple[torch.Tensor]], ... ) -> torch.Tensor: """Run the lora pass for QKV Layer.
Args: x: input matrix with shape (s, input_dim) qkv_lora_a: lora_a module for qkv, with shape (num_lora, 3 * r, input_dim) qkv_lora_b: lora_b module for qkv. If passed in as a tensor, its shape should be (num_lora, output_dim_q + 2 * output_dim_kv, r) """注意 qkv_lora_a 的形状是 (num_lora, 3 * r, input_dim)——三个投影的 被拼在了一起。而且传入的是 x 而不是 x_q、x_k、x_v:三个投影的输入本来是同一个张量(都是层的隐藏状态)。
这意味着三次 shrink 可以合并成一次:输入相同、只是权重不同,把权重在输出维上拼接,就是一个 维输出的 GEMM。同理 run_gate_up_lora 处理 gate_proj 与 up_proj,形状是 (num_lora, 2 * r, input_dim)。
这是一个纯收益的优化:内核启动次数从 6 次(q/k/v 各两次)降到 2 次,中间结果的显存占用不变(因为总输出维相同)。
这背后的前提是 SGLang 的模型层实现已经把 QKV 做成了融合层(QKVParallelLinear),SGLang 源码完全拆解(七):ForwardBatch、TpModelWorker 与 ModelRunner 里拆过的模型执行路径正是这样组织的。LoRA 层只要挂在这个融合层上,就自然继承了这个融合结构。
源码还提供了 tuple 形式的 qkv_lora_b(一个给 、一个给 ),文档串解释了原因:
If passed in as a tuple of two tensors, it should contain: a lora_b module for q, with shape (1, num_lora, output_dim_q, r) and a combined lora_b module for kv, with shape (2, num_lora, output_dim_kv, r)GQA 模型下 与 的输出维度不同( 有 num_heads 个头, 只有 num_kv_heads 个),所以 的切分不能简单按 1:1:1。传 tuple 让后端知道「这两个部分要分别处理」。这直接对应 GQA 完全拆解 里讲过的分组共享 KV 结构。
三种后端的取舍
--lora-backend 目前有两个正式选项,外加若干内部后端。
| 后端 | 内核 | 分段粒度 | 适用场景 |
|---|---|---|---|
triton | sgemm_lora_a/b(SGMV) | 一段 = 一个请求 | 通用、默认 |
csgmv | chunked_sgmv_lora_* | 合并同 adapter 的相邻请求,再按 chunk 切分 | LoRA 分布倾斜时 |
CSGMV 的动机在源码类文档串里写得很清楚:
class ChunkedSgmvLoRABackend(BaseLoRABackend): """Chunked LoRA backend using segmented matrix-vector multiplication.
This backend is largely based on the SGMV algorithm introduced in the Punica paper. One main variation made here is to segment the input sequences into fixed-size chunks, which reduces excessive kernel launches especially when the LoRA distribution is skewed. """「when the LoRA distribution is skewed」 是关键。考虑一个批次:100 个请求里 98 个用同一个 adapter,2 个用其他。Triton 后端会切出 100 个段,每个段都要一次 program 调度。而这两个「其他」的段可能只有几个 token,网格里绝大多数 program 的算力都浪费在极小的段上。
CSGMV 的做法分两步(merge_and_chunk_segments()):
for wi, pl in zip(weight_indices, pruned_lens): if seg_weight_indices and seg_weight_indices[-1] == wi: seg_lens[-1] += pl else: seg_weight_indices.append(wi) seg_lens.append(pl) # Split the last segment if it exceeds chunk_size while seg_lens[-1] > chunk_size: remainder = seg_lens[-1] - chunk_size seg_lens[-1] = chunk_size(1)合并:相邻且用同一 adapter 的请求合并成一个段。(2)切分:超过 max_chunk_size(默认 16)的段再切成固定大小的块。
合并解决倾斜问题,切分解决「合并后段太长导致负载不均」的问题。两个操作互为约束,最后得到的段既不会太碎(减少启动开销),也不会太长(保持负载均衡)。这正是为什么前面说 CSGMV 的 num_segments != bs。
chunk_size 的调优代价在文档里也有交代:
max_lora_chunk_size: Maximum chunk size for the ChunkedSGMV LoRA backend. Only used when —lora-backend is ‘csgmv’. Choosing a larger value might improve performance. Please tune this value based on your hardware and workload as needed. Defaults to 16.
这个参数没有普适最优值,取决于硬件与 workload——因为它是「启动开销」与「负载均衡」两个方向的权衡点。
工程实践:配置与常见陷阱
关键参数
| 参数 | 默认 | 作用与代价 |
|---|---|---|
--max-loras-per-batch | 8 | 槽位数。直接决定缓冲区显存占用;调小省显存但更容易被淘汰 |
--max-loaded-loras | 未设 | 限制 CPU 侧常驻的 adapter 数,必须 ≥ max-loras-per-batch |
--max-lora-rank | 自动推断 | 缓冲区的 rank 维度大小;影响显存与能否动态加载更大 rank 的 adapter |
--lora-target-modules | 自动推断 | 决定要建多少缓冲区、多少内核;可设 all 但性能变差 |
--lora-eviction-policy | lru | lru 缓存效率更好,fifo 兼容旧行为 |
--enable-lora-overlap-loading | 关 | H2D 与计算重叠,适合频繁加载大 adapter 的场景 |
陷阱一:max_lora_rank 事后无法放大
源码注释点出了这个约束:
This argument is needed when you expect to dynamically load adapters of larger LoRA rank after server startup.
max_lora_rank 在初始化时就决定了缓冲区形状。如果启动后想加载一个 rank 比它大的 adapter,加载会失败。所以要按「未来可能出现的最大 rank」来设定,而不是按当前已知的 adapter。
同理适用于 lora_target_modules:
This argument is needed when you expect to dynamically load adapters of different target modules after server startup.
如果启动时只声明了 q_proj,之后想加载一个也适配 MLP 的 adapter,那些 MLP 权重会被跳过(skipped_weight_names 逻辑)——adapter 会「加载成功」但行为是错的(MLP 部分没生效)。这是一个特别隐蔽的问题,源码里那段警告就为此而生:
f"LoRA adapter '{uid}': {len(skipped_weight_names)} weight(s) " f"skipped because they did not match any target module in "实践建议:如果不确定未来会加载什么 adapter,宁可启动时声明的目标模块集合大一些,承担一点性能开销,也不要让后续加载的 adapter 静默失效。
陷阱二:DP attention 下 adapter 必须 pinned
前面提到 assert not self.attn_dp_enabled or lora_ref.pinned。这条约束的用户侧含义是:在 DP attention 部署下,--lora-paths 里的 adapter 必须用 JSON 形式带 "pinned": true。文档给的是这个格式:
{"lora_name":str, "lora_path":str, "pinned":bool}如果沿用了简化格式(<NAME>=<PATH>),在 DP attention 下会因为 pinned=None 而启动失败。
陷阱三:adapter 隔离带来的缓存收益下降
前面讲过 adapter 进前缀缓存键的必然性。工程上需要注意的推论是:多 adapter 混跑会稀释前缀缓存的收益。如果业务允许把同一 adapter 的请求路由到同一实例,前缀命中率会显著提高。这与 SGLang 源码完全拆解(五):KV 内存池与 RadixCache 的所有权闭环 里讨论过的前缀匹配逻辑直接相关——命中率取决于有多少请求真正共享 (adapter, tokens) 这一对。
陷阱四:加载时要预留显存余量
回看那段日志——avail mem 打印在加载前后。实践意义是:--max-loras-per-batch × max_lora_rank × target_modules 决定了需要预留的显存。如果启动时把 KV 缓存池按满显存分配,加载新 adapter 时会 OOM。SGLang 在启动时就按 max_loras_per_batch 预分配了缓冲(而不是按需分配),所以这部分显存在启动时就被锁定——不会在运行中突然不够。
完整链路:一个多 LoRA 请求如何穿过前向
把前面的碎片串起来,看一次实际的调用顺序。
阶段 0:请求进入
两个请求到达,它们的 lora_path 分别是 lora0 和 lora1。TokenizerManager 把它们变成 Req,lora_id 字段被填上对应的 adapter 标识。这一步与 SGLang 源码完全拆解(二):入口、分词与流式输出如何闭环 里拆过的路径完全一致——LoRA 只是请求上的一个附加字段。
阶段 1:调度与准入
Scheduler 把它们放进 batch。此时 adapter 可能还没在池里(注意 lora0、lora1 都还没进池),所以 Scheduler 侧需要知道「这个批次需要哪些 adapter」——如果超过 max_loras_per_batch,请求会被推迟(在 DP attention 下则是前面那条全局校验直接抛错)。
阶段 2:换入
fetch_new_loras() 被调用,cur_uids = {lora0, lora1}:
new_uids = {uid for uid in cur_uids if uid not in self.memory_pool.uid_to_buffer_id}两个都是新的,于是 prepare_lora_batch() 走淘汰逻辑:选两个槽作为受害者(可能是 None 基座槽或其他旧 adapter),调用 load_lora_weight_to_buffer() 把 lora0、lora1 的权重逐层写入槽 0、槽 1。写入前先清零(防残留),写完通知各层模块槽位已更新。
阶段 3:构造路由元数据
LoRAManager.prepare_lora_batch(forward_batch) 构造 LoRABatchInfo:
weight_indices = [base_weight_index] * len(forward_batch.lora_ids) for i, uid in enumerate(forward_batch.lora_ids): if uid not in self.memory_pool.uid_to_buffer_id: continue weight_indices[i] = self.memory_pool.get_buffer_id(uid)假设请求顺序是 [lora0, lora1],且它们的 prompt 长度是 100 和 60,则:
weight_indices = [0, 1] # 段 0 用槽 0,段 1 用槽 1seg_indptr = [0, 100, 160] # 段边界seg_lens = [100, 60]lora_ranks = [r0, r1, 0, 0, ...] # 按槽索引,后面是空槽scalings = [s0, s1, 0, 0, ...]阶段 4:逐层前向
模型从 embedding 层开始跑。每一层遇到 LoRA 挂载的线性层时:
- 先算基座 GEMM:;
- 调 shrink 内核:;
- 调 expand 内核:;
- 相加:。
内核内部,网格的 与段号 batch_id = program_id(axis=1) 结合,每个 program 通过 w_index 找到自己该用哪个槽的权重。整个过程没有一次 Python 层的分支判断。
阶段 5:KV 写入与前缀缓存
Prefill 完成后,KV 写入缓存。此时 extra_key 里带上 adapter 标识——这一步在 checkpoint() 里完成(见 SGLang 源码完全拆解(五) 拆过的 checkpoint 路径)。于是 (lora0, tokens[0:100]) 与 (lora1, tokens[0:100]) 成为两个不同的缓存条目。
阶段 6:后续 decode
后续每个 decode step 重复阶段 3-4。注意槽位在 decode 期间保持不变——因为 cur_uids 里包含 running_loras,正在跑的 adapter 不会被换出。这正是那条 cur_uids = new_loras | running_loras 存在的意义。
阶段 7:请求退出与槽位释放
请求结束后,LoRADrainer._update_fully_drained_loras() 检查该 adapter 是否还有别的运行中请求:
running_adapter_ids = {req.lora_id for req in running_reqs}如果 lora0 已经没有任何运行中的请求,它的槽位可以被标记为可淘汰。但不一定立即释放——因为马上可能有新请求又用它。实际的释放时机由淘汰策略在需要腾位置时决定。这个「延迟释放」的策略是刻意的:adapter 的复用概率通常远高于随机(业务上往往成簇出现),所以留着比立即清掉更划算。
小结
这一篇把 SGLang 的多 LoRA 服务拆完,核心结论有五条:
-
LoRA 服务的杠杆来自「权重小」与「常驻 + 批量」的组合。 一个 adapter 通常只占基座模型百分之几的显存,但只有把权重常驻 GPU、让一次前向同时服务多个 adapter,杠杆才能兑现。LoRAMemoryPool 与 SGMV 内核分别负责这两件事。
-
槽位模型是「按需分配内容、固定分配容器」的折中。
A_buffer/B_buffer按max_loras_per_batch一次性分配,整个生命周期地址不变,内容按需换入换出。这样既避开了运行中分配的开销与碎片,也让 CUDA Graph 可以安全地捕获内核——代价是容量上限硬编码在启动参数里。 -
SGMV 把「批内多适配器」降维成一次查表。 网格的第二维是段,段查
weight_indices得到槽号,槽号查lora_ranks/scalings得到属性,rank 为 0 的段直接早退。整个过程不需要内核知道有哪些 adapter,也不需要 Python 侧的任何分支——这是它能与批处理、CUDA Graph 兼容的关键。 -
三条边界必须显式处理: adapster 进前缀缓存键(否则会把 adapter A 的 KV 喂给 adapter B)、缓冲槽必须清零(否则残留权重会污染输出)、加载前必须全量校验权重名(否则半写状态难以回滚)。
-
代价落在三个地方: 缓冲区显存按
max_loras_per_batch × max_lora_rank × target_modules预占;前缀缓存命中率因 adapter 隔离而下降;max_lora_rank/lora_target_modules在启动时定死,事后放大会失败。
从系列视角看,这一篇补上了「请求身份」这条维度。前面十二篇反复出现的一个主题是「一个批次里有很多不同的请求」,而这一篇增加了一层:这些请求还可能属于不同的模型。下一篇会沿这条线继续走到另一个维度——输入不再是纯文本,而是图像、音频等多模态内容,此时 placeholder token、encoder 预算与 embedding 回填会成为新的调度对象。
参考资料
- SGLang LoRA Serving 官方文档
- SGLang LoRA 管理器源码(lora_manager.py,固定提交)
- SGLang LoRA 内存池源码(mem_pool.py,固定提交)
- SGLang LoRA 批内元数据源码(utils.py,固定提交)
- SGLang Triton LoRA 后端源码(backend/triton_backend.py,固定提交)
- SGLang Chunked SGMV 后端源码(backend/chunked_backend.py,固定提交)
- SGLang LoRA 淘汰策略源码(eviction_policy.py,固定提交)
- SGLang LoRA drain 机制源码(lora_drainer.py,固定提交)
- SGLang SGMV shrink 内核源码(kernels/ops/lora/dense/sgemm_lora_a.py,固定提交)
- SGLang 前缀缓存 RadixKey 源码(mem_cache/radix_cache.py,固定提交)
- S-LoRA 论文:Serving Thousands of Concurrent LoRA Adapters(arXiv:2311.03285)
- Punica 论文:Efficient Multi-Tenant LoRA Serving(arXiv:2310.18547)
- LoRA 原始论文:Low-Rank Adaptation of Large Language Models(arXiv:2106.09685)
- SGLang 源码完全拆解(五):KV 内存池与 RadixCache 的所有权闭环
- SGLang 源码完全拆解(十二):Disaggregation——Prefill 与 Decode 如何拆到两台机器、KV 如何跨实例传输
- vLLM 源码完全拆解(八):MoE 层的前向执行——Router、FusedMoE Kernel 与通信融合
- GQA 完全拆解:分组查询注意力,用 1/8 的 KV 缓存保住 MHA 的质量
- SGLang 源码完全拆解(七):ForwardBatch、TpModelWorker 与 ModelRunner——调度计划如何变成一次 GPU 前向
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



