


流水并行推理完全拆解:五个框架为什么选了五种流水形态
先看一个数字:20 层,两个气泡
一个 80 层的模型铺在 4 张卡上,pp_size = 4,每张卡 20 层。一个 decode step 的 GPU 计算时间 大致就是 20 层的 kernel 时间。如果四张卡严格一次只吃一个微批:卡 0 跑这 20 层时,卡 1、卡 2、卡 3 全在等;卡 1 跑时,其余三张在等。整个前向耗时约 ,每张卡真正干活的时间只有 ,利用率 25%。这就是流水线的第一笔账:气泡。
GPipe 在 2018 年提出的办法(2019 年发表在 NeurIPS)是把一个 mini-batch 切成 个微批(micro-batch),让不同卡同时处理不同微批,把气泡摊薄成「填充」和「排空」两段。它的经典示意图大致如下,左侧是「按层切到四张卡」的朴素模型并行,右侧是切微批之后的流水填充:
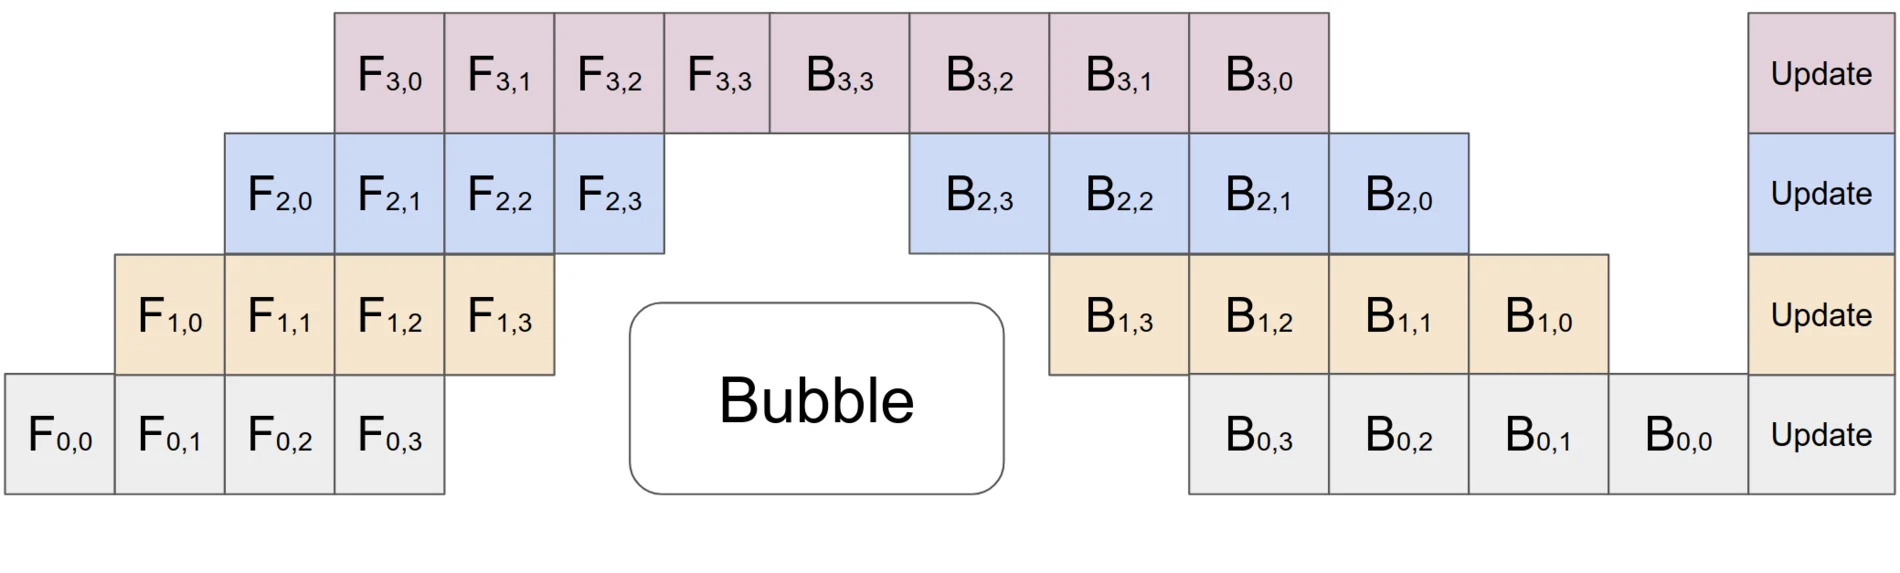
训练侧可以把 开得很大,因为每个 token 只关心自己的梯度。推理侧完全不是这么回事:一个 decode step 里,每个请求只产出一个 token,要切微批,就只能把「不同请求」切成不同的微批。于是气泡不再是一个可以无限摊薄的常数,而是和「这个 step 里有多少个请求」直接绑定的东西——请求少,切不出几个微批,气泡就原样回来了。
这一篇要回答的就是:在推理场景下,五个主流框架(vLLM、SGLang、llama.cpp、TensorRT-LLM、DeepInfer)各自把这个气泡和它带来的约束「接受」到什么程度,又是用什么机制去填它。
先把术语交代清楚。流水并行(Pipeline Parallelism,下称 PP)是把模型的层按顺序切成若干段(stage),每段放在不同的 GPU 上,段与段之间只传层与层之间的中间张量;它和张量并行(Tensor Parallelism,TP,把每一层的矩阵按列或按行切开、多卡协同算同一层)是正交的两条路:TP 每条层都要通信,PP 只在段边界通信。理解 TP 的切法和通信代价,可以回看 vLLM 源码完全拆解(十一):模型并行与 Worker 层。
气泡的算术:为什么推理侧特别难
设段数为 ,段内单微批的 forward 时间为 ,微批数为 ,则整条流水完成 个微批的总时间近似为:
而理想情况下(没有气泡)应该是 。填充阶段 是所有段依次被喂饱所需的时间,排空阶段同样是 。稳态下每个时刻会有若干段在空等,这些空等累计起来就是 的总空闲时间。气泡占比为:
这个式子里没有模型大小,也没有硬件,只有 和 的比值。它对推理侧给出的直接结论是:
- prefill 阶段好办。 一段长 prompt 切成多个 chunk,不同 chunk 可以进不同微批, 的上限大约等于
chunk 数,和 可以是同一个数量级甚至更大,气泡能压到 10% 以内。 - decode 阶段难办。 每个请求一步只出一个 token, 的上限就是「同时跑着的解码请求数」。假设某条服务里稳定有 8 个请求同时在解码、,气泡占比就是 ;只有 4 个请求时是 。
这就是为什么 PP 在推理社区的地位一直很尴尬:训练时它是「拿来就用」的扩展手段,推理时它却要求「先把批做大」。而做大批的代价是显存和时间——decode 单步时间随批增大、单 token 延迟上升。许多部署把它当成「TP 跨不过机间带宽时的妥协」,但一旦选择它,就必须在调度器和数据流两个层面同时做工程补偿。
下面这张图把 与 两种调度的填充/排空关系画在同一时间轴上(只画 forward,不含 backward)。左图对应 vLLM 的「每步单微批」,右图对应 SGLang / TensorRT-LLM 的「多微批在流水里流动」,彩色块代表不同请求:
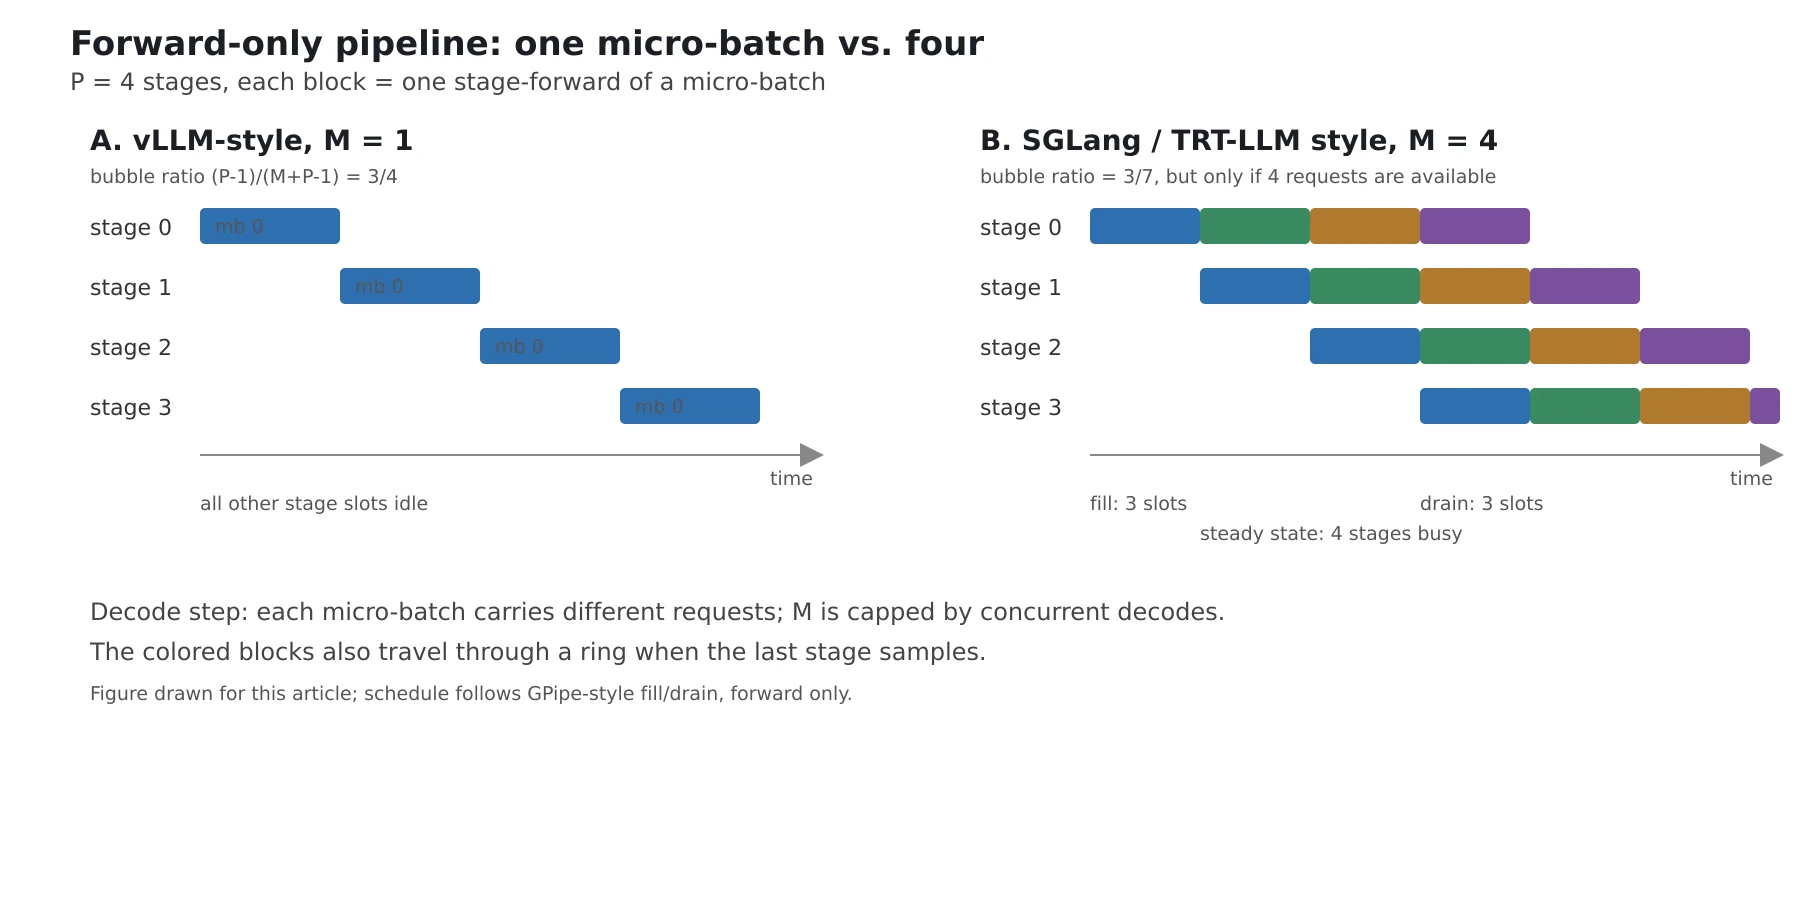
注意右图最后一列:块数从 4 开始递减,这正是排空阶段——前段已经没有新微批可发,只能等尾段把剩下的算完。真实系统里排空会更不规则,因为每个微批里请求的序列长度、是否命中前缀缓存、是否处于 prefill 还是 decode,都会让「一个块」的实际耗时不同。所以公式里的 只能当平均层时间去用,精确的气泡占比要靠 profiling。
接下来按五个框架逐一展开:它们的流水形态是什么、握手协议是什么、KV 和状态如何记账、取消和异常怎么处理。
vLLM:单步流水,调度器当数据中继
vLLM 的 PP 是最「经典」的一种:每个 step 只有一个微批,它依次穿过 个 stage,stage 之间不重叠;调度器在每个 step 发一张表,首段拿不到来自尾段的采样结果,所以尾段采出来的 token 必须由调度器在下一个 step 回传给首段。
每个 stage 是独立进程
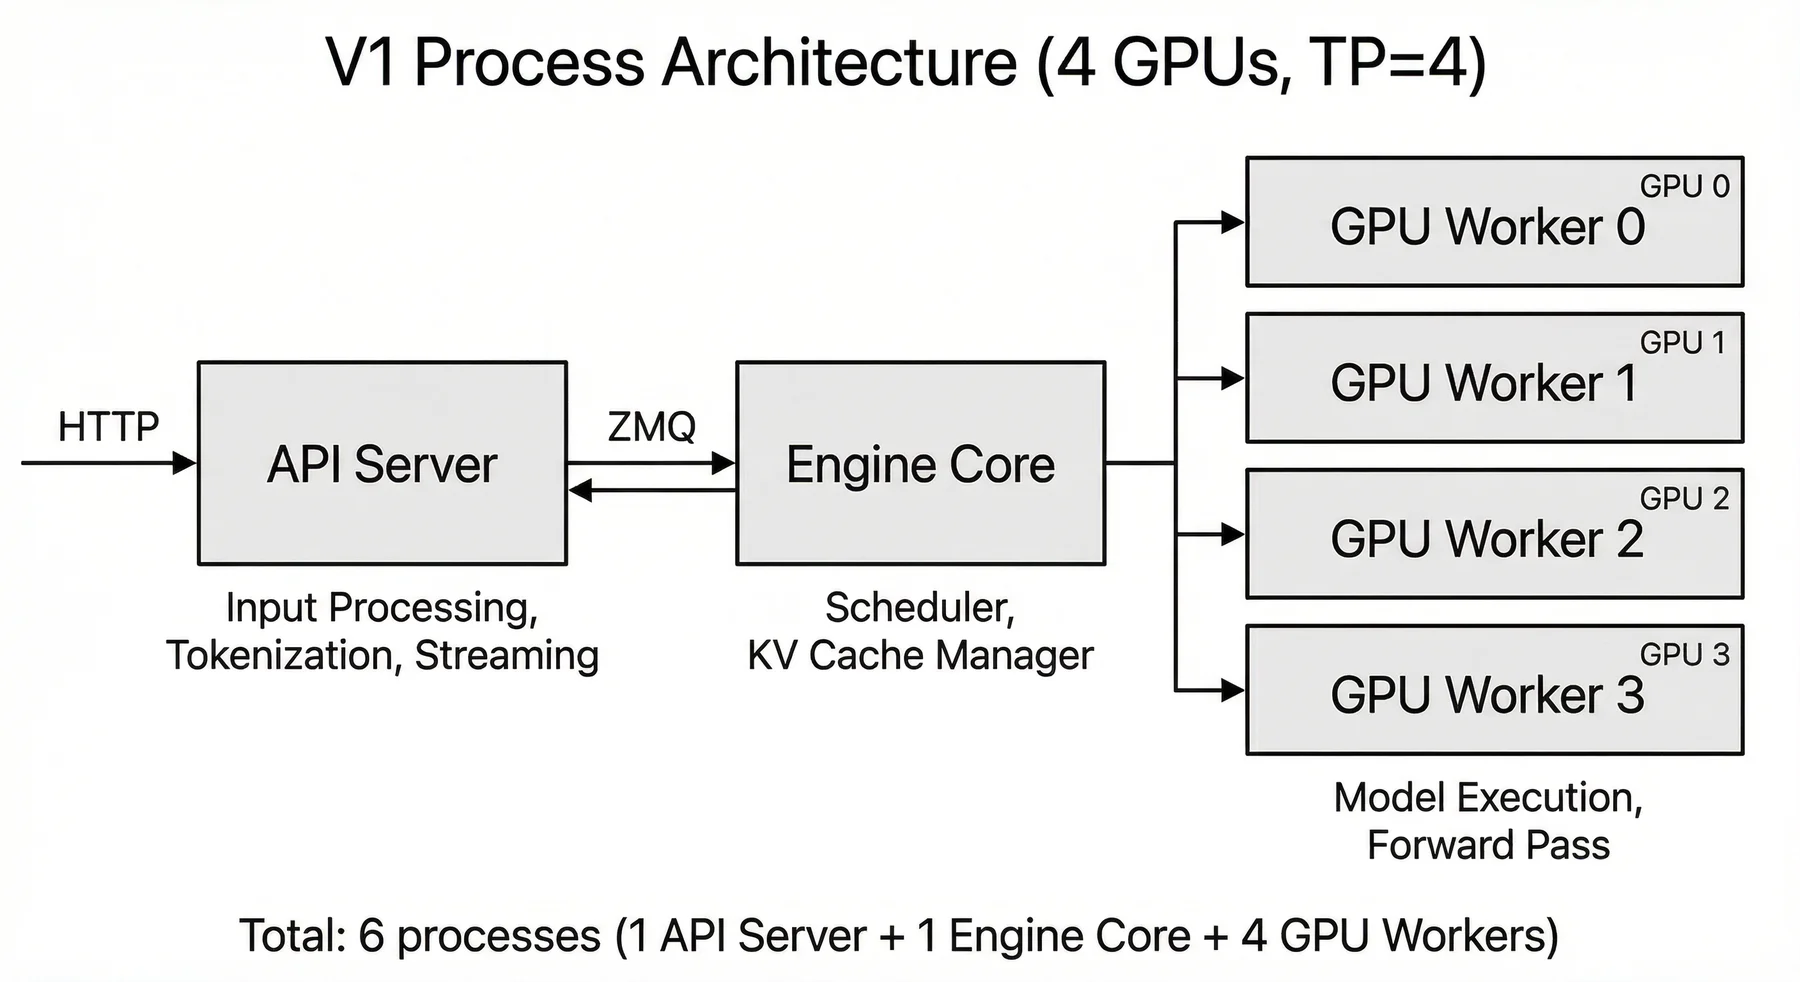
在 V1 架构下,每个 TP×PP rank 都是一个独立的 Worker 进程,进程拓扑由 docs 中的官方示意图说明(下图以 TP=4 为例,展示进程间只通过 ZMQ 传递控制消息、通过共享内存传数据):
PP 只是把 Worker 在「进程维度」上再排一层。层切分由 make_layers 完成:给定 num_hidden_layers、pp_rank、pp_size,get_pp_indices 先均分,余数从倒数第二段往前依次各加一层,最后一段不加——注释里写得很清楚,最后一段常常多一个 norm 层,所以把余数分给中间段能减少最大显存。同时 VLLM_PP_LAYER_PARTITION 环境变量允许显式给出每段层数,用来做手工微调。
执行三步:收、算、发
GPUWorker.execute_model(以 vLLM 0.9.2 为基线)里的逻辑非常短:
# 文件:vllm/v1/worker/gpu_worker.py(简化)intermediate_tensors = Noneif not get_pp_group().is_first_rank: intermediate_tensors = IntermediateTensors( get_pp_group().recv_tensor_dict(all_gather_group=get_tp_group()))
output = self.model_runner.execute_model(scheduler_output, intermediate_tensors)
if (backend != "external_launcher" and not get_pp_group().is_last_rank): get_pp_group().send_tensor_dict(output.tensors, all_gather_group=get_tp_group()) return Nonereturn output if self.is_driver_worker else None三个要点:
- 中间张量是两个数:
hidden_states和residual。 非首段收到这两个,首段用embed_tokens从 token id 算出它们,尾段跑完 norm 再算 logits。 all_gather_group=get_tp_group()是 PP 与 TP 的交界面。 在 TP 切分下,每张卡只持有中间张量的一部分列。如果直接把本地切片用 send 发给下一段,下一段会拿到半截。vLLM 的做法是「发送端只发自己那个切片、接收端做一次 all-gather」:send_tensor_dict里把张量reshape(tp_size, -1)取本 rank 行发出,recv_tensor_dict收下后对 TP 组all_gather(dim=0)拼回完整形状。这样跨段传输量从全量 × 每段一张卡降到1/tp_size × 每段一张卡,代价是接收端的一次 TP 组内 all-gather——而 TP 组在同一段内,带宽本来就足够。- 只有尾段的第一个 TP rank 是
driver_worker。_get_output_rank的注释给了公式:world_size - tp_size,即 PP 最后一层 TP 0 的全局 rank。collective_rpc(..., unique_reply_rank=self.output_rank)只等这一个 worker 的回复,其余 worker 返回None。
调度器变成 token 中继
在 PP 下,首段和尾段之间没有直接的通信链路——它们是不同的 GPU,中间隔着若干段。所以调度器必须承担「把采样结果传回首段」的角色。Scheduler._make_cached_request_data 里有一段关键的注释和对应逻辑:
if self.use_pp: # When using PP, the scheduler sends the sampled tokens back, # because there's no direct communication between the first- # stage worker and the last-stage worker. token_ids = req.all_token_ids[req.num_computed_tokens:req.num_computed_tokens + num_tokens] new_token_ids.append(token_ids)这一行意味着:每一步,调度器要把「自上次计算以来新产生的 token」额外塞进 CachedRequestData,让首段的 input_ids 有东西可查。这一步其实是 PP 推理最大的额外成本之一——CPU 侧每步多一个 O(请求数 × 新 token 数) 的拷贝,并随请求规模线性增长。
一次取消会穿过几张卡
PP 下取消请求的起点在 API server。vLLM 的 OpenAI server 用 with_cancellation 装饰器包住 handler:它同时监听 http.disconnect 与 handler 本身,任一先完成就取消另一个任务;流式响应的生成器随后收到 asyncio.CancelledError 或 GeneratorExit。AsyncLLM.generate 在 except (asyncio.CancelledError, GeneratorExit) 分支里做三件事中的第一件:await self.abort(request_id)。
abort 的链路是:
AsyncLLM.abort -> OutputProcessor.abort_requests(...) # 释放前端 RequestState / LoRA 状态 -> EngineCore.abort_requests_async(...) # 跨进程(ZMQ) -> Scheduler.finish_requests(ids, RequestStatus.FINISHED_ABORTED) -> _free_request -> _free_blocks -> kv_cache_manager.free(...)Scheduler.finish_requests 的注释写的是设计意图:它处理来自调度器外部(比如 API server)的结束信号,把请求从 running 或 waiting 队列里移除,再走和正常结束相同的 _free_request 路径。也就是说,取消没有独立的清理路径,而是复用「完成」的路径。
PP 让这件事变复杂的地方在于:EngineCore 只有一个、调度器只有一个,但 kv_cache_manager.free 的块释放指令必须下发到每一个 rank 的 KV 池。vLLM 用同一个块编号空间和 collective_rpc("initialize_cache", ...) 建立起来的一致性,让这一步成为可能;但如果在 abort 发生之前,某个 Worker 正在 execute_model 里阻塞(例如某一段的 NCCL 发送还没配对上),调度器的下一条 RPC 就要等这一段返回。VLLM_EXECUTE_MODEL_TIMEOUT_SECONDS 就是为这种情况留的兜底。这类「控制面请求被数据面阻塞」的问题,在单卡里根本不存在。
另外,如果请求处于 P/D 分离、KV 正在通过 connector 传输,_free_request 会先问 connector 是否要延迟释放(delay_free_blocks),因为接收端的写入还没完成。PP 与 P/D 叠加时,这段窗口还要再乘以段数。
统一的 KV 布局靠 unify
PP 的另一个隐蔽难点在初始化。每张卡的显存不同、每段的层数和参数不同,所以各自测出来的「可用于 KV 的显存」不同。调度器只有一份 num_gpu_blocks、一份 kv_cache_config,所有 worker 必须用同一份块表。EngineCore._initialize_kv_caches 的做法是:
kv_cache_configs = [get_kv_cache_config(vllm_config, spec, mem) for spec, mem in zip(kv_cache_specs, available_gpu_memory)]// 共享中央调度器要求所有 worker 的 kv_cache_config 一致unify_kv_cache_configs(kv_cache_configs)unify_kv_cache_configs 做的事只有两件:先断言每个 worker 的 KV cache group 在 kv_cache_spec 上完全一致(层数、head 数、dtype、页大小),再把所有 worker 的 num_blocks 改成全体最小值。注释特意说明,并不需要真的把张量缩小——只用前 num_blocks 块就行。所以张量的形状是各卡各自的显存预算算出来的,而可用的块编号区间是全流水线统一的最短板。这是「显存最紧的那段决定全流水线的 KV 容量」的具体落地:PP 部署时,首尾段常见「多一两个 emb/norm/lm_head」的额外显存,而中间段最空,统一后中间段的 KV 池会跟着最紧的那段缩水。
为什么 vLLM 没做多流重叠
在 v0.9.x 的实现里,GPUWorker.execute_model 是同步的:先 recv 再 compute 再 send,每个 worker 在一个 step 里只处理一个微批。它没有 SGLang / TensorRT-LLM / llama.cpp 那样的「多微批在流水里流动」机制。这是设计取舍:V1 的核心哲学是「调度器掌握全部状态、worker 无状态执行」;要让 worker 自己跑流水,worker 就必须自己持有并推进多个微批的批次状态、等待 token、处理取消,这与「worker 只被 RPC 驱动」的架构直接冲突。
代价就是前面那道算术:M=1,气泡占比 ;decode 阶段除了最后一个 stage,其余 stage 的时间几乎全空。
SGLang:微批流水的调度器——同一段里排多个批
SGLang 的选择是把流水「搬进调度器本身」。每个 PP rank 上都有一个完整的 Scheduler 进程,它同时维护 pp_loop_size 个批次槽。
环形回传与统一调度
init_pp_loop_state 里:
self.pp_loop_size = get_parallel().pp_size + get_parallel().pp_async_batch_depthself.mbs = [None] * self.pp_loop_sizeself.running_mbs = [ScheduleBatch(reqs=[], batch_is_full=False) for _ in range(self.pp_loop_size)]注意 + pp_async_batch_depth 这一项:尾段可以多缓存若干批还没处理完的结果,把「GPU 正在算下一批」和「CPU 正在处理上一批」错开。event_loop_pp 的事件循环注释是一份非常漂亮的设计说明:
Stage Precv ith req from previous stagerecv ith proxy from previous stagerun ith batchrecv prev (i+1)%mb_size th outputsprocess batch result of prev (i+1)%mb_size th batch (can be run in parallel with the curr batch GPU computation)send ith req to next stagesend ith proxy to next stagesend current stage's outputs to next stage循环的每一拍做「一次接收 + 一次发射 + 处理上一拍的结果」。请求对象本身也沿着流水一路传下去:第 0 段收到客户端请求后,除了把 hidden state 发给第 1 段,还必须把请求的元数据(recv_reqs)也发给第 1 段,否则第 1 段的调度器根本不知道「这个 hidden state 属于哪个请求、该写哪个 KV 槽」。
这正是 SGLang PP 最微妙的部分:它把整个请求生命周期复制到了每一段。 每段都要有自己的 Req、自己的 ScheduleBatch、自己的 KV 分配、自己的 tree_cache;只有「采样」发生在最后一段,采样出的 token 再沿 output 环回。
请求复制带来的第一个后果是前缀缓存不再是一份全局状态。每段的 tree_cache 只缓存自己那几层的 KV,命中判定也由本段调度器独立完成。多数时候各段的请求顺序一致,radix 树会同步生长;但一旦某段的批组成因为显存压力或抢占发生变化,它可能提前淘汰某个前缀节点,而另一段还留着。于是同一个请求可能在第 0 段命中 8 个块、在第 3 段只命中 5 个块。正确性不受影响(每段只重算自己缺的那几层 KV),但性能上会出现「部分 stage 多做了一段 prefill」的隐性浪费。这是 PP 与 radix cache 组合时最容易被忽略的账。
第二个后果是取消要沿每一段传播。客户端 abort 时,AbortReq 和普通请求一样被 ingest_requests 收进来,随后由非最后一段继续转发给下一段;每一段的 abort_request 都要同时扫 waiting queue、grammar queue、chunked req、running batch 以及 P/D 队列。少扫一处,就会留下一个永远等不到结果的 Req,最终把 has_unfinished 卡成 true。
pp_loop_size 比 pp_size 多出的槽位是给流水环的缓冲:它允许最后一段的 GPU 在算下一批时,CPU 还在处理上一批结果。深度为 0 时,尾段与 rank 0 之间没有额外的环缓冲,一次调度抖动就可能让尾段停下来等;深度太大时,last_rank_comm_queue 会囤积大量 PPProxyTensors,host 内存和 event 数量都会上升。它不是越大越好,实践中常从 1–2 试起,按实际抖动调整。
采样结果的环形回传
最后一段不能直接对首段发送采样结果——首段和尾段之间可能隔着多条链路,每一段有自己的 scheduler 在运行。SGLang 的做法是让 output 张量沿 PP 环单向走:最后一段把 next_token_ids、logprobs 等打包成 PPProxyTensors,发给 rank 0;rank 0 先处理自己要消费的那一份,再原样转发给 rank 1,依此类推,直到最后一段之前的那一段。每个 output 都带微批 id 和 ready event,每一段只在自己对应的槽位上消费,消费完就继续往下传。源码里 _pp_send_output_to_next_stage 的两个分支分别处理「最后一段发给 rank 0」和「非最后一段转发上一轮 output」,注释写得很直白:send the outputs from the last round to let the next stage worker run post processing。
_pp_launch_batch 把本段 forward 的结果交给 GenerationBatchResult,里面同时有 hidden 代理张量和(尾段才有的)采样结果。TpModelWorker.forward_batch_generation 对最后一段跑 logits + 采样,对非最后一段只返回 pp_hidden_states_proxy_tensors——代码里是同一个函数,用 pp_group.is_last_rank 分支区分。
用动态分块填 TTFT 的气泡
SGLang 的官方文档把 PP 的动机明确写成了「超长输入的 TTFT」:一个 128K 的 prompt 只放在一个 stage 上,prefill 就是一条串行的 128K 长链。PP 可以让不同 stage 同时处理同一个请求的不同 chunk,理论上把 TTFT 降到接近 。
但固定 chunk 会让 prefill 的气泡重新变得严重:Transformer 的 attention 部分计算量随前缀长度 增长,同样 chunk 大小,后面的 chunk 更慢,气泡会在 stage 之间积累。SGLang 引入的 --enable-dynamic-chunking 的核心条件就是文档里那行公式:
即「让下一个 chunk 的运行时恰好等于初始 chunk 的运行时」。它先 profile 若干不同 ITL 的请求,把累计运行时间拟合为长度的二次函数,反过来解 。计算出的值还不直接用,会向下取整到 max(page_size, 64) 的倍数——因为 chunk 边界必须落在页粒度上,否则 KV 页分配和 attention 内核都对不上。这个取整细节可以对照 KV Cache 的页粒度 理解:SGLang 的 KV 池按 token 槽位寻址(分配仍以页为单位),但 chunk 边界上要配合 attention backend 的页对齐要求。
另外一条文档里少见的工程经验是层切分顺序:在层数不能被 pp_size 整除时,「把多出来的层放在偏后的段」往往比放前面更好,因为后段的 stage 在等待前一段的结果时 GPU 是空的,给它多一层可以把它填满。给出的例子是 DeepSeek-V3.1、pp_size=4 时 SGLANG_PP_LAYER_PARTITION=15,15,15,16 优于 16,15,15,15。
限制条件
SGLang PP 的可用面比看起来窄,而且这些限制在启动参数校验里是硬断言,不是文档建议:
- 不能和 overlap scheduler 同时开。
check_pipeline_parallel_compat的第一条就是assert cfg.disable_overlap_schedule;PP 自己已经用多微批事件循环做重叠,再叠一层 overlap scheduler 会让两套「延后提交结果」的时序互相打架。 - 投机解码只支持非多层 EAGLE,而且默认的 PP + spec 路径只允许在 P/D 分离的 prefill 节点上使用;打开
SGLANG_ENABLE_PP_SPEC后又不能和 attention DP 同时用,因为「每个 stage 都要重建相同的 verify 输入」这个前提会被 DP 按 rank 切分破坏。 - DeepSeek-V4.1 在 SGLang 里目前直接不支持 PP。
deepseek_v4_hook.py的 unsupported 列表把pipeline parallelism与 two-batch overlap、HiSparse 等特性并列,启动时直接报错。 - NPU 上的 PP 还受内存分配器约束:
init_zbal_on_npu在pp_size > 1且不是 zbal mix 模式时直接报only zbal mix mode support pp_size > 1!。这是平台内存管理带来的限制,不是 PP 语义的一部分。 - P/D 分离下的 PP 仍然需要两个方向的共识:bootstrap 的 rid 列表要从前向后传,release 的 rid 列表要反向传;后段只保留与前段完成集合的交集,避免某一段提前释放、另一段还在传。
llama.cpp:单进程内,后端与微批
llama.cpp 的 PP 名字最容易误会:它不是多进程的流水并行,而是同一个 llama_context 里多个 ggml backend(多个 CUDA device)之间的流水执行。
什么时候开启
llama-context.cpp 里有一段非常直接的开关逻辑:
// enabling pipeline parallelism in the scheduler increases memory usage, so it is only done when necessarybool pipeline_parallel = model.n_devices() > 1 && model.n_gpu_layers() > model.hparams.n_layer_all && model.split_mode() == LLAMA_SPLIT_MODE_LAYER && cparams.offload_kqv && !model.has_tensor_overrides() && cparams.moe_cache_size == 0; // not supported by the MoE cache逐条读懂:多于 1 个设备;所有层都上了 GPU(n_gpu_layers 超过总层数);按层切分(不是 row 模式);KV 也在 GPU 上;没有 -ot 张量覆盖;没有开 MoE 缓存。另外还要求每个后端都支持 async compute 和 event 能力。若 compute buffer 分配失败,会静默回退到非流水模式——这是社区里一个常被忽略的细节:日志里只会出现一句 compute buffer allocation failed, retrying without pipeline parallelism。
ggml 里的多拷贝
ggml 的 ggml_backend_sched 里,n_copies 就是流水深度:
sched->n_copies = parallel ? GGML_SCHED_MAX_COPIES : 1;parallel=true 时每个 backend 有多个「张量拷贝槽」,cur_copy / next_copy 在每个图分配时轮转。ggml_backend_sched_compute_splits 在每个 split 开始前只做两类同步:若本 split 没有输入、且紧接着的是另一个 backend,它会等上一个 backend 完成(因为分配器可能复用缓冲);拷贝跨 backend 输入时,它等的是目的 backend 同一 copy 槽位的上一轮 compute,而不是上一拍。正是这个「按槽位而非按拍」的 event 语义,让相邻 split 的输入拷贝与计算可以重叠:第 个 copy 的输入拷贝,等的是第 个 copy 的 compute 完成。
// 拷贝输入时,只等「目的 backend 同一 copy 槽位」的上一轮if (sched->events[split_backend_id][sched->cur_copy] != NULL) { ggml_backend_event_wait(split_backend, sched->events[split_backend_id][sched->cur_copy]);}这套机制的收益和代价都很明确:收益是单进程、零跨进程通信,所有 backend 共享同一份 KV cache 与同一套图;代价是「一份图有 份输入/中间缓冲」,compute buffer 占用成倍上升,所以只在「确实需要」时才开启,而且一旦分配不下就悄悄关掉。
对推理真正意味着什么
从模型看,它就是「GGUF 模型太大、单卡放不下、两台机器用 -sm layer 各拿一半」的部署形态:进程 0 是 rank 0,另外几个进程负责层。llama-server 这边只看 slot 与 batch,PP 完全藏在 llama_context/ggml 里。所以:
- 它没有专门的请求握手协议,也没有调度器层面的微批——单进程内就是一张图跑完一段、交给下一个 backend。
- 它的「微批」只存在于图内部:不同 backend 的 split 之间相互重叠,但同一请求的前向还是从输入层到输出层依次执行,不存在「把不同请求放到不同 stage」。
- 它的收益主要来自计算与跨卡拷贝的重叠(拷贝与计算被分进不同 copy 槽),而不是 decode 气泡;对 decode 阶段的低批场景,帮助极其有限。
关于 ggml 的图、内存分配与跨 backend 切图,可以回看 llama.cpp 源码完全拆解(二):ggml 计算图与内存分配器。对后端 kernel 的拆解可以参考 llama.cpp 源码完全拆解(七):后端与 Kernel。
TensorRT-LLM:把微批状态放进 executor
TensorRT-LLM 的 PyExecutor 是五个框架里 PP 设计最接近「训练流水」的:它把一个 BatchStatePP 数组当作流水槽,每个微批有自己的 schedule、sample state 和 send handle。
流水槽与环形采样状态
# 同步 relay(默认)下,微批槽数等于 PP 段数;异步 relay 会扩到 max(pp_size, 1024)self.num_micro_batches = self.dist.pp_sizeself.micro_batches: List[BatchStatePP | None] = [None] * self.num_micro_batchesself.send_handles = [None] * self.num_micro_batches每个微批都对应一个 BatchStatePP(BatchState 加一个 microbatch_id)。一轮循环里,每一个微批都要:拉取自己这一轮的调度输入 → 发起 GPU 前向 → 把 sample state 交给环上的下一个 rank → 处理「此前某个微批」回来的 sample state。源码里的注释把环形方向写得很直白:
send/recv chain: (pp_size - 1) -> 0 -> 1 -> ... -> (pp_size - 2)offset = -1 if self.dist.is_last_pp_rank else (1 - self.dist.pp_size)executed_microbatch_id = (microbatch_id + offset) % self.num_micro_batchespp_size - 1 是最后一段,它从下一环位「拉」;其它 rank 则往后 1-P 个位置取。源码注释把方向写成「」,含义是:本 rank 在这一拍处理的,是环上前 拍从尾段发出、正好绕回到自己槽位的那一批采样结果。偏移量之所以用取模,是为了让「微批 id」和时间拍号在两个不同的计数空间里对齐。
为什么「同步中继」不是「异步中继」
默认配置里 pp_async_broadcast_sample_state = False,注释解释得极其克制:
"1": a background thread relays them, overlapping with forward,but it needs the GIL and can be starved into a PP deadlock by GIL-holding native calls."0": relay inline.异步线程中继可以更好地和 forward 重叠,但它需要 GIL;一旦某个 rank 正在某个 native call 里持有 GIL,采样状态的中继就会被饿住,流水线就死锁。所以默认是在 executor 线程里同步中继——用少量 CPU 时间换确定性。异步模式需要更大的微批窗口(MIN_ASYNC_MICRO_BATCH_NUM = 1024)来吸收传输延迟,这本身就是一笔不小的 host 内存。
PP 下的取消与抢占:两个「等一等」
取消在 PP 下比单卡复杂得多,因为同一个请求的不同 step 可能还留在不同位置的 micro_batches 槽里。_try_cancel_request 的注释里指出了三种「暂时不能取消」:
- KV connector 还在做未完成的 prefix load。
release_unstarted_prefix_loads()先释放还没开始的装载;defer_load_termination()表示装载还在进行,取消要等它结束。 - 请求是一个「抢占受害者」,正在等 connector 归还页。 此时调用
finish_by_reason(CANCELLED)会被后续的 preemption completion 撤销——因为抢占结束时,KV 管理器会把该请求放回 context 状态等待重新 prefill。源码的处理方式是「挂起取消、等 completion 之后再应用」,并把请求 id 留在canceled_req_ids里下轮重试。 - P/D 分离下该请求正在传输中。 如果传输管理器支持「in-flight cancel」,就触发传输取消;否则继续等。
这些判断共同说明一件事:所以「取消」在 PP 里不是一次写完的标记位,而是一个要等每个「还持有该请求状态」的组件都归零才收敛的过程。TensorRT-LLM 的 canceled_req_ids 列表和「只有真正能取消时才从列表移除」的策略,本质上是把「取消」实现为「可重试的收敛过程」。
KV 管理与 P/D 分离
TensorRT-LLM 的 PP 在 KV 上是「每段各自持有属于自己层的 KV 页」,页分配在每段独立进行但尺寸由全局统一配置决定;在 P/D 分离下,PP 与传输层的交互通过 kv_connector_manager 和 kv_cache_transceiver 两个抽象完成。这里的细节可以回看 TensorRT-LLM 源码完全拆解(十六):P/D 分离与 KV 传输;并行拓扑和通信层可以参考 TensorRT-LLM 源码完全拆解(十一):并行拓扑与通信。
一个有意思的生产倾向
TensorRT-LLM 对 PP 还有几处一票否决:conditional disaggregation 的 remote tail replay 要求 pp == cp == 1,encoder-decoder 模型也拒绝 pp_size > 1。这不是「PP 不好」,而是这些优化默认「某个请求的 KV 只在一个 rank 上」,PP 一层层切开后这个前提不再成立,实现方宁可禁止而不是逐个改。这与 vLLM 用 unify KV 和中继 token 来「补丁化」支持 PP 的做法,是同一道理的不同表达:不是不支持,而是支持它就要在每一层抽象上都补一套分支。
DeepInfer:在架构上就不做 PP
DeepInfer 是一个有意思的反例:它在并行拓扑里没有流水并行。
在 deepinfer/model_executor/parallel_utils/parallel_state.py 里,ParallelProcessGroup 只有 dp、cp、ep、enp(Engram 并行)、world、local 这几组,没有 pp 字段。create_process_groups 用一个很说明问题的 einops 写法来分 rank:
ranks = torch.arange(max(enp_size, dp_size * cp_size))dp_ranks = rearrange(ranks, "(replica dp cp) -> (replica cp) dp", dp=dp_size, cp=cp_size)cp_ranks = rearrange(ranks, "(dp cp) -> dp cp", cp=cp_size)ep_ranks = rearrange(ranks, "(edp ep) -> edp ep", ep=ep_size)enp_ranks = rearrange(ranks, "(replica enp) -> replica enp", enp=enp_size)坐标轴只有 replica、dp、cp、ep、enp 这几个名字,层维度根本不在名字里。ParallelConfig 也印证了这一点:model_parallel_size = context_parallel_size,world_size = max(model_parallel_size * data_parallel_size, engram_parallel_size)——「模型并行」在这里只有上下文并行一种理解,没有「把层切给不同 rank」的配置项。
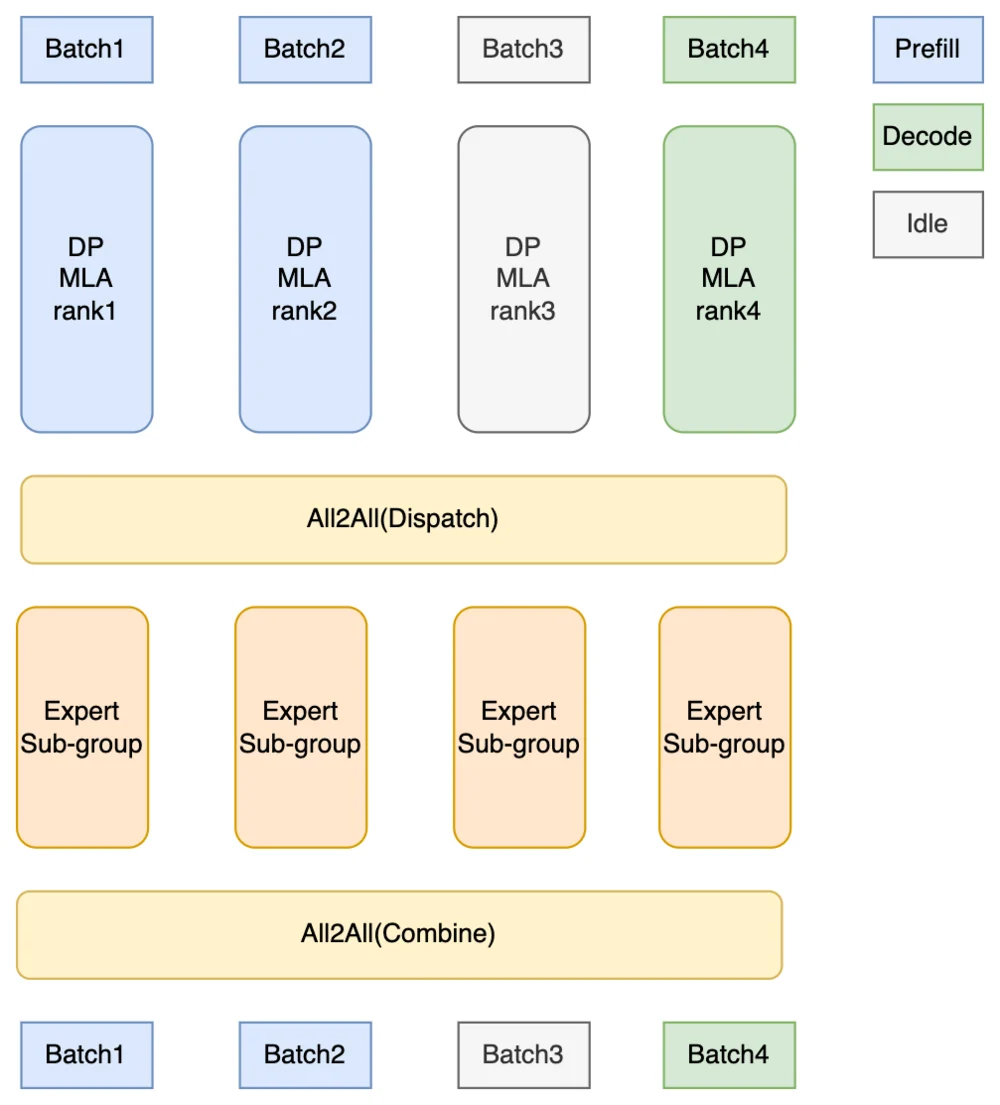
(replica dp cp) / (edp ep) 重新推导,详见站内拆解)这条路线和 SGLang 的 --enable-dp-attention 是一脉相承的:对 MoE 模型来说,最贵的通信是专家并行的 all-to-all,最不能被「按层切段」破坏的是隐藏态(hidden state)在多机之间的字节吞吐——而流水恰恰是把隐藏态一层一层地跨机搬运。DeepInfer 的选择是把跨机的通信留给 EP/CP,把注意力做数据并行,让每个 rank 都拥有完整的层堆叠,于是:
- 没有流水气泡,decode 时每个 DP rank 都在跑自己那批请求的全部层(MoE 部分再按 EP 切专家);不存在「前一段算完才能算下一段」的串行边界。
- 不需要把采样结果沿环回传,因为没有层的切分,同一组 rank 完成全部层,最后的 logits 在本地就能拿到(若词表并行,再做一次 gather)。
- KV 与状态的管理只面对一套拓扑:DP Attention 下注意力 KV 跟着请求所在的 DP rank,EP 下 MoE 权重按专家切开,状态槽(SWA)和 MLA latent 都在同一 rank 的本地池里。
ParallelConfig 里还有两个细节值得抄下来:
# data_parallel_size 为 0 时,由 EP 与 CP 反推if data_parallel_size == 0: data_parallel_size = max(1, expert_parallel_size // context_parallel_size)self.model_parallel_size = self.context_parallel_sizeself.world_size = max(self.model_parallel_size * data_parallel_size, self.engram_parallel_size)# EP 必须整除「模型并行 × 数据并行」assert (self.model_parallel_size * self.data_parallel_size) % self.expert_parallel_size == 0world_size 的表达式里只有 model_parallel_size * data_parallel_size 与 engram_parallel_size 两项,没有一个 pp_size 因子;再引入 PP,就要么把 model_parallel_size 解释成 cp * pp(那 CP 和 PP 的语义会混在一起),要么新增一个维度并重写所有 assert。这不是「忘了加」,而是这套 rank 坐标系从一开始就按「不切层」设计的。
长上下文怎么办?DeepInfer 的答案是 CP,而不是 SGLang 那种「把 prompt 切成 chunk 放进流水」。CP 把序列维切开,每个 CP rank 处理一段 token 的注意力,并在需要全局 KV 时做收集;它降低的是单 rank 的序列长度,不是层数。站内 DeepInfer 源码拆解(二十五):上下文并行 CP 全链路 拆过 zigzag 切分、mirror 布局与 KV 收集的细节。两者的差别可以压成一句话:PP 用「层」换显存,CP 用「序列」换显存;前者引入流水气泡,后者引入注意力里的 KV 收集通信。 DeepInfer 选了后者,因为它的目标负载是长上下文 + 大 MoE,而不是「单机放不下整个模型」。
这个选择的代价是:当网络带宽不足以支撑 EP all-to-all 时,DeepInfer 没有「再退一步」的 PP 可用;以及在一个「MoE 不大、EP 通信量很小、但单机内存放不下」的模型上,PP 原本是唯一可行的扩展方式,DeepInfer 这条路走不通。它是一家公司为自家模型(DeepSeek V4 系列,MoE 占比高、专家数多)做的特化,而不是一个通用的并行策略框架。DeepInfer 的完整并行拓扑拆解可以看 DeepInfer 源码拆解(十三):DP Attention 与 Wide-EP;通信缓冲的细节可以看 userbuffer 与对称内存 那一篇。
层切分:余数放在哪一段
流水真正的第一行代码不是通信,而是「第几层到第几层」的算术。vLLM 的 get_pp_indices 与 SGLang 文档给出的建议看起来都只是在分配余数,但背后是两种不同的显存权衡。
vLLM 的默认规则:先 num_hidden_layers // pp_size 均分,余数 r 从倒数第二段开始往前分配:
layers_per_partition = num_hidden_layers // pp_sizepartitions = [layers_per_partition for _ in range(pp_size)]if remaining_layers := num_hidden_layers % pp_size: for i in range(2, remaining_layers + 2): partitions[-i] += 1注释写得很清楚:最后一段常常多一个 norm 层,首段和尾段还有 embedding 与 lm_head,所以余数优先给「既没有输入层也没有输出层」的中间段,减少最大显存。VLLM_PP_LAYER_PARTITION 可以覆盖这个默认值,但要求个数等于 pp_size、总和等于层数。
SGLang 文档给的经验恰恰相反:DeepSeek-V3.1 在 pp_size=4 时 15,15,15,16 比 16,15,15,15 更好。理由不是显存,而是流水填充:最后一段在等待前几段时最闲,多给它一层可以把它填满;而第一段如果多一层,后面的段都要多等一拍,气泡会被放大。
这两种建议不矛盾,它们优化的是不同的目标:
- 显存优先:vLLM 的默认策略让最大显存最小,适合「每张卡都卡在 95% 占用」的部署。
- 气泡优先:SGLang 的建议让每段的计算时间尽量相等,适合「显存有富余、吞吐是瓶颈」的部署。
实际调参时可以两种都试一次:把 VLLM_PP_LAYER_PARTITION 设成偏前的和偏后的两个版本,各跑一遍 decode 吞吐。层数差 1 在 80 层模型里只差 1.25% 的计算,但气泡差异可能超过 5%。
还需注意:首尾段的额外参数不是小事。以 、词表 32K 为例,lm_head 在 FP16 下约 256 MB;换成 、词表 128K,则是约 1.8 GB。embedding 与它同量级。在 很大、单段层数很少时,这两块会成为该段显存的主要构成,不能按「每段层数相等」来估。这也是为什么 SGLang 文档的「后段多一层」建议需要配合实测——首段没有 lm_head、尾段没有 embedding,它们的基线显存本来就不一样。
把账算细:字节、延迟与气泡
抽象地说「气泡」很容易,落到部署上要回答三个具体问题:每一步搬多少字节、每段多出多少延迟、 到底该选几。
每步搬多少
vLLM 的 PP 段边界传两个张量:hidden_states 和 residual。设 hidden 维度 、dtype 2 字节、批内请求数 ,单边界单步的字节数是:
这是逻辑字节量;在 TP 下,send_tensor_dict 的发送端只发自己那一份切片,实际每卡线速还要除以 tp_size,接收端再用 TP 组内的 all-gather 补回完整形状。以 DeepSeek 系列的 为例,单个请求单边界是 字节,约 28 KiB; 时约 896 KiB, 时有 3 个边界,共约 2.6 MiB/step。若 decode 跑到 50 step/s,单条链路的平均带宽约 131 MiB/s——对 NVLink(数百 GB/s)甚至 100 GbE(约 12.5 GB/s)都不算大。PP 的难处不是带宽,而是每一步都要跨段往返一次的固定延迟。 一次 send/recv 的 kernel launch、NCCL 建链与 event 等待,往往是几十微秒量级;三段就是上百微秒,而 decode 单步本身可能只有几毫秒。 越小,这份固定开销占比越高。
对比 TP:按 ring all-reduce 的经典结论,单次 all-reduce 每个 rank 的收发量约为 ( 是被归约张量的字节数)。TP=8、80 层、每层一次对 hidden 的 all-reduce,把 hidden 字节记为 ,则单 token 每层每 rank 约 字节, 字节,80 层累计约 2 MiB/token/rank。PP 在 时只搬 84 KiB/token,带宽账远小于 TP;但 TP 的 all-reduce 可以和下一层计算重叠,PP 的段间传输却卡在「上一段算完、下一段才能开始」的串行边界上。省带宽不等于省时间,这是 PP 在 decode 上经常「账面上很划算、体感上不划算」的原因。
气泡表
把 展开成一张表, 用并发解码请求数代入:
| \backslash | 4 | 8 | 16 | 32 | 64 |
|---|---|---|---|---|---|
| 2 | 20.0% | 11.1% | 5.9% | 3.0% | 1.5% |
| 4 | 42.9% | 27.3% | 15.8% | 8.6% | 4.5% |
| 8 | 63.6% | 46.7% | 30.4% | 17.9% | 9.9% |
这张表给出的工程结论很直接:在 时,若 decode 并发长期低于 ,PP 的气泡会达到或超过 30%,此时用 PP 扩吞吐基本是亏的; 的临界点略低,但趋势相同。 反过来,若并发能稳定在 以上,气泡压到 20% 以内,PP 才具备和 TP/EP 比较的资格。
prefill 的 TTFT 账
设 prompt 长度 、chunk 大小 、单 token 的单层计算时间 、段数 。不分块时,prefill 串行时间约 (因为要跑完所有层);分块后,理想情况下不同 chunk 在不同段同时推进,总时间约:
相对串行的加速比是:
时接近 倍;但 太小会让每个 chunk 的 kernel 启动、KV 页分配、调度开销占比上升。SGLang 文档建议从 4K 起步逐步增加,并给出了 DeepSeek-V3.1 在 H20 上 4K 固定 chunk 的基线,以及动态分块初始 12K、平滑因子 0.65 的调参组合。这些数字不是「最优值」,而是「在 128K 输入、4 节点、TP=8/PP=4 这个具体配置下」测出来的;换模型、换卡、换输入长度都要重测。
怎么选
一个可以直接套的流程:
- 先算单段显存:。其中 是权重总字节, 是激活与 workspace。若任何一段超过单卡上限,先降 或换更小的量化,而不是硬上 PP。
- 再看 decode 并发:若峰值并发 ,说明 PP 的气泡会长期偏高;此时要么把请求攒批(提高 TTFT),要么改用 TP/EP。
- 最后看互联:段间传输走的是跨机网络还是 NVLink。跨机时每段边界都可能经过一层交换机,固定延迟比带宽更值得关注;同机多卡时 PP 通常不如 TP,因为 TP 的 all-reduce 走 NVLink,而 PP 白白浪费了同机带宽。
- 层数不能整除时,按「哪一段最缺显存/最闲」来分:vLLM 默认把余数给中间段(最后一段常带 norm、首尾段带 embedding 与 lm_head),SGLang 文档则建议把多出来的一层给靠后的段,因为后段在等前段时更闲。两种策略没有绝对优劣,取决于模型首尾是否有额外参数,以及部署更在意显存峰值还是气泡。
五家放在一起:一张表看清差异
| 框架 | PP 粒度 | 微批机制 | 中间传递物 | 采样结果回传 | 调度器与 worker 的关系 | 典型用途 |
|---|---|---|---|---|---|---|
| vLLM | 进程级,每 rank 一个 Worker | 无(每步单微批) | hidden_states + residual,经 TP all-gather | 调度器把 token 塞回 CachedRequestData | 调度器居首、worker 无状态 | 多节点、层切分后的标准部署 |
| SGLang | 进程级,每段一个完整 Scheduler | 有,pp_loop_size = pp_size + async_batch_depth | 请求对象 + hidden proxy tensors | 环回 output 张量 | 每段都有状态、各自推进 | 128K 超长上下文、跨节点 TP 瓶颈 |
| llama.cpp | 同进程内多 backend | 无(图内的 compute 与拷贝重叠) | ggml 张量(多 copy 槽) | 不涉及(单进程) | 上下文独占 | 双/多卡本地部署、GGUF |
| TensorRT-LLM | executor 内的微批槽 | 有,默认 num_micro_batches = pp_size | sample state + schedule | 环形 relay(默认同步) | executor 持有全部批次状态 | 生产级多节点、P/D 分离 |
| DeepInfer | 没有 PP(DP Attention + Wide-EP + CP) | — | 请求在 DP 组间分片;MoE 的 token all-to-all | 不涉及 | 每 rank 持有完整层堆叠 | DeepSeek MoE 大规模部署 |
这张表最重要的一列是「调度器与 worker 的关系」:
- vLLM 有状态的是调度器,worker 不持有请求状态——所以它能靠调度器做中继,但代价是每步 O(N) 的 token 拷贝。
- SGLang 的每段都是全量调度器——所以每段都持有请求、都能自行推进,但代价是请求元数据要在流水上「复制」一遍,状态一致性边界变多。
- TensorRT-LLM 是中间态:executor 是唯一的控制面,但微批槽让 executor 承担了「时间轴」的职责,于是取消、抢占的「延期应用」成为必需。
- DeepInfer 索性不做——用 DP/EP 绕开流水。
流水与 P/D 分离:谁拥有 KV、谁定义完成
P/D 分离把一次请求拆成「prefill 实例算完 KV」和「decode 实例接着生成」两段。PP 再叠加进来,就有两个正交的切分:按阶段切层、按阶段切角色。两者的交互点只有一个,但非常致命:KV 的归属与「完成」的定义。
vLLM:调度器一份账,worker 多份缓存
vLLM 的 KVConnector 在调度器侧负责「这个请求的 KV 什么时候可以释放、要传给谁」,在 worker 侧负责真正的页读写。PP 之后,worker 侧的 connector 按 stage 分裂:每段只持有自己那几层的 KV 页,传输时每段都要参与;调度器侧的 connector 仍然只有一份,它看到的是逻辑上的「这个请求的 KV」。unify_kv_cache_configs 在这里再次起作用:只有各段的页格式、块大小、层组完全一致,连接器才能用同一套块编号指认「哪一页属于哪一层」。
这也解释了为什么 vLLM 在 PP + P/D 场景下更倾向于「同构部署」:所有 stage 用同样的 TP、同样的页大小、同样的 dtype。任何一段用了不同的量化 KV 或不同的页大小,启动时的 kv_cache_spec 一致性断言就会先挡住;PP 抽象里没有为「各段 KV 格式不同」留转换路径。
SGLang:两轮共识
SGLang 的 PP + P/D 在代码里有两套共识:
- bootstrap 共识:prefill 节点完成 bootstrap 后,第一段把 rid 列表往后传,后一段拿本地完成集合与前一阶段的集合求交,只有交集里的请求才继续往后走。这样避免某一段认为「已经可以传 KV」、下一段还没准备好。
- release 共识:decode 节点释放请求时,最后一段发起 release rid 列表,沿环反向传回;每一段确认自己负责的 KV 已经不再被引用,才真正释放。代码里的
_pp_pd_send_consensus_release_ids和_pp_pd_get_prefill_transferred_ids就是这两套共识的落地。
这套设计的代价是「完成」不再是单个 scheduler 的本地事件,而是一个跨段的分布式判定。任何一个 stage 的 event 延迟,都会拖慢整条 release 链;而在单卡 P/D 里,release 只是一个本地 free。
TensorRT-LLM:取消与传输的「挂起-重试」
TensorRT-LLM 的 PP + disagg 把「取消」做成可重试的收敛过程:_try_cancel_request 先看 KV connector 是否有未完成的 prefix load,再看请求是否是抢占受害者,最后看 P/D 传输是否还在进行。三者任一为真,就把 rid 留在 canceled_req_ids 里,下一轮再试。PP 在这里的作用是让「一个请求可能同时处在多个 micro_batch 槽」成为常态,所以「挂起-重试」不是可选的优化,而是正确性要求。
DeepInfer:因为没有 PP,P/D 反而干净
DeepInfer 用 EngineType 区分 PROMPT、COMPLETION、NORMAL 三种引擎:prompt 引擎只做 prefill,completion 引擎只做 decode。因为没有 PP,每个引擎都持有完整的层堆栈,KV 是整模型级的;P/D 之间传输的就是完整 KV,不需要按段协商。这是「少一种并行轴」换来的结构简化,也是 DeepInfer 在 P/D 分离上比另外三家更容易讲清楚的原因。
流水并行真正难的地方
把五家的实现放在一起看,流水的难点不在「按层切」,而在下面这几件容易在纸面上被忽略的事。
1. 采样结果是控制面信息
一个 step 里,GPU 产出的不只是 hidden state,还有「这个请求下一步该读哪个 token」。而这一步只能由尾段完成。尾段和首段之间隔着 段,于是采样结果必须回到首段,而这条回传链要么经过调度器(vLLM)、要么沿环走(SGLang、TensorRT-LLM)。每多一段,这条回传路径的延迟就多一次往返,而 decode 的单步延迟就是这些往返的累加。这是 PP 的延迟惩罚不是 的「流水气泡」所描述的那回事——气泡说的是利用率,这里说的是端到端首 token 之后每一步的延迟。
2. KV 与状态必须在每一段都有账
每个 stage 都有自己那部分层的 KV 页。对 MLA 模型来说,KV 是 latent(每层 512 维的压缩表示),PP 切层后每段只持有自己那几层的 latent,显存总量和层数成正比分摊——这很好。但前缀缓存、KV 传输、KV 压缩这些「全模型级」的功能,在 PP 下都要在每段重新走一遍。TensorRT-LLM 的 P/D 分离、SGLang 的 disagg release 共识、vLLM 的 KV Connector,都在处理「多段之间如何就同一个请求的 KV 状态达成一致」;这类工程的复杂度远高于模型层的切分。
3. 取消与抢占:「标记」变为「收敛」
单卡里,取消就是调度器把一个请求从 running 删掉、释放 KV 页。PP 里,这个请求可能同时出现在:
- 首段的
waiting/running - 尾段的
running(还没产出的那一批) micro_batches槽里(TensorRT-LLM)- KV connector 的
requests_in_transfer里 - 抢占受害者的等待队列里
TensorRT-LLM 的 canceled_req_ids 「可重试」模式正是为此:每一个「暂时不能取消」的位置都要等它自己的状态归零。SGLang 在 abort_request 里也做类似的事(把等待队列、grammar 队列、chunked req、running batch、P/D 队列全扫一遍),而每一段都要做一次。SGLang 单卡场景下这条取消路径的完整拆解可以看 请求生命周期 与 调度器状态机 两篇;PP 下这些路径会被「乘以段数」。
4. CUDA Graph 与流水是一对矛盾
CUDA Graph 的前提是「形状固定、没有 host 端参与」。PP 下每一步的 hidden state 都要跨卡传输,一次 recv + 一次 send 的调度与等待都发生在 CPU 线程里。TensorRT-LLM 和 SGLang 都尝试把传输放进 stream,但这与 CUDA Graph 的捕获要求相互冲突——图里一旦捕获到主机侧同步点,图就不能重放。SGLang 的 SGLANG_PP_COMM_OVERLAP 用一个独立的 communication stream 把传输和 forward 分开;TensorRT-LLM 则用 pp_multi_stream_sample 把采样放到独立 stream。这两者的共同思路是:把「必须串行化的部分」用 event 隔离,而不是用图来收纳。
5. 流水与量化/多模态/投机解码的相互作用
- 量化:线性层的量化格式可以按段或按层不同(首尾段常见「多精度混合」),PP 本身不要求各段一致;但 KV 的 dtype 会被
kv_cache_spec的一致性断言约束,各段不能各用各的 KV 量化。 - 投机解码:EAGLE/MTP 的草稿头通常要 full hidden state,而 tail 段才有。SGLang 在 PP + spec 时只在尾段构建 draft worker(
pp_size > 1且非尾段时draft_worker为None,注释解释得很清楚:draft 模型需要 final hidden states 和 lm_head,二者只存在于最后一个阶段),并把验证轮次的结果通过 relay 回传。这给流水的「环」多套了一层状态:不仅采样结果要回传,verify 的接受长度、草稿树也要回传。 - 多模态:视觉编码器大多只放在首段,编码后的 embedding 要随 hidden 一起进入流水,意味着首段的显存和传输量都更高。这与 vLLM unify KV 的「最紧段决定全流水容量」是同一个矛盾的两面。
故障排查:PP 部署最容易踩的八个坑
- 层数对不上。 vLLM 的
VLLM_PP_LAYER_PARTITION必须满足「个数等于pp_size、总和等于num_hidden_layers」,否则get_pp_indices直接抛ValueError。手工调参时先把这两个数写在纸上,再改环境变量。 - rank 布局写反了。 vLLM 的 PP 组在全局 rank 上按「TP 内、PP 外」排列:同一段的 rank 是连续的一段,段与段之间按
pp_rank递增;_get_output_rank的注释直接给出了world_size - tp_size这个推导。如果自定义RANK/LOCAL_RANK的启动脚本按「PP 内、TP 外」去映射 GPU,组边界就会错位,表现是 rank 之间发收不到对方,日志停在第一次 forward。 - 只有尾段 TP 0 返回结果,其它 worker 返回
None。 vLLM 的unique_reply_rank是world_size - tp_size,只有这个 worker 的ModelRunnerOutput会被收集;中间段返回None,尾段其余 TP rank 也返回None。自定义 executor 时如果按「所有 rank 都有输出」去写,调度器会拿到None或形状不对的张量。 - SGLang 开了 overlap scheduler。
check_pipeline_parallel_compat会直接断言失败,报Pipeline parallelism is not compatible with overlap schedule。PP 自己已经是多微批重叠,必须关掉另一套。 - SGLang 把 PP 和 attention DP 一起开。 普通 PP 路径不一定报错,但 PP+spec 的 relay 会直接拒绝
--attn-dp-size,因为「每个 stage 重建相同 verify 输入」的前提被破坏。看到SGLANG_ENABLE_PP_SPEC is not compatible with attention DP时,先确认是不是同时开了两个开关。 - TensorRT-LLM 在 encoder-decoder 或 remote tail 上用 PP。 encoder-decoder 模型直接拒绝
pp_size > 1;conditional disaggregation 的 remote tail replay 要求pp=cp=1。这不是 bug,而是这些优化假设了「KV 只在一个 rank 上」。 - llama.cpp 的 PP 被静默关掉。 只要 compute buffer 分配失败,
llama-context会把cparams.pipeline_parallel设回 false,只在日志里留一句compute buffer allocation failed, retrying without pipeline parallelism;MoE cache、-ot张量覆盖、非 layer split 也都会让开关不成立。部署后先 grep 日志里的pipeline parallelism enabled,不要假设它一定开了。 - KV 块数被最紧的那一段卡住。 vLLM 的
unify_kv_cache_configs把num_blocks取全体最小值;如果某一段因为多带 embedding、norm 或 lm_head 而剩余显存少,整条流水线可用的块编号区间都会跟着缩水。调层数时,不要只看「每段层数相等」,要看「每段剩余显存相等」。
还有两个不那么像「坑」、但很常见的现象:
- PP 下吞吐上不去,先看并发。 用前面的气泡表算一下;如果 ,不是代码问题,是负载形态不适合 PP。
- PP 下首 token 之后的每 token 延迟变高,先看段间传输。 vLLM 每步都要由调度器把采样 token 回传首段,SGLang/TRT-LLM 还要走环;这条路径的延迟和段数成正比,和模型大小无关。
各框架的 PP 启动参数示例
下面四段配置只列出与 PP 直接相关的参数和字段,省略了模型路径、端口、并行组初始化等通用项;它们用于对照各框架的启动形态,不是可以直接复制的完整脚本。
vLLM(跨机、每机 TP=8、4 机 PP=4):
vllm serve <model> --tensor-parallel-size 8 --pipeline-parallel-size 4 \ --nnodes 4 --node-rank 0 --master-addr <head-ip> --master-port 29500 \ --max-num-seqs 128若某段层数不均,加 VLLM_PP_LAYER_PARTITION=20,20,20,20 之类的环境变量;不设置时由 get_pp_indices 自动分。
SGLang(4 机、每机 TP=8、PP=4,长上下文 prefill):
python3 -m sglang.launch_server --model-path <model> \ --nnodes 4 --node-rank 0 --dist-init-addr <head-ip>:29500 \ --tp 8 --pp-size 4 --chunked-prefill-size 4096 \ --disable-overlap-schedule --attention-backend fa3如果目标是降低 TTFT,再加 --enable-dynamic-chunking 并把 --chunked-prefill-size 调到 3 倍左右,配合 SGLANG_DYNAMIC_CHUNKING_SMOOTH_FACTOR 调参。注意 --enable-dp-attention 与 PP+spec 互斥,PP 和 overlap scheduler 也不能同时开。
llama.cpp(两台机器、每台一张卡,按层切):
# 节点 1:先启动 RPC 后端,把本机 GPU 暴露出去rpc-server -H 0.0.0.0 -p 50052
# 节点 0:把一部分层放到远端 backendllama-server -m model.gguf --rpc <peer-ip>:50052 \ --split-mode layer -ngl 999 -fa日志里看到 pipeline parallelism enabled 才算真的开了;看到 retrying without pipeline parallelism 说明 compute buffer 不够,先把 -c(上下文长度)降一半再试。
TensorRT-LLM(PyExecutor,PyTorch 后端):
# LlmArgs / ParallelConfig 中与 PP 直接相关的字段pipeline_parallel_size = 4# 同步 relay 下 num_micro_batches = pp_size# 异步 sample-state 中继需要更大的微批窗口(默认关闭)TLLM_PP_ASYNC_BROADCAST_SAMPLE_STATE = 0TensorRT-LLM 的 PP 与 encoder-decoder、部分 disagg 特性互斥,启动时请看它自己的参数校验错误信息,不要硬改。
选择建议:什么时候用 PP
把上面五家的实现与代价放在一起,可以压成四条判断:
- 如果你在做长上下文服务,且瓶颈是 TTFT:选 SGLang 的 PP + 动态分块,它把 TTFT 的气泡问题当成主要矛盾来解。需要接受的是请求状态的复数化(每段一个 scheduler)带来的运维复杂度。
- 如果你要跨多节点、模型大到 TP 跨机带宽不够:PP 是必然的。此时要重点看哪家对「采样结果回传」的代价做了优化。TensorRT-LLM 的环形 relay 比 vLLM 的调度器中继更省 CPU;但 vLLM 的调度器布局更容易理解、调试。可以参考 Continuous Batching 与 Sarathi-Serve 理解调度器侧的批处理代价。
- 如果在单机里多卡放不下 GGUF 模型:llama.cpp 的 PP 是最轻的方案,但不要指望它解决 decode 吞吐——它解决的是「能用」,不是「够快」。
- 如果是 DeepSeek 这类超大 MoE:PP 往往不是正确的选择。DeepInfer 的选择是用 DP Attention 与 Wide-EP 替代,这背后有一个更根本的判断:MoE 推理的瓶颈在专家通信,而不在层间串行;把层切开反而会让每段的 hidden 传输量成为新的瓶颈。
反过来说,PP 在推理侧真正合适的场景,是「层数很多、单层显存小、TP 跨机带宽吃紧、请求并发足够大」——这四个条件同时满足时,vLLM 或 TensorRT-LLM 的实现可以把气泡压到 20% 以下。缺少其中任何一个,都建议重新评估 DP/EP 或其他拓扑。
小结
- 流水的核心算术是气泡占比 。推理侧 decode 阶段 受并发数限制,所以 PP 的难度在「怎么把 做大」,不在「怎么切层」。
- 五个框架选择了五种形态:vLLM 单微批 + 调度器中继;SGLang 微批流水 + 环回;llama.cpp 进程内多 backend 重叠;TensorRT-LLM executor 内微批槽 + 环形 relay;DeepInfer 干脆不做。
- 难点集中在四类:采样结果是控制面信息、KV 与状态的复数化记账、取消从「标记」变成「收敛」、CUDA Graph 与流水的冲突。
- PP 不是一个可以随意叠加的开关:它和 DP Attention、EP、投机解码、多模态都有组合边界。选型时先确认「这四个条件」是否成立,再选框架。
下一篇将讨论推理框架里的「采样结果回传」在 PP 与 P/D 分离两种场景下的统一抽象,以及各家框架如何把「谁产出了 token、该发给谁」这件事收敛到一套协议上。
参考资料
- GPipe: Efficient Training of Giant Neural Networks using Pipeline Parallelism (arXiv:1811.06965)
- vLLM 官方文档:架构总览(v1 进程架构图)
- vLLM 源码:vllm/v1/worker/gpu_worker.py
- vLLM 源码:vllm/v1/core/sched/scheduler.py(use_pp 与 token 回传)
- vLLM 源码:vllm/distributed/parallel_state.py(send/recv with TP all-gather)
- SGLang 官方文档:Pipeline Parallelism for Long Context
- SGLang 源码:python/sglang/srt/managers/scheduler_pp_mixin.py
- llama.cpp 源码:ggml-backend.cpp(n_copies 与 compute_splits)
- llama.cpp 源码:src/llama-context.cpp(pipeline_parallel 判定)
- TensorRT-LLM 源码:tensorrt_llm/_torch/pyexecutor/py_executor.py(BatchStatePP 与环形采样状态)
- DeepInfer:DeepSeek 官方推理引擎
- DeepInfer 源码:deepinfer/model_executor/parallel_utils/parallel_state.py
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



