


DeepInfer 源码拆解(三十六):选行与采样输入——一个 prefill batch 里只有最后一行要去采样
一次 prefill 前向算完,模型吐出的是一个形状为 [total_q, hidden] 的张量:total_q 是这一步所有被调度 token 的数量,可能上万。但采样器真正需要的,往往只是每条请求的最后一行。夹在两者之间的那个函数,决定了哪些行进入 LM Head、哪些行进入采样、哪些行只是为 prompt_logprobs 服务、哪些行要留给投机解码的验证路径。它在 DeepInfer 里叫 prepare_sampler_inputs,位于 csrc/engine/prepare_sample.cpp。
这个函数不显眼:没有 kernel,没有通信,也没有 CUDA Graph,只是几个 for 循环和几个 int 偏移。但它产出的五个数组——selected_token_indices、selected_prompt_indices、sample_positions、mtp_first_token_positions、mtp_info_read_rows——是采样层全部的输入契约。任何一处算术错了,表现都不是崩溃,而是更隐蔽的东西:采到了别的请求的分布、prompt logprobs 错位一位、投机验证读到了上一拍的草稿概率。读推理框架源码,这类”索引账”往往比注意力 kernel 更容易被跳过,也更容易在排查线上问题时被忽略。
前三十五篇已经把 DeepInfer 的主干拆得差不多了:整体架构 给出了仓库地形,异步调度与 ZOS 讲了 CPU 后处理如何离开关键路径,KV 内存与 SWA 有界重放 拆开了两本块账,投机解码 讲了 DSpark 的变长验证,InputMetadata 的构造 讲了调度元数据如何变成 GPU 张量,变长验证的输出账本 讲了多 token 结果如何记账。这些文章都提到过 sampler_inputs,但都把它当成一个已经装好的盒子。这一篇把盒子打开,只回答一个问题:给定这一拍的 SequenceMetadata 列表,怎么算出采样器要的那些行。
LM Head 的账:选行不是微优化
先把”为什么必须选行”算清楚。DeepInfer 的 get_logits 是一个 bf16 的 GEMM:bf16_gemm_nt(hidden_states, embedding, logits),输出 fp32。对一行 hidden state 而言,LM Head 的乘加量是
其中 是 hidden 维, 是词表大小。以 DeepSeek 系列常见的 、 为例,一行就是约 GFLOP。对应的 logits 行是 个 fp32,即约 KiB。
这两个数字乘上 token 数,代价立刻变得具体。一个 32K token 的 prefill,如果对每一行都做 LM Head,需要约 TFLOP 的计算,并物化一个约 GB 的 logits 张量。只对每请求最后一行做,则是 2 行、约 GFLOP、约 MiB。差了四个数量级。
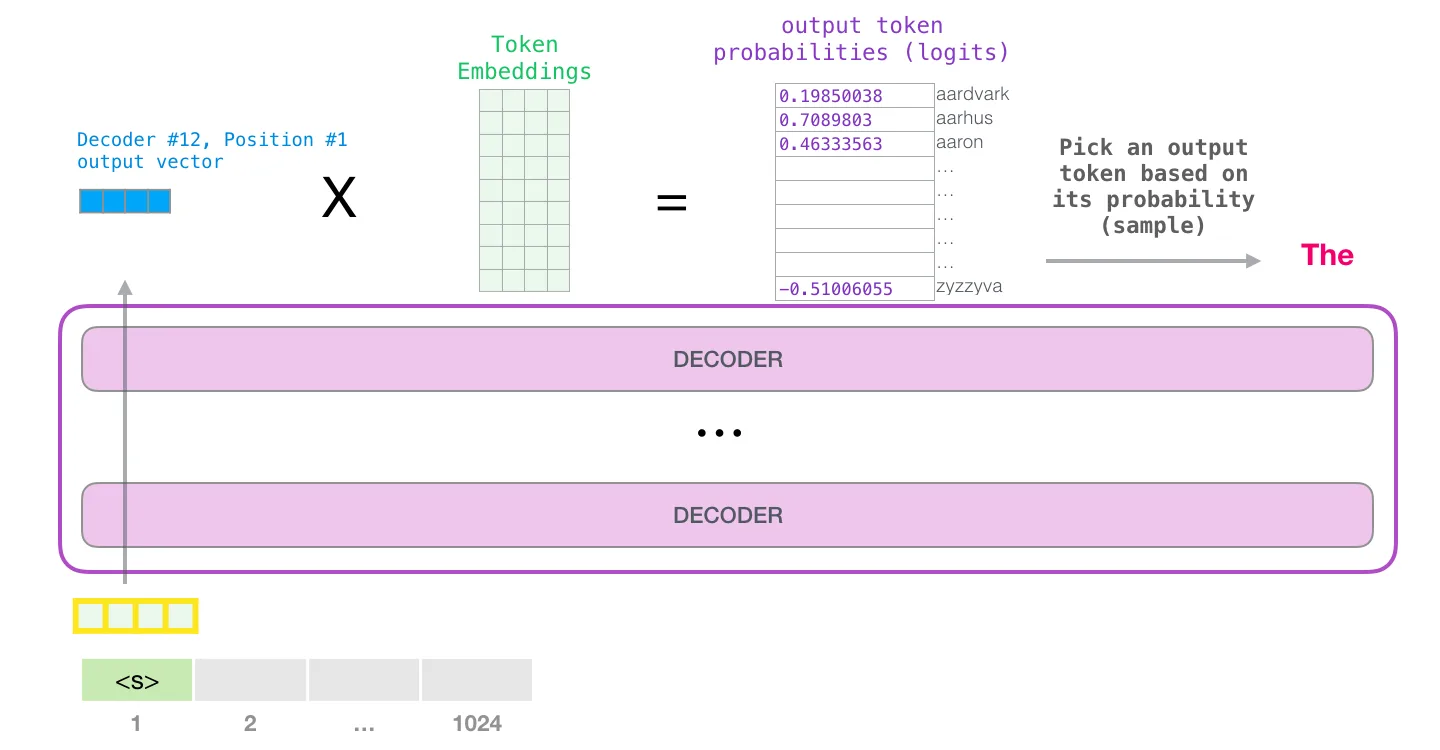
图源:Jay Alammar, The Illustrated GPT-2(jalammar.github.io)。图中只画了最后一个位置产生输出分布,这正是自回归生成的实际用法。
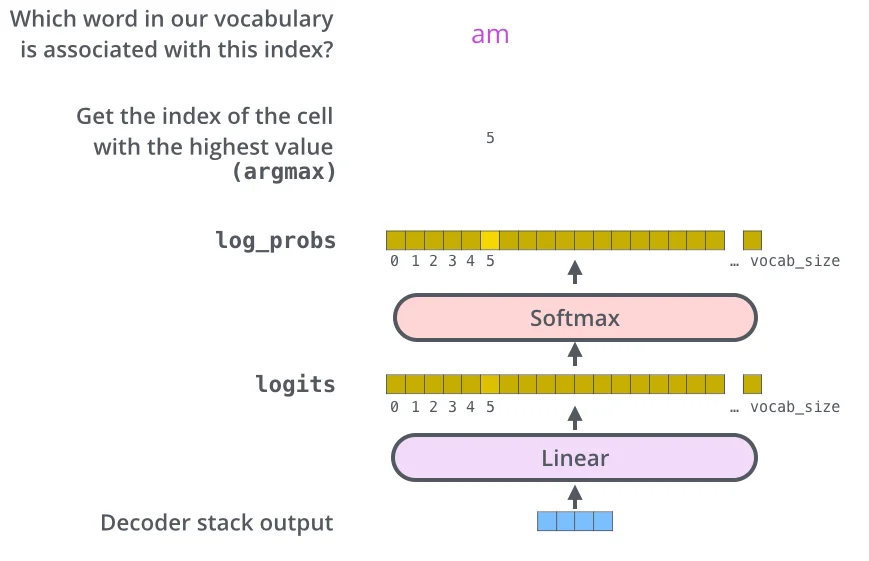
图源:Jay Alammar, The Illustrated Transformer(jalammar.github.io)。每个位置都有一份分布,但生成只需要最后一个位置的那份。
这里要避免一个常见误解:选行省掉的是 LM Head 与 logits 物化,不是 Transformer 层本身。prefill 的每一个 token 仍然要过全部注意力与 MLP 层,否则后续 token 的 KV 就不完整。选行发生在最后一层之后:hidden states 已经算完,只是不把它们全部投影到词表空间。这也是为什么 prepare_sampler_inputs 拿到的是 SequenceMetadata 而不是 hidden states——它要在前向之前就把”要哪几行”算好,前向之后只做 gather。
第二个误解是”一行 hidden state 对应一个 token 的分布”。这句话只在自回归的因果模型里成立,而且方向要反过来理解:第 行的 hidden state 经过 LM Head 得到的是”第 个 token 的分布”。因此 prompt 的最后一个 token 所在行,产出的正是首个生成 token 的分布;而 prompt logprobs 要的 行,恰好是前 个位置。后文的所有”减一”都来自这个错位。
四种行,四种消费者
把选行按用途拆开,DeepInfer 的五个数组其实在回答四个不同的问题。
| 行类型 | 每请求行数 | 何时产生 | 消费者 |
|---|---|---|---|
| 采样行 | 1(prefill chunk)或 (decode + 投机) | 总是 | process_sampling / fused_sample |
| prompt logprob 行 | ,按 chunk 拆开 | 请求开启 prompt_logprobs | compute_prompt_logprobs |
| 验证行 | (与采样行重合) | decode 且有 draft | 拒绝采样与接受判定 |
| 草稿锚点行 | 1 个锚点 + 个读槽 | decode 且启用 MTP | DFlash.decode_forward |
采样行与验证行在物理上是同一批行:decode 时每请求的 行既要有分布来采样,也要有分布来做接受判定。把它们分成两个概念,是为了讲清楚为什么 decode 的 selected_token_indices 长度是 ,而不是请求数。
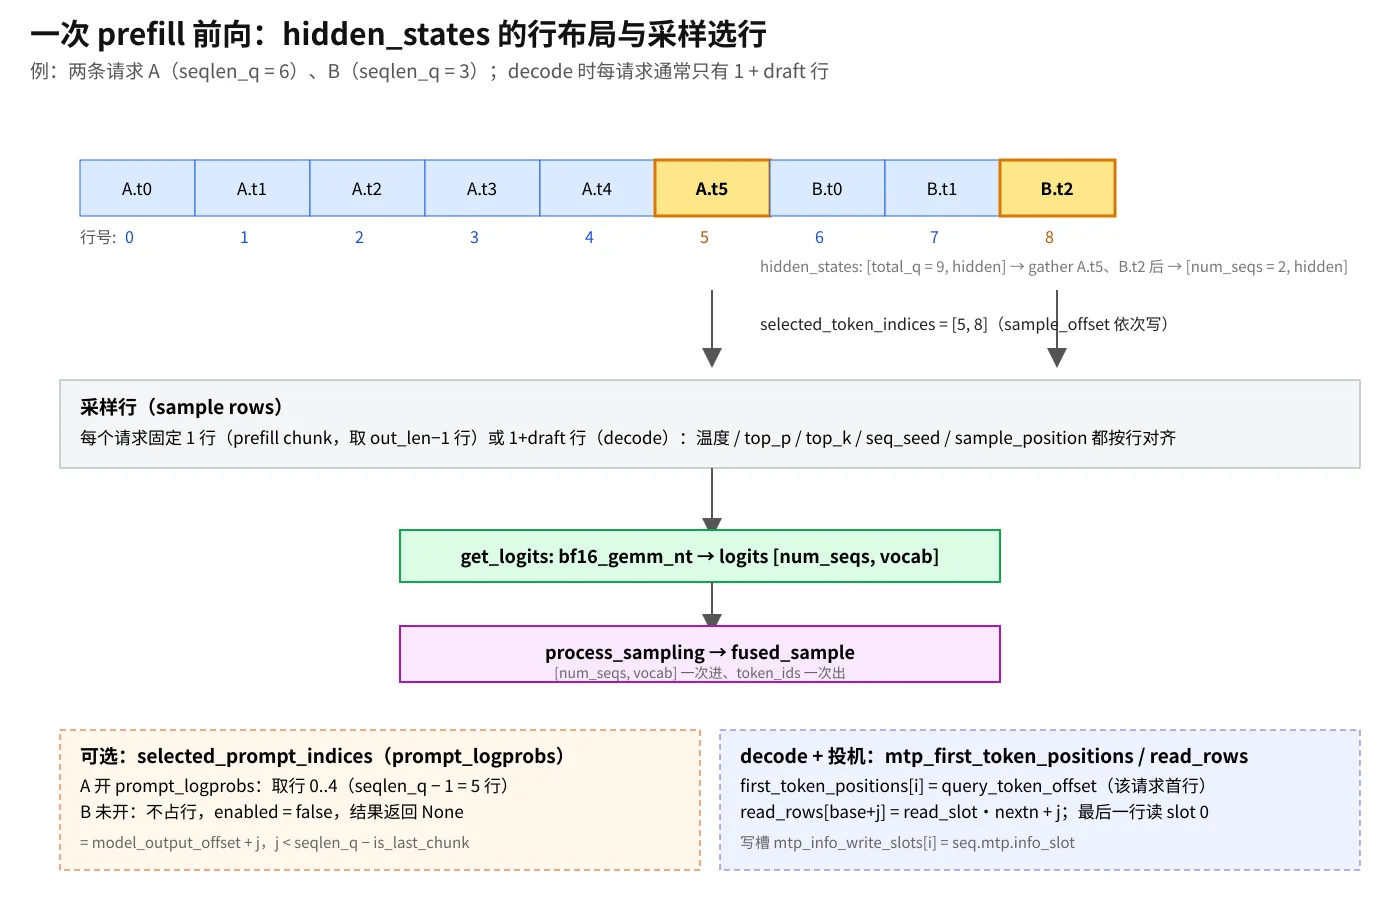
图:DeepInfer prefill 的 selected_token_indices、selected_prompt_indices 与 decode 的 MTP 锚点。依据 csrc/engine/prepare_sample.cpp 绘制(自制图)。
这张图里有三个容易看漏的点。
第一,selected_token_indices 在 prefill 下的长度等于请求数,不是 token 数。图中 A 有 6 个 token、B 有 3 个,但数组只有两个元素 [5, 8]。采样器拿到的 logits 形状是 [2, vocab],两条请求各一行。
第二,selected_prompt_indices 是另一套行号,只对开启 prompt_logprobs 的请求出现。它和采样行可以指向同一段 hidden_states,但两者在采样器里走不同的路径:采样行经过温度、top-p、top-k 与随机采样;prompt logprob 行只做 log-softmax 再按目标 token 查表。
第三,decode 的”锚点”不是采样行。mtp_first_token_positions[i] 记录的是第 条请求在本拍扁平布局中的首行,草稿头需要从这一行开始读 hidden states 与 KV,而不是从最后一行。它和采样行的关系是”区间起点”与”区间内每一行”的关系。
理解了这四种行,后面的算术就只是偏移累加。真正需要小心的是:这些偏移是在 CPU 上按请求顺序逐条累加的,任何一条请求的分支走错,后面的所有行都会整体错位。
prepare_sampler_inputs 的逐请求算术
函数签名不长:
SamplerInputs prepare_sampler_inputs( const std::vector<SequenceMetadata *> &seq_metadata_list, int max_mtp_tokens, YocoPrefillTruncationMode yoco_prefill_truncation_mode, int yoco_prefill_keep_tokens);四个入参分别回答:这一拍有哪些序列、投机最多几层、prefill 是否开启 YoCo 截断、截断后保留多少 token。函数体里没有并行,也没有分支预测之类的技巧,就是按 seq_metadata_list 的顺序做一次扫描。扫描过程中维护五个偏移:
| 偏移 | 含义 | 递增方式 |
|---|---|---|
sample_offset | 已写入的采样行数 | 每条请求 +1(prefill)或 +seqlen_q(decode) |
prompt_token_offset | 已写入的 prompt logprob 行数 | 每条请求 +num_prompt_logprobs |
parameter_offset | 已写入的采样参数组数 | 每条请求 +1 |
query_token_offset | 已扫过的 query 行数 | 每条请求 +seqlen_q |
model_output_offset | 已扫过的 model output 行数 | 每条请求 +out_len |
前三个是”写指针”,后两个是”读指针”。读指针里最容易被忽略的是 model_output_offset:在普通 prefill 下它和 query_token_offset 完全同步,但在 YoCo 压缩模式下,模型的输出行数会被截断,二者不再相等。这一点后文会单独讲。
这五个偏移最终落到五组张量上。把它们的形状列清楚,后面看任何一段索引代码都不会迷路:
| 张量 | dtype | prefill 长度 | decode 长度 | 写入者 | 消费者 |
|---|---|---|---|---|---|
selected_token_indices | int32 | 请求数 | sample_offset | gather → get_logits | |
selected_prompt_indices | int32 或 None | 各请求本 chunk 的 num_prompt_logprobs 之和 | None | prompt_token_offset | compute_prompt_logprobs |
sample_positions | int32 | 请求数 | 请求数 | sample_offset / 请求下标 | 采样内核的随机流 |
temperatures / top_ps / top_ks | fp32 / fp32 / int32 | 请求数 | 请求数 | parameter_offset | expand_sampling_params |
seq_seeds | uint64 | 请求数 | 请求数 | parameter_offset | 采样内核 |
表里有两个”长度”需要区分:prefill 的采样行与参数组数都等于请求数,看起来一一对应;decode 的采样行数大于参数组数,必须先展开再对齐。prepare_sampler_inputs 只负责把两组数组都填到”按请求对齐”的形态,展开发生在采样器内部。这种分工让 C++ 侧的循环保持简单,代价是 Python 侧必须知道 row_to_req 与 local_step 的语义。
Python 侧的类型定义在 sampling_inputs.py。它直接复用 deepinfer._C.engine 里的原生结构,同时补上 MTP 所需的 MTPSamplingInput、MTPDriverInput、MTPDecodeInput。模块开头有一段容易被忽略的说明:原生 vector 字段在访问时会被拷贝成 Python list,调用方必须把它们当成不可变快照。这条约束和 ZOS 的”借用视图”是同一类设计——控制面数据一旦跨过 pybind 边界,就不再跟随 GPU 侧的状态变化。MTPDecodeInput.first_token_positions 的注释也写得很明确:-1 表示 CUDA Graph 的 padding 行。选行函数不会写 -1,它只写真实的 query_token_offset;padding 是在图捕获路径里补出来的。
先看 prefill 分支。每条请求要做四件事,顺序不能换。
第一,算这条请求要多少 prompt logprob 行:
int num_prompt_logprobs(const SequenceMetadata &seq_metadata) { if (!seq_metadata.sampling.need_prompt_logprobs) { return 0; } TORCH_CHECK(seq_metadata.prompt_tokens != nullptr); return seq_metadata.seqlen_q - int(seq_metadata.is_last_prompt_chunk());}seqlen_q 是本 chunk 带进来的 query token 数。如果不是最后一个 prompt chunk,每个 token 的下一个 token 都还在 prompt 里,所以每个位置都要算;如果是最后一个 chunk,最后一个 prompt token 的下一个 token 是首个生成 token,其分布归采样行使用,因此要减一。这个减一是整篇文章里最重要的一个减法。
第二,为这些行填目标 token 与采样参数:
selected_prompt_indices_ptr[prompt_token_offset + j] = model_output_offset + j;prompt_tokens_ptr[prompt_token_offset + j] = (*seq_metadata->prompt_tokens)[seq_metadata->seqlen_k - seqlen_q + j + 1];注意目标 token 的下标是 seqlen_k - seqlen_q + j + 1,也就是”第 行的下一个位置”。seqlen_k 是本 chunk 结束后的总上下文长度,减去 seqlen_q 得到本 chunk 的起点。这个 与前面的 是同一件事的两面:最后一行的目标越过了 prompt 边界,所以不能算;其余行的目标都在 prompt 内,所以要右移一位。
第三,填采样行。采样行不是”第一行”,也不是”每个 chunk 的第一行”,而是本请求在 model output 里最后一行:
selected_token_indices_ptr[sample_offset] = model_output_offset + out_len - 1;sample_positions_ptr[sample_offset++] = seq_metadata.seqlen_k;model_output_offset += out_len;out_len 默认等于 seqlen_q,在 YoCo 压缩模式下会被截短。sample_positions 填的是 seqlen_k,即这条请求采样时的绝对位置。它不是行号,而是随机流的锚点:采样内核用 seq_seed 与位置共同决定这一拍的随机数,因此同一请求在同一位置重放会得到同一结果。这一点在 采样、惩罚与确定性校验 里已经展开过,这里只强调它为什么在选行函数里出现——采样参数必须和采样行一一对齐,而位置是参数的一部分。
第四,EOS 抑制。若请求设置了 first_n_token_no_eos == 1 且当前是最后一个 prompt chunk,就把这条请求的采样行号与 EOS id 记进 eos_suppression_rows / eos_token_ids。采样器随后只对这几行把 EOS 的 logit 置为 。这是一个”按行生效”的约束,所以它必须使用 sample_offset,而不是请求下标。
decode 分支的规则完全相反:每一行都要采样。
for (int j = 0; j < seqlen_q; j++) { selected_token_indices_ptr[sample_offset++] = model_output_offset + j;}model_output_offset += seqlen_q;sample_positions_ptr[i] = seq_metadata.seqlen_k - seqlen_q + 1;普通 decode 的 seqlen_q 等于 1,这段循环只写一行。启用投机解码后,seqlen_q 等于 :第一行是上一拍接受的最后一个 token,后面 行是草稿 token。每一行都要有分布,因为验证器要逐行比较目标分布与草稿分布,并在拒绝点重新采样。于是 selected_token_indices 的长度从”请求数”变成”请求数乘以每请求行数之和”。
这里有一个容易混淆的地方:采样参数的数组长度仍然是请求数,不是行数。num_sampling_positions 在代码里写作 is_prompt ? total_batch_size : num_seqs,decode 下就是请求数。为什么可以这样?因为同一请求的 行共享温度、top-p、top-k 与 seed,只有”请求内第几步”不同。这个差异由后续的 expand_sampling_params 补上:
sample_positions_q = params.sample_positions[req] + local_step * DRAFT_POS_HASH_MULrow_to_req 把每一行映射回请求,local_step 是行在请求内的序号。位置加上 local_step 乘一个固定常数,使同一请求的不同草稿步得到不同的随机流,同时保持”同请求、同步、同位置”的可复现性。参数空间与行空间在这里第一次分开,后面还会再合并。
最后是几个断言,它们的作用是把上面所有算术的自洽性钉死:
TORCH_CHECK_EQ(sample_offset, total_batch_size);TORCH_CHECK_EQ(parameter_offset, num_sampling_positions);TORCH_CHECK_EQ(prompt_token_offset, prompt_tokens_size);读源码时,这类断言比注释更有信息量。sample_offset 必须正好等于预算的采样行数,说明每条请求恰好贡献了预期行数;prompt_token_offset 必须等于预算的 prompt logprob 行数,说明 num_prompt_logprobs 的累加没有漏掉任何一个 chunk。如果线上出现”采样结果错位”,第一件事就是看这几个断言有没有被绕过——它们都在 prepare_sampler_inputs 返回前执行,正常构建不会跳过。
把这三条请求放进一次 prefill,可以把所有偏移走一遍。假设批里有 A、B、C 三条:A 的 prompt 已在上一拍算完一半,这一拍送来 5 个 token 且是最后一块,开启了 prompt_logprobs;B 是完整 prompt,长度 3,没开 logprobs;C 是长 prompt 的第二块,长度 4,不是最后一块。seqlen_k 分别是 12、3、9,seqlen_q 分别是 5、3、4。
| 请求 | model_output_offset(进入时) | num_prompt_logprobs | 写入的 prompt 行 | 采样行 | sample_positions | out_len |
|---|---|---|---|---|---|---|
| A | 0 | 5 − 1 = 4 | 0..3 | 4 | 12 | 5 |
| B | 5 | 0 | 无 | 7 | 3 | 3 |
| C | 8 | 4 − 0 = 4 | 8..11 | 12 | 9 | 4 |
三个细节只有走一遍才会显出来。第一,A 是最后一块,所以 prompt 行比 seqlen_q 少一;C 不是最后一块,所以四行全算。第二,B 没开 logprobs,prompt_token_offset 不为它前进,但 model_output_offset 仍要为它前进 3——两本账是独立的。第三,sample_positions 填的是 seqlen_k,不是 seqlen_q 或行号:A 的 12 表示”采样发生在 12 个 token 之后”,与它在本拍的 5 行没有直接关系。
如果这时把 YoCo 压缩打开,假设 A 的 out_len 被裁到 3,那么 A 的采样行变成 0 + 3 - 1 = 2,B 的 model_output_offset 从 3 开始而不是 5。所有后续行号整体左移两格。这就是为什么 model_output_offset 必须独立维护:它跟踪的是”模型实际产出了多少行”,不是”调度器发了多少 token”。
prompt logprobs:为什么是 行,跨 chunk 怎么接
把 prompt logprobs 单独拎出来,是因为它同时牵动三件事:行数、跨 chunk 状态、显存。
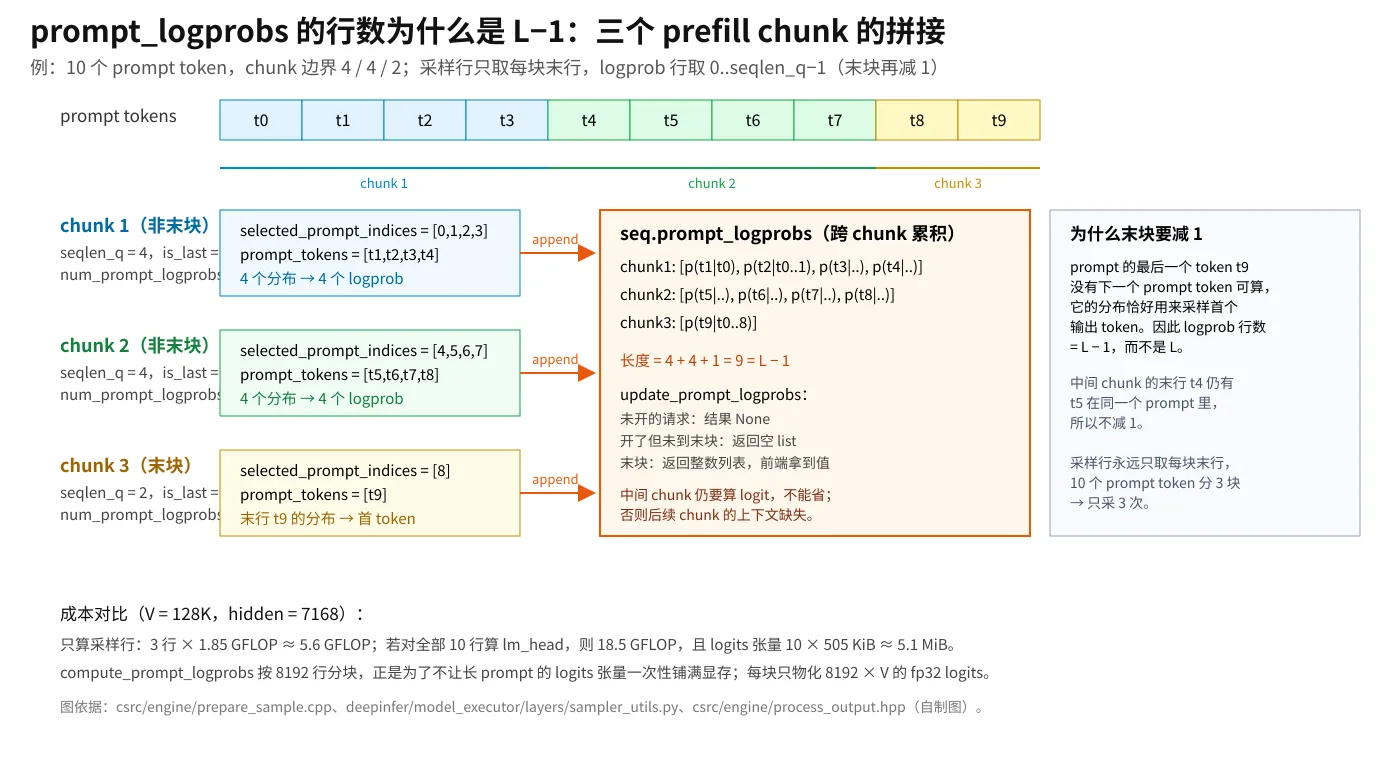
图:10 个 prompt token 分三个 chunk 时,selected_prompt_indices 与目标 token 的对应关系。依据 prepare_sample.cpp、sampler_utils.py、process_output.hpp 绘制(自制图)。
图中最左边是原始的 10 个 token,中间三个色块是三个 chunk。chunk 1 与 chunk 2 各取 4 行,chunk 3 只取 1 行,合计 9 行,正好是 。如果只看单个 chunk,会觉得”末块减一”是个奇怪的边界处理;把三个 chunk 拼起来才看得出它是全局 在分块下的自然结果。
为什么要跨 chunk 累积?因为一个长 prompt 可能被切成多个 prefill chunk,每个 chunk 只能看到自己那一段的 logits。prepare_sampler_inputs 为每个 chunk 算出局部的 prompt_logprobs_lens,采样器把这一段的 logprob 算出来,再由 update_prompt_logprobs 追加到 seq_metadata->prompt_logprobs 里:
if (seq_metadata->prompt_logprobs == std::nullopt) { seq_metadata->prompt_logprobs = prompt_logprobs_;} else { seq_metadata->prompt_logprobs->insert( seq_metadata->prompt_logprobs->end(), prompt_logprobs_.begin(), prompt_logprobs_.end());}这段代码有两个值得注意的语义。第一,nullopt 与空列表不是一回事:nullopt 表示这条请求没开 prompt logprobs,空列表表示开了但这一段没有产出(例如非末 chunk 的返回值只是占位)。第二,只有 is_last_prompt_chunk() 为真时才把累积结果返回给 Python 侧;中间 chunk 的 logprob 已经写进序列状态,但不会立刻上报。这与”客户端只关心整段 prompt 的 logprobs”的语义一致。
split_prompt_logprobs 负责把扁平的 logprob 列表按请求切开。它的输入是 enabled 与 prompt_logprobs_lens 两个数组,输出是每条请求一个列表或 None。enabled=false 的请求不占行、不参与偏移,这一点在 prepare_sampler_inputs 里就已经决定了:它的 num_prompt_logprobs 返回 0,循环里也不会写任何索引。
成本控制有三层。第一层是 selected_prompt_indices 只挑需要的行,不把整段 hidden states 送进 LM Head。第二层是 compute_prompt_logprobs 按 8192 行分块:
_PROMPT_LOGPROB_CHUNK_SIZE = 8192for start in range(0, full_batch_size, _PROMPT_LOGPROB_CHUNK_SIZE): ...这个分块不是为了并行,而是为了限制 logits 张量的峰值。若一个 32K token 的 prompt 一次算完,fp32 logits 是 字节,约 16.9 GB;按 8192 行切,每块约 4.2 GB,仍然是很大的数字,但至少不会和 KV 池、权重、workspace 抢同一瞬间的峰值。第三层是 DEEPINFER_SAMPLER_FORCE_TOPK:开启后先用 topk 把 logits 裁到 top-k 空间并记下 token_indices,log-softmax 只在这个小空间里算,再用 map_lookup(mode="by_key") 按目标 token 查值:匹配不到的 key 由 torch.where(..., -inf).max 归到 。关闭时(by_index)直接按列下标取值,越界同样填 。这是一个”用精度换带宽”的开关,默认关闭。
还有一个跨框架都会遇到的边界:前缀缓存。如果 prompt 的前若干 token 命中了前缀缓存,那一段的 hidden states 根本没有重新计算,也就没有 logits 可以产出。DeepInfer 的处理是让 prompt_logprobs 与 YoCo 的 consumer compaction 互斥,在 prepare_sampler_inputs 里直接断言:
TORCH_CHECK(!seq_metadata->sampling.need_prompt_logprobs, "prompt_logprobs is incompatible with yoco consumer compaction ...");TensorRT-LLM 在类似场景下只发一条警告,说明”由于 KV cache reuse,部分 context logits 无法产出”。两种做法没有对错,区别是 DeepInfer 选择在入口处拒绝,TensorRT-LLM 选择带着不完整的结果继续。读源码时看到这类分歧,往往能反推出各自对”可观测性”的优先级:一个宁可报错,一个宁可降级。
最后是 CP 的细节。prompt logprobs 只在 CP rank 0 上物化,其他 rank 的 compute_prompt_logprobs 返回 None。但所有 rank 仍然要执行同样的 gather 与分块循环,因为分块边界必须对齐,否则 rank 0 的 chunk 与 follower 的 hidden states 行数会对不上。这也是为什么 compute_prompt_logprobs 的注释强调”每个 CP rank 必须收到相同的 hidden-state 行数”。
投机解码:decode 为什么是 行
普通 decode 的选行很无聊:每请求一行。加入投机解码后,选行才真正变成一门算术。
先明确 的来源。DeepInfer 的 DSpark 不是固定深度的投机:调度器会根据上一步草稿头的置信度、当前批的 token 预算与 decoded 性能曲线,给每条请求分配不同的验证长度。因此 seqlen_q 在 decode 批里不是常数,而是逐请求不同;max_mtp_tokens 只是上限。prepare_sampler_inputs 的 total_batch_size 在 decode 分支里做的是 ,而不是 num_seqs * (1 + max_mtp_tokens)。
每一行对应一个候选位置。第 0 行是上一拍已经接受的最后一个 token,它给出的是”下一个草稿 token”的分布;第 行()是第 个草稿 token,它给出的是”再下一个草稿 token”的分布。验证器需要逐行比较目标分布与草稿分布,所以每一行都要有 logits、都要进采样内核。只给最后一行,验证就退化成”只看最终结果”,无法回滚到第一个被拒绝的位置。
选行函数为这种布局准备了两套辅助索引。
第一套是草稿头的锚点:
mtp_first_token_positions_ptr[i] = query_token_offset;mtp_seqlens_q_ptr[i] = seqlen_q;query_token_offset 在写入之前是该请求首行的全局行号,因此草稿头知道”这条请求的 行从哪开始、有多少行”。草稿头不需要采样行的列表,它按请求读一段连续的 hidden states,再用固定步长切片:
logits = logits_next[step_i :: self.max_MTP_value]这是第三种选行方式:不是索引列表,也不是单点偏移,而是”从锚点开始、按步长跨行”。第 step_i 步的草稿头只取每个请求内偏移为 step_i 的那些行。三种方式在同一份引擎里共存,各自适合不同的数据布局。
第二套是 MTP 信息池的读写槽:
mtp_info_write_slots_ptr[i] = seq_metadata->mtp_info_write_slot;mtp_info_read_rows_ptr[row_offset + j] = seq_metadata->mtp_info_read_slot * nextn_token_cnt + j;mtp_info_read_rows_ptr[row_offset + seqlen_q - 1] = 0;信息池是一个二维池:每个槽位占 nextn 行,行内存放草稿 token、草稿 logprob(或 top-k 索引)与置信度。槽位 0 被保留为 padding,内容初始化为”token id = vocab−1、logprob 除首项外全为 、首项为 0”。这样,当某个槽位还没被写过、或最后一行需要一份”中性”的草稿分布时,读槽 0 不会引入偏差。
读行的映射值得逐项解释。read_slot * nextn + j 表示”本请求的读槽第 行”,对应上一拍草稿头为第 个草稿位置存下的分布。最后一行(seqlen_q - 1)不读草稿分布,因为它是本拍新采出来的 token,没有”上一拍的草稿”可读,所以显式指向 padding 槽 0。写槽则按请求写:草稿头这一拍算出的 个新草稿,写回同一个 info_slot,供下一拍读取。
这两个槽位号来自调度器。Sequence 的 MTP 状态里保存 info_slot,调度器在请求进入 running 时分配、离开时回收;take_draft_info_slot() 是一个”读后即焚”的操作:
int take_draft_info_slot() { int read_slot = has_draft_info ? info_slot : 0; has_draft_info = false; return read_slot;}has_draft_info 为假时读槽 0,表示这条请求没有可用的上一拍草稿(新请求、被抢占后重算、或 prefill 刚结束)。这解释了为什么选行函数拿到的是 mtp_info_read_slot 而不是直接拿 info_slot:读与写是两个语义,读槽可能是 0,写槽一定非 0。
还有两处与选行相关的配置。stop_token_ids 是每条请求两个 int32:第一个是本拍的 EOS(ignore_eos 时写 −1),第二个当前恒为 −1,留给未来的第二停止条件。golden_output 只在存在 golden_token 的请求时分配,初值全部为 −1,用于强制指定采样结果;它的写入也按行偏移,row_offset += is_prompt ? 1 : seqlen_q,与采样行的记账保持一致。
process_MTPInfo 在调度器侧还有一条约束:非最后一个 prefill chunk 不生成真正的草稿信息,mtp.draft_tokens 会被清空,has_draft_info 也不会置位。这与选行函数里的 query_token_offset 无关,但解释了为什么 prefill chunk 的 selected_token_indices 只有一行:草稿头在 prefill 阶段不参与,MTP 信息池只在 decode 阶段被读写。
CPU 算索引,GPU 做 gather
到这里,五个数组都算出来了。接下来的问题是:它们怎么从 CPU 到 GPU,以及 GPU 上怎么用。
索引本身很小。selected_token_indices 是 total_q 个 int32,total_q 取 32K 时是 128 KiB;selected_prompt_indices 在开启 logprobs 时按 行计,量级相同;其余三个数组按请求数计,通常只有几 KiB。prepare_sample.cpp 在返回前把这些张量搬到默认设备:
copy_to_default_device(prepared.selected_token_indices);copy_to_default_device(prepared.selected_prompt_indices);...这些张量在分配时使用 pinned(torch::kInt32),即页锁定内存,H2D 可以走异步拷贝。用几十到几百 KiB 的索引,换掉几 GB 的 LM Head 计算与 logits 物化,这是整个选行机制的经济学基础。
GPU 侧不是用 PyTorch 的高级索引,而是一个 TileLang 的行 gather 内核:
def gather(x, index, out=None): """Row gather x[index] with out-of-range indices zero-filled.""" ... kernel = ops.gather_tl(x.shape[1], x.dtype, index.dtype, x.stride(0)) kernel(x, index, y)它有三个实现细节。第一,按字节搬运,不关心 dtype,因此同一内核可以用于 hidden states、logits、甚至 KV 页。第二,支持带 stride 的行视图,非连续输入只要每行内部连续就不需要先 contiguous()。第三,越界索引填零,而不是报错或读脏数据。第三条尤其重要:CUDA Graph 的批会被 pad 到固定形状,num_reqs 可能小于图批大小;如果索引里出现指向 padding 行的值,gather 返回零行,后续 logits 是无意义的,但不会越界。采样器再按真实请求数截断输出,padding 行被丢弃。
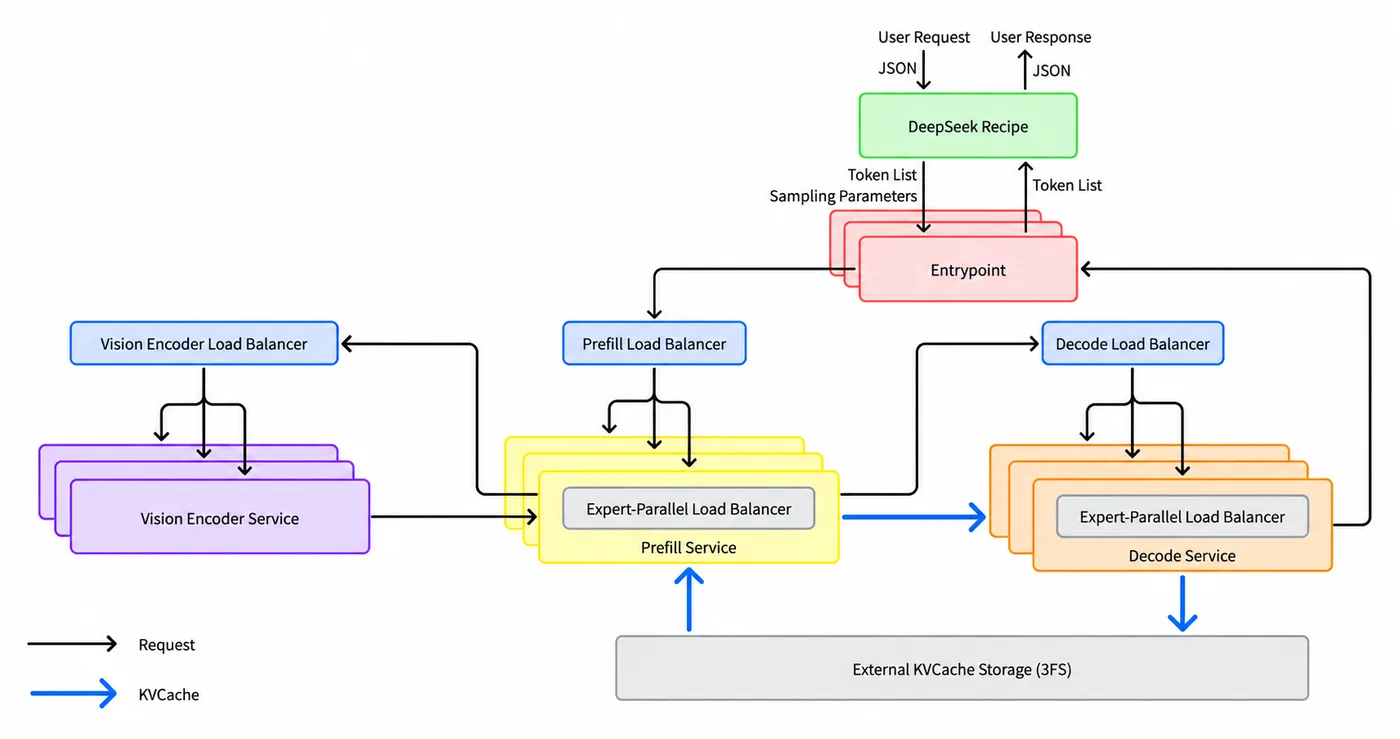
图源:DeepInfer 仓库 doc/images/architecture_overview.png。选行发生在 Worker 的 model runner 内,位于前向输出与 sampler 之间。
在 CP 场景下,选行只由 driver rank 计算一次,然后把五个数组广播给 follower:
metadata_dict = { "is_prompt": input_metadata.is_prompt, "selected_token_indices": sampler_inputs.selected_token_indices, "selected_prompt_indices": sampler_inputs.selected_prompt_indices, "mtp_first_token_positions": ..., "mtp_seqlens_q": ...,}broadcast_tensor_dict(metadata_dict, src=0)follower 不再执行逐请求循环,而是直接构造 SamplerInputs。这并不是为了省 CPU——循环本身很便宜——而是为了保证一致性:CP 切的是序列维,各 rank 看到的 seq_metadata 行布局可能不同,如果各自独立计算,索引会分叉。让 driver 算一次、广播一次,是这类”控制面算术”的标准做法。
与 CUDA Graph 的关系需要单独说一句。选行的结果是输入张量,不是图结构:图捕获的是 gather、get_logits、process_sampling 这些算子的形状与地址,索引内容每拍都可以变。真正影响图的是”行数”——selected_token_indices 的长度决定 logits 的行数,而 logits 的形状又被采样内核与后续输出缓冲依赖。因此 DeepInfer 的图按批大小分档,采样输入按真实 num_reqs 截断,padding 行由 gather 的越界填零兜底。这条链路在 CUDA Graph 捕获与重放 里有完整展开,这里只强调:选行是图内的数据,不是图外的控制流。
与其余四个框架的选行对照
DeepInfer 的 prepare_sampler_inputs 不是行业孤例。vLLM、SGLang、TensorRT-LLM、llama.cpp 都面临同一个问题,并且都选择了”以每请求末行偏移为基元、只对选中行做 LM Head”的路线,差别在投机多行、input logprobs 和图内动态索引这三处。
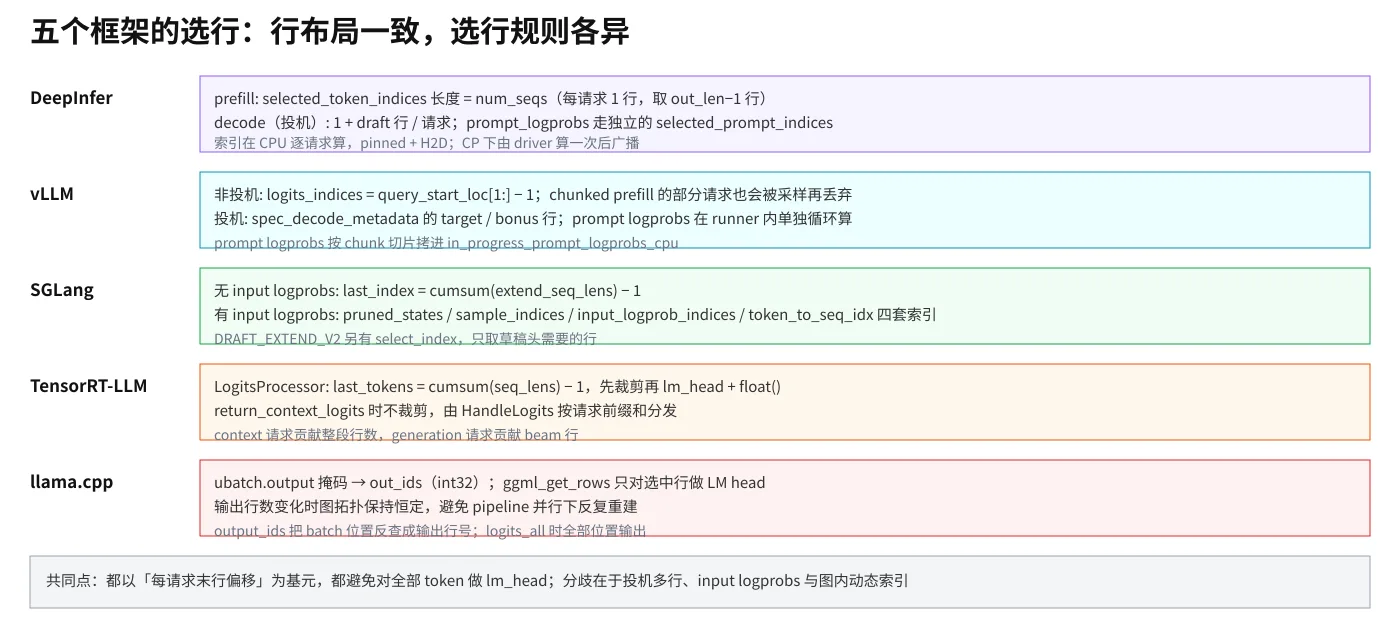
图:DeepInfer、vLLM、SGLang、TensorRT-LLM、llama.cpp 的选行规则对照。依据各仓库当前源码核对(自制图)。
vLLM V1 的选择在 gpu_model_runner.py 里。非投机路径用一行 numpy 就写完了:
logits_indices = query_start_loc[1:] - 1query_start_loc 是 [num_reqs + 1] 的前缀和,第 项是第 条请求的末行位置。代码上方有一段注释,承认 chunked prefill 的部分请求也会被采样,然后”为了简单”把多余结果丢弃。这种做法与 DeepInfer 的”精确选行”不同:vLLM 接受一点浪费,换取实现简单。投机路径则由 _calc_spec_decode_metadata 构造 logits_indices、target_logits_indices、bonus_logits_indices 三套索引,拒绝采样器用它们分别取目标分布、bonus 采样与写回 logprobs。prompt logprobs 在 vLLM 里是另一条路径:_get_prompt_logprobs_dict 按请求在 runner 内单独循环,对每个 chunk 切片计算 LM Head,再拷进 in_progress_prompt_logprobs_cpu。它的注释直言”prompt logprobs 是罕见功能,优先可维护性而非性能”,这与 DeepInfer 把它做进 C++ 统一选行函数的选择形成对照。
SGLang 的选行集中在 LogitsProcessor。没有 input logprobs 时,last_index = torch.cumsum(extend_seq_lens) - 1,一次向量化的前缀和就得到所有末行。有 input logprobs 时,它会算出四套索引:pruned_states 是真正要算 logits 的行,sample_indices 是要采样的行,input_logprob_indices 是输入 token 的 logprob 行,token_to_seq_idx 把每个行映射回请求。源码注释里给了一个完整的例子:三条请求长度 4、5、6,pruned_states 是 [t00..t03, t14, t23..t25],sample_indices 是 [3, 4, 7]。这与 DeepInfer 用两套索引(采样与 prompt logprob)的思路一致,但 SGLang 把它们做成了三个逻辑行域的笛卡尔积,读者需要先把三个行域分开再对应。
TensorRT-LLM 的选行发生在 LogitsProcessor,而且选行先于 LM Head:
last_tokens = torch.cumsum(attn_metadata.seq_lens_cuda, dim=0, dtype=torch.long) - 1hidden_states = hidden_states[last_tokens]logits = lm_head(hidden_states)logits = logits.float()return_context_logits 时不裁剪,保留全部行,由 HandleLogits 按 num_context_logits_prefix_sum 把 context 与 generation 两段分发回各请求。context 请求贡献整段行数,generation 请求贡献 beam 行。这套前缀和的语义与 DeepInfer 的 model_output_offset 很接近:都是在扁平行布局上给每个请求划一段区间,区别是 TensorRT-LLM 把它做成了”要哪些行”的前缀和,DeepInfer 把它做成了”当前扫到哪”的游标。
llama.cpp 的选行写进图里。llm_graph_input_out_ids::set_input 按 ubatch->output 掩码生成 out_ids 数组;建图时 build_inp_out_ids 把 out_ids 作为 ggml_new_tensor_1d(GGML_TYPE_I32, n_outputs) 的输入张量,再由 ggml_get_rows 只对选中行做输出投影。它的注释说明了一个 DeepInfer 不需要关心的约束:当 n_outputs < n_tokens 时本可以跳过 ggml_get_rows,但那样会让图的拓扑依赖输出行数,进而与 pipeline 并行所需的恒定拓扑冲突,所以它选择保留这次 gather。这是”选行”这个操作在不同执行模型下的形态差异:在 eager 框架里它是一个独立的 gather 调用,在静态图框架里它是图的一个节点,节点必须存在,形状就必须固定。
把五家的关键差异压成一张表:
| 框架 | 选行发生的位置 | 末行偏移的算法 | prompt logprobs 的处理 | 投机多行 |
|---|---|---|---|---|
| DeepInfer | C++ prepare_sampler_inputs | 逐请求游标 + out_len-1 | 独立索引,跨 chunk 累积 | 全行采样 + 草稿锚点 + 信息池 |
| vLLM | Python gpu_model_runner | query_start_loc[1:] - 1 | runner 内单独循环,按 chunk 切片 | target/bonus 两套索引 |
| SGLang | Python LogitsProcessor | cumsum(extend_seq_lens) - 1 | 三套逻辑行域 + token_to_seq_idx | select_index 只取草稿头所需行 |
| TensorRT-LLM | Python LogitsProcessor | cumsum(seq_lens) - 1 | 不裁剪,HandleLogits 按前缀和分发 | 按 beam 宽度与 draft 长度计行 |
| llama.cpp | 图内 out_ids + ggml_get_rows | ubatch->output 位图 | 全部位置输出(logits_all) | 由输出位图表达 |
表格里最值得对照的是最后一列。DeepInfer 把投机的多行做成”采样行 + 锚点 + 读写槽”三件套,vLLM 把它拆成 target/bonus 两套索引,SGLang 用 select_index 只取草稿头需要的行,TensorRT-LLM 把 beam 与 draft 一起算进行数,llama.cpp 则回到最朴素的位图:要哪一行就在 output 数组里标 1。五种表达方式背后是同一个约束——验证需要逐行的分布,而分布必须来自目标模型的前向。
五个框架放在一起,可以看到一条共同的设计线:每请求的”末行偏移”是基元,所有更复杂的行选择都是由它组合出来的——加一个减一就是 prompt logprob,加一个步长就是投机验证,加一个前缀和就是 input logprobs。选行的复杂度不在算术,而在哪些请求走哪个分支,以及分支之间的行域如何不互相污染。
两个交叉点:YoCo 截断与宽 EP 分片
选行函数有两个参数看起来与采样无关,其实直接影响行账:yoco_prefill_truncation_mode 与 yoco_prefill_keep_tokens;以及一个不在函数签名里、但在调用方决定的事实:当前 worker 是否持有这条请求的全部专家。
YoCo 截断是第一个交叉点。YoCo 的核心是让 prefill 的后续层只计算”尾部”一部分 token,因为早先 token 的贡献可以被截断近似吸收。开启 COMPACT 模式时,模型输出不再是 seqlen_q 行,而是 out_len 行:
const int q_start = seq_metadata->seqlen_k - seqlen_q;const int data_len = seq_metadata->seq_data->get_len();const int clip_prefix = std::clamp(data_len - yoco_prefill_keep_tokens - q_start, 0, seqlen_q - 1);out_len = seqlen_q - clip_prefix;clip_prefix 是被裁掉的行数,上界是 seqlen_q - 1。上界取减一的理由写在注释里:每个 prefill chunk 都要有一个 token 过采样,因此即使整个 chunk 被截断,也要保留至少一个占位 token,保证 selected_token_indices 有合法的 model output 行可寻址。采样行取 model_output_offset + out_len - 1,也就是保留区间的最后一行。
这里最容易出错的是 model_output_offset 与 query_token_offset 的分离。在 COMPACT 模式下,读指针必须按 out_len 走,不能按 seqlen_q 走;若误用后者,下一条请求的采样行会指向越界位置。prompt_logprobs 与压缩模式互斥的断言,本质上是在保护这种分离:prompt logprob 索引假设 model_output_offset + j 对应第 个 query 行,压缩后这个对应关系不再成立。YoCo 的完整机制见 KV 内存与 SWA 有界重放,这里只说选行侧的影响。
宽 EP 分片是第二个交叉点,但它不在 prepare_sampler_inputs 里,而在它的调用方。DeepInfer 在 Wide-EP 下按 EP rank 物化专家,隐藏状态在 MoE 层前后需要 dispatch/combine。选行发生在整个模型前向之后,此时每条请求的 hidden states 已经”回到”持有该请求的 rank 上。但如果一个 batch 被切到多个 DP rank,每张卡只看到自己那部分请求,selected_token_indices 也只在本地有效。这就是为什么 CP 需要广播选行结果,而 DP 不需要:DP 的每个 rank 独立维护自己的请求集合与自己的采样输入。prepare_sampler_inputs 的逐请求循环天然支持这种”本地视角”——它只处理传进来的 seq_metadata_list,从不假设自己看到了全局请求。
六个容易读错的细节
读完函数本身,还有六处细节值得单独记下来。它们不影响主流程,但决定了你排查问题时能不能快速定位。
第一,非末 chunk 的采样行是算了但不用。DeepInfer 在每个 prefill chunk 都会为每条请求选一行采样,哪怕这个 chunk 不是最后一个;SequenceMetadata 的构造函数会把非末 chunk 的 last_output_token 置为 −1,采样器据此跳过结构化输出状态更新。vLLM 的注释说得更直白:部分请求的采样结果会被忽略。两家的共同点是”仍然要算这一行”,因为采样内核需要一条完整的行来保持形状与参数对齐,丢弃比特殊分支更便宜。
第二,sample_positions 不是行号。prefill 填 seqlen_k,decode 填 seqlen_k - seqlen_q + 1。前者是”采样发生在 prompt 之后”,后者是”采样发生在第一个 query 位置”。若把它写成行下标,同一请求在同一位置的多次重放会得到不同随机数,batch-invariant 与投机验证的确定性都会失效。这个字段在 采样、惩罚与确定性校验 里是主角,在选行函数里它只是被搬运,但搬运错了同样致命。
第三,selected_prompt_indices 可以与 selected_token_indices 指向同一行。末 chunk 的最后一个 prompt token 所在行既可能是采样行(如果它是请求的最后一行),也可能是 prompt logprob 行(如果它不是最后一行)。两套索引互不排斥,采样器会分别 gather,分别处理。读代码时不要假设”一行只能属于一种用途”。
第四,减一取决于 chunk 边界,而不是 prompt_logprobs 的总长度。is_last_prompt_chunk() 是序列状态,不是本拍调度结果。如果调度器把一条请求的 prompt 拆成两个 chunk,第一块按 seqlen_q 算,第二块按 seqlen_q - 1 算;如果拆成三块,前两块都按 seqlen_q 算。总行数始终是 ,但每个 chunk 的贡献不同。任何按”固定每块减一”写的自定义逻辑都会少算。
第五,索引的 dtype 是 int32,token id 在写入前要过 checked_token_id。后者检查 int64 的 token id 能否放进 int32,不能就抛错。这不是吹毛求疵:词表大小接近 13 万,单个 id 远小于 int32 上限,但 model_output_offset 是行偏移,total_q 在极端长上下文下可能很大。代码选择用 int32 存行号,是用”批大小不会超过 21 亿”这个工程假设换一半的索引带宽。读到这里应当意识到:如果未来支持更长的单批,这些数组的 dtype 会成为第一个要改的地方。
第六,广播的五个键与本地计算的五个数组不是一一对应。mtp_info_read_rows、mtp_info_write_slots、stop_token_ids、golden_output 都在 driver 上算好后留在本地,没有进广播字典;follower 只需要 selected_token_indices、selected_prompt_indices、mtp_first_token_positions、mtp_seqlens_q 与 is_prompt。原因是 follower 不执行采样,也不写 MTP 信息池;它只需要知道 gather 哪些行、草稿头的锚点在哪。这也是为什么 SamplerInputs 的 Python 侧只重建了这几个字段。
选行下游:gather 之后到采样之前
行选出来之后,数据还要经过几步才能进入采样内核。这中间有一个环节最容易被认为与选行无关,但它的输入正是选行函数产出的长度:隐藏状态 gather 之后,按行展开采样参数。
Sampler.forward 的做法是:先判断 is_prompt,如果在 prefill,并且 selected_prompt_indices 不为空,就为 prompt logprob 行单独 gather 一份 hidden states;随后无条件按 selected_token_indices gather 采样行。两份 gather 互不影响,因为它们在不同的行域上工作,输出张量也分开持有。代码里有一句注释值得记住:
# CUDA Graph model_output retains graph-batch padding; gather trims hidden_states.hidden_states = gather(hidden_states, selected_token_indices)这句话把图批 padding 与真实请求数的关系说透了:图输出的行数可能大于真实批,selected_token_indices 的长度按真实批来写,于是 gather 之后张量被裁剪到真实行数。后续 get_logits、采样、输出记账都只看裁剪后的形状。如果索引里混入了指向 padding 行的值,gather 会返回零行,采样结果对这些行毫无意义,但它们不会污染真实请求——因为采样器按 num_reqs 读取结果。
expand_sampling_params 是另一个与选行长度直接耦合的环节。它的实现是三个 gather 加一次加法:
temperatures_q = params.logits.temperatures[req]seq_seeds_q = params.seq_seeds.view(torch.int64)[req].view(torch.uint64)sample_positions_q = params.sample_positions[req] + local_step * DRAFT_POS_HASH_MULreq 是 [total_q] 的 row_to_req,local_step 是每行在请求内的序号。这里有两个工程细节。第一,seq_seeds 是 uint64,PyTorch 的高级索引对 uint64 支持不完整,所以先 view(int64) 索引再 view(uint64) 还原;位模式不变,只是借用 int64 的索引路径。第二,位置混入用的是加法,不是乘加,local_step 先乘一个固定奇数常数(DRAFT_POS_HASH_MUL)再相加。选择奇数是哈希的常见做法:乘奇数在模 下是双射,不同的 local_step 不会因为乘法产生碰撞;而乘偶数会让低位信息丢失,某些步长下会把不同步映射到同一位置。这个常数不是论文里的参数,而是一个让随机流按步长散开的工程选择。
参数展开之后,行空间才算完整:每一行同时有 hidden state、温度、top-p、top-k、seed 与位置。采样内核可以完全按行工作,不再需要知道这一行属于哪条请求的第几步。从选行到展开,整个链路的设计目标是一致的——把按请求的组织信息,在进入 kernel 之前全部压平成按行。这样内核的并行维度只有一个,不需要分支,也不需要跨请求的边界判断。
force_topk 在展开之后还有一次行内操作:先用 topk 把每行 logits 裁到 top-k,返回裁剪后的 logits 与 token_index;采样在这个小空间里做;最后用 map_lookup 把草稿 token 或目标 token 映射回小空间。由于裁剪后的 token 下标是局部的,草稿头与目标模型之间的同一个 token 需要一次 remap:remap_draft_topk 把草稿 top-k 索引按目标 top-k 的 token 集合重新排序,映射不到的草稿 token 被标记为 −1,接受判定直接拒绝。这和选行的思想相同:不同视角下对同一行的定义不同,必须显式建立映射,而不能假设下标一致。
一张核对表
如果要在自己的环境里验证这些算术,最省事的办法是用两条请求、一段短 prompt、一个强制分块的配置,把中间结果打印出来对照。下面这张表可以作为对照基准。
| 场景 | selected_token_indices | selected_prompt_indices | sample_positions | mtp_first_token_positions |
|---|---|---|---|---|
| prefill,两条请求长度 6/3,均不开 logprobs | [5, 8] | None | [6, 3] | 不适用 |
| prefill,A 开 logprobs、B 不开 | [5, 8] | [0,1,2,3,4] | [6, 3] | 不适用 |
| prefill 分两块,A 的第一块长度 4 | [3] | [0,1,2,3] | [4] | 不适用 |
| decode,两请求,均 1 行 | [0, 1] | None | [s_k, s_k] | [0, 1] |
| decode,A 有 2 个草稿、B 有 1 个 | [0,1,2,3,4] | None | [s_k-2, s_k-1] | [0, 3] |
表里的 s_k 是各请求本拍的 seqlen_k。这张表只覆盖最常见的组合,真正的价值在于它给出了”行数、偏移、长度”三者的对应关系:看到任何一个数组的长度不对,就能反推出是哪条请求的哪个分支多算或少算了一行。
小结
选行是推理引擎里最不像”优化”的优化。它没有 kernel 技巧,没有通信重叠,也没有图捕获;它只是几个循环和几个偏移,把哪些行值得花 LM Head 的算力这件事算清楚。但正是这几个偏移,决定了 prefill 的 32K token 不会变成 16.9 GB 的 logits,决定了 prompt logprobs 能按 chunk 拼接,决定了投机解码的 行能各归其位。
DeepInfer 的实现有三条值得记住的设计选择。第一,用游标而不是前缀和:model_output_offset 逐请求推进,天然支持 YoCo 这种”行数会被截断”的布局,代价是必须严格区分读指针与写指针。第二,把 prompt logprobs 做进统一选行函数:它没有走”单独循环”的捷径,而是和采样行共用同一套偏移,换来的是 C++ 侧一次算清、driver 一次广播。第三,把行选择与图执行解耦:索引是数据,行数是形状;图按形状分档,索引每拍可换。
下一篇继续沿采样路径往下,进入 fused_sample 内核内部:top-k 与 top-p 如何在一次遍历里完成裁剪、log-softmax 怎样避开溢出、拒绝重采样如何复用已经算出的残差分布,以及种子流如何让同一请求的多个草稿步互不相关。
参考资料
- DeepInfer 官方仓库
- prepare_sample.cpp:prepare_sampler_inputs 的完整实现
- sampler_utils.py:get_logits、compute_prompt_logprobs 与 split_prompt_logprobs
- process_output.hpp:update_prompt_logprobs 的跨 chunk 累积
- sampling_inputs.py:SamplerInputs 的 Python 侧定义与 MTP 输入
- vLLM gpu_model_runner.py:logits_indices 与 prompt logprobs 路径
- SGLang logits_processor.py:last_index 与四套索引
- llama.cpp llama-graph.cpp:out_ids 与 LM Head 的行选择
- TensorRT-LLM 官方仓库
- Jay Alammar, The Illustrated GPT-2
- Jay Alammar, The Illustrated Transformer
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



