


前缀缓存命中之后:五个推理框架如何把一段旧 KV 接进一次新前向
先问一个容易忽略的问题
前缀缓存(prefix caching)的文章通常把注意力放在“怎么找”:怎么建前缀树、怎么算块哈希、淘汰时该丢谁。这些问题当然重要,但一次真实的命中并不止于“找到了”。从调度器确认命中,到 GPU 真正跑出第一个新 token,中间还有一段很长的路:命中长度要写回请求的记账,块表要拼成一次前向能用的形状,查询的位置编号要从命中点之后开始,注意力元数据要告诉 kernel 哪些块只读、哪些块要写,最后还要决定命中之后剩下的 token 是走 prefill 还是直接进 decode。
这段路在不同框架里长得完全不一样。同样是“命中 2048 个 token”,vLLM 可能只认整块,SGLang 的树匹配落在页边界上,TensorRT-LLM 的块复用要经过资源管理器的事件,llama.cpp 在上下文里做 token 级公共前缀裁剪,DeepInfer 则把命中数当成外部缓存系统注入的一个数字,再围绕 SWA 状态做有界重放。命中粒度的差异,最终会变成位置编号、mask、KV 写入边界和 TTFT 的差异。
这篇文章只追一条路径:命中之后。前缀树的构造、淘汰策略和哈希细节在站内已有专文,这里只在必要处引用,不重复展开。先看五个框架各自的“命中交接”代码,再把它们放到同一张对照表上,最后讨论一个实际工程问题:为什么同样一条 prompt,命中长度会在五个框架里给出五个答案。
命中之后到底要交接什么
在逐个读代码之前,先把“交接”拆成六个可以独立核对的问题。后面每个框架都用这六个问题检查一遍,这样横向对比才有统一口径。
第一,谁负责匹配。 有的框架由调度器直接持有缓存管理器,匹配发生在 schedule() 里;有的框架把匹配做成一个独立的、可被外部调用的探测接口,调度器只是消费结果;还有的框架把匹配藏在模型执行器内部,调度器只看到“这段前缀可以复用”。
第二,命中长度怎么对齐。 块哈希只能给出整块命中,SGLang 的 radix 树可以精确到 token,但页大小大于 1 时又会把结果向下取整到页边界。命中长度如何对齐,直接决定“最后一个命中块能否整体复用”。
第三,命中块的引用计数怎么涨。 命中不等于占用。命中块可能正被别的请求使用,可能已经被标记为可淘汰,也可能处在“已淘汰但仍可复活”的状态。块表里到底是直接引用原块,还是复制一份。
第四,位置编号从哪里开始。 这是最容易出错、也最少被讨论的一环。查询的位置不是从 0 开始,而是从命中长度开始;如果有投机解码的草稿 token,位置还要再往后延伸;如果是 SWA 有界重放,位置还必须保证可见窗口完整。
第五,注意力 mask 怎么表达“前半段只读”。 命中段的 KV 已经在池里,本次前向不需要再次写入;但查询仍然要 attend 到它们。分块 KV 的 block table、连续 KV 的 slot 映射、SWA 的 ring buffer,对“只读段”的表达方式各不相同。
第六,命中之后是否还要算。 有一种情况是全命中:prompt 的每个 token 都命中了。这时模型仍需计算最后一个 token,以拿到 logits。另一种是部分命中,剩下的 token 走 prefill。还有一种是在分块 prefill 的中间 chunk 上,命中段之前的部分已经被别的 chunk 计算过,这一 chunk 要接着往后算。
把这六个问题记住,读下面的源码就不容易迷路。
vLLM:块哈希、整块命中与 num_computed_tokens
vLLM 的前缀缓存建立在块哈希上。hash_block_tokens 把每个块的 token 与前一个块的哈希串起来,形成链式哈希;只有前一个块命中,后一个块才可能命中。这一点决定了 vLLM 的匹配一定是“从头开始的一段连续整块”。
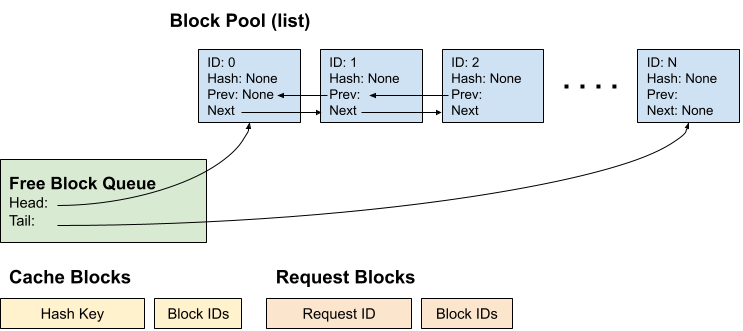
(图源:vLLM 官方设计文档“Automatic Prefix Caching”。图中 BlockHash、BlockPool 与 KVCacheManager 的关系,正是下文 get_computed_blocks 到 allocate_slots 的调用链。)
匹配入口:get_computed_blocks
vLLM V1 的调度器在把一个 waiting 请求放进本轮 batch 之前,先调用 KVCacheManager.get_computed_blocks。这个函数的返回值是三元组:命中块、命中 token 数、以及一个 shared_prefix_boundary。
def get_computed_blocks(self, request: Request): if not self.prefix_cache_lookup_enabled(request): return self.empty_kv_cache_blocks, 0, 0
# 全命中时也必须重算最后一个 token 以得到 logits max_cache_hit_length = request.num_tokens - 1 computed_blocks, num_new_computed_tokens, num_uncached = ( self.coordinator.find_longest_cache_hit( request.block_hashes, max_cache_hit_length ) ) ... blocks = self.create_kv_cache_blocks(computed_blocks) return blocks, num_new_computed_tokens, shared_prefix_boundary这里有两个细节值得停下来看。第一,max_cache_hit_length 被截断到 num_tokens - 1。原因写在注释里:如果所有 token 都命中,模型没有任何新 token 可算,就拿不到 logits。所以必须留最后一个 token 重算。第二,因为 allocate_slots 要求 num_computed_tokens 按块对齐,这个截断在实践中会触发整个最后一块的重算,而不仅仅是一个 token。注释也坦承“移除这个限制可以在未来略微提升性能”。
find_longest_cache_hit 本身在两种协调器里实现不同。UnitaryKVCacheCoordinator 是单组,直接把 block_hashes 交给唯一的单类型管理器;HybridKVCacheCoordinator 要处理多个 KV 组(例如 Mamba + 全注意力),用迭代不动点的方式不断降低候选长度:
while True: curr_hit_length = hit_length for idx, (spec, group_ids, manager_cls, use_eagle) in enumerate( self.attention_groups ): ... hit_blocks, _new_hit_length = manager_cls.find_longest_cache_hit( block_hashes=block_hashes, max_length=_max_length, kv_cache_group_ids=group_ids, block_pool=..., kv_cache_spec=spec, drop_eagle_block=drop_eagle_block, alignment_tokens=self._cache_hit_alignment_tokens, dcp_world_size=..., pcp_world_size=..., )每个注意力类型要么接受当前长度,要么降低它。只要有一类降低了,循环就从头再检查所有类型。因为长度单调下降且下界为 0,算法收敛。全注意力组有一个优化:它是“向下封闭”的,一旦查过一遍缓存块,后续只按降低后的长度裁剪即可,无需再查树。
FullAttentionManager.find_longest_cache_hit 的第一阶段是从头开始的连续整块遍历:
for block_hash in itertools.islice(full_block_hashes, max_length // block_size): cached_block = block_pool.get_cached_block(block_hash, kv_cache_group_ids) if not cached_block: break for computed, cached in zip(computed_blocks, cached_block): computed.append(cached)hit_length = len(computed_blocks[0]) * block_size链式哈希保证了“碰到第一个 miss 就可以停”。如果哈希块大小小于缓存块大小(细粒度哈希),还有第二阶段:在第一个未满块内部,从高到低探测内部哈希边界,找到最长命中。这是 hash_block_size < block_size 的细粒度模式下才有的路径。
命中之后:allocate_slots 的三段布局
命中块拿到手之后,调度器进入 allocate_slots。这个函数的 docstring 里画了一张布局图,几乎就是 vLLM 对“命中之后”的完整定义:
| < comp > | < new_comp > | < ext_comp > | < new > | < lookahead > |其中 comp 是请求此前已经计算过的 token(同一请求在分块 prefill 中上一轮算过的部分),new_comp 是本轮刚刚通过前缀缓存命中的本地块,ext_comp 是 KV connector 从别的实例加载来的块,new 是本次要新计算并分配的 token 数,lookahead 是投机解码草稿需要的预留槽。
这个布局有一个很实际的后果:num_computed_tokens 是三个来源之和,而注意力 kernel 只看到 num_computed_tokens 这一个标量。命中段和已有段在 kernel 眼里没有区别,都是“可以直接读的 KV”。
位置与 mask:从 num_computed_tokens 出发
命中写入请求状态后,后续所有派生量都从这个数字出发。在 gpu_model_runner.py 里:
self.positions[:total_num_scheduled_tokens] = ( self.num_computed_tokens[req_indices_gpu].to(torch.int64) + self.query_pos.gpu[:total_num_scheduled_tokens])self.seq_lens[:num_reqs] = ( self.num_computed_tokens[:num_reqs] + num_scheduled_tokens_gpu)位置 = 已计算 token 数 + 本批内查询序号。如果命中 2048 个 token、本轮调度的查询是 256 个 token,位置就是 2048 到 2303。query_start_loc 按请求累加本批调度 token 数,seq_lens 是“已计算 + 本批调度”,注意力 kernel 用两者推导 chunked prefill 的 mask。
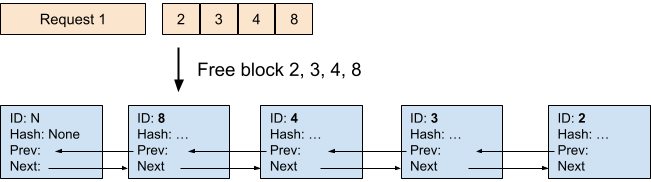
(图源:vLLM 官方设计文档“Automatic Prefix Caching”。图中空队列与可复用队列的分离,解释了为什么命中块的重新占用必须走“从空队列取出”而不是从缓存队列直接拿。)
一个容易被忽略的细节在细粒度哈希模式下:_cache_partial_tail_block 只把 prompt 的最后一个哈希边界注册为部分前缀项,中间边界故意不登记。原因是重复发送的 prompt 最多命中 prompt_len - 1,而 EAGLE 的查找会读过整个 prompt 再丢掉一个哈希单位。这些设计共同决定了:vLLM 的命中永远是“从头开始、整对齐、最后一个 token 必重算”。
EAGLE 的额外扣减
find_longest_cache_hit 在启用 EAGLE / MTP 时还有一个 drop_eagle_block:命中后主动丢掉最后一个命中单位。原因在 docstring 里:EAGLE 需要生成点之前的 token 重新计算,以得到 hidden states 供草稿头使用。细粒度模式下丢一个哈希单位,粗粒度模式下丢一个缓存块,然后按 alignment_tokens 向下取整、裁剪多余块。
这一条对后面横向对比很关键:投机解码会主动缩短前缀命中。同一段 prompt,开不开 EAGLE,命中长度就可能差一个块。
SGLang:radix 树的精确匹配与页对齐
SGLang 的前缀缓存是 RadixAttention,树节点存的是 token id 数组而不是块哈希。因此它天然支持 token 级精确命中;但 SGLang 同样把 KV 放在页里,页大小大于 1 时匹配结果会被取整。
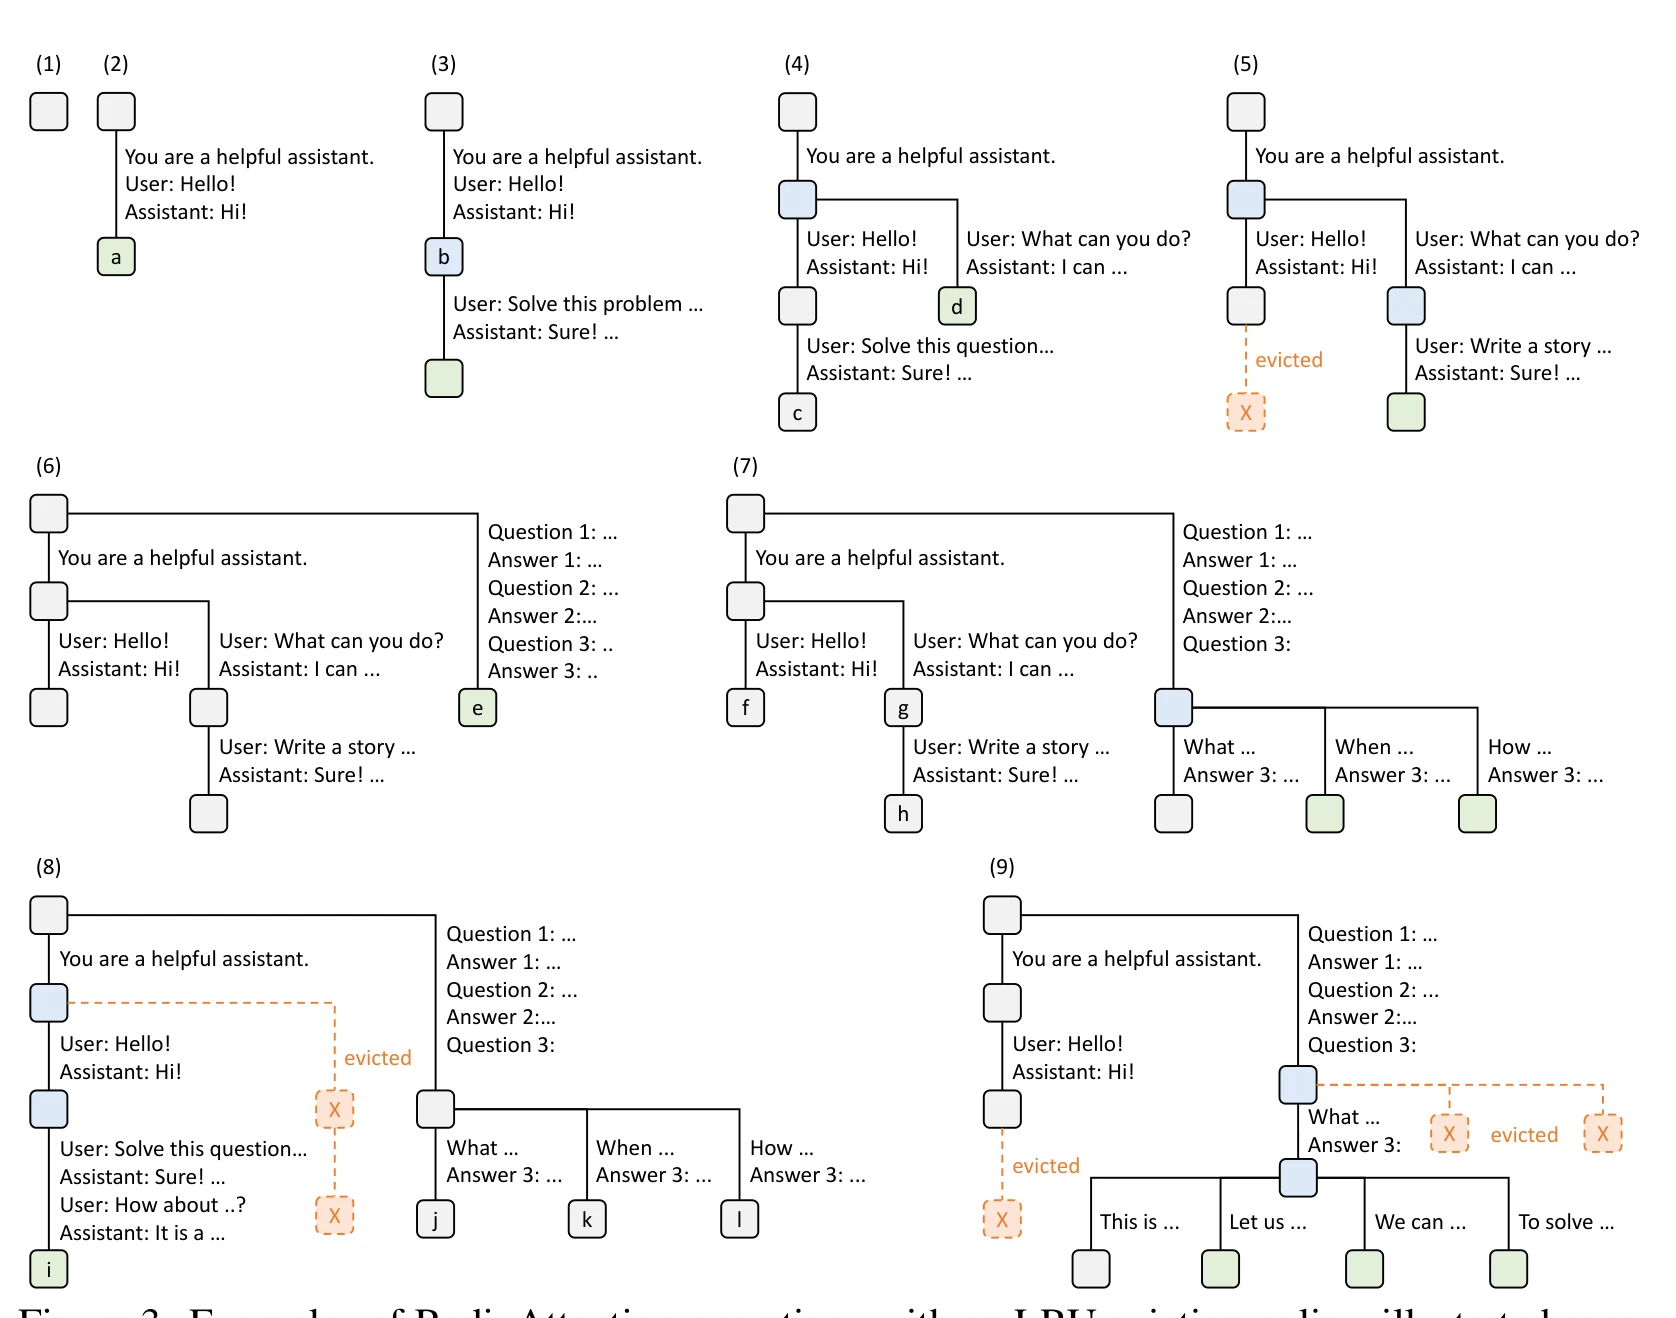
(图源:SGLang / RadixAttention 论文 图 3。图中同一棵树上同时挂着多个会话的共享前缀,命中之后要锁住路径节点,这和下文 match_prefix 返回 last_device_node 的设计直接相关。)
RadixKey.match:指数搜索加二分
RadixKey.match 负责在两个 token id 数组之间找公共前缀长度。它不是逐 token 循环,而是用「倍增窗口 + 二分」的方式,在 C 层做切片比较:
matched_tokens = nlo = 0step = 1while lo < n: hi = lo + step if lo + step < n else n if t0[lo:hi] != t1[offset + lo : offset + hi]: while hi - lo > 1: mid = (lo + hi) // 2 if t0[lo:mid] == t1[offset + lo : offset + mid]: lo = mid else: hi = mid matched_tokens = lo break lo = hi step *= 2
matched_tokens = min(matched_tokens, len(self), len(other) - offset)if page_size == 1: return matched_tokensreturn (matched_tokens // page_size) * page_size最后两行是重点:页大小大于 1 时,命中长度向下取整到页边界。这与 vLLM 的整块对齐是同一种思想的两种表达——只不过一个按哈希块,一个按页。
match_prefix 与节点分裂
match_prefix 返回 device_prefix_len 与 last_device_node。遍历过程中,如果匹配停在一个已存段的中间,会调用 _split_node 把这个段一分为二,让命中边界成为树上的真实节点。这样后续的“锁路径”和“插入”都落在精确边界上。
命中之后,SGLang 并不是立刻把节点锁死给请求;它要等 prefill 真正插入了这段 KV、完成 checkpoint 之后,才把 req.lock 从旧节点切换到新节点:
self.token_to_kv_pool_allocator.free_segment( kv_indices[req.kv.cache_protected_len : result.prefix_len], start_pos=req.kv.cache_protected_len,)return radix_key, kv_indices, result.prefix_len这段代码出现在 _insert_cache 之后:cache_protected_len 是请求仍然私有的部分,prefix_len 是整个前缀。已经被树保护的部分归还给分配器,请求只保留自己额外拿到的段。
prefix_len 如何变成 batch 的 prefix_lens
命中长度最终要落到 ScheduleBatch 上。SGLang 在组 batch 时,把每个请求的 prefix_len 和 extend_len 放进列表:
self.prefix_lens = prefix_lensself.extend_lens = extend_lensself.seq_lens = seq_lens_tensorself.extend_num_tokens = extend_num_tokens这里还有一个多模态的剔除步骤:如果编码器输出的 token 已经算过,encoder_len 会从 prefix_lens 和 extend_lens 里扣掉,保证“prefix 不跨编码器边界”。这说明前缀命中在 SGLang 里不是一个孤立数字,而是要在 prefill 输入组装阶段和编码器、图像 token 边界一起被修正。
位置:compute_position 从 extend_prefix_lens 开始
ForwardBatch.init_new 里,extend 模式会调用 compute_position,后者按每个请求的 extend_prefix_lens 和 extend_seq_lens 生成位置序列:
positions = torch.cat([ torch.arange(prefix_len, prefix_len + extend_len, device=...) for prefix_len, extend_len in zip(extend_prefix_lens, extend_seq_lens)], dim=0)这与 vLLM 的表达式在数学上完全等价,只是 vLLM 用“标量 + 批内序号”,SGLang 用“每个请求的 prefix_len 生成 arange”。两种写法对 kernel 的语义是一样的:命中段的位置已经被占用,新查询从 prefix_len 开始编号。
KV 写入:out_cache_loc 只覆盖新算段
SGLang 的 alloc_for_extend 返回 out_cache_loc,它是“新算 token 的 KV 槽位”,不是“命中 token 的槽位”。命中段的槽位已经在请求的 req_to_token_pool 行里,或者已经在树的路径上。forward 结束后,这些新槽位通过 checkpoint 写回树,成为后续请求可命中的部分。
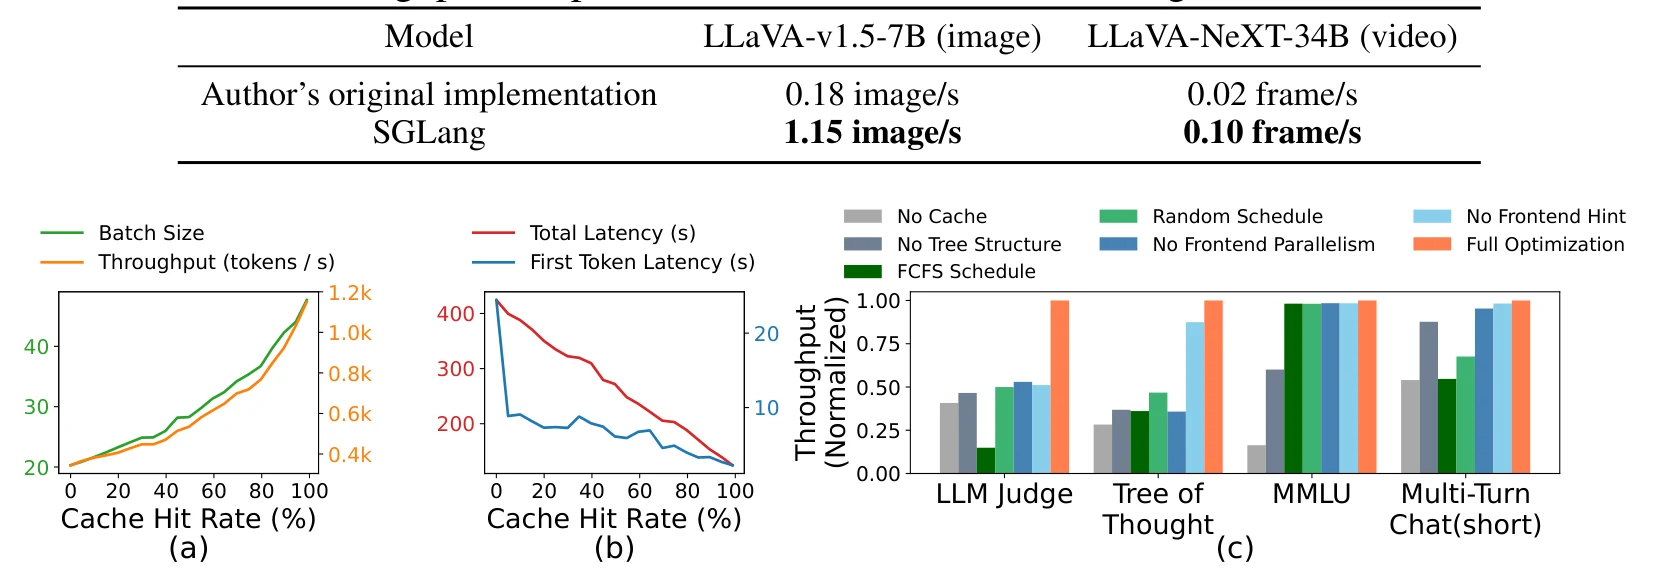
(图源:RadixAttention 论文(SGLang) 图 8。左侧击中率消融说明树缓存对请求序列的敏感性,右侧 RadixAttention 对比说明共享前缀在多轮任务中的收益规模。)
llama.cpp:上下文里的公共前缀裁剪
llama.cpp 没有独立的块哈希和 radix 树。它的“前缀缓存”是 server 的 slot 策略:每个 slot 保存上次处理过的 prompt token 序列,新请求到达时,如果选择复用某个 slot,就在该 slot 的 token 序列和新输入之间求公共前缀。
slot 选择:LCP 相似度
server-context.cpp 在选择空闲 slot 时,会计算每个已缓存 slot 的公共前缀长度与输入长度的比值:
const size_t lcp_len = tokens.get_common_prefix(task.tokens);const float f_sim_cur = float(lcp_len) / task.tokens.size();if (f_sim_cur > f_sim_best && f_sim_cur > slot_prompt_similarity) { f_sim_best = f_sim_cur; ret = &slot;}如果选中的 slot 会丢掉它超过一半的已有上下文,就先把当前上下文存进 prompt cache(update_cache = true),然后再进入下一步。
n_past 与 seq_rm
真正的交接发生在 slot 开始处理新任务时。n_past 是“可以复用的 token 数”,由 get_common_prefix(input_tokens) 得到,再用几项硬上限裁剪:
n_past = slot.prompt.tokens.get_common_prefix(input_tokens);if (slot.task->n_tokens_shared > 0) n_past = std::min(n_past, slot.task->n_tokens_shared);if (n_decision_first >= 0) n_past = std::min(n_past, n_decision_first);if (slot.alora_invocation_start > 0) n_past = std::min(n_past, slot.alora_invocation_start - 1);这几项硬上限分别对应:共享前缀的子请求不能越过父请求的共享边界;decision 任务必须重新评估首位置;alora 调用之后的部分不能被缓存。这些限制不是“优化”,而是正确性边界。
然后是最关键的一步:把上下文里的 KV 裁剪到 n_past。裁剪之前还要处理 SWA 与 checkpoint:
const llama_pos pos_eval = pos_next - (has_new_tokens ? 0 : 1);const auto pos_min_thold = std::max(0, n_swa > 0 ? pos_eval - n_swa + 2 : pos_eval);如果当前上下文的最小位置 pos_min 已经不满足 SWA 窗口要求(例如 SWA 或混合循环层已经丢掉了更早的 KV),就会尝试恢复最近的 checkpoint;如果没有可用 checkpoint,就强制全量重算:
if (do_reset) { pos_next = 0; n_past = 0;}最后还有一个“至少算一个 token”的保护:
if (n_past == slot.task->n_tokens() && n_past > 0) { n_past--;}这和 vLLM 的 num_tokens - 1 截断是同一个道理的两种写法。
n_cache_reuse:块移位复用
llama.cpp 还有一个 vLLM / SGLang 都没有的机制:n_cache_reuse。当新 prompt 与旧 prompt 不只是头部相同,而是中段也有大块相同文本时,可以把旧 KV 的一段平移到新位置复用:
while (head_c < slot.prompt.tokens.size() && head_p < input_tokens.size()) { size_t n_match = 0; while (head_c + n_match < ... && slot.prompt.tokens[head_c + n_match] == input_tokens[head_p + n_match]) n_match++; if (n_match >= (size_t) n_cache_reuse) { const int64_t kv_shift = (int64_t) head_p - (int64_t) head_c; slot.mem.seq_rm(slot.id, head_p, head_c); slot.mem.seq_add(slot.id, head_c, head_c + n_match, kv_shift); ... } else { head_c += 1; }}前提是 llama_memory_can_shift 为真。它本质上把“前缀命中”从“头部公共前缀”扩展到了“中段块匹配”,代价是需要按位置平移 KV,并且对不支持 shift 的注意力类型(例如部分 SWA 实现)会直接禁用。
位置与写入
llama.cpp 的位置来自 slot.prompt.tokens.pos_next(n_past),它是“token 序列中第 n_past 个 token 的绝对位置”。命中段的 KV 已经在上下文里,新 token 继续往后追加;seq_rm 已经删掉了 n_past 之后的部分,所以 seq_add 只会写入新的 token。
llama.cpp 的代表性在于:它没有块池,也没有跨请求共享的树,命中收益来自“同一个 slot 的上下文复用”。这让它的命中粒度最细(token 级),但命中范围也最窄(只在同一 slot 的保留上下文中)。
TensorRT-LLM:资源管理器的事后校正
TensorRT-LLM 的交接路径最绕。它不是“调度器先问命中再分配”,而是“调度器先把请求放进批里,资源管理器在 addSequence 时查复用树,然后再倒回来校正 token 预算”。
微批调度器只看到估算值
TensorRT-LLM 的 MicroBatchScheduler 在准入时使用的是一个估算值 estimated_reusable_tokens,它来自 radix 树的探测。真正的复用长度 prepopulated_prompt_len 是在 KVCacheManager.addSequence 里算出来的:
for (size_t i = 0; i < n; ++i) { auto& llmRequest = llmRequests[i].get(); if (mEnableBlockReuse) { llmRequest.setPrepopulatedPromptLen(minPrepopulatedLen[i], getTokensPerBlock()); llmRequest.setEstimatedReusableTokens(0); }}minPrepopulatedLen 是“所有窗口里最小的预填充长度”。Variable SWA 下同一个序列会被多个窗口管理器处理,每个窗口能匹配的长度不同,取最小值保证所有窗口都对得上。
事后校正:maybe_fit_token_budget
问题在于估算值和真实值可能不一致。resource_manager.py 里有一段很长的注释,解释为什么必须在所有管理器跑完之后再裁剪 token 预算:
The micro-batch scheduler admits the batch on estimated_reusable_tokens (a radix-tree guess). The real reuse is prepopulated_prompt_len, computed inside addSequence. #13318 is the case where the two differ, so no check running before addSequence can see the divergence.
Until setPrepopulatedPromptLen runs, context_chunk_size still spans the reusable prefix — it is not a token count, and reading it as one over-charges a reuse hit by the whole cached prefix.
这段注释直接回答了本文的核心问题之一:命中长度在调度器的两个阶段是两个不同的数字,一个是估算,一个是真相。TensorRT-LLM 选择“先按估算准入,再用真相修正”,修正点放在 prepare_resources 的末尾:
def prepare_resources(self, scheduled_batch): for _, resource_manager in self.resource_managers.items(): if hasattr(resource_manager, "prepare_resources"): resource_manager.prepare_resources(scheduled_batch) self.maybe_fit_token_budget(scheduled_batch)裁剪之所以安全,是因为它只缩小、不推迟:没有请求被移出 batch,因此注意力 DP 的投票、PP 的 inflight 集合、前面所有管理器的每请求状态都与当时计算的 batch 一致。
资源探测接口:probe_prefix_match_length
TensorRT-LLM 还暴露了一个独立的探测接口,供 cache-aware 路由使用:
def probe_prefix_match_length(self, input_tokens, lora_task_id=None, cache_salt=None): if not self.enable_block_reuse: return 0 ... block_key = BlockKey(tokens=input_tokens, lora_task_id=lora_task_id) unique_tokens = block_key.unique_tokens dummy_req = CppLlmRequest(request_id=0, max_new_tokens=0, input_tokens=input_tokens, ...) summary = self.impl.analyze_prefix_reuse(unique_tokens, dummy_req) return summary.reusable_blocks_all * self.tokens_per_block注意它用的是 reusable_blocks_all 而不是 reusable_blocks_allocated。前者是“树上存在”的块,后者是“当前仍被引用、一定可用”的块。路由阶段还没有分配,所以用前者;真正 addSequence 时会再检查引用状态。analyzePrefixReuse 的底层实现还显式禁用了 partial reuse:
auto reuseMatches = findReusableBlockMatches( blockKeys, /*enablePartialReuse=*/false, /*copyOnPartialReuse=*/false, ...);这是因为分析阶段不应该产生副作用(复制或部分复用会改块状态),真正复用时才按配置启用。
位置:context_current_position
TensorRT-LLM 的 LlmRequest 有两个容易混淆的位置量:context_current_position 与 context_chunk_size。命中之后,context_current_position 从 prepopulated_prompt_len 开始;_pack_context_requests 里:
begin_compute = request.context_current_positionend_compute = begin_compute + request.context_chunk_sizeprompt_tokens = request.get_tokens_range(0, begin_compute, end_compute)position_ids.extend(range(begin_compute, begin_compute + len(prompt_tokens)))位置 = 当前上下文位置到当前 chunk 结束。context_chunk_size 在 setPrepopulatedPromptLen 之前包含整个复用前缀,所以不能在之前把它当成 token 数;这也正是 maybe_fit_token_budget 必须后移的原因。
还有一个“lookahead token”的细节:如果当前 chunk 不是最后一个,会取 chunk 结束处的下一个 token 作为 context_prompt_lookahead,供某些模型在最后一块时预测下一块的开头。命中长度改变 chunk 边界时,这个 lookahead 也要跟着变。
DeepInfer:外部缓存注入与 SWA 有界重放
DeepInfer 与前四个最大的不同是:它的开源版本里没有前缀树。README 明确写着完整推理服务还需要一个 KV cache system,而开源的 DeepInfer 只提供引擎本体。命中数在请求进入引擎时由外部系统注入,调度器把它当成一个已经存在的 cache.num_tokens。
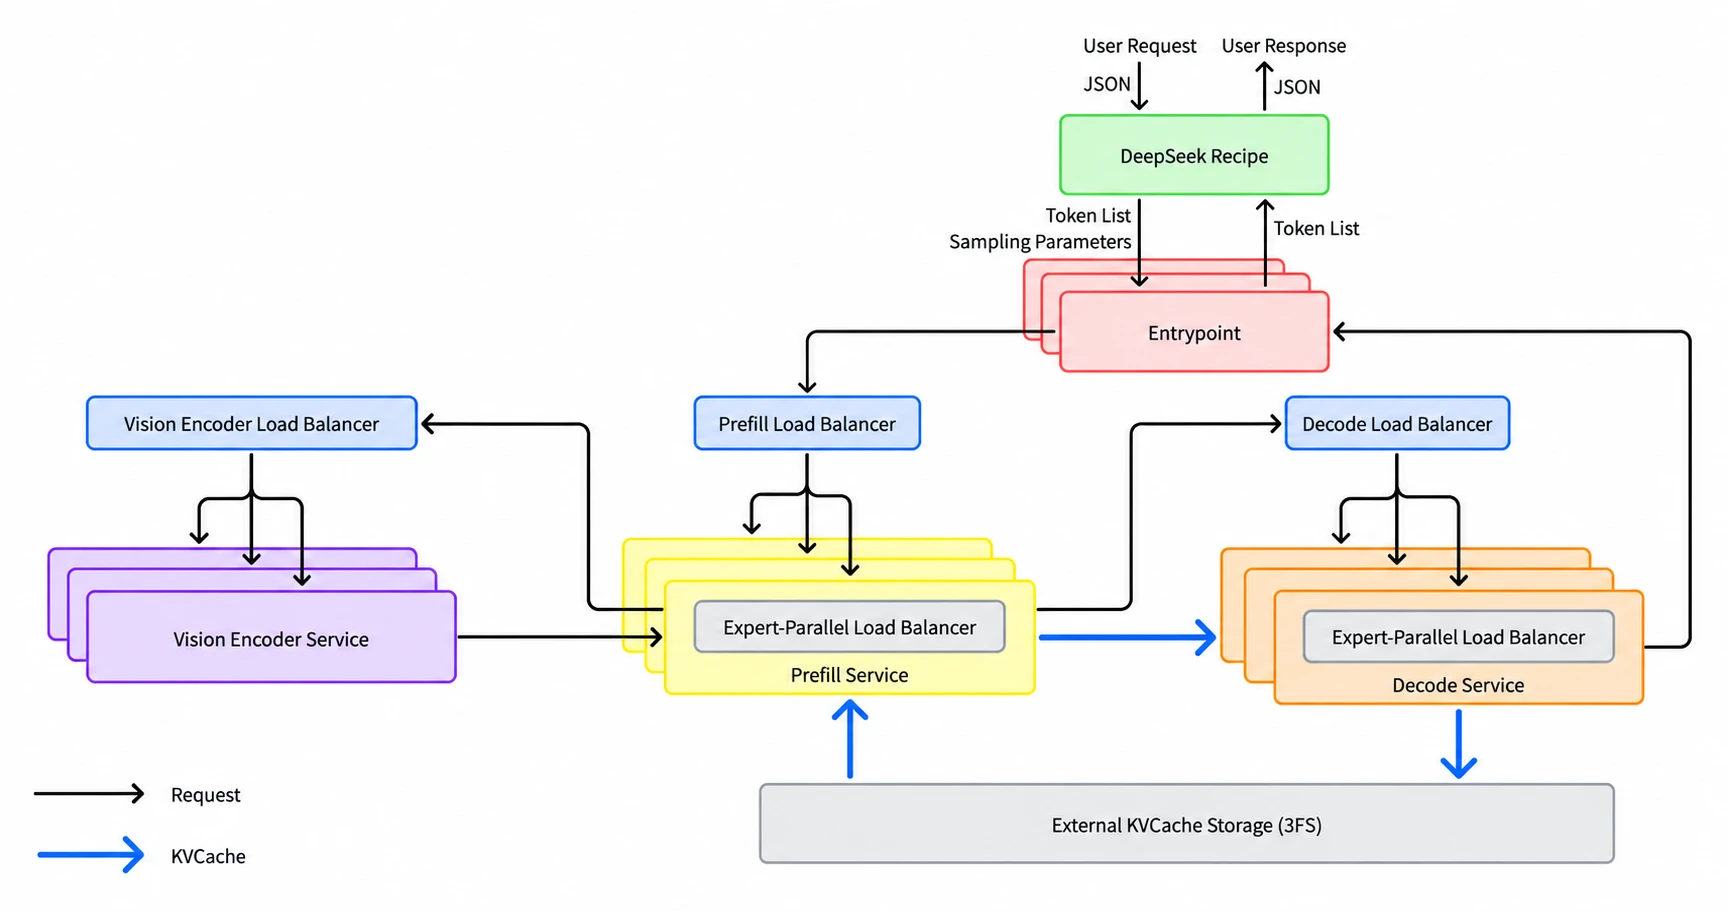
(图源:DeepInfer 官方仓库 文档图。图中被标注为“not included”的 KV cache system 与 P/D 分离部分,正是命中数注入与 KV 装载的边界。)
命中数是一个外部注入的标量
Sequence 的 C++ 状态里,命中数不是一个专门的 hit_tokens 字段(虽然存在 cached_hit_tokens 属性,但在开源路径里并不参与调度),而是 cache.num_tokens:
struct KvCacheState { int block_size{0}; int previous_num_tokens{0}; int num_tokens{0}; int hit_tokens{0}; int swa_valid_start{0}; std::vector<int> block_table; int state_id{-1}; int last_copy_state_token_idx{0};
void set_num_tokens(int value) { num_tokens = value; previous_num_tokens = value; }};外部系统把 KV 块直接写进 GPU 池、把块表填进 block_table,然后把 num_tokens 设为命中长度。调度器只关心 num_tokens > 0 且 block_table 非空。
fork:把一段前缀复制给一批请求
DeepInfer 提供了一个 fork_seq 接口,给测试与上层系统复用:从一个已经 prefill 过前缀的源序列,fork 出一批共享同样前缀的新序列:
SequencePtr fork_seq(const SequencePtr &seq, py::object blocks, std::string &&target_branch_id, ...) { TORCH_CHECK(seq->cache.num_tokens > 0, "Cannot fork a sequence without a computed prefix"); const bool prompt_incomplete = seq->cache.num_tokens < seq->get_len() - 1; ... init.cache.block_table = seq->cache.block_table; // 或外部传入的 blocks ... fork_seq->cache.set_num_tokens(std::min(seq->cache.num_tokens, fork_seq->get_len() - 1)); ... block_manager->pin_blocks(fork_seq->cache.block_table); if (state_manager) { fork_seq->cache.state_id = seq->cache.state_id; state_manager->pin_block(seq->cache.state_id); } if (prompt_incomplete) { waiting.emplace_front(fork_seq); } else { prompted.emplace_back(fork_seq, true); }}三个细节:set_num_tokens(min(num_tokens, get_len() - 1)) 同样保留了最后一个 token;块表被 pin 住,防止源序列释放后 fork 的序列读到已回收块;如果源序列的 prompt 已经完整(prompt_incomplete 为假),fork 出来的序列直接进 prompted 队列,跳过 prefill。
注意 state_branch_id 与 block table 的关系:fork 时如果不提供 blocks,新序列直接引用源序列的块表、并把它们 pin 住。这意味着上层系统只负责“源序列的命中段在哪”,DeepInfer 自己负责引用计数。
命中之后的调度:chunked prefill 从 num_tokens 起算
_schedule_prefill 里,num_prompt_tokens = seq->get_len() - seq->cache.num_tokens。如果 num_tokens == 0,走普通前缀查找分支(开源版里其实是“没有命中”);如果 block_table 非空,则走 branch_id 以 _ 开头的 fork 分支:
if (seq->schedule.branch_id.compare(0, 1, "_") == 0) { _clone_state(*seq); auto new_blocks = block_manager->allocate_nolock(to_allocate_blocks); if (seq->cache.num_tokens % seq->cache.block_size) { // 有尾巴,需要 copy clone_blocks.emplace_back(seq->cache.block_table[num_reserve_blocks]); clone_blocks.emplace_back(new_blocks.front()); } for (size_t i = ...; i < seq->cache.block_table.size(); ++i) { clone_blocks.emplace_back(seq->cache.block_table[i]); clone_blocks.emplace_back(0); }}fork 的序列如果与源序列共享最后一个不完整块,会先把那个块复制到新块(clone_blocks 是 (src, dst) 对,dst=0 表示只归还 src),然后让新序列拥有自己的尾巴块。这是分叉的核心:共享的块保持引用计数,写的位置用私有块。
位置与 SWA:seqlen_k 与 swa_valid_start
DeepInfer 的注意力元数据不是“position 数组 + mask”,而是“seqlen_q / seqlen_k + 压缩比例 + SWA 有效下界”。命中之后,seqlen_k 从 cache.num_tokens 加本批查询长度;位置在 prepare_tensor_input_v4.cpp 里由 seqlen_k - seqlen_q 推出:
int32_t q_start = p_seq->seqlen_k - q_len;也就是“本 chunk 的起始绝对位置”。这与前四个框架的位置表达式完全同构,只是它不显式构造位置数组,而是在 kernel 内按绝对位置索引 RoPE 表。
SWA 层的 KV 读取则多了一层 padding_len:
const int32_t history_end = p_seq->seqlen_k - p_seq->seqlen_q;const int32_t history_begin = history_end - window_size;const int32_t padding_len = std::clamp(p_seq->swa_valid_start - history_begin, 0, window_size);const int32_t valid_begin = history_begin + padding_len;builder.append_zero_fill(padding_len);builder.append_ring_range(p_seq->state_id, valid_begin, history_end);如果 swa_valid_start 大于窗口左边界,说明窗口左侧一部分 KV 已经被清零(零状态重算),这段要用零填充而不是读 ring buffer。这就是“命中之后”在 SWA 模型上多出来的第 7 个问题:命中段的 SWA 状态是否还完整。
YoCo 有界重放:命中长度在 prefill 里被重新定义
DeepInfer 对 SWA 模型的 prefill 有一个额外机制:YoCo 有界重放。当 DEEPINFER_YOCO_PREFILL_TRUNCATION_MODE 非 off 且 keep_tokens 为 140 时,长 prompt 的 prefill 只计算最后一段矩形区、再用 SWA 可见性拼出窗口:
int32_t abs_lo = std::clamp(std::max({pos - window_size + 1, rect_lo, valid_start}), 0, pos + 1);int32_t start_slot = abs_lo - (q_start - window_size);...return {start_slot, window_size - start_slot, k_lo, new_len};其中 rect_lo = data_len - keep_tokens,valid_start 是 SWA 状态的有效下界。compact 模式会截掉矩形之前的行,mask 模式不截行但把可见域收窄。在有界重放开启时,命中长度小于等于 keep_tokens 时直接收益为零,因为这段本来就会被重放覆盖;只有命中超过窗口长度之外的前缀部分才有收益。这一条在 vLLM 的 DSV41 路径里也有类似的处理(prefix_replay_tokens)。
统计:num_cached_tokens_gpu
DeepInfer 的 SchedulerOutputs 带一个 num_cached_tokens_gpu,统计层把它和 num_batched_tokens 相加作为“总需要访问的 token”:
calc_tokens = s.num_batched_tokens + s.num_cached_tokens_gpuself._prefill_cached_tokens.append((calc_tokens, s.num_cached_tokens_gpu))这个口径对应“命中率”的另一种定义:不是“命中 token / prompt token”,而是“命中 token / (新算 token + 命中 token)”。在分块 prefill 场景下,这个口径更能反映实际节省的注意力计算量。
当命中段被并发共享:引用、写时复制与“命中之后”的第二层账
前面五个框架的代码都默认了一件事:命中的块在本轮前向期间不会被别人动。真实服务里这并不成立。一段被多个请求同时命中的前缀,可能在 A 的 chunk 还在计算时被 B 命中、被 C 驱逐、被 D 的写时复制拆开。这一节讨论“命中之后”的第二层账:共享与写入的交互。
vLLM 的处理方式最典型:块池里每个块有一个 ref_cnt,还有一条空队列与一条可复用队列。get_cached_block 找到块后会把它从可复用队列摘下并加引用;如果同一块同时被多个请求命中,引用计数叠加。驱逐时只从“引用计数为零”的尾部开始,所以“正在被命中的块”在引用释放前不可驱逐。vLLM 官方设计文档里的“free queue”示意图正是这个结构:空队列与可复用队列分离,命中块回到空队列后才能被重新分配。
SGLang 用树的节点锁代替引用计数。match_prefix 找到的路径节点会被请求锁住,直到 prefill 的 checkpoint 完成;如果节点在锁定期间需要分裂或插入,树会先分裂节点、再把锁转移到新节点。这套机制的好处是“树的拓扑本身就是引用关系”,坏处是锁的粒度是节点而不是页,长前缀会锁住很长的路径。
llama.cpp 没有跨请求共享,但它在单个 slot 内部处理写时复制:seq_rm 会把 n_past 之后的 KV 删掉,seq_add 只在尾部追加,中间不会出现新旧两条序列共用一段 KV 需要写时复制的情况。
TensorRT-LLM 的块复用树在 claim 阶段区分“可复用但已被引用”与“可复用且空闲”两种状态。findReusableBlockMatches 里,只有满足 copyOnPartialReuse,或者块既无引用又是叶子节点时,部分复用才会被接受;后者是“直接接管空闲叶子块”,前者是“复制一份”,两种情形都不会让新请求与仍在使用的块共用可写状态。副本的产生时机在 addSequence 里,而不是在探测接口里,因为探测必须无副作用。
DeepInfer 的 fork 直接 pin_blocks 共享块表,不复制;只有 fork 序列的最后一个“不完整块”被复制成私有块。所有共享块的生命周期靠引用计数维持,源序列释放时其他 fork 序列的读写不受影响。
把这五种处理放在一起,可以看到一个共同结论:“命中”是在读的语义,“共享”是在写的语义,两者之间的桥就是引用计数、节点锁或写时复制。命中之后真正容易出问题的,不是匹配本身,而是“命中块刚好被另一个请求写入”。这也是页面粒度、块大小与写时复制策略必须一起设计的原因:块越大,写时复制越贵;块越小,引用计数与索引开销越大。
横向对比:六个问题、五个答案
把前面的代码整理成一张表。行是六个交接问题,列是五个框架。
| 交接问题 | vLLM | SGLang | llama.cpp | TensorRT-LLM | DeepInfer |
|---|---|---|---|---|---|
| 谁负责匹配 | KVCacheManager,在调度器内 | RadixCache,在 prefill 组装前 | server slot 的 token 序列 | 资源管理器 addSequence + 独立 probe | 外部 KV 系统,引擎只接收标量 |
| 命中粒度 | 块哈希,整块;细粒度哈希可到哈希边界 | 树精确到 token,页大小 > 1 时取整到页 | token 级公共前缀 | 块级,radix 树 | 块级,由外部系统决定 |
| 命中长度上限 | num_tokens - 1,并块对齐 | input_len - 1,页对齐 | n_tokens - 1(全命中时减一) | prompt_len(setter 要求 < promptLen) | min(num_tokens, len - 1) |
| 命中块引用 | get_cached_block 取出并加引用 | match_prefix 返回节点,prefill 后锁路径 | 不适用,直接改上下文 | 复用树 claim,partial reuse 按配置 | fork 时 pin_blocks 并共享 block table |
| 位置起点 | num_computed_tokens + 批内序号 | extend_prefix_lens 生成 arange | tokens.pos_next(n_past) | context_current_position | seqlen_k - seqlen_q |
| 只读段的表达 | 块表已含命中块,mask 用 num_computed_tokens 推出 | prefix_lens 进入 attention metadata | seq_rm 删掉尾巴,seq_add 只写新段 | 块表 + prepopulated_prompt_len | block table + swa_valid_start |
| 命中之后还算不算 | 部分命中走 prefill;全命中重算最后一个 token | 同左,编码器段单独剔除 | 全命中时 n_past-- | 同左,预算事后校正 | 同左,fork 时进 prompted 跳过 prefill |
| 特殊机制 | EAGLE 丢一个块;KV connector | encoder len 扣除;mamba 分支 | n_cache_reuse 中段移位 | 估算值与真实值的两阶段校正 | SWA 有界重放与零状态重算 |
这张表里最值得单独讨论的是三行。
命中长度上限:为什么所有框架都留一个 token
五个框架都做了同一件事:命中长度最多到 len - 1。原因不是实现偷懒,而是因果 LM 的性质:最后一个 token 的 logits 必须由模型计算出来。如果最后一个 token 也命中,模型就没有可算的查询,采样器拿不到 logits。
但“留一个 token”和“留一个块”是两个不同的实现。vLLM 因为 allocate_slots 要求块对齐,实际上会重算整个尾块;SGLang 的页大小小于 token 数时,可能只重算一个页;TensorRT-LLM 的 prepopulated setter 要求 prepopulated < promptLen,只保证最后一个 token 不在命中段里。
这个细节对 TTFT 的影响是:块越大,多算的 token 越多。128 token 的块在短 prompt 上可能多算 127 个 token,在 8k prompt 上可以忽略。这也是页面粒度在短请求上差异明显、在长请求上差异不明显的原因。
只读段的表达:三种完全不同的接口
vLLM 表达只读段的方式最“干净”:命中块直接进块表,注意力 kernel 用 num_computed_tokens 推出“前 num_computed_tokens 个 token 不需要查询”。SGLang 表达只读段的方式是 prefix_lens + extend_lens,attention backend 用这两个数组生成各自的 metadata(FlashAttention 用 seq_lens 和 extend_start_loc,FlashInfer 用 prefix_lens 与页表)。llama.cpp 表达只读段的方式最粗暴:seq_rm 直接把尾巴删掉,KV 数组里只剩下命中的那一段,新 token 直接 seq_add 追加。
TensorRT-LLM 和 DeepInfer 则介于两者之间:TensorRT-LLM 用块表加 prepopulated_prompt_len,DeepInfer 用块表加 swa_valid_start。区别在于:DeepInfer 多了一个“哪些命中段不可读”的维度。当 swa_valid_start > 0 时,命中段里可能有一部分 KV 是被清零的,kernel 必须用零填充而不是读取。
命中之后是否还要算:全命中的分歧
全命中时,vLLM / SGLang / llama.cpp / TensorRT-LLM 都会把请求丢进 prefill,只算最后一个 token(或最后一块);DeepInfer 的 fork_seq 在 prompt_incomplete 为假时,会把 fork 出来的序列直接放进 prompted 队列,跳过 _schedule_prefill,由 decode 分支处理。这两条路径的差别在于“谁来算最后一个 token”和“KV 写入边界在哪里”,但结果一样:只算一个 query。
三处容易读错的边界:编码器、多模态与变长验证
在横向对比之前,先补三个“读到一半会卡住”的边界。它们不属于任何一个框架的主线,但都直接影响命中的拼接方式,并且在多个框架里存在结构相似的对应物。
编码器输出段不能跨越命中边界。 SGLang 的 ScheduleBatch 在组 batch 时,会把每个请求的 encoder_len 从 prefix_lens 和 extend_lens 里扣掉:如果命中的前缀长度小于编码器输出长度,整段编码器输出被视作一个整体、不计入 prefix_lens,只有解码器部分才参与 extend。这背后的原因是编码器输出并非由本请求计算,它与 image token 的边界绑定;命中点落在编码器输出中间,会让“解码器 token 的 prefix 位置”与视觉 token 的放置对不上。
多模态 token 在 vLLM 里走的是另一条预算线。 vLLM V1 的调度器在 allocate_slots 的参数里同时带着 num_encoder_tokens 和 encoder_inputs_to_schedule。编码器输入有自己的预算与缓存(encoder_cache_manager),前缀命中只覆盖解码器 KV;二者在 batch 组装时被分别计算,但共享同一个 num_new_tokens 上限。这也是为什么图像请求的前缀命中收益通常以“文本部分”来衡量:视觉编码器的结果虽然可以缓存,但它不属于块哈希体系。
投机解码的变长验证会再拆一次位置。 DeepInfer 的 MTPVarlen::schedule 在调度阶段就按置信度把所有请求的草稿位置排序成一列,再按性能模型的估计在每个请求前面“保留 1 个位置”、其余位置按全局置信度发放。被选中的位置数决定 seqlens_q,而 seqlens_q 又决定每个请求在这一次前向里的位置区间。命中段、金色 token、草稿 token 在同一批里以不同的 seqlen_q 出现,位置编号必须按请求分别生成,不能假设“每个请求位置连续”。
这三处边界共同说明一件事:命中之后的位置与 mask,从来不是全局统一的。它必须在“每个请求、每种段类型、每个验证分支”三层上分别对齐;任何一层错位,都会表现为某个请求的输出偏掉、或者某个批次的 mask 漏读一段 KV。
一个不太直觉的结论:命中长度不等于节省
读到这里很容易形成一个直觉:命中越多,节省越多。但从 TensorRT-LLM 的 maybe_fit_token_budget 和 DeepInfer 的有界重放可以看出,命中长度并不直接等于节省。
第一层,估算与真相的偏差。 TensorRT-LLM 的微批调度器用估算值准入,如果估算偏乐观,批里会被塞进太多请求,真正的复用长度不够,导致 max_num_tokens 被超出。这时 maybe_fit_token_budget 必须把 chunk 缩小。这个过程本身是“命中越长、校正越频繁”的,因为估算和真相的差距随命中长度线性放大。
第二层,重放的吞没。 DeepInfer 的 YoCo 有界重放会把 prefill 收缩到 keep_tokens。如果命中长度小于 keep_tokens,这部分本来就会被重放覆盖,命中收益为零。vLLM 的 DSV41 路径也有类似逻辑:num_computed_tokens <= prefix_replay_tokens 时直接清零重算。命中长度必须超过重放窗口,才算真正省下计算。
第三层,粒度的下限。 块哈希只能整块命中。如果共享前缀的尾部只差几个 token,整个块都要重算;如果最后一个块只有一半命中,命中就会被截断到前一个块边界。这个损失与“共享前缀的平均长度除以块大小”成正比。
第四层,投机解码的扣减。 EAGLE / MTP 要求生成点之前的 token 重算,因此命中长度要再减一个单位。当草稿头需要多 token hidden states 时,扣减可能不止一个块。
第五层,SWA 与混合状态。 纯 SWA 层只能复用它窗口内的 KV;混合模型里同时有 SWA 层和全注意力层,命中必须取“所有层都能复用”的长度。vLLM 的 HybridKVCacheCoordinator 用迭代降低长度解决这个问题;SGLang 的 prefix_len 在 SWA 有界重放时会被 swa_evict_floor 限制;DeepInfer 的 swa_valid_start 则是“命中段里哪些 KV 还能读”的直接表达。
这五层叠加起来,解释了为什么实际服务里“前缀命中率 90%”并不等于“TTFT 降低 90%”。命中率是缓存层的指标,节省量是 kernel 层和调度层的指标,两者之间隔着一整套交接逻辑。
从交接看设计:五个框架各自押注了什么
如果把五个框架的交接方式放到同一张坐标系里,会发现它们各自押注了不同的东西。
vLLM 押注“统一抽象”。 块表 + num_computed_tokens 让命中段、已有段、外部段在 kernel 眼里没有区别,所有注意力后端都能用同一套元数据。代价是块对齐带来的重算尾巴,以及 EAGLE 扣减和 connector 引入的额外复杂度(num_external_computed_tokens、delay_cache_blocks、skip_zeroing_group_ids)。
SGLang 押注“树的结构”。 radix 树的精确匹配让命中粒度尽可能细,节点分裂让命中边界成为真实节点,prefill 后的 checkpoint 让新插入的段能被后续请求复用。代价是树操作本身的开销、页对齐的取整,以及 encoder 段、mamba 段、SWA 段的边界处理。
llama.cpp 押注“上下文的可塑性”。 没有块池和树,但有 seq_rm / seq_add / shift,可以在单个上下文里裁剪、追加、平移。代价是命中范围只在同一 slot,且 shift 依赖内存实现;优点是逻辑简单、调试直观。
TensorRT-LLM 押注“资源管理器为中心”。 它把命中的副作用(引用、分配、预算)全部放进 KVCacheManager 和 ResourceManager 里,调度器只做估算,事后校正。代价是两阶段数字不一致带来的校正复杂度,优点是把 P/D 分离、可变 SWA、多池布局都统一进同一个资源管理层。
DeepInfer 押注“引擎与存储解耦”。 命中数由外部 KV 系统注入,引擎只提供 fork、pin、SWA 边界和 YoCo 收缩。代价是开源版缺少完整的 KV cache system 和 P/D 分离,优点是引擎可以适配不同的外部存储(3FS、Mooncake 等)而不改内核。
这五种押注没有绝对优劣,它们是对“命中之后由谁负责”这个问题的不同回答。理解这一点,比记住任何一张对照表都更有用。
小结
- 前缀命中不是一个数字,而是一次交接:命中长度、块表、位置、mask、写入边界、是否重算,六个问题缺一不可。
- vLLM 用块哈希和
num_computed_tokens把命中段变成“已在块表里的前缀”,并保留最后一个 token 重算;EAGLE 会再丢掉一个命中单位。 - SGLang 用 radix 树做精确匹配,页大小大于 1 时取整;命中后通过
prefix_lens进入 prefill,prefill 完成后再 checkpoint 回树。 - llama.cpp 在 slot 上下文里做 token 级公共前缀裁剪,用
seq_rm删尾巴、seq_add追加,并可选n_cache_reuse做中段移位复用。 - TensorRT-LLM 的命中是两阶段的:微批调度器用估算值准入,
addSequence得到真相后由资源管理器事后校正 token 预算。 - DeepInfer 把命中数当作外部注入的标量,用 fork 共享块表,用
swa_valid_start表达“命中段里哪些 KV 不可读”,用 YoCo 有界重放收缩 prefill。 - 命中长度不等于节省:估算偏差、重放吞没、块粒度下限、投机扣减与 SWA 边界共同决定最终收益。
- 命中块与共享写入之间隔着引用计数、节点锁与写时复制;命中段被并发共享时,写路径比匹配路径更容易出错。
参考资料
- vLLM Automatic Prefix Caching 设计文档
- vLLM v1 core kv_cache_manager.py 源码
- vLLM v1 core kv_cache_utils.py 源码(hash_block_tokens)
- vLLM v1 core sched scheduler.py 源码
- vLLM v1 core single_type_kv_cache_manager.py 源码
- SGLang(含 RadixAttention)论文
- SGLang mem_cache radix_cache.py 源码
- SGLang managers schedule_batch.py 源码
- SGLang model_executor forward_batch_info.py 源码
- llama.cpp tools/server/server-context.cpp 源码
- TensorRT-LLM PyTorch pyexecutor resource_manager.py 源码
- TensorRT-LLM batch_manager kvCacheManager.cpp 源码
- TensorRT-LLM engine runners decoder inputs.py 源码
- DeepInfer 官方仓库
- DeepInfer csrc/engine/scheduler.hpp 源码
- DeepInfer csrc/engine/sequence.hpp 源码
- DeepInfer csrc/engine/input_metadata/prepare_tensor_input_v4.cpp 源码
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



