


Batch-invariant 推理完全拆解:五个推理框架如何让同一请求不再随 batch 漂移
现象:同一条请求,答案为什么随负载变化
把温度设成 0,也就是贪心解码,理论上每一步都选概率最高的 token。按这个定义,同一段 prompt、同一份权重、同一个采样参数,输出应当完全一致。但几乎所有在线推理服务都不满足这个直觉:同一个问题连问几次,开头几十个 token 一样,后面突然分叉;换一个时间段再问,答案又变了。很多人把原因归结为“GPU 并行导致浮点误差”,这个解释只说对了一半,而且把真正的工程症结藏了起来。
Thinking Machines Lab 的 Horace He 在 2025 年 9 月 10 日的文章 Defeating Nondeterminism in LLM Inference 里做了一个很直接的实验:用 Qwen3-235B-A22B-Instruct-2507,温度 0,对同一句 “Tell me about Richard Feynman” 生成 1000 条、每条 1000 token 的续写。结果出现了 80 种不同的完成结果,最常见的一种出现 78 次。所有结果在前 102 个 token 上完全一致,分歧从第 103 个 token 开始:992 条写成 “Queens, New York”,另外 8 条写成 “New York City”。把内核换成 batch-invariant 版本后,1000 条结果全部逐位相同。
这个实验说明的不是“模型本身有随机性”,而是推理系统的数值结果依赖于同批次里还有谁。在线服务的 batch 组成由当时的请求负载决定,对单个用户来说,其他人的请求既不是输入,也不可控;于是从用户视角看,系统就是不确定的。即使你在本地用 vLLM 或 SGLang 跑,只要并发数变化,同一个请求也可能落到不同的 batch 形状里,拿到不同的 logits。
工程上把这种性质称为 batch invariance(批次不变性):对任意一个请求,无论它和多少条其他请求拼在一起、在 batch 里排第几位、prompt 被切成几段 prefill,模型产生的 token 与 logprob 都必须逐位相同。注意它比“跑两遍结果一样”更强。一次固定的脚本重复执行 100 次结果一致,只能叫 run-to-run determinism;batch invariance 要求的是同一请求在不同 batch 组成、不同批内位置下仍然一致;再往上还有一层更难的统一性,即同一请求走不同调度路径也必须一致。
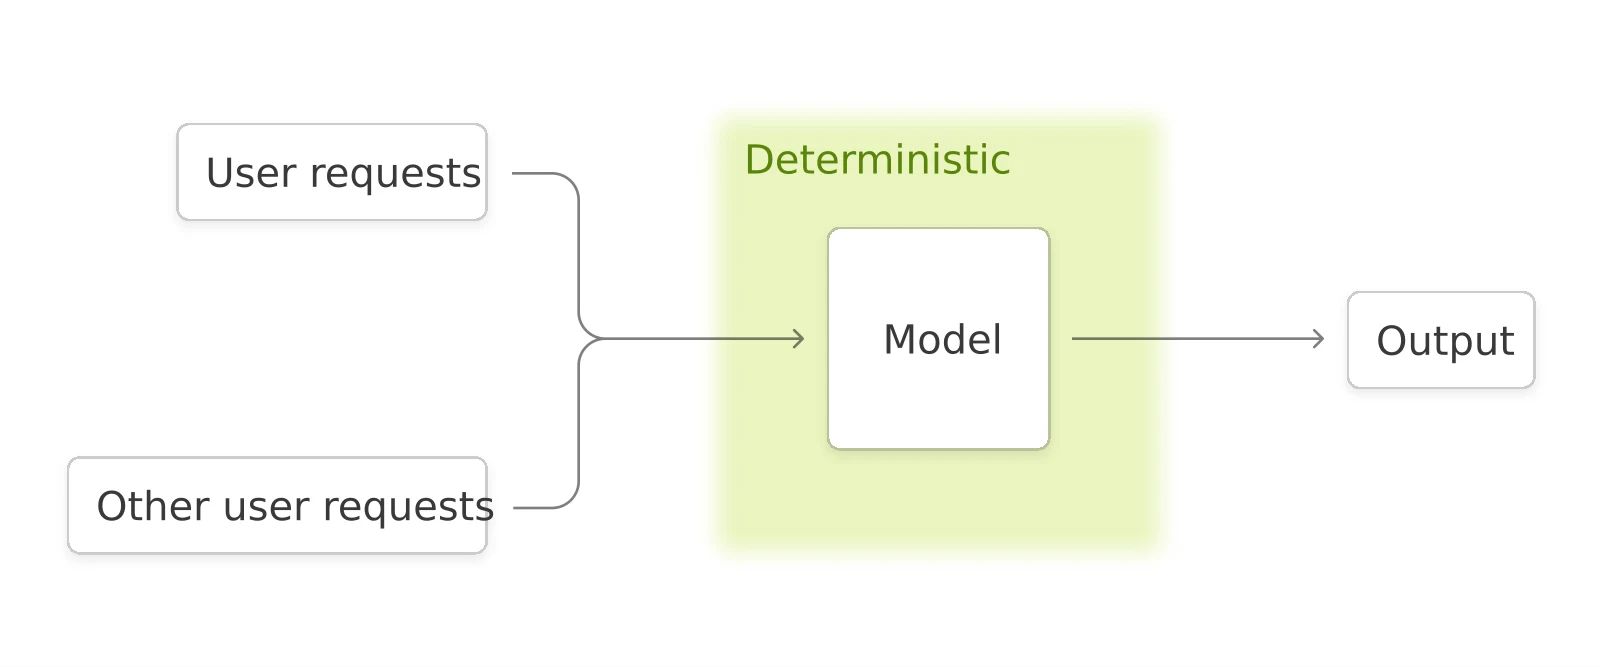
Thinking Machines Lab 博客里的第一张示意图:服务器收到完全相同的一组请求时,每次给出的输出都一样。这说明推理系统本身是 run-to-run 确定的,问题不在这里。图片来自 Defeating Nondeterminism in LLM Inference。
为什么推理框架要专门为这件事做工程?至少有三类场景会被它直接卡住:
- 可复现评测与调试:评测集上同一条样本,今天跑和明天跑分数不同,无法判断是模型变化还是服务负载变化。
- Agent 与工具调用:结构化输出、JSON 解析、代码生成对首 token 和前缀极其敏感,一次 token 翻转可能让整条工具链失败。
- P/D 分离与前缀缓存:同一段 prompt 命中前缀缓存与未命中缓存,走的计算路径不同;如果 attention 的归约顺序随路径变化,缓存复用就会悄悄改变输出。
后面的内容按“先定位根因,再改造三类归约算子,最后看五个框架怎么做”的顺序展开。核心结论可以先放在这里:不确定性的主因不是 atomicAdd,也不是线程竞争,而是 kernel 的归约策略随形状变化;要修它,必须把 RMSNorm、GEMM、Attention 三个算子的归约顺序钉死,再把调度层的 chunked prefill、前缀缓存、投机解码、专家并行逐一接上。
先把误解拆掉:GPU 并发与 atomicAdd 不是元凶
最常见的解释是:GPU 上很多线程并发执行,归约时用 atomicAdd 累加,哪个线程先完成就先加,加法顺序因此不确定;浮点加法又不满足结合律,于是每次结果不同。
这段话有两个问题。
第一,LLM 的前向计算里通常没有 atomicAdd。现代 GPU kernel 在 reduction 维度上的并行有更便宜的做法:如果 batch 维度已经有足够多的行,就让一个 CTA 负责一整行的归约,完全不需要跨 CTA 通信;如果行数不够,就用 split reduction 或树形归约,再用一个很小的 clean-up kernel 合并,或者用信号量保证合并顺序。真正大量依赖 atomicAdd 的是 scatter_add 一类操作,在 LLM 推理里主要是 FlashAttention 的反向传播,而推理只跑前向。Horace He 还提到一个细节:常用的 Triton 版 FlashAttention 反向实现为了避免 atomicAdd,额外做了重计算,FLOPs 比论文版本多约 40%。这属于训练侧代价,不在本文讨论范围内,但它说明“为了确定性而绕开 atomic”并不是不可行。
第二,同一个 kernel 对同一组输入重复执行,结果是确定的。哪怕它内部有并发,只要线程块的数量、每块的划分、归约树的形状不变,执行顺序就是固定的。可以用一段很小的代码验证:
import torch
A = torch.randn(2048, 2048, device="cuda", dtype=torch.bfloat16)B = torch.randn(2048, 2048, device="cuda", dtype=torch.bfloat16)ref = torch.mm(A, B)for _ in range(1000): assert (torch.mm(A, B) - ref).abs().max().item() == 0这段代码在 1000 次重复里不会失败。可见“有并发”与“结果不确定”之间并没有必然联系。真正的变量是形状:当 batch 大小改变时,kernel 为了填满 GPU,会改变切分方式、split 数、tile 大小,甚至换一条 tensor core 指令;归约树随之改变,加法顺序也就变了。
一个更直观的例子来自同一篇文章:
import torchtorch.set_default_device("cuda")B, D = 2048, 4096a = torch.linspace(-1000, 1000, B * D).reshape(B, D)b = torch.linspace(-1000, 1000, D, D).reshape(D, D)
out1 = torch.mm(a[:1], b) # 只算一行out2 = torch.mm(a, b)[:1] # 算完整个 batch 再取第一行print((out1 - out2).abs().max()) # tensor(1669.2500, device='cuda:0')从数学上看,矩阵乘的每一行是独立的:第一行的结果不应该因为后面多了 2047 行而改变。但实测差到了 1669.25。原因是 a[:1] 的 M 维只有 1,cuBLAS 或 PyTorch 会选一个适合 skinny GEMM 的 kernel;a 的 M 维是 2048,走的是另一套 tile 配置。两者对 K 维的归约顺序不同,舍入误差就不同。
由此可以区分三个层次的性质:
| 性质 | 含义 | 是否常见 |
|---|---|---|
| run-to-run determinism | 同一输入、同一形状,重复执行结果逐位一致 | 绝大多数前向 kernel 满足 |
| batch-position invariance | 改变元素在 batch 中的位置,结果不变 | 普通 matmul 通常满足 |
| batch invariance | 改变 batch 大小或组成,单条请求结果不变 | 默认不满足,需要专门改造 |
还有一个反例值得记住:stream-K 连 batch-position invariance 都不满足。stream-K 为了改善负载均衡,会针对不同的输出 tile 采用不同的 K 维切分方式;同一行元素处在不同位置时,可能落到不同的切分方案里。这也是为什么“给 matmul 换一个更聪明的调度器”与“保证确定性”经常冲突。
浮点非结合性:误差如何被放大成一个 token 的翻转
上面反复提到“加法顺序不同”,根因是浮点数的非结合性:
用十进制浮点做一个简化演示。假设尾数只有 3 位有效数字,指数 1 位:
精确结果是 157.5,但 3 位尾数只能表示到 1.57 × 10^2 或 1.58 × 10^2,多出来的 0.5 被舍入掉。换个顺序,先把两个小数相加,再加大数,结果又不同。每次相加时,只要两个数的指数不同,较小的一方就会损失低位;损失的多少取决于相加的顺序。
把这个现象放大到一组数上,结果可以非常夸张。文章给了一个例子:对 [1e-10, 1e-5, 1e-2, 1] 以及它们的相反数做求和,随机打乱 10000 次,能得到 102 种不同的结果,分布在 -8.3e-17 到 8.3e-17 之间。数学上这八个数的和是 0,但浮点运算给出了上百个“0”。
在 Transformer 里,这类归约无处不在:
- RMSNorm 对 hidden 维求平方和;
- GEMM 对 K 维做点积;
- Attention 对 KV 序列做加权求和;
- Softmax 对 logits 求最大值与指数和;
- MoE 的 AllReduce 对多个 rank 的部分和做累加。
每一步的误差都很小,通常是 1e-3 到 1e-6 量级。问题在于,误差不需要累积到很大,只需要在决策边界上翻转一次排序。贪心解码每一步取 argmax,如果 top-1 与 top-2 的 logit 差距小于归约误差,那么两种归约顺序就可能选出不同的 token。一旦某个 token 被改写,自回归的后续输入就变了,后面所有 token 都会沿着另一条轨迹生成;这就是实验中“前 102 个 token 相同,第 103 个 token 分叉”的机制。
可以用一个简单的概率模型描述这种放大。设某一步 top-1 与 top-2 的 logit 差为 ,归约误差为 。只有当 时,排序才可能翻转。Transformer 的 logits 尺度通常在个位数到十几之间,而不同 kernel 配置之间的差异可以达到 1e-3 甚至 1e-2,所以在 top-2 接近的步上,翻转概率并不低。一个 1000 token 的生成过程有 1000 次 argmax,只要有一步翻转,输出就会分叉。
这也解释了为什么“提高精度”不是万能药。把 bf16 换成 fp32 可以减小 ,但只要还存在 split-K、split-KV 这类形状相关的归约,误差就不会消失,只是翻转的概率变低。要彻底消除用户可见的不确定性,必须让同一条请求在所有 batch 组成下的归约顺序完全一致,而不只是让误差更小。
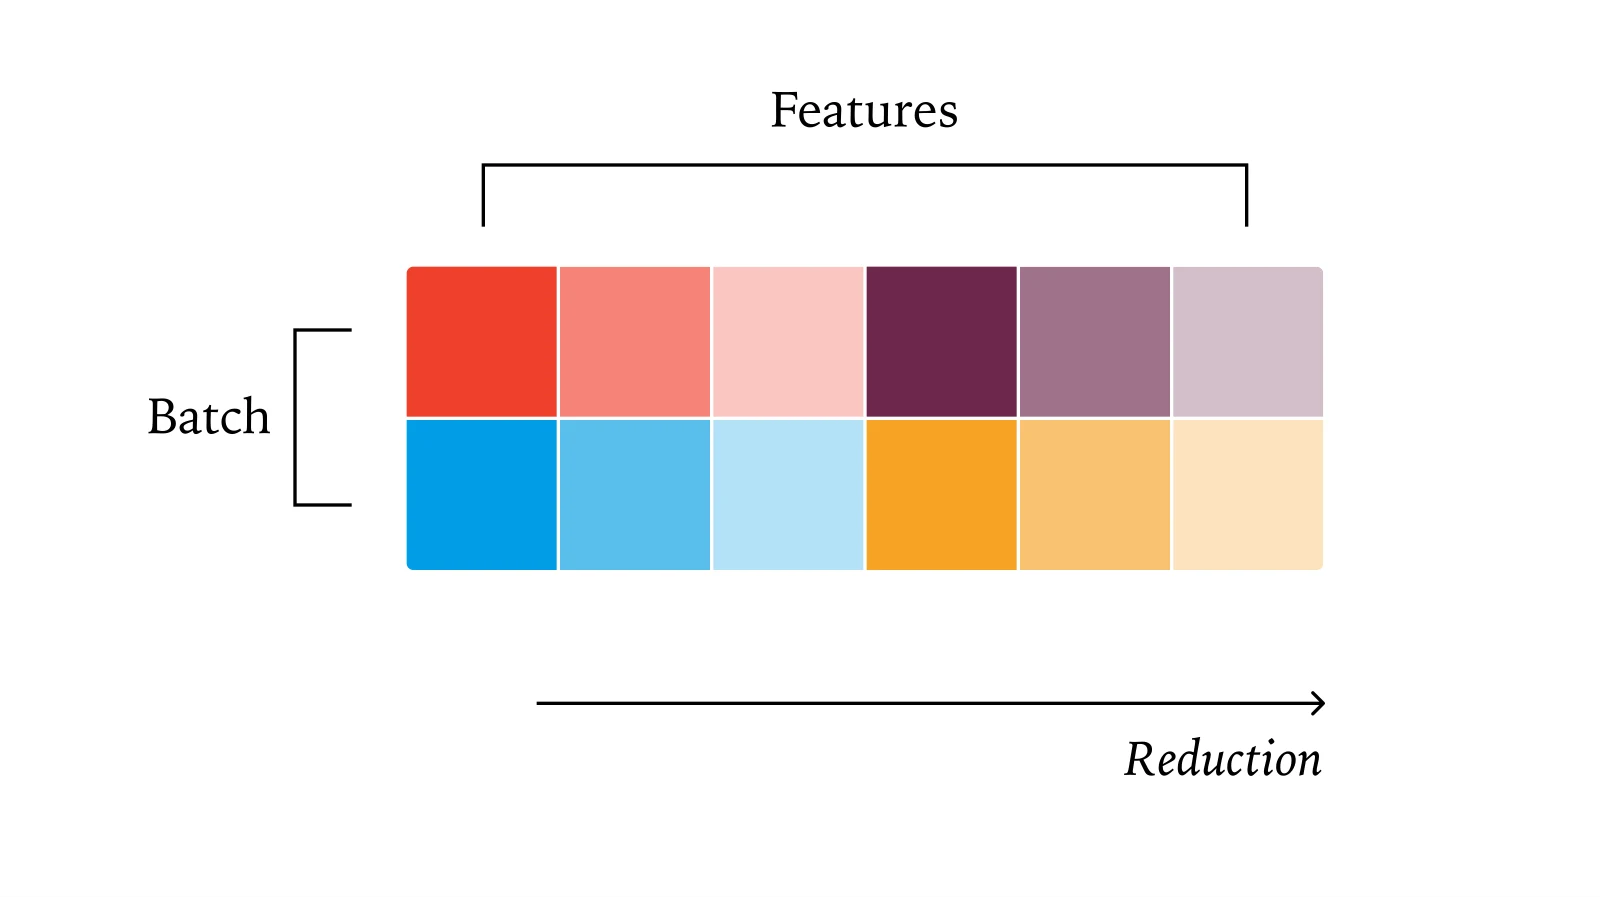
RMSNorm 是三类算子里最容易处理的:只要每行由一个 CTA 独立归约,batch 变大只是多开 CTA,顺序不变。图中展示的反面情形是 batch 太小时把一行拆给多个 CTA 的 split reduction,归约树因此依赖 batch 大小。图片来自 Defeating Nondeterminism in LLM Inference。
三类归约算子:RMSNorm、GEMM 与 Attention 的固定顺序改造
一个 Transformer 前向里绝大多数算子都是逐元素操作,例如 residual add、SiLU、乘 scale。逐元素操作天然满足 batch invariance:每个元素只依赖自己,batch 大小不影响它的计算。真正需要改造的只有三类带 reduction 的算子:RMSNorm(沿 hidden 维归约)、GEMM(沿 K 维归约)、Attention(沿 KV 序列归约)。难度依次上升,因为可用的并行维度依次变少。
RMSNorm:拒绝 split reduction 的诱惑
RMSNorm 的定义是
其中 是一行 hidden state, 是逐通道的缩放权重, 防止除零。对一个形状为 的张量,归约只发生在最后一维, 行之间完全独立。
最自然的并行策略是数据并行:一个 CTA 负责一行,行内用线程或 warp 做树形归约。batch 变大时,只是 grid 变大,每一行内部的归约树不变;batch 变小时,问题来了:如果 小于 SM 数量,大量 CTA 空闲,kernel 利用率很低。一个追求性能的 kernel 工程师会自然地引入 split reduction:把一行的 个元素切成几段,交给多个 CTA 分别求平方和,最后再合并。这样一来,归约树就依赖“切了几段”,而切几段又取决于 batch 大小,batch invariance 立刻被破坏。
batch-invariant 版本的做法很“笨”,但正确:每行固定由一个 program 处理,block 大小固定,沿列方向串行循环。vLLM 的 rms_norm_batch_invariant 就是这么写的,核心循环可以简化成下面的形式:
@triton.jitdef _rms_norm_kernel(input_ptr, weight_ptr, output_ptr, input_row_stride, output_row_stride, n_cols, eps, BLOCK_SIZE: tl.constexpr, HAS_WEIGHT: tl.constexpr): row_idx = tl.program_id(0) row_start = input_ptr + row_idx * input_row_stride sum_sq = tl.zeros([1], dtype=tl.float32) # 固定 BLOCK_SIZE,沿列方向串行累加 for col_offset in range(0, n_cols, BLOCK_SIZE): col_idx = col_offset + tl.arange(0, BLOCK_SIZE) mask = col_idx < n_cols vals = tl.load(row_start + col_idx, mask=mask, other=0.0).to(tl.float32) sum_sq += tl.sum(tl.where(mask, vals * vals, 0.0)) inv_rms = 1.0 / tl.sqrt(sum_sq / n_cols + eps) for col_offset in range(0, n_cols, BLOCK_SIZE): col_idx = col_offset + tl.arange(0, BLOCK_SIZE) mask = col_idx < n_cols vals = tl.load(row_start + col_idx, mask=mask, other=0.0).to(tl.float32) out = vals * inv_rms if HAS_WEIGHT: w = tl.load(weight_ptr + col_idx, mask=mask, other=1.0).to(tl.float32) out = out * w tl.store(output_ptr + row_idx * output_row_stride + col_idx, out.to(vals.dtype), mask=mask)启动方式是 grid = (n_rows,),每个 program 只处理一行。BLOCK_SIZE 被固定为 1024,循环次数只由 n_cols 决定,而 n_cols 在模型结构确定后是常数。因此无论 n_rows 是 1 还是 512,某一行的平方和都按同样的块顺序、同样的树形归约完成,结果逐位一致。代价是当 batch 很小时,GPU 上只有少量 program 在跑,算力严重闲置;对 decode 阶段动辄几十毫秒的端到端延迟来说,这点 RMSNorm 的浪费通常还能接受,因为它只占前向 FLOPs 的很小一部分。
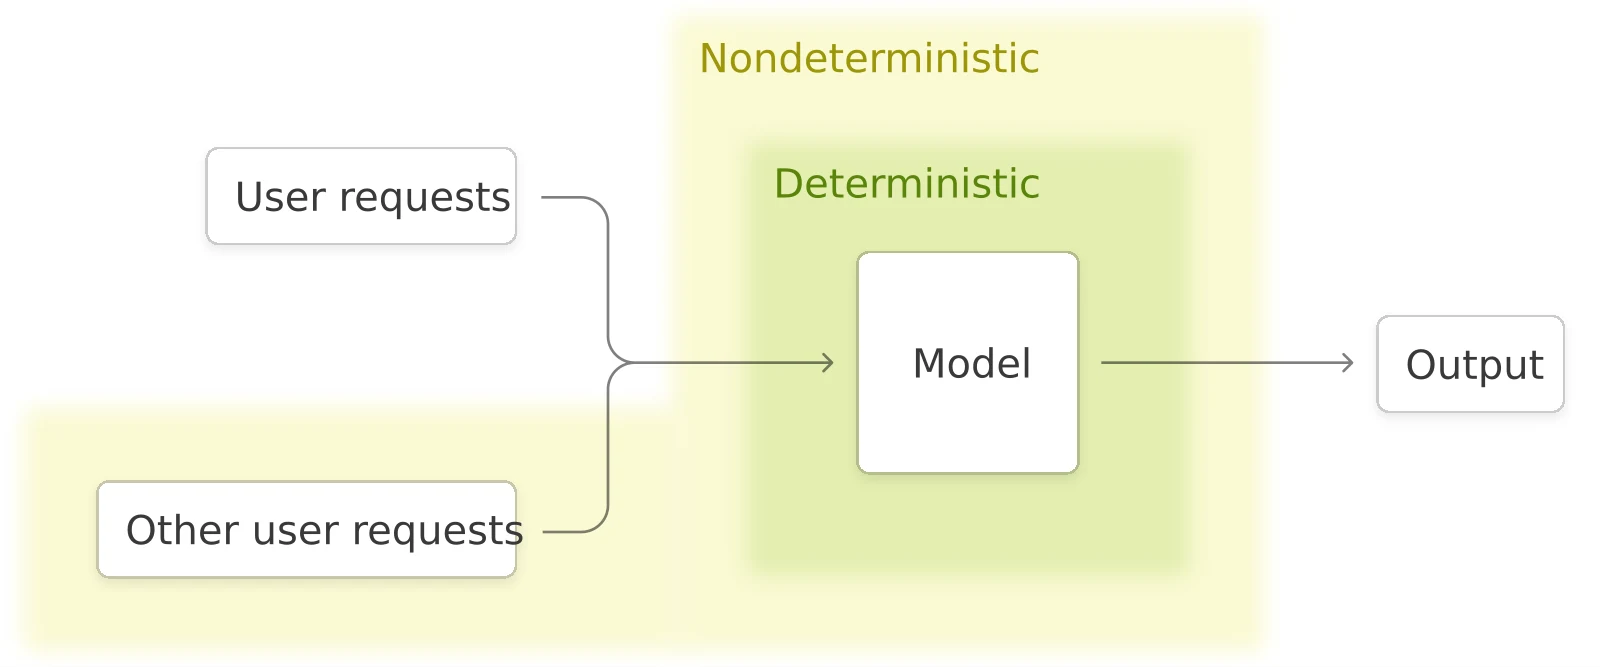
把非批次不变的内核放进完整推理系统后,情况就反转了:服务器收到的请求集合不变时仍然确定,但单个用户无法控制同一时刻还有谁在请求,batch 组成因此成为用户侧不可见、不可控的变量。图片来自 Defeating Nondeterminism in LLM Inference。
vLLM 在实现里还处理了两个边界条件。第一,带 residual 的融合路径:rms_norm_batch_invariant 在传入 residual 时会直接调用自定义的 ops.fused_add_rms_norm,这条路径是否严格 batch-invariant 取决于该 CUDA 算子内部的归约实现,属于需要单独验证的例外,而不是“替换 aten 就自动安全”。第二,FP32 累加:kernel 内部把 bf16/fp16 输入转成 fp32 做平方和,避免 bf16 累加在 hidden 维较大时溢出,同时保证不同 batch 下的中间精度一致。
SGLang 的实现与 vLLM 同源,rms_norm 同样是 grid=(n_rows,)、BLOCK_SIZE=1024、每行一个 program;它的 batch_invariant_ops 目录还额外提供了 NPU 版本的 npu_add_rms_norm_batch_invariant,说明这套思路并不局限于 CUDA。
GEMM:把 tile 配置和 split-K 一起冻住
矩阵乘是推理里 FLOPs 最大的算子。设 ,,,每个输出元素是
归约沿 维。为了喂饱 tensor core,kernel 不会按单个元素计算,而是把输出切成二维 tile,例如 ,每个 CTA 负责一个 tile,tile 内再用 warp 和 MMA 指令完成更细的划分。
在 batch 较大、 和 都足够大时,数据并行就足够了:tile 数量远超 SM 数量,每个输出元素的所有 次乘加都在同一个 CTA 内完成,归约顺序与 batch 无关。问题是 decode 阶段 很小,可能只有几条请求、几十个 token;如果 也不大,tile 数量不足以填满 GPU。这时 kernel 会沿 维切分,也就是 split-K:多个 CTA 各算一部分点积,最后把部分和加起来。
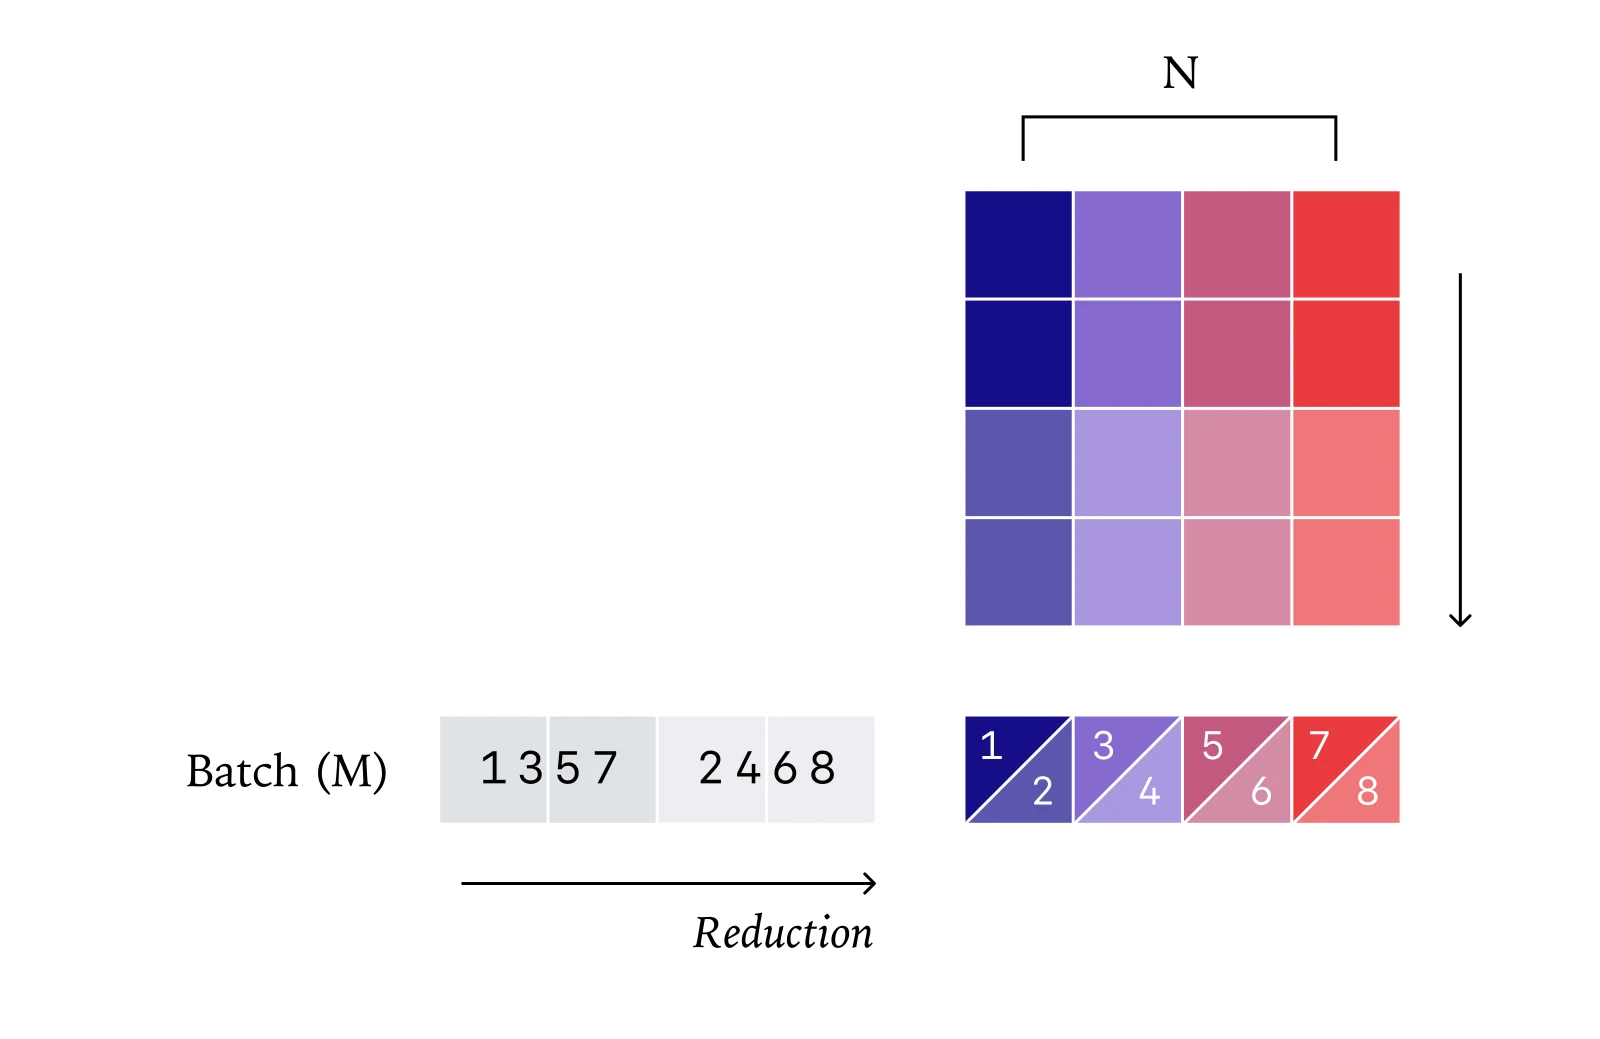
图中每个输出 tile 的 K 维点积被拆成两段,分别在不同核心上累加,最后再合并。这样并行度从 4 个 tile 变成 8 个核心的负载,但每个输出元素的部分和分组取决于 split 数,split 数又随 batch 形状变化,同一行结果因此随 batch 漂移。图片来自 Defeating Nondeterminism in LLM Inference。
split-K 的问题不只是“多了一次合并”。不同的 split 数会产生不同的部分和分组,例如把 4096 个 K 元素分成 4 段和分成 8 段,合并树的形状完全不同;即使都用树形归约,舍入结果也不一样。更隐蔽的是 stream-K:它按 tile 的实际工作量动态分配 K 区间,同一个输出 tile 在不同 SM 上可能拿到不同的 K 切分,连“元素在 batch 中的位置不变”都无法保证。
要让 GEMM 满足 batch invariance,需要同时满足三个条件:
- 每个输出元素的 维归约在同一个 program 内完成,不跨 CTA;
- 方向的块大小
BLOCK_K固定,循环边界只由 决定; - 不因为 太小而切换 tensor core 指令或退回非 tensor core 路径。
注意,输出 tile 的 、 形状可以随 batch 变化,只要每个输出元素内部的 循环顺序不变。这一点容易被误解:有人以为必须把所有 shape 都固定成同一个 tile 配置,实际上不必。vLLM 的 resolve_tuned_matmul_configs() 在确定性模式初始化时,按模型的每个线性层 提前解析好 BLOCK_SIZE_K 与 block_n 等配置,再按 分桶选择 block_m/num_warps。同一个 下,无论 落在哪个桶,BLOCK_SIZE_K 都不变,每个输出元素的 K 循环次数和顺序也就固定;变的只是并行粒度和 SM 占用。
具体实现分两条路线:
- 在 SM8x(Ampere、Ada 等 8.x 设备)、ROCm 以及部分非 CUDA 后端上,cuBLAS/cuBLASLt 无法保证 batch invariance,vLLM 直接用 Triton 写的 persistent matmul 覆盖
aten::mm、aten::addmm、aten::matmul、aten::linear。这个 kernel 用固定BLOCK_K串行遍历 K,累加器留在寄存器里,不产生 atomicAdd,也不做 split-K。 - 在 Hopper(SM90)和 Blackwell(SM100)上,cuBLASLt 的主体实现本身是 run-to-run 确定的,batch 方差主要来自 split-K。vLLM 的做法不是替换整个 matmul,而是通过 workspace 配置关掉 split-K,并禁止 FP32 走 TF32 的近似舍入。
后者的取舍很值得体会:保留厂商库的 tile 调度和 tensor core 指令选择,只把“会随形状改变归约树”的 split-K 关掉,性能损失通常小于自己写一套 Triton kernel。前者的取舍则相反:牺牲一部分峰值性能,换取跨架构的一致性。文章给出的实测是,未经优化的 Triton batch-invariant matmul 比 cuBLAS 慢约 20%,而且在小 batch 区域由于指令过大、并行度不足,性能曲线会出现明显的“锯齿”。
除了单卡 GEMM,张量并行还会引入第四类归约:AllReduce。Ring AllReduce 按 rank 顺序累加,树形 AllReduce 按二叉树合并,两者的加法顺序不同;NCCL 还可能根据消息大小切换协议和算法。vLLM 在开启 batch invariance 时,会把自定义 AllReduce 固定为 1-stage 算法,并把 NCCL 协议钉成 Simple、通道数钉成 1、AllReduce 算法钉成 tree。原因很直接:只有 1-stage kernel 的归约顺序与数据大小、rank 数无关;多 stage 或 ring 的切分随规模变化,又会把形状依赖带回来。同样地,LoRA 的 shrink 归约被拆成 8 个固定长度的 K 分块并按固定顺序求和,避免使用 atomicAdd;在 Ada、Hopper、Blackwell 上,vLLM 还会用可打断的 CUDA Graph 让 tile 配置跟随运行时 batch,而不是被整图捕获时的形状永久冻结。
Attention:fixed split-size 与 KV 边界块
Attention 比前两者更难,因为它有两个归约维度:特征维和序列维。标准写法是
FlashAttention 把 、 切成块,边算边维护 online softmax 的 running max 与 running sum。并行策略是沿 维切分:每个 CTA 负责一段 query,独立遍历整个 KV 序列。这个策略天然是数据并行的,因为每条 query 的归约都在自己的 CTA 内完成。
到了 decode 阶段,query 长度通常只有 1(或投机解码的几条草稿 token),沿 Q 维几乎没有并行度;如果 batch 也小,GPU 会空转。于是有了 split-KV(也叫 FlashDecoding):把 KV 序列切成多段,每段由一个 CTA 计算部分 attention 输出与部分 softmax 统计量,最后再合并。合并公式是
其中 、、 分别是第 段的 running max、running sum 和部分输出。合并本身是结合的,但浮点下不同分组会得到不同结果。
这里有一个关键的设计选择:固定 split 数量,还是固定每个 split 的大小。
常见的 split-KV 实现按“需要多少并行度”决定 split 数,再把 KV 长度平均分。例如 KV 长度 1000、需要 4 路并行,就每段 250。这样做的并行度很好,但每段的长度依赖 KV 长度和当前 batch,归约分组随之变化。FlashInfer 的 balanced scheduling 就是这种思路:选择能填满所有 SM 的最大 split size,split 数随负载变化。
batch-invariant 版本反过来:固定每个 split 的大小,例如每段 256 个 KV,最后一段可以不足 256。KV 长度 1000 时分成 256、256、256、232 四段;KV 长度 2000 时分成八段。split 数量会变,但每个 KV 位置落在哪一段、段内按什么顺序归约,只由位置决定,与 batch 无关。合并时按 split 下标从小到大做固定顺序的树形归约,就能保证同一条 query 在任何 batch 下得到相同结果。
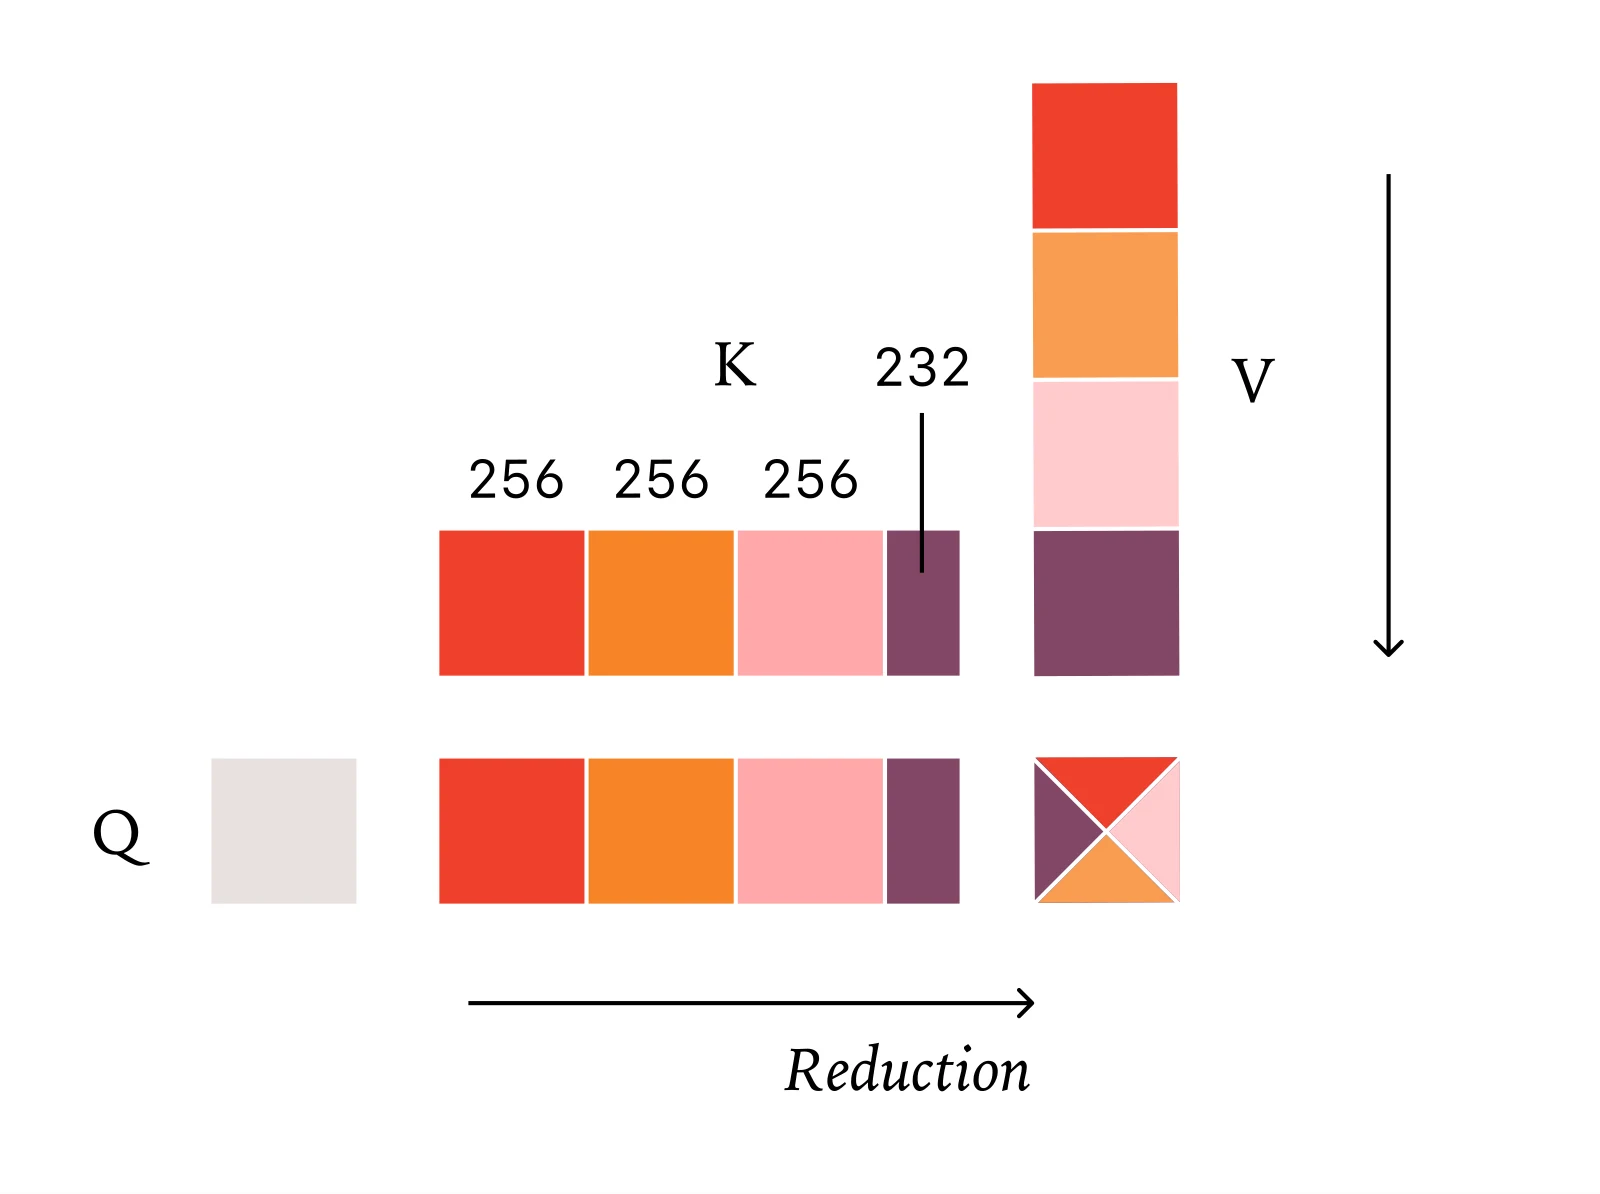
固定 split 大小后,KV 序列的切分边界只由绝对位置决定:1000 个 KV 位置切成三段 256 加一段 232,batch 与 query 长度只改变并行任务数量,不改变每条 query 的归约树。图片来自 Defeating Nondeterminism in LLM Inference。
第二个坑是 KV cache 与当前 token 的边界块。假设 attention kernel 的 KV block size 是 32,cache 里已有 80 个 token,本次又要处理 48 个新 token。如果把 cache 和新增 token 分开计算,cache 部分需要 3 个块(两个满块加一个 16 的尾块),新增部分需要 2 个块(一个满块加一个 16 的尾块),总共 5 个块;但如果这 128 个 token 一次性 prefill,只需要 4 个满块。块数和尾块位置不同,online softmax 的合并顺序就不同。同一段 prompt 走 prefill 还是走 decode,结果会不一致。
| 处理方式 | KV cache 中的 80 个 token | 本次新增的 48 个 token | 块总数 |
|---|---|---|---|
| cache 与新增分开计算 | 32 + 32 + 16,共 3 块 | 32 + 16,共 2 块 | 5 |
| 一次性处理 128 个 token | 不适用 | 32 + 32 + 32 + 32,共 4 块 | 4 |
把已缓存的 80 个 token 和新增的 48 个 token 分开算,会得到 5 个块;一次性处理 128 个 token 只有 4 个块。尾块位置不同,online softmax 的合并顺序就不同。
解决方式不是改归约公式,而是改数据布局:在进入 attention kernel 之前,先把本次要处理的 KV 写入 paged KV cache,并更新 page table(分页 KV 的块表机制见 PagedAttention 完全拆解);这样 kernel 看到的永远是一条连续的逻辑序列,不管它是 cache 命中、chunked prefill,还是一次性 prefill,块边界都按全局位置对齐。Horace He 在文章里明确说,这一步是 attention batch invariance 的必要条件。
第三层是 采样前的 logits 归约。即使模型前向完全一致,采样器里的 log_softmax、top-k、top-p 也会对 vocab 维做归约;如果这些归约的实现随 batch 变化,最终 token 仍可能不同。vLLM 和 SGLang 都把 aten::_log_softmax、aten::softmax、aten::mean.dim 一并替换成固定顺序的 Triton 实现,原因就在这里。
把三类算子放在一起看,规律很清楚:batch invariance 不是“让浮点更精确”,而是“让每个输出元素的归约树与 batch 解耦”。RMSNorm 用固定块大小和每行一个 program;GEMM 用固定 BLOCK_K、禁用 split-K 和 stream-K;Attention 用固定 split 大小、先写 KV cache 再计算、固定 log_softmax。三者的共同点是放弃一部分形状自适应优化,换取可预测的加法顺序。
从 kernel 到系统:调度层还有哪些不确定性
把三类算子的归约顺序钉死,只是走完了第一段路。推理框架在 kernel 之上还有一整层调度:请求被切成 chunk、前缀被缓存、草稿 token 被插入、专家被搬来搬去。这些机制都会改变“哪些 KV 在什么位置、按什么顺序被读”,如果不专门处理,kernel 再确定,端到端结果仍然会漂。
chunked prefill:切几段都要落到同一套块边界
chunked prefill 把长 prompt 切成预算大小的片段,分多次前向执行,目的是避免一个超长 prefill 长时间占住 GPU、拖高其他请求的尾延迟(调度侧的取舍可参考 Sarathi-Serve 完全拆解)。对 batch invariance 来说,它制造了一个新问题:同一条 prompt 在“一次处理”与“分三段处理”两种情形下,attention 看到的 KV 形态不同。前两段被写完、存进 KV cache;第三段只处理尾巴,并且要与 cache 里的前两段一起做 attention。如果 kernel 分别处理 cache 与新增 token,就回到了上一节说的边界块问题。
所以 chunked prefill 与 batch invariance 的兼容条件与 prefill 完全一致:每次前向都能看到从位置 0 到当前位置的完整 KV,块边界按绝对位置对齐,而不是“cache 一段、新增一段”各算各的。SGLang 在确定性推理的兼容表里把 chunked prefill 与 radix cache 逐后端列出支持情况,本质上就是同一套约束:只要 attention 的块边界按绝对位置对齐,切几段都不影响结果。
前缀缓存与 RadixCache:命中与否都要算出同样的 logits
前缀缓存(vLLM 的 prefix caching、SGLang 的 RadixCache)把公共前缀的计算结果存成 KV block,后续请求命中后直接复用;RadixCache 的树结构与引用计数在 RadixAttention 完全拆解 里有完整展开。这个优化对 batch invariance 是双重考验:
- 同一条 prompt,首次请求要全量 prefill,后续请求只算后缀。两者的 attention 输入形态不同,但最终 logits 必须相同,否则“缓存命中”会改变用户看到的答案。
- 多租户共享前缀时,block 会被不同请求复用,block 在 cache 里的物理位置与请求的逻辑位置脱钩。如果 kernel 依赖物理块连续性或按块枚举顺序做归约,复用就会带来差异。
SGLang 的确定性测试专门有 radix_cache 模式:同一段 prompt,一次走缓存命中、一次走全量 prefill,比较输出是否逐位相同。它的确定性推理文档把 RadixCache 支持情况列在特性表里,说明这条路径是被显式验证的,而不是“理论上没问题”。
投机解码:草稿长度不能改变目标模型的 logits
投机解码先让草稿模型生成 个候选 token,再由目标模型一次前向验证,接受最长前缀;特征级草稿与树验证的机制可参考 EAGLE 完全拆解。草稿长度 随上下文变化(例如 EAGLE-2 的动态草稿树),验证时的 query 长度也随之变化:有时是 1 个 token 的普通 decode,有时是一次验证 6 或 8 个 token。
对 batch invariance 而言,危险点在于 query 长度也进入了 kernel 的并行维度。如果 attention kernel 按 维切分、且切分方式依赖于 query 总数,那么“验证 6 个 token”与“逐个 decode”在归约树上就不一样。解决办法仍然是固定归约结构:Q 维切分只影响“哪些 query 放在一起算”,但每条 query 对 KV 的遍历顺序必须只由 KV 位置决定;对被拒绝的 token,必须把 KV 回滚到接受点,避免残留的草稿 token 改变后续 attention 的可见范围。
SGLang 的确定性测试集里专门有 EAGLE 拒绝采样的用例,说明推理框架并不把“确定性”和“投机解码”当作天然兼容的两件事,而是逐条路径单独验证。
专家并行与 EPLB:AllReduce 和专家重排
MoE 模型的推理常用专家并行(EP):不同 rank 持有不同专家,token 需要被 dispatch 到目标 rank,计算结果再 combine 回来。这一步涉及两类通信:
- AllToAll dispatch/combine:token 从各 rank 发出,按专家分桶后送到目标 rank。如果分桶顺序、每个 rank 收到的 token 排列随 batch 变化,后续的加权求和顺序就会变化。
- AllReduce:MoE 层的输出可能需要在 TP 组内做部分和合并,AllReduce 的算法(ring/tree/1-stage)决定加法顺序。
EPLB(Expert Parallelism Load Balancer)在运行中复制热点专家、重排专家位置,以均衡负载;DeepInfer 的副本分配与逐层放置可参考 MoE 专家并行与 EPLB。重排本身不改变数学结果(每个 token 只会被路由到逻辑上同一个专家),但它会改变“哪个 rank 持有哪个专家”,进而改变通信路径与合并顺序。对 batch invariance 来说,这意味着专家重排不能改变逻辑专家的归约顺序:物理副本可以换,逻辑上的加法树必须保持稳定。
一个具体的例子是 DeepEP 的 allow_multiple_reduction 参数:它允许在多次归约中采用不同策略以换取带宽,这会破坏确定性。DeepInfer 在开启 batch invariance 且启用专家重排时,把这个参数强制设为关闭,原因正是两者冲突。
调度顺序与批内位置
还有一类更细的不确定性来自批内位置。如果一个 kernel 的 tile 调度按 pid 递增分配,而 pid 与请求在 batch 中的位置相关,那么请求 A 排第 1 位和排第 7 位,可能落到不同的 tile 编号上;只要 kernel 内部的归约与 tile 编号无关,结果就不受影响。但如果 kernel 使用了按 tile 编号变化的 splitable 调度(stream-K)或按 tile 分组的 persistent 调度,批内位置就会进入归约路径。DeepInfer 的 EPLB 实现可参考 DeepInfer 源码完全拆解(四):MoE 专家并行与 EPLB。
因此“batch-position invariance”与“batch invariance”要分开验证。多数厂商 GEMM 满足前者;Triton persistent matmul 如果采用固定的 tile 映射,也能满足前者。真正的风险点集中在 stream-K、balanced split-KV 和动态 EPLB。
采样器:种子也必须可复现
模型前向确定性之后,采样器还有自己的随机性。temperature、top-k、top-p 采样需要随机数。多数框架的随机数生成器按“batch 内位置”分配种子或偏移量,batch 变化时同一条请求拿到的随机数就不同。要做到端到端确定性,采样器必须支持按请求绑定种子:例如 SGLang 在确定性推理模式下默认使用固定采样种子 42,并允许请求携带 sampling_seed;DeepInfer 要求传入固定的 seq_seed,并关闭投机解码的变长草稿路径。
到这里可以把系统层的约束归纳成一张表:
| 机制 | 对归约的影响 | 兼容条件 |
|---|---|---|
| chunked prefill | KV 被分多次写入,attention 看到分段序列 | 先写 KV cache,按绝对位置对齐块边界 |
| 前缀缓存 / RadixCache | 命中与未命中的计算路径不同 | 全量 prefill 与命中路径逐位一致 |
| 投机解码 | 验证阶段 query 长度随草稿变化 | Q 维切分不影响每条 query 的 KV 遍历顺序;被拒 KV 要回滚 |
| EP / EPLB | 通信合并顺序随 rank 与专家位置变化 | 固定 AllReduce 算法;专家重排不改变逻辑归约顺序 |
| 采样器 | 随机数按 batch 位置分配 | 按请求绑定种子 |
五个框架的实现对照
下面把五个框架放在同一张桌上比较:vLLM、SGLang、TensorRT-LLM、llama.cpp、DeepInfer。它们的目标不完全一样,有的是单机开源服务,有的是面向生产的推理引擎,有的是本地端侧运行器,所以“确定性”被落到了不同的层级。
| 框架 | 开放方式 | 确定性入口 | 主要改造点 | 已知限制 |
|---|---|---|---|---|
| vLLM | 环境变量 VLLM_BATCH_INVARIANT=1 | aten 算子级替换 + 库参数固定 | Triton RMSNorm/GEMM/softmax/AllReduce、cuBLASLt 关 split-K、NCCL 固定 | SM8x 需替换 matmul;部分融合算子需单独验证 |
| SGLang | 启动参数 --enable-deterministic-inference | 在 TML batch-invariant-ops 基础上扩展 | RMSNorm、log_softmax、bmm、mean、attention 后端约束、采样种子 | 仅 FlashInfer、FA3、Triton 三个 attention 后端 |
| TensorRT-LLM | 无公开的 batch-invariant 开关 | 构建期静态形状 + CUDA Graph | 固定 shape 的引擎、静态图、attention 插件 | 不保证跨 batch 组成或跨引擎配置一致 |
| llama.cpp | 无确定性开关 | 单序列图 + 固定 ubatch | 每序列独立图、KV cache 与 ubatch 边界 | 多序列共享 ubatch 时行为依赖具体模型/kernel |
| DeepInfer | DEEPINFER_BATCH_INVARIANT=1 | 引擎级开关 | 确定性算子库、seq_seed、EPLB/DeepEP 参数耦合、投机限制 | batch invariant 仅 NVIDIA(SM100);Ascend 待补齐;与变长投机不能同时开启 |
vLLM:把 aten 算子整体替换成 batch-invariant 实现
vLLM 的入口是一个环境变量:
VLLM_BATCH_INVARIANT=1 vllm serve meta-llama/Llama-3.1-8B-InstructvLLM 的文档目前把这项能力标注为 beta,支持 NVIDIA compute capability 8.0 及以上、AMD gfx90a/gfx942/gfx950,以及需要 Triton Attention 后端的 Intel XPU;并且给出了一份已验证模型清单(DeepSeek-V3/V3.1/R1、Qwen3 系列、Llama 3 系列、GPT-OSS 等)。内部初始化流程分四步,定义在 vllm/model_executor/determinism/batch_invariant.py 的 init_batch_invariance() 里:
resolve_tuned_matmul_configs():按模型维度提前选好block_k等参数,避免运行时再按 batch 调参;override_envs_for_invariance():覆盖 AllReduce、cuBLAS workspace、NCCL 协议、ROCm skinny GEMM、torch.compile 的 inductor batch_invariant 配置;enable_batch_invariant_mode():注册torch.library.Library("aten", "IMPL"),用 Triton 实现覆盖aten::mm、aten::addmm、aten::mm.out、aten::addmm.out、aten::matmul、aten::linear、aten::mean.dim、aten::_log_softmax、aten::softmax、aten::_softmax、aten::bmm、aten::bmm.out;- 关闭 TF32 与 fp16/bf16 的 reduced-precision reduction,防止 matmul 在累加时降精度。
这段代码里有几个设计细节很值得讲。
按硬件分流。在 Hopper 和 Blackwell 上,vLLM 不替换 matmul,而是设置 CUBLAS_WORKSPACE_CONFIG=:16:8、CUBLASLT_WORKSPACE_SIZE=1 来关闭 split-K;注释里写得很清楚:“Hopper (SM90) and Blackwell (SM100): the only source of batch variance is split-k”。在 SM8x 和 ROCm 上则退回到 Triton persistent matmul,因为 cuBLASLt 和 hipBLASLt 在这两类设备上无法保证 batch invariance。同一套 API,不同硬件走不同路径,这是工程上非常典型的分层。
注册 .out 重载。PyTorch 的 torch.mm(a, b, out=c) 走的是 aten::mm.out 而不是 aten::mm;如果只替换前者,代码里带 out= 的路径仍然会落到厂商库。vLLM 把 .out 变体一起注册,并在 torch 2.12+ 上对内置 bmm 使用 allow_override=True,说明“把所有入口封死”是这件事的必要步骤。
对 XPU 的差异化处理。注释指出 oneDNN 后端的 softmax、log_softmax、bmm 本身就 batch-invariant,所以只在 CUDA 上注册这些覆盖;XPU 上只替换 matmul/linear 相关入口与 mean。这说明“哪些算子是问题”本身依赖后端,不能一刀切。
AllReduce 的固定。override_envs_for_invariance() 把 VLLM_CUSTOM_ALLREDUCE_ALGO 固定为 1stage,并设置 NCCL_LAUNCH_MODE=GROUP、NCCL_PROTO=Simple、NCCL_MIN/MAX_NCHANNELS=1、NCCL_ALGO=ring,tree;allreduce:tree。注释里有一处非常具体的坑:NCCL 2.31 之后,设置 NCCL_ALGO 会清空所有集合通信的算法表,只保留被点名的算法;如果集合通信没有被点名,会以 ncclInvalidUsage 失败。因此代码先把 ring、tree 为所有集合通信打开,再把 AllReduce 钉到 tree。这种“看起来无关的配置导致启动失败”的细节,正是确定性工程比论文复杂的地方。
测试体系。vLLM 的 tests/v1/determinism/ 下有一整套用例:test_batch_invariance、test_online_batch_invariance、test_rms_norm_batch_invariant、test_matmul_batch_invariant、test_nvfp4_batch_invariant、test_mx_linear_batch_invariant、test_cutlass_batch_invariance、test_lora_shrink_batch_invariant。从命名可以看出它覆盖了量化 GEMM、LoRA、在线服务等不同路径,也说明 vLLM 把“batch invariance”当作一个持续维护的子系统,而不是一个开关。
SGLang:deterministic inference 模式与采样种子
SGLang 的入口是一个启动参数:
python3 -m sglang.launch_server \ --model-path Qwen/Qwen3-8B \ --attention-backend fa3 \ --enable-deterministic-inference它的文档直接写明:实现基于 Thinking Machines Lab 的 batch_invariant_ops,并在其上兼容 chunked prefill、CUDA Graph、RadixCache 与非贪心采样。代码层面,python/sglang/srt/batch_invariant_ops/batch_invariant_ops.py 提供了:
matmul_kernel_persistent与_matmul_persistent_triton、_matmul_persistent_deepgemm两条 matmul 路径,其中 DeepGEMM 路径会先调用get_deterministic_algorithms()检查状态——注释写明 DeepGEMM 0.2 的 bf16 GEMM 默认走 cuBLASLt、其归约会随 batch 变化——必要时临时切到确定性算法,算完再切回去;_log_softmax_kernel/log_softmax,固定BLOCK_SIZE沿 vocab 维串行;mean_kernel/mean_dim;bmm_kernel_persistent/bmm_batch_invariant;_rms_norm_kernel/rms_norm_batch_invariant,注释里标明改编自 vLLM 的对应实现;enable_batch_invariant_mode(),用torch.library覆盖aten::_log_softmax、aten::rms_norm等,并提供set_batch_invariant_mode()上下文管理器;get_batch_invariant_attention_block_size()返回block_m=16, block_n=16,用于把 attention 的块大小固定住。
与 vLLM 相比,SGLang 的特点在于:
attention 后端受限。确定性推理只在 FlashInfer、FA3、Triton 三个后端下支持,文档里的特性表写明 FlashInfer 后端不支持 RadixCache,而 FA3 和 Triton 全部支持。这里必须点出来:RadixCache 支持与否直接影响“缓存命中路径与全量 prefill 路径是否一致”,不是可以忽略的表格项。
采样种子按请求绑定。确定性推理模式下默认种子是 42,并且请求可以携带 sampling_seed。对 GRPO 这类需要“同一 prompt 多次采样、但每次可复现”的场景,这个设计很实用:不同 seed 给出多样本,同一个 seed 给出逐位相同的样本。
RadixCache 一致性验证。python3 -m sglang.test.test_deterministic --test-mode radix_cache 专门比较“缓存命中”与“未命中”的输出,预期结果是 Unique samples: 1。这个测试设计值得借鉴:它验证的不是“同一个脚本跑两遍”,而是两条不同的运行时路径。
NPU 分支。python/sglang/srt/hardware_backend/npu/batch_invariant_ops/npu_batch_invariant_ops.py 覆盖了 aten::_log_softmax、npu_fused_infer_attention_score、npu_add_rms_norm 等 NPU 算子,说明同一套思路可以在昇腾上复现,但需要逐算子重写。
TensorRT-LLM:静态形状与 CUDA Graph 的另一条路
TensorRT-LLM 在公开文档与代码组织里没有 --enable-deterministic-inference 这样的开关,但它有一套结构性的“确定性来源”:构建期把模型编译成静态形状的引擎,运行时按固定 shape 执行。
传统 TensorRT 引擎在构建时确定每个 kernel 的 tile 配置、tensor core 指令与 split 策略,运行时不能根据 batch 大小重新选 kernel。加上 CUDA Graph,整个前向是一次图的回放,kernel launch 顺序、grid 大小都固定。这天然满足了“同一 shape 重复执行结果一致”,也满足“在同一个引擎、同一个 shape 下 batch 组成不影响单条请求”的很多条件。
但要讲清楚它的边界:
- 跨 batch size 不保证一致。TensorRT-LLM 的 dynamic shape 或 padding 策略可能会把不同 batch 形状的请求映射到同一个执行 profile;如果两个 profile 使用不同的 kernel 配置,同一个请求在不同 profile 下结果就可能不同。它不是 vLLM 那种“任意 batch 组成逐位一致”的承诺。
- 插件与自定义 kernel 是变量。attention 插件、MoE 插件、量化 GEMM 插件各自有自己的归约实现;插件升级、量化方案切换都会改变数值。
- P/D 分离与 KV 传输。TensorRT-LLM 的 disaggregated serving 需要把 KV cache 从 prefill 实例搬到 decode 实例;如果两边使用不同的引擎配置,KV 的量化与布局可能不同,结果也会不同。
因此,TensorRT-LLM 的“确定性”更接近“在固定引擎、固定 shape profile 下的可重复”,而不是推理框架级的 batch invariance。它的优势是把很多不确定性提前到构建期消除;劣势是灵活性下降,动态 shape 与多 profile 会让“同一请求走哪个 profile”变成新的不确定性来源。如果要在 TensorRT-LLM 上做真正的 batch-invariant 服务,通常需要把 batch 维度固定成少量 profile,并保证所有 profile 的数值行为一致,或者把请求 padding 到固定形状——后者代价是算力浪费。
llama.cpp:单序列语义与 ubatch 的边界
llama.cpp 的目标不是高并发在线服务,而是本地、多平台的推理。它的确定性特性来自结构设计而非显式开关:
每个序列独立构图。在 llama_context 中,llama_batch 被切分成若干 llama_ubatch,每个 ubatch 构建自己的 llm_graph_result。对于单个序列,同一段 prompt 的图结构只由 token 与 KV 状态决定;如果 n_ubatch 足够大、整段 prompt 落在一个 ubatch 里,结果就是固定的。
ubatch 切分是主要变量。当 prompt 长度超过 n_ubatch(默认等于 n_batch),它会被切成多个 ubatch 分段计算。这与 chunked prefill 类似:只要 attention 在每一段都能看到前面的 KV,且 KV 的块边界按位置对齐,结果就应当稳定;但不同模型、不同 backend 的 attention kernel 是否真的如此,需要逐项确认。
多序列共享 ubatch。llama.cpp 的 ubatch 可以把多个序列的 token 合并在一起,以提升 CPU/GPU 利用率(split_simple 等拆分方式)。这时,不同序列共享同一个图,但每条序列的 attention 只访问自己的 KV;是否 batch-invariant 取决于各 backend 的 kernel 实现。llama_context.cpp 里有一条注释:“TODO: add new split mode where we pad the input sequences so that ubatch.equal_seqs == true”,说明作者也意识到“等长序列填充”可以简化 batch 的处理,只是当前的 split 方式并不保证这一点。
sampling 与 logits 的边界。llama.cpp 的采样器按序列各自维护 sampler chain,logits 的提取位置与 batch 内位置无关;但 logits 的 n_vocab 维归约由 backend 的 softmax/top-k 实现决定,不同 CPU 指令集(AVX2、AVX512、NEON)的归约可能给出不同结果。所以 llama.cpp 上的“确定性”通常是“同一机器、同一后端、同一 ubatch 配置下可重复”,跨设备/跨后端不保证逐位一致。
适合的场景。本地单用户、agent 本地运行、评测离线批跑;在这些场景里,请求队列通常很短,batch 组成稳定,ubatch 切分固定,确定性带来的风险通常小于在线服务。但如果把 llama.cpp 的 server 当作多用户服务,且 batch 动态变化,就需要自己核对 n_batch、n_ubatch、attention 后端的数值行为。
DeepInfer:batch invariant、确定性采样与 EPLB 的耦合
DeepInfer 是 DeepSeek 开源的推理引擎,仓库见 deepseek-ai/DeepInfer。当前版本支持 DeepSeek-V4.1-Flash,面向 NVIDIA SM100 与华为 Ascend 950。它的 README 把 “Batch-invariant inference” 与 “Deterministic sampling” 单列为两项功能,并给出了很具体的配置方式:
# batch invarianceexport DEEPINFER_BATCH_INVARIANT=1
# deterministic sampling:需要同时满足三个条件export DEEPINFER_BATCH_INVARIANT=1export DEEPINFER_ENABLE_MTP_VARLEN=0# 并向 SamplingParams 传入固定的 seq_seed这两组配置揭示了 DeepInfer 对确定性的分层理解:前向的 batch invariance 与采样器的确定性是两件独立的事。前向确定性保证了 logits 不随 batch 变化;采样确定性还要求随机数种子按请求绑定(seq_seed),并且关闭“变长投机验证”(MTP_VARLEN)——因为变长验证会改变 query 长度和 KV 访问路径,README 明确要求确定性采样时把它关闭。
代码层面,deepinfer/environ.py 用 EnvVar.bool() 定义了 DEEPINFER_BATCH_INVARIANT;deepinfer/worker/runtime_config.py 的 configure_worker_kernels() 在 GPU 上调用 deep_gemm.use_deterministic_algorithms(True) 与 tile_kernels.use_deterministic_algorithms(True),同时在 Ascend 上直接断言不允许开启(注释是“待完整支持 batch invariant 后移除”)。这说明 DeepInfer 的确定性建立在它自研的算子库上:DeepGEMM 与 TileKernels 提供确定性模式,而不是覆盖 PyTorch 的 aten。
与 EPLB 的耦合值得单独展开。deepinfer/model_executor/parallel_utils/userbuffer.py 在分配 DeepEP 的 EP 缓冲区时写:
allow_multiple_reduction=not ( envs.DEEPINFER_BATCH_INVARIANT and envs.DEEPINFER_EXPERT_REARRANGEMENT_STEP_INTERVAL > 0)含义是:只要同时开启了 batch invariance 与专家周期性重排,就不允许 DeepEP 在一次通信中做多种 reduction。原因在系统层小节已经讲过:多种 reduction 的合并顺序会随分组变化,专家重排又会改变分组,两者叠加就破坏了逻辑上的归约顺序。
fused kernel 的让步。deepinfer/model_executor/models/v4_modules/attn.py 里有一个 use_fused_norm_rope_attn_rope_cast 开关,启用条件包含 not envs.DEEPINFER_BATCH_INVARIANT and cfg.engine_type == EngineType.PROMPT。也就是说,在 prompt 引擎的 dense packed-KV 路径上,确定性模式会关闭默认高性能的“norm + RoPE + attention + RoPE + cast”融合 kernel,退回更朴素、归约顺序可控的实现。这是一个很典型的“确定性成本”落点:融合越深,越难保证每一步的归约顺序与 batch 无关。
attention 后端的开关透传。deepinfer/model_executor/layers/attention_backend.py 的 flash_mla_with_kvcache(..., enable_batch_invariant=batch_invariant) 把开关传给 FlashMLA;对 sparse MLA 路径,DeepInfer 还会走 TileLang 的 flash_mla_sparse_fwd 与 fused_norm_rope_attn_rope_cast.decode;后者在 fused_norm_rope_cast_kwargs 不为空时直接走融合 kernel。需要说明的是,sparse 路径的融合判断条件与 dense prompt 路径不同,确定性开关并不能自动覆盖所有融合分支,这也是“逐路径验证”比“打开一个开关”更重要的原因。
测试。tests/models/test_batch_invariant.py 的做法是:64 条随机 prompt(长度按均值 2500、标准差 1000 采样,max_tokens=50、top_logprobs=5),先以 batch 形式生成,再让单条 prompt 单独跑一遍,比较 token id、logprob、top-5 token 与 top-5 logprob 是否完全相等;单独跑时借用首轮的 token 作为 golden_token_ids,让两条路径对齐在同一条随机流上。用例在 EP 规模为 8 的集群上运行,并可开启 use_nextn_decode=5 覆盖 NextN 投机解码。这个测试比“同脚本跑两遍”严格得多:它同时验证了批内位置、batch 大小、EP 并行与投机解码对结果无影响。
把五个框架并排看,可以归纳出四种工程策略:
- 算子替换型(vLLM、SGLang):在 aten 或算子库层注入确定性实现,调度和模型代码基本不变。优点是通用性强、可以覆盖任意模型;缺点是依赖每个算子都被正确覆盖,融合算子与量化路径容易漏。
- 引擎编译型(TensorRT-LLM):在构建期冻结形状与 kernel 选择,运行时只回放固定图。优点是数值路径稳定;缺点是对动态形状不友好,跨 profile 不保证一致。
- 端侧结构型(llama.cpp):依靠单序列构图与固定的 ubatch 切分,确定性与平台和后端强相关。
- 引擎自研型(DeepInfer):从自研算子(DeepGEMM、TileKernels、FlashMLA)开始就提供确定性模式,并在调度、通信、专家重排处显式处理耦合关系。优点是全链路可控;缺点是跨平台(尤其 Ascend)仍在补齐。
代价、收益与验证方法
确定性不是免费的。把上面五个框架的代价放在一起看,可以分成四类。
kernel 利用率下降。RMSNorm 每行一个 program、固定 BLOCK_SIZE,在小 batch 时 program 数不足,SM 空转;Triton persistent matmul 关掉 split-K 后,小 M 时并行度不够;RMSNorm 固定 1024 块、每行一个 program,decode 小 batch 下只开几十个 CTA。Thinking Machines Lab 给出的实测是:单卡 Qwen-3-8B、1000 条请求、输出长度 90 到 110,vLLM 默认耗时 26 秒,未优化的确定性版本 55 秒,改进 attention kernel 后 42 秒。也就是说,即使不做深度优化,代价大约在 1.6 倍到 2.1 倍之间,改进后仍有约 1.6 倍的差距。Horace He 也说明这部分没有花大力气优化,后续仍有空间。
算子选择受限。融合算子(norm+RoPE+KV 写入、fused add RMSNorm、fused MoE)在确定性模式下经常要拆开;FlashInfer 的 balanced scheduling、stream-K、动态 split-KV 这类性能特性在确定性模式下通常不可用。对 DeepSeek-V4 这类依赖融合 kernel 与稀疏索引的模型,DeepInfer 选择在确定性模式下关闭部分融合路径,代价是每层多几次 kernel launch 与访存。
并行策略收敛。AllReduce 必须固定成 1-stage 或 tree,NCCL 通道数钉成 1,通信带宽利用率下降;EPLB 的灵活性被限制,专家重排与多 reduction 不能叠加。对大规模 EP 集群,这可能是最显著的代价。
工程复杂度上升。一个框架的确定性依赖:每个带归约的 aten 算子都被覆盖、每个融合 kernel 都有确定性版本、每个后端都验证过、调度层的每条路径(chunked prefill、前缀缓存、投机、P/D、LoRA、量化)都跑过测试。任何一个漏点,都会让“batch invariant”在某个特定路径上失效。vLLM 用一整个 tests/v1/determinism/ 目录维护这件事,SGLang 用 test_deterministic.py 的多种模式验证,DeepInfer 用单条对 batch 的逐位比较测试,都是这个复杂度的体现。
收益方面,最直接的是:评测可复现、RL 采样可复现、Agent 工具调用可复现、缓存命中与未命中的行为一致。Horace He 还提到一个衍生收益:当采样器与训练器在 logprob 上逐位一致时,on-policy RL 才真正是 on-policy,KL 散度可以稳定在 0,避免奖励崩塌。这部分涉及训练,但推理侧的确定性是它的前提。
自己动手验证:三条检查线
无论使用哪个框架,验证 batch invariance 至少要过三条线:
第一条:同一请求,不同 batch 组成。 构造一组短 prompt、一组长 prompt,混合成不同 batch(例如 1、4、16、64 条一起),比较同一条 prompt 的 token id、logprob、top-k logprob。DeepInfer 的 test_batch_invariant.py 就是这个思路的完整版本。
第二条:不同并行路径。 让同一条 prompt 分别走“全量 prefill”与“前缀缓存命中”,以及“普通 decode”与“投机解码验证”。SGLang 的 --test-mode radix_cache 就是这条线。
第三条:不同 chunk 切分。 同一条长 prompt 分别以整段 prefill 与 chunked prefill 计算,比较 logits。可以借用 vLLM 的 tests/v1/determinism/test_online_batch_invariance.py 的思路:通过并发数控制 batch 大小,比较同一请求在不同负载下的输出。
一个最小化的验证脚本可以写成:
from openai import OpenAI
client = OpenAI(api_key="EMPTY", base_url="http://localhost:8000/v1")
def ask(prompt, seed=42): r = client.completions.create( model="meta-llama/Llama-3.1-8B-Instruct", prompt=prompt, max_tokens=64, temperature=0.0, seed=seed, logprobs=5, ) return r.choices[0].logprobs
ref = ask(TARGET_PROMPT)# 在另一段时间、不同并发负载下再次请求,比较 logprobs 是否逐位相同如果比较的是 logprob 数组而不是最终文本,就能在 token 分叉之前发现问题。对比文本“看起来一样”并不可靠:分歧往往发生在第 100 个 token 之后,而评测只比较最终答案。
小结
batch invariance 是一个比“可重复执行”更严格的性质:它要求同一请求在不同 batch 大小、不同批内位置、不同调度路径下得到逐位相同的 token 与 logprob。推理框架的默认实现不满足它,原因不是 atomicAdd,也不是线程调度,而是 kernel 为了填满 GPU 会按形状选择不同的归约树——RMSNorm 的 split reduction、GEMM 的 split-K/stream-K、Attention 的 balanced split-KV 与 KV 边界块,都是典型例子。
修复的路径可以总结成四句话:
- 把归约树与形状解耦:固定块大小、固定 split 大小、固定 tensor core 配置,让每个输出元素的加法顺序只由模型结构决定;
- 把数据布局先整理好:进 attention 前把 KV 写入 paged cache,让 chunked prefill、前缀缓存、decode 看到同一条逻辑序列;
- 把通信与并行钉死:AllReduce 算法、NCCL 协议、专家重排、专家复制都要与确定性策略对齐;
- 把采样器纳入确定性:logits 确定了还不够,随机数要按请求绑定种子。
五个框架给出的答案各不相同:vLLM 选择在 aten 层做通用替换并用硬件分流降低代价;SGLang 在 TML 算子库上扩展并约束 attention 后端;TensorRT-LLM 用构建期静态形状获得结构性稳定;llama.cpp 依赖单序列图与固定 ubatch;DeepInfer 从自研算子库到调度、通信、专家重排做全链路耦合。它们共同的启示是:确定性不是某一个 kernel 的属性,而是从算子到调度的整条链路的属性。
延伸阅读:KV cache 的分页与物理块管理可参考 PagedAttention 完全拆解 与 vLLM 源码完全拆解(四):KVCacheManager 如何分配、复用与回收物理 Block;分块 prefill 与调度可参考 Sarathi-Serve 完全拆解;FlashInfer 的注意力实现与 balanced scheduling 可参考 FlashInfer 完全拆解;专家并行负载均衡可参考 DeepInfer 源码完全拆解(四):MoE 专家并行与 EPLB。
参考资料
- Defeating Nondeterminism in LLM Inference — Thinking Machines Lab
- thinking-machines-lab/batch_invariant_ops
- vLLM Batch Invariance 文档
- vLLM batch_invariant.py 源码
- vLLM determinism 目录源码
- SGLang Deterministic Inference 文档
- SGLang batch_invariant_ops 源码
- DeepInfer 仓库与 Batch-invariant 说明
- SGLang 确定性推理测试 test_deterministic.py
- TensorRT-LLM 仓库
- llama.cpp 仓库
- SGLang NPU batch-invariant 算子
- DeepInfer 批次不变性测试 test_batch_invariant.py
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



