


DeepInfer 源码拆解(十三):DP Attention 与 Wide-EP——不做张量并行的四轴并行拓扑
从第十二篇留下的问题说起
前十二篇沿着 DeepInfer 的执行路径走了一遍:请求怎么进引擎、C++ 调度器怎么出计划、KV 与状态槽怎么记账、MoE 专家怎么排布、投机解码与结构化输出怎么闭环、CUDA Graph 怎么把动态批冻成静态图。到这一步,单机内部的机制基本齐了,但还有一层一直没有正面回答:这些 rank 之间到底怎么分工,谁和谁通信,为什么 DeepInfer 的代码里找不到熟悉的张量并行?
这不是一个边角问题。读 vLLM 或 TensorRT-LLM 的源码时,ColumnParallelLinear、RowParallelLinear、all_reduce 会反复出现,读者很容易形成一种默认预期:大模型推理的并行 = 张量并行(TP)打底,再叠加流水并行(PP)、数据并行(DP)与专家并行(EP)。DeepInfer 打破了这个预期:model_executor/layers/linear.py 里只有一个 ReplicatedLinear,ParallelConfig 里没有 tp_size 这个字段,官方部署文档则直接写明“TP and CP are not used for now”。
本文要回答四个问题:
- 没有 TP,一个 40 层、384 个路由专家的模型如何摊到 64 张甚至更多 GPU 上?
- 代码里的 DP、EP、CP、ENP 四条并行轴各自切什么、在哪些 rank 之间建组、每步要付多少通信?
- 既然不做 TP,为什么
parallel_utils里还留着完整的 CP 实现?它在什么条件下才会被打开? - 这套拓扑与 vLLM 的 TP、SGLang 的 DP Attention、TensorRT-LLM 的 Mapping 体系相比,设计前提和代价分别是什么?
先把结论摆出来,后文再逐条给证据:
- DeepInfer 的生产拓扑只有两条主轴承:attention 走 DP,MoE 走 Wide-EP。 官方部署口径是
#DP = #EP,每个 GPU 是一个独立的调度引擎,持有完整的注意力权重,专家则按 EP 切分。专家权重占模型参数的绝大多数,所以“注意力复制、专家切分”在显存和带宽上都是划算的。 - 没有 TP 的直接后果是 dense 路径上没有任何逐层 all-reduce。 一个 decode step 的集合通信几乎只剩 MoE 层的 dispatch/combine,以及一条用于 DP 对齐的控制型 all-reduce。对毫秒级解码来说,省掉的不是带宽,而是每层一次全局同步的延迟。
- MoE 的通信量按“激活专家数 × 隐维”计,而不是按“整层激活”计。 V4.1-Flash 是 384 选 6,单 token 每层只搬 6 份 5120 维向量;EP 越大,每卡负责的专家越少、每步读的权重越少,这正是 Wide-EP 在 decode 阶段提高 TPS 的机制。
- CP 是代码里存在、但生产部署暂时不用的第五条轴。 它按 zigzag 方式把 prompt 的 token 切给各 rank,在模型首尾与注意力内部做 all-gather;能缓解长 prompt 的 prefill 压力,但会把 KV 与调度复杂度一起放大,所以当前版本选择用 DP 负载均衡而不是 CP 来解决长上下文。
- ENP 是 Engram 专属的分片轴。 它不是把权重切给 expert,而是把哈希表按行切开,查询时按 hash 跨 rank 取 embedding;这解释了为什么
ParallelProcessGroup里还有一组enp组。
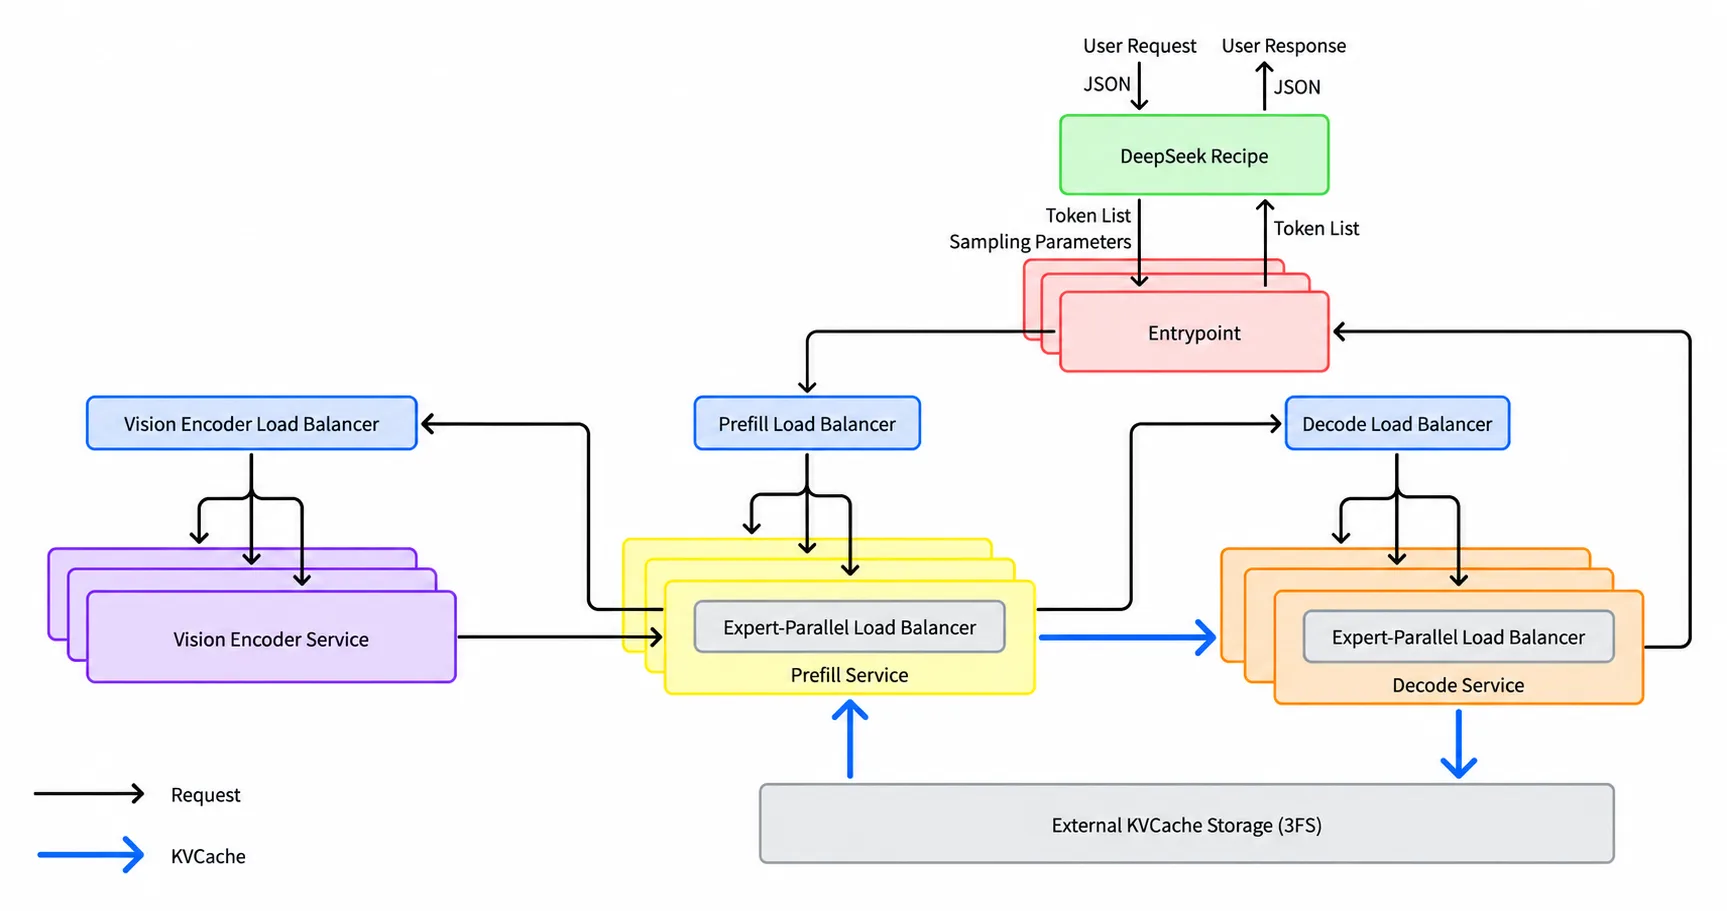
(图源:DeepInfer 官方仓库 doc/images/architecture_overview.png。图中 Decode 实例内部的多卡组织方式就是本文要拆的 Wide-EP;后文会说明为什么这张图里没有出现 TP 的痕迹。)
先把四条轴的定义摆清楚
在进入源码之前,用一张表建立坐标系。这里的“切什么”指的是权重或计算被切分的维度,“组内通信”指的是这条轴在一步前向里需要的集合通信。
| 并行轴 | DeepInfer 里的字段 | 切什么 | 组内通信 | 生产是否启用 |
|---|---|---|---|---|
| DP(数据并行) | data_parallel_size | 请求批次;每个 rank 是独立引擎,持有完整注意力权重 | 无逐层通信;仅控制面的 all_reduce(MAX) 用于对齐“还有没有活” | 是,且 DP = EP |
| EP(专家并行) | expert_parallel_size | MoE 路由专家的物理槽位,physical / EP 个/rank | 每层一次 dispatch + combine(All-to-All) | 是,decode 用 EP64–128 |
| CP(上下文并行) | context_parallel_size | prompt 的 token 序列(zigzag 切分) | 模型首尾 all-gather、注意力内 KV all-gather | 代码支持,生产暂不使用 |
| ENP(Engram 并行) | engram_parallel_size | Engram 哈希表的行 | 按 hash 远程取 embedding,scale 因子 all-gather | 仅 Engram 层 |
| TP(张量并行) | 无 | — | — | 否 |
这张表里最容易被忽略的是最后一行:DeepInfer 不是“把 TP 藏起来了”,而是根本没有这条轴。 deepinfer/config.py 的 ParallelConfig 只接收 data_parallel_size、context_parallel_size、expert_parallel_size、engram_parallel_size、engine_rank、engine_group_rank 六个参数;model_parallel_size 不是用户传入的 TP 大小,而是由 CP 大小推导出来的:
self.model_parallel_size = self.context_parallel_sizeself.engram_parallel_size = engram_parallel_size or (self.model_parallel_size * data_parallel_size)self.world_size = max(self.model_parallel_size * data_parallel_size, self.engram_parallel_size)也就是说,在这个代码库里“模型并行”这个词指向的是 CP:一个模型副本被 CP 切成若干段序列,而不是被 TP 切成若干段权重。world_size 的公式则说明 ENP 可能比 DP×CP 更大——Engram 表可以跨到比模型副本更多的 rank 上,这一点后面单独讲。
为什么不做张量并行:先把账算清楚
要理解一个“缺失的设计”,最好的办法是把它本来要解决的问题摆出来,再看不做它会失去什么、又避开了什么。
TP 到底切了什么
张量并行把一个线性层的权重矩阵按列或按行切开。以 Y = XW、W 形状 [K, N] 为例,列并行把 W 按 N 切成 W_1 ... W_p,每个 rank 算 Y_i = XW_i,输出按列拼接;行并行把 W 按 K 切,每个 rank 算部分和 Y_i = XW_i,最后 all-reduce 求和。Megatron-LM 的经典做法是 attention 的 QKV 投影用列并行、输出投影用行并行,MLP 的 gate/up 用列并行、down 用行并行,于是一个 Transformer 层里有两处 all-reduce:
all-reduce 的耗时不只取决于字节数。按经典的 α-β 模型,一次 ring all-reduce 的延迟约为:
其中 是并行度, 是单次消息的固定延迟, 是链路带宽, 是要规约的字节数。第一项与数据量无关,只与 rank 数和网络延迟有关;第二项才是带宽项。decode 阶段每步的 token 数很少(比如 60 个并发序列、每 rank 每步 60 个 token), 很小,TP 的代价几乎全部落在第一项上:40 层、每层两次 all-reduce,就是 80 次全局同步。即使每次只要 10–20 μs,也会给一个本已压到毫秒级的 step 增加 1 ms 量级的固定开销。
MoE 的账本正好相反
DeepSeek 系列模型的主体参数在 MoE 专家里。V4.1-Flash 的配置是 hidden_size=5120、moe_intermediate_size=2304、n_routed_experts=384、num_experts_per_tok=6、num_hidden_layers=40。单个专家的参数量约为:
三个矩阵分别是 gate、up、down;按 FP4 权重每元素 0.5 字节计,一个专家约 17.7 MB。384 个专家合计约 6.8 GB/层,40 层约 272 GB——这才是模型权重的大头。相比之下,一层注意力的 Q/KV 低秩投影、输出投影加起来只有千万级参数。
于是两种切法的收益完全不同:
- TP 切注意力:每层省下的权重读取量有限,却要付出每层两次 all-reduce 的固定延迟;而且 V4.1-Flash 的
num_key_value_heads=1,KV 只有一个头(MLA 的低秩 latent),按头切分根本切不出并行度,只能把 latent 本身切开再做聚合,复杂度更高。 - EP 切专家:每卡只读
physical / EP个专家,权重读取量按 EP 线性下降;通信只发生在 MoE 层,且只搬“被路由到的 token”,不搬整层激活。
官方部署文档把这两点总结得很直接:prefill 用 EP2–8 / DP2–8,“用 HBM 允许的最小 EP/DP”;decode 用 EP64–128 / DP64–128(Wide-EP),“用可用 GPU 允许的最大 EP/DP”,并且明确写着 “TP and CP are not used for now”。这不是一句省略,而是这套模型结构下的最优解。
一个容易误读的地方:DP 不等于“复制整个模型”
严格说,DeepInfer 的 DP rank 复制的是注意力与稠密部分,不是全部权重。MoE 专家由 EP 切分(EP 组的构成见下一节),因此每个 DP rank 的显存账单是:
这正是“DP Attention + EP MoE”这个组合的含义:注意力按请求复制,专家按权重切分。它和 DeepSeek-V3/R1 在线系统的“MLA/共享专家 DP、路由专家 EP”是同一套思路,本站此前拆过的 DeepSeek-V3/R1 推理系统 给过生产口径的对照:prefill 是 EP32/DP32,decode 是 EP144/DP144。
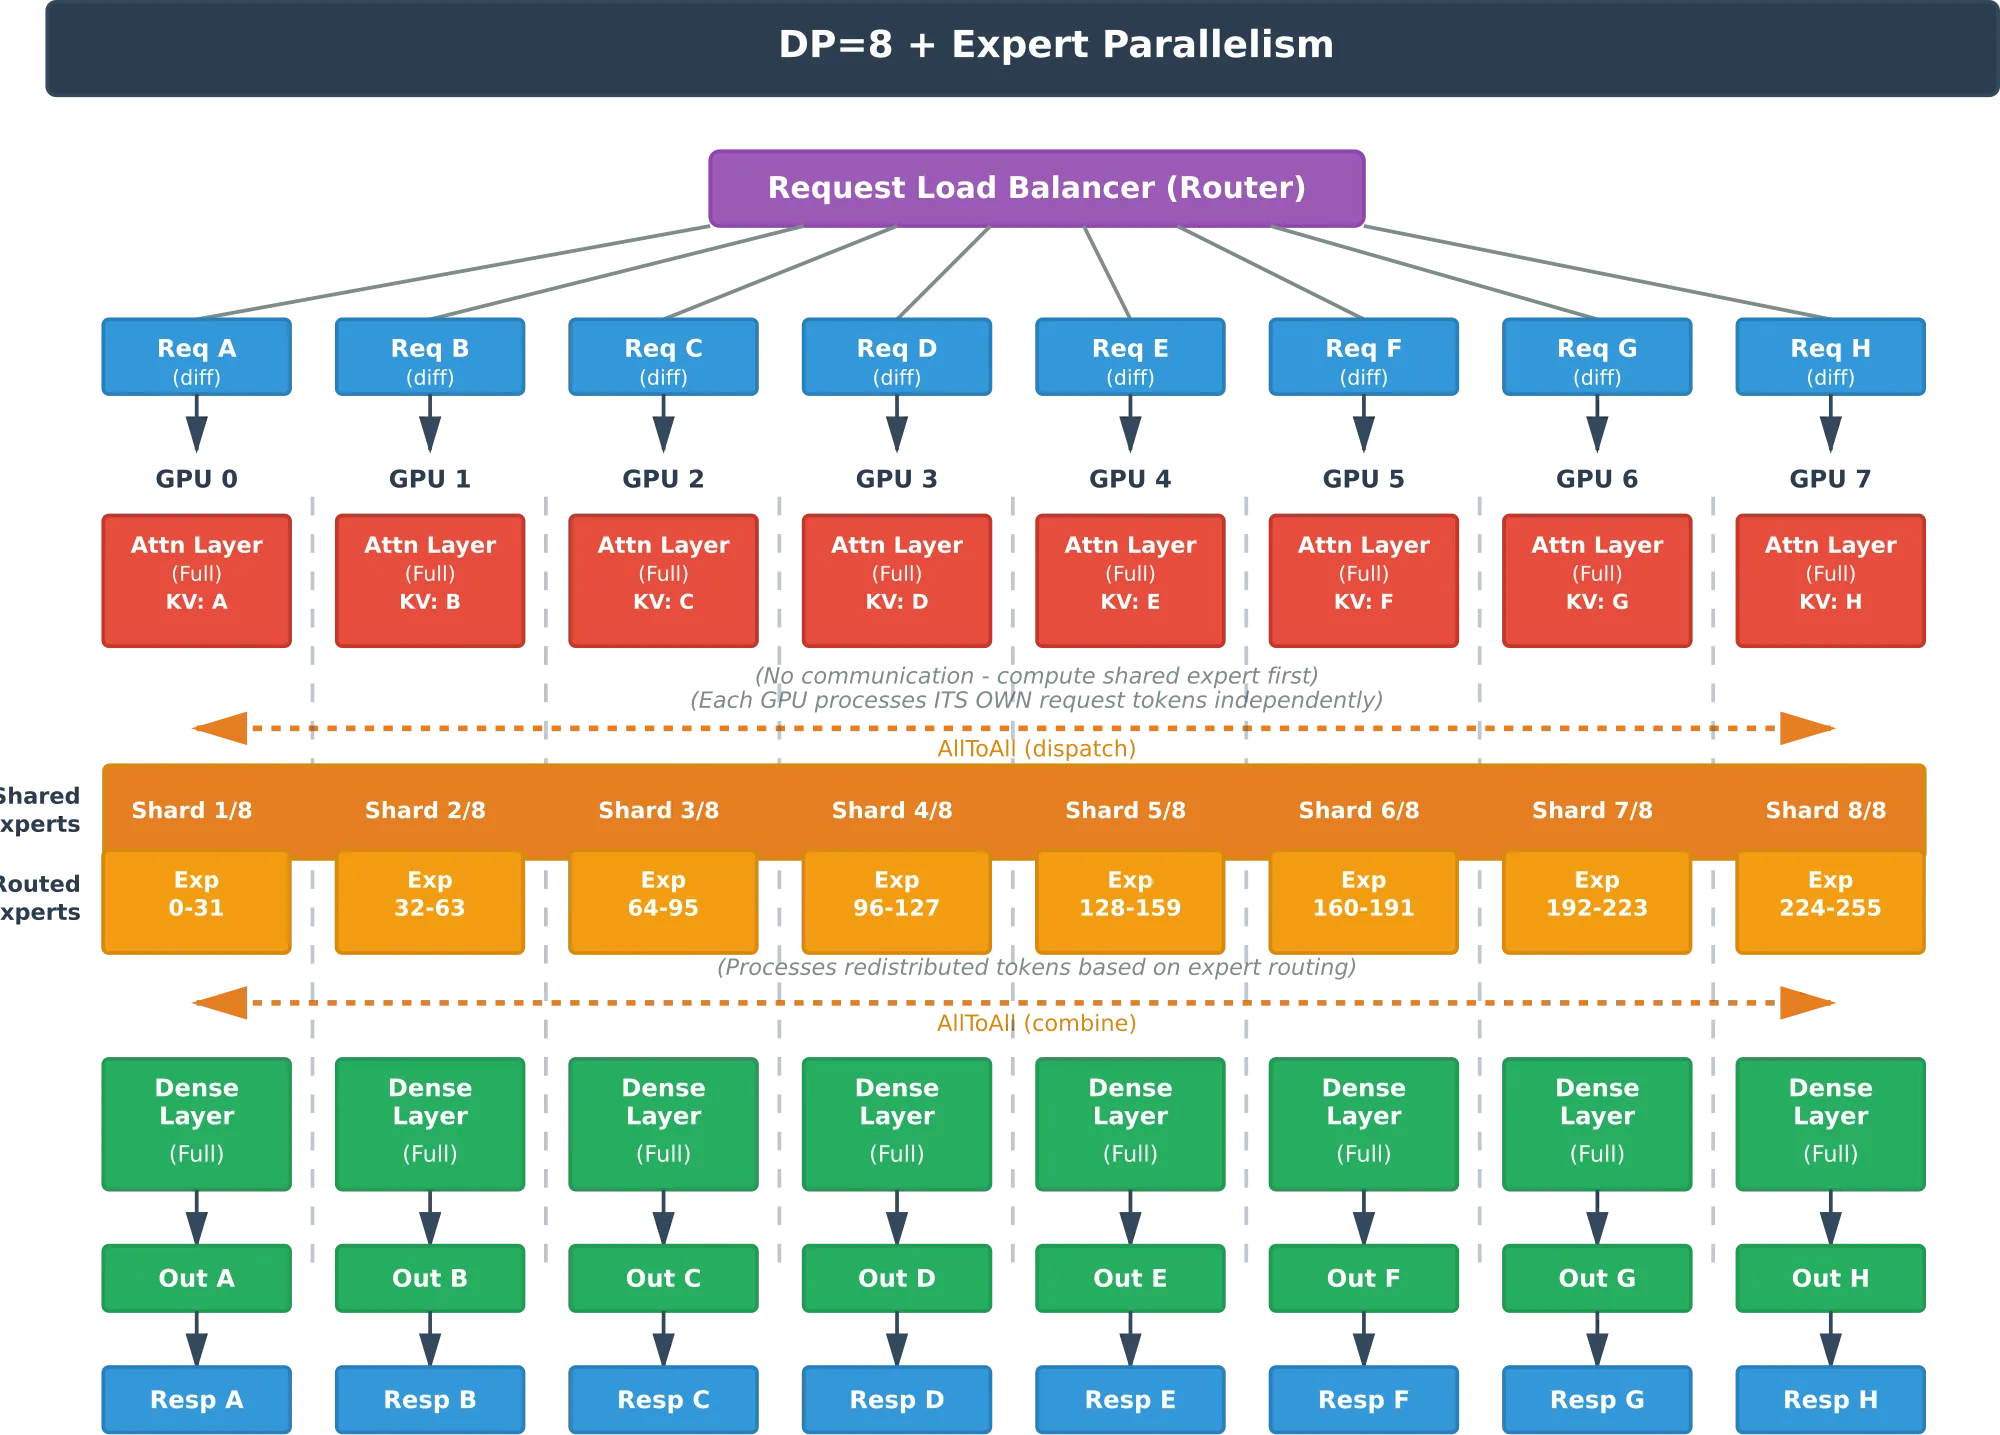
(图源:AMD ROCm vLLM MoE Playbook 中的 DP + EP 部署示意。这张图解释了为什么“DP 复制注意力”与“EP 切分专家”可以同时成立:两者切的是不同的东西,通信只发生在 MoE 层的 token 搬运上。)
建组:ParallelProcessGroup 的四次 rearrange
所有并行轴最终都落到进程组上。DeepInfer 的建组代码在 parallel_utils/parallel_state.py,核心只有一个函数 create_process_groups。它先按 world_size 开出一串全局 rank,然后用四次 rearrange 把它们切成四类组。
全局 rank 的编号规则
进程组的 rank 不是随便排的。worker/base.py 里写得很清楚:
self.dp_rank = parallel_config.data_parallel_rank # engine_rank % dp_sizeself.global_rank = parallel_config.engine_rank * parallel_config.context_parallel_size + cp_rank而 config.py 里 data_parallel_rank = engine_rank % data_parallel_size。把两者合起来看,全局 rank 的布局是:
也就是先排 DP、再排副本、最内层排 CP。用 einops 的记号就是 (replica dp cp):CP 是内层,DP 是中层,replica 是外层。选这个顺序不是随意的:同一个 CP 组内的 rank 必须落在同一台机器、同一个 NVLink/scale-up 域里,因为 CP 的 all-gather 每层都会发生;而 DP 副本之间本来就没有逐层通信,放在外层最安全。
四类组的切法
ranks = torch.arange(max(enp_size, dp_size * cp_size))
# World:全部 rank 一个组self.world = _split_group([ranks.tolist()], ...)
# Local:每个 rank 自成一组self.local = _split_group(ranks.unsqueeze(-1).tolist(), ...)
# DP 组:固定 (replica, cp),沿 dp 维建组dp_ranks = rearrange(ranks, "(replica dp cp) -> (replica cp) dp", dp=dp_size, cp=cp_size)
# CP 组:固定 (dp),沿 cp 维建组cp_ranks = rearrange(ranks, "(dp cp) -> dp cp", cp=cp_size)
# EP 组:连续的 ep_size 个 rankep_ranks = rearrange(ranks, "(edp ep) -> edp ep", ep=ep_size)
# ENP 组:固定 replica,沿 enp 维建组enp_ranks = rearrange(ranks, "(replica enp) -> replica enp", enp=enp_size)
# EP-in-DP:同样是连续 ep_size 个 rankep_in_dp_ranks = rearrange(ranks, "(edp ep_in_dp) -> edp ep_in_dp", ep_in_dp=ep_size)逐个解读:
DP 组。
对某个固定的 CP rank 来说,DP 组成员是 rank 间隔为 cp_size 的一组 rank。DP 组只用于控制面(后面第“集合通信账本”一节会看到),不参与逐层前向。
CP 组。 (dp cp) -> dp cp 的切法让 CP 组是所有相邻的 cp_size 个 rank。结合全局 rank 公式,这正好是同一个 engine 内部的 cp_size 个 worker:一个引擎进程加若干 worker-cp{n} 子进程。llm_engine.py 的 _init_workers 印证了这一点:driver 占 local_rank=0,其余 CP worker 用 cp_rank % ngpus 作为本机 GPU 号——一个引擎覆盖 cp_size 张卡,而 DP/EP 的并行度来自“有多少个引擎”。
EP 组。 (edp ep) -> edp ep 是最朴素的做法:把全局 rank 按 ep_size 连续分段,每一段是一个 EP 组。这意味着:
- 默认
cp_size = 1时,一个 EP 组恰好就是一个引擎的全部 rank,EP 组和“实例”重合。 cp_size > 1时,一个引擎内的cp_size个 rank 仍然在同一个 EP 组里,每个 rank 切走physical / EP个专家。- 当
ep_size小于world_size而dp_size = world_size时,多个相邻的 DP rank 也会被划进同一个 EP 组——这正是benchmark.py直接令ep_size = world_size、dp_size = ep_size // cp_size的原因:在这种写法下,所有 rank 同属一个 EP 组,DP 组退化为“每个 rank 自己”。
这一步是理解“EP 组和 DP 组是两套不同切法”的关键:DP 组沿 cp_size 为步长跨 rank 取,EP 组沿连续区间取。 生产上官方取 #DP = #EP,两者是同一个 rank 集合,只是两种视角;一旦两者不等,两组就交叉,代码允许这种配置,但部署文档说明 prefill 的 EP/DP 总是成对给出。
ENP 组。 切法与 DP 相同,只是步长换了。world_size = max(DP×CP, ENP),所以当 ENP > DP×CP 时,world_size 会比“模型副本数 × CP”更大,多出来的 rank 只用来分 Engram 表。
一个容易被忽略的初始化细节:子组必须“预热”一次
init_device_groups 的 docstring 写了一句很典型的工程注释:默认进程组改成 CPU/gloo 后端之后,NCCL/HCCL 子组失去 eager 初始化,全部变成 lazy——“必须先跑一次 collective 才会真正建 comm”。
for value in self.__dict__.values(): if not isinstance(value, ProcessGroup) or dist.get_backend(value) not in ("nccl", "hccl"): continue ... dist.all_reduce(torch.zeros(1).cuda(), group=value)注释还特别点明:单 rank 组也不能跳过,因为 Engram 的 DeepEP 会通过 backend._comm_ptr() 复用这里建出的 communicator,空指针会导致段错误。这类细节不写进文章很容易被当成废话,但它恰好说明 DeepInfer 的通信层是“薄封装 + 直接触碰 NCCL 内部状态”的风格——nccl_memory.py 会直接遍历 c10d._world.pg_map 并读取每个组的 memory_stats()["total"],定期打印每个 communicator 占用的显存。
CP 组顺带开了一条 gloo 通道
self.cpu_dp_group = _split_group(dp_ranks.tolist(), backend="gloo")self.cpu_cp_group = _split_group(cp_ranks.tolist(), backend="gloo")...if cp_size > 1: self.mq = MessageQueue.create_from_process_group(self.cpu_cp_group, 1 << 20, 10)CP 组额外建了一条 CPU 侧的 MessageQueue(1 MB 缓冲、10 个队列),用于 cp_broadcast_object:CP 内 driver 把 Python 对象(比如 InputMetadata 里的非张量字段、调用名和 kwargs)广播给其余 worker。为什么不用 NCCL?因为 NCCL 只能传张量,而 broadcast_tensor_dict 需要同时传“字典的结构信息”——它把张量元数据(dtype、size)和普通 Python 值经共享内存广播,再对张量本身做 dist.broadcast。这种“结构走 CPU、数据走 GPU”的拆分在任何支持 CP 的框架里都会出现,DeepInfer 的实现是把它收进一个 MessageQueue。
Wide-EP:专家在 64 个 rank 上怎么分、怎么算
DP Attention 解决了“注意力放哪”的问题,剩下的大头是专家。DeepInfer 的 MoE 容器 FusedExperts 一开头就把三个计数口径写进了 docstring:
logical = cfg.moe.n_routed_experts 门控可选的路由专家范围extra = cfg.moe.n_redundant_experts EPLB 写的冗余副本physical = logical + extra 实际分配的专家槽位总数local = physical // ep_size 本 rank 持有的专家数这四个词要分清,否则后面很多数字会对不上。
从 384 到 448:冗余专家不是“额外加几个”
V4.1-Flash 的 n_routed_experts=384,num_experts_per_tok=6。如果 EP=64,直接除不尽:384 / 64 = 6,其实整除;但 EPLB 还要加冗余副本。model_loader._configure_moe_redundancy 调用 resolve_num_extra_experts:
padding = -(num_routed_experts + min_num_extra_experts) % ep_sizereturn min_num_extra_experts + padding假设冗余下限是 1(decode 的官方起点是“每 GPU 1 个冗余专家”,取整后总数可被 EP 整除):
padding = -(384 + 1) % 64 = 63extra = 1 + 63 = 64physical = 384 + 64 = 448local = 448 / 64 = 7所以官方 Q&A 说 EP64 下“每 GPU 7 个专家(不含共享专家)”。“每 GPU 1 个冗余”不是一个固定的小数目,而是一个下限:当 logical + min 不能被 EP 整除时,resolve_num_extra_experts 会把冗余数补齐到下一个整除点——EP64 时补到 64,EP8 时则刚好补到 8。在这个模型上 384 恰好能被常见 EP 整除,于是补齐后的冗余数也落在 EP 的整数倍上,每个 rank 拿到的物理槽位数量完全一致——这是后面 grouped GEMM 能按 physical / EP 等分的前提。EP 越小,physical/EP 越大,每卡要扛的专家越多,这正是 Wide-EP 的反面。
参数容器:expert-major 的打包矩阵
FusedExperts 里每个 rank 只建自己的专家:
self.ep_group = PG.expert_parallel_group()self.ep_size = self.ep_group.size()self.n_local_routed_experts = self.n_routed_experts // self.ep_sizeself.linear1 = ParallelRoutedLinear( cfg.hidden_size, self.hidden_dim * 2, self.n_local_routed_experts, ...)self.linear2 = ParallelRoutedLinear( self.hidden_dim, cfg.hidden_size, self.n_local_routed_experts, ...)ParallelRoutedLinear 的 docstring 说得很清楚:形状是 (n_local_experts * h_in, h_out),也就是把多个专家的 gate/up 权重沿输入维拼成一个大矩阵,供 grouped GEMM 一次处理。运行时 process_moe_weight 再把它重排成 [E, K, N]:
deepinfer_w = src_w.view(n_experts, -1, src_w.shape[1]).mT.contiguous().mT 交换最后两维,让权重按 [expert, in, out] 排列。DeepGEMM 的 grouped GEMM 用连续布局(contiguous layout)按专家分段,配合每个专家的 token 数前缀和 psum_num_recv_tokens_per_expert,一次 kernel 把所有本地专家的矩阵乘做完。
共享专家和门控则是复制的:
self.shared_gate_up_proj = _replicated_linear(shared_expert.linear1.weight)self.shared_down_proj = _replicated_linear(shared_expert.linear2.weight)self.gate = ReplicatedLinear(..., weight=moe_module.gate.Wgate.weight)共享专家只有 1 个,参数量小,复制到每个 rank 反而省掉一次通信;门控必须看到全部 384 个逻辑专家才能做 top-k,也天然是复制的。“哪些参数复制、哪些参数切分”不是拍脑袋,而是由“这个参数是否需要全局视图”决定的:门控需要全局专家分数,所以复制;路由专家只需本地计算,所以切分。
前向的两条路径:标准 DeepEP 与 MegaMoE
DeepseekMoE.__init__ 里有一个条件决定走哪条路:
self.use_mega_moe = ( (PLATFORM.is_gpu or self.mma_type == "fp8xfp4") and self.mma_type in ("fp8xfp4", "fp8xfp8", "bf16xbf16") and PG.is_within_nvl_domain(PG.expert_parallel_group()))is_within_nvl_domain 的判断是:
if PLATFORM.is_npu: return Truereturn group.size() == 1 or group.size() <= deep_ep.get_physical_domain_size(group)[1]也就是说,MegaMoE 只在 EP 组整体落在同一个 NVLink/scale-up 物理域内时才启用。EP64 跨节点时,组会超出单机 NVLink 域,只能走标准路径:
- dispatch:
self.ep_buffer.dispatch(...)把每个 token 的 hidden state 按 top-k 路由发到目标专家所在 rank,同时把 top-k 权重和 EPLB 统计一起带过去;use_fp8_dispatch让传输用 FP8,do_expand=True让接收端直接展开成按专家分组的 token 块。 - 本地 grouped GEMM:gate/up → SwiGLU → down,三段都在本地专家上完成。
- combine:
self.ep_buffer.combine(...)把各专家的输出按原路送回,聚合 top-k 结果;bias=shared_hidden_states意味着共享专家的结果可以在 combine 时顺带加进去,少一次独立 kernel。
MegaMoE 则把 gate、dispatch、grouped GEMM、combine 融进一个 deep_gemm.fp8_fp4_mega_moe kernel,用对称内存(deep_gemm.SymmBuffer)做 rank 间数据交换。官方 Q&A 的口径是:在 scale-up 域内,无论 EP 大小与 batch 大小,Mega MoE 都明显快于未融合版本。代价是它要求 EP 组不跨域,所以 Wide-EP 跨节点时仍然得回到 DeepEP 的两段式。
Wide-EP 为什么能提高 decode 的 TPS
decode 是权重带宽受限的:每步只处理很少的 token,但要把激活到的专家权重从 HBM 读一遍。每个 rank 每层读的专家权重大约是:
其中 是每个权重元素的字节数(FP4 为 0.5), 是本 rank 上真正被路由到的专家数。EP 越大, 越小;同时每个本地专家分到的 token 越多,grouped GEMM 的算术强度越高。用 V4.1-Flash 的数字粗算:
- EP64:每 rank 7 个专家,单专家约 17.7 MB,一层最多读约 124 MB;
- EP8:若沿用同样的最小冗余口径,每 rank 49 个专家,一层最多读约 867 MB;生产 prefill 会额外加冗余专家,实际数字更高。
两者相差约 7 倍。这就是 Wide-EP 在 decode 阶段的核心收益:把“每卡读全部激活专家”变成“每卡只读一小撮专家”,同时把每个专家的 batch 做大。代价是 dispatch/combine 的跨节点流量,以及所有 rank 必须同步参与每一层 all-to-all——这两点分别由 DeepEP 的高吞吐 kernel 和下一节的 DP lockstep 机制来处理。
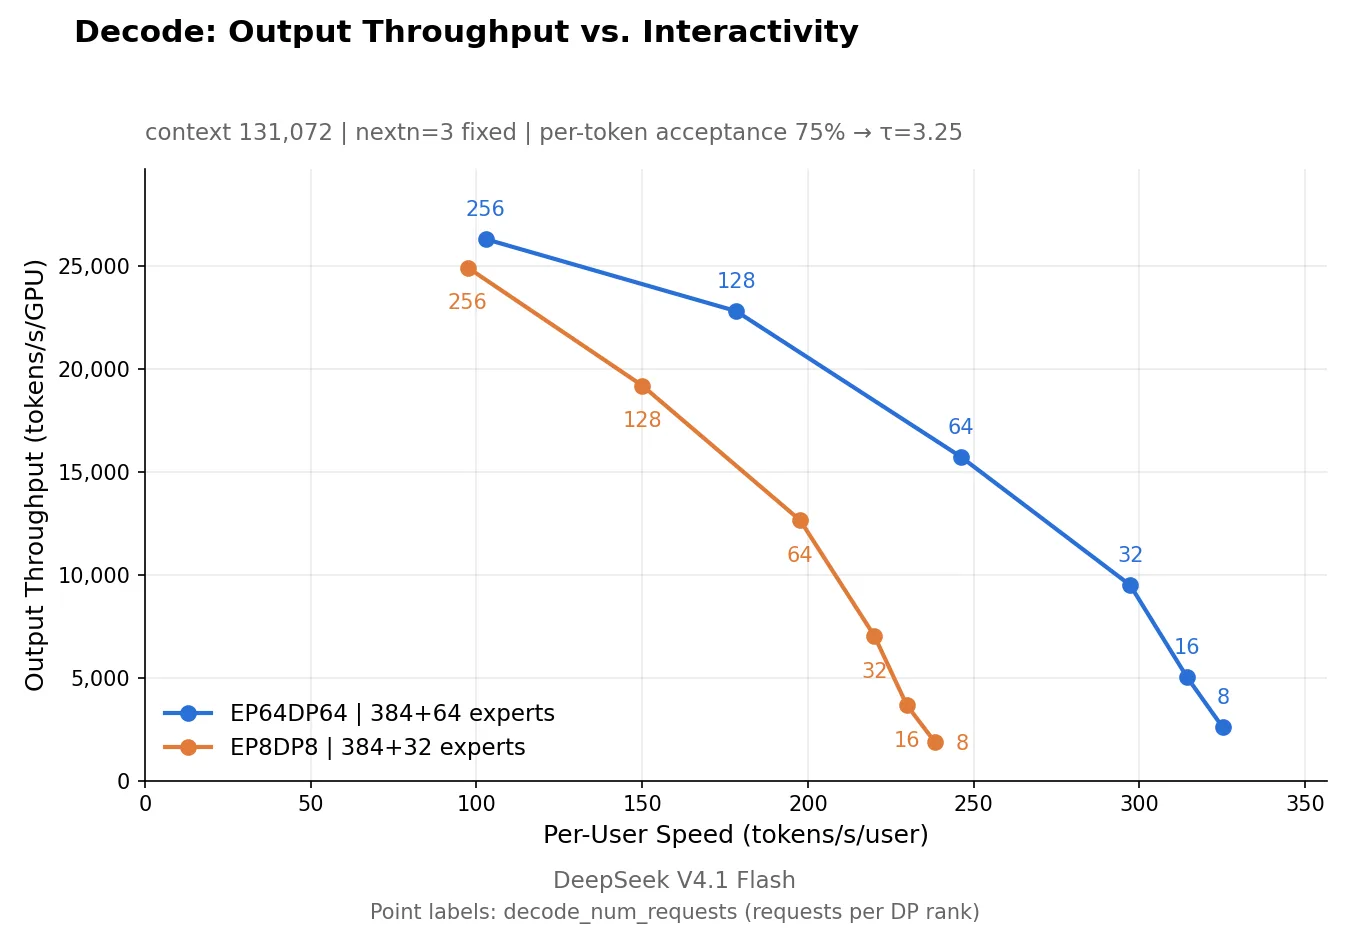
(图源:DeepInfer 官方仓库 doc/images/wide_ep_decode_pareto.png。横轴是每 rank 的并发序列数,纵轴是吞吐;EP64 的曲线整体上移,说明同样的显存与延迟预算下,把专家摊到更多 rank 上能换到更高的 token 吞吐。)
DP Attention:64 个引擎如何保持同一步
Wide-EP 要求所有 rank 一起完成每层 all-to-all,但请求是分散到各个 DP rank 上的。一个 rank 分到的请求少、另一个分到的多,如果各自按自己的节奏跑,EP 组就会在某个 all-to-all 上永远等不齐。DeepInfer 的 DP 侧设计围绕“让所有引擎始终处在同一步”展开。
每个 DP rank 是一个完整引擎
llm_engine.py 的 _init_workers 只在一个引擎内部拉起 cp_size 个 worker:
for cp_rank in range(1, cp_size): worker = SpawnProcessWithCrashHeader(... name=f"worker-cp{cp_rank}", ...) worker.start()self.driver_worker = Worker(..., local_rank=0, cp_rank=0, ..., True)cp_size=1 时没有子进程,driver worker 就是这张卡上唯一的执行体。每个引擎有自己的 Scheduler、BlockManager、CacheEngine 与 KV 池;请求由外部的负载均衡器分派进来,引擎之间不共享调度队列。ParallelProcessGroup 里的 DP 组因此只承担两件事:控制面的存活对齐和调度器的 prefill 投票。
存活对齐:一条 all_reduce(MAX)
LLMEngine.has_unfinished_requests 是入口循环判断“还要不要继续 step”的地方:
unfinished = self.scheduler.has_unfinished_seqs()if dp_group.size() > 1: unfinished = torch.full((1,), unfinished, dtype=torch.int64, device=device) dist.all_reduce(unfinished, op=dist.ReduceOp.MAX, group=dp_group) unfinished = unfinished.item() > 0只要任何一个 DP rank 还有未完成请求,所有 rank 都继续 step。ZOS 开启时这条 all_reduce 走 CPU 的 gloo 组(cpu_data_parallel_group),避免在 GPU 流上插一个同步点;非 ZOS 时走 NCCL 组。一个 int64 的 MAX all_reduce 数据量可以忽略,它的作用是把“谁先退出”变成一个全局一致的决定。
空步不是空转:placeholder step
如果某个 rank 这一步没有请求,调度器会返回空的 SchedulerOutputs。这时 worker 仍然要跑一次前向,只是用一个占位序列代替真实批次:
if is_placeholder: seq_metadata_list = [self.model_runner._placeholder_seq_metadata(is_prompt)]为什么必须跑?因为 EP 组的 all-to-all 是集合操作,任何一个 rank 不调用,其他 rank 就会卡死。占位序列的 token 会被路由到某些专家、产生一次真实的 dispatch/combine,保证通信图完整;它的输出随后被丢弃。这个设计在数据并行 + 专家并行的系统里是必需的,代价是空步也要付一次前向与通信的钱。也正因如此,请求负载均衡(尽量让每个 rank 都有活)不是锦上添花,而是直接影响吞吐。
调度器里的 DP 投票
LLMEngine._create_scheduler 把 DP 组传给了 C++ 调度器:
return Scheduler( ..., PG.cpu_data_parallel_group() if envs.DEEPINFER_ZERO_OVERHEAD_SCHEDULING else PG.data_parallel_group(), self.scheduler_config, ...)SchedulerConfig 里有两个与 DP 相关的间隔:
prefill_attempt_interval:NORMAL 引擎每隔多少个 decode step 尝试一次 prefill,采用 ALL 投票——所有 rank 都有活才一起做 prefill;prefill_any_attempt_interval:ANY 保底投票——任一 rank 有活就集体 prefill,防止某个 rank 的 prefill 请求被长期饿死。
为什么 prefill 要投票?因为一次 prefill 步的 token 数远大于 decode,如果各 rank 随意插入 prefill,EP 组的 batch 形状会频繁抖动,通信与 GEMM 的负载也会失衡。把“要不要在这一步做 prefill”提升为组级决策,是用一点调度灵活性换整组步调的稳定。
负载均衡在引擎之外
引擎内部不做跨 DP 的路由。官方 Q&A 描述了外层的两个均衡器:Prefill Load Balancer 按上下文长度把请求分成 <16K / 16–64K / 64–256K / ≥256K 四档,每档按上一轮的计算配额需求动态分配引擎数量;Decode Load Balancer 则在所有 decode GPU 上按“请求数”和“KV 总长度”两个维度做均衡。这样做的前提是 KV Cache 不绑定在单机上——DeepSeek 把块级 KV 放进了 3FS 存储集群,任何 prefill 机器都能命中任意前缀,因此不需要前缀亲和路由。本站拆过的 DeepSeek 3FS 与 DualPath 分别讲了这条存储路径与解码侧 KV 读取优化,可以和本节对照看。
CP:存在但不启用的第五条轴
前面几节都在讲 DP 与 EP。但 parallel_utils 里还有一整套上下文并行的实现:CPManager、prepare_cp_mirror、cp_broadcast_object、cp_broadcast_multi_tensor,attn.py 里也到处是 use_cp = ... and PG.context_parallel_group().size() > 1 的判断。这部分代码不是遗留物,它在 prefill 路径上是完整可用的。
为什么需要 CP,为什么生产没用
长 prompt 的 prefill 是计算密集型,一张卡算得太慢。CP 把一条序列的 token 沿序列维切给多个 rank,每个 rank 只算自己那段 query,但 attention 仍然需要看到完整的 K/V。标准的做法是在 attention 内部做一次 all-gather,把各 rank 的 K/V 拼成完整序列,再算局部 query 对全局 key 的注意力。
DeepInfer 当前的官方选择是先不用 CP,原因是部署层面的:CP 会把一个引擎的 KV、调度与元数据布局都变成“分段”的,而 Wide-EP 已经把 decode 侧的问题用专家切分解决了;prefill 侧的长上下文压力则交给 Prefill Load Balancer 按长度分档来处理。代码保留 CP,意味着将来模型更大、单卡 prefill 真正成为瓶颈时,可以打开它。
建组与缓冲区
CP 组是引擎内部的 cp_size 个相邻 rank。缓冲区由 userbuffer.allocate_cp 分配:
max_ag_bytes_per_session = max_num_tokens * max_ag_bytes_per_token * cp_group.size()max_ag_bytes_per_session += max_num_ags_per_session * deep_ep.get_num_rdma_alignment()max_num_tokens 取的是 max_num_prefilling_tokens,而后者在 finalize_model_config 里被除以了 CP 大小:
model_cfg.gpt.max_num_prefilling_tokens = model_cfg.gpt.max_num_batched_tokens // PG.context_parallel_group().size()也就是说,开 CP 后每个 rank 的 prefill token 预算是总预算的 1/CP,缓冲按“本 rank token 数 × 每 token 每 rank 字节数 × CP”估出一次 gather 的大小。max_ag_bytes_per_token 由模型侧逐层累加得出:V4AttentionBase.get_max_ag_bytes_per_token 加上 SWA 的 qk 维、投影 KV 维、索引器 K 维等,最后取所有层的最大值。max_num_ags_per_session = 8 则允许一次 session 里同时发起多条 gather(模型首尾各一条、注意力若干条)。
zigzag 切分:每段从哪开始
CP 的核心是一个索引预处理 kernel prepare_cp_mirror。它接收每条的 query 长度与 key 长度,算出三样东西:
mirror_cp_index:本 rank 要处理的 token 在原 varlen 批里的位置,长度cp_mirror_len,-1表示 padding;mirror_cp_reverse_index:逆映射,把 gather 回来的完整序列还原成原始顺序;- 每个压缩率下的
ks/ke:Attention 的 K 范围,考虑 KV 压缩后 key 的数量变化。
纯 Python 参考实现把“zigzag”讲得很直白:
ps = (sq + 2 * cp_size - 1) // (2 * cp_size) # 每条序列沿 2*cp_size 个块均分for rank in range(cp_size): for half, block in enumerate((rank, 2 * cp_size - 1 - rank)): for j in range(ps): local_idx = ps * block + j一条长度为 的序列被切成 块( 是 CP 大小),rank 拿走第 块和第 块。也就是 rank 0 拿“最前一段 + 最后一段”,rank 1 拿“第二段 + 倒数第二段”,依此类推。之所以不用“连续切段”,是因为因果注意力下 rank 0 只算最早那段 query,却要等所有 rank 的 K;zigzag 让每个 rank 同时持有序列的头尾,各 rank 的 key 覆盖范围更接近、负载更均衡。这和 Ring-Attention 里按块轮转的做法是同一个思路的变体。
ks / ke 的计算则处理压缩 KV:对压缩率 ,本 rank 处理第 段 query 时,需要看的 key 数量是
也就是说,压缩 KV 的窗口随 query 在序列中的位置增长,再按压缩率折算成压缩条目数。这样 attention kernel 不需要知道 CP 的存在,只拿到一个“本段 query 对应的 key 区间”。
前向里的三处 gather
打开 CP 后,HFModel.forward 在两个位置各做一次 all-gather:
if input_metadata.is_prompt and PG.context_parallel_group().size() > 1: input_metadata.prepare_for_mirror_cp() hidden_states = gather(hidden_states, input_metadata.mirror_cp_index)
...
if input_metadata.is_prompt and PG.context_parallel_group().size() > 1: with userbuffer.cp_session(): gathered_hidden_states = userbuffer.cp.all_gather(hidden_states)() hidden_states = gather(gathered_hidden_states, input_metadata.mirror_cp_reverse_index)入口处把本 rank 的 token 重排进 mirror 布局(每段的 token 拼在一起),跑完 40 层后再 gather 一次、按逆映射切回本 rank 的 token。之所以“进出各 gather、中间不切”,是为了让每层都只算本 rank 的 query——如果每层都重新切分,通信次数会乘以层数。
中间还有一处:注意力里的 KV all-gather。V4AttentionBase 的 prefill 分支:
with userbuffer.cp_session(enabled=use_cp): wait_projected_kv = _make_cp_gather_getter(projected_kv, use_cp) if not yoco_full_kv_stored else None q_a, kv_swa = self._project_q_and_swa(hidden_states, shared_hidden_bf16) ...注意 projected_kv 的 gather 在 Q 投影之前发起,等待放在后面真正用到 KV 的时候。这是 CP 路径上最典型的重叠手法:all-gather 在通信流上异步进行,GPU 同时在计算本 rank 的 Q 投影、SWA KV 与索引器,等到要组装完整 KV 时再 wait()。prepare_cp_mirror 的测试用例覆盖了 cp_size ∈ {2,4,8}、随机长度、含 padding 的序列,参考实现逐元素对照,这部分逻辑的正确性是有回归保护的。
CPManager.all_gather 的返回值是一个闭包而不是张量:
handle = self._buffer.all_gather(x)return lambda: handle.wait().view(gathered_shape).flatten(0, 1)调用方拿到它之后可以先去干别的,等需要数据了再调用。这种“发起即返回、等待即取值”的接口,是 DeepEP 异步通信 API 的惯用形态,本站在 DeepEP 完全拆解 里讲过 EventOverlap 的那一套。
解包后的重新切分
gather 回来的 KV 是“按 rank 拼接”的顺序,而 attention 需要的是按序列顺序的完整序列。所以 attn.py 会用 mirror_cp_reverse_index 再 gather 一次——这里的 gather 是 TileLang 实现的按索引重排(不是集合通信),把 [rank][block] 布局还原成 [token] 布局。mirror_cp_reverse_index 的第 项记录了“原始位置 的 token 在 gather 结果里的位置”,包括 padding 的位置,所以输出张量按它的形状分配,填充行会在后续被 mask 掉。
ENP:Engram 表为什么有自己的并行轴
Engram 是 DeepSeek 提出的“条件记忆”机制,用哈希 N-gram 查表给模型补上一级稀疏记忆。本站 Engram 完全拆解 讲过其原理,这里只看它的并行方式。
V4.1-Flash 的配置里有两个 Engram 层(engram_layer_ids = [1, 14]),每层的表大小是 engram_num_embeddings = [384006168, 384016682]——单层就有近 4 亿行,每行 256 维(engram_head_dim)。如果每个 DP rank 都复制整张表,显存直接爆炸。
DeepInfer 的切法在 NgramEmbeddingParameters:
alignment = math.lcm(256, engram_parallel_size)num_embeddings = sum(self.head_vocab_sizes)padded_rows = (num_embeddings + alignment - 1) // alignment * alignmentself.num_per_part = padded_rows // engram_parallel_sizerow_start = engram_parallel_rank * self.num_per_part按行平均切分,并且把总行数向上对齐到 lcm(256, ENP),保证每个 rank 的行数相同、地址对齐。查询时,每个 token 的 N-gram 哈希落在哪个 rank 上是不确定的,所以不能像专家并行那样“路由到本地”。DeepInfer 用一个 EngramBuffer(DeepEP 提供的对称内存 + RDMA 取数)来搬:
hashes = tile_kernels.engram.engram_hash(...)ngram_embed_hooks = self.engram_runtime.fetch(hashes)fetch 返回的是“按哈希异步取回 embedding”的钩子,模型前向时通过 embed_hook() 拿到结果。fetch 在模型最外层、所有层之前发起——这是有意的:哈希只依赖 token id,不依赖前几层的结果,可以比模型前向早得多地开始取数,把远程访问藏在前向计算下面。这也是 Engram 相比动态专家并行的关键优势之一:确定性寻址、可预取。
EngramBuffer 的存储可以在 CPU 内存 + RDMA 上(use_cpu_rdma_storage = not envs.DEEPINFER_ENGRAM_FORCE_GPU_STORAGE),把 4 亿行的表放在 GPU 显存里显然不现实。EP 组与 ENP 组的关系是:ENP 默认等于 DP × CP(每个模型副本的 rank 数),但在大 EP decode 下,表的行数可以跨到比一个引擎更多或更少的 rank 上——world_size = max(DP×CP, ENP) 的公式就是为这个准备的。
集合通信账本:一次 decode step 到底通信几次
把前面几节的内容汇成一张账本,对比 DeepInfer 与常见 TP 布局在一个 decode step 内的集合通信次数( 为层数, 为 MoE 层数):
| 通信点 | DeepInfer(DP + Wide-EP,无 CP) | 典型 TP + EP 布局 |
|---|---|---|
| 每层 attention 输出 all-reduce | 无 | 1 次 × |
| 每层 MLP 输出 all-reduce | 无 | 1 次 × (稠密层) |
| 每层 MoE dispatch + combine | 2 次 × (All-to-All) | 2 次 × |
| 步首/步尾的 DP 存活对齐 | 1 次 all_reduce(MAX)(CPU gloo 或 GPU) | 通常由外部负载均衡器处理 |
| 参数加载期 | KV 块数 world all-reduce;NCCL 组预热 all-reduce | 同 |
两条结论:
- 在 dense 路径上,DeepInfer 的通信次数是 0。 V4.1-Flash 的 40 层每层都有 MoE,但 attention、门控、共享专家、输出投影都是复制的,不存在逐层规约。对 decode 这种每步只有几十个 token 的负载,这省下的不是带宽,而是每层两次全局同步的延迟。
- MoE 的通信是“按 token 与路由”的,不是“按层激活”的。 dispatch 只搬被路由到的 hidden state(每 token 6 个专家 × 5120 维),combine 搬回来并顺带加共享专家。Wide-EP 让 层的通信量不变、但每卡的计算量和权重读取大幅下降,这两者的比值(通信/计算比)需要 DeepEP 的高吞吐 kernel 和异步重叠来控制。
MegaMoE 那条路径把 dispatch、GEMM、combine 融成一个 kernel,通信与计算在同一 kernel 内靠 SymmBuffer 做 rank 间交换,CPU 侧看不到独立的通信 kernel;nccl_memory.py 定期打印的“每个 communicator 的显存占用”则是用来诊断多组通信带来的额外显存。
CP 打开后账本会变:模型首尾各一次 all-gather、每层 attention 内部 1–3 次 KV all-gather。以 40 层计,CP 的通信次数与 TP 相当,甚至更多;这也是它不适合 decode 的原因——decode 的每步 token 少,gather 的固定延迟会被放大。CP 只对 prefill 有意义。
和其他框架对照
与 vLLM
vLLM 的并行以 TP 为核心:ColumnParallelLinear / RowParallelLinear 是默认线性层,tensor_parallel_size 是主要参数,DP 与 EP 是在 TP 之上叠加的。DeepInfer 的 ReplicatedLinear 正好相反——所有线性层都复制,注意力不切分;专家切分从第一天就是 MoE 实现的主体。这不是能力差距,而是模型形态决定的:DeepSeek 的模型参数绝大部分在专家里,TP 切注意力几乎不省显存。
读者可以对照本站的 vLLM 源码完全拆解(十一):张量并行与 Worker 看 TP 的一整套实现:权重切分、all-reduce、Executor 广播。DeepInfer 恰好是把那篇里的大部分机制省掉之后的形态。
与 SGLang
SGLang 的 DP Attention 与 DeepInfer 的思路一致:注意力按 DP 复制、MoE 按 EP 切分,用 deep_ep 做 dispatch/combine。差异在于 SGLang 仍然支持 TP,并在 DP Attention 模式下要把各 rank 的 hidden state 做 gather/scatter 来保证注意力的一致性;DeepInfer 不做 TP,DP rank 之间的注意力完全独立,唯一的同步是存活对齐与 prefill 投票。本站的 SGLang 源码完全拆解(十七):DP Attention 与专家并行 可以拿来逐项对照。
与 TensorRT-LLM
TensorRT-LLM 的 Mapping 是一个显式的多维 rank 坐标系(tp、pp、cp、dp、ep 各自一组),DeviceMesh 在此基础上建组,Communicator 提供自定义集合通信原语。DeepInfer 没有这种通用坐标系,它直接按“DP/CP/EP/ENP”四次 rearrange 建组,并用一个 ParallelProcessGroup 对象持有全部组。灵活度不如 TensorRT-LLM,但因为只服务一个模型,拓扑是固定的,省掉了坐标系带来的抽象层。相关实现见本站 TensorRT-LLM 源码完全拆解(十一):并行拓扑与通信。
三者的共同点
三个框架都收敛到同一个结论:大 MoE 模型推理的瓶颈在专家权重带宽,因此 EP 越大越好;注意力的跨卡同步则是纯开销,能不做就不做。 vLLM 通过 DP Attention、SGLang 通过 DP Attention、DeepInfer 通过“不做 TP”,走的是同一条路线,只是起点的默认值不同。
注意力的并行空间在哪里:o_groups 与“结构上开的口子”
按 8 个输出组切,而不是按头切
前面的账只说明了“不做 TP 更好”,但没有说清楚 V4.1-Flash 的注意力参数是否本身就预留了并行空间——如果某个参数天然只能被整体复制,那么 TP 缺失就是结构决定的,而非选择。V4.1-Flash 的公开配置给出了一组值得琢磨的数字:num_attention_heads=64、head_dim=512、o_groups=8、o_lora_rank=1024、q_lora_rank=1280、kv_lora_rank 在公开 config 里没有直接出现。
o_groups=8 是其中最值得注意的一项:它把 64 个 query 头分成 8 组、每组 8 个头,mla_attn.py 的容器构造先断言“头数能被组数整除”,再把每个组的 Value 投影输入拼在一起:
self.n_wv_group = cfg.o_groupsassert self.n_head % self.n_wv_group == 0self.o_head_dim = cfg.o_lora_rank or self.v_head_dim # V4.1-Flash 中为 1024mid_dim = self.n_wv_group * self.o_head_dim # 8 * 1024 = 8192wv_in_features = (self.kv_lora_rank + self.rope_head_dim) * (self.n_head // self.n_wv_group)self.Wv = ReplicatedLinear(wv_in_features, mid_dim, bias=False, use_fp8_gemm=True)两处细节值得展开。第一,Wv 的输入宽度是“组内头数 ×(KV latent 维 + rope 维)”,说明 8 个组是沿输出维度拼接的,而不是沿输入维度切分——所有组看到的是同一份压缩 KV。第二,每组经 Wv 得到 o_head_dim = 1024 宽的低秩表示,8 组拼起来是 8192 宽,再由 out_proj 投回 hidden_size = 5120;运行时侧 wv_group_dim = (num_heads // n_wv_group) * qk_head_dim = 8 × 512 = 4096 则是每组 Value 在低秩投影之前的宽度。Wv 与 out_proj 在容器里都是 ReplicatedLinear,没有按组切到不同 rank 上。
从张量并行的角度看,8 个输出组确实是一个天然的切分维度:把组切到不同 rank 上,每组只做本组 Value 的低秩投影,最后对 out_proj 的输入做一次聚合,就能把输出侧的计算摊开而不必按 query 头切分。
DeepInfer 当前没有这么做,原因不难推:每个 rank 的注意力仍然要看到全部 query 头去算 q·k,输出组切分只能省掉输出投影那一小段计算,收益有限,却会引入一层跨 rank 聚合。这组参数说明的是“如果要在这里做注意力 TP,入口是输出组而不是头”,而不是“现在已经在做”。out_proj 的输入已经按组展平成 n_wv_group * o_head_dim,它同样是一个 ReplicatedLinear——在 DeepInfer 里,连这层“天然可切”的投影也选择了复制,和前面的账保持一致。读这类配置时,区分“结构上开出的口子”和“部署上实际使用的切法”,比单看参数名更有价值。
流水并行:代码里没有,部署里要防
Pipeline Parallelism(PP)在 DeepInfer 的 ParallelConfig 里同样不存在,层不会跨机器切。但部署 Q&A 里有一条相关约束:decode 的最小高效部署单元是 EP64 以上,即“64 卡 prefill + 64 卡 decode”;跨数据中心拆分 P 与 D 在技术上可行,代价是可靠性,预算约为每 8 个 GPU 400 Gbps 互联带宽。这说明 DeepInfer 把“跨机器”全部留给了 P/D 分离与 KV 传输,不在单个模型实例内部做层切分——一个实例内部只用 scale-up 互联(NVLink),跨机器的部分一律走 KV Cache 的搬运。这是“引擎只服务一个模型”的又一处体现:模型实例的拓扑被固定在单节点或单超节点内。
读这份拓扑代码时容易踩的坑
model_parallel_size是 CP,不是 TP。config.py里这个名字很容易误导,看到它出现在world_size公式里,先确认它等于context_parallel_size。- EP 组是连续区间,DP 组是步长为 CP 的间隔。 当
#DP ≠ #EP时两组交叉,别用“EP 组就是实例”的直觉去推。 resolve_num_extra_experts的返回值会被向上取整。 “每 GPU 1 个冗余专家”在 EP64 下是 64 个物理冗余,不是 1 个。- MegaMoE 的条件是“EP 组不跨 NVLink 域”。 跨节点 Wide-EP 走的是 DeepEP 两段式,性能结论不能直接套用到 MegaMoE。
- placeholder step 是正确性要求,不是优化。 少跑一个 rank 的 all-to-all,整个 EP 组会挂住。
- CP 只在 prefill 生效。
llm_engine.py里context_parallel_size > 1时断言引擎类型不能是COMPLETION;decode 永远走 full 布局。
小结
把前十几篇的内容按层归位,DeepInfer 的机制大致可以分成三圈:内圈是算子层与 TileLang kernel(第七篇、第十一篇),决定单个 kernel 的效率;中圈是执行层,负责把调度计划变成 GPU 前向、并处理 KV 的内存账(第三篇到第十一篇);外圈才是本篇讲的并行拓扑——哪几个 rank 组成一个引擎、一个引擎与谁交换 token 与 KV。本文的结论可以精简成这么几行:
- 没有 TP 不是遗漏,而是取舍。 dense 路径上零逐层 all-reduce,attention 复制到每个 DP rank,专家按 EP 切分。
- Wide-EP 的收益来自“每卡只读一小撮专家”,通信只发生在 MoE 层,且只搬运被路由到的 token。
- DP 侧的同步被压到最少:一条存活对齐的 all-reduce、调度器里的 prefill 投票、以及保证集合通信完整性的 placeholder step。
- CP 是一套完整但暂不启用的实现,只有在 prefill 才允许打开;
o_groups=8是如果要在这里做注意力并行时天然可用的切分口子。
DeepInfer 的并行拓扑可以用一句话概括:不带张量并行的 DP Attention + Wide-EP。
- 注意力权重复制到每个 DP rank,省掉了每层两次 all-reduce;MoE 专家按 EP 切分,把权重带宽从“每卡读全部激活专家”降到“每卡读一小撮专家”。
ParallelProcessGroup用四次 rearrange 建出 DP、CP、EP、ENP 四类组,全局 rank 按(replica dp cp)排列,CP 在最内层,保证同机通信。- DP 侧的同步只有一条
all_reduce(MAX)的存活对齐和调度器里的 prefill 投票;空 rank 用 placeholder step 跟上 EP 组的步调。 - CP 是一套完整但暂不启用的实现:zigzag 切分、
prepare_cp_mirror索引 kernel、首尾与注意力内部的 all-gather,全部走 DeepEP 的异步接口,可以在需要时打开。 - ENP 把近 4 亿行的 Engram 表按行切开,靠按哈希的远程取数来查表,并在前向开始前预取。
下一篇会把视线从“rank 之间怎么分工”挪到“rank 内部怎么把计算流组织起来”:DeepInfer 的 attention 与 MoE 如何在 CUDA 流上重叠、DeepEP 的异步事件如何与计算流交错,以及这些重叠在 ZOS 延后一拍的框架下如何与调度器配合。
参考资料
- DeepInfer 官方仓库(deepseek-ai/DeepInfer)
- DeepInfer 部署 Q&A:DeepSeek V4.1 Flash Inference Deployment Q&A
- DeepSeek-V3 / R1 推理系统概览(知乎官方文章)
- DeepEP 官方仓库(MoE 专家并行通信库)
- DeepGEMM 官方仓库(FP8 GEMM 与 grouped GEMM)
- Megatron-LM: Training Multi-Billion Parameter Language Models Using Model Parallelism
- SGLang 官方仓库(DP Attention 与 EPLB)
- TensorRT-LLM 官方仓库
- DeepSeek-V4.1-Flash 模型卡与 config.json(Hugging Face)
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



