


llama.cpp 源码完全拆解(七):后端与 Kernel——mmq、flash-attn 与 CPU 指令集特化如何把图跑成算力
引言:图建好了,接下来交给谁
前六篇把 llama.cpp 从外到内拆了一遍:第一篇画了整体地图,第二篇讲 ggml 的计算图与内存分配器,第三篇讲 GGUF 与权重装载,第四篇讲 llama_context 与 KV 记忆系统,第五篇讲采样与语法约束,第六篇讲 llama-graph 如何把模型结构翻译成 ggml 图。到这里,一张 ggml_cgraph 已经建好——每个节点是一个算子,每个张量都知道自己的形状、类型和所在缓冲区。
但图本身不会跑。ggml_backend_sched 把图切开、分配好内存之后,真正的计算发生在各个后端的 graph_compute 里:ggml-cuda/ 目录下的 CUDA kernel、ggml-cpu/ 下的 SIMD 与 repack 内核、以及 Vulkan/Metal/SYCL 等其他后端各自的实现。这一篇要回答四个问题:
- 一个后端到底要实现什么——
ggml_backend_i/ggml_backend_device_i/ggml_backend_buffer_type_i三组接口各自负责什么,为什么要把「设备」和「执行流」拆开; - CUDA 后端如何组织计算——设备初始化、显存池、kernel 启动包装、
ggml_cuda_op_*分发表,以及一次graph_compute里算子如何被逐个派发; - 量化矩阵乘为什么是 llama.cpp 性能的核心——
mul_mat_q(MMQ)如何用q8_1中间格式、SRAM 分块和__dp4a/MMA 指令直接啃量化权重,mul_mat_vec_q(MMVQ)为什么在解码场景取代前者,以及每个 GPU 架构一套的mmq-config-*.cuh在调什么; - 注意力与其后的调度器——
fattn-*系列如何按头维、精度与批大小分派内核,CPU 侧的 ARM/AVX 指令集特化与repack权重重排如何把内存带宽吃干榨净,以及ggml_backend_sched在跨后端执行时付出的拷贝代价。
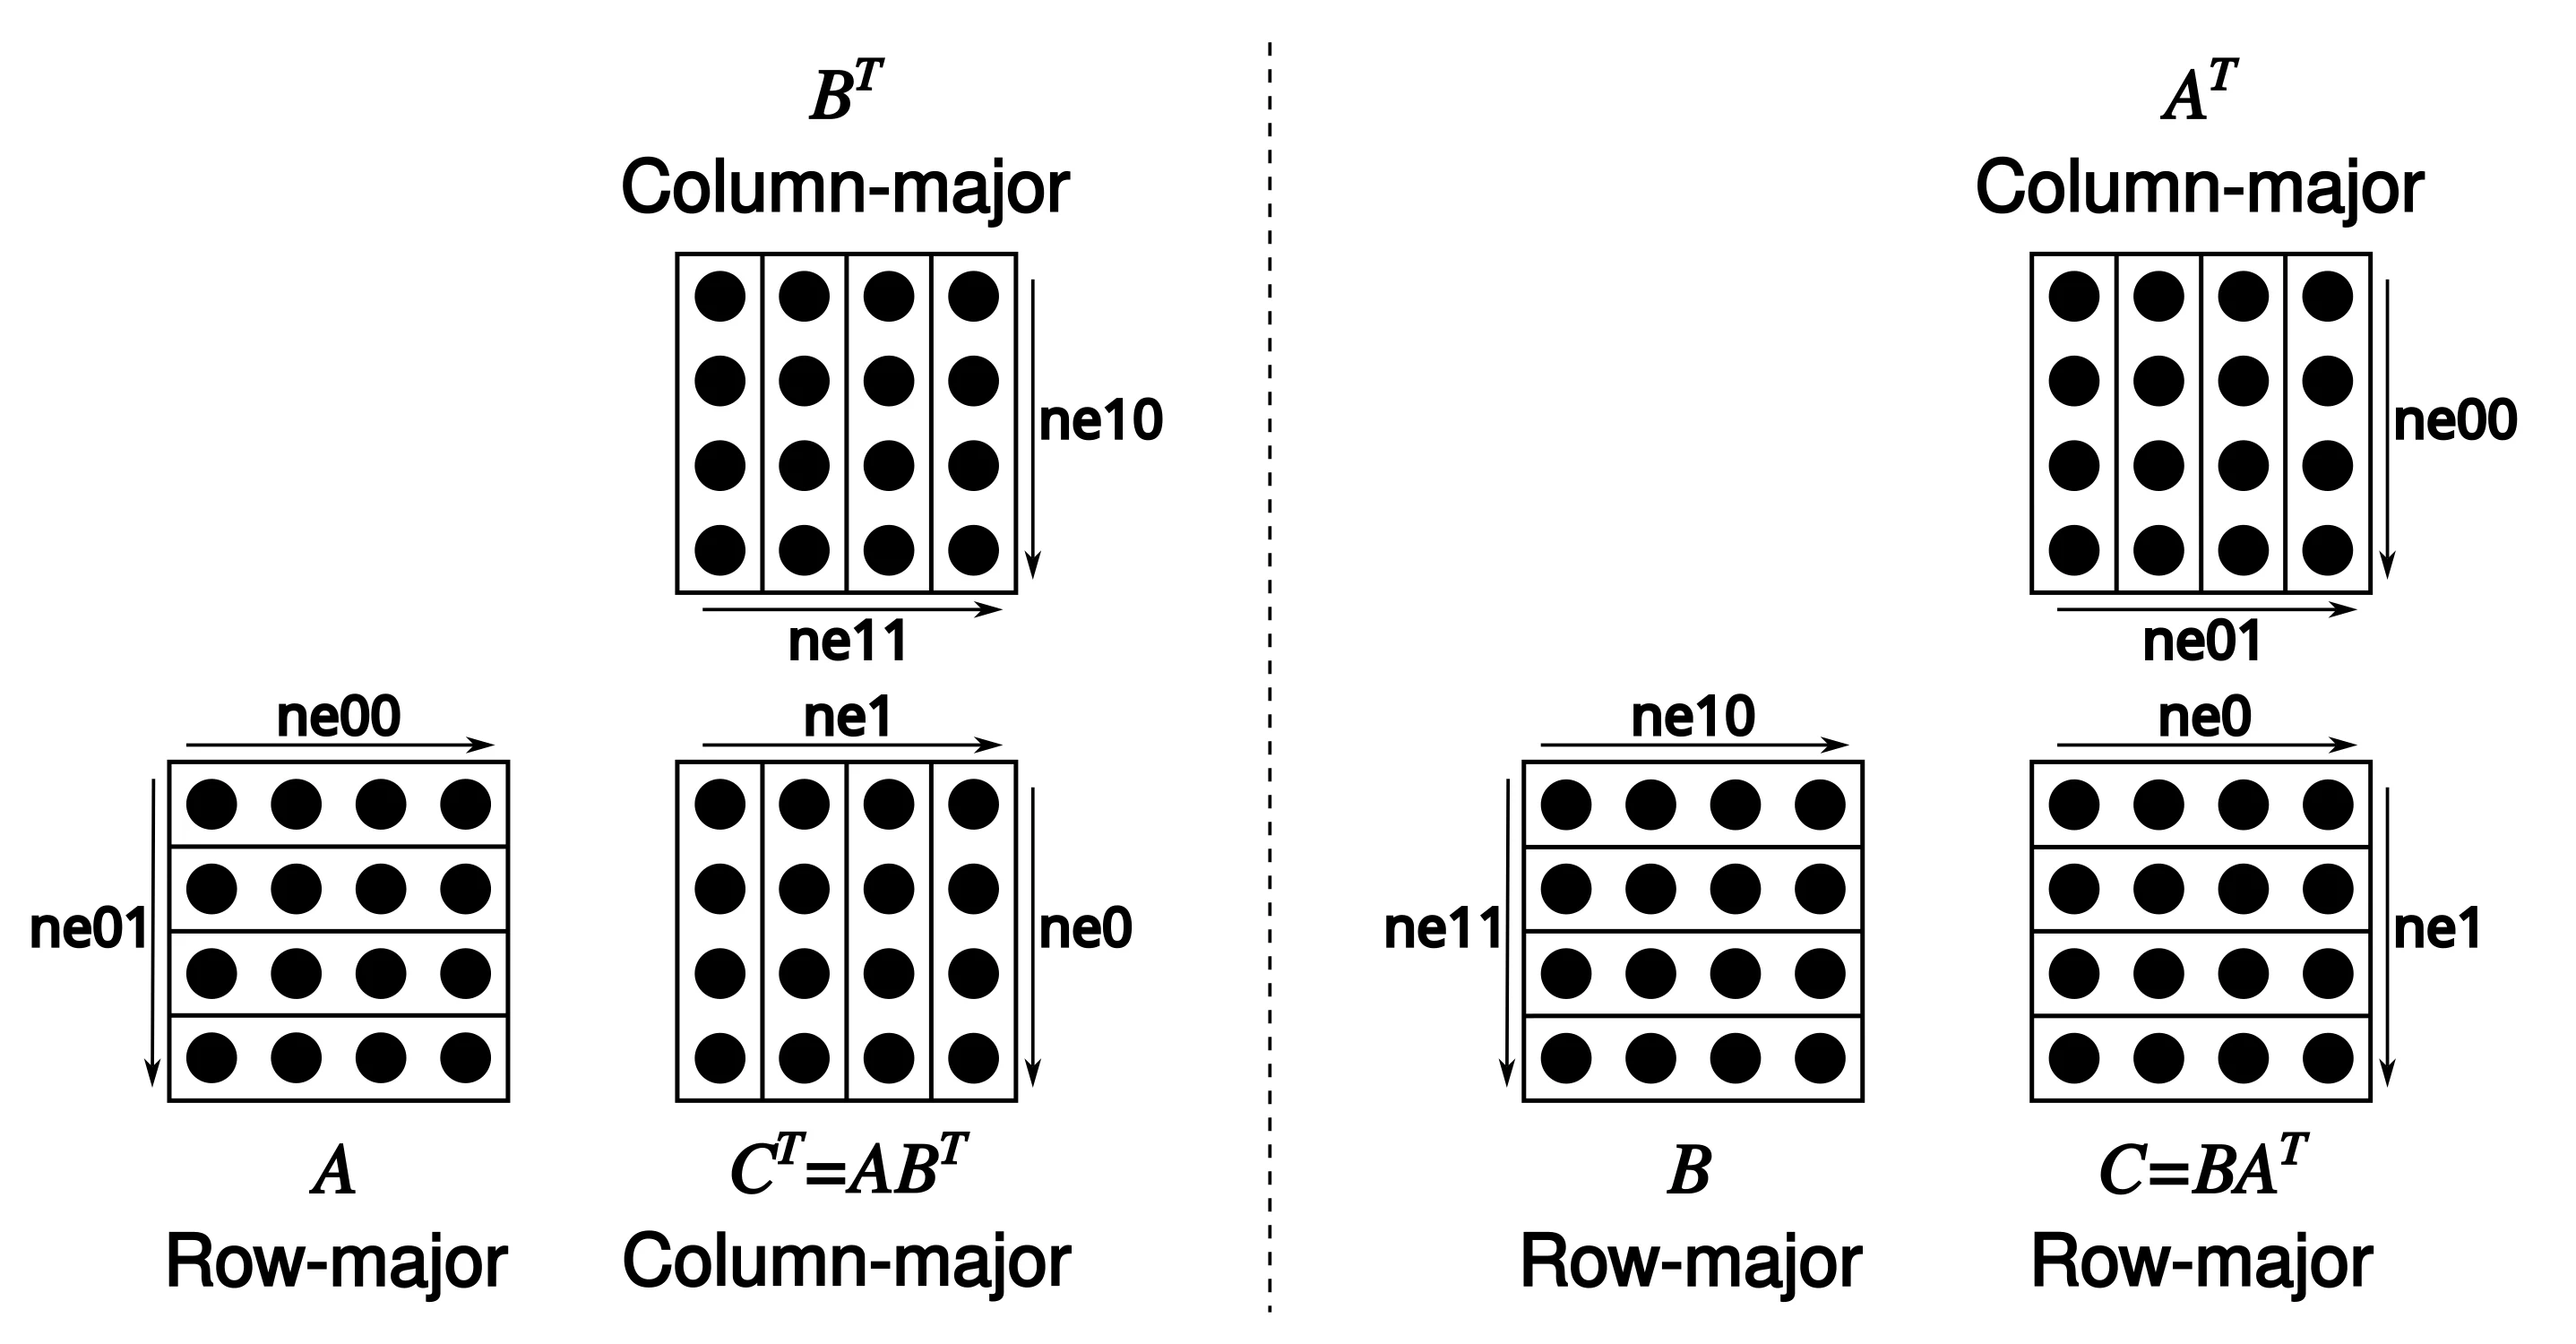
上图是 llama.cpp 官方仓库里的矩阵乘布局示意,它画的是 ggml 视角下的 mul_mat 语义:src0(权重)与 src1(激活)沿着哪几个维度对齐、结果 dst 的形状如何确定。本篇后面讲的所有优化——SRAM 分块、q8_1 中间格式、repack 交错——都是为了让这两个矩阵在这个布局约束下少搬字节、多算乘加。图片来源:llama.cpp 仓库 media/matmul.png。
后端契约:一个后端到底要实现什么
ggml-backend.h 与 ggml-backend-impl.h 定义了三层抽象:设备(device)、执行流(backend)、缓冲区类型(buffer type)。这三层是理解后面所有执行行为的前提,值得先把接口逐条看清楚。
设备:物理资源与能力声明
ggml_backend_device_i 描述「一块能算东西的硬件」的能力,关键函数有:
get_memory(dev, &free, &total):报告显存/内存占用,llama.cpp 用它决定模型能否装下、KV 缓存能开多大;init_backend(dev, params):为一个设备创建一个执行流,也就是ggml_backend_t。同一个设备可以有多个 backend(例如多个 CUDA stream),但通常一个设备一个;get_buffer_type(dev):该设备的首选缓冲区类型,CUDA 设备返回显存缓冲区类型,CPU 返回普通内存缓冲区类型;get_host_buffer_type(dev):可选的主机固定内存(pinned memory)缓冲区类型,用于跨设备拷贝与 mmap 模型;buffer_from_host_ptr(dev, ptr, size, max_tensor_size):从一段宿主内存指针直接建缓冲区。这一条是第三篇讲的 mmap 装载能在 CUDA 上成立的关键——文件映射进来的字节不搬迁,直接包成设备可读的缓冲区;supports_op(dev, op):这个设备能不能算这个算子。调度器切图时逐节点问它;supports_buft(dev, buft):这个设备能不能直接读写这种缓冲区里的数据。比如 CUDA 设备只能直接读显存缓冲区与(部分)主机固定内存缓冲区,读不了 mmap 出来的普通内存;offload_op(dev, op):可选。有些算子(典型的是大矩阵乘)即使权重在 CPU 内存里,搬到 GPU 上算也比留在 CPU 上算划算——offload_op就是给这种情况开的后门,可以让调度器把节点强制分配给这个设备。
执行流:真正干活的对象
ggml_backend_i 是「执行流」接口,核心只有两件事:
- 数据传输:
set_tensor_async/get_tensor_async及其 2D 版本、还有cpy_tensor_async(src_backend, dst_backend, src, dst)(跨后端异步拷贝)、以及synchronize(等待所有异步操作完成)。注意这些函数名里的 async:后端被约定为「异步执行模型」,调用返回时不保证数据已经就位,跨后端同步交给事件机制; - 图执行:
graph_compute(backend, cgraph)是整个后端层最重要的一行签名。它接收一张切好的子图,在设备上把它算完。注释里写明「always async if supported by the backend」,即允许立刻返回、由事件或synchronize兜底; - 事件:
event_record/event_wait,用来在两条流之间做同步(例如 CUDA 的cudaEventRecord/cudaStreamWaitEvent)。调度器跨设备拷贝时用的就是这两个函数; graph_optimize:新的可选接口,让后端有机会重排图节点。头文件里同时定义了ggml_backend_graph_optimize_params,其中add_alloc_dep(tensor, until)允许后端声明「某个张量必须活到某个节点算完为止」——这是因为有些后端会多流并行执行图的不同部分,内存分配器必须知道哪些张量被异步读取,不能提前复用。
缓冲区类型:内存从哪来
ggml_backend_buffer_type_i 描述「一类可以做张量存储的内存」,它管的是分配而不是计算:
alloc_buffer/alloc_buffer_n:分配一整块缓冲区,后者的_n版本允许一次性为一组张量分配(默认实现退化为普通分配 + 线性分配器);get_alignment:对齐要求;get_alloc_size(可选):为某个张量分配时实际需要的字节数,默认等于ggml_nbytes。这个函数的存在感比看起来强:有些后端的输出张量需要额外空间(例如把中间结果直接算进输出缓冲的「就地」策略,见头文件里TAG_ALLOC_SIZE_EXPAND的注释),ggml_op_alloc_size_may_expand会告诉分配器哪些算子可能超配;is_host:这块缓冲区是不是「宿主内存 + 标准 ggml 布局」。为真时,调度器知道数据可以被 CPU 直接读写、可以用普通 memcpy 搬运,不必绕道设备 API。
一个具体例子能把三层的关系摆清楚:在 CUDA 设备上跑 Q4_K 量化的 Llama 模型,实际会出现至少四种缓冲区类型:
| 缓冲区类型 | 物理内存 | 典型用途 |
|---|---|---|
CUDA 显存缓冲(CUDA0) | 显存 | 权重张量、KV 缓存、中间激活 |
| CUDA 主机缓冲(pinned) | 锁页内存 | 跨设备拷贝的暂存、KV cache 的 host 备份 |
| CPU 缓冲 | 普通内存 | 留在 CPU 上的层、采样与调度数据结构 |
| CPU_REPACK 缓冲 | 普通内存 | CPU 上被重排过的量化权重(第五、六节详述) |
调度器在图执行时做的所有事情,本质上就是决定「每个节点在哪个设备上算、它的输入输出张量各自生活在哪种缓冲区里」——这是第二篇讲过的切图问题,而它能不能切、怎么切,取决于上面三个接口的回答。
ggml-cuda 的全局骨架:设备、显存池与一次前向的派发
设备初始化与能力探查
ggml-cuda.cu 启动时会遍历所有可见 GPU,把每张卡的信息收进一个全局的 ggml_cuda_device_info:
struct ggml_cuda_device_info { int device_count; struct ggml_cuda_device_prop { char name[128]; char description[256]; int cc; // compute capability,如 80 / 89 / 90 / 120 int warp_size; // NVIDIA 恒为 32 int nsm; // SM 数量 int smpbo; // 每 block 可用 shared memory 上限(字节) bool vmm; // 是否支持 CUDA 虚拟内存管理 size_t vmm_granularity; bool integrated; // 是否为核显/集成 GPU ... } devices[GGML_CUDA_MAX_DEVICES];};这里有几个字段后面的内容都会用到:
cc(compute capability):整套 kernel 分派与mmq-config-*.cuh查表的索引键。turing_mma_available(cc)、fp16_mma_hardware_available(cc)、amd_mfma_available(cc)这些宏全部由它推导,决定了走 dp4a 还是走 Tensor Core MMA;smpbo:每个 block 能用的 shared memory 上限。这个数字直接决定 MMQ 能不能启动——代码里有一条硬判据:
// MMQ tiles require at least 48 KiB per-block shared memory; fall back to BLAS otherwise.const size_t smpbo = ggml_cuda_info().devices[id].smpbo;if (smpbo < 48 * 1024) { return false;}换言之,共享内存不足 48 KiB 的设备直接放弃 MMQ,退回 cuBLAS。这是设计约束而不是性能偏好:MMQ 的分块加载需要一块能装下完整权重 tile 的 SRAM,装不下就只能换算法。
-
warp_size:NVIDIA 恒为 32,但在 AMD CDNA 上是 64。所有 kernel 的线程组织都通过ggml_cuda_get_physical_warp_size()间接取值,而不是硬编码 32——这是 llama.cpp 能同时跑 NVIDIA 与 AMD 的关键抽象之一。注意代码里刻意区分了「物理 warp(warp_size)」与WARP_SIZE(模板与布局推导时用的逻辑常数),把两者混用会在 CDNA 上算错 tile 尺寸。 -
vmm(虚拟内存管理):决定用哪个显存池,下面单独讲。
两种显存池:ggml_cuda_pool_leg 与 ggml_cuda_pool_vmm
ggml_cuda.cu 里有两条池实现,由 new_pool_for_device 二选一:
std::unique_ptr<ggml_cuda_pool> ggml_backend_cuda_context::new_pool_for_device(int device, size_t alloc_size_min) { if (ggml_cuda_info().devices[device].vmm) { return std::unique_ptr<ggml_cuda_pool>(new ggml_cuda_pool_vmm(device)); } return std::unique_ptr<ggml_cuda_pool>(new ggml_cuda_pool_leg(device));}ggml_cuda_pool_leg:传统做法。用cudaMalloc申请一块较大的虚拟地址区间,自己维护一个按大小分桶的空闲链表,alloc(size)就在链表里找一个足够大的块切出去——本质上是一个自己的 malloc,目的是避免每次算子都调用cudaMalloc(那是同步操作,会打断异步流水线)。它的问题是内存碎片与「池只增不减」:一旦某个大块因为一次超大分配而被撑开,之后不会再还给驱动。ggml_cuda_pool_vmm:借助cuMemCreate/cuMemMap的虚拟内存管理 API,把物理显存页映射到一段虚拟地址上。好处是分配粒度可控(vmm_granularity)、可以按页释放、地址空间连续而物理页离散。对推理来说最实际的价值是减少显存碎片:在长时间服务的进程里,反复申请释放不同尺寸的中间张量很容易把显存打成筛子,VMM 能把它按固定粒度切齐。
池的分配结果通过 ggml_cuda_pool_alloc<T> 这个 RAII 包装使用,析构时自动归还。MMQ 的一次调用里就能看到好几处:src1_q8_1(量化后的激活)、ids_src1/ids_dst/expert_bounds(MoE 的索引辅助数组)、tmp_fixup(stream-K 的归约暂存)都从池里要——这些都是每次调用都可能变尺寸的临时缓冲,池化收益最大。
一次前向的派发:从 graph_compute 到 ggml_cuda_op_*
后端的入口是 ggml_backend_cuda_graph_compute。它的骨架比想象中短:
static enum ggml_status ggml_backend_cuda_graph_compute(ggml_backend_t backend, ggml_cgraph * cgraph) { ggml_backend_cuda_context * cuda_ctx = (ggml_backend_cuda_context *) backend->context; ggml_cuda_set_device(cuda_ctx->device);
// ... 决定是否启用 CUDA Graph(warmup 判定,见下节)...
ggml_cuda_graph_evaluate_and_capture(cuda_ctx, cgraph, use_cuda_graph, cuda_graph_update_required, graph_key); return GGML_STATUS_SUCCESS;}真正的执行在 ggml_cuda_graph_evaluate_and_capture 的节点循环里:它按拓扑序遍历子图的每个节点,先把节点映射到具体的 ggml_cuda_op_* 函数,再启动 kernel。映射方式是一张基于 op 与张量类型的 switch:GGML_OP_MUL_MAT 走 ggml_cuda_mul_mat,GGML_OP_MUL_MAT_ID 走 ggml_cuda_mul_mat_id,GGML_OP_FLASH_ATTN_EXT 走 ggml_cuda_flash_attn_ext,GGML_OP_RMS_NORM 走 ggml_cuda_op_rms_norm,GGML_OP_ROPE 走 ggml_cuda_op_rope,以此类推。
这个循环里还有一个值得单独讲的机制:多流并发执行(concurrent events)。ggml_cuda_stream_context 里维护一张 concurrent_events 表,记录「从哪个节点开始、在几条额外流上并行执行到哪个节点」。执行时主循环遇到 fork 节点就 cudaEventRecord 记一个事件,让第 1..N 条流 cudaStreamWaitEvent 等它,随后几条流并行跑各自的子段——这正是 ggml_backend_graph_optimize_params::add_alloc_dep 要解决的问题:并行的分支会让某些张量的生命周期超出「按拓扑序算完就释放」的假设,内存分配器必须被告知「这个张量得活到某个汇合节点」。这个机制服务于 MoE 里「不同专家共享/路由分支可以并行」以及 SSM/门控网络的多分支结构。
CUDA Graph:跳过 kernel 启动开销
ggml_backend_cuda_graph_compute 里那段 warmup 判定是 CUDA Graph 能正确生效的关键:
if (!graph->warmup_complete) { // Warmup: need at least 2 calls with no property change on the 2nd call if (!properties_changed) { graph->warmup_complete = true; use_cuda_graph = true; cuda_graph_update_required = true; }} else { if (properties_changed) { graph->warmup_complete = false; // 形状变了,重新 warmup } else { use_cuda_graph = true; cuda_graph_update_required = graph->instance == nullptr; }}三段逻辑各有原因:
- 至少要连续两次调用、且第二次没有属性变化,才认为这个图稳定、可以捕获。一次调用可能是首次预热(cuBLAS handle 初始化、kernel 首次加载),此时捕获进去的运行时状态不具代表性;
graph_key:CUDA Graph 不是一张而是一组,按graph_key = ggml_cuda_graph_get_key(cgraph)索引。不同形状/不同拓扑的图有不同的 key,各捕获各的实例;- 属性变化即回退:
ggml_cuda_graph_update_required检测图的结构性与参数属性有没有变。一旦变了就把warmup_complete打回 false,退回「直接执行」直到重新稳定。这条规则是安全阀——捕获期间若有节点访问了会变化的固定地址(例如指针变了的 KV 缓存),重放就会读错数据。
捕获本身用 cudaStreamBeginCapture(cudaStreamCaptureModeRelaxed) 包住一次正常的 evaluate_and_capture 调用,之后每次直接 cudaGraphLaunch 整图重放。收益主要在解码阶段:小 batch 时单个 kernel 只跑几微秒,而每次 kernel 启动(含参数打包)要几微秒,CPU 侧启动开销占比极高;一张包含几百个节点解码图重放一次,等于把这些启动开销全压掉。这也解释了为什么 llama.cpp 的 CUDA Graph 只对形状稳定的图有意义——正是第十节讲的「形状分桶」那套思路在 llama.cpp 侧的对应实现。
mul_mat_q:量化矩阵乘为什么需要一套专门的 kernel
问题:mul_mat 是推理里唯一真正吃算力的算子
一次 Transformer 前向里,绝大部分 FLOPs 落在 mul_mat 上:QKV 投影、注意力输出投影、FFN 的 gate/up/down 三个线性层。对量化模型来说,这些 mul_mat 的 src0(权重)是 Q4_K、Q6_K、IQ2_XXS 之类的块量化格式,src1(激活)是 FP32。
不能直接喂给 cuBLAS 的原因是格式不匹配:cuBLAS 只认 FP16/BF16/FP8/INT8 这些标准格式,量化块的位布局(每 32 个权重共享一个 scale、还有 6-bit 的二级量化 scale 之类)它完全不认识。最朴素的做法是「先反量化成 FP16,再调 cuBLAS」,但那样等于把量化带来的显存收益吃掉一半,而且反量化本身要读写一遍完整权重——在解码阶段这是灾难,因为解码根本是带宽受限的。
于是有了 mul_mat_q:直接在量化格式上做矩阵乘的 CUDA kernel。它的核心手段是:
- 把激活
src1从 FP32 量化成 q8_1(8-bit 值 + 每 32 元素一个 FP16 scale); - 把权重的量化块加载进 shared memory,按 tile 组织;
- 用
__dp4a(4 个 int8 的点积,一条指令完成 4 次乘加)或者 Tensor Core 的 MMA 指令做内积。
因为两边都是整数点积、scale 单独累加,整条路径不需要把权重展开成浮点,也不需要把权重完整读进寄存器两遍。
派发顺序:五条路径的优先级
ggml_cuda_mul_mat 是一棵判定树,顺序即优先级:
static void ggml_cuda_mul_mat(ggml_backend_cuda_context & ctx, const ggml_tensor * src0, const ggml_tensor * src1, ggml_tensor * dst) { GGML_TENSOR_BINARY_OP_LOCALS
if (ggml_cuda_op_mul_mat_use_fwht(dst) && ggml_cuda_op_fwht(ctx, src1, dst)) return;
const bool bad_padding_clear = ... ; // src0 是带 padding 的临时缓冲且是视图时,不能安全清零 if (bad_padding_clear || src1->type != GGML_TYPE_F32 || dst->type != GGML_TYPE_F32) { ggml_cuda_mul_mat_cublas(ctx, src0, src1, dst); return; }
if (ggml_cuda_should_use_mmvf(...)) { ggml_cuda_mul_mat_vec_f(ctx, ...); return; } if (/* 转置向量仍可用 MMVQ 的特例 */) { ggml_cuda_mul_mat_vec_f(ctx, ...); return; } if (ggml_cuda_should_use_mmf(...)) { ggml_cuda_mul_mat_f(ctx, ...); return; } if (ggml_cuda_should_use_mmvq(src0->type, cc, ne11)) { ggml_cuda_mul_mat_vec_q(...); return; } if (ggml_cuda_should_use_mmq(src0->type, cc, ne11, 0)) { ggml_cuda_mul_mat_q(...); return; }
ggml_cuda_mul_mat_cublas(ctx, src0, src1, dst); // 兜底}逐条解释为什么是这个顺序:
bad_padding_clear为什么必须让路给 cuBLAS:mul_mat_q与mul_mat_vec_q都会把src0的 padding 清零(因为 tile 加载是无条件下标访问,没有谓词判断,读到的 padding 必须是 0 才能保证结果正确)。但如果src0是临时计算缓冲、且它是另一个张量的视图,清零就会把别人的有效数据抹掉。这种情形只能退回 cuBLAS。mul_mat_vec_f(MMVF):F16 权重的向量版矩阵乘。注释说得很直接——「only faster for GPUs without tensor cores or with a thin src0 matrix (particularly KQV in attention)」。在解码阶段,注意力的 KQV 投影是「瘦矩阵乘胖向量」,MMVF 能吃到这类形状的红利。mul_mat_f(MMF):F16/BF16 矩阵乘内核族(mmf.cuh,925 行),内部用tile<16,8,...>描述 MMA 的 fragment 布局,走 Volta/Turing/AMD WMMA/MFMA 的 Tensor Core 路径,并且支持ids(即mul_mat_id)——也就是说 MoE 的分专家矩阵乘也能走这条统一路径。它出现在 MMVQ 之前,说明在支持 Tensor Core 的设备上,F16 权重优先用 MMA 而不是 dp4a。mul_mat_vec_q(MMVQ,mmvq.cu):量化权重的向量版。它是解码阶段的实际主角,下一小节展开。mul_mat_q(MMQ):量化权重、批量激活(batch 大)时的主力。- cuBLAS 兜底:反量化到 FP16 后交给 cuBLAS。
MMVQ:解码阶段为什么它赢
要理解 MMVQ 的地位,先要看清预填充与解码的形状差异:
| 阶段 | src1(激活)形状 | 算术强度 | 瓶颈 |
|---|---|---|---|
| Prefill | 一次几百到几千个 token | 高 | 算力 |
| Decode | 一次 1 个 token(或几十个) | 极低 | 显存带宽 |
解码时 ne11(激活的列数)就是 batch 大小,常常是 1。此时 mul_mat 退化成矩阵-向量乘:要读完全部权重(例如 7B 的 Q4_K 约 4 GB),只做一遍极少的乘加。读权重的时间决定了延迟,而权重必须从显存读、必须解量化。
MMVQ 针对这个场景的三条设计:
- 每 warp 负责一组输出行,权重按需解量化进寄存器:不做 SRAM 分块(没有复用的必要,反正是向量乘),直接把量化块加载到寄存器里解;
- 不写回中间结果:既然
ncols很小,结果就是一行,直接写出; - 按量化类型特化:
mmvq.cu里有针对 Q4_0/Q4_1/Q5_0/Q5_1/Q8_0/Q2_K…/IQ* 各自的多套实现,以及多种 tile 变体与__dp4a路径。
选它的判据是 ggml_cuda_should_use_mmvq(src0->type, cc, ne11),核心思路是「量化类型受支持 + batch 足够小」。而 MMQ 的判据里有一条专门为分界点写:
#define MMQ_DP4A_MAX_BATCH_SIZE 64 // Max. batch size to use for dp4a MMQ kernels when FP16 tensor cores are available....if (GGML_CUDA_CC_IS_NVIDIA(cc)) { return !fp16_mma_hardware_available(cc) || ne11 < MMQ_DP4A_MAX_BATCH_SIZE;}读法:在没有 FP16 Tensor Core 的老卡上,MMQ 永远可用;在有 Tensor Core 的卡上,只有当 batch 小于 64 时才倾向 MMQ(dp4a 版本)。batch 超过 64 之后,反量化成 FP16 走 Tensor Core 的算力优势开始压过 dp4a。这个 64 是实测出来的经验常数,代码里只留了注释没有推导——这是工程代码的常态:性能分界点来自 benchmark,不来自理论。
MMQ 的 tile 形状与 J 的选择
MMQ 的核心参数是三个方向的 tile 尺寸:
- K 方向:
MMQ_ITER_K = 256个元素(FP4 路径用MMQ_ITER_K_FP4 = 512),这是内层点积一次迭代覆盖的深度; I = 128:SRAM tile 在src0->ne[1]方向的宽度,即每个 block 处理 128 个输出行。Ampere 及以上的配置表里I恒为 128;J:SRAM tile 在src1->ne[1]方向(输出列 / batch)的宽度,从 8 到 128 步进 8 在运行期选择——这就是mmq_args::J_best的来历。
J_best 的选法在 ggml_cuda_mul_mat_q 里,逻辑只有十行但很值得看:
int ntiles_J_best = INT_MAX;for (int J = 8; J <= 128 && ntiles_J_best > 1; J += 8) { const ggml_cuda_mmq_config config = ggml_cuda_mmq_get_config(src0->type, J, fallback, cc, prec_src1); if (config.type == GGML_TYPE_COUNT) continue; // 该量化类型 + 该 J 没有配置,跳过 if (mmq_get_nbytes_shared(config, cc) > smpbo) continue; // SRAM 装不下,跳过 const int ntiles_x = (ncols_opt + config.J - 1) / config.J; if (ntiles_x < ntiles_J_best) { J_best = J; nthreads_best = config.nthreads; ntiles_J_best = ntiles_x; }}三个约束按顺序生效:
- 配置存在性:
ggml_cuda_mmq_get_config(type, J, fallback, cc, prec_src1)在mmq-config-*.cuh的表里查。表里对每个「量化类型 × J」组合给出nthreads、occupancy、I、J、SRAM 布局、K_vram、stream_k、fallback。不是每个组合都有——查不到就返回GGML_TYPE_COUNT,跳过。这张表本身就是 llama.cpp 的调参成果:每个量化类型在每种架构上哪些 J 组合值得试,全是实测出来的。 - SRAM 容量:
mmq_get_nbytes_shared算的是nbs_ids + nbs_x + pad(nbs_y),其中nbs_x是权重 tile 占用、nbs_y = J * sizeof(block_q8_1_mmq)是激活 tile 占用。超过smpbo就跳过这个 J。这解释了为什么 J 不能无脑取 128:激活 tile 随 J 线性增长。 - tile 数量最小化:
ntiles_x = ceil(ncols_opt / J),取能让 tile 数量最少的 J。循环条件ntiles_J_best > 1是提前退出——一旦某个 J 能让整个 batch 塞进一个 tile,就没必要再试更大的 J(tile 数已经是 1,再大只是浪费 SRAM)。
注意 ncols_opt 在 MoE 情形下会被改成 ne12,而在 RDNA3/RDNA4 上更进一步换成「每个专家平均看到的 token 数」(ne12*n_expert_used + ne02 - 1) / ne02——因为分专家之后每个专家的矩阵乘只处理自己那部分 token,按总量选 tile 会选得过大。这个细节很能说明这张表的性质:它不是理论最优,而是逐架构、逐场景调出来的经验配置。
顺带解释 fallback:ggml_cuda_mmq_needs_fallback(nrows_x) 用于行数不是 tile 整数倍的边界情形,此时 kernel 要有越界谓词判断,会影响性能。所以 fallback 是模板参数而不是运行期分支——边界情形用一个稍慢的专用实例,主路径保持无谓词。
block_q8_1_mmq:为什么激活要先量化成 8 位
MMQ 的第一步是把 FP32 激活量化成 q8_1。为此 llama.cpp 专门定义了一个放大版本:
static constexpr int QK8_1_MMQ = 4*QK8_1; // QK8_1 = 32,故 QK8_1_MMQ = 128
struct block_q8_1_mmq { union { struct { ggml_half d; ggml_half s; } GGML_COMMON_AGGR_S; ggml_half2 ds; } GGML_COMMON_AGGR_U; int8_t qs[QK8_1_MMQ]; // 128 个 8-bit 整数};static_assert(sizeof(block_q8_1_mmq) == QK8_1_MMQ + 4*sizeof(half2), "Unexpected block_q8_1_mmq size");static_assert(sizeof(block_q8_1_mmq) == 4*sizeof(block_q8_1), "Unexpected block_q8_1_mmq size");两个 static_assert 把设计意图说清楚了:block_q8_1_mmq 恰好是 4 个标准 block_q8_1 拼起来——128 个 int8 值 + 4 组 (d, s)(QK8_1 = 32、QI8_1 = QK8_1/(4*QR8_1) = 8)。d 是缩放因子,s 是 d * sum(qs[i]) 的预计算和,用于非对称量化的偏移修正。
为什么是 128 而不是 32?因为量化块的行长要和 tile 迭代对齐:MMQ tile 的 K 方向是 MMQ_ITER_K = 256,两个 q8_1_mmq 块正好一轮迭代。同时 128 个 int8 = 32 个 int32,正好是一个 warp 一次能整齐搬运的单位(mmq.cuh 的注释也是这样写的:「block_q8_1_mmq has (128 8-bit ints == 32 32-bit ints + 4 32-bit scales)」)。让字节数与寄存器宽度对齐,是为了后续用 __dp4a 与定宽 memcpy 做批量搬运。
量化激活带来两层收益:
- 带宽:
src1从 4 字节/元素变成 1 字节/元素(外加 scale 摊销),搬运量降到约 1/4; - 指令:整数点积可以用
__dp4a(一条指令算 4 个 int8 乘加),比 FP32 的 FMA 路径吞吐更高。
代价是精度:激活被压到 8 位。llama.cpp 的处理是按块独立量化、保留 per-32 的 scale,并且允许在支持的硬件上提升到原生 FP4 路径(GGML_PREC_Q4,见本节末尾)。per-block scale 的存在让量化误差按块归一化、块内动态范围被压小,这是 8 位激活在实践中精度损失有限的根本原因。
vec_dot 内核:一条 dp4a 路径的完整解剖
MMQ 最内层的计算是 ggml_cuda_mmq_vec_dot_* 函数族(在 mmq-vec-dot.cuh,1237 行)。挑 Q4_0 这条最经典的路径看:
template <ggml_type type, int J, bool fallback>static __device__ __forceinline__ void ggml_cuda_mmq_vec_dot_q4_0_q8_1_dp4a( const int * __restrict__ x, const int * __restrict__ y, float * __restrict__ sum, const int k00) { constexpr int warp_size = ggml_cuda_get_physical_warp_size(); constexpr int nwarps = ggml_cuda_mmq_get_nthreads(type, J, fallback, GGML_PREC_Q8) / warp_size; constexpr int I = ggml_cuda_mmq_get_I(type, J, fallback, GGML_PREC_Q8);
constexpr tile_x_sizes txs = mmq_get_dp4a_tile_x_sizes(GGML_TYPE_Q4_0, I); const int * x_qs = (const int *) x; const float * x_df = (const float *) x_qs + txs.qs; // 权重 tile 里的 scale 区 const int * y_qs = (const int *) y + 4; // 激活 tile:前 4 个 int 是 scale const half2 * y_ds = (const half2 *) y;
for (int k01 = 0; k01 < MMQ_TILE_NE_K; k01 += QR4_0*VDR_Q4_0_Q8_1_MMQ) { const int k0 = k00 + k01;
#pragma unroll for (int j0 = 0; j0 < J; j0 += nwarps) { const int j = j0 + threadIdx.y; #pragma unroll for (int i0 = 0; i0 < I; i0 += warp_size) { const int i = i0 + threadIdx.x; const int kyqs = QI8_1 * ((k01/2) / (QI8_1/2)) + (k01/2) % (QI8_1/2);
int u[2*VDR_Q4_0_Q8_1_MMQ]; int tmp0[4], tmp1[4]; #pragma unroll for (int l0 = 0; l0 < 4 / mcpy_int; ++l0) { ggml_cuda_memcpy_1<max_cpy>(tmp0 + l0*mcpy_int, &y_qs[j*MMQ_TILE_Y_K + kyqs + l0*mcpy_int]); ggml_cuda_memcpy_1<max_cpy>(tmp1 + l0*mcpy_int, &y_qs[j*MMQ_TILE_Y_K + kyqs + QI4_0 + l0*mcpy_int]); } // 把两半 4-bit 交错成 8 个 int,得到连续 layout u[0]=tmp0[0]; u[2]=tmp0[1]; u[4]=tmp0[2]; u[6]=tmp0[3]; u[1]=tmp1[0]; u[3]=tmp1[1]; u[5]=tmp1[2]; u[7]=tmp1[3];
sum[...] += vec_dot_q4_0_q8_1_impl<VDR_Q4_0_Q8_1_MMQ>( &x_qs[i*(MMQ_TILE_NE_K + 1) + k0/QR4_0], u, x_df[i*(MMQ_TILE_NE_K/QI4_0) + i/QI4_0 + k0/(QR4_0*QI4_0)], y_ds[j*MMQ_TILE_Y_K + k01/QI8_1]); } } }}这里有几处设计值得逐条讲:
(1)线程组织是「warp 管行、threadIdx.y 管列」的二维划分。 threadIdx.x 在 [0, warp_size) 上遍历 i(输出行维度,i0 += warp_size),threadIdx.y 在 [0, nwarps) 上遍历 j(batch 列维度,j0 += nwarps)。于是每个线程负责 (I/warp_size) × (J/nwarps) 个「行-列」交点上的内积片段,sum[] 数组按这个划分索引。这个二维划分直接决定了 nthreads = warp_size × nwarps,而 nthreads 正是配置表里的那一列——所以配置表调的其实是「每个 block 用多少 warp、每个 warp 负责多少列」。
(2)u 数组的构造是解包 4-bit 权重的关键。 Q4_0 的 4-bit 值被压在 int32 里(QI4_0 = 8,即一个 int 装 8 个 4-bit)。内积要按 q8_1 的 8 位对齐做,所以代码把「前一半 4-bit」与「后一半 4-bit」分两次 memcpy_1 取出,再交错塞进 u[0..7](偶下标放前半、奇下标放后半)。交错之后,u 就是一个能直接喂 __dp4a 的 int8 数组。这一步是「量化格式适配硬件指令」的缩影:算法上等价,但内存访问模式与寄存器排布被重排成了硬件喜欢的样子。
(3)ggml_cuda_memcpy_1<max_cpy> 而非逐字节读。 max_cpy = ggml_cuda_get_max_cpy_bytes() 取当前架构支持的最大定宽拷贝宽度,一次搬一整块。这是把「已知对齐」这个前提兑换成带宽的手段——tile 在 SRAM 里的布局就是为了保证这种定宽访问是合法的。
(4)x_qs[i*(MMQ_TILE_NE_K + 1) + ...] 里那个 +1 是什么。 它是 padding:K 方向每行多留一个 int 的空间。mmq.cuh 对 padding 有专门说明——tile 加载是无条件下标访问,需要 padding 里的内容确定。这个 +1 既保证换行时地址计算不落到别行,也让对齐得以保持。
(5)scale 的处理:x_df 与 y_ds 分开传。 vec_dot_impl 除了 u 还接收权重的 scale(x_df,含 q4_0 的 delta)、以及激活的 half2 ds(d 与 s = d*sum(qs))。s 预计算的意义在于:非对称 4-bit 的零点修正原本要在每次内积后按 sum 修正,把 sum(qs) 提前算好存进块头,就变成一次乘减。这是「把 per-block 统计量预计算掉、让内积路径只剩乘加」的通用优化,和 FlashAttention 里预计算行和是同一类思想。
(6)shared memory 是运行期动态指定的。 启动写成:
mul_mat_q<type, J, fallback, prec_src1><<<block_nums_stream_k, block_dims, nbytes_shared, stream>>>(...)其中 nbytes_shared = mmq_get_nbytes_shared(config, cc)、block_dims = (warp_size, nwarps, 1)。共享内存大小按配置算出来再显式传入——这正是为什么要拿 smpbo 校验 48 KiB:动态 shared memory 超过设备上限会直接启动失败。
stream-K:当 tile 数量填不满 SM 时的补救
mmq.cuh 里还有一条不太起眼但很重要的分支:stream-K 分解(配置项 stream_k)。launch_mul_mat_q 里算:
const int ntiles_dst = ntx * nty * ntzw;const int tiles_nwaves = (ntiles_dst + nsm - 1) / nsm;const int tiles_efficiency_percent = 100 * ntiles_dst / (nsm*tiles_nwaves);
const int nwork = ntiles_dst * ((args.ncols_x + config.K_vram - 1) / config.K_vram);const dim3 block_nums_stream_k(GGML_CUDA_CC_IS_NVIDIA(cc) && tiles_efficiency_percent >= 90 ? ntiles_dst : std::min(nsm, nwork), 1, 1);
const bool fixup_needed = ntiles_dst % block_nums_stream_k.x != 0;问题的本质是负载不均衡:如果 tile 总数不是 SM 数量的整数倍(例如 100 个 tile 跑在 108 个 SM 上),最后一轮只有少数 SM 在干活,其余空转。tiles_efficiency_percent 就是把这个浪费量化出来的指标。
stream-K 的思路来自 CUTLASS:不按「一个 block 包一个输出 tile 的全部 K」切,而是按「K 方向切开、多个 block 协作算同一个输出 tile、最后归约」切。这样能把工作量摊平到所有 SM 上。代价是需要一个 fixup kernel 做部分和归约——mul_mat_q_stream_k_fixup,用 tmp_fixup 缓冲暂存部分结果,block_nums_fixup = (block_nums_stream_k.x, I/warp_size, 1)。
代码里的判据很微妙:只有在 NVIDIA 卡且 tile 效率 ≥ 90% 时才用「每个 tile 一个 block」的朴素切法(block 数 = ntiles_dst),否则用 min(nsm, nwork) 作为 block 数走 stream-K。反过来说:tile 效率低于 90% 就值得为负载均衡多付一个 fixup kernel 的开销。这个 90% 又是一条实测阈值。
FP4 原生路径:GGML_PREC_Q4
MMQ 原本的假设是「权重任意量化 × 激活 q8_1」。但新一代硬件(Blackwell、部分 AMD)有原生 FP4 Tensor Core,把激活压到 8 位反而浪费了硬件的 FP4 吞吐。于是有了第二条精度路径:
const ggml_prec prec_src1 = ggml_cuda_mmq_get_prec_src1(src0, dst, cc);const bool use_native_fp4 = prec_src1 == GGML_PREC_Q4;const size_t y_block_size = use_native_fp4 ? sizeof(block_fp4_mmq) : sizeof(block_q8_1_mmq);const size_t y_values_per_block = use_native_fp4 ? QK_FP4_MMQ : QK8_1_MMQ;...quantize_mmq_fp4_cuda(src1_d, nullptr, src1_q8_1.get(), src1_scale.ptr, src0->type, use_aligned_float8, ...);要点:
GGML_PREC_Q4是模板参数,不是运行期分支——DECL_MMQ_CASE_W4A4(GGML_TYPE_MXFP4)与DECL_MMQ_CASE_W4A4(GGML_TYPE_NVFP4)为 FP4 类型额外实例化一套 kernel,注释写明「uses native FP4 MMA instead of keeping src1 at Q8_1」;block_fp4_mmq与block_q8_1_mmq同尺寸(static_assert保证),只是QK_FP4_MMQ = 2*QK8_1_MMQ = 256——同样的字节数装 256 个 4-bit 值,而不是 128 个 8-bit 值;- 激活量化目标变成 FP4,并多出一个
src1_scale显式缩放数组(src1_scale.alloc(ne13*ne12*ne11)),因为 FP4 的动态范围太窄,必须有 per-token 的 scale 兜底; - 对齐检查:
ggml_cuda_is_aligned(src1, 32)决定用对齐版还是非对齐版的量化 kernel。
这条路径的存在说明 MMQ 不是一个静止的实现,而是跟着硬件指令集演进的容器:同样的 tile 框架,把内层点积从 __dp4a 换成 MMA、把激活格式从 q8_1 换成 FP4,就能吃到新硬件的吞吐。
顺带放一张同类工作的示意图。Marlin 是 IST-DASLab 提出的、面向「混合精度自回归并行推理」的 4-bit 权重 × FP16 激活 GEMM 内核(论文,2024 年),它的核心手段同样是「离线把权重重排成适合 Tensor Core 的条带布局 + 运行期用软件流水线掩盖解包延迟」——和 MMQ 走的是同一条设计思路的两个变体(一个面向 __dp4a/INT8,一个面向 FP16 Tensor Core):
这张图来自 IST-DASLab/marlin 官方仓库。对比之下可以看出两类内核的共同点:都要在 kernel 之外(离线或装载期)完成一次权重重排,才能在 kernel 内做到「无谓词、无分支、定宽访存」。这也是 llama.cpp 侧 repack 机制与 MMQ 的 SRAM 布局共享的设计哲学。
flash-attn:把注意力的 KV 读取压到一次
三个内核家族
fattn.cu 把 FlashAttention 实现分成三族,用枚举 best_fattn_kernel 表达:
enum best_fattn_kernel { BEST_FATTN_KERNEL_NONE, BEST_FATTN_KERNEL_TILE, // fattn-tile.cuh 通用分块内核 BEST_FATTN_KERNEL_VEC, // fattn-vec.cuh 向量内核,每 warp 处理一行 BEST_FATTN_KERNEL_MMA_F16, // fattn-mma-f16.cuh Tensor Core 内核};
void ggml_cuda_flash_attn_ext(ggml_backend_cuda_context & ctx, ggml_tensor * dst) { switch (ggml_cuda_get_best_fattn_kernel(ggml_cuda_get_device(), dst)) { case BEST_FATTN_KERNEL_TILE: ggml_cuda_flash_attn_ext_tile(ctx, dst); break; case BEST_FATTN_KERNEL_VEC: ggml_cuda_flash_attn_ext_vec(ctx, dst); break; case BEST_FATTN_KERNEL_MMA_F16: ggml_cuda_flash_attn_ext_mma_f16(ctx, dst); break; ... }}三族的适用面:
fattn-vec(611 行):ncols=1或极小批量的解码专用路径。它不做 K/V 的 SRAM 分块,而是让每个 warp 沿 KV 序列前进、把Q·K的分数算出来后立刻在线 softmax 并累加V。这是「解码时 Q 只有一行」这个事实的直接映射;fattn-tile(1355 行):通用的分块内核,K/V 走 shared memory 分块,适用于没有 Tensor Core 的设备(老 NVIDIA、部分 AMD)和中等批量;fattn-mma-f16(2175 行):体积最大的一个,把QK^T与PV都喂给 Tensor Core 的 MMA 指令,并带 sparse(稀疏 gather) 变体。
分派启发式:一串「实测阈值」的集合
ggml_cuda_get_best_fattn_kernel 是全文最长的函数之一,读完会发现它几乎不含「优雅的算法推理」,全是工程判据。几条关键规则:
(1)头维度先过一遍白名单。 switch (K->ne[0]) 列出 40/64/72/80/96/128/112/256/192/320/512/576,default 直接返回 NONE(即这个后端不支持,让上层退回别的实现)。其中几个特殊组合还需要 GQA 条件:
case 192: if (V->ne[0] != 128 || !gqa_opt_applies) return BEST_FATTN_KERNEL_NONE; if (gqa_ratio % 8 != 0) return BEST_FATTN_KERNEL_NONE; break;case 320: if (V->ne[0] != 256 || !gqa_opt_applies) return BEST_FATTN_KERNEL_NONE; if (gqa_ratio % 32 != 0) return BEST_FATTN_KERNEL_NONE; break;192/128 与 320/256 这两组正是 MLA 的「QK 头维 ≠ V 头维」形态(DeepSeek 系列的 K 头维 192、V 头维 128;另一些配置是 320/256)。它们只能走 MMA 路径,且必须启用 GQA 优化。这条规则是架构特性直接写进分派函数的例子:MLA 的 V 维度小,正好和 GQA 的「多个 Q 头共享一组 KV 头」在数据布局上契合。
(2)gqa_opt_applies 是「能不能把 batch 放大」的开关。
bool gqa_opt_applies = gqa_ratio >= 2 && mask && max_bias == 0.0f && K->ne[1] % FATTN_KQ_STRIDE == 0;// 随后检查 Q/K/V/mask 的 stride 是否都能被 16 整除,不能则关闭含义:当 gqa_ratio ≥ 2、有 mask、没有 ALiBi(max_bias == 0)、且 KV 长度是 FATTN_KQ_STRIDE 的整数倍时,同一个 KV 头可以同时服务多个 Q 头,于是「有效批量」等于 Q->ne[1] * gqa_ratio_eff。这一点非常重要:解码时 Q->ne[1] = 1(只有一个 query),如果没有 GQA 复用,整个 kernel 就只有一行 Q 在工作,GPU 利用率极低。GQA 复用把有效批量乘上 gqa_ratio,是解码注意力能跑起来的前提。
代码里还有个细节——gqa_ratio_eff 是取 2 的幂的:
const int ncols2_max = Q->ne[0] == 320 ? 32 : ((Q->ne[0] == 576 || Q->ne[0] == 192) ? 16 : 8);int gqa_ratio_eff = 1;while (max_bias == 0.0f && gqa_ratio % (2*gqa_ratio_eff) == 0 && gqa_ratio_eff < ncols2_max) { gqa_ratio_eff *= 2;}因为 ncols2 是模板参数(每个 GQA 分组处理的 query 数),只能在编译期实例化有限几种,取 2 的幂就把实例数量压到了 O(log)。
(3)Turing 及以上的主判据。
if (turing_mma_available(cc) && Q->ne[0] != 40 && Q->ne[0] != 72) { if (can_use_vector_kernel) { if (!ggml_is_quantized(K->type) && !ggml_is_quantized(V->type)) { const bool sparse_decode = gqa_opt_applies && gqa_ratio > 4 && ...; if (!sparse_decode && cc >= GGML_CUDA_CC_ADA_LOVELACE && Q->ne[1] == 1 && Q->ne[3] == 1 && !(gqa_ratio > 4 && (Q->ne[0] >= 256 || K->ne[1] >= 8192))) { return BEST_FATTN_KERNEL_VEC; } } else { if (cc >= GGML_CUDA_CC_ADA_LOVELACE) { if (Q->ne[1] <= 2) return BEST_FATTN_KERNEL_VEC; } else { if (Q->ne[1] == 1) return BEST_FATTN_KERNEL_VEC; } } if (!gqa_opt_applies && Q->ne[1] == 1) return BEST_FATTN_KERNEL_VEC; } return BEST_FATTN_KERNEL_MMA_F16;}逐条读:
- 头维 40/72 被排除(它们没有对应的 MMA 实例),只能用 tile/vec;
- Ada Lovelace 及新架构上,未量化 KV 且单 query 时优先 VEC——除非同时满足「GQA 比 > 4 且(头维 ≥ 256 或 KV 长度 ≥ 8192)」,此时 MMA 的稀疏 gather 更划算;
- 老 Turing 架构上,量化 KV 只在
Q->ne[1] == 1时用 VEC,而 Ada 上放宽到 ≤ 2——新卡上 VEC 内核的吞吐更高,能承受更宽的批量; - 其余情况一律走 MMA。
(4)Volta 与 AMD 的阈值表。 Volta 段:
if (volta_mma_available(cc) && Q->ne[0] != 40 && Q->ne[0] != 72) { if (can_use_vector_kernel && Q->ne[1] * gqa_ratio_eff <= 2) return BEST_FATTN_KERNEL_VEC; if (Q->ne[1] * gqa_ratio_eff <= 16) return BEST_FATTN_KERNEL_TILE; // Volta 的 Tensor Core 只在矩阵足够大时才快 return BEST_FATTN_KERNEL_MMA_F16;}「Volta tensor cores are only faster for sufficiently large matrices.」——Volta 是第一代 Tensor Core,小矩阵下 MMA 的 fragment 布局与数据搬运开销压不过收益,所以 16 以内退回 tile 内核。AMD MFMA 段则是一张按头维分档的阈值表(Q->ne[0] <= 64 且批量 > 8、<= 128 且批量 > 16、<= 256 且批量 > 64、> 256 且批量 > 128),注释说明「AMD MFMA needs a certain minimum batch size to outscale the tile kernel for large head sizes」。AMD WMMA 段另有一条「宽 tile 算术强度高时才比 tile 内核快」。
这一整段代码是硬件特性差异到批量阈值的翻译,它的信息密度很高,但读者应当注意它并没有普适结论:这些数字是特定架构、特定内核实现下的实测边界,换硬件或换实现都要重测。
vec 内核内部:在线 softmax 与 warp 归约
fattn-vec.cuh 的主循环是理解「解码注意力 GPU 实现」最直接的样本。骨架:
float KQ_max[ncols];float KQ_sum[ncols];half2 VKQ[ncols][(D/2)/nthreads_V]; // 累加器:V 的加权和
for (int k_VKQ_0 = blockIdx.y*nthreads; k_VKQ_0 < k_VKQ_max; k_VKQ_0 += gridDim.y*nthreads, ...) { float KQ_max_new[ncols]; ... // 1) 算 Q·K 得分数,warp 内做 max 归约 KQ_max_new[j] = fmaxf(KQ_max_new[j], sum + FATTN_KQ_MAX_OFFSET); KQ_max_new[j] = __shfl_xor_sync(0xFFFFFFFF, KQ_max_new[j], offset, WARP_SIZE);
// 2) 在线 softmax 重缩放:老累加器乘上 exp(old_max - new_max) const float KQ_max_scale = expf(KQ_max[j] - KQ_max_new[j]); KQ_max[j] = KQ_max_new[j]; KQ_reg[j] = expf(KQ_reg[j] - KQ_max[j]); KQ_sum[j] = KQ_sum[j]*KQ_max_scale + KQ_reg[j]; VKQ[j][i_VKQ_0/nthreads_V] *= KQ_max_scale_h2;
// 3) 累加 V 的加权和 VKQ[j][i_VKQ_0/nthreads_V + i_VKQ_1] += tmp[i_VKQ_1]*KQ_k[j];}三个技术点:
(1)在线 softmax 的「运行期最大值」。 KQ_max 是滚动的:每处理一批 KV,先算这一批的最大值,若比历史最大值大,就把已累加的 VKQ 整体乘上 exp(old_max - new_max) 重新缩放到新的基准。这与 FlashAttention 论文里的 online softmax 完全一致,但 fattn-vec 把它写成了最朴素的形式——没有分块,只是一维地扫过 KV 序列。代价是重缩放的次数等于 ceil(KV长度 / (nthreads * gridDim.y)),收益是不需要保存任何中间分数矩阵。
注意 FATTN_KQ_MAX_OFFSET:算出的分数加上这个常量再加 fmaxf,是数值安全措施——防止在全 -inf(全被 mask)的情况下 KQ_max 停在初值 -FLT_MAX/2 导致后续指数运算下溢成 0/0。这类「偏移一个小常数」的写法在数值代码里极常见。
(2)__shfl_xor_sync 做 warp 内归约。 最大值归约用的不是 shared memory 而是 warp shuffle:
KQ_max_new[j] = __shfl_xor_sync(0xFFFFFFFF, KQ_max_new[j], offset, WARP_SIZE);每个 offset 轮次(16、8、4、2、1)把半个 warp 的值换过来比一次,五轮之后全 warp 都拿到最大值。用 shuffle 而不是 SMEM 是因为延迟低、不需要 barrier,在每轮 KV 都要归约一次的热路径里差别很大。
(3)跨 warp 归约只在最后做一次。 循环结束后还有一段收尾:
__shared__ float KQ_max_shared[ncols][WARP_SIZE];__shared__ float KQ_sum_shared[ncols][WARP_SIZE];...KQ_max_shared[j][threadIdx.y] = KQ_max[j];...float kqmax_new = KQ_max_shared[j_VKQ][threadIdx.x];const float kqmax_scale = expf(KQ_max[j_VKQ] - kqmax_new);因为不同 warp 处理的是 KV 序列的不同分段(k_VKQ_0 = blockIdx.y*nthreads,加上 gridDim.y*nthreads 的步长),所以每个 warp 维护着自己的一份在线状态,最后必须用 shared memory 把所有 warp 的 KQ_max/KQ_sum 再合并一次、并把各自的 VKQ 按合并后的基准重缩放后相加。这是「在线 softmax 天然可并行、但归约必须显式做」的直接体现,也是 FlashDecoding 那套「序列维并行 + 最后归约」在 llama.cpp 里的对应实现。
CPU 后端:llama.cpp 的主战场与权重 repack
很多人把 llama.cpp 当成「GPU 推理框架的轻量替代」,这个定位其实是反的:CPU 后端才是它的主战场,也是它能在一台没有独显的机器上跑起 70B 模型的原因。这一节看 CPU 侧的两件核心工作:指令集特化(SIMD 抽象层)与权重重排(repack)。
指令集特化:一份代码如何适配五种 SIMD
ggml-cpu/simd-mappings.h(1368 行)定义了一层宏,把不同 ISA 的向量类型统一成同一组符号。核心是 GGML_F32_VEC 这类宏——它随编译目标展开成不同的实际类型:
// x86 AVX#define GGML_F32_VEC GGML_F32x8// x86 AVX512#define GGML_F32_VEC GGML_F32x16// ARM NEON#define GGML_F32_VEC GGML_F32x4// RISC-V / 通用回退#define GGML_F32_VEC GGML_F32xt对应地,运算宏 GGML_F32_VEC_ADD、_MUL、_FMA、_MAX 等在这一层被映射到具体的 intrinsic(_mm256_add_ps、vaddq_f32 等)。上层的算子实现(vec.cpp、ops.cpp)只写一次,靠这层映射被编译成不同 ISA 的版本。
这套抽象对非 SIMD 场景也有交代:GGML_F32_VEC 可以是 GGML_F32xt——一个标量循环的「伪向量」类型,由编译器决定是否自动向量化。这让同一份代码在没有手写 dispatch 的平台上仍然能跑。
CPU 侧量化推理的瓶颈与收益空间,可以借 T-MAC 的公开数据来对照。T-MAC 由微软亚洲研究院提出(论文,2024 年),它的核心主张是:把低比特点积从「解包 + 融合乘加」换成「查表」,从而绕开 CPU 上指令开销过高的问题。它在多批量 GEMM 上相对 llama.cpp 的加速比与功耗对比:
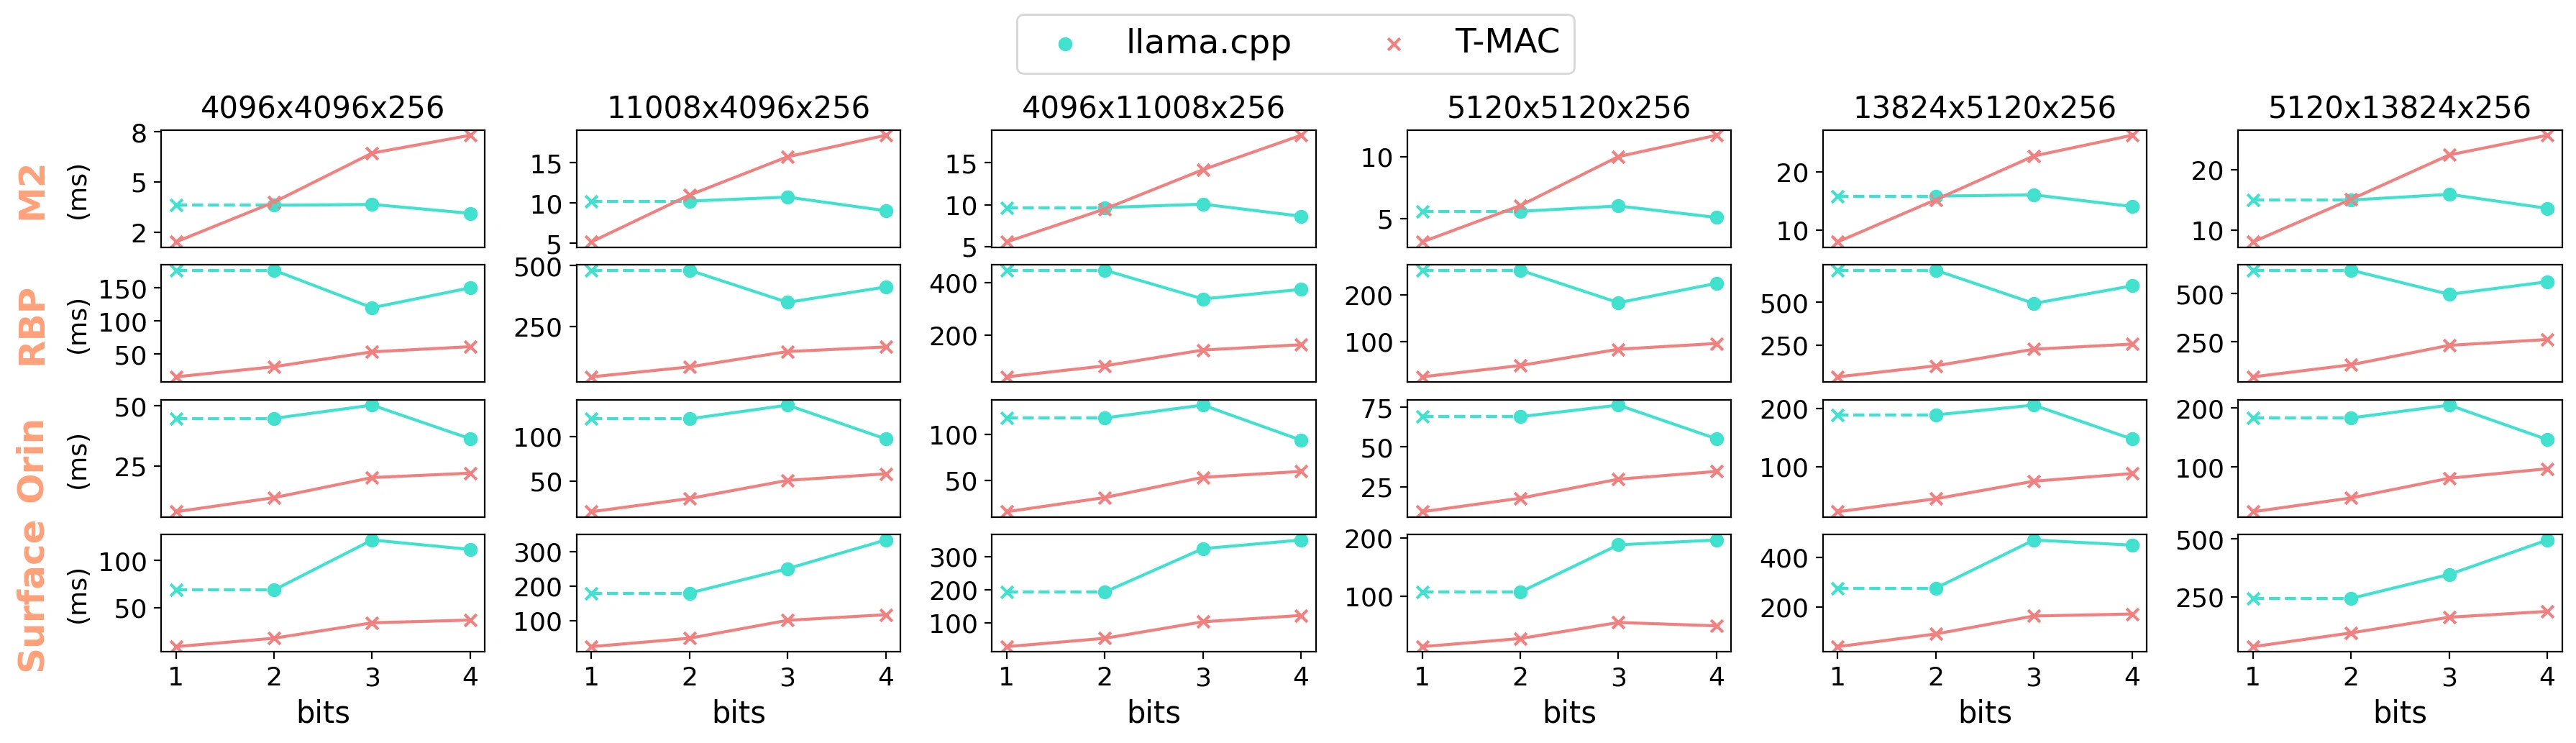
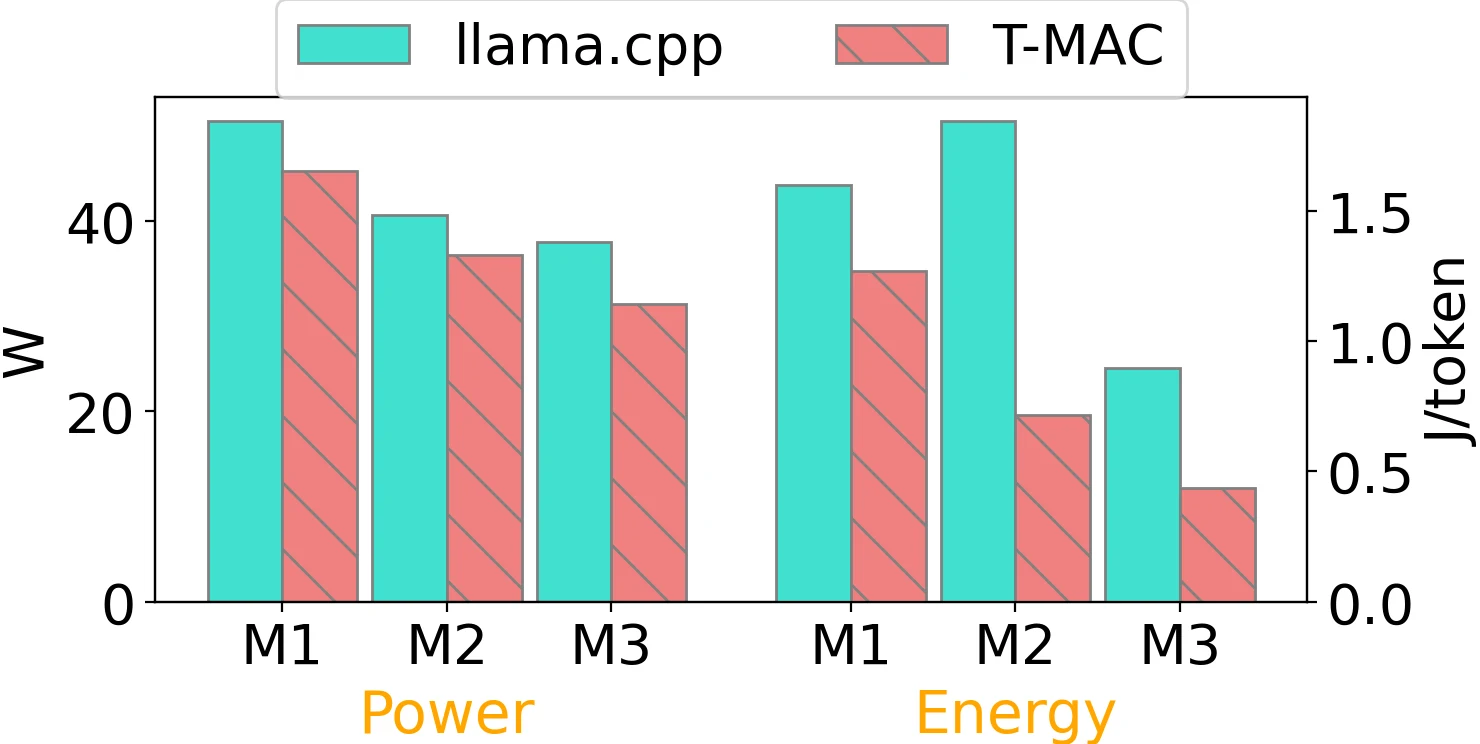
两张图来自 microsoft/T-MAC 官方仓库。上图按线程数与批量列出各比特宽度下 GEMM 的加速比,下图是 M2-Ultra 上三个模型的功耗与总能耗(数据由 powermetrics 采样)。它们说明同一件事的两个侧面:CPU 上做量化推理,瓶颈在「解包 + 点积」这条路径的指令开销(上图),而这个开销最终直接反映到端到端能耗上(下图)。llama.cpp 的 repack 机制要解决的正是前者——用数据布局重排减少解包与 gather,而不是改变计算范式。
repack:把量化权重在装载时重排成 SIMD 友好的布局
这是 CPU 后端里最值得讲的一块。问题的起点是一个纯粹的内存访问问题。
原始 GGUF 里的 Q4_0 权重布局是「块连续」:每个 block_q4_0 是 2 字节的 d(FP16 scale)+ 16 字节的 4-bit 量化值,块与块首尾相接。做 mul_mat 时,如果需要同时处理 多行 权重(GEMM 场景,或 batch 内多个 token),每行的量化块在内存里相隔很远——SIMD 想一次加载多行的对应字节,就得做 gather,而 gather 在 CPU 上很贵。
repack.cpp(5255 行)的解法是:在装载时把权重重新排布成「多行交错」的布局,让同一次 SIMD 加载能拿到的字节恰好属于相邻的多行。源码开头的注释把设计说得很清楚:
// interleave 4 block_q4_0s in blocks of blck_size_interleave// returns an interleaved block_q4_0x4// in the interleaved block_q4_0x4, place deltas for 4 block_q4_0 blocks// first, then interleave quants from 4 block_q4_0s in blocks of blck_size_interleave//// - in : an array of block_q4_0 pointers// - blck_size_interleave : the block_q4_0 quants bytes are interleaved in blocks of// blck_size_interleave bytes// - xor_mask : the mask to convert the nibbles in block_q4_0 quants bytes// from bias offset form to pure sign form (this saves subtract// operations durin unpacking)三点信息量很大:
(1)布局:先放 4 个块的 delta,再交错放量化值。 原来散落在 4 个块头里的 scale 被集中到开头——一次 SIMD 加载就能拿到 4 行的 scale,不必分四次读。
(2)交错粒度 blck_size_interleave 是可调参数,代码里能看到 1、4、8 三种值,分别对应不同的内核变体和 ISA。粒度越大,一次加载覆盖的行内字节越多,但对行数与对齐条件的要求也越严。
(3)xor_mask 是纯计算优化。 Q4_0 的 4-bit 值存的是有偏偏移形式,解包时需要减偏移。repack 在装载时用异或掩码把它转成纯符号形式,省掉解包路径上的减法。代价是装载时多一遍计算,收益是每次前向都少一批指令——典型的「把一次性成本前置到装载期」。
生成交错布局的代码本身就是一个索引变换:
const int blck_size_interleave = 4;for (int j = 0; j < QK4_0 * 4; j++) { int src_offset = (j / (4 * blck_size_interleave)) * blck_size_interleave; int src_id = (j % (4 * blck_size_interleave)) / blck_size_interleave; src_offset += (j % blck_size_interleave); ...}src_id 选行(第几行)、src_offset 选行内偏移。这就是「行优先转交错」的全部逻辑——形式上和矩阵转置的索引变换同构,只是作用在更细的字节粒度上。
repack 的接入方式:一个「额外缓冲区类型」
repack 不是一个开关,而是通过 ggml 的扩展缓冲区类型机制接进调度器的。整个链路有四步。
第一步,CPU 后端导出扩展缓冲区类型。 在 ggml-cpu.cpp 里:
std::vector<ggml_backend_buffer_type_t> & ggml_backend_cpu_get_extra_buffer_types() { static std::vector<ggml_backend_buffer_type_t> bufts = []() { std::vector<ggml_backend_buffer_type_t> bufts; if (ggml_backend_amx_buffer_type()) bufts.push_back(ggml_backend_amx_buffer_type()); if (ggml_backend_cpu_riscv64_spacemit_buffer_type()) bufts.push_back(...); if (ggml_backend_cpu_kleidiai_buffer_type()) bufts.push_back(...);#ifdef GGML_USE_CPU_REPACK if (ggml_backend_cpu_repack_buffer_type()) bufts.push_back(ggml_backend_cpu_repack_buffer_type());#endif return bufts; }(); return bufts;}这份清单里还有 AMX(Intel 的高级矩阵扩展指令)、KleidiAI(ARM 的推理加速库)、SpaceMIT(RISC-V 平台)——它们是同一个「额外缓冲区类型」机制的四位租客。好处是上层完全不用知道下面有几种加速方案,谁被编译进来谁就参与竞争。
导出走的是后端的 get_proc_address 查询接口:
if (strcmp(name, "ggml_backend_dev_get_extra_bufts") == 0) { ggml_backend_dev_get_extra_bufts_t fct = ggml_backend_cpu_device_get_extra_buffers_type; return (void *)fct;}ggml_backend_reg_get_proc_address 是 ggml 后端层的「可选能力查询」通道,用字符串名字取函数指针——一种不改 ABI 就能扩展后端能力的做法。
第二步,模型装载时把它们排进候选清单。 llama-model.cpp 的 make_cpu_buft_list 里:
// add extra buffer typesif (use_extra_bufts) { auto * cpu_dev = ggml_backend_dev_by_type(GGML_BACKEND_DEVICE_TYPE_CPU); auto * cpu_reg = ggml_backend_dev_backend_reg(cpu_dev); auto ggml_backend_dev_get_extra_bufts_fn = (ggml_backend_dev_get_extra_bufts_t) ggml_backend_reg_get_proc_address(cpu_reg, "ggml_backend_dev_get_extra_bufts"); if (ggml_backend_dev_get_extra_bufts_fn) { ggml_backend_buffer_type_t * extra_bufts = ggml_backend_dev_get_extra_bufts_fn(cpu_dev); while (extra_bufts && *extra_bufts) { buft_list.emplace_back(cpu_dev, *extra_bufts); ++extra_bufts; } }}注意顺序:ACCEL 类型 → host 类型 → extra 类型 → 普通 CPU 类型。repack 排在普通 CPU 缓冲之前,所以只要判定通过,权重就会优先落到 repack 缓冲里。这个顺序本身就是优先级声明。
第三步,逐个张量试选缓冲区类型。 select_buft 是一个「试了再说」的循环:
template<typename F>static ggml_backend_buffer_type_t select_buft(const buft_list_t & buft_list, const F & fn) { for (const auto & cur : buft_list) { if (buft_supported(cur.second, cur.first, fn)) return cur.second; } throw std::runtime_error("no suitable buffer type found");}buft_supported 的判定方式很聪明:临时建一个 ggml context、造一个代表该层典型算子的张量、把它的 src[] 的 buffer 指向候选 buft,然后直接问后端 ggml_backend_dev_supports_op:
ggml_backend_buffer_ptr buf { ggml_backend_buft_alloc_buffer(buft, 0) };ggml_tensor * op_tensor = fn(ctx.get());for (int i = 0; i < GGML_MAX_SRC; i++) { if (op_tensor->src[i] != nullptr) { op_tensor->src[i]->buffer = buf.get(); }}return ggml_backend_dev_supports_op(dev, op_tensor);调用点给的 fn 很简化:
ggml_backend_buffer_type_t llama_model::select_buft(int il) const { return ::select_buft(*pimpl->dev_layer.at(il).buft_list, [&](ggml_context * ctx) { ggml_tensor * cur = ggml_new_tensor_1d(ctx, GGML_TYPE_F32, hparams.n_embd); ggml_tensor * layer_dir = ggml_new_tensor_1d(ctx, GGML_TYPE_F32, hparams.n_embd); return ggml_add(ctx, cur, layer_dir); });}用一个 ggml_add 当代表算子——因为大多数加速方案都会实现或至少声明支持逐元素加法,用它能快速筛掉完全不兼容的设备/buft 组合。真正决定 repack 是否启用的,是 repack 自己实现的 supports_op:
bool supports_op(ggml_backend_dev_t, const struct ggml_tensor * op) override { if (op->op == GGML_OP_MUL_MAT && op->src[0]->buffer && (ggml_n_dims(op->src[0]) == 2) && op->src[0]->buffer->buft == ggml_backend_cpu_repack_buffer_type() && ggml_repack_get_optimal_repack_type(op->src[0])) { if (op->src[1]->buffer && !ggml_backend_buft_is_host(op->src[1]->buffer->buft)) return false; if (op->src[1]->type == GGML_TYPE_F32) return true; ... } else if (op->op == GGML_OP_MUL_MAT_ID && (ggml_n_dims(op->src[0]) == 3) && ...) { ... } return false;}判据逐条:是 mul_mat(或 mul_mat_id)→ 权重是二维(或三维,即 MoE 的分专家权重)→ 权重就在 repack 缓冲里 → 这个权重有针对当前 CPU 的最优重排类型;此外还要求激活张量在 host 内存里、且类型为 F32(注释里留了两行被注释掉的 Q8_0 分支,写着「may be possible if Q8_0 packed…」——说明让激活也走量化中间格式是已知的后续方向)。
第四步,真正重排。 重排发生在 set_tensor 时——也就是权重数据从 GGUF 文件搬进这块缓冲的时候:
static enum ggml_status ggml_backend_cpu_repack_buffer_init_tensor(ggml_backend_buffer_t buffer, struct ggml_tensor * tensor) { tensor->extra = (void *) const_cast<ggml::cpu::tensor_traits *>(ggml_repack_get_optimal_repack_type(tensor)); return GGML_STATUS_SUCCESS;}
static void ggml_backend_cpu_repack_buffer_set_tensor(ggml_backend_buffer_t buffer, struct ggml_tensor * tensor, const void * data, size_t offset, size_t size) { GGML_ASSERT(offset == 0); GGML_ASSERT(size == ggml_nbytes(tensor)); auto tensor_traits = (ggml::cpu::repack::tensor_traits_base *) tensor->extra; auto OK = tensor_traits->repack(tensor, data, size); GGML_ASSERT(OK == 0);}init_tensor 在张量上挂一个 extra 指针(指向选定的重排方案),set_tensor 时用这个 extra 把原始字节重排写进缓冲。注意 get_tensor = nullptr、cpy_tensor = nullptr——这块缓冲里的数据不能被读回,因为它已经不是标准 ggml 布局了。这个「只写不可读」的约定,是 repack 缓冲与普通缓冲最本质的区别;也意味着任何需要读取权重原始字节的操作都必须在重排之前完成。
ggml_repack_get_optimal_repack_type:一张 ISA × 量化类型 × 交错粒度的三元表
这个函数(repack.cpp:4925)是整块 repack 逻辑的决策中心。它先静态声明一批 tensor_traits 实例,每个实例的模板参数是 <量化块类型, 行数, 交错粒度, 激活类型>:
// instance for Q4static const ggml::cpu::repack::tensor_traits<block_q4_0, 4, 4, GGML_TYPE_Q8_0> q4_0_4x4_q8_0;static const ggml::cpu::repack::tensor_traits<block_q4_0, 8, 4, GGML_TYPE_Q8_0> q4_0_4x8_q8_0;static const ggml::cpu::repack::tensor_traits<block_q4_0, 8, 8, GGML_TYPE_Q8_0> q4_0_8x8_q8_0;
// instance for Q4_Kstatic const ggml::cpu::repack::tensor_traits<block_q4_K, 4, 8, GGML_TYPE_Q8_K> q4_K_8x4_q8_K;static const ggml::cpu::repack::tensor_traits<block_q4_K, 8, 8, GGML_TYPE_Q8_K> q4_K_8x8_q8_K;命名规则是 <块类型>_<行数>x<交错粒度>_<激活类型>:q4_0_8x8_q8_0 读作「Q4_0 权重,8 行一组,交错粒度 8 字节,激活用 Q8_0」。GGML_TYPE_Q8_K 是给 K-quant 系列(Q2_K/Q4_K/Q5_K/Q6_K)用的激活中间格式,块大小 256(QK_K),比 Q8_0 的 32 大得多——因为 K-quant 的超级块本身就覆盖 256 个元素,激活按同样粒度量化才能对齐。
然后是按指令集能力的选择链,以 Q4_0 为例:
if (cur->type == GGML_TYPE_Q4_0) { if (ggml_cpu_has_avx2() || (ggml_cpu_has_sve() && ggml_cpu_has_matmul_int8() && ggml_cpu_get_sve_cnt() == QK8_0)) { if (cur->ne[1] % 8 == 0) return &q4_0_8x8_q8_0; } if (ggml_cpu_has_neon() && ggml_cpu_has_matmul_int8()) { if (cur->ne[1] % 4 == 0) return &q4_0_4x8_q8_0; } if (ggml_cpu_has_neon() && ggml_cpu_has_dotprod()) { if (cur->ne[1] % 4 == 0) return &q4_0_4x4_q8_0; } if (ggml_cpu_has_vxe()) { if (cur->ne[1] % 4 == 0) return &q4_0_4x4_q8_0; } if (ggml_cpu_has_riscv_v()) { switch (__riscv_vlenb() * 8) { case 256: { if (cur->ne[1] % 16 == 0) return &q4_0_16x1_q8_0; break; } case 128: case 512: case 1024: { break; } // TODO default: { return nullptr; } } }}四个平台分支值得逐条看:
- x86 AVX2:优先
8x8。AVX2 有 256 位向量,8 行交错正好让一次加载覆盖 8 行的对应字节。条件cur->ne[1] % 8 == 0(输出行数是 8 的倍数)是硬要求——交错布局要求行数能被分组大小整除; - ARM NEON +
matmul_int8:4x8。这里的matmul_int8指 ARMv8.2 的SMMLA/UMMLA指令(int8 矩阵乘),比dotprod(SDOT/UDOT,8 位点积)更强——一次算的是矩阵乘而不是点积,所以能支持更大的交错粒度 8; - ARM NEON +
dotprod:退回4x4。粒度小是因为SDOT吞吐有限,交错粒度大了反而增加解包成本; - RISC-V +
ZVFH(向量浮点半精度扩展):走16x1,交错粒度为 1。代码注释解释了原因:
// instances for RISC-V//// These implement outer-product style matrix multiplication kernels with// an interleave of 1.RISC-V Vector 的编程模型(可伸缩向量长度)与固定宽度 SIMD 不同,它更适合外积式(outer-product)矩阵乘:粒度 1 意味着不做交错,靠向量的 gather/scatter 能力与可变长寄存器组织数据。同一个 repack 框架下,不同 ISA 需要的是完全不同的数据布局哲学——这是本节的要点之一:布局不是锦上添花的优化,而是 ISA 编程模型的直接后果。
再往下是实际调用的算子。repack.cpp 里成对存在 gemv(矩阵-向量)与 gemm(矩阵-矩阵)的特化:
template <> void gemv<block_q4_0, 8, 8, GGML_TYPE_Q8_0>(int n, float * s, size_t bs, const void * vx, const void * vy, int nr, int nc) { ggml_gemv_q4_0_8x8_q8_0(n, s, bs, vx, vy, nr, nc);}...template <> void gemm<block_q4_0, 8, 8, GGML_TYPE_Q8_0>(...) { ggml_gemm_q4_0_8x8_q8_0(n, s, bs, vx, vy, nr, nc);}每个重排实例都要配一对自己写的手工 SIMD 内核(ggml_gemv_q4_K_8x8_q8_K_generic、ggml_gemm_q4_0_8x8_q8_0_generic 这些函数在文件里各自上百行,内层全是 GGML_F32_VEC 系列的宏)。这解释了 repack.cpp 为什么有 5255 行:它是一个「N 种 ISA × M 种量化类型 × K 种交错粒度」的内核矩阵,每格都要手写。
gemv 与 gemm 分开的原因是形状差异:解码时 batch=1,走 gemv(权重是矩阵、激活是向量);预填充时 batch 大,走 gemm。两者的最优数据布局与并行划分不同——gemv 带宽受限(只读一遍权重),gemm 有复用空间(同一块权重服务多个 token)。所以 repack 为同一对 <块类型, 行数, 粒度> 提供两套内核,由输出行数与批量大小决定实际走哪条。
repack 的代价
有收益就有代价,值得列清楚:
- 装载时间与内存:重排要在装载时做一遍完整的读写,且交错布局要求行数能被分组大小整除,否则这个张量拿不到 repack 方案(
cur->ne[1] % 8 == 0这类条件失败就一路往下掉,最后返回nullptr); - 不可读回:如前所述,
get_tensor/cpy_tensor为nullptr,数据不能再被当普通张量读; - 必须整体装载:
set_tensor里GGML_ASSERT(size == ggml_nbytes(tensor))——不能分片写。这与第三篇讲的 mmap 惰性装载有直接冲突:repack 缓冲里的权重必须完整读进内存,不能留在磁盘上按需读取。所以「用 repack 换 CPU 吞吐」与「用 mmap 换内存占用」是两条要权衡的路,llama.cpp 把它们做成可选(GGML_USE_CPU_REPACK编译开关 +use_extra_bufts运行开关),让使用者按场景取舍; - 只对特定算子有效:
supports_op只覆盖mul_mat/mul_mat_id。其他需要读权重的算子在 repack 缓冲上会判定不支持,调度器必须把它们安排到普通 CPU 缓冲或别的设备上——这就把「权重在 repack 缓冲里」变成了对图切分的一个额外约束。
最后补一点背景:repack 这套机制的最初动机来自 ARM 上的 Q4_0_4x4 系列内核(社区里常说的「Q4_0_4x4 / Q4_0_8x8 模型格式」),当时是通过单独的 GGUF 类型来表达交错布局;现在演进成了「运行时按最优方案重排」的通用机制。这也是为什么在 llama.cpp 的 issue 与文档里会看到两套说法——旧的表述是「文件格式里存交错布局」,新的表述是「装载时按 CPU 能力重排」,讨论的是同一件事的两个阶段。
调度器执行侧:跨后端切图的真实代价
后端和 kernel 都讲完之后,还剩一个绕不开的问题:图被切成多个 split、分给不同后端执行时,中间数据怎么搬。 答案在 ggml_backend_sched_compute_splits(ggml-backend.cpp:1865)。
主循环:先搬输入,再算,再记事件
static enum ggml_status ggml_backend_sched_compute_splits(ggml_backend_sched_t sched) { int prev_backend_id = -1;
for (int split_id = 0; split_id < sched->n_splits; split_id++) { struct ggml_backend_sched_split * split = &splits[split_id]; int split_backend_id = split->backend_id; ggml_backend_t split_backend = sched->backends[split_backend_id];
// ensure the previous split's async work has completed before we start // this split, the allocator may have reused buffer regions across splits if (split->n_inputs == 0 && prev_backend_id >= 0 && prev_backend_id != split_backend_id) { if (sched->events[prev_backend_id][sched->cur_copy] != NULL) ggml_backend_event_synchronize(sched->events[prev_backend_id][sched->cur_copy]); else ggml_backend_synchronize(sched->backends[prev_backend_id]); }
// copy the input tensors to the split backend // the weights in host memory are copied last, so that the copy callback can read the other inputs of the split for (int input_id = 0; input_id < split->n_inputs; input_id++) if (!ggml_backend_sched_is_host_weight(split->inputs[input_id])) ggml_backend_sched_copy_input(sched, split, split->inputs[input_id]); for (int input_id = 0; input_id < split->n_inputs; input_id++) if (ggml_backend_sched_is_host_weight(split->inputs[input_id])) ggml_backend_sched_copy_input(sched, split, split->inputs[input_id]);
ggml_backend_graph_compute_async(split_backend, &split->graph);
// record the event of this split if (sched->events[split_backend_id][sched->cur_copy] != NULL) ggml_backend_event_record(sched->events[split_backend_id][sched->cur_copy], split_backend);
prev_backend_id = split_backend_id; }}四个设计点:
(1)为什么先搬非权重输入、再搬权重。 注释明说了:「the weights in host memory are copied last, so that the copy callback can read the other inputs of the split」。拷贝回调(下面讲的 MoE 专家拷贝)需要读这一 split 里的其他输入(尤其是 ids)来决定搬哪些专家,所以 ids 必须先就位。这个顺序不是随意的,而是回调机制的硬性依赖。
(2)n_inputs == 0 时的同步是内存复用的保护。 如果一个 split 没有任何输入需要搬(说明它完全接着上一个 split 的中间结果算),且上一个 split 在不同后端上,就必须先同步——因为跨后端意味着内存分配器可能把上一段缓冲复用给了这一段。这是「异步执行 + 内存复用」这对矛盾在调度器里唯一的显式妥协点。
(3)事件只记不等待。 每个 split 结束后 event_record,但主循环不等它。真正使用这个事件的地方是下一个 split 的 copy_input(event_wait)与 n_inputs == 0 的分支。这就是整个执行链能做到「提交完所有 kernel 再统一同步」的原因:split 之间靠事件串起来,CPU 侧不阻塞。
(4)sched->cur_copy:多副本机制。ggml_backend_sched 支持 n_copies 份张量副本,用于同时进行多条独立的执行序列(例如并行处理多个 batch)。tensor_id_copy(id, backend_id, copy_id) 这个宏就是按「张量 × 后端 × 副本」三维索引副本。这是 llama.cpp 支持多序列并行与投机解码多路验证的底层支撑。
copy_input:一条完整的同步决策链
ggml_backend_sched_copy_input(1818 行)是拷贝路径的全部逻辑,值得逐段看:
static void ggml_backend_sched_copy_input(ggml_backend_sched_t sched, struct ggml_backend_sched_split * split, struct ggml_tensor * input) { ggml_backend_t input_backend = ggml_backend_sched_get_tensor_backend(sched, input); struct ggml_tensor * input_cpy = tensor_copy(input, split_backend_id, sched->cur_copy);
if (input->flags & GGML_TENSOR_FLAG_INPUT) { // inputs from the user must be copied immediately to prevent the user overwriting the data before the copy is done ggml_backend_event_synchronize(...); // 或 ggml_backend_synchronize ggml_backend_tensor_copy(input, input_cpy); return; }
// wait for the split backend to finish using the input before overwriting it ggml_backend_event_wait(split_backend, sched->events[split_backend_id][sched->cur_copy]);
if (sched->callback_copy != NULL && ggml_backend_sched_is_host_weight(input) && sched->callback_copy(split_backend, input, input_cpy, &split->graph, sched->callback_copy_user_data)) { return; }
// try async copy, but if not possible, we can still use a sync copy without synchronizing the dst backend, ... if (!split_backend->iface.cpy_tensor_async || !split_backend->iface.cpy_tensor_async(input_backend, split_backend, input, input_cpy)) { ggml_backend_synchronize(input_backend); ggml_backend_event_synchronize(...); ggml_backend_tensor_copy(input, input_cpy); }}(1)用户输入必须立即拷贝。 GGML_TENSOR_FLAG_INPUT 标的是外部喂进来的张量(token id、位置、KV 槽位索引等)。注释说得很清楚:必须立刻拷,否则用户可能在拷贝完成前就覆写了原缓冲。这是一个 API 契约层面的约束——它意味着调度器在这里放弃了异步性,换取正确性。
(2)覆写前的等待。 event_wait(split_backend, ...) 保证目标后端的上一次使用已完成,才能把新数据写进这块副本。「多个副本 + 事件」的组合让这件事不需要全后端同步。注意注释里的细节:「we can still use a sync copy without synchronizing the dst backend, since we handle the synchronization here with multiple copies and events」——用事件把同步范围缩小到必要的后端对。
(3)异步拷贝失败才退化。 优先尝试 cpy_tensor_async(跨后端异步拷贝,CUDA↔CUDA 走 cudaMemcpyAsync、CUDA↔CPU 走 pinned 暂存等)。失败才退回「同步源后端 + 同步目标事件 + 普通拷贝」这条路。这条 fallback 路径是全同步的,代价最大——所以后端实现里有没有 cpy_tensor_async 直接决定了跨后端切图的性能上限。
(4)is_host_weight 的判定。
static bool ggml_backend_sched_is_host_weight(const struct ggml_tensor * t) { return t->buffer != NULL && ggml_backend_buffer_get_usage(t->buffer) == GGML_BACKEND_BUFFER_USAGE_WEIGHTS && ggml_backend_buffer_is_host(t->buffer);}三个条件:有缓冲 + 用途是权重 + 数据在宿主内存。也就是「权重留在 CPU 内存里、被某块 GPU 借去算」这个典型场景(-ngl 只卸载部分层时很常见)。这个判据决定了这条输入会不会走拷贝回调,也是下面 MoE 专家按需上传的入口。
拷贝回调:一次 MoE 层只上传用到的专家
这是 llama.cpp 里最精彩的一处「调度器与模型语义的耦合」。llama_context 在初始化时注册回调:
ggml_backend_sched_set_copy_callback(sched.get(), sched_copy_experts, this);llama_context::sched_copy_experts(llama-context.cpp:2762)的实现:
bool llama_context::sched_copy_experts(ggml_backend_t backend, const ggml_tensor * src, ggml_tensor * dst, ggml_cgraph * graph, void * user_data) { auto * lctx = static_cast<llama_context *>(user_data);
// the slot maps of the MoE cache if (lctx->moe_cache && lctx->moe_cache->copy(backend, src, dst, graph)) return true;
auto & st = lctx->copy_experts;
// the ids must be computed before the split starts, so only the first node of the split is considered if (ggml_graph_n_nodes(graph) == 0) return false; const ggml_tensor * node = ggml_graph_node(graph, 0); if (node->op != GGML_OP_MUL_MAT_ID || node->src[0] != dst) return false;
const ggml_tensor * ids = node->src[2]; if (ggml_nelements(ids) == 0) return true;
const int64_t n_expert = src->ne[2]; const size_t expert_size = src->nb[2];
if (ids != st.ids || (int64_t) st.used.size() != n_expert) { st.ids_data.resize(ggml_nbytes(ids)/sizeof(int32_t)); ggml_backend_tensor_get_async(backend, ids, st.ids_data.data(), 0, ggml_nbytes(ids)); ggml_backend_synchronize(backend);
st.used.assign(n_expert, false); for (int64_t i1 = 0; i1 < ids->ne[1]; i1++) { for (int64_t i0 = 0; i0 < ids->ne[0]; i0++) { const int32_t id = st.ids_data[i1*ids->nb[1]/sizeof(int32_t) + i0*ids->nb[0]/sizeof(int32_t)]; GGML_ASSERT(id >= 0 && id < n_expert); st.used[id] = true; } } st.ids = ids; }
// group consecutive experts and copy them together for (int64_t first = 0; first < n_expert; ) { if (!st.used[first]) { first++; continue; } int64_t last = first; while (last + 1 < n_expert && st.used[last + 1]) last++;
int64_t next = first; for (int64_t e = first; e <= last && lctx->moe_cache; ) { const int64_t n = lctx->moe_cache->copy_experts(backend, src, dst, e, last); if (n == 0) { e++; continue; } if (next < e) { ggml_backend_tensor_set_async(backend, dst, (const uint8_t *) src->data + next*expert_size, next*expert_size, (e - next)*expert_size); } e += n; next = e; }
// copy a bit extra to ensure there are no NaNs in the padding of the last expert, this is necessary for MMQ in the CUDA backend const size_t offset = next*expert_size; const size_t padding = last < n_expert - 1 ? std::min<size_t>(expert_size, 512) : 0; const size_t size = (last + 1 - next)*expert_size + padding; if (size > 0) { ggml_backend_tensor_set_async(backend, dst, (const uint8_t *) src->data + offset, offset, size); }
first = last + 1; }
return true;}这段代码值得完整拆解,因为它把「MoE 推理的调度语义」直接写成了拷贝逻辑。
(1)触发条件极其精确。 只有当这个 split 的第一个节点是 GGML_OP_MUL_MAT_ID、且它的权重正是要拷贝的 dst 时才介入。MUL_MAT_ID 就是「按专家 id 分组做矩阵乘」,即 MoE 层。注释说明为什么只看第一个节点:「the ids must be computed before the split starts」——ids 必须在这个 split 开始前就算出来,所以只认第一个节点。这个约束反过来限制了图切分:ids 的计算节点必须在 MoE 的矩阵乘之前,且被安排在同一个或更早的 split。
(2)先读 ids、算出「这一批用到哪些专家」。 把 ids 张量异步读回 host(ggml_backend_tensor_get_async + synchronize),然后在 host 上扫一遍,把用到的专家在 st.used[] 里打标记。这是一次 host-device 往返,代价不小,所以结果被缓存:if (ids != st.ids || ...) —— 只有当 ids 张量换了、或专家数变了才重算。同一批内的所有 MoE 层复用同一份 used 标记(因为 ids 是同一批路由结果)。
(3)只上传用到的专家,且合并连续区段。 主循环 for (int64_t first = 0; first < n_expert; ) 扫描 used 数组,找出连续被使用的专家区间 [first, last],然后一次性把这一整段拷上去(ggml_backend_tensor_set_async(..., next*expert_size, (e-next)*expert_size))。这是个典型的「把随机访问合并成区间拷贝」优化:
- 如果按单个专家逐个上传(每个专家一个
set_async),调用次数等于激活专家数(Top-K × token 数,很容易上百),每次都是一次独立的 DMA 提交; - 按连续区间合并后,调用次数降到「连续段的个数」,而 MoE 的路由结果通常有明显的局部性(相邻 token 倾向选到相近的专家,加上代码里
topk-moe/mm-id的索引重排会先按专家排序,连续段很少)。
(4)MoE 缓存优先。 循环里的 lctx->moe_cache->copy_experts(...) 是另一层优化:如果配置了 moe_cache_size,部分专家权重可以常驻在设备显存里(llama_moe_cache),命中缓存的部分不走 host→device 上传,直接从设备内存拷。返回的 n 是命中的专家数,代码据此跳过这些区间(e += n; next = e;)——这是个「热专家常驻、冷专家按需上传」的分层策略,和 KV 缓存的分层思路同构(可参考站内 SGLang 源码完全拆解(十六):HiCache——三级 KV 缓存、分层前缀树与异步搬运 中分层缓存的记账方式)。
(5)padding 的 512 字节例外。 最后那段注释是全篇最具体的一处工程细节:
// copy a bit extra to ensure there are no NaNs in the padding of the last expert, this is necessary for MMQ in the CUDA backendconst size_t padding = last < n_expert - 1 ? std::min<size_t>(expert_size, 512) : 0;为什么要多拷最多 512 字节? 因为前面讲过,MMQ 的 tile 加载是无条件下标访问,读到 padding 里的内容必须确定(不能是 NaN/垃圾)。专家权重张量的最后一段会有 padding,如果只拷到 last 的末尾,padding 区域就是未初始化的设备内存——MMQ 读进去就可能算出 NaN。所以这里多拷一点宿主内存里的真实数据去覆盖 padding。「多搬 512 字节」是前面讲的无条件访存策略在 MoE 路径上的代价显式化——两节的内容在这里对上了。
(6)回调的返回值语义。 返回 true = 「我自己处理了这次拷贝,调度器别再管」;返回 false = 「我不管,走默认路径」。这让回调可以选择性地只接管 MoE 的权重上传,而把其他权重留给默认的 cpy_tensor_async。这是一种「拦截器」式的扩展方式:调度器不需要知道 MoE 的存在,模型层通过回调按需介入。
这一节想说明什么
把调度器执行路径与 kernel 放在同一篇里讲,是为了让一个因果关系显形:kernel 的性能设计会反向约束调度器与模型层。
- MMQ 的「无条件下标访问 + padding 清零」要求 → 决定了
bad_padding_clear情形必须退回 cuBLAS,也决定了 MoE 拷贝要多搬 512 字节; - MMQ 的「tile 共享内存 ≥ 48 KiB」要求 → 决定了共享内存不足的设备必须换算法;
- MoE 的「按专家分组矩阵乘」→ 决定了
MUL_MAT_ID必须作为 split 的第一个节点,否则拷贝回调无法拿到ids; - 后端是否实现
cpy_tensor_async→ 决定了跨后端切图是走异步事件链还是全同步兜底。
读推理框架源码时,kernel 层的约束往往比调度层更”硬”:调度层可以重排、可以回退、可以加回调,而 kernel 层的访存模式、对齐要求、共享内存尺寸是不可谈判的。这一篇把两边放在一起,就是想把这层关系讲清楚。
小结
七篇下来,llama.cpp 的执行侧可以概括成六个判断:
第一,后端抽象是三层的,而不是一层的。 ggml_backend_device_i 声明能力(supports_op/supports_buft/get_memory)、ggml_backend_i 负责执行(graph_compute/异步拷贝/事件)、ggml_backend_buffer_type_i 管内存(alloc_buffer/get_alloc_size/is_host)。设备与执行流分开,是为了让「一块硬件」与「一条执行序列」解耦——同一设备可以有多个流,同一流可以访问多种缓冲区。
第二,CUDA 后端的骨架由三样东西撑起来:能力表、显存池、派发树。 ggml_cuda_device_info 里的 cc/smpbo/warp_size/vmm 四个字段贯穿全篇;两种显存池(pool_leg 的 malloc 式与 pool_vmm 的虚拟内存式)决定碎片表现;ggml_cuda_mul_mat 的五条分支按「量化类型 → 批量大小 → 硬件能力」逐层收窄,顺序本身就是优先级。
第三,MMQ 的每一个设计都在回答「怎么让量化格式对接硬件指令」。 激活量化成 q8_1(带宽降到 1/4、可用 __dp4a)、block_q8_1_mmq 的 128 元素对齐(字节数与寄存器宽度对齐)、4-bit 交错成 int8 数组(格式适配)、scale 与 sum(qs) 预计算(内积路径只剩乘加)、J_best 的十行循环(配置存在性 → SRAM 容量 → tile 数最小化)、stream-K 的 90% 效率阈值(负载均衡换一次 fixup kernel)。这些全是为了让「已经量化好的权重」不必展开就能参与矩阵乘。
第四,FlashAttention 侧的核心是派发决策,而非单一内核。 三族内核(vec / tile / mma-f16)由 ggml_cuda_get_best_fattn_kernel 按「头维白名单 → GQA 可复用性 → 架构能力 → 批量阈值」选出。GQA 复用(gqa_ratio_eff 取 2 的幂)是解码注意力能利用 GPU 的前提,而 192/128、320/256 这类「QK 头维 ≠ V 头维」的组合只走 MMA 路径,正是 MLA 结构的直接映射。vec 内核则展示了在线 softmax 在 GPU 上的最朴素形态:__shfl_xor_sync 做 warp 内归约、末尾用 shared memory 合并各 warp 的分段结果。
第五,CPU 后端的核心机制是 repack,而 repack 的本质是「把布局问题前置到装载期」。 通过「额外缓冲区类型」机制接入(与 AMX、KleidiAI、SpaceMIT 共用同一通道),由 ggml_repack_get_optimal_repack_type 按 ISA × 量化类型 × 交错粒度选方案,set_tensor 时重排、之后不可读回。不同 ISA 需要不同的交错粒度甚至不做交错(RISC-V 的 16x1),说明布局是 ISA 编程模型的后果而非通用的优化技巧。
第六,调度器执行侧的代价集中在「拷贝」上,而拷贝的形态由 kernel 约束决定。 先搬非权重输入再搬权重(为了回调能读到 ids)、n_inputs == 0 时的显式同步(内存复用保护)、事件链代替全局同步、cpy_tensor_async 失败即全同步兜底。MoE 的拷贝回调把「只上传用到的专家」与「合并连续区间」写在一起,末尾那 512 字节的 padding 多拷贝,是 MMQ 无条件访存策略在调度层的回声。
下一篇进入 llama.cpp 源码完全拆解(八):服务化与调度——tools/server/ 如何把一次前向变成多用户服务。前面七篇讲的都是「一次前向怎么算」,下一篇要讲「多个用户请求怎么排队、怎么共享上下文、怎么在流式输出下记账」:server-context 的槽位管理、连续批处理在 llama.cpp 里的形态、多序列共享 KV 的分支策略、以及 --parallel / --cont-batching 这些参数背后的实现。站内已有 连续批处理完全拆解:Orca 的迭代级调度与选择性批处理 与 vLLM 源码完全拆解(三):Scheduler.schedule 如何分配 Token 预算与 KV Block 从另外两个框架的角度讲过调度,下一篇补的是 llama.cpp 侧的最小实现。
参考资料
- llama.cpp 官方仓库(ggml-org/llama.cpp)
- ggml 后端接口与实现 ggml/src/ggml-backend-impl.h
- 后端调度器实现 ggml/src/ggml-backend.cpp
- CUDA 后端主体 ggml/src/ggml-cuda/ggml-cuda.cu
- 量化矩阵乘 MMQ 内核 ggml/src/ggml-cuda/mmq.cu 与 mmq.cuh
- MMQ 逐架构配置表 ggml/src/ggml-cuda/mmq-config-ampere.cuh
- MMQ 内积实现 ggml/src/ggml-cuda/mmq-vec-dot.cuh
- FlashAttention 派发与内核 ggml/src/ggml-cuda/fattn.cu 与 fattn-vec.cuh
- CPU 权重重排实现 ggml/src/ggml-cpu/repack.cpp
- CPU 后端主体 ggml/src/ggml-cpu/ggml-cpu.cpp
- SIMD 抽象层 ggml/src/ggml-cpu/simd-mappings.h
- 模型装载与缓冲区类型选择 src/llama-model.cpp
- 上下文与调度回调 src/llama-context.cpp
- 量化块与 GGUF 元数据结构 ggml/src/ggml-common.h
- T-MAC: CPU Renaissance via Table Lookup for Low-Bit LLM Deployment on Edge
- T-MAC 官方仓库(microsoft/T-MAC)
- Marlin: Mixed-Precision Auto-Regressive Parallel Inference on Large Language Models
- Marlin 官方仓库(IST-DASLab/marlin)
- FlashAttention-2: Faster Attention with Better Parallelism and Work Partitioning
- FlashAttention-3: Fast and Accurate Attention with Asynchrony and Low-precision
- Efficient and Accurate Low-Bit Quantization: k-quants 设计讨论(llama.cpp PR #1684)
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



