


llama.cpp 源码完全拆解(十六):LoRA 适配器——低秩补丁如何挂进 ggml 计算图
一个基座模型同时服务多个微调版本,是推理服务里很常见的一类需求:同一个 Llama、Qwen 或 DeepSeek 底座,上面挂着客服话术、代码补全、领域问答等若干 LoRA。把这些适配器全部合并进权重,意味着每个版本都要复制一份完整的基座模型;只保留一份基座、在推理时按请求临时叠加低秩增量,则可以把显存占用压到「一份权重 + 若干个小矩阵」。llama.cpp 选择了后者,但它实现这件事的方式和很多推理框架不同:LoRA 不是运行时替换指针,也不是先合并再算,而是在建图阶段把 B(Ax) 这条低秩分支直接拼进 ggml 计算图。
这个选择带来了一串连锁后果。图的节点数会随适配器数量增长,图缓存需要在适配器切换时失效,服务端必须保证同一个 batch 里的所有序列挂着同一组适配器,前缀缓存的复用边界也要跟着适配器的生效范围重新划线。本文沿着 llama-adapter.cpp、llama-graph.cpp、llama-context.cpp 与 tools/server/server-context.cpp 的真实代码,把这些机制一层层拆开。
为什么低秩增量可以「后加」
LoRA 的基本形式在原始论文里写得很清楚。对一个预训练权重矩阵 ,微调不再直接更新 ,而是学习两个低秩矩阵 与 ,前向变成:
其中 是输入向量, 是秩, 是缩放超参数。这个式子最重要的性质是线性可加:基座权重和低秩增量作用在同一个输入上,输出直接相加。因此推理时完全不需要把 先加进 ,只要分别算一次基座矩阵乘和一次「先降维、再升维」的矩阵乘,再把结果加起来。
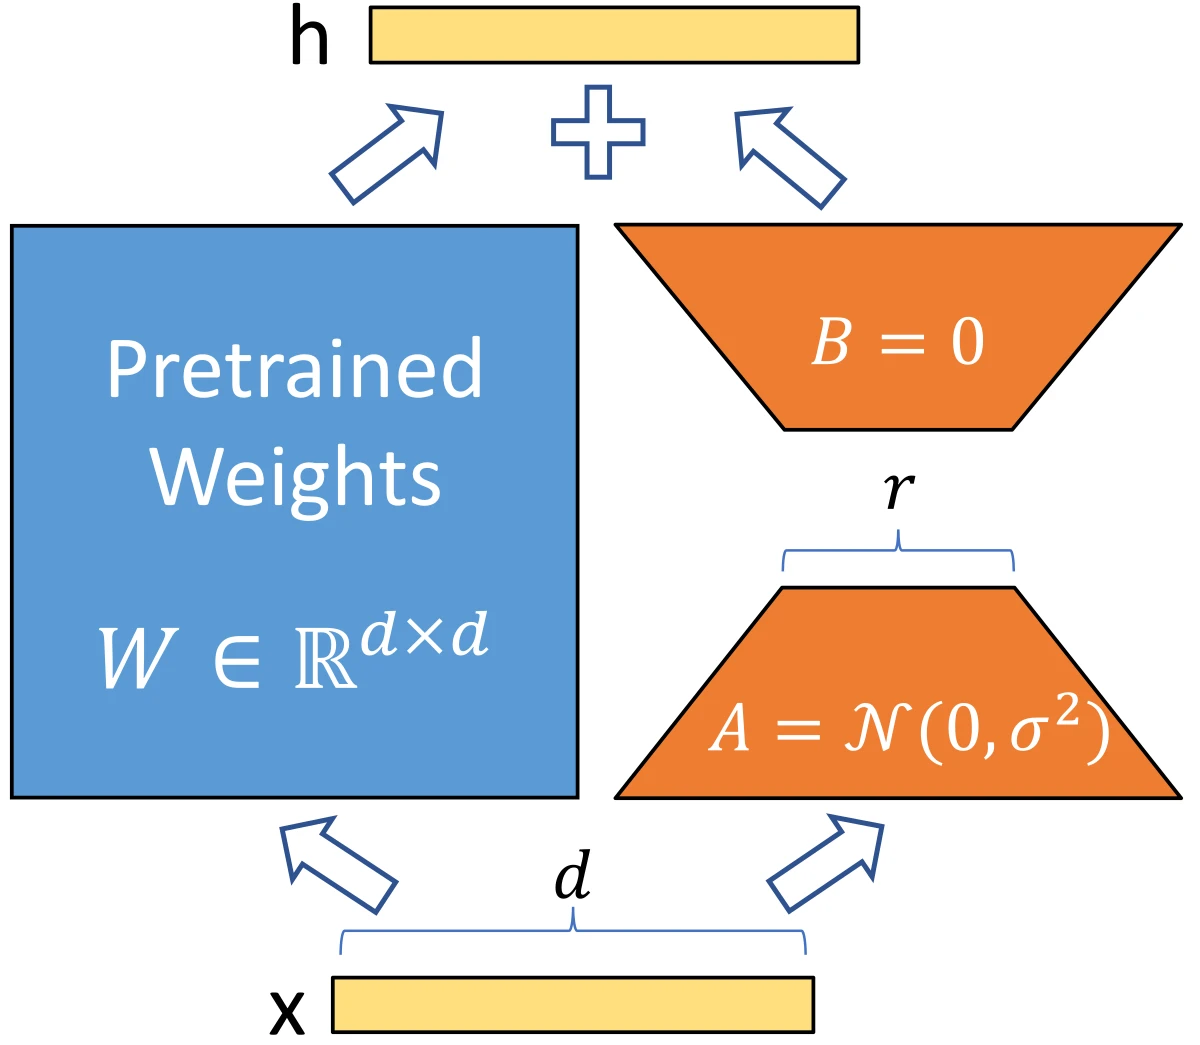
图里的两条路径正好对应 llama.cpp 建图时的两个分支:左边是原始权重 的矩阵乘,右边是 先投影到秩空间、 再投影回输出空间。注意图中的 是随机初始化、 是零初始化;这只是训练时的安排,推理侧只关心两个矩阵已经学好的数值。
从算术量看,未合并的 LoRA 对每个 token 多做 次乘加(先 再 ),而基座矩阵乘是 次。以 、 为例,低秩分支只增加约 的乘加量。但在 decode 阶段,瓶颈通常不是算力而是显存带宽:每生成一个 token 都要把整套权重从 HBM 读一遍,LoRA 分支额外读取的 、 很小,代价主要是多出来的 kernel launch 与中间张量。也正因为如此,「合并进权重」在大 batch、固定适配器的场景更划算,而「图内叠加」在多租户、频繁切换适配器的场景更灵活。
缩放系数到底乘在哪
llama.cpp 没有把 预先乘进 或 ,而是在图里对低秩分支的输出做一次 ggml_scale。llama_adapter_lora_weight::get_scale 的实现是:
float get_scale(float alpha, float adapter_scale) const { const float rank = (float) b->ne[0]; const float scale = alpha ? adapter_scale * alpha / rank : adapter_scale; return scale;}这段代码有三个容易看漏的点。
第一,rank 取的是 b->ne[0],不是 a->ne[0]。ggml 的矩阵按列主序理解,b 的逻辑形状是 (ne[0]=r、ne[1]=d),所以 ne[0] 正是秩。第二,adapter_scale 是调用方传入的运行时缩放,服务端用它支持「同一个适配器按不同强度挂载」;alpha 是文件里记录的训练超参。两者相乘后再除以秩,才是 LoRA 论文里的 。第三,如果文件里没有写 adapter.lora.alpha,gguf_get_val_f32 返回 0,代码走 adapter_scale 分支,相当于把 视为 1。这不是错误,而是兼容旧文件的约定:早期导出的适配器可能没有 alpha 字段,此时缩放完全由调用方控制。
把缩放放在图里而不是预乘进权重,还有一个实际好处:同一份适配器可以用不同 scale 挂到不同请求上,不需要为每个强度复制一份权重。代价是每次前向都要多一个 scale 节点,节点数要计入图预算。
GGUF 里的适配器长什么样
llama.cpp 不认识 PyTorch 的 .bin 或 PEFT 的 adapter_model.bin,它只认 GGUF。一个 LoRA 文件本质上是一个特殊的 GGUF:元数据声明自己是 adapter,张量名按「基座张量名 + .lora_a / .lora_b」组织。llama_adapter_lora_init_impl 在装载时做了四类检查,每一类都对应一种常见的适配器错误。
元数据:先确认「你是谁、挂在谁身上」
装载入口先调用 gguf_init_from_file_ptr 读元数据,然后逐项校验:
auto general_type = get_kv_str(llm_kv(LLM_KV_GENERAL_TYPE));if (general_type != "adapter") { throw std::runtime_error("expect general.type to be 'adapter', but got: " + general_type);}
auto general_arch_str = get_kv_str(llm_kv(LLM_KV_GENERAL_ARCHITECTURE));auto general_arch = llm_arch_from_string(general_arch_str);if (general_arch != model.arch) { throw std::runtime_error("model arch and LoRA arch mismatch");}
auto adapter_type = get_kv_str(llm_kv(LLM_KV_ADAPTER_TYPE));if (adapter_type != "lora") { throw std::runtime_error("expect adapter.type to be 'lora', but got: " + adapter_type);}
adapter.alpha = get_kv_f32(llm_kv(LLM_KV_ADAPTER_LORA_ALPHA));general.type=adapter 把 LoRA 文件与普通模型文件区分开;general.architecture 必须和基座模型一致,否则即使张量名碰巧相同,旋转位置编码、注意力布局也可能不同;adapter.type=lora 则给未来其他适配器类型(例如控制向量、AdaLoRA)留了扩展位。adapter.alpha 缺失时取 0,前面已经解释过它的后果。
元数据里还有一个可选字段 adapter.alora.invocation_tokens,它是一个 uint32 数组。aLoRA 用这个数组记录「激活词序列」的 token id,服务端会在 prompt 里倒序扫描这段序列,决定从哪个位置开始启用适配器。这个机制放在服务端一节展开。
张量配对:.lora_a 与 .lora_b
读完元数据后,代码遍历 GGUF 里的所有张量,按后缀配对:
for (ggml_tensor * cur = ggml_get_first_tensor(ctx.get()); cur; cur = ggml_get_next_tensor(ctx.get(), cur)) { std::string name(cur->name); if (str_endswith(name, ".lora_a")) { replace_all(name, ".lora_a", ""); if (ab_map.find(name) == ab_map.end()) { ab_map[name] = llama_adapter_lora_weight(cur, nullptr); } else { ab_map[name].a = cur; } } else if (str_endswith(name, ".lora_b")) { replace_all(name, ".lora_b", ""); if (ab_map.find(name) == ab_map.end()) { ab_map[name] = llama_adapter_lora_weight(nullptr, cur); } else { ab_map[name].b = cur; } } else if (str_endswith(name, "_norm.weight")) { // TODO: add support for norm vector continue; } else { throw std::runtime_error("LoRA tensor '" + name + "' has unexpected suffix"); }}配对后的 key 是基座张量名,例如 blk.0.attn_q.weight;value 是一对 a、b 指针。任何不在这三类后缀里的张量都会直接抛异常,这是刻意的严格:适配器文件里出现未知张量,通常意味着导出脚本版本不对,静默忽略只会让错误更难查。
_norm.weight 被显式跳过。LoRA 通常只训练线性层,LayerNorm/RMSNorm 的逐元素缩放不参与低秩分解;有些微调脚本会把 norm 参数也存进适配器,llama.cpp 选择不加载它。代码里的注释说「大多数适配器不带它也能正常工作」,这是一个明确的取舍:不支持的张量不报错,但也不会生效。
形状校验:为什么 token embedding 的 A/B 是反的
配对完成后,代码对每一对做形状检查。普通线性层的规则是:
if (model_tensor->ne[0] != w.a->ne[0] || model_tensor->ne[1] != w.b->ne[1]) { throw std::runtime_error("tensor '" + name + "' has incorrect shape ...");}if (w.a->ne[1] != w.b->ne[0]) { throw std::runtime_error("lora_a tensor is not transposed ...");}基座线性权重在 ggml 里是 (ne[0]=k 输入维、ne[1]=d 输出维),所以 A 必须是 、B 必须是 ,且 A->ne[1] == B->ne[0] == r。第二条检查专门拦截「旧版 finetune 脚本导出的转置 A」——那类文件的 A 是 ,与当前约定不兼容。
token embedding 是唯一的例外:
if (is_token_embd) { // expect B to be non-transposed, A and B are flipped; see llm_build_inp_embd() if (model_tensor->ne[0] != w.b->ne[1] || model_tensor->ne[1] != w.a->ne[1]) { throw std::runtime_error("tensor '" + name + "' has incorrect shape ..."); }}基座的 token_embd.weight 是查表矩阵 (ne[0]=d、ne[1]=V),它的「行」是词表项,不是线性层的输入维。LoRA 对查表的修正是给每个 token 的嵌入向量加一个低秩增量,因此 A 的形状是 、B 是 ,与普通线性层正好互换。图里对应的实现是 ggml_get_rows(lw->a, ids) 先取出每个 token 的 维向量,再用 ggml_mul_mat(lw->b, ...) 升到 维。这个例外如果写错,文件会在装载阶段就报 shape 错误,不会等到前向才炸。
还有一条与量化相关的检查:
if (model.hdmd.inverse_blocks.count(name)) { throw std::runtime_error("LoRA tensor '" + name + "' targets a prism.hadamard latent lookup table, which is not supported");}这是针对 Hadamard 旋转后的「latent lookup table」的保护。某些量化/压缩模型会把权重和 embedding 表旋转到另一个基再存储,LoRA 增量仍然定义在原始基里;如果直接挂到旋转后的表上,语义就错了。代码选择拒绝,而不是悄悄算错。
缓冲区:适配器跟着基座张量走
形状通过后,适配器张量并不会统一放到 CPU。代码先找到基座张量所在的 buffer type,再为每种 buffer type 建一个 ggml_context:
auto * buft = ggml_backend_buffer_get_type(model_tensor->buffer);// do not load loras to extra buffer types (i.e. bufts for repacking) -> use the CPU in that casefor (auto & ex : buft_extra) { if (ex == buft) { LLAMA_LOG_WARN("%s: lora for '%s' cannot use buft '%s', fallback to CPU\n", ...); buft = ggml_backend_dev_buffer_type(cpu_dev); break; }}这样做的原因是前向时 A、B 要和基座权重做矩阵乘,放在同一个设备上可以避免每层都跨设备拷贝。如果基座张量使用了「repacking」之类的特殊 buffer(例如某些 CPU 后端为量化权重准备的重排缓冲),LoRA 无法直接复用,代码会退回 CPU buffer,并打一条 warning。这条 fallback 在纯 GPU 部署里很少触发,但在 CPU 后端或混合后端里会出现,日志里看到 fallback to CPU 就说明该层的低秩分支会走主机内存。
最后,适配器被注册进模型:
model.loras.insert(&adapter);llama_model 里的 loras 是一个 unordered_set<llama_adapter_lora *>,只负责「这个适配器还活着」;具体哪些适配器参与当前前向,由 llama_context 决定。这个两级所有权是后面所有生命周期问题的根源。
从 PEFT 到 GGUF:导出链上的转置约定
源码之外,适配器能不能被 llama_adapter_lora_init 正着装载,几乎完全取决于导出脚本。convert_lora_to_gguf.py 做的是「把 PEFT 的命名和张量约定翻译成 ggml 期望的约定」:
is_lora_a = ".lora_A.weight" in name or ".lora_embedding_A" in nameis_lora_b = ".lora_B.weight" in name or ".lora_embedding_B" in name...for name, tensor in tensor_map.items(): assert tensor.A is not None assert tensor.B is not None yield (name, cast(torch.Tensor, LoraTorchTensor(tensor.A, tensor.B)))PEFT 的 lora_A 是 nn.Linear 的权重,PyTorch 里形状为 ,转成 ggml 的 要做一次整体转置;这个转置由 LoraTorchTensor 的 get_lora_A_B() 统一完成,所有架构共用同一套逻辑。脚本里唯一单独处理的是 token embedding:
# here we only need to transpose token_embd.lora_a, see llm_build_inp_embd()if "token_embd.weight" in dest_name: lora_a = lora_a.T这行注释直接点回了图构建代码,也印证了前一节的形状契约:embedding 的 lora_a 在 GGUF 里存成 ,比普通线性层多一次转置。
导出脚本还负责写元数据:
self.gguf_writer.add_string(gguf.Keys.General.TYPE, "adapter")self.gguf_writer.add_string(gguf.Keys.Adapter.TYPE, "lora")self.gguf_writer.add_string(gguf.Keys.General.ARCHITECTURE, ...)self.gguf_writer.add_float32(gguf.Keys.Adapter.LORA_ALPHA, self.lora_alpha)lora_alpha 来自 PEFT 配置里的 lora_alpha;注意它是训练时的 alpha,不是已经除过秩的值。装载端再除以秩,两边约定必须一致,否则挂载后的输出会整体缩放错位。这是「同一份文件在不同框架里行为不同」最常见的原因:有的框架导出时就把 乘进了 B,再在 llama.cpp 里加载就会得到双重缩放。
除了直接挂载,llama.cpp 还提供了 export-lora 工具,把基座权重与一个或多个适配器合成为普通模型文件。它用同一个 scale 公式做一次离线的图计算:
const float alpha = adapters[i]->alpha;const float rank = (float) inp_b[i]->ne[0];const float scale = alpha ? adapters[i]->scale * alpha / rank : adapters[i]->scale;delta = ggml_scale(ctx0, delta, scale);cur = ggml_add(ctx0, delta, cur);这里同样从 inp_b[i]->ne[0] 取秩、同样处理 alpha 缺失的情况,说明「缩放口径」在加载路径和合并路径上是统一的。合并工具还把基座解量化到 F32 再累加,最后转回输出类型,这在数值上是更干净的做法,但产物是完整权重,失去了「一份基座 + 多个小适配器」的灵活性。
真正的核心:建图时如何把低秩分支拼进去
装载完成只是准备了张量,适配器真正影响推理的地方在 llama-graph.cpp。llama.cpp 把一个适配器对某个权重的修正封装成 build_lora_mm:
ggml_tensor * llm_graph_context::build_lora_mm( ggml_tensor * w, ggml_tensor * cur, ggml_tensor * w_s) const { ggml_tensor * cur_mm = build_hadamard_input(w, cur); ggml_tensor * res = ggml_mul_mat(ctx0, w, cur_mm);
if (w_s) { res = ggml_mul(ctx0, res, w_s); }
for (const auto & lora : *loras) { llama_adapter_lora_weight * lw = lora.first->get_weight(w); if (lw == nullptr) { continue; }
const float adapter_scale = lora.second; const float scale = lw->get_scale(lora.first->alpha, adapter_scale);
ggml_tensor * ab_cur = ggml_mul_mat( ctx0, lw->b, ggml_mul_mat(ctx0, lw->a, cur) );
ab_cur = ggml_scale(ctx0, ab_cur, scale); res = ggml_add(ctx0, res, ab_cur); }
return res;}这段不到三十行的函数,是理解 llama.cpp LoRA 的关键节点,它包含四层机制。
第一层,基座分支不变。 ggml_mul_mat(ctx0, w, cur_mm) 仍然是原始的权重矩阵乘;w_s 是 per-tensor 的量化缩放,按原逻辑乘上。适配器不会改变基座的量化路径——这就是为什么 GGUF 适配器必须用 F16/F32 存储,而基座可以是任意量化格式:量化只发生在 w 上,A、B 保持浮点。
第二层,按张量名查找。 get_weight(w) 用 w->name 在 ab_map 里查这一层有没有对应的适配器。不同架构的层命名不同,但都通过基座张量名对齐,所以一个适配器只覆盖它训练过的那些层;没有覆盖的层 lw == nullptr,直接跳过,不产生任何节点。
第三层,每个适配器各建一条 B(Ax)。 注意循环是 for (const auto & lora : *loras),loras 是当前 context 上激活的适配器集合。也就是说,同一个权重可以叠加多个适配器,它们各自的低秩增量被依次加起来。图里每条分支都是「先 A 降维、再 B 升维」,中间张量的宽度是秩 ,所以激活 个适配器会额外产生 个矩阵乘节点。
第四层,缩放节点单独存在。 ggml_scale 把 乘到分支输出上才相加。把 scale 放在相加之前而不是预先乘进 B,是为了让同一份 B 支持任意强度的挂载;代价是多一个节点,但它位于低秩分支末端,对计算量没有实质影响。
Hadamard 折叠权重与原型基输入
build_lora_mm 第一行 build_hadamard_input(w, cur) 在大部分模型里是恒等变换,但在使用了 Hadamard 折叠权重的模型(见前文「Hadamard latent lookup table」的拒绝检查)里,它会先把输入变换到权重所在的基,再和折叠权重做矩阵乘。低秩分支却直接读取原始的 cur,而不是变换后的 cur_mm。代码注释解释得很直接:
// a Hadamard-folded weight reads the transformed input; a LoRA delta lives in the primal basis and reads `cur`也就是说,A、B 是在未旋转的原始坐标系下训练出来的,即使基座权重被旋转到另一个基存储,低秩增量依然作用在原始输入上。这条区分如果不看注释,很容易把 cur_mm 顺手传给低秩分支,结果就是静默的数值错误——不会报错,只会让输出逐渐偏离。
MoE 专属的 build_lora_mm_id
专家层不能用普通矩阵乘:每个 token 只走 Top-K 个专家,权重按专家 id 路由。llama.cpp 为它单独写了 build_lora_mm_id:
ggml_tensor * cur_mm = build_hadamard_input(w, cur);ggml_tensor * res = slots == nullptr ? ggml_mul_mat_id(ctx0, w, cur_mm, ids) : ggml_mul_mat_id(ctx0, moe_cache->get_experts(w), cur_mm, slots);...for (const auto & lora : *loras) { llama_adapter_lora_weight * lw = lora.first->get_weight(w); if (lw == nullptr) { continue; }
const float alpha = lora.first->alpha; const float rank = (float) lw->b->ne[0]; const float scale = alpha ? lora.second * alpha / rank : lora.second;
ggml_tensor * ab_cur = ggml_mul_mat_id( ctx0, lw->b, ggml_mul_mat_id(ctx0, lw->a, cur, ids), ids );
ab_cur = ggml_scale(ctx0, ab_cur, scale); res = ggml_add(ctx0, res, ab_cur);}关键在两次 ggml_mul_mat_id:A 的矩阵乘也按 ids 路由。lw->a 的专家维是 n_expert,ids 指定每个 token 用哪个专家的 A;B 同理。这和基座分支的 ggml_mul_mat_id 语义一致——「对每个 token 取它选中的专家,做一次批量化矩阵乘」。如果把低秩分支写成普通 ggml_mul_mat,就会出现所有 token 共用同一个专家的 A,MoE 的 LoRA 语义就错位了。
注意这里 slots 参数只影响基座分支,不影响低秩分支:专家缓存按槽位换入换出的是基座权重,LoRA 的 A、B 仍按逻辑专家 id 索引。这要求 LoRA 的专家维与逻辑专家数一致,也意味着 MoE 的 LoRA 文件通常比注意力层的 LoRA 大得多——每个专家一对 A、B。
嵌入层:查表后再加增量
token embedding 不是矩阵乘,而是查表。build_inp_embd 里的低秩分支因此换了一种写法:
for (const auto & lora : *loras) { llama_adapter_lora_weight * lw = lora.first->get_weight(tok_embd); if (lw == nullptr) { continue; }
const float adapter_scale = lora.second; const float scale = lw->get_scale(lora.first->alpha, adapter_scale);
ggml_tensor * inpL_delta = ggml_scale(ctx0, ggml_mul_mat( ctx0, lw->b, // non-transposed lora_b ggml_get_rows(ctx0, lw->a, ids) ), scale);
cur = ggml_add(ctx0, cur, inpL_delta);}先用 ggml_get_rows(lw->a, ids) 把每个 token 的 维低秩向量取出来,再用 lw->b 升到 n_embd 维,乘以 scale 后加到查表结果上。这正是前一节里 A 的形状被定为 的原因:A 的「行」是词表项,和基座 embedding 表一样按 token id 索引。
lm_head 如果与 embedding 共享权重(tied),则走的是 build_logits 里的普通 build_lora_mm,因此同一个 token_embd 适配器对输入嵌入和输出投影都生效。这也是导出脚本会警告「适配器里有 lm_head 但基座忽略它」的原因:tied 模型只保留一份表,两个方向的修正是同一个对象。
图会变长:节点预算与图复用
既然 LoRA 是建图期拼进图里,它就必须回答两个工程问题:图的节点预算怎么算、图的复用怎么失效。
llama_context::graph_max_nodes 在计算最坏情况的节点数时,把每个已注册适配器贡献的节点数直接加了进去:
res = std::max<uint32_t>(1024u, 8u*model.n_tensors());for (const auto & lora : model.loras) { res += lora->get_n_nodes();}而 get_n_nodes 的定义是每个权重 6 个节点:
uint32_t get_n_nodes() const { return ab_map.size() * 6u; // a, b, scale, add, 2 x mul_mat}6 这个数字是一个保守预算,不是一次前向的逐节点普查。对一条最普通的低秩分支,实际节点是 A 矩阵乘、B 矩阵乘、scale、add 四个;但源码还要覆盖带 w_s 的量化缩放、Hadamard 输入变换、以及不同架构里额外的 reshape/cont 等路径。注释里列的 a, b, scale, add, 2 x mul_mat 更接近「按分支上限留余量」的记法,而不是严格按 build_lora_mm 的函数体逐行数出来的结果。读这段代码时不要把 6 当成可以推导出的精确值,它的作用是保证最坏情况下 ggml_backend_sched 的节点数组不会越界。
这个预算有两个直接后果。第一,适配器数量越多,max_nodes 越大,ggml_backend_sched 和 llm_graph_result 的预分配就越大,启动显存/主存占用随适配器数线性增长。第二,这里的计数按已注册适配器算,而不是按当前激活的算;即使某个 context 只挂载其中一个,预算也会按全部注册量预留。对于「加载十几个适配器、每个请求只用其中一两个」的部署,这会偏保守,但不会溢出。
真正的切换发生在 llama_context::set_adapters_lora:
void llama_context::set_adapters_lora(llama_adapter_lora ** adapters, size_t n_adapters, float * scales) { if (adapters_lora_are_same(adapters, n_adapters, scales)) { return; }
loras.reset(new llama_adapter_loras());
for (size_t i = 0; i < n_adapters; i ++) { if (scales[i] != 0.0f) { loras->insert({adapters[i], scales[i]}); } }
sched_need_reserve = true;}三个细节都值得展开。
adapters_lora_are_same 先做幂等判断。 它逐对比较指针与 scale,并忽略 scale == 0 的项,再比较「非零项数量」是否等于当前 loras 的大小。这个比较避免了一个常见陷阱:服务端每个 batch 都会调用一次 set_adapters_lora,如果每次都重建 loras,图复用将永远无法命中。
loras 被整体替换。 新的 unordered_map 通过 reset 换掉旧的,指针本身发生变化。这一点与图复用紧密相关,见下文。
sched_need_reserve = true。 下一次 sched_reserve() 会重建最坏情况图、重新计算 max_nodes、重新分配调度器缓冲区。适配器集合变化是「图结构变化」的一类,必须让调度器重新做内存规划。
loras 也是图复用判定的输入。llm_graph_params::allow_reuse 的最后一段条件里有一项:
return cparams.embeddings == other.cparams.embeddings && ... cvec == other.cvec && loras == other.loras && cross == other.cross;loras 是 const llama_adapter_loras *,比较的是指针。由于 set_adapters_lora 每次都 reset 出一个新的 map,只要适配器集合真的变了,指针就一定不同,旧的图结果不会被复用;而 adapters_lora_are_same 的幂等判断保证了「集合没变」时指针也不变,图可以正常复用。也就是说,这里用「指针身份」代替了「内容相等」,逻辑成立的前提正是前面的幂等判断——两处代码必须配合着看,单看任何一处都会觉得奇怪。
生命周期:谁拥有适配器
适配器的所有权分成两级:llama_model 的 loras 集合只登记「还活着」的适配器,llama_context 的 loras 映射记录「当前挂在哪」。释放时只清理第一级:
void llama_adapter_lora_free(llama_adapter_lora * adapter) { if (adapter == nullptr) { return; }
if (adapter->model != nullptr) { adapter->model->loras.erase(adapter); adapter->model = nullptr; }
delete adapter;}llama.h 里的注释说得很明确:加载的适配器如果没有手动释放,会在关联模型销毁时一起释放。这带来两条使用规则。
第一,如果先调用了 llama_adapter_lora_free,但某个 context 的 loras 映射里还挂着这个指针,那么下一次前向就会读到悬垂指针。安全的顺序是:先对所有 context 调 llama_set_adapters_lora 传入空列表,再释放适配器。这不是 llama.cpp 内部会帮你防守的事情——set_adapters_lora 只保存指针,不持有所有权。
第二,模型销毁时会释放所有已注册适配器,但 context 必须在模型之前销毁。这是 llama.cpp 一贯的层级约定,LoRA 只是其中一个受影响对象。
还有一个小接口容易被忽略:llama_adapter_meta_* 系列函数可以让调用方枚举适配器 GGUF 里的元数据(adapter.lora.task_name、adapter.lora.prompt_prefix 等)。GET /lora-adapters 接口返回的适配器列表里就带着这些字段,因此导出脚本写入的 task_name 和 prompt_prefix 不只是装饰,它们会影响 UI 里适配器的可读性。
单适配器的前向调用顺序
把前面零散的 API 串起来,一个完整的单适配器推理流程是这样的:
// 1. 加载基座llama_model * model = llama_model_load_from_file(model_path, mparams);
// 2. 加载适配器(会注册进 model->loras)llama_adapter_lora * lora = llama_adapter_lora_init(model, lora_path);
// 3. 创建 contextllama_context * ctx = llama_init_from_model(model, cparams);
// 4. 挂载,scale 由调用方决定llama_adapter_lora * adapters[] = { lora };float scales[] = { 1.0f };llama_set_adapters_lora(ctx, adapters, 1, scales);
// 5. 正常 decode —— 图里已经带上低秩分支llama_decode(ctx, batch);
// 6. 切换或卸载llama_set_adapters_lora(ctx, nullptr, 0, nullptr);第 4 步的 scale 是「运行时强度」,与文件里的 alpha 相乘后除以秩才进入图;设为 0 等价于卸载,因为 set_adapters_lora 会跳过零 scale 项。第 6 步传入空列表,loras 变为空 map,下一次 sched_reserve 把图缩回不带 LoRA 的形态。
第 2 步加载的适配器张量是按「基座张量所在的设备」分配的,第 3 步创建的 context 决定了 loras 映射挂载哪些适配器。一个适配器可以被多个 context 同时挂载,因为张量本身是共享只读的;这也是 loras 映射存指针而不是复制张量的原因。反过来,一个模型可以有多个 context 各自挂不同的适配器组合——这一点在批处理服务里会被用来做「适配器隔离」,但 llama-server 的当前实现并没有走这条路,原因在下一节。
适配器集合的另两种用法:持久挂载与全局切换
llama_context 的 loras 映射是「当前集合」,但服务端有两套不同的入口去修改它,理解它们的差异能避免一类排查困难的问题。
第一种是启动即挂载。--lora path 或 --lora-scaled path:scale 把适配器加入 params.lora_adapters,加载基座时 common_init_from_params 会逐个 llama_adapter_lora_init,随后调用一次 common_set_adapter_lora(lctx, params.lora_adapters)。这类适配器从此一直挂在 context 上,所有请求默认携带它们,scale 由启动参数决定。--lora-scaled 的意义在于同一份适配器文件可以用不同强度挂载,例如对某个领域适配器整体减半。
第二种是运行时全量替换。POST /lora-adapters 对应 SERVER_TASK_TYPE_SET_LORA 任务,请求体是 [{ "id": 0, "scale": 0.8 }, ...] 这样的索引数组。它的处理路径是:
auto new_loras = construct_lora_list(task.set_lora);params_base.lora_adapters = new_loras;注意这里改的是 params_base.lora_adapters,也就是全局默认集合。之后启动的请求如果没有带 per-request lora 字段,会走 slot.lora = params_base.lora_adapters,从而继承全局设置。--lora-init-without-apply 是它的配套开关:启动时只加载不挂载,等客户端通过 POST /lora-adapters 决定初始状态。GET /lora-adapters 则返回当前列表,并附带把 aLoRA 的 invocation token 还原成可读字符串——这就是前面提到的 llama_adapter_get_alora_invocation_tokens 的用途。
需要注意,这三种入口最终都落到同一个 set_adapters_lora,但触发时机不同:
| 入口 | 修改对象 | 何时生效 | 影响范围 |
|---|---|---|---|
--lora / --lora-scaled | 启动时挂载 | 下一次前向 | 所有请求 |
POST /lora-adapters | 全局默认集合 | 之后启动的请求 | 不带 lora 字段的请求 |
请求体 lora 字段 | 单个 slot | 该请求所在 batch | 该请求 |
一个常见困惑是:调用 POST /lora-adapters 之后,某个已经在运行的请求并没有变。这不是 bug——它的 slot 在接纳时已经固定了适配器集合,正在执行的请求不会被中途改写;即使后续同 slot 继续解码,也不会重新读取全局默认。要改变生效范围,必须让新请求带上正确的 lora 字段,或等待已有请求结束。
另一个细节是:一个 slot 的 can_batch_with 比较的是整个 lora 向量,包括零 scale 的占位项。由于 construct_lora_list 总是返回与 params_base.lora_adapters 等长的向量,不同请求的选择在向量层面是「同一组适配器、不同强度」而不是「不同的子集」。这简化了比较逻辑,但也意味着切换全局集合时,所有 slot 的向量长度和顺序都会跟着变,已有的前缀缓存需要按 lora_should_clear_cache 的规则处理。
前缀缓存与适配器:复用边界怎么划
llama.cpp 的 slot 级前缀缓存 server_prompt 保存的是「已计算的 token 序列 + KV 检查点」,复用发生在两个层面。
第一层是同一 slot 内的增量续写。服务端用 get_common_prefix(input_tokens) 找出新旧 prompt 的公共前缀,从该位置继续计算。如果适配器没变,这段公共前缀的 KV 可以直接用。如果适配器变了,lora_should_clear_cache 在接纳时已经把 slot.prompt 清空,get_common_prefix 自然退化为 0,相当于从头算。
第二层是 llama.cpp 底层的跨 slot 缓存——它由 llama_memory 的实现决定,通常基于 token 序列的公共前缀(类似 RadixAttention 的简化版)。这一层不感知适配器:同一个 token 序列如果先被适配器 A 算过,后面被适配器 B 的请求命中,就会复用错误的 KV。因此服务端必须在前缀层面就把适配器隔离掉——这也是 lora_should_clear_cache 只能做到「整段清空」而不是「按适配器分区缓存」的原因。当前 llama.cpp 的缓存实现没有「按适配器打标签」的能力;需要精细隔离时,只能靠部署层面把不同适配器分配到不同 server 实例。
理解这一点,就能解释一个现象:在多适配器服务里,切换适配器后第一批请求的 TTFT 会明显变差,因为前缀缓存清空了;后续同适配器的请求又能重新命中。流量在适配器之间来回切换时,缓存命中率会被反复打断,这是 llama.cpp 多 LoRA 服务在「适配器切换频繁」负载下吞吐下降的主要来源之一,而不是低秩分支本身的计算开销。
服务端:一个 context 只能挂一组适配器
llama-server 的并发模型和 vLLM、SGLang 不同:它只有一个 llama_context,多个 slot 共享同一份 KV 缓存和同一个计算图。LoRA 的挂载状态属于 context,而不是 slot,因此「一个 batch 里的请求必须挂同一组适配器」不是优化选择,而是结构约束。
请求里的适配器选择
启动时 --lora 可以加载多个适配器,服务端把它们存成 params_base.lora_adapters,每个元素是 common_adapter_lora_info:
struct common_adapter_lora_info { std::string path; float scale;
std::string task_name; std::string prompt_prefix;
struct llama_adapter_lora * ptr;};请求里的 lora 字段不是一个路径列表,而是一个 {索引: scale} 的映射。服务端用 construct_lora_list 把它翻译成与基座列表等长的向量:
std::vector<common_adapter_lora_info> construct_lora_list(const std::map<int, float> & config) const { std::vector<common_adapter_lora_info> output = params_base.lora_adapters; // copy for (size_t i = 0; i < output.size(); ++i) { auto it = config.find(i); if (it != config.end()) { output[i].scale = it->second; } else { output[i].scale = 0.0f; } } return output;}这个设计有一个容易误解的地方:请求里没选的适配器不是「不存在」,而是 scale=0 的占位项。后续 are_lora_equal 会比较整个向量(包括零 scale 项),set_adapters_lora 则跳过零 scale 项。两者配合的结果是:选择集合变了,向量就不同,图要重建;集合没变,向量完全相同,图可以复用。
批兼容性:为什么不同 LoRA 不能同批
slot 在加入 batch 前要经过 can_batch_with:
return task->type == other_slot.task->type && inp_embd.size() == other_slot.inp_embd.size() && are_lora_equal(lora, other_slot.lora);are_lora_equal 逐项比较 scale 与 ptr:
bool are_lora_equal( const std::vector<common_adapter_lora_info> & l1, const std::vector<common_adapter_lora_info> & l2) { if (l1.size() != l2.size()) { return false; } for (size_t i = 0; i < l1.size(); ++i) { // we don't check lora.path to reduce the time complexity if (l1[i].scale != l2[i].scale || l1[i].ptr != l2[i].ptr) { return false; } } return true;}所以两个请求只要挂的适配器或强度不同,就不会进入同一个 batch。它们会被拆成两个 batch 依次执行;每个 batch 执行前,服务端调用一次:
common_set_adapter_lora(ctx_tgt, slot_batched->lora);这个函数只是把非空项展开成指针数组与 scale 数组,再转交 llama_set_adapters_lora。一个 batch 只设置一次,因为 batch 内所有 slot 的适配器已经保证相同。
这与 vLLM/SGLang 的「批内多适配器」形成鲜明对比。后者用 SGMV(Segmented Gather Matrix-Vector)一类内核,把不同 adapter 的低秩乘按段分组,一次 kernel 处理多个 adapter;llama.cpp 的 ggml 图里每条低秩分支是一个独立的 ggml_mul_mat,无法在同一张图里表达「这批 token 用 A、那批 token 用 B」。下图是 S-LoRA 的分离批量计算示意:基座 GEMM 统一批处理,adapter 计算走支持变长和变秩的自定义 kernel——这正是 llama.cpp 当前架构没有走的方向。
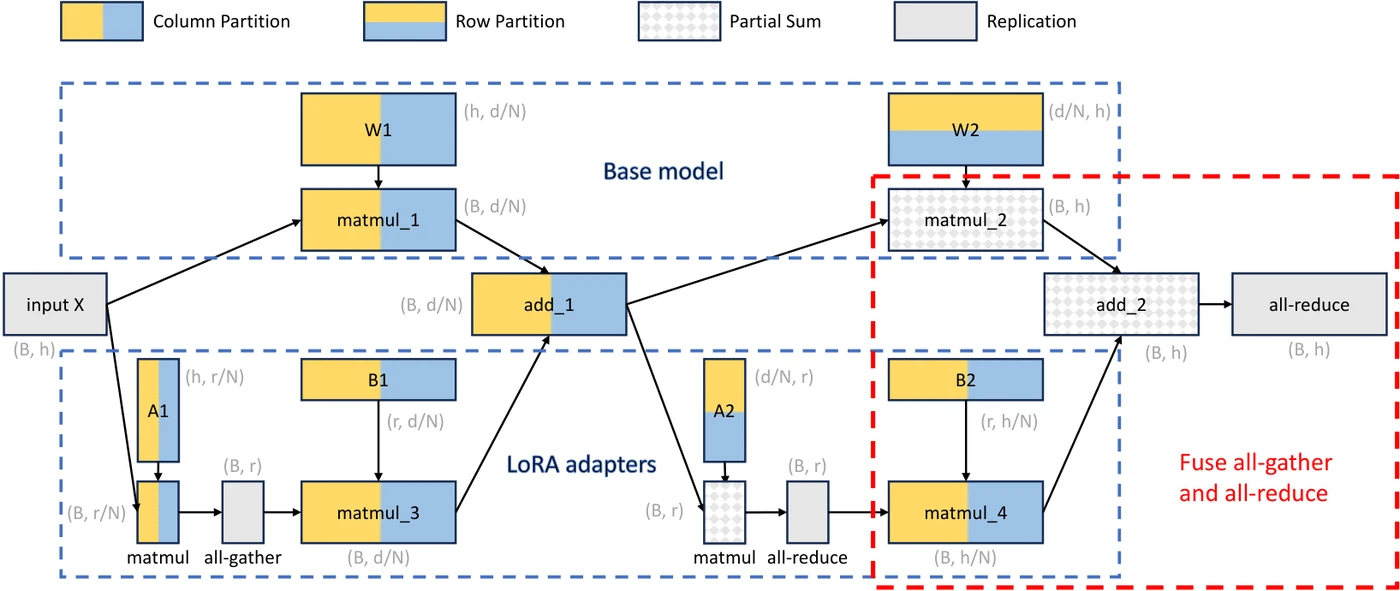
这个限制的代价取决于流量形态。如果同一时刻的请求大多共享同一个微调版本,batch 兼容性不会损失吞吐;如果请求在几十个适配器之间均匀分布,每个 batch 只能装同一适配器的请求,GPU 利用率会明显下降。llama.cpp 的定位是单机、端侧、轻量服务,这个取舍与它的整体设计一致;大规模多租户适配器服务通常会用 vLLM 的 Punica 或 SGLang 的 SGMV 路线。
切换适配器时,KV 缓存怎么办
前缀缓存复用的是旧前向算出的 KV。KV 里存的是「K/V 投影后的结果」,而 LoRA 会改变 k_proj、v_proj 等层的输出,因此用适配器 A 算出的 KV 不能直接给适配器 B 用。服务端用一个专门的判断处理这件事:
bool lora_should_clear_cache( const std::vector<common_adapter_lora_info> & current, const std::vector<common_adapter_lora_info> & next) { GGML_ASSERT(!are_lora_equal(current, next));
return ( !(lora_get_enabled_ids(current).empty() || lora_all_alora(current)) || !lora_all_alora(next));}这个布尔表达式看起来绕,拆开就是:只有当「当前没有启用任何适配器,或当前全是 aLoRA」且「下一组也全是 aLoRA」时,才不清缓存;其余情况一律清空 prompt 缓存。原因分两类:
- 普通 LoRA 一旦启用,KV 就带上了该适配器的印记;换到另一个普通 LoRA,必须重算。
- aLoRA 的特殊性在于它在激活词之前是「未启用」状态。服务端只缓存到激活词之前,因此这段 KV 与具体是哪个 aLoRA 无关;从 aLoRA A 换到 aLoRA B,前缀部分仍然可以复用。
lora_get_enabled_ids 只收集 scale > 0 的项,lora_all_alora 则要求所有启用项都带 invocation tokens。两个函数都忽略零 scale 项,和 set_adapters_lora 的口径一致。
aLoRA:让适配器在 prompt 中间生效
aLoRA 想解决的问题是:同一个请求的前半段用基座能力,读到某个触发词之后切换到某个微调人格/技能。它的实现不在图里,而在服务端的 token 扫描与 batch 切分。
launch_slot_with_task 在接纳请求时做一次倒序扫描:
int match_idx = static_cast<int>(n_invocation_tokens) - 1;for (int i = task.tokens.size() - 1; i >= 0; --i) { if (task.tokens[i] == invocation_tokens[match_idx]) { if (match_idx == 0) { alora_invocation_start = i; break; } --match_idx; } else { match_idx = static_cast<int>(n_invocation_tokens) - 1; }}
if (alora_invocation_start == task.tokens.size()) { slot.lora[enabled_ids[0]].scale = 0.0f;} else { slot.alora_invocation_start = alora_invocation_start;}扫描从 prompt 末尾往前找「最后一次出现」的激活序列。找不到就把该 aLoRA 的 scale 置 0,请求退化成纯基座;找到就记录起点。只允许一个启用的 aLoRA,多个会直接返回 Cannot run multiple aLoRAs in a single request——因为一个 context 不能在同一次前向里让不同 token 走不同适配器。
真正的难点在 batch 组装。如果激活点之前的 token 还没有被缓存,它们必须不带适配器先算一遍;从激活点开始才挂上适配器。服务端为此做了三件事:
- 组 batch 时在激活点前一个 token 处截断:
if (alora_scale > 0 && slot.prompt.n_tokens() == slot.alora_invocation_start - 1) { SLT_DBG(slot, "stop prompt batch filling at (n_tokens = %d, alora_invocation_start = %d)\n", ...); break;}- 这一批执行前,临时把 aLoRA 的 scale 设为 0:
alora_scale = slot.lora[enabled_loras[0]].scale;slot.lora[enabled_loras[0]].scale = 0.0f;alora_disabled_id = enabled_loras[0];- batch 执行完后恢复 scale,下一批从激活点开始就带上适配器:
common_set_adapter_lora(ctx_tgt, slot_batched->lora);
if (alora_scale > 0.0f) { SLT_DBG("re-enabling alora with scale %f\n", alora_scale); slot_batched->lora[alora_disabled_id].scale = alora_scale;}缓存边界也一起调整。复用旧 prompt 时,n_past 被钳到激活点之前:
if (slot.alora_invocation_start > 0) { SLT_DBG(slot, "only caching to alora invocation start (n_past = %d, alora_invocation_start = %d)\n", ...); n_past = std::min(n_past, slot.alora_invocation_start - 1);}这条钳制保证「带适配器的 KV」永远不会被当成「不带适配器的 KV」复用。换句话说,aLoRA 的缓存复用只发生在激活点之前,激活点之后每次都要重算。对于「系统提示很长、触发词在末尾」的用法,这个代价可以接受;如果触发词出现在开头,收益就很小。
性能与工程取舍
把前面的机制合起来,可以列出 llama.cpp LoRA 在推理侧的真实成本。
图节点与调度器内存。 每个适配器按每权重 6 个节点预留,节点预算随注册适配器数增长。图复用依赖 loras 指针身份,切换适配器会触发 sched_need_reserve,下一次前向要重新 reserve 最坏情况图并重分配调度缓冲。对高频切换适配器的服务,这部分开销会进入尾延迟。
额外的矩阵乘与中间张量。 每个启用的适配器、每个被覆盖的权重,都多两次矩阵乘和一次 scale/add。decode 阶段单 token 的计算量增加很小,但 kernel launch 数增加明显;在小 batch、低延迟场景里,launch 开销可能比乘加本身更贵。llama.cpp 的图执行会把相邻节点融合/调度,但低秩分支是独立的 matmul,没法完全藏掉。
显存/内存占用。 适配器只存 A、B,单个线性层的大小是 个元素,和基座的 相比通常小两三个数量级。以一个 32 层、、FFN 中间维 的 7B 级模型为例,对 q/k/v/o 与 gate/up/down 七个线性层挂 :
| 项目 | 每层参数量 | 32 层合计 | F16 字节数 |
|---|---|---|---|
| 基座线性权重 | M | B | GB |
| LoRA() | M | M | MB |
也就是说,一份覆盖全部七个线性层的 rank-16 适配器只有约 80MB,约为基座线性权重的 0.6%。十个这样的适配器约 800MB,仍然远小于复制十份基座。rank 翻倍,适配器大小也翻倍;这个线性关系让 rank 成为最直接的「质量/内存」旋钮。
代价是每个适配器要按基座张量的 buffer type 分配一份独立缓冲,且注册后即使不启用也会计入节点预算(张量本身仍常驻)。加载几十个适配器时,预算和缓冲的碎片化比权重本身更值得关注。
batch 兼容性。 不同适配器的请求不能同批,这是 llama.cpp 与多租户推理框架最大的差距。它不会影响正确性,但会把「适配器分布均匀」的负载切成很多小 batch。判断是否该用 llama.cpp 做多 LoRA 服务,先看请求的适配器分布,而不是看单请求延迟。
合并 vs 热挂载。 如果某个适配器是长期主力、流量占比很高,export-lora 把它合并进基座往往更划算:图里不再有低秩分支,节点预算和 batch 兼容性问题都消失,代价是多一份完整权重。反过来,适配器多、切换频繁、显存紧张时,图内挂载是唯一现实的选择。llama.cpp 同时提供两条路径,正是为了让这个取舍留在部署侧,而不是框架侧。
常见错误与排查路径
装载阶段的异常信息都比较具体,按报错就能定位到导出链的哪一环。
| 报错 | 含义 | 排查方向 |
|---|---|---|
expect general.type to be 'adapter' | 文件不是适配器 GGUF | 是否误传了基座模型;导出脚本是否写入了 general.type |
model arch and LoRA arch mismatch | 适配器与基座架构不同 | 检查 general.architecture,确认适配器确实基于该基座训练 |
expect adapter.type to be 'lora' | 适配器类型不支持 | 当前只支持普通 LoRA;控制向量走 llama_set_adapter_cvec |
LoRA tensor '...' has unexpected suffix | 出现未知张量名 | 导出脚本版本;是否混入了 optimizer state 或 base layer |
LoRA tensor pair ... is missing one component | 只有 A 或只有 B | PEFT 目录不完整;合并脚本是否过滤掉了另一半 |
tensor '...' has incorrect shape | 形状与基座不符 | 基座版本不对;token_embd 的 A/B 转置是否按约定处理 |
lora_a tensor is not transposed | 旧版 finetune 导出格式 | 用当前 convert_lora_to_gguf.py 重新导出 |
targets a prism.hadamard latent lookup table | 适配器指向旋转后的查表 | 该量化模型不支持此类适配器,换非折叠基座或改用合并路径 |
运行时还有两类不属于「报错」的现象。
第一类是挂载成功但输出完全没变。常见原因是适配器只覆盖了模型没使用的层(例如只训练了 lm_head,而基座是 tied embedding 且导出时忽略了 lm_head),或者请求里的 scale 为 0。先看 llama_adapter_lora_init 日志里的 loaded N tensors,再确认 set_adapters_lora 传入的 scale 非零。
第二类是输出轻微漂移、困惑度变差。优先检查 alpha 口径:适配器文件里的 adapter.lora.alpha 是否与训练配置一致,导出时是否已经把 乘进了 B。llama.cpp 的公式是 adapter_scale * alpha / rank,任何一边多乘一次都会让低秩分支整体缩放错位。其次检查基座量化版本:LoRA 张量是 F16/F32,基座可以是量化权重,但两者的数值差异会在低比特基座上被放大;用同一份基座的 F16 版本对照一次,可以快速区分「适配器问题」和「量化误差」。
常见疑问
为什么 llama.cpp 不把 LoRA 合并进权重再算? 合并确实更快,export-lora 做的就是这件事。不默认合并的原因是灵活性:合并后每份适配器都要一份完整基座,而 llama.cpp 的典型部署是单机、模型常驻内存、适配器按需挂载。图内叠加让「一份基座 + N 份小矩阵」成为可能,代价是图变长、切换时重建。
能不能在一个 batch 里混合不同 LoRA? 在 llama.cpp 当前的图模型下不能。build_lora_mm 对所有 token 使用同一组适配器,图里没有「按 token 选择 adapter」的原语。服务端因此用 are_lora_equal 把不同适配器的 slot 拆到不同 batch。
LoRA 会影响 KV Cache 吗? 会。k_proj、v_proj 的输出被低秩增量改变了,所以用适配器 A 算出的 KV 不能给适配器 B 用。lora_should_clear_cache 在接纳请求时决定要不要清空前缀缓存;aLoRA 只在激活点之后受影响,因此缓存边界被钳到激活点之前。
alpha 缺失会不会算错? 不会算错,但语义会变。文件里没有 adapter.lora.alpha 时按 0 处理,缩放退化为 adapter_scale,相当于把 视为 1。加载和合并两条路径的公式一致,不会出现「加载缩放和合并缩放不同」。但如果你期望的是训练时的 ,那么确实少了一个缩放因子——这需要导出时写入 alpha。
为什么 token embedding 的 A/B 和线性层反着存? 因为 embedding 是查表,A 的「行」是词表项。A 存成 让 ggml_get_rows(lw->a, ids) 能按 token id 直接取出 维向量,B 再升到 维。装载时的形状校验和 convert_lora_to_gguf.py 的单独转置都围绕这个约定。
适配器加载了但输出没变化,怎么查? 先看日志里的 loaded N tensors;如果 N 为 0,说明 ab_map 为空。再确认请求的 scale 非零、set_adapters_lora 确实被调用。最后确认适配器覆盖的层确实参与前向:只训练 lm_head、而基座 tied 且导出忽略 lm_head 的适配器,在 llama.cpp 里就没有可挂载的目标。
与系列其他框架的对照
把 llama.cpp 的 LoRA 实现放回推理框架的全景里,差异就清楚了。vLLM 用 Punica 的 SGMV,在同一个 kernel 里按 adapter 分段处理 shrink/expand,并把 adapter 放在 GPU 槽位里按需换入;具体的槽位管理、按 token 的 adapter 映射和前缀隔离可以参考站内 vLLM 源码完全拆解(十八):多 LoRA 服务——adapter 槽位、Punica 低秩核与批内多租户路由。SGLang 在 S-LoRA 的内存池基础上做 SGMV,并显式校验 max_loras_per_batch,DP attention 下还要跨 rank gather 适配器 id,可参考 SGLang 源码完全拆解(十三):多 LoRA 服务——adapter 池、SGMV 内核与批内多适配器共存。TensorRT-LLM 把 adapter 当作可替换的权重块,按配置预分配 rank 维度的 workspace,详见 TensorRT-LLM 源码完全拆解(二十一):LoRA 服务——adapter 池、批内多适配器与前向替换的完整链路。
四者的共同点是「基座权重复用、低秩增量叠加」,分歧集中在三个问题上:
- 低秩增量在哪里计算。vLLM/SGLang/TensorRT-LLM 用专门内核在批维度上做分段 gather,一个 kernel 处理多个 adapter;llama.cpp 把每条分支做成图节点,由 ggml 调度器逐个执行。
- adapter 如何与 batch 共存。前三者允许同一个 batch 内按请求路由 adapter;llama.cpp 要求整个 batch 一组 adapter。
- adapter 的驻留与切换。前三者有显式的池、槽位与 LRU 策略;llama.cpp 的 adapter 张量在加载时按基座设备分配,常驻直到释放,切换只是改 context 上的指针集合。
第 3 点决定了吞吐上限,第 1 点决定了单 batch 内低秩计算的效率,第 3 点决定了「适配器很多、流量分散」时的内存与切换成本。llama.cpp 的选择在单机、少量适配器、流量集中的场景下没有明显劣势;一旦适配器数量和分布逼近多租户,架构差异就会直接反映成 batch 规模。
从读源码到改源码:几个可以落地的扩展点
如果要在 llama.cpp 上做 LoRA 相关的二次开发,有四个位置值得先看:
- 合并多个适配器为一份图内分支。
build_lora_mm里每个 adapter 建一条分支,如果多个 adapter 在同一个权重上、且秩相同,理论上可以把它们的A在秩维拼接、B做分块对齐后合成一条更大的低秩乘。这会把 条分支降成一条,减少节点与 launch 数,但需要保证拼接后的数值与逐条相加完全等价(B_i A_i分块求和即可),并且不能破坏get_scale的 per-adapter 缩放语义——只能在 adapter 的 scale 相同,或把 scale 预先乘进某一边时合并。 - 给前缀缓存加 adapter 标签。当前的清空策略是「一变就清」,粒度太粗。可以在
server_prompt或底层的 memory 实现里把「适配器集合指纹」作为缓存键的一部分,从而实现按适配器隔离的缓存;代价是需要重新设计缓存查找,以及处理 aLoRA 这种「同一请求内前半段无适配器」的分段情况。 - 按请求路由的低秩内核。要走 vLLM 那条路,需要在 ggml 里实现一个「带 token→adapter 映射的批量低秩乘」,让不同 adapter 的 token 在一个 kernel 里分别处理。这是架构级的改动,不是图节点层面的小修补,但它能解除 batch 兼容性约束。
- adapter 的按需加载与卸载。当前适配器加载后常驻。如果注册的适配器很多,可以引入类似 S-LoRA 的 LRU,按需把
A、B从主机搬到设备;llama_adapter_lora的张量本来就按 buffer 分配,卸载需要与set_adapters_lora的生命周期配合,避免悬垂指针。
这四个方向分别对应 llama.cpp LoRA 的四个瓶颈:图内分支数、缓存复用粒度、批处理兼容性、常驻内存。它们也正好是前面几个推理框架各自已经解决的问题——所以读 llama.cpp 的 LoRA 源码,不只是理解一个实现,也是在理解一个框架在「保持 ggml 静态图模型」这一约束下,能走多远、在哪里必须让位。
小结
llama.cpp 的 LoRA 实现可以概括成一句话:把适配器当作建图期的权重补丁,而不是运行时的权重替换。
- 装载阶段,GGUF 元数据确定「适配器类型、基座架构、alpha」,张量按
.lora_a/.lora_b配对,形状按线性层与 token embedding 两套约定校验,缓冲按基座张量所在设备分配。 - 建图阶段,
build_lora_mm在基座矩阵乘之后追加B(Ax)分支,按scale = adapter_scale * alpha / rank缩放后相加;MoE 用build_lora_mm_id把路由 id 同时传给两条低秩矩阵乘;embedding 用查表后的低秩增量。 - 生命周期上,模型登记「有哪些适配器」,context 记录「当前挂哪些、强度多少」;
set_adapters_lora的幂等判断与指针替换共同决定图能否复用。 - 服务端受「一个 context 一组适配器」约束,batch 必须适配器一致;普通 LoRA 切换会清前缀缓存,aLoRA 通过激活词扫描、batch 切分和缓存边界钳制,把适配器的生效范围压到激活点之后。
这套设计的优点是简单、可控、与 ggml 的静态图模型完全一致;代价是多适配器并发时的 batch 利用率,以及适配器切换时的图重建。理解这条边界,就能判断什么时候该用 llama.cpp 的热挂载,什么时候该用 export-lora 合并,什么时候该换到支持批内多适配器的推理框架。
- LoRA: Low-Rank Adaptation of Large Language Models
- S-LoRA: Serving Thousands of Concurrent LoRA Adapters
- llama.cpp 源码:llama-adapter.h
- llama.cpp 源码:llama-adapter.cpp
- llama.cpp 源码:llama-graph.cpp
- llama.cpp 源码:llama-context.cpp
- llama.cpp 源码:server-context.cpp
- llama.cpp LoRA 导出脚本:convert_lora_to_gguf.py
- llama.cpp 合并工具:export-lora
- llama.cpp 的 LoRA 服务端测试:test_lora.py
参考资料
- LoRA: Low-Rank Adaptation of Large Language Models
- S-LoRA: Serving Thousands of Concurrent LoRA Adapters
- llama.cpp 源码:llama-adapter.h
- llama.cpp 源码:llama-adapter.cpp
- llama.cpp 源码:llama-graph.cpp
- llama.cpp 源码:llama-context.cpp
- llama.cpp 源码:server-context.cpp
- llama.cpp LoRA 导出脚本:convert_lora_to_gguf.py
- llama.cpp 合并工具:export-lora
- llama.cpp 的 LoRA 服务端测试:test_lora.py
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



