


llama.cpp 源码完全拆解(三):GGUF 装载、mmap 与张量放置——一个模型文件如何变成设备上的权重
前两篇把 llama.cpp 的地基打完了。第一篇建立整张地图:ggml/ 是自包含的张量库,张量是惰性的图节点,后端用「注册表 → 设备 → 缓冲区类型 → 缓冲区」四层句柄描述,ggml_backend_sched 负责把一张图切到多块设备上执行。第二篇把「惰性张量」与「切图」落到真实代码上:ggml_tensor/ggml_context/ggml_cgraph 三个结构体的逐字段含义、ggml_gallocr 如何在图执行前就算出每个中间张量的地址、ggml_backend_sched 的五 pass 切图,最后合到一次 llama_decode。
这两篇反复出现一个前提,却始终没有展开:张量最终住在哪里,是谁决定的? 第二篇讲到 ggml_gallocr 只负责「计算缓冲区」——也就是前向过程中那些中间结果的显存。但权重不是中间结果,权重的字节数往往比计算缓冲区大两个数量级,它们不在 gallocr 的管辖范围内。60 亿参数的模型以 4 bit 存储时约 4 GB,以 16 bit 存储时约 12 GB;这些字节从磁盘上的 .gguf 文件开始,最终要出现在 CPU 内存或 GPU 显存里,中间发生了什么,是 llama.cpp 装载路径要回答的问题。
这一篇就填这个缺口。它承接第二篇末尾给出的路线预告,沿四个文件走完全程:src/llama-model-loader.cpp(约 81 KB,装载器主体)、src/llama-mmap.cpp(约 30 KB,跨平台内存映射抽象)、src/llama-model.cpp(约 187 KB,模型与张量放置决策)、src/llama.cpp(约 22 KB,设备枚举与模型装配入口)。这四段代码合起来回答三个问题:
- 文件里有什么? GGUF 的元数据字典与张量信息表如何被解析成一张「张量名 → 文件偏移」的索引,以及多文件切分(split)如何被合并成统一索引。
- 字节怎么进内存? mmap、mlock、direct I/O、按需惰性读取四种装载模式的真实语义差别,以及
mmap之后页面何时才真正从磁盘进入物理内存。 - 张量怎么选设备?
-ngl、-ot、--split-mode、--main-gpu如何变成每个张量具体的缓冲区类型,以及「层归属」与「缓冲区类型」这两套机制如何协作。
站内已有 GGUF 完全拆解:一个文件里的张量布局、k-quants 块量化与元数据字典 从文件字节层面讲透了 GGUF 的二进制布局与 k-quants 的位排布。那一篇回答的是「这个文件长什么样」;这一篇回答的是「llama.cpp 怎么把它读进来、放在哪」。两篇合起来才是完整的装载侧知识。
装载路径的全景:三个对象,两条路
在深入任何代码之前,先把参与装载的对象和它们之间的关系说清楚。llama.cpp 的装载不是「打开文件 → 读出权重 → 放到设备」这种线性流程,而是三个对象的协作:
llama_model_loader:负责「文件侧」。它持有打开的llama_file列表、GGUF 元数据上下文(gguf_context)、以及一张weights_map——从张量名到「哪个文件、哪个偏移、多少字节」的索引。它还负责创建ggml_tensor结构体(只有元数据、没有数据),并在最后把数据灌进去。llama_model(实现类是llama_model_base):负责「设备侧」。它持有设备列表(devices)、每层的设备归属(dev_layer)、每层的缓冲区类型候选表(buft_list),以及最终的后端缓冲区(ctxs_bufs)。llama_context:负责「运行时」。它不管权重装载,但 KV 缓存与计算缓冲区由它管理——这部分留给后续一篇。
三者之间的关键接口是 create_tensor() 的回调式协作。装载器遍历模型架构声明的张量清单,每遇到一个张量就调用模型提供的 create_tensor(...),由模型侧决定「这个张量该用哪种缓冲区类型」;装载器只负责按这个决定去建结构体、留位置。这个分工很重要:装载器不需要知道模型有几层、哪层在哪块 GPU 上,模型也不需要知道文件偏移怎么算。
两条路的区别在启动入口就能看出来。src/llama.cpp 里的 llama_model_load() 是装配函数:
static std::pair<int, llama_model *> llama_model_load(struct gguf_context * metadata, ..., const std::string & fname, std::vector<std::string> & splits, FILE * file, llama_model_params & params) { try { llama_model_loader ml(metadata, set_tensor_data, set_tensor_data_ud, fname, splits, file, params.load_mode, params.check_tensors, params.no_alloc, params.load_mtp, params.kv_overrides, params.tensor_buft_overrides);
ml.lazy.mode = params.lazy_mode;
ml.print_info(); std::unique_ptr<llama_model> model_ptr(llama_model_create(ml, params));
bool ok = llama_prepare_model_devices(params, model_ptr.get()); if (!ok) { return {-1, nullptr}; } ... model->load_tensors(ml);读这段代码要注意两个顺序细节。第一,llama_model_loader 的构造函数里,metadata_ptr.reset(gguf_init_from_file(fname.c_str(), params)) 已经把 GGUF 的元数据与张量信息表全部读进内存并解析完了——注意 params.no_alloc = true,它表示「只读元数据,不读张量数据」。装载结束时打印的 file format / file type / file size ... BPW 就来自这一步积累的 n_bytes/n_elements。
第二,llama_model_create(ml, params) 会先根据元数据里的架构名与超参创建模型骨架(层数、头数、专家数),然后 llama_prepare_model_devices() 才枚举设备并决定用哪些 GPU,最后 load_tensors(ml) 才真正把权重搬进来。设备决策发生在张量创建之前,这一点决定了后面所有放置逻辑的形态。
GGUF 解析:元数据、张量信息表与统一索引
gguf_init_from_file() 在 ggml/src/gguf.cpp 里,不在本文的重点文件范围内,但它产出的两个东西决定了装载器的全部行为,必须先讲清楚。
第一是元数据字典(KV 区)。GGUF 文件开头是魔数、版本号、张量数量与 KV 数量,接着是一组键值对:general.architecture = "llama"、llama.block_count = 32、llama.attention.head_count = 32、llama.context_length = 131072 等等。每个键的类型是显式编码的(uint32、float32、字符串、数组……),所以解析不需要猜测。装载器读这些键的方式是模板方法 get_key / get_arr / get_key_or_arr:
template<typename T>bool get_key(enum llm_kv kid, T & result, bool required = true);模板参数 T 决定期望的类型,required 决定键缺失时是抛异常还是返回 false。llm_kv 这个枚举是 llama.cpp 对键名的一层封装——LLM_KV_GENERAL_ARCHITECTURE、LLM_KV_SPLIT_COUNT 这种枚举在 llama-arch.cpp 里映射到真实字符串,这样调用方不用硬编码 "general.architecture",也便于统计「某个架构需要哪些键」。
第二是张量信息表。每个张量有名字、维度数组(ne[])、量化类型(GGML_TYPE_Q4_K 之类)和相对数据区的偏移。gguf_init_from_file 会把它们建成轻量的 ggml_tensor 结构体挂在一个 ggml_context 上,但不分配数据——这正是 no_alloc = true 的含义。这些结构体的 data 指针是空的,ne[] 与 type 是真实的。
装载器构造函数的这个循环是核心:
for (ggml_tensor * cur = ggml_get_first_tensor(ctx); cur; cur = ggml_get_next_tensor(ctx, cur)) { std::string tensor_name = std::string(cur->name); if (weights_map.find(tensor_name) != weights_map.end()) { throw std::runtime_error(format("invalid model: tensor '%s' is duplicated", ggml_get_name(cur))); } n_elements += ggml_nelements(cur); n_bytes += ggml_nbytes(cur); weights_map.emplace(tensor_name, llama_tensor_weight(files.back().get(), 0, metadata, cur));}三件事同时完成:去重检查(同名张量直接报错,这是发现损坏文件最有效的手段)、体积统计(n_bytes 用于进度条与 BPW 报告)、索引建立。llama_tensor_weight 的构造函数把「文件内偏移」算成绝对偏移:
offs = gguf_get_data_offset(gguf_ctx) + gguf_get_tensor_offset(gguf_ctx, tensor_idx);if (offs + ggml_nbytes(tensor) < offs || offs + ggml_nbytes(tensor) > file->size()) { throw std::runtime_error(format("tensor '%s' data is not within the file bounds, model is corrupted or incomplete", ggml_get_name(tensor)));}这里有两个容易被忽略的工程细节。第一,offs + ggml_nbytes(tensor) < offs 这个看似冗余的检查是整数溢出防护:offs 与 nbytes 都是 size_t,恶意或损坏的文件可以让两者之和回绕,从而绕过上界检查,让后续 mmap 得到一个指向文件之外的指针。第二,检查用的是「张量声明的字节数」而不是「文件里实际能读到的字节数」,所以它能抓住截断文件,但抓不住数据区内容错误——后者要靠 --check-tensors 时逐行校验(后面会讲)。
weights_map 的比较器值得一提,它决定了装载顺序:
struct weight_name_comparer { bool operator()(const std::string & a, const std::string & b) const { int a_layer = -1; int b_layer = -1; sscanf(a.c_str(), "blk.%d.", &a_layer); sscanf(b.c_str(), "blk.%d.", &b_layer); if (a_layer != b_layer) { return a_layer < b_layer; } return a < b; }};它把 blk.17.ffn_gate.weight 这样的名字按层号排序,而不是按字典序。字典序会把 blk.10. 排在 blk.2. 前面。按层号排序的实际收益有两个:装载日志按层递增,便于对照模型结构;进度回调的 size_done 线性增长,进度条不会跳跃。
多文件切分:split 如何合并成一张索引
大模型常常被切成多个 .gguf 文件(--split-max-size 转换时的产物)。装载器对切分的处理逻辑是:主文件必须带 split.no = 0,否则直接报错拒绝装载:
uint16_t n_split = 0;get_key(llm_kv(LLM_KV_SPLIT_COUNT), n_split, false);
if (n_split > 1) { uint16_t idx = 0; const std::string kv_split_no = llm_kv(LLM_KV_SPLIT_NO); get_key(kv_split_no, idx); if (idx != 0) { throw std::runtime_error(format("illegal split file idx: %d (file: %s), model must be loaded with the first split", idx, fname.c_str())); } ... for (idx = 1; idx < n_split; idx++) { gguf_context_ptr ctx_gguf { gguf_init_from_file(fname_split, split_params) }; ... for (ggml_tensor * cur = ggml_get_first_tensor(ctx); cur; cur = ggml_get_next_tensor(ctx, cur)) { ... weights_map.emplace(tensor_name, llama_tensor_weight(files.back().get(), idx, ctx_gguf.get(), cur)); } } get_key(llm_kv(LLM_KV_SPLIT_TENSORS_COUNT), n_tensors); const int n_tensors_loaded = (int) weights_map.size(); if (n_tensors != n_tensors_loaded) { throw std::runtime_error(format("corrupted model: %d tensors expected but %d found", n_tensors, n_tensors_loaded)); }}这里有三个设计决策值得拆开看。
为什么必须从 split 0 开始装载? 因为主 GGUF(split 0)承载着全部元数据——架构名、层数、超参、词表。后续 split 只带自己的 KV 子集(split.no、split.count)与张量数据。如果允许从任意 split 进入,就得额外实现「元数据合并」,代价远大于收益。
为什么每个 split 用独立的 gguf_context,索引却合并? 每个 split 有自己的 gguf_get_data_offset()——元数据区长度不同,数据区起始位置就不同。所以 llama_tensor_weight 必须记录 idx(哪个文件)+ 该文件内的绝对偏移。合并后的 weights_map 是「一个名字对应一个文件位置」的全局表,装载时按 w.idx 去 mappings.at(w.idx) 或 files.at(w.idx) 取数据。这套设计让上层代码完全不需要感知「模型是否被切分」。
split.tensors.count 的交叉验证为什么重要? 它把「所有 split 里实际找到的张量总数」与「主文件声明的总数」比对。这是唯一能发现「少了一个 split 文件」的检查——否则装载会在某个张量找不到时以「missing tensor」报错,虽然也能失败,但错误信息指向的是具体张量名,不利于使用者定位成「你漏下载了一个分片」。
最后一步是 done_getting_tensors() 的收尾校验:
void llama_model_loader::done_getting_tensors(bool partial) const { if (n_created > n_tensors) { throw std::runtime_error(format("%s: too many tensors created; expected %d, got %d", __func__, n_tensors, n_created)); } if (n_created < n_tensors) { if (!partial) { throw std::runtime_error(format("%s: wrong number of tensors; expected %d, got %d", __func__, n_tensors, n_created)); } LLAMA_LOG_INFO("%s: partial load — used %d of %d tensors in the file (rest belong to a sibling model on the same .gguf)\n", __func__, n_created, n_tensors); } ...}n_tensors 是文件里声明的数量,n_created 是模型架构实际索要的数量。两者不等通常意味着「架构实现与文件不匹配」——比如文件是某个新架构,而当前代码里的 load_arch_tensors 还没实现对应的张量清单。partial 参数服务于一个特殊场景:同一个 .gguf 里放了多个相关模型(例如主模型与它的嵌入模型),本次只装载其中一部分张量是合法的,--model 指向同一个文件但架构参数不同时可以走这条路。
mmap:让文件的字节成为进程地址空间的一部分
装载路径的核心问题在这里:权重以什么形式从文件进入可访问的内存。llama.cpp 给出了四种模式,定义在 llama.h 的 llama_load_mode 枚举里:NONE(普通读)、MMAP(内存映射)、MLOCK(映射并锁定常驻)、MMAP_MLOCK(映射并锁定)、DIRECT_IO(绕过页缓存直接读)。默认 AUTO 会依据设备能力挑选。要理解这些模式为什么这样设计,必须先讲清 mmap 的机制。
mmap 到底做了什么
mmap(NULL, size, PROT_READ, MAP_SHARED, fd, 0) 返回一个指针 addr,此后 addr + off 处的读取就等价于读文件偏移 off 处的字节。它没有一次性读入整个文件。理解这一点必须区分三个层次:
- 虚拟地址空间:
mmap调用成功时就建立了映射。内核只是在进程页表里登记「地址区间[addr, addr+size)对应文件的[0, size)」,并记录PROT_READ/MAP_SHARED。这一步只消耗页表空间,几乎不消耗物理内存。 - 物理页帧与页缓存:真正的字节存在于内核页缓存(page cache)里。页缓存是全系统共享的——如果同一个模型文件被两个进程 mmap,它们共享同一批物理页。
- 进程页表项:当某个地址第一次被访问时,CPU 触发缺页异常(page fault),内核在页缓存里找到(或从磁盘读入)对应的 4 KB 页,把物理页帧号填进该进程的页表项,然后恢复执行。
对装载路径来说,这条机制的推论极其重要:mmap 只是把「读文件」推迟到了「第一次访问」。装载阶段调用 ggml_backend_tensor_alloc(buf_mmap, cur, data) 时,传入的 data 就是 mapping->addr() + weight->offs——一个映射区内的地址。这个调用不读数据,它只是告诉后端「这个张量的数据在这个地址上」。数据何时进内存,取决于之后谁先碰它。
if (from_mapping) { const auto & mapping = mappings.at(weight->idx); uint8_t * data = (uint8_t *) mapping->addr() + weight->offs;
ggml_backend_buffer_t buf_mmap = nullptr; for (const auto & buf : bufs) { const uint8_t * base = (const uint8_t *) ggml_backend_buffer_get_base(buf); if (base && base <= data && data + n_size <= base + ggml_backend_buffer_get_size(buf)) { buf_mmap = buf; break; } } ... if (buf_mmap && cur->data == nullptr) { ggml_backend_tensor_alloc(buf_mmap, cur, data); ... } else { ggml_backend_tensor_set(cur, data, 0, n_size); }}这段代码里的 buf_mmap 查找循环是一个容易读漏的细节。一个文件的张量可能被放在多个缓冲区里——因为不同层属于不同设备、或者同一个上下文里的张量分散在文件的不连续区段(后面 get_mapping_ranges 会解释)。每个缓冲区在创建时用的是「映射区内的一段连续区间」,所以要判断「这个张量落在哪个缓冲区覆盖的区间里」。找到就不拷贝(cur->data 直接指向映射区),找不到才走 ggml_backend_tensor_set 做一次真实的拷贝。
unmap_fragment:装载完成后把没用的映射还回去
llama_mmap 里有一个不太显眼但很关键的方法:unmap_fragment(first, last)。它在 load_all_data 的最后被调用:
if (size_done >= size_data) { if (use_mmap) { for (uint32_t idx = 0; idx < mappings.size(); idx++) { const auto & mmap_used = mmaps_used.at(idx); auto & mapping = mappings.at(idx); mapping->unmap_fragment(0, mmap_used.first); if (mmap_used.second != 0) { mapping->unmap_fragment(mmap_used.second, mapping->size()); } } } ...}mmaps_used[idx] 在装载过程中被不断收窄,记录「实际被使用的字节区间」:
auto & mmap_used = mmaps_used[weight->idx];mmap_used.first = std::min(mmap_used.first, weight->offs);mmap_used.second = std::max(mmap_used.second, weight->offs + n_size);装载结束后,映射区里 [0, used.first) 与 [used.second, size) 这两段就没用了——它们通常是 GGUF 的元数据区、词表对齐填充,或者被卸载到 GPU 的张量数据。unmap_fragment 把它们 munmap 掉,同时维护一个「还剩哪些已映射片段」的列表:
void unmap_fragment(size_t first, size_t last) { int page_size = sysconf(_SC_PAGESIZE); align_range(&first, &last, page_size); size_t len = last - first; if (len == 0) { return; } GGML_ASSERT(first % page_size == 0); GGML_ASSERT(last % page_size == 0); GGML_ASSERT(last > first);
void * next_page_start = (uint8_t *) addr + first; if (munmap(next_page_start, len)) { LLAMA_LOG_WARN("warning: munmap failed: %s\n", strerror(errno)); }
std::vector<std::pair<size_t, size_t>> new_mapped_fragments; for (const auto & frag : mapped_fragments) { if (frag.first < first && frag.second > last) { new_mapped_fragments.emplace_back(frag.first, first); new_mapped_fragments.emplace_back(last, frag.second); } else if (frag.first < first && frag.second > first) { new_mapped_fragments.emplace_back(frag.first, first); } else if (frag.first < last && frag.second > last) { new_mapped_fragments.emplace_back(last, frag.second); } else if (frag.first >= first && frag.second <= last) { } else { new_mapped_fragments.push_back(frag); } } mapped_fragments = std::move(new_mapped_fragments);}这段代码有两个必须讲清的点。
第一,为什么必须按页对齐并在片段列表上做区间减法? munmap 的粒度是页。如果 first 落在页中间,直接 munmap 会连带把同一页上属于「仍被使用的数据」的部分一起卸掉——一个张量的尾部与另一个张量的头部可能共用一页。align_range 的做法是:起始地址向上取整到页边界、结束地址向下取整到页边界,只解除「完整落在无用区间内」的那些页。代价是边界上的部分页会被保留(浪费最多 2 页),收益是绝不会误伤有用数据。
第二,为什么需要一个「已映射片段列表」而不是一次 munmap 整个区间? 因为 unmap_fragment 可能被调用多次(不同 split 文件各自处理、以及前面提到的 lazy 张量场景),每次只解除一段。列表的作用是让析构函数知道最终还剩哪些片段需要逐个 munmap,而不是假设整个文件映射仍然有效。五个分支就是在对一个片段列表做「减去区间 [first, last)」的集合运算。
这个设计的实际意义是:mmap 模式下,被卸载到 GPU 的那部分权重数据可以在装载完成后从进程地址空间里消失,从而不占用 CPU 侧的页缓存引用与地址空间。对「把大部分层放到 GPU、只留少数层在 CPU」的配置,这个收益很直接。
mmap 的三种建议:MADV_WILLNEED、MADV_RANDOM 与 MAP_POPULATE
llama_mmap::impl 的构造函数里有一组 madvise 调用,它们是性能调优的关键:
int flags = MAP_SHARED;if (numa) { prefetch = 0; }#ifdef __linux__ if (posix_fadvise(fd, 0, 0, POSIX_FADV_SEQUENTIAL)) { ... } // MAP_POPULATE would fault in the lazy ranges too if (prefetch && lazy_ranges.empty()) { flags |= MAP_POPULATE; }#endif addr = mmap(NULL, file->size(), PROT_READ, flags, fd, 0); ... if (prefetch > 0) { for (const auto & range : ranges_complement(lazy_ranges, std::min(file->size(), prefetch))) { advise(range.first, range.second, POSIX_MADV_WILLNEED, "POSIX_MADV_WILLNEED"); } } for (const auto & range : lazy_ranges) { advise(range.first, range.second, POSIX_MADV_RANDOM, "POSIX_MADV_RANDOM"); } if (numa) { if (posix_madvise(addr, file->size(), POSIX_MADV_RANDOM)) { ... } }逐个解释:
POSIX_FADV_SEQUENTIAL 是在文件描述符上给内核的提示:这个文件会被顺序读取。内核据此把预读窗口加大到两倍、并在读过的页上做更积极的回收标记。对 GGUF 完全成立——张量按文件顺序排列,装载就是顺序扫一遍。
MAP_POPULATE 是一个更强的提示:在 mmap 调用时就预先把所有页建立页表项(相当于一次性触发全部缺页)。它把「装载阶段成百上千次微小缺页」变成「一次大块填充」,对顺序访问是大赢。但这里的条件很讲究:if (prefetch && lazy_ranges.empty())。只要存在惰性读取区间,就不用 MAP_POPULATE——因为那些区间的整个设计意图就是「不要提前读进来」,MAP_POPULATE 会违背这个意图。代码里的注释把这一点写得很直白:MAP_POPULATE would fault in the lazy ranges too。
POSIX_MADV_WILLNEED 是每个区间粒度的建议:告诉内核「这段马上要用」。它不阻塞,只是把页异步读入页缓存。llama.cpp 只对前 prefetch 字节做这件事——init_mappings 传入的 prefetch_size 是 prefetch && use_mmap ? -1 : 0,也就是「打开预取时预取整个文件」。配合 ranges_complement(lazy_ranges, min(file->size(), prefetch)),它预取的是「除惰性区间外的全部」。
POSIX_MADV_RANDOM 用在惰性区间上,语义相反:告诉内核「这里的访问是随机的,不要预读」。这直接减少无用 I/O。它在 NUMA 模式下还会被施加到整个映射上。
numa 分支为什么把 prefetch 清零? 因为 is_numa 为真时走的是「每页落在哪个 NUMA 节点由首次访问的 CPU 决定」的策略,提前在某一个 CPU 上预取整文件会把所有页都拉到那一个节点的本地内存里,反而破坏后续多节点均衡。所以 NUMA 下不预取、只标 MADV_RANDOM。判定 NUMA 的方式是通过后端注册表查询扩展函数:
auto * dev = ggml_backend_dev_by_type(GGML_BACKEND_DEVICE_TYPE_CPU);if (dev) { auto * reg = ggml_backend_dev_backend_reg(dev); auto * is_numa_fn = (decltype(ggml_is_numa) *) ggml_backend_reg_get_proc_address(reg, "ggml_backend_cpu_is_numa"); if (is_numa_fn) { is_numa = is_numa_fn(); }}这是第二篇讲过的「注册表扩展函数」模式的又一个实例:CPU 后端特有的能力(是否 NUMA 机器)通过 proc_address 查询,避免了在核心代码里引入 CPU 特有头文件。
llock:把页锁定在内存里
llama_mlock 只是 mlock/VirtualLock 的薄封装,但它解决的问题很实际。mmap 的一个后果是:页缓存里的页可能被内核回收。当系统内存紧张时,一个 4 GB 的模型即使只读了一部分,内核也可能把已读的页换出去,下次访问再触发磁盘读。对外置 SSD 的机器,这会让解码速度随内存压力剧烈波动。
grow_to(target_size) 是增量式的:
if (lmlocks && !lazy.has(cur)) { const auto & lmlock = lmlocks->at(weight->idx); lmlock->grow_to(weight->offs + n_size);}装载器遍历张量时不断把 mlock 的覆盖范围向前推进到「当前张量末尾」,而不是一次性锁住整个文件。因为张量按偏移单调递增,grow_to 的增量就是这个张量的字节数。注释里还专门说明了一个例外:惰性张量不加锁(!lazy.has(cur)),理由是「锁一个惰性张量会把它整个页进来,而这正是 lazy 要避免的」——mlock 会强制所有页驻留,与按需读取的意图直接冲突。
非 mmap 模式下 mlock 的对象不同:mmap 模式锁映射区,NONE 模式锁的是权重缓冲区本身:
if (use_mlock && ggml_backend_buffer_is_host(buf) && ggml_backend_buffer_get_base(buf) != nullptr) { pimpl->mlock_bufs.emplace_back(new llama_mlock); auto & mlock_buf = pimpl->mlock_bufs.back(); mlock_buf->init (ggml_backend_buffer_get_base(buf)); mlock_buf->grow_to(ggml_backend_buffer_get_size(buf));}这里出现了一个边界情况:ggml_backend_buffer_get_base(buf) != nullptr 这个条件是为了排除 multi_buffer——由多块小缓冲区拼成的大缓冲区没有单一基址,而它的组成部分(通常是固定上限的 pinned host buffer)本身已经是锁定内存,不需要再加锁。多设备或张量跨区段时就会出现 multi_buffer,正是 ggml_backend_dev_buffer_from_host_ptr 返回的那种。
惰性读取:把最大的张量留在磁盘上
llama_load_mode 之外,还有一个正交的维度:--lazy / llama_lazy_mode。它的对象是单个超大张量,典型的例子是逐层词嵌入(PLE, per-layer embedding)与 Engram 张量——某些架构里这些张量单个就有几 GB。
判定逻辑集中在 lazy_read::add:
bool llama_model_loader::lazy_read::add(const std::string & name, const ggml_tensor * t, const llama_tensor_weight * w) { if (mode == LLAMA_LAZY_MODE_OFF) { return false; }
// do not lazy-read small tensors, it has significant overhead and is not worth it constexpr size_t auto_min_size = 4ull * 1024 * 1024 * 1024; if (mode != LLAMA_LAZY_MODE_ON && ggml_nbytes(t) <= auto_min_size) { return false; }
if (!llama_mmap::SUPPORTED) { LLAMA_LOG_WARN("%s: mmap is not available, so tensor %s (size = %zu MiB) is loaded into RAM in full\n", __func__, name.c_str(), ggml_nbytes(t)/1024/1024); return false; }
if (w) { ranges[w->idx].emplace_back(w->offs, w->offs + ggml_nbytes(t)); tensors.insert(name); LLAMA_LOG_INFO("%s: tensor %s (size = %zu MiB) lazy read enabled\n", __func__, name.c_str(), ggml_nbytes(t)/1024/1024); }
return true;}四道门的含义各不相同。
第一道,mode == OFF 直接拒绝——用户没有要求惰性读取。
第二道,auto_min_size = 4 GiB。这是自动模式(LLAMA_LAZY_MODE_AUTO)的阈值:只有超过 4 GiB 的张量才值得惰性读取。理由写在注释里——「小张量惰性读取的开销很大,不值得」。开销来自哪里?惰性张量的数据不在后端缓冲区里,每次算子要用它都得先把它从磁盘读进一块主机内存。对 4 MiB 的小张量,一次磁盘读的延迟与传输时间会远超省下的那 4 MiB 内存的价值。只有当张量足够大、且每次前向只用其中一小部分(比如 PLE 只取当前层那一份)时,这个交换才划算。
第三道,!llama_mmap::SUPPORTED。惰性读取必须依赖 mmap——它通过 unmap_weight 把不需要的区段卸掉,用 load_data_range 从映射区取数据。在没有 mmap 的平台上(部分嵌入式环境)只能放弃并打警告。注意 llama_mmap::SUPPORTED 的判定条件:
#if defined(_POSIX_MEMLOCK_RANGE) || defined(_WIN32)const bool llama_mmap::SUPPORTED = true;也就是说,SUPPORTED 在编译期由平台宏决定,而不是运行时探测。
第四道,只有传入 w(权重索引)时才真正登记。add 被调用两次的设计是:第一次在创建张量结构体前询问「要不要惰性」,此时还不知道文件偏移;第二次在拿到偏移后正式登记 ranges 与 tensors 两个集合。ranges 供 llama_mmap 构造时决定哪些区间用 MADV_RANDOM,tensors 供 has() 查询。
惰性张量使用专用的 ggml context 与缓冲区,这一点在 create_tensor 里通过 ctx_key 表达:
struct ctx_key { ggml_backend_buffer_type_t buft; bool lazy;};
auto ctx_for_buft = [&](ggml_backend_buffer_type_t buft) -> ggml_context * { const ctx_key key { buft, is_lazy }; auto it = ctx_map.find(key); if (it == ctx_map.end()) { ... ctx_map.emplace(key, ctx); return ctx; } return it->second.get();};以及 create_tensor 里的这一段:
if (is_lazy) { return lazy_read::buft();}lazy_read::buft() 的实现是:
ggml_backend_buffer_type_t llama_model_loader::lazy_read::buft() { auto * cpu_dev = ggml_backend_dev_by_type(GGML_BACKEND_DEVICE_TYPE_CPU); if (!cpu_dev) { throw std::runtime_error("no CPU backend found"); } return ggml_backend_dev_buffer_type(cpu_dev);}惰性张量强制落在 CPU 缓冲区类型上,无视 -ngl——理由很直接:惰性张量在加载时只是「登记」,实际数据在每次前向时按需从磁盘读入主机内存,再交给计算。它没有「常驻在某块 GPU 上」这个状态。这一点也解释了 load_tensors 里对惰性上下文的特殊处理:
// a lazy context is mapped whatever the load mode, but the memory-fit pass maps nothingconst bool is_lazy_mapped = ctx_key.lazy && !ml.no_alloc;
if ((ml.use_mmap || is_lazy_mapped) && use_mmap_buffer && buffer_from_host_ptr_supported && is_default_buft) {即使装载模式不是 mmap,惰性上下文也走映射路径——否则惰性读取就没有数据来源。这是「功能依赖压倒配置一致性」的一个实例,也是上一节里 init_mappings 那句注释的具体落点:
// note: read_lazy also requires mmap; this condition make sure it's usable even when --load-mode is not set to mmapif (use_mmap || lazy.any()) {字节实际怎么走:load_all_data 的三条分支
到这里,文件侧的准备全部就绪:weights_map 建好、mappings 建立、每个张量的 create_tensor 已经返回了缓冲区类型、缓冲区也已经分配。剩下的是 load_all_data——把数据真正搬到位。它有三条分支,每条对应一种装载模式。
分支一:mmap 直映射(from_mapping)
前面已经讲过:取映射区地址、找到覆盖该地址的缓冲区、ggml_backend_tensor_alloc 把张量的 data 指向映射区。零拷贝。这也是为什么 mmap 模式下 upload_backend 是空的:
ggml_backend_t upload_backend = [&](const char * func) -> ggml_backend_t { if (use_mmap || check_tensors) { return nullptr; } ...}(__func__);mmap 时不需要异步上传,因为根本没有「上传」这个动作;check_tensors 时也不走异步路径,因为校验需要顺序读取(校验本身会并行执行,但读文件的主线程不能与上传抢位)。
分支二:非 mmap 且目标是主机缓冲区——直接读文件
} else { const auto & file = files.at(weight->idx);
if (ggml_backend_buffer_is_host(cur->buffer)) { file->seek(weight->offs, SEEK_SET); file->read_raw(cur->data, n_size); if (check_tensors) { validation_result.emplace_back(std::async(std::launch::async, [cur, n_size] { return std::make_pair(cur, ggml_validate_row_data(cur->type, cur->data, n_size)); })); } }直接读进权重缓冲区,中间没有暂存。read_raw 会一次性读 n_size 字节。对 CPU 缓冲区(ggml_backend_buffer_is_host 为真),cur->data 就是最终位置。
分支三:非 mmap 且目标是设备缓冲区——pinned 内存 + 异步上传
这是最复杂的一条,也是「不用 mmap 装到 GPU」时的实际路径。设计要点是:用固定数量的 pinned(锁页)主机缓冲区轮转,从文件里分块读,异步拷到 GPU。
// 4 staging buffers for async uploads, each sized 1MB seems to be a good default for single NVMe drives.// NVMe raid configurations might require more / larger buffers.constexpr size_t n_buffers = 4;...const size_t buffer_size = alignment != 1 ? LLAMA_DIRECT_IO_BUFFER_SIZE + 2 * alignment : 1 * 1024 * 1024;n_buffers = 4 是实测经验值(注释里明确说是针对单块 NVMe)。buffer_size 有两条路:direct I/O 模式下用 64 MiB 的大块(LLAMA_DIRECT_IO_BUFFER_SIZE),普通模式用 1 MiB。为什么 direct I/O 要大这么多?因为 direct I/O 绕过页缓存,每次读都要付对齐与设备访问的固定成本,小块会显著降低吞吐;而 64 MiB 对 NVMe 是能保持顺序读带宽的量级。+ 2 * alignment 是为了容纳读取范围两端因对齐而产生的额外字节。
upload_backend 的构造是一个逐项检查的能力协商过程,它决定了异步路径是否可用。四项条件缺一不可:
auto * buft = ggml_backend_buffer_get_type(buf);auto * dev = ggml_backend_buft_get_device(buft);if (!dev) { ... return nullptr; }if (buft != ggml_backend_dev_buffer_type(dev)) { ... return nullptr; }ggml_backend_dev_props props;ggml_backend_dev_get_props(dev, &props);if (!props.caps.async || !props.caps.host_buffer || !props.caps.events) { ... return nullptr; }auto * host_buft = ggml_backend_dev_host_buffer_type(dev);if (!host_buft) { ... return nullptr; }逐个看:必须有设备(否则不知道该往哪拷);缓冲区类型必须是该设备的默认类型(自定义/组合缓冲区类型下异步拷路径未必正确);设备必须支持异步执行、主机缓冲区与事件;必须有主机缓冲区类型(pinned 内存由它分配)。任何一项不满足就返回 nullptr,装载退回到同步路径。
异步循环的主体是:
size_t offset = weight->offs;alignment = file->read_alignment();size_t aligned_offset = offset & ~(alignment - 1);size_t offset_from_alignment = offset - aligned_offset;file->seek(aligned_offset, SEEK_SET);
size_t read_start = aligned_offset;size_t read_end = (offset + n_size + alignment - 1) & ~(alignment - 1);
while (bytes_read < read_end - read_start) { size_t read_size = std::min<size_t>(buffer_size, read_end - read_start - bytes_read);
uintptr_t ptr_dest_aligned = (reinterpret_cast<uintptr_t>(host_ptrs[buffer_idx]) + alignment - 1) & ~(alignment - 1);
ggml_backend_event_synchronize(events[buffer_idx]);
file->read_raw_unsafe(reinterpret_cast<void *>(ptr_dest_aligned), read_size);
uintptr_t ptr_data = ptr_dest_aligned; size_t data_to_copy = read_size;
if (bytes_read == 0) { ptr_data += offset_from_alignment; data_to_copy -= offset_from_alignment; }
if (aligned_offset + bytes_read + read_size > offset + n_size) { data_to_copy -= (read_end - (offset + n_size)); }
ggml_backend_tensor_set_async(upload_backend, cur, reinterpret_cast<void *>(ptr_data), data_read, data_to_copy); ggml_backend_event_record(events[buffer_idx], upload_backend);
data_read += data_to_copy; bytes_read += read_size;
++buffer_idx; buffer_idx %= n_buffers;}这段代码围绕「对齐」展开,必须逐个解释。
为什么要对齐? O_DIRECT 要求文件偏移、读长度、目标内存地址都对块大小(通常是 512 B 或 4 KB)对齐。llama.cpp 用 llama_file::read_alignment() 拿到设备的对齐要求(direct I/O 时返回实际值,普通模式返回 1)。于是:读取起点 aligned_offset 向下取整到对齐边界,终点 read_end 向上取整。
为什么目标地址也要对齐? ptr_dest_aligned = (uintptr_t(host_ptrs[buffer_idx]) + alignment - 1) & ~(alignment - 1) —— 在 pinned 缓冲区内部再向上取整一次。
多读的字节怎么处理? 对齐导致读取范围比张量数据范围大,两端多出来的字节不属于这个张量。代码用 offset_from_alignment(首端多余)与 read_end - (offset + n_size)(尾端多余)把它们从 ptr_data/data_to_copy 里减掉,只上传真正的数据部分。这是必须的——否则会把邻接张量的字节写进当前张量,损坏权重。
同步语义在哪? ggml_backend_event_synchronize(events[buffer_idx]) 出现在「复用这个缓冲区之前」,而不是「提交之后」。四块缓冲区轮转,当我们绕回来要用第 0 块时,先等它上一轮的异步上传完成。这个 synchronize 是整段代码里唯一的阻塞点,它的位置决定了流水线深度:四个缓冲意味着最多 3 个上传在飞行中。
read_raw_unsafe 与 read_raw 的区别也值得一提:前者不做边界与错误检查(性能优先,用于已经对齐好的大块读),后者做检查。read_raw_unsafe 只在 direct I/O 路径上可用,非 Windows 平台直接转发到 read_raw。
同步回退路径
当 upload_backend 为 nullptr(设备不支持异步、或缓冲区类型非默认),走的是:
} else { // scoped to one tensor so only one staging buffer is alive at a time std::vector<no_init<uint8_t>> read_buf(n_size); file->seek(weight->offs, SEEK_SET); file->read_raw(read_buf.data(), n_size); ggml_backend_tensor_set(cur, read_buf.data(), 0, n_size); if (check_tensors && !ggml_validate_row_data(cur->type, read_buf.data(), n_size)) { throw std::runtime_error(format("tensor '%s' has invalid data", ggml_get_name(cur))); }}它按「一个张量一个暂存缓冲」的方式工作,no_init 是避免对几 GB 内存做无意义的清零。对超大张量,这个路径会申请一块与张量等大的主机内存,这正是 load_all_data 开头那个排序想缓解的问题:
if (!use_mmap) { std::stable_sort(tensors.begin(), tensors.end(), [](const ggml_tensor * a, const ggml_tensor * b) { const bool staged_a = a->buffer && !ggml_backend_buffer_is_host(a->buffer); const bool staged_b = b->buffer && !ggml_backend_buffer_is_host(b->buffer); if (staged_a != staged_b) { return staged_a; } return staged_a && ggml_nbytes(a) > ggml_nbytes(b); });}把需要暂存的(非主机缓冲区的)张量排在前面,且按体积从大到小。 注释给出了理由:「load them biggest-first so the largest staging buffer is allocated while the fewest weights are resident」——最大的暂存缓冲在「已驻留权重最少」的时候分配。虽然同步路径的暂存缓冲是逐张量作用域(std::vector<no_init<uint8_t>> read_buf(n_size) 在作用域结束时释放),但它的峰值仍与「当时已占用的显存/内存」叠加,所以让大块的时刻尽量靠前是有意义的。
load_tensors 里还有一层对应的分区:
if (!ml.use_mmap) { std::stable_partition(ctx_bufs.begin(), ctx_bufs.end(), [](const auto & x) { const auto & bufs = x.second; return !bufs.empty() && !ggml_backend_buffer_is_host(bufs[0]); });}把非主机上下文的装载整体提前——先处理 GPU 权重,再处理 CPU 权重。理由是 GPU 侧要经过暂存缓冲,而 CPU 侧是直接读,先把 GPU 侧的峰值压力在前,等到 CPU 侧开始读时暂存缓冲已经不再需要。
校验:--check-tensors 与并行验证
check_tensors 打开时,每个张量读完后会提交一个异步校验任务:
if (check_tensors) { validation_result.emplace_back(std::async(std::launch::async, [cur, n_size] { return std::make_pair(cur, ggml_validate_row_data(cur->type, cur->data, n_size)); }));}ggml_validate_row_data 按张量类型逐行检查数据是否「合法」——对量化类型,检查的是每行的缩放因子与整数是否在合法范围、是否存在 NaN/Inf 缩放因子。它不是「与原始 fp16 比对」,而是「格式自洽性检查」。在装载末尾统一收割结果:
bool validation_failed = false;for (auto & future : validation_result) { auto result = future.get(); if (!result.second) { LLAMA_LOG_ERROR("%s: tensor '%s' has invalid data\n", __func__, ggml_get_name(result.first)); validation_failed = true; }}if (validation_failed) { throw std::runtime_error("found tensors with invalid data");}用 std::async 而不是串行校验,是因为校验是纯 CPU 计算,可以与读盘并行;最后统一 future.get() 保证了「先报全部错误再抛异常」,便于一次性看到所有坏张量而不是修一个发现一个。
张量放置:从层归属到缓冲区类型
下面进入本文的另一半——张量放在哪块设备上。这是 -ngl、-ot、--split-mode、--main-gpu 这些命令行参数真正落地的地方,也是 llama.cpp 与 vLLM/SGLang 在工程形态上差别最大的部分:后者由框架统一管理显存,前者把控制权交给用户,代价是需要一套更细的决策逻辑。
第一步:设备枚举(llama_prepare_model_devices)
设备列表不是简单地把「所有 GPU」列出来,而是有明确的顺序与去重规则:
std::vector<llama_device> gpus;std::vector<llama_device> igpus;std::vector<llama_device> rpc_servers;...case GGML_BACKEND_DEVICE_TYPE_GPU: { ggml_backend_reg_t reg = ggml_backend_dev_backend_reg(dev); if (ggml_backend_reg_name(reg) == std::string("RPC")) { rpc_servers.push_back({false, dev}); } else { ggml_backend_dev_props props; ggml_backend_dev_get_props(dev, &props); auto it = std::find_if(gpus.begin(), gpus.end(), [&props](const llama_device & d) { ggml_backend_dev_props d_props; ggml_backend_dev_get_props(d.dev, &d_props); if (props.device_id && d_props.device_id) { return strcmp(props.device_id, d_props.device_id) == 0; } return false; }); if (it != gpus.end()) { LLAMA_LOG_INFO("%s: skipping device %s (%s) with id %s - already using device %s (%s) with the same id\n", ...); } else { gpus.push_back({false, dev}); } } break;}case GGML_BACKEND_DEVICE_TYPE_IGPU: // igpus.empty() - workaround for integrated devices seen by multiple backends if (igpus.empty() || ggml_backend_dev_backend_reg(dev) == ggml_backend_dev_backend_reg(igpus.back().dev)) { igpus.push_back({false, dev}); } break;三个规则。
按 device_id 去重。 同一块物理 GPU 可能被多个后端看见(CUDA 与 Vulkan 同时编译进去时很常见)。如果不去重,同一块卡会出现在设备列表里两次,tensor_split 的计算与层的分配都会错。去重的键是 props.device_id(PCI bus id 一类),比设备名更可靠。
RPC 服务器排在最前。 末尾有:
// add RPC servers at the front of the list to minimize network transfersmodel->devices.insert(model->devices.begin(), rpc_servers.begin(), rpc_servers.end());model->devices.insert(model->devices.end(), gpus.begin(), gpus.end());if (gpus.empty()) { model->devices.insert(model->devices.end(), igpus.begin(), igpus.end());}RPC 后端把远端机器的 GPU 暴露成本地设备。放在最前是为了「最小化网络传输」——按 llama.cpp 的层分配规则(后面会看到),前面的设备会拿到靠前的层,而计算是从第 0 层开始顺序进行的。
集成显卡只在没有独显时才启用。 if (gpus.empty())。原因是 iGPU 与独显共享系统内存,带宽与算力都低一个量级;把它放进来只会拖慢。但如果没有独显,它就是唯一的加速器。
然后是 --split-mode none 的裁剪:
if (params.split_mode == LLAMA_SPLIT_MODE_NONE && !model->devices.empty()) { if (params.main_gpu < 0) { model->devices.clear(); } else { if (params.main_gpu >= (int)model->devices.size()) { LLAMA_LOG_ERROR("%s: invalid value for main_gpu: %d (available devices: %zu)\n", ...); return false; } llama_device main_gpu = model->devices[params.main_gpu]; model->devices.clear(); model->devices.push_back(main_gpu); }}main_gpu < 0 时清空设备列表,意味着完全不用 GPU。 这是 --split-mode none 且未指定主卡的语义。main_gpu >= 0 就只保留那一块卡,其余全部丢弃——这就是「单卡模式」。
最后还有 LLAMA_SPLIT_MODE_TENSOR 的特殊分支,它不构造设备列表,而是构造一个 Meta device:
if (params.split_mode == LLAMA_SPLIT_MODE_TENSOR) { std::vector<ggml_backend_dev_t> devs; for (size_t i = 0; i < ggml_backend_dev_count(); ++i) { auto * dev = ggml_backend_dev_get(i); if (ggml_backend_dev_buffer_type(dev) == ggml_backend_cpu_buffer_type()) { LLAMA_LOG_INFO("%s: skipping %s (%s) for tensor parallelism\n", __func__, ...); continue; } devs.push_back(dev); } ... model->get_split_state_ud.n_devices = devs.size(); model->get_split_state_ud.model = model; gpus.push_back({ true, ggml_backend_meta_device( devs.data(), devs.size(), llama_meta_device_get_split_state, &model->get_split_state_ud) });}张量并行模式下,多块 GPU 被合成一个逻辑设备。 后续的层分配、缓冲区选择都只看到这一个 Meta device,真正的切分由 llama_meta_device_get_split_state 回调决定:它根据全局张量编号与分片权重,算出这个张量的哪些维度切给哪些物理设备。这个设计的好处是上层逻辑完全不需要为张量并行写第二套代码——-ngl 仍然是「放几层到设备上」,只不过那个设备是逻辑上的。CPU 设备在这里被跳过:ggml_backend_dev_buffer_type(dev) == ggml_backend_cpu_buffer_type() 判断出来的 CPU 设备不参与张量并行。
第二步:计算分片比例
load_tensors 里先把每个设备的「份额」算出来。默认按空闲显存比例:
bool all_zero = tensor_split == nullptr || std::all_of(tensor_split, tensor_split + n_devices(), [](float x) { return x == 0.0f; });std::vector<float> splits(n_devices());if (all_zero) { for (size_t i = 0; i < n_devices(); ++i) { ggml_backend_dev_t dev = devices[i].dev; size_t total; size_t free; ggml_backend_dev_memory(dev, &free, &total);
// devices can return 0 bytes for free and total memory if they do not // have any to report. in this case, we will use the host memory as a fallback if (free == 0 && total == 0) { ggml_backend_dev_memory(cpu_dev, &free, &total); } splits[i] = free; }} else { std::copy(tensor_split, tensor_split + n_devices(), splits.begin());}默认策略是「按空闲显存加权」,而不是均分。这直接对应「双卡不一样大」的常见场景:24 GB 卡与 12 GB 卡上,前者自动拿到约 2/3 的层。free == 0 && total == 0 的兜底是因为某些后端不上报显存(注释指向的 issue #18577),此时退回到用主机内存估算。
然后是归一化成累积分布:
float split_sum = 0.0f;for (size_t i = 0; i < n_devices(); ++i) { split_sum += splits[i]; splits[i] = split_sum;}for (size_t i = 0; i < n_devices(); ++i) { splits[i] = split_sum != 0.0f ? splits[i] / split_sum : float(i + 1) / n_devices();}累积和再归一化,得到 splits = [s1, s1+s2, ..., 1.0]。这个形状是为了后面用二分查找定位层归属。split_sum == 0 的兜底给出均匀分布。
第三步:层归属(get_layer_buft_list)
核心是这个 lambda,它把「层号」映射到「设备 + 缓冲区类型候选表」:
const int i_gpu_start = std::max(n_layer_all + 1 - n_gpu_layers, 0);const int act_gpu_layers = devices.empty() ? 0 : std::min(n_gpu_layers, n_layer_all + 1);auto get_layer_buft_list = [&](int il) -> llama_model::impl::layer_dev { const bool is_swa = il < n_layer_all && hparams.is_swa(il); if (il < i_gpu_start || (il - i_gpu_start) >= act_gpu_layers) { LLAMA_LOG_DEBUG("load_tensors: layer %3d assigned to device %s, is_swa = %d\n", il, ggml_backend_dev_name(cpu_dev), is_swa); return {cpu_dev, &pimpl->cpu_buft_list}; } const int layer_gpu = std::upper_bound(splits.begin(), splits.begin() + n_devices(), float(il - i_gpu_start)/act_gpu_layers) - splits.begin(); auto * dev = devices.at(layer_gpu).dev; LLAMA_LOG_DEBUG("load_tensors: layer %3d assigned to device %s, is_swa = %d\n", il, ggml_backend_dev_name(dev), is_swa); return {dev, &pimpl->gpu_buft_list.at(dev)};};逐项拆解。
i_gpu_start:GPU 覆盖从哪一层开始。 n_layer_all + 1 - n_gpu_layers——注意 +1,因为输出层算一层。-ngl 20 在 32 层的模型上意味着 i_gpu_start = 33 - 20 = 13,即第 13 到第 32 层(含输出层)放在 GPU 上,第 0 到第 12 层在 CPU 上。放在后面而不是前面,有一个明确理由:输出层与最后几层在解码时是热路径,且 KV 缓存随层数增长——把尾部放 GPU 能让最常用的部分留在快速设备上。std::max(..., 0) 处理 -ngl 大于总层数的情况。
act_gpu_layers:实际能放几层。 std::min(n_gpu_layers, n_layer_all + 1),同样受设备非空约束。devices.empty() 时直接为 0——这就是上一节的 main_gpu < 0 清空设备列表的效果,一次判断完成了「完全不用 GPU」。
layer_gpu = upper_bound(...):用二分查找在累积分布上定位。 std::upper_bound 在 splits(累积归一化数组)上找 float(il - i_gpu_start)/act_gpu_layers 的插入位置,返回第一个「累积份额严格大于该比值」的设备下标。举例:两块卡各自空闲显存 24 GB 与 12 GB,splits 归一化累积后是 [0.667, 1.0];-ngl 覆盖 21 层时,第 0 层对应比值 0,第 13 层对应 13/21 ≈ 0.619,第 14 层对应 0.667——upper_bound 对 0.619 返回下标 0(进第一块卡),对 0.667 返回下标 1(进第二块卡)。层是成块分配的,不是逐层轮流,这保证了同一层的全部张量在同一块卡上,跨设备通信只发生在层边界。这与第二篇讲的 ggml_backend_sched 切图逻辑正好衔接:切图的边界就是这里算出的层分组边界。
is_swa 与日志里的 is_swa = %d 是滑窗注意力(sliding window attention)的标记。它在 get_layer_buft_list 里被算出来并打印,但当前这段代码没有用它做归属决策——它是给后端的缓冲区类型选择提供信息(某些后端对 SWA 层的 KV 布局有不同处理)。日志里保留这个字段,是为了在排查「某层放错地方」时能一眼看出层的类型。
输入层与输出层的特殊处理:
// assign the input layer// there is very little benefit to offloading the input layer, so always keep it on the CPUpimpl->dev_input = { cpu_dev, &pimpl->cpu_buft_list };
// assign the repeating layers to the devices according to the splitspimpl->dev_layer.resize(n_layer_all);for (int il = 0; il < n_layer_all; ++il) { pimpl->dev_layer[il] = get_layer_buft_list(il);}
// assign the output layerpimpl->dev_output = get_layer_buft_list(n_layer_all);输入层永远在 CPU。 注释给出的理由是「卸载输入层几乎没有收益」。技术上更完整的解释是:输入层做的主要是 token 嵌入查表(GGML_OP_GET_ROWS),这是带宽受限的按行取数据,计算量极小;把它放 GPU 需要在每步前向把几千个 embedding 行拷进去或让 GPU 去读一份 CPU 上的词表,收益远小于复杂性。输出层走正常归属规则(get_layer_buft_list(n_layer_all)),所以在 -ngl 覆盖到最后一层时它在 GPU 上——这也是为什么前面 i_gpu_start 计算里要 +1。
第四步:缓冲区类型候选表
有了「层在哪个设备上」,下一步是「这个设备的哪种缓冲区」。load_tensors 构造两张表:
pimpl->cpu_buft_list = make_cpu_buft_list(devices, params.use_extra_bufts, params.no_host);for (const auto & dev : devices) { buft_list_t buft_list = make_gpu_buft_list(dev.dev, split_mode, tensor_split); // add CPU buffer types as a fallback buft_list.insert(buft_list.end(), pimpl->cpu_buft_list.begin(), pimpl->cpu_buft_list.end()); pimpl->gpu_buft_list.emplace(dev.dev, std::move(buft_list));}每条 GPU 的候选表末尾都接上 CPU 候选表,这是一条兜底链:如果这个张量的算子在 GPU 上不被支持,就会落到 CPU 缓冲区类型上——这正是后面 n_tensors_moved 统计的场景。
make_gpu_buft_list 的顺序体现了优先级:
static buft_list_t make_gpu_buft_list(ggml_backend_dev_t dev, llama_split_mode split_mode, const float * tensor_split) { buft_list_t buft_list;
// add the device split buffer type if requested and available if (split_mode == LLAMA_SPLIT_MODE_ROW) { ggml_backend_reg_t reg = ggml_backend_dev_backend_reg(dev); auto ggml_backend_split_buffer_type_fn = (ggml_backend_split_buffer_type_t) ggml_backend_reg_get_proc_address(reg, "ggml_backend_split_buffer_type"); if (ggml_backend_split_buffer_type_fn) { size_t dev_index = [&]() { auto * reg = ggml_backend_dev_backend_reg(dev); for (size_t i = 0; i < ggml_backend_reg_dev_count(reg); ++i) { if (ggml_backend_reg_dev_get(reg, i) == dev) { return i; } } throw std::runtime_error(format("device %s not found in its backend reg", ggml_backend_dev_name(dev))); }(); auto * buft = ggml_backend_split_buffer_type_fn(dev_index, tensor_split); if (buft != nullptr) { buft_list.emplace_back(dev, buft); } } else { throw std::runtime_error(format("device %s does not support split buffers", ggml_backend_dev_name(dev))); } }
// add the device default buffer type buft_list.emplace_back(dev, ggml_backend_dev_buffer_type(dev));
// add the device extra buffer type (if any) ggml_backend_reg_t reg = ggml_backend_dev_backend_reg(dev); if (reg) { auto ggml_backend_dev_get_extra_bufts_fn = (ggml_backend_dev_get_extra_bufts_t) ggml_backend_reg_get_proc_address(reg, "ggml_backend_dev_get_extra_bufts"); if (ggml_backend_dev_get_extra_bufts_fn) { ggml_backend_buffer_type_t * extra_bufts = ggml_backend_dev_get_extra_bufts_fn(dev); while (extra_bufts && *extra_bufts) { buft_list.emplace_back(dev, *extra_bufts); ++extra_bufts; } } }
return buft_list;}顺序是:split 缓冲区类型(SPLIT_MODE_ROW 时)→ 设备默认类型 → 设备额外类型。
SPLIT_MODE_ROW 的 split buffer 排在第一位,因为它是「在同一个张量的行维度上切给多块卡」的方案,必须优先于「整张量放一块卡」。它通过注册表扩展函数取得:ggml_backend_split_buffer_type_fn(dev_index, tensor_split)。注意这里为了把 dev 转成后端内部的设备序号,做了一次 ggml_backend_reg_dev_get 的线性查找——因为 split buffer 的接口是按后端内序号索引的。找不到函数就直接抛异常(而不是静默退化),因为用户显式选择了 ROW 模式,静默退化成另一种语义会让人困惑。
为什么默认类型排在额外类型前面? 默认类型是各后端的主路径(CUDA 的 CUDA0、Metal 的默认 buffer),额外类型通常是特殊用途(例如 CUDA 的 host buffer、固定大小缓冲)。主路径优先是合理的默认。
make_cpu_buft_list 的顺序:
static buft_list_t make_cpu_buft_list(const std::vector<llama_device> & devices, bool use_extra_bufts, bool no_host) { buft_list_t buft_list;
// add ACCEL buffer types for (size_t i = 0; i < ggml_backend_dev_count(); ++i) { ggml_backend_dev_t dev = ggml_backend_dev_get(i); if (ggml_backend_dev_type(dev) == GGML_BACKEND_DEVICE_TYPE_ACCEL) { auto * buft = ggml_backend_dev_buffer_type(dev); if (buft != ggml_backend_cpu_buffer_type()) { buft_list.emplace_back(dev, buft); } } }
// add a host buffer type // storing the tensors in a host buffer is useful when the processing of large batches // is offloaded to a GPU device, since it reduces the time spent on data transfers // generally, this will be done using the first device in the list if (!no_host) { for (const auto & dev : devices) { ggml_backend_buffer_type_t buft = ggml_backend_dev_host_buffer_type(dev.dev); if (buft) { buft_list.emplace_back(dev.dev, buft); break; } } }
// add extra buffer types if (use_extra_bufts) { ... }
// add the CPU buffer type for (size_t i = 0; i < ggml_backend_dev_count(); ++i) { ggml_backend_dev_t dev = ggml_backend_dev_get(i); if (ggml_backend_dev_type(dev) == GGML_BACKEND_DEVICE_TYPE_CPU) { buft_list.emplace_back(dev, ggml_backend_dev_buffer_type(dev)); } }
return buft_list;}第一项是 ACCEL 类型设备(加速器设备,如某些 NPU 后端)。它在最前,意味着「有加速器时优先用加速器」。第二项是 host buffer(pinned 主机内存),注释解释了它的价值:当大批量处理被卸载到 GPU 时,把张量放在主机缓冲区能减少数据传输时间——因为 pinned 内存可以用 DMA 直接搬到 GPU,而普通可换页内存不行。它只取设备列表里的第一块卡(break),并且可以被 no_host(对应 --no-host 参数)关掉。最后才是 CPU 缓冲区类型,作为最终兜底。
第五步:逐张量选择与 -ot 覆盖
create_tensor 里的 buft_for_tensor lambda 是最终的决策点。它按张量所属的层类别选候选表:
const buft_list_t * buft_list;switch (info.layer) { case LLM_TENSOR_LAYER_INPUT: buft_list = buft_list_input; break; case LLM_TENSOR_LAYER_OUTPUT: buft_list = buft_list_output; break; case LLM_TENSOR_LAYER_REPEATING: GGML_ASSERT(buft_list_layer != nullptr); buft_list = buft_list_layer; break; default: GGML_ABORT("invalid layer %d for tensor %s", info.layer, tn.str().c_str());}llm_tensor_info_for(tn_tensor) 给出的 info.layer 把张量分成三类:输入层(词嵌入)、输出层(LM head)、重复层(每一层的注意力与 FFN 权重)。前两类用各自的表(输入表其实就是 CPU 表,因为 dev_input 固定为 CPU),第三类用所属层的表——这正是 dev_layer[il] 的用途。
然后是 -ot(张量缓冲区类型覆盖):
// select the buffer type for this tensorif (tensor_buft_overrides) { std::string tensor_name = tn.str(); for (const auto * overrides = tensor_buft_overrides; overrides->pattern != nullptr; ++overrides) { std::regex pattern(overrides->pattern); if (std::regex_search(tensor_name, pattern)) { if (overrides->buft == ggml_backend_cpu_buffer_type()) { // when overriding to a CPU buffer, consider the extra buffer types buft = select_weight_buft(hparams, t_meta, op, buft_list_cpu); if (use_mmap) { static std::once_flag once; std::call_once(once, [] { LLAMA_LOG_WARN("llama_model_loader: tensor overrides to CPU are used with mmap enabled - consider using --load-mode none for better performance\n"); }); } } else { buft = overrides->buft; }
LLAMA_LOG_DEBUG("tensor %s (%zu MiB %s) buffer type overridden to %s\n", tensor_name.c_str(), ggml_nbytes(t_meta) / 1024 / 1024, ggml_type_name(t_meta->type), ggml_backend_buft_name(buft)); break; } }}三个细节。
-ot 用正则匹配张量名。 tensor_name = tn.str() 会生成 blk.15.ffn_gate_exps.weight 这样的全名,用户可以用 \.ffn_.*_exps\. 这类模式一次性选中所有层的专家权重——这是「把 MoE 专家留在 CPU、其余层放 GPU」的标准做法,也是 -ngl 999 -ot "exps=CPU" 这类常见命令的实现基础。
命中即 break,取第一个匹配的模式。 所以 -ot 列表的顺序有意义:越靠前优先级越高。这与许多工具「最后一条生效」的直觉相反,值得注意。
覆盖到 CPU 时有特殊处理与警告。 如果目标缓冲区类型是 ggml_backend_cpu_buffer_type(),代码不直接用 CPU 类型,而是再走一遍 select_weight_buft(hparams, t_meta, op, buft_list_cpu)——因为 CPU 侧其实有一串候选(ACCEL、host buffer、extra bufts、CPU),既然张量要落在 CPU 侧,就应该享受和普通 CPU 张量一样的选择逻辑。同时打出一条一次性警告:mmap 模式下覆盖到 CPU 会损失性能,建议用 --load-mode none。为什么?因为 mmap 模式下把张量显式放到 CPU 缓冲区会触发一次真实的拷贝(映射区 → CPU 缓冲区),而 mmap 本来就打算零拷贝。这是「配置组合之间相互影响」的典型例子。
第六步:能力校验(weight_buft_supported)
候选表给出了「偏好顺序」,但某个缓冲区类型未必能执行这个张量的算子。select_weight_buft 就是按顺序试:
static ggml_backend_buffer_type_t select_weight_buft(const llama_hparams & hparams, ggml_tensor * tensor, ggml_op op, const buft_list_t * buft_list) { GGML_ASSERT(!buft_list->empty()); for (const auto & cur : *buft_list) { ggml_backend_dev_t cur_dev = cur.first; ggml_backend_buffer_type_t cur_buft = cur.second; if (weight_buft_supported(hparams, tensor, op, cur_buft, cur_dev)) { return cur_buft; } } return nullptr;}第一个能跑就选它。weight_buft_supported 的做法是构造一个真实的小规模算子并问后端是否支持:
static bool weight_buft_supported(const llama_hparams & hparams, ggml_tensor * w, ggml_op op, ggml_backend_buffer_type_t buft, ggml_backend_dev_t dev) { GGML_ASSERT(w != nullptr);
if (op == GGML_OP_NONE) { return true; }
ggml_init_params params = { /*.mem_size =*/ ggml_tensor_overhead()*8, /*.mem_buffer =*/ NULL, /*.no_alloc =*/ true, }; ggml_context_ptr ctx_ptr { ggml_init(params) }; ... ggml_tensor * op_tensor = nullptr;
switch (op) { case GGML_OP_GET_ROWS: { ggml_tensor * b = ggml_new_tensor_1d(ctx, GGML_TYPE_I32, 512); op_tensor = ggml_get_rows(ctx, w, b); } break; case GGML_OP_MUL_MAT: { ggml_tensor * b = ggml_new_tensor_4d(ctx, GGML_TYPE_F32, w->ne[0], 512, w->ne[2], w->ne[3]); op_tensor = ggml_mul_mat(ctx, w, b); } break; case GGML_OP_MUL_MAT_ID: { // Used for either MoE expert routing or embedded adapter routing const int n_ids_used = hparams.router_layer >= 0 ? 1 : hparams.n_expert_used_max(); GGML_ASSERT(n_ids_used > 0); ggml_tensor * b = ggml_new_tensor_3d(ctx, GGML_TYPE_F32, w->ne[0], n_ids_used, 512); ggml_tensor * ids = ggml_new_tensor_2d(ctx, GGML_TYPE_I32, n_ids_used, 512); op_tensor = ggml_mul_mat_id(ctx, w, b, ids); } break; case GGML_OP_ADD: ... case GGML_OP_MUL: ... case GGML_OP_ROPE: ... case GGML_OP_SSM_CONV: ... case GGML_OP_SSM_SCAN: ... case GGML_OP_RWKV_WKV6: ... case GGML_OP_IM2COL: ... case GGML_OP_SCALE: ... default: GGML_ABORT("%s: missing test for op %s for tensor %s", __func__, ggml_op_name(op), w->name); }
// create a temporary dummy buffer for the weight so that supports_op can check the buffer type GGML_ASSERT(w->buffer == nullptr); w->buffer = ggml_backend_buft_alloc_buffer(buft, 0); bool op_supported = ggml_backend_dev_supports_op(dev, op_tensor); ggml_backend_buffer_free(w->buffer); w->buffer = nullptr;
return op_supported;}这段代码有几个值得学的设计。
为什么不用「查表」而用「真正构图」? 因为「某个后端是否支持 Q4_K 权重的 GGML_OP_MUL_MAT」这种问题的答案依赖于后端实现细节与张量的具体形状。CUDA 后端对 mmap 的 MUL_MAT 支持是按(量化类型 × 形状)实现的;Metal 对某些形状有特殊路径。用查表就得维护一张同步表,一旦后端加了新的类型支持就会不同步。构造一个真实(但极小)的算子,把它交给 ggml_backend_dev_supports_op 则总是精确的。
为什么临时缓冲区必须是「零字节的 dummy buffer」? ggml_backend_buft_alloc_buffer(buft, 0)——因为 supports_op 需要 w->buffer 非空来判断「权重来自哪种缓冲区类型」,但它不需要真实内存。分配 0 字节既满足接口要求又不占资源。调用后立刻释放并把 w->buffer 复位为 nullptr,保证不污染后续逻辑(下一行 GGML_ASSERT(w->buffer == nullptr) 就是在守这条)。
b 张量里那个 512 是什么? 它是「测试用批大小」。对 MUL_MAT,b 的形状是 [w->ne[0], 512, w->ne[2], w->ne[3]]——沿批维取 512 个 token。这个数字足够大到能触发后端里「批量路径」的实现,又不至于真的分配大量内存(no_alloc = true,只要元数据)。选 512 而不是 1,是因为很多后端对 batch=1 与 batch>1 走不同 kernel,只测 batch=1 会漏掉大批量路径的不支持。
MUL_MAT_ID 分支里 n_ids_used 为什么与 router_layer 有关? MUL_MAT_ID 同时服务两个场景:MoE 的专家路由与嵌入式适配器(LoRA)路由。hparams.router_layer >= 0 表示这个模型用专家路由,此时 n_ids_used = 1(单个专家 id 就足以测试算子路径);否则按 n_expert_used_max() 构造多个 id。这个细节说明「能力测试的形状要贴近实际使用形状」这条原则。
第七步:mmap 下禁用 host buffer,并统计「被迫移动」
回到 buft_for_tensor,选完缓冲区类型后还有一段修正:
// avoid using a host buffer when using mmapauto * buft_dev = ggml_backend_buft_get_device(buft);if (use_mmap && buft_dev && buft == ggml_backend_dev_host_buffer_type(buft_dev)) { auto * cpu_dev = ggml_backend_dev_by_type(GGML_BACKEND_DEVICE_TYPE_CPU); if (!cpu_dev) { throw std::runtime_error("no CPU backend found"); } buft = ggml_backend_dev_buffer_type(cpu_dev);}
if (buft != buft_list->front().second) { if (n_tensors_moved == 0) { first_tensor_moved_name = t_meta->name; first_tensor_moved_type_name = ggml_type_name(t_meta->type); first_moved_from_buft = buft_list->front().second; first_moved_to_buft = buft; } n_tensors_moved++;}
return buft;第一条修正:mmap 时把 host buffer 替换成 CPU 缓冲区类型。 原因与 -ot 到 CPU 的警告同源——host buffer 是 pinned 内存,mmap 下的张量数据已经在页缓存里,再拷一份到 pinned 内存是纯粹的浪费。换到普通 CPU 缓冲区后,load_all_data 里的 buf_mmap 匹配会命中,走零拷贝路径。
第二条:统计「第一个被迫降级的张量」。 只要最终类型不是候选表的第一项,就说明发生了降级(front() 是首选)。只记住第一个(含张量名、类型、从哪个 buft 到哪个 buft)并计数,然后在 done_getting_tensors 里输出:
if (n_tensors_moved > 0) { LLAMA_LOG_DEBUG("%s: tensor '%s' (%s) (and %zu others) cannot be used with preferred buffer type %s, using %s instead\n", __func__, first_tensor_moved_name.c_str(), first_tensor_moved_type_name.c_str(), n_tensors_moved - 1, ggml_backend_buft_name(first_moved_from_buft), ggml_backend_buft_name(first_moved_to_buft));}「只记第一个」是一个刻意的可观测性设计:如果有 200 个张量降级,逐条打印会淹没日志;给出「第一个 + 还有几个」既让人知道发生了什么,又能通过第一个的名字定位模式(通常降级是整类张量一起发生的,例如「所有 MLA 的 KV 压缩投影都落到 CPU」)。日志级别是 DEBUG,因为它属于排查信息而非正常运行输出。
缓冲区创建:ctx_map 与 buffer_from_host_ptr
张量结构体创建完毕后,load_tensors 进入缓冲区创建阶段。这里的关键结构是 ctx_map——「一个缓冲区类型对应一个 ggml context」:
auto ctx_for_buft = [&](ggml_backend_buffer_type_t buft) -> ggml_context * { const ctx_key key { buft, is_lazy };
auto it = ctx_map.find(key); if (it == ctx_map.end()) { int max_n_tensors = n_tensors; max_n_tensors += 1; // duplicated output tensor max_n_tensors += hparams.n_layer()*2; // duplicated rope freq tensors if (files.empty()) { max_n_tensors += hparams.n_layer()*256; // this should be well above what any model actually uses } const size_t ctx_size = ggml_tensor_overhead()*max_n_tensors;
ggml_init_params params = { /*.mem_size =*/ ctx_size, /*.mem_buffer =*/ NULL, /*.no_alloc =*/ true, };
ggml_context * ctx = ggml_init(params); ... ctx_map.emplace(key, ctx); return ctx; } return it->second.get();};为什么按缓冲区类型分 context? 因为一个 ggml_backend_buffer 是由一个 context 里的全部张量一次性分配的(ggml_backend_alloc_ctx_tensors_from_buft(ctx, buft))。要让「同类型的张量聚在一块缓冲区里」,就必须让它们属于同一个 context。这也让后面的 ctx_bufs 循环(每个 context 分配一块或几块缓冲区)变得直接。
max_n_tensors 的估算值得注意:它从文件里声明的张量数出发,加上「重复的输出张量」(某些模型把词嵌入同时当输出层,需要两份结构体)、「每层两个重复的 RoPE 频率张量」,并且在 files.empty()(虚拟模型,无文件)时给出一个宽松上限。多估一点无害(只是多占几个 ggml_tensor 结构体的元数据内存),估少了会直接 GGML 断言失败,所以这里取的是保守方向。
真正创建缓冲区时,mmap 路径与非 mmap 路径分叉:
for (auto & [ctx_key, ctx_ptr] : ml.ctx_map) { ggml_backend_buffer_type_t buft = ctx_key.buft; ggml_context * ctx = ctx_ptr.get();
if (ggml_get_first_tensor(ctx) == nullptr) { continue; }
ggml_backend_dev_t dev = ggml_backend_buft_get_device(buft); if (!dev) { dev = ggml_backend_dev_by_type(GGML_BACKEND_DEVICE_TYPE_CPU); if (!dev) { throw std::runtime_error(format("%s: no CPU backend found", __func__)); } } ggml_backend_dev_props props; ggml_backend_dev_get_props(dev, &props); bool buffer_from_host_ptr_supported = props.caps.buffer_from_host_ptr; bool is_default_buft = buft == ggml_backend_dev_buffer_type(dev);
std::vector<ggml_backend_buffer_ptr> bufs;
const bool is_lazy_mapped = ctx_key.lazy && !ml.no_alloc;
if ((ml.use_mmap || is_lazy_mapped) && use_mmap_buffer && buffer_from_host_ptr_supported && is_default_buft) { GGML_ASSERT(!ml.no_alloc); const size_t max_size = ggml_get_max_tensor_size(ctx);
for (uint32_t idx = 0; idx < ml.files.size(); idx++) { void * addr = ml.mappings.at(idx)->addr();
for (const auto & range : ml.get_mapping_ranges(idx, ctx)) { ggml_backend_buffer_t buf = ggml_backend_dev_buffer_from_host_ptr(dev, (char *) addr + range.first, range.last - range.first, max_size); if (buf == nullptr) { throw std::runtime_error(format("unable to allocate %s buffer", ggml_backend_buft_name(buft))); } bufs.emplace_back(buf); } } } else { ggml_backend_buffer_t buf; if (ml.no_alloc) { buf = ggml_backend_buft_alloc_buffer(buft, /*size =*/ 0); // dummy buffer for (ggml_tensor * t = ggml_get_first_tensor(ctx); t != nullptr; t = ggml_get_next_tensor(ctx, t)) { t->buffer = buf; // set dummy buffer for weights so that the backend scheduler won't try to allocate them } } else { buf = ggml_backend_alloc_ctx_tensors_from_buft(ctx, buft); // real buffer } if (buf == nullptr) { throw std::runtime_error(format("unable to allocate %s buffer", ggml_backend_buft_name(buft))); } ... bufs.emplace_back(buf); }mmap 路径的核心是 ggml_backend_dev_buffer_from_host_ptr:它把一个「主机指针 + 长度」包装成一个后端缓冲区,让张量直接指向 mmap 区。四个成条件缺一不可:use_mmap(或用的是惰性上下文且不是 no_alloc)、use_mmap_buffer(常量 true)、设备支持 buffer_from_host_ptr、这个缓冲区类型是该设备的默认类型。
最后一条限制(is_default_buft)值得解释:buffer_from_host_ptr 对非默认类型不成立,因为自定义缓冲区类型往往有额外的元数据与对齐要求(例如 CUDA 的 split buffer 需要知道分片信息)。这也解释了为什么前面 create_tensor 里要把 mmap 下的 host buffer 换成 CPU 默认类型——换成默认类型才能命中这条零拷贝路径。
max_size = ggml_get_max_tensor_size(ctx) 是给后端的一个提示:这块缓冲区里最大的张量有多大。后端用它判断是否需要预先保留额外的对齐空间。
get_mapping_ranges(idx, ctx) 的必要性在注释里:
// map the mmap regions that contain the tensors of this context// this is important for metal with apple silicon: a backend buffer pins everything it// wraps, so the regions owned by the other contexts (lazy tensors read on demand// from disk, MoE tensors kept on the CPU, etc) are left out and stay out of RAM// this also allows using partial offloading when the model size exceeds the metal buffer// size, but not the RAM size关键约束:后端缓冲区会「钉住」它包装的整段主机内存。 对 Apple Silicon 的 Metal(统一内存,GPU 能直接访问主机内存)这个约束尤其尖锐:如果为 GPU 上下文创建的缓冲区覆盖了整段映射区(包括那些本来要留在 CPU 上的 MoE 专家张量),这些张量也会被钉进 GPU 可访问的内存,白白占掉 GPU 侧配额。
于是有了 get_mapping_ranges:
std::vector<llama_model_loader::mapping_range> llama_model_loader::get_mapping_ranges(uint32_t idx, ggml_context * ctx) const { GGML_ASSERT(idx < mappings.size());
// data of this context, and data of the other contexts that share the same file // a weight that is mapped in several contexts (e.g. the token embedding) is not foreign data std::unordered_set<const llama_tensor_weight *> own; mapping_ranges own_ranges; mapping_ranges other;
for (ggml_tensor * tensor = ggml_get_first_tensor(ctx); tensor; tensor = ggml_get_next_tensor(ctx, tensor)) { const auto * weight = get_weight(ggml_get_name(tensor)); if (!weight || weight->idx != idx) { continue; } own.insert(weight); own_ranges.push_back({ weight->offs, weight->offs + ggml_nbytes(tensor) }); }
for (const auto & it : ctx_map) { if (!it.second || it.second.get() == ctx) { continue; } for (ggml_tensor * tensor = ggml_get_first_tensor(it.second.get()); tensor; tensor = ggml_get_next_tensor(it.second.get(), tensor)) { const auto * weight = get_weight(ggml_get_name(tensor)); if (!weight || weight->idx != idx || own.count(weight)) { continue; } other.push_back({ weight->offs, weight->offs + ggml_nbytes(tensor) }); } }
return sub_ranges(merge_ranges(std::move(own_ranges)), merge_ranges(std::move(other)));}算法是三步的区间集合运算:① 收集本 context 在这个文件里的张量区间(own);② 收集其他 context 在同一文件里的张量区间(other);③ sub_ranges(own, other) 做差集。差集的语义是「本 context 需要、且只属于本 context 的字节区间」。
为什么需要做差? 因为同一段字节可能被多个 context 引用(注释点名的例子是 token embedding——它可能同时出现在 CPU context 与输出 context 里)。如果直接把 own 的全部区间都交给缓冲区,就会出现「两块缓冲区覆盖同一段内存」,浪费并且可能引起不一致。own 集合(std::unordered_set<const llama_tensor_weight *>)配合 own.count(weight) 判断,正确地排除了「本 context 也用、别的 context 也用」的共享字节——共享数据交给第一个(或某个)context 就够了,反正它已经在映射区里,其他 context 的算子可以读同一块内存。
merge_ranges 把重叠区间合并,sub_ranges 做有序差集,两个辅助函数都很直白:
static mapping_ranges merge_ranges(mapping_ranges ranges) { std::sort(ranges.begin(), ranges.end(), [](const auto & a, const auto & b) { return a.first < b.first; });
mapping_ranges res; for (const auto & range : ranges) { if (!res.empty() && range.first <= res.back().last) { res.back().last = std::max(res.back().last, range.last); } else { res.push_back(range); } }
return res;}结果是:每个 context 拿到一串「互不重叠且不含他人数据」的字节区间,每个区间包装成一块 buffer_from_host_ptr 缓冲区。前面 load_all_data 里那个 buf_mmap 查找循环(在 bufs 里找覆盖当前张量地址的那一块)就是为这个多缓冲区布局准备的。
非 mmap 路径简单得多:ggml_backend_alloc_ctx_tensors_from_buft(ctx, buft) 一次性为本 context 的全部张量分配真实内存。no_alloc 模式下的 dummy buffer 也在这一段——它把所有张量的 buffer 指向一块零字节缓冲区,目的是「让后端调度器不要试图为权重分配内存」(第二篇讲的 ggml_backend_sched 会把权重张量当作「已在缓冲区里」处理)。
最后一步是把权重缓冲区的用途标记出来:
for (auto & buf : bufs) { // indicate that this buffer contains weights // this is used by ggml_backend_sched to improve op scheduling: ops that use a weight are preferably scheduled to the backend that contains the weight ggml_backend_buffer_set_usage(buf.get(), GGML_BACKEND_BUFFER_USAGE_WEIGHTS); buf_ptrs.emplace_back(buf.get());}GGML_BACKEND_BUFFER_USAGE_WEIGHTS 是给切图用的信号:第二篇讲过 ggml_backend_sched 的 Pass 1 会「从已经确定的事实出发」判定算子归属,其中一条事实就是「权重已经在这块设备的缓冲区里」——用权重的算子优先调度到权重所在的设备,避免搬权重(搬权重比搬激活贵得多)。装载路径打的这个标记,就是那条规则的输入。
随后是 ctxs_bufs 与 ctx_bufs 的组装,前者持有所有权(ggml_context_ptr + 缓冲区指针),后者是给 load_all_data 用的裸指针视图:
pimpl->ctxs_bufs.emplace_back(std::move(ctx_ptr), std::move(bufs));ctx_bufs.emplace_back(ctx, std::move(buf_ptrs));所有权与视图分离的理由是 load_all_data 只需要指针,不需要(也不应该)参与生命周期管理。ctxs_bufs 挂在 pimpl 上,随模型对象一起析构。
装载完成后的收尾
load_all_data 返回后,load_tensors 还有三件收尾工作。
第一件,mmap 的所有权移交:
if (use_mmap_buffer) { for (auto & mapping : ml.mappings) { pimpl->mappings.emplace_back(std::move(mapping)); }}映射的生命周期必须长于装载器对象——张量的 data 指针指向映射区,如果映射被 llama_mmap 的析构函数解除,所有指向它的张量都会变成悬垂指针。把 unique_ptr 移动给模型对象,保证映射与模型同生命周期。
第二件,Hadamard 折叠(load_tensors_hadamard())。这是某些新架构(Prism 系列量化)用的预处理:元数据里带 prism.hadamard.version 与 prism.hadamard.tied_output,装载后需要对部分权重做 Hadamard 变换的折叠。
第三件,显存与层分布的日志:
if (llama_supports_gpu_offload()) { const int n_gpu = std::min(n_gpu_layers, n_layer_all);
int n_repeating = n_gpu; if (n_repeating > 0) { LLAMA_LOG_INFO("%s: offloading output layer to GPU\n", __func__); n_repeating--; } LLAMA_LOG_INFO("%s: offloading %d repeating layers to GPU\n", __func__, n_repeating); ...}
// print memory requirements per buffer typefor (auto & [_, bufs] : pimpl->ctxs_bufs) { for (auto & buf: bufs) { LLAMA_LOG_INFO("%s: %12s model buffer size = %8.2f MiB\n", __func__, ggml_backend_buffer_name(buf.get()), ggml_backend_buffer_get_size(buf.get()) / 1024.0 / 1024.0); }}n_repeating-- 那一段对应前面 i_gpu_start 里的 +1:-ngl 覆盖的层里有一层是输出层,其余才是重复层。日志里把两者分开报,用户看到 offloading output layer to GPU + offloading N repeating layers 就能对上自己给的值。
「每个缓冲区类型的显存占用」这一行是排查「为什么显存不够」的第一手材料——它按缓冲区逐块打印,能直接看出权重分别落在哪些设备、各占多少。它也为后续的 llama_context 显存规划提供了输入:KV 缓存与计算缓冲区的预算是在权重的实际占用确定之后才算的。
四种装载模式的取舍:一张表与三条判据
把前面所有机制合起来,四种模式的实际行为可以归纳成一张表:
| 模式 | 字节如何进内存 | 峰值主机内存 | CPU 侧解码速度 | 典型适用 |
|---|---|---|---|---|
NONE | read_raw 直读进权重缓冲区 | ≈ 权重总量(含 GPU 侧的主机副本) | 稳定、快 | 内存充足、追求确定性 |
MMAP | 按需缺页,页缓存承载 | 可小于权重总量 | 受内存压力与磁盘影响 | 模型接近或超过可用内存 |
MLOCK / MMAP_MLOCK | 映射后 mlock 锁定常驻 | ≈ 权重总量(不可换出) | 稳定、快 | 内存足够、要求低抖动 |
DIRECT_IO | 绕过页缓存,64 MiB 大块直读 | 暂存缓冲 + 目标缓冲区 | 一次性装载快,重复访问不占缓存 | 装载后不再重复读的场景 |
判据有三条。
第一条:模型能否完全装进内存。 能装下就选 NONE 或 MLOCK——NONE 少了页表与缺页的开销,MLOCK 多了抗内存压力的能力。装不下就必须用 MMAP,让内核按需把它需要的页调进来。AUTO 的默认行为正是这条:在 load_tensors 里,它检查每块设备的 props.caps.mmap_support,只要有设备不支持 mmap 就退回 NONE:
if (ml.use_mmap && params.load_mode == LLAMA_LOAD_MODE_AUTO) { for (const auto & dev : devices) { ggml_backend_dev_props props; ggml_backend_dev_get_props(dev.dev, &props); if (!props.caps.mmap_support) { ml.use_mmap = false; break; } }}
// resolve AUTO on systems without mmap support (e.g. iGPUs): fall back to OFF; see #28160if (ml.lazy.mode == LLAMA_LAZY_MODE_AUTO) { for (const auto & dev : devices) { ... if (!props.caps.mmap_support) { ml.lazy.mode = LLAMA_LAZY_MODE_OFF; break; } }}注意第二段对惰性读取也做了同样的降级,因为上一节讲过惰性读取依赖 mmap。注释点名的例子是 iGPU——某些集成显卡后端不支持 mmap 加载,此时必须回退。
第二条:是否在意尾延迟抖动。 如果关注,用 MLOCK 系列。mmap 的抖动来自缺页:每一次新的页访问都要等磁盘,而 MLOCK 之后所有页都已驻留,不存在缺页。代价是「锁住的内存不能被别的进程使用」,在多租户机器上要谨慎。
第三条:是否要同时把大张量留在磁盘。 那就在 mmap 之上再加 --lazy,让 PLE/Engram 这类张量按需读取。前面已经讲过它的四道门与专用缓冲区。
关于 direct I/O 的 --load-mode direct-io,值得补一句它的取舍边界。它绕过页缓存,代价是每次读到同一份数据都要真实访问设备(没有缓存命中),收益是不污染页缓存。所以它的适用场景很窄:一次性装载、装载后内存里一直有完整副本、且不想让装载把页缓存里的其他有用数据挤掉。如果模型在解码时要反复读(MMAP 的常态),direct I/O 会让每一步都付设备访问成本。LLAMA_DIRECT_IO_BUFFER_SIZE(64 MiB)与 4 块轮转缓冲就是为「一次性大吞吐」优化的配置。
与 vLLM/SGLang 的装载路径对照
这一节不是为了凑结构,而是因为「装载」这件事在两个生态里的分工完全不同,理解差别有助于把知识串起来。
vLLM 的权重装载走的是 torch.load / safetensors 读进 CPU 内存,再按 tensor_parallel_size 与 pipeline_parallel_size 切片,最后 tensor.to(device) 搬到 GPU。量化权重由 GPTQ/AWQ/Marlin 等 kernel 在 GPU 上现场解量化。装载路径完全依赖 PyTorch 的存储层,没有自己的 mmap 逻辑(vLLM 有 --load-format 与 use_tqdm 之类的选项,但底层是 safetensors 库)。站内 Marlin 完全拆解:4-bit 权重如何喂满 GPU Tensor Core 与 AWQ 完全拆解:只保护 1% 的显著权重,4-bit 量化如何接近无损 讲过那些 kernel 侧的机制。
SGLang 同样基于 safetensors,但它的 model_loader 有分层的加载器抽象(DefaultModelLoader、LayersModelLoader 等),支持从 CPU 逐层加载并做 --load-format 选择。站内 SGLang 源码完全拆解(一):整体架构、进程拓扑与请求数据流 有整体架构的对照。
llama.cpp 的差别有三条。 第一,它自己做 mmap:权重不需要经过一个中间的主机副本,映射区可以同时是 CPU 计算的数据源与 buffer_from_host_ptr 的基底。第二,量化是一等公民:GGUF 里的 Q4_K 权重不需要解量化成 fp16 就能被算子消费,所以装载路径里没有「反量化」这一步,只有「搬到位置」。第三,放置决策在用户手里:-ngl/-ot/--split-mode 让用户逐层甚至逐张量指定位置,而 vLLM/SGLang 的放置由并行配置与显存管理器统一决定。
这三条差别的共同根源是目标场景:llama.cpp 面向「单机、异构、内存受限」,所以它必须把「文件到内存」这一段做到极致且可配置;vLLM/SGLang 面向「服务器、同构、显存充足」,所以它们可以把这一段交给成熟生态,把工程力集中在调度与批处理上。
小结
本篇沿 src/llama-model-loader.cpp、src/llama-mmap.cpp、src/llama-model.cpp、src/llama.cpp 走完了 llama.cpp 的装载与放置路径,核心结论有八条。
第一,装载由三个对象分工完成:llama_model_loader 管文件侧(GGUF 解析、张量索引、mmap、数据搬运),llama_model 管设备侧(设备枚举、层归属、缓冲区类型选择),llama_context 管运行时(KV 缓存与计算缓冲区)。它们之间的接口是 create_tensor 的回调式协作——模型决定「用哪种缓冲区类型」,装载器只负责执行这个决定。
第二,GGUF 解析只读元数据不读数据(gguf_init_from_file 配合 no_alloc = true),产出的 weights_map 是「张量名 → 文件 + 绝对偏移」的统一索引。多文件切分在此被合并成一张表,上层完全不需要感知切分。done_getting_tensors 用 n_created 与 n_tensors 的比对抓住「架构实现与文件不匹配」。
第三,mmap 的本质是把读取推迟到第一次访问。装载阶段 ggml_backend_tensor_alloc 只把张量的 data 指向映射区地址,不读字节。POSIX_FADV_SEQUENTIAL 加大预读窗口,MAP_POPULATE 在无惰性区间时一次性建立全部页表项,MADV_WILLNEED 做区间级异步预取,MADV_RANDOM 抑制惰性区间的预读。unmap_fragment 在装载后把无用区间按页对齐地归还地址空间。
第四,llama_mlock 是抗抖动的工具,它按张量顺序增量式 grow_to 推进锁定范围,并且显式排除惰性张量——因为锁定会把惰性张量整个页进来,与按需读取的意图冲突。
第五,惰性读取有一个 4 GiB 的自动阈值与 mmap 硬依赖,惰性张量强制落在 CPU 缓冲区类型上(无视 -ngl),并使用专用 ggml context 与专用缓冲区。它服务的是 PLE/Engram 这类「单个几 GB、每次只用一小部分」的张量。
第六,load_all_data 有三条分支:mmap 零拷贝直映射、非 mmap 主机缓冲区直读、非 mmap 设备缓冲区经 pinned 内存 + 4 块轮转缓冲异步上传。异步路径围绕对齐展开,多读的字节必须精确剔除,唯一阻塞点是复用缓冲区前的 event_synchronize。--check-tensors 用 std::async 并行做格式自洽性校验。
第七,张量放置是一条「设备枚举 → 分片比例 → 层归属 → 缓冲区候选表 → 逐张量选择 → 能力校验」的决策链。设备枚举按 device_id 去重、RPC 优先、iGPU 有独显时不启用;分片比例默认按空闲显存加权并归一化成累积分布;层归属用 upper_bound 在累积分布上二分、层成块分配、输入层固定 CPU、输出层参与正常归属;缓冲区候选表把 CPU 表接在 GPU 表后面作为兜底;逐张量选择先看 -ot 正则覆盖(首个匹配生效),再做 weight_buft_supported 的真实算子构造式能力校验。
第八,缓冲区创建的核心是 ctx_map 与 get_mapping_ranges。一个缓冲区类型一个 context;mmap 下用 buffer_from_host_ptr 把映射区片段直接包装成后端缓冲区,前提是设备支持该能力且缓冲区类型是默认类型;get_mapping_ranges 用「本 context 区间减去其他 context 区间」的集合运算,精确地只把本 context 独占的字节交给缓冲区,避免后端缓冲区钉住不该钉住的内存(这对 Apple Silicon 的统一内存尤其重要)。缓冲区被标记为 GGML_BACKEND_BUFFER_USAGE_WEIGHTS,成为后续切图时算子归属判定的输入。
下一篇进入 llama.cpp 源码完全拆解(四):llama_context 与记忆系统——沿 src/llama-context.cpp 与 src/llama-kv-cache.h 看上下文初始化时如何根据权重占用算出 KV 缓存与计算缓冲区的预算、llama_memory_i 接口如何抽象「KV 缓存」与「循环状态」两类记忆、slot_info 与序列操作如何支撑多序列批处理、以及 KV 缓存的量化存储(--cache-type-k/--cache-type-v)如何与权重的量化类型共用同一套块布局。站内已有 KIVI 完全拆解:非对称 2-bit KV Cache 量化,为什么 Key 按通道、Value 按 token 与 vAttention 完全拆解:用 CUDA 虚拟内存保住连续 KV Cache 分别从量化与虚拟内存角度讲过 KV 缓存,那一篇补的是 llama.cpp 自身的记忆抽象。
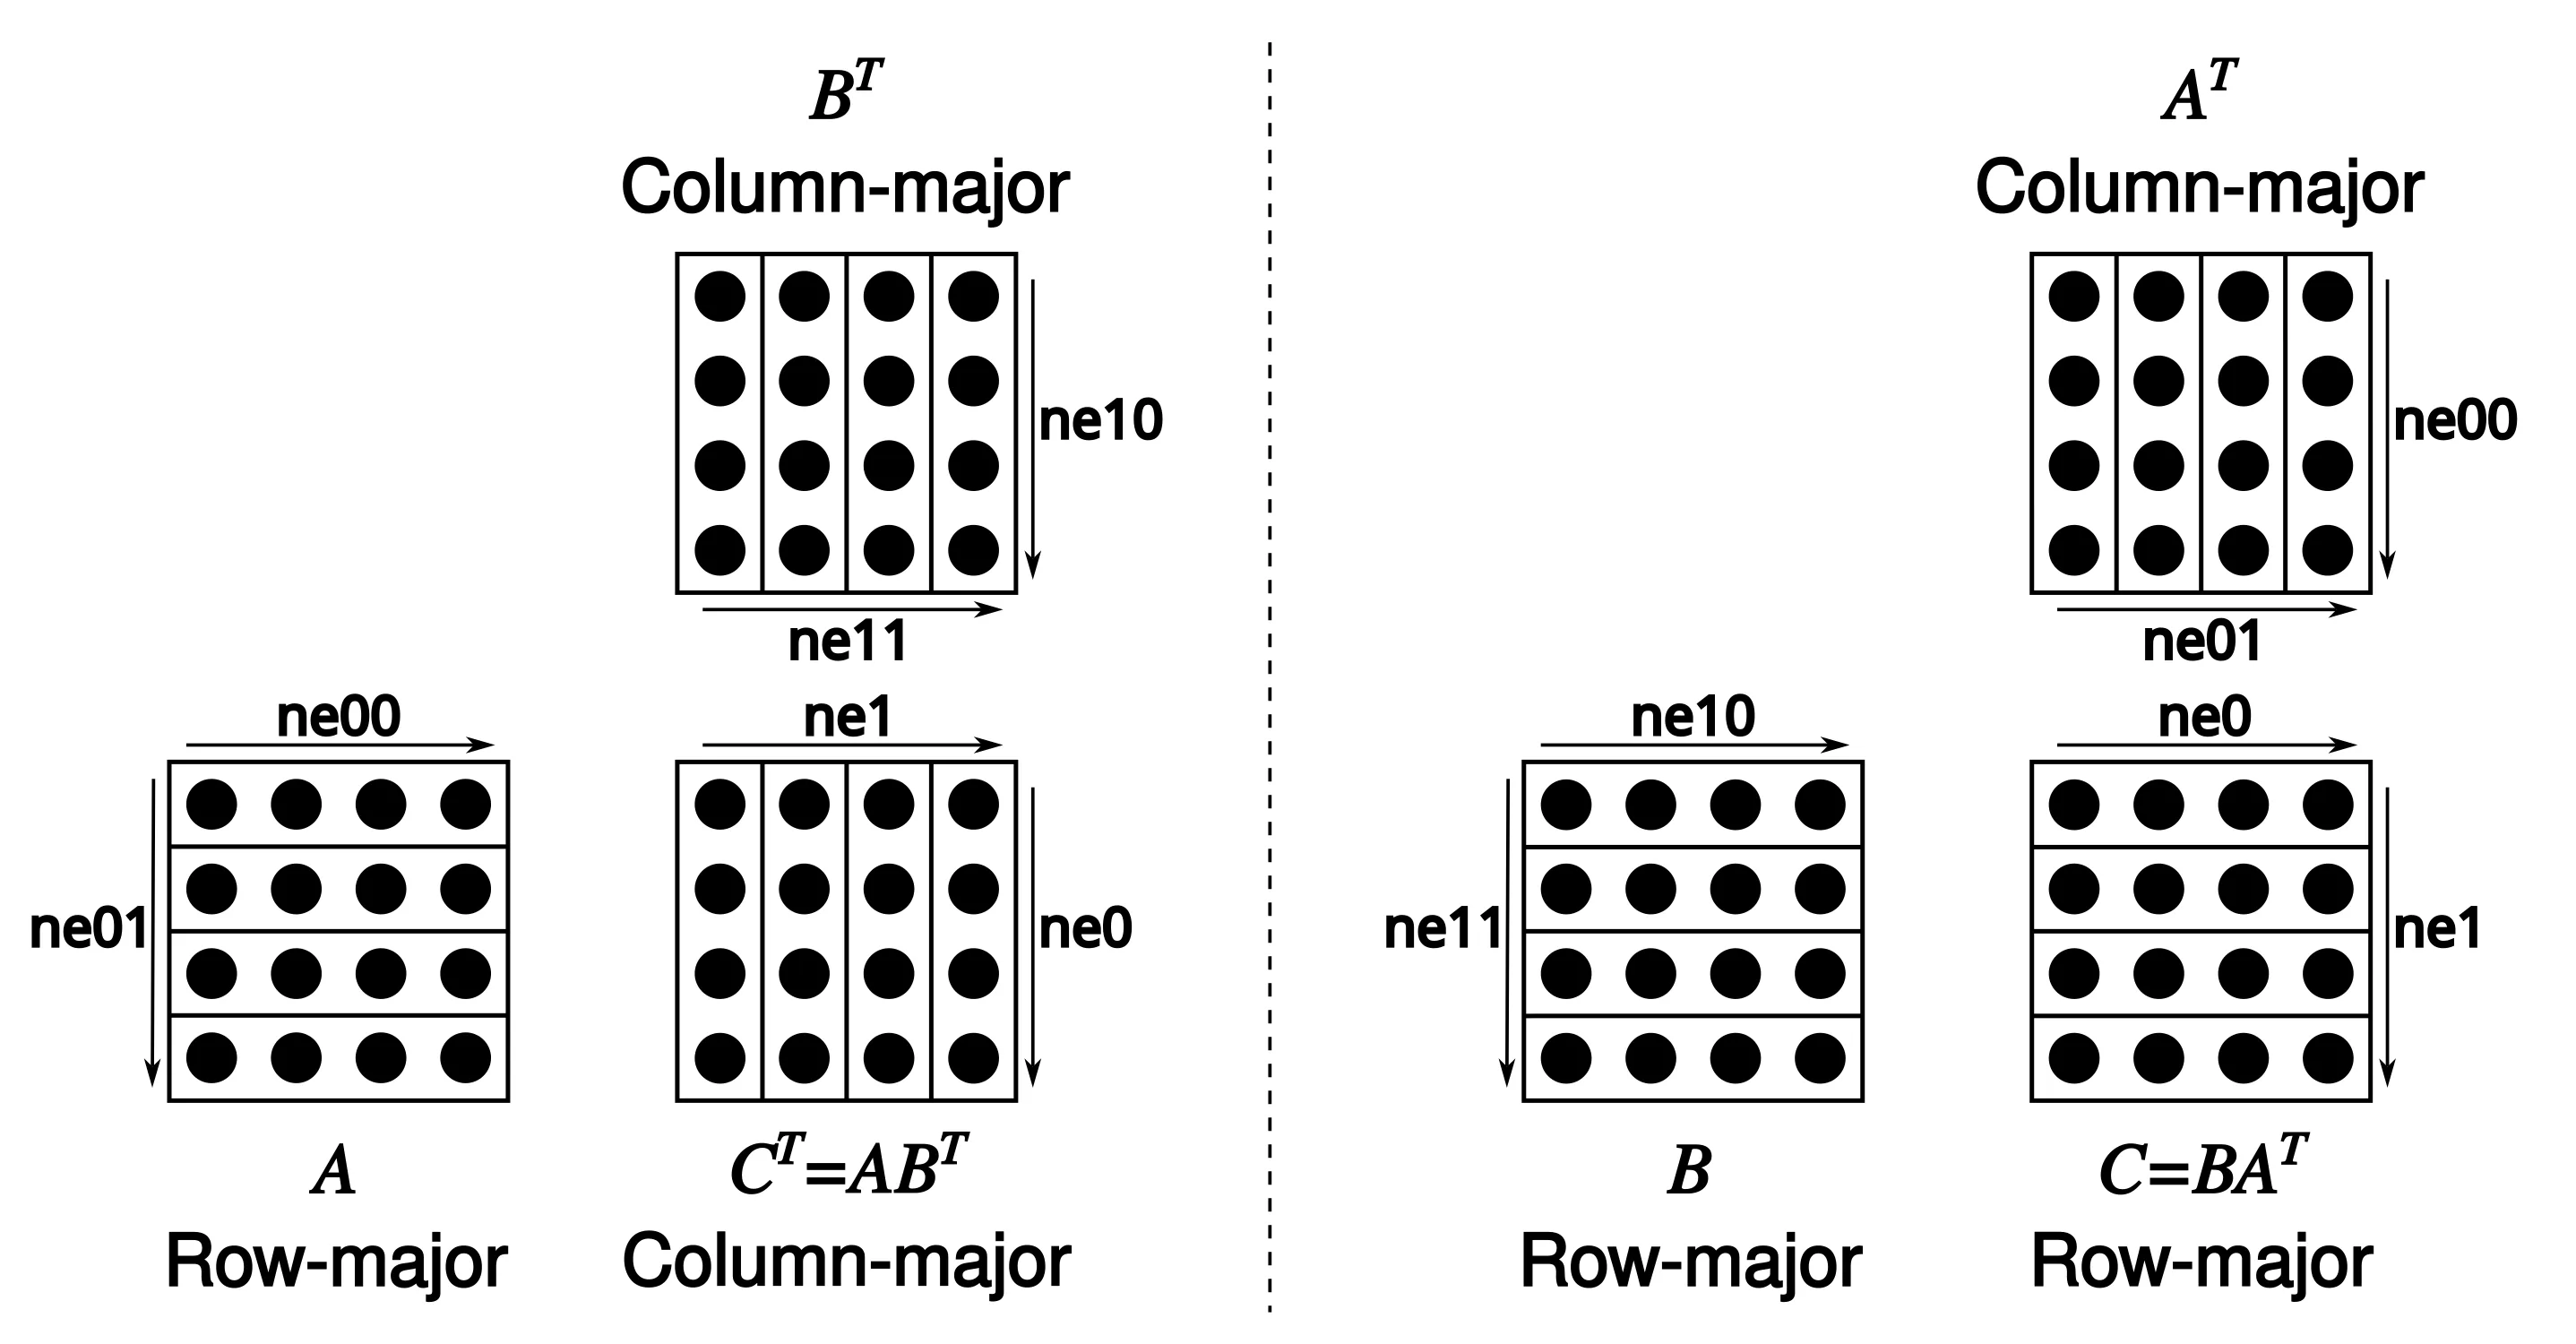
上图(来源:llama.cpp 官方仓库 media/matmul.png)是 ggml 里量化矩阵乘的布局示意。它与本篇的接口在两处:第一,图中按块存储的权重正是 llama_tensor_weight 里 ggml_nbytes(tensor) 的计算依据——一个 Q4_K 张量的字节数由 ne[0]/256 × 块大小 决定,装载器的边界检查与进度统计都用这个值;第二,因为量化块在文件里就是最终内存布局,mmap 之后的映射区可以直接被 kernel 消费,这正是装载路径里没有「反量化」步骤的原因。
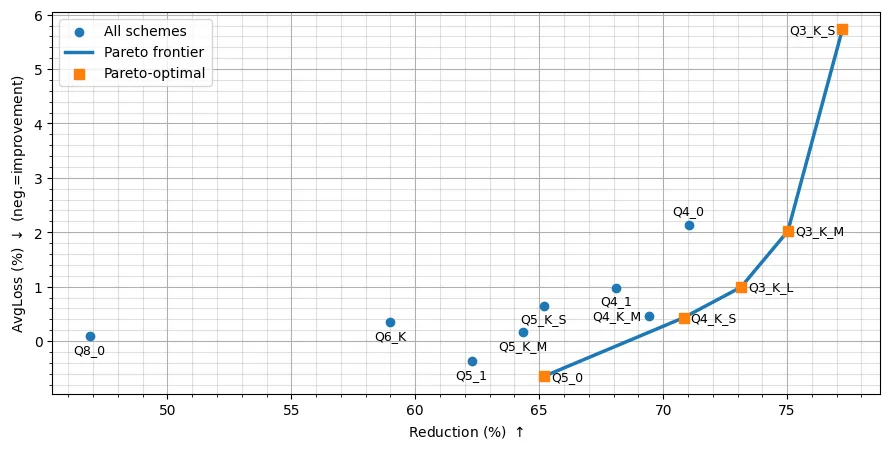
上图(来源:arXiv 论文《Which Quantization Should I Use? A Unified Evaluation of llama.cpp Quantization on Llama-3.1-8B-Instruct》,图 1)给出压缩率与基准质量损失的关系。把它放在这里是因为它解释了「装载路径为什么值得为一个文件格式投入这么多代码」:4 bit 档位(Q4_K_M 一类)在体积压到约 70% 的同时质量损失接近于零,而跨到 3 bit 以下损失迅速变大。装载器的 BPW(bits per weight)报告与这些档位一一对应,用户选择哪个档位直接决定 weights_map 的总体积,进而决定 mmap 是否必要、-ngl 能放几层。GGUF 完全拆解 讲过这些档位的位级排布,本篇补上它们在装载路径上的后果。
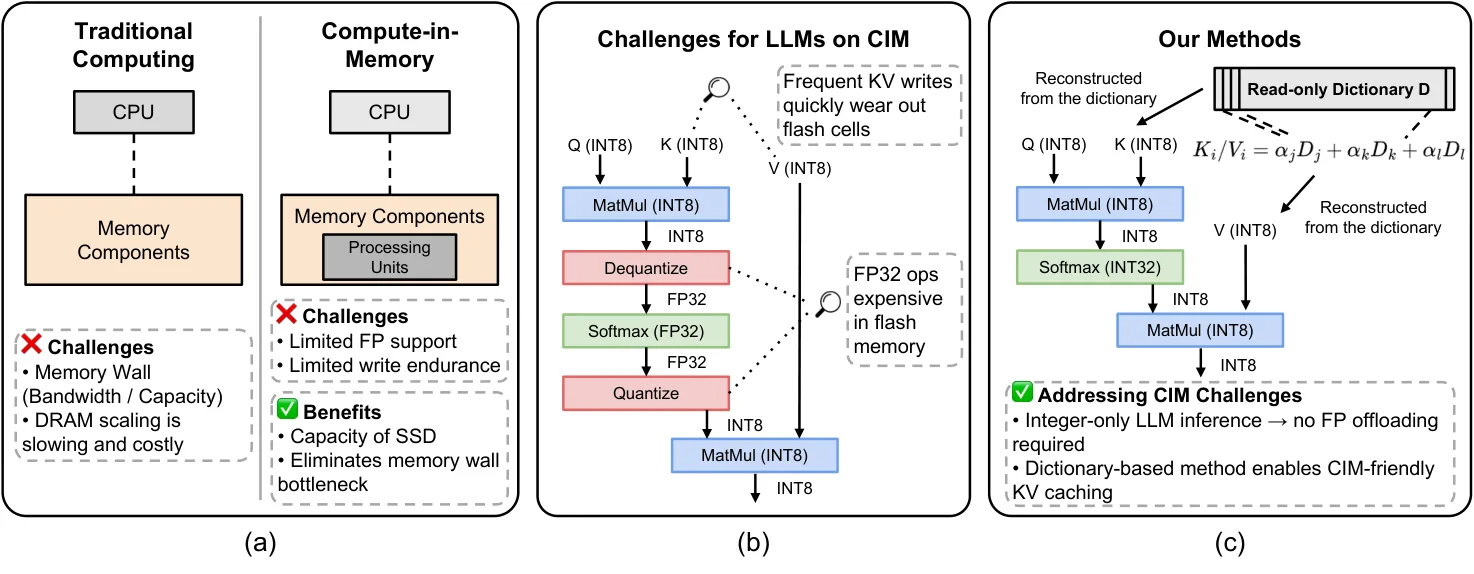
上图(来源:arXiv 论文《LLM Inference in a Flash!》,图 1)展示了一条与本篇互补的技术路线:把权重压缩到可以在存储与内存之间高效流式传输的程度。llama.cpp 的 mmap 与惰性读取解决的是「权重以什么形式驻留、何时从磁盘进入内存」,而这类工作关注的是「进入内存之后如何进一步减少需要搬运的字节」。两条路线在「内存受限 + 存储介质」这个共同约束下交汇:llama.cpp 用页缓存与按需缺页;站内 KV Cache Offloading 完全拆解:把显存装不下的历史塞进 CPU、SSD 与远端内存 与 FlexGen 完全拆解:用线性规划编排 GPU、CPU 与 SSD 上的大模型推理 讲的是 KV 与激活侧的同类问题。
参考资料
- llama.cpp 官方仓库(src/ 与 ggml/ 源码)
src/llama-model-loader.cpp:GGUF 装载器主体与load_all_datasrc/llama-model-loader.h:llama_tensor_weight、lazy_read与装载器接口src/llama-mmap.cpp:llama_file、llama_mmap、llama_mlock的跨平台实现src/llama-mmap.h:内存映射抽象接口与 direct I/O 缓冲尺寸常量src/llama-model.cpp:load_tensors、make_cpu_buft_list、make_gpu_buft_list与缓冲区创建src/llama.cpp:llama_prepare_model_devices与llama_model_loadggml/src/gguf.cpp:GGUF 二进制格式解析实现- ggml 仓库 GGUF 格式规范文档
- llama.cpp 官方文档:多 GPU 使用与 split mode 说明
- Which Quantization Should I Use? A Unified Evaluation of llama.cpp Quantization on Llama-3.1-8B-Instruct
- LLM Inference in a Flash!
- llama.cpp 官方仓库 media 目录(ggml 矩阵乘布局示意)
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



