


SanDisk 高带宽闪存(HBF)Tutorial:从 NAND 堆叠到 LLM 推理内存层的完整拆解
HBF 是什么:介于 HBM 与 SSD 之间的新内存层
高带宽闪存(High Bandwidth Flash,HBF)概念由 SanDisk 在 2025 年提出,并在 2025 年 8 月的 FMS 上首次公开展示;随后 SanDisk 与 SK hynix 启动标准化合作,2026 年 8 月 4 日两家公司通过 OCP(Open Compute Project)在 FMS 2026 上发布了第一版 HBF 标准规范。这份规范名为 High Bandwidth Flash Specification,版本 v0.7,共 130 页,落款日期 2026 年 8 月 3 日,公开在 OCP 网站上。它是目前关于 HBF 最完整、最权威的一手文档,本文的主干内容全部来自这份规范,外加两家厂商的新闻稿、FMS 2026 的主题演讲以及与 HBF 相关的最新论文。
要一句话说清楚 HBF:把 NAND 闪存裸片像 HBM 那样垂直堆叠在加速器旁的硅中介层或封装里,用 UCIe 片间接口直连 GPU/xPU,从而在接近 HBM 的读取带宽下拿到 8 到 16 倍的容量。
OCP 规范的开篇是这么定义它的:
High Bandwidth Flash (HBF), a non-coherent memory-centric flash device, will redefine AI infrastructure by providing extremely high TB/s bandwidth with very high capacity. The HBF sits very close to the GPU/TPU/xPU data processing units. HBF addresses the memory wall problem, where wide-IO NAND-based memory architecture offers 8x to 16x of the capacity of HBM, while delivering the same read bandwidth.
拆开这句话有几个关键信息:
- non-coherent:HBF 不是缓存一致性的 DRAM,它是”以内存为中心”的设备,CPU 和 GPU 之间的地址空间各管各的,没有 cache coherent 语义。这决定了它在软件层更像”慢一点的、可被随机访问的外存”,而不是系统内存;
- close to xPU:它必须紧贴处理单元放置,通过 UCIe 这种 die-to-die 接口连接,而不是走 PCIe 或 CXL 挂到远端;
- same read bandwidth with 8x-16x capacity:读取带宽对标 HBM,容量对标 SSD 区间的起点——一个 HBM4 cube 大约是 36 至 48 GB,HBF 单个 16 层堆叠就是 512 GiB。
站在存储层级的视角,HBF 补的是一块一直缺失的拼图:HBM 有带宽没容量,SSD 有容量没带宽,中间”TB 级容量 + TB/s 级带宽”的区间过去只能靠 DDR 主存勉强撑住,而 DDR5 每堆叠的带宽只有几十 GB/s 量级。
如果对 HBF 与 HBM 混合架构的设计空间感兴趣,可参考 H³ 完全拆解;OCP 规范中通道、地址映射与 LLM 应用的要点,在 HotChip/FMS 内存墙(二) 里已有概览。
| 层级 | 典型延迟 | 每堆叠带宽 | 容量 | 是否易失 | 到处理器距离 |
|---|---|---|---|---|---|
| SRAM(片上) | 约 1 ns 级 | TB/s 量级 | MB | 易失 | 片上 |
| HBM4 | 约 100 ns | 约 2 TB/s | 36 至 48 GB | 易失 | 中介层,毫米级 |
| HBF(Grade 3) | 微秒级 | 最高 3.072 TB/s | 最高 512 GiB | 非易失 | 封装内,毫米级 |
| DDR5 主存 | 几十至一百 ns | 约 50 GB/s | GB 级 | 易失 | PCB,数十厘米 |
| 企业级 SSD | 几十至上百 µs | 约 7 GB/s | TB 级 | 非易失 | PCIe,数十厘米至米级 |
HBF 的物理外形同样是它的卖点:规范给出的近似封装尺寸是 10.975 mm × 16 mm × 775 µm(长 × 宽 × 高),堆叠高度与 HBM4 对齐,这样厂商在同一个封装设计里既能放 HBM 也能放 HBF,互相替换或叠加都不需要重做封装。
物理原理:NAND 单元不变,靠”CBA + 宽通道 + TSV”换带宽
把 NAND 放到 HBM 的位置上,最大的质疑是”闪存的带宽天生比 DRAM 低一到两个数量级,怎么可能接近 HBM”。规范本身没有详细展开底层工艺,但结合 SanDisk 的公开材料,可以从架构上把这件事讲清楚。
单元与访问粒度天生不同
DRAM 是 1T1C 单元,按 32 B 或 64 B 级的突发粒度访问;NAND 以页(page)为读单位、以块(block)为擦除单位,HBF 规范里定义的 NAND page size 就是 4 KiB。NAND 的物理读单位是 4 KiB,协议层却允许 64 B 粒度的读请求——Base die 会把一次页读的结果放进页缓存,再用 64 B 的片段逐段返回。所以 HBF 的”最小物理访问单位”和”HBM 的 32 B/64 B cache line”并不是一个层级的概念:前者是介质决定的,后者是协议决定的。
这直接带来软件层的硬约束:任何小于 4 KiB 的随机读,底层都要付一次整页读的成本,能不能摊薄取决于页缓存命中率;而任何写都必须凑满一个 4 KiB 的 device logical unit。后面讲读写模型时会反复看到这条约束。
CBA:从”多裸片并联”到”单裸片内部并行子阵列”
传统 NAND 提高带宽的办法是多通道并联,比如把 16 颗 NAND 封成一个 SSD,靠主控同时访问 16 条通道拿到 GB/s 级带宽。HBF 的路线则更极端:它把一个堆叠里的 16 层 NAND die 全部放在同一颗 Base die 之上,Base die 提供 16 条独立的 UCIe host channel,每条 channel 接一组独立的 NAND die,channel 之间互不相交、各自独立计时。
SanDisk 在 BiCS NAND 上采用的 CBA(CMOS directly Bonded to Array,CMOS 与存储阵列直接键合)把外围 CMOS 电路与存储阵列分开制造再键合,使一颗 die 内部可以把存储阵列切成大量可并行工作的子阵列(plane/bank)。规范里给出的堆叠容量算式就是:
- 每个 cube 16 颗 die;
- 每条 channel 16 个 bank;
- 每页 4 KiB;
- 合计 512 GiB。
单 cube 的原始带宽算式同样很直白:每条 host channel 64 bit 数据位宽、32 GT/s 线速率,就是 256 GB/s;16 条 channel 合计 4096 GB/s;AXI 链路层协议效率按 75% 计,有效带宽 3072 GB/s = 3.072 TB/s。规范把这个数字写进了”Total Effective BW per Cube”一栏,并且在 UCIe-A 配置表里给出了三档速度等级:
| 速度等级(Grade) | 最大用户带宽 | UCIe 配置 | 最大堆叠高度 | UCIe 速率 | 每 channel 的虚拟 AXI 数 |
|---|---|---|---|---|---|
| 1 | 0.384 TB/s | x64 | 8 层 | 8 GT/s | 1、2、4 |
| 2 | 1.536 TB/s | x64 | 16 层 | 16 GT/s | 1、2、4 |
| 3 | 3.072 TB/s | x64 | 16 层 | 32 GT/s | 1、2、4 |
这张表读起来有一个容易看错的地方:Grade 那一列是 UCIe 速率(8 / 16 / 32 GT/s),堆叠高度列是 8 / 16 / 16 层。所以三者的差别主要在链路速率和容量规模上——Grade 1 是 8 层、8 GT/s,单 cube 约 0.384 TB/s,适合对带宽不敏感、只要非易失性的场景;Grade 2 是 16 层、16 GT/s,单 cube 约 1.5 TB/s,是多数实际部署的”甜点”;Grade 3 是 16 层、32 GT/s,靠把每条链路速率翻倍把单 cube 推到 3 TB/s 级别,代价是更苛刻的信号完整性要求。三条 channel 的虚拟 AXI 数量都允许 1、2 或 4,由 host 按应用自行选择。
SK hynix 新闻稿中给出的对外口径是”容量覆盖至 512GB,基于 8 层和 16 层两种 NAND die 堆叠配置;带宽分为 Grade 1 至 Grade 3 三个等级,从约 0.4TB/s 到 3.0TB/s 可扩展”。这与规范表格完全吻合,可以互相印证。
Grade 1 的 0.384 TB/s 还有一个可以从算式反推出的细节:如果 8 GT/s、64 bit 位宽、16 条通道全部启用,原始带宽应是 1024 GB/s,按 75% 效率是 768 GB/s;而规范给出的是 384 GB/s,正好是一半。这意味着 Grade 1 的 8 层堆叠只启用了 8 条 host channel,而不是 16 条。容量等级与通道数在 HBF 里是绑定的:层数少、通道少、带宽低,三者一起缩放。
一个容易被误读的细节:读带宽与写带宽不对称
规范在 Feature 列表里写的读请求条件是:Burst Length 为 64 B 至 4 KiB,步长 64 B,地址 64 B 对齐,并且不能跨过 4 KiB 的 NAND 页边界。写请求则是 Burst Length 固定 4 KiB,地址 4 KiB 对齐。
这是一条非常重要的信息,说明 HBF 从一开始就不是”对称读写的大 HBM”:读取可以细到 64 B(对 cache line 友好的粒度),写入必须整页。这套设计动机很清晰——NAND 编程是慢操作,Host 不应该能看到半页数据;而读取主要服务的是推理时对权重与 KV 的随机读取,64 B 粒度刚好对应 GPU 一次 L2 行请求的宽度。
把这条不对称翻译成数字,可以更直观地看到它对推理的影响。设一次 HBF 读请求的有效数据量为 ,单通道带宽为 ,则单次读的传输时间近似为:
而 NAND 页读延迟 (微秒量级)是固定成本。有效带宽可以写成:
对 64 B 的随机读, 只有纳秒级, 完全被 支配,一条通道的实际吞吐可能只有几十 MB/s;而当一次读覆盖”4 KiB × N × 16”时,分子放大到数百 KiB, 才开始与 同量级,有效带宽才逼近链路带宽。这就是规范反复强调”跨通道交错 + 大页并发”的量化理由,不是排版偏好。
写侧则是另一种成本结构。NAND 的 program 时间同样在微秒以上,且必须以 4 KiB 为单位。如果推理框架按 token 粒度追加 KV,假设每 token 每层只新写 1 KiB 的新数据,那么一次 4 KiB 写里有 3 KiB 是”为凑页而读改写”或者干脆浪费;更糟的是,同一个 NAND 块会不断接收这种不完整写。规范用”4 KiB 累积超时”和”不允许跳页”两条规则把这条路堵死,逼着软件把 KV 写入设计成先缓冲、凑满页、再批量落盘。
从这个角度看,scratchpad 的价值就不只是”低延迟缓存”:它是一个天然的 KV 写入聚合缓冲区。decode 阶段把新生成的 KV 先写进 scratchpad(64 B 粒度、微秒级以下完成),当某一个 NAND 页的 4 KiB 凑齐后,再一次性刷到 NAND 上。这样既避免了不完整写,也把写操作从 decode 的关键路径上移走。
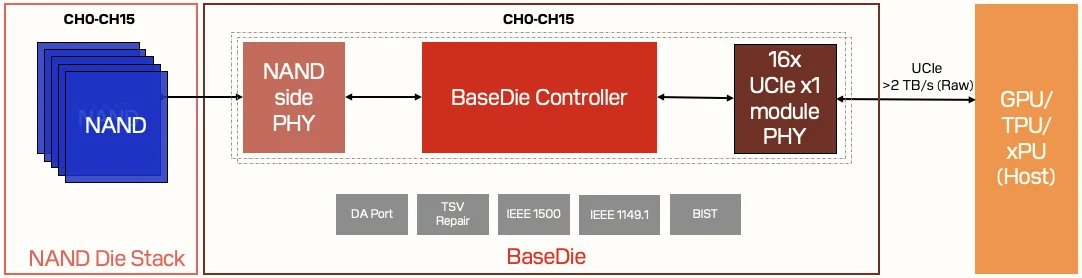
Base die 与 Core die:接口、控制器与 NAND 的职责划分
规范把 HBF 拆成三个主要实体:Base die、Core die 和 TSV 通道。
Base die 是整个堆叠唯一”有脑子”的部分,它是硅片里的 CMOS 层,包含四个子系统:
- UCIe 控制器与 UCIe PHY:直接和 host xPU 说话,负责 UCIe 协议管理和 die-to-die 适配器;
- Base die 控制器:处理 UCIe 控制器送下来的命令,管理 host 命令与响应,管理 NAND 命令与响应,做 ECC 编解码、错误处理、page/block 地址映射、TSV 冗余映射,并维护”Block 读计数(Page Read Counter)“用于向 host 报告需要刷新的块;
- Admin/Debug 管理:IEEE 1500 测试口和 DA(Direct Access)调试口的控制;
- TSV 冗余与修复:Base 到 Core 之间的 TSV 有专门的可修复冗余通路。
Core die 是 NAND 堆叠本体,最多 16 颗 die 层叠。
TSV 通道 把 Base die 的信号路由到各层 NAND。
关键在于 Base die 集中承担了全部”存储管理”逻辑:坏块管理、ECC、地址映射、TSV 修复、读计数、scratchpad、zone remap 全部在这里。Host 侧拿到的不是裸 NAND,而是一个已经把物理 NAND 复杂度藏起来的逻辑设备。对 GPU 上运行的推理框架来说,它看到的只是一个通过 UCIe 连进来的、有 16 条通道、每条通道是”线性地址空间”的内存区域,最多再额外知道每个地址的 bank 和 die 编号(这属于可选信息)。
每条 host channel 的信号也很清楚:主带 64 bit 数据位宽 + 4 bit 冗余,2 路时钟 + 冗余,1 bit valid + 冗余,1 bit track,半双工的 sideband 另有 1 bit 数据 + 1 bit 时钟;这些信号加上全局的复位、100 MHz 参考时钟、READY、CATTRIP(灾难性温度触发)、Vmon、STRAP、CHIPID 和 IEEE 1500 测试信号共同构成一颗 HBF 设备的对外引脚。
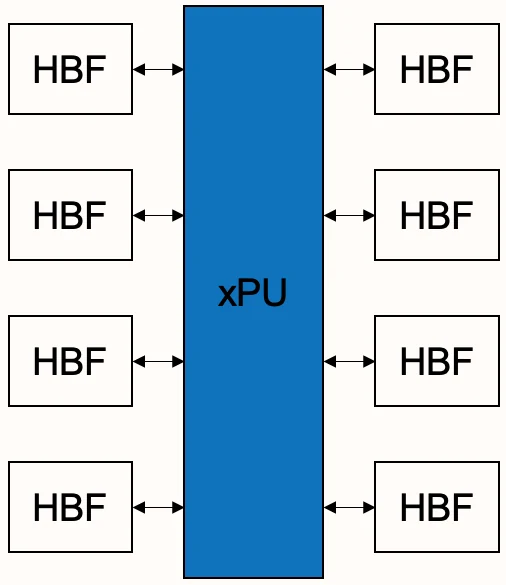
上图里的数字值得细看:一个 host 上挂了 4 个 HBF chipset,每个含 16 条 host channel、512 GiB 容量。四个加起来是 2 TiB 的封装内容量,对应 64 条 UCIe 链路。这是规范用来例示”TB 级封装内内存”的典型配置——HBM4 在同样封装面积下给的容量是几十 GB 级别,差了一个数量级以上。
UCIe 3.0 作为互联标准
规范明确要求每条 channel 的主带是全双工的 64 bit 数据总线,遵循 UCIe 3.0 的标准指引,并支持 UCIe Host streaming protocol。UCIe 是 chiplet 互联的开放标准,其核心价值在于:HBF 堆叠可以直连 GPU、CPU、NPU 等不同类型的处理器,不需要为每种 host 定制接口。SK hynix 的新闻稿也特别强调”HBF 采用 UCIe 行业标准连接接口,为在不同处理器类型间灵活集成打好了基础”。
UCIe-A 的三种 speed grade 在规范里给出了详细的链路初始化、电气特性、sideband 消息支持等要求。对软件开发者而言,这些细节都不需要关心——host 侧只需按 UCIe 通道 + AXI 协议模型访问即可,真正的复杂度在芯片内部。
这里有一层容易混淆的协议栈关系值得说明:UCIe 提供的是 die-to-die 的物理层、适配层与协议层,AXI 是跑在它上面的”应用协议”。规范 5.2 节定义了 “AXI over UCIe” 的链路层适配器(AXI Link Layer Adapter),把 AXI 的读写事务打包成 UCIe 的 flit 传输;UCIe 的 streaming protocol 负责在两条 die 之间维持 credit 与流控。对 host 软件来说,看到的就是一个标准的 AXI slave:发起 AR/AW 事务、等待 R/B 响应;对 HBF 的 Base die 来说,收到的是 UCIe flit,需要由适配器还原成 AXI 事务,再交给 Base die 控制器。
这套分层带来一个实际好处:HBF 的软件模型可以复用现有的 AXI/DMA 驱动栈,而不需要为 UCIe 重新发明一套内存访问 API。代价是协议开销——flit 头、CRC、credit 管理都会吃掉一部分原始带宽,规范把 AXI 链路层的效率按 75% 计入,正是这部分开销的体现。
AXI 协议层:为什么是 AXI 而不是别的
规范在 5.2 节详细定义了 HBF 的 AXI 接口:主带 64 bit 数据、AXI 支持 ID 宽度 14 bit(R_ID_WIDTH / B_ID_WIDTH),R_DATA_WIDTH 512 bit(因为一条 UCIe channel 内部可以把多个虚拟 AXI 口聚合起来),R_USER/B_USER/AR_USER 各 9 bit 用于携带错误码和附加信息。
虚拟 AXI 通道是理解 HBF 性能模型的关键:一条 UCIe channel 可以配置为 1、2 或 4 个虚拟 AXI 接口,host 可以把地址以 64 B 的任意倍数粒度交错映射到这些虚拟接口上,每个虚拟 AXI 口的容量均等分。规范明确写道,如果四个 AXI 口都能以 4 KiB 交错的全带宽同时响应 host,就能达到 HBF 的最大读带宽。这条规则在后续小节会反复出现,因为地址交错粒度直接决定了带宽利用是否最大化。
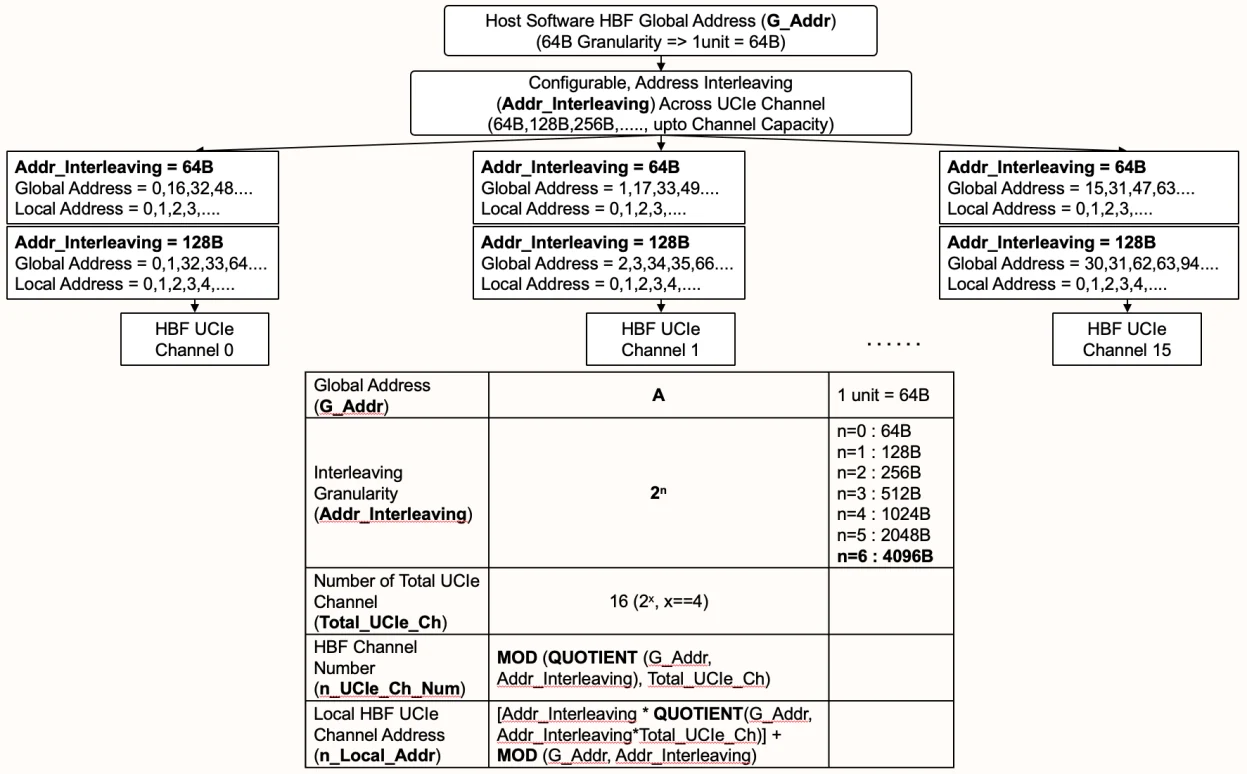
规范还给出了一条有用的”偷看”规则:如果 host 想知道某个逻辑地址落在哪个 bank 和 die 上,LA 的前 4 bit 是 bank 编号,紧接着的 2 bit 是 die 编号。这属于可选能力,host 通常不需要,但设备配置寄存器里会公开这些参数,供需要在软件层面做负载均衡的框架使用。
地址映射与数据条带:把”4 KiB × N × 16 通道”变成一次访问
HBF 的容量是”按通道划分的”,每条 UCIe channel 拥有一段完全独立、连续的本地地址空间,跨 channel 访问会被设备拒绝(返回 invalid address 错误)。因此 host 软件必须自己决定”全局地址到本地地址”的切分方式。
Device Logical Unit:4 KiB 是最小读写单位
规范定义 Device Logical Unit Size = 4 KiB,由 16 个 bank/die 组合构成(规范例子里给出的是每 die 16 个 bank、4 颗 die 的情况),计算公式是 Device Logical Unit = LA >> 6(以 KiB 计数)。这个”单元”的物理意义是:Base die 一次调度到底层的最小单位。一个读请求如果没对齐到它,Base die 会先累积、再一起下发;一个写请求如果没有凑齐整个单元,Base die 会等待直到超时。
地址条带:最优读的大小是”4 KiB × N × 16 channel”
规范在 Software Userguide 的 11.1.1 节给出了 HBF 的性能最优规律:
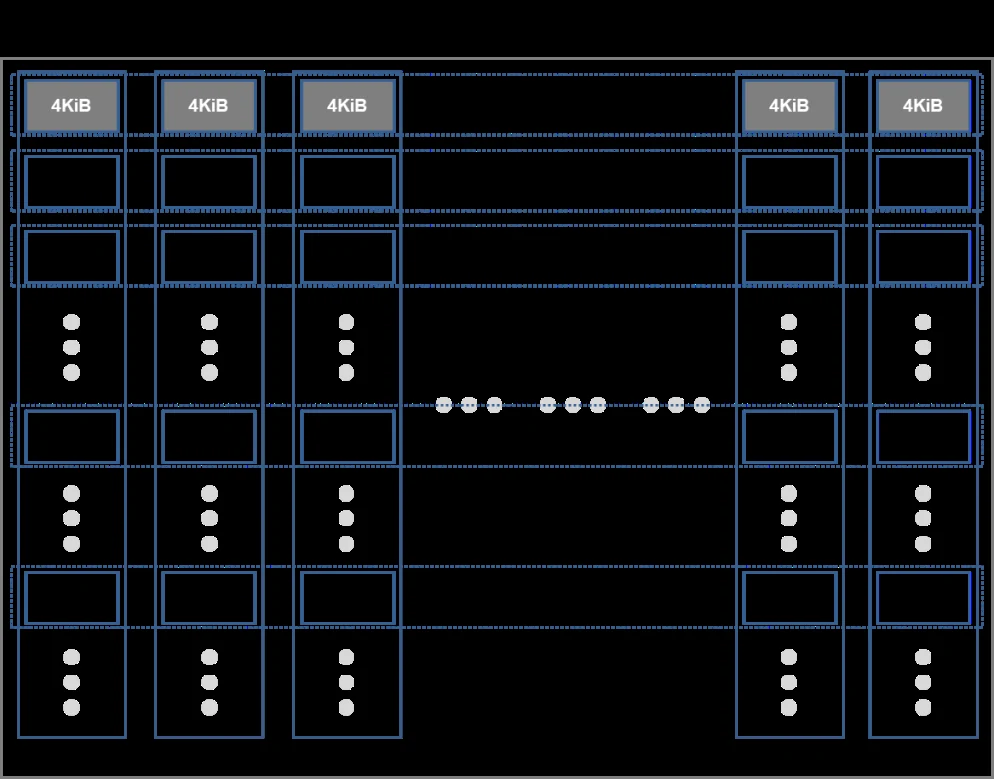
The maximum performance of HBF is achieved when the host system page buffer is managed to transfer “(4KiB × N) × all UCIe channels in HBF” at once, where N is the number of banks or planes in a die.
也就是说,要让 HBF 达到最大带宽,host 侧的一次读请求应该覆盖:每通道 4 KiB × N(N 为该 die 的 plane 数或 bank 数)× 全部 16 条通道。当这个条件满足时,一次 HBF 读延迟内可以并行返回数百 KiB 的数据。
这个规律有很实际的工程含义。以推理中最常见的”读取一层的权重矩阵”为例,如果某个 FFN 的 up-projection 权重为 4 MiB 的 FP16 数据,单通道 4 KiB 访问意味着需要 1024 次串行访问;而按”4 KiB × N × 16”分页后,只占用约 8 次延迟就能读回全部数据。软件层的地址布局几乎决定了 HBF 能不能真正用出带宽。
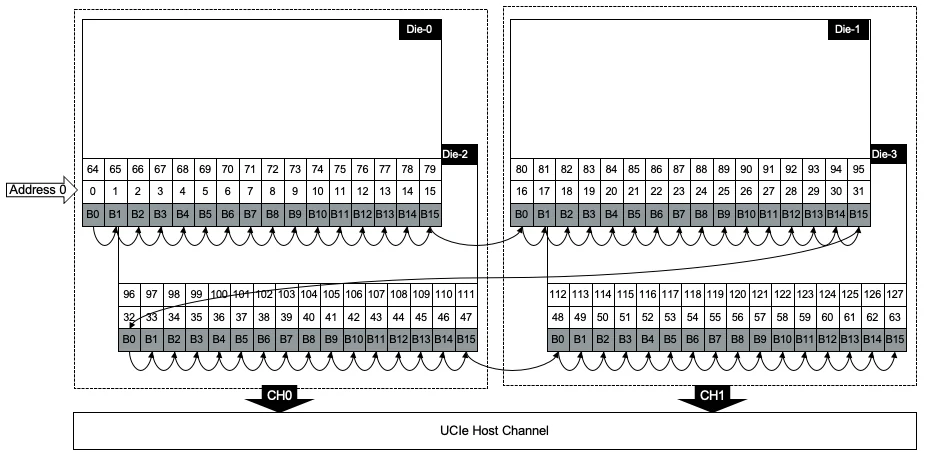
4 KiB 交错:跨通道最公平的切法
规范在 Figure 42 与 Figure 43 中定义了 4 KiB 交错的映射方式:一个 4 KiB 的数据块被拆成 64 个 64 B 的全局地址(GA),这 64 个 GA 分别映射到 16 条通道,每条通道各拿 4 个 64 B,对应这条通道本地地址空间里的 4 KiB 中的一部分。
用表来说就是:
| 层面 | 操作单位 | 软件职责 |
|---|---|---|
| 全局地址 GA | 64 B | host 决定 GA 如何跨所有通道分布 |
| 通道本地地址 LA | 4 KiB | 每条通道独立线性编址,Base die 内部再映射 |
| Device logical unit | 4 KiB | Base die 调度到底层的最小单位 |
| NAND page | 4 KiB | NAND 物理读单位 |
| NAND block | 产品相关 | NAND 擦除单位,也是块刷新粒度 |
注意规则里的一个限制:64 B 的 GA 在 4 KiB 内不必连续,但只要把它们收集起来,就必须正好构成 4 KiB 且没有缺失、没有重复。对于需要”页级整读”的模型权重加载,这意味着 host 软件可以在写入时把权重按 4 KiB 粒度打散、以 64 B 交错写进 16 条通道,读取时再以 4 KiB × N × 16 一次性并发读回。
写最优的规律与它对不上”对称”的读写
规范在 11.2.2 节中写道:写的最优条件是 host 同时写所有 channel 的所有 bank,并且 同一 NAND die 内的所有 bank 必须写入同一个 page 号。不同 die 或不同通道可以有不同的 page 号。
这条约束对写性能的直接影响是:一次 4 MiB 的模型权重写入,如果按”4 KiB × N × 16”顺序写到所有通道的所有 bank,就能拿到最大写带宽;如果写顺序在 die 内部错开了 page 号,Base die 只能串行调度。
读行为:64 B 读、4 KiB 累积、批读提示与 Page Cache
规范给出了读请求的三条硬规则,理解它们就能理解 HBF 的读性能上限来自哪里。
读请求的 ID 与顺序
读请求以 64 B 粒度下发,但完整的 4 KiB 数据需要用不同 AXI ID 的 64 个读命令去取,或者使用 burst read、burst length 0–63。不同 AXI ID 的读可以在完成时乱序返回,同一 AXI ID 内保序——这是一套典型的 AXI 乱序完成模型,软件需要通过 ID 区分”同一次 4 KiB 读”里的不同片段。
两个 Page Cache 缓冲与大页优先
规范 5.3.1 节中有一条实际很关键的策略建议:
HBF supports two cache buffers for each bank to hold up to at least two pages of data. It is recommended to read the full first 4KiB page before issuing a third 4KiB address that will evict the first 4KiB data.
每个 bank 有两个页缓存,能同时保持两页数据。如果 host 对同一 bank 连续下发三个 4 KiB 的读地址,第三个就会驱逐第一页。反过来说,如果 host 能保证”一次 4 KiB 读完再读下一个 4 KiB”,Page Cache 的命中率会明显提高——这是 NAND 页读延迟能”隐藏”起来的物理基础。
批读(Batch Read)提示
规范提供了一种软件可控的延迟优化机制:在 AXI 的 aruser 第 0 位置 1 表示”这是批读”。Base die 在收到批读提示时不会等待 timer 到期,而是把目前收到的所有读请求一起调度到 Core die,直到 host 下发一个普通读命令才认为批读结束。
这个机制的使用场景非常典型:模型加载、KV 预处理这类”已知要连读多个 4 KiB 页”的批量操作,加上批读提示可以让 Base die 不必按固定 timer 等待,直接把它们合并为一次 Core die 访问。
Scratchpad:L3 级延迟的小容量高优先级区域
规范在 Feature 里定义了 optional scratchpad memory,位于每条 UCIe channel 内,是一个独立的小型 SRAM,读写延迟”在 L3 cache 读写量级”,host 可以把它当作低延迟数据槽使用。
几个设计细节值得拆开讲:
- scratchpad 不属于 NAND 地址空间,由设备配置寄存器(SMEMSA、SMEMSZ)公开起始地址与大小,host 软件负责管理其内容;
- scratchpad 的读写都是高优先级请求,会在几个周期内完成,但内容和有效性对 HBF 完全透明——HBF 不检查也不维护它;
- scratchpad 掉电即失,只有上电期间有效;
- scratchpad 写粒度是 64 B,不需要凑满 4 KiB;
- scratchpad 读忽略批读提示,所有 scratchpad 读都按普通读处理。
规范给了一个提示使用场景:把中间激活、层间缓冲放在 SRAM 里。这条用例其实暗示了 HBF 的另一种工作模式:把 scratchpad 用作 GPU 侧 L2/L3 的”近端缓冲区”,让推理框架可以把小粒度、弱局部性的 KV 片段先写入 scratchpad,再按需刷回 NAND 块。后面讲 HBF 相关论文时会看到,多个研究工作的设计正是围绕”哪些数据应该落在 scratchpad、哪些落在大 NAND 块”展开的。
错误与重试在协议层的位置:ruser / buser 的 9 位信息
读侧与写侧的错误码并不单独占用一根线,而是复用 AXI 协议里本来就存在但通常闲置的 user 字段。规范把 R_USER_WIDTH、B_USER_WIDTH 和 AR_USER_WIDTH 都定义为 9 bit(另外 R_DATA_WIDTH 为 512 bit、R_ID_WIDTH 与 B_ID_WIDTH 为 14 bit),这 9 位被切成三段使用:
ruser[5:2](读)/buser[5:2](写):4 bit 的错误类型编码,也就是前文表格里 0x1 至 0xF 的那套错误码;ruser[8:6](读)/buser[8:6](写):3 bit 的附加信息。读侧用来承载”退役容量粒度”(NAND 块 / bank / die / channel)或”read retry 阶段号”,写侧用来承载写顺序违规的原因(不允许跳页、前一页编程失败等);aruser[0](读请求):批读提示位;aruser其余位是保留位。
这套设计对推理框架的实现有一个直接影响:框架的 I/O 后端必须把 user 字段原样透传。如果中间层(比如某个通用 DMA 封装)把 user 字段清零,Base die 就无法把错误码与重试阶段带回 host,“看到 0x6 就原样再读一次”的自动化流程会彻底失效,只能退化成”读失败就报错”。对一个把 HBF 当关键存储层的框架来说,这是必须提前在 DMA 与页表管理里设计好的细节。
同一套 user 字段在混读写场景下也承担了”读到了未写满页”的语义:读请求落在只累积了部分数据的 4 KiB 写地址上时,已累积的 64 B 段正常返回,其余段携带 0xA 错误码。框架层要能识别”部分成功”这种情况,而不是把整个 4 KiB 读当作全失败处理。
写行为:4 KiB 整页、不跳页、自动擦除、超时错误
写模型比读模型要严格得多,这是由 NAND 的物理特性决定的。
六条硬性写规则
- 所有写都是 non-posted 写:一次写命令只收到一个响应,无论长度多少;
- 写命令必须在数据真正写入 Core die 之后才算完成,不能”进入缓冲即返回”;
- 写粒度到 Core die 是 4 KiB,Base die 先累积完整的 4 KiB 才下发;
- 在 host channel 分配的全局地址范围内,不允许跳过或跳跃 4 KiB 本地地址;
- 当 HBF 收到某个 NAND block 的第一页(page-0)写请求时,会自动擦除该 block,host 不需要显式下发擦除命令;
- 第一份 64 B 写请求到达后,Base die 必须在 host 初始化时配置的时间窗内收到该 4 KiB 的其余数据,否则返回错误。
这几条合在一起,构成了一个很清晰的”流式顺序写”模型:HBF 期望 host 以大块、顺序、密集的方式写入。这与推理场景中”一次性把模型权重写入 HBF”的行为高度契合,但与 KV Cache”边生成边追加”的稀疏写入模式并不天然合拍——这也是后面讲 KV Cache 落 HBF 时要重点处理的问题。
混读写顺序与”读到了未写满的页”
规范对混读写场景的处理非常细致:Base die 在 64 B 粒度上维护读写顺序,所以同一个 64 B 地址”先写后读”会正确返回;但如果读到了”只累积了部分 4 KiB 的写”,Base die 对已经累积的部分正常返回数据,对尚未到达的部分返回 0xA 读错误(Read from a pending Write)。这种错误不是 bug,而是给 host 的信号——“你正在读一块还没写完的数据”。
错误码体系:读侧与写侧各 15 类
规范定义了从 0x1 到 0xF 的读错误码与写错误码,每一项都对应一套 host 需要执行的动作。这里挑几个最具工程意义的展开:
读侧:
0x1invalid address:地址超出通道容量或已经被退役;host 需要在软件层面把对应 NAND block 标记为不可用;0x4UECC(需要刷新):ECC 引擎报不可纠正错误,返回的数据无效;规范建议 host 如果有备份副本,先用备份,不要在刷新前再访问这个 NAND block;0x5CECC(高可纠错错误,需要刷新):可能返回有效数据,但已观察到高纠错率,推荐先刷新再使用;0x6UECC read retry:需要 host 用同一个地址再读一次(并在ruser[8:6]中回填复制信息),让 Base die 执行下一步 read-retry 流程;0x7read from erased page:读到了全 1 页,通常意味着读到的是尚未写过或已被擦除的数据;0x8通道本地容量退役:某个 block、bank、die 或整条通道被判定不可恢复;ruser[8:6]携带退役的粒度(0x1NAND block、0x2bank、0x3die、0x4channel);0x9die 临时阻塞:触发恢复流程,需要 host 等待;0xA读到了尚未写完的数据(前面提到的 pending write)。
写侧:
0x2overlap:同一地址有尚未完成的写,重复下发;0x4pending 数量到达上限:该 4 KiB 逻辑单元正在等待完成,host 需要先等已有写完成;0x54 KiB 累积超时:写数据没有在配置的时间窗内到达;0x6写顺序违规:host 没有按 page 顺序编程,典型原因是跳页;0x7program fail:Core die 编程失败,host 必须从 page-0 开始重放整个 NAND block;0x8通道容量退役:与读侧相同,表示一个 block/bank/die/channel 已被标记不可用。
规范在 11.5 节里还明确要求 host 需要在 24 至 48 小时的周期内刷新全部数据(具体间隔由产品可靠性规格决定),因为 NAND 存在数据保持与读扰动(read disturb)问题;“Block 读计数(Page Read Counter)“就是 Base die 提供给 host 判断某块数据是否需要刷新的信号。
这条要求点出了”HBF 非易失”这个说法需要加限定:它的非易失性是相对 DRAM 的刷新功耗而言的,不等于”写一次可以放几年”。在数据中心的高温环境与持续读写下,数据保持时间会明显缩短,规范因此把”周期性刷新”写成 host 的强制职责。对推理框架,这意味着 HBF 上长期驻留的模型权重也需要被纳入刷新调度——刷新本身是读加写,会占用带宽、消耗 PEC,属于必须计入 TCO 的运营成本。
可靠性与磨损:Zone Remapping 与 Read Retry 的工程流程
NAND 天然不适合写入密集与读扰动,这是 HBF 落地推理基础设施时最需要认真处理的可靠性问题。规范给出了一套相对成熟的解决方案。
不支持 GC,支持 Zone Remapping
规范 11.4 节写道:
HBF does not support any GC (garbage collection) or the transfer of active data from one physical location to another. HBF only supports remapping the UCIe channel local address from one physical location to another, as a part of wear leveling.
这是 HBF 与 SSD 的本质区别之一。SSD 内部会做完整的 FTL(闪存转换层)和后台 GC,代价是写放大和尾延迟抖动;HBF 则把 GC 甩给 host 软件——host 自己管理 zone 与 wear leveling,只通过 Zone Remapping 把某个本地地址映射到别的物理位置。
Zone Remapping 的流程是:
- host 把每条 UCIe channel 的容量切成 N 个 zone,每个 zone 大小相同、是 Core die NAND block 大小的整数倍;
- Base die 提供一组 CSR 寄存器,供 host 读取每个 zone 的 PEC(program-erase cycle,编程擦除次数);
- host 根据 zone 的用途和当前 PEC,把高 PEC 的 hot zone 与低 PEC 的 cold zone 交换;
- 交换前 host 必须确认这两个 zone 的数据已无效,且不再有 IO 读请求打到这两个 zone;
- 下发 zone remap 命令完成物理位置的映射重定。
规范还给出一条约束:不同 zone 的平均 PEC 差异不能超过某阈值(阈值由产品规定),保证磨损均衡。
Read Retry 的自动化流程
NAND 的读重试本质上就是”用不同的读参考电压再读一次”。规范通过 0x6 错误码 + ruser[8:6] 携带重试阶段信息,把整个流程自动化:
- host 发出读
addr; - Base die 第一次读失败(UECC),返回
0x6与一个重试阶段标记; - host 把同一地址连同
ruser[8:6]中的信息再读一次; - Base die 根据阶段执行下一次读重试;
- 如果所有重试阶段都失败,最终返回
0x4UECC,host 应改用备份副本并触发该 NAND block 的刷新。
这个流程对 host 软件的要求是”看到 0x6 就原样再读一次,并把 ruser 复制回去”,实现起来并不复杂,但需要框架层把读路径设计成可重试的状态机。
高温与温度节流
规范 9.2 节定义了温度节流与关机策略:设备内部有温度传感器(2 bit 编码的温区输出),超过阈值会通过 CATTRIP 信号通知 host(CATTRIP 是可编程阈值,Core die 温度传感器也可能触发它)。Base die 还提供 TMON、TTTEMP 寄存器,供 host 读取当前温度与节流阈值。
温度是 HBF 一个容易被忽视的问题:NAND 堆叠的热导性天然不如逻辑 die,而 HBF 与 GPU 放在同一个封装里,工作温度高。规范把温度节流写进标准,说明厂商已经把这件事当作产品的必需能力。
软件层如何使用 HBF:官方应用场景
规范 13 章用几个具体场景说明”HBF 怎么用”,这些场景几乎就是给推理框架作者写的设计指南。
单模型服务:跨通道交错
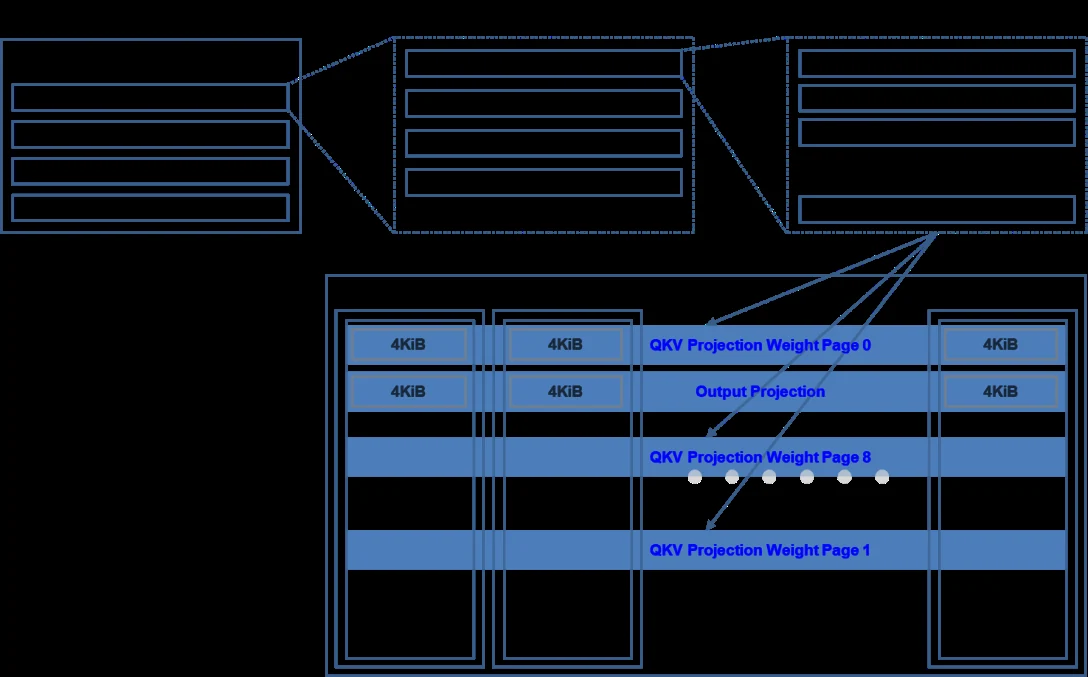
当 host 把模型权重写入 HBF 时,按”4 KiB × N × 16 通道”的顺序写入;推理时,所有通道的”4 KiB × N × 16”页并行读回。规范明确指出 QKV Projection、Output Projection、Gate Up Projection 和 Down Projection 权重都应拆成这个大小的页,目的就是”通过全部通道交错,保持读带宽最大”。
多模型服务:交错与专有通道两种选项
- 带交错多模型:多个模型都跨全部通道交错写入,运行时切换模型不需要重新加载权重,因为都已在 HBF 上。规范原文说:“在传统 GPU 上,换模型需要把权重从 SSD 加载到 GPU 内存;而在 HBF 上,模型加载已经完成,切换模型时直接访问,没有任何延迟。”
- 不带交错(专有通道):每个模型占用自己的一组通道,模型之间不互相争抢通道带宽,对”GPU 同时访问多个模型”的场景可能更有利,代价是总带宽利用率下降。
规范明确说这两种方式的选择取决于目标是”性能”还是”容量利用率”,MoE、Agentic Workloads、多模态模型都可以按同样的原则组合。
AI 参数库与 KV Cache 的布局建议
规范在 13.3 节中给出了两条直接面向推理场景的布局建议:
AI 参数库:参数需要”每生成一个 token 重新加载”,大小从数 GiB 到数百 GiB,所以要充分利用全通道带宽。写入与读取都要跨通道交错。
KV Cache 布局:prefill 时为每层生成 KV,decode 时逐 token 使用前面层的 KV。KV 的写入和读取性能取决于 host 的布局选择——规范原文说”host 应该充分理解 LLM 或其它 AI/ML 架构,来优化数据放置以获得最佳读写性能”。HBF 只负责提供硬件钩子。
权重与 KV 的通道分区
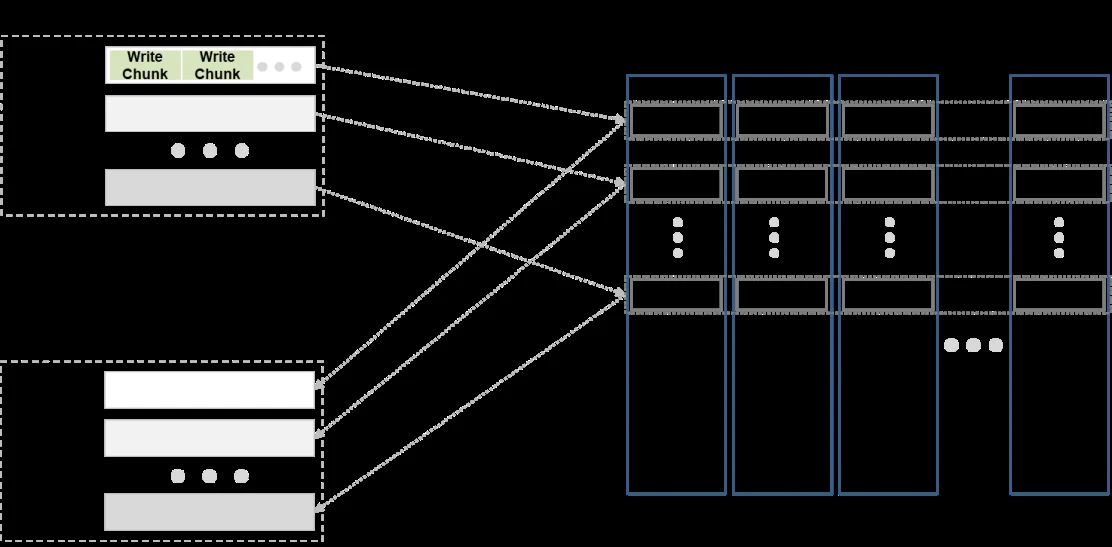
规范在 13.3.3 节给出了最后一条建议:如果权重和 KV 混在一个 zone,对寿命和容量利用率都不利,应该考虑用通道为单位把它们分开:
- 场景 1 面向寿命(均匀分区):通道均分两组,权重一组、KV 一组;权重重写(数据保持刷新)时迁移到 PEC 较低的那组,简化 host 的磨损均衡算法;
- 场景 2 面向容量(非均匀分区):按模型权重大小决定通道数,剩余通道留给 KV,最大化容量利用率。
这两条建议其实揭示了一个非常重要的事实:权重是只读的,KV 是读多写少、但写是连续的;把这两类数据混在同一个 NAND 块里,会让权重块被反复擦写(因为 KV 不断在同一个块内追加),从而显著缩短寿命。这直接启发了后面几篇论文中”按数据生命周期分区”的思路。
KV Cache 在存储层的分层与落盘,站内已有两篇系统侧拆解可以作为延伸:FlatCake 完全拆解:把 DRAM 与 SSD 拉平成同一层 KV 存储 讨论的是 SSD 与 DRAM 的边界,DeepSeek 3FS 完全拆解 讨论的是分布式文件系统如何承载 KVCache 卸载。HBF 的加入改变的是”近端容量层”的带宽与延迟参数,但分层的核心判断——哪些数据值得留在近端、哪些可以下沉——并没有变。
把 HBF 放进真实推理系统:容量、带宽与调度的算术
规范回答的是”设备怎么接、命令怎么发”,但没有回答”它在真实推理系统里到底值不值”。这一节用几个具体的算术例子,把 HBF 的能力边界量化出来。所有数字都基于公开的模型结构与规范给出的带宽/容量,目的是建立量级判断,而不是给出某个产品的 benchmark。
容量账:HBF 解决的是”放不下”,不是”算得快”
先看一个稠密模型的例子。假设一个 70B 参数模型以 FP8 存储,权重约 70 GB;采用 80 层、8 个 KV head、head_dim 128 的典型 GQA 结构,则每 token 每层的 KV 大小为:
80 层合计 160 KiB/token(FP8 KV)。一条 128K 上下文会占 20 GiB,8 条并发就是 160 GiB。若一台机器配 8 颗 48 GB 的 HBM4(384 GB),扣掉 70 GB 权重后剩 314 GB,理论上刚好能放下 8 条 128K 会话,余量已经很薄;一旦并发升到 16 条,HBM 就放不下,只能驱逐 KV 并承受重算。
此时加一颗 512 GiB 的 HBF,容量账立刻宽松:314 GB HBM + 512 GB HBF ≈ 826 GB,可以容纳 16 条以上 128K 会话,且被驱逐的 KV 不必重算,而是落到 HBF 上等下次命中。HBF 的第一价值是”把 KV 从易失的 HBM 容量约束里解放出来”,这一点与规范 13.3.2 节、以及 Lachesis、Hot-Cold Tiering 等论文的出发点完全一致。
但容量账有一个反面:如果把这 70B 模型的权重也放到 HBF 上,单 token 解码需要读 70 GB 权重。按 Grade 2 单 cube 1.5 TB/s 计算:
这还没有算 NAND 延迟和任何低效。对单流交互式推理,47 ms/token 意味着约 21 tokens/s,体验会明显落后于 HBM 方案。稠密模型的权重不适合直接长期驻留 HBF,除非能做到高命中率的预取,或者用批量把权重读取摊薄。
MoE 则是另一幅图景。一个 671B 总参数、37B 激活参数的 MoE 模型,FP8 下每 token 只需读约 37 GB 激活权重。按 1.5 TB/s:
在 batch 为 32 时,这 25 ms 可以产出 32 个 token,吞吐约 1280 tokens/s,而单 token 延迟仍是 25 ms。MoE 的”总容量大、激活比例低”恰好把 HBF 的容量优势放大、把带宽劣势摊薄。规范把 MoE 列为典型应用、Trillion-Parameter MoE in a Box 专门研究”单节点托管万亿参数 MoE”,原因就在这里。
带宽账:延迟被摊薄的三个条件
HBF 的有效带宽不是一个固定值,它取决于三个可调条件:
条件一:单次访问的数据量足够大。 前面已经给出 的表达式。若 按 10 µs 量级估算,要让有效带宽达到链路带宽的 80%,需要:
按单通道 96 GB/s(Grade 2 的 256 GB/s 原始带宽乘 75% 效率再除以 2 个虚拟 AXI 口的典型值)估算, 需要达到约 3.8 MB 量级才能让延迟占比降到 20%。这解释了一个反直觉的结论:HBF 的”高带宽”要靠大块并发访问才能兑现,小粒度随机读拿到的是”高延迟、低有效带宽”。
条件二:多个请求在途。 规范允许每个 channel 配置多个虚拟 AXI 口,不同 AXI ID 的读可以乱序完成。只要软件能维持足够的 outstanding 请求,NAND 的页读延迟就能被流水线重叠掉一部分。HBF-Sim 论文特别指出”可用带宽取决于并发如何分散到通道亲和的 die 集合”,说的就是这件事。
条件三:Page Cache 命中。 每个 bank 有两个页缓存。对顺序扫描(模型权重、连续 KV 段)来说,页缓存可以把第二次 4 KiB 读的延迟降到接近零;对完全随机的 KV 访问来说,命中率低,延迟就会暴露。KV 的布局如果按 token 连续、按层分块,顺序性会明显好于”按 head 交错”,这也是规范建议 host”深入理解模型结构再做布局”的原因。
调度策略:把 HBF 当第二级权重池与 KV 仓库
结合上面的算术,可以把 HBF 在推理系统里的角色归纳为三个具体职责,每个职责对应不同的软件机制:
职责一:冷专家池(MoE)。 HBM 里放路由最频繁的专家,HBF 放长尾专家。每个 MoE 层的路由决定在进入该层前就能拿到,因此可以提前 prefetch 下一层可能用到的专家权重;只要预测准确率足够高,NAND 延迟就能被当前层的计算盖住。Beyond Capacity 与 Trillion-Parameter MoE in a Box 都在探索”直接 HBF→GPU 路径”与”经 HBM 中转”的组合,本质是在 prefetch 带宽与 HBM 占用之间做权衡。
职责二:非活跃 KV 仓库(Agent/多轮)。 活跃会话的 KV 放 HBM,空闲或低优先级会话的 KV 搬到 HBF。恢复会话时,KV 从 HBF 读回,避免全量重算。Lachesis 按生命周期放置、Hot-Cold Tiering 按冷热分层,都是这一职责的具体策略。这里的关键指标是”恢复命中率”与”写放大”,而不是单纯的容量。
职责三:权重的一次性仓库(多模型)。 多个模型的权重常驻 HBF,切换模型时不需要从 SSD 重新加载。规范 13.2.1 节明确说这是 HBF 相对传统 GPU 的优势。对模型即服务(MaaS)平台,这意味着”模型切换”从秒级 IO 变成毫秒级地址切换;代价是每个模型都要占用通道容量,需要按规范 13.3.3 的非均匀分区做容量规划。
与 CXL 内存、远端 DRAM 的区别
HBF 经常被拿来和 CXL 内存扩展比较,但两者的定位差别很大:
| 维度 | HBF | CXL.mem / 远端 DRAM |
|---|---|---|
| 位置 | 封装内,紧邻 xPU | 机箱内或机架内,经 PCIe/CXL 链路 |
| 互联 | UCIe,die-to-die | CXL over PCIe,板级/机架级 |
| 带宽 | 单 cube 最高 3.072 TB/s | 受 PCIe 代际与链路数限制,单设备通常几十至百 GB/s 级 |
| 延迟 | 微秒级 | 数百纳秒至微秒级(取决于拓扑) |
| 容量 | 单 cube 512 GiB | 单设备可达 TB 级,可池化 |
| 一致性 | 非一致(non-coherent) | CXL.mem 可提供主机管理的一致性语义 |
| 写寿命 | 有限,需要磨损管理 | DRAM 无限写 |
HBF 的带宽优势来自”封装内、并行 16 条 UCIe 通道”;CXL 的优势是”容量池化、机架级共享、软件成熟”。两者并不是替代关系:HBF 适合放”每个 xPU 私有、需要高带宽读取”的权重与 KV;CXL 适合放”跨节点共享、对带宽不敏感”的容量池。 规范没有把 HBF 定义成”CXL 的替代品”,而是明确把它放在 xPU 旁边,这个定位本身就说明了分工。
边界与未解决的问题
HBF 的标准很完整,但它的工程边界同样清晰。把这些边界讲清楚,比重复宣传口号更有价值。
延迟是硬约束,不是靠软件能完全消除的
NAND 的页读延迟在微秒量级,比 HBM 高两个数量级。规范提供的 Page Cache、批读、scratchpad 都只能”减少暴露”,不能”消除延迟”。对单流、低延迟的交互式推理,HBF 只适合承载”不在关键路径上”的数据;一旦权重或 KV 的读取进入每个 token 的关键路径,延迟就会直接体现在 TPOT 上。HBF 的拥护者常说”用预取盖住延迟”,但预取的前提是”能提前知道要读什么”——MoE 的路由、Agent 的下一轮请求、多模型切换都可以预测,稠密模型的逐层权重则只能靠固定顺序预取,效果取决于计算与访存的重叠程度。
写寿命与刷新是长期运营成本
规范要求 host 在 24 至 48 小时内刷新全部数据,并要求 host 自己做 zone remapping 和磨损均衡。这意味着 HBF 的”运维复杂度”比 HBM 高得多:HBM 不需要刷新(DRAM 有刷新但由硬件管理),不需要磨损均衡,不需要处理坏块;HBF 把这些全部交给软件。对推理框架来说,这是一整套新的”存储管理子系统”,而不是加一个 malloc 就能用。
Gandalf 论文给出的 KV 写入量级值得警惕:生产负载下 KV 总写入量会超过 SSD 容量,把寿命从数年压缩到数月。HBF 的 NAND 质量更好、PE 次数更高,但”写放大 + 持续追加”的模式如果不改,寿命问题只是被推迟,不会被消除。
标准仍在早期,生态尚未定型
OCP v0.7 是 0.7 版,不是最终版;SK hynix 与 SanDisk 的联合体 2026 年 2 月才成立,Google 与 Tenstorrent 是早期成员。这意味着:
- 不同厂商的 HBF 产品在容量、Grade、scratchpad 大小、可靠性参数上会有差异;
- 软件栈(驱动、内存分配器、推理框架的 HBF 后端)还没有形成事实标准;
- 现有模拟器(HBFSim、HBF-Sim)各自的建模假设不同,论文结论不能直接横比。
对早期采用者,这意味着”按规范写抽象层、把设备相关参数做成可配置”比”针对某一颗芯片硬编码”更重要。
它可能被什么替代
HBF 的核心价值主张是”TB 级容量 + TB/s 带宽 + 非易失 + 低成本”。如果未来几年出现以下变化,HBF 的窗口会被压缩:
- HBM 的容量密度与成本改善快于预期(例如 3D DRAM 或 4F² DRAM 大规模量产);
- CXL 内存的带宽提升到接近封装内水平,且软件生态成熟;
- 模型结构进一步稀疏化,使”容量”不再是主要瓶颈;
- 推理负载从”长上下文、多会话”转向”短上下文、高并发”,KV 容量压力下降。
反过来,如果 Agent 与长上下文继续推高 KV 容量需求,而 HBM 容量增长受封装与成本限制,HBF 的”容量层”定位就会越来越稳固。规范把 HBF 定义为”介于 HBM 与 SSD 之间的新层级”,这个定义本身就承认了它的存在依赖于”HBM 不够大、SSD 不够快”这个中间地带长期存在。
硬件与产业链:从 SK hynix 的 375 层 V10 到 OCP 标准
HBF 的产业落地节奏,和它作为开放标准的定位密切相关。
2026 年 8 月的 FMS 发布
SK hynix 新闻稿给出了完整的时间线:
- 2025 年 8 月:SK hynix 与 SanDisk 开始 HBF 标准化合作;
- 2026 年 2 月:HBF 联合体(consortium)成立;
- 2026 年 8 月 4 日:第一版 HBF 标准通过 OCP 向全行业开放,距联合体成立约 6 个月;
- Google 与 Tenstorrent 已加入 HBF 联合体。
标准本身在 OCP 上以 “HIGH BANDWIDTH FLASH (HBF™) SPECIFICATION”,版本 v0.7 的形式公开,包含接口电气特性、die 堆叠工艺的可靠性与封装指南、软件 I/O 指南等内容。
375 层 V10 NAND
SK hynix 在 FMS 2026 展台首次公开了第十代(V10)375 层 4D NAND 晶圆与产品,新闻稿称其”每瓦性能较上一代提升 2.5 倍”,计划 2027 年初量产基于该 NAND 的高性能大容量 eSSD。
HBF 的容量和成本曲线与 NAND 层数强相关:层数越高,单个 die 容量越大,封装内 16 颗 die 的容量就越大;同时 CBA 架构与高密度阵列也决定了每比特成本能否继续下降,这正是 HBF 在容量上”对标 SSD 起点、接近 HBM 带宽”的经济基础。规范里的 512 GiB 只是 Grade 2 的起点,SK hynix 在其它场合提到的后续世代容量会更高。
成本是 HBF 最容易被低估的变量。NAND 的每比特成本天然低于 DRAM,这是 HBF 相对 HBM 的核心经济优势;但 HBF 不是”把 NAND 卖成 DRAM 的价格”,它的成本结构里还叠加了三项 HBM 式的开销:TSV 堆叠与 Base die 的良率、硅中介层/先进封装的面积、以及 UCIe PHY 的硅面积。换句话说,HBF 的每比特成本会明显高于普通 SSD,但会明显低于同等容量的 HBM。它瞄准的是”容量成本介于 SSD 与 HBM 之间、带宽接近 HBM”的中间生态位,而不是”最便宜的存储”。
这也解释了为什么 HBF 的早期落地场景集中在 MoE 与多模型服务:这些场景对容量成本最敏感、对单次访问延迟相对不敏感,正好落在 HBF 的性价比区间内。
一个关键的工程指标:封装内功耗与热
SK hynix 新闻稿提到 HBF 与 HBM4 在封装尺寸、功耗曲线与堆叠高度上匹配;这背后的工程逻辑是”HBF 可以放在原本给 HBM 预留的封装位置上”,不需要为它单独设计封装。
当前 HBF 研究的共识与争论
HBF 规范落地仅几个月,学术界已经围绕它发表了一批系统层研究。这些论文的价值在于:它们把”HBF 能做推理内存”这句宣传,拆成了具体场景下能不能真正跑起来的工程判断。
共识一:HBF 不是”大 HBM”
多篇论文反复强调同一个观点:
- HBF-Sim 指出,HBF”既不是大 HBM,也不是快 NVMe SSD”,其可用带宽取决于 GPU cache line 请求如何映射到 NAND 页、并发如何分散到”通道亲和”的 die 集合、以及媒体管理与 GPU 内存流水线如何交互;
- HBFSim(另一篇模拟器文章)指出 HBF 的 NAND 基础会带来”长延迟、异地更新、有限写寿命”三个问题,这些问题会直接影响加速器内存层级;
- Characterizing HBF 论文把”HBF 用于 LLM 服务”的实验结论直接落在”访问成本”和”有限写寿命”两项限制上。
对推理框架作者而言,这意味着 HBF 的接入不能按”多了一块慢内存”处理,而要按”一条有磨损预算、有读扰动、有大页粒度的随机读设备”处理。
共识二:读重写轻的工作负载最适合;KV Cache 写入需要特殊设计
从规范本身与论文都能看到同一条结论:权重更适合 HBF。
- 规范直接指出”权重只读、KV 读多写少”,并把两者放在不同通道分区;
- SPLASH 在论文中主张”有限写寿命使只读权重成为 HBF 最自然的用途”,其研究因此把 HBF 指向与稀疏注意力配合的长上下文 decode;
- Lachesis 提出”按生命周期把 KV 放到 HBM 与 HBF 之间”:生命周期短的数据放 HBM,让 HBM 吸收 agent 一次运行的更多写入,减少落到 HBF 上的写;
- Hot-Cold Tiering 则提出”HBM 存热数据、HBF 存温冷数据”,因为 HBF 的读能耗高、写寿命有限,不能把任意 KV 都直接落到它上面。
这几条结论背后的物理原因一致:NAND 的 program/erase 是慢操作,且每次 PE 都消耗寿命。KV Cache 在 decode 时不断追加写入,而 HBF 的写入粒度是 4 KiB,如果按 token 粒度追加 KV,几乎每个 token 都会触发一整个 4 KiB 的写——这既是带宽浪费,也是寿命浪费。
共识三:MoE 是 HBF 最自然的落点之一
规范在 13.2.3 节将”MoE(Mixture of Experts)“与多模态、agentic workloads 并列为 HBF 的典型场景,并按”性能 vs 容量利用率”给出交错与专有通道两种写法。
学术工作方面,Trillion-Parameter MoE in a Box 用两万亿参数 MoE 模型的算子分析、实测路由轨迹与多轮 agent trace,探索”低并发下单节点托管 TB 级权重”的设计空间;Beyond Capacity 探索”HBF 到 GPU 的直接路径 + 经 HBM 的路径”两条专家传输路线的组合;HBFlex 关注”细粒度 KV 状态与粗粒度 HBF 并行执行”之间的桥接;Exploring High-Bandwidth Flash 分析了 HBF 作为 GPU 主内存部件在多种配置下的表现。
MoE 适合 HBF 的原因是不难理解的:MoE 权重大、单 token 激活参数少,对容量极其敏感、对延迟不如密集模型敏感;且专家权重是只读的,完美绕开 HBF 写寿命问题。
一个需要工程化才能解决的难点:写寿命与刷新
Gandalf 论文给出了一个直观的数量级判断:在生产环境的 LLM 负载(多轮对话、agent)中,KV Cache 总写入量会远超 SSD 容量,从而把 SSD 寿命从”数年”压缩到”数月”。HBF 的写寿命虽然比普通 SSD 更好(厂商会用更高质量 NAND),但同一类问题依然存在。
规范给出的对策是 Zone Remapping + 通道分区 + 数据刷新;论文给出的对策是”按生命周期放置 KV”(Lachesis)、“HBM 吸收热数据”(Hot-Cold Tiering)、“通过历史访问模式门控 KV 写入”(Gandalf 提出的思路)以及”写成策略感知的 KV 管理”(Generative Recommendation 场景中的 write-aware KV 策略)。
这些方法有一个共同点:它们都不是 HBF 内部能解决的,必须由推理框架在软件层实现。
小结
HBF 要解决的问题可以用一句话概括:推理时代需要一个”TB 级容量 + TB/s 带宽 + 非易失”的内存层,而 HBM 给不了,SSD 也给不了。
OCP v0.7 规范把这件设备从”发布会上的概念”变成了可实现的接口:
- 硬件层面:NAND 堆叠 + Base die + 16 条 UCIe channel,单 cube 512 GiB、最高 3.072 TB/s;
- 地址模型:4 KiB 逻辑单元、64 B 交错、跨通道条带;host 软件负责全局地址的切分;
- 读写模型:64 B 粒度的读、4 KiB 整页写、批读提示、Page Cache、scratchpad;
- 可靠性:读错误码、写错误码、read retry、Zone Remapping、定期刷新、温度节流;
- 软件模型:模型权重跨通道交错、KV Cache 布局由 host 决定、权重与 KV 按通道分区。
从系统角度看,HBF 真正的改变不是”又多了 512 GiB 内存”,而是”内存层级第一次出现了按数据写入生命周期来分层的必要”——权重、KV、激活、中间结果在 HBF 上的合适位置并不相同。这一层设计才是推理框架在 HBF 时代最值得提前投入的部分。
把全文的要点压缩成一张检查清单,方便在评估一个 HBF 方案时逐条对照:
| 检查项 | 关键判断 |
|---|---|
| 容量是否够 | 权重 + 峰值 KV + 预留刷新空间,按 FP8 估算,不要按 FP16 估 |
| 访问粒度是否对齐 | 读是否尽量凑到”4 KiB × N × 通道数”,是否避免了 64 B 级别的随机小读 |
| 写入是否整页 | KV 写入是否经过聚合缓冲,是否有”不完整 4 KiB 写”的路径 |
| 通道分区是否合理 | 权重与 KV 是否分在不同的 zone 或通道组,是否按规范的分区场景做过规划 |
| 磨损与刷新是否有计划 | 是否有基于 PEC 的 zone remap 策略,数据刷新是否纳入调度 |
| 错误路径是否完整 | DMA 层是否透传 ruser/buser,框架是否能处理 0x6 重试与 0xA 部分读 |
| 延迟是否在关键路径外 | 是否有预取、是否有 scratchpad 缓冲、是否只承载非关键路径数据 |
参考资料
- OCP High Bandwidth Flash (HBF™) Specification v0.7(2026-08-03)
- SK hynix:Unveils First HBF Standard Specifications with Sandisk at FMS 2026
- HBFSim: A Simulator for Exploring HBF in Memory Hierarchies for LLMs(arXiv:2610.23503)
- HBF-Sim: An Extensible HBF Simulator for Large-scale GPU Memory Systems(arXiv:2609.29246)
- Characterizing High Bandwidth Flash for LLM Serving(arXiv:2609.39131)
- SPLASH: Co-Designing Sparse Attention with High-Bandwidth Flash for Efficient Long-Context Inference(arXiv:2609.23816)
- Lachesis: Lifetime-Aware KV Cache Placement for Agent Serving across HBM and High-Bandwidth Flash(arXiv:2610.08378)
- Hot-Cold Tiering of HBM and High Bandwidth Flash for Agentic LLM Serving(arXiv:2609.25782)
- Trillion-Parameter MoE in a Box: Decoupling Memory Provisioning with High-Bandwidth Flash(arXiv:2609.15636)
- HBFlex: A Flexible Memory System for Bridging Fine-Grained LLM States and Coarse-Grained HBF Parallel Execution(arXiv:2609.18675)
- Beyond Capacity: Scalable MoE LLM Inference via High-Bandwidth Flash with Direct GPU and HBM Paths(arXiv:2608.14333)
- Exploring High-Bandwidth Flash for Modern LLM Inference: Opportunities and Challenges(arXiv:2608.13868)
- Gandalf: Flash Shall Not Die! Increasing Flash Storage Lifetime for KV Cache Offloading in LLM Serving(arXiv:2610.30791)
- Enabling High-Bandwidth Flash for Generative Recommendation Serving with Write-Aware KV Cache Policy(arXiv:2609.07175)
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



