


vLLM 源码完全拆解(十九):TurboQuant KV Cache 量化——Hadamard 旋转、Lloyd-Max 标量量化与分页缓存内核
从一笔显存账说起
KV Cache 的显存占用有一个可以直接算出来的公式。对于标准的多头注意力模型,一个 token 在每层需要保存一个 K 向量和一个 V 向量,每个向量的长度是注意力头的维度 ,缓存里的头数是 KV 头数 (GQA 下远小于查询头数),层数为 ,每个元素占 字节,于是单个 token 的 KV 开销是
以一个 32 层、、、以 FP16()缓存的模型为例,一个 token 占 字节,也就是 128 KiB。8K 上下文的一条请求已经吃掉 1 GiB 的 KV。如果模型有 64 层、、,数字再翻一倍到 256 KiB/token。一张 80 GiB 的 H100 在装载权重之后往往只剩四五十 GiB 可给 KV 用,扣掉预留与碎片,能同时容纳的 8K 请求只有几十条。决定推理服务吞吐的,往往不是 GPU 的算力,而是这几十条能装进显存的 KV。
降低 是最直接的杠杆。FP8 把每元素从 16 bit 降到 8 bit,存储减半;再往下走,4 bit 能减到四分之一,3 bit 能减到六分之一不到。问题是,量化越激进,注意力分数和输出就越容易被噪声污染,而 KV 的量化比权重量化更难:K 要被 query 点积之后过 softmax,任何一点相对误差都会被指数放大;V 要被 softmax 权重加权求和,它的误差直接进入输出。很多 KV 量化方案因此在 4 bit 附近碰壁,更极端的位宽要么精度崩掉,要么只能靠每通道 scale、敏感层保护之类的额外机制去补救。
vLLM 在 2026 年版本里新增了一条名为 TurboQuant 的 KV Cache 量化路径,它在 3 到 4 bit/元素的量级上仍然维持了可以接受的生成质量,并且把它完整地接进了 vLLM 的分页 KV 缓存、注意力后端和 CUDA Graph 体系。这条路线的算法来源是 Zandieh 等人发表在 ICLR 2026 的 TurboQuant 工作,vLLM 的源码注释里同时也明确标注了它的历史渊源:DRIVE(Vargaftik 等,NeurIPS 2021)、EDEN(Vargaftik 等,ICML 2022)与 HIGGS 的标量情形(Malinovskii 等,NAACL 2025),以及最早把这一思路用在 KV Cache 压缩上的 Cache Me If You Must(Shutova 等,ICML 2025)。理解这些出处有助于看清一个事实:TurboQuant 并不是发明了一个全新的量化器,而是把”随机旋转 + 逐坐标标量量化”这一组合从权重压缩迁移到了 KV 压缩,并在 vLLM 里解决了一堆只有服务系统才会遇到的工程问题——分页布局、混合批、前缀缓存、CUDA Graph、PreMo 与后续 prefill。
本篇要回答的是这一类问题的源码答案:
- 为什么 TurboQuant 的第一步是乘一个 Hadamard 矩阵做旋转?旋转改变了什么,又没改变什么?
- 旋转之后的每个坐标为什么可以近似看成高斯分布,Lloyd-Max 又是怎样为这个分布求最优码本的?
- 3-bit 的 K 与 4-bit 的 V 如何挤进一个
head_size长的 slot 里,字节布局具体长什么样? - 写入 kernel 如何把旋转、归一化、二分类桶化(bucketize)、位打包和 V 量化融成一个 Triton kernel?
- decode 时如何从 packed slot 里还原 K/V 并完成数值稳定的 split-K softmax?为什么 norm correction 能提升精度?
- 接入引擎时,
--kv-cache-dtype的四个预设、首尾层的保护、混合模型特殊处理、CUDA Graph 的静态网格与 workspace 预分配分别是怎么落地的?
先看它在 vLLM 里占据什么位置,再逐层往内核里走。
TurboQuant 在 vLLM 中的位置
一条 kv-cache-dtype,两条默认的量化路线
vLLM 的缓存在服务启动时按 cache_config.cache_dtype 决定数据类型。FP8、INT8 这类方案走的是”每个元素独立存储、读取时再解量化”的简单模型;TurboQuant 走的却是”每个 KV 头在每个位置只占一段定长的 packed 字节”。这意味着它不能复用任何现有注意力后端的 KV 读写逻辑,必须同时改三处:
- KV 缓存规格:
AttentionSpec里的state_content_bytes原本描述”两个向量(K 和 V)的存储字节”,TurboQuant 把它改成”一个 slot 的字节数”。 - 注意力后端:新增
TurboQuantAttentionBackend,注册在 backend 注册表里,名字是TURBOQUANT。 - 写入路径:TurboQuant 注意力层把 K/V 的写缓存做成独立的 kernel,而不是依赖后端自带的
unified_kv_cache_update。
缓存规格被改写成”一个 slot”
TurboQuantAttentionBackend.customize_spec 在注意到 kv_quant_mode.is_turboquant 时,用预设参数算出 slot 大小写入 state_content_bytes:
@classmethoddef customize_spec(cls, spec: AttentionSpec) -> AttentionSpec: """TurboQuant packs K+V into one slot per head.""" if spec.state_content_bytes is not None or not spec.kv_quant_mode.is_turboquant: return spec from vllm.model_executor.layers.quantization.turboquant.config import ( TurboQuantConfig, )
# KVQuantMode member names mirror the preset strings. tq = TurboQuantConfig.from_cache_dtype( spec.kv_quant_mode.name.lower(), spec.head_size ) return replace(spec, state_content_bytes=tq.slot_size_aligned)这段逻辑改写了 vLLM 里”KV Cache 的每一页由若干个 head×head_dim 的 K 和 V 组成”的默认假设。原本一页的字节数等于 block_size × num_kv_heads × head_size × 2 × element_size,而 TurboQuant 之后,K 和 V 不再各自成块,而是合并成一条”slot”。之后 KVCacheManager、页表、block table 等组件仍然按”页 → 每页若干 slot”的方式管理,只是 slot 的尺寸变了。PagedAttention 的分页结构和页粒度这篇站内文章可以对照着看:KV Cache 的页粒度:128 token 一块的账,以及五个推理框架为什么选了五个不同答案。
后端能力声明
TurboQuantAttentionBackend 声明的关键能力:
accept_output_buffer: bool = Trueforward_includes_kv_cache_update: bool = False
supported_dtypes: ClassVar[list[torch.dtype]] = [ torch.float16, torch.bfloat16,]supported_kv_cache_dtypes: ClassVar[list[CacheDType]] = [ "turboquant_k8v4", "turboquant_4bit_nc", "turboquant_k3v4_nc", "turboquant_3bit_nc",]
@classmethoddef supported_kv_cache_layouts(cls) -> tuple[KVCacheLayout, ...]: return (KVCacheLayout.LBNHC,)
@staticmethoddef get_supported_kernel_block_sizes(kv_cache_spec=None) -> list[int | MultipleOf]: return [16, 32, 64, 128]
@classmethoddef supports_attn_type(cls, attn_type: str) -> bool: return attn_type == AttentionType.DECODER
@classmethoddef supports_per_head_quant_scales(cls) -> bool: return False逐条解释这些声明的含义:
forward_includes_kv_cache_update = False:与 FlashAttention 后端一致,KV 的写入被拆成独立一步(do_kv_cache_update),在 attention 前向之前执行。这样做的好处是当模型中某几层被get_boundary_skip_layers跳过时,写入端可以逐层决定是否量化,而前向端依旧走同一个后端。supported_kv_cache_layouts = (LBNHC,):缓存张量的逻辑布局是(num_blocks, block_size, num_kv_heads, slot_bytes),不再有”最前面那个大小为 2 的 K/V 维”。代码里还额外做了一次kv_cache.transpose(1, 2)转成(B, H, N, C),让 Triton kernel 读起来像普通的 tensor layout。supported_kernel_block_sizes = [16, 32, 64, 128]:页大小的选择有限,因为写入 kernel 的BLOCK_SIZE是编译期常量,而 3-bit packing 的字节跨页有对齐问题,后文会说明。supports_per_head_quant_scales = False:TurboQuant 不使用 per-head 的 scale,因为每个向量自带自己的 norm 或 scale,这是它的设计核心。supports_attn_type = DECODER:只支持 decoder 型注意力,encoder/decoder 混合的模型不可用。
四个预设对应什么
真正控制量化方式的,是 TurboQuantConfig 里的 TQ_PRESETS:
# Named TQ presets: each maps to frozen config parameters.# key_quant_bits: 8 = FP8 keys, 3-4 = MSE (Lloyd-Max) quantized keys.# value_quant_bits: 3-4 = uniform quantized values.TQ_PRESETS: dict[str, dict] = { "turboquant_k8v4": { "key_quant_bits": 8, "value_quant_bits": 4, "norm_correction": False, }, "turboquant_4bit_nc": { "key_quant_bits": 4, "value_quant_bits": 4, "norm_correction": True, }, "turboquant_k3v4_nc": { "key_quant_bits": 3, "value_quant_bits": 4, "norm_correction": True, }, "turboquant_3bit_nc": { "key_quant_bits": 3, "value_quant_bits": 3, "norm_correction": True, },}TurboQuantConfig 的 docstring 直接给出了各预设的压缩倍数和困惑度(PPL)代价:
| 预设 | K 位宽 | V 位宽 | norm correction | 压缩倍数 | PPL 增量 |
|---|---|---|---|---|---|
turboquant_k8v4 | FP8(8 bit) | 4 | 否 | 2.6× | +1.17% |
turboquant_4bit_nc | 4 bit MSE | 4 | 是 | 3.8× | +2.71% |
turboquant_k3v4_nc | 3 bit MSE | 4 | 是 | ~3.5× | +10.63% |
turboquant_3bit_nc | 3 bit MSE | 3 | 是 | 4.9× | +20.59% |
这张表里的四行就已经说明了整套工程取舍:K 的位宽对精度影响远大于 V;把 K 和 V 同时压到 3 bit 时 PPL 已经上涨 20%,基本只能在”显存极度紧张、又只关心能不能跑”的场景下使用。为什么 K 的量化如此敏感?因为 K 参与 softmax,误差是”在指数前”发生的;V 是”加权求和”,误差被 softmax 的凸组合稀释。稍后会给出更明确的推理。
为什么不用 QJL
TurboQuantConfig 的 docstring 里有一段值得单独拿出来讲的取舍:
QJL is intentionally omitted: community consensus (5+ independent groups) found it hurts attention quality by amplifying variance through softmax.
原论文 TurboQuant 的完整算法里还有一个 QJL(Quantized Johnson-Lindenstrauss)分量,用来在残差上进一步压缩,理论上可以做到接近无损的 1-bit 残差。但 vLLM 的实现完全没有采用它,理由是多个独立的复现团队发现 QJL 会在 softmax 之前放大方差,进而损害注意力质量。这条取舍背后有清晰的直觉:QJL 存储的是被量化之后残差的方向,如果在下游 softmax 之前没有合适的归一化,残差噪声会被直接打进 logits,再被 softmax 的指数放大。TurboQuant 在 vLLM 中实际采用的三件套是”Hadamard 旋转 + Lloyd-Max 标量量化 + norm correction”,把 K 的噪声主要限制在一个可估计的范围内。
为什么先旋转:随机正交变换如何把坐标变成高斯分布
问题的本质:非均匀维度
假设每层每个 KV 头有一个 K 向量 ,长度 128。如果直接对每个坐标用同一个量化区间做标量量化(比如最简单的”线性均匀量化”),效果会很差,原因有三:
- 坐标分布不均匀:经过 RMSNorm、RoPE 之后,K 的坐标通常有一个很大的集中区(接近 0)和一条长尾,均匀量化会把大量码字浪费在尾部。
- 坐标尺度差异:不同头、不同层的 K 数值范围不同,如果共享码本,必然有的头饱和、有的头分辨率浪费。
- 维度间的相关性:直接量化每个坐标相当于把问题看成”独立维度”,但坐标之间有相关性,量化误差会集中到某些方向。
经典的解决办法是”每通道/每组 scale + zero”(比如 FP8 per-head scale、INT8 per-token per-head)。但那样会引入额外元数据:每个头要存一个 scale,每个组要存一个 scale。位宽越低,元数据占比越高——3 bit 时一个 fp16 的 scale 就占掉 5 个元素的存储量。
旋转的关键定理
TurboQuant 的思路是:先把这个向量乘上一个随机正交矩阵,让每个坐标近似服从同一个高斯分布。理由来自高维几何里的一个结论:
设 是随机正交矩阵(), 是任意固定的单位向量,则当 较大时, 的每个坐标近似服从 。更准确地说, 在单位球面上”像随机方向一样分布”,而单位球面上的随机方向在每个坐标轴上投影的方差就是 。
这个结论可以用两条步骤直观推导:
- 第一步:固定 ,随机选择正交 ,等价于在单位球面上随机取一个方向 。因为正交变换对所有方向一视同仁。
- 第二步:单位球面上的均匀分布 在任意坐标轴上的投影,密度正比于 。当 时,这个分布收敛到 。可以用 Berry-Esseen 不等式或更直接的”球面集中”来论证: 时误差已经很小。
所以”随机旋转 → 高斯坐标”不是巧合,而是几何必然。旋转之后的向量,每个坐标的统计特性都一样了。这时候我们只需要设计一个标量量化器,就能适用于所有坐标、所有头、所有层。这就是为什么低比特标量量化加上旋转会比每个头各自 scale 的量化更划算。
为什么 vLLM 选了 Hadamard 而不是随机正交矩阵
源码里 _build_hadamard 的注释写得非常直白:
def _build_hadamard(d: int, device_str: str) -> torch.Tensor: """Orthonormal Hadamard matrix (Sylvester construction), cached per (d, device).
Precomputed D×D matrix enables matmul-based WHT — single cuBLAS GEMM instead of log2(D) butterfly kernel launches. 64KB for D=128. """ return _build_hadamard_cached(d, str(torch.device(device_str)))
@functools.cachedef _build_hadamard_cached(d: int, device_str: str) -> torch.Tensor: H = torch.tensor([[1.0]]) while H.shape[0] < d: H = torch.cat([torch.cat([H, H], 1), torch.cat([H, -H], 1)], 0) return (H / math.sqrt(d)).to(torch.device(device_str))Hadamard 矩阵具备三个关键性质:
- 正交:(归一化后乘 保证这一点),满足”旋转”要求。
- 对称:,所以逆旋转等于正旋转。
- 是”足够随机”的:Hadamard 被视为一种确定性随机旋转变体,对高斯化坐标同样有效。更重要的是它的元素只有 ,没有浮点数值本身的误差。
源码 _ensure_on_device 里进一步解释了为什么不加随机符号翻转:
# Pure Hadamard: orthonormal + symmetric (H = H^T), enabling# in-kernel butterfly fusion and trivial inverse for continuation.H = _build_hadamard(D, str(device))layer._tq_PiT = Hlayer._tq_Pi = H# fp16 copy for rotation in continuation prefill pathlayer._tq_Pi_half = H.to(torch.float16)# The Hadamard rotation is shared across all layers: random sign# flips do not improve Lloyd-Max quantization quality because the# quantizer is symmetric around zero (sign-flipping a coordinate# maps it to the mirror centroid with identical distortion).这三段注释合起来回答了四个问题:
- 为什么不用随机高斯矩阵? 因为它需要一次真正的 GEMM,元素是浮点,需要额外存储随机种子。
- 为什么不用”Hadamard + 随机符号”这种原论文的写法? 因为 Lloyd-Max 量化器是对称的(以 0 为中心),坐标翻转后落到对称码字上,畸变完全一样,所以随机符号对量化质量没有增益。
- 为什么共享 D×D 矩阵而不是逐层生成? 矩阵本身和层无关,共享节省了 的显存。
- 为什么不是 Fast Walsh-Hadamard 蝶形运算? 注释写得很实在:预计算 D×D 矩阵,然后一次
matmul比 个 kernel 的蝶形运算更省。对 的矩阵,64KB 可以一直驻留 GPU 的一个内存块里,每次变换只花一次 cuBLAS 调用。
旋转前后的”不变”与”改变”
旋转是一个正交变换,所以:
- 不变的是:向量长度 保持不变(正交变换保距);两个向量的内积 保持不变(正交变换保角)。这正是为什么旋转对”要算 softmax 的 “没有本质损伤——如果 K 只是旋转,Q 不旋转,则 ,所以 Q 也必须同步旋转(下文的写入和读取路径都会说明)。
- 改变的是:每个坐标的分布从”任意、不均匀”变成了”近似高斯、方差 “;每个坐标的期望接近 0。这恰好是 Lloyd-Max 量化器所需要的假设。
一个具体的图像
设想一个维度为 128 的单元球面。任取一个单位向量 ,它的坐标往往有几个很大的值(比如由 RMSNorm 之后的某个高频分量主导)和大量接近零的分量。乘上 之后,结果是一个类似”随机方向”的单元向量,每个坐标的幅值在 附近波动,满足近似高斯。
这个变换把”如何构造一个能适配所有头的码本”从一个与数据强相关的问题,变成了一个与数据无关的问题:只需要知道旋转后坐标为 这一事实,就能对所有模型、所有层用同一套码本。这是 TurboQuant 的核心。
Lloyd-Max 量化器:为高斯分布求解最优码本
标量量化的三个对象
一旦坐标被旋转成近似 ,问题就退化为一个一维标量量化问题。一个 bit 的标量量化器由三样东西定义:
- 码本: 个重建电平 ;
- 判决边界: 个分界点 ;
- 编码规则:坐标 落入第 个区间 时,编码为 ;
- 解码规则:拿到 后重建为 。
量化误差(畸变)用均方误差衡量:
其中 ,。
Lloyd-Max 的两个最优性条件
对于给定的 ,我们要找一组 使 最小。对 分别关于 和 求偏导并令其为零,得到两个条件:
条件一:最近邻划分。 相邻两个重建电平之间的分界点必须取中点:
因为如果分界点偏向任意一侧,把边界移动一点都能让该区间的误差变小。这个条件与输入分布无关——无论 是什么,边界都取相邻电平的算术平均。
条件二:质心重建。 每个重建电平必须是该区间内分布的条件期望:
因为 在 处最小。
这两个条件互相依赖:质心依赖边界,边界依赖质心。Lloyd-Max 算法采用不动点迭代:
- 初始化一组质心(比如在 上均匀放置);
- 用条件一算出边界;
- 用条件二算出新的质心;
- 重复直到质心变化小于容差。
对于高斯分布,这个迭代一定收敛到局部最优;由于高斯是单峰的、关于 0 对称,初始值取对称均匀栅格时收敛到全局最优,且解关于 0 对称。
vLLM 的实现:数值积分而不是解析解
centroids.py 里的 solve_lloyd_max 没有用解析公式(高斯的区间期望没有初等闭式表达),而是直接做数值积分:
def solve_lloyd_max( d: int, bits: int, max_iter: int = 200, tol: float = 1e-10,) -> tuple[torch.Tensor, torch.Tensor]: """Solve Lloyd-Max optimal quantizer for N(0, 1/d) distribution.""" n_levels = 2**bits sigma2 = 1.0 / d sigma = math.sqrt(sigma2)
def pdf(x): return _gaussian_pdf(x, sigma2)
lo, hi = -3.5 * sigma, 3.5 * sigma centroids = [lo + (hi - lo) * (i + 0.5) / n_levels for i in range(n_levels)]
for _ in range(max_iter): boundaries = [ (centroids[i] + centroids[i + 1]) / 2.0 for i in range(n_levels - 1) ] edges = [lo * 3] + boundaries + [hi * 3] new_centroids = [] for i in range(n_levels): a, b = edges[i], edges[i + 1] num = _trapz(lambda x: x * pdf(x), a, b) den = _trapz(pdf, a, b) new_centroids.append(num / den if den > 1e-15 else centroids[i])
if max(abs(new_centroids[i] - centroids[i]) for i in range(n_levels)) < tol: break centroids = new_centroids
boundaries = [(centroids[i] + centroids[i + 1]) / 2.0 for i in range(n_levels - 1)] return ( torch.tensor(centroids, dtype=torch.float32), torch.tensor(boundaries, dtype=torch.float32), )几个实现细节值得解释:
- :这是旋转后每个坐标的方差。注意它是由维度决定的,而不是从数据里估计出来的。这意味着码本与具体模型无关,所有层、所有头、所有请求共享同一套中心点。
- 积分区间 ,外层再扩到 :高斯在 之外的尾部质量约 ,对 KV 向量来说可以忽略;把外层边界写成
lo*3与hi*3只是数值积分的端点,避免最外侧区间积分不完整。 _trapz固定 200 个梯形:中心点数量最多 16,每个区间 200 点积分足以把量化器求到 的稳定性。它是纯 Python 循环,只在模型初始化时跑一次,不进入推理热路径。- 最多 200 次迭代:大多数情况下十几次就收敛;200 是安全上限。
求解结果用 @lru_cache(maxsize=32) 缓存,键是 (d, bits)。一个服务进程里,无论多少层调用 get_centroids(128, 3),都只计算一次。
3-bit 和 4-bit 的码本长什么样
把上述结果算出来,会看到典型的高斯量化码本。以 、 为例:
- 4 bit(16 电平):最外侧两个质心大约在 附近,相邻电平间距在中心区域约 ,在尾部约 。越靠近尾部,电平间距越大——因为高斯尾部的概率密度低,把码字放在那里不划算。
- 3 bit(8 电平):最外侧质心约在 ,中心间距约 ,尾部间距约 。
这与均匀量化形成鲜明对比:均匀量化会在 的整个区间等距撒点,中心区域的分辨率被尾部”浪费”掉;Lloyd-Max 把码字集中到概率质量大的地方,因此在同样的 bit 数下 MSE 更小。对于高斯分布,最优固定速率标量量化的高码率近似为
代入 ,得到整条单位向量的归一化畸变(NMSE):
- 4 bit:
- 3 bit:
这两个数字与后面精度表的态度一致:4-bit 的 K 只引入约 1% 的方向误差,3-bit 则接近 4%,后者的 PPL 代价明显更高。注意这是”方向”的误差,向量的长度另存为 fp16,不参与这个估算。
熵编码视角:为什么固定速率不是最优但更实用
上面的式子是固定速率标量量化的结果。如果允许熵编码(不同码字用不同比特数),高斯分布的最优标量量化畸变可以降到 ,比固定速率好约一倍。但 KV Cache 的读取是随机访问的:每读一个 token 的 K,都要在常量时间内定位到它的编码。变长编码会引入前缀解析、偏移表,并且让分页寻址变得复杂。TurboQuant 选择固定速率 + 定长 slot,牺牲了约 2 倍的率失真增益,换来的是”每个 token 的 K 恰好占固定字节数”这一工程性质。这是整个方案能在 vLLM 里落地的关键前提。
量化误差怎样进入注意力分数
设原始 K 向量为 , 是单位方向。量化重建为
其中 是由 个质心分量拼成的向量(可能再做 norm correction)。注意力分数为
误差来自 与 的偏差。设 ,则
如果 的每个坐标量级为 (经过训练后通常近似如此), 的量级为 ,则分数误差的标准差大约为 。4-bit 下 ,3-bit 下约 ——这已经是相当可观的相对误差。softmax 会把 logits 的差异指数化,所以 K 的位宽必须谨慎;而 V 的误差不经过 softmax 的指数放大,只被权重加权,宽容得多。这就解释了为什么 k3v4(K 3 bit、V 4 bit)的 PPL 代价(+10.63%)明显低于 3bit(K 和 V 都 3 bit,+20.59%):把有限的比特优先给 K,收益更大。
论文本身区分了两种量化目标:TurboQuantmse 以均方误差为目标,量化重建更接近原向量,但用它做内积估计会引入偏置;TurboQuantprod 在 MSE 量化器的残差上再加一层 1-bit QJL,换来无偏的内积估计。vLLM 采用的前者(MSE 码本 + norm correction),没有采用 QJL,原因下一节会讲。下面两张图是论文在 1536 维 DBpedia 向量上对这两种量化器的实测:
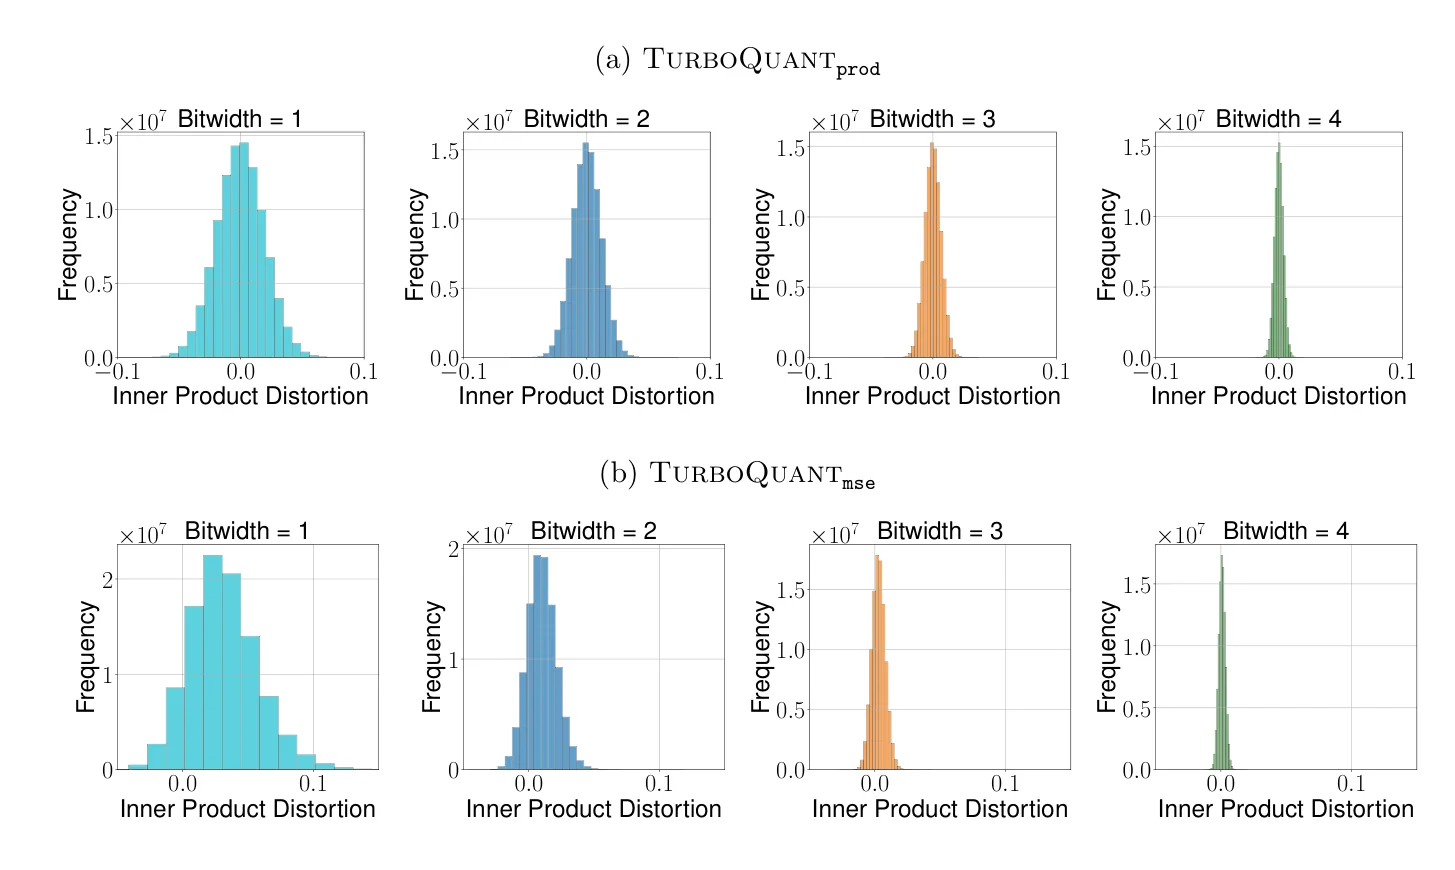
图源:Zandieh 等,TurboQuant: Online Vector Quantization with Near-optimal Distortion Rate(ICLR 2026,arXiv:2504.19874)图 1。上排为 TurboQuantprod,下排为 TurboQuantmse;横轴是内积畸变,四列对应 1 到 4 bit。
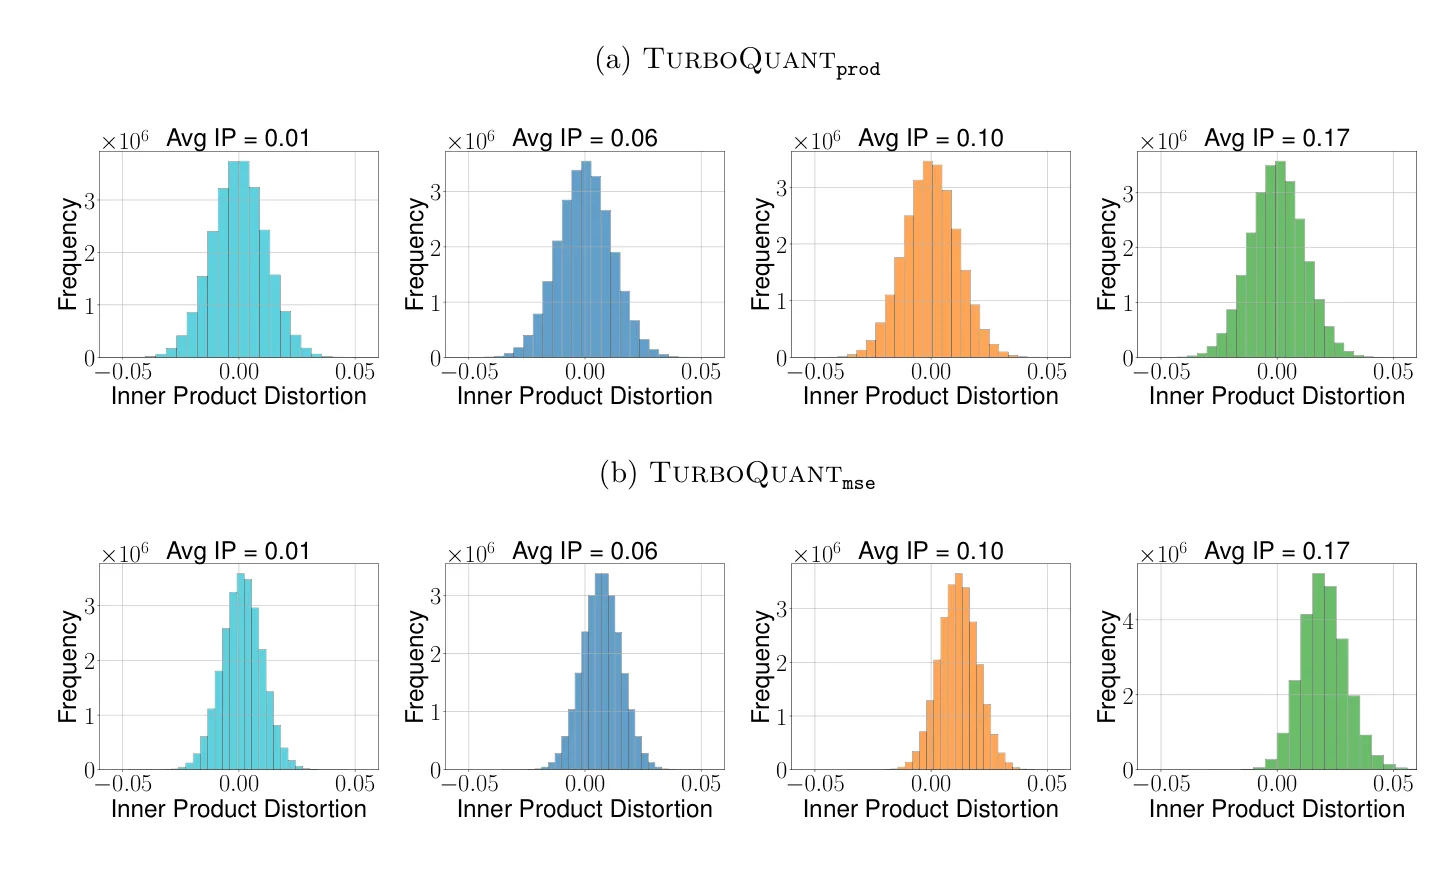
图源:同论文图 2。2-bit 下 TurboQuantprod 的内积误差方差在不同平均内积下保持稳定,TurboQuantmse 的偏置随平均内积增大而增大。
norm correction:修正”量化会缩短向量”
Lloyd-Max 重建有一个系统性偏差:对单位向量逐坐标取质心,重建出来的向量长度通常小于 1。原因很直观——质心是条件期望,条件期望会把极端值往中心拉,相当于对每个坐标做了一次收缩。结果 。如果不修正,解码得到的键长度变成 ,所有注意力分数被整体缩小,softmax 的温度被无意中调高,分布变平。
vLLM 的 norm_correction 就是把 重新归一化:
这样 ,键的长度严格等于存储的 。源码的 docstring 给出的数据是:在 4-bit 下,norm correction 把 PPL 再降低约 0.8%。这个数字不大,但它是”免费”的——只需要在解码时多做一次 维的平方和开方(后来 vLLM 甚至把它折叠到了写入端,见下一节)。
与”每头一个 scale”的对比
传统 INT4/FP8 KV 量化通常为每个头(或每个 token 的每个头)存一个 scale 和一个 zero。以 head_dim=128、4 bit 为例,数据占 64 字节,加上两个 fp16 的 scale/zero 共 68 字节,元数据占 6%。到 3 bit 时数据 48 字节,元数据仍是 4 字节,占比升到 8%。TurboQuant 的 K 侧元数据只有一个 fp16 的向量 norm(2 字节),3-bit 时数据 48 字节,元数据占 4%;4-bit 时数据 64 字节,元数据占 3%。更关键的是,它不需要为每个头校准 scale——码本由维度和 bit 数决定,是全局常量。这既省了元数据,也省掉了校准时对数据的依赖。
代价是:TurboQuant 假定旋转后的坐标严格服从 。如果某个模型的 K 分布严重偏离这个假设(比如维度很小、或某些层有异常大的离群坐标),量化误差会比理论值大。vLLM 用”首尾层跳过量化”来对冲这一点,后文会讲到。
vLLM 内置的 Lloyd-Max 码本:3-bit 与 4-bit 的实际数值
在动笔讨论内核之前,先把码本本身的数值算出来,后面读 kernel 时会有直观参照。按照 centroids.py 的算法,对 的坐标分布()求解 Lloyd-Max,得到的 8 电平与 16 电平码本大致如下(数值取自同一迭代算法,按对称性只列正半边):
| bit | 电平数 | 正整数质心(约) | 最外质心(约) |
|---|---|---|---|
| 3 | 8 | 0.0217, 0.0668, 0.1188, 0.1902 | 0.1902 |
| 4 | 16 | 0.0114, 0.0343, 0.0581, 0.0833, 0.1111, 0.1431, 0.1829, 0.2416 | 0.2416 |
这组数字反映了两条规律:其一,码本质心落在 之内(),3-bit 的电平间距约是 4-bit 的 1.8 至 2 倍;其二,最外侧电平在 (3-bit)到 (4-bit)之间,说明大部分概率质量被 0 附近的少量区间吃掉,尾部只分到 1 至 2 个电平。对于 KV 缓存来说,这恰好是想要的效果:多数 K 坐标集中于 0 附近,给它们更多的分辨率,才能让旋转后点积的误差小。
在 kernel 里,Lloyd-Max 的判决边界被固化为 midpoints 张量:
# _ensure_on_devicec_sorted, _ = layer._tq_centroids.sort()layer._tq_midpoints = (c_sorted[:-1] + c_sorted[1:]) / 2这段代码只算一次二分中点,之后所有写入都用同一组 midpoints 做二分搜索,读取时用 centroids 做查表重建。码本和边界都以 fp32 保存,因为它们是所有 token 共享的常量,精度必须最高;每个 token 自己携带的向量长度才用 fp16 压缩存进 slot。
存储布局:一个 slot 里如何塞下 3-bit 的 K 和 4-bit 的 V
从 slot_size 的三项算术开始
TurboQuantConfig 把每个头每个位置的存储拆成两部分。K 部分(key_packed_size)取决于 K 走 FP8 还是 MSE:
@propertydef key_packed_size(self) -> int: """Packed bytes for a single KEY vector.""" if self.key_fp8: return self.head_dim # 1 byte per element mse_bytes = math.ceil(self.head_dim * self.key_mse_bits / 8) norm_bytes = 2 # vec_norm fp16 return mse_bytes + norm_bytes
@propertydef value_packed_size(self) -> int: """Packed bytes for a single VALUE vector.""" data_bytes = math.ceil(self.head_dim * self.value_quant_bits / 8) return data_bytes + 4 # +2 scale(fp16) +2 zero(fp16)
@propertydef slot_size(self) -> int: return self.key_packed_size + self.value_packed_size
@propertydef slot_size_aligned(self) -> int: """Slot size rounded up to next even number.""" s = self.slot_size return s + (s % 2)这里有两个容易忽略的细节:
- K 的 MSE 索引按
ceil(d * bits / 8)字节打包,再加 2 字节的 fp16 向量范数。这个范数是整条 K 向量的 ,不是每个坐标的 scale。 - V 的数据按
ceil(d * bits / 8)打包,再加 2 字节 fp16 scale 和 2 字节 fp16 zero。V 采用”整条向量的 min/max 线性量化”,所有坐标共享一组 scale/zero。 slot_size_aligned向上取偶,因为 vLLM 的通用 KV 缓存规格在某些路径上会把state_content_bytes折半当作”等效 head_size”处理,要求它能被 2 整除。
把四个预设代入 ,可以得到源码测试里锁定的那一组具体数字:
| 预设 | K 数据字节 | K 元数据字节 | V 数据字节 | V 元数据字节 | slot | 对齐后 |
|---|---|---|---|---|---|---|
turboquant_k8v4 | 128(FP8) | 0 | 64 | 4 | 196 | 196 |
turboquant_4bit_nc | 64(16 电平×128/8) | 2(norm) | 64 | 4 | 134 | 134 |
turboquant_k3v4_nc | 48(8 电平×128/8) | 2(norm) | 64 | 4 | 118 | 118 |
turboquant_3bit_nc | 48 | 2(norm) | 48 | 4 | 102 | 102 |
这组数字来自 tests/quantization/test_turboquant.py 的 PRESET_EXPECTED,它是对外承诺的布局契约,任何改动都要同步更新测试。
一个 slot 的字节图
以 turboquant_k3v4_nc、 为例,一个 slot 的 118 字节是这样排的:
offset 0 48 50 114 118 | K indices (3bit×128) | K norm | V indices (4bit×128) | V scale | V zero | |<----- 48 B --------->| 2 B |<----- 64 B ---------->| 2 B | 2 B |- 偏移
0..47:128 个 3-bit 质心下标,每 8 个下标打包成 3 字节( bit),共 16 组、48 字节。 - 偏移
48..49:K 向量的 fp16 范数 。 - 偏移
50..113:128 个 4-bit 的 V 下标,每两个打包成一个字节,共 64 字节。 - 偏移
114..115:V 的 fp16 scale。 - 偏移
116..117:V 的 fp16 zero。
布局是 AoS(Array of Structures):同一个 token 的 K 和 V 紧挨在一起,同一页内按 token → head → slot 的顺序排列。这样做的好处是 decode 读一个 token 的 K 和 V 时只碰相邻的两段内存,坏处是 scale/zero 这类”每 token 只读一次”的标量也夹在数据流里,会给向量化访存带来额外的事务。后文的 SoA 优化正是针对这一点。
一个容易踩的坑在 turboquant_attn.py 开头的模块 docstring:它写着
Per-head per-position slot layout: [key_packed (kps bytes) | value_fp16 (D*2 bytes)] For turboquant_k3v4_nc head_dim=256: [100 bytes key | 512 bytes value] = 612这段注释停留在”V 保持 FP16”的早期版本,与当前 TurboQuantConfig、store kernel、decode kernel 以及测试里的 118 字节布局都不一致。如果照着注释去算 slot 大小,会多算出一倍多的显存。源码注释会随着迭代过期,布局这类”直接影响正确性”的数字应当以 config 与测试为准,这也是读框架源码时值得养成的习惯。
页内寻址:一页多少字节,slot 落在哪里
state_content_bytes = slot_size_aligned 之后,FullAttentionSpec.page_size_bytes 变成
例如 、block_size=16、slot=118 时,一页 字节。这个页大小比 FP16 的 字节小了 4 倍多,直接决定了同样的显存能装下多少 token。
Triton kernel 里计算 slot 地址的方式是
page_idx = kv_offs // BLOCK_SIZEpage_off = kv_offs % BLOCK_SIZEblock_nums = tl.load(Block_table_ptr + bt_base + page_idx, ...)slot_bases = ( block_nums * stride_cache_block + page_off.to(tl.int64) * stride_cache_pos + tl.cast(kv_head, tl.int64) * stride_cache_head)这里的 stride_cache_pos 是”同一页内相邻 token 的字节跨度”,在 AoS 布局下等于 num_kv_heads * slot_size_aligned;stride_cache_head 等于 slot_size_aligned。注意 block_table 存的是物理页号,与 PagedAttention 的页表语义一致;不同请求的同一个逻辑位置可以映射到不同物理页,这就是分页 KV 缓存的基础。站内 PagedAttention 完全拆解 和 vLLM 源码完全拆解(四):KVCacheManager 已经把这一层讲透,这里不再重复。
为什么 block_size 只有 16/32/64/128
get_supported_kernel_block_sizes 返回四个值,不是随意选的:
- 16 是 SoA 优化与 FlyDSL decode 的硬性要求。FlyDSL 的 eligibility 检查里写着
kv_cache.shape[1] in (16, 32);SoA 布局里 metadata 区按[H, fields, block_size]排列,block_size 太小会让 K norm、V scale、V zero 三个数组的交错粒度太细,收益下降。 - 128 是 vLLM 的默认页大小,能保证大多数模型的调度器按惯常的页粒度工作。
- 3-bit 打包的字节数必须是 3 的倍数。128 个坐标的 3-bit 索引正好 48 字节,而如果 block_size 不是 8 的倍数,最后一个 token 的 3-bit 组会跨页,写入 kernel 需要处理跨页写,复杂度陡增。16、32、64、128 都是 8 的倍数,避开了这个问题。
- CUDA Graph 的静态形状:decode kernel 的
BLOCK_SIZE是编译期常量,页大小一旦确定就不再变化,才能把整张图捕获下来。
AoS 与 SoA:两种页内布局
vLLM 里存在两套 TurboQuant 页内布局:
- AoS(默认,Triton store + Triton decode):每个 slot 内依次是 K 数据、K norm、V 数据、V scale、V zero。整个页按 token 顺序排列。
- SoA(FlyDSL 路径必需,Triton store + Triton/SoA decode):把一页拆成”数据区”和”元数据区”两块:
block start| data region: [block_size, H, key_data_bytes + val_data_bytes] || meta region: [H, num_soa_fields, block_size] of fp16 |数据区只放 packed K 索引和 packed V 数据;元数据区按 head 分组,每个 head 存 block_size 个 K norm、block_size 个 V scale、block_size 个 V zero。源码注释里的说法是 data region [bs, H, KEY_DATA_BYTES+VAL_DATA_BYTES], followed by metadata region [H, NUM_SOA_FIELDS, bs] of fp16。
SoA 的动机是访存局部性:decode kernel 每一轮要读 BLOCK_KV 个 token 的 K norm 和 V scale/zero,AoS 下这些值分散在每 token 的 slot 尾部,需要跨 stride 的小粒度 gather;SoA 下同一个 head 的这些标量在页内是连续的 block_size 个 fp16,可以一次 u16 load 拿到一段。源码注释给出的量化收益是:把 norm correction 的 1/||c_t|| 折叠进存储的 K norm 之后,gpt-oss 在 4096 上下文下 TQ 开销降低约 26%。
SoA 的另一项收益:把 norm correction 折进写入端
AoS 路径的 decode 每次都要对每个 token 的质心向量算一次 ,这需要 个平方、一次归约、一次开方、一次除法,并且每个 tile 都要重复。SoA 的 store kernel 把它挪到了写入端:
# When norm_correction=True, the kernel folds 1/||c_t|| into the# stored per-token K-norm so the load kernel can skip per-tile norm# math (Opt#1). centroids is only dereferenced inside the kernel when# NORM_CORRECTION=1; pass midpoints as a harmless placeholder otherwise.vn_f32 = tl.load(Norms_ptr + pid) # ||k_t||, fp32
if NORM_CORRECTION: safe_idx = tl.minimum(tl.maximum(idx, 0), N_CENTROIDS - 1) c_vals = tl.load(Centroids_ptr + safe_idx, mask=d_mask, other=0.0) c_norm_sq = tl.sum(tl.where(d_mask, c_vals * c_vals, 0.0), axis=0) c_inv_norm = 1.0 / tl.sqrt(c_norm_sq + 1e-16) vn_f32 = vn_f32 * c_inv_norm
vn_u16 = vn_f32.to(tl.float16).to(tl.uint16, bitcast=True)tl.store(KV_cache_u16_ptr + knorm_u16_addr, vn_u16)这段代码的含义是:写入时算出这条 K 的质心向量 ,求它的范数 ,把 当作新的”存储范数”。读取时只需要做
就等价于先归一化 再乘以 。每次 decode 只多一次乘加,省掉了每 tile 的归约与开方。注意写入端需要先拿到完整的 idx 数组,因此这项优化只能在 store kernel 内部做,不能放在外层 Python 里——这也是 SoA store 把 bucketize 和 norm folding 融进同一个 kernel 的原因。
元数据为什么用 fp16 而不是 fp32
K norm、V scale、V zero 都存成 fp16。理由有三:
- 带宽:每个 token 每头要读这三个标量,fp32 会让元数据带宽翻倍。decode 是带宽受限的,元数据的每字节都值钱。
- 精度足够:norm 和 scale 本身是从 fp16 的 K/V 算出来的,存成 fp16 不会引入比原始数据更大的误差;zero 也类似。
- 与 SoA 的 u16 寻址对齐:
kv_cache.view(torch.uint16)要求每个 fp16 落在偶数字节上。AoS 布局里 K norm 的偏移是MSE_BYTES(48 或 64,均为偶数),V scale 的偏移是KPS + VAL_DATA_BYTES(50+64=114,偶数),保证了 2 字节对齐;这也是slot_size_aligned取偶的原因之一。
布局层面的取舍总结
| 设计点 | 选择 | 替代方案 | 代价 |
|---|---|---|---|
| K 元数据 | 每条向量一个 fp16 norm | 每头一个 scale、每组一个 scale | 无法适应头间尺度差异,但省掉了校准 |
| V 量化 | 每条向量 min/max 线性 | 每坐标 Lloyd-Max | V 的分布不适合固定码本,线性更稳 |
| 页内布局 | AoS 默认、SoA 可选 | 纯 SoA 或纯 AoS | 两套 kernel,代码复杂度上升 |
| slot 对齐 | 向上取偶 | 不补齐 | 最多浪费 1 字节/token/头,换来 u16 对齐 |
| 页大小 | 16/32/64/128 | 任意值 | 3-bit 打包跨页问题,所以限制为 8 的倍数 |
写入内核:store 路径如何旋转、量化与打包
写入发生在 attention 之前
TurboQuant 的 attention 后端声明 forward_includes_kv_cache_update = False,因此模型层在执行注意力前,会先调用 do_kv_cache_update:
def do_kv_cache_update(self, layer, key, value, kv_cache, slot_mapping): N = slot_mapping.shape[0] if N <= 0: return device = key.device self._ensure_on_device(layer, device)
k = key[:N].view(N, self.num_kv_heads, self.head_size) v = value[:N].view(N, self.num_kv_heads, self.head_size) # (B, H, N, C) -> (B, N, H, C) for TQ kernels kv_cache = kv_cache.transpose(1, 2) self._store_kv(k, v, kv_cache, slot_mapping, layer)这段代码包含三个关键约定:
- 只处理
N个实际 token:key和value是批内全部 token 的 QKV 投影结果,slot_mapping被调用方裁到num_actual_tokens,避免把 padding token 写进缓存。kernel 内部还会再次检查slot < 0并直接返回,这是给 CUDA Graph 的 padding 槽位留的保险。 - K/V 的视图是
(N, H_kv, D):vLLM 的投影输出通常把 head 维拼在最后一维,这里按 KV 头数重新解释;head_size是模型真实的 K 维度,不是 slot 的等效 head size。 - 缓存转置成
(B, N, H, C):vLLM 的缓存物理布局是(num_blocks, block_size, num_kv_heads, slot_bytes),也就是逻辑上的(B, N, H, C);但有些上层路径传进来的是(B, H, N, C)视图,这里统一转置,后续 kernel 的 stride 计算才一致。
_store_kv 再按 _soa_store 开关分派到两套 Triton store:AoS 版本和 SoA 版本。参数完全一致,差别只在页内偏移的计算方式。
K 的归一化与旋转为什么放在 kernel 外面
MSE 路径的 Python 侧代码非常短:
# Normalize + rotation GEMM externally (cuBLAS is faster than in-kernel)k_flat = key.float().reshape(NH, D)norms = k_flat.norm(dim=1, keepdim=True)x_hat = k_flat / (norms + 1e-8)y = x_hat @ PiT
v_flat = value.float().reshape(NH, D)它做了四件事:
- 把 K 转成 fp32,避免 fp16 归一化时的下溢;
- 求每个头向量的 L2 范数
norms; - 归一化成单位向量
x_hat,分母加1e-8防止零向量; - 右乘
PiT(Hadamard 矩阵)得到旋转后的单位向量y。
为什么不把归一化和旋转也塞进 Triton kernel?源码注释给出的理由是 cuBLAS 更快:x_hat @ PiT 是一个 乘 的 GEMM,对于 、prefill 几千 token 的规模,cuBLAS 的 tiling 和 Tensor Core 利用率远高于一个手写 Triton 的逐元素归约。把旋转放在外面,kernel 只负责”给定旋转后的单位向量,做查表和打包”,每个 program 的计算量小、访存规整,反而更容易打满带宽。
代价是多了一次显存的往返:y 要物化成 fp32 张量,k_flat 也是 fp32,prefill 8K token、8 个 KV 头时约 32 MiB 级别,可以接受。对 decode 这种每步只有几十个 token 的场景,这个 GEMM 的 launch 开销占比更高,但 decode 的瓶颈本来就在 KV 读取而不是写入,所以问题不大。
融合 kernel 的骨架:一个 program 处理一个 (token, head)
store kernel 的 grid 是 (NH,),即每个 token 的每个 KV 头一个 program。pid 同时编码 token 和 head:
pid = tl.program_id(0)token_idx = pid // Hhead_idx = pid % H
slot = tl.load(Slot_mapping_ptr + token_idx)if slot < 0: returnblk = (slot // BLOCK_SIZE).to(tl.int64)off = (slot % BLOCK_SIZE).to(tl.int64)head_idx_i64 = tl.cast(head_idx, tl.int64)slot_base = ( blk * stride_cache_block + off * stride_cache_pos + head_idx_i64 * stride_cache_head)这个 program 的粒度选择有两层考虑:
- 一个 program 正好覆盖一条 K 向量和一条 V 向量,所有坐标都能放进寄存器/SRAM,不需要跨 program 同步;
H是编译期常量,token_idx和head_idx的除法取模被编译器优化掉;slot_base的三个 stride 也都是constexpr,地址算术不会变成运行时乘法。
slot_mapping 是调度器为每个 token 分配的全局逻辑槽位,slot // BLOCK_SIZE 得到物理页号,slot % BLOCK_SIZE 得到页内偏移。这里没有直接使用 block_table,因为 store 端的 slot_mapping 已经是经过页表映射后的物理槽位;只有读取端才需要按 block_table 查页。
二分查找:3 到 4 次比较替代线性扫描
K 的量化核心是”给定一个旋转后的坐标 ,找到它落在哪个 Lloyd-Max 区间”。最直接的做法是线性扫描 n_centroids - 1 个边界,3-bit 要 7 次比较、4-bit 要 15 次。kernel 用了二分:
y_vec = tl.load(Y_ptr + base + d_offs, mask=d_mask, other=0.0)lo = tl.zeros([BLOCK_D], dtype=tl.int32)hi = tl.full([BLOCK_D], N_CENTROIDS - 1, dtype=tl.int32)for _ in range(MSE_BITS): mid = (lo + hi) >> 1 safe_mid = tl.minimum(mid, N_CENTROIDS - 2) mid_val = tl.load(Midpoints_ptr + safe_mid, mask=d_mask, other=0.0) lo = tl.where(y_vec >= mid_val, mid + 1, lo) hi = tl.where(y_vec >= mid_val, hi, mid)idx = tl.minimum(lo, N_CENTROIDS - 1)逐行解释:
lo=0, hi=n_centroids-1,搜索区间是质心下标的闭区间。循环MSE_BITS次(3 或 4 次),每次把区间折半,最后lo就是插入位置。safe_mid = min(mid, n_centroids-2):当mid落到最后一个质心时,midpoints只有n_centroids-1个元素,直接索引会越界;把它夹到最后一个边界,比较结果仍然正确,因为已经收敛的 lane 不再改变mid。tl.where(y_vec >= mid_val, mid+1, lo)与hi = where(..., hi, mid)是标准的 lower_bound 写法;用>=而不是>,保证等于边界时落到右侧区间,和训练时”左闭右开”的定义一致。mask=d_mask:BLOCK_D是next_power_of_2(D),当 不是 2 的幂时(例如 96),超出部分不参与加载;y_vec的对应 lane 是 0,比较结果会被后面的 mask 丢掉。
为什么用二分而不是把边界做成查找表?因为 midpoints 是 7 或 15 个 fp32,常量缓存里一放,二分查找只需要 3 到 4 次常量加载;而查找表要么是 256 项的线性表(需要更多常量内存),要么是插值近似(会引入额外误差)。二分在 GPU 上还有一个好处:每个 lane 独立走同样的迭代次数,没有 warp divergence,3 到 4 次循环完全展开后就是 3 到 4 条比较指令。
位打包:3-bit 的 8 个一组与 4-bit 的 2 个一组
查表得到下标后,要把 int32 的 idx 向量压成字节流。4-bit 的打包很直观:
idx_pairs = tl.reshape(idx, [BLOCK_D // 2, 2])shifts_4 = tl.arange(0, 2) * 4packed = tl.sum((idx_pairs & 0xF) << shifts_4[None, :], axis=1).to(tl.uint8)mse_offs = tl.arange(0, BLOCK_D // 2)mse_mask = mse_offs < MSE_BYTEStl.store(KV_cache_ptr + slot_base + mse_offs, packed, mask=mse_mask)idx_pairs 是 (64, 2),每个 pair 的两个 4-bit 值分别左移 0 和 4 位,按位或(用 sum 实现,因为两个 nibble 不重叠)得到一个字节。mse_offs = arange(0, 64) 是字节偏移,mse_mask 保证只写到 MSE_BYTES( 时为 64)个字节。
3-bit 更麻烦,因为 8 个 3-bit 值正好 24 bit,跨 3 个字节,不能按 2 的幂对齐:
grp_offs = tl.arange(0, BLOCK_GRP)grp_mask = grp_offs < (D // 8)idx_grp = tl.reshape(idx, [BLOCK_GRP, 8])shifts_3 = tl.arange(0, 8) * 3packed_24 = tl.sum((idx_grp & 0x7) << shifts_3[None, :], axis=1)b0 = (packed_24 & 0xFF).to(tl.uint8)b1 = ((packed_24 >> 8) & 0xFF).to(tl.uint8)b2 = ((packed_24 >> 16) & 0xFF).to(tl.uint8)tl.store(KV_cache_ptr + slot_base + grp_offs * 3, b0, mask=grp_mask)tl.store(KV_cache_ptr + slot_base + grp_offs * 3 + 1, b1, mask=grp_mask)tl.store(KV_cache_ptr + slot_base + grp_offs * 3 + 2, b2, mask=grp_mask)BLOCK_GRP 是 next_power_of_2(D // 8), 时为 16。每个 group 的 8 个下标被排成 (16, 8),分别左移 0、3、6、…、21 位,累加成一个 24-bit 整数,再拆成低、中、高三个字节。这里用 sum 而不是 or 也可以,因为 3-bit 值只占 0..7,移位后不会重叠;但如果某个 lane 的 idx 越界(理论上有 min 保护,不会发生),sum 会产生进位而 or 不会,所以生产代码里 min 是必要的。
grp_offs * 3 是这个设计的核心约束:每个 3-bit 组必须从 3 的倍数偏移开始。这要求 D 是 8 的倍数(128、96、64 都满足),否则最后一组不足 8 个值,打包后的字节数不是 3 的倍数,跨 slot/跨页的边界就会错位。vLLM 的 TurboQuant 只对 head_dim 为 8 的倍数的模型开放,测试里也只覆盖 64、96、128、256 这些常见值。
向量范数的存储与 norm correction 的折叠
K 的范数在 MSE 路径里由 Python 侧算好传进来(norms),kernel 只负责存成 fp16:
vn_f32 = tl.load(Norms_ptr + pid) # ||k_t||, fp32
if NORM_CORRECTION: safe_idx = tl.minimum(tl.maximum(idx, 0), N_CENTROIDS - 1) c_vals = tl.load(Centroids_ptr + safe_idx, mask=d_mask, other=0.0) c_norm_sq = tl.sum(tl.where(d_mask, c_vals * c_vals, 0.0), axis=0) c_inv_norm = 1.0 / tl.sqrt(c_norm_sq + 1e-16) vn_f32 = vn_f32 * c_inv_norm
vn_u16 = vn_f32.to(tl.float16).to(tl.uint16, bitcast=True)tl.store(KV_cache_u16_ptr + knorm_u16_addr, vn_u16)idx 是刚刚二分得到的质心下标向量,Centroids_ptr + safe_idx 是一次 gather:每个坐标取自己的质心值,拼成重建向量 。c_norm_sq 是 ,c_inv_norm 是 。当 NORM_CORRECTION=1 时,存储的范数变成 ,读取端就可以直接做 ,不必再算范数。
这段代码也解释了为什么 norm correction 几乎”免费”:写入时每个 token 已经要读一遍 idx 和 centroids,多算一次 维平方和与开方,相对于整个 store kernel 的访存量可以忽略;而读取端每次 decode 都要对每个 tile 的每个 token 重复算,省下来的就是实打实的算力。源码注释里说,在 gpt-oss、4096 上下文下这条优化减少了约 26% 的 TQ 开销,量级是合理的。
V 的 min/max 均匀量化
V 的处理和 K 完全不同:不做旋转、不做 Lloyd-Max,而是对每条 V 向量做 min/max 线性量化。3-bit 分支:
val_vec = tl.load(Value_ptr + base + d_offs, mask=d_mask, other=0.0).to(tl.float32)val_min = tl.min(tl.where(d_mask, val_vec, float("inf")), axis=0)val_max = tl.max(tl.where(d_mask, val_vec, -float("inf")), axis=0)v_scale = (val_max - val_min) / 7.0v_scale = tl.where(v_scale > 1e-8, v_scale, 1e-8)
q_vals = tl.minimum( tl.maximum(((val_vec - val_min) / v_scale + 0.5).to(tl.int32), 0), 7)四个细节:
tl.min/tl.max用where(d_mask, ..., ±inf)把 padding lane 排除。如果直接对未 mask 的 0 取 min,零会被误当成最小值,量化区间就被污染了。v_scale = (max-min)/7:3-bit 有 8 个电平,区间宽度除以2^b-1而不是2^b,保证最大值能映射到 7。+0.5后转int32实现四舍五入;clamp(0, 7)防止浮点误差把边界值推到 8 或 -1。v_scale下限1e-8:常数向量(max=min)时 scale=0,除零会产生 NaN;夹到极小值后所有值都量化到 0,重建为val_min,语义正确。
4-bit 分支只是把 7.0 换成 15.0、0x7 换成 0xF,其余结构相同。打包时 3-bit 走”8 个一组、3 字节”的路径,4-bit 走”2 个一组、1 字节”的路径,与 K 的打包逻辑对称。
scale 和 zero 都存成 fp16:
sc_offset = val_cache_offset + VAL_DATA_BYTESsc_f16 = v_scale.to(tl.float16)sc_u16 = sc_f16.to(tl.uint16, bitcast=True)tl.store(KV_cache_ptr + slot_base + sc_offset, (sc_u16 & 0xFF).to(tl.uint8))tl.store(KV_cache_ptr + slot_base + sc_offset + 1, ((sc_u16 >> 8) & 0xFF).to(tl.uint8))这里用两个 uint8 写一个 fp16,而不是直接 tl.store 一个 fp16 指针:KV_cache_ptr 是 uint8*,Triton 的指针类型是显式的,不能在一个 uint8* 上直接存 fp16。用 bitcast 加两次字节写,编译器会把它们合并成一条 16-bit store(如果地址对齐),即使不合并,两次相邻写也落在同一 cache line 里。
一次写入的成本账
把上面的步骤合起来,一个 program 的访存和计算大致是:
- 读 K: 个 fp16(Python 侧已经读过一次做归一化,这里读的是旋转后的 fp32
y, 字节); - 读 V: 个 fp16( 字节);
- 读
midpoints:3 到 4 次标量常量加载; - 写 K 索引: 字节;
- 写 K norm:2 字节;
- 写 V 数据: 字节;
- 写 V scale/zero:4 字节。
、3-bit K、4-bit V 时,单头单 token 约读 768 字节、写 118 字节。这个比例说明 store kernel 是”读多写少”的带宽型 kernel,计算(二分、打包、min/max)相对于访存很轻。融合的主要收益不是省算力,而是省 kernel launch 和中间张量:如果分成”归一化、旋转、二分、打包、V 量化、写缓存”六个 kernel,每个 kernel 都要把中间结果写回显存再读出来,prefill 大 batch 下这部分流量会翻倍。源码注释明确写了融合消除了”每次调用 4 个 PyTorch kernel launch”(相对于先 pack、再单独写 scale 的旧实现)。
FP8 K 路径:不旋转,直接 cast
turboquant_k8v4 走另一条分支。K 不归一化、不旋转、不查表,而是在 kernel 里直接转 FP8:
k_vals = tl.load(Key_ptr + base + d_offs, mask=d_mask, other=0.0).to(tl.float32)k_fp8 = k_vals.to(tl.float8e4b15) if FP8_E4B15 else k_vals.to(tl.float8e4nv)k_bytes = k_fp8.to(tl.uint8, bitcast=True)tl.store(KV_cache_ptr + slot_base + d_offs, k_bytes, mask=d_mask)FP8_E4B15 是一个按设备能力缓存的常量:
def _use_fp8_e4b15(device: int = 0) -> int: """Return 1 if device needs fp8e4b15 (Ampere/Ada, SM < 8.9), else 0.""" if device not in _FP8_E4B15: if current_platform.is_cuda_alike(): cap = torch.cuda.get_device_capability(device) _FP8_E4B15[device] = 1 if cap < (8, 9) else 0 else: _FP8_E4B15[device] = 0 return _FP8_E4B15[device]Ampere(SM 8.0/8.6)和 Ada(SM 8.9 之前)没有原生的 E4M3 FP8 指令,只能用 E4B15 这种”指数 4 位、尾数 3 位”的格式来模拟;Hopper(SM 9.0)及以上有 e4nv,精度和动态范围都更好。这个分支只影响 K 的 cast,V 仍然是 4-bit 量化,因此 k8v4 的 slot 是 128 + 68 = 196 字节。
k8v4 的意义是给”只要比 FP16 省一半、但不想承担 K 的量化误差”的场景一个中间档。它的 PPL 增量只有 +1.17%,在四个预设里最小,但压缩比也最低(2.6×)。值得注意的是,它没有 norm correction:FP8 的 per-tensor 动态范围已经足够,K 的范数信息保留在 FP8 的指数里,不需要额外的 norm 存储。
读取内核:decode 如何从 packed slot 还原 K/V 并保持 Softmax 数值稳定
读取比写入难:分页、解包和在线 softmax 要同时处理
写入时一个 token 的 K/V 就是全部数据;读取时一条请求的历史可能横跨几十个物理页,页号由 block_table 决定,页内位置由 seq_len 决定。decode 每一步对每个请求只产生一个 query,却要读完整段历史 KV。TurboQuant 的 decode kernel 采用”split-KV + 两阶段”结构,和 vLLM 的 Triton 解码注意力一致:
- Stage 1:grid 是
(B, H_q, NUM_KV_SPLITS),每个 program 负责一个请求、一个 query 头、一段 KV 区间。它在 tile 内部完成”解包 K → 算分 → 在线 softmax → 解包 V → 加权累加”,最后写出这一段的局部部分和()与 log-sum-exp()。 - Stage 2:grid 是
(B, H_q),复用triton_decode_attention._fwd_kernel_stage2,对NUM_KV_SPLITS个部分和做一次合并,得到最终输出。
NUM_KV_SPLITS 是 max_num_kv_splits,来自 attention 配置 tq_max_kv_splits_for_cuda_graph。注释里说得很明确:grid 维度必须是常量才能进 CUDA Graph,而基准测试显示固定 split 数和动态 split 在 eager 模式下没有性能回退。这是一个典型的”服务系统优先”的决策:牺牲一点动态性,换 CUDA Graph 的可捕获性。
程序入口:split 区间怎么算
bid = tl.program_id(0) # batch indexhid = tl.program_id(1) # q_head indexsid = tl.program_id(2) # kv_split index
kv_head = hid // KV_GROUP_SIZE
seq_len = tl.load(Seq_lens_ptr + bid)
split_len = tl.cdiv(seq_len, NUM_KV_SPLITS)split_start = split_len * sidsplit_end = tl.minimum(split_start + split_len, seq_len)
if split_start >= split_end: return这里有三个值得注意的点:
kv_head = hid // KV_GROUP_SIZE:GQA 下多个 query 头共享一个 KV 头,KV_GROUP_SIZE = H_q / H_kv是编译期常量。grid 按 query 头展开(每个 query 头独立算分),而 KV 读取按 KV 头寻址,这样同一段 KV 会被KV_GROUP_SIZE个 program 重复读。这是 GQA 的固有代价,也是为什么 split 数不能开太大:split 越多,KV 读取的重复度越高。split_len = ceil(seq_len / splits):区间按”向上取整”均分,最后一个 split 可能比前面短。split_end用min夹到seq_len。split_start >= split_end直接返回:当序列短于 split 数时,尾部几个 split 没有数据,直接退出,避免空转。返回是安全的,因为 stage 2 会把没有写过的中间缓冲当成lse = -inf处理(前提是缓冲区被初始化过;实际实现里工作区预分配时已清零)。
为解包预计算位索引
K 和 V 的解包都要”从字节里取第 个 3-bit/4-bit 值”,所以 kernel 在循环外先把位偏移、字节下标、位内偏移算好:
if not KEY_FP8: mse_bit_off = d_offs * MSE_BITS mse_byte_idx = mse_bit_off // 8 mse_bit_shift = mse_bit_off % 8 mse_mask = (1 << MSE_BITS) - 1
if VQB == 3: val_bit_off = d_offs * 3 val_byte_idx = val_bit_off // 8 val_bit_shift = val_bit_off % 8d_offs = arange(0, BLOCK_D) 是坐标下标向量,mse_bit_off 是每个坐标的起始 bit。mse_byte_idx 和 mse_bit_shift 是它的字节位置和位内起始位置。这些量只依赖 d_offs,与 token、split 无关,放在循环外可以避免每个 tile 重复计算 次除法与取模。
mse_mask = 2^b - 1 用于 (raw16 >> shift) & mask 提取。这里用 raw16 = raw0 | (raw1 << 8) 把两个相邻字节拼成 16-bit,再按 mse_bit_shift 右移、按 mse_mask 截取。为什么拼 16 位?因为一个 3-bit 值可能跨字节边界(例如 bit 6 开始的 3 位占 byte0 的 bit6-7 与 byte1 的 bit0),拼成 16 位后一次移位可以覆盖所有跨字节情况;4-bit 值同样可能跨越,用 16 位拼装比两次分支判断更简单。
分数计算:FP8 K 与 MSE K 的两条路径
FP8 K 路径直接把字节 cast 回 FP8 再乘:
k_addrs = slot_bases[:, None] + d_offs[None, :]k_raw = tl.load(KV_cache_ptr + k_addrs, mask=kv_mask[:, None] & d_mask[None, :], other=0)if FP8_E4B15: k_float = k_raw.to(tl.float8e4b15, bitcast=True).to(tl.float32)else: k_float = k_raw.to(tl.float8e4nv, bitcast=True).to(tl.float32)scores = tl.sum(tl.where(d_mask[None, :], q_rot[None, :] * k_float, 0.0), axis=1) * ATTN_SCALE注意 slot_bases 的形状是 (BLOCK_KV,),[:, None] 变成 (BLOCK_KV, 1),加上 d_offs[None, :] 的 (1, BLOCK_D) 得到 (BLOCK_KV, BLOCK_D) 的地址矩阵,一次 load 拿到整个 tile 的 K。q_rot 是 (BLOCK_D,),广播成 (BLOCK_KV, BLOCK_D) 后逐元素乘、按 axis=1 求和,得到每个 token 的分数。
ATTN_SCALE 是 1/sqrt(D),在 launcher 里从 scale 参数传入。这里没有像标准的 softmax(q·k^T / sqrt(d)) 那样把 scale 放在最后的 softmax 前,而是乘在分数上,效果等价,但少一次逐 token 的乘。
MSE K 路径更复杂,需要”解包 + 查表 + 点积 + 乘范数”:
mse_addrs0 = slot_bases[:, None] + mse_byte_idx[None, :]mse_raw0 = tl.load(KV_cache_ptr + mse_addrs0, mask=..., other=0).to(tl.int32)mse_raw1 = tl.load(KV_cache_ptr + mse_addrs0 + 1, mask=..., other=0).to(tl.int32)raw16 = mse_raw0 | (mse_raw1 << 8)mse_idx = (raw16 >> mse_bit_shift[None, :]) & mse_mask
c_vals = tl.load(Centroids_ptr + mse_idx, mask=..., other=0.0)
term1 = tl.sum(tl.where(d_mask[None, :], q_rot[None, :] * c_vals, 0.0), axis=1)
norm_bases = slot_bases + MSE_BYTESn_lo = tl.load(KV_cache_ptr + norm_bases, mask=kv_mask, other=0).to(tl.uint16)n_hi = tl.load(KV_cache_ptr + norm_bases + 1, mask=kv_mask, other=0).to(tl.uint16)vec_norms = (n_lo | (n_hi << 8)).to(tl.float16, bitcast=True).to(tl.float32)
scores = vec_norms * term1 * ATTN_SCALE这条路径的核心是 c_vals = tl.load(Centroids_ptr + mse_idx, ...):mse_idx 是一个 (BLOCK_KV, BLOCK_D) 的下标矩阵,每个元素都是 [0, 2^b) 的整数,这一步是一次”tile 内 gather”。Triton 的 gather 在底层是每个 lane 独立从常量内存或 L1 读取,centroids 只有 8 或 16 个 fp32,完全能放进常量缓存,所以 gather 的代价是每个元素的几次缓存访问,而不是 DRAM 随机访问。这也是为什么 Lloyd-Max 码本只支持 3 到 4 bit:如果码本太大(比如 8 bit 的 256 个中心),gather 的缓存命中率会下降,反而不如直接存 FP8。
term1 是 ,即”旋转后的 query 和质心向量的点积”。因为旋转矩阵是正交且对称的,,而 正是解包后的 K(未乘范数)。所以 term1 乘上存储的范数,就是 q·k 的近似值。这个推导说明Q 必须旋转:如果 Q 不旋转,直接用原始 Q 和旋转后的质心点积,结果完全不对。
当 NORM_CORRECTION=0(AoS 路径的 k8v4 之外的某些组合)时,vec_norms 就是 ,读取端直接乘;而当 NORM_CORRECTION=1 且是 SoA store 时,存储的范数已经是 ,读取端直接乘就完成了归一化,不需要再算质心范数。AoS 路径的 NORM_CORRECTION 分支则是在 kernel 里实时算:
if NORM_CORRECTION: c_norm_sq = tl.sum(tl.where(d_mask[None, :], c_vals * c_vals, 0.0), axis=1) c_inv_norm = 1.0 / tl.sqrt(c_norm_sq + 1e-16) c_vals = c_vals * c_inv_norm[:, None]这段代码在每个 tile、每个 token 上算一次 维平方和、开方、缩放,这正是 SoA 路径把它折叠到写入端要省掉的工作。
V 的解包:3-bit 的跨字节与 4-bit 的 nibble
V 的解包与 K 的索引解包类似,但多了 scale/zero 的读取。4-bit 分支:
vb_idx = d_offs // 2vb_shift = (d_offs % 2) * 4val_addrs = val_bases[:, None] + vb_idx[None, :]val_raw = tl.load(KV_cache_ptr + val_addrs, mask=..., other=0).to(tl.int32)v_idx = ((val_raw >> vb_shift[None, :]) & 0xF).to(tl.float32)每个字节装两个坐标:偶数坐标取低 4 位,奇数坐标取高 4 位。vb_idx 把 d_offs 折半,vb_shift 在 0/4 之间交替。
3-bit 分支用与 K 相同的”拼 16 位”策略:
val_bit_off = d_offs * 3val_byte_idx = val_bit_off // 8val_bit_shift = val_bit_off % 8val_raw0 = tl.load(KV_cache_ptr + val_addrs0, ...)val_raw1 = tl.load(KV_cache_ptr + val_addrs0 + 1, ...)raw16 = val_raw0 | (val_raw1 << 8)v_idx = ((raw16 >> val_bit_shift[None, :]) & 0x7)scale 和 zero 从 slot 的 val_bases + VAL_DATA_BYTES 处各读 2 字节,反序列化成 fp16:
sc_lo = tl.load(KV_cache_ptr + sc_bases, mask=kv_mask, other=0).to(tl.uint16)sc_hi = tl.load(KV_cache_ptr + sc_bases + 1, mask=kv_mask, other=0).to(tl.uint16)v_scales = (sc_lo | (sc_hi << 8)).to(tl.float16, bitcast=True).to(tl.float32)注意 sc_bases = val_bases + VAL_DATA_BYTES 是 (BLOCK_KV,) 形状,mask=kv_mask 是逐 token 的,所以每个 token 读一次 scale 和 zero,而不是每个坐标读一次。这在循环里只多了 2 条 load,相对于 (BLOCK_KV, BLOCK_D) 的 V 数据读取是九牛一毛。
在线 softmax:为什么要用”减法”而不是”除法”
TurboQuant 的 stage 1 用的是标准在线 softmax:
n_e_max = tl.maximum(tl.max(scores, 0), m_prev)re_scale = tl.exp(m_prev - n_e_max)p = tl.exp(scores - n_e_max)acc = acc * re_scale + tl.sum(p[:, None] * values, 0)l_prev = l_prev * re_scale + tl.sum(p, 0)m_prev = n_e_max逐条解释:
scores已经是q·k * scale,可能很大(fp16 下 logits 超过 11 就溢出exp);先减去当前 tile 的最大值n_e_max再exp,保证指数参数 ≤ 0,exp结果在 。re_scale = exp(m_prev - n_e_max)修正之前 tile 累积的acc和l:之前用的是旧的 maxm_prev,现在 max 变大(或持平),之前所有项的指数都要按比例缩小。acc是未归一化的加权 V 和,l是未归一化的权重和。每个 tile 结束时acc和l的比值就是归一化后的输出。- 最后存
acc / safe_l和lse = m_prev + log(l):lse是 log-sum-exp,stage 2 用它做跨 split 合并。
safe_l = where(l_prev > 0, l_prev, 1.0) 是为了防止空 split(split 区间全是 mask 掉的 token)时除以 0。空 split 的 acc=0, l=0,存 0/1=0、lse=-inf+log(1)=-inf,stage 2 合并时 exp(-inf)=0,不影响结果。
数值精度:累加器为什么是 fp32
acc 声明为 tl.zeros([BLOCK_D], dtype=tl.float32),m_prev、l_prev 也是 fp32。原因有二:
- 累加:
acc要把整个BLOCK_KV行的p * v加起来,p在 、v是 fp16 反序列化的值,如果acc用 fp16,几千个 token 累加后会丢精度;fp32 的 24 位尾数足够。 exp与log:Triton 的tl.exp/tl.log默认返回 fp32,用 fp16 反而会引入额外转换。
输出阶段 acc / safe_l 仍然在 fp32 里算,最后在 launcher 的 stage 2 里按 out_dtype 转成 query 的 dtype(fp16/bf16)。
prefill 路径:不读缓存,直接算,再写缓存
Prefill 不走 decode kernel。forward 按批次类型分三种情况:
- 纯 decode:所有请求
max_query_len == 1,直接调_decode_attention。 - 纯 prefill:
num_decodes == 0,走_prefill_attention。 - 混合批:decode 在前、prefill 在后(由
reorder_batch_threshold=1保证),两段分别调,结果写进同一块输出。
_prefill_attention 里有一个重要的快速路径:
if _HAS_FLASH_ATTN and attn_metadata.max_query_len == attn_metadata.max_seq_len: return self._flash_attn_varlen( q=query, k=key, v=value, cu_seqlens_q=attn_metadata.query_start_loc, cu_seqlens_k=attn_metadata.query_start_loc, max_seqlen_q=attn_metadata.max_query_len, max_seqlen_k=attn_metadata.max_query_len, )当批次里每个请求的 query 长度都等于序列长度(即没有任何请求有历史缓存)时,直接用 batch 里的原始 K/V 跑 FlashAttention,完全不读 TurboQuant 缓存。这是 prefill 最常见的场景:新请求的第一段 prompt。do_kv_cache_update 已经在这之前把这段 prompt 量化写进了缓存,供后续 decode 使用;而这次 prefill 本身用 FP16 的原始 K/V 算,精度最高。
混合批里还要处理一个细节:prefill 子批的 max_seq_len 要用 seq_lens_cpu[num_decodes:] 重新算,而不是沿用整批的 max_seq_len。注释解释了原因:decode 请求会把整批 max_seq_len 撑大,导致 FlashAttention 的”fast path”(max_query_len == max_seq_len)无法触发。用 CPU 侧的 seq_lens_cpu 算 prefill 子批的最大值,既避免了一次 GPU→CPU 同步(seq_lens_cpu 是调度器在 CPU 上维护的上界),又能让 first-chunk prefill 命中 fast path。
续写 prefill:小 chunk 走 decode,大 chunk 走反量化
当 prefill 请求带有历史缓存(例如 chunked prefill 的后几个 chunk、多轮对话的第二轮)时,q_len < seq_len,要同时看到历史和当前 chunk 的 K/V。TurboQuant 有两个策略:
cached_len = seq_len - q_lenif q_len <= _CONTINUATION_DECODE_THRESHOLD: # Fast path: treat each query as a decode request synth_seq_lens = _arange_cache[cached_len + 1 : seq_len + 1] synth_bt = attn_metadata.block_table[i : i + 1].expand(q_len, -1) out = triton_turboquant_decode_attention(...)else: out = self._continuation_prefill(...)_CONTINUATION_DECODE_THRESHOLD = 128。小 chunk(≤128 个 query)直接复用 decode kernel:把每个 query token 当成一个”序列长度为 cached_len + k 的 decode 请求”,用 arange 预生成 seq_lens,用 block_table 的一行 expand 成 q_len 行。这样因果掩码自然由 seq_lens 的递增实现,不需要额外构造 mask。
大 chunk 才走 _continuation_prefill:先用 _tq_full_dequant_kv 把整段历史反量化成 fp16,再和当前 chunk 的原始 K/V 拼接,最后调 FlashAttention。反量化的代价是 O(cached_len * D),对 8K 历史、128 维、8 个 KV 头,约 1M 个元素的读取与写回,明显比 decode kernel 的 O(cached_len) 重。
源码注释解释了阈值的选择:
do_kv_cache_update already stored all tokens to TQ cache, so the decode kernel can read them efficiently. This avoids O(cached_len) dequant work per continuation, eliminating the O(N²/chunk_size) collapse at long context.
如果每个 chunk 都反量化整段历史,chunk 数 ,总代价是 ,长上下文下会崩;而 decode kernel 对历史只读一遍压缩数据,总代价 。128 这个阈值是”decode kernel 的 tile 效率”与”FlashAttention 的吞吐”之间的平衡点:chunk 太小,decode kernel 的每 token 开销占主导;chunk 够大,反量化一次摊到很多 query 上更划算。
反量化 kernel:_tq_full_dequant_kv
_continuation_prefill 调用的 _tq_full_dequant_kv 是一个独立的 Triton kernel,grid 是 (alloc_len, batch*heads):每个 program 负责一个位置、一个 KV 头,输出 fp16 的 K 和 V。它的逻辑和 decode kernel 里的解包完全一致,只是没有 softmax,纯粹把 packed slot 展开成 fp16。
反量化完还要做逆旋转:k_cached @ Pi_half。Pi_half 是 Hadamard 矩阵的 fp16 拷贝,注释里的理由是”fp16 matmul 比 fp32 省一半带宽,且能用 Tensor Core”。这一步把质心空间的 K 转回原始空间,才能和当前 chunk 的原始 K/V 拼在一起。
SoA、FlyDSL 与三套 decode 的关系
TurboQuantAttentionImpl 在 decode 时有三条路径:
- FlyDSL decode(AMD gfx950):条件非常严格——
not key_fp8、key_mse_bits == 4、value_quant_bits == 4、head_size == 128、GQA 比在{8,16}或支持 GQA-6、block_size in (16, 32)、无 sink、无滑动窗口。不满足就退回 SoA Triton。 - SoA-aware Triton decode:
_dispatch_decode_soa,用inspect.signature过滤soa_decode支持的参数,如果有非 None 的额外参数被丢弃就抛NotImplementedError,避免悄悄丢掉功能(比如 sink 或滑动窗口)。 - 默认 AoS Triton decode:
triton_turboquant_decode_attention。
三条路径的计算逻辑一致,差别在字节寻址。FlyDSL 是 AMD 的 DSL,能把 decode 的 tile 循环编译成更贴近 MI300/gfx950 硬件的加载模式;SoA 的地址计算把 K norm、V scale/zero 放在页内的连续区,decode 读取时可以一次 u16 load 拿一段,减少小粒度 gather。
这个”多路径 + 严格回退”的写法暴露了一个服务系统里的现实:最优 kernel 的适用条件往往很窄,而回退路径必须语义等价。源码在回退时打 logger.warning_once,记录不满足的条件(key_fp8、mse_bits、vqb、head_size、num_kv_groups、sinks),方便用户定位为什么这个模型没走到最快的路径。
接入引擎:缓存 dtype、层跳过与 attention backend 的选择
--kv-cache-dtype 的解析
四个预设字符串在 vllm/config/cache.py 的 CacheDType 里注册,解析后进入 KVQuantMode 枚举:
class KVQuantMode(IntEnum): NONE = 0 FP8_PER_TENSOR = 1 # per-tensor scales (current fp8 path) INT8_PER_TOKEN_HEAD = 2 # per-token-head dynamic scales for int8 FP8_PER_TOKEN_HEAD = 3 # per-token-head dynamic scales for fp8 INT4_PER_TOKEN_HEAD = 4 # packed 2×int4/byte, RHT + asymmetric zp NVFP4 = 5 # packed fp4 data + fp8 block scales # Hadamard-rotated Lloyd-Max quant, packed K+V per slot. TURBOQUANT_K8V4 = 6 TURBOQUANT_4BIT_NC = 7 TURBOQUANT_K3V4_NC = 8 TURBOQUANT_3BIT_NC = 9 NVFP4_DS_MLA = 10 # opaque-bytes NVFP4 DS-MLA layouts (FlashMLA sparse) ULTRAQUANT_4BIT = 11 # packed FP4 values + UE8M0 group scales CUSTOM = 12这个枚举有两层作用:
- 让 kernel 分发不靠字符串匹配:注意力后端可以用
spec.kv_quant_mode.is_turboquant、.is_nvfp4、.is_per_token_head判断走哪条路径。 - 给
customize_spec提供名字反查:TurboQuantConfig.from_cache_dtype(spec.kv_quant_mode.name.lower(), spec.head_size)依赖”枚举名小写后等于预设字符串”这一约定,所以四个枚举成员的名字必须和TQ_PRESETS的键严格一致。
is_turboquant 是一个属性:
@propertydef is_turboquant(self) -> bool: """True for any turboquant quantization mode.""" return self in ( KVQuantMode.TURBOQUANT_K8V4, KVQuantMode.TURBOQUANT_4BIT_NC, KVQuantMode.TURBOQUANT_K3V4_NC, KVQuantMode.TURBOQUANT_3BIT_NC, )把它写成”四个成员之一”而不是”值 ≥ 6”,是为了给后面的 ULTRAQUANT_4BIT = 11 留出独立的判断空间——两个 packed 格式在缓存规格、层跳过和后端选择上逻辑相同,但 kernel 完全不同,分开判断能让代码在新增格式时只加一个成员,而不是改区间。
首尾层保护:get_boundary_skip_layers
TurboQuant 并不对所有注意力层做量化。get_boundary_skip_layers 返回需要跳过的层索引:
@staticmethoddef get_boundary_skip_layers(model_config: ModelConfig, n: int = 2) -> list[str]: if model_config.is_hybrid: attn_indices = _get_full_attention_layer_indices(model_config) if not attn_indices: raise NotImplementedError(...) logger.info("TQ hybrid: full-attention layers %s", attn_indices) return []
num_layers = model_config.hf_text_config.num_hidden_layers if n <= 0 or num_layers <= 0: return [] n = min(n, num_layers // 2) first = list(range(n)) last = list(range(num_layers - n, num_layers)) indices = sorted(set(first + last)) return [str(i) for i in indices]三个设计决策:
- 为什么跳过首尾层:源码注释给出的经验数据是”没有它,Qwen3-4B 的 GSM8K 会掉约 30 分”(
without it GSM8K drops ~30 points)。首层和末层的注意力对 KV 的精度最敏感:首层的 K/V 直接决定后续残差的起点,末层的 K/V 直接影响 logits。这两类层保留原生 dtype(fp16),代价是每层每 token 多占2 * n_kv * d * 2字节,对 64 层模型只有 4 层不省,压缩比下降约 6%。 n被min(n, num_layers // 2)夹住:小模型(比如 4 层)如果去掉首尾各 2 层,就没有层被量化了,所以最多跳过一半。- 混合模型(attention + Mamba/线性注意力)不跳过:混合模型通常只有 8-12 个全注意力层,首尾各跳 2 层会覆盖约 40% 的全注意力层,压缩比几乎腰斩;而 Mamba/线性层本来就不存 KV Cache,跳过它们没有意义。
_get_full_attention_layer_indices兼容三种社区约定:layer_types(Qwen3.5/Next)、layers_block_type(Jamba/Zamba2)、attn_type_list(Minimax)。
跳过层如何落地?在 create_engine_config 里:
uses_packed_kv_backend = ( resolved_cache_dtype.startswith("turboquant_") or resolved_cache_dtype == "ultraquant_4bit")if uses_packed_kv_backend: boundary = TurboQuantConfig.get_boundary_skip_layers(model_config) # Sorted so the order does not depend on set iteration: the list is # a CacheConfig hash factor. Entries can also be attention type # names (e.g. "sliding_window"), so sort them as strings. cache_config.kv_cache_dtype_skip_layers = sorted( set(cache_config.kv_cache_dtype_skip_layers) | set(boundary) )注意这是并集而不是覆盖:用户可以通过 --kv-cache-dtype-skip-layers 额外跳过某些层(例如 sliding_window),程序再把首尾边界层加进去。排序的原因很实际:kv_cache_dtype_skip_layers 是 CacheConfig 的哈希因子之一,如果顺序依赖 set 遍历顺序,同一个配置在不同进程里会得到不同哈希,影响缓存复用和编译缓存命中。
后端选择:TURBOQUANT 在优先级列表的位置
vllm/platforms/cuda.py 里给每个设备能力返回一个候选后端列表,TURBOQUANT 被放在最后:
return [ AttentionBackendEnum.FLASH_ATTN, AttentionBackendEnum.FLASHINFER, AttentionBackendEnum.TRITON_ATTN, AttentionBackendEnum.FLEX_ATTENTION, AttentionBackendEnum.TURBOQUANT,]选择逻辑是”从列表头开始,第一个同时满足 dtype、head size、KV cache dtype 等约束的后端胜出”。前四个后端在 supports_kv_cache_dtype 里都不接受 turboquant_*,所以最终一定落到 TURBOQUANT。把它放在末尾是防御性的:如果将来某个通用后端(比如 FlashInfer 的新版本)开始支持 packed KV,选择器会优先用那个后端,而不是这里的 Triton 实现。
TURBOQUANT 自己的能力约束也会进一步过滤:
supports_kv_cache_dtype只接受turboquant_前缀;supports_attn_type只接受DECODER;supports_per_head_quant_scales返回 False(不走 per-head scale 的通用路径);supports_head_size接受任意正数(因为这里的head_size是 slot 折算后的”等效 head size”,不是模型的真实 head_dim)。
FlashAttention 版本被强制到 2
create_engine_config 里还有一段容易忽略的逻辑:
# TurboQuant requires FlashAttention 2 — FA3 boundary layers assert# FlashAttentionImpl which fails with TurboQuantAttentionImpl.if uses_packed_kv_backend and ( attention_config.flash_attn_version is None or attention_config.flash_attn_version >= 3): logger.warning(...) attention_config.flash_attn_version = 2原因在于边界层:首尾层被跳过量化的层仍然走 FlashAttentionImpl,而 TurboQuant 的 prefill 快速路径也依赖 FlashAttention 2 的 flash_attn_varlen_func。FA3 的 FlashAttentionImpl 在初始化时会 assert isinstance(impl, FlashAttentionImpl),而 TurboQuant 的 TurboQuantAttentionImpl 不是它的子类,断言会失败。强制降级到 FA2 是当前实现的兼容性折中,代价是 Hopper/Blackwell 上新请求的 prefill 少了一些 FA3 的调度优化。
页大小统一:packed 布局与 skip 层混用
vLLM 的 KV 缓存页大小必须对所有层统一(unify_kv_cache_spec_page_size),否则一个 block 在内存里无法同时服务不同层的 layout。TurboQuant 的 packed 页比标准 FullAttentionSpec 的页小,而跳过层用标准页:
elif ( cache_config.cache_dtype.startswith("turboquant_") or cache_config.cache_dtype == "ultraquant_4bit"): # TurboQuant and UltraQuant have packed K|V layouts; the standard # FullAttentionSpec formula over-sizes them ... tq_spec = FullAttentionSpec( block_size=1, ... ) ...源码在计算”1 token 的页大小”时,对 packed 格式用后端自己的 customize_spec 算 slot 大小;对 skip 层仍用标准公式。两者取 max,保证 mamba padding 覆盖最大实际页。也就是说,当模型同时有 packed 层和 skip 层时,整个缓存按标准页大小分配,packed 层会浪费一部分页空间。这是”边界保护”的直接代价:跳过的层越多,浪费越大。
测试口径:GSM8K 与 ROCm
tests/evals/gsm8k/configs/ 里有四个配置,以 Qwen3-4B-TQ-k3v4nc.yaml 为例:
model_name: "Qwen/Qwen3-4B"accuracy_threshold: 0.78num_questions: 1319num_fewshot: 5server_args: "--kv-cache-dtype turboquant_k3v4_nc --max-model-len 4096"四个配置的阈值(0.78、0.80 等)是 CI 用来防回归的底线,不是性能宣称。每个预设都有 ROCm 版本(-ROCm.yaml),说明 SoA 和 FlyDSL 路径在 AMD 上也有覆盖。num_fewshot: 5 是 GSM8K 的标准 5-shot 设定,1319 是 GSM8K 测试集的全量题数。把 4096 作为 max-model-len 是因为 4B 模型在这个长度下 KV 压力刚好能测出压缩收益,又不至于让 CI 花太多时间。
精度与性能:预设参数背后的取舍
四个预设的精度与压缩一览
把前文的两张表合并,用同一个维度看这四档方案:
| 预设 | 每元素有效位宽 | 单 token 每层每 KV 头字节数 | 相对 FP16 压缩 | PPL 增量 |
|---|---|---|---|---|
| FP16(基线) | 16 | 512 | 1.0× | 0 |
turboquant_k8v4 | 约 6 | 196 | 2.6× | +1.17% |
turboquant_4bit_nc | 约 4.2 | 134 | 3.8× | +2.71% |
turboquant_k3v4_nc | 约 3.7 | 118 | 约 4.3×(源码注释给 ~3.5×) | +10.63% |
turboquant_3bit_nc | 约 3.2 | 102 | 4.9× | +20.59% |
“每元素有效位宽”是 slot_size * 8 / (2 * D),把 K 和 V 的元数据一起摊到 2D 个元素上。它能帮助理解为什么 k3v4_nc 的压缩比(slot 118 字节)比 4bit_nc(134 字节)高,但源码注释只给 ~3.5×:因为实际分配时还会叠加首尾层跳过、页对齐和 CUDA Graph 预留,按整模型摊开后的比例低于按 slot 算的理论值。
精度的拐点:3-bit K 是悬崖
四档方案里,4bit_nc 到 k3v4_nc 是一个明显的台阶:V 位宽没变(都是 4-bit),只把 K 从 4-bit 降到 3-bit,PPL 增量就从 +2.71% 跳到 +10.63%。这个台阶可以用第二节的误差分析解释:K 的误差直接进入 logits,softmax 的指数放大让 3-bit 的 ~4.25% NMSE 变成约 20% 的分数相对误差,远超 softmax 能吸收的范围。
对比 vLLM 的边界层保护经验(去掉首尾层会掉 30 分 GSM8K),可以看出 K 的量化误差是“局部但致命”:只有少数层的误差累积到影响输出,跳过这几层就能把损失拉回可接受范围。但 k3v4_nc 的 +10.63% 已经把 3-bit K 的损失算进了边界保护的收益,说明即使保护了首尾层,3-bit K 的剩余误差仍然明显。
3bit_nc 把 V 也压到 3-bit,PPL 再翻一倍到 +20.59%。V 的误差本来被 softmax 加权平均稀释,但 3-bit V 的 scale/zero 只有 8 个电平,量化后的加权和会带一个系统性偏差;这个偏差不会随 token 数增加而抵消,反而因为累加而放大。从工程角度,3bit_nc 更适合“只要模型不崩就行”的离线评测或显存极度受限的场景,生产环境的生成质量很难接受。
精度之外:吞吐和延迟怎么变
KV 变小对 decode 的影响是双面的:
- 收益:读取的字节数减少,decode 的带宽压力下降。以
k3v4_nc为例,每个 token 的 KV 从 512 字节降到 118 字节,L2/HBM 的流量降到约 23%。在 batch 大、page 密集的场景,同一个 SM 能在相同 memory-bound 时间内处理更多 token,吞吐提升可以接近压缩比。 - 代价:解包和查表引入额外指令。3-bit 跨字节提取需要 2 次 load + 移位 + mask,质心 gather 需要每个坐标一次常量缓存访问,在线 softmax 的 fp32 累加器也占寄存器。对 compute-bound 的 prefill,这些开销不明显;对 decode,如果压缩后的数据小到不再是瓶颈(比如 batch 很小、上下文很短),解包开销可能反而让延迟上升。
源码里的两个优化正是为了压住这部分代价:SoA 把标量元数据集中,decode 的 gather 变成连续 u16 load;norm correction 折叠到写入端,省掉每个 tile 的归约。注释里的“gpt-oss 4096 上下文下 TQ 开销降低约 26%”就是这两项叠加后的量化收益。
CUDA Graph 与 split 数的性能权衡
tq_max_kv_splits_for_cuda_graph 决定 decode stage 1 的 grid 第三维。split 越多:
- 每个 program 的 KV 区间越短,tile 循环更短,单个 program 的工作量更小;
- stage 2 要合并的
NUM_KV_SPLITS个中间结果更多,mid_o缓冲更大; - GQA 下每个 KV 头被重复读的次数不变(每个 query 头都要读),但每个 split 的 program 数增加,总 program 数
B * H_q * S增大,launch 开销也增大。
注释说“固定 split 数和动态 split 在 eager 模式下没有性能回退”,原因是 decode 的序列长度通常远大于 NUM_KV_SPLITS * BLOCK_KV,每个 split 都能填满 tile,固定 split 的均分损失很小。反过来,如果序列很短(比如 128),固定 split 会让很多 program 空转;但短序列的 decode 本来就不是瓶颈,这点浪费可以接受。
内存:workspace 预分配
TurboQuantMetadataBuilder._reserve_workspace 为 decode 和续写 prefill 预留工作区:
current_workspace_manager().get_simultaneous( ((max_num_reqs, num_heads, max_num_splits, head_size + 1), torch.float32), ((max_num_reqs, num_heads, head_size), model_config.dtype), ((max_num_reqs, num_heads), torch.float32),)三块缓冲分别是:
mid_o:(max_num_reqs, num_heads, max_num_splits, head_size + 1)的 fp32,最后一个元素存lse;output:(max_num_reqs, num_heads, head_size),按模型 dtype(fp16/bf16)存最终输出;lse:(max_num_reqs, num_heads),stage 2 的输入。
这个尺寸在 、、、 时,mid_o 约 MiB,output 约 MiB。mid_o 是大头,它只用来在 stage 1 和 stage 2 之间传递部分和,理论上可以在 stage 2 里直接读写同一个缓冲,但 CUDA Graph 要求每个 kernel 的输入输出形状固定,所以只能预留。
如果 enable_chunked_prefill 且 max_num_batched_tokens > _CONTINUATION_DECODE_THRESHOLD,builder 还会多预留两块 (1, num_kv_heads, alloc_len, head_size) 的 fp16 缓冲,给 _continuation_prefill 的反量化使用。alloc_len 是 max_model_len - 1 向上对齐到 block_size,对 32K 模型、8 个 KV 头、128 维,每块约 MiB,两块共 128 MiB。这个空间在所有层之间共享,注释说“long context 下节省 60× 内存”,指的就是不按层数重复分配。
什么场景该用哪一档
k8v4:只要省一半显存、又不想调精度,或者模型对 K 的量化特别敏感(比如小模型、推理任务)。FP8 的 K 不需要旋转和查表,kernel 路径最短,适合作为“低风险”的第一步。4bit_nc:默认推荐。3.8× 压缩、PPL 增量可接受,K 和 V 都是 4-bit,码本和打包逻辑最规整,各种后端路径都支持。k3v4_nc:显存紧张、但还能容忍一定质量损失(比如长上下文的检索式应用、内部工具)。要接受 +10.63% 的 PPL 和随之而来的生成质量下降。3bit_nc:极端的显存受限场景,或者只需要模型“能跑、格式对”的离线任务。4.9× 压缩,但 PPL +20.59%,不建议用于面向用户的生产服务。
与 FP8 KV Cache 的对比及适用边界
同样是 8-bit 起点的两条路
FP8 KV Cache 是 vLLM 更早、更成熟的方案,两者最容易比较的是 turboquant_k8v4 与 fp8_e4m3:
| 维度 | FP8(fp8_e4m3,逐张量 scale) | turboquant_k8v4 |
|---|---|---|
| K 存储 | FP8,1 字节/元素 | FP8,1 字节/元素 |
| V 存储 | FP8,1 字节/元素 | 4-bit 均匀量化 + fp16 scale/zero |
| 单 token 每层每 KV 头字节 | 256(K 128 + V 128) | 196 |
| 压缩比(相对 FP16) | 2.0× | 2.6× |
| 计算方式 | 可走 FP8 注意力(FA3),Q 也量化 | Q 不量化,K 解包后与 fp16 Q 点积 |
| 精度损失 | 小,取决于 scale 校准 | K 的 FP8 误差 + V 的 4-bit 误差;PPL +1.17% |
| 校准 | 可选,per-head scale 需要 llm-compressor | 不需要,码本与数据无关 |
k8v4 的压缩比高,主要来自 V 被压到 4-bit,而 V 的误差对输出影响小,所以 PPL 只比纯 FP8 略高。它不需要校准,也不需要为每个头存 scale,元数据的节省在低比特下更明显。
4-bit 的对比:TurboQuant 与 per-token-head INT4/NVFP4
vLLM 的 KVQuantMode 里还有 INT4_PER_TOKEN_HEAD 和 NVFP4,也是 4-bit 级的方案:
- INT4 per-token-head:每个 token 的每个头存一个 scale/zero,K/V 对称或非对称量化,元数据随头数增长。
- NVFP4:4-bit 浮点 + 每 16 个元素一个 FP8 block scale,精度比 INT4 线性量化更好,但元数据更多。
- TurboQuant 4-bit:每个向量一个 fp16 norm(K)或一对 fp16 scale/zero(V),码本固定,不需要校准。
TurboQuant 的特别之处在于码本与数据无关:INT4/NVFP4 的 scale 是从数据里统计出来的,每个 token、每个头都要额外存;TurboQuant 只存一个向量范数,码本是全局常量。这让它在低比特下元数据占比最低,代价是它依赖“旋转后近似高斯”这个假设。
适用边界:什么时候选 TurboQuant
- K 维度不大、分布接近高斯:旋转后的高斯假设成立时,码本精度好。经过 RoPE 的长上下文可能让 K 的分布偏离,此时码本的误差会变大;vLLM 用首尾层保护来对冲。
- 需要极低比特:FP8 只能到 8-bit,再往下 per-head scale 的元数据会吃掉收益;TurboQuant 的 3 到 4-bit 是它的主场。
- 不想做校准:码本与数据无关,开箱即用;FP8 per-head scale 和 INT4 的动态 scale 都需要额外配置或统计。
- 需要 MLA:TurboQuant 当前不支持 MLA(只支持
DECODER型、LBNHC布局的普通注意力),MLA 模型走 FP8/NVFP4 的专用路径。这是选型时必须先确认的边界。
论文给出的长上下文证据最直接。下面这张图是 Llama-3.1-8B-Instruct 上的“大海捞针”(Needle-In-A-Haystack)结果,所有方法都按 0.25 的压缩比(只保留 25% 的 KV)比较,纵轴是深度位置,横轴是文档长度:
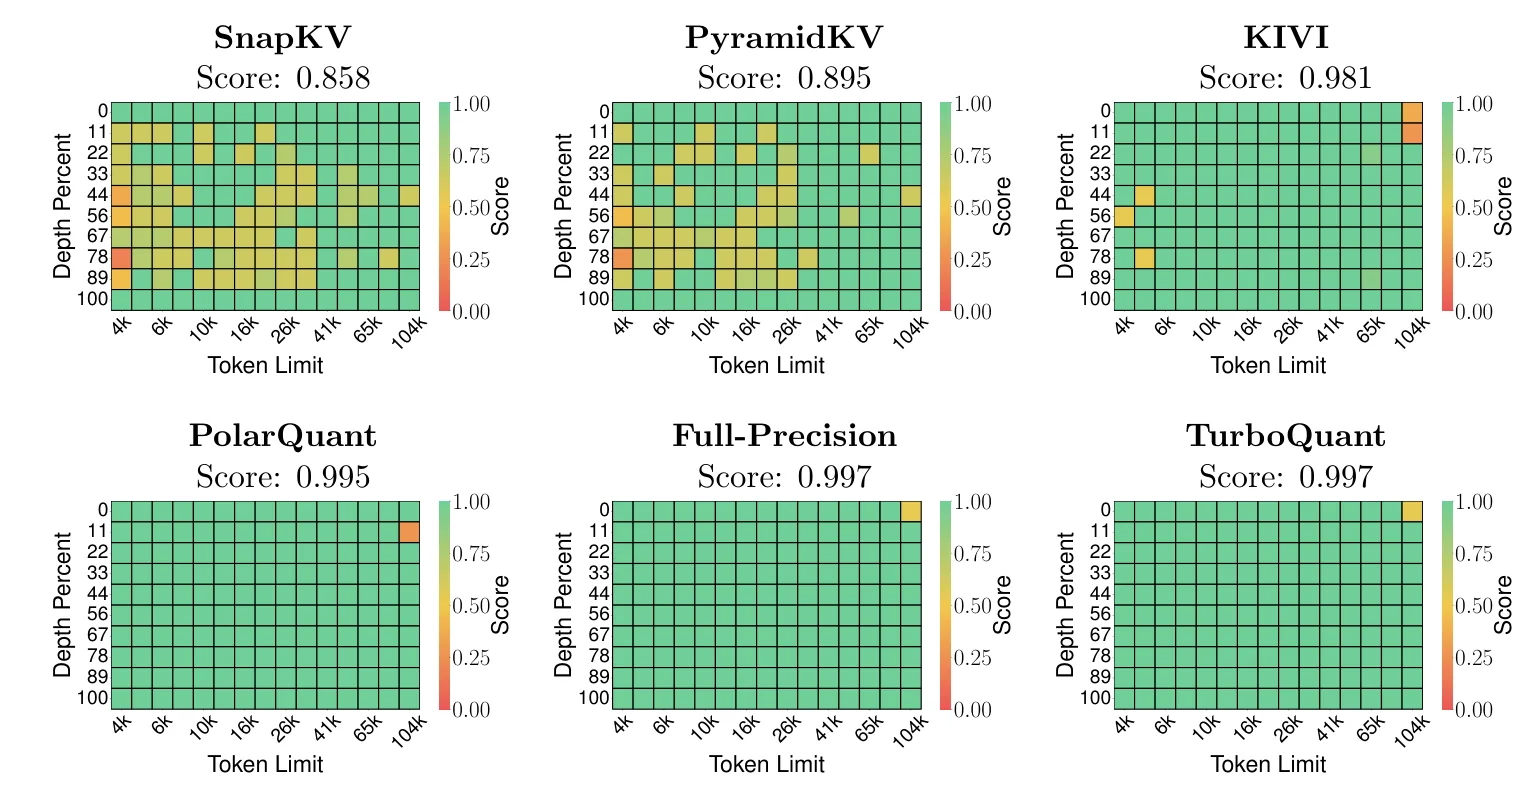
图源:同论文图 4。六种方案依次为 SnapKV、PyramidKV、KIVI、PolarQuant、全精度与 TurboQuant,标题中的 Score 是整体召回分。TurboQuant 的 0.997 与全精度一致,高于同属量化路线的 PolarQuant(0.995)和 KIVI(0.981);token 级压缩的 SnapKV(0.858)与 PyramidKV(0.895)明显更低。
这张图解释了一个工程经验:论文把“有理论保证的量化”和“token 级压缩”区分开,前者在 4× 压缩下几乎不掉点,后者在长上下文里召回不稳定。它对应本文前面的误差分析——K 的量化误差受理论码本约束,而按 token 丢弃 KV 直接损失信息。但要注意这是论文自己的实验设置(压缩比 0.25、通用 KV 量化),vLLM 里按 preset 跑到 3 到 5 bit/元素时,PPL 的增幅来自文档里给出的实测,两者不能直接换算。
局限与未解决的问题
- 码本假设的脆弱性:高斯近似在大多数模型上成立,但对维度很小(比如 )、或者 K 有明显离群坐标的模型,Lloyd-Max 的误差会比理论值高。源码没有逐层检测分布,只能靠首尾层保护兜底。
- 不支持 MLA / 滑动窗口 / sink 的最优路径:FlyDSL 对 sink 和滑动窗口不适用;SoA decode 对有 sink 的层会退回 AoS。这些层仍然是正确的(语义等价),只是没走到最快的 kernel。
3bit_nc的 V 量化:3-bit V 的 scale/zero 只有 8 个电平,输出质量损失明显;如果后续能引入 V 的码本量化,或者更精细的分组 scale,这个档位可能会变得实用。- 首尾层跳过与页大小的冲突:packed 层和 skip 层混用时,整页按标准页大小分配,浪费一部分显存。跳过层越多,压缩比越接近标准 FP16。
- 多路径维护成本:AoS、SoA、FlyDSL 三套 kernel 加两套 store,任何布局改动都要同步三处;源码里注释与实现不同步(比如 docstring 里的 612 字节布局)就是这种成本的体现。
小结
TurboQuant 在 vLLM 里的实现可以概括为四层:
- 算法层:Hadamard 旋转把任意方向的 K 变成每个坐标近似 的向量,再用一个与数据无关的 Lloyd-Max 码本做逐坐标标量量化;V 则用整条向量的 min/max 均匀量化。旋转保证了 的近似在正交变换下“换基不换值”。
- 存储层:K 和 V 合并成定长 slot,K 存索引 + 一个 fp16 范数,V 存索引 + fp16 scale/zero。AoS 默认布局简洁,SoA 可选布局把元数据集中,降低 decode 的 gather 开销;norm correction 把质心向量的范数折叠进写入端。
- 内核层:写入用一个融合 kernel 完成二分、打包、V 量化和缓存写入;读取用 split-KV 两阶段 kernel,在 tile 内解包、查表、点积、在线 softmax,stage 2 合并部分和。prefill 走 FlashAttention 快速路径,续写 prefill 在小 chunk 时复用 decode、大 chunk 时反量化。
- 引擎层:
--kv-cache-dtype的四个预设驱动缓存规格、层跳过、后端选择和 FlashAttention 版本;首尾层保留原生 dtype,混合模型自动识别全注意力层;CUDA Graph、workspace 预分配和页大小统一都是为了让这套 packed 格式在真实服务里稳定运行。
如果只看一个指标,这四档方案的取舍是清晰的:4bit_nc 是精度与压缩的平衡点,k3v4_nc 开始进入“质量换显存”的区间,3bit_nc 是极限档。KV 量化的真正难点从来不是打包和解包,而是“3-bit 的 K 进入 softmax 后误差被放大”这一物理事实;TurboQuant 用旋转、最优码本和范数修正把误差尽量压小,再用首尾层保护兜住最后的余量。
参考资料
- TurboQuant: Online Vector Quantization with Near-optimal Distortion Rate(Zandieh et al., arXiv:2504.19874)
- vLLM 源码:TurboQuant 配置与预设(
vllm/model_executor/layers/quantization/turboquant/config.py) - vLLM 源码:Lloyd-Max 码本求解(
turboquant/centroids.py) - vLLM 源码:TurboQuant 注意力后端(
vllm/v1/attention/backends/turboquant_attn.py) - vLLM 源码:融合 store kernel(
vllm/v1/attention/ops/triton_turboquant_store.py) - vLLM 源码:split-KV decode kernel(
vllm/v1/attention/ops/triton_turboquant_decode.py) - vLLM 源码:SoA 布局 store kernel
- vLLM TurboQuant 单元测试(
tests/quantization/test_turboquant.py) - vLLM 量化 KV Cache 文档
- Pushing the Limits of Large Language Model Quantization via the Linearity Theorem(HIGGS,Malinovskii et al., NAACL 2025)
- Cache Me If You Must: Adaptive Key-Value Quantization for Large Language Models(Shutova et al., arXiv:2501.19392)
- TurboQuant PyTorch 社区复现与 QJL 消融(tonbistudio/turboquant-pytorch)
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



