


llama.cpp 源码完全拆解(十三):ggml-cpu 的一次 mul_mat——量化点积、任务切分与线程池如何榨干 CPU
为什么还要看 CPU 后端
llama.cpp 从 2023 年起就有一个容易被忽略的定位:它首先是一个 CPU 推理框架,GPU 只是它众多后端中的一个。在个人电脑、边缘盒子、没有独显的服务器上,模型能够跑起来的唯一依靠就是 ggml-cpu 这一套代码:量化权重的内存布局、SIMD 点积内核、多线程任务切分,全部围绕「用有限的内存带宽喂饱所有核心」这件事设计。
前面几篇已经把这个框架的外围讲完了:整体架构、ggml 图与内存分配器、GGUF 装载、上下文与 KV Cache、采样、图构建、后端与 kernel 总览、服务化调度、投机解码、多模态、嵌入与模板。这一篇回到最底层,只回答一个问题:
一次
mul_mat(矩阵乘,推理里出现频率最高的算子)在 CPU 上究竟被执行成了什么?
沿着这条路径,会依次遇到四层机制:量化块的内存布局、整数点积内核、mul_mat 内的任务切分、以及线程池的同步协议。四层是嵌套关系,任何一层的设计都会改变另外三层的写法。
先把账算清楚:CPU 推理的瓶颈在哪里
在拆代码之前,需要先建立一个数量级直觉,否则无法理解后面那些设计为什么值得。
自回归解码阶段,每生成一个 token,模型要把它经过的每一层权重完整读一遍。以 70B 参数、4-bit 量化为例,权重体积约 40 GB(加上 scale、量化元数据与部分未量化的层,实际略多)。解码时 batch 通常只有 1,每生成一个 token 就要把这 40 GB 从内存搬到 CPU 的寄存器里,再算一次乘加。
于是解码的耗时下限由内存带宽决定:
其中 是每 token 需要读取的权重字节数, 是实际可达的内存带宽。一台双通道 DDR5-5600 的机器理论带宽约 89.6 GB/s,实测流式读取通常落在 60–75 GB/s;按 70 GB/s 算,40 GB 权重对应的时间下限是:
也就是每秒不到 2 个 token。这个数字和很多人在纯 CPU 上跑 70B 的实测体验一致,说明解码阶段是彻底的 memory-bound:算力再翻几倍也没用,唯一有效的优化是减少要读的字节数(更低比特量化)或者提高带宽利用率(更好的访存布局、更多通道、把权重留在缓存里)。
再看预填充阶段。一次处理 个 token,权重读一遍就能被 个 token 复用,算术强度随 线性上升。此时瓶颈从带宽转向算力,SIMD 宽度、指令吞吐、量化点积的指令数成为关键。
这就解释了两件事:
- llama.cpp 的量化格式必须紧凑,4-bit 甚至更低比特是主流,因为字节数直接就是解码时间;
- 量化点积内核必须在不增加额外内存流量的前提下完成解包与乘加,否则带宽省的字节又被额外的指令开销吃回去。
后面的所有设计——超级块、6-bit 二级 scale、Q8_0 激活量化、按行切任务——都可以从这两条约束推导出来。
权重在内存里到底是什么样:量化块的位级布局
要看懂点积内核,先得知道它读进来的字节是什么。llama.cpp 的量化不是「每个元素存 4 bit」这么简单,而是按固定大小的块(block)组织:每块共享一个或几个缩放系数,块内元素共享同一套解包规则。
最基础的两块:Q4_0 与 Q8_0
ggml-common.h 里 Q4_0 的定义只有两行:
#define QK4_0 32typedef struct { ggml_half d; // delta uint8_t qs[QK4_0 / 2]; // nibbles / 32 个 4-bit 值压进 16 字节} block_q4_0;一个块覆盖 32 个权重,占 字节,折合 bit/权重。注意这里没有「4.5 位」的玄机:4 bit 是量化值本身,多出来的 0.5 bit 是那个 FP16 的块缩放 。
解量化公式是:
其中 由块内绝对值最大的那个带符号权重 决定:(Q4_0 把 4-bit 值当作有偏码,减去 8 变成 ), 是 4-bit 整数。负号让 与 反号,从而使 的符号与原始权重一致。同一个块内所有元素共用一个 ,这是整个方案的关键取舍:块越小, 越贴合局部数值范围、量化误差越小,但元数据占比越高;块越大,压缩率越高,误差越大。
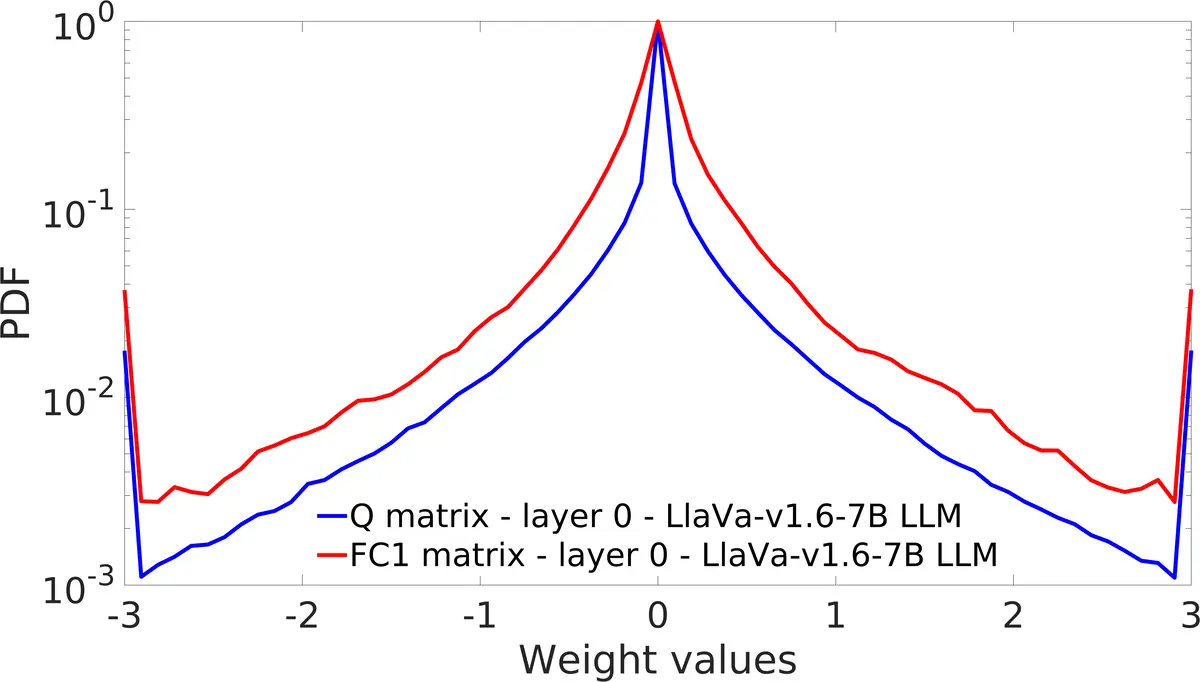
上图来自 QuantX 论文的 Figure 1:图 (a) 对比同一层里自注意力 矩阵与 MLP 第一层的权重分布,图 (b) 对比同一层、不同模型的 矩阵分布。分布的形状、宽度、长尾在不同层与不同模块之间差异明显:有的接近高斯,有的拖出长尾,有的明显偏向一侧。这直接解释了为什么「整个张量一个 scale」不可行,也解释了为什么 K-quant 要在 256 元素的超级块内部再切出 8 个子块、并给每个子块单独的 scale 与 min——局部统计量必须跟得上分布的局部变化。
Q8_0 是给激活用的对称量化:
#define QK8_0 32typedef struct { ggml_half d; int8_t qs[QK8_0];} block_q8_0;32 个元素直接存成 32 个 int8,加一个 FP16 scale,合计 34 字节,8.5 bit/元素。它只在计算过程中存在,不写进模型文件。
K-quant:为什么需要超级块
Q4_0 的 32 元素块有两个问题。第一,4-bit 的表示范围太窄,遇到权重分布有明显长尾时,一个块内的小值会被大值「挤」掉。第二,每个块一个 FP16 scale,在 2-bit、3-bit 这种更低比特下,元数据占比会迅速失控:2-bit、32 元素块如果还带 FP16 scale,就是 字节,折合 2.5 bit/权重,压缩率被元数据吃掉一大截。
K-quant 的解法是两层缩放:超级块(super-block)覆盖 256 个元素,持有一对 FP16 的全局缩放 与全局最小值 ;超级块内部再切成 8 个 32 元素的子块,每个子块有自己的 6-bit 缩放 和 6-bit 最小值 。以 Q4_K 为例:
#define QK_K 256#define K_SCALE_SIZE 12typedef struct { ggml_half d; // 超级块缩放 ggml_half dmin; // 超级块最小值的缩放 uint8_t scales[K_SCALE_SIZE]; // 8 个 scale + 8 个 min,各 6 bit uint8_t qs[QK_K/2]; // 256 个 4-bit 值} block_q4_K;解量化公式变成:
是元素所属的子块编号,。与 Q4_0 相比,多出来的 是非对称量化的下界偏移:每个子块可以有自己的最小值,不必假设分布关于零点对称。对 Transformer 的权重来说这很重要——很多投影层的权重分布明显偏向一侧,强行对称量化会浪费一半的动态范围。
体积账: 字节覆盖 256 个元素,等于 144 字节,折合 4.5 bit/权重。和 Q4_0 一样是 4.5 bpw,但量化粒度从 32 元素细化到「32 元素一套 scale+min,再叠加 256 元素一套全局缩放」,精度更好,体积不变。这就是 K-quant 在 4-bit 档位成为默认选择的根本原因。
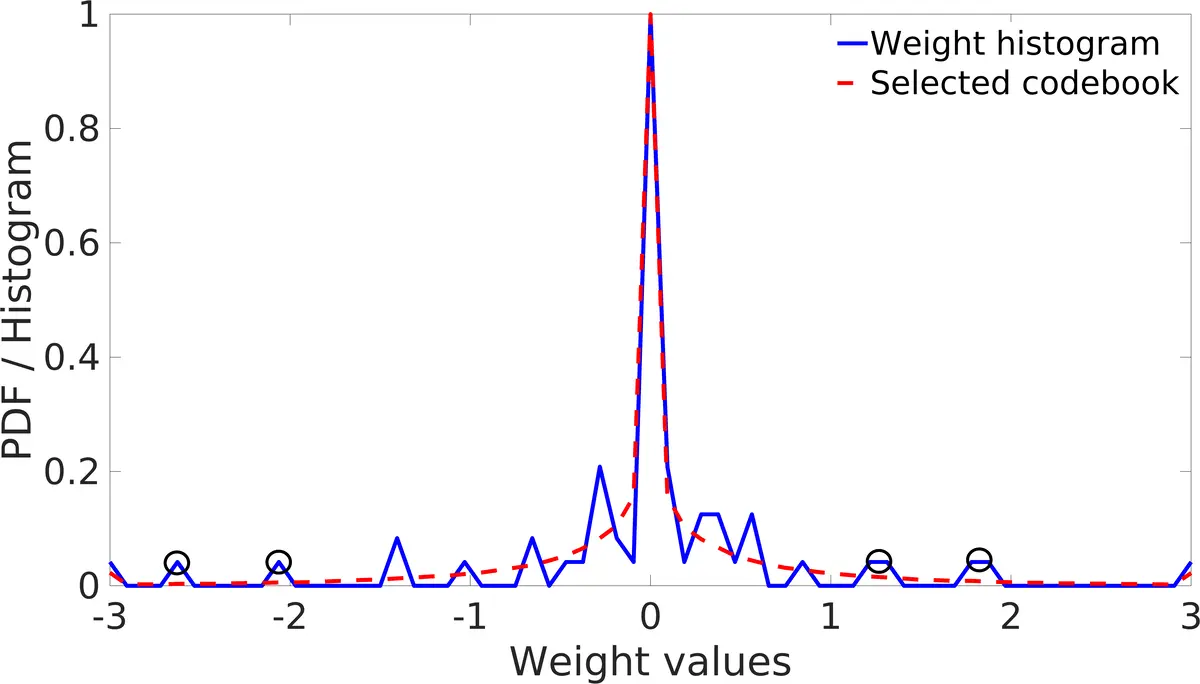
上图取自 QuantX 论文(arXiv:2505.07531,2025 年)。左侧是 Q4X 的直方图学习流程,右侧对比了同一组权重在 Q4_0、Q4K 与 Q4X 下的量化矩阵形态。图中能直接看到 Q4K 与 Q4_0 的差别不在「每个数存几位」,而在分组结构与共享参数的排布:Q4K 的块更大、块内又分小组,小组参数被压在块头里。这正是下一节点积内核要解包的东西。QuantX 的作者把该方案接进了 llama.cpp,所以这张图描述的就是本站讨论的这套格式族。
6-bit 参数是怎么塞进 12 字节的
8 个 scale 加 8 个 min,每个 6 bit,一共 bit,正好 12 字节。听起来很紧凑,代价是解包时要跨字节拼接。
打包侧的逻辑在 quantize_row_q4_K_ref 里:前 4 个子块的 scale 直接占 scales[0..3] 的低 6 位,前 4 个 min 占 scales[4..7] 的低 6 位;后 4 个子块的 scale 与 min 各取低 4 位,拼进 scales[j+4] 的高、低半字节,剩下的高 2 位分别塞回 scales[j-4] 与 scales[j] 的最高两位。读的时候必须把这 2 位从「别人的字节」里捞回来:
static inline void get_scale_min_k4(int j, const uint8_t * q, uint8_t * d, uint8_t * m) { if (j < 4) { *d = q[j] & 63; *m = q[j + 4] & 63; } else { *d = (q[j+4] & 0xF) | ((q[j-4] >> 6) << 4); *m = (q[j+4] >> 4) | ((q[j-0] >> 6) << 4); }}j < 4 时直接掩低 6 位;j >= 4 时取第 j+4 字节的低 4 位作为低半部,再把第 j-4 字节的最高 2 位左移 4 位补成高 2 位。这是「用别处的 2 个空闲位存本值的剩余位」的经典位打包,省下 4 字节,代价是每次解包多两次移位和掩码。
内核里的通用实现(quants.c 的 ggml_vec_dot_q4_K_q8_K_generic)为了减少逐字节判断,干脆用三个掩码一次性把 12 字节拆成 4 个 uint32:
static const uint32_t kmask1 = 0x3f3f3f3f; // 每字节低 6 位static const uint32_t kmask2 = 0x0f0f0f0f; // 每字节低 4 位static const uint32_t kmask3 = 0x03030303; // 每字节低 2 位utmp[3] = ((utmp[2] >> 4) & kmask2) | (((utmp[1] >> 6) & kmask3) << 4); 这一行就是「把两个来源的半字节拼成一个字节」。四个 uint32 装下 8 个 scale 和 8 个 min,后面按字节取用即可。这种写法的目的不是炫技,而是把 16 次逐字节判断压成 4 组 32 位掩码运算;在 AVX2 版本里,同样的拆包结果会被直接 cvtepu8_epi16 扩展成 16 位的 scale 向量,供后面的整数乘加使用。
更低的比特:Q6_K 与 Q2_K 的取舍
同一套超级块结构下,不同比特宽度的布局差异很大:
- Q6_K:
ql[128]存低 4 位,qh[64]存高 2 位,scales[16]是 16 个 int8(每个 8 bit,不用再打包),再加 FP16 的 。合计 字节 / 256 元素 = 6.5625 bpw。6-bit 值直接做有符号整数,没有 min 偏移:,。没有 min 项意味着它的点积内核不需要bsums,少一条归约路径;代价是每组只有 16 个元素、scales用满 8 bit,元数据比 Q4_K 更贵。 - Q2_K:256 个 2-bit 值只占 64 字节,但子块缩放到 16 个、每个 4 bit,另有 FP16 的 与 ,合计 84 字节 / 256 = 2.625 bpw。它在极低比特下靠「更多子块 + 非对称 min」勉强维持精度,代价是解包路径更复杂。
- Q8_K:只用于中间结果,
float d、int8_t qs[256]、int16_t bsums[16],合计 292 字节 / 256 = 9.125 bpw。那个bsums不是给解量化用的,而是给点积内核省一次求和,后面会看到它为什么值这 32 字节。
从 Q4_0 到 Q4_K 的变化可以总结成一句话:在总比特数不变的前提下,把「一个块一套参数」换成「两层块、两套参数」,用更细的量化粒度换精度,同时把参数压进 6 bit 以控制元数据开销。这个结构直接决定了点积内核长什么样。
点积内核:不反量化也能算出正确结果
为什么不能先反量化再乘
最直观的写法是:把 Q4_K 块解成 256 个 float,把 Q8_K 的激活也解成 float,然后做 256 次乘加。这条路径在两个地方吃亏。
第一是内存流量。解码阶段已经证明了瓶颈在带宽,如果每读 144 字节的量化权重就要在寄存器或栈上展开成 字节的 float,那么中间过程虽然不落内存,但会占满向量寄存器,破坏流水线,而且解量化的指令数远远超过乘加本身。
第二是精度与指令宽度。CPU 的 SIMD 向量对 int8 有专门的乘加指令:x86 的 pmaddubsw(无符号乘有符号、相邻两两求和成 int16)、pmaddwd(int16 两两相乘求和成 int32);ARM 的 NEON 有 sdot(4 个 int8 点积累加到 int32)。直接用整数算 4-bit × 8-bit 的点积,一条指令顶掉一串浮点乘加。
于是 llama.cpp 的写法是:权重不反量化,激活先量化成 int8,点积在整数域完成,最后再把缩放系数乘回去。这是量化推理里一个普适的套路,「整数量化点积」这一名称本身不够直观,本质是「把缩放系数提到求和号外面」。
正确性:缩放系数可以提到求和号外面
设权重块内解量化是 ,激活是 ( 为 int8)。块内点积为:
右边两项各自只剩一个整数点积和一个整数和,缩放系数全是常数。这就是整数量积的正确性来源:只要块内的 scale 和 min 是常数,它们就可以在求和完成后一次性乘上去。
第二项 看上去要单独求一次和,其实不需要——block_q8_K 里的 bsums[16] 已经在量化激活时算好了每 16 个元素的和(quantize_row_q8_K_ref 的尾部循环),内核只需要把这 16 个 int16 与对应的 min 相乘再相加。代价是激活块多 32 字节,收益是每个权重块少一次 256 元素的求和。解码时权重是批量读取、激活只有一两行,这笔账明显划算。
还要注意 Q4_K 的 nibble 打包方式。quantize_row_q4_K_ref 在写 qs 时是:
for (int j = 0; j < QK_K; j += 64) { for (int l = 0; l < 32; ++l) q[l] = L[j + l] | (L[j + l + 32] << 4); q += 32;}第 j..j+31 个元素的低半字节与第 j+32..j+63 个元素拼进同一批字节。也就是说每个 32 字节的向量里,低半部对应子块 、高半部对应子块 ,正好与「32 元素一个子块、每块一套 scale」的排布对齐。解包时用 & 0xF 取低半部、>> 4 取高半部,再分别配上面 32 个元素与后面 32 个元素的 scale。
通用实现:先看没有 SIMD 的版本
quants.c 里的 ggml_vec_dot_q4_K_q8_K_generic 是理解所有 SIMD 版本的地基。它的主循环体如下:
for (int j = 0; j < QK_K/64; ++j) { const uint8_t * q4 = x[i].qs + 32*j; for (int l = 0; l < 32; ++l) a[l] = (int8_t)(q4[l] & 0xF); for (int l = 0; l < 32; ++l) a[32 + l] = (int8_t)(q4[l] >> 4); ... a = aux8; for (int j = 0; j < QK_K/32; ++j) { // 8 个子块 int32_t scale = scales[is++]; for (int l = 0; l < 8; ++l) aux16[l] = q8[l] * a[l]; for (int l = 0; l < 8; ++l) aux32[l] += scale * aux16[l]; // ... 同样的 8 元素片段重复 4 次 }}三个关键点:
- 解包只做移位和掩码,没有任何浮点;
- 乘积先用 int16 暂存(
aux16),再乘 scale 累加进 int32(aux32)——scale 是 6-bit 的整数,乘上乘积后有可能超出 int16,因此必须用 32 位累积; - 最后的
d * aux32才进入浮点,一个块只做一次 FP32 乘加。
这里的步长是 8 个元素一组,而不是 32。原因在于通用版本没有 SIMD,编译器自动向量化时会按 int16 向量的自然宽度(AVX2 为 16 个 int16,SSE 为 8 个 int16)组织,写 8 是两边都不吃亏的折中。
手算一个子块:整数路径到底省了什么
拿一个具体例子走一遍,能把上面所有符号落到实处。设某个 32 元素子块的参数为:
- 超级块 ,;
- 该子块 ,;
- 该子块所有量化值 ;
- 对应的激活块 ,所有 。
先走「反量化再乘」的路径:每个权重 ,每个激活 ,32 个元素的点积是 。
再走整数路径:
第一项是 ,第二项是 ,相减得 ,与逐元素计算完全一致。
差别在指令数:逐元素路径要做 32 次解量化(每次一次乘、一次减)、32 次浮点乘、31 次浮点加,再加一次块级缩放;整数路径只做 32 次整数乘加(在 AVX2 上,32 个元素对应 1 条 maddubs + 1 条 maddwd)、一次 16 组 bsums 与 min 的乘加、两次块级浮点乘和一次相减。同样的算术结果,浮点运算次数从近百次降到个位数。这就是为什么量化推理能在 CPU 上跑得动:不是把浮点乘加变快了,而是把它们大部分换成了整数指令。
AVX2 版本:三条指令算完 32 元素
x86 的 AVX2 版本(arch/x86/quants.c)把上面的逻辑翻译成向量操作:
const __m256i m4 = _mm256_set1_epi8(0xF);__m256i sumi = _mm256_setzero_si256();
for (int j = 0; j < QK_K/64; ++j) { const __m256i q4bits = _mm256_loadu_si256((const __m256i*)q4); q4 += 32; const __m256i q4l = _mm256_and_si256(q4bits, m4); const __m256i q4h = _mm256_and_si256(_mm256_srli_epi16(q4bits, 4), m4);
const __m256i q8l = _mm256_loadu_si256((const __m256i*)q8); q8 += 32; __m256i p16l = _mm256_maddubs_epi16(q4l, q8l); p16l = _mm256_madd_epi16(scale_l, p16l);
const __m256i q8h = _mm256_loadu_si256((const __m256i*)q8); q8 += 32; __m256i p16h = _mm256_maddubs_epi16(q4h, q8h); p16h = _mm256_madd_epi16(scale_h, p16h); sumi = _mm256_add_epi32(sumi, _mm256_add_epi32(p16l, p16h));}逐条解释:
_mm256_and_si256(q4bits, m4):32 个字节一次拿到 32 个低半字节;_mm256_srli_epi16(q4bits, 4) & 0xF:按 16 位向右移 4 位再掩码,得到高半字节。注意必须用 16 位移位而不是 8 位,x86 没有针对 256 位向量的逐字节移位,16 位右移会让相邻字节的高位混入低位字节的高半部,但紧接着的& 0xF把这些混入的 4 位抹掉了——先污染再清洗是 4-bit 解包的标准技巧;_mm256_maddubs_epi16(q4l, q8l):把无符号 8 位与有符号 8 位相乘,相邻两个乘积求和成为 int16。一次处理 32 对元素,得到 16 个 int16;_mm256_madd_epi16(scale_l, p16l):再把 16 个 int16 与对应 scale 相乘后两两求和成 8 个 int32。
于是每个 64 元素的 j 迭代只需要 2 次加载 q4 字节、4 次加载 q8、2 次 maddubs、2 次 maddwd、若干次移位和掩码,就把 64 个元素的点积(含 scale)算完并累加进 sumi。相比通用版本的标量循环,指令数差了一个数量级以上。
scale 的广播也用了同样的思路:先把 16 个子块参数扩展成 16 位,再用 _mm256_shuffle_epi8 配合预定义的 shuffle 表,把子块 的 scale 复制成 32 字节的向量,使其与 q4l 的 32 个字节一一对应:
const __m256i scales = MM256_SET_M128I(sc128, sc128); // 16 个 int16 scaleconst __m256i scale_l = _mm256_shuffle_epi8(scales, get_scale_shuffle_k4(2*j+0));const __m256i scale_h = _mm256_shuffle_epi8(scales, get_scale_shuffle_k4(2*j+1));get_scale_shuffle_k4 是一张编译期常量表,内容就是「低半字节对应哪个子块、高半字节对应哪个子块」的索引。这一步把「解包 → 找 scale → 配对」这三件事压进两条指令。
min 项与最终归约
上文的例子只处理了 scale 项。min 项走另一条路径,因为要乘的是 bsums 而不是逐元素值:
const __m256i q8sums = _mm256_loadu_si256((const __m256i*)y[i].bsums);const __m128i q8s = _mm_hadd_epi16(_mm256_extracti128_si256(q8sums, 0), _mm256_extracti128_si256(q8sums, 1));const __m128i prod = _mm_madd_epi16(_mm256_extracti128_si256(mins_and_scales, 1), q8s);acc_m = _mm_fmadd_ps(_mm_set1_ps(dmin), _mm_cvtepi32_ps(prod), acc_m);bsums 是 16 组、每组 16 个元素的整数和;mins 是 8 个子块的最小值(每 32 元素一套)。16 组和 8 个子块不是一一对应,所以这里先用 hadd 把相邻两组相加,凑成 8 个与子块对齐的值,再做 int16 乘加。最后与 相乘累加——注意 dmin 在这段代码里取了负号(-y[i].d * FP16(dmin)),于是最终结果直接做加法,省一次减法。
块末的缩放因子 d = y[i].d * FP16(x[i].d) 只出现一次:
__m256 vd = _mm256_set1_ps(d);acc = _mm256_fmadd_ps(vd, _mm256_cvtepi32_ps(sumi), acc);cvtepi32_ps 把 8 个 int32 转成 float,一次 FMA 完成缩放与累加。从整数域回到浮点域只发生在这一行,这正是「提出求和号」的价值:256 个元素的块,浮点运算次数从 256 次乘减降到 8 次 FMA。
hsum_float_8(acc) 把 8 个 float 归约成一个标量返回。对 mul_mat 调用方来说,vec_dot 的签名固定为「给定两个块指针,返回一个 float」,所以横向归约无法避免;它的开销由调用频率决定——每个「权重行 × 激活行」对都要做一次。这就是后面 mul_mat 要按 的小块组织循环的原因之一:把多个 vec_dot 的结果集中在一个栈数组里,让归约后的写回次数可控。
其他 ISA 的同一件事
- ARM NEON:4-bit 解包靠
vandq_u8与vshrq_n_u8(NEON 有真正的逐字节右移,比 x86 那条路径更直接),点积用vmull_s8成对相乘再vpadalq_s16累加;ARMv8.2 有sdot指令后,可以直接用vdotq_s32一次完成 4 个 int8 的乘加。 - AVX512 与 VNNI:
vpdpbusd把「无符号 8 位 × 有符号 8 位 → int32 累加」再合并一步,一次处理 64 个元素,是 AVX2 指令数的两倍压缩。 - ARM 的 MATMUL_INT8(i8mm):这一特性让
nrows变成 2——一次vec_dot可以同时处理两行权重与两列激活,产出 4 个点积结果。这正是后面num_rows_per_vec_dot存在的来源。
同一个 type_traits_cpu[type].vec_dot 函数指针,在所有 ISA 上都是「给定块指针、返回 float」的同一份契约,差异全部被编译期宏消化。这种设计的工程意义是:mul_mat 不需要知道底层用了什么指令,只需要知道一个点积要处理几行。
mul_mat:一次矩阵乘被切成什么样
vec_dot 只是最内层的「一个块对一个块」。真正跑的算子是在 ggml_compute_forward_mul_mat 里组织的矩阵乘:权重 src0 是 的量化矩阵(每行 个元素、共 行),激活 src1 是 的矩阵( 个 token),输出是 。解码时 ,预填充时 可能是几百上千。
第一步:激活得先变成 Q8_K
vec_dot 的签名已经暗示了这一点:Q4_K 的 vec_dot_type 是 GGML_TYPE_Q8_K。代码里先检查:
if (src1->type != vec_dot_type) { char * wdata = params->wdata; // 计划阶段分配好的工作缓冲 ... for (int64_t i11 = 0; i11 < ne11; ++i11) { int64_t ne10_block_start = (ith * ne10/bs) / nth; int64_t ne10_block_end = ((ith + 1) * ne10/bs) / nth; from_float(src1_row, wdata_row, ne10_block_size); }}三个细节值得展开:
- 工作缓冲
wdata不在算子内部分配,它来自cplan->work_data,由规划阶段根据每个节点的work_size一次性算好。原因是多线程下每个线程都要往同一块缓冲的不同行写数据,必须提前约定好地址; - 量化按块切分给线程:第
ith个线程负责ne10/bs个块中的一段。块边界天然对齐(ne10必为块大小 256 的整数倍),所以线程之间的切分不会破坏块; - F16/BF16 的激活不做量化,而是加宽成 F32。此时
vec_dot_type是GGML_TYPE_F32,ggml_cpu_fp16_to_fp32逐行转换。也就是说,量化权重与半精度激活的混合精度乘也是支持的,只是走的是另一条点积路径。
转换完成后,所有线程在 ggml_barrier 处集合——后续所有线程都要读完整的激活缓冲,必须等最后一个线程写完。
第二步:决定把工作切成什么样
const int64_t nr0 = ne0; // 输出行数(= 权重行数 N)const int64_t nr1 = ne1 * ne2 * ne3; // 输出列数(= 激活行数 M,含 batch 维)
int chunk_size = 16;if (nr0 == 1 || nr1 == 1) chunk_size = 64;
int64_t nchunk0 = (nr0 + chunk_size - 1) / chunk_size;int64_t nchunk1 = (nr1 + chunk_size - 1) / chunk_size;
if (nchunk0 * nchunk1 < nth * 4 || ggml_is_numa()) { nchunk0 = nr0 > nr1 ? nth : 1; nchunk1 = nr0 > nr1 ? 1 : nth;}参数的含义:
chunk_size = 16是「每个任务块至少 16 行」,保证一个任务里至少有 次vec_dot,摊薄任务派发和归约的开销;nr0 == 1 || nr1 == 1时放大到 64:解码阶段 ,如果还按 16 行切,任务数会变成 ,在 很大但没有多少线程可用的机器上反而增加调度开销。放大到 64 让每个任务干得更久;- 兜底条件
nchunk0 * nchunk1 < nth * 4:如果按 16 切出来的任务块总数还不到线程数的 4 倍,就放弃二维切分,直接沿长边一维切成nth份。注释里明确写了这个分支在 NUMA 系统上实测更快(llama.cpp PR #6915)。「每个线程只碰自己那份内存」对 NUMA 来说比细粒度负载均衡更重要,因为跨节点访问内存的代价远超轻微的不均衡。
最后计算每个任务块的跨度 dr0、dr1,然后用一个共享计数器派发:
int current_chunk = ith; // 每个线程从自己的编号开始,省掉第一次协调while (current_chunk < nchunk0 * nchunk1) { ... 计算 ir0_start/end、ir1_start/end,调用 one_chunk ... if (nth >= nchunk0 * nchunk1) break; current_chunk = atomic_fetch_add_explicit(&tp->current_chunk, 1, memory_order_relaxed);}ith == 0 的线程在进入循环前把计数器重置为 nth 并做一个 barrier,之后每个线程先把 current_chunk = ith 作为自己的第一块,不会所有线程一上来都抢同一块。之后再由原子加法动态领取。这就是工作窃取的极简版:没有队列,只有一个原子计数器,任务块太大时就退化成静态划分。
第三步:任务块内部的两层小循环
ggml_compute_forward_mul_mat_one_chunk 里还有一层 的细分:
const int64_t blck_0 = 16;const int64_t blck_1 = 16;float tmp[32];
for (iir1 in ir1_start..ir1_end step 16) for (iir0 in ir0_start..ir0_end step 16) for (ir1 in iir1..iir1+16 step num_rows_per_vec_dot) { ... 找到 src0 行指针 src0_row、src1 列指针 src1_col ... for (ir0 in iir0..iir0+16 step num_rows_per_vec_dot) vec_dot(ne00, &tmp[ir0 - iir0], ..., src0_row + ir0*nb01, ..., src1_col, ..., num_rows_per_vec_dot); for (cn = 0; cn < num_rows_per_vec_dot; ++cn) memcpy(&dst_col[iir0 + cn * nb1/nb0], tmp + cn*16, (MIN(iir0+16, ir0_end) - iir0) * sizeof(float)); }为什么是 :
tmp[32]装得下 16 个结果(nrows = 2时是两行共 32 个),所以一组行 × 一组列的结果可以先落在栈上,再一次性memcpy回输出矩阵。注释说这是为了减少 false sharing,但实测「看起来没有差别」——真正起作用的是把 16 个独立的横向归约集中在一起,让归约结果写入输出时是连续的 16 个 float;- 的块里,同一条
src0_row会被 16 列复用,同一条src1_col会被 16 行复用。权重行被读 16 次时,若这一行几十 KB 的字节能留在 L1/L2 里,实际内存流量就只算一次; 的粒度就是在这个「留得住」与「切得更细能更好均衡」之间取的折中。这是矩阵乘标准的寄存器分块思路,只不过分块粒度小、块在 L1 里就能装下; num_rows_per_vec_dot的检查逻辑:输出行数、激活行数或任一任务块跨度是奇数时,退回 1。原因是 mmla 型内核一次处理两行两列,无法在奇数边界处对齐。
dst_col 的寻址 &dst_col[iir0 + cn * nb1/nb0] 需要解释一下:输出张量的第 0 维(行)/第 1 维(列)步长分别是 nb0、nb1,而写入的单位是 float,所以「往后跳 cn 列」等价于往后跳 cn * nb1 / nb0 个 float。当 nb1 == nb0 时,这等价于跳到下一个行向量。
为什么每个任务都要重新量化激活
一个容易误解的点是:from_float 转换放在 ggml_compute_forward_mul_mat 里,而不是在每个任务块里。也就是说,一次算子调用只量化一遍激活,所有任务块共享同一份 wdata。这是正确的——但如果一张图里有多个 mul_mat 使用同一份激活(例如共享输入的 Q、K、V 三个投影),每个 mul_mat 都会各自量化一遍。llama.cpp 后来引入的融合路径正是针对这类重复工作,不过那属于图优化范畴,本篇不展开。
线程池:每个节点之间的一次全同步
mul_mat 已经算完了,但它是被谁调用的、在什么同步框架里跑的?这一层在 ggml-cpu.c 的线程池与 ggml_graph_compute_thread 里。理解它,才能理解为什么 CPU 推理的并行效率常常卡在 60%–80%,而 GPU 上同样的矩阵乘可以跑到 90% 以上。
下文讨论的是 GGML_USE_OPENMP 未定义时的自建线程池路径。若编译期启用了 OpenMP,图计算被包在一个 #pragma omp parallel 区域里,节点间的同步换成 #pragma omp barrier,ngraph/current_chunk 的用法与本节描述基本一致,区别主要在线程生命周期与自旋策略。
一个池子长什么样
struct ggml_threadpool { ggml_mutex_t mutex; ggml_cond_t cond;
struct ggml_cgraph * cgraph; struct ggml_cplan * cplan;
atomic_int n_graph; // 高 16 位:graph 编号;低 16 位:参与线程数 atomic_int n_barrier; atomic_int n_barrier_passed; atomic_int current_chunk; // mul_mat 的动态任务计数器
atomic_bool stop; atomic_bool pause; atomic_int abort;
struct ggml_compute_state * workers; int n_threads; int32_t prio; uint32_t poll; // 0 表示不忙等,1–100 表示自旋轮数系数 enum ggml_status ec;};几个字段的设计意图:
n_graph同时装两样东西。低 16 位是本次图参与计算的线程数(上限 65535,远超实际核心数),高 16 位是图的序号。这样 worker 只要读一个原子量,就能判断「有没有新图」「我是否被这次调用选中」。把两个状态塞进一个原子量,是为了让一次seq_cst写入同时发布两份信息,避免两个原子量之间的排序问题。current_chunk独立存在,因为它只在mul_mat内部使用,不能和 graph 序号混在一起——mul_mat结束时它可能停在任意值,而n_graph必须严格递增。poll是自旋预算。worker 在休眠前先自旋1024 × 128 × poll轮,轮数用_mm_pause或yield填充。对推理来说,图是一张接一张连续提交的,自旋能让下一次唤醒省掉一次条件变量系统调用;但poll调得太大,空闲时会白烧 CPU。llama.cpp 把这做成了可调参数,ggml_threadpool_params_init里的默认值是 50(取中间档,开启「混合自旋」);线程多、空闲期长时通常调小,延迟敏感时调大。abort是取消位,主线程在每算完一个节点后检查abort_callback,一旦用户取消请求,就把abort写成当前节点号,其他线程在节点循环条件里看到它,立刻退出。取消不是立刻停,而是「最多再算完当前节点」——因为节点内部没有中断点。
barrier 的实现:自旋 + 序号翻转
void ggml_barrier(struct ggml_threadpool * tp) { int n_threads = atomic_load(&tp->n_graph) & GGML_THREADPOOL_N_THREADS_MASK; if (n_threads == 1) return;
int n_passed = atomic_load(&tp->n_barrier_passed); int n_barrier = atomic_fetch_add(&tp->n_barrier, 1); // seq_cst
if (n_barrier == n_threads - 1) { // 最后一个到达者 atomic_store(&tp->n_barrier, 0); atomic_fetch_add(&tp->n_barrier_passed, 1); // 翻转「已通过」序号 return; }
while (atomic_load(&tp->n_barrier_passed) == n_passed) ggml_thread_cpu_relax();}这是「计数器 + 代际」型 barrier 的标准实现,但有两个细节值得注意:
- 最后到达的线程负责清零
n_barrier并递增n_barrier_passed,其他线程通过「n_barrier_passed是否变化」判断自己可以走了。这样不需要重置每个线程的私有状态,下一轮 barrier 可以直接复用同一对计数器; - 进入和退出都用
seq_cst。barrier 的语义不只是「等人到齐」,还包括「人到齐之前的写操作,必须对之后的所有线程可见」。如果只用relaxed,编译器或 CPU 可能把 barrier 前的写操作重排到 barrier 之后,导致某个线程读到别的线程尚未写完的wdata。seq_cst的代价是每次 barrier 都要发一次完整的内存栅栏指令,在x86上是mfence或带lock前缀的原子操作,开销在几十到上百个周期。
每个图节点之间都要过一次 barrier。这就是 CPU 推理并行效率的结构性上限:注意力、RoPE、RMSNorm 这些节点的计算量远小于 mul_mat,但它们同样要付一次全线程同步的代价。一个几十层的模型、每层十几个节点,decode 一步就是几百次 barrier。同步开销是固定的,节点越小,占比越高。这也解释了为什么 llama.cpp 后来在图层面引入了算子融合(把 norm、RoPE、KV 写入合成一个 kernel),本质上是在减少 barrier 的次数,而不只是减少 kernel launch。
一次图计算的完整生命周期
主线程与 worker 的分工如下:
- 主线程调用
ggml_graph_compute,更新线程池上的cgraph/cplan指针、清零current_chunk、把abort置为 -1,然后ggml_graph_compute_kickoff:在持锁状态下把n_graph的高 16 位加一、低 16 位写成线程数,用seq_cst发布; - worker 在
ggml_graph_compute_check_for_work里先自旋poll轮,没等到就持共享锁进条件变量睡眠。被唤醒(或自旋等到)后检查state->pending,确认自己被选中,然后调用ggml_graph_compute_thread; ggml_graph_compute_thread里是一个按拓扑序的节点循环:
for (int node_n = 0; node_n < cgraph->n_nodes && tp->abort != node_n; node_n++) { struct ggml_tensor * node = cgraph->nodes[node_n]; if (ggml_op_is_empty(node->op)) continue; if ((node->flags & GGML_TENSOR_FLAG_COMPUTE) == 0) continue;
const int n_fused = ggml_cpu_try_fuse_ops(cgraph, node_n, ¶ms, cplan); if (n_fused > 0) node_n += n_fused; else ggml_compute_forward(¶ms, node);
if (state->ith == 0 && cplan->abort_callback && cplan->abort_callback(...)) { atomic_store(&tp->abort, node_n + 1); tp->ec = GGML_STATUS_ABORTED; } if (node_n + 1 < cgraph->n_nodes) ggml_barrier(tp);}ggml_barrier(tp);- 主线程本身也是 worker 0,跑同一段循环,所以「主线程只负责派发」的说法并不准确——它派发完就立刻投入计算,不额外占一个核。
ggml_cpu_try_fuse_ops 是后来加入的融合入口。它在节点循环里检查「当前节点和后续节点能否合并成一个 kernel」,能合就跳过若干节点。这与上面的 barrier 成本直接相关:融合掉 个节点,就少 次 barrier。不过融合的判定目前仍在每次执行时做,源码里留了一条 TODO——「应该把融合决策移到 ggml_graph_plan,只做一次」。
任务数:不是所有算子都值得多线程
ggml_graph_plan 会遍历整张图的每个节点,调用 ggml_get_n_tasks 给出该节点的 n_tasks,并按 n_tasks 估算该节点需要的工作缓冲。最后的 cplan.n_threads 取全图所有节点 n_tasks 的最大值,再与请求线程数和线程池容量取小:
const int n_tasks = ggml_get_n_tasks(node, n_threads);max_tasks = MAX(max_tasks, n_tasks);...cplan.n_threads = MIN(max_tasks, n_threads);换句话说:一次图计算里所有节点都用同一个线程数,n_tasks 的作用是给每个节点的工作缓冲定尺寸(work_size 的估算里大量出现 ... * n_tasks),以及决定这张图全局要拉起多少线程。ggml_get_n_tasks 在源码里按算子类型给出几类量级:
| 算子类别 | n_tasks 典型取值 | 含义 |
|---|---|---|
| 逐元素与拷贝(ADD、MUL、CPY、CONT、DUP) | n_threads | 每个线程独立处理一段,无跨元素依赖 |
| 激活(SiLU、GELU 等) | n_threads | 同上 |
| 部分一元算子(RELU、SIGMOID、TANH、EXP) | 1 | 实现上未做按线程分段的路径 |
| 归约类(SUM、SUM_ROWS、MEAN、ARGMAX)与多数逐点 SIMD 算子 | 1 | 需要跨元素合并或实现里只有单线程路径 |
| 注意力与矩阵乘 | min(n_threads, 行数/头数) | 并行度受可独立的行或头数量限制 |
按 n_tasks 估算缓冲的原因因算子而异:对需要临时区的算子(量化加法、归一化、flash_attn 等),每个线程要有一份独立的中间结果或部分和,work_size 因此与 n_tasks 成正比;对纯逐元素的非量化路径,各线程直接按行区间写 dst,并不真的使用 work 缓冲,规划期的估算只是保守预留。n_tasks 设得比实际参与线程少,缓冲可能不够;设得比实际多,只是多占内存。
真正决定「每个线程干什么」的是各算子内部的切分逻辑,n_tasks 不参与这些切分。具体到 mul_mat,切分由上一节的 nchunk0 × nchunk1 和原子计数器完成;n_tasks 对它的影响只体现在「这张图总共拉起多少线程」和「wdata 按多少份估算」上。因此 mul_mat 的实际并行度由任务块数决定,而 barrier 的等待集合由整张图决定——这也是为什么 chunk_size 的选择会直接改变 barrier 前的等待时间分布:任务块数少于线程数时,一部分线程领不到活,但仍然要到 barrier 处集合。
工作缓冲与 cplan
ggml_cplan 是规划阶段的产物,包含 n_threads、work_size、work_data、use_ref、abort_callback 与 threadpool 等字段。work_data 是一块所有线程共享的缓冲,mul_mat 用它装量化后的激活,flash_attn 用它装中间结果。
work_size 的计算在每个算子的 work_size 函数里,通常是「按最坏情况估算」:例如 mul_mat 的 wsize 是 ne13 * nbw3,即所有激活行的量化结果总大小。规划阶段一次性算最大值,运行时不再分配,避免了在热路径上调用 malloc。代价是内存占用偏高:一张图里如果有多个大 mul_mat,work_size 取的是它们的最大值而不是和,因此不会叠加,但仍然要按最大的那个预留。
到这里,一次 mul_mat 的四层机制已经串起来了:块布局决定字节流,点积内核决定每条字节被怎么用,mul_mat 决定这些内核怎么分给线程,线程池决定线程之间怎么同步。下面用一组真实测量数据,看看这套机制在端到端的 tokens/s 上留下什么痕迹。
真实数字:这套机制在端到端上留下了什么痕迹
量化格式对吞吐的影响并不只由比特数决定
一组公开的实测数据来自 Which Quantization Should I Use?(arXiv:2601.14277,2026 年 1 月)。作者在双路 Intel Xeon Platinum 8488C(96 物理核、AVX-512)上,用 llama.cpp 的 llama-bench 对 Llama-3.1-8B-Instruct 的各类 GGUF 格式测了 prompt processing(512 token)与 token generation(128 token)两档吞吐。下面摘录几个代表性格式(表 3,单位 tokens/s):
| 格式 | pp512 | tg128 |
|---|---|---|
| F16 | 79.57 ± 1.00 | 2.83 ± 0.01 |
| Q3_K_S | 57.39 ± 3.01 | 9.91 ± 0.03 |
| Q4_0 | 97.35 ± 0.68 | 4.36 ± 0.20 |
| Q4_K_S | 92.52 ± 1.53 | 4.65 ± 0.15 |
| Q4_K_M | 87.70 ± 0.70 | 5.12 ± 0.37 |
| Q5_0 | 61.44 ± 2.47 | 6.66 ± 0.06 |
| Q8_0 | 71.42 ± 3.15 | 5.03 ± 0.16 |
这张表里有几处与「比特越低越快」的直觉相反:
- Q4_0 的 pp512(97.35)比 Q4_K_S(92.52)、Q4_K_M(87.70)都高。预填充是计算受限的,Q4_0 的 32 元素块解包只需要一个 FP16 scale,而 Q4_K 要拆 12 字节的 6-bit 参数、再逐子块乘 scale。一个合理的解释是:同样的比特数,解包与缩放指令更多的格式在计算受限阶段会吃亏;此外 Q4_0 与 K-quant 在 CPU 上走的内核实现并不相同(前者更适合 repack 成 4 行交错布局,后者更适合通用
vec_dot),两者的指令路径不能直接按比特数比较。 - Q3_K_S 的 tg128(9.91)是 Q4_K_S 的 2 倍多,但 pp512 只有它的一半。比特越低,解码阶段读的字节越少,这是纯带宽收益;但 3-bit 解包路径更复杂,预填充阶段更容易被指令吞吐而不是带宽限制;
- Q5_0 的 pp512(61.44)高于 Q5_K_S(55.31)与 Q5_K_M(58.24),tg128(6.66)也高于 Q5_K_S(5.98),但仍低于 Q5_K_M(6.85)。5-bit 档内部并没有「一路 K-quant 更快」的单调关系。原文作者在分析中特别指出,prompt processing 的吞吐「并不只由名义比特数决定」,而受「kernel 选择、访存模式、计算与带宽的平衡」影响——这正好对应本节讨论的三个层次:block layout 影响访存,点积内核决定指令数,mul_mat 的切分决定并行度。
原表里 F16 参考的 tg128 只有 2.83 tokens/s,而量化格式普遍在 4–10 tokens/s。在同样 96 核的机器上,这正是带宽账的直接体现:F16 的 8B 模型每 token 要读约 16 GB 权重,量化后 Q4 只有 4 GB 左右,解码速度与「每 token 读取的字节数」成反比,比例大致吻合。
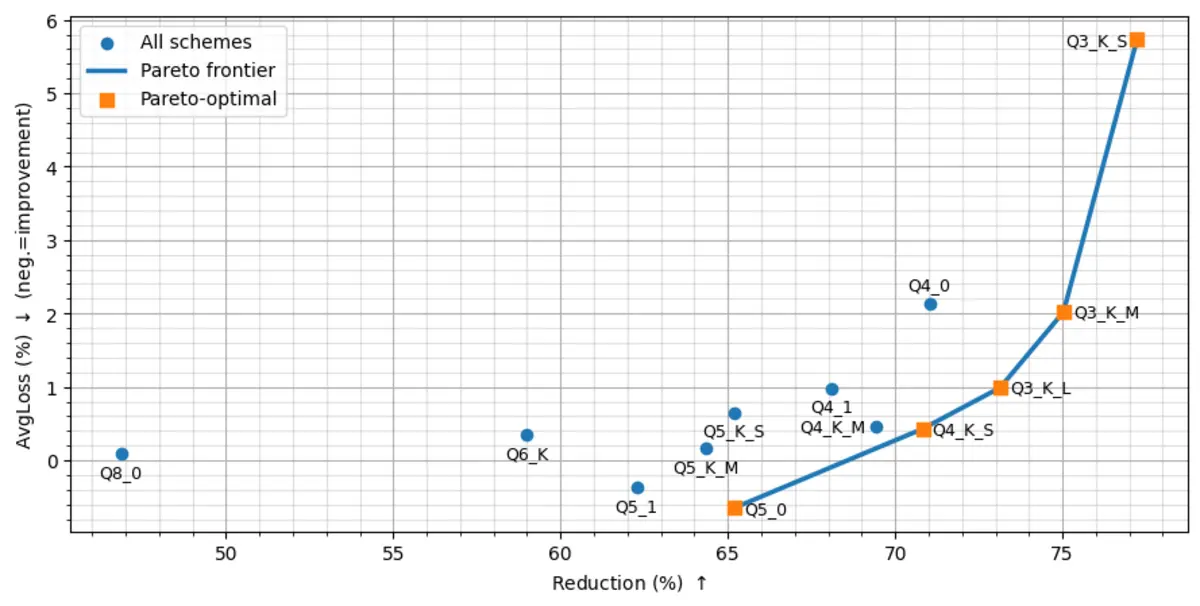
上图是该论文的 Figure 1,横轴是模型体积压缩比例,纵轴是相对 F16 的平均精度损失()。曲线的形状直接印证了前面讨论的块结构收益:Q4_0 的压缩率约 71.0%、平均精度损失约 2.1%;Q4_K_S 在几乎相同的压缩率(70.8%)下把损失压到 0.43%;Q3_K_L 把压缩率推到 73.1%,损失约 1%。同一名义比特数下,不同的块组织会落在不同的 Pareto 点上——这正是「块布局」这一层设计对端到端取舍的影响。
同一份 llama.cpp 内核对不同格式的适配
另一组数据来自 QuantX(arXiv:2505.07531),作者把 Q4X 量化方案接进 llama.cpp,在 Milk-V Jupiter 板(RISC-V 平台)上跑 Llama-3.2-1B-Instruct,对比 Q4_0、Q4_K、Q4X:
| 方案 | 有效比特 | 文件大小 (MiB) | Prefill / Decode (tokens/s) | 困惑度 |
|---|---|---|---|---|
| FP16 | 16 | ~2300 | 0.12 / 0.06 | 13.16 |
| Q4_0 | 4.5 | 727.75 | 6.03 / 4.28 | 15.22 |
| Q4_K | 4.5 | 732.25 | 7.77 / 5.06 | 14.45 |
| Q4X | 4.28 | 702.38 | 8.64 / 5.29 | 14.67 |
这张表最值得注意的是 Q4_K 与 Q4_0 体积几乎相同(732 vs 728 MiB),但 Q4_K 在 decode 上快了约 18%、prefill 快了约 29%,困惑度还更低(14.45 vs 15.22)。体积相同说明两者每 token 读的字节基本相同,那速度差异来自哪里?两个来源:
- 点积内核效率:Q4_K 用 256 元素的超级块,
vec_dot的内层循环迭代次数只有 Q4_0 的 1/8,横向归约与块头解析的固定开销被摊薄到八分之一的元素上(需要说明:内核实现差异也可能反向抵消这一收益,因此在没有 repack/矩阵扩展特化的平台上,这条解释更显著); - 非对称量化的精度收益:同样的文件体积下,Q4_K 用 6-bit 子块 scale 换来了更好的精度。
这组数据说明:在同一个字节预算下,「块怎么组织」和「内核怎么写」带来的收益,可以与多换一位比特相提并论。QuantX 本体的贡献在于直方图驱动的不均匀量化,与本文讨论的块结构是叠加关系,不是替代关系。
用「每 token 字节数」解释解码速度
把上面的表代进第一节的带宽公式,可以检验机制是否自洽。Llama-3.1-8B 约 80 亿参数,Q4_K_M 平均约 4.85 bpw,权重约 GB;tg128 是 5.12 tokens/s,则每 token 吞吐对应带宽约 GB/s。对于双路 96 核的服务器,这个带宽不算高,说明实际耗时并不全由内存带宽决定,同步开销与部分非量化层的计算也在其中。这也从反面说明线程池同步与任务切分不是可以忽略的细节——如果只有带宽在起作用,5.12 这个数字应该更高。
工程上的坑
把四层机制放回工程视角,有几个反复出现的问题值得单独记录,因为它们不是「读代码能看出来」的,而是在实际部署中才会碰到。
线程数与核心拓扑:为什么不是越多越好
ggml_compute_forward_mul_mat 里那段 NUMA 兜底逻辑的注释直接说明了问题:在 NUMA 系统上,细粒度任务切分反而比「每个线程一块固定内存」慢。原因有两个:
- 远端内存访问:线程在节点 A,权重在节点 B 的内存里,读一次要比本地慢几倍。任务窃取会让每个线程都碰到「别人节点上」的任务块;
- 超线程:逻辑核数不等于物理核数。
n_threads设成逻辑核数时,两个超线程共享同一组执行单元与 L1 缓存,对于mul_mat这种打满 FPU 与 L1 的工作负载,超线程几乎没有收益,反而让 L1 容量被两份数据流分摊,命中率下降。llama.cpp 的--threads默认值是物理核数而非逻辑核数,也是这个原因。
在实践中,「n_threads 从 32 加到 64 反而变慢」的曲线非常常见。这条曲线的拐点由三件事共同决定:L1/L2 的容量是否能装下所有线程的工作集、内存控制器是否已经饱和、barrier 的开销是否开始主导。
任务块太小:原子计数器的代价
chunk_size = 16 的二维切分在「行数很多、线程数很多」时,任务块数会远超线程数: 行、16 行一块就是 896 个任务块。每个任务块结束时都要做一次 atomic_fetch_add 到同一个缓存行,所有线程都在争用同一个内存地址写——这是典型的伪共享 + 缓存行乒乓。原子操作本身在 L1 命中时只要十几周期,但当多个核同时写同一缓存行时,会出现缓存行在核间反复迁移,每次迁移的代价在几十到几百周期。
llama.cpp 的处理方式是限制每个任务的最小工作量(16 行 × 个元素),而不是进一步细分。当 很大(如 4096)时,一个任务块的计算量足够大,原子操作的摊销可忽略;当 很小(如某些门控投影),小任务块会让原子操作成为热点——这也是 chunk_size 在单行场景下放大到 64 的原因之一。
激活量化重复与融合
前面提过:每个 mul_mat 各自量化一遍激活。对于共享同一输入的多路投影(Q/K/V,或 MLA 的降维与升维),这意味着同一行激活会被量化多次,每次都要写 wdata、做 barrier。这部分工作在图层面完全冗余。llama.cpp 的融合路径会把这几个算子合成一个节点执行,让激活只在开始时量化一次;这也是「节点融合不仅省 kernel launch,还省激活转换」这一结论在 CPU 侧的具体体现。
类似的融合在 ggml_compute_forward_mul_mat 的开头还有一个特例:
const int32_t hint = ggml_get_op_params_i32(dst, 1);if (hint == GGML_HINT_SRC0_IS_HADAMARD && !params->use_ref) { ggml_compute_forward_fwht(params, dst); return;}当权重是 Hadamard 矩阵时(在某些量化方案里用于随机旋转),mul_mat 直接走快速 Walsh–Hadamard 变换,复杂度从 降到 。这里用 op 参数里的一个 hint 做分发,而不是新增一个算子类型,是因为 ggml 的算子集合要保持稳定,新增类型会破坏旧模型文件的兼容性。
中间缓冲区被反复 memset
mul_mat 的一个任务块结束时,tmp[32] 是栈上的局部数组,不需要清零;但 wdata 里的激活、aux32 之类的中间缓冲会被清零多次。在标量内核里,每个超级块开头都有 memset(aux32, 0, 8*sizeof(int32_t)) 与 memset(sums, 0, 8*sizeof(float))。编译器的「死存储消除」有时无法证明这些清零是多余的(因为指针别名),于是多余 memset 会留在循环体里。SIMD 版本通过把累加器声明成向量寄存器变量(__m256i sumi = _mm256_setzero_si256())绕开了这个问题——寄存器初始化天然不会被当成内存写。这是编写 SIMD 内核时一个不太起眼但影响实际性能的习惯。
小结
回到开头的问题:一次 mul_mat 在 CPU 上究竟被执行成了什么?
- 字节流:权重按超级块组织,每 256 个元素占 144 字节(Q4_K),其中 12 字节是打包成 6-bit 的 16 个子块参数。Q4_0 与 Q4_K 同为 4.5 bpw,区别在于分组粒度与参数位宽。
- 点积:不反量化权重。激活先按行量化成 Q8_K(带
bsums辅助和),权重解包只做移位与掩码,乘加用maddubs/maddwd这类整数指令完成。缩放系数被提到求和号外,每 256 元素只做一次浮点归约与缩放。 - 矩阵乘切分:先按 16 行 × 16 列的任务块二维切分,再用原子计数器动态派发;任务块内部再按 组织
vec_dot调用,结果先落栈上再合并写回。 - 线程池:一张图拉起的所有线程在每个节点之间做一次
seq_cstbarrier;poll决定空闲时的自旋预算,abort让取消最多延迟一个节点,current_chunk让mul_mat的线程之间用原子计数器动态领活。
四层之间是严格的嵌套关系:块布局决定了点积能一次处理多少元素,点积的调用粒度决定了任务块内循环怎么写,任务块的数量决定了线程在 barrier 前能领到多少活。任何一层的改动都会沿着嵌套关系向上或向下传递,这也是 llama.cpp 这种「单一代码库撑起所有硬件」的工程范式能够长期成立的原因:契约只有一个(vec_dot 的签名),其余全部可以在编译期或规划期决定。
下一篇会沿同一张图往上走一层,看 ggml-cpu 如何把 mul_mat 之外的算子(注意力、RoPE、RMSNorm、KV 写入)安排进同一条线程池节拍里,以及节点融合如何把几次 barrier 合并成一次。
参考资料
- llama.cpp 官方仓库
- ggml-cpu 源码:ggml-cpu.c
- ggml-cpu 量化内核:quants.c
- ggml 量化块定义:ggml-common.h
- llama.cpp PR #6915:NUMA 友好的 mul_mat 任务切分
- Which Quantization Should I Use? A Unified Evaluation of llama.cpp Quantization on Llama-3.1-8B-Instruct(arXiv:2601.14277)
- QuantX: A Framework for Hardware-Aware Quantization of Generative AI Workloads(arXiv:2505.07531)
- llama.cpp x86 量化内核:arch/x86/quants.c
- llama.cpp SIMD 映射层:simd-mappings.h
这套机制为什么长成这样:设计空间的回看
把四层机制放回设计空间里,回答几个「为什么不」的问题,能更清楚地看出 llama.cpp 的取舍边界。
为什么不把权重量化成 FP4、NVFP4 这类浮点块格式? 浮点块格式(E2M1 + 块级 E4M3 scale)在硬件上有原生支持时非常划算,但在纯 CPU 上,E2M1 的解包需要查表或位域拆分,再做浮点乘加,没有整数量积那样一条 maddubs 顶掉一串运算的收益。整数量积之所以成立,是因为 int8 点积在 x86、ARM、RISC-V 上都有专用指令或至少能高效自动向量化。llama.cpp 近年开始支持 MXFP4 与 NVFP4,但它们的 vec_dot_type 是 Q8_0 而不是 Q8_K——块粒度更小(对齐硬件的 16/32 元素块),点积路径也换成了另一套,这是格式与指令集共同演进的结果,而不是简单的「换成浮点更好」。
为什么任务切分用原子计数器,而不是线程池的任务队列? 队列要加锁、要分配节点、要处理优先级,开销对「微秒级的 mul_mat」来说太大。原子计数器只有一个共享变量,一次 fetch_add 就能领一个任务块,在 x86 上是一条带 lock 前缀的自增。只有在无锁方案本身成为热点时(任务块太小、核太多),才需要回头增大任务块或做 NUMA 分区,而不是换更复杂的调度器。
为什么不在每个节点内部做更细的同步? 例如让 mul_mat 的线程在算完自己那块后直接进入下一个算子,只等待「自己依赖的那几行」。这种做法叫细粒度数据流同步,学术系统里有过实现,但工程代价极高:需要依赖分析、每次算子变化都要更新依赖图、调试困难。llama.cpp 选择的是节点级全同步——简单、可预测、开销固定,在节点计算量足够大时几乎免费。只有当一个节点很小、同步开销占比很高时,才值得考虑融合节点(减少同步次数)而不是细化同步。这条「先减少次数,再细化粒度」的路线,在 CPU 上被证明是更实际的顺序。
为什么不用 OpenMP? 源码里保留了 GGML_USE_OPENMP 分支:编译期若开启,ggml_graph_compute 会用 #pragma omp parallel 包住整个节点循环,barrier 直接映射到 #pragma omp barrier(CMake 里对应的选项 GGML_OPENMP 默认是 ON,只要能找到 OpenMP 运行库就会被链接进来)。但 OpenMP 的运行时有自己的线程管理与任务调度,它与 llama.cpp 需要「一张图一张图连续提交、空闲时自旋等待」的模式不匹配:OpenMP 的并行区域以「一次图计算」为粒度,线程池生命周期由运行时管理,空闲时线程回到运行时池里休眠,自旋预算 poll 这套机制在 OpenMP 路径下无处安放。llama.cpp 自建线程池就是为了让整个推理请求期间线程一直活着、在节点之间只做 barrier,并能按部署形态精确控制自旋。
为什么 poll 要可调? 自旋等待是「用 CPU 时间换唤醒延迟」的交易。推理服务里,如果每张图之间间隔很短(连续 decode),自旋几乎总能等到下一张图,收益明显;如果是交互式使用、用户思考时间长,自旋就纯属浪费。llama.cpp 把它暴露成参数,正是承认「最优自旋预算」不是代码能单方面决定的,而取决于部署形态。
把这些机制串成一条时间线
把一次 decode 步(32 层模型)在这四层里发生的事按顺序铺开,可以更直观地看到瓶颈在哪里:
- 图规划:每张图在首次执行时由
ggml_graph_plan决定每个节点的n_tasks与总work_size,之后若图结构不变就直接复用计划; - 激活量化:每个
mul_mat入口处,所有线程分段把当前 token 的激活行量化成 Q8_K 写入wdata,barrier; - 任务派发:
ith == 0重置原子计数器,barrier,然后所有线程领取任务块; - 点积:每个 块的内部循环执行数百到数千次
vec_dot,整数乘加占绝对多数; - 节点 barrier:
mul_mat完成,所有线程在节点边界同步,进入下一个算子(注意力的 softmax、RoPE、norm 等); - 重复:32 层 × 每层若干节点,每个节点一次 barrier。
时间线上真正花在「计算」上的,只有第 2、4、5 三段的计算部分;barrier、激活量化、任务派发都是围绕计算的固定开销。解码阶段因为每次只算一两行激活,barrier 与派发的占比会被放大——这也解释了为什么 llama.cpp 在解码上做了大量「合并节点、预捕获图、减少任务块」的优化:瓶颈不是乘加,而是乘加周围的那些簿记。
本篇没有覆盖的部分
为了把四层讲透,本篇刻意缩小了范围,以下内容留到后续:
- 注意力与 KV 写入的 CPU 路径:
flash_attn_ext在 CPU 上怎么按 head 与 KV 长度切任务,以及 K/V 写入如何与分页缓存对齐; - 节点融合的判定逻辑:
ggml_cpu_try_fuse_ops在什么条件下把哪几种算子合成一个节点,以及融合如何改变 barrier 的位置; - repack 与 AMX/KleidiAI 的接入细节:上一篇文章(llama.cpp 源码完全拆解(七):后端与 Kernel)已经从缓冲区类型角度讲过 repack 的接入,本篇只在点积层面对比了指令路径;AMX 的 tile 指令与 KleidiAI 的融合内核属于更高一层的加速器,值得单独展开;
mul_mat_id(MoE 专家路由下的矩阵乘):它比mul_mat多了一层「按专家 ID 分组」的逻辑,是本篇mul_mat的直接扩展,但分组带来的任务派发问题很不一样。
下一步按上面列的顺序,从注意力与 KV 写入的线程安排开始讲。如果更关心 MoE 推理在 CPU 上的表现,也可以先跳到 mul_mat_id;这两条路线在同一个线程池框架下其实是同一个问题:节点之间的 barrier 仍然是主角,变的只是节点内部怎么派活。
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



