


llama.cpp 源码完全拆解(二十三):graph_compute 的图路径——键、uid、分块捕获与 cudaGraphExecUpdate 的逐节点比对
引言:一次回放要穿过的六道判定
在 llama.cpp 里,一次 decode 步最终会落到这样一行调用:
// src/llama-context.cpp: llama_context::graph_compute()auto status = ggml_backend_sched_graph_compute_async(sched.get(), gf);sched 是 ggml_backend_sched_t,负责把一张 ggml 计算图按后端切分、拷贝跨后端的输入、再逐段交给各后端执行 graph_compute;gf 是 llama_graph_result::get_gf() 返回的 ggml_cgraph *。ggml-cpu 在收到这一段图之后如何用线程池跑完非 GEMM 算子,在 llama.cpp 源码完全拆解(二十二):ggml-cpu 的非 GEMM 算子 中已经拆过;本篇把镜头对准 GPU 后端:ggml/src/ggml-cuda/ggml-cuda.cu 里的 ggml_backend_cuda_graph_compute。
大多数介绍 CUDA Graph 的文章到这里就结束了:捕获一次、回放多次、省掉 kernel launch 开销。但真实代码里,从「调度器觉得这张图可以用图来跑」到「GPU 上真正发出一次 cudaGraphLaunch」,中间要穿过一串判定:
- 这张图应该挂在哪个捕获对象上?(
graph_key) - 这个对象上次记录的节点列表,能否原样代表本次这张图?(
cgraph->uid与node_props) - 本次图能否被捕获?(
ggml_cuda_graph_check_compability) - 图还「热」够了吗?(
warmup_complete) - 捕获时哪些节点真的发射、哪些被融合吸收、哪些在多流区域里?(
ggml_cuda_try_fuse、concurrent_events) - 块边界切在哪、旧的可执行图是更新还是重建?(
GGML_CUDA_GRAPH_CHUNK_SIZE、cudaGraphExecUpdate)
这六道判定每一道都对应一类线上事故:挂错捕获对象导致图里读到别的步的地址、节点属性漏比对导致形状变了还在回放旧图、在多流区域里切块导致事件悬空、融合节点与块边界交错导致某段 kernel 被重复或漏发……本篇顺着源码把它们逐个讲清楚。所有讨论都基于 llama.cpp 当前主线代码;涉及版本相关的细节(比如 mul_mat_id 的 fallback 条件)以正文引用的文件为准。
图源:[PyTorch 官方博客 Accelerating PyTorch with CUDA Graphs](https://pytorch.org/blog/accelerating-pytorch-with-cuda-graphs/),2021 年 10 月。重放阶段图中所有 kernel 的参数与地址都在捕获时冻结,这正是后文所有比对逻辑存在的根本原因。
背景与问题定义:为什么解码图适合图化,又为什么这么难图化
一次 decode 步的 CPU 侧开销
解码阶段每一步只新增一个 token,GPU 上跑的是小矩阵乘向量、归一化、注意力这些短 kernel,单个 kernel 在 GPU 上的执行时间常常只有几微秒,而 CPU 侧要依次完成:Python/C++ 层的参数准备(这里 llama.cpp 没有 Python,但模板展开、图重排、张量视图仍有代价)、CUDA runtime 的 cudaLaunchKernel 参数打包、驱动层的工作队列提交。一个 70 层左右的模型,每层十余个算子,一步就是上千次 launch。即便每次 launch 只花 35 微秒,累计也有 35 毫秒,足以让 GPU 在每个 kernel 之间不断空转。
CUDA Graph 的核心是把「一串 kernel 及其依赖关系」一次性录制成一张有向无环图,之后每次只需要一次 cudaGraphLaunch 把整段工作提交给 GPU。CUDA Graph 最早随 CUDA 10(2018 年发布)引入,核心 API 包括 cudaStreamBeginCapture/cudaStreamEndCapture(流捕获)与 cudaGraphInstantiate/cudaGraphLaunch(实例化与回放);PyTorch 在 1.10 版本(2021 年)通过 stream capture 暴露了这一能力,其官方博客在 2021 年给出了一个直观的时间线对比。
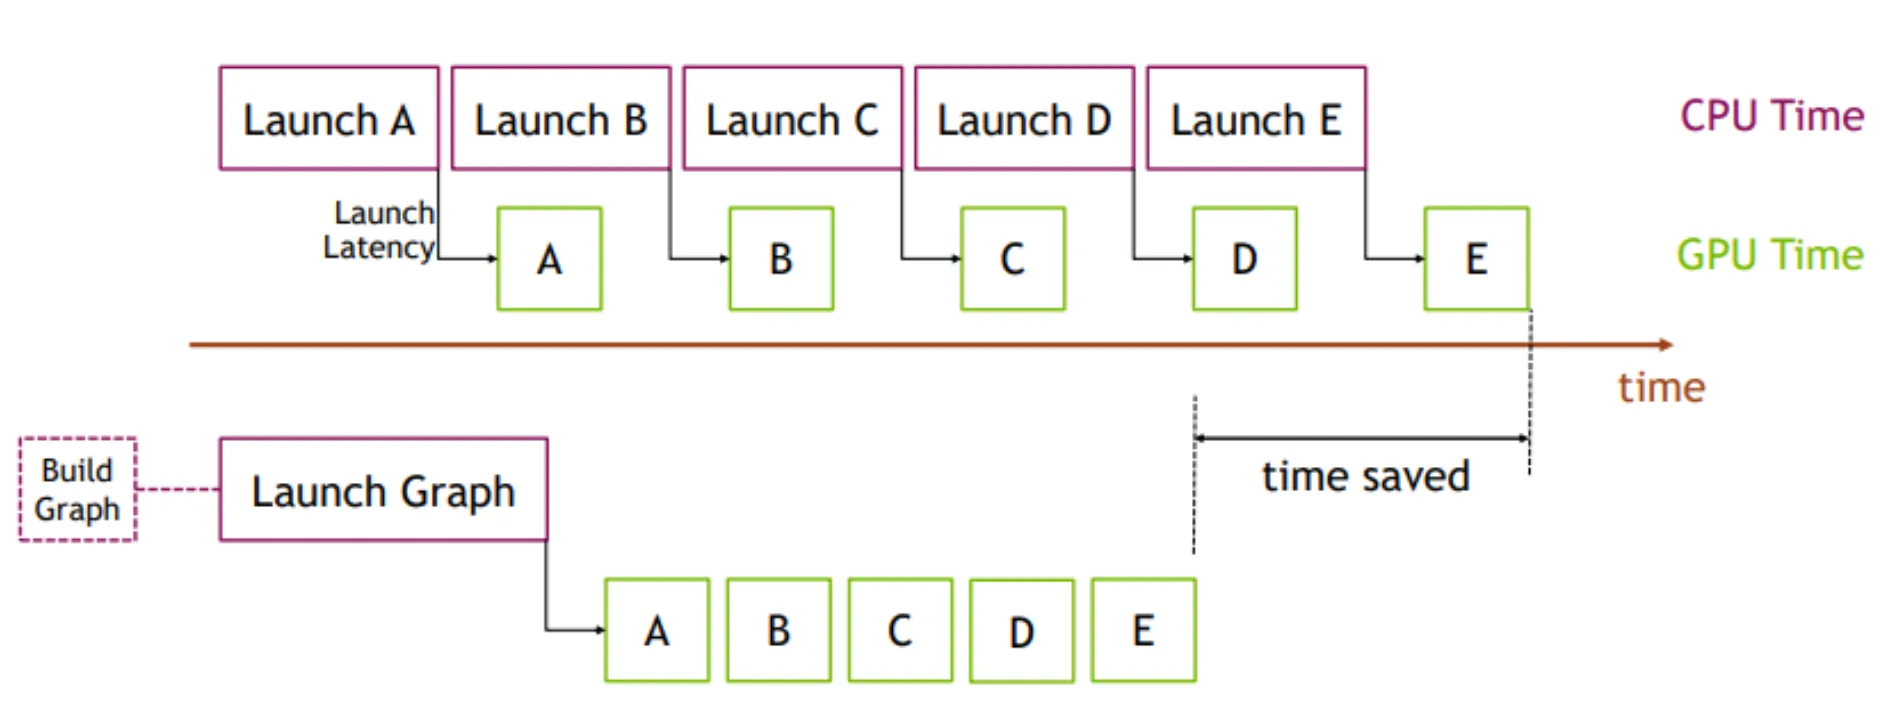
图源:[PyTorch 官方博客 Accelerating PyTorch with CUDA Graphs](https://pytorch.org/blog/accelerating-pytorch-with-cuda-graphs/)(Figure 1)。空窗的长度就是 CPU 提交开销,图化之后这些空窗被压缩成一次提交。
难点:llama.cpp 的执行形态和 PyTorch 不一样
PyTorch 的典型图化用法是:准备好固定形状的静态输入张量,用示例输入先 eager 跑几轮热身,然后 with torch.cuda.graph(g): 在捕获流里跑一次,之后每次把新数据 copy_ 进静态输入再 replay()。形状变了就重新捕获一个新图,或者用 make_graphed_callables 为每个可捕获模块单独建图。这种模式依赖框架在 Python 层做「按形状分桶」。
llama.cpp 的路径则完全不同,它没有「每档 batch 一个静态图」的显式管理,而是让 GPU 后端在每次 graph_compute 时自己去判断「这张图和上次那张是不是同一张」:
- 计算图常常每步都重建,但重建是「确定性的」。解码步走
llama_context::process_ubatch:当上一张图仍活跃、且llm_graph_result::can_reuse(gparams)返回真时,直接复用旧图,只通过set_inputs(ubatch)刷新输入张量的内容;否则先res->reset()、ggml_backend_sched_reset(sched),再model.build_graph(gparams)重建。reset()的关键在于它并不释放元数据内存,而是把buf_compute_meta原样传给ggml_init,再ggml_new_graph_custom开一张新图——新张量依旧从同一段 buffer 的开头依次分配,因此张量结构体指针会重复出现。这正是「首节点地址可以当图键」的前提;真正会变的是data指针(调度器分配的 buffer 可能换位置)与ne/nb(batch 大小不同),这也正是逐节点快照要记录的内容。代码里对复用路径有一句很精确的注释:为了正确复用,图的完整拓扑必须由这些图参数唯一决定——同样的约束也间接约束了后端侧的图身份比对。 - 图可能被调度器切成多段。
ggml_backend_sched_split_graph把大图按后端切分成若干 split(比如中间夹着一段 CPU 上的 MoE 专家),每个 split 用ggml_graph_view变成子图再交给对应后端。于是同一份计算在不同后端上会变成不同首节点的子图,各自需要独立的捕获对象。 - 同一个 CUDA 上下文里有多条图在轮流出现。生成阶段(tg,每序列一步一个 token)与提示处理阶段(pp,一次处理若干 token)的图结构不同;
can_reuse只看图参数(ubatch 形态、图类型、记忆上下文等)是否一致,序列数、输出数一变就要重建。混合 MoE 的--n-cpu-moe部署下,每层还会被 CPU 段打断成多个 GPU split。所有这些形态都要在同一份cuda_graphs台账里区分清楚、互不串用。
所以 llama.cpp 必须自己维护一套「图身份」的判定,而且判定粒度不能太粗(粗了会回放错误的图),也不能太细(细了就每步都重新捕获,图化白做)。下面这张 Nsight 时间线能说明「太细」的代价:当 CPU 被 launch 逻辑占满、GPU 在 kernel 之间大量空转时,省下来的空隙本来就不多,若每步都重新捕获,捕获自身的开销很容易把收益吃回去。
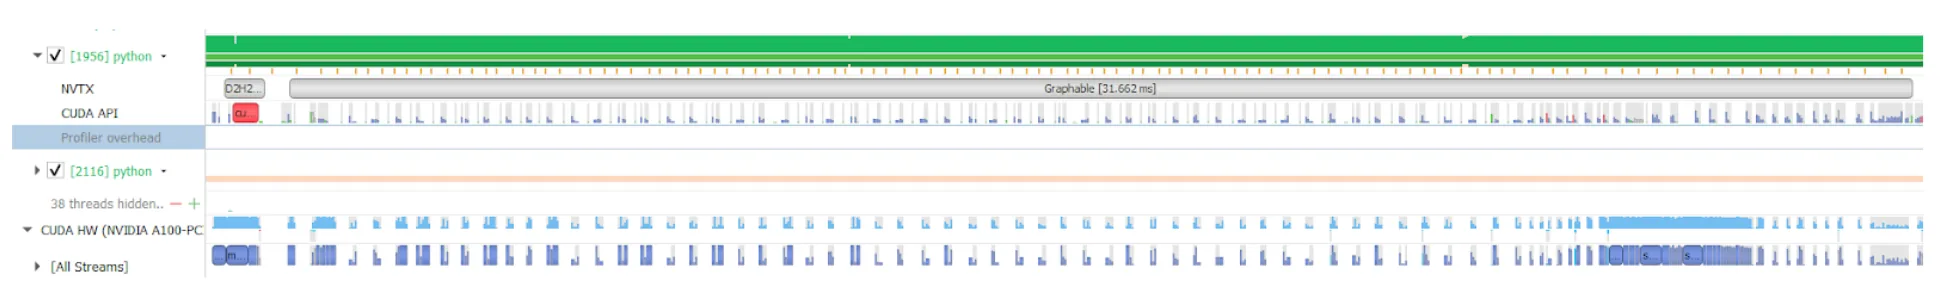
图源:[PyTorch 官方博客 Accelerating PyTorch with CUDA Graphs](https://pytorch.org/blog/accelerating-pytorch-with-cuda-graphs/)(Figure 3,Mask R-CNN 的 Nsight 时间线)。同样的形态在解码阶段更极端:每一步的 kernel 更短、更密,launch 开销占比更高。
PyTorch 官方博客在 2021 年给出的数据可以当作量级参考:在 Mask R-CNN 上,只把 resnet 主干图化,被图化的那一段从 31 ms 降到 6 ms(约 5 倍),整模型端到端约 1.7 倍;BERT 在 4096 卡配置下整体约 1.12 倍;推荐模型 DLRM 的收益则在小 batch 下更明显,因为小 batch 时单个 kernel 更短、CPU 提交在总时间里的占比更高。这些是训练负载的数据,但机制完全一致:批量越小、kernel 越碎,launch 开销占比越高,图化的收益越大。解码阶段的每步前向正是「批量小、kernel 碎」的极端情形。
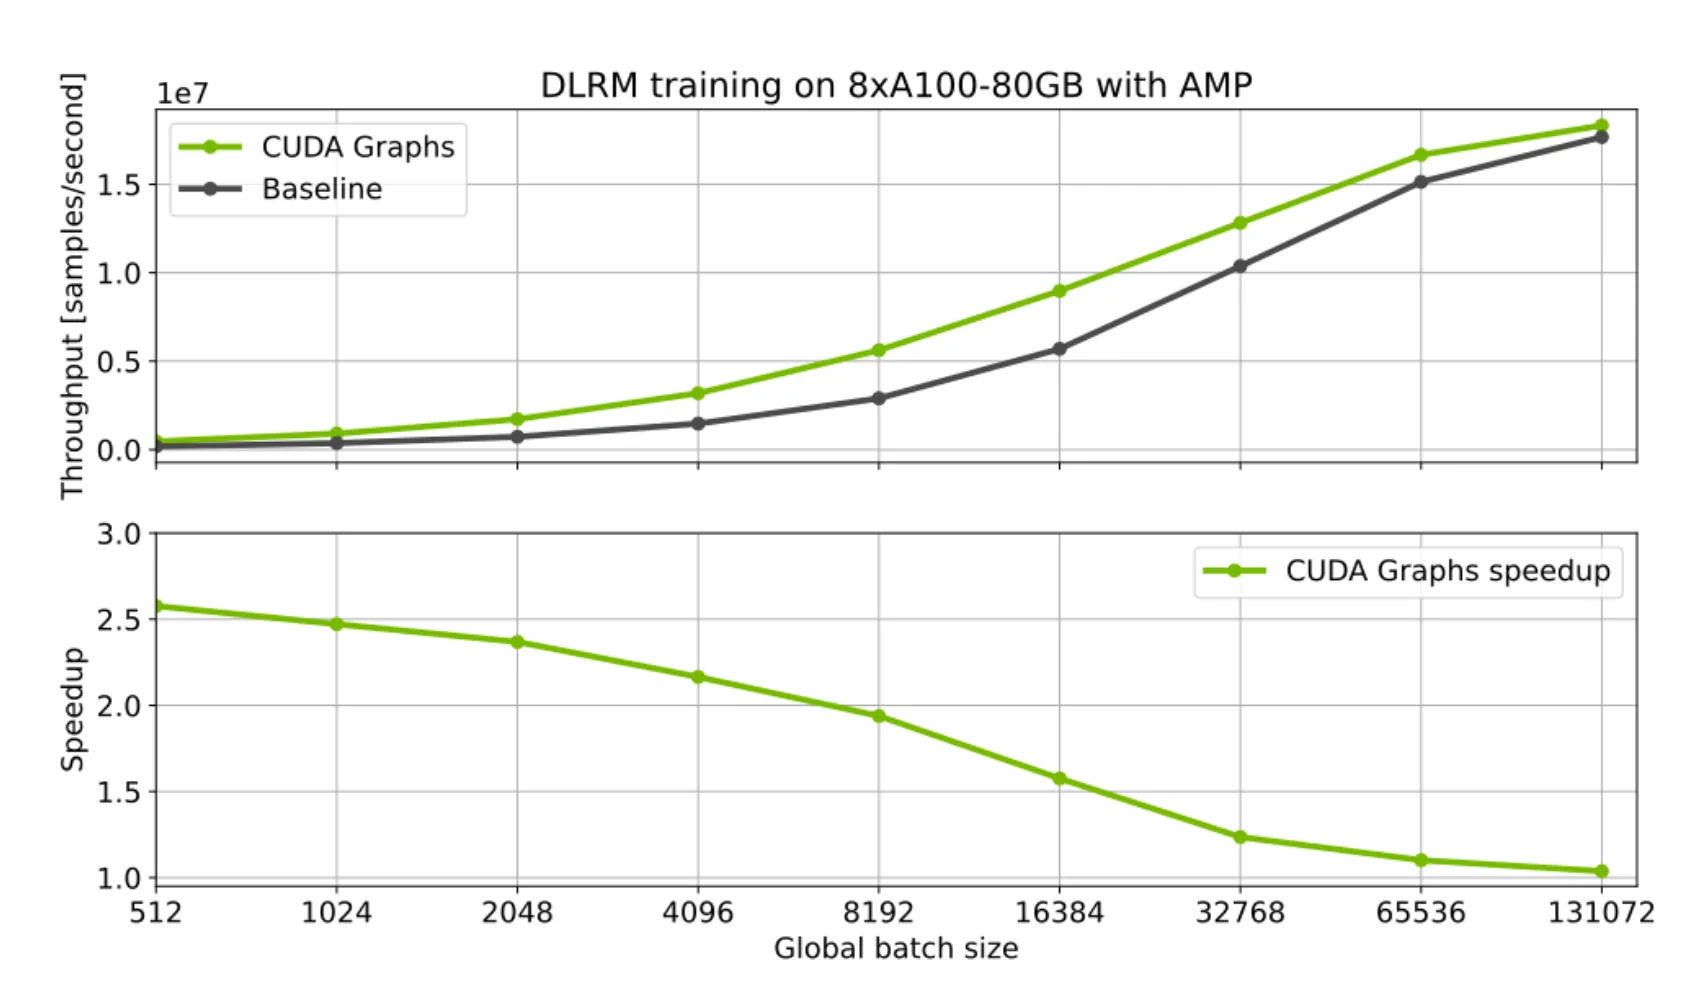
图源:[PyTorch 官方博客 Accelerating PyTorch with CUDA Graphs](https://pytorch.org/blog/accelerating-pytorch-with-cuda-graphs/)(Figure 6,DLRM 的基准结果)。横轴为 batch size,可以看到收益随批量减小而放大——这正是解码阶段最需要图化的原因。
图化的三条硬约束
在进入代码之前,先把 CUDA Graph 对图内节点提出的要求摆出来,后面每一种特殊处理都能对号入座:
- 参数地址静态。图里每个 kernel 读写的 buffer 地址在捕获时确定,回放时不会变。所以本次计算必须把结果写进「上次捕获时用的同一批地址」。
- 形状静态。一个 kernel 的 block/grid 维度、向量化宽度等都是从张量形状推出来的,形状变了意味着必须换一个 kernel 配置,旧图里记下的配置无法使用。
- 图内不允许隐含同步。捕获期间不允许 CPU 与 GPU 之间同步、不允许访问主机端可页交换内存、不允许多个流之间的无序交互(除非用事件显式建模)。llama.cpp 的 MoE
mul_mat_id在某些硬件上要走「先算 ids、回读、再排序」的 fallback 路径,其中包含cudaStreamSynchronize;一旦图里出现这种节点,整张图就不能捕获。
核心思想:一套「同一性台账」,而不是一批「静态图」
把 llama.cpp 的图路径抽象出来,本质上是三本台账:
- 图键(graph_key):用一张 ggml 图的首节点指针做键,把「形状与拓扑相同、每步重新构建」的图归并到同一个
ggml_cuda_graph对象上。首节点是这一段 split 里第一个节点——可能是某层的归一化、也可能是从 CPU 段搬回来的拷贝;只要这段 split 的入口不变,重建后它的地址就会重复出现。 - 同一性台账(uid + node_props):每个
ggml_cuda_graph记下上一次比对通过的图 uid,以及每个节点当时的一个「属性快照」——节点结构体整体拷贝、每个源张量的指针、形状、步长。只要本轮图的 uid 和上次不同,就逐个节点比一遍,任何一项不同就判定「图变了」,需要重新捕获。 - 可执行实例表(instances):一张 ggml 图被切成若干个 chunk,每个 chunk 对应一个从
cudaStreamBeginCapture到cudaStreamEndCapture录下的 CUDA 图,实例化成cudaGraphExec_t存进instances。回放时按顺序cudaGraphLaunch每块。
这里有个很关键的取舍:llama.cpp 用的是 cudaGraphExecUpdate(更新已有可执行图)而不是「形状一变就重新实例化一张新图」。cudaGraphExecUpdate 允许在节点拓扑不变的前提下,把参数指针、kernel 配置等「属性」换成新的值;只有更新失败时才销毁重建。这样做的好处是避免了 cudaGraphInstantiate 那种毫秒级开销在每次形状变化时反复发生,代价是必须自己精确判断「这次到底哪些属性变了」,而且要比对得足够全——漏一项,旧图就会带着旧参数被回放。
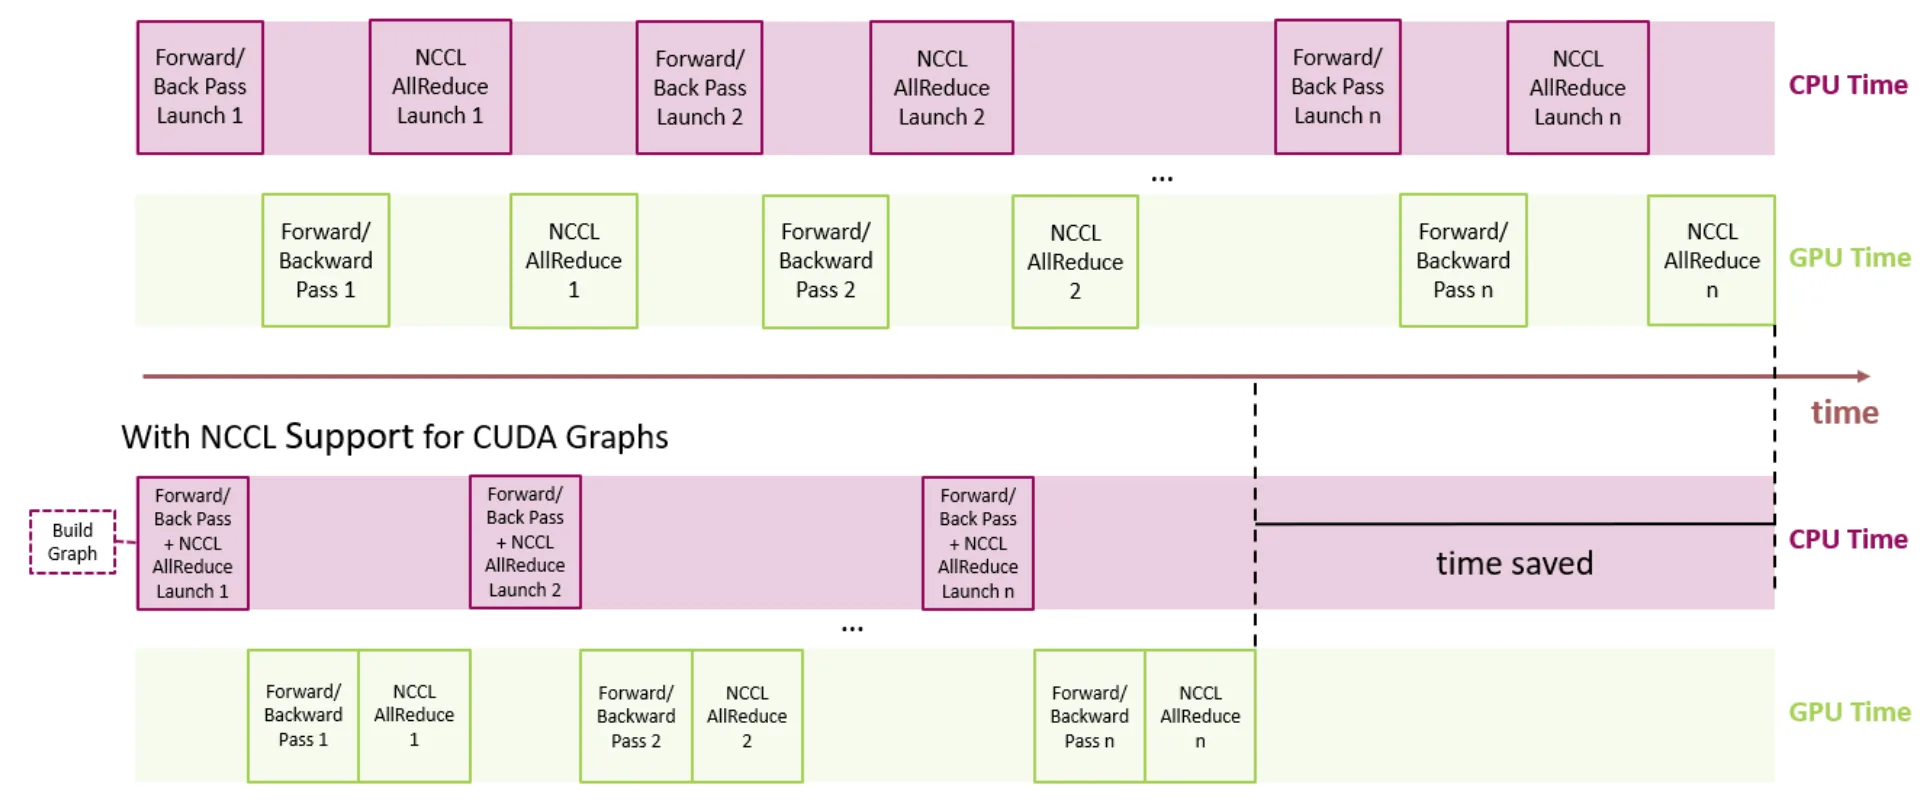
图源:[PyTorch 官方博客 Accelerating PyTorch with CUDA Graphs](https://pytorch.org/blog/accelerating-pytorch-with-cuda-graphs/)(Figure 2)。分布式推理里同样存在通信与计算 kernel 的提交开销。主机侧如何把多进程接成一条流水线,在 [vLLM 源码完全拆解(二十一):分布式执行器](/articles/insights/posts/vllm-distributed-executor/) 一节里拆过;而每个进程内的 GPU 段,各自走本篇这套图路径。
原理详解:从 graph_compute 到 cudaGraphLaunch
数据结构:ggml_cuda_graph 里到底存了什么
这个结构定义在 ggml/src/ggml-cuda/common.cuh 中,并且只在编译开启了 GGML_CUDA_USE_GRAPHS(HIP 为 GGML_HIP_GRAPHS)时才有成员:
struct ggml_cuda_graph {#ifdef USE_CUDA_GRAPH ~ggml_cuda_graph() { for (cudaGraphExec_t instance : instances) { CUDA_CHECK(cudaGraphExecDestroy(instance)); } } // the ggml graph is captured as a series of CUDA graphs, // so the GPU can run one chunk while the next is enqueued std::vector<cudaGraphExec_t> instances; size_t num_nodes = 0; std::vector<cudaGraphNode_t> nodes; bool disable_due_to_gpu_arch = false; bool warmup_complete = false; uint64_t uid = 0; int64_t last_used_time = 0; struct node_properties { ggml_tensor node; void * node_src_data_ptrs[GGML_MAX_SRC]; int64_t node_src_ne[GGML_MAX_SRC][GGML_MAX_DIMS]; size_t node_src_nb[GGML_MAX_SRC][GGML_MAX_DIMS]; }; std::vector<node_properties> node_props;
bool is_enabled() const { static const bool disable_cuda_graphs_due_to_env = (getenv("GGML_CUDA_DISABLE_GRAPHS") != nullptr); return !(disable_due_to_gpu_arch || disable_cuda_graphs_due_to_env); }#endif};逐字段读:
instances:这是「一张 ggml 图 → 多张 CUDA 图」映射的产物。块大小由GGML_CUDA_GRAPH_CHUNK_SIZE决定,默认 512 个 ggml 节点一块;为什么分块、分块的边界为什么不能随便切,见后面的小节。node_props:同一性比对的台账。注意它不是只存「指针」或只存「形状」,而是把三个维度都存了:整个ggml_tensor结构体(包含op、op_params、flags等)、每个源指针src[j]->data、每个源的形状ne与步长nb。这一组合基本覆盖了「同一张图」的所有可观察差异。warmup_complete:热身标志,参与「要不要开始捕获」的判定。下一小节细讲。uid:上一次被认定「与这张图相同」的 ggml 图 uid(由ggml_graph_next_uid()全局递增分配)。这是判断「要不要做逐节点比对」的快捷通道。last_used_time与外部淘汰扫描:图对象按需创建,也按需回收——最近 10 秒没被用到的图会被清掉,避免大量不同的图把显存里的捕获资源一直占着。
ggml_cuda_graph 对象本身由上下文里的 std::unordered_map<const void *, std::unique_ptr<ggml_cuda_graph>> cuda_graphs 持有,键是「首节点指针」。这个选择很讲究:跨后端切分后,每个 split 都是 ggml_graph_view,它的 nodes[0] 指向原大图里一段连续节点的第一个;在重建确定性的前提下,这个指针会重复出现。为什么不直接用 split 的序号(或 split.graph 的地址)做键?因为调度器重新切图后 split 的数量与次序都可能变——比如某些层被移出 GPU、或者 MoE 段的边界挪了位置——同一个序号会指到完全不同的计算段,旧图就会被错配。首节点是「计算段内容」的一部分,跟着内容走,比跟着容器走更可靠。
第一道关卡:graph_key 到底指向谁
static const void * ggml_cuda_graph_get_key(ggml_cgraph * cgraph) { return cgraph->nodes[0];}只有一行,却决定了这条路径在混合 CPU/GPU 部署下是否成立。代码里注释写得很直接:「Map from first_node_ptr to cuda_graph - allows multiple graphs per context when the computation is split across CPU/GPU (e.g., with --n-cpu-moe)」。
设想一个开着 --n-cpu-moe 的模型,专家段被放在 CPU 上:第 1 层是 [GPU: attention + FFN];第 2 层是 [GPU: attention] → [CPU: MoE 的 up/gate/down] → [GPU: 下一层 attention]。于是第 2、3 层之间会形成两个 GPU split:前一段以第 2 层 attention 链条的第一个节点开头,后一段以 GGML_OP_CPY 开头,那个 CPY 负责把 CPU 上的专家输出搬回 GPU。第 1 层、第 2 层前半、第 2 层后半这三段各有不同的首节点,各自进入一张独立的 ggml_cuda_graph。如果拿 split 序号做键,一旦切分数量变化,序号 1 可能从「第 2 层 attention 段」变成「第 5 层 FFN 段」,图就会被张冠李戴;而按首节点取键,新的计算段自然拿不到旧的捕获对象。
还有一个细节:首节点指针稳定并不等于「同一张 split」——它只说明「这一段计算的入口张量分配在同一个地址」。真正的等价性判定交给后面的 uid/node_props,所以键选得「够稳」就行,不需要精确。
第二道关卡:uid 快捷通道与逐节点比对
// 注:为便于阅读,下面把调试日志与空指针判断等语句合并省略了少许行static bool ggml_cuda_graph_update_required(ggml_backend_cuda_context * cuda_ctx, ggml_cgraph * cgraph) { bool res = false;
const void * graph_key = ggml_cuda_graph_get_key(cgraph); ggml_cuda_graph * graph = cuda_ctx->cuda_graph(graph_key);
// ① uid 相同 → 直接返回 false,不做逐节点比对 if (cgraph->uid != 0 && cgraph->uid == graph->uid) { if (ggml_cuda_graph_debug_enabled()) { GGML_LOG_DEBUG("CUDA Graph id %zu reused\n", cgraph->uid); } GGML_ASSERT((int)graph->node_props.size() == cgraph->n_nodes); return false; }
graph->uid = cgraph->uid;
// ② 节点数变了 → 需要更新 if ((int)graph->node_props.size() != cgraph->n_nodes) { res = true; graph->node_props.resize(cgraph->n_nodes); }
// ③ 逐节点比对属性快照 for (int i = 0; i < cgraph->n_nodes; i++) { ggml_cuda_graph::node_properties prop = {}; memcpy(&prop.node, cgraph->nodes[i], sizeof(ggml_tensor));
for (int j = 0; j < GGML_MAX_SRC; ++j) { if (cgraph->nodes[i]->src[j]) { prop.node_src_data_ptrs[j] = cgraph->nodes[i]->src[j]->data; memcpy(prop.node_src_ne[j], cgraph->nodes[i]->src[j]->ne, sizeof(prop.node_src_ne[j])); memcpy(prop.node_src_nb[j], cgraph->nodes[i]->src[j]->nb, sizeof(prop.node_src_nb[j])); } }
if (res || memcmp(&graph->node_props[i], &prop, sizeof(prop)) != 0) { graph->node_props[i] = prop; res = true; } }
return res;}uid 快捷通道从哪来。 sched->splits[i].graph.uid = ggml_graph_next_uid(); 在 ggml_backend_sched_split_graph 里被逐 split 赋值。而 split_graph 只在 sched_alloc_graph/sched_reserve 中被调用。关键问题是:解码时调度器会每步重新 alloc 吗?不会——ggml_backend_sched_graph_compute_async 的判断是:
if (!sched->is_reset && !sched->is_alloc) { ggml_backend_sched_reset(sched);}if (!sched->is_alloc) { if (!ggml_backend_sched_alloc_graph(sched, graph)) { return GGML_STATUS_ALLOC_FAILED; }}return ggml_backend_sched_compute_splits(sched);只要调度器上一次已经 alloc 过、之后没有被 reset,同一个图结构就在持续复用,split 的 uid 保持不变。于是解码时,绝大多数步骤在 ① 处就短路返回「无需更新」,只做一次 cudaGraphLaunch。
这里的因果链值得写清楚,因为它把「上层图复用」和「下层图回放」连在一起:
llama_context::process_ubatch在can_reuse(gparams)为真时不重建图,sched也不会被 reset,下一步graph_compute_async直接跳过alloc_graph,于是split_graph不再执行,uid 不变;- 一旦
can_reuse为假(序列数、输出数、图参数、记忆上下文任何一项不兼容),res->reset()与ggml_backend_sched_reset都会发生,uid 重新发号,① 不再命中,于是走 ②③ 的逐节点比对; - 逐节点比对的结果,才决定「是不是真的要重新捕获」的后续判定。
也就是说:上层「图能不能复用」的判定,直接决定了后端「图能不能直接回放」的判定是否要付出比对成本。两者用的是两套不同的比较逻辑(llm_graph_params::allow_reuse 比参数,后端比节点属性),但答案在大多数情况下一致。这也解释了为什么代码里对 can_reuse 有一句谨慎的注释:为了让复用正确,图的完整拓扑必须由这些图参数唯一决定。若这个前提被破坏,后端侧还有一次「逐节点比对」兜底,代价是每步一次全图快照比对。
ggml_backend_sched_synchronize 里还有一段相关注释:图没有处于 allocated 状态时,同步之后总把 next_copy 归零,使得生成阶段每次使用同一个拷贝缓冲,避免图因为在两个拷贝之间来回切换而失效。
顺带一提,ggml_backend_sched_synchronize 里有一段相关注释:图没有处于 allocated 状态时,同步之后总把 next_copy 归零,使得生成阶段每次使用同一个拷贝缓冲,避免图因为在两个拷贝之间来回切换而失效。
漏掉 uid 会让什么出错。 如果某个 split 的 uid 恰好被另一张形状不同的图复用了(比如 pp 图与 tg 图的某个 GPU split 在同一调度器上先后 alloc),① 就会误判。llama.cpp 通过两点规避:一是 split_graph 对每个 split 都重新发号,不同形状的图在 alloc 时得到不同 uid,不会在 ① 处错配;二是即便 ① 通过,② 的节点数断言 GGML_ASSERT((int)graph->node_props.size() == cgraph->n_nodes) 也会在节点数不一致时直接 abort,而不是静默回放一张错的图。
属性快照为何存三样。 三项分别覆盖三类「图里会变的东西」:
| 快照字段 | 对应变化 | 典型场景 |
|---|---|---|
node(整个结构体拷贝) | 算子种类、op_params、flags、ne/nb、data 指针变了 | 某个张量被 alloc 到不同地址;MoE 路由的 top_k 参数变化导致算子参数变 |
node_src_data_ptrs | 上游张量的数据地址变了 | 调度器换了拷贝缓冲 cur_copy;KV Cache 写指针不同 |
node_src_ne / node_src_nb | 上游的「形状视图」变了但数据地址没变 | 同一块 buffer 被重新解释成不同形状:batch 从 1 变 4,n_tokens 变了 |
这份快照有多大、比对有多贵。 按结构体字段估算:node_properties 里存了一份完整的 ggml_tensor(含 ne/nb、op_params、src[10] 指针等,几百字节),再加上 10 个源的 data 指针(80 字节)、10 组 ne(10×4×8=320 字节)与 10 组 nb(同样 320 字节),单节点约在 1 KB 量级。一张上千节点的大图,一次全量 memcmp 就是约 1 MB 的内存读。单看它不足以主导一个几十毫秒的解码步,但它与「一次回放省下的提交开销」处在同一量级——若每步都做全量比对,图化的净收益会被抵消掉相当一部分。这就是 uid 快捷通道存在的意义:形态稳定时,比对应当被跳过。
第三项是最容易被忽略的。ggml_tensor 里 ne 表示逻辑形状、nb 表示步长;很多「原地复用的 buffer」在解码时地址不变,但作为某个算子的源时形状含义不同(例如 VIEW 之后 reinterpret 成不同的行数)。如果只比对数据地址,就会漏掉这类差异。
第三道关卡:可捕获性检查
static bool ggml_cuda_graph_check_compability(ggml_cgraph * cgraph) { bool use_cuda_graph = true; for (int i = 0; i < cgraph->n_nodes; i++) { ggml_tensor * node = cgraph->nodes[i]; if (ggml_cuda_is_view_or_noop(node)) { continue; } // [TAG_MUL_MAT_ID_CUDA_GRAPHS] if (node->op == GGML_OP_MUL_MAT_ID) { const int cc = ggml_cuda_info().devices[ggml_cuda_get_device()].cc; if (ggml_cuda_mul_mat_id_needs_sync(node, cc)) { // the mul_mat_id fallback path synchronizes the stream, // so we cannot use CUDA graphs use_cuda_graph = false; ... } } } return use_cuda_graph;}整个检查只排查一种「致命算子」:GGML_OP_MUL_MAT_ID,也就是 MoE 的按专家分组的矩阵乘;同一类算子在别的框架里也有对应实现,比如 vLLM 的 FusedMoE 层与 SGLang 的门控 Router 与按专家对齐。原因是 ggml_cuda_mul_mat_id 有一条 fallback:当类型不是 F32,或本次行数超过 MMVQ/MMQ/MMF 的适用上限时,它会把输入按专家「排序」成一段连续的 get_rows 矩阵乘:ids 的排序索引先在主机上构造出来(std::vector<int32_t> ids_to_sorted_host 那一套),回传 GPU 后还要用 cudaStreamSynchronize 等排序 kernel 完成,再发真正的矩阵乘 kernel。捕获期间不允许这种同步,所以整张 GPU split 直接放弃图化——注意是整张,而不是只有这一个节点退回 eager。
ggml_cuda_mul_mat_id_needs_sync 只做「与内核能力相关的判定」,不做任何形状之外的复杂分析:
static bool ggml_cuda_mul_mat_id_needs_sync(const ggml_tensor * dst, const int cc) { const ggml_tensor * src0 = dst->src[0]; const ggml_tensor * src1 = dst->src[1];
if (src1->type != GGML_TYPE_F32 || dst->type != GGML_TYPE_F32) return true;
if (dst->ne[2] <= MMVQ_MAX_BATCH_SIZE) { if (ggml_is_quantized(src0->type)) { if (dst->ne[2] <= get_mmvq_mmid_max_batch(src0->type, cc)) return false; } else if (GGML_CUDA_CC_IS_AMD(cc)) { return false; } } if (ggml_cuda_should_use_mmq(src0->type, cc, src1->ne[2], /*n_experts=*/src0->ne[2])) return false; if (ggml_cuda_should_use_mmf(src0->type, cc, warp_size, src0->ne, src0->nb, src1->ne[2], /*mul_mat_id=*/true)) return false; return true;}注意它关注的是 dst->ne[2],也就是这次 MoE 层要处理的行数(token 数 × 每 token 专家数),而不是「专家数量」。对解码阶段,ne[2] 通常只有几行到几十行,必然能落进 MMVQ 的快速路径,因此不会触发关闭;而预填充大批量时 ne[2] 很大,可能进 MMQ/MMF——只要进了这三条任何一条,就 return false(无需同步)。真正导致关闭的是「三条快速路径都不满足」,常见于非常规 dtype(比如非 F32 的输出)或 AMD 上非量化的特殊组合。
mmq / flash-attn 这些 kernel 的内部细节已在 llama.cpp 源码完全拆解(七):后端与 Kernel 里拆过,这里只需要记住一个结论:MoE 层的图化与否,取决于 MoE 矩阵乘当时走的是哪条 kernel(MMVQ/MMQ/MMF),而这又与「量化类型 + 硬件 + 本次行数」三者共同决定。对同一份模型、在同一个 GPU 上,解码时基本恒定,所以要么一直能图化,要么一直不能;但每次开关 --n-cpu-moe 或更换量化版本,都可能改变结论。
第四道关卡:热身状态机——为什么必须连续两次稳定
static enum ggml_status ggml_backend_cuda_graph_compute(ggml_backend_t backend, ggml_cgraph * cgraph) { ... graph_key = ggml_cuda_graph_get_key(cgraph); ggml_cuda_graph_set_enabled(cuda_ctx, graph_key); ggml_cuda_graph * graph = cuda_ctx->cuda_graph(graph_key);
if (graph->is_enabled()) { const bool graph_compatible = ggml_cuda_graph_check_compability(cgraph); if (graph_compatible) { const bool properties_changed = ggml_cuda_graph_update_required(cuda_ctx, cgraph);
if (!graph->warmup_complete) { // Warmup: need at least 2 calls with no property change on the 2nd call if (!properties_changed) { graph->warmup_complete = true; use_cuda_graph = true; cuda_graph_update_required = true; } } else { if (properties_changed) { graph->warmup_complete = false; // 属性变了 → 重置热身 } else { use_cuda_graph = true; cuda_graph_update_required = graph->instances.empty(); } } } } ...}这段逻辑可以这样理解。第一次遇到某张图时,update_required 必然返回 true:这个 ggml_cuda_graph 是新对象,uid 为 0、node_props 为空,逐节点比对必然发现「全部需要更新」,于是本次只做 eager 执行、顺便把第一轮属性写进快照。第一次不能直接捕获,因为「这张图第一次被跑」时的状态往往还不是稳态:cuBLAS/cuBLASLt 的句柄与 workspace 可能在这时初始化、部分内核模块可能尚未加载、调度器的 buffer 也可能在这一步才定型。要求「第二次属性仍然一致」才捕获,相当于用一次完整的前向确认「地址与形状已经稳定」,避免把只属于首轮的状态录进图里。
- 第 1 次:
update_required=true,不捕获,eager 执行,记下属性; - 第 2 次:
update_required=false→ 置warmup_complete=true,捕获并执行; - 第 3 次起:
update_required=false→cuda_graph_update_required = instances.empty(),此时instances非空,直接cudaGraphLaunch回放。
如果中途属性变了:warmup_complete 被重置为 false,下一次又回到 eager 执行、重新记快照。这种「变了就重新热身」的代价是:形状频繁变动的场景(比如每步 n_tokens 都不同的 prefill)根本到不了回放——每次都是 eager。这是 llama.cpp 的图化只对解码阶段(batch 稳定、n_tokens 固定)有效的原因。
还要补一个只在上方骨架里省略掉的细节:架构判定写在 ggml_cuda_graph_set_enabled 里,而不是 is_enabled() 中。该函数在 instances 还是空的时候(也就是这张图第一次出现)检查设备计算能力,低于 Volta(compute capability 7.0)就把 disable_due_to_gpu_arch 置真;之后 is_enabled() 会一票否决。把这段逻辑放在「首次出现」时做,是为了避免每步重复查询设备属性,也避免在已有实例之后突然改变策略。
第五道关卡:捕获主循环——融合、并发流、分块
真正的执行与捕获逻辑在 ggml_cuda_graph_evaluate_and_capture。它的外层是这样的:
while (!graph_evaluated_or_captured) { // Only perform the graph execution if CUDA graphs are not enabled, or we are capturing the graph. if (!use_cuda_graph || cuda_graph_update_required) { ... for (int i = 0; i < cgraph->n_nodes; i++) { ggml_tensor * node = cgraph->nodes[i];
// ① 分块边界 if (use_cuda_graph && chunk_size > 0 && i >= chunk_end && !is_concurrent_event_active) { ggml_cuda_graph_launch_chunk(cuda_ctx, graph, n_chunks++); CUDA_CHECK(cudaStreamBeginCapture(cuda_ctx->stream(), cudaStreamCaptureModeRelaxed)); chunk_end = i + chunk_size; }
// ② 并发流的 fork / join if (is_concurrent_event_active) { if (node == concurrent_event->join_node) { ... // 汇合:record join_events + streamWaitEvent is_concurrent_event_active = false; } else { cuda_ctx->curr_stream_no = concurrent_event->stream_mapping[node]; } }
prev_i = i;
// ③ 视图/no-op 节点直接跳过 if (ggml_cuda_is_view_or_noop(node)) continue;
// ④ 非计算标志的节点直接跳过 if ((node->flags & GGML_TENSOR_FLAG_COMPUTE) == 0) continue;
// ⑤ 融合尝试:返回跳过多少个后续节点 int nodes_to_skip = ggml_cuda_try_fuse(cuda_ctx, cgraph, i); if (nodes_to_skip != 0) { i += nodes_to_skip; continue; }
// ⑥ 普通单节点执行 bool ok = ggml_cuda_compute_forward(*cuda_ctx, node); GGML_ASSERT(ok); }
if (use_cuda_graph && cuda_graph_update_required) { // End CUDA graph capture ggml_cuda_graph_launch_chunk(cuda_ctx, graph, n_chunks++); // drop the chunks left over from a longer graph for (size_t i = n_chunks; i < graph->instances.size(); ++i) { CUDA_CHECK(cudaGraphExecDestroy(graph->instances[i])); } graph->instances.resize(n_chunks); graph_evaluated_or_captured = true; } else { graph_evaluated_or_captured = true; } }
if (use_cuda_graph && !cuda_graph_update_required) { // the chunks were launched during capture, otherwise launch them here for (cudaGraphExec_t instance : graph->instances) { CUDA_CHECK(cudaGraphLaunch(instance, cuda_ctx->stream())); } }}这里面有几个非常值得展开的点。
融合让「哪些节点会被发射」这件事本身成了图的一部分
ggml_cuda_try_fuse 从当前的节点 i 出发,识别一段模式(比如 MUL_MAT_ID → MUL_MAT_ID → GLU 合并成一次路由专家 + 共享专家的 mmvq;或者 RMS_NORM → MUL → ROPE(VIEW) → SET_ROWS 合并成一个 kernel;或者 gated_delta_net → cpy 合并成带状态落盘的算子),命中则执行融合 kernel,并返回被吸收的后续节点数量。主循环直接 i += nodes_to_skip; continue;,那些节点既不会各自发射 kernel,也不会被当成视图跳过。
在捕获模式下这产生了一个微妙后果:「被融合的节点里是否包含分块边界」。假如分块在节点 512 处切,而节点 500 开始的融合吸收到节点 515,那么:
- 按「每个 chunk 都是独立的 CUDA 图」来看,节点 501~515 在执行上由一个 kernel 完成,它只能被录进其中一个 chunk;
- 主循环的切块判断在
i >= chunk_end时才触发,而融合路径直接跳过了i后面的节点,因此切块不会发生在一个融合内部。也就是说,融合的「原子性」自然保证了切块边界的合理性:chunk 只会切在「不被任何融合吸收的节点之前」。 - 融合的匹配条件可能依赖当前 batch 大小(比如
ggml_cuda_should_fuse_mul_mat_vec_q检查n_tokens是否在 MMVQ 的适用范围内),因此「本次是否会融合」在运行时才定。但要注意:这种「执行期融合」不改变 ggml 图的节点列表,只改变「哪些节点真的发射了一次 kernel」,所以node_props的长度不会因此变化。真正会让属性比对失败的是形状与地址变化:batch 从 1 变 2,源张量的ne变了,第 ② 步的memcmp立刻判定「需要更新」,于是重新捕获,并在新一次捕获里按新 batch 重新做融合决策。注释里那句「the MMVQ batch size check is done inggml_cuda_try_fuse」说的正是这个分工:规划期(graph_optimize,影响 buffer 依赖与拓扑)的融合判断必须与 batch 无关;执行期(try_fuse,只影响本次发射哪条 kernel)的 batch 判断可以放开,由属性比对兜底。
还有一个与「可捕获性」耦合的点:融合判断里如果包含主机侧回读(例如某些融合需要先知道排序结果),就不能在图内使用。像 ggml_cuda_match_shared_expert 这种「只在没有并发流时尝试」的融合(concurrent_events.empty()),是为了让同一段代码既能用于多流区域,又不至于让融合和多流状态互相干扰。
并发流区域:以事件建模的多流,必须整段处于一个 chunk 中
多流区域来自 ggml_backend_cuda_graph_optimize:调度器在切好 split 后,对 GPU 后端调用一次优化回调,GPU 后端分析 split 图,找出「一段分叉 → 汇合」的结构(典型的是注意力里 K、V 的取投影分支),为它建立 ggml_cuda_concurrent_event:
ggml_cuda_concurrent_event concurrent_event(nodes_per_branch.size());concurrent_event.join_node = join_node;for (size_t branch_idx = 0; branch_idx < nodes_per_branch.size(); branch_idx++) { for (const ggml_tensor * n : nodes_per_branch[branch_idx]) { concurrent_event.stream_mapping[n] = branch_idx + 1; // 分支 0 对应流 1 }}...concurrent_events.emplace(root_node, std::move(concurrent_event));主循环的做法是:
- 遇到 fork 节点:在主流(
curr_stream_no == 0)上cudaEventRecord(fork_event),每条分支流cudaStreamWaitEvent(fork_event); - 分支内的节点:把
curr_stream_no切换到对应分支流,kernel 发射到该流; - 遇到 join 节点:每条分支流 record 自己的 join event,主流 wait 这些事件,
curr_stream_no归 0。
在捕获模式下,这套事件也是「被录进图里」的节点,所以一个 fork—join 区域必须是连续的、且完整属于同一个 chunk。主循环对此的写法就是切块条件里那个 && !is_concurrent_event_active:处于并发区域内部时,即使到了 chunk 边界也不切块;只有等 join 之后,才在下一个节点处切块。注释也写得很清楚:「a concurrent region must join before its capture can end」。
这里有一个容易忽略的时序前提:并发事件不是每个 graph_compute 都重算的。ggml_backend_graph_optimize 由调度器在 split_graph 里、alloc_graph 拆分之后调用一次(与 uid 的重新发号同频);之后解码的每一步只要调度器没有再次 alloc,就沿用这批事件。主循环对它们的有效性做了一个防御:
- 先检查
stream_ctx.concurrent_events里每个事件的is_valid(); - 若有效,则在遍历前先把并发区域里被「交错排放」的节点按
original_order还原成原始顺序(把同一条分支的节点排成连续的),这样ggml_cuda_try_fuse才能在分支内部继续做融合; - 若某条事件的
original_order在当前图里找不到全部对应节点,就跳过该区域,不做切流。
若整个集合为空,则直接 concurrent_events.clear(),此时图里没有分叉区域,也就不会有块内部切流。这段逻辑说明:concurrent_events 与 node_props 一样,都是「在一次 alloc 的生命周期内有效」的状态,调度器一旦重新 alloc,它们就失去意义——只不过前者在 graph_optimize 里被重新生成,后者在 update_required 里被重新比对。
再看一个副作用:并发区域的存在会影响分块边界的位置。切块条件里带了 !is_concurrent_event_active,因此在 fork—join 区域内部不切,等到区域结束后才在下一个节点切;若块容量本来恰好用完、又正处在区域中间,这个块就会多装一段。所以默认的 512 并不保证「每块一定不超过 512」,而是「在不违反融合与并发约束的前提下,大约每 512 个节点切一次」。对常见的解码图(每层十几到几十个节点、7080 层,总计几百到上千个节点),这通常意味着 12 块;只有在超长的 prefill 图或混合批里才会出现多块。
分块:为什么是「多张图」,而不是「一张图」
ggml_cuda_graph_chunk_size 默认返回 512:
static int ggml_cuda_graph_chunk_size() { static const int chunk_size = [] { const char * env = getenv("GGML_CUDA_GRAPH_CHUNK_SIZE"); return env != nullptr ? atoi(env) : 512; }(); return chunk_size;}设为 0 表示把整张 ggml 图作为一个 CUDA 图。注释给出了分块的理由:「the GPU can run one chunk while the next is enqueued」。CUDA Graph 虽然把提交开销压到了单次 launch,但一次 launch 里 kernel 仍然按图内拓扑顺序执行;当一张图非常长(比如上千个节点),而 CPU 侧还有下一块准备发出时,多张可执行图可以让「上一块的 GPU 执行」与「下一块的 CPU 提交」并行起来。这是「软件流水」思想在捕获层面的落地。
分块带来的最大工程问题是:每块都是一个独立的 cudaGraphExec_t,必须能独立重放。这意味着:
- 块边界两侧的依赖必须通过「本块输入缓冲 + 上块输出缓冲」在块外显式保持。ggml 调度器为每个 split 分配的 buffer 是整段共享的,所以只要本块里每个张量的
data地址都不变,块边界处的依赖自然成立。 - 块数变化时,旧的多余块必须销毁(主循环里
drop the chunks left over from a longer graph的那段):n_chunks减少时把instances[n_chunks..]销毁并resize(n_chunks)。如果不销毁,多出来的块会一直占着被实例化的资源。 - 融合不能跨块:一旦某融合吸收的节点横跨边界,切块逻辑就不会在其中切开(前面讲过);但如果块边界恰好落在「某融合的起始节点之前」,那融合本身也只会出现在一个块里,不会出现「半个融合」。
每块的捕获与更新:cudaGraphExecUpdate 的两种结局
static void ggml_cuda_graph_launch_chunk(ggml_backend_cuda_context * cuda_ctx, ggml_cuda_graph * graph, size_t idx) { cudaGraph_t cuda_graph = nullptr; CUDA_CHECK(cudaStreamEndCapture(cuda_ctx->stream(), &cuda_graph));
if (idx < graph->instances.size()) { ggml_cuda_graph_update_executable(graph->instances[idx], cuda_graph); } else { GGML_ASSERT(idx == graph->instances.size()); graph->instances.emplace_back(nullptr); CUDA_CHECK(cudaGraphInstantiate(&graph->instances[idx], cuda_graph, nullptr, nullptr, 0)); } CUDA_CHECK(cudaGraphDestroy(cuda_graph));
CUDA_CHECK(cudaGraphLaunch(graph->instances[idx], cuda_ctx->stream()));}注意这里的 EndCapture 是「先结束、马上 launch」。捕获出来的块在本次也会被执行——这就是为什么主循环里 if (!use_cuda_graph || cuda_graph_update_required) 的条件下,捕获块也在走一遍执行路径;捕获过程本身就在把 GPU 工作跑一遍。
ggml_cuda_graph_update_executable 是「更新优先、重建兜底」的典型实现:
static void ggml_cuda_graph_update_executable(cudaGraphExec_t & instance, cudaGraph_t cuda_graph) { cudaGraphExecUpdateResultInfo result_info; cudaError_t stat = cudaGraphExecUpdate(instance, cuda_graph, &result_info);
if (stat == cudaErrorGraphExecUpdateFailure) { // The pre-existing graph exec cannot be updated due to violated constraints // so instead clear error and re-instantiate (void)cudaGetLastError(); CUDA_CHECK(cudaGraphExecDestroy(instance)); instance = nullptr; CUDA_CHECK(cudaGraphInstantiate(&instance, cuda_graph, nullptr, nullptr, 0)); } else { GGML_ASSERT(stat == cudaSuccess); }}cudaGraphExecUpdate 的语义是:把一张新录制的 cudaGraph_t 的节点参数与依赖边更新到已有的 executable 上。更新规则里最常用的几条是:节点数一致(或不一致但可替换)、节点类型一致、节点之间的边拓扑一致,允许参数(指针、形状、kernel 参数)不同。任何一项不满足就返回 cudaErrorGraphExecUpdateFailure(旧签名里也返回具体失败的节点)。
这从另一个角度解释了 node_props 为什么要逐节点比对:比对是用来决定「要不要重新捕获」的;而「要不要走 Update 还是 Instantiate」取决于本次捕获结果与旧 executable 的拓扑差异。两者是两层:
- 比对不变 → 根本不重新捕获,直接 launch;
- 比对变了 → 重新捕获一块 → 尝试 Update,Update 成功就复用 executable,失败就 Instantiate 新建。
在 llama.cpp 里,「比对变了」的常见来源是数据地址变了(比如调度器换拷贝缓冲、KV 写指针换位置)而拓扑一样,这时 Update 成功,成本很低;而「拓扑变了」(比如 n_tokens 变了导致某个 split 的节点数变了、或者说融合结论变了)时,Update 失败,退化为 Instantiate。所以真正高频的是「Update 路径」,而 Instantiate 的毫秒级开销只在形状真正改变时出现。
捕获前后与显存池的耦合
ggml_cuda_graph 的生命周期还和显存池绑在一起。CUDA 图里记录的是 buffer 的具体地址,如果这块 GPU 内存被池子回收给别的用途,图再回放就会踩到别人的数据。所以 ggml_cuda_pool 在以下两种情况下都会把所有 cuda_graphs 清空:
void invalidate_cuda_graphs() { int n_captured = 0; for (const auto & [key, graph] : ctx.cuda_graphs) { n_captured += graph->instances.size(); } if (n_captured > 0) { GGML_LOG_DEBUG(GGML_CUDA_NAME " pool[%d]: memory freed, %d captured CUDA graphs " "must be captured again\n", device, n_captured); } ctx.cuda_graphs.clear();}一是 alloc 失败(cudaErrorMemoryAllocation)时先 cudaDeviceSynchronize()、clear_pool(),再 invalidate_cuda_graphs() 后重试分配;二是 free 时池子满了(超过 MAX_BUFFERS)无法缓存、只能 cudaFree。两个场景的共同点是「池子里的地址会发生变化」,因此所有基于 pool 地址录下的图全部作废。注意 clear() 销毁的是 ggml_cuda_graph 对象,其析构函数会把 instances 里每个 cudaGraphExec destroy 掉——地址回收是显存的,但图资源的回收由这套析构负责。
这条规则对推理部署有直接含义:显存紧张时(例如并发请求突增、临时 buffer 扩容),一次池子回收就会让接下来的若干步退回 eager 跑,因为图被全部清空、需要重新经历「热身两次 + 捕获」。这不是 bug,而是「图里地址即身份」这一语义的必然代价。也正因为如此,llama.cpp 在构建上下文时就分别用 pp 与 tg 两张最坏情况图各做一次 reserve,把 buffer 峰值一次性撑到最大,运行期尽量不再 realloc——这段记忆系统与图预留的细节在 llama.cpp 源码完全拆解(四):llama_context 与记忆系统 里有完整拆解。
图对象按需创建、按时间淘汰
ggml_cuda_graph * cuda_graph(const void * first_node_ptr) { const int64_t time_now = ggml_time_us();
// sweep every 5s, evicting cuda graphs unused for >=10s if (time_now - last_graph_eviction_sweep >= 5'000'000) { last_graph_eviction_sweep = time_now; for (auto it = cuda_graphs.begin(); it != cuda_graphs.end(); ) { if (time_now - it->second->last_used_time >= 10'000'000) { it = cuda_graphs.erase(it); } else { ++it; } } }
auto it = cuda_graphs.find(first_node_ptr); if (it == cuda_graphs.end()) { it = cuda_graphs.emplace(first_node_ptr, std::make_unique<ggml_cuda_graph>()).first; } it->second->last_used_time = time_now; return it->second.get();}这是一个很朴素的「LRU 近似」:5 秒扫一次,10 秒没用的图删掉。动机很好理解:llama.cpp 的一个 server 实例同时跑多个 slot、多个序列,不同的 n_tokens 组合可能产生几十种不同的图;这些图里每个 cudaGraphExec 都要占用驱动侧资源(主机内存与内部对象),不做回收会越积越多。10 秒的阈值意味着「短时间内的请求形态波动」不会导致图被销毁,而「长时间换了一种负载」则会被自动清掉,回到冷启动的两步热身。
这里与前面的 last_used_time 字段呼应:捕获、回放、比对,每次都会更新它,从而保证正在用的图不会被回收。
调试与观测:怎么确认一张图到底走没走回放
源码里留了三类观测手段,排查「为什么图化没生效」时可以直接拿来用。
第一类,环境变量开关。 GGML_CUDA_DISABLE_GRAPHS 存在即全局关闭(注意 is_enabled() 里用的是 getenv(...) != nullptr,哪怕设成 0 也会关闭,这是很多人的坑);GGML_CUDA_GRAPH_DEBUG 打开图路径内部的关键事件日志(架构禁用、热身完成/重置、uid 复用、Update 失败、池回收导致图失效等);GGML_CUDA_GRAPH_CHUNK_SIZE 调整每块节点数,设 0 表示整图一块;GGML_CUDA_DISABLE_FUSION 关闭融合,用来验证「某个回放异常是否与融合有关」。上层的 LLAMA_GRAPH_REUSE_DISABLE 则关闭 llama_context 层的图复用,构造出「每步都重新比对」的最坏情况,常用于排查属性比对是否漏项。
第二类,统一的性能统计。 llama_perf_context_print 会输出 graphs reused = N 与 graph reallocs = <same> / <changed>。graphs reused 来自 process_ubatch 复用分支里的 n_reused++,度量的是上层图复用次数;graph reallocs 来自 sched_graph_realloc 回调,第一个数字是「图大小没变却重新分配」(n_reallocs_same),第二个是「图大小变了」(n_reallocs_diff)。前者才是最危险的那一类:大小没变、却重新 alloc,说明 buffer 预算不够或后端归属不稳定,这会连带导致后端侧的图反复重新热身。
第三类,GGML_CUDA_DEBUG 编译宏。 融合命中时会打 nodes_fused: N, first: ..., last: ...,用来看某一版图里到底有哪些融合生效、融合链有多长。它与「属性快照比对结果」配合,能快速回答「这次为什么判定图变了」。
这三类手段组合起来,一个典型排查路径是:先看 graphs reused 是否随步数增长(不增长说明上层就不在复用,看 can_reuse 参数),再看是否出现 n_reallocs_same(出现就先查 buffer 预算与显存池),最后用 GGML_CUDA_GRAPH_DEBUG 确认后端侧命中的是回放分支还是热身分支。另外,llama-graph.cpp 里 llm_graph_result::can_reuse 在调试级别大于 0 时会逐输入打印 can reuse graph = 0/1,可以精确定位是哪个输入张量让上层复用失败。
真实代码里最容易踩的四处
① 断言与 abort 的位置:GGML_ASSERT((int)graph->node_props.size() == cgraph->n_nodes)
在 update_required 的 uid 快捷通道里。如果键命中但节点数不一致,说明「同一个首节点下出现了结构不同的两张图」——在拓扑随配置变化(如设备分配改变、融合开关变化)时理论上可能出现。源码选择 abort 而不是静默处理,因为此时图已被错误地关联到同一个 ggml_cuda_graph,如果继续执行,回放的一定是错的图。这属于「设计上不应该出现,出现就立刻停」的保护。
② cudaGraphExecUpdate 失败后的错误必须清理
(void)cudaGetLastError(); 那句不是多余的。CUDA runtime 返回 cudaErrorGraphExecUpdateFailure 后,错误会留在线程本地的 last error 上;后续任何 CUDA_CHECK 都会读到它并误报。所以重建之前必须清掉。
③ 融合函数返回值的语义不是「融合了多少节点」,而是「主循环应跳过的节点数」
return 5; 表示从当前 i 起共 6 个节点(含 i)由一次融合 kernel 完成,主循环 i += nodes_to_skip 后 ++i,下一个处理的正是 i + 6。写死数字(而不是 sizeof(array) - 1 推导)在这个文件里很常见,因为融合函数的模式是显式列出的;但这使得「模式扩展」时必须同步改返回值。任何一次改错都会导致「少跳一个 → 重复发射」或「多跳一个 → 漏发」,而后者在图里尤其危险:漏发的节点可能在后面仍被当成已产出,结果被后续 kernel 读到未初始化数据。
④ 在捕获模式下,curr_stream_no 与「非 0 流的切换」必须与块边界安全配合
主循环在 is_concurrent_event_active 为真时不允许切块。如果不是这样,块边界落在分支内部就会出现:前一块录入了 fork 与部分分支、后一块直接从「流号已经不在 0」的状态开始录制,导致后一块的录制缺少 fork 事件,回放时它要等到一个从未被 record 的 fork event。
融合与图拓扑:为什么必须在建图期定死
再往上追一层,会看到一个很值得注意的设计:llama_context 在 reserve 阶段调用了 resolve_fused_ops(mctx, n_seqs),它会针对每一种「融合探测」(llm_fused_op_probe),用对应的 n_tokens_per_seq * n_seqs 先建一张测试图(split_only = true,只切分、不分配),检查该融合是否真的落到了与层所属设备一致的 backend 上;若发现「融合节点被切到了别的设备」,就关闭这个融合。建图侧(llama-graph.cpp)因此会按「这一层是否启用某融合」来生成不同的节点序列。
这一步的存在说明:会改变图拓扑的融合,必须在建图期就定下来。resolve_fused_ops 之所以要「先建一张测试图、看融合节点落在哪个设备上」,是因为一旦融合节点被调度器切到了与层不一致的设备,这段融合在语义上就不再等价——必须关掉它、退回到未融合的节点序列。这个决策必须在建图时完成,因为建图决定了节点列表,而节点列表又决定了切分、buffer 分配与后端侧的 node_props 长度。
反过来说,后端 try_fuse 里那些「执行期融合」是另一类:它们不改变 ggml 图节点列表,只改变「这一轮哪些节点被一次 kernel 吸收」。这类判定允许依赖 batch(例如 MMVQ 的行数上限),因为它的结果不会写进图拓扑;一旦 batch 变化,源张量的 ne 先被属性比对捕获,图会重新捕获并重新做决策。两层机制合起来就是:「拓扑级融合在建图期固化,发射级融合在运行期决定,且由属性比对保证运行期决策不会被旧图复用」。
关掉融合来排查,是有效的对照实验
GGML_CUDA_DISABLE_FUSION 常被当作「关融合看看有没有问题」的开关,在排查图化故障时它也确实是一个好用的对照,但要说清楚它能对照出什么、不能对照出什么:
- 能对照的:融合改变了「哪些 ggml 节点会被跳过」,因此改变了实际发射的 kernel 序列,也改变了分块边界落点(切块只在不被融合吸收的节点前触发)。如果「开融合时回放正常、关融合时异常」,优先怀疑块边界与并发事件、以及捕获时
curr_stream_no的切换位置。 - 不能对照的:执行期融合(
try_fuse里的 MMVQ/MMF 选择、GLU 合并等)不会改变 ggml 图的节点列表,所以它不会改变node_props的长度,也不会让属性比对「因为融合不同而判定图变了」。属性比对只看节点、源指针与形状;形状一变(batch 变),它无论如何都会判定「需要更新」。
真正会改变「图拓扑」的,是建图期就能决定的融合(resolve_fused_ops 与模型图里显式生成的融合节点)以及 graph_optimize 给分配器登记的依赖;这部分必须与 batch 无关,否则每次 ubatch 变化都会触发 buffer 重新 reserve,连带把已经捕获的图全部作废。
与站内其它框架的对照:llama.cpp 的图路径「特殊」在哪
把 llama.cpp 放进五个框架的图化方案里看,它最大的不同就是没有「桶」。vLLM 在编译时枚举一批 batch size 档位、每次 decode 按真实 batch 查表取对应的静态图,这套桶表与 padding 的完整拆解见 CUDA Graph 的桶与垫:五个推理框架如何把动态解码批塞进静态图;TensorRT-LLM 把「一档批形态一张图」做成了 BufferManager 的显存预算项;llama.cpp 的前端(llama-server)则把多序列解码拼进同一个 ubatch,让后端看到的是「一个稳定的 n_tokens」。
llama.cpp 则是:
- 按首节点地址+属性快照懒创建:没有启动期的枚举,没有桶表。第一次遇到某种形态就热身两次、捕获一次;
- 用 Update 取代「每档一张图」:拓扑不变就更新现有 executable,避免几十种
n_tokens组合下捕获资源无序膨胀; - 用分块取代「整图一张」:超过 512 个节点的大图被拆成多张,靠块边界外的 buffer 维持流水。
这套设计的直接好处是「零配置」;直接代价是:
- 只对稳定形态有效,解码时
n_tokens必须稳定(每序列 1 token,参与合批的序列数决定它),一旦序列数变化,上层can_reuse与后端属性比对都会判定「变了」,重新热身; - 没有对动态 batch 的「垫」机制,无法像 vLLM 那样把 batch 3 垫到 batch 4 复用图;
- 错误比较「响」:比对断言、可捕获性检查都倾向于「宁可退化也不错放」,代价是某些 MoE 配置下完全放弃图化。
缓冲这一侧的处理可以用另一篇对照:TensorRT-LLM 的 BufferManager 如何把 KV 池、workspace 与 CUDA Graph 缓冲装进同一份预算 讲的是「让图里的地址在整段生命周期里不动」,而 llama.cpp 讲的是「当地址真的动了之后,怎样让这张图重新变得可用」。
这也解释了为什么 llama.cpp 的图化对「单会话长解码」的效果最好:此时 batch=1、序列数=1、形态完全稳定,一旦热身完成,回放路径就长期成立;而多并发的 server 场景,形态变化频繁,图化收益会被热身和重建的代价抵消一部分。
不过在 llama_context 层面,llama.cpp 用了一个与 vLLM「桶」功能类似但实现完全不同的手段:把多个序列的解码拼进同一个 ubatch。llama.cpp 源码完全拆解(八):服务化与调度 里拆过 server-context 如何把多序列的解码合批、如何触发 prefill 并让出 GPU;当多个 slot 的解码被合并成一次前向时,n_tokens 等于参与批处理的序列数,只要这个数字稳定,后端的图就能长期命中回放。反过来说,并发数频繁变化的 server,正是 llama.cpp 图化最不擅长的工作负载——这也是它更偏向「先保证正确性再谈图化收益」的设计取向。
再横向看一眼 DeepInfer 的做法可以形成对比:DeepInfer 的 CUDA Graph 捕获与重放 把「捕获哪些形状、什么时候捕获、是否用 cudaGraphExecUpdate 热更新」都做成了显式配置与调度器已知的状态,而 llama.cpp 把这些判断全部推迟到后端运行时。两者在语义上要做同一件事——确认「一步计算能否安全地复用上一次的记录」——只是前者把判断放在调度器、后者放在算子图属性上。
小结
用一张图把本篇的关键结构串起来:
sched graph_compute_async(sched, gf) └─ per split: ggml_backend_cuda_graph_compute(backend, &split.graph) ├─ graph_key = split.graph.nodes[0] ├─ graph = cuda_graph(graph_key) // 懒创建 + 10s 淘汰 ├─ is_enabled() // Volta- 或 GGML_CUDA_DISABLE_GRAPHS ├─ graph_check_compability() // 只有 MUL_MAT_ID 的同步 fallback 会关闭 ├─ update_required() │ ├─ uid 相同 ? → false │ └─ 逐节点: node 结构体 + src data 指针 + src ne/nb ├─ warmup: 连续 2 次无变化后才开始捕获 └─ evaluate_and_capture() └─ for node in graph: ├─ 分块(512 节点、不切开并发区域与融合) ├─ 并发区域:fork/join 事件、切流 ├─ 跳过 view/noop、跳过非 COMPUTE ├─ try_fuse → 命中则 i += nodes_to_skip └─ compute_forward(node) └─ 每块: EndCapture → Update 或 Instantiate → Launch这一整套「键 + 快照 + 块 + Update」的机制,本质是在 CUDA Graph 静态语义与 llama.cpp 动态执行形态之间做适配。理解了它,再去看 vLLM 的 BatchDescriptor 分派、TensorRT-LLM 的 BufferManager 预算、DeepInfer 的 CUDA Graph 捕获与重放,就能看出各框架只是把「图身份由谁决定」这件事放在了不同层次:vLLM 放在调度器的 batch 维度上,llama.cpp 放在后端的节点属性上。两者都在回答同一个问题——这一步的计算,能否安全地借用上一次录好的图。
参考资料
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



