


SGLang 源码完全拆解(二十):门控 Router 与按专家对齐——三份路由账本、五种输出格式与 moe_align_block_size 的排序账
承接:从”专家放在哪”回到”token 去找谁”
SGLang 子系列走到第十九篇为止,请求主线与并行主线都已经闭合:请求经 TokenizerManager 分词、由 ZMQ 送进 Scheduler,调度器把 token 预算与 KV 页交给 PrefillAdder 与 RadixCache,TpModelWorker 与 ModelRunner 组装 ForwardBatch 交给各层执行;注意力侧的后端、KV 池、前缀缓存都有独立篇目;并行侧先讲 DP Attention 与专家并行(SGLang 源码完全拆解(十七):DP Attention 与专家并行),再讲弹性 EP 与故障恢复(SGLang 源码完全拆解(十八):弹性 EP 与故障恢复)。
这两篇解决的是 MoE 的物理侧:专家由谁持有、放在哪张卡上、重排时怎么搬。但一个 token 进入 MoE 层后,第一件事是回答逻辑侧的问题:这一层的 256(或 512、896)个专家里,它应该去投哪几个。SGLang 里这个决定主要由 python/sglang/srt/layers/moe/topk.py(约 3200 行)做出,打分与 top-k 的具体内核则落在 python/sglang/kernels/ops/moe/ 下的 JIT kernel 里。
本篇是第一篇专讲 MoE 的单框架文章,聚焦路由的前半程:从门控 logit 到”可以交给分桶内核”的 topk_ids 与 topk_weights,再往后一小步到 moe_align_block_size 产出的按专家排序表。分组 GEMM 本体、EP 通信、EPLB 重排作为下一阶段的主题;这里只到”账本交出去”为止。
之所以值得专门写这一层,是因为它看起来只是”取前 k”,实际却把六件容易混在一起的事压在几行调用里:
- 门控分数怎么从 logit 变成”愿望值”(softmax / sigmoid / sqrtsoftplus);
- DeepSeek 式的分组选组、修正偏置”只参与选、不参与算”;
- 选定后要不要归一、归约的起点与 epsilon;
- 共享专家是拼进 topk 输出、还是另外走一条路;
- 逻辑专家号什么时候变成物理槽位(EPLB);
- 交给下游时,是标准三元组、紧凑压缩格式、还是干脆不路由。
下面按”打分 → 选择 → 后处理 → 对齐”四段走一遍源码,所有代码引自仓库当前版本(python/sglang/ 目录,2026 年 10 月的开发分支),少量简化只体现在省略号,不改变语义。
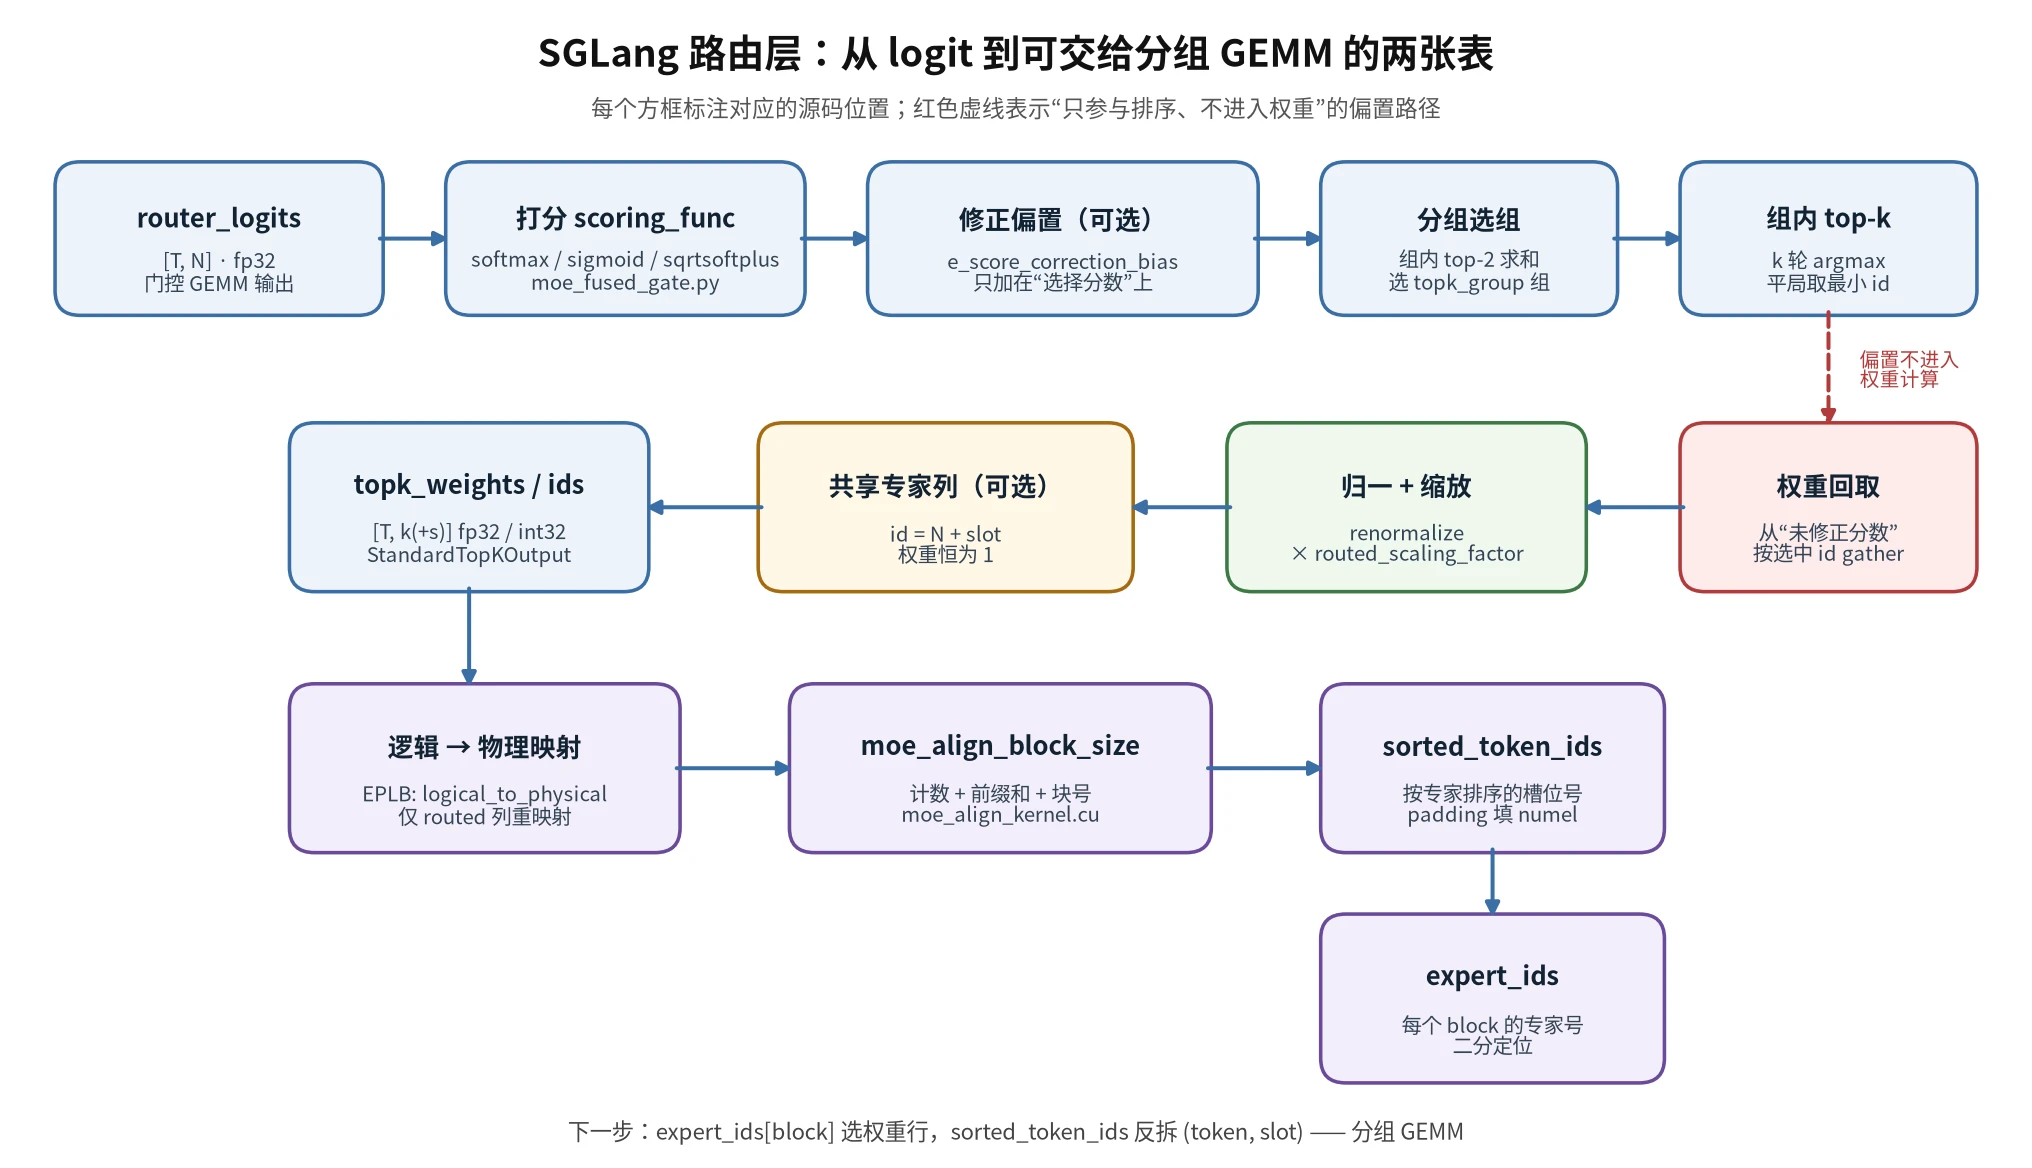
图中的红色虚线是整篇最需要记住的一条路径:修正偏置进入”选组 / 选专家”的比较,却在”权重回取”时从 activated(未修正分数)取值;下游的 topk_weights 因此只反映模型原始分数,偏置不会改变输出幅度。
门控这一步在推理里要满足什么约束
先把”为什么不能简单写torch.topk”说清楚,后文所有取舍都围绕这几点。
稠密 FFN 每层是两个矩阵;MoE 把它换成 (N) 个专家加一张门控矩阵 (W_g \in \mathbb{R}^{N \times d})。一个 token 的隐状态 (x \in \mathbb{R}^d):
(g) 的第 (j) 个分量表示”这个 token 有多想去专家 (j)“。从 (g) 到真正算完,中间有选择(256 选 8)、权重(归一)、分桶、逐专家 GEMM、加权合并几步。门控层只负责前两步,但它的输出格式直接决定后面能不能按块切。
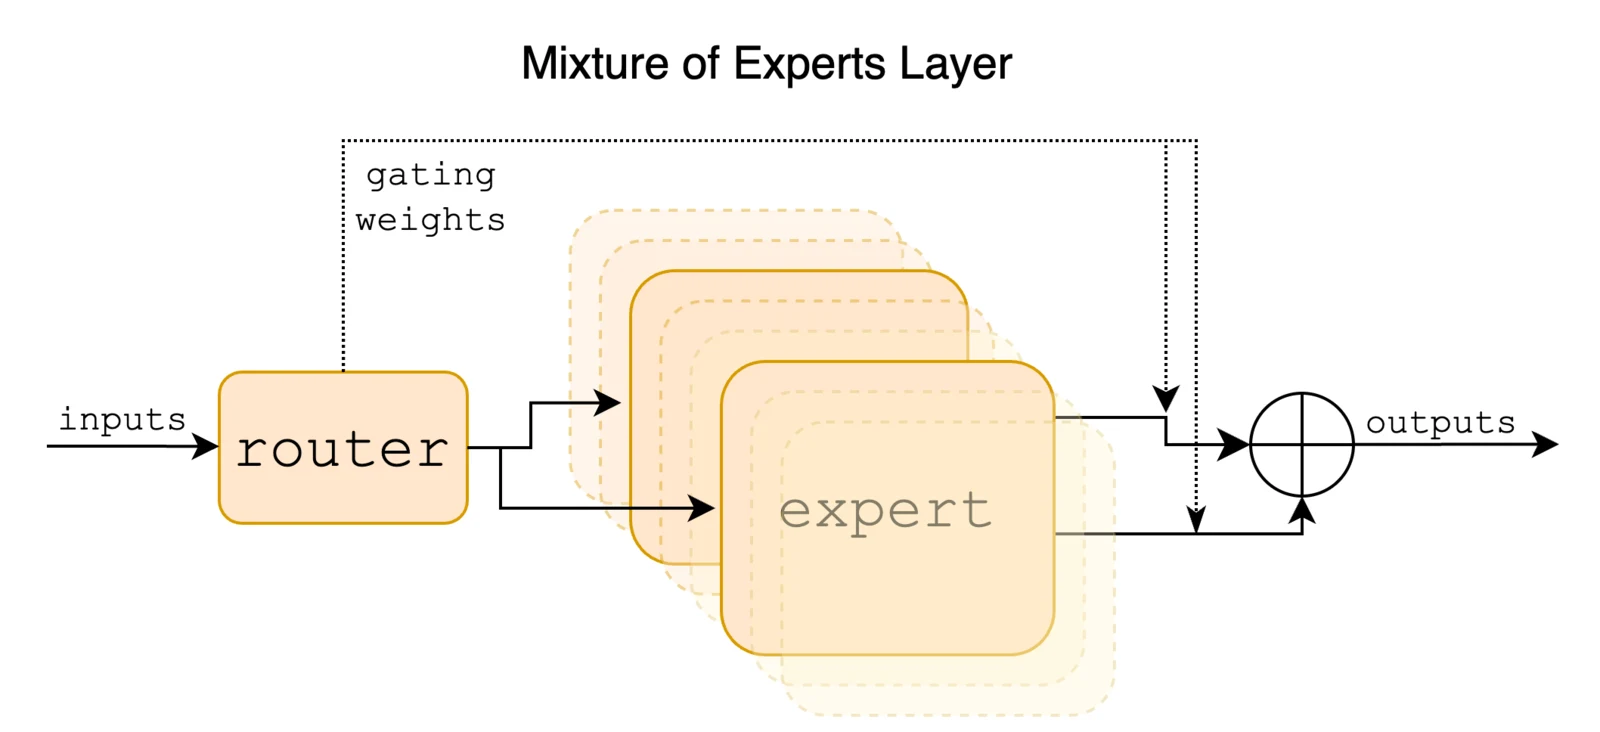
Mixtral 的 8 选 2 是最朴素的路由:一个 token 一个 router 向量,softmax 后取前 2 名,两个专家各自跑一遍 FFN,再按权重相加。SGLang 的 fused_topk 负责的正是图中”router → 2 个专家 → 加权”里的前后两段,中间那段 GEMM 由后续分组内核接管。
推理与训练的不同在形状:训练的 batch 大且固定,可以容忍每一步都做 all-to-all;推理时 batch 可能是 1 条 prefill 的两万 token,也可能是 32 条 decode 的 32 个 token,每层路由出来的专家分布都不一样。由此得到三条约束:
- 不能在主机上等 topk 结果。一旦把
topk_ids拷回 CPU 来决定下一步,解码每 step 就多一次 kernel 加一次同步,而 decode 一次 step 也许只有几百微秒; - 输出必须是下游内核能直接下标访问的布局,不能”先产出分数、再让下游自己找”;
- 同一请求在任意 batch 下结果尽量稳定。路由是排序,平局怎么破、归约顺序怎么定,都会让同一 token 在不同 batch 大小下走出不同的专家。
topk.py 的结构就是对这三条约束的逐条回应。
分数三种算法:softmax、sigmoid、sqrtsoftplus
三种主流路由方式在 SGLang 里是同一个参数 scoring_func 的三个取值。
softmax:(g) 直接做行内 softmax,取 top-k。softmax 与 top-k 可交换(单调变换),所以既可以先取 top-k 再做 k 个元素的 softmax,也可以先做全行 softmax 再取。Mixtral、Qwen 系列属于这一支。
sigmoid:(\sigma(g_j)) 作为分数,取 top-k,再在选中的 k 个之间归一。DeepSeek-V3 引入的 noaux_tc 路由用这一支。
sqrtsoftplus:(\sqrt{\ln(1+e^{x})}),DeepSeek-V4 系列使用。它的作用是压平尾部:平方根让分数差异收缩,让偏置修正机制在 top-k 边界附近更有效。
三种算法的差异远不只是”激活函数选哪个”。softmax 做全行归一,意味着分数本身已经带上了”所有专家”的信息;而 sigmoid、sqrtsoftplus 是逐元素函数,没有全行归一,所以”归一”必须额外做一次,而且只能在选中的 k 个之间做——这正是 DeepSeek 路由”选完再归一”的结构来源。
入口:TopK 算子与 TopKConfig
SGLang 把路由封装成一个算子类 TopK,继承平台的 BaseFusedOp,按设备分派到 forward_cuda / forward_npu / forward_cpu / forward_xpu / forward_musa。它的构造函数把所有路由相关的配置收进一个 TopKConfig 数据类:
# python/sglang/srt/layers/moe/topk.py(节选)@dataclassclass TopKConfig: top_k: int use_grouped_topk: bool = False topk_group: Optional[int] = None num_expert_group: Optional[int] = None renormalize: bool = True correction_bias: Optional[torch.Tensor] = None torch_native: bool = False routed_scaling_factor: Optional[float] = None apply_routed_scaling_factor_on_output: bool = False output_format: Optional[TopKOutputFormat] = None runner_backend: Optional[MoeRunnerBackendLike] = None scoring_func: str = "softmax" sqrtsoftplus_log1p: bool = False fused_gate_packed_ids: bool = False allow_routed_experts_capture: bool = True layer_id: Optional[int] = None逐项说明:
top_k:输出的总宽度,包含共享专家的槽位。注释写得很明确:“routed experts plus shared TopK slots”。所以当模型有共享专家且选择融合进 topk 时,top_k参数本身只是路由专家数,真正的输出宽度是top_k + num_shared_topk_slots。use_grouped_topk/num_expert_group/topk_group:分组路由开关与两个规模参数。renormalize:选完后是否在 k 个权重上归一。correction_bias:DeepSeek 的e_score_correction_bias,一个长度为 (N) 的向量;注释里还说明它可以是二维的”逐 token 偏置”(dynamic_bias)。apply_routed_scaling_factor_on_output:routed_scaling_factor是否已经由路由自己乘上。这个区分很重要——后文”缩放折叠”一节讲。output_format:路由输出给下游的格式,五种之一,见下文。runner_backend:下游 MoE 执行后端(Triton / FlashInfer / AITERT / DeepGEMM 等),它决定output_format。layer_id:全局层号,EPLB 的按层映射、专家分布记录器都按它索引。allow_routed_experts_capture:投机解码的草稿层会把它关掉,避免草稿路由污染目标层的专家分布统计。
TopK.__init__ 里还有一处容易被忽略的细节:它从全局的”当前模型”对象读取共享专家配置:
shared_experts = get_model().shared_expertsself.enable_waterfill = shared_experts.use_waterfillnum_shared_slots = shared_experts.num_shared_topk_slotsself.topk_config = TopKConfig( top_k=top_k + num_shared_slots, ...)“Waterfill” 是一种按专家容量均衡的路由扩展(标准 topk 之后按剩余容量再分),它要求路由输出是标准格式,因为 Waterfill 需要读 topk_weights / topk_ids 再改写。所以 output_format 在启用 Waterfill 时会强制回到 STANDARD。
选择之前:select_experts 的决策树
真正的分派在 select_experts 里。它的主要分支如下(只保留结构,省略非关键参数):
# python/sglang/srt/layers/moe/topk.py(节选)def select_experts(hidden_states, router_logits, topk_config, *, layer_id=None, num_token_non_padded=None, expert_location_dispatch_info=None, dynamic_expert_bias=None, router_logits_partials=None): top_k = topk_config.top_k use_grouped_topk = topk_config.use_grouped_topk ... if dynamic_expert_bias is not None: topk_weights, topk_ids = biased_grouped_topk_impl(...) # 逐 token 偏置,永远走 torch 实现 elif use_grouped_topk: if correction_bias is None: topk_weights, topk_ids = grouped_topk(...) # 分组但不带偏置 else: topk_weights, topk_ids = biased_grouped_topk(...) # 分组 + 偏置 elif topk_config.torch_native and custom_routing_function is None: topk_weights, topk_ids = fused_topk_native(...) elif custom_routing_function is None: if scoring_func == "sqrtsoftplus" or scoring_func == "sigmoid": topk_weights, topk_ids = biased_topk_jit_kernel_impl(...) # JIT 融合路由 elif <flashinfer_trtllm_routed 且 softmax 且无偏置>: topk_weights, topk_ids = fused_topk_softmax_torch_raw_logits(...) else: topk_weights, topk_ids = fused_topk(...) # softmax 主路径 else: topk_weights, topk_ids = custom_routing_function(...) ... topk_ids, topk_weights, recorder_topk_ids = _post_process_topk_ids( topk_ids=topk_ids, topk_weights=topk_weights, topk_config=topk_config, router_logits=router_logits, layer_id=layer_id, num_token_non_padded=num_token_non_padded, expert_location_dispatch_info=expert_location_dispatch_info, padded_rows_masked=padded_rows_masked, ) return StandardTopKOutput(topk_weights, topk_ids, router_logits)决策树的要点:
- 按模型配置分支,不按运行时形状分支。路由形式由模型结构决定,启动之后就固定。唯一随形状变化的是
torch_native(纯 torch 实现),它只在硬件没有专用 kernel、或torch.compile有收益(batch size 1)时开启。 dynamic_expert_bias总是退回 torch 实现。逐 token 偏置意味着偏置表形状是[T, N],现有 JIT kernel 只接受”一组向量”;这一点后文单独讲。- 分组 + 偏置走一条独立分支:注意
grouped_topk(无偏置)与biased_grouped_topk(有偏置)是两个函数,后者内部再选 JIT / FlashInfer / torch 实现。
分组路由的实现:先把组选出来,再在组里选专家
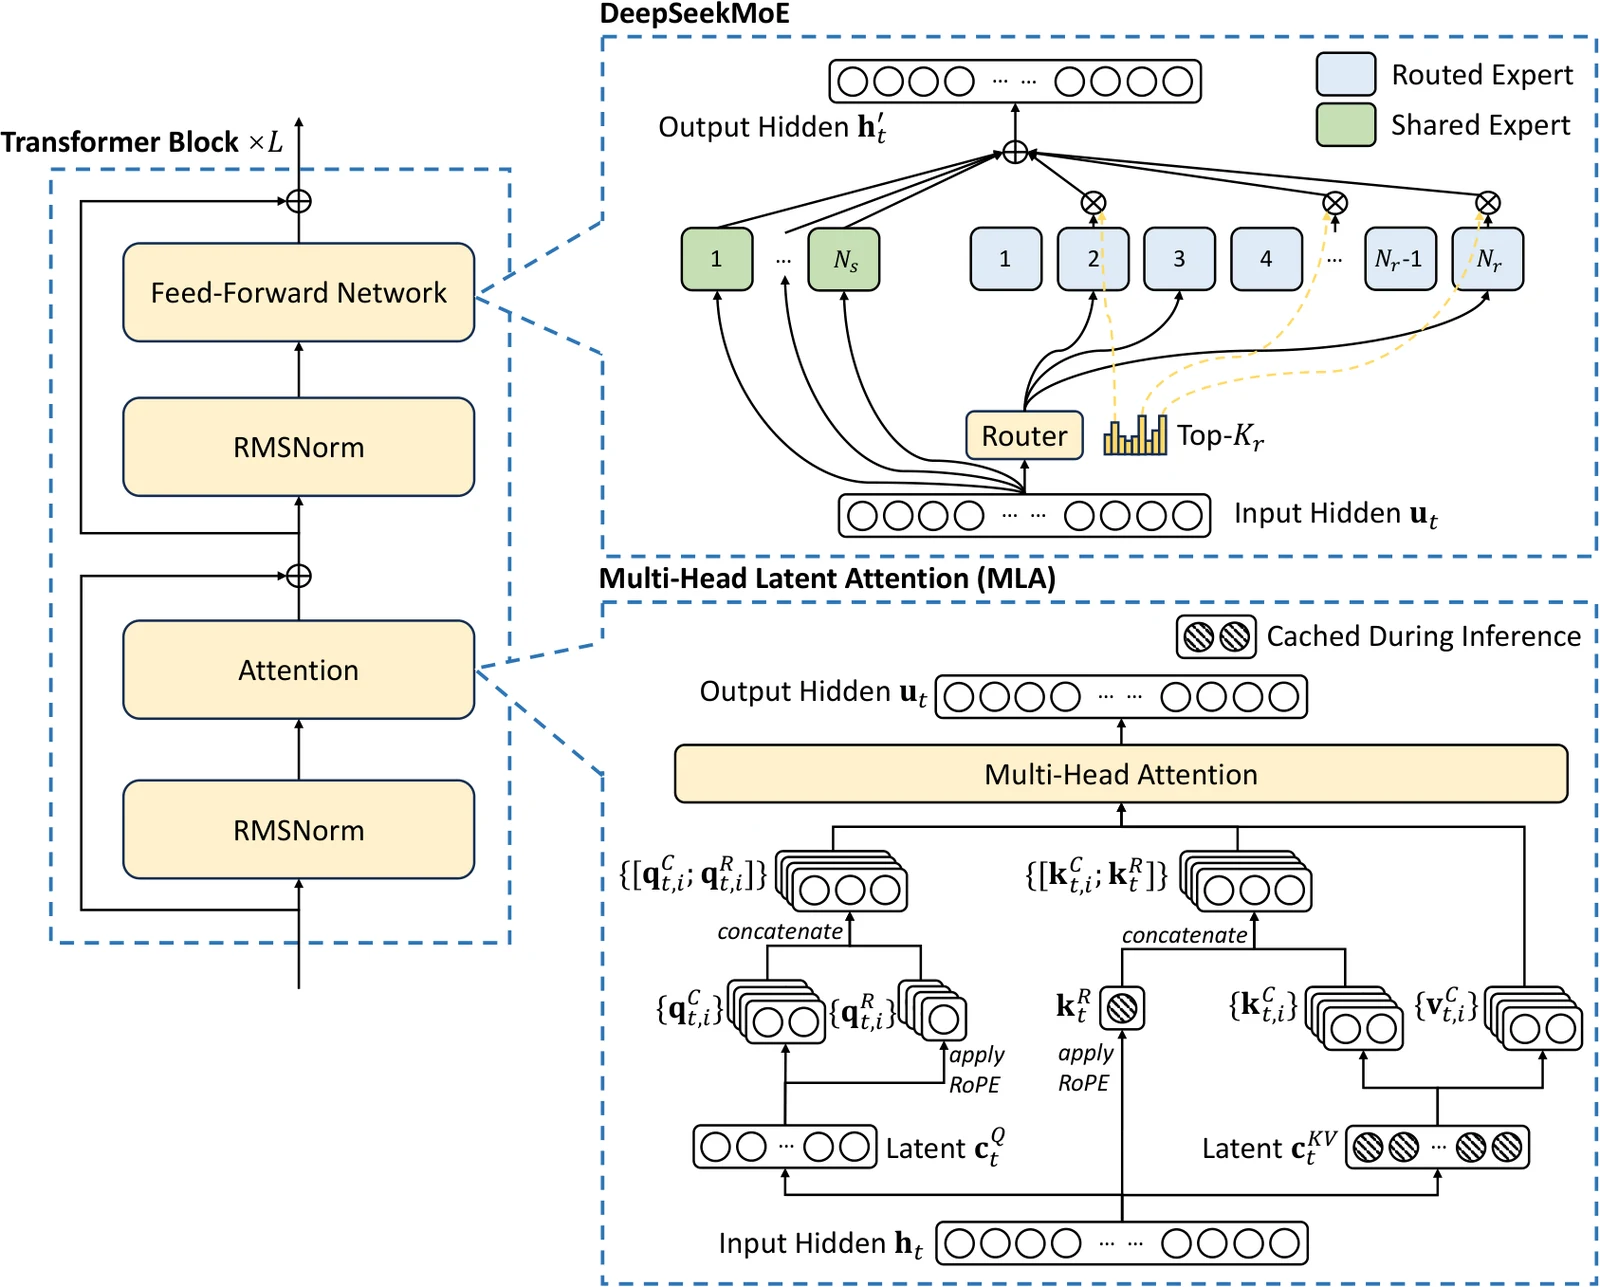
DeepSeek-V3 的每个 MoE 层有 1 个共享专家、256 个路由专家,路由专家分成 8 组、每组 32 个;每 token 选 8 个路由专家,共享专家恒被激活。SGLang 的路由层要处理的就是这张图里”256 选 8、8 组选 4 组”的部分,再把共享专家以额外槽位的方式拼进输出。
grouped_topk_gpu 和 biased_grouped_topk_impl 是理解 DeepSeek 路由的两份”可读参考实现”。前者不带偏置,用 torch.compile 编译;后者带偏置,是 JIT kernel 不满足条件时的兜底。
先看无偏置版本的核心:
# python/sglang/srt/layers/moe/topk.py(节选,grouped_topk_gpu)scores = torch.softmax(gating_output, dim=-1) if scoring_func == "softmax" else gating_output.sigmoid()num_token, num_experts = scores.shapegroup_scores = scores.view(num_token, num_expert_group, -1).max(dim=-1).values # [T, G]group_idx = torch.topk(group_scores, k=topk_group, dim=-1, sorted=False)[1] # [T, k_g]group_mask = torch.zeros_like(group_scores)group_mask.scatter_(1, group_idx, 1)score_mask = group_mask.unsqueeze(-1).expand(num_token, num_expert_group, scores.shape[-1] // num_expert_group).reshape(num_token, -1) # [T, N]tmp_scores = scores.masked_fill(~score_mask.bool(), 0.0)topk_weights, topk_ids = torch.topk(tmp_scores, k=topk, dim=-1)这段的语义是:每组取组内最大分作为组代表分,选前 topk_group 组,把其余组的专家分数清零,再在全行取 top-k。注意”清零”而不是设成负无穷:masked_fill(..., 0.0) 对 sigmoid/softmax 分数是安全的,因为分数非负,清零后不可能进入 top-k。但若本批 slot 总数少于专家数(例如 batch size 1、k = 2 时只有 2 个 slot),那么”可选的专家”只有 2 个,剩下 k − 2 个槽位必然落到被清零的 0 分专家上——下游就会读到”得分 0 的专家 id”。因此这条路径主要作为参考实现,以及 FlashInfer fused_topk_deepseek 与 JIT 路由都不可用的兜底;生产路径走的是下文的下标路线,padding 行有单独的 -1 约定。
再看真正在 DeepSeek-V3 上用的带偏置版本:
# python/sglang/srt/layers/moe/topk.py(节选,biased_grouped_topk_impl)scores = gating_output.sigmoid()scores_for_choice = scores.view(num_token, -1) + correction_bias.view(-1, num_experts)group_scores = (scores_for_choice.view(num_token, num_expert_group, -1) .topk(2, dim=-1)[0].sum(dim=-1)) # [T, G]group_idx = torch.topk(group_scores, k=topk_group, dim=-1, sorted=False)[1]group_mask = torch.zeros_like(group_scores)group_mask.scatter_(1, group_idx, 1)score_mask = ...tmp_scores = scores_for_choice.masked_fill(~score_mask.bool(), float("-inf"))_, topk_ids = torch.topk(tmp_scores, k=topk, dim=-1)topk_weights = scores.gather(1, topk_ids) # 权重取自未加偏置的 scores与无偏置版本的三个差别:
- 组代表分是组内 top-2 的和,而不是最大值。DeepSeek-V3 的技术报告里这个设计让一个”单点极强但整体偏弱”的组更难挤进前
topk_group,让组的选择更看整体; - 未选中的组用
-inf屏蔽而不是 0,与后面选专家时”任何未被组选中的专家不可能被选中”的语义一致; topk_weights = scores.gather(1, topk_ids):用未加偏置的scores取权重。这是全篇最重要的语义点——偏置只改”选谁”,不改”算多少”。如果偏置也进入权重,负载均衡的力度就会直接扰动模型输出;训练时e_score_correction_bias作为独立的偏置参数(只作用于选择阶段)才能实现”不依赖辅助损失的负载均衡”(noaux_tc)。
这套机制来自字节跳动 Seed 团队的 Loss-Free Balancing 工作(论文,2024 年 8 月)。它的要点正如图 2 所示:每个训练 step 按”带偏置的门控分数”选专家,step 结束后再按各专家的负载更新偏置——负载超载的专家偏置下调,闲置的专家偏置上调。
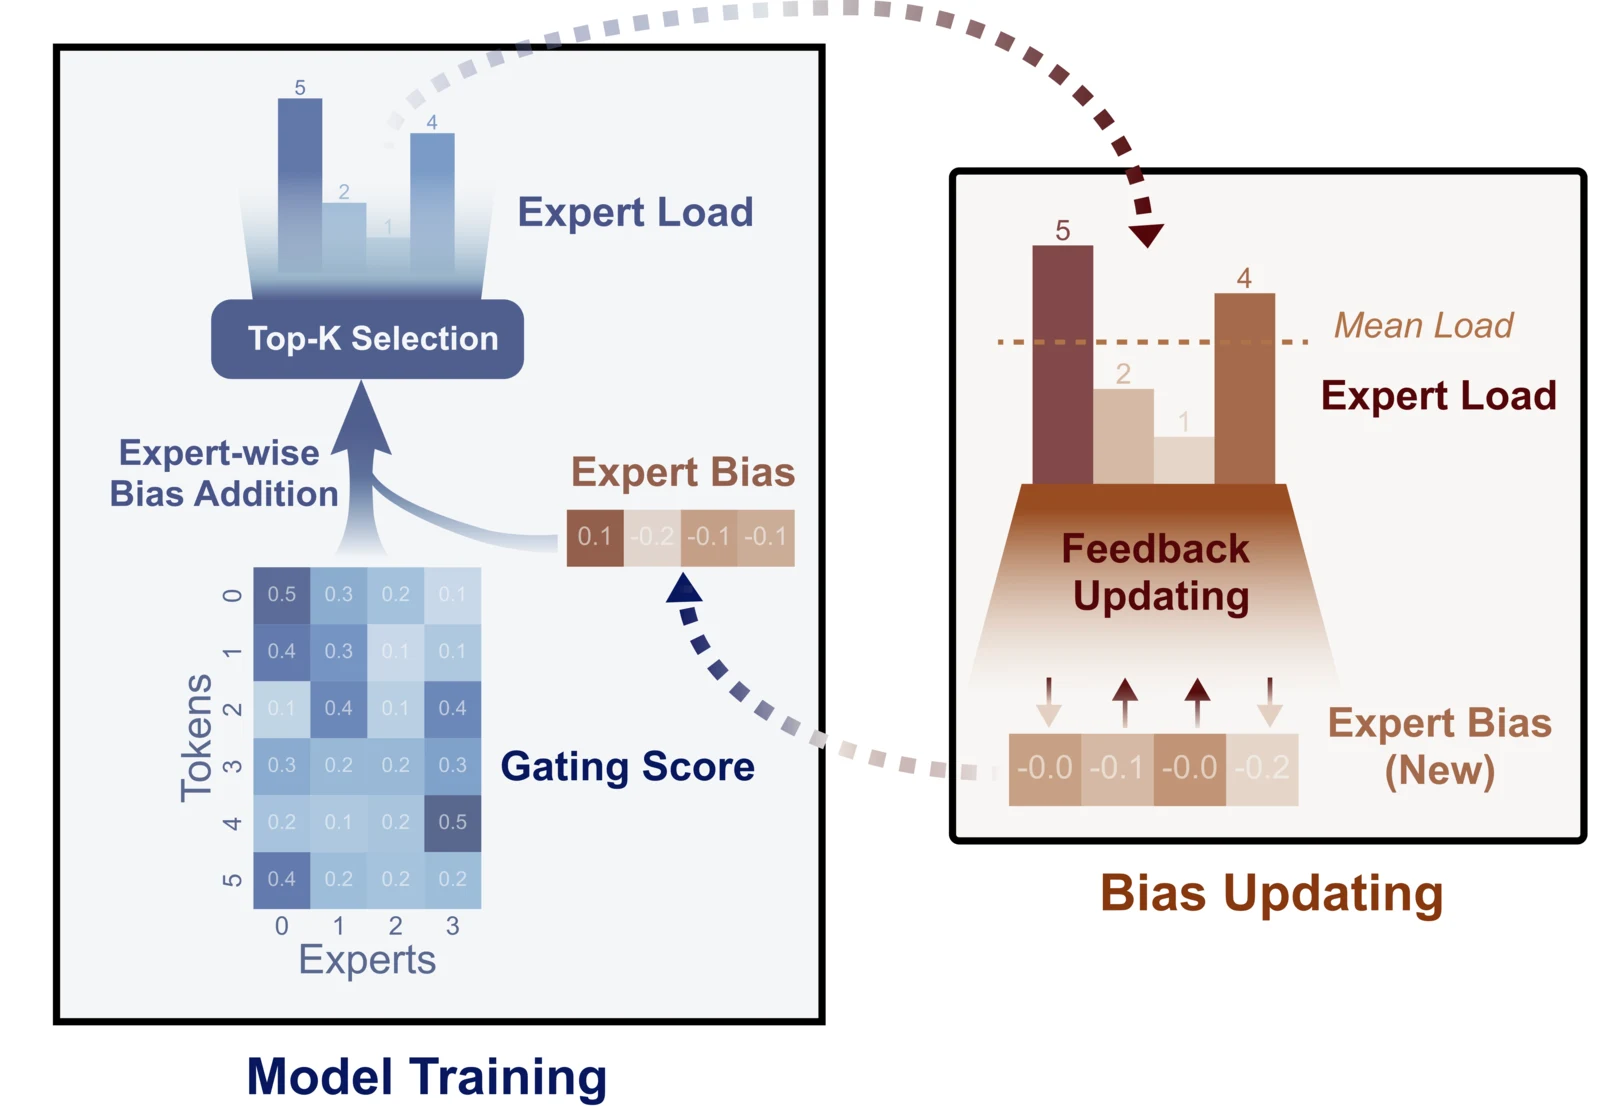
推理阶段偏置已经固定,本篇文章关心的是它被”怎样使用”:只进入选择分数的比较,不进入选中专家的权重。上图画的是训练时偏置的更新循环,推理时只剩”用偏置选、用原分算”这半圈。
同一个文件里 grouped_topk_gpu 选组用的是 max,而 biased_grouped_topk_impl 用组内 top-2 之和,这是两个不同路由配置的差别,不是实现不一致——前者的配置来自 topk_method == "greedy" 那类模型,后者来自 "noaux_tc"。
生产路径:JIT Triton 路由内核逐段拆
真正在生产中跑的是 python/sglang/kernels/ops/moe/moe_fused_gate.py 里的 _router_triton_kernel。它用一行 token 分块(BLOCK_M 行)乘一个专家分块(BLOCK_N,N 向上的 2 的幂),在寄存器与共享内存里把”打分 → 修正 → 选组 → 选专家 → 归一 → 写出”全部完成。下面按段看。
装载与平局规则
# python/sglang/kernels/ops/moe/moe_fused_gate.py(节选)pid = tl.program_id(0)offs_m = pid * BLOCK_M + tl.arange(0, BLOCK_M)offs_n = tl.arange(0, BLOCK_N)mask_m = offs_m < Mmask_n = offs_n < Nif HAS_BIAS: bias = tl.load(bias_ptr + offs_n * stride_bias, mask=mask_n, other=0.0).to(tl.float32)else: bias = tl.zeros([BLOCK_N], dtype=tl.float32)...scores = tl.load(row_ptr, mask=mask2d, other=0.0).to(tl.float32)几个值得停下来的点:
BLOCK_M是按max(1, min(4, 256 // BLOCK_N))算的:专家少(N=64)时一个程序最多处理 4 行,专家多(N=896、BLOCK_N=1024)时只处理 1 行。官方注释解释了:单 warp 处理一行时,top-k 归约全部落在 warp shuffle 上;专家很宽时 k 次顺序 argmax 成为主要开销,所以要把 warp 数调到 4。other=0.0:越界的专家列补 0,然后统一用mask_n在比较前替换成-inf。对 sigmoid 来说σ(0) = 0.5,如果忘记替换,越界的列会被错当成”有 0.5 愿望”的专家进入选择。代码在每次比较前都做了tl.where(mask_n, biased, -inf)。HAS_BIAS为编译期常量:无偏置的 softmax 路由不需要为”空偏置”分配一个显存张量,直接在寄存器里放一个零向量。注释写的是”keep the zero value in registers rather than materializing and clearing a device tensor per call”。
三种打分与可选的软上限
if SCORING_FUNC == 0: activated = tl.sigmoid(scores) biased = activated + row_biaselif SCORING_FUNC == 1: sp = tl.where(scores > 20.0, scores, libdevice.log1p(libdevice.exp(scores))) activated = libdevice.sqrt(sp) biased = activated + row_biaselse: logit = scores if HAS_SOFTCAP: z = logit / moe_softcapping logit = moe_softcapping * (2.0 * tl.sigmoid(2.0 * z) - 1.0) # tanh 的 sigmoid 形式 biased = logit + row_bias row_max = tl.max(biased, axis=1)[:, None] exp_row = tl.where(mask_n[None, :], tl.exp(biased - row_max), 0.0) activated = exp_row / tl.sum(exp_row, axis=1)[:, None]log1p(exp(x))对大的正 (x) 等于 (x + \ln(1 + e^{-x}) \approx x),但exp(x)在 (x > 88) 时溢出为 inf,log1p(inf)仍是 inf——所以先where(scores > 20, scores, ...)截断,这一步把 softplus 在饱和区的误差从”精度损失”降成”近似恒等”。同时scores > 20时σ已经等于 1,因此 sigmoid 那里同样适用。- softmax 分支里
activated是全行 softmax 概率,而biased是加了偏置的 logit,用于排序。注释解释了原因:softmax 是单调的,所以”选出的 k 个”既可以用 logit 排名,也可以用概率排名;但最终的权重应该取 softmax 概率,才能保证”k 个专家的权重之和 ≤ 1”。于是代码把排序与加权分开:cur = biased用于找最大,win_activated取activated。 HAS_SOFTCAP实现的是 (\tanh) 软上限:(\tanh z = 2\sigma(2z) - 1),乘以上限 (c)。这是一个 2025 年后出现的模型设计,用来限制 logit 幅度。
分组:对每一组做”组内 top-2 求和”,再选保持组
if N_GROUP > 1: offs_g = tl.arange(0, BLOCK_G) group_of_n = offs_n // EXPERTS_PER_GROUP group_score = tl.full([BLOCK_M, BLOCK_G], -float("inf"), dtype=tl.float32) for g in tl.static_range(N_GROUP): in_g = (group_of_n[None, :] == g) & mask_n[None, :] vals = tl.where(in_g, biased, -float("inf")) top1 = tl.max(vals, axis=1)[:, None] vals2 = tl.where(vals >= top1, -float("inf"), vals) top2 = tl.max(vals2, axis=1)[:, None] group_score = tl.where(offs_g[None, :] == g, top1 + top2, group_score)- 组号由
offs_n // EXPERTS_PER_GROUP给出,即专家按连续区间分组。Triton 里没有”按段归约”的原语,这里用for g in static_range(N_GROUP)在每个组上做一次”全局 max → 屏蔽掉等于 max 的位置 → 再 max”,代价是 (G) 次全行归约。对 DeepSeek-V3 的 (G = 8)、每行 256 个专家,这 8 次归约的开销远小于 (k) 次 argmax 的顺序循环。 vals >= top1而不是>:如果组内最大值出现两次,第二个也会被屏蔽,于是 top-2 和变成2 * top1而非top1 + 次大。这是一个取舍——对并列的最大值无所谓”哪个是第二”,对整体组分数的影响是”并列越多分数越高”。这个行为与参考实现(torch.topk的 strict 语义)未必完全一致,属于实现细节层面的近似,不影响路由的”选组”行为在绝大多数情况下的一致性。tl.static_range意味着N_GROUP是编译期常量;同一模型所有层共享同一个N_GROUP,所以同一份 kernel 只编译一次。
接下来选组:
gcur = group_score keep = tl.zeros([BLOCK_M, BLOCK_N], dtype=tl.float32) for _i in tl.static_range(TOPK_GROUP): gmax = tl.max(gcur, axis=1)[:, None] glane = tl.where(gcur == gmax, offs_g[None, :], N_GROUP + 1) win_g = tl.min(glane, axis=1)[:, None] # 平局取组号最小的 keep = tl.where(group_of_n[None, :] == win_g, 1.0, keep) gcur = tl.where(offs_g[None, :] == win_g, -float("inf"), gcur) biased = tl.where(keep > 0.0, biased, -float("inf"))“平局取组号最小的”这个规则不是随便定的。gcur == gmax 得到一组布尔;不匹配的位置填 N_GROUP + 1,匹配的填组号;取 min 得到最小匹配组号。整个 kernel 对平局都遵循”id 最小者胜”,这一致性让”同一 token 与同一组 logit 在任何 batch 形状下都选出同一批专家”,是 batch-invariant 推理的一个微观前提。
选专家:k 轮顺序 argmax
cur = biased remaining = tl.broadcast_to(mask_n[None, :], (BLOCK_M, BLOCK_N)) for k in tl.static_range(K_ROUTED): max_val = tl.max(cur, axis=1)[:, None] is_max = remaining & (cur == max_val) lane_id = tl.where(is_max, offs_n[None, :], N + 1) win_lane = tl.min(lane_id, axis=1)[:, None].to(tl.int32) win_activated = tl.sum(tl.where(offs_n[None, :] == win_lane, activated, 0.0), axis=1)[:, None] slot = offs_k[None, :] == k selected_vals = tl.where(slot, win_activated, selected_vals) selected_idx = tl.where(slot, win_lane, selected_idx) remaining = remaining & (offs_n[None, :] != win_lane) cur = tl.where(remaining, cur, -float("inf"))这段是路由内核的真正主体。它没有用 tl.topk(早期 Triton 没有),而是做 K_ROUTED 次”求最大 → 找最大位置中编号最小者 → 记录 → 屏蔽”的循环。三件事值得拆:
win_activated从activated取值,不从biased取。这就是”偏置只参与选取”在 kernel 层面的体现,和第 8 节 torch 实现里的scores.gather是同一条语义。remaining是每轮更新的掩码。第二轮的最大值只在上一轮之外的位置上找,而不是每次重排整行。Triton 的 shape 是静态的,无法”缩小向量”,所以用一个布尔掩码 +cur里填-inf的组合实现”已选过的位置被淘汰”。- 平局规则与分组选组完全一致:
lane_id不匹配填N + 1,再取 min。所以”选专家”和”选组”的平局规则是互相印证的。
代价也很明显:(N = 896)、(K = 16) 时,这 16 轮中每一轮都是一次 1024 宽度的全行归约。这也解释了为什么 SGLang 给”宽行”专门加了 radix 快速路径(下文)。
归一、缩放与共享专家列
routed_sum = tl.sum(tl.where(mask_k_routed[None, :], selected_vals, 0.0), axis=1)[:, None] if RENORMALIZE: if RENORMALIZE_EPSILON > 0.0: norm = routed_sum + RENORMALIZE_EPSILON else: norm = tl.where(routed_sum > 0.0, routed_sum, 1.0) selected_vals = selected_vals / norm if APPLY_SCALE: selected_vals = selected_vals * routed_scaling_factor if K_ROUTED < K: is_shared = (offs_k[None, :] >= K_ROUTED) & mask_k_total[None, :] shared_weight = 1.0 if APPLY_SCALE else 1.0 / routed_scaling_factor shared_idx = (N + (offs_k - K_ROUTED)).to(tl.int32)[None, :] selected_vals = tl.where(is_shared, shared_weight, selected_vals) selected_idx = tl.where(is_shared, shared_idx, selected_idx)routed_sum 显式排除了共享列:归一只能在路由专家之间做。共享专家的权重分两种写法,取决于路由是否已经乘过 routed_scaling_factor,核心目的是让共享专家的最终系数为 1:
- 若路由已经乘缩放(
APPLY_SCALE),共享权重直接写 1; - 若缩放留给下游乘(合并阶段把整个
topk_weights再乘一次),共享权重预先写成 (1 / s),乘完之后正好是 1。
共享专家的 id 写成 N + (offs_k - K_ROUTED),即”接在路由专家编号之后”。下游 GEMM 只要把专家权重张量的第 N 行当作共享专家,就无需再分出一条稠密路径。这与其在 DeepInfer 源码拆解(三十五):MoE 层的 MLP 里”共享专家单独走 ReplicatedLinear”的做法不同——两条路线都能让 token 经过共享专家,区别在于”共享专家要不要占 topk_ids 的一个槽位”。占槽位的版本会让分桶内核多一列、让每个 token 多一次”路由”,但省掉了分支与一次小矩阵乘的 launch。
padding 行掩码与打包输出
if HAS_PADDING: selected_vals = tl.where(live_m[:, None], selected_vals, 0.0) selected_idx = tl.where(live_m[:, None], selected_idx, -1)CUDA Graph 或分块预填会把 batch 补齐到固定形状,尾部若干行是”假 token”。num_token_non_padded 是一个设备端标量(不读回主机),kernel 直接拿它做行掩码:padding 行输出权重 0、id -1。-1 这个值在下游 moe_align_block_size 里会被特殊处理——topk_ids[i] + 1 变成 0 号桶,也就是”无效专家”桶(见第 13 节),从而不参与任何真实专家的 GEMM。
另一个可选输出是 HAS_PACKED:
if HAS_PACKED: w_bits = selected_vals.to(tl.bfloat16).to(tl.int16, bitcast=True).to(tl.int32) packed = (selected_idx << 16) | (w_bits & 0xFFFF)把 expert id 放进高 16 位、bf16 权重位放进低 16 位,合成一个 int32。这是 FlashInfer 的路由 MoE 内核期望的输入格式,一次写出两种信息而不是两个 tensor,可以省一次全局读写。代价是权重被截断成 bf16——对路由权重而言,bf16 的 7 位精度已经足够,后续合并也是累加 bf16/fp16 结果。
宽行专家:从 k 轮 argmax 到 Radix-Select
主线内核的 K_ROUTED 轮顺序 argmax 有一个隐含成本:每一轮都要把长度为 BLOCK_N 的向量做一次全行归约。Mixtral 的 8 个专家、DeepSeek-V3 的 256 个专家都没问题;但 Kimi K3 这类模型有 896 个专家、top-16,16 轮 1024 宽度的归约开始主导路由耗时。
SGLang 的对策是在 moe_fused_gate 入口加一条专用分支:满足 scores 宽度 896、topk == 16、bias 为 fp32、行连续、dtype 为 bf16/fp32 时,调用 moe_route_radix.route_radix。这个 Radix-Select 内核的工作方式与 argmax 循环完全不同:
- 键留在寄存器里:224 个线程、每个线程负责 4 个专家,把 896 个分数放进寄存器,不做全局排序;
- 按字节做基数选择:把 fp32/bf16 的分数按二进制位分成”桶”,每一轮只看一个字节(8 位),从高位到低位逐字节收窄候选集合;某一轮若 top-k 已经能在该字节边界上完整分出,后续低位直接跳过(注释里的 “rounds exit early when the top-k separates on a byte boundary”);
- 前缀和用 warp scan 而不是 CUB:每个 warp 内部的桶计数用 shuffle 前缀和,避免为小规模数据启动 CUB 的 block scan;
- 输出顺序可省:主线的 k 轮 argmax 返回的是”按分数降序、平局按 id 升序”;Radix 内核默认
sorted=False,返回”按专家 id 升序”的结果。下游 GEMM / combine 对槽位顺序不敏感,因此跳过最后的排序。
代码注释给出的实测结论是:在 B200 上,[1..8192, 896] top-16 区间内比 Triton 主线快 3.1–3.5 倍;两条路径的获胜集合逐位一致,只有归一化求和的顺序不同,权重最多差约 1 ulp。这个”集合一致、顺序不同”的取舍值得记下来:它说明路由层的正确性标准是”选出的专家集合 + 每个专家的权重”(权重对求和顺序不敏感),而不是”输出槽位的排列顺序”。
这也解释了为什么 Radix 路径要求那么严格:num_fused_shared_experts == 0、num_expert_group <= 1、无 softcap、无 padding、无 packed 输出。任何一个条件不满足,内核就必须维持”排序后的槽位顺序”或额外处理共享列,省排序的收益就消失了。SGLang 选择”只在收益确定时启用”,而不是为了覆盖率把 Radix 做成通用路径。
共享专家:拼进 topk,还是单独走一条路
共享专家在 SGLang 里不是”特例分支”,而是一组被追加在路由专家之后的固定槽位。TopKConfig.num_shared_topk_slots 决定追加几个,_post_process_topk_ids 负责把它们拼到 topk_ids / topk_weights 的最后一列。拼接方式有两种:
- 全局共享槽位:所有 rank 共享同一组共享专家 id,权重恒为 1(或 (1/s),见缩放一节)。适合共享专家被复制到每个 rank 的部署。
- 按 rank 的共享槽位(
has_per_rank_fused_shared_slots):每个 rank 有自己的共享专家副本,remap_topk_for_per_rank_shared_slots会把路由 id 先按”每 rank 的本地路由专家数”重排,再在对应 rank 的块后插入共享槽位。这个函数里最容易被忽略的是:
# python/sglang/srt/layers/moe/topk.py(节选)routed_ids = topk_ids + (topk_ids // num_local_routed) * num_fused_shared_expertsshared_ids = ep_rank * num_local_experts + num_local_routed + torch.arange(num_fused_shared_experts, ...)(topk_ids // num_local_routed) * S 这一项是”每经过一个 rank 的专家块,就为它前面的共享槽位留出 S 个位置”。如果只加一个固定偏移(+ S),当 S > 1 时后一个 rank 的路由 id 会与前一个 rank 的共享槽位撞号。这个细节说明:共享专家一旦进入 topk_ids,它就成为 EP 分块布局的一部分,必须参与逻辑到物理的地址计算,不能再当成”额外的一条稠密路径”。
与 DeepInfer 的对照很能说明两种设计的取舍。DeepInfer 把共享专家实现成 ReplicatedLinear,在 MoE 分支之外单独算一条稠密 MLP;SGLang 把共享专家拼成额外 topk 槽位。前者省掉了”每个 token 多一个路由槽位”的分桶与 GEMM 开销,但多一次独立的小矩阵乘与一次加法;后者让共享专家与路由专家共用同一套 grouped GEMM,代价是分桶数组多一列、EP 布局需要重排。哪种更好取决于 decode batch 大小:小 batch 下独立 MLP 的 launch 开销更贵,大 batch 下共享槽位的分桶浪费更明显。
五种输出格式:为什么下游要看到不同的账本
TopKOutputFormat 定义了五种格式,对应不同后端对”路由结果”的不同消费方式:
| 格式 | 输出内容 | 适用后端 | 为什么需要 |
|---|---|---|---|
STANDARD | (topk_weights, topk_ids, router_logits) | Triton fused_experts、AITER、DeepGEMM 等 | 通用格式,下游自己分桶 |
STANDARD + packed | 上面三元组 + packed_topk_ids | FlashInfer mxfp4 MoE | 额外提供 id<<16 | bf16 权重 |
TRITON_KERNEL | RaggedTensorMetadata、gather_indx、scatter_indx、gate_scal | triton_kernels 的 routed 风格 | 内核自己按 expert 扫描,需要 gather/scatter 下标而非排序表 |
BYPASSED | hidden_states、原始 logits、配置 | FlashInfer TRT-LLM routed MoE | 不做路由,把路由交给下游内核内部完成 |
PACKED | packed_topk_ids | FlashInfer TRT-LLM routed MoE | 只有压缩格式 |
这里最值得讲的是 BYPASSED。FlashInfer 的 TRT-LLM 风格路由 MoE 内核(从 TRT-LLM 移植过来)会在自己的 kernel 里做打分、top-k 与分桶,如果 SGLang 再前置一个 select_experts,就是”路由两次”。所以 TopK 在 bind_runner_backend 时检测到后端是 flashinfer_trtllm 且路由配置满足 _can_bypass_trtllm_routing,就把输出格式设为 BYPASSED,并把原始 logits 原样交出去:
# python/sglang/srt/layers/moe/topk.py(节选,TopK.forward_cuda)elif output_format == TopKOutputFormat.BYPASSED: return BypassedTopKOutput( hidden_states=hidden_states, raw_router_logits=router_logits, topk_config=self.topk_config, num_token_non_padded=num_token_non_padded, expert_location_dispatch_info=expert_location_dispatch_info if requires_remapping else None, )BypassedTopKOutput.to_standard() 则提供了”按需物化”的出口:如果下游某个 kernel 不支持内部路由,就调用 to_standard() 再走一遍 select_experts。而它里面的 expert_location_dispatch_info 一旦非空(EPLB 需要逻辑到物理重映射),就会在 router_logits 属性访问时抛 NotImplementedError——注释说得很直接:“Expert placement remapping requires materialized TopK routing; this MoE kernel routes directly from logits.” 也就是说,一旦启用专家重映射(动态 EPLB),就必须把路由物化成 topk_ids,因为下游内核自己算出来的逻辑专家号没有办法被”路由之外”的层改写。
这条约束把本篇后半程的逻辑串起来了:EPLB 越积极,路由输出越必须显式。
后处理:_post_process_topk_ids 里的四件事
不管走哪条内核,select_experts 最后都会把 topk_ids / topk_weights 交给 _post_process_topk_ids 处理。从源码看,它做的是四件事:共享列追加、逻辑到物理重映射、padding 行掩码、专家分布记录。
逻辑专家 → 物理槽位
EPLB 的核心是”逻辑专家号不知道它现在在谁手里”,所以必须有一张表。映射入口在 python/sglang/srt/eplb/expert_location_dispatch.py:
# python/sglang/srt/eplb/expert_location_dispatch.py(节选)def topk_ids_logical_to_physical(topk_ids, info, log2phy_prob=None): if info is None: return topk_ids if info.ep_dispatch_algorithm == "static": return _topk_ids_logical_to_physical_static(topk_ids, info) if info.ep_dispatch_algorithm in ["dynamic", "fake"]: return _topk_ids_logical_to_physical_dynamic(topk_ids, info) if info.ep_dispatch_algorithm == "lp": return _topk_ids_logical_to_physical_probability(topk_ids, info, log2phy_prob) raise NotImplementedError(...)
def _topk_ids_logical_to_physical_static(topk_ids, info): physical_topk_ids = info.partial_logical_to_rank_dispatch_physical_map[topk_ids] return physical_topk_ids.to(topk_ids.dtype)ExpertLocationDispatchInfo 里有三张表:
partial_logical_to_rank_dispatch_physical_map:形状[num_logical_experts],每个逻辑专家在本 rank 上的物理槽位;partial_logical_to_all_physical_map:形状[num_logical_experts, X],每个逻辑专家全部副本的物理槽位(X 是最大副本数);partial_logical_to_all_physical_map_num_valid:每个逻辑专家实际有几个有效副本。
static 算法只用第一张表做一次 gather;dynamic 算法在两维表上”按行均匀分摊副本”,目的是把同一逻辑专家分散到不同副本上。rank_invariant 这个字段解释了为什么要按行而不是按随机:
Under
rank_invariantthe replica is picked by token row rather than at random:torch.randintreads the default CUDA generator, so agreement across ranks would rest on their philox offsets staying aligned, which nothing asserts, and it would make greedy requests non-reproducible.
rank_invariant 为真意味着”所有 rank 都要对同一个 token 选同一个物理专家”。在无 all-to-all 的 EP 实现里,每个 rank 都拿着一份完整 token 列表、各自算 MoE,最后求和输出;如果每个 rank 选不同的副本,同一个逻辑专家就会被加了好几次。所以副本选择必须由 token 行号唯一决定,而不能用 torch.randint 这种依赖随机种子的方式——后者即使每个 rank “碰巧”种子一致,也会让贪心解码的请求在不同时间跑出不同结果。
padding 行掩码:-1 与 0
# python/sglang/srt/layers/moe/topk.py(节选)def _mask_topk_ids_padded_region(topk_ids, num_token_non_padded=None, fill_value=-1): if num_token_non_padded is None: return ... if _is_cuda and topk_ids.dtype == torch.int32 and fill_value == -1: mask_topk_ids(topk_ids, num_token_non_padded)padding 行写成 -1,之后在 moe_align_block_size 里 -1 + 1 = 0 落进”0 号桶”。这里有一点必须注意:kernel 注释里提到”HIP fills padded ids with 0, not -1”,也就是在 ROCm 平台上这个约定是 0。两边都需要下游对齐函数能识别”无效专家桶”,这正是对齐内核的 ignore_invalid_expert 参数存在的意义。
专家分布记录
if recorder_topk_ids is not None: get_global_expert_distribution_recorder().on_select_experts(topk_ids=recorder_topk_ids)记录器按层累积”每个逻辑专家被选了多少次”,是 EPLB 重排专家位置的输入之一。它只记录逻辑 id,所以 _post_process_topk_ids 要在映射成物理 id 之前或之后区分出”原始的逻辑排名”,避免把物理槽位当成逻辑专家统计。
从 topk 到分组 GEMM:moe_align_block_size 的排序账
topk_ids 是 [T, k] 的二维表,分组 GEMM 要的是”按专家连续排布、每个专家一段、每段长度对齐到 block_size”。中间的转换函数是 moe_align_block_size,定义在 python/sglang/srt/layers/moe/moe_runner/triton_utils/moe_align_block_size.py。它的 docstring 给出一个可以直接手算的例子:
Given topk_ids = [[2, 3, 4], [1, 2, 4], [1, 3, 4], [1, 2, 3]], block_size = 4, num_experts = 4:
- 12 (token, expert) slots, 4 experts, 3 tokens each;
- pad 1 token per expert since block_size is 4;
- flatten → [2,3,4, 1,2,4, 1,3,4, 1,2,3]; append padding [12,12,12,12] per block;
- sorted by expert → [3,6,9,12, 0,4,10,12, 1,7,11,12, 2,5,8,12]; tokens 12 are padding.
这 16 个数字就是 sorted_token_ids;配一个 expert_ids = [0,1,2,3],num_tokens_post_padded = 16,一次 4 块 × 每块 4 行的 GEMM 就正好对应”4 个专家 × 每专家 4 个 slot”。
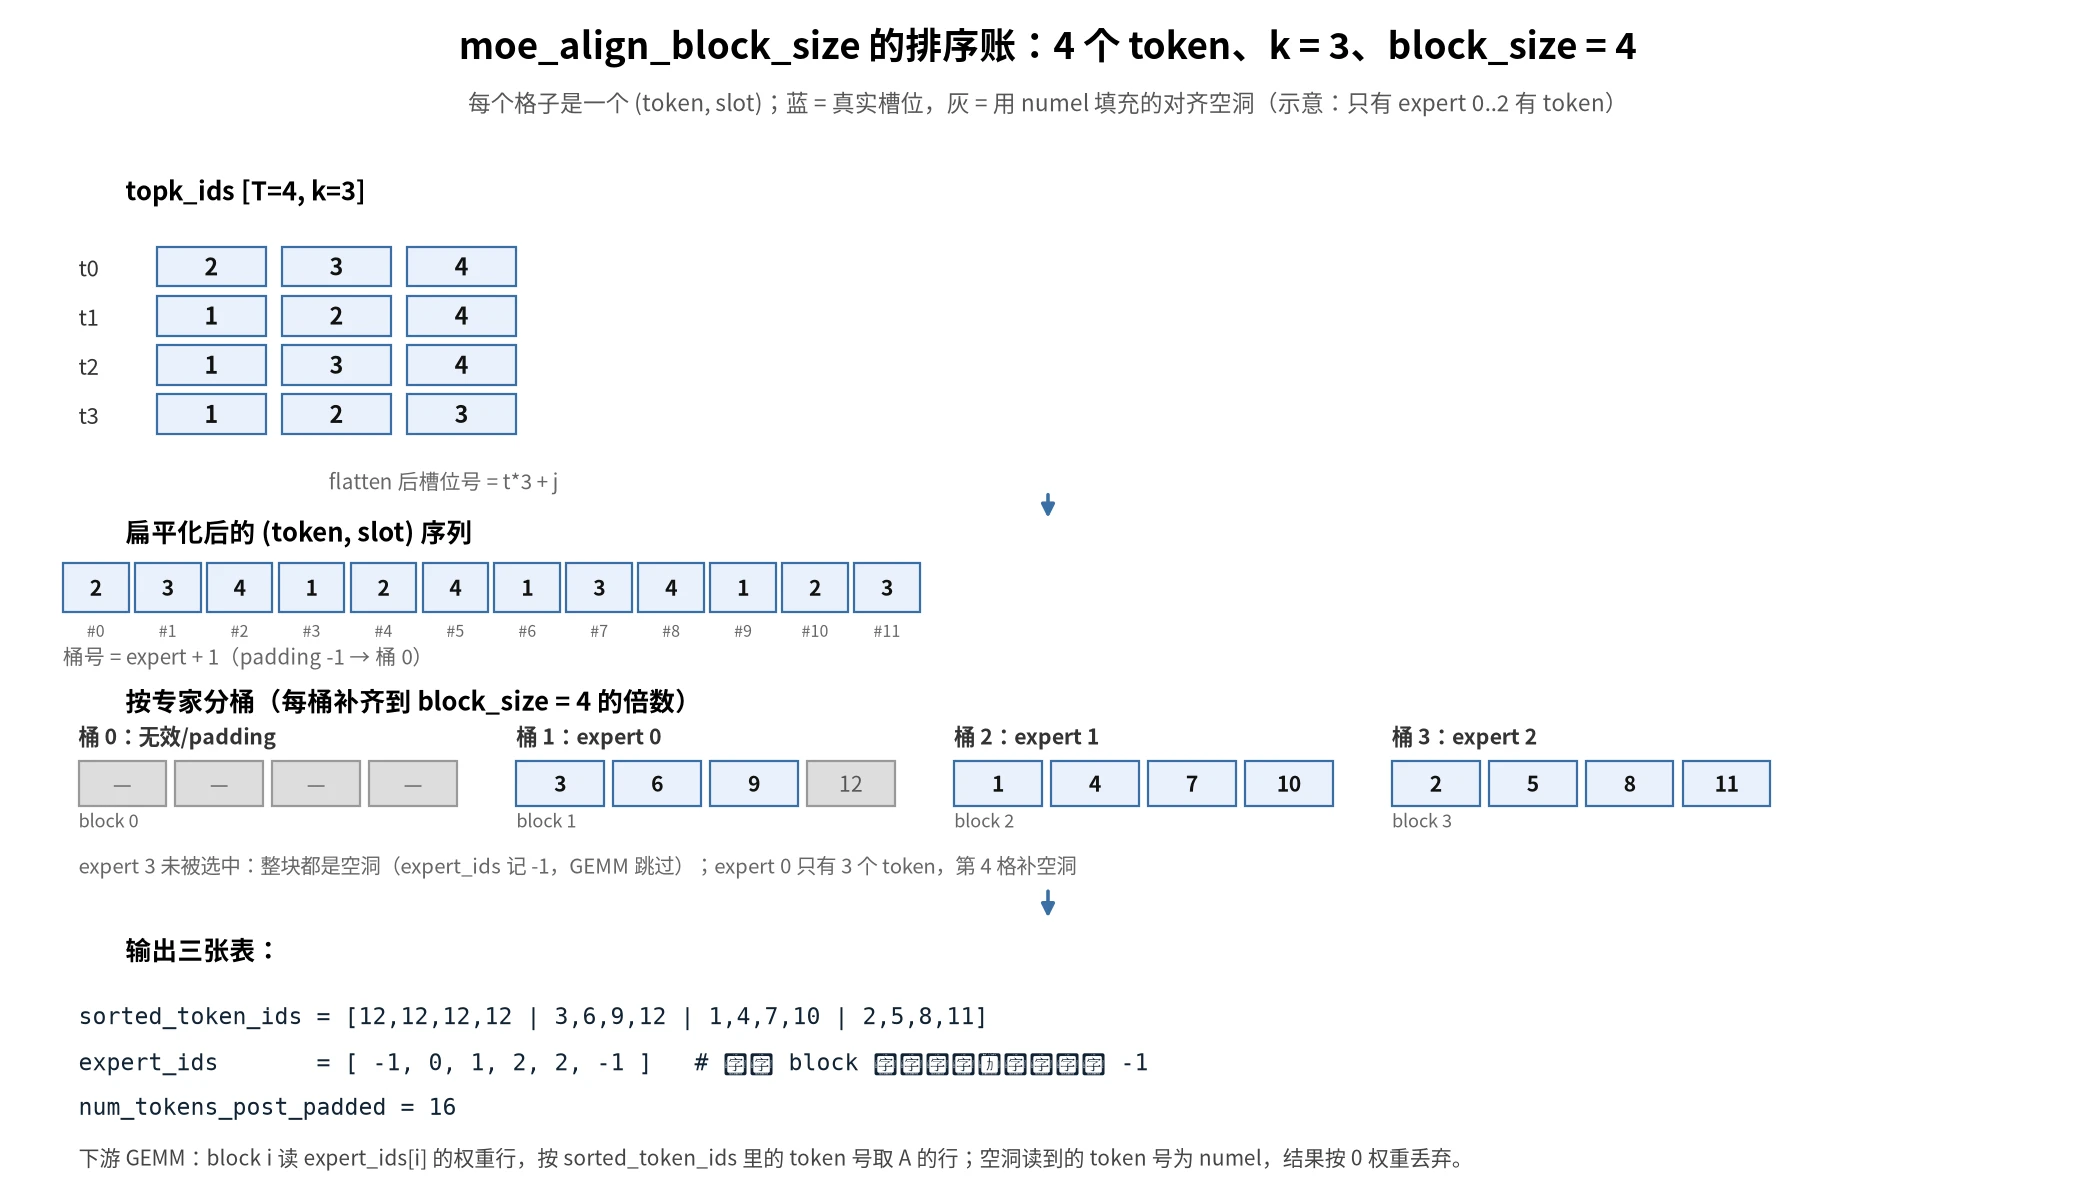
图中把 topk_ids 的每个 (token, slot) 压成一个全局槽位号,再按 expert + 1 分桶。真实槽位用蓝色,补齐用的空洞用灰色:空洞里写的不是 0,而是 numel = T × k,即”所有真实 token 之后的下标”。下游 GEMM 读到 numel 就知道这一行是填充,按 0 权重丢弃;这样 padding 永远不会与真实 token 0 撞号。
这里有一个初学者最容易写错的细节:padding 值为什么是 numel 而不是 0。如果 padding 写 0,那么一个”专家 A 的第 1 个 slot”和”专家 A 的补齐行”都会指向 token 0,GEMM 会把 token 0 的隐状态算两遍,再把两份结果都写回 token 0,导致输出翻倍。写 numel 之后,填充行的 token 下标越界,GEMM 要么用 mask 跳过,要么读到一个不会被写回的位置;总之不会污染真实 token。这个约定在 vLLM 的 moe_align_block_size 里同样存在,是 MoE 推理内核的公共常识。
先看容量预算:
# python/sglang/srt/layers/moe/moe_runner/triton_utils/moe_align_block_size.py(节选)if topk_ids.numel() < num_experts + 1: max_num_tokens_padded = topk_ids.numel() * block_sizeelse: max_num_tokens_padded = topk_ids.numel() + (num_experts + 1) * (block_size - 1)max_num_tokens_padded = (max_num_tokens_padded + 3) // 4 * 4 # int4 写入对齐sorted_ids = torch.empty((max_num_tokens_padded,), dtype=torch.int32, device=topk_ids.device)max_num_m_blocks = triton.cdiv(max_num_tokens_padded, block_size)expert_ids = torch.empty((max_num_m_blocks,), dtype=torch.int32, device=topk_ids.device)num_tokens_post_pad = torch.empty((1,), dtype=torch.int32, device=topk_ids.device)cumsum_buffer = torch.empty((num_experts + 2,), dtype=torch.int32, device=topk_ids.device)max_num_tokens_padded 的推导值得一算:
- 如果本批 slot 总数少(
numel < E + 1),每个专家最多装numel个,对齐后是numel × block_size,这是最坏情况(所有 slot 挤一个专家); - 否则,假设 (E + 1) 个桶(含无效桶)都至少有一个 slot,每个桶的最后一块最多补
block_size - 1个,所以上界是numel + (E + 1) × (block_size - 1)。
后者精确到只按”真正有 token 的桶”计算会更紧,但 kernel 在 GPU 上无法方便地先数”有几个桶非空”再分配,所以用这个上界——多分配的一点显存远小于”分配不足”带来的隐患。(x + 3) // 4 * 4 是为了让后面用 int4 向量写入 padding。
cumsum_buffer 长度为 E + 2:topk_ids + 1 之后的桶号范围是 [0, E](-1 → 0,E-1 → E),再加一个位置给前缀和。
CUDA 对齐内核:一次扫描 + 二次扫描 + 二分定块
对齐 CUDA kernel 在 python/sglang/kernels/jit/csrc/moe/moe_align_kernel.cu。它的主 moe_align_block_size_kernel 只用一个 CTA 做”计数 + 前缀和 + 填块号”,另用一个 CTA 负责先把 sorted_token_ids 用 numel 填满(padding 标记):
// python/sglang/kernels/jit/csrc/moe/moe_align_kernel.cu(节选)if (blockIdx.x == 1) { if (pad_sorted_token_ids) { Vec fill_vec; fill_vec.x = fill_vec.y = fill_vec.z = fill_vec.w = numel; int32_t total_vecs = max_num_tokens_padded / VEC_SIZE; Vec* out_ptr = reinterpret_cast<Vec*>(sorted_token_ids); for (int32_t i = threadIdx.x; i < total_vecs; i += blockDim.x) out_ptr[i] = fill_vec; for (int32_t i = total_vecs * VEC_SIZE + threadIdx.x; i < max_num_tokens_padded; i += blockDim.x) sorted_token_ids[i] = numel; } return;}这里有三处细节:
- padding 值不是 0 而是
numel。numel = T*k是一个”不存在的 token 下标”,它恰好落在所有真实 token 之后;GEMM 内核读到这个 id 时会取越界行,但会用-1的 expert 或block_size对齐把整块跳过。选numel而不是 0 的原因很直接:0 是一个真实 token 的编号,如果 padding 用 0,那么对同一 token 的读取就会被”算两遍”。 int4向量化填充。padding 的写入量可能很大(max_num_tokens_padded),用 128 位存储把写带宽降到四分之一;尾部不足一个int4的部分单独循环处理,注释里写着 “a partial last vector would write past the buffer”,也就是绝不越界。- 这一步与计数+前缀和并行在两个 CTA 里,不需要同步——
blockIdx.x == 1的 CTA 只写 padding 区域,之后被计数 CTA 的真实写入覆盖,最后剩下没被覆盖的就是 padding。
接下来是计数与前缀和:
extern __shared__ int32_t smem[]; int32_t* shared_counts = smem; int32_t* prefix = shared_counts + num_experts; int32_t* scan_buf = prefix + num_experts + 1; __shared__ int32_t s_total_tokens_post_pad; ... for (size_t i = tid; i < numel; i += stride) { int expert_id; if constexpr (kMapInvalidExpertsToSentinel) expert_id = sentinel_expert_bucket(topk_ids[i], num_experts); else expert_id = topk_ids[i] + 1; atomicAdd(&shared_counts[expert_id], 1); } __syncthreads(); int32_t padded_count = 0; if (tid < num_experts) { int32_t count = shared_counts[tid]; padded_count = (count + block_size - 1) / block_size * block_size; scan_buf[tid] = padded_count; }几个关键决策:
- “计数用原子加、排序用一次原子加”。原版 vLLM 的
moe_align_block_size用两遍 kernel:第一遍count_and_sort_expert_tokens_kernel用atomicAdd(&cumsum[expert+1], 1)直接得到每个 slot 在sorted_token_ids中的位置;第二遍用前缀和算每个专家块的起点。SGLang 把这套逻辑放进一个 CTA,先在共享内存里做计数(原子加只落在 shared memory,不产生全局原子竞争),再前缀和,然后把槽位号直接按专家落盘。这样避免了”先全局累加再回读”的两次 HBM 往返。 - 按块对齐而不是按 token 对齐:
padded_count = ceil(count / block_size) * block_size。一个专家只处理 3 个 token 时,也会占满一整块 4 行——GEMM 块的最小粒度就是block_size,不足一块必须补齐。 +1偏移:topk_ids[i] + 1。原因是-1(padding)要落进 0 号桶。这就是”桶号 = 专家号 + 1”的来源,也是cumsum_buffer长度为E + 2的来源。kMapInvalidExpertsToSentinel:另一个更通用的映射sentinel_expert_bucket:
template <typename scalar_t>__device__ __forceinline__ int32_t sentinel_expert_bucket(scalar_t expert_id, int32_t num_buckets) { using unsigned_t = std::make_unsigned_t<scalar_t>; const unsigned_t shifted = static_cast<unsigned_t>(expert_id) + unsigned_t{1}; return shifted < static_cast<unsigned_t>(num_buckets) ? static_cast<int32_t>(shifted) : 0;}把 id 当作无符号数加 1:-1 变成 0(sentinel),而 -2、-3 等更大的负数被无符号解释后一定大于 num_buckets,也落到 0。这条规则让”任何负数 id”统一进 sentinel 桶,而不是只认 -1。
前缀和部分在 CUDA 与 HIP 下是两份代码:HIP 没有可用的 inclusive_sum 原语时用 Blelloch 扫描;CUDA 用 device::warp::inclusive_sum<32> 加跨 warp 的二级前缀和(每个 warp 先算一次 warp 内前缀,再由 0 号 warp 对 warp 之和做扫描,最后每个线程加上自己 warp 的偏移)。
最后是”块号表”:
if (tid <= num_experts) cumsum[tid] = prefix[tid]; const int32_t num_blocks = s_total_tokens_post_pad / block_size; for (int32_t i = tid; i < num_blocks; i += stride) { int32_t block_start = i * block_size; int left = 0, right = num_experts; while (left < right) { int mid = (left + right) >> 1; if (prefix[mid] <= block_start) left = mid + 1; else right = mid; } expert_ids[i] = left - 2; } if constexpr (kPadExpertIds) { for (int32_t i = num_blocks + tid; i < max_num_m_blocks; i += stride) expert_ids[i] = -1; }expert_ids 是”第 i 个 block 属于哪个专家”。给定该 block 在全局 sorted_token_ids 中的起点 block_start,用二分在(前缀和 + 1 偏移)的数组里找到”第一个 prefix > block_start”的位置 left,left - 2 就是专家号。减 2 的原因是两重偏移:桶号 = 专家 + 1,前缀和 prefix[桶] 是桶之前所有块的总长度(一个桶占一段),所以 left 是第一个”段结束点 > block_start”的桶,桶号减 1 是专家号,再因为数组下标偏移 1,共减 2。
这段代码把”每个 block 属于哪个专家”用二分查找算出来,而不是写一个”按段展开”的循环。这看起来绕,但好处是:每个 block 的处理独立、没有数据依赖,而且当一个专家占多个 block 时,二分能自然地返回同一个专家号。
小 batch 路径
decode 时 numel = 32 × 8 = 256,对齐表的规模很小,主 kernel 的”一个 CTA 扫描”在大 batch 下合适,在小 batch 下会有大量线程空转。SGLang 因此有两条小路径:
- CUDA 端的
moe_align_block_size_small_batch_expert_kernel(注释里标注 “Adapted from vLLM PR #29642”):把tokens_cnts做成[blockDim × num_experts]的二维共享内存表,让每个线程处理自己的负载并自行算出”我负责的专家有几个 token”,从而去掉全局前缀和; - Triton 端的
moe_align_small_numel:topk_ids.numel() <= SMALL_NUMEL_LIMIT且桶数超过 CUDA 小 batch kernel 的容量时,用一个单 CTA 的 Triton kernel 做两两比较排序,代码注释写”O(numel²) pairwise”。
选择规则在 wrapper 里:
if (_is_cuda and topk_ids.numel() <= SMALL_NUMEL_LIMIT and num_experts + 1 > _CUDA_SMALL_BATCH_MAX_BUCKETS and not ignore_invalid_expert and not pad_expert_ids): moe_align_small_numel(...) return sorted_ids, expert_ids, num_tokens_post_pad注意条件里的”num_experts + 1 > _CUDA_SMALL_BATCH_MAX_BUCKETS”:当桶数少时 CUDA 小 kernel 已经够快(它只做 O(numel) 工作),Triton 的 O(numel²) 反而更慢;所以只在”桶数多、CUDA 小 kernel 覆盖不到”时才启用。
缩放系数放在哪里:一次折叠省一个 kernel
routed_scaling_factor(DeepSeek-V3 是 2.5)在数学上只是一个乘法,但它和”共享专家权重恒为 1”、“归一是否在 k 个上进行”、“下游 epilogue 会不会再乘一次”纠缠在一起。SGLang 用两件事把它理清楚:
apply_routed_scaling_factor_on_output:告诉下游”路由已经把缩放乘进去了,epilogue 不要再乘”;fold_scale_after_routing:某些路径(torch native、自定义路由、非 JIT 内核)的内核不接受缩放参数,此时select_experts在拿到输出后自己补乘:
# python/sglang/srt/layers/moe/topk.py(节选)if (fold_scale_after_routing and apply_routed_scaling_factor_on_output and routed_scaling_factor is not None): num_routed_for_gate = top_k_for_gate - num_shared_topk_slots_for_gate topk_weights[:, :num_routed_for_gate] *= routed_scaling_factor注意只乘 [:num_routed_for_gate]:共享列保持自己的权重(1 或者 (1/s)),不会被这次补乘再改一遍。
为什么”内核里乘”比”输出后再乘”好?decode 时 topk_weights 是 [T, k]、T 可能只有几十,这个乘法本身可以忽略;真正要省的是一次额外的 kernel launch。在每层都要做一次乘法时,几十层的 decode 会产生几十次 launch,每次 launch 即使只有几微秒,也积少成多。把缩放写进路由内核的 APPLY_SCALE 编译期开关,就等于在已有的 tl.store 之前多一条 mul 指令,零额外 launch。
同理,is_routed_scaling_factor_fused_in_topk 这个函数存在的意义是”让下游知道要不要跳过缩放”:
def is_routed_scaling_factor_fused_in_topk(topk_config): if topk_config.apply_routed_scaling_factor_on_output: return True if not _use_aiter: return False if topk_config.use_grouped_topk: return topk_config.correction_bias is not None return (topk_config.scoring_func == "sqrtsoftplus" and topk_config.custom_routing_function is None)这段说明 AITER 后端”总是在内核里折叠缩放”,而其它后端要显式传参。跨后端一致性靠这一个函数显式维护,而不是靠”大家都记着别乘两次”。
逐 token 偏置与”fake 路由”:工程细节两则
dynamic_expert_bias
有模型(例如某些推测解码的草稿层、或者多模态 token 需要独立偏置的)会给出逐 token 的偏置 [T, N],而不是一组 [N]。JIT kernel 只接受一组,于是 select_experts 一开始就把这条分支指向 biased_grouped_topk_impl:
if dynamic_expert_bias is not None: if scoring_func != "sigmoid": raise ValueError("Per-token expert bias is only supported with sigmoid routing") topk_weights, topk_ids = biased_grouped_topk_impl(...)同时有个硬限制——per-token 偏置只支持 sigmoid 路由。原因是 biased_grouped_topk_impl 里的 scores.gather(1, topk_ids) 依赖”权重取自未修正分数”这一语义,sqrtsoftplus 的逐 token 实现没有对应处理(sqrtsoftplus_log1p 分支只存在于 JIT kernel 里)。
fake 与模拟路由
transform_select_experts_inputs 在 ep_dispatch_algorithm == "fake" 时会把 logits 直接覆盖成均匀随机数:
def transform_select_experts_inputs(router_logits, correction_bias, info): if (info is not None) and (info.ep_dispatch_algorithm == "fake"): router_logits.uniform_(5, 10) if correction_bias is not None: correction_bias = torch.zeros_like(correction_bias) return router_logits, correction_bias这是压测工具,不是生产路径:用随机路由来测”MoE 完全不平衡时”系统的行为(分桶不均、通信量、专家负载)。它放在 select_experts 入口,而不是放在某个后端里,保证所有后端压测出来的是同一种输入分布。
此外还有两个环境变量 SGLANG_SIMULATE_UNIFORM_EXPERTS 与 SGLANG_SIMULATE_ROUND_ROBIN_EXPERTS,作用于路由输出之后:前者把 topk 的专家选择改写为均匀分布,后者改写为轮转分发。二者互斥,使用时会通过 apply_routing_simulation 重写 topk_ids 与 topk_weights,并把 padded_rows_masked 置回 False(因为模拟重写了所有行,包括 padding 行)。
精度账:为什么 logit 是 fp32、ids 是 int32
路由层是 MoE 前向里精度要求最微妙的一段。几个看起来”无所谓”的决定都有原因:
- logit 强制 fp32。
TopK.__init__说明门控层的输出是 fp32(例如ReplicatedLinear(..., use_fp32_output=True)),JIT kernel 的注释也写明 “raw logits, fp32/fp16/bf16 (upcast to fp32 on load)“。原因是 top-k 本质是排序,FP16 只给 10 位尾数,两个接近的专家分可能被抹平成相等,使平局分辨率依赖归约顺序;fp32 让”非常接近但不相等的两个分数”仍能区分。 - 累加在 fp32。
routed_sum的求和与除法都在 fp32 下进行;torch 参考实现里topk_weights.sum(dim=-1, dtype=torch.float32)也显式指定了 fp32 累加。 - 归一用”零和保护”而不是 epsilon。JIT kernel 的默认
RENORMALIZE_EPSILON = 0.0,走norm = tl.where(routed_sum > 0.0, routed_sum, 1.0);torch 路径用+ 1e-20。两者对”和为 0 时”的语义一致(把分母换成 1,权重保持为原值),差异只在极小正和时的精度——1e-20 在 fp32 的可表示范围内(最小正规数约 (1.18 \times 10^{-38})),不会下溢为 0。 topk_ids为 int32。一是moe_align的桶号需要E + 1,而E = 896尚能塞进 int16;但 padding 用-1以及 sentinel 映射用到无符号解释,窄类型反而增加边界情况。二是打包格式(id << 16) | weight_bits本身要求 int32。三是下游 Triton GEMM 的索引运算习惯 int32,避免每次读 id 都做一次窄转宽。
精度的一般背景可参考 答疑特辑(二):浮点数五问。
分组路由的出处:DeepSeekMoE 与 Loss-Free Balancing
本节把”分组选组 + 偏置修正”这套机制的来源补上,避免把 SGLang 的实现当成凭空设计。
分组本身就是 DeepSeekMoE 的结构(DeepSeekMoE 完全拆解)。把 256 个专家切成 8 组、每组 32 个,是”细粒度专家切分”的自然结果:专家越细,单次 top-k 选出的 8 个专家越可能扎堆在同一组里,路由容量被浪费在”一个组的不同专家”身上。分组选组强制先保证每组至少有一个代表,相当于在”专家多样性”上加一道软约束。图 1 里右侧”细粒度切分 + 共享专家”那一列,就是分组路由的硬件前提。
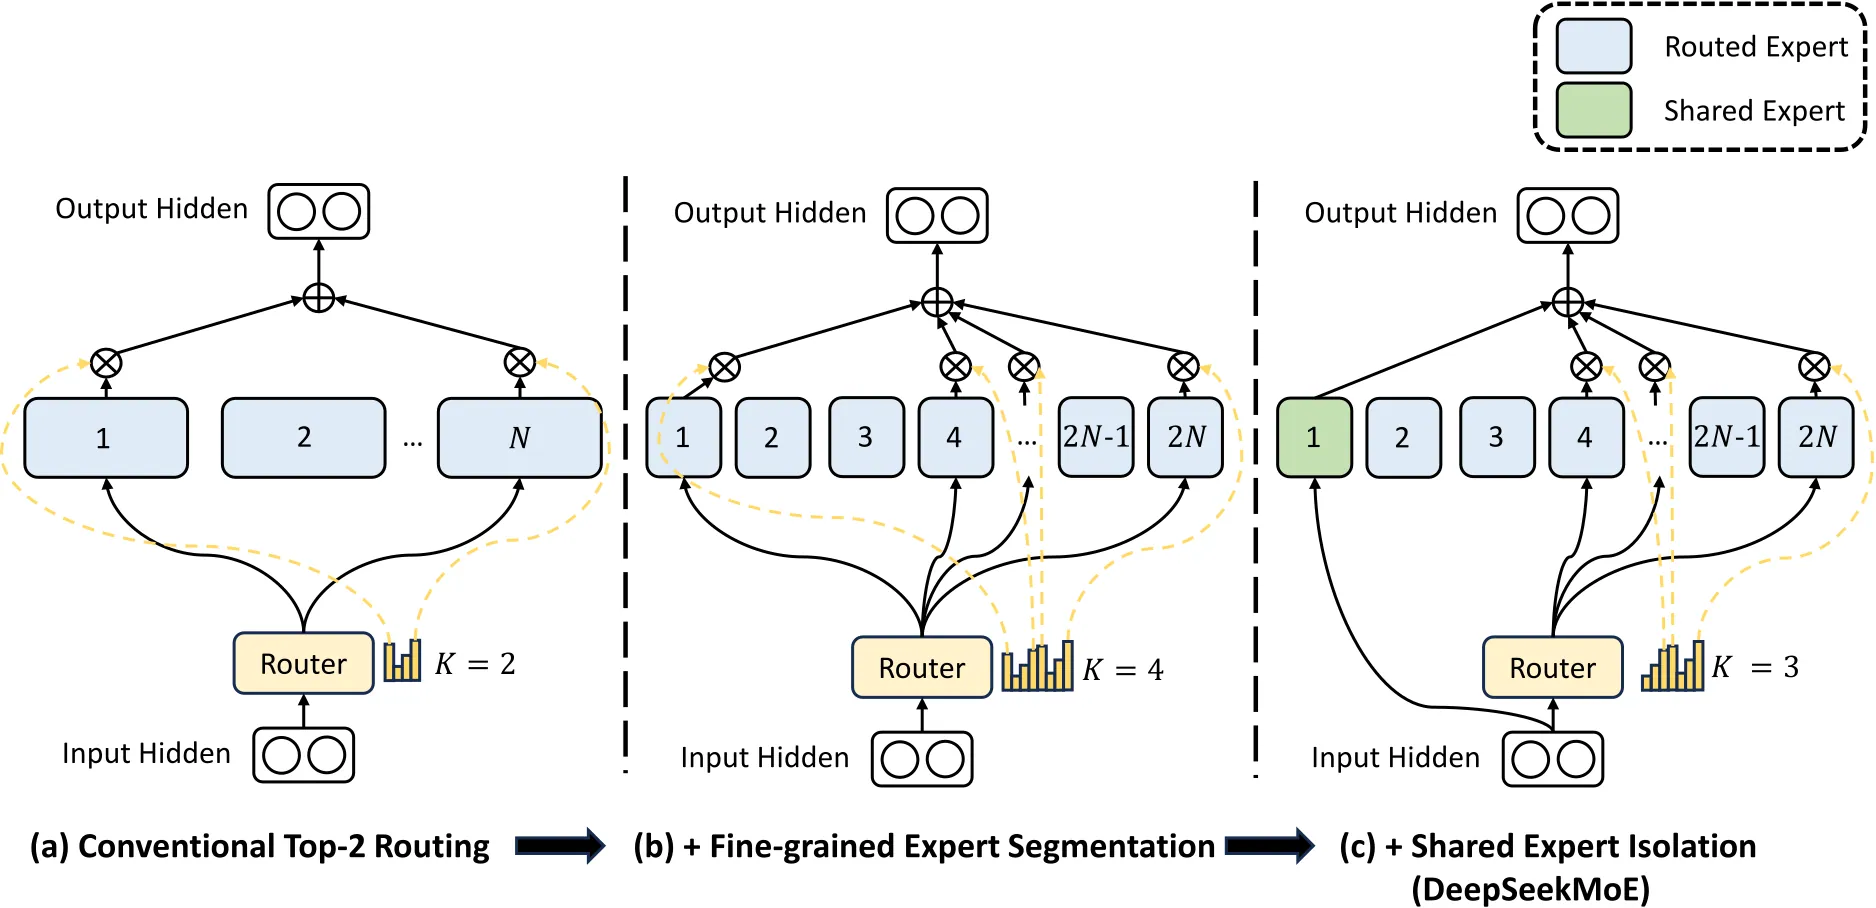
从左到右:传统 MoE 的专家很大、知识混杂;细粒度切分把专家拆小、让路由更精确;共享专家再把”公共知识”从路由路径里摘出来,保证所有 token 都能看到它。SGLang 的 num_fused_shared_experts 和分组 topk,本质上是在执行这张图里的后两步。
修正偏置来自 Loss-Free Balancing(论文,字节跳动 Seed 团队,2024 年 8 月)。传统方法用辅助损失强迫负载均衡,辅助损失越大越均衡、但越伤模型质量;Loss-Free Balancing 改用一组”每个专家一个”的偏置向量 (b_j):训练时每个 step 结束后,负载超高的专家下调 (b_j)、负载过低的专家上调,路由只拿 (s_j + b_j) 去比较。由于 (b_j) 不参与权重计算,它对模型输出的影响被限制在”改变谁来处理这个 token”这一层,而不是”改变每个专家贡献多少”。SGLang 的 correction_bias 参数正是把这个训练期学到的向量带进推理。论文的 Load-Free Balancing 图示(Figure 1)画出了这张偏置更新循环,SGLang 在推理时只执行它的右半圈——“用偏置选”。
为什么 SGLang 还要保留 torch 参考实现:grouped_topk_gpu 与 biased_grouped_topk_impl 都是 torch.compile 或纯 torch 版本。它们不是”性能路径”,而是”语义基线”。当 JIT kernel 在某些特殊配置(逐 token 偏置、专家数不是 2 的幂、topk_group 与 num_expert_group 的组合不被 FlashInfer 接受)下降级到 torch 实现时,两者必须给出同一组 topk_ids。这一点决定了 SGLang 在写 JIT kernel 时要严格遵守 torch.topk 的平局语义(下标较小者优先),否则两条路径会在同一 logit 上选出不同专家。
排查清单:路由层最容易出错的八个地方
把这一层读完之后,遇到”MoE 输出不对 / 吞吐异常 / 结果随 batch 漂移”时,可以按下面顺序排查。每一条都对应源码里一个具体的约定。
一、逻辑专家号与物理槽位混用。 topk.py 产出的是物理 id,select_experts 入口收到的 router_logits 宽度是逻辑专家数。二者在 ep_dispatch_algorithm is None 时相等,一旦启用 EPLB 就不再相等。把 topk_ids 直接当逻辑专家用于统计,会把”物理槽位 7”误认为”逻辑专家 7”。
二、padding 行的 -1 被当成真实专家。 _mask_topk_ids_padded_region 在 CUDA 上写 -1,HIP 上写 0;两种约定都要求下游 moe_align_block_size 能识别。若自己实现下游内核而没有使用 ignore_invalid_expert,-1 + 1 = 0 会被当成”0 号专家”,导致 padding 行参与真实 GEMM。
三、共享专家的缩放被乘了两次。 若路由层已经把 routed_scaling_factor 乘进 topk_weights,下游 epilogue 不能再乘;反之,若共享权重被预写成 (1/s),而下游又跳过了缩放,共享专家就只剩 (1/s) 的贡献。判断依据是 is_routed_scaling_factor_fused_in_topk,不要凭”我记得这里乘过”。
四、归一化的范围包含了共享列。 路由专家的权重归一只能在路由专家之间做;把共享列算进分母会让共享专家的固定权重被压低(或抬高)。主线内核用 routed_sum 显式排除共享列,torch 参考实现用 topk_weights[:, :-num_shared] 求和,两处是同一个语义。
五、分组选组用最大值而非 top-2 之和。 grouped_topk_gpu(无偏置)用 max,biased_grouped_topk_impl(有偏置)用组内 top-2 之和。把两者的组分数混用,会让”组选择”在最边界的情况下出现差异。选择哪种取决于模型的 topk_method,不是性能开关。
六、平局规则不一致。 JIT 内核在”选组”和”选专家”两处都用”id 最小者胜”;torch 的 torch.topk 在 sorted=False 时也保证下标较小者优先。自定义路由函数(custom_routing_function)如果用了不稳定的排序,会让同一请求在不同后端产生不同的 topk_ids。排查”同一 prompt 在 A/B 两个后端结果不同”时,先查这里。
七、output_format 与下游后端不匹配。 BYPASSED 格式意味着路由没有物化;一旦启用 EPLB 重映射,BypassedTopKOutput.router_logits 会直接抛异常。这不是 bug,而是设计约束。看到这个异常时,要么关掉动态 EPLB,要么把后端换成消费 STANDARD 的 kernel。
八、KV 页大小与 MoE 块大小混淆。 moe_align_block_size 的 block_size 是”分组 GEMM 的行块”,与 PagedAttention 的 KV page size(SGLang 默认 1 或 128 token)完全无关。把两者当成同一个参数,会在调优时改错地方:前者影响 GEMM 的对齐浪费,后者影响 KV 的碎片率。
与 DeepInfer 和 vLLM 的横向对照
同一条”token → 专家”的路,在三套框架里被安排在完全不同的位置。
DeepInfer(DeepInfer 源码拆解(三十五):MoE 层的 MLP)把门控、选专家、逻辑到物理映射一起塞进了同一个内核(moe_topk_gate,或 MegaMoE 路径下的 bf16_mega_gate)。它这样做的原因是:标准路径上门控输出 [T, 384] 的 fp32 logits 要先落盘再读回,在 decode 的小 T 下这次中间读写与 GEMM 本身相当。融合之后,logits 只存在于寄存器/共享内存。代价是”路由逻辑”与”专家执行逻辑”绑定得比较紧,换后端就要动内核。
vLLM 的 fused_topk 是 Triton 或 CUDA 内核,但把分组路由、偏置、映射拆成多个较小的步骤,并允许不同 MoE 后端(Triton、CUTLASS、Marlin、DeepGEMM)各自消费 topk_ids。它对”逻辑到物理”的处理依赖 expert_map,但分桶一般在后端内部做。
SGLang 处于中间位置:路由内核本身是融合的(一次 launch 产出权重与 id),但”逻辑到物理”、“共享列追加”、“padding 掩码”、“分布记录”留在 Python 层,并通过 TopKOutputFormat 决定”要不要真的物化”。它的灵活性主要来自 BYPASSED——对于”有能力自己路由”的后端,SGLang 不重复劳动,只做 EPLB 校验。
三者面对同一组硬约束(不能同步主机、账本要能直接下标、结果在 batch 间稳定),但把”融合到什么程度”放在了不同位置。这也是阅读推理框架时一个可复用的观察角度:同一段逻辑放在哪一层,往往决定了框架的扩展方式。
下一篇的入口:从对齐表到分组 GEMM
本篇走到 moe_align_block_size 的输出为止:
输入: topk_ids [T, k(+s)] 物理 expert id,padding 行为 -1 block_size GEMM 的块粒度(Triton 实现通常是 64 或 128 行)输出: sorted_token_ids [max_num_tokens_padded] 按专家排序后的 (token*k + slot) 全局槽位号 expert_ids [max_num_m_blocks] 每个 block 负责的专家号 num_tokens_post_pad [1] 总填充后的 slot 数 cumsum(可选) [E + 2] 每桶起点下一环是分组 GEMM 本身:fused_moe_kernel 如何用 expert_ids[block] 选出权重、用 sorted_token_ids 的 token*k+slot 反拆出 token 与 slot、在 block_size 行上做 A[token] × B[expert],以及 decode 时”每专家只有十几行”的桶如何被 padding、如何与 BLOCK_SIZE_M 的取舍叠加。之后还有 EP 通信(all-to-all 与 DeepEP)与 EPLB 重排两篇——那时会回到本篇的”逻辑到物理映射”表,讲它如何被重新计算并下发到每一层。
参考资料
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



