


世界模型从零讲起(三十三):同一套动力学,换一层粒度还成立吗——多粒度结构管理与抽象误差账本
从上一篇的结尾说起
上一篇讨论的是跨环境的结构迁移:同一个因果变量集合,换一个环境,哪些机制保持不变、哪些参数必须重估、哪些拓扑结构可以复用。那一篇隐含了一个前提——粒度不变。变量还是那些变量,只是它们之间的函数关系换了。
这一篇把前提本身拿出来检查。真实世界模型很少只用一种粒度描述世界。同一台机械臂,在关节控制器看来是六个角度与角速度,在抓取规划器看来是一只正在接近杯子的末端执行器,在任务规划器看来是”把它放到水槽里”这个动作对应的几十秒。三种描述都在描述同一套物理动力学,但变量数目差了几个数量级,时间步长差了上百倍。一个自然的问题是:如果我在细粒度上已经把动力学学得不错,能不能把它压缩成粗粒度的版本继续用?压缩之后粗粒度模型还能不能忠实回答”改变某件小事会发生什么”?
这个问题在因果推断里有确定的名字:因果抽象(Causal Abstraction)。它源自 Rubenstein 等人 2017 年关于结构方程模型跨层一致性的工作,Beckers 与 Halpern 在 2019 年给出完整形式化,同一年 Beckers、Eberhardt 与 Halpern 又把它推广成近似抽象(Approximate Causal Abstraction)。2023 年 Geiger 等人把这一整套理论系统地接入机制可解释性领域,写成了《Causal Abstraction: A Theoretical Foundation for Mechanistic Interpretability》。这一篇要做的事情,是先把这套形式条件讲清楚,再把它落到世界模型的多粒度结构管理上:哪一层应该用哪种粒度、粗化之后误差有多大、这个误差在 rollout 里怎么传播、调度器怎么在精度和算力之间做选择。
一、粒度不是模型属性,而是描述选择
在开始推导之前,需要先把一个常见的误解拆掉。
很多讨论里”多粒度”被当成一种模型结构——比如”这个网络有全局分支和局部分支”。但粒度本质上是一种描述选择,它由三个互相独立的成分决定:
- 变量选择:哪些量被保留为变量,哪些量被聚合掉或丢弃。像素级世界里变量是 个数;物体级世界里变量是十几个物体的位姿;任务级世界里变量可能只有”目标是否达成”一个布尔值。
- 时间步长:一步转移覆盖多长时间。关节控制一步是 20ms,抓取动作一步是几百毫秒,任务一步是几十秒。
- 动作空间:在这个粒度上”能做哪些干预”。细粒度能下关节力矩,粗粒度只能请求”执行抓取动作 ”。
同一套系统在这三个成分上取不同值,就得到不同粒度的模型。所以”粗粒度模型对不对”这个问题不能笼统回答,必须具体到:在哪个变量集合上、哪个时间步长上、对哪一类干预,它是忠实的。
这里有一个容易忽略的对称性:粗粒度不是细粒度的子集,而是一种投影。 细粒度状态有几十万个自由度,粗粒度只有十几个。投影必然丢信息,问题只是丢掉的这部分信息对我们要做的决策有没有影响。如果一个粗粒度模型丢掉了大量细节,但在我们关心的所有干预上给出的预测都和细粒度一致,那它就是好的;反过来,如果它保留了几乎所有状态,只是把 10 个像素合成 1 个格子,那它虽然”粗”了一点,却没有真正获得粗粒度的收益——变量数还是那么多,规划搜索空间几乎没变小。
这就是后面所有讨论的主线:粒度选择是在”丢多少信息”和”搜索/计算省多少”之间做交换,而这个交换是否划算,取决于丢掉的信息在干预下是否可观测。
二、粗化的数学:状态聚合与双模拟
先从最朴素的做法开始:把细粒度状态按某种规则合并。
设细粒度(ground)状态空间为 ,粗粒度(abstract)状态空间为 。粗化映射是一个函数 。如果两个状态 在合并后落到同一个抽象状态,即 ,那么它们就被当成”一样”。
合并本身不难,难点在于合并之后转移怎么定义。最直接的想法是:抽象转移按所有被合并状态的转移概率加权平均。这等于给每个细粒度状态一个初始分布 ,然后计算
这个写法能出结果,但它有一个致命问题:加权平均出来的抽象状态在物理上没有对应物。 想象两个状态 和 被合并成 。 距离障碍物 1cm, 距离障碍物 1m。按平均, 就好像”距离障碍物 50.5cm”。从这个虚构状态出发预测”如果向左移动 1m”,得到的碰撞风险既不对应 的真实情况,也不对应 。更糟的是,如果动作对状态非线性(碰撞就是典型的非线性),平均出来的预测可能完全失真。
这个问题在马尔可夫决策过程的研究里有很长的历史,标准答案是双模拟(bisimulation)。Givan、Dean 与 Greig 在 2003 年的《Equivalence notions and model minimization in Markov decision processes》里系统整理了这类等价关系。双模拟的直觉是:两个状态可以合并,当且仅当在所有动作下,它们转移到相同抽象状态族的概率相同,且立即收益相同。形式地,对于任意动作 和任意抽象状态族 ,
注意这里用的是集合上的总概率而不是”平均转移”,这就避免了虚构均值状态的问题:抽象模型回答的是”到达某一类状态的总概率是多少”,而不是”平均落在哪个状态”。
双模拟有一个非常有用的性质:它精确保持最优策略的价值。 如果 是双模拟,那么在抽象 MDP 上求出的最优动作序列,在细粒度 MDP 上执行也会得到相同的最优价值。这是多粒度世界模型最想要的性质——粗粒度模型可以安全替代细粒度模型做规划。
但双模拟要求非常苛刻。它要求抽象状态族对每个动作的转移概率完全相等,不允许任何近似。在真实环境里,几乎不存在满足完整双模拟的粗化。这引出了两个后续问题:
- 如果允许近似,代价怎么量化?— 这就是因果抽象和近似抽象要解决的。
- 如果我们只关心某个选项(option)集合而不关心所有原始动作,能否放松要求?— 这就是 temporally abstract 的抽象怎么做(见第六节)。
三、因果抽象:干预下的可交换性
双模拟是纯马尔可夫的讨论,它不区分”观测”和”干预”。可是我们要问的问题是:“如果我改变某件小事,结果会怎样”——这是干预问题,不是预测问题。因果抽象正是为干预问题设计的。
3.1 因果模型与干预
先回顾机制(mechanism)视角下的因果模型。Geiger 等人沿用的定义是:
一个确定性因果模型是 ,其中 是签名(变量集合及每个变量的取值域),每个变量 有一个机制 。求解模型就是让所有机制同时满足自己:给定外部变量(如果有的话)的取值,算出每个 的值。这是一个不动点问题,对无环模型总是有唯一解。
硬干预:把变量 的机制替换成常量函数 。直观上就是”把 强行掰到 “。干预之后,只有依赖 之后的部分会改变, 之前的部分不受影响——这正是”Do 演算”区别于”看到 “的地方。
软干预:把机制替换成另一个函数,可以依赖其他变量。例如”让 变成原先值的平方”。
因果抽象的核心思路是:在粗粒度模型上做一个干预 ,其结果应该等于把细粒度模型上对应的干预 执行后的结果再通过 映射过去。也就是说,在粗粒度空间做实验和在细粒度空间做实验、然后把结果投影过来,应当得到同样的结果。
3.2 精确变换
Beckers 与 Halpern 的精确抽象定义可以抽象成一个可交换的图:
横向的 是”把细粒度模型的状态投影到粗粒度空间”,纵向的是”施加干预并求解”。可交换的意思是:先横着走再竖着走,和先竖着走再横着走,到达同一个结果。左边是细粒度模型的干预 ,右边是它对应的粗粒度干预 。
对于每个细粒度干预 ,都有一个对应的粗粒度干预 。精确变换要求对每个允许的 ,下面的式子成立:
左边是:先做细粒度干预,求解,再投影到粗粒度空间。右边是:先把干预投影到粗粒度空间再做,然后求解粗粒度模型。如果两边永远相等,那么这个粗粒度模型就是细粒度模型的一个精确抽象。注意 与 分别负责”状态空间的投影”和”动作/干预空间的投影”,它们是两个独立的选择。
这个定义有几个要点:
- 必须是满射(surjective partial function):粗粒度里每个状态都要有细粒度状态映射过来,否则粗粒度模型里有”凭空出现”的状态,没有对应的物理现实。
- 必须是序保持的(order preserving):如果细粒度干预 “比” 更强(),那么对应到粗粒度也应保持这个次序。这是为了让粗粒度模型上的干预语义和细粒度对齐。
- 公式是逐干预点对点成立的,不是某种统计意义上的”平均成立”。所以它是无近似的严格条件。
3.3 最常见的一种:构造性因果抽象
在精确变换的几种形态里,工程上最常碰到的是构造性因果抽象(Constructive Causal Abstraction)。它的做法是:
- 先用 把细粒度变量组合成粗粒度变量, 通常就是”取某些变量的函数”——例如”物体位置 = 物体像素块的质心坐标”。
- 对粗粒度变量 定义一个构造出来的机制 :它不直接学,而是先通过 的”抬升”从粗粒度配置回到一个细粒度配置族,在族里求解细粒度机制,再把结果通过 投影回来。
- 检查对每个粗粒度干预 ,上面那张可交换图都成立。
它的价值在于:粗层机制不是另起炉灶训练出来的另一个模型,而是对细层机制的显式重构。 所以它天然满足”忠实”,代价是粗化映射 必须足够简单、可逆性足够好。这也是为什么第五节的物体级粗化都倾向于用显式的几何聚合,而不是一个不受约束的编码器。
与它对应的是双射翻译(Bijective Translation): 是双射,信息没有任何损失,本质上只是换个坐标系。抽象程度最低,只能用于重参数化,不能用于真正的跨粒度压缩。
四、近似抽象与”映射太强”的陷阱
精确抽象很漂亮,但它是全有或全无的。一个真实世界模型不可能在每一帧、每一个干预上都精确满足可交换。更麻烦的是,精确抽象的失败方式也不有用:如果我们想量化”这个粗化有多忠实”,精确抽象只给是/否两种答案。
4.1 近似变换的定义
Beckers、Eberhardt 与 Halpern 在 2019 年的《Approximate Causal Abstraction》里把它推广成可以量化的形式。Geiger 等人的综述把它写成:
给定
- 距离(或相似度)函数 ,把两个粗粒度完整配置映射成一个实数;
- 一个干预上的概率分布 ,描述我们预期会遇到的干预分布;
- 一个聚合统计量 (如期望、最大值),
近似程度定义为
如果这个数在某个阈值 之下(或之上,取依赖 的约定),就称粗粒度模型是 -近似抽象。
这个式子拆开看是三个独立的设计决定:
- 决定我们在意哪类干预。 它把”忠实”从绝对概念变成相对概念。如果我们只在”机器人被轻轻推动”这类干预上关心预测,那 只在这些干预上有质量,细粒度模型对”推 10kN 力”的预测再准也不计入分数。这一点在工程上特别重要:粒度对不对是一个分布相关的问题。
- 决定误差用什么尺度来量。 如果粗粒度状态是”物体位置”, 可能就是欧氏距离;如果是”任务是否完成”的示性变量, 可能就是 0/1 损失。同一个抽象,在不同 下的近似等级完全不同。
- 决定我们关心平均误差还是最坏误差。 期望(average)适合”多数情况下误差小”,最大值(max)适合”不能有超限失败”。Beckers 等人原本给出的 - 近似取的就是最大值。两者会导致非常不同的粒度选择。
4.2 映射太强会让理论失效
2025 年 Sutter、Minder、Hofmann、Pimentel 发表的《The Non-Linear Representation Dilemma: Is Causal Abstraction Enough for Mechanistic Interpretability?》点出了这个理论的一个核心漏洞。
因果抽象的定义里没有规定 必须是线性的。它可以是任意函数——只要存在一个满射的 和一个序保持的 ,可交换图就成立。问题是:如果 可以是任意函数,那么任何模型都可以抽象成任何算法。 Sutter 等人证明,在合理假设下,任意神经网络都能映射成任意算法(比如冒泡排序、比如一个简单的符号程序)。
这个结果听起来像”任意网络都能被解释为任意算法”,非常反直觉,但它其实说明一件事:抽象的”忠实程度”不能仅仅由映射存在性来断言,必须同时约束映射的形式、映射的复杂度、以及它在你关心的干预分布上的误差。
这条批评对世界模型有一个直接的推论:如果一个粗粒度世界模型声称”捕捉了任务级因果结构”,但不能证明 的复杂度或者不能在各层 上给出有界的近似误差,那它的”捕捉”是空的。 这解释了为什么工程实践里更常看到”在某层做显式聚合、用有限几个抽象变量、再做误差审计”的做法,而不是”训练一个任意映射然后声称它学到了抽象”。
五、世界模型里的四层粒度
上面都是形式化讨论,现在回到世界模型本身。从大量现有工作可以归纳出四种常见的粒度层,每一层有自己惯用的状态变量、动作接口和误差来源。
5.1 像素层
状态是图像或视频帧。动作是每帧施加的低层控制。典型代表是视频生成式世界模型(Sora、GAIA-1、Cosmos、Genie 这类)以及世界模型里的 DINO-WM 等潜空间模型。
- 变量:像素级、数以万计。
- 时间步长:每帧 33ms 到 100ms。
- 优点:一切都在观测量里,不需要额外标注。
- 误差来源:像素级复合误差,在几十帧之后完全脱离真实;长程一致性极差。
- 抽象程度:最低(几乎不丢信息,但抽象带来的算力节省也最少)。
5.2 潜空间层
状态是学出来的隐向量 , 大约几百到几千。动作仍可以是低层控制。典型代表是 Dreamer、TD-MPC2、PlaNet 这类。
- 变量:隐向量,维度小两个数量级。
- 时间步长:与像素层相同(每一帧或每一次控制)。
- 优点:变量数和算力比像素层小得多,可做大规模 rollout。
- 误差来源:编码器丢掉的细节不会在潜空间里被补回来;如果编码器对齐有问题,潜空间动力学会偏离物理。
- 抽象程度:中等。
5.3 物体/场景图层
状态是若干个物体的位姿、类别、相互关系的图。典型代表是 Slot Attention 系(可参考 《世界模型从零讲起(十三):把世界拆成物体——Slot Attention 与物体中心的动力学》)、场景图世界模型(SGImagineNav)、以及 QCC-WM 里的宏节点。
- 变量: 个物体,每个物体几十个自由度。
- 时间步长:与像素层接近,但一步可以覆盖”整个抓取动作”。
- 优点:变量可解释、可组合、可做关系推理;错误不再从像素级复合,而是从物体身份、属性聚合上复合。
- 误差来源:物体漏检、分裂、混淆;聚合后的属性丢失接触状态、材质等对动力学敏感的信息。
- 抽象程度:高。
5.4 任务/符号层
状态是”任务进度”、“子目标是否完成”等少量符号变量。典型代表是分层 RL 里的高层策略、符号世界模型(如 LLM 生成的世界模型)。
- 变量: 或 个。
- 时间步长:整段子任务,几十秒。
- 优点:搜索空间小,可以做长时规划。
- 误差来源:子任务本身的成功率、跨层接口歧义、对初始状态的敏感性。
- 抽象程度:最高。
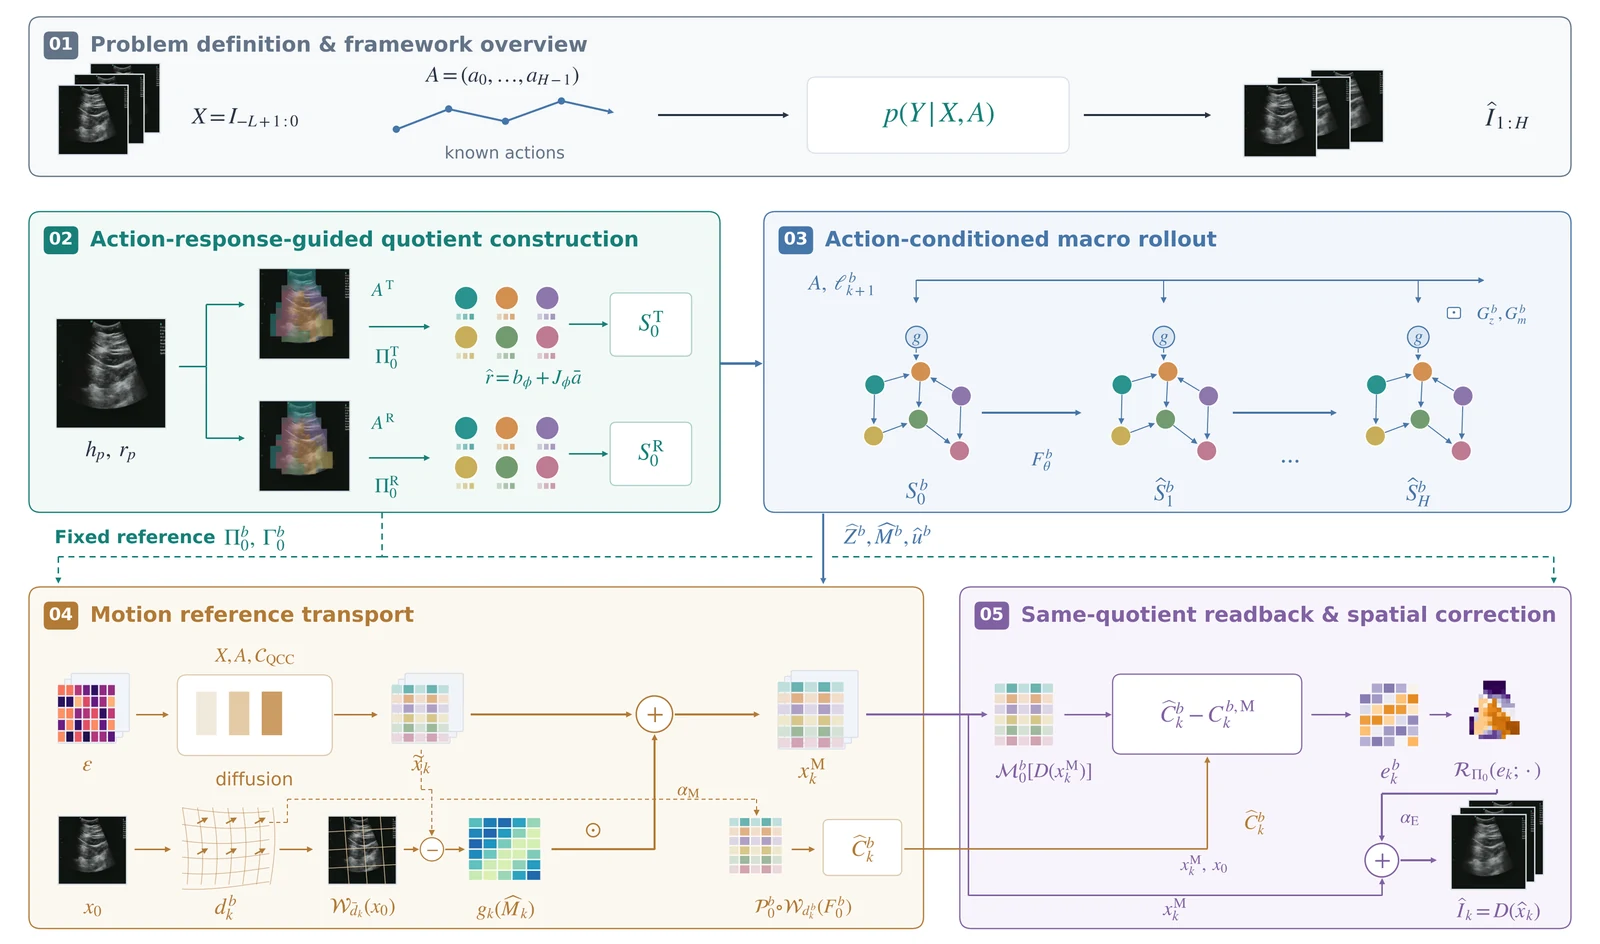
上图是 QCC-WM(2026)的整体框架,它大致对应”像素层 → 宏节点层”的一种显式粗化。最上面两个方框是问题定义与框架总览:给定历史观测 和已知动作计划 ,要学习条件分布 。四个主模块从左到右: (a) 动作响应引导的商空间构造——用动作引起的局部响应来组织宏节点; (b) 动作条件化的宏状态 rollout——在固定的参考商测度下递归预测内容与运动; (c) 运动参考传输——把预测出的运动作用到参考图像潜变量上; (d) 同位测度读回与空间校正——用同一套商测度量出当前生成的宏级内容误差 ,再映回局部空间做校正。
它之所以是多粒度问题的好样本,是因为它把”粗化”的每一步都显式定义了映射:哪个像素区域属于哪个宏节点、宏节点的状态怎么测、宏级预测怎么映回局部空间。这正好对应第三节里的 与 要有明确定义。
5.5 四层之间的抽象关系
四层之间不是简单的链式嵌套,而是”同一动力的不同投影”。可以画一张表:
| 层 | 变量规模 | 时间粒度 | 可表达的动作 | 适合的决策 | 抽象误差主导项 |
|---|---|---|---|---|---|
| 像素 | – | 1 帧 | 低层控制 | 视觉预测、生成 | 像素复合误差 |
| 潜空间 | – | 1 帧 | 低层控制 | rollout、规划 | 编码器信息损失 |
| 物体层 | – | 百 ms | 抓取、移动等原语 | 中程规划 | 物体身份与属性丢失 |
| 任务层 | 数十秒 | 子任务、技能 | 长程规划 | 子任务接口歧义 |
这张表的意义在于:同一段想象中的同一个动作指令,在四层里的”精度-算力”比完全不同。 这正是第 7 节要形式化的问题。
六、时间抽象与空间抽象:两类粗化
前面五节把粗化看成一个整体。实际上,多粒度结构管理里有两条不同的粗化轴,它们带来的数学性质差别很大。
6.1 空间抽象:把”像素簇”合成”物体”
QCC-WM(2026,《QCC-WM: Linking Macro-State Dynamics and Visual Generation via Quotient Causal Construction》)的做法属于空间抽象。它用预训练的 I-JEPA 编码器提取观测特征,然后:
- 维护一组全局原型 ,每个原型对应一个宏节点;
- 用动作计划调节局部特征与原型之间的亲和度——注意这一步很关键,它不是单纯做聚类,而是让节点组织方式本身依赖动作;
- 结合空间距离确定软分配,并迭代更新节点质心,得到每个宏节点的空间支撑(即 、 这些商测度);
- 从历史描述符预测局部动作响应,把响应也纳入软分配,再做几轮精化。
这里 是软分配矩阵:每个像素有一定概率属于每个节点。粗粒度状态就是这些节点的聚合测量。QCC 的关键设计是同一套商测度用在三处:构成目标、未来监督、生成读回。读回用的是
其中 是解码器, 是商测度。由于目标构造和读回共享同一套 ,误差 的节点定义和空间原点都是固定的,所以它才是有意义的”差距”,而不是两套不同测量口径的差。
这就是一条工程原则:在粗粒度上定义的误差,必须用同一套映射去测量。 否则误差永远不可比。后面第七节会讲这条原则怎么变成一个通用约束。
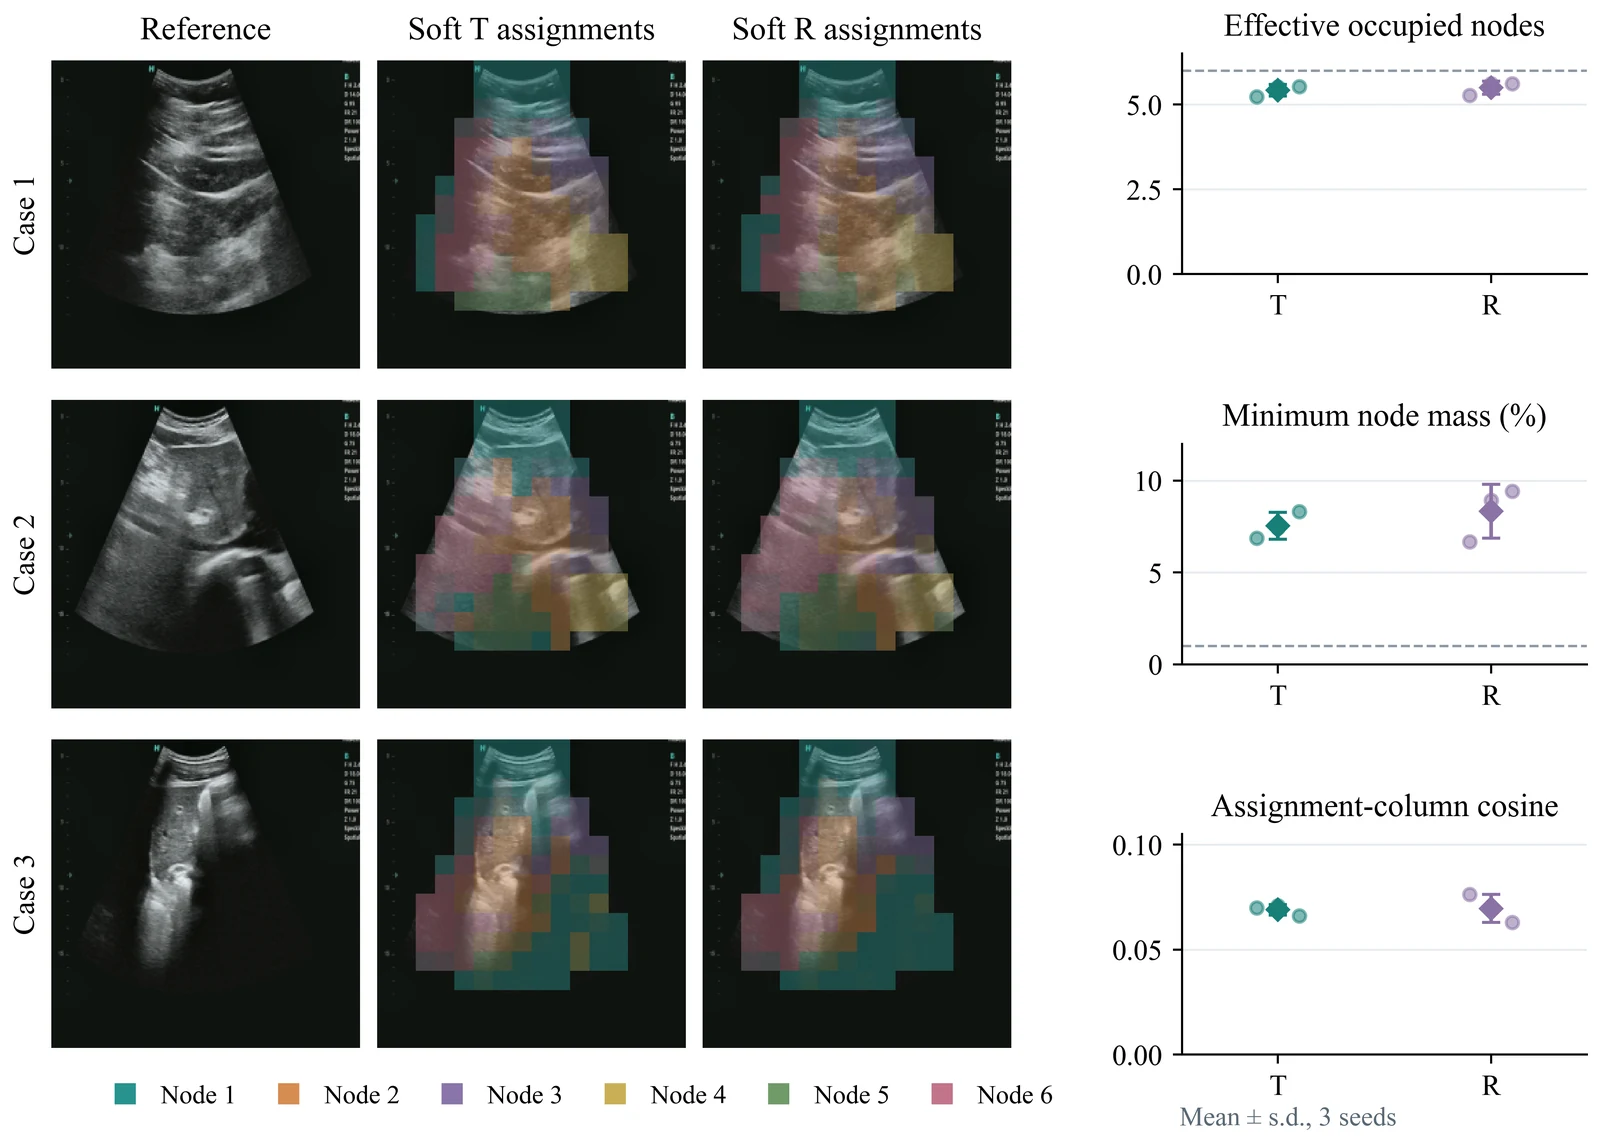
上图展示 QCC 的构造过程:从 I-JEPA 特征出发,经过原型分组、动作响应调制、迭代质心更新,得到每个宏节点的空间支撑。注意图中每个节点的颜色不同、边界是软分配,这对应 不是硬划分。硬划分会让一个像素只属于一个节点,软分配则允许相邻节点对边界像素共同负责,代价是计算量略增,收益是粗化误差在边界处更小。
SGImagineNav(2025)的做法是另一种空间抽象:它维护一个层级场景图,节点是房间、家具、物体,用大型视觉语言模型预测未见区域,再据此做语义导航。它没有 QCC 那样的连续商测度,但它的层级结构本身就是一种粗化:从物体层到房间层,父节点聚合子节点的空间关系。
6.2 时间抽象:把”长串动作”合成”技能”
时间抽象的代表是 option 框架(Sutton、Precup、Singh,1999)。一个 option 由三元组 定义:启动集 、内部策略 、终止条件 。执行一个 option 相当于在细粒度上执行一段策略,直到 触发。
上层模型看到的环境,是”只允许执行 option”之后的粗化 MDP:
其中 是 option 执行的时间长度。这一步粗化最直接的效果是:时间步长变成了”以 option 为单位”,而不再是原始控制步。 一段一分钟的想象,在细粒度上需要 3000 步,在 option 粒度上只需要十步左右。
Rodriguez-Sanchez 与 Konidaris 在 2024 年的《Learning Abstract World Model for Value-preserving Planning with Options》里给出了时间抽象下的动力学保持抽象(Dynamics-Preserving Abstraction)定义。他们的出发点是:给定一个 option 集合,能不能学出一个映射 (),使得在 压缩后的空间里,粗粒度轨迹的分布与细粒度一致?
他们的定义是:如果对所有可达状态 和所有 option ,下面成立
就称 是动力学保持的。注意第一行右边是 ——这说明 是预测下一状态分布的充分统计量;第二行保证 option 的启动条件也只看 。
他们特意指出两点与传统双模拟的区别:
- 更强的状态充分性: 必须是下一状态分布的充分统计量(相当于 Markov 性要求),比双模拟那种”在抽象集合上总概率相同”更强。这一点是关键的工程含义:在 option 粒度上做抽象时,不能只是聚类,必须保证抽象状态本身是下一步预测的充分统计量。
- 不要求关于真奖励保 Markov:因为一个抽象模型会复用于多个任务(任务奖励是后加的),如果要求对真奖励保 Markov,就限制了能抽掉的变量数。只要求对 option 动力学和启动条件忠实,使抽象在尽可能多的变量上成立。
这两点正是工程上常遇到的取舍:抽象的价值在于复用。一旦抽象里塞进了任务专有的奖励信息,它就在多任务之间不再通用。这条取舍与上一篇讨论的”哪些因果结构可以跨环境复用”是同一个问题的两个侧面。
他们用互信息来学习 ,目标为
即希望 尽可能多地保留”对下一状态与 option 启动的可预测性”。这个目标正是动力学保持定义的信息论版。
6.3 两类抽象不能混为一谈
空间抽象粗化的”变量”多、时间粒度不变;时间抽象反过来,时间步长大、变量不变。两者的误差机制也完全不同:
- 空间抽象的误差来自合并导致的混合:不同物理状态被映射到同一个抽象变量,动作的结果分布被抹平。
- 时间抽象的误差来自跨步复合:一次 option 执行内部有 步,每步误差复合,终点分布被放大。
所以一个模型要同时用两种粒度,就需要分别定义和分别审计误差——这正是第十节”失效边界”要展开的。
七、多粒度组合:单层粗化还是层级粗化
真实系统很少只做一次粗化。常见的是层级化:粗化 -> 再粗化 -> 再粗化。
Schiewer、Subramoney、Wiskott 在 2024 年的《Exploring the limits of Hierarchical World Models in Reinforcement Learning》里给出一个非常有代表性的层级世界模型。它是一个逐层时间压缩的世界模型栈:
- 第 层接收的原轨迹是前一层每 步压缩过一次的版本;
- 观测只为第 0 层保留;
- 目标 :每一段 取该段最后一步的模型状态 ;
- 奖励 ;
- 终止标志 。
这个压缩规则很有讲究。目标取段末模型状态,这样做是为了让第 层和第 层之间有”语义连接”:第 层的目标是第 层的终点,而不是某个虚构的平均状态。奖励取段均值、终止取段最大值,都是保守的聚合——只要段内有一次终止,段就被标记为终止,避免”段内发生终止但段终状态没变”的歧义。
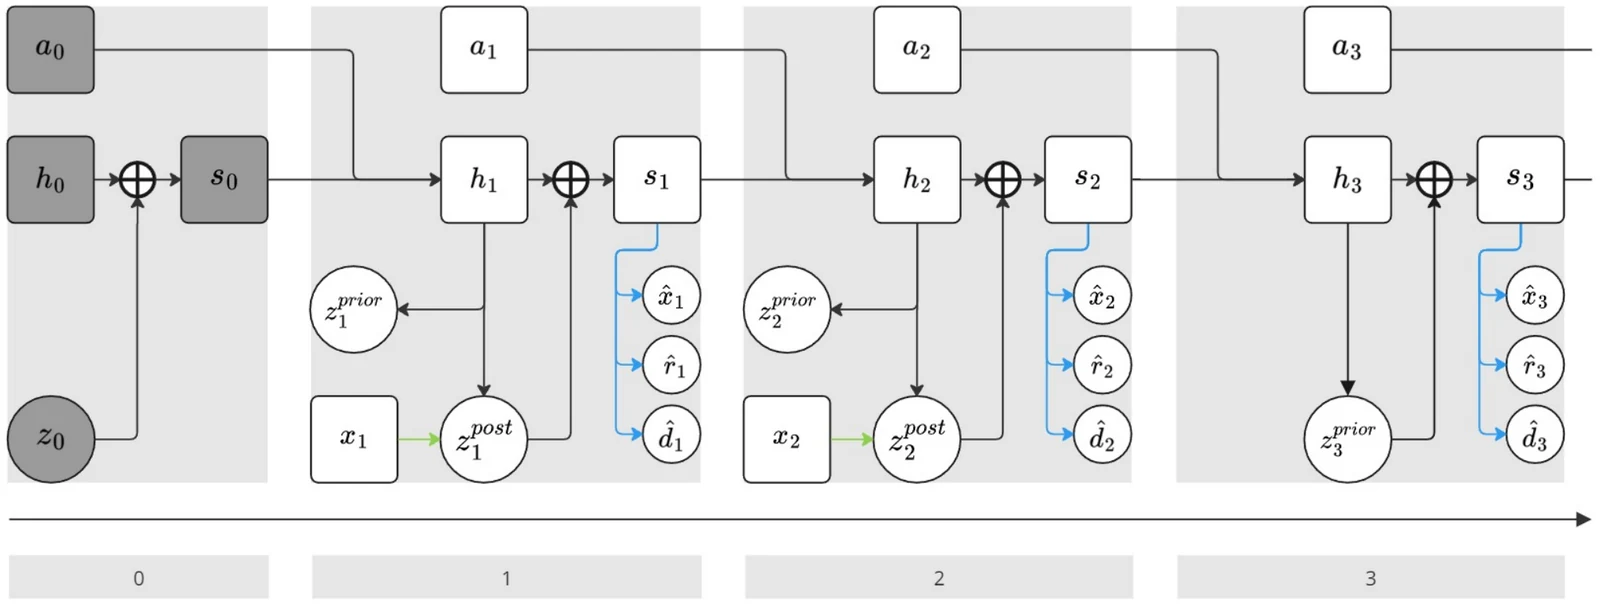
上图是这篇论文中 RSSM rollout 图的示意:每个灰框是一段时间步,方块代表确定性隐状态(GRU 递推部分),圆圈代表随机潜变量(分布采样部分),时间步按灰框分组。在层级世界模型中,每一层的 恰好对应一组这样的灰框,第 层看到的是”一组灰框的终点状态”,而不是灰框内部的变化。这就清楚地展示了前面那个公式:粗化在每层只保留段末状态,段内的细节全部被丢弃。
7.1 压缩比例与误差的关系
给定最底层时间步长 和每层的压缩比例 ,第 层的时间步长是:
一个 3 层模型、每层压缩 或 ,顶层步长就是 ——如果底层是 50ms,顶层一步覆盖 300ms。对于”走到门口”这类任务,300ms 的粒度可能够用;对于”抓住滑动的杯子”,300ms 的粒度就太粗。
论文的模型利用实验直接暴露了这个问题:在一个改动过的 Nav2d 环境里(进入终点区域就给奖励),层级智能体学会了”笔直冲向终点”,但在终点附近会来回抖动或后退几步——人工检查模拟奖励时发现,第 1 层智能体在某些步拿到了正奖励,却没有触发终止标志 1,这在真实环境里是不可能的。也就是说,第 1 层模型在终点区域边界处给出了真实的虚假状态:奖励和终止的不一致。这就是层级粗化导致的虚假自由:粗化后的模型不能表达真实约束,规划器就去利用这个漏洞。
这个现象说明:层级化不是免费午餐。 每加一层,就多一个”粗化不真实性”的漏洞面,而且这个漏洞面会随着层数增加而增大,因为粗层利用的是多个细层共同积累的空洞。粗化的收益是算力,代价是给规划器制造了可被利用的虚假自由。
这里还有一条经验教训:奖励和终止标志的聚合方式必须一致。 论文的规则是奖励取段均值、终止取段最大值。这个设计避免了”段内终止”被漏掉,但没有避免”段末给出正奖励却没终止”的不一致——因为均值奖励可以在段内某一步拿到 1,而终止标志却来自别的步。如果两个聚合方式来自不同的段内步,粗层就可能同时认为这两件事都成立。 工程上通常的做法是把奖励、终止、状态这三样从同一个段末时刻读取,代价是丢失段内的瞬时奖励,收益是粗层不会自相矛盾。
7.2 图世界模型中的多粒度:不是时间,而是”视野”
WorldGraph(2026,《Graph-Native World Modeling》)给多粒度提供了另一个角度:不是时间上的粒度,而是结构视野上的粒度。
它把世界状态定义为一张演化的图 ,演化的差分是 。它的状态模型是
即世界状态既包含当前图,也包含上一段的差分,还包含之前的隐状态。这里的”粒度”体现在结构视野:有些图转移依赖长程链(例如两个没有直接共投票边的国家,可能通过多个中间节点的多跳链联系起来),有些转移只依赖局部近邻(例如用户近期偏好)。所以它的状态编码器用两路互补的视图:
- 跳级消息传递(hop-level message passing):对每个节点,计算 跳以内的邻居嵌入 。
- 随机游走路径采样(random-walk path sampling):从每个节点出发采样 条路径,每条路径用注意力聚合整条路径上的节点特征。
- 多粒度注意力融合(multi-granularity attention fusion):把两路嵌入融合成结构感知节点嵌入 ,再做平均池化得到图嵌入 。
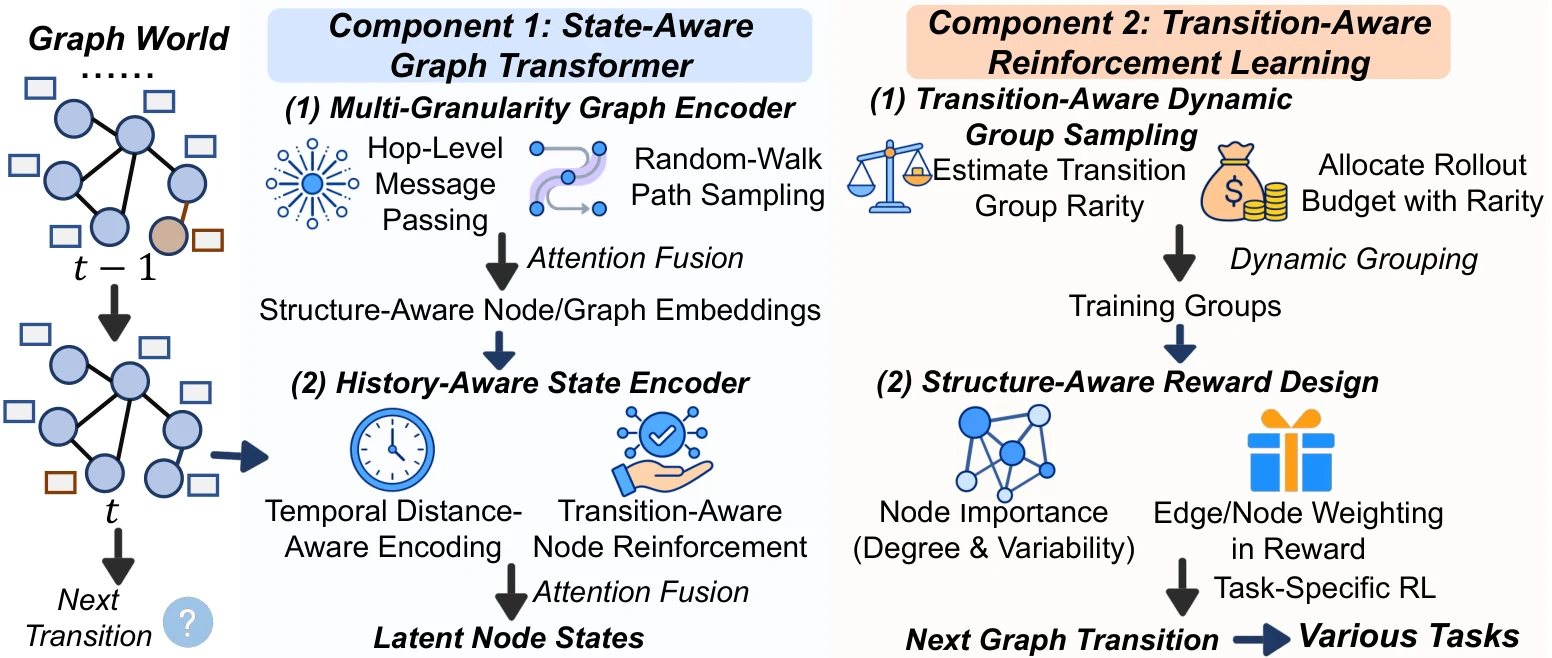
上图是 WorldGraph 的整体结构,右边 Component 1 是状态感知的图 Transformer:上面一路做跳级消息传递(hop-level message passing),下面一路做随机游走路径采样(random-walk path sampling),再注意力融合成结构感知节点/图嵌入。Component 2 是转移感知的强化学习,用动态分组采样和结构感知的奖励设计来训练。
从抽象的角度看,WorldGraph 的两种视图构成了一个”多粒度”:跳级视图在结构上是局部的、确定性的、每跳一层就扩大一次感受野;路径视图在结构上是全局的、采样性的、每条路径覆盖一条随机信道。两者融合后 和 可以分别独立调整,就像时间维的分层压缩一样控制”粗化程度”。
论文的复杂度分析印证了这两条路是不同粒度:跳级部分的复杂度是 量级(与图大小和跳数相关),路径部分与 与路径长度 和节点数 相关。两条路可以独立调度——如果某类转移主要是局部决定,就减小 和 ;如果主要是全局多跳,就增大。这就是后面第九节”按需粒度”的雏形。
八、抽象误差的三项分解与 rollout 传播
现在到这一篇最核心的技术部分:抽象误差怎么拆、怎么传播。
8.1 三项分解
把一个粗化的世界模型和它对应的细粒度模型放在一起看,一个粗化层 的抽象误差可以分解成三个来源(这三个来源与第五节表格最右列对应):
- 投影误差:细粒度状态通过 投影到粗粒度后,粗粒度变量是否还能保留对下一步预测的充分信息。这对应 的构造是否过于激进。若 把两个物理上很不一样的状态合并(比如 靠近障碍、 远离障碍),投影误差就大。QCC-WM 用软分配降低投影误差:靠边界的像素可以同时属于两个节点,不完全合并。
- 动力学误差:粗粒度模型 本身预测下一粗状态的误差。这对应 与真实粗化转移的距离,与 无关,是学习问题。
- 读回误差:粗粒度预测映回细粒度( 或 的反向)时的误差。这一项常被忽略,但 QCC-WM 专门用同位读回测出来:它用同一套商测度去测生成的宏内容与目标之间的差距,得到的 就是读回误差的观测。若读回映射与目标构造用的不是同一套测度,读回误差会被测量口径本身掩盖。
三项各自有独立的控制手段:
| 误差项 | 来源 | 主要控制手段 | 典型失败 |
|---|---|---|---|
| 投影 | 过度合并 | 软分配、依赖动作的节点组织 | 边界处预测完全错位 |
| 动力学 | 粗层学得不准 | 更多数据、模型容量、在粗层加约束 | 粗层预测漂移 |
| 读回 | 映射不一致 | 用同一套测度读回(QCC 的做法)、显式空间校正 | 预测看着对但落点差 |
三项分解是分析工具,实测还需要一个可操作的探针。机制可解释性里的对齐交换干预(aligned interchange intervention)提供了一个直接的做法:取一对输入(base 与 source),在细粒度模型的某一组变量上,把 base 的取值强行替换成 source 在该组变量上的取值,得到细粒度输出;再对粗粒度模型做对应的替换,得到粗粒度输出。若粗化映射 是忠实的,这两条路径的结果在粗粒度空间的差应该很小。把所有可能的替换组合做一遍,结果一致的比例就是交换干预准确率(Interchange Intervention Accuracy)。它比”比较观测分布”更严格,因为它强制模型对反事实输入给出正确响应;又比”精确抽象”更可用,因为它给出的是一个 0 到 1 之间的分数,可以直接当粒度选择的依据。
对齐交换干预还解决了”往哪一层替换”的问题:在粗化场景里,替换的目标集合本身就可以按粒度选。在物体层做交换,考的是物体变量的因果角色;在任务层做交换,考的是子任务接口的因果角色。同一套探针在不同粒度上重复,就得到一张”误差随粒度变化”的曲线,比任何单点指标都好用。
8.2 误差在三项之间的传导
三项不是独立的。投影误差会抬高动力学误差的下限:如果 把物理上不同状态合并,粗层动力学再怎么学也无法预测被合并状态的分支——因为信息在输入时就被抹掉了。所以有
即投影误差设了一个下限。这个不等式在工程上的含义是:先修投影,再修动力学。 如果粗层学习一直不收敛,先检查是不是粗化本身把信息抹掉了。这与机制可解释性里的经验一致:不是所有”网络学不到”都是训练问题,有些是表示层本身不允许表达。
读回误差则会放大动力学误差:粗层预测的粗状态 经过读回,可能有多种细粒度实现,读回选择哪一个会带来额外误差。QCC-WM 的做法是不仅读回,还做显式空间校正——用节点-位置的映射直接把误差展开到局部空间。
8.3 rollout 中的误差传播
单步误差小,不代表多步误差小。假设每一步的粗化误差都把粗状态扰动一个固定的量级 ,而动力学在每个扰动方向上按雅可比矩阵 传递它。于是 rollout 步后,最坏情况下的复合误差由各步扰动之和给出:
若把雅可比范数近似成常数 ,就得到常用的经验估计 (扰动逐帧放大的情形则用 : 是粗层动力学雅可比矩阵的谱半径估计)。下面讨论用后一种形式。
注意这里的尺度很直观:如果粗层动力学是开环不稳定的(),粗化误差会被逐帧放大。 这就是为什么上一篇讨论闭环误差时强调,粗层的稳定性条件比单步精度更重要。一个单步误差 1% 的粗化,如果在 的动力学下跑 100 步,复合误差就是 ——完全爆炸。相反, 的粗化误差即使在 100 步后也会衰减到约 。
这个公式和粗化层的选择直接相关:
- 粗化让 增大还是减小? 这取决于被合并的变量。如果合并掉的是不稳定变量(例如两个刚体之间的碰撞检测),那粗化后粗层动力学变得”看起来”稳定(因为碰撞被抹平了),但这是虚假稳定;一旦实际在细层执行,碰撞会发生,粗层根本没有对应。所以粗化后的谱半径 不能单独证明粗化安全,必须检查被合并的变量里是否承载了不稳定模式。
- 时间抽象让 减小:这是它最直接的好处。同样的物理时长,option 粒度只有 步,复合误差的线性累积立刻被砍掉一个因子 。这也是层级世界模型的核心动机。
但时间抽象带来一个新问题:终点分布的方差反而更大。 因为每个 option 内部有 步,终点分布是 步分布的复合,分布本身变宽。所以对”点到点”的精度要求,粒度太粗反而更差。这就是为什么后面要做”预算-误差”的联合优化,而不是单纯追求最小 。
九、粒度选择:一个带预算的调度问题
讲完误差,就可以形式化”该用哪一层”了。
9.1 问题设定
设一个任务需要在物理时长 内做出决策。可用粒度集合是 ,每层 有时间步长 和单步抽象误差 (由第八节的分解给出)。每层做一次预测的计算代价是 (与前向计算量相关,通常 )。决策要求的精度门限是 。
要选的是:每段物理时间里用哪一层,以及该层的规划深度 。
一个简单的启发:每层的单步误差与复合误差都要检查。 用第八节的经验式:
这组约束的意思是:在第 层做 步 rollout,复合误差必须小于门限。 随 增大而迅速减小(时间步长变大),而 也随 增大而迅速减小。但 随 增大而显著增大(粗层丢的信息更多),所以两个方向相反的力量会互相抵消,导致三种可能: 时粗化几乎总是更差( 变小救不了指数放大); 时粗化更稳且更省( 变小直接压制误差); 时看 随粒度增长的速度。
9.2 一个数值例子
取一个具体场景。假设一个 7 自由度机械臂,任务是”把杯子从桌上放到水槽里”,物理时长 s。
- 第 0 层(关节控制):ms,cm 级的末端位置误差(用真实传感器验证),;。
- 第 1 层(抓取原语):ms,cm 级误差,;。
- 第 2 层(子任务):s,cm 级误差,;。
情形 A:(临界情形)。 三层复合误差量级分别是:第 0 层 ;第 1 层 ;第 2 层 。三层复合误差量级恰好相近。 这不是巧合:粗化的代价 被时间步长变长带来的 减小所补偿,在误差随粒度线性增长、动力学谱半径接近 1 时,复合误差与粒度近似无关。算力从 看,第 0 层是 150,第 1 层是 1.5,第 2 层是 0.03——差了两三个数量级。所以换粒度的收益几乎全在算力侧,代价几乎全在单步误差侧。这就是为什么临界情形下应该”用尽量粗的粒度做大部分规划”。但注意:这里的”近似无关”是指量级差在常数因子以内,不是”完全一样”。
情形 B:(稳定衰减)。 第 0 层 ;第 1 层 ;第 2 层 。粗层反而更差——虽然每层的指数衰减都压住了误差,但粗层的单步误差大了两个数量级,衰减不足以补偿。这时候细层反而是对的,直到单步误差差异大到超过衰减。这推翻了”粒度越粗越好”的直觉。
情形 C:(指数放大)。 第 0 层 ;第 1 层 ;第 2 层 。粗层好得多——因为指数项 在 大时炸开,而 小直接压住了它。这就是为什么在处理接触、碰撞这类本质上不稳定段时,即使粗层的单步误差更大,只要它的”不稳定模式”被正确保留,粗层反而可能更稳。
三种情形的对比说明:粒度选择不是查表,而是要先测量 。同一组 、、,在不同的 下最优层可能完全不同。这就是为什么第九节最后要强调”必须先测谱半径”。这也暴露了一个工程上常犯的错误:直接用”单步误差”来选粒度。单步误差是局部量,复合误差才是决策量,两者差一个 因子。
实用原则(在 或 的稳定段):在精度允许的前提下,用尽量粗的粒度做大部分规划,只在关键决策点用细粒度。 在 的不稳定段,则是:用能保留不稳定模式的最粗粒度,且必须显式验证该模式没被合并掉。 前者是”省钱优先”,后者是”稳定优先”。这就引出下一节的”混合粒度调度”。
9.3 混合粒度与边界
更精细的做法是混合粒度调度:不是整段用一个粒度,而是根据任务状态选择粒度。
一个可行的规则:
- 接触密集段用细粒度( 对接触状态高度敏感)。
- 自由移动段用粗粒度( 减少的直接收益最大)。
- 任务分叉点(多个子目标分叉)用能保留所有分叉的粒度,并在分叉后用细粒度重放一段。
下一篇会专门讲”同一任务里怎么切粒度”。这里只把误差约束写清楚。
混合粒度调度有一个数学上很优雅的写法:把调度变量 看成”第 段用第 层”的指示变量,优化
这就是一个 0-1 规划问题。实践中不必严格求解,贪心按”单位时间算力收益/误差增量”排序即可。
九点五、结构管理:变量不是白选的
第九节的调度问题隐含了一个假设:粒度层已经给定,只需在层之间调度。 但粗层的变量集合是怎么来的?这是一个比调度更上层的问题,也是”结构管理”里”管理”二字真正指向的地方。
9.5.1 变量选择的三条原则
第五节的四层粒度只是常见形态,不是唯一答案。在一个具体场景里,粗层应该选哪些变量,有三条经验原则:
- 充分性优先:粗层变量必须足以预测下一步的动作效果,而不只是足以重建观测。Rodriguez-Sanchez 与 Konidaris 的定义把这一条写成 ,即 是下一状态的充分统计量。重建观测的充分性与预测转移的充分性常常不是同一个变量集合——例如相机参数在重建里不可或缺,但它不是动力学的必要变量。
- 可干预性优先:粗层变量应该能被粗层动作影响。如果一个变量在粗层永远不变,那它只是常量,不应该作为状态变量;如果它能变但粗层动作无法影响它,它只是噪声源,应该在粗层条件化掉。
- 可观测性约束:粗层变量必须在部署时能从观测中快速、稳定地估计出来。这决定了变量能否真的用作状态。一个物理上充分但难以观测的变量(例如”物体内部应力”),在粗层模型里只能作为不可见潜伏变量存在,这会让粗层动力学的可辨识性下降很多。
三条原则之间有冲突。充分性会推动变量变多,可干预性和可观测性推动变量变少。多粒度结构管理的核心工作,是在这三条约束下找到一个最小充分变量集合。
9.5.2 最小充分变量集的检验
一个直接但昂贵的检验是删减测试:从粗层变量集合中逐个删掉一个变量,重新训练一个轻量预测器,看对动作效果的预测误差增量。若某个变量的删减去误差增量小于 ,则认为它在粗层里是冗余的。这个方法在因果表示学习里常见,代价是要重训 次, 是变量个数。
一个更可操作的近似:直接看互信息。Rodriguez-Sanchez 与 Konidaris 的目标 可以解释为”保留对动作效果的可预测性”。在实践中,可以把它拆成逐变量的互信息贡献,去掉贡献最小的那些变量,保留前 个,然后验证 的削减是否让交换干预准确率显著下降。这个验证环节是必要的——因为互信息的估计在大量变量上很不稳定,删完必须用第八节的探针来兜底。
9.5.3 粗层动力学与粗层变量的一致性
另一个容易被忽略的问题是:粗层变量集合选定之后,粗层动力学还需要和细层动力学在抽象意义上一致。 一种直接检查是”边界一致性”:从任意一个细层状态 ,随机执行一系列粗层动作(在细层上展开为具体执行),到达某个起点 ;再用粗层模型从 开始预测同样一系列粗层动作;最后把 投影到粗层,比较 和粗层预测 。若这个比较在整个 rollout 上都能保持小误差,粗层动力学和粗层变量就是一致的。这就是第八节误差分解里”动力学误差”和”读回误差”的联合定义。
这里有一个顺序问题:应该先选粗层变量,还是先学粗层动力学?工程上通常先选变量,再学动力学,然后再做边界一致性检查,发现偏差就回到第一步。这是一个反复迭代的过程,不是一次成型。多粒度结构管理真正要”管理”的,正是这个迭代过程:每层维护自己的变量集合和映射,每次上游粒度变化后都要做一致性检查,并把检查结果反馈到调度器。
十、推理账本:同一段想象,四种粒度各花多少
算力是第七、八节的另一条主线。这里用一个具体例子把”四种粒度各花多少”算清楚。
10.1 以视频式世界模型为例
考虑一个 视频生成式世界模型,用 DiT 主干, 个 token(每个 token 是 潜在块),, 层, 步去噪。一次 1 秒生成( 帧,25fps)的总 token 前向数大致是:
代入: 个”层-帧-去噪步”组,每组的 约 。总规模约 FLOPs 量级(粗估,仅用于说明梯度)。这是像素层,每秒生成的代价。
现在换成同样的场景,在物体层做:只保留 12 个物体,每个 256 维状态, 步,粗层 4 层。单步的计算是 ,总 FLOPs。与像素层差约五个数量级。
再做时间抽象:在物体层上压缩到 步(每 5 个物体动作合成一步),再砍一个因子 5,变成 量级。
然后在任务层:10 个子目标,每个 64 维,10 步,4 层: 量级。从物体层到任务层又差约两个数量级。
四层从 到 ——差七个数量级。 这就是为什么”该用哪一层”本身是推理系统里最贵的决策之一。
10.2 读回与校正的额外开销
上面的账只算了”粗层预测”。QCC-WM 的做法提醒了一个容易忽略的开销:读回和空间校正本身不是免费的。 它需要解码器 跑一次(或者至少跑一次特征到图像的投影),再用商测度测宏内容,最后还要按节点-位置映射展开误差。解码器往往是像素级的——它的开销可以比整个粗层 rollout 还大。
因此,粗化层的实际节省小于名义上的 。 名义上四层之间相差七个数量级;实际算上解码读回和空间校正,经常只省三到五个数量级。这是多粒度结构管理里最常被低估的成本项:如果读回需要全分辨率解码,那么”在粗层做计划”省下的算力,可能被一次读回全部吃掉。 工程上的应对是把读回做成分辨率可调的:只在需要校验时读回完整分辨率,平时用低分辨率的商级读回。
10.3 预算约束下的选择
把第八节的误差传播和第十节的算力放在一起,一个规划请求的总代价是:
它受精度约束 和预算约束 共同限制。 是 rollout 分支组数, 是读回一次的全额开销。
在预算 下,问题变成:在满足精度的层里,选算力最省的层,做最多的 rollout 组(即规划的分支数)。同等的算力,粗粒度让你做更多的分支,细粒度让你做更准的单步。 这就是规划里的”宽度 vs 深度”权衡在多粒度上的直接体现。本系列第二十篇讨论跨会话迁移时已经遇到类似的权衡(状态快照与重新观测),这里是它在粒度维度上的版本。
十一、失效边界
多粒度模型不是”粒度越细越好”,也不是”粒度越粗越省越好”。下面六类失效是实践中最常见的。
11.1 读回与目标不同测度
如果粗化时定义的状态度量 ,和目标监督、读回使用的度量 不一致,那么”粗化后误差小”是测量口径造成的幻觉。QCC-WM 专门强调共享同一套 正是为了避免这一点。工程上对应的检查是:构造目标、监督、读回这三处,是否用的是同一个映射实例、同一组参数。
11.2 被合并变量的不稳定模式
第八节已经指出:合并掉不稳定变量会让粗层动力学”看起来稳定”。典型例子是把碰撞检测从粗层拿走,粗层就学会了”穿过物体”,而这一点在细层不可行。检查方法是:在粗化后,对每个被合并的变量做小扰动,看粗层预测的谱半径是否显著低于细层——如果显著低,说明粗层可能已经抹掉了不稳定模式。
11.3 粗层虚假自由
Schiewer 等人的模型利用实验是最直接的例子:粗层在障碍物内部给出了”可以继续移动”的虚假许可。规划器利用这个许可获得了仿真上的奖励,真实环境则不可能。这类失效很难从粗层看出来,需要在细层做对照 rollout:把粗层的计划拿回细层执行,比较奖励。
11.4 跨层接口歧义
层级模型之间必须有明确的接口。最容易被忽略的是动作抽象接口:下层看到的是”动作序列”,上层发出的是”抽象动作”。Schiewer 等人尝试过两种抽象方式:用 VAE 压缩动作序列,或用 k-means 聚类成离散动作。两种方式都会引入接口误差——VAE 的压缩误差或聚类的量化误差。如果这个误差在下层没有被正确补偿,长期使用会让下层动力学偏移。
11.5 映射太强导致的空断言
第四节讨论过:任意映射 都能让任何模型映射到任何算法。所以”我们的粗层模型捕捉了任务级因果结构”这句断言,在没有给出映射复杂度或误差界之前,是空的。工程上的检查:每一层的映射是否有显式的函数形式(聚合、投影、聚类),而不是一个不受约束的神经网络。
11.6 分布外干预
近似抽象的定义里有一个 ,描述我们预期会遇到的干预。如果实际遇到的干预落在 的质量之外,粗层的近似误差不再有统计保证。这对部署的启示是:调度器应该监控实际干预与训练时的干预分布的距离,一旦偏离显著,就自动回退到更细的粒度。
十二、小结
这一篇把”粒度”从一个结构选择提升为一个可形式化、可审计、可调度的对象。
- 粒度由三个成分决定:变量选择、时间步长、动作空间。它不是模型固有属性。
- 空间粗化的严格条件是双模拟,它精确保持最优价值;因果抽象把粗化问题推广到干预:粗层干预的结果要等于细层干预后投影的结果。
- 精确抽象太苛刻,所以用近似抽象:三个设计决定 、、 分别指定”在意哪类干预、用什么尺度量、关心平均还是最坏”。
- 映射太强会让理论失效(2025 年的 Sutter 等人),所以粗化要显式化、要审计。
- 世界模型里有四层常用粒度:像素、潜空间、物体、任务,各层的变量、时间、动作、决策不同。
- 两类粗化轴:空间抽象(QCC 的商测度、物体节点)和时间抽象(option 框架、动力学保持抽象)。
- 抽象误差三项分解:投影、动力学、读回。投影误差设定了动力学误差的下限,读回误差会放大动力学误差。
- rollout 复合误差:单步误差按 累积;同样一组参数, 时粗层更稳, 时细层反而更准。粗化的真实风险在于被合并变量里可能承载了不稳定模式。
- 粒度选择是一个带预算的调度问题:先用交换干预准确率测出每层的 ,再测谱半径 ,然后在精度与预算约束下选层或混合调度。
- 结构管理:粗层变量集合要满足充分性、可干预性、可观测性三条原则;变量选定与动力学学习要迭代进行,每次都要做一致性检查。
- 推理账本:四层粒度从 到 ,但读回/校正会吃掉 2–4 个数量级的收益。
- 六类失效:读回不同测度、被合并变量中的不稳定模式、粗层虚假自由、跨层接口歧义、映射太强的空断言、干预分布外。
下一篇:同一段物理时间里,为什么有的段适合粗粒度、有的段必须细粒度——混合粒度调度里的切分点怎么找。 切分点不能单看时间长度选,得看接触密度、动力学稳定性、任务结构这三个信号。到时候需要把第八节的误差分解和第九节的预算约束真正联动起来,算出逐段的调度。
参考资料
- Approximate Causal Abstraction(Beckers, Eberhardt, Halpern, 2019)
- Causal Abstraction: A Theoretical Foundation for Mechanistic Interpretability(Geiger et al., 2023)
- The Non-Linear Representation Dilemma: Is Causal Abstraction Enough for Mechanistic Interpretability?(Sutter et al., 2025)
- Causal Abstraction in Model Interpretability: A Compact Survey(2024)
- Equivalence notions and model minimization in Markov decision processes(Givan, Dean, Greig, 2003)
- Learning Abstract World Model for Value-preserving Planning with Options(Rodriguez-Sanchez, Konidaris, 2024)
- Exploring the limits of Hierarchical World Models in Reinforcement Learning(Schiewer, Subramoney, Wiskott, 2024)
- WorldGraph: Graph-Native World Modeling(Ding, Li, Xie, 2026)
- QCC-WM: Linking Macro-State Dynamics and Visual Generation via Quotient Causal Construction(2026)
- Imaginative World Modeling with Scene Graphs for Embodied Agent Navigation(SGImagineNav, 2025)
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



