


DeepInfer 生产系统的 KV Cache 存储:块缓存、SWA 状态槽与 3FS 命中重算
从「开源版缺了什么」说起
DeepInfer 的开源仓库把边界写得很清楚:这次放出的是离线推理,以及支撑大规模服务所需的核心引擎能力。README 在「完整推理服务还需要什么」一栏列出了三项没有随仓库发布的部分:
- 一套 KV Cache 系统;
- VE/Prefill/Decode 三段分离(引擎侧的大部分功能已经实现);
- Prefill 与 Decode 的 DP 副本间负载均衡。
这三项恰好是「单机引擎」与「集群服务」之间的接缝。站内前二十五篇已经把接缝左侧拆得比较细:KV 内存与 SWA 有界重放 拆过引擎内的两本账——分页 KV 池与 SWA 状态槽;启动时的显存 profiling 拆过如何把显存峰值折算成 KV 块数;上下文并行 CP 全链路 拆过 KV 如何按 zigzag 切分与收集。但这些都停留在一块 GPU、一个引擎进程的边界内。
本篇补的是接缝右侧:请求结束、引擎换机、进程重启之后,KV 还存在哪里,下一次请求如何找到它,找到之后又怎样把它搬回来。 主要依据是 DeepInfer 官方仓库里的 部署问答,以及它引用的 DeepSeek V4.1-Flash 推理系统设计文章。需要先说明证据边界:kvcache-store、负载均衡器和 Entrypoint 的内部实现并没有开源,官方问答描述的是系统行为与接口语义,不是可以直接对照的函数。因此下文会严格区分「官方明确写出的行为」与「从行为反推的工程含义」,不把推测写成源码事实。
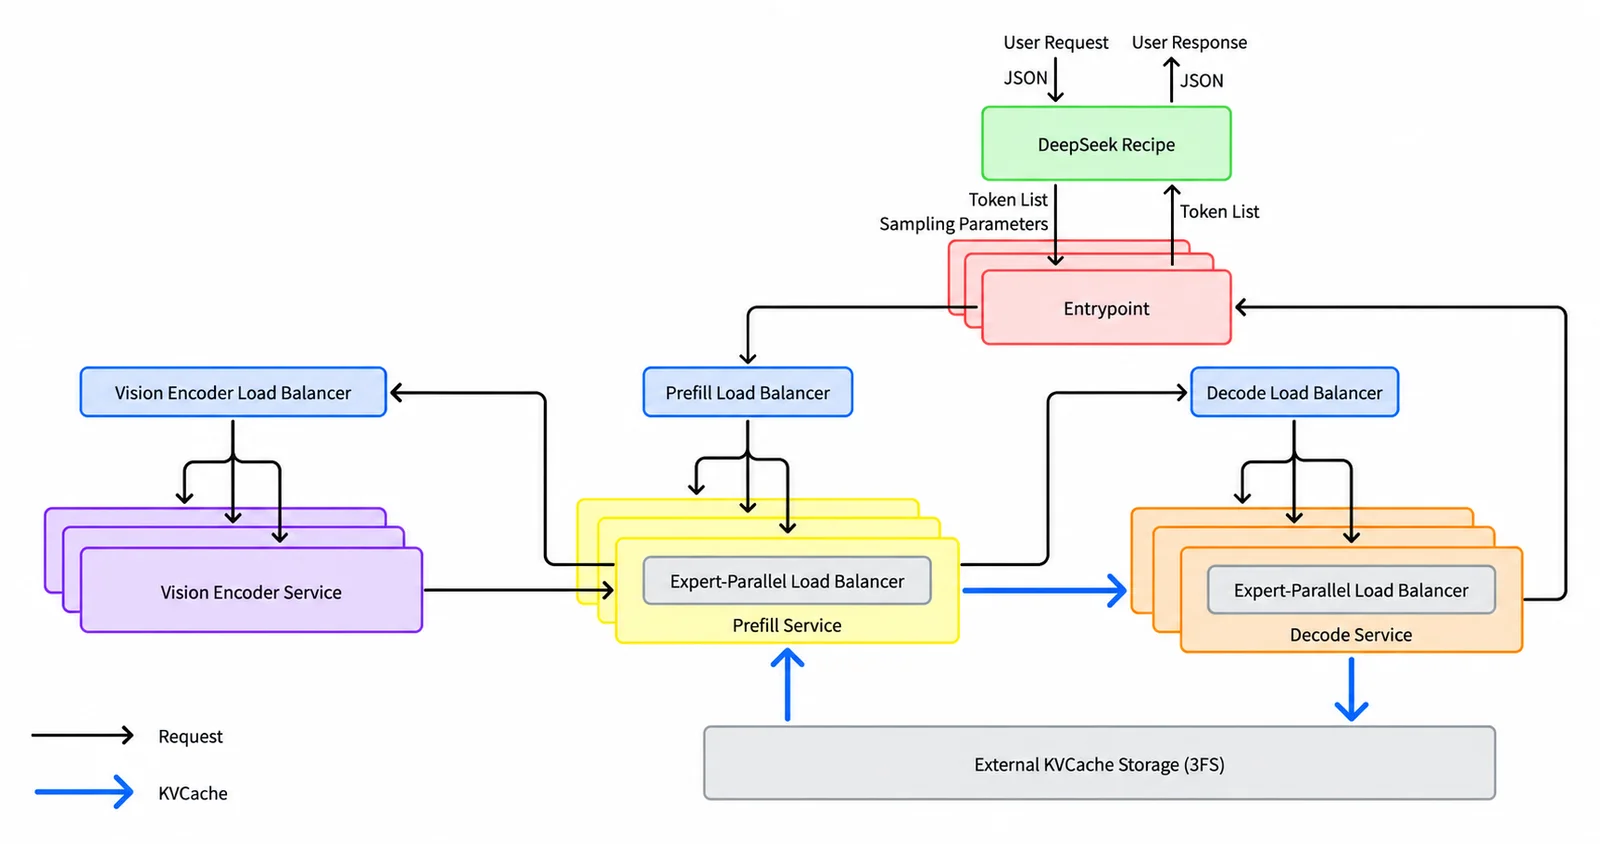
(图源:DeepInfer 官方仓库 doc/images/architecture_overview.png。读这张图时抓四个层次:最右是三类负载均衡器——Vision Encoder LB、Expert-Parallel LB、Prefill 与 Decode 各自的 LB;中间三个服务框是计算侧;图底部还有一条 KVCache 连线指向 External KVCache Storage (3FS),也就是本篇讨论的持久化缓存。需要注意的是,这条线画得很简略:图里没有画出 CHECK 角色、SWA 状态槽与内存目录,这三样才是下面几节真正要拆的部分。)
为什么 KV Cache 必须离开 GPU
先算一笔最朴素的账。DeepSeek-V4.1-Flash 的全局 KV 是 890 字节/token,这个数字来自技术报告的压缩结果:跨层 KV 复用把多层 latent 压成少量共享条目,FP4 caching 再把元素位宽压到 4 bit。按这个口径:
- 一条 32K token 的序列,KV 约 MB;
- 一条 128K token 的序列,约 111 MB;
- 一条 1M token 的序列,约 890 MB。
单看一条序列并不夸张。问题在于并发与复用同时出现。一个 Decode 引擎要同时挂住几百条序列,每条序列的 KV 都要在 HBM 里保持可读写;而前缀缓存又希望把「历史上算过的前缀」留得越久越好。两件事争的是同一块 HBM:前者是 in-flight 状态,后者是可能被再次命中的历史。HBM 的容量由卡决定,前缀缓存的命中率却随容量增长,这是一条无法在单机内解决的曲线。
官方给出的生产口径把这件事拆成了三层介质:
| 内容 | 介质 | 副本策略 | 管理者 |
|---|---|---|---|
| in-flight block KV + state KV | 推理 GPU 显存 | 无 | Prefill / Decode 实例 |
| SWA KV cache | 本机 host memory | 单副本,不落 3FS | Prefill / Decode 实例;跨机命中走 400G VLAN |
| paged block KV cache | 专用 3FS 存储集群 | 无应用层副本,依赖 3FS 自身冗余 | kvcache-store |
这张表把「快、慢、久」三种时间尺度分开了:HBM 服务当前 step,host memory 服务当前请求的窗口状态,3FS 服务跨请求、跨机器、跨天的前缀复用。后面几节会逐层解释每一层为什么只能放这些内容。
从容量上看,官方披露的持久化层是一个约 100 PiB 的 SSD 池,按 14.4 TB/GPU 的逻辑口径折算,约相当于七千张卡的逻辑缓存总量。这个数字不该被理解成「每张卡真的写 14.4 TB」,它表达的是存储集群与计算集群解耦扩容之后,缓存容量不再受单机盘位限制。单台存储服务器的推荐配置是 20 块 30.73 TB SSD,读吞吐至少 40 GB/s、写吞吐至少 5 GB/s,并保留 24 小时数据;存储服务器数量随推理部署规模扩展。
为什么不放本地 DRAM:前缀亲和与负载均衡的冲突
读到「KV 放远端存储」,第一反应通常是:为什么不放本机 DRAM?SGLang HiCache 这类分层缓存正是这么做的——HBM 之外再加一层 host memory,命中在本机完成,延迟最低。DeepInfer 的选择是专用存储集群,官方给出的理由有三条,每一条都指向集群调度而不是单机缓存:
- 让任意 Prefill 机器命中任意前缀。 如果缓存放在本机 DRAM,请求就必须被路由到「持有该前缀的那台机器」,否则命中不了。这会把前缀亲和(prefix affinity)引入路由,和负载均衡目标直接冲突:忙的机器可能恰好持有热门前缀,空闲的机器却只能重算。
- 存储扩容与计算扩容解耦。 计算节点按流量扩缩,存储节点按缓存容量扩缩,两者的扩缩节奏和故障率都不同。官方特别指出,计算节点的故障率比存储节点高一个数量级以上;把持久缓存放在计算节点本地,等于让高故障率的机器承载低故障率的职责。
- 故障域隔离。 计算节点挂了,缓存还在;换一台机器起来,前缀仍然可命中。这是「缓存不绑定副本」的直接收益。
代价也很明确:每次命中都要跨网络取回,而且命中判定发生在路由之前,天然在关键路径上。官方问答没有回避这一点,反而把开销拆开说明了:匹配(matching)无法隐藏,取回(fetching)可以异步,换入(swap-in)可以与前向重叠。这三句话基本定义了整套系统的性能模型,后文会逐段展开。
还要注意一个容易忽略的规模前提:官方说 P 与 D 跨数据中心部署「技术上可行」,代价是可靠性,预算约为每 8 张 GPU 配 400 Gbps 互联带宽。这说明存储层不是挂在一台机器旁边的 NAS,而是与计算集群同等级的网络基础设施。站内 DeepSeek 3FS 完全拆解 已经拆过 3FS 的 CRAQ 链式复制、USRBIO 零拷贝与 KVCache 读吞吐,这里不再重复文件系统内部,只把它当作「共享 KV 池的底座」。
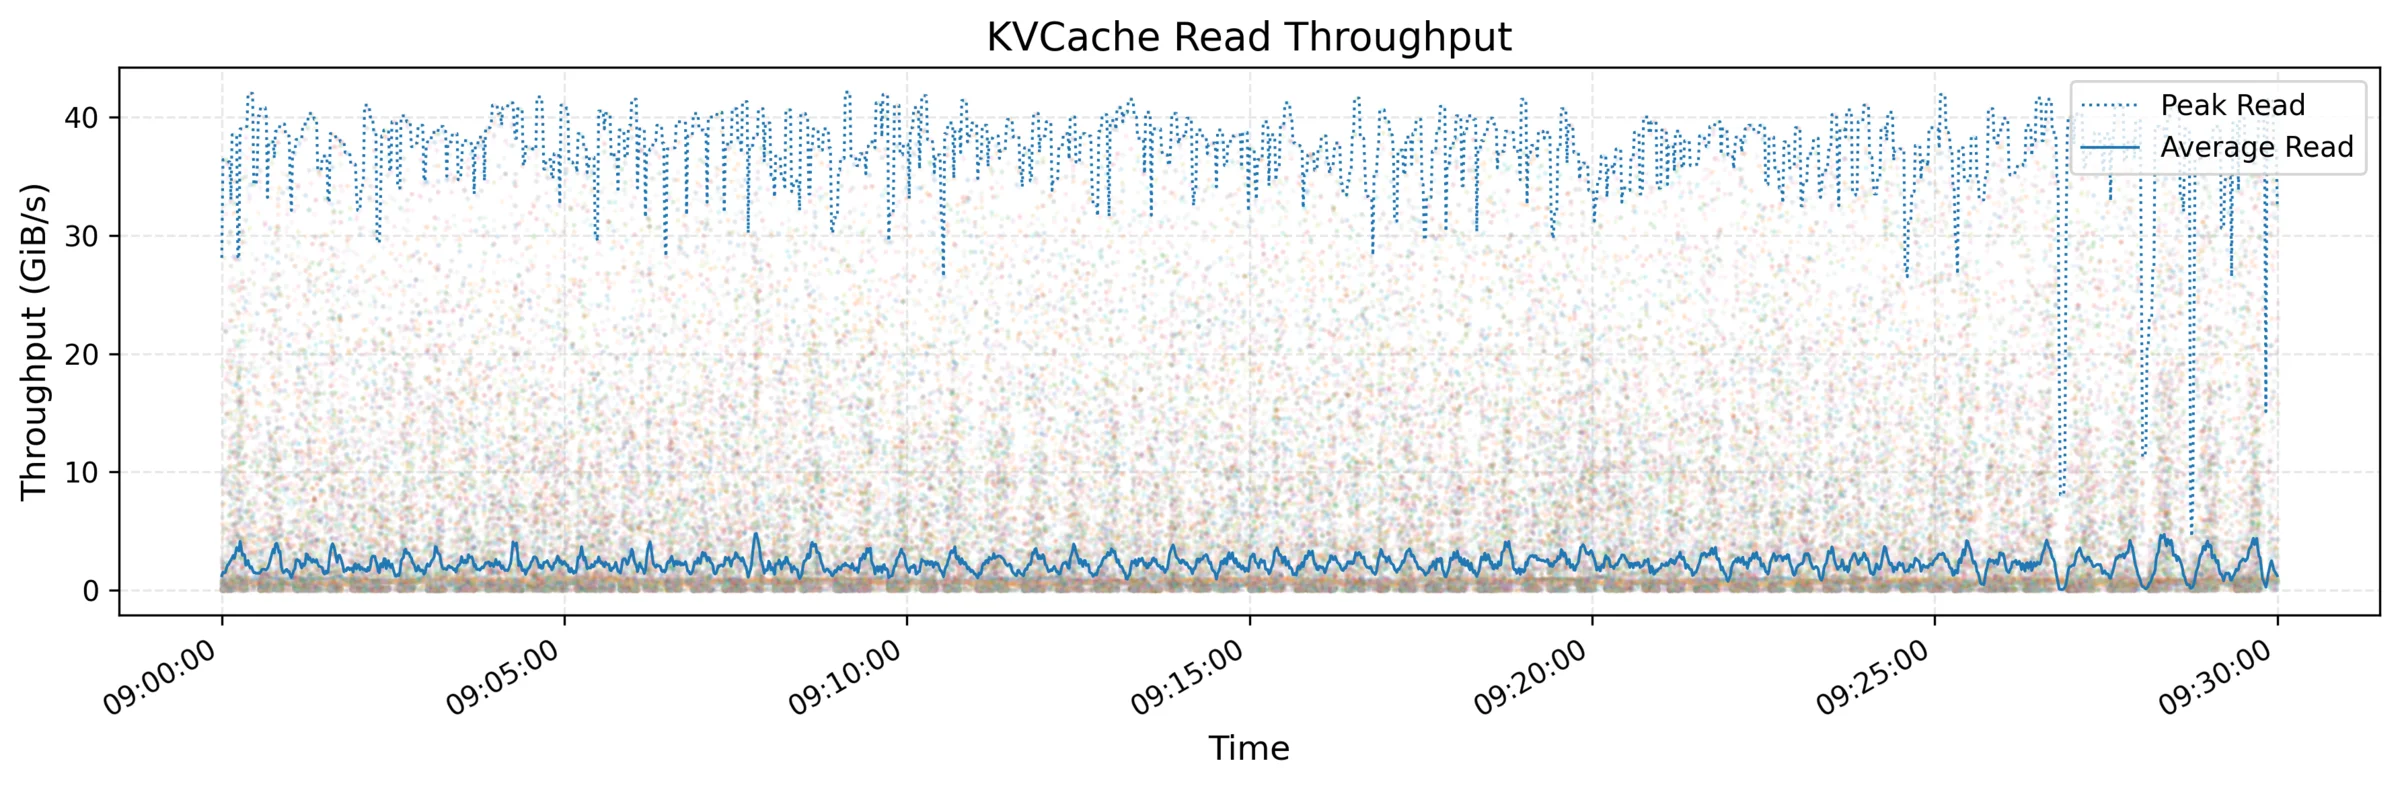
(图源:3FS 官方仓库 docs/images/kvcache_read_throughput.png。峰值与平均值的巨大差距说明 KV 取回是突发负载:系统必须按峰值准备带宽,但大部分时间用不满。)
介质分工:三张表与三个时间尺度
把三层介质放回一次请求的生命周期,会看到它们各自回答不同的问题:
| 层 | 生命周期 | 回答的问题 | 失效后果 |
|---|---|---|---|
| HBM 中的 block KV + state KV | 当前 step | 「这一步的注意力读什么」 | 请求无法继续,必须抢占或重算 |
| host memory 中的 SWA KV | 当前请求、可能跨机 | 「这条序列的滑动窗口从哪里接上」 | 重算最后 128 token,代价近似常数 |
| 3FS 中的 paged block KV | 数天 | 「下一次相同前缀能否跳过 prefill」 | 退回完整 prefill,算力成本上升 |
这三个问题的粒度也不同。HBM 按块分配,块是 128 token;SWA 按序列槽分配,槽是固定大小;3FS 按前缀链组织,链的节点仍然是 128-token 块。三者共享同一个 128 这个数字,不是巧合:它是引擎内 block manager 的分配单位,也是落盘时的对齐单位,还是命中长度的最小步长。理解这一点,后面所有「向上/向下对齐」的规则才有统一的解释。
另一个容易混淆的地方是「state KV」和「SWA KV」这两个词。官方表格把 in-flight 的 state KV 放在 HBM,把 SWA KV cache 放在 host memory。它们不是两份不同的数据,而是同一份状态在不同阶段的形态:请求运行时,state slot 在 HBM 中参与前向;请求结束后,只有其中需要跨请求保留的那一段被复制到 host memory,成为可被下一次命中的 SWA 缓存。前文已经拆过 StateBlock 内部的三段布局,这里只保留存储侧的结论:进 host memory 的不是整个 state slot,而是 state_size_to_disk 那一段。
Block KV 存什么:主 KV 与索引器 K
官方问答对块缓存的内容给了一个很容易被略过的括号:block KV cache(main KV + indexer K)。主 KV 好理解,MLA 压缩后的 latent 与 RoPE 部分;索引器 K 则是 DeepSeek 稀疏注意力路线特有的东西。
DeepSeek-V3.2 的 DSA(DeepSeek Sparse Attention)在注意力之前加了一个轻量索引器:它用一组小维度的 query/key 计算「哪些历史块值得看」,再只对选中的块做真正的 MLA 注意力。索引器的 key 不是主注意力的 K,它有自己的投影与维度;如果只缓存主 KV 而不缓存索引器 K,那么每次命中前缀都要重新跑一遍索引器投影,稀疏注意力的「省」就被抵消了一半。站内 DSA 稀疏注意力完全拆解 拆过索引器与 Top-K 选择,DeepInfer 注意力族与压缩 KV 拆过 DeepInfer 里索引器如何跨层共享;两篇合起来能看出为什么索引器 K 必须和主 KV 一起持久化。
和 HBM 块池比,3FS 块多付了什么
同样一条 128-token 的块,放在 HBM 里是一个由 block table 指向的物理页;放在 3FS 上,它至少多出四样东西:
| 开销 | HBM 块 | 3FS 块 |
|---|---|---|
| 寻址 | 块号 + 页内偏移 | 前缀哈希链 + 存储键 |
| 元数据 | block table 一项 | 块哈希、位置、长度、存储位置 |
| 读写路径 | HBM 直接访问 | 3FS 客户端 + 网络 + 存储节点 |
| 失效 | 引用计数归零即回收 | GC 批量回收 + TTL 语义 |
这四样开销里,前三样是每次命中都要付的,第四样是后台付的。它们共同决定了 3FS 块不适合被当作「更便宜的 HBM」来用:
- 元数据放大:一条 1M token 的前缀有 8192 个块,每个块都要在
kvcache-store里有一条记录;如果元数据不能全部驻留内存,CHECK 就会退化成多次小读。 - 小对象问题:111 KiB 的块对 3FS 来说不算大对象,块级读写会放大小文件/小 IO 的开销;这也是为什么落盘要按块批量写、读回要按前缀批量取,而不是一块一块地随机读。
- GC 与 TTL 的耦合:3FS 的 GC 是批量触发的,TTL 决定池子水位;水位越高,GC 尖峰越频繁。块缓存不能像 HBM 那样「引用计数归零立刻回收」,它必须接受「过期后还可能被读到、读到时发现已失效」的语义。
理解了这四样开销,就能理解为什么官方要把「匹配」和「取回」分成两个阶段:匹配只付第一、二样(元数据),取回才付第三样(网络与存储)。如果匹配也要读数据,那么每次未命中都会先付一遍取回成本,缓存的意义就被抵消了。
这也解释了为什么块缓存的字节数不能简单按「主 KV 的 890 B/token」来估。890 B/token 是技术报告给出的全局 KV 口径,索引器 K 的每 token 字节数没有在公开材料里单独给出。按 128 token 一块计算,主 KV 的下限是:
实际落盘的块还要加上索引器 K,所以 111.25 KiB 只能当作下限。这个细节在容量规划时很重要:如果按 890 B/token 乘上下文长度去估算 3FS 占用,会系统性低估;低估的比例取决于索引器维度与共享策略,公开材料不足以给出精确系数。
块缓存按 128 token 分页还有一层工程含义:落盘、命中、换入三件事共享同一套块号。引擎内的 block table 把逻辑位置映射到物理块号;落盘时以块为单位写;命中时以块为单位算长度;换入时以块为单位做 H2D。只要有一处不是 128 对齐,就会出现「半块」——半块无法单独命中,也无法单独换入,最后只能退化成一整块重算。官方在启动阶段要求块数为偶数、落盘位置向下对齐到 128,本质上都是在避免半块进入这条链路。
3FS 上的分页块:键、链与元数据
块缓存落在专用 3FS 集群上,由 kvcache-store 管理。公开材料没有给出文件布局与键的编码方式,但给出了匹配语义,这已经足够理解系统行为:
匹配由 Entrypoint 对本地
kvcache-store在 CHECK 角色下完成,是对元数据的 hash-chain 前缀匹配;但命中长度必须在路由之前算出来,所以它无法被隐藏。
这句话里有三个关键词。
hash-chain 前缀匹配。 前缀缓存的核心是把 token 序列切成块,对每一块算一个哈希,再把哈希按顺序串成链。匹配时从第一块开始逐块比对,直到某一块的哈希对不上为止。链式结构保证了「命中一段前缀」而不是「命中某个中间片段」;如果只做单块哈希查找,就会出现「中间某块命中、前面不命中」的碎片,无法直接复用。站内 RadixAttention 用前缀树表达同一件事,只是数据结构不同:树适合在内存里做插入/淘汰,哈希链适合在分布式 KV 存储里做只读匹配。
只查元数据。 CHECK 阶段不读 KV 数据,只读块哈希与位置信息。这让匹配的 IO 量与前缀长度成线性、与 KV 字节数无关:一次 128K 前缀的匹配只需要读几千条元数据,而不是一百多 MB 的 KV。对于「先判断命中、再决定路由」的架构,这是必须的——否则路由决策会被数据搬运拖住。
无法隐藏。 匹配在关键路径上,因为路由需要知道命中长度。如果先路由再匹配,请求可能被送到一台「缓存里没有这个前缀」的引擎,命中就失效了;如果让每台引擎自己匹配,又回到了前缀亲和与负载均衡的冲突。官方选择把匹配集中到 Entrypoint,用一次元数据查询换取全局命中能力,代价是这次查询的延迟直接加到 TTFT 上。
3FS 侧的淘汰策略与匹配策略是分开的。kvcache-store 本身没有过期逻辑,回收完全交给 3FS 的 GC;TTL 由业务侧设定:agent 流量 3 天,chatbot 流量 7 天。官方给了一个很有说服力的数字:把 chatbot 的 TTL 从 7 天缩短到 3 天,会损失 0.5%–1% 的 KV 命中率。这说明 chatbot 流量的命中分布有很重的长尾——少量 KV 被反复读取很多次,丢掉的不是「平均命中」,而是「高频复用的那一小撮」。
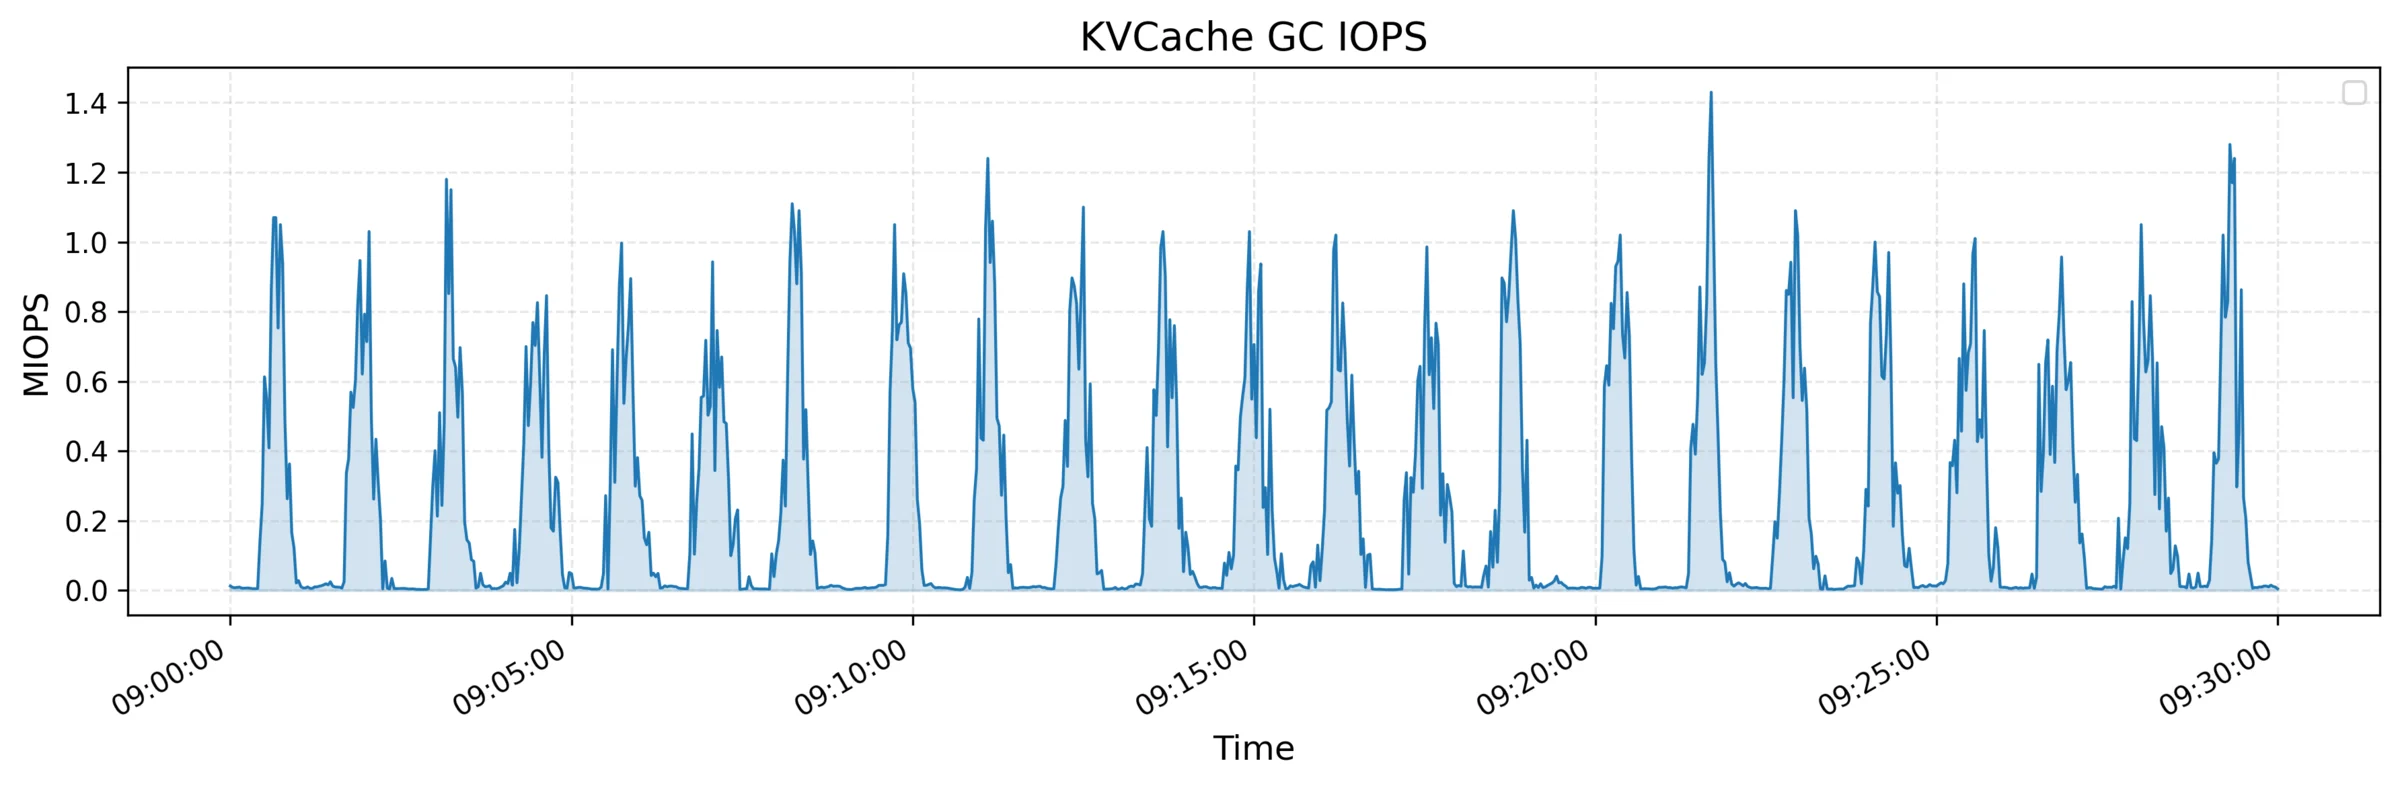
(图源:3FS 官方仓库 docs/images/kvcache_gc_iops.png。GC 是批量触发的:缓存池到达水位后,一轮回收会在极短时间内产生百万级元数据操作。TTL 越长,池子越满,GC 尖峰越需要被存储层吸收。)
3FS 的冗余方式也值得放在这里:数据用 10+2 纠删码存储,每个 EC 组容忍两个节点同时故障;一次读会向组内 11 个存储节点同时发请求,任意 10 个返回即可解码。应用层不再做副本,是因为存储层已经承担了冗余;这也解释了官方表格里「无应用层副本,依赖 3FS 自身冗余」那一列。对 KV 缓存来说,这是一种成本上合理的选择:缓存丢失可以重算,不需要像模型权重那样追求强一致的多副本。
SWA 缓存的存储:state_type 是什么
Block KV 是「序列历史」,SWA 缓存是「序列状态」。官方对它的存储规则写得非常细,细到可以当作一份状态机来读。先引用原文,再逐句拆:
SWA KV cache 不进 paged KV 块,而是存在 state cache 里,每条序列占一个固定大小的槽(
StateBlock)。每个槽按是否需要存盘分为两段:[保存段:SWA] [丢弃段:YOCO consumer SWA]。保存在段的 SWA 窗口需要跨请求保留。丢弃段存放 YOCO consumer SWA 层(其恢复依赖 prefill 重算)以及 C2 压缩边界累加器ca_state/ica_state(压缩窗口边界天然对齐到 128 token 存储粒度的整数倍,所以不存在跨边界依赖)。对 V4.1 来说,保存的是前 20 层。
为什么是前 20 层
V4.1-Flash 的注意力不是一种,而是好几族:一部分层是普通的全注意力/SWA 注意力,一部分是压缩器(compressor),一部分是索引器,还有解码器层的 YoCo 消费层。前文拆过两本账与 YoCo 截断,模型层的装配与超连接主干 拆过解码器里 YoCo 层为什么只读不写。
「只保存前 20 层」对应的正是编码器侧需要被后续请求直接复用的 SWA 窗口。解码器侧的 YoCo 消费层用的是另一套机制:它的 block KV 由最后一层编码器的 hidden state 投影而来,SWA 部分则可以依赖重算恢复。如果把解码器的 SWA 也存下来,每序列字节数会翻倍,而能省下的只是「重算 128 token × 层数」这一点。
ca_state 和 ica_state 放在丢弃段是同一逻辑的延伸。它们是压缩边界的累加器,记录「窗口压到哪、下一个压缩边界从哪开始」。由于压缩窗口边界被设计成 128 token 的整数倍,累加器在请求结束后其实不需要保留:下一次命中时只要重新从边界算起,累加器的值就能被重建。「天然对齐」这四个字换来的是「不必存盘」——这是设计阶段就把存储粒度写进算法的一个典型例子。
每序列到底存多少字节
官方把落盘量算成了一行乘法:
进 store 的只有
state_size_to_disk= 20 层 × 134 token × 528 B = 1,415,040 B/序列。528 B/token 是 MXFP8 的 SWA KV 格式。
逐项解释:
- 20 层:上面说的保存段层数;
- 134 token:窗口长度 128,加上 6 个回退位置。前文已经论证过这个 6 的来历——投机解码回滚最多需要 6 个位置,decode 阶段 store 拷贝最多越界 5 个位置,取两者最大值。存储层要存的是「完整窗口 + 回退历史」,否则命中后无法直接用于变长验证;
- 528 B/token:MXFP8 格式。MX(Microscaling)是块级共享指数的格式,FP8 元素加一个很小的 scale,平均每个元素不到一个字节的额外开销。528 这个数不是元素宽度 1 字节乘某个维度得到的整数,而是层内 K/V 打包后的实际字节数;
- 乘积 1,415,040 B ≈ 1.35 MiB:这是一个可被 400G VLAN 一次低开销回拉的量级。
这条乘法也说明了 SWA 缓存和块缓存的量级差异:一条 128K 序列的块缓存约 111 MiB(下限),而它的 SWA 缓存只有约 1.35 MiB。前者需要存得久、存得全;后者只需要在当前序列的窗口边界上「续上」。这个 80 倍的差距,直接决定了为什么两者的介质、冗余与 TTL 完全不同。
槽的物理形态:环形缓冲与多出的 6 个位置
前文拆过 StateBlock 的三段布局与 ring 长度,这里补存储侧的视角。存进槽的窗口不是一段连续的「0 到 133」,而是一个环形缓冲:窗口右端不断向前推进,左端不断被覆盖。为什么可以覆盖?因为 SWA 注意力只读最近 128 个位置,更早的位置在计算上已经不再被引用。
但存储需要的是「某一种对齐位置上的快照」。环形的优势是增量写入:每生成一个 token,只写一个位置;劣势是「快照」不是现成的,需要知道当前窗口在环上的起点。副本区机制就是为此存在的(后面一节会讲)。那 6 个多余位置的意义也在这里体现:拷贝触发有粒度,可能越过边界最多 5 个 token;多出的 6 个位置让「越过边界的那一段」仍然留在环里,不会被提前覆盖。
用公式描述环形缓冲的索引:
其中 是 token 的绝对位置, 是当前窗口的起点, 是环长度(窗口 + 回退余量)。对 V4.1 的保存段,。这个取模只在 GPU 侧写入与读取时使用;落盘时需要的是逻辑位置,而不是环上的物理位置,所以 copy 到副本区时还要把逻辑起点一起记下来。
128 边界的存储状态机
官方对 SWA 的写入时机给了一段几乎逐状态机式的描述,值得完整拆开:
Prefill 结束后:
存储位置取序列末尾留出一个 token 后向下对齐到 128 所得的位置;若不足一个完整 128 token 单元,则本轮不存储;chunked prefill 中途不存储,只有最后一个 chunk 存储。
三个动作对应三个判断:
- 位置计算 。留一个 token 是为了保证锚点处已经产生过该位置的 token;向下对齐保证落在块边界。
- 长度判断 时 ,没有完整窗口可存,直接跳过。短 prompt 不占 SWA 存储。
- 分块判断 chunked prefill 只在最后一个 chunk 写入。一个请求一次写,把 IO 次数与 chunk 数解耦。
Decode 阶段:
另开一块副本区,每跨过一个 128 tokens 边界就把该请求当前的窗口在显存内拷入副本区;请求结束时从副本区中最近一次完成拷贝的位置存储,附着点向下对齐到 128 边界;拷贝位置最多越过边界 5 个 token,由 ring 比窗口多出的 6 个位置吸收。
这段机制前面已经拆过,这里只保留一个存储侧的观察:Decode 的存储时间点是「请求结束」,而不是「每跨一次边界」。跨边界时的动作只是一次显存内的拷贝(copy 到副本区),真正的落盘发生在请求结束、且取的是副本区里最近一次完成的拷贝。这样做的直接收益是写放大可控:一条生成 3000 token 的请求会跨过大约 23 个边界,但在 host memory 里只写一次;如果每次跨边界都直接写主 ring,就会在环被覆盖之前拷出不一致的状态。
slot_mapping_store_swa 这个张量名可以从源码侧印证这条链路:前文引用过 prepare_tensor_input 里的 slot_mapping_store_swa 与 state_block_idx_out,它们正是把「哪些位置需要写入 SWA 存储」和「写到哪个 state slot」编码进前向输入的两个张量。也就是说,SWA 的存储写入本身是由模型前向携带的 kernel 完成的,而不是请求结束后由 host 侧逐层拷出来。这一点在性能上很重要:每层前向本来就要写主 KV,顺手把需要保留的那一段也写到 slot 里,边际成本只是多一个目的地址。
命中判定:块缓存先说,SWA 缓存再兜底
官方给出了命中策略,原文只有一句,但背后的决策树很长:
原则是:命中长度由 block KV cache 决定,最后一个块是否需要重算是 SWA KV cache 决定——SWA 没命中就回退一个块并重算。具体来说,在 YOCO 截断要求下,长度为 L 的输入最大命中长度至多为 L − 134(128 token 窗口 + 6 token 投机回退)。在这个上限下,先查 block KV cache 得到命中长度 L1(128 的整数倍),再查 SWA KV cache;若 SWA KV 存在于 L1 − 128 到 L1 之间,命中长度为 L1;否则为 L1 − 128。
上限为什么是 L − 134
命中意味着「前缀部分不再前向」。但命中之后紧接着要做的是 decode 或继续 prefill 剩余部分,而 decode 的第一步需要 SWA 窗口里的最近 128 个位置,以及投机解码可能回退的 6 个位置。如果命中长度取到 ,窗口末端落在输入的最后端,那么 SWA 缓存的锚点是 本身——但 Decode 时还需要「从 往后生成」的位置,环里必须留出余量。
官方选择让命中长度不越过 ,等于强制把最后 134 个 token 留在重算范围内。这 134 个 token 会随剩余的 prefill 一起前向,顺带重建保存段的窗口。134 这个数在前文里被拆成 128 + 6;这里看到的是它在命中口径上的用途:不是 KV 池的物理尺寸,而是「命中最多到哪里」的逻辑上限。
L1 与 L1 − 128 的选择
命中决策分两步:
- 在 上限内查块缓存,得到 ,它是 128 的整数倍;
- 查 SWA 缓存是否覆盖 这段窗口。
如果覆盖,命中 ;如果没有,命中长度退回 ,并把最后一个块纳入重算。
为什么一块 SWA 缺失要退回整整 128 个 token,而不是只重算「缺的那几个位置」?因为前向的最小执行单位就是块。如果一个块里的 SWA 窗口不完整,那么这一块的前向结果就不能被信任——注意力看到的 K 少了一截。退回一块并重算,让这一块的窗口完整重建,代价是 128 token 的前向;如果只补几个位置,则需要更细粒度的前向,反而会让 kernel 形状变得不规则。
prefix (L1) ----------------------------------------------------> 命中长度上限 L-134 block cache 命中 L1 ├────────┤ SWA 窗口覆盖 [L1-128, L1]? 是 -> 命中 L1 否 -> 命中 L1-128,重算最后一个块这个决策树还有一个隐含前提:SWA 缓存的存在与否不改变块缓存的命中长度。也就是说,块缓存被查到了,数据就已经在;SWA 缺失只是让最后一块重新前向一次,并不会让前面已经命中的块作废。这保证了「SWA 缺失」的代价是常数级,而不是随前缀长度线性增长——这是后面「有界重放」这一节的核心结论。
一个 128K 输入的具体账
把公式代进一个真实长度。设 (128K token):
块缓存查询只能返回 128 的整数倍,所以
此时未命中的后缀只有 个 token。若 SWA 缓存覆盖 ,命中长度就是 130816,Prefill 只需要算 256 个 token;若 SWA 缺失,命中长度退回 130688,需要算 384 个 token,并且重放 128 个 token 来重建窗口。
把这个例子换算成比例:
- 完全命中: 的 token 需要前向;
- SWA 缺失: 的 token 需要前向。
两种情况下,prefill 的计算量都比全量重算低两个数量级以上。块缓存按主 KV 下限估算约 MB,按 40 GiB/s 峰值取回约 2.7 ms;而 13 万 token 的全量 prefill 在同样硬件上是百毫秒量级。这个对比说明:命中收益的上限由前缀长度决定,下限由取回带宽决定;在长前缀上,取回几乎总是划算的。
命中之后:三段时间的开销怎么被拆开
官方对缓存开销的拆分是三段:
匹配由 Entrypoint 在 CHECK 角色下完成,只查元数据,但命中长度必须在路由前算出,无法隐藏;取 KV 在独立进程里异步做,从 3FS 搬到宿主机 shm;换入从 shm 到 HBM 在 engine 进程内的线程里做,目标是逐层 H2D 与前向计算重叠。
把它画成时间线:
请求到达 │ ├─[Entrypoint] CHECK:读元数据,算命中长度 L1、SWA 是否命中 ← 关键路径 │ ├─[路由] 按命中长度与负载选 Prefill 实例 │ ├─[fetch 进程] 3FS → host shm(独立进程,异步) ← 可隐藏(部分) │ ├─[engine 线程] shm → HBM:逐层 H2D,与前向重叠 ← 可隐藏(设计目标) │ └─[prefill] 只算未命中的后缀匹配为什么藏不掉,却又必须放在前面
假设把匹配挪到路由之后:请求先按负载被送到某台 Prefill,那台机器再查自己本地能命中多少。这能隐藏匹配延迟,但会失去「任意机器命中任意前缀」的能力——除非所有机器都能访问整个块缓存。而它们确实能访问 3FS 同一份数据,那么「匹配」就变成了「每台机器都对 3FS 查一次元数据」,查询量随机器数放大,且命中长度仍然要在调度器决定「这台机器该做多少 prefill」之前算出来。
换句话说,匹配无法隐藏的根源不是「实现不好」,而是它决定了后续所有资源的分配量:命中长度决定这台 Prefill 要算多少 token,而算多少 token 又决定要选哪台机器、要不要分块、要不要跨实例。官方选择把这次决定性查询集中到 Entrypoint,用一次集中的小查询替代 N 次分散的查询。
fetch 与 swap-in:为什么分两个进程、两种技术
fetch 从 3FS 到 host shm,由独立进程异步完成。独立进程的意义在于隔离 CUDA 上下文与 Python GIL:搬运是纯 IO/SHM 操作,不需要碰 GPU 的代码,放在 engine 进程里会干扰调度线程的实时性。
swap-in 从 shm 到 HBM,在 engine 进程内的线程里做,并且要求「逐层 H2D 与前向重叠」。逐层是这里的核心:不是先把几百 MB KV 全部搬到 HBM 再开始前向,而是每算一层之前把这一层的 KV 搬进来。这样搬运时间被前向计算掩盖,前提是搬运速度快于该层前向的耗时。
官方还专门解释了为什么用 GDR(GPUDirect RDMA) 而不是 CUDA copy engine:
由于 CUDA copy engine 对 KVCache Block 的细粒度拷贝性能不佳,换入使用 GDR 实现,RDMA 网卡就能打满 PCIe 带宽,并且不占 SM。
这里有两层含义。第一层是细粒度:KV 块是 128 token 的小块,逐层换入会产生大量小块拷贝,copy engine 的启动开销与小块带宽利用率都不好。第二层是不占 SM:copy engine 的替代方案(例如 SM 内手写拷贝 kernel)会占用流多处理器,而这正是前向要用的资源。GDR 让网卡直接 DMA 写显存,既绕过 copy engine 的短板,又不抢计算资源。
对于 Decode 侧,官方明确说不做 KV offload:Decode 不受缓存容量约束,所以也不会使用 Hi-Sparse。但 Decode 阶段产生的 KV 仍然会写盘——目的是提高下一次的命中率。这是一个值得注意的取舍:Decode 的 KV 写盘是为了未来的命中,不是为了当前的复用;写盘开销被算进「长尾收益」而不是「当前请求延迟」。
一次命中的成本账
把三段成本写成近似式:
其中 随前缀长度线性增长但常数很小; 与 都随字节数增长,二者可部分重叠; 是剩余后缀的 prefill,为 0 时表示完全命中。与「不命中」的对照式:
只有当 时,命中才划算。对 V4.1-Flash 来说,这个条件在长前缀上几乎总是成立:111 MiB 的块缓存取回,按 40 GiB/s 的峰值算约 2.8 ms;而 128K token 的 prefill 在任何可用的 GPU 上都是数百毫秒量级。命中率的价值因此与前缀长度强相关——短前缀命中可能还不如重算,长前缀命中则收益巨大。这也解释了为什么路由要先按缓存长度分层(下一节)。
三档 SWA 策略与「有界重放」
命中判定里有一步「SWA 没命中就退回一块重算」,代价是 128 token 的前向。这个代价之所以是常数而不是线性,依赖的机制是SWA 有界重放(bounded replay)。KV 内存与 SWA 有界重放已经把它拆得很细,这里只从存储策略的角度重新组织。
DeepSeek 在 V4 的注意力论文里讨论过磁盘 KV 缓存共享前缀时的三种 SWA 策略:
| 策略 | 存什么 | 命中时 | 权衡 |
|---|---|---|---|
| Full SWA Caching | 全部位置的滑窗 KV | 直接读最后 个位置,零重算 | 存储占用最大,SSD 写入模式不友好 |
| Periodic SWA Caching | 周期性存滑窗 KV | 读最近的周期点,重算一小段 | 存储与重算折中 |
| Zero SWA Caching | 不存滑窗 KV | 用块缓存重算最后 个 token | 存储最省,重算量有上界 |
这三种策略的关键变量都是重算量。Full 把重算压到零,但每序列每 128 token 都要多存一份窗口;Zero 把存储压到零,但每次命中都要重算 个 token( 是层数),在 40 多层的 V4 上是几千 token 的前向。Periodic 介于两者之间。
DeepInfer 在生产上没有走任何一个极端,而是走了一条更细的路:SWA 缓存存一部分(前 20 层、每序列一个槽),缺失时用有界重放兜底。所谓「有界」,是指重放只重算命中前缀的最后 128 个 token,并且把重放段内的注意力窗口截断,让重算的代价与上下文长度、层数都无关:
其中 是参与重放的层数,对 encoder 侧就是保存段的 20 层。这个式子与「Zero 策略」的 形式相同,但作用范围被限制在重放段内:重放的 query 只与重放段内的 K 做注意力,不回溯整个前缀。
重放段为什么不写块缓存
前文有一个很重要的结论:重放段只重建 SWA 缓存,块缓存原样复用、不重算、不覆写。从存储角度看,这条约束是必须的:
- 块缓存是持久化、跨机、可能被其他请求命中的共享数据。一次局部重放如果顺手覆写它,就会污染其他请求的命中结果。
- 重放段只有 128 个 token,凑不出一个完整的压缩窗口(压缩需要 个 token 的窗口累加),所以它根本没有能力重建块缓存。
- 块缓存本来就在缓存里,重算纯属浪费。
这条约束把两本账的「写入权限」分得很清楚:重放是状态账的修复操作,不是块账的修复操作。
两处重放的存储差异
KV 内存与 SWA 有界重放 拆过 Encoder 侧与 Decoder 侧两种重放,它们在存储策略上的差别值得单独强调:
| 维度 | Encoder 侧重放 | Decoder 侧重放 |
|---|---|---|
| 触发 | 前缀命中、但 SWA 缓存缺失 | 每次 prefill 都会发生 |
| 重算范围 | 命中前缀的最后 128 token | prompt 末尾 128 token |
| 产物去向 | 重建 SWA 缓存,供本次 decode 与后续命中使用 | 仅服务本次 decode,不进缓存 |
| 块缓存 | 原样复用 | 由编码器末层 hidden state 投影得到 |
Decoder 侧重放的产物不进缓存,是一个典型的「存储成本 > 复用收益」判断。它的覆盖范围只有 prompt 末尾 128 token,而且是「跨层投影之后的消费层状态」,这种状态与具体的层、具体的窗口强绑定,下一次请求能复用的概率极低。如果为了它设计一套跨机存储与 TTL,就会得到一张占用很大、命中极小的缓存。
从 Prefill 到 Decode:状态如何跨实例迁移
P 与 D 部署在不同实例上时,KV 必须从 Prefill 的引擎传送到 Decode 的引擎。官方对这条路径只给了一句「SWA KV 缓存与 block KV 缓存共享同一条 P→D 传输路径」,但结合前文可以推出这条路径必须满足的三个条件:
- 块缓存与 SWA 缓存分别打包。 两者的介质、大小、对齐规则完全不同:块缓存按 128 token 的块搬运,SWA 缓存按每序列 1.35 MiB 的整块搬运。共享「路径」不等于共享「格式」。
- 块缓存可以走共享存储中转。 因为块缓存本来就在 3FS 里,P 侧的产出写入 3FS,D 侧按命中长度直接取回即可;这是三段分离架构把 KV 缓存放到共享存储的另一个收益——P/D 之间不需要点对点搬全量 KV。
- SWA 缓存必须走点对点或 VLAN 回拉。 它不落 3FS,只在本机 host memory;跨实例就需要显式搬运。官方说跨机命中靠 Entrypoint 的内存目录配合 400G VLAN 回拉,正是指这条路径。
这也解释了为什么 P/D 分离对 SWA 缓存格外敏感。块缓存可以从 3FS 重新取,SWA 缓存丢了就必须重放;重放本身很便宜(常数),但它是串行的——必须在 decode 开始前完成。官方选择「SWA 缓存走 VLAN、块缓存走 3FS」,本质上是用两条不同带宽特征的路径分别服务「延迟敏感的小数据」与「吞吐敏感的大数据」。
扩缩容时的长尾请求迁移
Decode 侧的弹性扩缩容有一个不常见的机制:Decode 引擎(CE)收到关闭通知后进入 1 分钟宽限期;仍在处理的请求连同它们的 KV 缓存会被一次性转发到其他 CE 继续解码。
这个机制的直接目的,是解决「大规模 EP 部署下长尾请求造成的资源浪费」:一个 CE 上可能只剩下几条很慢的请求,如果让整个 CE 等它们跑完,整组 GPU 都被低利用率地占用。官方没有给出迁移的协议细节,但从存储层看,迁移至少要带走三样东西:
- 该请求的分页块表与块缓存(可以从 3FS 命中,不必点对点搬);
- SWA 状态槽(必须点对点搬,因为不在 3FS);
- 调度侧的请求元数据与采样状态(在确定性采样模式下必须保持一致)。
三样东西里,只有 SWA 状态槽是「搬不动就得重算」的。这也解释了为什么宽限期是分钟级而不是秒级:迁移要经过调度、网络、目标引擎的准入,中间还可能有排队。
另外,官方披露部署会保留冗余配额:一部分机器留在池中不占负载作为扩容库存;并且在配额利用率高于 0.8 时禁止缩容。这两条与 KV 存储的容量规划直接相关——缩容意味着 CE 数量的下降,也就意味着能被命中的「本机 SWA 缓存」分布发生变化;保留一定冗余,是为了让宽限期迁移不至于触发连锁迁移。
P 与 D 的容量比例、KV 命中与存储规模
官方给出的最小部署单位很有意思:1P + 1D 可部署,实际 P
P
- 命中率高时,P 的负载大
- 命中率高时,每个请求要算的 prefill token 变少,P 的算力需求下降,但 P 仍要承担「取回 + 换入 + 处理未命中后缀」的全部工作;命中率低时,P 要算的 token 变多,但缓存取回的压力变小。P 的负载在两种极端下都不会消失,这让 1:1 成为一个保守但不离谱的起点。
- Decode 的成本主要由「每步读取的专家权重 + KV 注意力」决定,与 P 的 prefill 成本不是同一种资源曲线。两者按 1:1 配置,说明生产上更愿意为 TTFT 留出足够的 P 算力,而不是把 P 压到「刚好不排队」。
真正需要单独算的是存储侧容量。官方给了三个可以直接相乘的口径:
- 每 GPU 约 14.4 TB 逻辑 KV;
- 3FS 提供约 100 PiB SSD;
- TTL:agent 3 天、chatbot 7 天。
按 14.4 TB/GPU 的口径,一个 64P + 64D 的部署单元对应约 PB 的逻辑缓存量;100 PiB 的池子能容纳几十个这样的单元。这个换算只能当作量级参考,因为「每 GPU 14.4 TB」是官方按实际部署统计的逻辑口径,不是每个部署都必须达到的配额;它更像是在说「缓存容量与计算规模是同一量级的」,而不是「每张卡固定分到 14.4 TB」。
写入侧的口径同样值得算。单台存储服务器要求至少 40 GB/s 读、5 GB/s 写。一条 128K 序列的块缓存下限约 111 MiB,如果 Prefill 集群每秒完成 10 条这样的请求,写入量约 1.1 GiB/s;单台服务器 5 GB/s 的写带宽能吸收,但前提是请求被分散到多台存储服务器。读侧的压力更大:同样 10 条请求全部命中,读量也是 1.1 GiB/s;如果突发到 100 条,读量 11 GiB/s,已经接近单客户端 40 GiB/s 峰值的四分之一。3FS 的读吞吐图之所以呈现「峰值高、均值低」,正是因为这类突发是常态。
官方还给了每 8 张 GPU 约 400 Gbps 的互联预算。400 Gbps 约等于 50 GB/s,而单客户端 KVCache 读峰值约 40 GiB/s(约 43 GB/s),两者在同一量级。这不是巧合:网络预算必须覆盖「8 张卡同时取回」的峰值,否则命中率越高、网络越先成为瓶颈。换句话说,KV 存储系统的容量规划不能只看 PiB,还要看「每 GPU 对应的网络带宽」是否与缓存命中带来的取回量匹配。
TTL 的选择则是另一条曲线。3 天与 7 天的差别,在 chatbot 流量上是 0.5%–1% 的命中率;在 agent 流量上官方没有给具体数字,但 agent 的会话通常更短、前缀更集中,长尾可能没有 chatbot 那么重。把 TTL 从 3 天拉到 7 天,容量占用近似翻倍,命中率只提升不到一个百分点——这是一笔需要按存储成本与 prefill 算力价格共同定价的账,不存在「越长越好」的默认答案。
与主流框架的对照
把 DeepInfer 的选择放进主流推理框架的坐标系,差异会更清楚。下表的比较只针对「跨请求 KV 复用」这一层,不涉及各框架的 kernel 与调度细节:
| 框架 | 块 KV 的主位置 | 是否有跨节点共享 | 命中判定在哪 | SWA/状态缓存 |
|---|---|---|---|---|
| vLLM | HBM 中的 paged KV | 默认不共享;可通过 KV connector/offload 扩展 | 引擎内的 block hash 表 | 统一放在 KV 池 |
| SGLang | HBM radix tree | HiCache 提供 host 与 L3 分层 | 引擎内的 radix tree | 统一放在 KV 池 |
| TensorRT-LLM | HBM paged KV | 实例内复用;offload 可到 host/disk | 引擎内的块管理器 | 统一放在 KV 池 |
| llama.cpp | HBM/CPU 的 KV cache | 单机;prompt cache 可落盘 | slot/prompt cache | 统一放在 KV 池 |
| DeepInfer | 专用 3FS 集群 | 全局共享,Entrypoint 统一匹配 | Entrypoint 的 kvcache-store CHECK | SWA 单独放 host memory |
和 vLLM:本地优先 vs 远端优先
vLLM 的前缀缓存是本地优先的典型:块哈希表在引擎进程内,命中在本机 HBM 完成,未命中就重新算。它的扩展方式是通过 KV connector 把 KV 搬到其他介质或其他实例,但「是否命中」仍然由引擎自己判断。这种设计的优点是命中延迟极低、实现简单;缺点是跨节点命中需要额外的连接器与路由策略,默认不保证任意前缀可命中。
DeepInfer 反过来,把块 KV 的主位置放在远端 3FS,HBM 只保留 in-flight 部分。代价是每次命中都要取回;收益是命中不依赖请求落在哪台机器。两者不是「谁更先进」的关系,而是对「缓存容量 vs 命中延迟」的不同取舍。vLLM 适合单机/小集群、命中以本地热前缀为主的场景;DeepInfer 适合大规模、跨机前缀复用价值高的场景。
和 SGLang HiCache:分层缓存的两种形态
SGLang HiCache 是最接近 DeepInfer 的对标物:它把 KV 缓存分成 HBM、host memory、L3 三层,用分层 radix tree 维护命中,并做异步预取与写回。站内 SGLang HiCache 拆解 已经拆过它的分层前缀树与搬运流水线。
两者的关键差异有三点:
- DeepInfer 的块缓存没有「本地 HBM 层」作为持久缓存。 HBM 只放 in-flight KV;跨请求复用的块缓存从 3FS 直接取。HiCache 则优先在 HBM/host 命中,L3 是兜底。前者把网络放在更前面,后者把本地层级放在更前面。
- DeepInfer 把 SWA 缓存从块缓存里拆出来,单独放 host memory。 HiCache 的层级是「同一份 KV 的不同介质」,DeepInfer 的层级是「不同性质的状态用不同介质」。这是模型结构(SWA/YoCo/CED)带来的特化,不是通用缓存设计。
- DeepInfer 的命中判定在 Entrypoint,HiCache 的命中判定在引擎侧。 前者让路由知道命中长度,后者让缓存感知调度在引擎/路由器之间协调。两者都在解决「前缀亲和 vs 负载均衡」,只是把决策点放在了不同位置。
和 TensorRT-LLM、llama.cpp:块管理相似,系统边界不同
TensorRT-LLM 的 KV 池、分页块、KV offload 与 DeepInfer 的块管理在单机层面很像:都是分页块表、块粒度写入、按层换入。区别在系统边界:TensorRT-LLM 的 KV 复用主要在实例内,跨实例要靠 disaggregated serving 的 KV 传输;DeepInfer 则把「跨实例复用」做成了默认能力,块缓存从一开始就放在共享存储里。
llama.cpp 的 prompt cache 更简单:把一段会话的 KV 状态存到文件,下次相同前缀时读回。它是单机、单进程的缓存,没有全局目录,也没有跨机命中。把它放进这张表,是为了说明「KV 落盘」本身不新鲜;新鲜的是落盘之后如何被全局匹配、如何在路由前算出命中长度、如何在多租户集群里淘汰。
这套设计的边界与代价
官方材料把行为讲得很清楚,但没有开源的部分也留下了几条必须尊重的边界。
未公开的实现细节
kvcache-store 的文件布局、块键的编码、元数据的索引结构、并发写入的一致性协议,都没有公开。官方只说了「hash-chain 前缀匹配」「CHECK 角色」「无过期逻辑」。这意味着:
- 不能从公开材料推断它是「每个前缀一个文件」还是「所有块写进一个大文件」;
- 不能推断多台 Prefill 同时写同一前缀时的去重/覆盖策略;
- 不能推断 CHECK 的元数据是全部驻留内存,还是按需读 3FS。
这些细节会显著影响尾延迟与扩展性,但在没有源码的情况下,只能把它们当作「待验证的实现问题」,而不是设计结论。
匹配在关键路径上的成本
hash-chain 匹配的复杂度与前缀块数成正比。一条 1M token 的输入有 8192 个 128-token 块;即使只读元数据,一次匹配也要处理八千多条记录。Entrypoint 要为每个请求做这件事,并且要在路由前完成。官方没有披露元数据缓存策略与批量查询优化,因此「匹配会不会成为 Entrypoint 的瓶颈」是一个合理的工程疑问,而不是可以忽略的细节。
从系统设计上看,这条路径有几个可能的缓解手段:按块批量读元数据、在 Entrypoint 本地缓存热前缀的匹配结果、把匹配拆成「粗粒度段匹配 + 细粒度块匹配」。但官方材料没有确认任何一种,所以这里只能把它们列为「可预期的优化方向」。
存储集群的依赖与故障域
块缓存依赖 3FS 的可用性。3FS 用 10+2 纠删码,每个 EC 组容忍两个节点同时故障;读请求向 11 个节点并发发出,任意 10 个返回即可解码。这套冗余让「存储节点故障」不至于直接丢缓存,但它不能消除网络分区、元数据服务故障、GC 尖峰带来的尾延迟。
官方说计算节点故障率比存储节点高一个数量级以上,这是把缓存放到存储集群的理由之一;但反过来说,存储集群一旦抖动,影响的是所有 Prefill 的命中率与取回延迟,而不是一台机器。这是集中式缓存的固有风险,需要用存储侧的冗余与限流来吸收。
SWA 缓存的单副本风险
SWA 缓存只存在产生它的那台机器的 host memory,单副本、不落 3FS。机器重启或故障,这部分缓存就丢了。丢失的后果是有界重放:重算最后 128 token,代价近似常数。这个设计之所以成立,是因为「重算便宜」;如果 SWA 窗口更长、层数更多,单副本策略就会变得不可接受。
跨机命中时,SWA 缓存走 400G VLAN 回拉。这里有一个隐含的容量问题:SWA 缓存是按「每序列 1.35 MiB」算的,如果一台机器上同时驻留几千条序列的 SWA 缓存,host memory 的占用会达到几 GiB;官方没有给出 host memory 的容量上限与淘汰策略,只说了「单副本、留在产生它的机器」。这意味着 SWA 缓存的容量规划需要按「并发序列数 × 1.35 MiB」单独算,不能混进 HBM 的 KV 账。
没有 Decode offload,也不代表 HBM 不紧张
官方明确说 Decode 不做 KV offload,也不使用 Hi-Sparse,因为 Decode 不受缓存容量约束。这句话容易被误读成「Decode 的 KV 不占显存」。实际上 in-flight block KV 与 state KV 仍然在 HBM 里,只是不需要把「历史的、非当前的」KV 搬到远端。890 B/token 让单条序列的 KV 变小,但 Decode 的并发序列数、MoE 的专家权重、CUDA Graph 的私有池仍然在争同一块 HBM。启动时的显存 profiling 的启动账本已经说明:在 V4.1-Flash 上,KV 池通常不是最先见底的那一项。
多租户与安全边界
公开材料没有描述 KV 缓存的租户隔离、访问控制与加密。共享存储意味着不同请求的 KV 可能落在同一套 3FS 集群上;如果业务是多租户的,键空间隔离、元数据访问控制、缓存命中是否可能跨租户,都是需要额外确认的问题。本文不假设官方实现了某种隔离机制,只把它标为「公开材料未覆盖」。
小结
DeepInfer 的 KV Cache 存储系统可以压缩成一句话:把「序列历史」放上共享 3FS,把「序列状态」留在本机内存,把「命中长度」放到路由之前算。
围绕这句话,本篇拆了六件事:
- 介质分层:in-flight KV 在 HBM,SWA 在 host memory,分页块 KV 在 3FS。三层分别服务 step、请求、天三个时间尺度,128 token 是三者共享的粒度。
- 块缓存的内容:主 KV 加索引器 K。索引器 K 必须一起持久化,否则稀疏注意力的索引器要重跑;按 890 B/token 估容量会低估,因为索引器 K 没有公开的每 token 字节数。
- 匹配语义:Entrypoint 对
kvcache-store做 hash-chain 元数据匹配,命中长度必须在路由前算出。匹配无法隐藏,取回可以异步,换入可以与前向重叠。 - SWA 存储:前 20 层、134 token、528 B/token、每序列约 1.35 MiB;只存保存段,丢弃段依赖重算;decode 用副本区,请求结束才落盘。
- 命中策略:块缓存决定命中长度,SWA 决定最后一块是否重算;上限是 ;SWA 缺失时退一块,用有界重放把重算代价压成常数。
- 容量与代价:100 PiB、14.4 TB/GPU、3/7 天 TTL、40 GB/s 读与 5 GB/s 写、每 8 GPU 400 Gbps;命中率与 TTL、前缀长度、网络预算三者互相约束。
这套设计不是「把 KV 放磁盘」这么简单,而是把缓存命中变成了一个路由前的全局决策。它换来了任意机器命中任意前缀的能力,也换来了匹配延迟、存储依赖与单副本 SWA 的风险。理解这些取舍,才能判断它在什么规模的部署里划算、在什么场景下应该退回本地分层缓存。
参考资料
- DeepInfer 官方仓库(DeepSeek-AI)
- DeepInfer 官方部署问答:KV Cache 存储、负载均衡与集群配置
- DeepSeek V4.1-Flash 推理系统设计(官方知乎文章,部署问答引用)
- DeepSeek-V4.1-Flash 模型仓库与技术报告(KV cache 压缩、890 字节/token)
- 3FS 官方仓库(KVCache for Inference、设计文档与压测图)
- Fire-Flyer AI-HPC: A Cost-Effective Software-Hardware Co-Design for Deep Learning(arXiv:2408.14158,SC24)
- DeepSeek API 文档:上下文硬盘缓存(Context Caching on Disk)
- vLLM 官方文档:Automatic Prefix Caching(块哈希与前缀复用设计)
- SGLang HiCache 设计文档(三级缓存与分层前缀树)
- TensorRT-LLM 官方文档:KV Cache System(分页池、复用与 offload)
- llama.cpp 官方仓库:server prompt cache 与 slot 状态
- DeepSeek-V3.2 技术报告(DSA 稀疏注意力与索引器 K)
- 站内:DeepInfer 源码完全拆解(三):KV 内存与 SWA 有界重放
- 站内:DeepInfer 源码完全拆解(二十):启动时的显存 profiling
- 站内:DeepInfer 源码拆解(十一):注意力族与压缩 KV
- 站内:DSA 稀疏注意力完全拆解
- 站内:DeepSeek 3FS 完全拆解
- 站内:RadixAttention 完全拆解
- 站内:SGLang HiCache 拆解
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



