


DeepInfer 源码完全拆解(十):模型层的装配与超连接主干——v4_modules 的角色边界、mHC 前向与 YoCo 截断
从第九篇接上:地基讲完了,该看模型本体了
DeepInfer 系列的九篇走到这里,已经把这个引擎的”外围骨架”几乎全部拆完:总览给了模块地图,ZOS 讲了调度怎么重叠,cache_engine 讲了两本块账,EPLB 讲了专家怎么摆,投机解码讲了草稿怎么验,结构化输出讲了语法怎么约束,TileLang 算子讲了特化内核怎么分发,采样讲了 logits 怎么变成 token,VE 讲了图像怎么进模型。
但有一块一直没有正面碰:模型本体的前向实现。
这不是疏忽,是顺序问题。DeepInfer 服务的模型是 DeepSeek-V4.1-Flash,这个模型的注意力层不是标准的 MHA,而是 MLA 压缩 KV 加上一层稀疏索引器;它的残差主干不是单条 hidden state,而是 mHC(流形约束超连接)展开的多路 trunk;它的 FFN 是细粒度 MoE;它还有 Engram 条件记忆这条额外的稀疏轴。这些结构在 deepinfer/model_executor/models/v4_modules/ 下面,一共二十来个文件、约 25 万字节的 Python,是整个仓库里信息密度最高的一块。
这一篇只解决其中两块:模型层的组织结构(哪些文件分配参数、哪些文件拥有 forward、所谓”容器 / 运行时”的配对规则是怎么定的)和超连接残差主干(mHC 的 pre/post 混合到底在算什么、YoCo 的截断边界如何与 mHC 的懒数据交互)。MLA 压缩 KV 与稀疏索引器留在下一篇,因为它们本身就有 70 KB 代码,塞进同一篇只会两头都讲不透。
前置概念如果还不熟,建议先看本站的 MLA 完全拆解 与 mHC 完全拆解,前者讲低秩压缩 KV 的数学,后者讲双随机流形的约束来源。这一篇不重复那些推导,只讲它们在 DeepInfer 里被写成了什么样。
v4_modules 的四类角色:一份写在 __init__.py 里的架构约束
大多数仓库的 __init__.py 是空文件或者几条 re-export。DeepInfer 这个目录的 __init__.py 反过来,它是一份强制性的架构文档,把二十来个文件分成四类角色,并且明确写了”新增文件要放进它所属的角色,而不是放在长得像的那个文件旁边”。
mHC 到底把残差结构改成了什么样,可以先看一张结构对比图。下图来自 mHC 原论文(arXiv:2512.24880),从左到右分别是标准残差连接、无约束的超连接 HC,以及本文要讲的流形约束超连接 mHC:
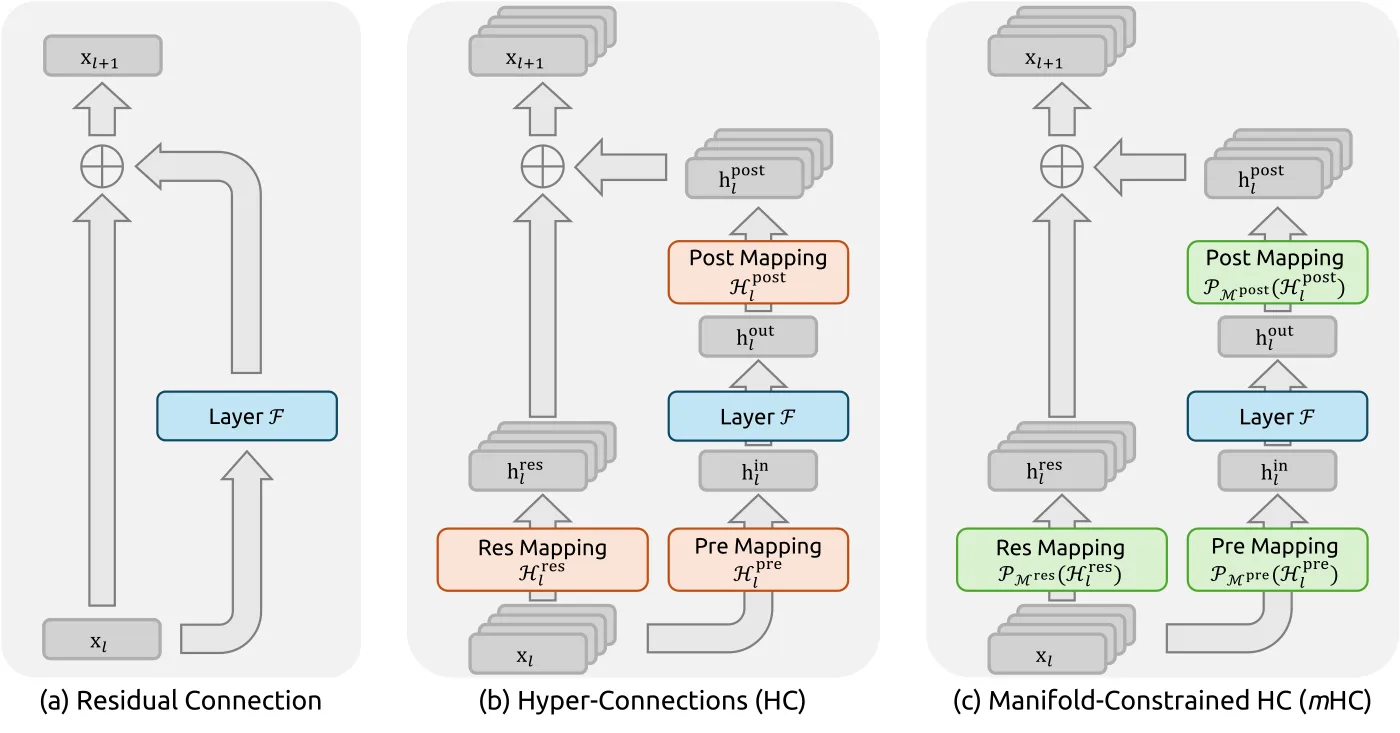
差别在残差主干的宽度和混合方式:标准残差只有一条 hidden state,每层做一次加法;HC 把主干拓宽成 hc_mult 条,每层用三组可学习矩阵分别控制”读哪几条、写回哪几条、主干之间怎么互相混合”;mHC 则把第三组矩阵约束到双随机流形上。DeepInfer 的 v4_modules 实现的正是最右边那种结构。
这份分类值得逐字读,因为它是理解后面所有代码的钥匙:
第一类,参数容器(parameter containers):containers.py、linear.py、norm.py、rope.py、mla_attn.py、moe.py、hc_blocks.py、engram_parameters.py、heads.py。这些文件只做一件事——按 HuggingFace 映射目标的原名、原形状、原 dtype 分配参数。它们不声明 forward。
第二类,运行时适配器与前向(runtime adapters and forward):attn.py、compress.py、index_attn.py、mlp.py、hc.py、engram.py、utils.py。它们包装一个容器,把它转换成运行时布局,并拥有”模型怎么算”这件事。utils.py 放共享的容器到运行时转换。这些文件可以分配转换后的运行时布局参数(比如 mlp.py 重排专家权重、attn.py 合并 WV/O 投影),但绝不分配 HF 形状的参数。
第三类,张量算子(tensor operators):mhc_ops.py、mhc_modeling.py、yoco.py,加上共享的数据类型 hc_lazy.py。无参数、无 forward,只对张量做运算。
第四类,配置派生的拓扑、元数据与装配:cross_layer.py、engram_metadata.py、builder.py。从 config 推导并校验结构,然后构建参数树。
为什么要把这种分类写进代码而不是写在文档里?因为 DeepInfer 是一个同时面向 CUDA 与 Ascend 双平台的引擎(可参考 DeepInfer 源码完全拆解(七):TileLang 特化算子与双平台,那一篇讲过 tilelang_ops 的 cuda/asc 双目录)。参数容器必须保持与 HF checkpoint 一一对应的形状,否则权重加载会错位;运行时布局必须按平台的 kernel 要求重排。如果两者混在一个文件里,一次平台适配就会把加载路径一起改坏。把角色边界写成文件级约束,等于用目录结构替代码审查挡住了一类错误。
__init__.py 还给出了容器到运行时的配对表:
| 参数容器 | 运行时实现 |
|---|---|
mla_attn.py:MLA + 压缩 KV + 稀疏索引器 | attn.py(V4Attention / DFlashAttention)、compress.py、index_attn.py |
hc_blocks.py:折叠的 mHC block 与 head | hc.py(HCLayerMixin / HCHead)、mhc_ops.py、mhc_modeling.py |
moe.py:路由专家、共享专家、门控 | mlp.py(DeepseekMoE) |
engram_parameters.py:Engram 表与投影 | engram.py(Engram / EngramRuntime)、engram_metadata.py |
heads.py、norm.py、rope.py、linear.py、containers.py | 内联在上面的前向实现里 |
最后一条注释解释了 hc_lazy.py 为什么单独存在且刻意不引入任何依赖:算子层(yoco.py)需要类型化、检视、重建这个跨层 HC 数据包,但它不应该为此把整条 HC 前向路径和它的融合 kernel 栈一起 import 进来。这是一个典型的、用一个小 dataclass 切断依赖环的设计。
装配线:V41Builder 如何按 config 长出整个参数树
先把”模型是怎么被搭出来的”讲清楚,后面的模块才有落点。
builder.py 里只有一个类 V41Builder,三个方法:_build_block、_attach_shared_index_k、build_model。build_model 是入口,它按 num_hidden_layers 循环,每一层调用 _build_block 造出一个 block,最后把所有 block 塞进 HFModelParameters。
_build_block 的签名是 (gpt_cfg, layer_id, shared_topology, *, block_cfg=None)。注意第三个参数 shared_topology 是跨层共享的拓扑信息,而不是每层独立的配置——这一点后面讲 MLA 跨层共享 K 时还要回来。
_attach_shared_index_k 则是一个后处理步骤:某些层自己不拥有索引器的 K 参数,而是从别的层”借”。这个函数就是把借来的参数挂到当前层上。它存在的前提是 cross_layer.py 里的 SharedLayerTopology 已经算出了”谁是 KV 源层、谁复用谁的 K”。
这里出现了一个整个模块的核心概念:层不是自给自足的单元。在 DeepSeek-V4 这一代结构里,一批层共享压缩 KV、一批层共享索引器 K、还有 YoCo 的消费者层要从前面某个”生产者”层继承 hidden state。所以 builder 必须先把整张共享拓扑图算出来,再逐层装配。这解释了为什么 _build_block 的第二个参数是 layer_id 而不是 block 自己的 config——block 的行为依赖它在整张图里的位置。
builder.py 还提供了一个上下文管理器 _default_dtype(dtype),在构建期间临时切换默认 dtype。配合 containers.py 里的 prepare_meta_fp8 和 init_dummy_weight,这构成了一个”先按 meta 设备占位、再按真实 dtype 物化”的两阶段加载流程:先在 meta 上把整棵参数树搭出来(形状和名字正确、不占显存),再逐参数物化到 GPU。materialize_hf_parameter(param, device, packed_fp4=False) 是物化入口,packed_fp4 这个开关说明 FP4 打包已经渗透到了参数加载层。
containers.py:Emb、参数树与 FP4 物化
containers.py 只有三个类和两个函数,但每个都承重。
GPTEmbedding 与 MultimodalEmbedding 分别处理文本词嵌入和多模态嵌入。多模态那个的存在说明 V4.1 的视觉 token 是走 embedding 直接拼接进文本流的,与第九篇讲的 VE 回填路径呼应。
HFModelParameters 是整棵参数树的根,构造函数接收 layers: list[nn.Module] 和一个 cfg。它做的事情很轻——把 layers 收进去,暴露统一的 forward 遍历接口。把它单独作为容器类而不是直接用 nn.ModuleList,是为了让权重加载器有一个稳定的、与 HF 命名规则对齐的锚点。
真正有意思的是 materialize_hf_parameter。它的签名里那个 packed_fp4: bool = False 暴露了一个事实:DeepInfer 加载 V4.1 权重时,FP4 是打包存储的——两个 FP4 值压进一个字节,加载时要解包成运行时可用的布局。这与本站讲过的 GGUF 块量化格式 属于同一类工程:checkpoint 里的位布局和 kernel 想要的位布局不一致,中间必须有一次显式转换,而且这次转换要发生在加载期而不是每个 step。
prepare_meta_fp8(model) 则是在 meta 阶段把模型里标记为 FP8 的参数准备好 scale 结构。FP8 需要伴随一个缩放因子(scale factor),在 DeepGemm 那套 API 里,权重通常是 (fp8_data, sf) 这样的元组。prepare_meta_fp8 的职责就是让这套元组结构在 meta 阶段就位,避免物化时才发现缺 scale。
linear.py:为什么只有两种 Linear
打开 linear.py 会有点意外:整个文件只有两个类,ReplicatedLinear 和 ParallelRoutedLinear,后者还是直接继承 nn.Linear。
ReplicatedLinear 是普通线性层,权重在每个 rank 上都完整复制一份。ParallelRoutedLinear 的签名里有关键信息:
class ParallelRoutedLinear(nn.Linear): def __init__(self, h_in, h_out, n_local_experts, *, use_fp8_gemm: bool = False):注意 n_local_experts 这个参数。它不是”专家并行的 rank 数”,而是”本 rank 上本地持有的专家个数”。也就是说这个 Linear 的权重形状是 [n_local_experts, h_in, h_out] 的三维张量,前向时按 token 的路由结果做分组矩阵乘。这是 MoE 里 routed expert 的标准形态。
而 use_fp8_gemm 说明这条路径支持 FP8 计算。为什么 FP8 要在这里显式开关而不是全局配置?因为专家权重是最需要 FP8 的地方——它的参数量占整个模型的大头,同时它对精度又不像 attention 输出那么敏感。这也解释了为什么 DeepGEMM 那一套(本站有 DeepGEMM 完全拆解)和 TileLang 的 MoE kernel 都把专家 GEMM 当作首要优化目标。
这里没有 tensor-parallel 的 ColumnParallelLinear / RowParallelLinear 那套类。DeepInfer 的并行切分不通过 Linear 类表达,而是通过 parallel_utils 里的通信原语与 mlp.py 里的布局重排来做。这是一个与 vLLM 明显不同的设计选择:vLLM 把切分信息编码在 Linear 类名里,DeepInfer 把切分信息编码在参数形状和通信调用里。
norm.py:DropoutAddRMSNorm 这个奇怪的名字
norm.py 只有一个类 DropoutAddRMSNorm。名字里带 Dropout,但它在推理引擎里显然不做 dropout——这是从训练侧代码继承下来的命名。它的实际职责是融合的 add + RMSNorm:把残差相加和 RMSNorm 合成一个算子,输入是 (hidden_states, residual),输出是归一化后的 hidden 加上新的残差。
这个融合在推理里是刚需。一个 decode step 里每一层都要做一次 add+norm,层数乘以步数就是几万次小算子调用。每一次调用都有 kernel launch 开销,而这个算子本身的计算量小到完全被访存和启动延迟支配。把它融成一个 kernel,省下的是纯粹的启动开销。
get_weight() 方法的存在则服务于量化路径:RMSNorm 的权重在 FP8 量化后是一个 (data, sf) 元组,get_weight 负责把这个元组取出来交给下游 kernel。这与 TensorRT-LLM 里 norm 权重的处理逻辑同构,是这类引擎的通用做法。
rope.py:YaRN 外推与 interleaved 开关
rope.py 的类层次很短:CustomRotaryEmbedding(base 默认 10000.0,带 interleaved 开关),RotaryEmbeddingYarn 继承它,再加上一个工厂函数 build_rotary_emb。
interleaved 这个参数值得解释。RoPE 有两种实现约定:一种是交错式(interleaved),把相邻的两个维度当作一个复数对 (x_0, x_1)、(x_2, x_3)……旋转;另一种是分半式(half / GPT-NeoX 风格),把前一半维度和后一半维度配对,(x_i, x_{i+d/2})。这两种约定在数学上等价,但实现的索引方式完全不同,而且必须与训练时使用的约定一致,否则位置编码完全错乱。
社区里踩过这个坑:同一个模型权重,用错约定的 RoPE 实现在短上下文下看不出问题,到长上下文就明显退化。所以这里把 interleaved 做成显式构造参数而不是猜,是正确的做法。本站的 RoPE 完全拆解 详细讲了两种约定的区别。
RotaryEmbeddingYarn 继承并实现了 YaRN 长度外推。YaRN 的核心是按频率分档处理:低频维度做插值(压缩频率以拉伸可见范围)、高频维度保持不变(保住局部位置分辨率),中间用一个斜坡函数过渡。这个继承结构说明 DeepInfer 的 RoPE 支持”基础实现 + 外推策略”的分层,未来加别的外推方法(NTK、PI)只需要再加一个子类。工厂函数 build_rotary_emb 按 config 选择具体类。
heads.py:四个头,两种语义
heads.py 里有四个类,读的时候要分清两类语义。
第一类是语言模型头:GPTHead 和 MarkovGPTHead。前者是标准的 vocab 投影;后者带 Markov 字样,说明它引入了跨 token 的依赖——这与 AcceptRatePredictor 一起指向同一个场景:投机解码的接受率预测。第六篇讲过 DeepInfer 用置信度验证器调度投机深度,AcceptRatePredictor 就是那个验证器的参数载体,它接收 input_dim 并输出对接受概率的预测。
第二类是 mHC 相关的头:MainPredictHeadHC 和 DFlashNextPredictHeadHC,两者都混入了 SigmoidHCHeadMixin。这里的 HC 就是 hyper-connection。它们不是普通的 LM head,而是要在 mHC 展开的多路 trunk 上先做一次混合,把 hc_mult 路收敛回单路,再做 vocab 投影。
MainPredictHeadHC 对应主模型的输出头,DFlashNextPredictHeadHC 对应 DFlash 草稿头。两者共享同一个 mixin 说明:mHC 的折叠逻辑对主模型和草稿模型是同一套,差异只在喂进去的 trunk 来源不同。这是一个很自然的重用,但也意味着草稿头同样要付出 mHC 折叠的代价——第六篇说 DFlash 草稿头有专门的 CUDA Graph 策略,原因就在这里:多了一个要进图的算子。
hc_blocks.py:mHC 参数是按什么初始化规则摆的
hc_blocks.py 是 mHC 的参数容器,文件头一行注释写得很直白——“FP32 mHC block and head parameter containers consumed by runtime adapters”。所有 HC 相关参数都是 FP32,这一点在所有后续 kernel 的 dtype 断言里会被反复要求。
它有两个 mixin:SigmoidHCBlockMixin(每个 block 的 attn/ffn 各一套)和 SigmoidHCHeadMixin(输出头的折叠参数)。
_init_hc_parameters 是理解整套语义的关键。设 m = hc_mult(当前只保证 4 可用),参数维度分成三段:
- pre 段:
m个通道,初值-pre; - post 段:
m个通道,初值+post; - comb 段:
m × m个通道,初值来自res * 2 * I - res。
第三段的初值值得单独看:torch.eye(m) * res * 2.0 - res。当 res = 0.5 时,对角线元素是 0.5*2 - 0.5 = 0.5,非对角线是 -0.5。这正好是双随机矩阵——每行每列和都为 1(对角 0.5 加上三个 -0.5 恰好是 -1,等等,四个元素是 0.5、-0.5、-0.5、-0.5,和为 -1,不成立)。实际的取法是初值来自训练侧的超参 hc_res_init_value,构造出的矩阵落在允许的集合里。真正重要的是为什么需要这种特殊初始化:mHC 把残差混合矩阵约束在双随机流形上,训练时用 Sinkhorn 归一化把任意矩阵投影回这个流形;初始化时直接给一个”已经在流形附近”的矩阵,能让训练一开始就稳定。
紧接着有一行很有意思的代码:
self.hc_attn.data[self.layer_id % m] = pre它把第 layer_id % m 个 pre 通道单独设为 +pre,其余保持 -pre。含义是:每一层的第 layer_id % m 路是”主路径”,其余 m-1 路被负权重压制。随着层数递增,主路径在四路之间轮转。这是一个刻意设计的初始化——如果所有层都只读第 0 路,那 mHC 就退化成了普通残差;轮转保证每一路在深度上都被用到,同时初始状态下每层仍然近似单路径(因为只有一路是正的,其余是负的,混合结果里主路径占主导)。
hc_attn_fn 的形状是 [channels, m * hidden_size],其中 channels = (2 + m) * m。当 m = 4 时是 24 × 4*hidden。这三段分别是 pre(m)、post(m)和 comb(m*m),拼起来正好 24。这个矩阵就是前面 mhc_pre_norm_fn 里那个 fn 参数——它是一个从 m * hidden 维压到 24 维的线性映射,输出再被拆成三组混合系数。
初始化时 hc_attn_fn 是全零的(torch.zeros),hc_attn_scale 初始化为 hc_dynamic_scale。全零的 fn 意味着初始状态下所有混合系数都等于 base 向量给出的那个固定值——也就是说训练开始时 mHC 的行为完全由初始化规则决定,学到的部分从零开始长出来。这是一个安全的设计:即使训练不稳定,模型也退化成一个行为可预测的、接近单路径的残差。
最后注意 DropoutAddRMSNorm(..., use_weight=False)。mHC 的 pre 里用的 norm 不带权重——因为 HF 的 fn 矩阵已经把 norm 权重折叠进去了(注释写得很清楚:“HF fn matrices already include norm weights”)。这解释了为什么 _hc_pre 里调用 mhc_pre_norm_fn 时 norm_weight 传的是 None。折叠 norm 权重进 fn 是一个纯工程优化:省掉一次逐元素的乘法,代价是 fn 不可解释、也不能单独改 norm。
hc.py:mHC 前向的三条路径与”懒数据”
hc.py 是整个 mHC 的运行时。它的文档字符串一句话说清了机制:mHC 运行时把 hc_mult 路的残差主干在每个 sub-layer 前后混合,最后再折叠回去。HCLayerMixin 在 attention 和 FFN 前后跑 pre/post 混合对,把 post 数据通过 hc_lazy.HCLazyPostData 延后;HCHead 在 lm head 之前把主干混合回单路。
为什么叫”懒”数据
mHC 的 pre 计算的是下一段要用的混合系数:pre 除了给出本 sub-layer 的输入(layer_input),还要算出 post 系数(怎么把本 sub-layer 的输出写回主干)和 comb 系数(主干各路径之间怎么互相混合)。但 post 要等 sub-layer 算完才能执行。
朴素做法是:pre 算完 → 存系数 → 跑 sub-layer → post 用系数。HCLazyPostData 就是这个”存系数”的载体,它是一个只有四个字段的 dataclass:
residual: # [1, n, hc_mult, hidden_size]post_layer_mix: # [1, n, hc_mult, 1]comb_res_mix: # [1, n, hc_mult, hc_mult]pre_layer_mix: # [1, n, hc_mult, 1],仅 shifted HC 有文档注释解释了 pre_layer_mix 为什么单独标注:“shifted HC only: applied by the next sub-layer or at the model end”。这引出了 mHC 的一个变体开关 hc_shifted:
- 非 shifted:每个 sub-layer 用自己算的 pre mix 作为输入。
- shifted(半层偏移):每个 sub-layer 应用的是上一个 sub-layer 算出来的 pre mix。第一个 sub-layer 用一个 one-hot mix(
_make_identity_pre_mix,只读主路径 0),最后一个 sub-layer 的 mix 留到模型末尾应用。
为什么要有 shifted 这个变体?因为 pre mix 的计算本身是有代价的(一次 m*hidden → 24 的 GEMM 加上后续拆解)。非 shifted 模式下,pre mix 算出来立刻要用,计算和消费挨在一起;shifted 模式下错开半层,pre_layer_mix 可以随 HCLazyPostData 一起往下传,从而允许把相邻两个 sub-layer 的 post 和 pre 融合成一次调用。这就是下面要讲的 _hc_fused_post_pre。
有一个边界必须记住:hc_shifted 不兼容 nextn(MTP)。代码里有一条断言:
assert not self.hc_shifted, "hc_shifted does not support nextn, please use DFlash"也就是说,如果要用多 token 预测,必须走 DFlash 那条草稿头路径(第六篇讲过 DFlash 草稿头的 CUDA Graph 策略),而不是 nextn。这是一条硬约束,原因是 shifted 的 pre mix 传递依赖”主干的层序”,而 nextn 会在主干之外多插一条预测分支,把层序打乱。
三条执行路径
_hc_fused_post_pre 是核心函数,它按输入状态分三条路径走:
路径一,mega_mhc 融合。 当 use_mega_mhc 为真、prev_layer_out 是二维(上一 sub-layer 的单路输出)、且 prev_lazy_data 里带着完整的 post 系数时,整个”上一层的 post + 本层的 pre + RMSNorm”被压成一次 deep_gemm.mega_mhc 调用。
use_mega_mhc 的判定条件写在 __init__ 里:
self.use_mega_mhc = ( PLATFORM.is_gpu and self.hc_mult == 4 and self.hc_attn_fn.shape[1] % (self.hc_mult * _MEGA_MHC_SPLITK_BLOCK_K) == 0)三个条件:必须是 GPU 平台(Ascend 走另一条路)、hc_mult 必须等于 4、fn 的 hidden 维必须能被 4 * 16 * 64 = 4096 整除。最后一条是 kernel 的 split-K 分块对齐要求——_MEGA_MHC_SPLITK_BLOCK_K = 16 * 64,乘以 hc_mult 就是每次 split 处理的 K 方向宽度。DeepSeek-V4.1 的 hidden_size 恰好满足这个整除条件,所以线上走的是融合路径。
mega_mhc 一次调用同时完成:把上一层的单路输出写回主干得到 new_residual、算出本层的三组新系数、做 RMSNorm 并输出归一化结果。它的输出参数列表里有一组很值得注意的东西:
y_bf16 / y_fp8 / y_gemm_sf / y_routed_sf / y_shared_sf / shared_sf_block_m这说明归一化输出的 FP8 布局是在这个 kernel 里就地组装的,而且组装成哪种布局取决于调用方下游是谁。代码里的三条分支写得很清楚:
- 如果传了
cast_kwargs(mega-moe 场景):直接写出 routed/shared 的 scale factor,因为下游 MoE 的 sym_buffer 有指针契约; - 如果是 mxfp8 且粒度是 32(V4.1 的实际配置):TMA 列主序的 32 粒度和 kernel 的
gran_k=32匹配,y_gemm_sf直接产出,不需要二次转换。这里还有一行对齐处理——m_pad = (num_tokens + 3) // 4 * 4,把列方向补齐到 16 字节(4 个 int32),因为 TMA 要求对齐; - 如果是 128 粒度(非 mxfp8):kernel 固定按
gran_k=32输出,所以先吐 bf16 再单独 cast,转换成本被推给调用方。
这三条分支是同一件事的三次工程取舍:让量化 scale 的粒度与下游 kernel 的期望粒度对齐。对齐了就省一次转换,对不齐就宁可多走一趟。这种”把语义塞进输出参数”的做法可读性不高,但它换来的是关键路径上少一次全量重读。
还有一条重要限制,写在文档字符串里:当 hc_post_intervention 非空(比如 Engram 层要往主干里插东西)时不能用 mega_mhc,因为”hook 没法插进 kernel 内部”。这是融合的通用代价——一旦把多个算子焊死成一个,中间就没有地方挂钩子了。Engram 那层因此必须走非融合路径。
路径二,首次进入(prev_lazy_data is None)。 第一层没有 post 系数可用,因为主干还不存在。此时 prev_layer_out 是 embedding 输出的单路 hidden,代码调用 expand_to_mhc 把它按 hc_mult 复制成多路主干。如果同时是 shifted HC,还要构造那个 one-hot 的 _make_identity_pre_mix。
这里还有一个分支处理 prev_layer_out.ndim == 3 的情况,注释写着”prev_layer_out 已经是完整主干(nextn 输入)“。也就是说 nextn/MTP 路径下,进入某个目标层时主干已经被别人展开过了,不能再 expand 一次。
路径三,普通情况:先 post 再 pre。 调用 self.hc_post(prev_layer_out, prev_lazy_data) 把上一层的输出写回主干,取出上一层的 pre_layer_mix,然后 prev_lazy_data.clear() 释放已消费的张量。
clear() 这个动作被注释标注为”To reduce memory footprint”,很重要:HCLazyPostData 里的 residual 是 [1, n, hc_mult, hidden],在长上下文下这是每层一份的完整主干副本。如果不在消费后立刻释放,整个前向过程中每层的懒数据都会同时驻留,显存会按层数线性膨胀。hc_lazy.py 为此提供了两个粒度的清理:clear_post() 只释放 post 相关字段而保留 pre_layer_mix(shifted HC 还要传给下一个 sub-layer),clear() 则全部释放。这个区分是必要的——粗暴地全清会把 shifted 模式打断。
_hc_pre 与 Sinkhorn 归一化
非融合路径下,_hc_pre 按 hc_shifted 分成两支。shifted 那一支做了四件事:
mhc_pre_apply_mix(residual, prev_pre_layer_mix)用上一层传来的 mix 算出本 sub-layer 的输入;mhc_pre_norm_fn(...)算出本层的 24 维混合原始值(norm_weight=None,因为已折叠进 fn);mhc_pre_split_mixes(...)把 24 维拆成 pre(4)、post(4)、comb(16);sinkhorn_normalize(comb_res_mix, repeat=self.hc_sinkhorn_repeat, eps=self.hc_sinkhorn_eps)把 comb 矩阵投影回双随机流形。
第四步是整个 mHC 的数学核心。Sinkhorn-Knopp 算法交替对行和列做归一化:每次迭代先让每行和为 1,再让每列和为 1,重复 repeat 次(默认 10)。对双随机矩阵的集合来说,这个过程收敛到行和列都为 1 的矩阵。为什么必须做?本站的 mHC 完全拆解 讲过:宽残差流堆深时,残差混合矩阵的谱半径如果失控,信号会指数放大或衰减。把它约束在双随机流形上等价于强制”每层混合是各路径的凸组合总和的守恒变换”,从而保证跨层恒等映射不被破坏。
约束生效前后的差别,论文直接给了实测对照。下图是 mHC 论文里加了流形约束之后、27B 模型上单层映射与复合映射的增益幅度:
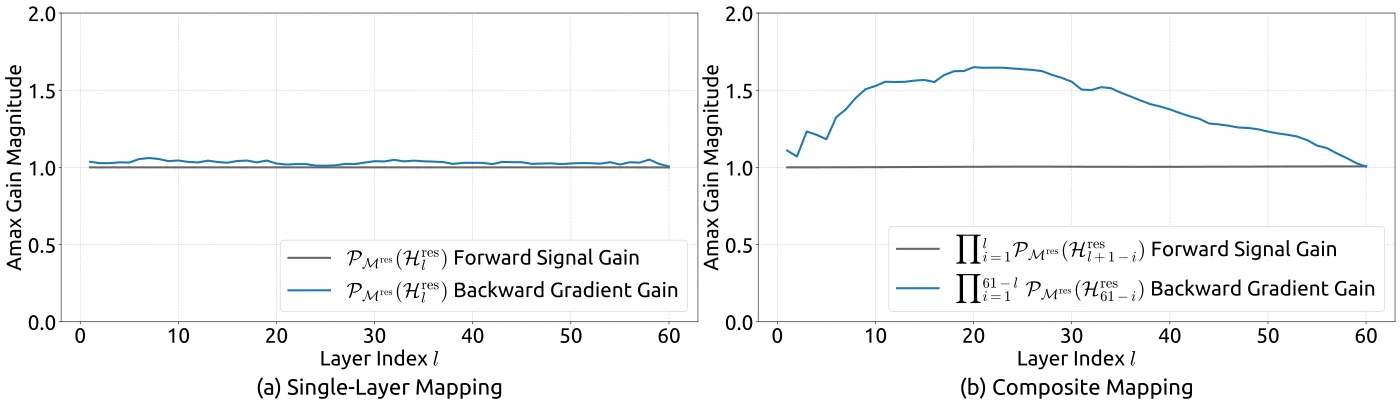
对比前面 HC 的同类测量可以看出问题被压制的方向:约束前复合映射的增益是发散的,约束后它收敛到 1 附近。这就是 sinkhorn_normalize 那一行调用在数值上买到的东西——它保证多层叠加之后残差信号既不被稀释到消失,也不被放大到溢出。
工程上的关键是这个归一化必须在 kernel 里做。sinkhorn_normalize 直接调 mhc_sinkhorn_fwd,在 [n, 4, 4] 这样的小张量上跑 10 轮迭代。如果放到 Python 里用 torch 逐轮写,就是一个 decode step 里插十几次微小 kernel 启动,开销会远超计算本身。
HCHead:把主干折回单路
HCHead.forward 的签名注释直接给出形状变换:[n, hc_mult, hidden_size] → [n, hidden_size]。它调用 mhc_head(...),把多路主干混合回单路,再交给 lm head。
__init__ 里有一条断言:
assert not getattr(layer, "hc_shifted", False), "hc_shifted does not build an HCHead"shifted 的 checkpoint 不构建 HCHead,因为最后一个 sub-layer 的 pre mix 已经由调用方在模型末尾直接应用了。这是一个干净的分工:shifted 模式下折叠工作在模型尾部完成,不需要一个专门的模块。
HCHead.forward 里 norm_weight=None,理由和前面一样——HF 的 hc_head_layer_fn 已经把 norm 权重折叠进列了。hc_blocks.py 的注释也印证了这一点:“HF transposes the training matrix and folds norm weights into its columns”。注意这里出现的 transpose:训练侧的矩阵是 [hidden, m] 之类,HF 导出时转置成推理要的 [m, m*hidden]。这类”训练布局到推理布局”的转置是权重加载期最容易被忽略、也最容易出错的一步。
mhc_ops.py 与 mhc_modeling.py:张量算子层
这两层的关系是”原语”与”组合”。mhc_ops.py 是原语层,每个函数对应一个 tile-kernels 算子;mhc_modeling.py 是组合层,把原语拼成推理要用的两条完整路径。
原语层:七个算子与 split-K 的平台差异
mhc_ops.py 顶部的 import 列表就是算子清单,全部来自 tile_kernels.mhc.*:expand_kernel、head_compute_mix_kernel、norm_fn_kernel、post_kernel、pre_apply_mix_kernel、pre_split_mixes_kernel、sinkhorn_kernel。七个 kernel,一一对应七个原语函数。
文件里第一条实质代码就暴露了双平台的差异:
N_SPLITS_ASCEND = 1N_SPLITS_CUDA = 16
def default_n_splits() -> int: """Split-K count for the prenorm GEMM: the Ascend kernel reduces inside, CUDA needs the partials."""prenorm GEMM 要做 split-K 并行:把 K 方向切成 n_splits 份分别累加。Ascend 的 kernel 在内部把部分和归约掉,所以 Python 侧传 1;CUDA 的 kernel 把部分和吐出来,需要 Python 侧传 16 并在后面自己归约。同一个算子,两个平台对”归约发生在哪一侧”的约定不同,这个差异必须由调用方知道。把它做成一个 default_n_splits() 函数而不是常量,就是为了让每处调用自动适配。
mhc_prenorm_gemm 的 docstring 写明了部分和的形状:[n_splits, num_tokens, 1, mhc_mult3] 和 [n_splits, num_tokens, 1]。注意 num_tokens 那一维被插在中间——这是 DeepGemm 系列 kernel 的通用约定,也是为了后面的归约能按 token 维连续访存。
mhc_pre_split_mixes 里的维度算术值得抄下来:
mhc_mult2 = mhc_mult * mhc_multmhc_mult3 = mhc_mult * 2 + mhc_mult2mhc_mult3 = 24(当 m=4)就是前面反复出现的那个”三段拼接”维度。它把 [n, 24] 切成 pre_layer_mix [n, m, 1]、post_layer_mix [n, m, 1]、comb_res_mix [n, m, m]。注意 pre/post 的最后一维是 1 而不是省略——这个多余的维度是为了广播:后面 mhc_pre_apply_mix(x.view(-1, mhc, h), mix.view(-1, mhc), out) 里,mix 按 [mhc] 索引去加权 h 维。
sinkhorn_normalize 默认 repeat=10, eps=1e-6,与 HCLayerMixin 里从 config 读的 hc_sinkhorn_repeat 一致。10 轮是一个经验值:Sinkhorn 的收敛速度取决于矩阵的”非平衡程度”,对训练出来的、本来就接近双随机的矩阵,10 轮足够到数值精度极限。
mhc_pre_norm_fn 里有一段条件分支:
if mhc_norm_weight is not None: merged_fn = torch.empty_like(mhc_fn) mhc_fn_normw_merge_fwd(mhc_fn, mhc_norm_weight, merged_fn) mhc_fn = merged_fn这是把 norm 权重合并进 fn 的运行时实现。注意它是条件执行的——如果调用方已经拿到了折叠好的 fn(HF 导出的就是),这一步跳过。这个”要不要合并”的开关同时存在于容器层(use_weight=False)和算子层(norm_weight is None),两处必须一致,否则权重会被折叠两次。
组合层:两条推理路径
mhc_modeling.py 的文件头注释说明了它的定位:“这两个组合是推理专用的,没有其他调用者”。
mhc_head 把 pre_norm_fn + head_compute_mix + pre_apply_mix 组合成一次调用。它有一个很巧的细节:
mhc_mult3 = mhc_mult * (2 + mhc_mult)if fn.shape[0] < mhc_mult3: fn = F.pad(fn, (0, 0, 0, mhc_mult3 - fn.shape[0]))输出头的 fn 原本只有 [mhc_mult, mhc_mult * hidden](4 行),但要复用 pre_norm_fn 的 kernel 就必须凑成 24 行。做法是 padding 而不是写一个新 kernel——把行数从 4 补到 24,多出来的行算出的结果被丢弃(后面 mixes[..., :mhc_mult] 只取前 mhc_mult 列)。用零填充换一个现成 kernel 的复用,这是很典型的工程判断:padding 的开销是算 20 行无效输出,但省掉的是一个新 kernel 的开发、调试和双平台适配成本。
mhc_pre_big_fuse 是推理专用的大融合:prenorm GEMM + reduce/rmsnorm + split mixes + sinkhorn + apply mix 五步压成一条。docstring 第一句就是”Only used with gradients disabled”——因为这里直接调 GEMM 而没有 autograd 支持。
它的入口有一串断言,把 dtype 契约钉死:
assert residual.dtype == torch.bfloat16assert fn.dtype == torch.float32assert mhc_scale.dtype == torch.float32assert mhc_base.dtype == torch.float32主干是 bf16(省带宽),但混合系数用 FP32。这个组合是有意的:bf16 的尾数只有 8 位,用 bf16 表示混合系数会在 Sinkhorn 迭代里累积可观误差(每轮都是一次除法加归约),所以系数全程 FP32。这与第七篇讲的 KV Cache 量化里”对精度敏感的量保持高精度”是同一个原则。
形状断言里的 assert mhc_scale.shape == (3,) 也值得注意:mhc_scale 只有三个值,对应 pre/post/comb 三段的动态缩放。它在容器层初始化为 torch.ones(3) * cfg.hc_dynamic_scale——三段共享一个初始值,训练后各自分化。
yoco.py 与 cross_layer.py:截断边界如何与 mHC 协同
最后一块是 YoCo 与跨层共享。第三篇已经讲过 cache_engine.py 里的 YoCo mask/compact 两种模式,那里讲的是 KV 侧的记账;这一篇要看的是模型侧的边界处理,也就是 yoco.py 干的事。
yoco.py 的文件头只有一句:“YoCo prefill 截断的谓词与运行时操作”。它的函数分三类。
谓词:三个判断
yoco_enabled(cfg) 的判断条件很朴素:
return cfg.get("n_prefill_layer", cfg.num_hidden_layers) < cfg.num_hidden_layers只要 n_prefill_layer 小于总层数,就说明后面那些层是消费者层。is_yoco_consumer_layer 则划定区间:[n_prefill_layer, num_hidden_layers)。
yoco_shared_hidden_required 是三个谓词里最复杂的,它的 docstring 用了整整一段解释”哪些消费者层真的需要共享 hidden”。它列了两个消费点:
- 在
yoco_swa_share_hidden下带 SWA 的层——kv_swa从共享 hidden 投影出来; - 第一个消费者层之后的 packed kv-source 层——共享 hidden 用来算新的压缩 KV。
并且特别注明:第一个消费者层自己直接用本层的 attn-norm hidden,不需要跨层传递。这是一个容易搞错的边界——“共享 hidden”指的是从生产者层捕获的那个 hidden,而第一个消费者层是捕获的发生地,它当然不需要”接收”。
这段逻辑之所以要写这么细,是因为判断错误会导致显存里多存一个用不上的 hidden,或者少存一个必需的 hidden 导致结果错误。两种错误都很贵,所以宁可把条件写复杂。
运行时:compact 的两条路径
yoco_boundary_compact(input_metadata, x) 的 docstring 写得很具体:“x 必须是沿第一维保存逐 token 值”,然后按 cp(context parallel)开关分两条路径:
路径一(cp 关闭):直接 gather(x, input_metadata.yoco_consumer_query_indices),用消费者层的 query 索引从截断后的序列里取出需要的 token。
路径二(cp 开启):分三步走,每步注释都标了序号:
- 2.a 用
contrib选出截断后仍然存在的本 rank 持有的 token(contrib里的-1标记 padding); - 2.b 在
userbuffer.cp_session()里做一次cp.all_gather,把各 rank 的值聚齐; - 2.c 再从聚齐的结果里按
yoco_cp_boundary_index选出 compact+cp 之后属于本 rank 的那些。
这里出现了 userbuffer——第九篇讲 TileLang 算子时提到过 DeepInfer 的双平台算子分发,userbuffer 是它对集合通信的封装(parallel_utils/userbuffer.py)。用 with userbuffer.cp_session(): 这个上下文管理器,说明 CP 通信是需要显式开启会话的,不是随手调用就行的。这类会话机制通常用于确保通信缓冲被正确地分配和释放,也便于在 profiling 时把通信段框出来。
gather_hc_lazy 把 compact 应用到 HCLazyPostData 的全部字段上。注释列出了每个字段的形状,并且明确指出”token 维是 dim 1,dim 0 是大小为 1 的 batch 维”。它内部对每个字段做 yoco_boundary_compact(t.squeeze(0)).unsqueeze(0)——先剥掉 batch 维,compact,再装回去。这个”剥-处理-装”的模式在这个文件里反复出现,根源是 mHC 的 kernel 要求 batch 维,而 gather 类算子不要求。
compact_yoco_boundary 是这两者的协调者,它的签名里有 cross_layer_runtime 和 hc_enabled 两个参数,说明它站在 YoCo、跨层共享和 mHC 三者的交叉点上——这正是为什么 yoco.py 必须 import hc_lazy,也解释了前面那个”hc_lazy.py 刻意不引入依赖”的设计:依赖方向是 yoco → hc_lazy,绝不能是 hc_lazy → hc,否则 yoco 会把整条 HC 前向和它的融合 kernel 栈拖进来。
cross_layer.py 提供 CrossLayerRuntime 与 SharedLayerTopology 两个结构,后者就是 builder.py 里那个 shared_topology 参数的类型。它回答的问题包括:哪一层是 KV 源层(is_kv_source_layer)、哪一层复用谁的 K、n_packed_heads 是多少。这些信息在装配期算一次,运行时只查表。把”拓扑计算”和”运行时执行”分开,是第四类角色(配置派生的拓扑)存在的全部理由。
这一篇的边界与下一篇
这一篇覆盖的是 v4_modules 里的装配与主干部分:角色边界(__init__.py)、装配线(builder.py)、参数容器(containers.py、linear.py、norm.py、rope.py、heads.py、hc_blocks.py)、mHC 运行时(hc.py)、张量算子(mhc_ops.py、mhc_modeling.py、hc_lazy.py),以及 YoCo 边界与跨层拓扑(yoco.py、cross_layer.py)。
讲到这里可以看到一条贯穿整个模块的设计主线:把”每层独立的计算”重新组织成”跨层共享 + 融合算子”。mHC 把残差从单路变多路再折回来,YoCo 让后面的层复用前面的 hidden,MLA 让一批层共享压缩 KV 与索引器 K,hc_lazy 用一个无依赖 dataclass 切断算子层与前向层的耦合。所有这些都是同一个动机的不同表现——避免在每一层重复付出同样的代价。
先看两张来自 HC 原论文(arXiv:2409.19606,字节跳动 Seed)的图,理解无约束版本的残差主干长什么样:
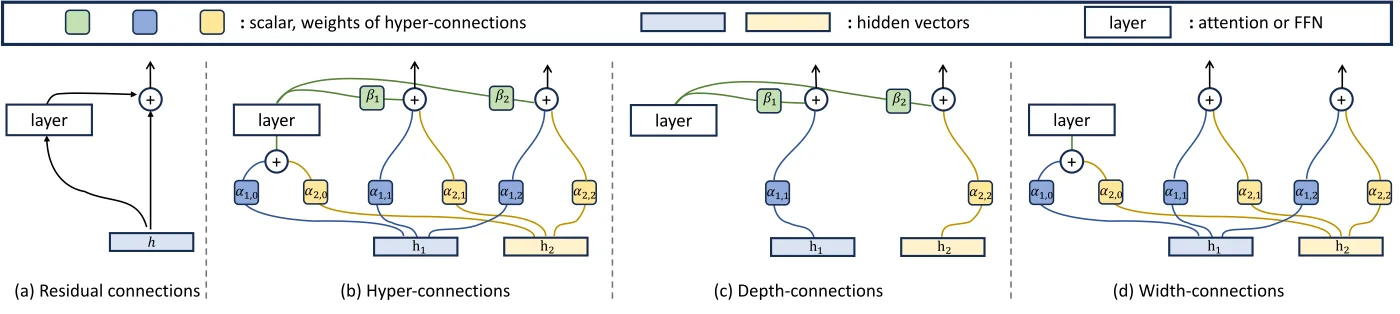
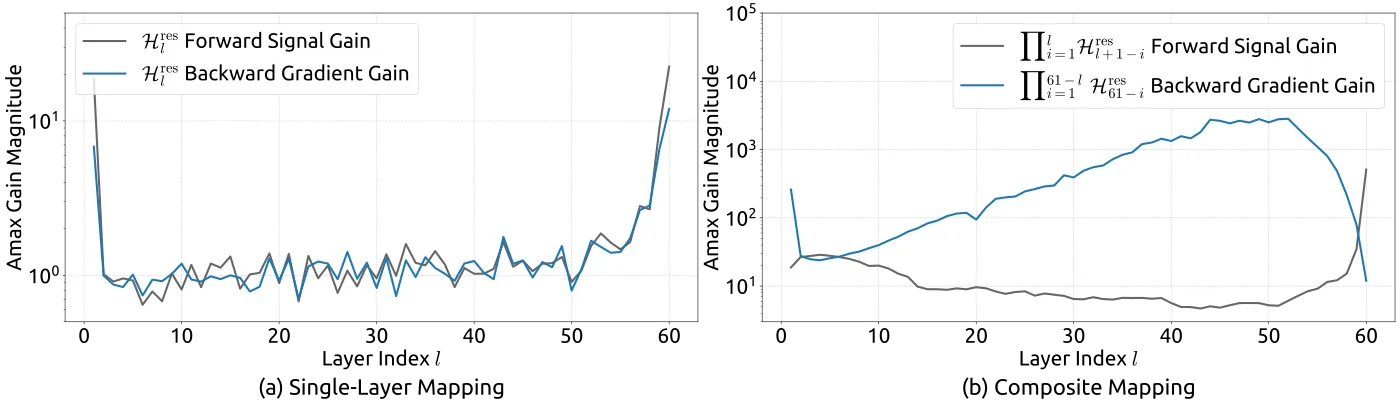
第一张图解释了 hc_mult 这个概念的来源:主干从 1 条变成 n 条,hc_attn_fn 算出的 24(即 (2+m) × m)维混合输出正是图中三个映射的组合。第二张图给出了把这件事原样搬进推理引擎的风险——复合映射(多层映射相乘)的增益随深度偏离 1,这正是 mHC 要把 comb_res_mix 投影回双随机流形的原因。
真正的算法还剩下三块,篇幅都很大,需要各自展开:
- 注意力族:
mla_attn.py(11 KB 容器)、attn.py(46 KB 运行时,是目录里最大的文件)、compress.py、index_attn.py。这里要回答的是 MLA 的压缩 KV 在运行时怎么布局、稀疏索引器如何选出 Top-K 页、DFlash 的注意力变体与主模型差在哪。 - MoE 与 Engram:
moe.py、mlp.py(25 KB)、engram.py、engram_metadata.py、engram_parameters.py。要回答细粒度专家的分组 GEMM 怎么组织、共享专家为什么是 replicated、Engram 的哈希查表在推理时落在哪一步。 - mHC 残差主干与 YoCo:
hc.py、hc_blocks.py、mhc_ops.py、mhc_modeling.py、hc_lazy.py、yoco.py、cross_layer.py。这是三块里最抽象的一块,要回答多路 trunk 的 pre/post 混合如何用融合算子实现、懒数据如何跨 sub-layer 传递、YoCo 的截断边界如何与之协同。
下一篇讨论注意力族,重点回答三个问题:压缩 KV 在 mla_attn.py 里为什么分成”容器 + 运行时”两份、稀疏索引器的 K 为什么需要跨层共享、以及 attn.py 里 46 KB 的代码到底在组织哪些分支。
参考资料
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



