


DeepInfer 源码拆解(三十二):norm、RoPE、量化与写 KV 合成一个 kernel——fused_transform 的五段流水与槽位分发
从第三十一篇接上:前向跑通了,写 KV 的那几行还没算过账
前面几篇里,主模型的一次前向已经能从头走到尾:三十一篇拆了 DeepseekModel 如何把 HF 参数壳装成四层对象、forward 主循环里各段怎么排队、最后 CausalLMForwardOutput 如何交给采样器。但那篇在讲子层的五件事时,对「写 KV」这一件只给了一句概括——注意力算完之后,K 要被归一化、加旋转位置编码、量化、再按 slot_mapping 散写进分页缓存。这几件事在 vLLM、SGLang 里通常是四五个独立的算子,各自一次 launch、各自若干次显存往返;而在 DeepInfer 里,它们被收束成了一个函数:
fused_norm_rope_hadamard_cast_store_kvcache(...)本篇就沿着这一个 kernel 走一遍,把它拆成五段:RMSNorm → RoPE → 可选的 Hadamard → 分通道量化 → 按槽位写分页 KV。每段都要回答三个问题:它原本是一整份什么工作、被融进来之后省掉了什么、以及为了能融,代码对上游提出了什么硬性要求。
需要说明的是,站内已经有两篇从不同角度碰到过这个算子:Linear、RMSNorm 与 RoPE 把 RoPE 当作「参数容器」讲,重点在 cos/sin 表怎么按行预计算、conjugate 逆旋转怎么用;KV Cache 的写入与取用 讲了分页 KV 的 slot 映射与装载计划。本篇不重复这两处的推导,而是补上中间缺的那一环:这三件事为什么能在同一个 kernel 里完成,融合的边界画在哪里,每一段内部又是怎么排布线程和数据的。 顺带补齐两处此前没有展开的东西:分页缓存里「数据段与 scale 段」的物理布局如何被反推出格式(cache_common.py),以及 indexer 那条路径上独有的「先存再返回中间量」模式。
先把它放在整机里的位置看一眼。官方部署文档给出的推理系统总览把服务拆成视觉编码器(VE)、Prefill 实例与 Decode 实例三类:Prefill 负责把 prompt 编码并写出可复用的块级 KV 前缀,Decode 每步只处理新生成的少量 token,KV 以分页块的形式在显存、主机共享内存与远端存储之间流动。本 kernel 落在两端的 GPU 上——Prefill 和 Decode 每层都要把本步算出的 K 写进分页缓存,Decode 侧每步的写入量最小,因此对每次写 KV 的 kernel 数最敏感。
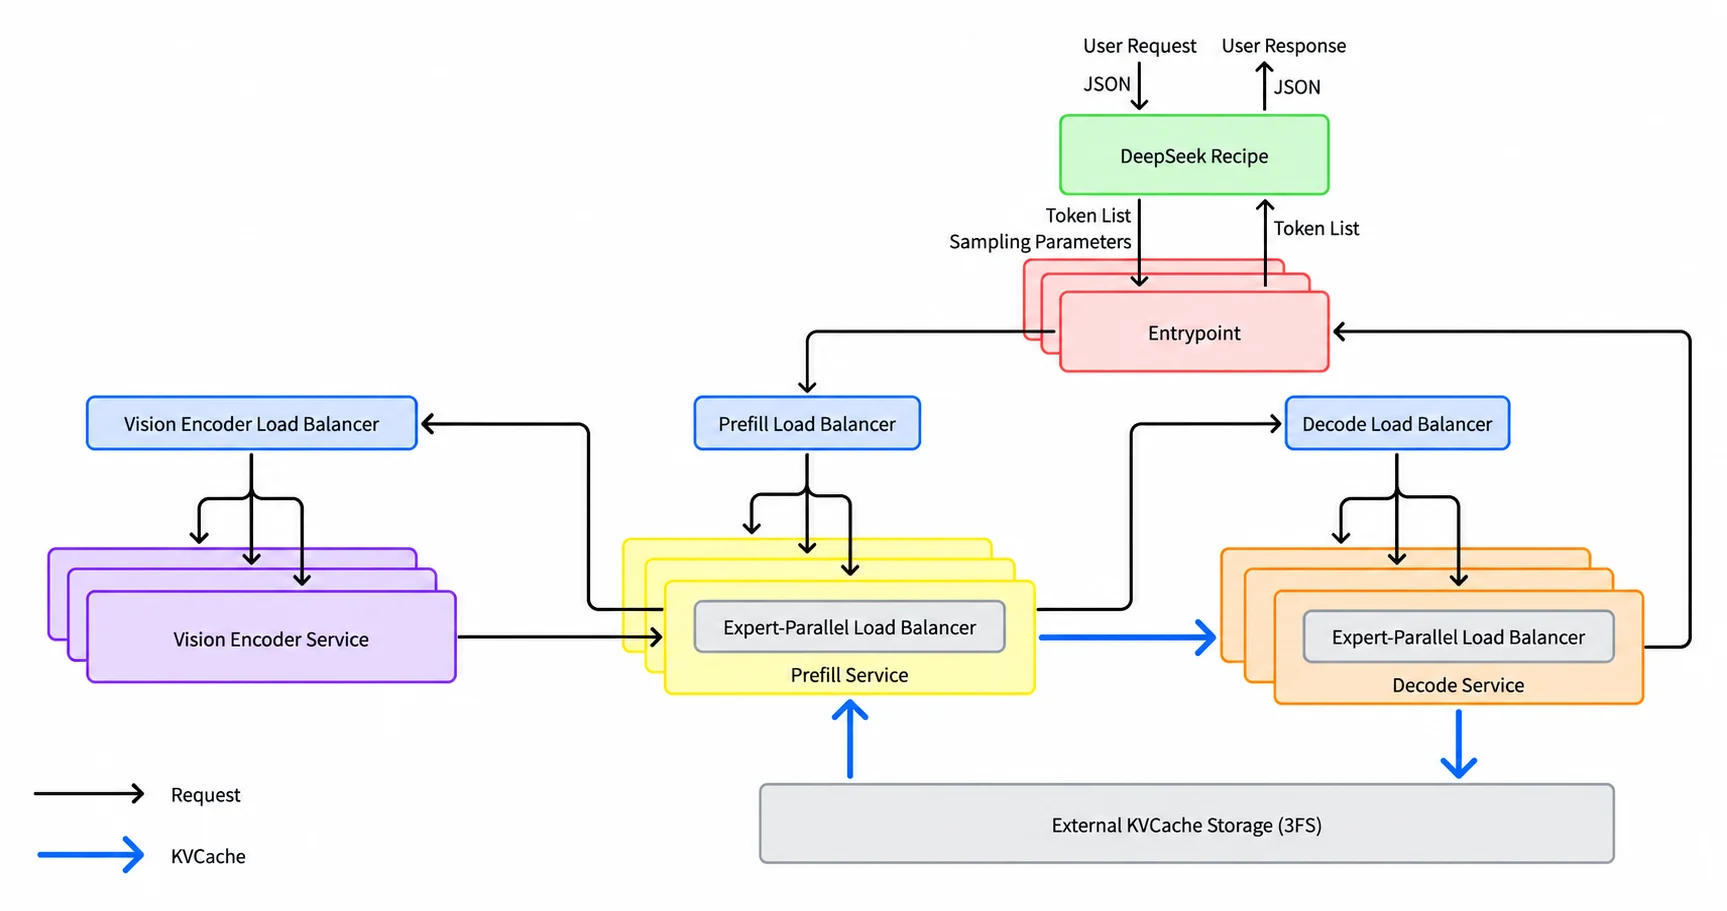
(图源:DeepInfer 仓库 doc/inference_deployment_qa.md 与 doc/images/architecture_overview.png)
先把一次「写 KV」摊开:不融时要发生什么
在拆融合之前,先算一笔账。假设一步 decode 有 个请求、每个请求一个 token,KV 头的维度是 512(DeepSeek 系 MLA 的 qk_head_dim),缓存里的元素精度是 FP8。按传统写法,写入路径大致是:
- 归一化:对
kv做一次 RMSNorm。读一遍 bf16( 字节),写回一遍 bf16。 - RoPE:读
kv、读 cos/sin 表、改写尾部 64 维,写回 bf16。读写量同上。 - 量化:按 32 个元素一组求 amax,算出 scale,再把值转成 FP8 并把 scale 写进 scale 段。读一遍 bf16,写一份 FP8 值 + 一份 scale。
- 散写缓存:把 FP8 值与 scale 按
slot_mapping拼到各自的页与槽位上。这一份可以和第 3 步合并,但它本身也是一次 kernel。
四步下来,中间那份 bf16 张量要被读两次、写两次。对 decode 这个场景来说,每步的总 token 数只有 (再乘以投机解码的验证长度),一个 512 维、每个请求一行的张量并不大——真正的成本不在算术,而在每次 kernel 启动的固定开销和这些多余的显存往返。DeepInfer 的取舍是:既然这四步的每一行数据彼此独立(都只依赖本行自身的值和该行的位置),那就没必要让它在显存里落地两次。
融合之后,上面四段变成一段:每行数据从全局内存读进寄存器一次,在寄存器/shared memory 里依次完成归一化、旋转、量化,最后一次性写进分页缓存。中间结果全程不落回全局内存——除了某些调用点明确要求返回中间量(后文会看到 indexer K 的「先存再返回」正是这种例外)。
这听起来像是一个顺理成章的优化,但把它真正写成一个大 kernel 会遇到不少细节问题,下一篇的结构就是围着这些问题展开:
- 归一化的归约要跨多少个线程?一行的 512 个元素怎么分给一个 warp 或多行?
- RoPE 需要交换同一行内成对的元素,这意味着线程之间要通信;而缓存里「数据段 | scale 段」的布局又要求写出去的行是连续的一块。两者对「线程持有哪一段数据」的要求是冲突的,怎么调和?
- FP8/FP4 的 scale 要按「每组 16 或 32 个元素」求 amax,一个组的元素可能分散在不同线程手里,谁来归约、结果怎么汇集?
slot_mapping里可能出现-1(无效槽位)或者越界值,写缓存时怎么不越界、又不拖慢有效行的写入?- 同一套接口要同时服务主 KV(一个 head、512 维)、Q 向量(64 个头、512 维)、indexer K/Q(128 维)、压缩 KV、SWA 前向里的 CP 中间量——这些调用点组合完全不同的阶段与输出目标,如果每处都写一份 kernel,维护成本会失控。
函数签名就是一张组合表
打开 deepinfer/model_executor/layers/tilelang_ops/fused_transform.py,主入口的签名很能说明问题:
def fused_norm_rope_hadamard_cast_store_kvcache( x: torch.Tensor, norm_args: NormArgs | None = None, rope_args: RopeArgs | None = None, hadamard_args: HadamardArgs | None = None, cast_args: CastArgs | None = None, out_args: torch.Tensor | ContiguousOutArgs | KVCacheOutArgs | None = None,) -> torch.Tensor | tuple[torch.Tensor, torch.Tensor] | None:除输入 x 外,五个可选参数各对应一段阶段或一个输出目的地,传 None 即关闭。这种「用 None 拼出子流水线」的设计有一个直接好处:调用方读代码时能一眼看出某个调用点做了哪几段,不需要去 kernel 里猜。把仓库里所有调用点列出来,组合关系是清楚的:
| 调用位置 | norm | rope | hadamard | cast | 输出目标 | 维度 |
|---|---|---|---|---|---|---|
attn.py Q 预处理 | Q 归一化(可选) | 有,尾部 64 维 | 无 | 无 | 返回 bf16 | 多 head × 512 |
attn.py SWA 写入 | 有 | 有 | 无 | e4m3 / ue8m0 | KVCacheOutArgs(主缓存) | 1 head × 512 |
attn.py DFlash main cache | 有(CP 时无) | 有 | 无 | e4m3 / ue8m0 | 主缓存,槽位来自 slot_mapping_store_swa | 1 × 512 |
attn.py DFlash 草稿 KV | 有 | 有 | 无 | e4m3 / ue8m0 | 主缓存,槽位来自 dflash_newx_slot_mapping_store | 1 × 512 |
compress.py 压缩 KV | 有 | 有 | 无 | CastArgs.from_cache_format | index 缓存 + 可选返回 norm 阶段中间量 | 1 × 128 |
index_attn.py indexer K | 有 | 有 | 无 | 同上 | index 缓存 | 1 × 128 |
index_attn.py indexer Q | 无 | 有 | 无 | 同上 | 返回 (quantized, sf) 元组 | 多 head × 128 |
这份 KV 到底长什么样:MLA 的 K/V 是同一份潜在向量
要理解这个 kernel 为什么能同时服务「主 KV」与「index KV」,得先回到 DeepSeek 的 MLA(Multi-head Latent Attention)。DeepSeek-V2 于 2024 年提出的 MLA 把 K 与 V 压缩成一份共享的低秩潜在向量,缓存里每个 token 只存这一份压缩后的 KV,而不是像标准多头注意力那样为 K、V 各存一份完整的 head 维度 —— 部署口径下 KV 缓存下降超过 90%。
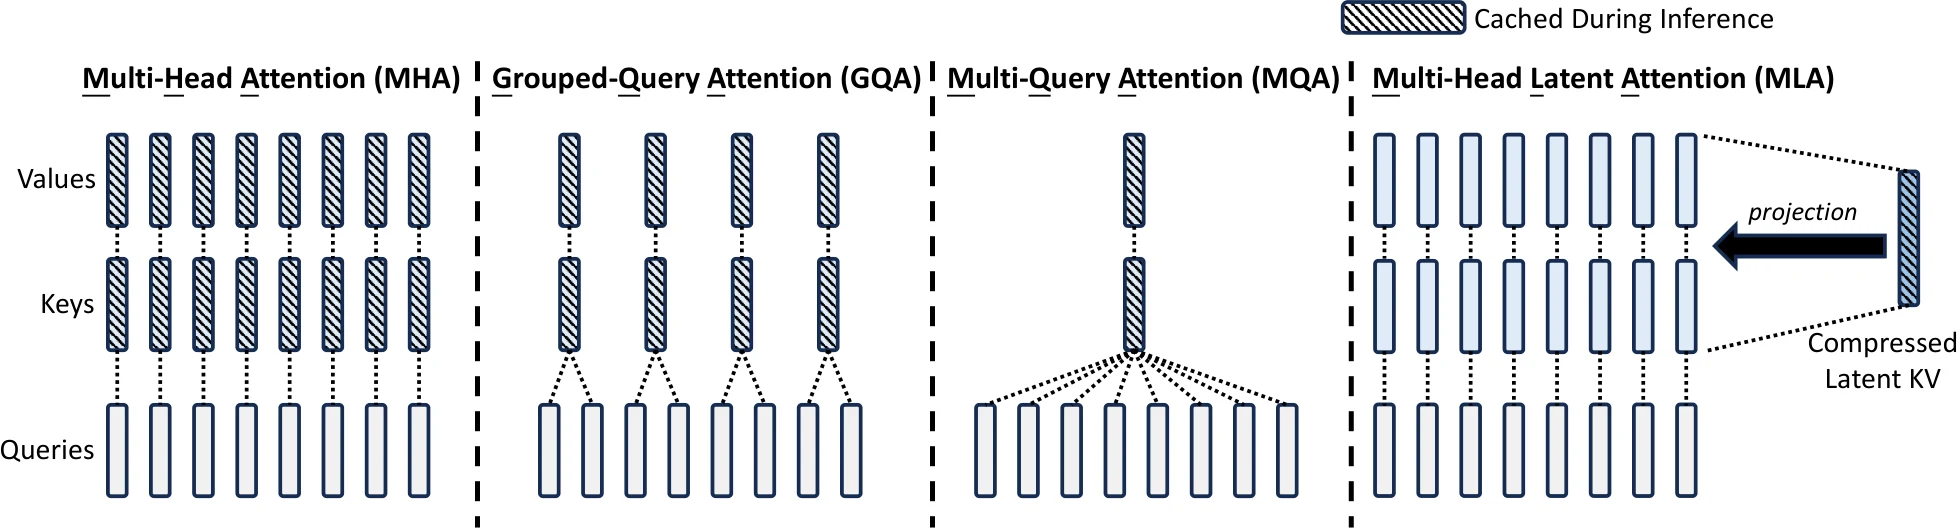
(图源:DeepSeek-V2 论文,arXiv:2405.04434)
这张图里的两处关键结构,直接决定了本 kernel 的形态:
- 被缓存的那份「潜在向量」,每个 token 只有一行。这意味着写缓存的路径天然是「一个 token 一行、一行一个 head」,上一节的
num_heads == 1断言正是这个结构在接口上的投影;而同一个 kernel 服务 Q 预处理时,输入变成「一个 token 多个 head」,它就不写缓存、只返回 bf16。 - 还原 K 与 V 的上投影发生在读取侧(注意力 kernel 内),而不是写入侧。写入侧只需要把「潜在向量」归一化、旋转、量化、落下——这恰好就是本 kernel 四段的来源。K/V 上投影带来的额外算术如果放进写入侧,会变成每层每 token 多几次矩阵乘,没有任何收益,因为读取侧无论如何都要做。
表里的形态切换
这张表里藏着几次形态切换,每一种都对应签名里的一项:
- 输出目标从「返回张量」变成「写缓存」:
out_args是KVCacheOutArgs时,结果直接散写进分页缓存,函数返回None(或可选的 bf16 中间量)。这个分支要求num_heads == 1——因为缓存里每个 token 一行,而多 head 的输入是「一个 token 多行」,必须多对一才对得上。 - 精度从 bf16 变成「量化值 + scale」:
cast_args且不写缓存时,返回一个二元组,值可能是 FP8 也可能是打包的 FP4。 - 需要中间态:
KVCacheOutArgs.out不为空时,函数除了写缓存还能顺带返回某个阶段的 bf16。out_stage取"norm"、"transform"或"cast_back",分别对应归一化后、旋转/变换后、量化再反量化回来三种状态。这个设计给了一条「带检查点的融合」路径:需要中间结果的调用点(后文会看到压缩 KV 为什么要 norm 之后的 latent)不用为此另跑一遍。
五个参数对象分别约束什么
每个参数对象都不是随便包的,它们在构造时就把「哪些组合合法」写死在断言里。按 kernel 的校验顺序读:
if do_rope: assert rotary_dim > 0 and rotary_dim <= head_dim and rotary_dim % 2 == 0 assert rope_offset + rotary_dim == head_dimif do_hadamard: assert head_dim == 128RoPE 只作用于 head 的尾部连续一段:offset 是起点,默认取 head_dim - rotary_dim,断言保证「起点 + 长度 = 结尾」。对 DeepSeek 的 MLA 来说,每个 head 由 qk_nope_head_dim 个不旋转的维和 qk_rope_head_dim 个旋转的维拼成,所以 offset 恰好落在 qk_head_dim - qk_rope_head_dim,见上一张表里所有 attn 调用点。Hadamard 则被限制在 head_dim == 128,原因在第三段再讲——蝶形运算要求每一行恰好是一条完整的 warp 级归约规模。
量化这一段有三组互斥规则:
if do_cast: assert sf_format in ("ue8m0", "e4m3", "fp32") assert num_per_channels in (16, 32, 64, 128) and head_dim % num_per_channels == 0 assert sf_format != "ue8m0" or round_sf assert sf_format != "e4m3" or not round_sf if cast_fmt == "e2m1": assert (num_per_channels, round_sf, sf_format) in ((16, False, "e4m3"), (32, True, "ue8m0"))- FP8(e4m3):分组可以是 16/32/64/128;scale 格式可以是
ue8m0(2 的幂)或fp32(任意实数)。 - FP4(e2m1):只有两种组合被支持——每 16 个元素一组、scale 存成 e4m3(即 NVFP4 系的「每 16 元素一个 FP8 scale」),或者每 32 个元素一组、scale 是 UE8M0(MXFP4 系)。这两套正好是主流 FP4 存储格式的两族。
round_sf与sf_format的绑定:UE8M0 只能配「2 的幂取整」的 scale(它本身只能表达 2 的幂),e4m3 只能配「不取整」的连续 scale。这条断言把一个很容易混淆的点固化下来:scale 的数据类型决定了它能不能承载非 2 的幂的数值。
写缓存分支的约束更紧:
assert num_heads == 1 and do_castif not cache_layout.do_cast: assert head_dim == 128 assert sf_format == cache_layout.sf_formatelse: assert (head_dim, num_per_channels, round_sf, sf_format) == ( 512, cache_layout.elements_per_sf, cache_layout.sf_format != "e4m3", cache_layout.sf_format, )「写缓存必须量化」是设计决定而不是限制——主缓存与 index 缓存本来就是量化存储的,bf16 缓存格式 do_cast=False 的存在只是为了兼容读取侧,写入路径不接受它。而主缓存只有 512 维、index 缓存只有 128 维这两条,加上上面 Hadamard 只在 128 维可用,把「哪条路径能用什么旋钮」限定得很死。
第一段:RMSNorm——一行的归约怎么摊到线程上
这段在算什么
RMSNorm 对每一行(一个 token 的一个 head)计算:
其中 是 head_dim(512 或 128), 是可学习的逐元素权重, 是防除零的常数。计算上要求先做一次全行归约(平方和),再用归约结果缩放每个元素。融合的第一段就要解决:这条归约的通信范围有多大。
按「每线程持有多大一块」反推线程分工
kernel 里没有把线程数写死,而是按 head_dim 推导,注释写明要考虑四个目标:最大化向量宽度、最小化补零、最大化占用率、最大化每线程处理的元素数。核心的几行:
threads = 128max_elements_per_thread = 16 if small_batch else 32alignment = max(tilelang.next_power_of_2(ceil_div(head_dim, 16)), threads)blk_d = min(tilelang.next_power_of_2(head_dim), align(head_dim, alignment))max_vec_size = math.gcd(32 // T.bfloat16.bytes, head_dim)max_vec_size是「一个 32 字节的向量事务能装下多少 bf16」,即 16 个元素。这是向量化读取的上限。blk_d是每个 program 一次处理的行宽(向上取到 2 的幂,但不无限放大,因为超过head_dim的部分要补零)。对 512 维,ceil_div(512,16)=32取成32,alignment=max(32,128)=128,align(512,128)=512,最终blk_d = min(512, 512)=512;对 128 维,blk_d = 128。换句话说,当前支持的两个维度都恰好让blk_d == head_dim,尾部补零只在理论上的非 2 幂维度出现。chunks_per_row = blk_d // thread_vec_size决定「一行的head_dim个元素要分给多少个线程」:512 维是 32 个 16 元素块,128 维是 8 个块。
再乘上 blk_m(一个 program 同时处理的行数,由 max_elements_per_thread * threads // blk_d 推得),512 维时 blk_m=8:8 行 × 32 块 = 256 个块,正好分给 128 个线程各 2 块,所以每个线程持有 32 个元素(来自两行),而每一行由一个 warp(32 线程)完整覆盖。128 维时 blk_m=32:32 行 × 8 块 = 256 个块,128 个线程各 2 块,每个 warp 覆盖 4 行。两种 shape 的 norm_threads_per_row 分别是 32 和 8,都落在单个 warp 内:
norm_warps_per_row == 1:当前两个维度的情形,每个线程先算自己那块的平方和,再在 warp 内用shfl_xor做蝶形归约。norm_warps_per_row > 1:一行跨多个 warp(理论情形),各 warp 的部分和先写进 shared memory,再汇总。
for r in T.unroll(norm_warp_round): partial = partial + T.shfl_xor(partial, 1 << (norm_warp_round - 1 - r))rstd_local[local_norm_row] = partial...rstd_local[local_norm_row] = T.rsqrt(rstd_local[local_norm_row] / head_dim + norm_eps)norm_warp_round = log2(min(norm_threads_per_row, 32))。归约只在一个 warp 内完成,前提是同一行的元素被分到同一个 warp 的连续 lane 上——这一点由 chunks_per_row <= warp_size 与 (blk_m * chunks_per_row) % threads == 0 两条断言保证。当一行需要超过一个 warp 时,代码会先把各 warp 的部分和写进 shared memory,再由每个 warp 的 lane 0 读出求和:
if norm_warps_per_row > 1: ... norm_partial_shared[local_row, w] = ......total = ...for w in T.unroll(norm_warps_per_row): total = total + norm_partial_local[w]rstd_local[local_norm_row] = total这里的同步由 program 内部其余同步点承担。代码注释特别强调 Keep bitwise aligned with the fragment version:两条归约路径必须产生逐位相同的结果,否则同一次前向在不同 shape 下会有微小的数值差异,进而破坏 batch-invariant 的承诺。这也是 rsqrt 只做一次、平方和按固定顺序两两相加的原因。
为什么是「先算平方和,再统一缩放」
代码先把整行的平方和算完再对所有元素乘缩放,而不是边读边乘。原因是 scale 依赖整行;如果按块读进来、立刻乘,就只能等归约结果回来再重读一遍——这在 warp 里可以靠寄存器缓住,但实现上要保证「同一行的所有块都还在这批线程的寄存器里」。代码用 x_fp32_local(每线程 elements_per_thread 个 fp32)把整块数据缓存住:
for chunk in T.unroll(chunks_per_thread): for k in T.vectorized(thread_vec_size): x_fp32_local[idx] = T.cast(x_bf16_local[idx], T.float32) norm_sq_local[...] = x_fp32_local[idx] * x_fp32_local[idx]bf16 输入先转 fp32 再平方,是因为 bf16 只有 8 位尾数,直接乘平方会丢精度,而归约结果要参与后面所有元素的缩放。转成 fp32 后,归约用 fp32、缩放用 fp32、最后才 T.cast(..., T.bfloat16) 写回 bf16——这与上一篇里 DropoutAddRMSNorm 的 fp32 累加规范一致。
第二段:RoPE——块内交换与缓存连续性的冲突
交换对:NEOX 与交错两种排布
RoPE 对尾部 rotary_dim 个维度按位置 旋转。记第 对元素为 ,第 个频率的角为 ,标准公式是:
关键在于「 与 在下标上相隔多远」有两种约定:
- NEOX 排布:前半段与后半段配对, 在下标 , 在下标 。
- 交错排布(GPT-J 风格,代码里
is_neox=False):相邻两维配对, 在下标 , 在下标 。
if is_neox: x0_idx = j x1_idx = half_rotary_dim + jelse: x0_idx = j * 2 x1_idx = j * 2 + 1两种排布下,一对元素都可能被不同的线程持有。NEOX 尤其明显: 与 相隔一整段,在「一行分给一个 warp」时落在不同的 lane 上。所以 RoPE 必然要在线程之间搬运数据,这就是为什么融合里必须引入一块 shared memory。
用 shared memory 做「行内转置」
代码的写法是把尾部旋转段从寄存器搬到 shared memory rope_shared,在 shared 里按对的布局读取、计算、写回,再搬回寄存器:
寄存器(本线程块) --写--> rope_shared[row, col - offset] --按对读+旋转--> 写回 rope_shared--读--> 寄存器(本线程块)之所以用 shared memory 而不是直接 shfl,是因为一对元素的 lane 距离不固定(NEOX 是 16 个 lane,交错是 0/1 个 chunk 的偏移),统一用一个可寻址的暂存区最省事。代价是两次额外的往返,但它发生在片上,而不是全局内存里。
shared memory 的排布有一个细节:rope_shared_dim = rotary_dim + (2 * chunks_per_row - rotary_dim) % (2 * warp_size)。这是错开行首的 bank 冲突处理——每行的起点按「chunk 数 × 2」个元素错开,使得相邻行写入时落在不同的 bank 上。注释直接写了理由:Stagger row banks。如果 chunks_per_row 恰好让错开量为 0(例如 64 个块与 warp 宽度成倍数),这项就没效果,但这是代价不高的启发式。
只同步 warp:为什么可以
共享内存在一般 kernel 里需要 __syncthreads() 级别的同步,而这个 kernel 在 RoPE 段只用了 T.sync_warp():
# rope_layout preserves each row's input warp, so warp-level synchronization is sufficient.T.sync_warp()注释里的 rope_layout 是一个 T.Fragment:
rope_layout = T.Fragment( (blk_m, rope_pairs), forward_thread_fn=lambda i, j: (i * chunks_per_row + j % chunks_per_row) % threads,)它规定「行 的第 对元素由哪个线程处理」,取模运算保证同一行的所有块落在同一个 warp 内,而且与写入 shared 时使用的线程映射一致:写进 shared 的线程、读出计算的线程、再把结果读回的线程是同一批人。于是行内通信的闭包完全在一个 warp 里,sync_warp 就够了。前提断言写得很清楚:
assert chunks_per_row <= warp_size and warp_size % chunks_per_row == 0assert (blk_m * chunks_per_row) % threads == 0循环读 cos/sin 表
RoPE 要在每行读取 cos[position] 与 sin[position]。decode 时每行对应一个位置,表是 [max_position, rotary_dim] 的 fp32。当 num_heads 很大(比如 Q 预处理里有 64 个头),同一个 token 的 64 行共享同一份 cos/sin;代码在 do_loop 模式下先把这次 program 会用到的那几行 cos/sin 预取进 shared:
for cache_row, j in T.Parallel(rope_cache_rows, half_rotary_dim): segment_row = bx * blk_m * head_blocks_per_program + cache_row * rope_rows_per_cache ... cos_shared[cache_row, j] = cos[position, j] sin_shared[cache_row, j] = sin[position, j]T.sync_threads()这里用 T.sync_threads()(不是 warp 级),因为预取时读 cos_shared 的线程与写入它的线程未必在同一 warp。rope_rows_per_cache = gcd(blk_m, num_heads) 是「一个 head_block 里出现了多少个共享同一位置的连续行」,用它把表行数压到最少。do_loop 只在 num_heads % blk_m == 0 and num_heads > blk_m 时开启——也就是只有「多 head 且能被整块整除」的场景(如 Q 的 64 个 head)才值得预取。
conjugate:逆旋转在同一段里
conjugate=True 时交换的是符号:
if conjugate: rope_shared[i, x0_idx] = T.cast(T.ieee_fmaf(x0, cos_val, x1 * sin_val), T.bfloat16) rope_shared[i, x1_idx] = T.cast(T.ieee_fmaf(x0, -sin_val, x1 * cos_val), T.bfloat16)else: rope_shared[i, x0_idx] = T.cast(T.ieee_fmaf(x0, cos_val, -(x1 * sin_val)), T.bfloat16) rope_shared[i, x1_idx] = T.cast(T.ieee_fmaf(x0, sin_val, x1 * cos_val), T.bfloat16)两处都用 T.ieee_fmaf 而不是先乘后加。IEEE 精度的 FMA 不给编译器把乘加拆开做重关联的自由,从而保证同一份代码在 CUDA 与 Ascend 两侧、以及不同编译选项下逐位一致。这与上一段「两条归约路径必须逐位对齐」是同一个主题:融合把多个数值步骤压进一个 kernel,任何一处引入非确定性的浮点差异,都会让「同一输入、同一 batch 组成 ⇒ 同一输出」的承诺失效。
conjugate 在 MLA 的 context 逆旋转里有用:注意力输出的尾部 64 维带着与 K 相同的位置旋转,为了让 O 投影看到原始基下的 V,需要先反旋一次。上一篇 Linear、RMSNorm 与 RoPE 已经把这层动机讲透,此处不再展开。
第三段(可选):Hadamard——为什么只允许 128 维
Hadamard 变换 是一个正交矩阵(未归一化的版本满足 ),作用在 head 的 128 维上一次「混洗」。在量化场景里它的作用是抹平离群值:量化按组求 amax,如果某一组里有几个特别大的值,scale 就被这几个值顶高,其余值的有效位数被吃掉;正交混合后每个元素都是全部元素的线性组合,离群被摊到所有维上,组内 amax 变小、量化误差下降。旋转之后每个元素的量级被拉平,再按组量化时 scale 更小、有效位更多。
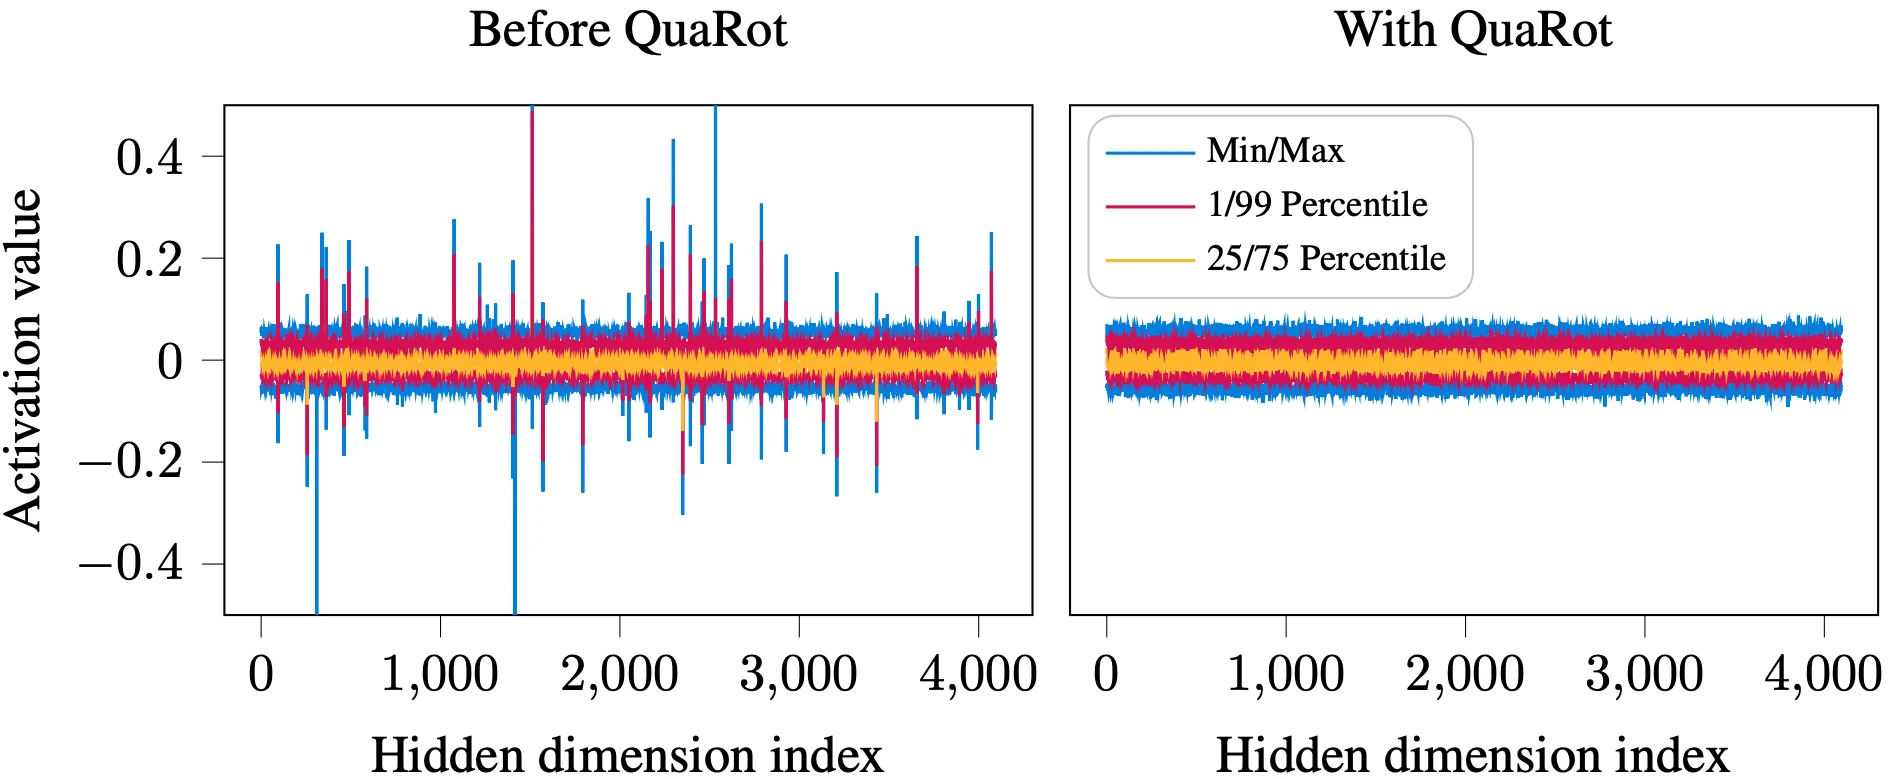
(图源:QuaRot 论文,arXiv:2404.00456。图中针对权重的旋转发生在离线阶段;本 kernel 里同一思想被用于推理期的激活/KV 量化,旋转在写入缓存前完成。)
代码里分两步实现,都是在寄存器里用蝶形运算(butterfly)完成:
# 线程内:每线程持有的 thread_vec_size 个元素之间做局部 Hadamardfor r in T.unroll(int(math.log2(thread_vec_size))): chunk_size = 1 << (r + 1) for butterfly in T.serial(thread_vec_size // chunk_size): for k in T.serial(chunk_size // 2): u, v = x_fp32_local[idx], x_fp32_local[idx + chunk_size // 2] x_fp32_local[idx] = u + v x_fp32_local[idx + chunk_size // 2] = u - v
# 跨 lane:用 shfl_xor 做剩下的 log2(head_dim / thread_vec_size) 级for r in T.unroll(int(math.log2(hadamard_threads_per_row))): sign = (tx >> r) & 1 x_peer_local[k] = T.shfl_xor(x_fp32_local[idx], 1 << r) x_fp32_local[idx] = T.Select( sign == 0, x_fp32_local[idx] + x_peer_local[k], x_peer_local[k] - x_fp32_local[idx], )hadamard_threads_per_row = head_dim // thread_vec_size。跨 lane 部分用 sign 判断自己是被加的一方还是被减的一方,保证 的符号模式(后一半减前一半)正确。最后的 hadamard_scale 由调用方给定:HadamardArgs 的字段默认是 1.0,测试矩阵传 让变换正交、输入输出能量一致。这两种取值对应两种语义——前者是「只做混洗、不归一化」,后者是「正交旋转」,量化前用哪一种取决于是否希望保持数值量级。
跨 lane 的蝶形要求一行恰好被一个 warp 的连续 lane 覆盖。head_dim == 128 时,thread_vec_size 为 16,hadamard_threads_per_row = 8,一个 warp(32 lane)可以覆盖 4 行,shfl_xor 的偏移不超过 4,行内闭包成立。如果 512 维也用同样的方法,一行要 32 个 lane——也能放进一个 warp,但那样 64 个头就只能串成一个 warp 处理一行,其它 warp 闲置,且和上面「多行并行」的调度冲突。因此 kernel 直接把 Hadamard 限制在 128 维。
需要说明的是,本篇列出的七个生产调用点都没有传 hadamard_args:包括 indexer K 与 Q 在内,走的都是「norm → RoPE → cast」这条不含旋转的路径。Hadamard 段目前由测试矩阵覆盖(FusedTransformCase(do_hadamard=True) 的组合,包括与 FP4/FP8 index 格式、fp32 scale 的搭配),接口保留它是为了在需要「靠旋转压低离群、换取更粗 scale」的格式或层上直接打开,而不必再写一个变体 kernel。这一点在读代码时容易误判:参数存在不等于生产路径启用,判断依据只能是调用点。
第四段:分通道量化——从 amax 到 UE8M0 字节
分组与并行归约
量化按 num_per_channels(16/32/64/128)一组做 per-group 对称量化:
其中正则是 FP8 e4m3 的最大有限值(448)或 FP4 e2m1 的最大值(6)。AMAX_MARGIN 是一个极小的下界,防止整组为零时除零。
代码先做 amax 归约。一个组的元素可能跨多个线程,所以归约分两级:线程内先求自己的 amax,再在同一位置的多个线程之间用 shfl_xor 做 warp 归约;若一组跨多个 warp,则部分结果落到 shared:
partial_float = T.cast(T.max(pair_max_local[0], pair_max_local[1]), T.float32)for r in T.unroll(int(math.log2(quant_warp_width))): partial_float = T.max(partial_float, T.shfl_xor(partial_float, 1 << r))scale_f32_local[local_group] = partial_float注意 pair_max_local 是 2 个 bf16 槽位:一个线程一次处理 16 个元素,把它拆成奇偶两个流各自 max,最后合并。这样向量化读取后可以直接在 bf16 域内比较(组内最大值的精度要求低于归约),再把结果转 fp32 参与 warp 归约。
UE8M0:只买 2 的幂的 scale
UE8M0 是一个 8 位指数、0 位尾数的格式——它的值只能是 。用这种 scale 量化,等于把每个组的缩放限制在「最近的 2 的幂」。实现里最关键的一行:
exp_scale = -ue8m0_exp_scale(amax * (1.0 / finfo_max))其中
def ue8m0_exp_scale(scale): scale_bits = T.reinterpret("uint32", scale) return -T.reinterpret("int32", ((scale_bits - 1) >> 23) + 1 - 127)这行位运算做的事:把 fp32 的 的指数部分取出来,并且向上取整到 2 的幂(减 1 再右移是「floor(log2 s) 除非 s 恰是 2 的幂,否则取 ceil」)。返回的 exp_scale 是「量化乘子 的指数」,所以 dequant 用的 scale 是 ,恰好是「不小于 amax/max 的最小 2 的幂」——这样量化不会溢出,代价是最多 2 倍的精度损失。UE8M0 的存储字节就是 exp_scale + 127,一个字节一个组。
对量化乘子,代码没有用 exp2 计算,而是直接造了一个 bf16:
scale_bf16_local[local_group] = T.reinterpret(T.cast((-exp_scale + 127) << 7, T.uint16), T.bfloat16)bf16 由 1 符号 + 8 指数 + 7 尾数组成,(e+127) << 7 恰好把指数摆到正确的位置、尾数置零,得到的正是 。这一步把「求一个 2 的幂」变成一条移位指令,避免了 exp2 的延迟与精度问题。
三个分支的对比
代码里按 sf_format 分三条路:
| scale 格式 | 乘子计算 | 相乘精度 | 适用缓存 |
|---|---|---|---|
ue8m0 | 不小于 amax/max 的最小 2 的幂(位运算),bf16 直接相乘 | bf16 × bf16 | V41 主 KV(e4m3)、MXFP8 index KV(e4m3) |
e4m3 | amax / max 后饱和到 e4m3 范围,乘子为 1/s | fp32 相乘 | V41 FP4 主缓存(每 16 元素一个 FP8 scale) |
fp32 | max / amax | fp32 相乘 | 旧版 V4 index KV(每 128 元素一个 fp32 scale) |
ue8m0 分支用 bf16 相乘是有意为之:乘子本身是 2 的幂,bf16 能精确表示;而「造一个 bf16 的 2 的幂」只需要一条位运算(上一段的 (e+127) << 7),乘法本身又能在 bf16 域直接做,整条量化的关键路径上没有 exp2、没有 fp32 转换。e4m3 分支的乘子不是 2 的幂,必须在 fp32 里算,否则丢精度后 amax 附近的元素会被量化到错误的档位。fp32 分支最慢但最准确,只在「scale 段预算宽松、精度优先」的旧格式上出现。
为什么选块状缩放而不是张量级缩放
DeepSeek-V3 于 2024 年底提出的 FP8 训练框架把 fp8 GEMM 写成「细粒度块状缩放 + 高精度累加」:权重按较小的块、激活按更大的块各自求 scale,部分和在 CUDA Core 里用 FP32 累加并周期性提升回高精度寄存器。训练侧需要这套口径,是因为 FP8 的尾数太短,长 K 维上整体一个 scale 会让误差在累加末端放大。
推理侧的 KV 量化把同一个思路换了一个切分方向:不是沿 GEMM 的输出块切部分和,而是沿每个 token 的 head 维度按 16/32/128 个元素一组求 scale。动机是同一个——局部统计出来的 scale 比全局 scale 更贴合实际数值分布,量化点的相对误差更小;代价是每组要多存一个 scale 字节。一个 512 维的 FP8 主缓存记录因此是 512 字节数据 + 20 字节 scale(每 32 元素一个 UE8M0 字节),bytes_per_token = 532,正是前面 stride_alignment 里那个 gcd(32, 532) = 4 的来源。
分组粒度也不是只有一种:V41 的 FP8 主缓存是每 32 元素一个 scale,FP4 主缓存是每 16 元素一个 FP8 scale(NVFP4 口径),旧版 V4 index 缓存则是每 128 元素一个 fp32 scale。粒度越细,scale 开销越大、但分布拟合越好——这三档正好覆盖了「省字节」到「保精度」的取舍。
压缩与写槽位:一次地址算术
量化完,最后一个动作是写。return_quant 时写到返回张量;store_cache 时按槽位写进分页缓存。写槽位前先把 slot_mapping 洗一遍:
if thread_in_cache_group == 0: slot = T.if_then_else(row < rows, slot_mapping[row], -1) slot = T.Select(slot < num_blocks * block_size, slot, -1)slot = T.shfl_sync(slot, 0, cache_slot_broadcast_width)三步:
row < rows之外的行(补零产生的 padding 行)不写,槽位置-1。- 越界值(
slot >= num_blocks * block_size,例如-1被当成无符号大数传进来,或调度器给了非法槽位)也置-1。 - 由组内 0 号线程读一次,然后广播给同组所有线程——同组线程写同一行,共用一个槽位,广播省掉了每个线程一次全局读。
之后 slot_block = slot // block_size、slot_offset = slot % block_size 完成从「逻辑槽位」到「页号 + 页内偏移」的翻译。
第五段:写进分页缓存——两种物理布局的反推
同一个 4D 张量,两种含义
分页 KV 缓存的公开形状是 [num_blocks, block_size, 1, bytes_per_token](uint8)。同样是这个形状,主缓存与 index 缓存的字节排布不一样:
- 主缓存(token-interleaved):每个 token 的一条记录是
[数据段 | scale 段],token 之间没有填充,records = cache[:, :, 0, :],然后data = records[..., :data_bytes]、sf = records[..., data_bytes:]。 - index 缓存(block-wide):一个 block 里先把所有 token 的数据段连续放、再把所有 token 的 scale 段连续放,
block_data = cache.view(num_blocks, block_size * bytes_per_token)。
if layout.token_interleaved: # V41 main/SWA: each record is [data | scale], with no token padding. records = kv_cache[:, :, 0, :] data = records[..., :data_bytes] sf_data = records[..., data_bytes:]else: # Index caches keep block-wide data/scale sections. block_data = kv_cache.view(num_blocks, block_size * layout.bytes_per_token) data = block_data[:, : block_size * data_bytes].view(num_blocks, block_size, data_bytes) sf_data = block_data[:, block_size * data_bytes :].view(num_blocks, block_size, layout.sf_bytes)为什么差异这么大?主缓存的读取 kernel(FlashMLA 系的 decode)是逐 token 取 K 的,让一个 token 的数据与它的 scale 在内存里相邻,gather 时一次向量化读就能拿到全部所需;index 缓存的读取是以大块 topk 候选为单位扫描的,按段组织能让同一段内的访问完全连续、便于大块搬运。两种布局服务两种访问模式,kernel 里用一个布尔量 token_interleaved 区分。
主缓存的偏移量怎么算
主缓存里每个 slot 写入时,数据段的地址是:
cache_quant_stride = ( stride_cache_sf_block * sf_element_scale * value_element_scale, stride_cache_quant, 1,)块步长从 scale 张量 的 block stride 推出来,经过两次单位换算:
数据段块步长(以值的元素数计) = scale 张量的块步长(以 scale 元素计) × sf_element_scale(一个 scale 元素占几字节) × value_element_scale(一个字节装几个值)sf_element_scale:UE8M0 与 e4m3 scale 都是 1 字节,fp32 是 4 字节。value_element_scale:FP8 一个字节一个值,乘 1;FP4 一个字节装两个值,乘 2。- 对 token-interleaved 的主缓存,scale 张量的块步长本身就以「每 token 记录(数据 + scale)」为单位计算,换算出字节数后再换算成值的元素数,刚好等于量化张量在该布局下的块步长(FP8 是 532 字节,FP4 的主缓存是 288 字节)。
- 对 index 缓存,数据段与 scale 段在 block 内分别连续,
stride_cache_quant是数据段的单行步长,stride_cache_sf_block主要用于块级对齐的校验与基址换算。
注释把为什么从 scale 张量推解释了:
Bind the physical block stride through cache_sf, whose element size islayout-dependent. Derive the value stride from that directly bound variable;expressions such as ``stride // 2`` cannot themselves be recovered as packed-APIarguments by TileLang.TileLang 的参数绑定机制要求 stride 以「实际传入张量的 stride」形式出现;如果直接给 stride // 2 这样的表达式,它无法回溯到某个实参的 stride,jit 时就无法把它当作 packed API 的参数处理。于是代码绕一步:从 scale 张量拿到块 stride,再乘以元素宽度得到数据段 stride。这是融合算子与普通 kernel 的差异——普通 kernel 里 stride/4 随便写,融合后要为多后端 + jit 参数化的约束让路。
对齐:保证「数据段」是连续的一块
stride_alignment 的计算也值得看:
return math.gcd(32, self.bytes_per_token) if self.token_interleaved else 32主缓存每个 token 的记录长度是 532 字节(512 字节数据 + 20 字节 scale),最大公约数是 4,所以块 stride 至少要 4 字节对齐;index 缓存按段组织,要求 32 字节对齐。上层还有一组更严的断言:
assert cache_quant.stride(1) % cache_layout.stride_alignment == 0assert cache_quant.stride(0) % 32 == 0kernel 内部再用 T.assume 把这两个对齐条件告诉编译器,从而选用向量化事务。前面第一篇里讲的「Linear 输出按 32 字节对齐」是同一个主题:写出去的行如果不对齐,向量化写就被拆成若干个标量写,融合的收益就没了。
调用点实况:同一段流水,七种用法
理论讲完,回到上文的组合表,逐一看几个最典型的调用点,说明为什么非融不可。
Q 预处理:只旋不写
attn.py 里 Q 的预处理调用只传了 norm_args(可选)与 rope_args,不传 cast_args、out_args:
result = fused_norm_rope_hadamard_cast_store_kvcache( q, norm_args=(NormArgs(self.q_b_norm.weight, ...) if self.use_q_b_norm else None), rope_args=RopeArgs( positions, self.rotary_emb.cos_sin_cache, self.qk_rope_head_dim, self.rotary_emb.is_neox_style, offset=self.qk_head_dim - self.qk_rope_head_dim, ),)这里 num_heads 是 64(MLA 的 head 数),head_dim 是 512。前面按四个目标推出来的 blk_m 对大 batch 是 8(32 × 128 / 512),64 能被它整除且远大于它,再加上不在 small_batch 分支,do_loop 条件成立:一个 program 连续处理 head_blocks_per_program = 64 / 8 = 8 个头块,cos/sin 表按位置预取进 shared。小 batch 时 max_elements_per_thread 降到 16,blk_m 变成 4,同时 do_loop 被 not small_batch 关掉——省下的 shared 预取开销比多出来的重复读更贵,这是融合 kernel 里典型的「按数据量切策略」。结果以 bf16 返回,直接送去注意力。这一路没有量化、没有写缓存,但它和写 KV 用的是同一个 kernel——这是接口统一的直接收益:Q 与 K 的旋转逻辑只写一份,测试矩阵一份覆盖两种 shape。
SWA 写入:写缓存 + 可选返回中间量
if use_cp: cast_args = CastArgs("e4m3", self.swa_cache_num_per_channels, round_sf=True, sf_format="ue8m0", cast_back=True) out_args = out # 一个 bf16 张量,接收量化再反量化的结果else: cast_args = CastArgs("e4m3", ..., round_sf=True, sf_format="ue8m0") out_args = KVCacheOutArgs(swa_cache, input_metadata.slot_mapping_store_swa)CP 开启时,K 要在各 rank 之间 all-gather(上一篇 上下文并行 CP 全链路 涉及过这一步)。为什么要先量化再反量化回 bf16?因为 all-gather 走的是通信缓冲,缓冲里的数据精度是写定的 bf16;如果不先在本地量化再反量回到与远端相同精度的 bf16,拼接后的结果与「先 all-gather 再整体量化」不一致——同一份数据,量化粒度可能不同,最终写进缓存的字节就不一样,这又破坏了「不同并行度下输出一致」。所以这里用 cast_back=True 让 kernel 在本地做一次「量化 → 反量化」的往返,输出 bf16 给通信层,代价是这份数据经过了有损压缩。非 CP 时则直接写缓存,不需要往返。
压缩 KV:先写缓存,再把 norm 后的 latent 拿回来
compress.py 的调用最特别:
fused_norm_rope_hadamard_cast_store_kvcache( kv_compressed, norm_args=NormArgs(self.norm.weight, ...), rope_args=..., cast_args=CastArgs.from_cache_format(cache_format), out_args=KVCacheOutArgs( kv_cache, input_metadata.slot_mapping_store_ca[self.ratio_key], out=pre_rope_kv, out_stage="norm", layout=cache_format, ),)out_stage="norm" 意味着:在写进缓存的同时,把 norm 之后、RoPE 之前的那个 bf16 张量拷贝到 pre_rope_kv。为什么要 norm 后的 latent?indexer 的 key 投影 KProject 的输入是「压缩后的 latent 在 norm 之后、RoPE 之前」——它自己还要做一次线性投影、再做 norm 和 RoPE。如果融合只写缓存不返回中间量,这条路径就得再重跑一遍 norm,白白多花一次全量读。
这条设计让 kernel 在流水中间开了一个「出口」:在计算路径上,norm 之后立刻 copy_cache_out("norm", work_3d),然后继续 RoPE、量化、写缓存。参考实现里这段代码很短:
copy_cache_out("norm", work_3d)if rope_args is not None: apply_rotary(work_3d[..., offset : offset + rotary_dim], ...)...copy_cache_out("transform", work_3d)out_stage 可以取 "transform"(旋转/Hadamard 之后)或 "cast_back"(量化再反量化后),对应三种中间态。这三个出口共享同一条流水,区别只是在哪一步多拷一份出来。
indexer Q:返回量化值本身
index_attn.py::_quantize_q 传 rope_args 与 cast_args,不传 out_args:
result = fused_norm_rope_hadamard_cast_store_kvcache( q_b, rope_args=RopeArgs(...), cast_args=CastArgs.from_cache_format(self.cache_format),)assert isinstance(result, tuple)result 是 (quantized, sf):Q 被量化成与 K 相同的 index 格式(FP4 或 MXFP8),然后交给稀疏注意力的打分 kernel。量化粒度与 scale 格式必须与 K 一致——两边都用 CastArgs.from_cache_format 从同一个 KVCacheFormat 派生,保证两边不会漂移。Hadamard 不在 KVCacheFormat 里,若某一侧启用旋转,另一侧必须由调用点显式传相同的 HadamardArgs,否则 Q 与 K 落在不同基上,点积失去意义。这也是把「格式」做成 KVCacheFormat 对象而不是散落的上百个参数的意义:它既是缓存文件的元数据,又是量化算子的配置,一处定义、两处引用。
一个 kernel 能不能替掉四五个:融合的代价和收益在哪
收益:一次 launch、一次往返、一次调度
从调用方看,融合带来的最直接变化是每次写 KV 只发一个 kernel。在 decode 这种每步几十到上千个 token 的场景里,GPU 的空闲常常发生在 kernel 之间的 gap 里;四个小 kernel 的串行会把 gap 累积成可观的启动开销。融合后,Q/K 的旋转、量化、写页全部在一个 grid 里完成,前一 kernel 的输出就是后一 kernel 的输入,没有「等待上一 kernel 全部完成再启动下一个」的 barrier。
第二个收益是中间张量不落地。不融时 bf16 中间结果会写回显存再读回,总量大约几 MB 到几十 MB(取决于 batch 与维度)。这个量级在 L2 里可以命中(kernel 里有一个 small_batch 判定:x.numel() * x.element_size() <= _L2_CACHE_SIZE,即 126 MB),但命中与否依赖调度;融合把它彻底变成寄存器与 shared 里的数据,与 L2 无关。
第三个收益是数值路径统一。前文的 batch-invariant、ieee_fmaf、Keep bitwise aligned 都是为这个服务的:如果归一化在 attn 里做、RoPE 在独立的 rope 算子里做、量化在量化库里做,三处的数值约定(fp32 还是 bf16 中间值、FMA 还是分两步、归约顺序)可能各不一样,最终「同一 batch 组成输出一致」就很难保证。把它们收进同一个 kernel,数值约定只需要在一处维护。
代价:可调试性、组合爆炸与形状约束
融合的代价同样真实:
- 可调试性。一个 600 行的 TileLang kernel 出错时,错误位置只有「某个 lane 的某个寄存器」这类线索。代码的对策是把参考实现
fused_..._ref写成「同样的流水但不融合」的朴素 PyTorch 版本,逐段调用既有算子(norm、apply_rotary、hadamard_transform_ref、quant.per_token_cast、store_kv_cache_ref),kernel 只和它对照。这是一个非常值得借鉴的做法:融合算子的正确性标准是「与不融合的流水逐字节一致」,而不是「和某个数学公式一致」。 - 组合爆炸。五段流水 × 三种输出 × 五种缓存格式 × 若干维度,合法组合不多但组合方式很多。代码的对策是把组合收敛到参数对象(
NormArgs/RopeArgs/HadamardArgs/CastArgs/KVCacheOutArgs)和一组断言里,而不是为每种组合写一个分支。 - 形状约束。
head_dim暂时锁在 128/512;Hadamard 只在 128;写主缓存必须 512 维;RoPE 只作用于尾部连续段;输入 stride 必须 16 元素对齐。这些约束在模型升级时会成为阻碍,但它们的代价由断言「早失败」承担,而不是运行中出现错误结果。
融合边界的画法
代码把「哪些事可以融」的边界画得很明确:
- 能融的:都是逐行独立、行内依赖有限(有界的 warp 内通信)的变换。归一化、RoPE、Hadamard、量化都属于此类。
- 不能融的:需要看全序列的操作(如 attention 本身、topk 选择)、跨 token 归约(如 RoPE 之外的某种统计)、以及需要全局同步的步骤。
store_kv_cache单独作为一个 kernel 存在(store_kv_cache.py),承接那些「数据已经做过 norm/rope、只剩搬运」的写入:prefill 的 SWA 分支就是典型——它先把历史 SWA 段load_paged_kv_cache进连续缓冲、与新算出的 KV 拼好,再在缓存读取之后用store_kv_cache落页;此时若再走融合路径,就会把同一批 KV 重复归一化和旋转一遍。
把边界画在这里有两个好处:一是 kernel 规模可控,每个 program 只处理固定行数、不跨 token;二是 CUDA Graph 捕获容易,固定形状下 grid 和 block 尺寸都是编译期常量。
测试矩阵:一个算子要证明哪些不变量
fused_transform.py 里有一个 600 多行的测试文件,参数矩阵本身也是一份文档。它用 _FusedTransformCase 把每种合法组合命名(operation 属性把阶段、量化、目的地、形状拼成一个可读字符串),再对不同 跑正确性,对 _benchmark 标记跑带宽。
几个覆盖点值得点出来:
n=1, 17, 32769:分别对应 decode 典型的超小 batch、warp 边界附近的尾部、以及超过一个「块」的大 batch。32769这类数字是刻意选的——32768 是很多 tile 尺寸的倍数,加一就落在尾部路径上。correctness_slots取continuous/cross-page/invalid:invalid会把部分槽位设为-1,直接检验上文「无效槽位不写、不越界」的处理。cross-page让一个 token 的写入跨越页边界,检验页号/偏移的翻译在边界处不丢数据。_guarded_store_cache:测试会额外分配前后 guard 区域,比较时检查未写入的槽位、页内 padding、存储偏移处的字节都没有被污染。写缓存类 kernel 最容易出的 bug 不是写错值,而是写到了不该写的地方;这个 guard 机制把后者也纳入正确性检查。torch.equal而非allclose:bf16/FP8 值逐字节比较,FP8 在部分后端不支持torch.equal,所以先转成uint8再比。这是前文「融合后的数值必须逐位一致」在测试层的体现。
对 benchmark,_benchmark_io_bytes 按「读输入 + 读 norm 权重 + 写缓存(含 scale)+ 可选写中间 bf16」统计真实字节数,算出有效带宽。融合 kernel 的优化目标是带宽而不是 FLOPs——它几乎不做大块矩阵乘,全是逐元素的读、算、写,所以用「每字节」而不是「每秒浮点」衡量才算对。
与 vLLM、SGLang 的对照
站内已经拆过这几个框架的同类路径,横向比较一下边界画法:
- vLLM(源码拆解见 vLLM 源码完全拆解(十七):KV Connector 所在的系列):
reshape_and_cache是一个独立 kernel,只做「按 slot 搬 K/V」,旋转与归一化在模型层的RotaryEmbedding与RMSNorm里各一步。FP8 分支会把缩放与转换融进写入,但融合的只是「缩放 + 转 FP8 + 写」,不含 RoPE。好处是每个环节可单独换实现、可单独调优;坏处是 decode 步的 kernel 数更多,且各环节的数值约定需要人为对齐。 - SGLang(注意力后端见 SGLang 注意力后端):注意力后端一侧同样有「缩放 + 写 KV 缓冲」的融合入口,模型层的 rope/norm 与 vLLM 结构类似。SGLang 的特色是 RadixAttention 的前缀复用,KV 写入路径要同时服务「新 token 追加」与「前缀导入」,融合边界因此更保守。
- llama.cpp:走的是 ggml 图算子路线,norm/rope 都是图里的独立算子,图优化器做的是合并点乘、消除拷贝这类通用变换,不会专门把 rope 和 kv 写入融合成一个 kernel。
- DeepInfer:因为只服务一个模型、一套注意力后端(FlashMLA)、一类缓存布局(V41 主缓存 + 三种 index 缓存),融合的边界可以画得最深——从归一化一路融到写页,并且把 DFlash 草稿 KV、压缩 KV、indexer K/Q 全部挂到同一个入口上。
三种做法对应三种可调试性:图算子最易验证、显式融合最易控制布局、模型层算子最易替换后端。它们的取舍取决于「换后端的频率」与「每步 kernel 数的敏感度」——DeepInfer 的判断是后者更关键。
工程边界:这套结构在哪些地方会咬人
head_dim的断言是升级路障。新模型如果 head_dim 不是 128/512,必须先扩 kernel 的blk_d推导与归约路径;Hadamard 只在 128 维,任何用 Hadamard 压离群值的格式升级都需要重新设计蝶形的跨 lane 部分。round_sf与sf_format的绑定是硬约束。想用「任意实数 scale + FP4」的组合会直接断言失败,因为代码里 FP4 只有两种「scale 也是低精度或 2 的幂」的组合。这是为了与存储格式对齐,代价是灵活性。- 写主缓存不允许 bf16。
do_cast=False的格式只出现在读取侧;如果以后想支持混合精度缓存(部分层 bf16、部分层 FP8),这条路径要重写。 - stride 假设。输入要求
x.stride(-1) == 1,且stride(0)、stride(1)都是 16 的倍数;缓存要求块 stride 32 字节对齐。如果一个上游算子产出的张量是切片视图,忘记.contiguous()就会在断言处失败,而不是在 kernel 里错算——这是「早失败」的另一个好处。 - CP 路径的量化一致性。
cast_back=True保证了本地量化与 all-gather 之后的量化在字节层面一致,但这要求所有 rank 的量化算法实现一致(同一个 kernel),任何一侧的版本差异都会让结果悄悄不一致。 ue8m0_exp_scale的边界。scale_bits - 1在s为 0 或非规格化数时会得到异常结果;AMAX_MARGIN保证了 amax 有下界,但finfo_max / amax这个乘子在 amax 极小时会溢出。代码在assert与 margin 上设了防线,但这一处是数值边界最容易出问题的点。
小结
本篇拆的是 DeepInfer 里一条很容易被忽略、但在每一步 decode 上都要跑的路径:把 RMSNorm、RoPE、可选的 Hadamard、分通道量化与分页 KV 写入合成一个 TileLang kernel。
- 归一化:按 head_dim 反推线程分工,行内归约在一个 warp 内用蝶形完成,跨 warp 时经 shared memory 汇总;两条路径必须逐位一致。
- RoPE:把旋转段搬进 shared memory,按 NEOX/交错两种配对读改写;由于线程映射保证行内闭包,只需 warp 级同步;
T.ieee_fmaf保证逐位一致,conjugate支持逆旋转。 - Hadamard:线程内蝶形 + 跨 lane
shfl_xor,只在 128 维上开放,用于抹平量化前的离群值;当前生产调用点均未启用,由测试矩阵覆盖。 - 量化:线程内→warp 内→跨 warp 三级 amax 归约;UE8M0 用位运算得到 2 的幂 scale,主缓存、index 缓存分别用 token-interleaved 与 block-wide 两种物理布局。
- 写页:槽位先经「padding 置 -1、越界置 -1、组内广播」,再翻译成页号与页内偏移;块 stride 从 scale 张量反推,满足 TileLang 的参数绑定约束。
- 组合表:七个调用点共享同一个入口,通过
None与KVCacheOutArgs.out_stage拼出「只旋不写」「写缓存 + 返回中间量」「返回量化值」等形态,并保证 index K 与 Q 的量化配置永远来自同一个KVCacheFormat。
站内已有 DeepGEMM 完全拆解 讲清了本 kernel 写出去的 FP8 数据与 UE8M0 scale 在 GEMM 侧怎么被消费;KVQuant 则从算法侧讨论了更低比特的 KV 压缩,恰好放在本 kernel 的「量化组粒度」这一档之上。把这三篇连起来看,写入侧、推理 GEMM 侧与 KV 算法侧的分工就完整了。
参考资料
- DeepInfer GitHub 仓库
- DeepInfer fused_transform 源码(TileLang 实现与测试矩阵)
- DeepInfer 分页 KV 缓存格式定义 cache_common.py
- DeepInfer 推理部署 Q&A(含 FP4/FP8 缓存格式说明)
- TileLang 项目主页(DeepInfer 特化算子的 DSL)
- FlashMLA 仓库(DeepSeek 多头潜在注意力 kernel)
- RoFormer:带旋转位置编码的 Transformer 论文
- QuaRot:用 Hadamard 旋转消除量化中的离群值
- DeepSeek-V2:MLA 与 KV 缓存压缩
- DeepSeek-V3 技术报告:FP8 块状缩放与高精度累加
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



