


DeepInfer 源码拆解(十一):注意力族与压缩 KV
从第十篇留下的三个问题接上
第十篇(DeepInfer 源码完全拆解(十):模型层与 mHC)走完了 v4_modules 的装配线与跨层拓扑,结尾留下的三个问题都落在注意力族上:
- 压缩 KV 在
mla_attn.py里为什么分成「容器 + 运行时」两份? - 稀疏索引器的 K 为什么需要跨层共享?
attn.py里 46 KB 的代码到底在组织哪些分支?
这一篇把这三个问题正面拆开。结论先给出来,全篇都在为它补充证据:
- 容器与运行时的分界,是「加载期事实」和「每步事实」的分界。 容器只描述权重结构与层间差异(哪些层真的持有压缩权重、哪些层真的持有索引器),运行时把容器适配成每步都要重算的调度键、缓存别名与量化布局。同一个
FlashMLA调度元数据按sched_meta_key缓存,这个键(压缩率、有无 packed KV、是否 SWA、topk 长度)只能由运行时拼出来,容器侧永远不需要知道。 - 索引器 K 之所以能共享,是因为它只是一次线性投影加一次 RMSNorm,投影的输入又是主压缩 KV 的同一份 pre-RoPE latent——每层各算一遍是纯粹的重复劳动。共享的代价是拓扑必须被显式校验(
SharedLayerTopology的 fail-fast),因为缓存引擎判断「这一层是否复用别人的缓存」靠的是配置里有没有那段layer_info_shared_cfg,配错了不会报错,只会静默读到未初始化的显存。 attn.py的 46 KB,是把「一次前向」在五个维度上展开:prompt 还是 decode、要不要 SWA、有没有本地索引器、这一层是源层还是消费者层、YoCo 截断的 compact 视图是否在场。每加一个维度,编排就多一层if,而每个if背后都对应一条被推到别处的约束(比如「SWA 的 store 槽位可能与 load 区间重叠,所以必须先 load 后 store」)。
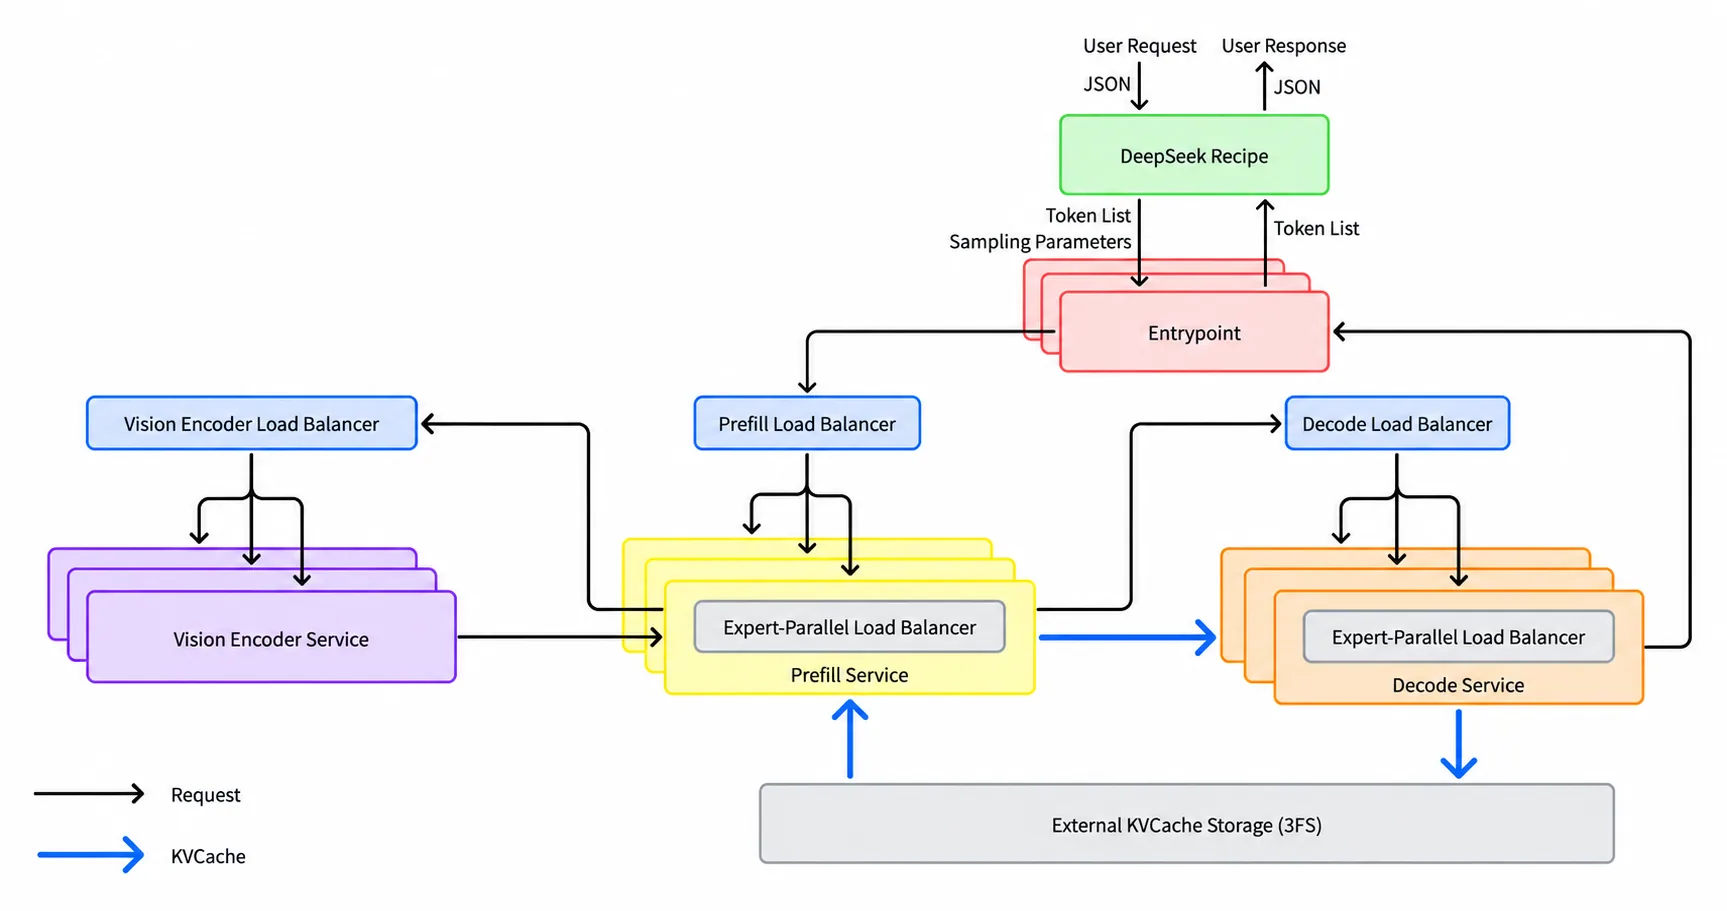
(图源:DeepInfer 官方仓库 doc/images/architecture_overview.png。本篇讨论的 model_executor/models/v4_modules/ 与 model_executor/layers/ 两层,正是图中「模型执行」与算子层之间的注意力族。)
注意力族的文件地图
在 v4_modules/ 目录里,注意力族由四个文件构成,加上第十篇已经讲过的 cross_layer.py,以及算子层的两个配角:
| 文件 | 规模 | 角色 |
|---|---|---|
mla_attn.py | 11 KB | 容器:权重的结构定义,含 MLA 低秩投影、压缩 KV 投影、索引器参数 |
attn.py | 46 KB | 运行时:V4Attention / DFlashAttention,把容器适配成前向模块 |
compress.py | 6 KB | 压缩运行时:Compressor 与 KProject,压缩 + norm + 落 KV cache |
index_attn.py | 22 KB | 索引器运行时:MQA,算 relu(q·k)·w 并选出 top-k 压缩条目 |
layers/attention_backend.py | 4 KB | FlashMLA 调用层:稀疏 prefill/decode 两个入口 |
layers/tilelang_ops/ | — | swa_index、kv_index_cat、load_paged_kv_cache 等拼装算子 |
先说清楚这四个文件里「谁定义、谁执行」的关系,后面三个问题才有落点:mla_attn.py 定义的是参数容器类,attn.py 里的 V4Attention 在构造时接收一个容器实例(attn_module),把它「适配」(adapt)成运行时模块——这是全篇反复出现的模式,第十篇讲的 builder.py 负责在装配期把容器挂到每一层上,而哪些层的容器里真的有压缩权重与索引器,由 cross_layer.py 的拓扑在装配期决定。
问题一:压缩 KV 为什么分成「容器 + 运行时」两份
容器侧:四个类,各自只管权重形状
mla_attn.py 的模块 docstring 把四个类列得很清楚,逐个看:
ColumnParallelLora 是 MLA 低秩投影的通用容器,描述的是 x -> A -> (norm) -> B 这条链:
class ColumnParallelLora(nn.Module): def __init__(self, in_features, out_features, rank, *, num_lora_rope_head=0, rope_head_dim=64, norm_module=None, use_fp8_gemm=False): self.A = ReplicatedLinear(in_features, rank + num_lora_rope_head * rope_head_dim, ...) self.B = ReplicatedLinear(rank, out_features, ...) if out_features > 0 else None self.norm = norm_module两个细节值得停顿:Wq 用 num_lora_rope_head=0(query 侧没有 MQA rope 头),而 Wkv 用 num_lora_rope_head=1——A 的输出维度是 rank + 1 * rope_head_dim,也就是低秩压缩 latent 与 MQA rope 头拼在同一个投影里,这正是 MLA 与「纯低秩 + 单独 rope」写法的区别;另外 Wkv 的 out_features=0,于是 B 为 None——KV 侧没有上投影,因为 V4.1 推理只缓存压缩后的 latent,上投影在注意力核心里按需恢复。
SoftmaxAPEGatedColumnParallelLora 是压缩 KV 的投影容器,docstring 一句话点破 C1 与 C2 的差别:
"""KV projection of the compressor: `A` produces the values, `Gate` produces the logits.
The single-token softmax of C1 is always 1, so only A is needed; C2 uses both A and Gate."""压缩率是 1 的路径(单 token 压缩)softmax 恒为 1,所以只需要 A;压缩率是 2 的路径既要值也要门控 logits,A 与 Gate 都要建。注意两者的注释:use_fp8_gemm=False——Gate 与 A 走 bf16,不参与 fp8 量化,因为它们是压缩权重(数值敏感度与主投影不同)。
MQAIndexer 是稀疏索引器的参数容器,构造时用一串断言把自己钉死在一条路径上:
assert self.use_ropeassert not self.use_q_normassert self.rope_dim == 64assert self.sparse_stage == 2assert not index_cfg.get("mlp_kproj", False), "DeepInfer KProject only supports a flat k_proj"也就是说索引器必须带 rope、rope 维度固定 64、只支持 stage-2 稀疏、且 k_proj 必须是扁平线性层(不支持 MLP 形态的 k 投影)。它持有三个投影:q_B(q_lora_rank -> n_head * head_dim,fp8)、weights_proj(hidden -> n_head,bf16,每头一个 logits 权重)、k_proj(kv_lora_rank + qk_rope_head_dim -> head_dim,bf16)。
容器侧的「结构性缺失」:哪些层留空
LoraRopeCompressFlashMHAAutoRecomp.__init__ 有两个参数:is_kv_source_layer 与 is_index_module_source_layer。它们决定容器里留空还是建实例:
self.PackedWkv = ( SoftmaxAPEGatedColumnParallelLora(...) if is_kv_source_layer else None)self.index_attn = Noneif self.sparse_stage == 2 and cfg.get("attn_index", None) is not None and is_index_module_source_layer: self.index_attn = MQAIndexer(cfg)注释写得很直白:只有 kv-source 层真的持有 PackedWkv;其它层的 PackedWkv 是 None,前向时从源层取。index_attn 同理。这意味着容器在设计上就承认了「层与层不一样」——不是每层都有完整的注意力参数,而是按拓扑分成源层与消费者层两组。哪些层是源层,正是由 cross_layer.py::SharedLayerTopology 从配置推导:layer_map[l] == l 的层是源层,其余层复用源层的模块。
这个设计还有一个隐含收益:显存和加载成本按源层数量计。如果 61 层里只有若干层持有压缩权重与索引器,参数加载与显存占用就只落在这些层上,其余层在容器侧是空的。
运行时侧:把容器适配成每步要用的东西
attn.py 里 V4AttentionBase.__init__ 做的是「适配」,主要动作有四类:
第一类,把 HF 权重整理成推理布局。 例如 q_a 与 kv_swa 的投影权重可以合并成一次 GEMM(merge_linear_weights),q_B 与索引器的 q_B 也可以合并;但注释立刻给出例外——开启 yoco_swa_share_hidden 时不能融合,因为 Q 与 KV 的输入不再是同一份 hidden。Wv 与 out_proj 则要做量化布局变换(transform_sf_into_required_layout 与 permute_wv_proj),把 fp8 scale 排成融合内核要求的形状。
第二类,把「层类型」翻译成运行时开关。
self.layer_cfg = getattr(attn_module, "cfg", AttrDict())self.is_sparse = bool(self.layer_cfg.get("index_topk"))self.has_packed_kv = getattr(attn_module, "n_packed_heads", 0) > 0self.use_swa = self.layer_cfg.get("use_swa", True)assert self.use_swa or self.has_packed_kv, "use_swa=False requires packed KV attention"if self.is_sparse: assert self.use_swa三行开关覆盖了注意力族的三个正交维度:有没有压缩 KV、要不要 SWA、有没有本地索引器。断言则固定住合法组合——稀疏必须以 SWA 在场为前提,因为稀疏索引选出的压缩条目要和滑窗 KV 拼在同一次注意力里。
第三类,构造调度键。 这是「运行时」存在的最直接证据:
self.sched_meta_key = f"{self.kv_compress_ratio}_{self.has_packed_kv}_{self.use_swa}_{self.layer_cfg.get('index_topk', 0)}"FlashMLA 的 tile scheduler metadata 按这个键缓存(input_metadata.flash_mla_sched_meta_dict[self.sched_meta_key])——键里的四个量全部来自运行时适配的结果,容器侧一个都不涉及。
第四类,决定是否启用融合内核。 use_fused_norm_rope_attn_rope_cast 的取值把「稠密 packed-KV 解码」排除在外(该场景禁用融合),并要求头数落在 (64, 128)、平台是 GPU。融合内核把 norm、rope、cast 与前向的 rope 收尾合成一步,是 FP8 路径上的常态。
把四类动作合起来看,问题一的答案就完整了:容器是加载期的事实(权重形状、层间差异、留空与否),运行时是每步的事实(调度键、缓存别名、量化布局、融合开关)。两者的边界之所以画在这里,是因为容器要在权重加载时确定、且必须能被 HF 权重映射稳定引用;而运行时的一切都要在每步前向里随批次形状与调度状态变化。
问题二:压缩 KV 的一次前向(compress.py)
compress.py 的两个类各有明确分工:KProject 把「压缩 latent」投影成索引器的 K;Compressor 负责压缩、norm、落 KV cache。
压缩本身:C1 与 C2 两条路径
Compressor 的构造断言把支持面收窄到 C1/C2:
self.ratio_key = str(self.kv_compress_ratio)if self.kv_compress_ratio not in (1, 2): raise ValueError("Only C1/C2 compression is supported")forward_pre_norm 按压缩率分支:
- C1(
kv_compress_ratio == 1):断言投影输出是 bf16 且state_cache is None——单 token 压缩没有需要攒的窗口,不需要状态缓存;若在 CP 下则先按mirror_cp_reverse_index做一次 gather。 - C2:断言投影输出是 fp32 且状态缓存在场,然后把投影输出按最后一维
chunk(2)切成score与latent——这正是SoftmaxAPEGatedColumnParallelLora里A与Gate两路的输出。
压缩的内核分 prefill 与 decode 两个入口,参数列表本身就是一份「压缩需要知道什么」的清单:
kv_compressed = compress_and_update_state_prefill( score, latent, state_cache, input_metadata.state_block_idx, input_metadata.compressed_batch_mapping[self.ratio_key], input_metadata.cu_seqlens_q, input_metadata.cu_seqlens_k, input_metadata.cu_compressed_seqlens_q[self.ratio_key], self.kv_compress_ratio, input_metadata.mirror_cp_reverse_index,)decode 侧的签名短得多,但多了一个关键参数:
kv_compressed = compress_and_update_state_decode( score, latent, state_cache, input_metadata.state_block_idx, input_metadata.context_lens, max_seqlen_q=envs.DEEPINFER_USE_NEXTN_DECODE + 1, compress_ratio=self.kv_compress_ratio,)max_seqlen_q = NEXTN + 1 这一行要和第三篇(KV 内存与 SWA 有界重放)对上:投机解码一次 decode step 可能推进多个草稿 token,被拒绝的部分要回滚,而压缩的 ring 缓存里同样留有回退历史。这里的 max_seqlen_q 就是压缩内核侧为这件事预留的声明。
存储路径:一次融合内核完成 norm、rope、cast、store
forward_store_kv_cache 是压缩 KV 落 cache 的唯一路径,注释把融合粒度写得很清楚:一次调用完成 norm、rope、Hadamard 变换、量化与落盘,目标 layout 由 get_kv_cache_format(kv_cache) 推出来(V4.1 上是 MXFP8/FP4 系列布局)。落盘位置是 slot_mapping_store_ca[self.ratio_key]——压缩条目按压缩率分桶存放,C1 与 C2 各自一张槽位表。
这段代码里最值得学的是一个「按需拷贝」的细节:
pre_rope_kv = torch.empty_like(kv_compressed) if return_pre_rope_kv else None注释交代了理由:只有 KProject 索引器需要这份 pre-RoPE latent,其它路径不拷贝。索引器的 K 由主压缩 KV 的 pre-RoPE 版本投影而来(见问题三),所以当这一层没有索引需求时,这份拷贝连同它的显存分配一起被省掉。这是典型的「把特化机会做到单字段」的写法。
问题三:稀疏索引器为什么需要跨层共享
索引器在算什么
index_attn.py 的 MQA 类 docstring 一句话给出算法定义:算 relu(q·k)·weights 的 logits,并为每个 query 选出 top-k 个压缩条目。数据格式上它有一组自己的约定(都在构造的注释里):
- 索引器的 Q 与 K 全程 FP4(E2M1 + UE8M0 scale),
weights与psum走 bf16——. # Indexer Q/K always use FP4 (E2M1 + UE8M0 scale); weights and psum use BF16.; max_kv_len = runtime_max_model_len // kv_compress_ratio,索引长度按压缩率折算;- psum 的行宽由 logits 的实际布局决定:稠密路径是
max_kv_len * 2字节,稀疏候选路径是候选 token 数乘 2,并断言 1024 字节对齐。
还有一个注释解释了这 22 KB 代码里最「玄学」的参数——分块宽度:
# NOTE The chunk size is min'ed with 8192 because mqa downclocks when the chunk size is large; the chunk has to be# split up and have some topk operations stacked on it to achieve the best performance.self.compute_chunk_size = min(8192, envs.DEEPINFER_INDEX_ATTN_MEMORY_LIMIT // psum_row_bytes // 8 * 8)compute_chunk_size 由显存配额 DEEPINFER_INDEX_ATTN_MEMORY_LIMIT 与 psum 行宽推出来,但必须再取一次 8192 的上限:chunk 太大时 MQA 内核会降频,把 chunk 拆小、再把 topk 叠上去才是最优解。这条限制的工程含义是:索引器的显存配额不只是「够不够」的问题,也是「性能对不对」的问题。
两级 topk:候选块与候选内选点
索引器的 topk 不是一次完成的,而是「块级 → token 级」两级:
- 候选源层先算块分数(
candidate_block_max,即块内 max-reduce),用topk选出candidate_topk_blocks个候选块,写入cross_layer_runtime.block_candidate_idxs; - 同组的后续层只在候选块集合内算 token 级 topk(
fp8_fp4_sparse_mqa_logits/fp8_fp4_paged_sparse_mqa_logits),算完再用restore_candidate_indices_inplace把「候选内下标」还原成全局下标。
这个两级结构是精度与吞吐的折中:块级筛选用更便宜的内核砍掉绝大部分 KV 页,token 级再用稀疏内核在候选集合里精确选点。构造侧的断言把候选配置钉死在一小组合法值上:candidate_block_size in (8, 16)、topk_block % 8 == 0、score_reduce in ("max",);消费者层的头部约束是 n_head <= 32 and head_dim == 128。
候选块机制的归属也在构造时确定:
self.is_candidate_topk_source = shared_topology is not None and shared_topology.is_candidate_source_layer(self.layer_idx)self.use_candidate_topk = candidate_source is not None and not self.is_candidate_topk_source候选源产生候选、消费者只消费候选——而「谁是源、谁是消费者」来自共享拓扑,这就自然引到下一个问题。
共享的机制:layer_index_k_map 与一次投影
索引器的 K(下称 index-K)是这样来的:主压缩 KV 的 pre-RoPE latent 经 k_proj 投影、再过 RMSNorm(KProject 的 docstring 原话),然后按 FP4 layout 落进索引器自己的 KV cache(ica_cache)。它的构造分支是共享的核心:
# HF V4.1 index-K is projected from the main compressed KV.# Shared index-K consumers reuse the source cache without constructing a K module.if self.store_index_k: self.index_k_module = KProject(index_attn_module.k_proj, index_attn_module.k_norm)store_index_k=False 的消费者层干脆不建 K 模块:decode 时直接读源层的 ica_cache,prefill 时复用源层 load 出来的那份张量(cross_layer_runtime.loaded_prefill_index_kv),自己只重算 MQA logits。
为什么值得共享?因为这份 K 的来路决定了它天然是「一份就够」的:所有消费者层的 index-K 都来自同一份主压缩 KV latent,投影矩阵也是同一组权重(源层与消费者的 kv_compress_ratio、index_topk 由拓扑断言强制相等)。每层各算一遍,是把一次线性投影加一次 RMSNorm 重复 N 遍;共享则把这个代价摊到源层一次。
拓扑为什么必须 fail-fast
cross_layer.py 的 SharedLayerTopology 把配置里的三张稀疏地图归一化成覆盖全部层的列表:
layer_index_module_map:索引器(topk 产出)的共享;layer_index_k_map:index-K 的共享,默认跟随 index-module 地图;layer_kv_map:主 KV(ca_cache)的共享。
归一化的规则是「自引用 = 源层」,消费者只能指向它前方最近的源层(分段共享,_validate_segmented_map)。在此之上还有一条粒度链校验:
self._validate_map_refines("index-topk", self.layer_index_module_map, "index-k", self.layer_index_k_map)self._validate_map_refines("index-k", self.layer_index_k_map, "kv", self.layer_kv_map)注释解释了为什么必须成立:消费者读的是源层的 ica_cache,而这份 K 又是从源层的压缩 KV 投影出来的,所以每一跳都不能跨过更粗粒度段的边界。换句话说,共享关系必须构成 index-topk ⊆ index-K ⊆ KV 的细化链;否则「复用谁的缓存」和「KV 是谁写的」会对不上。
这条链还有一个方向性的约束——share-kv 不能越过 YoCo 截断边界:
assert n_prefill_layer == cfg.num_hidden_layers or self.layer_kv_map[n_prefill_layer] == n_prefill_layer因为截断模式下,边界前后的 KV 归属不同(第十篇讲过的跨层共享与 YoCo 边界协同),消费者若跨越边界去复用,拿到的 KV 来源语义就变了。
最值得记录的是失败模式本身,源码把它写成了断言的理由:
# The cache engine decides whether a layer participates in sharing by "does this layer carry# layer_info_shared_cfg" (_get_shared_mapped_layer_id); if a consumer layer lacks it, the cache# engine treats it as a source and allocates an independent cache, but the topology side never# writes it, so it silently reads uninitialized memory, hence this must be fail-fast.缓存引擎与拓扑是两套判定:缓存引擎看「这一层有没有携带 layer_info_shared_cfg」来决定是否别名别人的缓存;拓扑只看地图。两边一旦不一致(比如消费者层漏配了那段配置),缓存引擎会把它当源层、给它分独立缓存,而拓扑侧永远不会往那块缓存里写——读到的就是未初始化的显存,且不会报错。所以这一条必须 fail-fast:宁可在模型构建时崩溃,也不能让错误的数据无声地流进注意力。
CrossLayerRuntime 则是每步前向的载体,docstring 列出了六类跨层值:shared_hidden(第一个 YoCo 消费者层的 bf16 hidden)、pre_rope_kv(最近 kv 源层的 pre-RoPE 压缩 KV,给索引器的 KProject 用)、topk_indices(最近索引源层的 topk,share-index)、block_candidate_idxs(候选块)、loaded_prefill_kv(最近的 kv 源层已经 load 好的 prefill KV,消费者直接复用同一张量、只覆盖其中的 SWA 区)、loaded_prefill_index_kv(索引源层已 load 的 index-K)。它只有一个槽位、不做来源匹配——因为拓扑是分段共享的,而层按递增的 layer_id 执行,消费者需要的永远是「前方最近的源层」写下的那份。
问题四:attn.py 的 46 KB 在组织哪些分支
三个类
文件里只有三个类:V4AttentionBase(适配层:norm、rope、权重合并、量化布局,及前述四类动作)、V4Attention(主模型注意力:压缩 KV、稀疏索引、SWA、YoCo、跨层共享五条线都汇在这里)、DFlashAttention(草稿注意力:独立的 draft KV)。
V4Attention.__init__:分支在构造期就分层
除了问题一讲的运行时开关,构造期还有一组「YoCo 相关」的判定:
self.is_yoco_hidden_consumer_layer = is_yoco_consumer_layer(cfg, layer_idx)self.is_first_yoco_consumer_layer = self.is_yoco_hidden_consumer_layer and self.layer_idx == cfg.n_prefill_layerself.yoco_swa_share_hidden = self.use_swa and self.is_yoco_hidden_consumer_layer and cfg.get("yoco_swa_share_hidden", True)yoco_swa_share_hidden 的含义是:YoCo 消费者层的 SWA 投影不消费本层 hidden,而消费跨层共享的那份 hidden(第一个消费者层例外——它直接用本层的 attn-norm 结果,见 _resolve_shared_hidden)。这解释了前面那个「Q 与 KV 不能融合」的例外来自哪里。
forward:一次前向的编排
主路径的 forward(约 120 行)是 46 KB 的缩影,按顺序可以压成九步:
1. 元数据扩展。 input_metadata.compute_attn_info(self.max_model_len, self.window_size, block_size)——注意 block_size 是从 kv_cache.ca_cache 反推的(shape[1] * kv_compress_ratio),压缩条目的块尺寸乘回压缩率才是 token 意义上的块尺寸。
2. 解析共享 hidden、投影当前 hidden。 _project_current_hidden_inputs 只让非 YoCo 的 KV 源层在这里投影主 KV——YoCo 共享 KV 走单独的投影(shared_hidden_kv_proj),因为它的输入不是本层 hidden。
3. YoCo compact 分支。 若 consumer_full_metadata 在场(compact prefill),先调 _store_yoco_full_kv:用全量 hidden 更新主/索引 KV,供 compact query 的前向使用;随后主路径跳过 KV 更新,只算 compact query 的 topk。注释强调这条分支的必要性:query 被裁剪了,但 KV 仍要覆盖完整上下文。
4. Q 与 SWA 投影。 _project_q_and_swa 一次拿到 q_a 与 kv_swa(能融合时是一路 GEMM);在 CP 下,压缩器输入的 all_gather 先发起(_make_cp_gather_getter),与下面的 Q 投影重叠。
5. SWA 张量准备。 _prepare_swa_kv 用融合内核完成 norm、rope、e4m3 量化(round_sf=True, sf_format="ue8m0")与落 cache;prefill 侧还负责把本 rank 的 KV 在 CP all_gather 后接回来。
6. Q 侧投影与拆包。 q_b_proj 一次算出主注意力 Q 与索引器 Q(merge_linear_weights 合并过),再 split 回两段;随后 _q_b_norm_rope 按融合内核开关决定是否省略。
7. _compute_kv_ca_index:把 KV 侧三件事串成一条。 顺序是「主 KV store(返回 pre-RoPE latent)→ index-K store/topk → 把 topk 写进 cross_layer_runtime」。共享判定在这里体现:kv 源层 _store_main_kv 并把 pre_rope_kv 写进运行时;is_index_k_source 的层从运行时取它;is_sparse 但不是索引源的层直接复用 cross_layer_runtime.topk_indices。若这一层自带 index_attn,则调用索引器(store_kv=not yoco_full_kv_stored——compact 分支下 KV 已经由全量路径写过,跳过重复 store)。收尾时 cross_layer_runtime.topk_indices = kv_ca_index,供后续消费者层复用。
8. prefill:拼装 KV 再跑注意力。
# Assemble the input kv for prefill attention: [swa cache | current swa kv | compressed cache]total_kv = total_k_swa_cached + total_k_swa_cur + total_k_compressed三段拼接:已缓存的 SWA、本次新增的 SWA、压缩条目,分别由 load_paged_kv_cache 与 kv_swa.copy_ 分段填充;kv_index_cat 把 SWA 与压缩两段索引拼成一份,送给稀疏 prefill 内核。这里藏着一条顺序约束,注释写得很明确:
# The SWA store slots may overlap the ranges loaded above, so prefill must store only after the cache load.SWA 的 store 槽位可能与上面的 load 区间重叠——同一块环形缓冲既被读也被写,所以必须先把旧内容读完,再写新内容,顺序颠倒就会读到自己的新值。这种约束不会出现在签名里,只能靠注释与代码顺序传递。
9. decode:SWA 与压缩 KV 各走各的 cache。
attn_kv_args = dict( key_cache=kv_cache.swa_cache, indices_in_kvcache=kv_swa_index, key_cache_extra=kv_cache.ca_cache, indices_in_kvcache_extra=kv_ca_index, index_length_extra=dense_index_len,)SWA 在场时,注意力内核的主 cache 是 SWA、额外 cache 是压缩条目;非 SWA 层则反过来只有 ca_cache 一路。keys_cache_extra 这个形参在 FlashMLA 侧的对应物就是第三篇提到的「extra k cache」。decode 还会带上 batch_invariant=envs.DEEPINFER_BATCH_INVARIANT——批量不变推理的开关直接贯穿到注意力内核,这是总览篇讲过的确定性要求在这条路径上的落点。
把九步里的分支条件抽出来,就是问题四的答案——attn.py 的代码量主要不是算法,而是分支矩阵:
| 维度 | 取值 | 主要后果 |
|---|---|---|
input_metadata.is_prompt | prefill / decode | 内核入口、KV 拼装、SWA 处理全不同 |
use_swa | 有 / 无 | 主 cache 与额外 cache 的归属互换 |
has_local_index | 有 / 无 | 是否调用索引器、是否消费 pre_rope_kv |
源层 / 消费者层(is_kv_source / is_index_source / is_index_k_source) | 是 / 否 | store 由谁做、topk 由谁算、缓存复用谁 |
yoco_full_kv_stored | 是 / 否 | 用全量 hidden 更新 KV 还是走常规路径 |
| CP / 非 CP | 是 / 否 | all_gather 的时机与 gather 缓冲区复用 |
DFlashAttention:草稿路径的注意力变体
DFlashAttention 服务于 DFlash/MTP 草稿,前向入口是 forward_drafts。与主路径的两个关键差别:
草稿 KV 是「一次 decode step 的临时物」。注释原话:
# Draft keys live for one decode step and are overwritten by the next step.草稿 KV 写进 swa_cache 的一小段专用槽位(dflash_newx_slot_mapping_store),下一步直接覆盖——不进主 KV cache,也不参与前缀复用。这与第六篇(投机解码篇)讲的草稿生命周期是同一件事,在这里能落到具体的槽位映射上。它的调度元数据用固定键 "DFlash" 缓存,独立于主路径的 sched_meta_key。
另外构造参数 prefill_only 会只保留 kv_norm 就返回——P/D 分离部署下,纯 prefill 角色不需要草稿侧的 Q 投影。
拼起来:注意力族在一次前向里的合流
把上面的线头收在一张流程里:
- 隐藏状态进入
V4Attention.forward,先做元数据扩展与共享 hidden 解析; q_a + kv_swa融合投影出 Q 的低秩部分与滑窗 KV,SWA 张量经融合内核直接进 cache;- 压缩 KV 经
PackedWkv(仅源层)投影、压缩(C2 走 score/latent 双路)、norm、rope、量化后落ca_cache;同时把 pre-RoPE latent 交给索引器的KProject——索引 K 与主 KV 来自同一次投影,这是共享的物质基础; - 索引器算出 relu(q·k)·w 的 logits,先用块级 topk 收窄候选(仅候选源层),再在候选内选 token 级 topk;
- prefill 时把「已缓存 SWA + 本次 SWA + 压缩条目」拼成一份 KV 与一份拼装索引(
kv_index_cat)交给稀疏内核;decode 时 SWA 与压缩条目分别作为主/额外 cache 交给 FlashMLA; - 注意力输出经
Wv与o_proj(量化布局融合)回到 hidden 维度。
下图是 FlashMLA 的 kernel 调度示意——第 5 步里两种 cache 的拼接与调度、warp 分工都发生在这一层内核里:
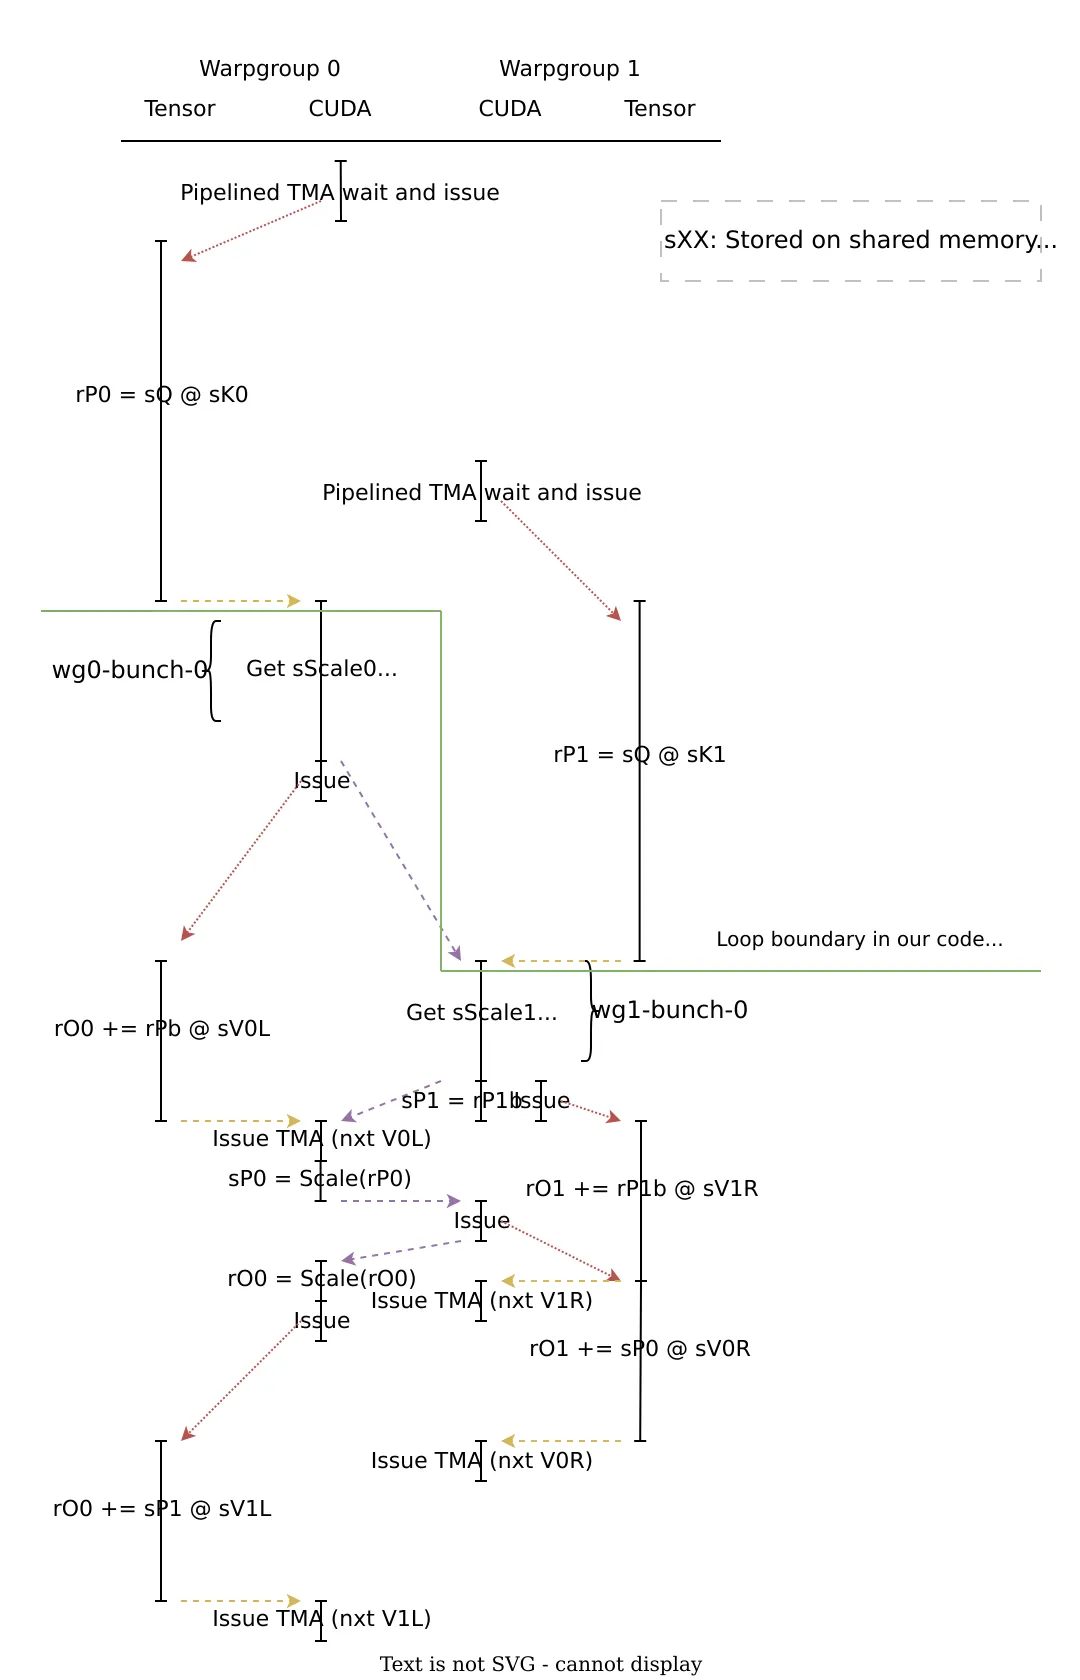
(图源:FlashMLA 官方仓库 docs/assets/MLA Kernel Sched.drawio.svg。)
而 MLA 低秩投影的结构本身,用一张对比图就能看清「为什么要压缩、压缩到哪里」——这也是本文容器侧 Wkv 只建 A 不建 B 的原因:
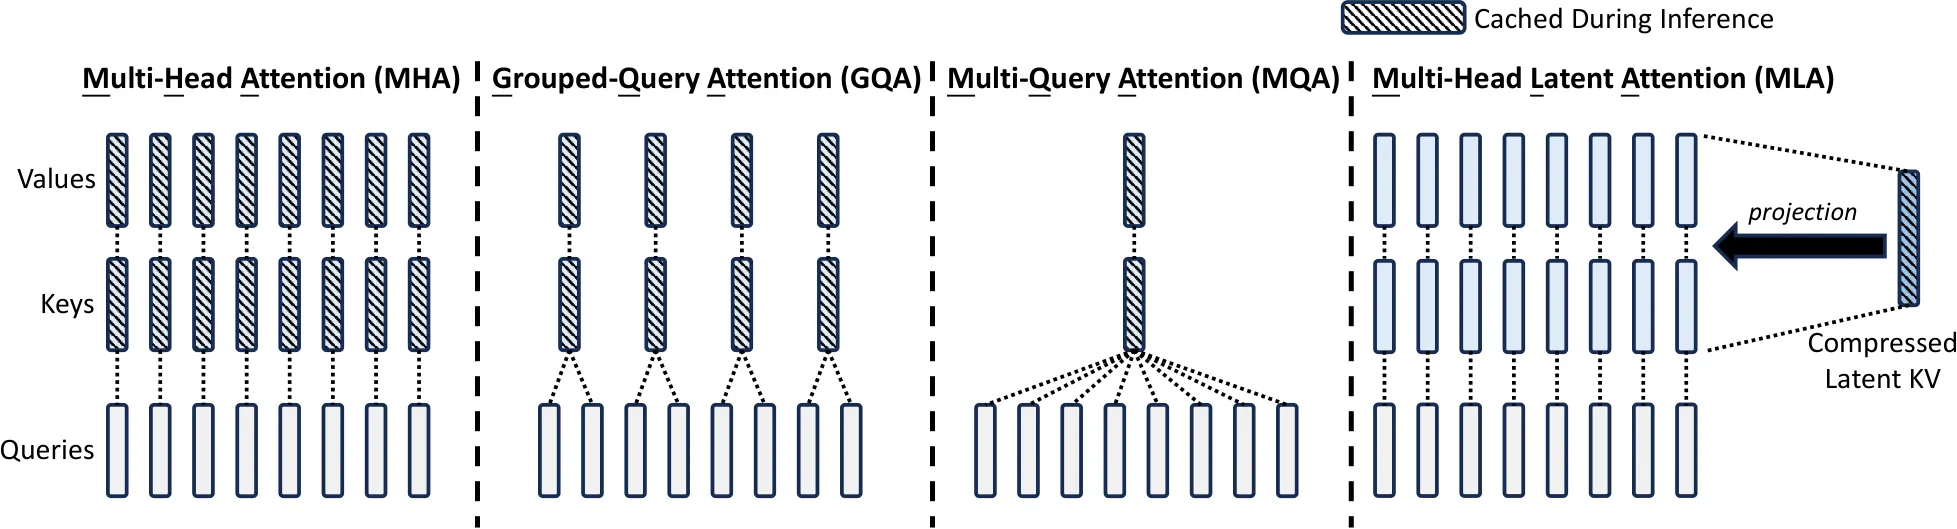
(图源:DeepSeek-V2 论文 Figure 3。MLA 把 K/V 联合压进一个潜向量(图中最右侧的 ),推理只缓存该潜向量;引擎侧对应 Wkv 的 A 投影输出压缩 latent 与 MQA rope 头,上投影在注意力核心里按需恢复。)
工程边界与陷阱
这一节集中列注意力族里「不满足就出错」的约束,它们分散在四个文件的断言与注释里:
拓扑侧(cross_layer.py)。
- 消费者层必须携带
layer_info_shared_cfg:否则缓存引擎把它当源层分配独立缓存、拓扑侧却不写它,静默读未初始化显存——这是拓扑存在 fail-fast 的首要理由。 - 三段共享必须构成细化链
index-topk ⊆ index-K ⊆ KV;分段共享要求消费者只指向前方最近的源层,任何「中间隔了自引用层」的地图会被直接拒绝。 - share-kv 不得越过 YoCo 截断边界(
layer_kv_map[n_prefill_layer] == n_prefill_layer);共享层与源层的kv_compress_ratio、index_topk(以及 share-kv 下的use_swa)必须一致。 - MTP 层不支持跨层共享;候选源的地图必须单调不减,且候选源的
index_topk > 0、必须自己是索引源层。
索引器侧(index_attn.py)。
- 只支持
use_kproj=True且k_proj为扁平线性层(mlp_kproj直接被断言挡掉)。 - 候选机制:
candidate_block_size in (8, 16)、candidate_topk_blocks是 8 的倍数且不超过 4096、score_reduce只有"max";消费者层n_head <= 32 and head_dim == 128;候选 token 数不得小于消费者层的index_topk。 - psum 行宽必须 1024 字节对齐;
DEEPINFER_INDEX_ATTN_MEMORY_LIMIT必须至少容下 8 行 psum,否则构造期直接报错。 end(有效长度)必须显式传给 topk 内核——越界的 psum 没有清零,漏传会把脏数据选进来。- topk 输出在 decode 侧是「逻辑下标」,必须经
convert_kv_index用block_tables原地换成物理槽位(-1保留为无效标记)。
压缩与 SWA 侧(compress.py / attn.py)。
- 只支持 C1/C2 两种压缩率;C1 必须
state_cache is None;两路的投影输出 dtype 分别是 bf16 与 fp32,喂错直接断言失败。 clear_compress_block_size_cache()只在改DEEPINFER_MAX_BACKTRACKING_TOKENS后手动调用(第三篇讲过它的后果);压缩 decode 的max_seqlen_q固定为NEXTN + 1,与回退余量绑定。- prefill 的 SWA 必须先 load 再 store(槽位重叠);SWA store 的槽位映射与压缩条目分桶(
slot_mapping_store_ca[ratio_key])各用各的表,不能混用。 - 融合内核(
use_fused_norm_rope_attn_rope_cast)在「稠密 packed-KV 解码」下被禁用;开启时q_b_proj的权重必须经过permute_q_b_proj预重排,否则首 token 的布局对不上。 - 草稿 KV 只活一步:
DFlashAttention的 draft KV 下一步就被覆盖,任何把它当成可复用 KV 的假设都会出错。
小结与下一篇
回到开头的三个问题:
容器与运行时的分界。 容器(mla_attn.py)描述加载期事实:权重形状、层间差异(源层才持有 PackedWkv / index_attn)、低秩投影的 A/B 结构;运行时(attn.py)把容器适配成每步事实:sched_meta_key、缓存别名、量化布局与融合开关。这条分界让「同一份容器被源层与消费者层以不同方式使用」成为可能,也让权重加载与运行时调度各自演进。
索引器 K 的共享。 index-K 来自主压缩 KV 的 pre-RoPE latent,一次投影加一次 norm,共享的物质基础是「同一份 latent」;共享的代价是拓扑校验必须 fail-fast,因为缓存引擎与拓扑是两套独立判定,配错只会静默读脏显存。
46 KB 的分支。 attn.py 的代码量来自六个维度的分支矩阵(prompt/decode、SWA、本地索引、源层/消费者、YoCo compact、CP),以及每个维度背后「顺序与边界」的不变式——比如先 load 后 store、topk 必须显式给 end、compact 分支下主路径跳过 KV 更新。
注意力族讲完,v4_modules 里剩下的主线还有两块:MoE 与 Engram(moe.py、mlp.py、engram.py 等——细粒度专家的分组 GEMM、共享专家为何 replicated、Engram 的哈希查表落在推理的哪一步),以及 mHC 残差主干与 YoCo 的算子层细节。下一篇按路线图讨论 MoE 与 Engram。
参考资料
- DeepInfer 官方仓库(README 与功能清单)
- DeepInfer mla_attn.py(参数容器:ColumnParallelLora / SoftmaxAPEGatedColumnParallelLora / MQAIndexer)
- DeepInfer attn.py(V4Attention / DFlashAttention 运行时)
- DeepInfer compress.py(Compressor 与 KProject)
- DeepInfer index_attn.py(MQA 索引器运行时)
- DeepInfer cross_layer.py(共享拓扑与跨层运行时)
- DeepInfer attention_backend.py(FlashMLA 稀疏注意力调用层)
- DeepInfer builder.py(注意力模块的装配线)
- DeepInfer environ.py(DEEPINFER_* 环境变量,含 INDEX\_ATTN\_MEMORY\_LIMIT 与 USE\_NEXTN\_DECODE)
- FlashMLA 官方仓库(稀疏 MLA kernel 与调度)
- DeepGEMM 官方仓库(fp8\_fp4 MQA logits 与分组 GEMM)
- DeepSeek-V2 论文(MLA 低秩投影与潜向量缓存的原始结构,arXiv:2405.04434)
- DeepSeek-V4.1-Flash-1017 模型卡
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



