


DeepInfer 源码完全拆解(二十):启动时的显存 profiling——从峰值到 KV 块数的那笔账
从第十九篇接上
第十九篇拆的是 DeepInfer 的算力账:FlopsEstimator 如何按调度长度估算一步的 FLOPs、MFU 的分母为什么乘 CP 规模、估算值如何与实测曲线对账。那篇文章回答的是「这一步理论上做了多少计算」。但对一个真的要启动的引擎来说,先要回答另一个更硬的问题:显存够不够装下权重、激活、KV 池和运行时缓冲。
这两笔账的入口不同。算力账在 Scheduler::schedule() 里顺手算完,服务于日志和性能分析;显存账发生在引擎初始化阶段,算错的直接后果是启动失败,或者在服务过程中 OOM。DeepInfer 没有把显存预算写成一组用户必须手填的参数,它选择在启动时真的跑一遍前向,量出峰值,再从总显存里把这笔峰值减掉。这套机制就是 profile_num_available_blocks()。
本篇按启动顺序拆这条链路:
- 从
LLMEngine._init_cache()看显存账在整个启动流程里的位置;为什么它必须在权重加载之后、CacheEngine初始化之前。 ModelRunner.profile_run()如何构造一组「哑序列」,让它们覆盖最长上下文、最大批量和解码形状;为什么这些序列不经过add_request(),也不进入调度器。- 峰值是怎么测量的:
mem_get_info()、max_memory_allocated()、empty_cache()各自负责什么;non_torch这一项为什么必须单独加回来。 - 从峰值到
num_gpu_blocks的减法顺序:总显存乘利用率、减峰值、减两倍状态池、除以块字节数;以及max_seq_len的 0.8 校验。 - 多卡为什么取平均块数,而不是每个 rank 各算各的;这种同构假设在什么情况下会出问题。
- DeepSeek-V4.1-Flash 的 890 字节/token 在这笔账里意味着什么;为什么它让 KV 池的容量常常不是瓶颈,而权重和运行时缓冲才是。
- 与 SGLang、TensorRT-LLM 的内存预算方式对照;最后给出启动失败时的排查顺序。
前十九篇里,整体架构与模块全景 给出了仓库地形,KV 内存与 SWA 有界重放 拆了两本块账,CUDA Graph 捕获与重放 讲了图捕获,LLMEngine 的 step 与 Worker 握手 讲了一次 step 怎么落到 GPU。这一篇补的是它们之前的那道门:在第一步 step 发生之前,引擎如何确定自己有多少显存可以花。
启动链全景
先把调用顺序摆出来。LLMEngine._init_cache() 的代码很短,但它规定了后面所有显存操作的先后:
# deepinfer/engine/llm_engine.py, LLMEngine._init_cacheself._run_workers("profile_num_available_blocks")num_gpu_blocks = self.cache_config.num_gpu_blockslogger.info(f"RANK {dist.get_rank()}, # GPU blocks: {num_gpu_blocks}")
if num_gpu_blocks <= 0: raise ValueError( "No available memory for the cache blocks. Try increasing " "`gpu_memory_utilization` when initializing the engine." )max_seq_len = int(self.cache_config.block_size * num_gpu_blocks * 0.8)if self.model_config.runtime_max_model_len > max_seq_len: raise ValueError( f"The model's runtime max seq len ({self.model_config.runtime_max_model_len}, " f"derived from max_model_len={self.model_config.max_model_len}) is larger " f"than the maximum number of tokens that can be stored in KV cache " f"({max_seq_len}). Try increasing `gpu_memory_utilization` or decreasing " f"`max_model_len` when initializing the engine." )
self._run_workers("init_cache_engine")if self.engine_type != EngineType.NORMAL: self.init_pd_split()logger.info("init_cache_engine done.")self._run_workers("warm_up_model")logger.info("warm_up_model done.")按时间顺序拆开:
| 阶段 | 已经分配的东西 | 这一步分配/测量什么 | 关键点 |
|---|---|---|---|
| 权重加载 | 模型权重、Engram 表、持久 buffer | 不测量 | 权重已经占住显存,后面的峰值包含它们 |
profile_num_available_blocks | 权重 + 运行时持久缓冲 | 临时 KV 池、哑批次激活、采样缓冲 | 用一次真实前向量峰值 |
init_cache_engine | 权重 + 持久缓冲 | 正式 KV 池、状态池 | 用上一步算出的块数分配 |
init_pd_split | 同上 | P/D 分离相关状态 | 只对 PROMPT/COMPLETION 引擎 |
warm_up_model | 权重 + KV 池 + 状态池 | CUDA Graph 私有池、图输入缓冲 | 图捕获发生在预算定完之后 |
这个顺序里有两个容易忽略的边界:
- profile 发生在正式 KV 池之前。
profile_run()自己造一个小型临时CacheEngine,跑完就释放;它测量的是「模型前向 + 临时 cache 读写」的峰值,不是「模型 + 正式 KV 池」的峰值。正式 KV 池的大小由这次测量反推出来,所以它当然不能先于测量存在。 - CUDA Graph 捕获发生在正式 KV 池之后。图捕获会额外分配私有内存池、输入输出缓冲和 NCCL 依赖;这些在
profile_run()时还不存在。gpu_memory_utilization留出的那部分余量,实际上要同时容纳图捕获和碎片。
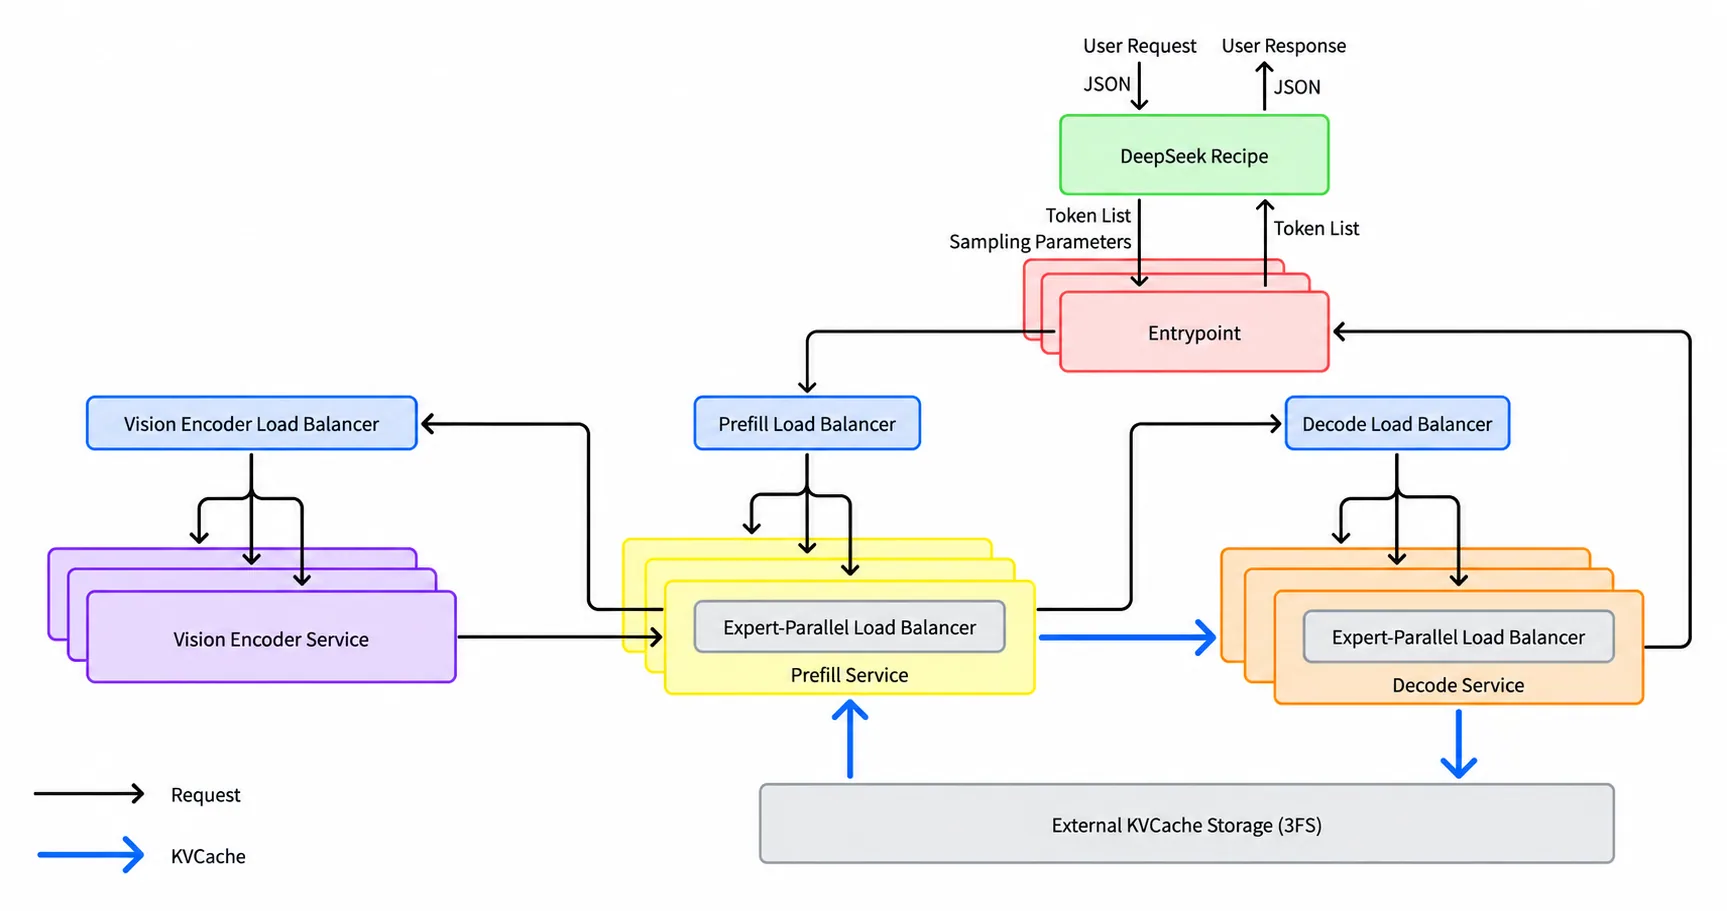
图源:DeepInfer 官方仓库 doc/images/architecture_overview.png。这张图在本系列第十九篇也出现过;这里用它定位显存账发生在哪一层:profile_num_available_blocks() 在 Worker 侧执行,CacheEngine 在它之后才被真正初始化,CUDA Graph Runner 又在 CacheEngine 之后才捕获。三者不是并行的初始化步骤,而是一条有严格先后顺序的链。
profile_num_available_blocks() 是在每个 Worker 上执行的,不是只在 driver 上算一次。原因很直接:每个 rank 的权重分片、NCCL/DeepEP 缓冲、CUDA context 开销都可能不同,显存峰值只能在本机量。量完之后,各 rank 再通过集合通信对齐块数,保证整个引擎用同一份 KV 池配置。这个对齐细节放在后面「多卡取平均」一节。
峰值里到底装了什么
在进入 profile_run() 之前,先建立一张「谁占显存」的清单。DeepInfer 的峰值至少包含五类:
- 模型权重。包括主干、MTP/DFlash、Engram 表、视觉塔;MoE 模型还有每个 EP rank 实际持有的物理专家。权重在 profile 之前就已经加载完成,所以它们会完整出现在
max_memory_allocated()里。 - 前向激活与 workspace。MoE 的 grouped GEMM workspace、DeepEP 的 dispatch/combine 缓冲、注意力 kernel 的临时张量、采样器的 logits 缓冲。它们随 batch 形状和路由分布变化,是这次 profile 真正想测的部分。
- 临时 KV 池。
profile_run()为了让 cache 读写 kernel 也走到真实路径,会按哑序列的块表分配一个小型CacheEngine。这块内存走cuMemAlloc,不计入 PyTorch 的 allocator 统计,跑完就释放。 - 非 PyTorch 持久内存。CUDA context、NCCL 通信缓冲、DeepEP 的 userbuffer、驱动/第三方库的常驻分配。它们不在
torch.cuda.memory_allocated()里,但在mem_get_info()的差值里。 - 词表矩阵这类容易被忽略的权重。DeepSeek-V4.1-Flash 的
vocab_size是 129280、hidden_size是 5120,且tie_word_embeddings: false。tok_emb与lm_head各是 的参数矩阵,BF16 下每个约 1.23 GiB,两块合计约 2.47 GiB。源码里的prepare_meta_fp8()会跳过名字含tok_emb或head的模块,所以它们不会跟随专家权重一起被 FP8/FP4 量化;VocabParallelEmbedding和ParallelLMHead也直接持有完整权重。对单个 rank 来说,这两块矩阵是峰值里实打实的一部分。
第 5 类值得单独说一句,因为它解释了一个常见的直觉偏差:权重并不只有专家层。MoE 的专家权重很大,但词表两端的两块稠密矩阵同样按 rank 复制;在 DP Attention 下,每个 DP rank 都要各自持有一份完整的 tok_emb 和 lm_head。这不是浪费,而是为了避免在采样前对 logits 做跨 rank 的 all-gather;代价是每张卡多出约 2.47 GiB 的常驻权重。这笔钱在 profile_run() 之前就已经花掉,所以会原封不动地进入峰值。
profile_run:用哑序列测出峰值
ModelRunner.profile_run() 是整个显存账的核心。它不读配置文件里的「理论显存占用」,也不靠参数量乘字节数估算,而是造一组形状最坏的 SequenceMetadata,真的跑一次前向、采样和后处理,让所有临时缓冲实际分配出来。
为什么是 SequenceMetadata,不是 Sequence
profile_run() 构造的是 SequenceMetadata,不是调度器里的 Sequence。这两个对象的职责不同:
Sequence是请求的生命周期载体,带request_id、user_id、arrival_time、sampling_params、状态机、块表、结构化输出 matcher 等;它由add_request()创建,进入 scheduler 的 waiting 队列。SequenceMetadata是一次前向的输入描述:seq_data、block_table、seqlen_q、seqlen_k、last_output_token、last_next_n_token、state_id等。调度器每步从Sequence组装出它,再交给 Worker。
显存测量只关心「这一次前向要读哪些 token、写哪些块、形状多大」,不关心请求从哪来、排队多久、有没有结构化输出。所以 profile_run() 直接跨过 add_request() 和调度器,手工拼 SequenceMetadata。这带来两个直接好处:
- 可以构造任意形状,包括「一个序列的 K 很长、其余序列的 K 很短」这种真实调度器不一定能立刻凑出的组合。
- 不会被请求校验、tokenizer、结构化输出编译、多模态预处理等路径干扰;profile 要测的是模型执行,不是请求入口。
代价是它必须自己补齐 SequenceMetadata 的所有字段。代码里几个看起来不起眼的赋值,其实都对应一个约束:
seq = SequenceMetadata( request_id=str(seq_id), seq_id=seq_id, is_prompt=is_prompt, seq_data=SequenceData(prompt_ids), compressed_seq_data=SequenceData(compressed_prompt_ids), multi_modal_data=None, sampling_params=SamplingParams(top_p=0.99, top_logprobs=20), block_table=list(range(num_blocks, num_blocks + num_seq_blocks)), seqlen_q=seq_len_q, seqlen_k=seq_len_k, last_output_token=0, last_accepted_token=[], last_next_n_token=[] if is_prompt else nextn_pad_token_id, # Unlike padding dummies, profile-run sequences need distinct writable slots. mtp_info_write_slot=seq_id + 1, state_id=seq_id % num_state_slots,)block_table是手工从num_blocks开始的连续块号,不经过BlockManager。这样 profile 的临时 cache 可以按「这些哑序列刚好需要多少块」来分配,不必预留正式池的容量。mtp_info_write_slot = seq_id + 1把 0 号槽空出来。CUDA Graph 重放时的 padding 序列会写 0 号槽,profile 的真实哑序列需要各自不同的可写槽;如果也从 0 开始,多个序列会踩同一块 MTP 元数据。这个细节在 CUDA Graph 捕获与重放 里也出现过。last_next_n_token在 decode profile 时填nextn_pad_token_id,让 MTP/DFlash 的草稿 token 也进入形状;prompt profile 时留空。state_id = seq_id % num_state_slots保证每个序列落在一个存在的状态槽里;状态槽数量来自get_num_state_slots(max_num_seqs),不一定等于max_num_seqs,取模是必要的边界保护。
prompt 形状:一条长序列加一群短序列
prompt 引擎的哑批次由 _build_prompt_profile_seq_lens() 生成。它的规则可以用三句话概括:
- 把
max_num_batched_tokens尽量平均分给max_num_seqs条序列,得到每条序列的seqlen_q。 - 把第一条序列的
seqlen_k直接拉到runtime_max_model_len,其余序列的seqlen_k先等于自己的seqlen_q。 - 如果设置了
DEEPINFER_PREFILL_MAX_SUM_SEQLEN_K,再把总 K 限制在「最小可行值」和「最大可能值」之间,多出来的 K 平均摊给其余序列。
代码里的前两步是:
profile_seq_lens_q = [ max_num_batched_tokens // max_num_seqs + (seq_id < max_num_batched_tokens % max_num_seqs) for seq_id in range(max_num_seqs)]profile_seq_lens_k = profile_seq_lens_q.copy()runtime_max_model_len = self.model_config.runtime_max_model_lenassert all(seq_len_q <= runtime_max_model_len for seq_len_q in profile_seq_lens_q)profile_seq_lens_k[0] = runtime_max_model_len这个形状是刻意做出来的「混合负载」:
- 第一条序列的
q只是平均值,但k是最大运行时长度。它模拟的是 chunked prefill 里最常见的长上下文场景:这一拍只算一小段 query,却要 attend 到全部历史 KV。注意力的 workspace 和 K 的读取量由seqlen_k决定,不是由seqlen_q决定;把k拉满,才能让长上下文注意力 kernel 的临时缓冲真正分配出来。 - 其余序列的
q = k,模拟的是短序列的整段 prefill。它们让 batch 维度、block table 的条目数、CP 切分后的行数都达到max_num_seqs量级。 - 两者的组合同时压到了「单条长序列的 K」和「多条序列的 batch」两个维度。如果只用一个均匀批次,长上下文注意力和大 batch 的 workspace 可能有一个测不到。
runtime_max_model_len 不是用户填的 max_model_len,而是加上了调度和草稿开销的上界。ModelConfig._get_runtime_max_model_len() 的定义是:
def _get_runtime_max_model_len(max_model_len: int) -> int: nextn = envs.DEEPINFER_USE_NEXTN_DECODE scheduler_overhead = nextn + (nextn + 1 if envs.DEEPINFER_ZERO_OVERHEAD_SCHEDULING else 0) draft_overhead = nextn return max_model_len + scheduler_overhead + draft_overhead按默认 nextn = 5、ZOS 开启来算,开销是 个 token。也就是说,一条标称 32768 的序列,运行时位置上界是 32784。profile 用这个上界做 k,是为了覆盖「调度器多排了几个 token、草稿又插进来几个 token」之后的最坏位置;如果只用 max_model_len,长上下文注意力的最后几个位置可能测不到。
sum-K 上限:不要让最坏形状把显存算爆
默认情况下,max_num_seqs 条序列的 K 之和可以非常大:第一条是 runtime_max_model_len,其余每条至少是 max_num_batched_tokens / max_num_seqs。如果 max_num_seqs 和 max_model_len 都很大,这个总 K 会远超真实负载,导致 profile 高估注意力 workspace,进而低估 KV 池。
DEEPINFER_PREFILL_MAX_SUM_SEQLEN_K 就是给这个总 K 设上限的。代码先算出最小值(第一条拉满、其余取 q)和最大值(每条都拉满),再把目标值夹在两者之间;多出来的 K 按剩余序列数平均分摊,每条序列最多加到 runtime_max_model_len:
min_profile_sum_seqlen_k = sum(profile_seq_lens_k)max_profile_sum_seqlen_k = max_num_seqs * runtime_max_model_lenprefill_sum_seqlen_k_limit = envs.DEEPINFER_PREFILL_MAX_SUM_SEQLEN_Kif prefill_sum_seqlen_k_limit is not None: profile_sum_seqlen_k_target = min( max(prefill_sum_seqlen_k_limit, min_profile_sum_seqlen_k), max_profile_sum_seqlen_k, ) # 把 target - min 平均摊给其余序列,每条不超过 runtime_max_model_len这里有一个取舍:这个环境变量不是「越大越安全」,而是「越接近真实负载越有意义」。设得太小,profile 测不到长上下文注意力的真实 workspace;设得太大,又会把 KV 池预算压得太低。源码在目标值被 clamp 时会打 warning,提示实际使用的值已经不等于用户给的值。
一条具体形状:以 offline 示例的配置走一遍
examples/offline_inference.py 用了一组便于本机跑的配置:max_num_seqs=4、max_num_batched_tokens=32768、max_model_len=32768。按上面的规则,q 会平均分成四条 8192;第一条的 k 拉到 32768 + 16 = 32784,其余三条的 k 仍是 8192。于是这个哑批次的形状是:
这不是一个「四条一样长」的批次,而是一条长上下文序列和三条普通序列拼在一起。它同时覆盖了:
- 单条序列 32K 上下文的注意力读取与 workspace;
- 四条序列的 block table、状态槽、MTP 写槽;
- CP 开启时,
q行数按 CP 切分后的镜像布局; - 采样器要处理的
total_q行 logits。
如果换成默认的 max_num_seqs=256、max_model_len=4096,形状会变成「256 条短序列,第一条 k 约 4112,其余每条 k 约 16」。这两种形状测出来的峰值可能相差很大,前者偏长上下文,后者偏大 batch。profile_run() 用 max_num_seqs 和 max_num_batched_tokens 而不是写死一个形状,就是为了让配置改变时,测量跟着改变。
decode 形状:1 + nextn 个 token
COMPLETION 引擎不做 prefill,它只测 decode。此时 is_prompt=False,每条序列的 q 和 k 都是 1 + nextn:
seq_len_q = 1 + self.nextnseq_len_k = 1 + self.nextnseq_data_len = seq_len_k - seq_len_q + 1nextn 来自 DEEPINFER_USE_NEXTN_DECODE,默认 5,所以 decode profile 每条序列按 6 个 token 算。这 6 个 token 对应「1 个主模型 token + 5 个草稿 token」的变长验证形状。它测的是 decode 路径上的 MoE workspace、DFlash 草稿头、采样器的 batch 维度,而不是长上下文注意力。
临时 KV 池:为什么要真的分配,还要清零
profile_run() 不是只跑模型前向。它会在跑之前按哑序列的块表分配一个小型 CacheEngine:
cache_engine = CacheEngine( cache_config, self.model.cfg, max_num_seqs, num_gpu_blocks=num_blocks)cache_engine.gpu_blocks.zero_()cache_engine.gpu_states.zero_()这两行清零不是洁癖。chunked prefill 的某些注意力路径会按 block table 做全量 gather;如果临时 cache 里是未初始化的显存,gather 可能读到 NaN 或极大值,污染注意力输出,甚至让后面的 kernel 走到异常分支。清零保证 profile 跑的是「数值上可预期」的路径,同时仍然走真实的 cache 读写 kernel,让这部分显存开销被计入峰值。
临时 cache 的块数 num_blocks 来自哑序列的 seq_len_k,不是正式池的块数;它只覆盖「这组哑序列刚好需要多少块」。源码注释明确说这块 cache 走 cuMemAlloc,不计入 PyTorch 显存统计,并且随 profile_run() 返回即释放,所以它不会污染后面的 profile_num_available_blocks() 记账。换句话说,临时 cache 的峰值被有意排除在 KV 预算之外:它只是为了测 kernel,不是正式池的一部分。
前向、采样、后处理都算
profile_run() 最后调用 execute_model_profile_run():
def execute_model_profile_run(self, seq_metadata_list, kv_caches) -> None: main_model_output = self.execute_main_model(seq_metadata_list, kv_caches) input_metadata = main_model_output.input_metadata model_output = Movable(main_model_output.model_output) del main_model_output
sampler_output = self.execute_sample( seq_metadata_list, input_metadata, model_output, kv_caches ) torch.cuda.current_stream().synchronize() self.post_process(seq_metadata_list, sampler_output, input_metadata.is_prompt)这个顺序说明 profile 测的不只是 Transformer 前向:
execute_main_model()测主干、MoE、注意力、MTP 目标层特征写入;execute_sample()测采样器:logits 的bf16_gemm_nt、温度/top-p/top-k、log-softmax、拒绝采样、结构化输出 mask;post_process()测输出回传、SamplerOutput的构造、可能的 logprobs 物化。
采样器的 logits 缓冲很容易被低估。词表 129280、total_q 是整批 query 行数时,logits 是一个 [total_q, 129280] 的 BF16/FP32 张量;即使只对选中的行算,临时 workspace 也不小。把它纳入 profile,才能让这部分内存在 KV 预算里被预留出来。
MoE 强制不均衡:1.8 倍是经验值
profile 的哑 token 是随机生成的,路由分布接近均匀。均匀路由下,每个专家分到的 token 数接近平均值,DeepEP 的 dispatch/combine 缓冲、grouped GEMM 的 workspace 都会偏小。真实请求的 token 分布很少这么均匀,热专家可能承担远高于平均的 token 数。
DeepInfer 的处理是:
envs.DEEPINFER_FORCE_IMBALANCE_RATIO = 1.8self.execute_model_profile_run(seqs, cache_engine.gpu_cache)envs.DEEPINFER_FORCE_IMBALANCE_RATIO = 0.0源码注释只说了「with MoE simulated imbalance enabled」,没有给出 1.8 的推导。合理的解释是:它把最热专家的负载抬到平均值的 1.8 倍左右,让按「每专家最大 token 数」定尺的通信/计算缓冲提前分配出来。这个系数是经验值,不是对真实流量的上界证明;如果线上路由比 1.8 更偏,profile 仍然可能低估。工程上应该把 EPLB 的负载统计和实际显存监控一起看,而不是把 1.8 当成安全保证。
MoE 的并行细节、EPLB 如何重排专家,见 MoE 专家并行与 EPLB;这里只关心它对显存峰值的影响:专家路由越集中,单卡上的临时缓冲越大。
profile_run:用哑序列测出峰值
从峰值到块数:一份预算的减法顺序
多卡取最小:为什么不能各算各的
从峰值到块数:一份预算的减法顺序
profile_run() 跑完,峰值已经产生。接下来是把峰值翻译成 KV 块数。WorkerBase.profile_num_available_blocks() 的代码可以逐行读:
# deepinfer/worker/base.py, WorkerBase.profile_num_available_blockstorch.cuda.empty_cache()torch.cuda.reset_peak_memory_stats()free_memory_pre_profile, total_gpu_memory = torch.cuda.mem_get_info()initial_torch_memory = torch.cuda.memory_allocated()
self.model_runner.set_block_size(self.cache_config.block_size)self.model_runner.profile_run(self.cache_config)
peak_torch_allocated_memory = torch.cuda.max_memory_allocated()torch.cuda.empty_cache()torch_allocated_memory = torch.cuda.memory_allocated()free_memory, _ = torch.cuda.mem_get_info()
total_allocated_memory = total_gpu_memory - free_memorynon_torch_allocated_memory = total_allocated_memory - torch_allocated_memorypeak_allocated_memory = peak_torch_allocated_memory + max(non_torch_allocated_memory, 0)
available_kv_cache_memory = ( total_gpu_memory * self.cache_config.gpu_memory_utilization - peak_allocated_memory)
cache_block_size = CacheEngine.get_cache_block_size( self.cache_config.block_size, self.model_runner.model.cfg,)state_size = math.prod( CacheEngine.get_state_shape( self.model_runner.model.cfg, self.model_config.max_num_seqs ))state_size *= 2 # state store & copy buffer, 所以要开两倍大小available_kv_cache_memory -= state_sizenum_gpu_blocks = int(available_kv_cache_memory // cache_block_size)num_gpu_blocks = max(num_gpu_blocks, 0)这段代码里有三次减法、一次乘法和一次除法,顺序不能换:
- 用
total_gpu_memory * gpu_memory_utilization得到引擎允许使用的总额度; - 减掉峰值
peak_allocated_memory; - 减掉两倍状态池
state_size; - 除以单块字节数
cache_block_size,向下取整。
写成公式是:
其中:
- 是
mem_get_info()返回的设备总显存; - 是
gpu_memory_utilization,默认 0.90,示例脚本可能用 0.85 或 0.95; - 是
torch.cuda.max_memory_allocated(),包含权重、激活、workspace 和采样缓冲; - 是
total_allocated - torch_allocated,即设备级已用显存里不由 PyTorch allocator 记账的部分; - 是
get_state_shape()的乘积,再乘 2; - 是一个 KV block 的字节数,由
block_size与每 token 的 KV 字节数决定。
为什么利用率乘的是总显存,不是空闲显存
gpu_memory_utilization 的语义是「最多允许这个引擎使用设备总显存的多少」。这和 vLLM 的 request_memory() 一致:它也是 total_memory * gpu_memory_utilization,然后和启动时的空闲显存做校验。DeepInfer 的写法更直接:预算从总显存算,不从空闲显存算;因为权重已经加载,空闲显存里已经扣掉了权重,如果再用空闲显存乘利用率,会漏掉权重这块最大的固定成本。
这个语义也解释了为什么 gpu_memory_utilization 不能设得太低。假设权重和运行时缓冲已经占了总显存的 70%,利用率设 0.75,预算只有总显存的 75%,留给 KV 和状态池的就只剩 5%;设 0.70 以下,available_kv_cache_memory 直接变成负数,块数为 0。反过来,利用率设得接近 1.0,虽然 KV 池变大,但 CUDA Graph 捕获、NCCL 缓冲增长和显存碎片就没有余量,启动后段容易 OOM。
empty_cache() 与 non_torch:两个不同世界的账
empty_cache() 在 profile 前后各出现一次,但作用不同:
- 第一次在 profile 之前:把 PyTorch 缓存分配器里暂时不用的块还给驱动,让
mem_get_info()的初始空闲值反映真实状态。否则缓存分配器占着的显存会算进「其它占用」,让non_torch偏大。 - 第二次在 profile 之后:profile 期间产生的临时激活可能已经被缓存分配器保留;先清掉再读
torch.cuda.memory_allocated(),留下的才是长期驻留的 tensor。如果不清理,non_torch会把「可复用的缓存」误当成「PyTorch 之外的占用」。
non_torch 这一项覆盖的是 PyTorch allocator 之外的世界:
- CUDA context、cuBLAS/cuDNN 的 workspace、驱动自身的分配;
- NCCL 通信缓冲、DeepEP 的 dispatch/combine 缓冲、userbuffer;
cuMemAlloc分配的 KV 池(在 profile 阶段是临时 cache,之后是正式池);- 其它进程在同一张卡上的显存占用。
最后一条是双刃剑。mem_get_info() 是设备级的,torch.cuda.memory_allocated() 是进程级的;如果同一张卡上还有别的进程,non_torch 会把别人的占用也算进来,导致峰值偏高、KV 池偏小。保守地说,这不会让引擎超分;但如果别的进程在 profile 期间释放了显存,non_torch 可能变成负数,代码用 max(non_torch, 0) 把它夹到 0。这个 clamp 只能防止记账出现负值,不能修复「测量期间别人改了显存」这个事实。生产环境应该把推理进程独占显卡,或者至少保证 profile 窗口内没有别的进程在分配/释放。
peak_torch 里有什么,没有什么
peak_torch 是 PyTorch allocator 视角的峰值,包含:
- 权重(在 profile 之前就已分配);
- 前向激活、注意力 workspace、MoE grouped GEMM workspace;
- 采样器的 logits、top-k/top-p 临时缓冲;
torch.empty一类的临时张量。
它不包含:
- 临时
CacheEngine的gpu_blocks/gpu_states,因为它们走cuMemAlloc,不在 PyTorch allocator 里; - NCCL/DeepEP 的持久缓冲,因为它们也不在 PyTorch allocator 里;
- CUDA Graph 的私有池,因为图还没捕获;
- 显存碎片造成的不可用空洞。
所以 peak_allocated_memory = peak_torch + non_torch 是一个「尽量把两个世界都算上」的近似,而不是一次完整的显存审计。它的准确性取决于三件事:profile 形状是否覆盖真实最坏情况、non_torch 是否只包含本进程、以及后续阶段(图捕获)是否还在预算内。
状态池为什么要乘 2
state_size *= 2 旁边的注释是 state store & copy buffer。DeepInfer 的状态缓存不是只有一份:一份是长期保存的状态槽,另一份是拷贝缓冲。拷贝缓冲服务于状态克隆、P/D 交接或跨拍复制;如果只按一份分配,运行时的 clone 路径会额外申请显存,破坏预算。
状态池的尺寸还与 max_num_seqs 绑定。get_state_shape(cfg, max_num_seqs) 的乘积随并发数增长,所以 max_num_seqs 不只是调度参数,也是显存参数。调低它可以给 KV 池腾出空间,但代价是并发上限下降;调高它会让状态池先吃掉预算。站内 KV 内存与 SWA 有界重放 拆过状态块的三段布局和 DEEPINFER_NUM_STATE_SLOTS_RATIO 的放大关系,这里只强调记账顺序:状态池必须在除块之前扣掉,否则块数会把状态池的钱也花掉。
max_seq_len 的 0.8 校验
块数算出来之后,_init_cache() 还会做一次校验:
并要求:
其中 是每块 token 数, 是上一步算出的块数, 是 runtime_max_model_len。这个校验回答的是:这块 KV 池能不能容纳一条最长序列,并且还留出 20% 的余量。
0.8 是硬编码的,源码没有给出推导。从效果倒推,它至少覆盖三类开销:
- 块表本身不是按「一条序列连续占满」组织的,块号可能分散;池子里需要留出分配碎片。
- 一条最长序列之外,引擎还要同时服务其它序列;如果池子刚好只够一条序列,任何并发都会触发抢占。
- 状态槽、MTP 元数据、cache 读写 kernel 的临时索引也占用同一预算的边角。
如果校验失败,启动直接报错,提示提高 gpu_memory_utilization 或降低 max_model_len。以 V4.1-Flash 的 890 字节/token 为例,一条 1M token 的序列需要约 890 MB KV;按 0.8 折算,池子至少要约 1.04 GiB 才能通过校验。这个数字本身不大,但它是「单条序列」的下限,不是「整个服务」的推荐容量。
一个示例账本
为了把减法顺序走通,下面用一组假想的数字演示,不是任何实测结果:
| 项目 | 符号 | 示例值 |
|---|---|---|
| 设备总显存 | 180 GiB | |
| 利用率 | 0.90 | |
| 预算 | 162 GiB | |
| PyTorch 峰值 | 68 GiB | |
| 非 PyTorch 占用 | 6 GiB | |
| 峰值合计 | 74 GiB | |
| 状态池 ×2 | 12 GiB | |
| KV 可用 | GiB |
如果每 token 是 890 字节,块大小按 128 token 算,单块约 111.25 KiB,76 GiB 可以切出约 71.6 万个块,对应约 9170 万 token 的 KV 容量。这个结果说明:在 890 字节/token 的模型上,KV 池通常不是最先见底的那一项;权重、激活、状态和图捕获才是。也正因如此,max_seq_len 校验和 gpu_memory_utilization 的选择,往往比「KV 池能装多少 token」更影响能不能启动。
多卡取平均:为什么不是各算各的
单卡的块数算完,还不算结束。DeepInfer 的每个 Worker 都执行了同一段 profile_num_available_blocks(),但每个 rank 的显存状况可能不同:EP rank 持有的物理专家数可能因为冗余专家而不同,CP rank 的注意力元数据不同,driver rank 还多一份采样/结构化输出侧的开销。各 rank 算出的 num_gpu_blocks 不能各用各的,否则同一份 block_table 在不同 rank 上会指向不同的物理块。
对齐代码是:
num_gpu_blocks = torch.tensor( num_gpu_blocks, device="cuda", dtype=torch.int64)dist.all_reduce( num_gpu_blocks, op=dist.ReduceOp.SUM, group=PG.world_group())num_gpu_blocks = ( num_gpu_blocks.item() // PG.world_group().size() // 2 * 2)self.cache_config.num_gpu_blocks = num_gpu_blocks拆开看:
- 把本 rank 的块数放到 GPU 上,做一次
SUMall-reduce; - 除以 world size,得到所有 rank 的算术平均;
- 再除以 2 取整、乘 2,向下对齐到偶数。
这不是「取最小」,也不是「取最大」,而是「取平均」。这个选择背后有一个明确的同构假设:同一引擎实例内的所有 rank 应该有相同的模型足迹和相近的运行时缓冲。在 EP/DP 都按对称方式切分、所有卡型号相同、没有别的进程干扰时,各 rank 的空闲显存差异主要来自分配时序和碎片;取平均比取最小更能避免某个瞬时低值把整池容量拖小。
平均的代价也很直接:如果某个 rank 真的比别人少了一大块显存(同卡上有别的进程、某个 rank 多加载了一张 Engram 表、或者 CP rank 0 多出采样缓冲),平均块数会让这个 rank 超分。init_cache_engine 在那个 rank 上分配正式池时就可能 OOM。DeepInfer 没有在代码里对这个情况做额外兜底,工程上要靠独占显卡、统一模型分片、监控每卡显存来保证同构。多租户或混部环境下,这一点比单机跑 benchmark 重要得多。
偶数对齐的动机,源码没有注释。从下游看,块号会进入 block_table、KV store 的落盘边界和状态池的索引;偶数对齐至少让块数在成对分配/对齐时不会出现半个块。这里只能确认「代码要求偶数」,不能把「为什么是偶数」讲成某个确定的硬件约束。
还有两个边界值得记住:
- 如果平均块数是 1,
// 2 * 2会把它变成 0,随后num_gpu_blocks <= 0的检查直接报错。也就是说,平均只剩一块在 DeepInfer 里等价于没有可用 KV 池。 - 如果某个 rank 的块数远高于其它 rank,平均会被拉高;如果远低于,平均会被拉低但不会低到该 rank 的真实值。两种方向都不是严格的安全值,只是同构假设下的折中。
缓存引擎落地:一次记账两次写入
预算算完,init_cache_engine 才真正分配 CacheEngine。CacheConfig 里此时已经有:
num_gpu_blocks:上一步对齐后的块数;bytes_per_block:单块字节数;num_state_seqs:状态槽数量;bytes_of_state_per_seqs:每个状态序列的字节数。
CacheEngine 用这些数字一次性分配主 KV 池和状态池。之后 Scheduler 通过 BlockManager(cache_config.num_gpu_blocks) 管 KV 块,通过 BlockManager(cache_config.num_state_seqs) 管状态槽;两本账各自独立,块号不会混用。这个分工在 整体架构与模块全景 和 KV 内存与 SWA 有界重放 里已经拆过,这里只补启动顺序上的含义:预算阶段的 state_size 减法,和 init_cache_engine 里的状态池分配,是同一笔钱的两个阶段。前者是预留,后者是实际支出;如果预留算少了,后者会把 KV 池的空间挤掉;如果预留算多了,KV 池会不必要地变小。
block_size 也不是随手设的。EngineArgs.create_engine_configs() 会先从模型元数据里取 resolved_tokens_per_block,再把它传给 CacheConfig;如果用户显式给了 tokens_per_block,代码只做一次 assert 校验,不匹配就报错:
model_metadata = ModelMetadata(model_config.model_cfg.gpt)resolved_tokens_per_block = model_metadata.resolved_tokens_per_blockif self.tokens_per_block != -1: assert resolved_tokens_per_block == self.tokens_per_block, ( f"{resolved_tokens_per_block=}, {self.tokens_per_block=}" )cache_config = CacheConfig( resolved_tokens_per_block, self.gpu_memory_utilization, self.lookahead_tokens,)这意味着 block size 是模型布局的函数,不是性能调优旋钮。V4.1-Flash 的压缩 KV、SWA cache、index cache 都按同一套块布局组织;改块大小会改变 cache_block_size、状态块边界和落盘粒度,不能只看「块大一点是不是碎片少一点」。
init_pd_split() 只在 engine_type != NORMAL 时执行,位于 init_cache_engine 之后。它不改变 KV 块数,但会决定 P/D 两侧如何交接状态;warm_up_model() 则在这个顺序的最后,负责 CUDA Graph 捕获和(MTP VARLEN 开启时的)decode 性能曲线测量。图捕获的内存不在 profile_run() 的峰值里,这一点下一节单独说。
890 字节/token 在这笔账里
DeepSeek-V4.1-Flash 的技术报告给了一个很醒目的数字:全局 KV cache 每 token 890 字节,约为 V4-Flash 的 1/4。技术报告的 Figure 1(b) 把几代模型的 per-token KV 放在同一张图里:
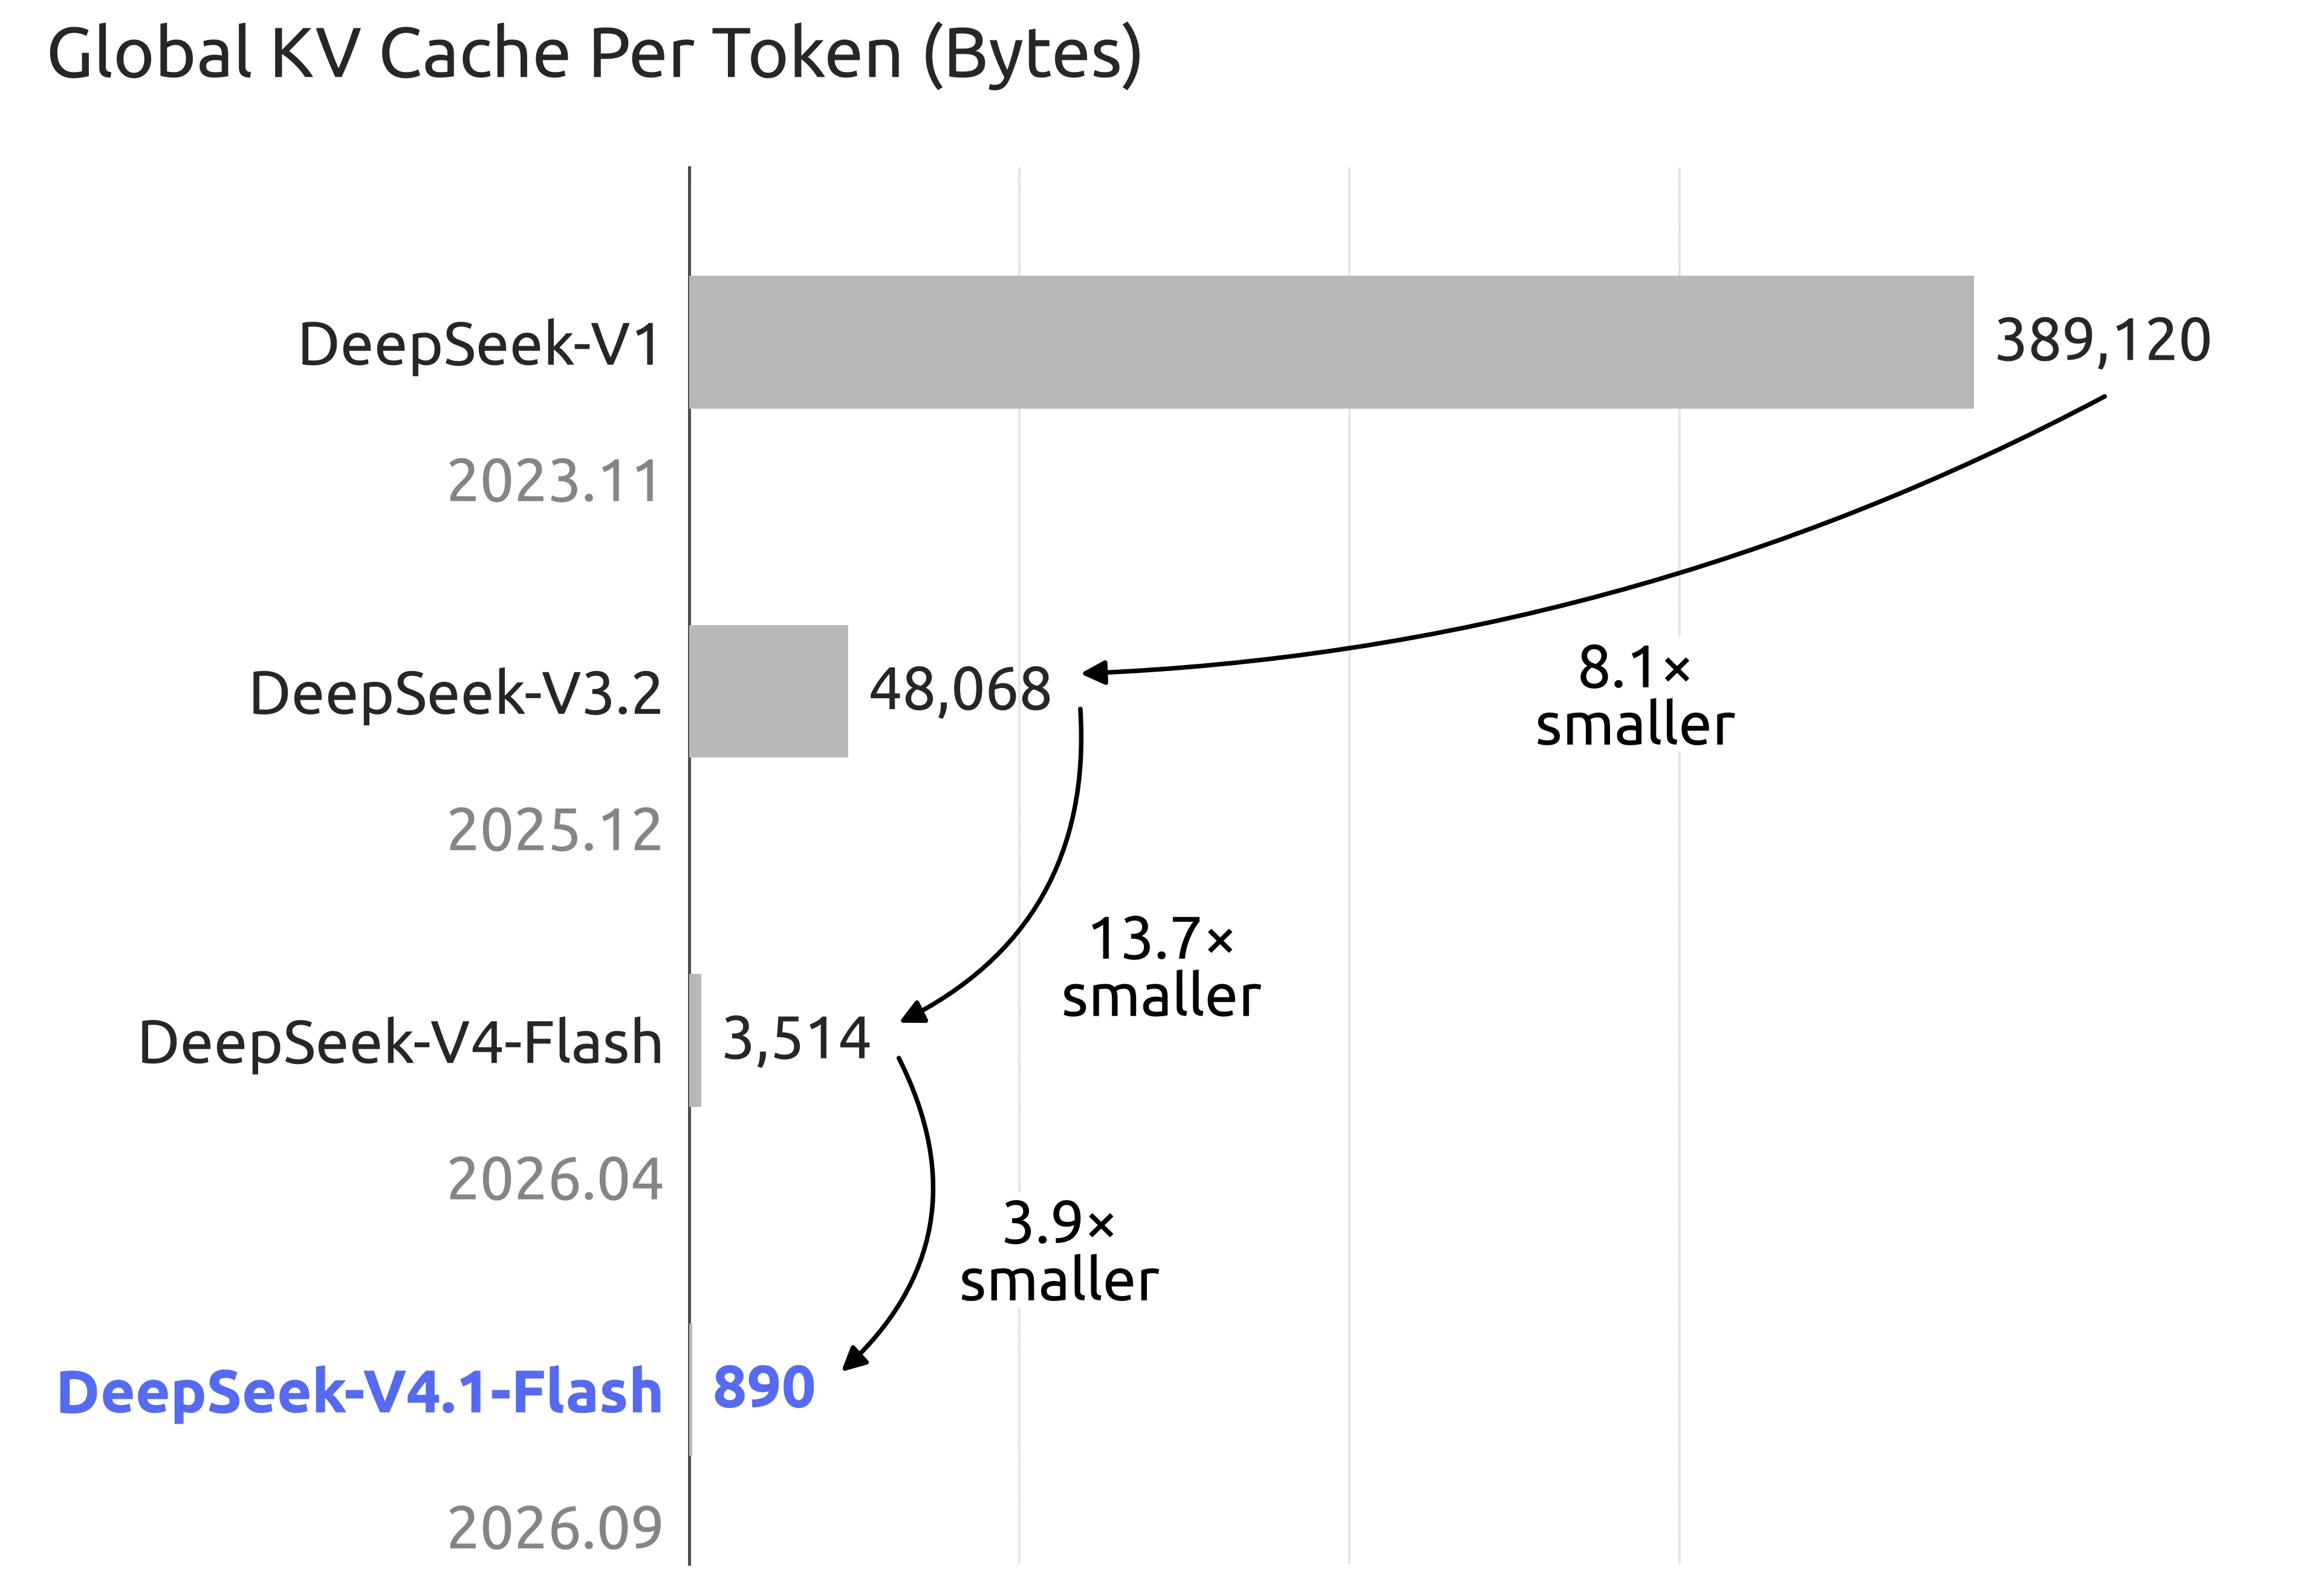
图源:DeepSeek-V4.1-Flash 技术报告 Figure 1(b),PDF。横轴是模型代际,纵轴是每 token 的全局 KV 字节数;从 V1 到 V4.1-Flash,累计缩小约 437 倍。这个数不是「每层每头」的 KV,而是把所有层、所有缓存加总后摊到每个 token 上的全局值。
站内 DeepSeek-V4.1-Flash 推理侧完全拆解 已经把 890 字节的来源拆开:CSA2 的跨层 KV 复用把多层 KV 压成少量共享 latent,FP4 KV caching 再把每个元素的位宽压到 4 bit。这里关心的是它对启动账本的影响:
- 一条 32K token 的序列,KV 约 MB;
- 一条 1M token 的序列,KV 约 890 MB;
- 一个 128-token 的块,KV 约 111.25 KiB;
- 1 GiB 的 KV 池,按 890 字节/token 算,约能装 120 万 token。
和传统的 MHA 模型相比,这个量级让「KV 池容量」很难成为第一瓶颈。以 180 GiB 级显卡、0.90 利用率为例,即使权重和运行时缓冲吃掉 70–80 GiB,剩下的几十 GiB 也能装下数千万 token 的 KV。真正容易把预算吃掉的,是:
- 权重本身,尤其是按 rank 复制的
tok_emb/lm_head和 EP 物理专家; - MoE 的 grouped GEMM / DeepEP workspace;
- 状态池(×2);
- CUDA Graph 捕获的私有池;
- 多卡平均时某个 rank 的额外占用。
这也解释了为什么 profile_run() 要跑「一条长序列 + 一群短序列」,而不是只按 890 字节/token 乘一下。KV 本身很便宜,但读 KV 的注意力 kernel、写 KV 的 cache kernel、MoE 路由的 workspace 并不便宜——这些临时缓冲的形状由 batch、K 长度、路由分布决定,必须实测。890 字节/token 让预算的分子变小,但没有让 profile 变得不必要。
与 SGLang、TensorRT-LLM 的对照
DeepInfer 的这套启动账不是凭空设计的。它和 vLLM 有直接的代码血缘:profile_num_available_blocks() 这个函数名、gpu_memory_utilization 的语义、mem_get_info 与 max_memory_allocated 的组合,都能在 vLLM 的 determine_available_memory() 里找到对应。和另外两个框架对照,可以看出它保留了哪些、改掉了哪些。
和 vLLM:同一套记账,多了状态池和平均对齐
vLLM V1 的启动账是:
# vllm/v1/worker/gpu_worker.py, determine_available_memoryself.model_runner.profile_run(randomize_inputs=self.randomize_dummy_inputs)...self.available_kv_cache_memory_bytes = ( self.requested_memory - profile_result.non_kv_cache_memory - cudagraph_memory_estimate_applied)其中 requested_memory 来自 request_memory():
requested_memory = math.ceil( init_snapshot.total_memory * cache_config.gpu_memory_utilization)三者的共同点是:
- 都按「设备总显存 × 利用率」给出预算,而不是按空闲显存;
- 都用一次真实 profile run 测峰值;
- 都区分 torch 内与 torch 外的占用。
DeepInfer 多了两处:
- 状态池要单独减掉,而且乘 2。vLLM 的模型不需要第二本状态账,它的 KV cache 就是主池;DeepInfer 的状态槽独立于 KV 块,必须在除法之前扣。
- 块数在 world group 上取平均并对齐偶数。vLLM 也会把各 worker 的容量收敛成一份所有 worker 都能用的配置;DeepInfer 的写法是
SUM // size // 2 * 2,这个平均语义意味着它假设各 rank 同构。
vLLM 提供了 profile_cudagraph_memory();在开启图显存估算时,它会把估算值从 KV 预算里扣掉;DeepInfer 的 profile_run() 不包含图捕获,图捕获发生在 warm_up_model 阶段,余量靠 gpu_memory_utilization 里的未用部分承担。这是两者在「预算时点」上的一个实际差异:vLLM 把图的账提前算进预算,DeepInfer 把它留给运行时余量。
vLLM 的 KV 池还有一层 DeepInfer 没有的分组抽象。下图来自 vLLM 的 hybrid KV cache manager 文档:每一行是一个 KVCacheTensor,对应一组共享同一 page size 的层,例如 full attention 层与若干 sliding-window 层;这些 group 从同一个 block 号空间里取块,斜线区表示该 group 当前未被分配的尾部。
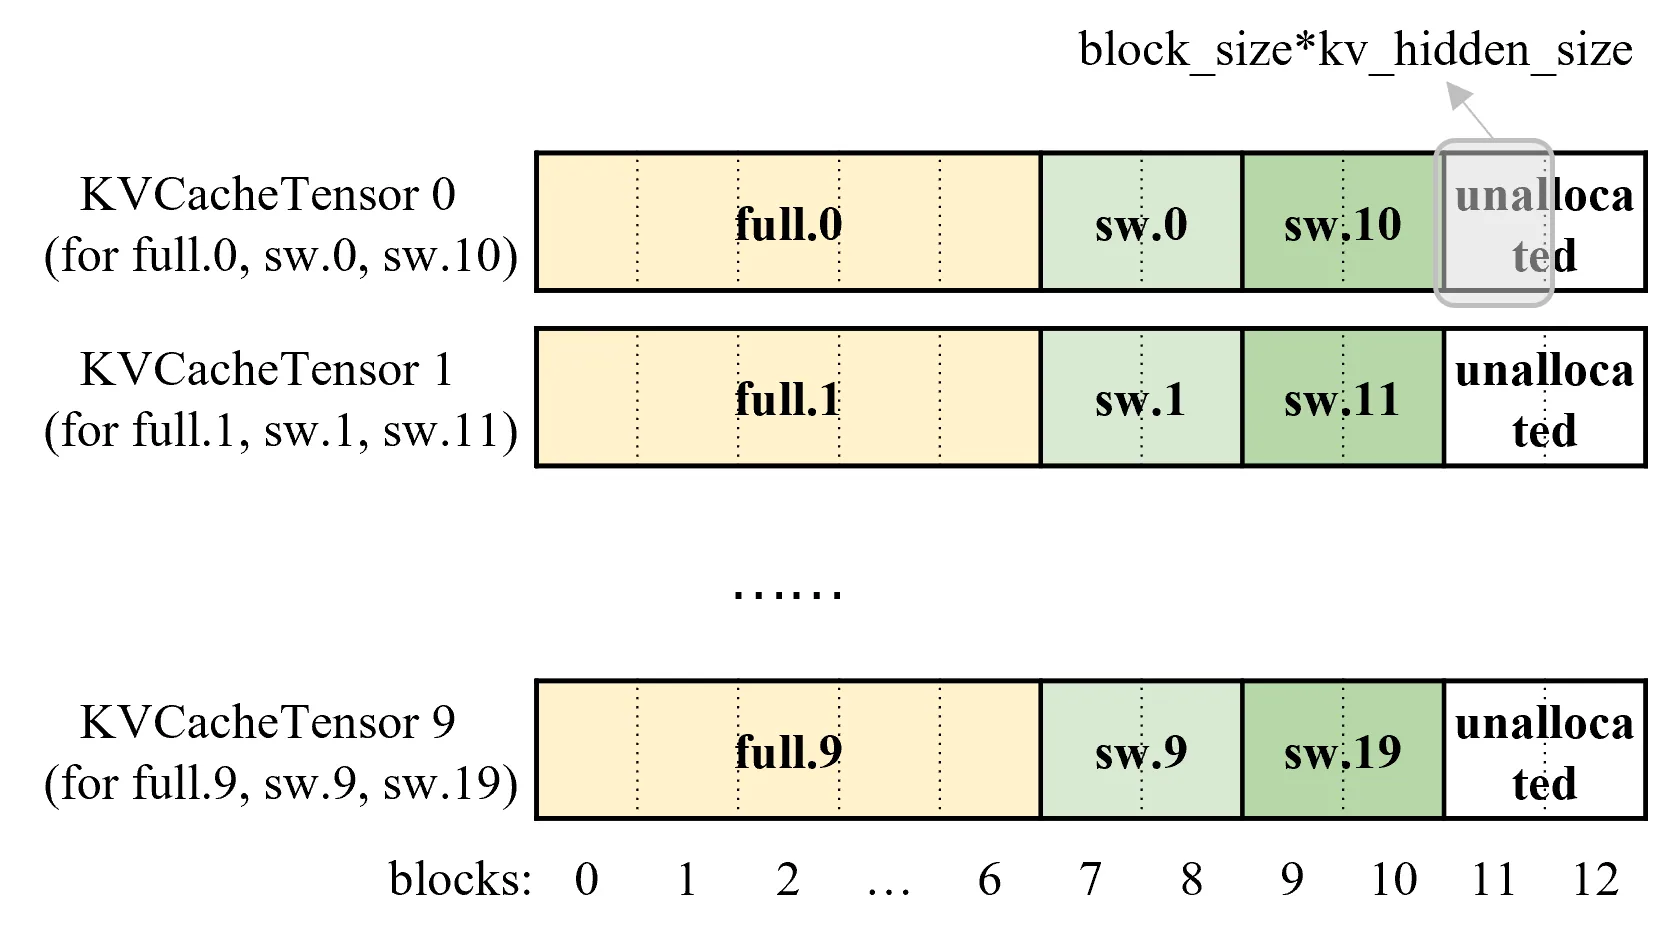
图源:vLLM 官方文档 docs/assets/design/hybrid_kv_cache_manager/memory_layout.png。这张图说明的是 vLLM 的「分组 + 共享块池」抽象:不同层只要 page size 兼容,就可以从同一块号空间里分配。DeepInfer 的账本不是这种按 group 拼层的组织,它把主 KV 池、SWA/index 相关缓存与状态池分开记;分账的目的是让状态槽和 KV 块解耦,而不是让所有层共享同一张块表。两种组织方式解决的是不同问题,不能直接比谁的「内存利用率更高」。
和 SGLang:静态比例 vs. 实测峰值
SGLang 的显存管理走的是另一条路:用 mem_fraction_static 作为静态显存比例,在模型 runner 初始化时计算 KV 池的可用 token 数,再把剩余部分留给动态激活和临时缓冲。对比之下:
| 维度 | DeepInfer | SGLang(静态比例) |
|---|---|---|
| KV 容量依据 | 实测峰值 + 减法 | 总显存 × 静态比例 − 非 KV 静态占用 |
| 对临时激活的覆盖 | profile 时实际分配 | 依赖比例余量 |
| 失败方式 | 启动时块数 ≤ 0 或 max_seq_len 校验失败 | 初始化时可用 token 不足 |
| 多卡一致性 | 平均块数 | 各 rank 按同一比例 |
SGLang 的静态比例把「KV 池能占多少」直接写成一个比例,优点是启动快、行为可预测;缺点是比例不随模型结构自动变化。DeepInfer 的实测峰值自动包含模型特化部分(Engram、索引器、状态池),代价是启动慢,而且测量窗口里如果其它进程在动显存,测量就不准。
站内 SGLang 源码完全拆解(十五):内存池与显存管理 拆过 SGLang 的 ReqToTokenPool、KVPool 与 allocator 如何记物理账;可以对照着看两边对「物理账」的切分方式。
和 TensorRT-LLM:预算是配置推导,不是实测
TensorRT-LLM 的 KV 容量由 max_tokens、max_gpu_total_bytes 等配置推导,并在 profiling 之后做一轮显式预留(多模态编码器、workspace、惩罚表等)。它的预算更像「配置 + 已知项」,而不是「跑一遍量峰值」。DeepInfer 的选择正好相反:让最坏形状自己去分配,再把测出来的值反推成块数。
三种方式没有绝对优劣:
- 配置推导快、可复现,但漏掉某一类临时缓冲时只能靠显式预留补;
- 实测峰值覆盖未知项,但测量窗口受环境影响,且形状选择决定测到多少;
- 静态比例最简单,但对模型特化的部分不敏感。
DeepInfer 之所以能选择实测,是因为它只服务 V4.1-Flash 这一族模型:模型结构已知、状态池和索引器的开销已知,最坏形状可以手工构造。通用框架要覆盖几百种模型,很难为每种模型都写一个精确的 profile 形状。
工程边界与排查
把这条链上的边界列出来,比抽象原则更有用。
启动失败的三类报错
No available memory for the cache blocks。说明 ,即预算在减掉峰值和状态池之后已经没有余量。排查顺序:先看权重和非 torch 占用是否偏高(是否多加载了东西、是否有别的进程占卡),再看状态池是否过大(max_num_seqs是否设得过高),最后才考虑调高gpu_memory_utilization。直接调高利用率可能只是把 KV 池从负数拉到接近零,随后在max_seq_len校验或图捕获时再次失败。runtime max seq len ... larger than the maximum number of tokens that can be stored in KV cache。说明块数非零,但block_size × num_gpu_blocks × 0.8小于runtime_max_model_len。这时 KV 池能装的总 token 不够一条最长序列。要么提高利用率,要么降低max_model_len。注意runtime_max_model_len比max_model_len多出nextn相关的十几个 token,报错里的两个数字不要混淆。init_cache_engine/warm_up_model阶段 OOM。预算算出来了,但实际分配失败。常见原因是多卡平均把某个 rank 的块数抬高了,或者 CUDA Graph 捕获超出了余量。排查时分别看:每个 rank 打印的# GPU blocks是否一致、图捕获阶段是否有额外的显存峰值、是否开了过多的图尺寸桶。
测量窗口的污染
profile_run() 依赖 mem_get_info() 和 max_memory_allocated() 的差值。下面这些情况会让差值失真:
- 同卡上还有别的进程在分配/释放显存:
non_torch把别人的占用算进来,或者在别人释放时变成负数(被 clamp 到 0)。 - 第一次
empty_cache()之前缓存分配器里有大块可复用内存:mem_get_info()的空闲值偏低,但这部分会被torch_allocated抵消一部分,影响取决于碎片形态。 - 临时
CacheEngine走cuMemAlloc,它的峰值在mem_get_info()差值里,但不在max_memory_allocated()里;如果它还没释放,non_torch会把它算成本进程占用。源码注释说明它随profile_run()返回即释放,所以正常情况下不会进入最终账。 - 其它 rank 的 NCCL 通信在 profile 期间分配缓冲:这些缓冲与 profile 的形状有关,可能让某个 rank 的
non_torch偏高。
DeepInfer 没有对「其它进程」做显式检测;它靠的是用户独占显卡。生产部署里,把推理进程和监控/训练进程放在同一张卡上,是最常见也最难排查的预算失真来源。
形状选择的影响
profile_run() 测的是形状的函数。下面几项改一个,测出来的峰值就可能明显不同:
| 参数 | 影响 |
|---|---|
max_num_seqs | 状态池大小、batch 维度、block table 条目数 |
max_num_batched_tokens | 每条序列的 seqlen_q、sum-K 下限 |
max_model_len | 第一条序列的 seqlen_k、runtime_max_model_len |
DEEPINFER_PREFILL_MAX_SUM_SEQLEN_K | 总 K 上限,影响注意力 workspace |
DEEPINFER_USE_NEXTN_DECODE | decode profile 的 1 + nextn、runtime_max_model_len 的开销 |
DEEPINFER_FORCE_IMBALANCE_RATIO | MoE workspace 的模拟不均衡程度 |
离线示例用 max_num_seqs=4 跑得动,不代表生产用 max_num_seqs=256 时同样的预算还成立;反过来,生产设了很大的 max_num_seqs,状态池和 batch 维度会先把预算占掉。调这些参数时,应该同时看启动日志里的 peak、non_torch、state_size、kv_cache_size 四个数,而不是只看最终块数。
CUDA Graph 的余量
warm_up_model 里的图捕获不在 profile 峰值里,但会真实占显存。工程上要留多少,取决于:
- 图尺寸桶的数量与最大尺寸(
build_graph_batch_sizes的幂次段 + 定宽段); - DFlash 的独立图;
- NCCL 在图里的依赖缓冲。
站内 CUDA Graph 捕获与重放 里提到,图捕获阶段的峰值可能高于运行时,而且图池一旦捕获就常驻。DeepInfer 因此把 gpu_memory_utilization 的未用部分当作图与碎片的余量;利用率设得越接近 1,这部分余量越少。遇到图捕获 OOM,优先调低利用率或减少桶,而不是去改 profile 逻辑。
一个可复现的启动检查清单
启动一个 DeepInfer 实例之后,按下面顺序读日志:
Memory profiling results: duration=..., total_gpu_memory=..., initial_memory_usage=..., initial_torch_memory=...:看 profile 开始前的初始占用,判断权重加载是否正常。peak_torch_memory=...:和模型参数量对得上吗?如果明显偏高,先怀疑 profile 形状或 MoE 不均衡系数。non_torch_memory=...:是否超过预期?超过说明有别的进程或通信缓冲常驻。state_size=...:和max_num_seqs一起看;状态池过大时先调并发,而不是调利用率。kv_cache_size=...:这是除块之前的可用 KV 字节数。RANK ..., # GPU blocks: ...:多 rank 之间是否一致;不一致说明同构假设被破坏。- 图捕获与 warmup 是否成功;失败说明余量不足。
小结
DeepInfer 的启动显存账可以压缩成一句话:用最坏形状跑一遍前向,量出峰值,再用「总显存 × 利用率 − 峰值 − 两倍状态池」除以单块字节数,得到 KV 块数。围绕这句话,本篇拆了五个环节:
- 测量时点:发生在权重加载之后、正式 KV 池之前;图捕获在预算定完之后的
warm_up_model里,靠利用率余量覆盖。 - 测量形状:prompt 是「一条长 K 序列 + 一群短序列」,decode 是「1 + nextn」;
runtime_max_model_len带上调度与草稿开销;sum-K 有上限;MoE 强制 1.8 倍不均衡。 - 测量口径:
peak_torch + max(non_torch, 0);empty_cache两次,分别清理前向前后缓存分配器的残留。 - 减法顺序:先乘利用率、再减峰值、再减两倍状态池、最后除块;之后有
max_seq_len × 0.8校验。 - 多卡对齐:
SUM // world_size // 2 * 2,取平均、对偶数;同构假设成立时安全,不成立时会超分。
890 字节/token 让 V4.1-Flash 的 KV 池容量通常不是瓶颈,但它没有让 profile 变得不必要:权重、MoE workspace、状态池、CUDA Graph 才是启动账里的大头。理解这条链,才能在启动失败时判断是形状问题、预算问题,还是多卡不同构的问题。
本系列的下一篇计划拆 Engram 之外的「首 token 成本」:从请求进入引擎到第一次采样,tokenizer、压缩 tokenizer、多模态预处理与结构化输出编译各自在哪一段耗时,以及哪些环节被挪到了异步路径上。
参考资料
- DeepInfer 官方仓库(README 与功能清单)
- DeepInfer 示例与 benchmark 口径说明
- DeepInfer llm_engine.py 源码
- DeepInfer worker/base.py 源码(profile_num_available_blocks)
- DeepInfer worker/model_runner.py 源码(profile_run)
- DeepSeek-V4.1-Flash 技术报告(KV cache 压缩与 890 字节/token)
- DeepSeek-V4.1-Flash 模型卡(配置与采样参数)
- vLLM gpu_worker.py(determine_available_memory)
- vLLM worker/utils.py(request_memory 的利用率语义)
- vLLM 文档:Conserving Memory
- vLLM 文档:KV Cache 设计
- vLLM hybrid KV cache manager 内存布局图
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



