


前缀共享的扇出难题:同前缀请求同时涌入时,KV Cache 复用的账怎么记
前缀缓存(prefix caching)是当前推理框架里性价比最高的优化之一:只要两个请求的开头 token 序列一模一样,第二个请求就完全不必重算这段前缀,直接从 KV Cache 里把已经算好的 Key/Value 读出来接着往下解码。工程上,它把多轮对话、RAG 固定文档、system prompt、Agent 系统提示词这些场景的 TTFT 砍掉一大截。
但把它放进真实服务里,最麻烦的时刻不是「没有命中」,而是命中的那一瞬间有一大批请求同时到达。一个热门前缀被 N 个并发请求同时命中,会发生什么?这 N 个请求读到的是同一份 KV 吗?如果其中一个要往后写、其余只读,怎么保证不出错?内存不够时,这段被共享的 KV 能不能被淘汰?淘汰了正在读它的请求怎么办?如果请求分散在集群的不同 GPU 上,又该谁来决定”去命中它的那张卡”还是”就近重新算一遍”?
这一篇就专门拆这件事——前缀共享的扇出(fan-out):一份 KV 被多个并发请求同时引用的那段时间里,引用计数、写时复制、前缀树锁与淘汰策略如何共同保证正确性与利用率。
一、先把问题定义清楚:什么是扇出
1.1 三种前缀共享场景
“共享前缀”听起来是一件事,实际上至少有三类,它们的生命周期完全不同:
第一类是同一请求内部的并行采样(parallel sampling)。一个请求要求生成 条回答, 条序列共享同一段 prompt 的 KV,只在生成阶段分叉。这是最经典的场景,PagedAttention 论文在 2023 年把它作为首要案例(SOSP 2023,Efficient Memory Management for Large Language Model Serving with PagedAttention)。
第二类是搜索类解码。Beam search 的 个候选、树状投机解码的多个枝干,它们的 KV 是从同一段历史里长出来的,分支之间共享大量前缀节点。
第三类是跨请求的系统级前缀缓存。这是扇出最剧烈的一类:不同用户、不同会话的请求,因为用了同一个 system prompt、同一份 RAG 文档、同一套 Agent 工具定义,prompt 的前几千个 token 完全相同。SGLang 的 RadixAttention 和 vLLM 的自动前缀缓存(APC)处理的都是这一类。
前两类共享是同一时刻、由同一个调度单元控制的,共享关系在解码过程中自然演化。第三类共享是异步、跨请求、由缓存命中发现的:请求 A 在昨天写下的 KV,今天被请求 B、C、D 同时命中。扇出问题真正棘手的地方在这里。
1.2 为什么”扇出”才是难点
假设一个 8K token 的 system prompt 被缓存住了,block size 为 16,那么它对应 512 个物理块。现在同时来了 64 个共享这段前缀的请求。朴素实现有两个极端:
- 极端一:命中即拷贝。 每个请求都复制 512 个块给自己用。省下了计算,但瞬间多占 个块的显存,往往直接把显存打爆——省了算力,亏了容量,甚至比不缓存更糟。
- 极端二:完全共享,谁都能写。 所有请求都指向同一批物理块。但 KV Cache 是追加写的结构:每个请求解码时要往自己的 KV 序列末尾写入新的 Key/Value。如果两个请求写到同一个物理块里,第 17 个 token 就会互相覆盖。
真实的系统必须在两者之间取一个精确的中间点:前缀部分共享只读,分叉部分各写各的。这条界线的位置、界线两侧的记账方式,构成了本文的全部内容。
1.3 三个必须回答的问题
把上面的分析收敛一下,扇出场景下系统必须回答三个问题:
- 归属:一块物理 KV 被 个请求引用时,它是谁的?谁能释放它?(第三章)
- 写入:当某个引用者要往这块 KV 里追加数据时,怎么保证不污染其他引用者?(第四章)
- 淘汰:内存紧张时,被引用的块能不能被换出去?换出去之后正在读它的请求怎么办?(第六章)
这三个问题在操作系统里都有成熟的答案——引用计数、写时复制、页锁——而 LLM 推理系统在 2023 到 2026 年间,几乎是把操作系统那套内存管理机制在 KV Cache 上重演了一遍,并在重演中补上了两个操作系统没有的新约束:块是追加写的,以及块的内容是”计算”出来的,重算代价极高。
二、归属模型:一块 KV 属于谁
2.1 PagedAttention 的答案:块表 + 引用计数
PagedAttention 的核心设计是把 KV Cache 切成固定大小的物理块(block),每个请求维护一张逻辑块到物理块的映射表(block table),不同请求的同一逻辑块可以指向同一个物理块。下图是原始论文给出的并行采样示意,可以看到两个序列的 block table 前几项指向完全相同的物理块,只在最后一个逻辑块上分家:
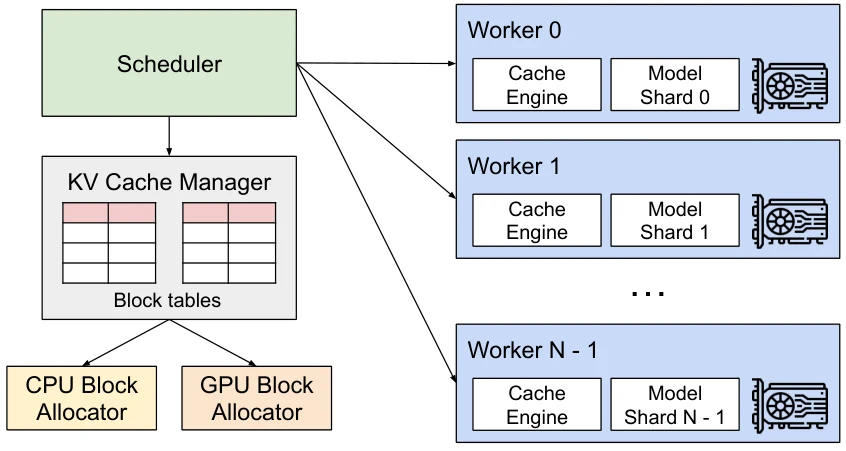
图片来源:vLLM 论文(SOSP 2023)arXiv:2309.06180 图 4 系统总览。
论文对引用计数的描述很直接:每个物理块维护一个引用计数,当计数大于 1 时,说明有多条序列在看同一份数据。论文给出的例子里,物理块 7 和 1 的引用计数都是 2。
引用计数的语义非常干净,一句话就能说清:
物理块的生命周期 = 引用计数归零的那一刻。
- 请求命中前缀缓存,把它命中的块挂进自己的 block table,每个块
ref_cnt += 1; - 请求结束或撤回,把自己的块逐个释放,每个块
ref_cnt -= 1; ref_cnt降到 0 的块不再被任何请求引用,可以立即被下一个请求复用;- 只要
ref_cnt > 0,这块 KV 物理上还存在、内容还有效,谁都不能覆盖它。
这套规则的妙处在于它同时解决了”容量”和”正确性”两件事:共享带来容量收益(64 个请求只占 512 个块而不是 32768 个),引用计数保证正确性(没人释放还在被读的块)。
2.2 vLLM V1 的实现:ref_cnt 在块元数据里
在 vLLM 当前的 V1 引擎里,这套记账落在 KVCacheBlock 这个结构上(vllm/v1/core/kv_cache_utils.py):
class KVCacheBlock: """KV-cache block metadata.""" # Block ID, ranging from 0 to num_gpu_blocks - 1. block_id: int # Reference count. ref_cnt: int = 0 # The hash key (block hash + group id) of the block, only available # when the block is full and cached. _block_hash: BlockHashWithGroupId | None = None # Used to construct a doubly linked list for free blocks. prev_free_block: "KVCacheBlock | None" = None next_free_block: "KVCacheBlock | None" = None注意三件事:
第一,ref_cnt 是块自己的属性,不是请求的属性。这很关键——共享关系是”多对一”的,把计数放在”一”这一侧,任何时刻问”这块还有人用吗”都是一次 查询。
第二,_block_hash 只在块写满并提交进前缀缓存之后才有值。一个块被创建出来、只写了一半内容时,它是”私有”的,没有任何人会命中它。
第三,块同时挂在三个结构上:请求的 block table(逻辑映射)、cached_block_hash_to_block(前缀缓存哈希表)、空闲块双向链表(FreeKVCacheBlockQueue)。一块 KV 在系统里同时是”某人的内存”、“某个哈希的缓存”和”候选的淘汰对象”,这三个身份必须保持一致,扇出的所有 bug 都出在身份转换的时刻。
2.3 命中时发生了什么:touch 与 free 的对称性
请求命中前缀缓存时,vLLM 会调用 BlockPool.touch()。这个函数短得可以整段贴出来,但它精确地刻画了”扇出的那一瞬间”:
def touch(self, blocks: Sequence[KVCacheBlock]) -> None: """Touch a block increases its reference count by 1, and may remove the block from the free queue. This is used when a block is hit by another request with the same prefix. """ for block in blocks: if block.is_null: continue # ref_cnt=0 means this block is in the free list (i.e. eviction # candidate), so remove it. if block.ref_cnt == 0: self.free_block_queue.remove(block) block.ref_cnt += 1这里的 if block.ref_cnt == 0: self.free_block_queue.remove(block) 是整个扇出机制里最容易被忽略、却最关键的一行。
回忆一下淘汰流程:一个请求结束,它持有的块 ref_cnt 降到 0。如果开启前缀缓存,这个块不会立刻被复用,而是被挂到空闲队列的尾部(后进后出的 LRU 语义),随时等着被某个新来的、前缀匹配的请求重新”拾起”。也就是说,“ref_cnt == 0 的块”有两种状态:还在队列里等着被复用,或者已经被分配出去、内容已经作废。
当一个请求命中这块 KV 时,它必须把块从空闲队列里摘出来,否则后续的分配会把这个块发给别的请求并覆写内容——而命中者手里还攥着指向它的 block table 条目。touch 的第一行是这个摘除动作,第二行才是计数加一。顺序不能颠倒:先摘除,再计数,中间不能有别的分配插入。
释放侧是对称的。BlockPool.free_blocks() 处理一批要释放的块,它把块分成两类:
block.ref_cnt -= 1if block.ref_cnt == 0: if block.block_hash is None or not self.enable_caching: # LIFO reuse of non-cached blocks for better GPU locality. blocks_to_evict_first.append(block) else: # FIFO reuse of cached blocks for LRU eviction behavior. blocks_to_evict_last.append(block)无哈希的块插到空闲队列头部(最后释放的最先复用,LIFO,为了 GPU 缓存局部性);有哈希的块插到尾部(最早释放的最先被淘汰,FIFO,也就是 LRU 语义)。这一个分支决定了前缀缓存的淘汰质量——缓存里真正的”冷块”总是排在最前面等着被覆盖。
2.4 状态速查表
把上面三节合起来,一块 KV 在扇出场景下的状态可以用一张表概括。vLLM 源码里 allocate_slots 的 docstring 恰好给了这样一张表,它把”被缓存”与”引用计数”两个维度正交化:
| < cached by vLLM > | not cached by | | vLLM, but || ref_cnt | ref_cnt not | cached by || increased| increased yet| connector |四种组合的含义:
| 状态 | ref_cnt | 哈希 | 含义 | 允许被覆写吗 |
|---|---|---|---|---|
| 私有可写 | 1 | 无 | 当前请求独占的尾部块 | 可以 |
| 共享只读 | 有 | 扇出的中心,多个请求在读 | 不可以 | |
| 缓存待复用 | 0 | 有 | 请求已结束,随时可能被命中 | 可以(命中者须先 touch) |
| 空闲待分配 | 0 | 无 | 内容已作废,在队列头部 | 可以 |
扇出的所有正确性条件都可以压缩成一句话:任何”允许被覆写”的状态,都必须先经过一次状态转换才能变成”共享只读”,而这次转换只对 ref_cnt == 1 且未被缓存的块成立。
这句话在下一章会变成一行代码。
三、写时复制:分叉点之后为什么要分家
3.1 从论文里的那个例子讲起
PagedAttention 论文用并行采样讲清楚了写时复制的必要性。假设一个请求要求 条回答,prompt 占满了一个半逻辑块:
- 逻辑块 0 被两个序列共享,物理块 1 的
ref_cnt = 2; - 逻辑块 1 只有一半有效数据,两个序列都要往它的后半写,物理块 7 的
ref_cnt = 2。
当序列 A1 采样出自己的第 1 个 token,它要写入逻辑块 1 的后半段。这时系统发现物理块 7 的 ref_cnt > 1,于是:
- 分配一个新的物理块(物理块 3);
- 把物理块 7 的内容完整拷到物理块 3;
- 把 A1 的 block table 中逻辑块 1 指向物理块 3;
- 物理块 7 的
ref_cnt减到 1(只剩 A2 在引用)。
之后 A1 往物理块 3 里写,A2 往物理块 7 里写,两条序列从这一刻起完全独立。论文的原话是:“vLLM implements a copy-on-write mechanism at the block granularity for the physical blocks that need modification by multiple sequences, similar to the copy-on-write technique in OS virtual memory (e.g., when forking a process).“
3.2 为什么必须是”块粒度”,而不是”字节粒度”
拷贝粒度有两个选择:拷整块,还是从分叉位置开始拷。论文选了整块。原因有三条:
第一,KV Cache 的写入总是顺序追加的。 一个块一旦被填满,就再也不会被修改。真正会发生”多写者”的块永远只有尾部那一个。换句话说,写时复制的触发频率与序列长度无关,每个请求在整个生命周期里只会触发常数次。拷整块因此完全没有放大效应。
第二,块是对齐单位。 后续 kernel 的寻址、缓存哈希、淘汰都以块为最小单位。如果允许”半块共享”,block table 就需要记录精确的分叉字节位置,寻址逻辑和 kernel 都要跟着变复杂,收益却接近于零。
第三,拷贝本身是可以被批量执行的。 论文里提到一个工程细节:写时复制产生的块拷贝可能落在不连续的物理块上,如果逐块调用 cudaMemcpyAsync,会有大量小启动开销。于是 vLLM 写了一个 fused block copy kernel,把多个不连续块的拷贝合并成一次 kernel 启动。这是个很典型的”机制正确但性能不行,所以补一个 kernel”的例子:写时复制的正确性由块表和计数保证,性能则由这个融合拷贝 kernel 兜底。
3.3 vLLM V1 里的可写性判定
在 vLLM V1 的实现里,“这块能不能被当前请求直接覆写”被抽象成一个判断函数(vllm/v1/core/block_pool.py):
def is_block_writable(self, block: KVCacheBlock) -> bool: """Return whether a block can be mutated by its sole owner.""" return not block.is_null and block.ref_cnt == 1 and block.block_hash is None三个条件缺一不可:
not block.is_null:空块(null block)是共享的占位块,永远不可写;block.ref_cnt == 1:只有唯一持有者才能直接写;block.block_hash is None:块还没有被提交进前缀缓存。
第三个条件值得多说一句。一个 ref_cnt == 1 但已经有哈希的块,为什么不可写?因为哈希一旦发布,别的请求就能通过前缀匹配找到它、touch 它。如果持有者在哈希发布后继续往这个块里写,就会出现”外部读者看到半更新内容”的竞态。哈希的发布是单向的承诺:发布之后,这个块的内容就被冻结了。
反过来说,这也解释了为什么 vLLM 要区分 cache_full_blocks(满块提交)和 cache_partial_block(部分块提交)两个入口。前者注册的是一个写满的块的哈希;后者允许”在一个更大的物理块里的某个细粒度边界”上建立一个可达的缓存入口,但用的还是同一个 KVCacheBlock,不额外分配也不拷贝:
“Prefix-cache keys normally identify full cache blocks. A partial entry makes an existing cache block reachable from a fine-grained prefix boundary inside that block without allocating or copying a new
KVCacheBlock.”
这是写时复制思想的一个变体:不拷贝数据,只添加一个指向同一份数据的新索引键。代价是这块块从此可能被多个哈希键指向,淘汰时必须把所有键一起清掉——所以源码里专门维护了 cached_block_hashes_by_block 这个反向表,_remove_cached_block_hashes() 会遍历删干净。
3.4 分叉点的两条实践规则
把写时复制落到调度上,有两个反直觉但极其重要的结论。
规则一:分叉必须发生在”写入之前”,而不是之后。 系统不能等到发现内容不一致才补救。vLLM 的做法是在 allocate_slots 阶段就决定每个块的归属:命中得到的块先 touch(只读共享),新追加的 token 分配新块(私有可写),只有那些”命中且需要继续在其内部追加”的尾部块,才需要考虑写时复制。这就是 docstring 里那张布局图的含义:
----------------------------------------------------------------------| < comp > | < new_comp > | < ext_comp > | < new > | < lookahead > |---------------------------------------------------------------------- | < to be computed > |---------------------------------------------------------------------- | < to be allocated > |----------------------------------------------------------------------comp 是请求已有(或命中得到)的只读部分,new 是本步要新算、必然要写的部分。两者在物理块上天然不重叠。
规则二:写时复制的受益者是”分叉者”,代价由分叉者承担。 拷贝发生时,是”要写的那一方”付出一次块拷贝的代价,而不是让所有共享者重新计算。这个不对称的选择是有道理的:重算的代价是 ,拷贝的代价是 ,在长前缀下差了不止一个数量级。论文的实测给出了这种共享能省多少:并行采样场景下,vLLM 相比 Orca 在 Alpaca 数据集上省下 6.1%–9.8% 的块,在 ShareGPT 数据集上省下 16.2%–30.5%;beam search 场景省得更多,分别是 37.6%–55.2% 和 44.3%–66.3%。
四、扇出下的淘汰:谁不能动
4.1 淘汰循环与 ref_cnt
引用计数解决了”谁拥有”,但没解决”内存满了怎么办”。vLLM 的分配路径是:get_new_blocks() 从空闲队列头部弹出块——头部就是”最该被淘汰的”那一端。
def get_new_blocks(self, num_blocks: int) -> list[KVCacheBlock]: if num_blocks > self.get_num_free_blocks(): raise ValueError(f"Cannot get {num_blocks} free blocks from the pool") ret: list[KVCacheBlock] = self.free_block_queue.popleft_n(num_blocks) ... if self.enable_caching: for block in ret: self._maybe_evict_cached_block(block) assert block.ref_cnt == 0 block.ref_cnt += 1 ... return retassert block.ref_cnt == 0 是这个函数里最重要的一行:分配器从不碰还有引用者的块。被共享的块根本不在空闲队列里,因此对分配器完全不可见。淘汰的选择性不是靠”分配时检查”,而是靠”不在队列里”这个结构性保证——这比运行时判断更可靠。
4.2 淘汰的是”缓存身份”,不是”内存”
_maybe_evict_cached_block() 做的是另一件事:
def _maybe_evict_cached_block(self, block: KVCacheBlock) -> bool: """If a block is cached in `cached_block_hash_to_block`, we reset its hash metadata and evict it from the cache. """ evicted_hashes = self._remove_cached_block_hashes(block) if not evicted_hashes: # The block doesn't have hash, eviction is not needed return False self._emit_block_removed_events(evicted_hashes) return True它删掉的是哈希表条目,不是块的物理内存(物理内存本来就已经被 popleft 拿走了)。这个区分在扇出场景里非常重要,因为它对应两条完全不同的淘汰路径:
- 路径一(正常淘汰):块在空闲队列里被
popleft拿走 → 删除哈希 → 分配给新请求 → 内容被覆写。这条路径上ref_cnt必然是 0。 - 路径二(KV connector 触发的淘汰):外部(比如 P/D 分离场景下的调度器)主动要求把某些块从前缀缓存里移除。
evict_blocks()的注释把边界写得很清楚:
“only evicts blocks that are currently cached (have a hash). blocks with
ref_cnt > 0are not freed from the block pool, only evicted from the prefix cache hash table.”
也就是说,ref_cnt > 0 的块可以被”从缓存里除名”,但内存不会被回收。共享它的请求继续正常读写,只是这些块以后不会再被新的命中者找到。这是”共享者的读取权”优先于”缓存的复用价值”的明确表态:正在跑的请求绝不能因为后台的缓存管理动作而失效。
4.3 前缀树上的淘汰:SGLang 的两级状态
vLLM 的模型是”块 + 哈希表 + 空闲队列”,SGLang 的模型是”前缀树”(radix tree)。树模型里,一块 KV 对应树上的一个节点(或节点里的一段),淘汰的对象是叶子。SGLang 的 RadixCache.evict() 实现给出了一套非常优雅的写法:
leaves = list(self.evictable_leaves)eviction_heap = [ (self.eviction_strategy.get_priority(node), node) for node in leaves]heapq.heapify(eviction_heap)
num_evicted = 0while num_evicted < num_tokens and len(eviction_heap): _priority, x = heapq.heappop(eviction_heap) self.token_to_kv_pool_allocator.free_segment(x.value, start_pos=0) num_evicted += len(x.value) self._delete_leaf(x) if len(x.parent.children) == 0 and x.parent.lock_ref == 0: new_priority = self.eviction_strategy.get_priority(x.parent) heapq.heappush(eviction_heap, (new_priority, x.parent)) self.kv_events.record_remove(x)四个设计要点:
只淘汰叶子。 evictable_leaves 是一个集合,只有叶子才进堆。这直接对应前缀树的一个硬约束:只有叶子可以被删除,因为一个内部节点被删掉会让整棵子树的路径断裂,而那些子节点可能还在被别的请求使用。
堆而不是队列。 get_priority(node) 由淘汰策略决定(默认是 LRU,看 last_access_time;也可以换成优先感知策略,看节点的 priority 字段)。用堆意味着淘汰不是简单的 FIFO,而是可以插入任意优先级函数。这一点比 vLLM 的双向链表更灵活,代价是每次淘汰要做一次堆操作。
叶子删完后,父节点可能”变成”新叶子。 if len(x.parent.children) == 0 and x.parent.lock_ref == 0 这一行是关键:一个节点的最后一个孩子被删除后,它自己变成了叶子,如果它没有被锁定,就可以进入堆继续被淘汰。这实现了”从外向内、逐层收缩”的淘汰顺序——共享度高的节点(靠近根的、被多个请求共用的)天然活得久,因为它们的孩子总是先被删掉,而只要还有一个孩子,它们就不进堆。这是前缀树结构对手工 LRU 的一个结构性优势。
lock_ref 是入堆的门槛。 见下面。
4.4 lock_ref:请求”正在使用”的声明
SGLang 的 TreeNode 有一个 lock_ref 字段,语义与 vLLM 的 ref_cnt 类似,但作用在树的路径上而不是单个块上:
def inc_lock_ref(self, node: TreeNode) -> IncLockRefResult: delta = 0 while node != self.root_node: if node.lock_ref == 0: self.evictable_size_ -= len(node.key) self.protected_size_ += len(node.key) delta -= len(node.key) node.lock_ref += 1 self._update_leaf_status(node) node = node.parent return IncLockRefResult(delta=delta)注意这个 while 循环:加锁不是加在一个节点上,而是从命中节点一路加到根。原因是前缀树里,“读取命中节点所代表的 KV”必须保证从根到该节点的整条路径都在。任何一个中间节点被淘汰,命中节点就失去了意义(它的 KV 是路径的拼接)。
对应的解锁函数是它的镜像:
def dec_lock_ref(self, node, params=None): while node != self.root_node: if node.lock_ref == 1: self.evictable_size_ += len(node.key) self.protected_size_ -= len(node.key) delta += len(node.key) node.lock_ref -= 1 self._update_leaf_status(node) node = node.parent源码里维护了两个统计量:evictable_size_(可淘汰的 token 数)和 protected_size_(被锁住的 token 数)。lock_ref 从 0 变 1 时,节点从”可淘汰”划入”已保护”;从 1 变 0 时划回来。这两个数的比例就是扇出强度的直接指标:protected_size_ 越大,说明同时有越多请求在共享同一批前缀,可用作缓存的内存池越小,命中率会下降。
还有一条比引用计数更严格的约束,写在基类接口的注释里(base_prefix_cache.py):
path_device_indices:Device KV indices on the path from the root to node; valid until the next allocation or eviction unless the path is locked.
命中结果给出的”这些 KV 落在哪些物理页上”这份索引,只在路径被锁住期间有效。一旦解锁且发生新的分配或淘汰,那些页可能被回收,索引立刻变成悬垂指针。这约束的已经不是”数据能不能被覆写”,而是”指针能不能被信任”——这也是为什么加锁必须紧跟在命中之后,而不是等到真正要用的时候再加。prefix_device_indices 的注释把时间窗口说得更清楚:“valid from match until allocation writes them into the row”——命中一发生,调度器就得尽快把这份索引写进请求自己的 req_to_token 行,那是它唯一真正拥有的映射。
4.5 evictable_leaves 的维护
_update_leaf_status() 是让上面这套记账自洽的胶水:
def _update_leaf_status(self, node: TreeNode): if node.evicted or node.lock_ref > 0: if node in self.evictable_leaves: self.evictable_leaves.remove(node) return ...规则一句话:被淘汰的节点或 lock_ref > 0 的节点,永远不在 evictable_leaves 里。因此 evict() 从堆里弹出的节点必然满足 lock_ref == 0,共享保护在结构上成立,不需要在淘汰循环里再做一次检查。
vLLM 的 touch 和 SGLang 的 inc_lock_ref 是同一件事的两种实现:
| 维度 | vLLM touch | SGLang inc_lock_ref |
|---|---|---|
| 加锁粒度 | 单个物理块 | 从命中节点到根的整条路径 |
| 数据结构 | 空闲块双向链表 | 前缀树 + 可淘汰叶子集合 |
| 淘汰顺序 | 队列头到尾(LRU/FIFO) | 优先级堆,只弹叶子 |
| 加锁时做的结构调整 | 从空闲队列摘除 | 从 evictable_leaves 摘除,更新两级统计量 |
| 无锁时的语义 | 块可被任何新请求复用 | 节点可被淘汰,子节点优先 |
五、扇出在集群上的版本:命中该去哪张卡
5.1 单机扇出的代价与多机扇出的矛盾
上面的讨论都假设”共享的 KV 就在手边”。真实服务里,请求会被负载均衡器撒到不同的 GPU 上,而前缀缓存的命中要求 KV 在同一张卡上。于是出现了一个新的两难:
- 就近派发(均衡优先):把请求按最小负载分散到各卡,集群利用率高,但共享前缀的请求被拆到不同卡上,每个卡都要把那段前缀重算一遍——省下的算力被重复计算抵消。
- 按缓存派发(命中优先):把带同一前缀的请求都送到缓存了这段前缀的那张卡上,命中率极高,但那张卡会被打爆——扇出在集群尺度上变成了热点问题。
Preble(2024,arXiv 预印本 Preble: Efficient Distributed Prompt Scheduling for LLM Serving)就是针对这个矛盾设计的。它先做了一项生产负载研究,得到的两个数字很能说明问题的规模:五个工作负载中,prompt token 共享率在 85% 到 97% 之间(即 85%–97% 的前缀 token 至少与另一个请求共享),而同一段公共序列平均被 8.6 到 126 个请求共享。
平均被上百个请求共享——这正是”扇出”在集群尺度上的定义。
5.2 E2 算法:用一次比较决定 exploit 还是 explore
Preble 的调度算法叫 E2(Exploitation + Exploration)。核心判断只有一行:这个请求被缓存覆盖的部分,和需要重新计算的部分,哪个更长?
设请求的 prompt 长度为 ,在全局前缀树上匹配到的最长缓存前缀长度为 ,则未命中长度为
当 时,选择 exploit:把请求送到”缓存了最长匹配前缀的那张 GPU”,从缓存它的候选集合 里挑负载代价 最小的那张。原因是此时复用省下的计算量大于新增的计算量,把请求专门送过去是净赚的。
反之,当未命中长度更长时,选择 explore:把请求发给负载最轻的 GPU,让它在新的卡上也建立一份缓存,为后续请求培养新的命中点。这里有个细节叫 ImbalR(负载不平衡比):如果某张卡的解码比例已经异常高(说明它已经被解码请求压住),直接选它作为最轻负载目标反而是错的,算法会跳过这一步重新做一次带惩罚的代价比较。
LoadCost(i, R_k) 由三项组成,都换算成”GPU 计算时间”来比较:本卡已有的计算负载 、这个新请求的 prefill 代价、以及它后续解码将要产生的负载。Preble 不去实际 profile 计算时间,而是只在全局调度器里维护 token 计数,用预训练的回归函数把 token 数映射成时间。这是为了把全局调度器的开销压到最低——它要服务整个集群的每一个请求。
5.3 两级调度:全局只管归属,局部才管迭代
Preble 的结构是两级调度:
- 全局调度器:维护全局前缀树(radix tree,每棵树有独立的根,存放共享前缀)、每张 GPU 的当前负载计数,做请求级的归属决策。
- 局部调度器:每张 GPU 一个,沿用已有的迭代级调度逻辑(连续批处理 + 分块预填充)。
全局前缀树的访问是无锁的:源码里明确写了,绝大多数操作是只读的,唯二需要原子指令的地方是”更新某节点被分配到哪张 GPU”和”该节点的命中计数递增”。这两个都可以用原子操作表达,因此不需要全局锁。
这里有一处容易被忽略的工程细节:全局前缀树上记录的是”这个节点被分配给了哪张 GPU”,而不是”这个 GPU 上真的有这个 KV”。真正的 KV 是否存在、是否已被淘汰,由各 GPU 的局部淘汰策略决定。所以全局调度器的决策是一个近似——它可能把请求送到一个”理论上应该命中、实际上已经被换出去”的卡上。论文承认这一点,并用局部调度的分块预填充作为兜底:即使命中失败,请求也能以 chunk 的形式正常算完,只是没那么快。
5.4 实测数据
Preble 在 A6000 与 H100 集群上、用两个开源模型、对五个真实工作负载做的评测给出了这样的区间:
- 相对当时的最优服务系统(SGLang 0.1.12 / vLLM 等),平均延迟降低 1.5× 到 14.5×,p99 延迟降低 2× 到 10×;
- 在编程类工作负载上(解码最长、prefill 占比最低,留给前缀复用的优化空间最小),相对 SGLang 仍有 平均延迟 1.56× 到 1.8×、p99 延迟 3× 到 4× 的改善;
- 从 2 张卡扩到 4 张卡时,相对优势基本保持不变,说明它在扩展时没有损失。
论文特别指出:对于完全没有共享前缀的负载,Preble 的行为与性能跟 vLLM 这类系统没有区别——它的全部收益都来自扇出场景。这是一条很有价值的边界结论:扇出优化是纯增益,不是全局重构。
六、扇出场景的调度取舍:命中之后到底省了多少
6.1 重新算一遍 vs 从缓存读一遍:两个代价模型
到这里必须回答一个被反复回避的问题:命中了就一定要复用吗? 不一定。复用不是免费的。
假设命中长度为 个 token,block size 为 ,则命中贡献 个块。复用路径要做两件事:把 block table 指向这些共享块( 次元数据写),以及在注意力 kernel 里遍历这些块(这部分读取本来就要做,不额外计)。重算路径的代价是 。
在 prefill 阶段,注意力本身就是 的,重算一段长前缀相当昂贵;而在 decode 阶段,每步的注意力是 、投影是 ,此时重算 个 token 意味着额外做一次完整 prefill,代价高得离谱。所以:
- 长前缀 + 短输出(RAG、Agent 工具定义、代码库上下文):复用收益极大。这也是 Preble 研究里”prompt 长度是输出长度的 4× 到 2494ד这个观察的直接推论。
- 极短前缀(几 token 的公共开头):复用和重算都要走一遍同样的 kernel 启动路径,元数据开销可能吃掉全部收益。
一个常见的实现约束是”至少命中一个完整的块才值得复用”。vLLM 的 get_computed_blocks() 里有这样一段注释:
“NOTE: When all tokens hit the cache, we must recompute the last token to obtain logits. Thus, set
max_cache_hit_lengthtoprompt_length - 1.”
这句话讲的是一个容易踩的坑:如果整个 prompt 都被命中了,最后一个 token 的 logits 就没有来源——缓存里只有它的 Key/Value,没有它经过 lm_head 之后的结果。所以系统必须把最后一个 token 排除在命中之外,强制重算它。而由于 vLLM 要求 num_computed_tokens 按块对齐,这个”重算一个 token”实际上常常会变成”重算整个尾部块”。注释也承认这一点并留了优化空间:“This can trigger recomputation of an entire block… Removing this limitation could slightly improve performance in the future.”
扇出的尾部块是最贵的一块——对每个命中者而言,最后那一个块都要重算一次。这正是第四章讲写时复制时那条界线的另一面:边界块既不能纯共享(要写),也不能纯复用(要算 logits)。
6.2 分叉点的第二个含义:缓存哈希的构造
前缀缓存要能正确工作,前提是”同一段 token 序列必然得到同一个哈希”。vLLM V1 在这件事上有几处容易忽略的设计(vllm/v1/core/kv_cache_utils.py)。
哈希是链式的。 每个块的哈希不是”这段 token 的哈希”,而是”父块哈希 + 本块 token”的哈希。这样前缀匹配被简化为:从头开始逐块比对哈希值,第一个不匹配的位置就是分叉点。链式结构还保证了”哈希相同 前缀完全相同”,这是扇出正确性的基石——不能出现两个哈希不同但内容相同的块,否则会漏掉本可以共享的扇出机会。
哈希里必须塞进所有会影响 KV 内容的量。 源码里 generate_block_hash_extra_keys() 把好几类东西塞进了 extra_keys:
- 多模态特征标识(
("mm", mm_feature.identifier, offset)):同一段文本配不同图片,KV 完全不同; - LoRA 适配器 ID:不同 LoRA 的同一段 prompt,KV 不同,绝不能共享;
- cache salt(
("cache_salt", request.cache_salt)):只加在第一个块上,用于把不同租户的缓存空间强制隔离; - prompt embedding 相关键。
这里最值得展开的是 LoRA。SGLang 的 RadixKey 用一个 extra_key 字段做同样的事,源码注释讲明了动机:
“Entries that share identical leading token ids but have different
extra_keyvalues are intentionally kept disjoint and never share prefix nodes. This is useful to: Isolate KV cache lines for different LoRA / adapter IDs. Separate requests that intentionally should not share state (e.g., different sampling salt, cache version, or retrieval augmentation context) by supplying a distinctextra_key.”
“相同的 token 序列未必有相同的 KV”——这是前缀缓存的根本前提。LoRA、采样 salt、多模态、缓存版本这些维度只要有一个不同,共享就是错的。反过来,如果实现里漏掉任何一个维度(比如没把 LoRA ID 放进哈希),就会产生静默的错误结果:不报错、不崩溃,只是输出内容悄悄错了。这是前缀缓存类 bug 最典型的形态,也是最难排查的一类。
顺带一提,SGLang 里这套机制还承担了多 LoRA 服务的隔离职责,可参考站内文章 SGLang 源码完全拆解(十三):多 LoRA 服务——adapter 池、SGMV 内核与批内多适配器共存。
6.3 同一批次内的扇出:kernel 侧的负担
最后落到 kernel 层。一个 batch 里如果有 32 个请求共享同一段 长的前缀,注意力 kernel 会对每个请求各读一遍这 个 token 的 KV。从显存带宽的角度看,这 个块被读了 32 次。
这是共享的代价侧:容量省了,带宽没省。也正因如此,前缀共享的收益主要体现在 prefill 计算量的减少( 量级)和 TTFT 的下降,而不是 decode 阶段吞吐的提升。FlashInfer 在 2024 年提出的 ping-pong 流水线就是针对这一类”同一批次内长短不一的共享前缀”做的调度改造——把 attention 的 stage 拆开,让长短不同的请求在同一批次里错位执行,减少短请求等长请求的尾部气泡:
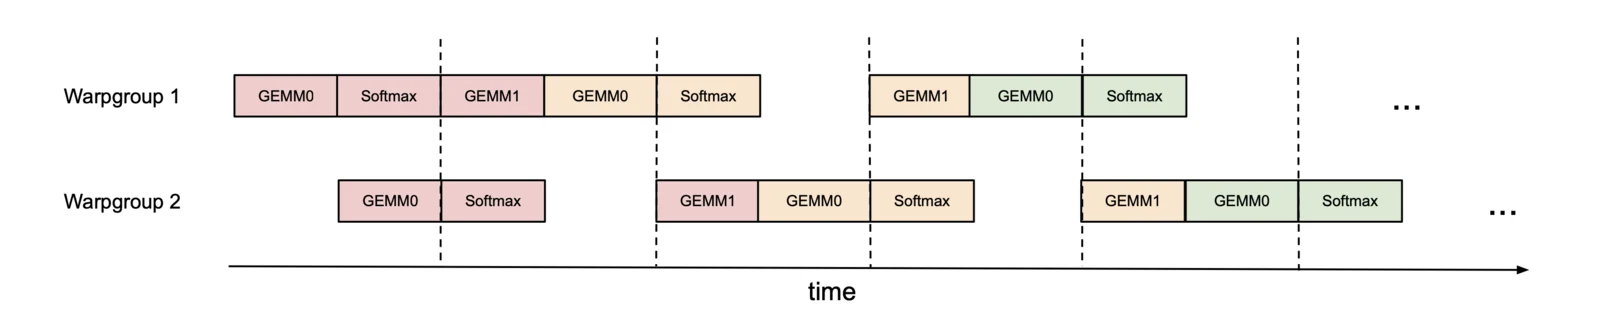
图片来源:FlashInfer 论文 arXiv:2407.08608(MLSys 2025)中的流水线调度示意图。
FlashInfer 的块稀疏 KV 表示与可定制注意力调度可参考站内文章 FlashInfer 完全拆解:把分页 KV、动态批处理与定制注意力编译成服务级 Kernel;前缀缓存本身的淘汰策略则可参考 前缀缓存淘汰完全拆解:为什么 14 种复杂算法赢不了 LRU。
6.4 把扇出提前:还在计算中的前缀能不能复用
前面所有的讨论都隐含一个假设:被共享的前缀已经算完并提交了。但扇出最猛烈的时刻恰恰是第一波——一批请求几乎同时到达,此时那段公共前缀根本还不在缓存里,第一个请求正在算它。
这带来两个麻烦:
- 后来的请求只能匹配到”目前已提交”的最长前缀,而那个长度往往是 0,于是也从头算一遍。N 个请求重复计算同一段前缀,前缀缓存在这一波里一点忙都没帮上。
- 即使允许它们等第一个请求算完再上车,调度器也没有”等待某个正在运行的请求”这种能力——那会把迭代级调度变成带依赖关系的图调度,复杂度和尾延迟都会失控。
SGLang 的答案是把”发布”这个动作提前:请求在分块 prefill 每次推进时(checkpoint),就把已经算完的那部分 KV 挂进前缀树。RadixCache.checkpoint() 的全部逻辑只有四步:
def checkpoint(self, req: Req, *, up_to: int): token_ids = req.full_untruncated_fill_ids[:up_to] ... radix_key, _, _ = self._insert_cache(req, token_ids, key_limit=key_limit, split_prompt=True)
# The prefix indices could be updated, reuse it match_result = self.match_prefix(MatchPrefixParams(key=radix_key)) new_last_node = match_result.last_device_node new_indices = self.path_device_indices(new_last_node) ... self.req_to_token_pool.write( (req.kv.req_pool_idx, slice(req.kv.cache_protected_len, len(new_indices))), new_indices[req.kv.cache_protected_len :], )
# With page_size > 1 the partial page stays in the request's row but not # in the tree; cache_protected_len marks the tree-owned part so the next # checkpoint or release_kv_cache frees the rest. req.kv.cache_protected_len = len(new_indices)
self.unlock(req.lock) req.lock = self.lock(new_last_node)逐句读这四步:
第一步,插入。 _insert_cache 把 token_ids[:up_to](按 page 对齐)插入前缀树,节点的 value 是这段 KV 在页分配器里的索引序列。
第二步,重新匹配并把索引写回自己的行。 插入之后树结构可能变了(前缀匹配常常在已有段的中间断开,match_prefix 会分裂一次节点),所以请求必须重新匹配一次,拿到新的 last_device_node,再把这条路径上的设备页索引写进自己的 req_to_token 行。这一步是整段代码的关键:请求的行从”我算的时候拿到的那些页”改成了”树拥有的那些页”——页的归属从请求转移到了树。
第三步,登记边界。 cache_protected_len 记录”树拥有的那部分”到哪里为止。注释专门说明了 page_size > 1 的情况:最后一个不满的页留在请求自己的行里,不进树。理由正是第三章的写时复制逻辑——那个页还会被继续写入,一旦进树就变成了”可被别的请求命中、但内容随时会变”的不一致状态。
第四步,换锁。 unlock(req.lock) 释放旧节点的路径锁,lock(new_last_node) 对新节点沿路径加锁。锁的”收据”语义(TreeLock(node, receipt),注释写的是 “receipt replays the acquire on release”)保证解锁时用的参数与加锁时完全一致,不会因为树结构变化而漏减计数。
做完这一步,其他请求立刻可以命中这段还在被计算的 KV——扇出被提前到了 prefill 阶段,第一波并发请求不再重复计算。
vLLM 的取舍正好相反:它只把写满的块发布进哈希表(cache_full_blocks),分块 prefill 过程中未满的尾部块始终保持私有。好处是哈希语义干净——“哈希存在 内容完整且不会再变”;代价就是上面第 1 个问题,同一前缀的第一波并发请求会各算各的。vLLM 在 P/D 分离场景里另有 delay_cache_blocks 参数控制”延后提交”的时机,注释说明它是为”从远端接收的 KV 传输”准备的。
Preble 的做法又在另一个层次上:全局调度器在把请求分配出去的那一刻就更新了树上节点的归属 GPU 与命中计数,所以后续请求立刻就能看到”这个前缀正在变成谁的缓存”。它登记的是计算意图,而不是计算结果。
“前缀发布的时机”是一个显式的设计取舍。 发布得早(SGLang 的 checkpoint),第一波并发就能共享,代价是要处理页面归属转移、节点重匹配与换锁,还必须靠”最后一个不满的页不进树”兜住一致性;发布得晚(vLLM 的满块提交),哈希语义最干净、最不容易出错,代价是第一波请求只能各算各的。两者都不是免费的。
七、扇出强度的量化:几个数字
前面几节讲了机制,这一节把”扇出到底有多强”用数字钉住。
7.1 PagedAttention 论文的共享收益
论文在 §6.3 给出了明确口径:memory saving = 共享省下的块数 / 不共享时的总块数。
| 场景 | 数据集 | 相对 Orca(Oracle)吞吐提升 | 内存节省 |
|---|---|---|---|
| 并行采样( 路) | Alpaca | 1.3× | 6.1%–9.8% |
| 并行采样( 路) | ShareGPT | — | 16.2%–30.5% |
| Beam search(宽度 6) | Alpaca | 2.3× | 37.6%–55.2% |
| Beam search(宽度 6) | ShareGPT | — | 44.3%–66.3% |
beam search 的节省远高于并行采样,原因是 beam 的候选之间存在大量交叉共享(同一段历史被多个候选引用),而并行采样只在 prompt 段共享。
跨请求的共享前缀场景,论文用 LLaMA-13B 跑 WMT16 英德翻译:
- 共享 1 个示例(80 token)的前缀时,vLLM 相比 Orca(Oracle)吞吐高 1.67×;
- 共享 5 个示例(341 token)的前缀时,吞吐高 3.58×。
这两个数字的对比本身就是一条重要结论:前缀越长,扇出的收益越明显,因为省下的 prefill 计算是前缀长度的平方量级。
7.2 Preble 的生产负载研究
Preble 对五类真实工作负载(LooGLE 长文档问答、Toolbench 工具调用、编程生成、具身 Agent、视频问答)的统计给出了扇出在真实负载中的分布:
| 指标 | 数值 |
|---|---|
| prompt 长度相对输出长度的倍数 | 4×(Azure chat)到 2494×(视频问答) |
| 前缀 token 共享率 | 85%–97% |
| 同一段公共序列被多少请求共享 | 平均 8.6–126 个 |
| 请求到达间隔变化范围 | 2 微秒到 217 秒 |
Preble 还指出,在他们的实验条件下 vLLM 的前缀共享收益明显低于 SGLang,原因列了四条:vLLM 当时的前缀共享功能还在 beta 版、没有用 FlashInfer kernel 让共享效率更高、不支持把分块预填充与前缀缓存一起用、以及调度延迟较大。这条对照值得记下来——前缀缓存的收益高度依赖两个外部条件:用什么样的注意力 kernel、以及能不能与分块预填充协同。一个”支持前缀缓存”的系统,如果没有为它优化过的 kernel 和与调度器的配合,命中带来的收益可能被这些缺失吃掉大半。
共享率 85%–97% 这个数字最值得记住:它意味着在这类负载下,几乎整个 prompt 都被至少两个请求共享。这也解释了为什么前缀缓存在 2024 年之后迅速成为推理框架的标配——它不是锦上添花,而是这类负载下 prefill 计算的主要去处。
同时,到达间隔从 2 微秒到 217 秒的巨大变化说明”扇出”不是稳态现象:它总是突发的。一段热门前缀可能在几毫秒内被上百个请求同时命中(比如某个 Agent 系统的会话开局、某个热门文档被批量检索),然后又归于冷清。系统必须在突发的那几百毫秒内正确处理上百个并发引用,然后在之后把这块缓存体面地冷掉。
7.3 扇出之外的另一条路:把 KV 本身变小
扇出优化处理的是”同一份 KV 被读多少次”,另一条完全正交的路线是”这份 KV 本身有多大”。两者互补:前缀共享减少的是计算量(每个 token 的 KV 字节数不变),结构性压缩与量化减少的是每个 token 的 KV 字节数。
最经典的结构性压缩是 KV 头的共享。MHA 每个 query 头配一个 KV 头,MQA 让所有 query 头共享一组 KV,GQA 取中间:把 query 头分组,每组共享一组 KV 头:
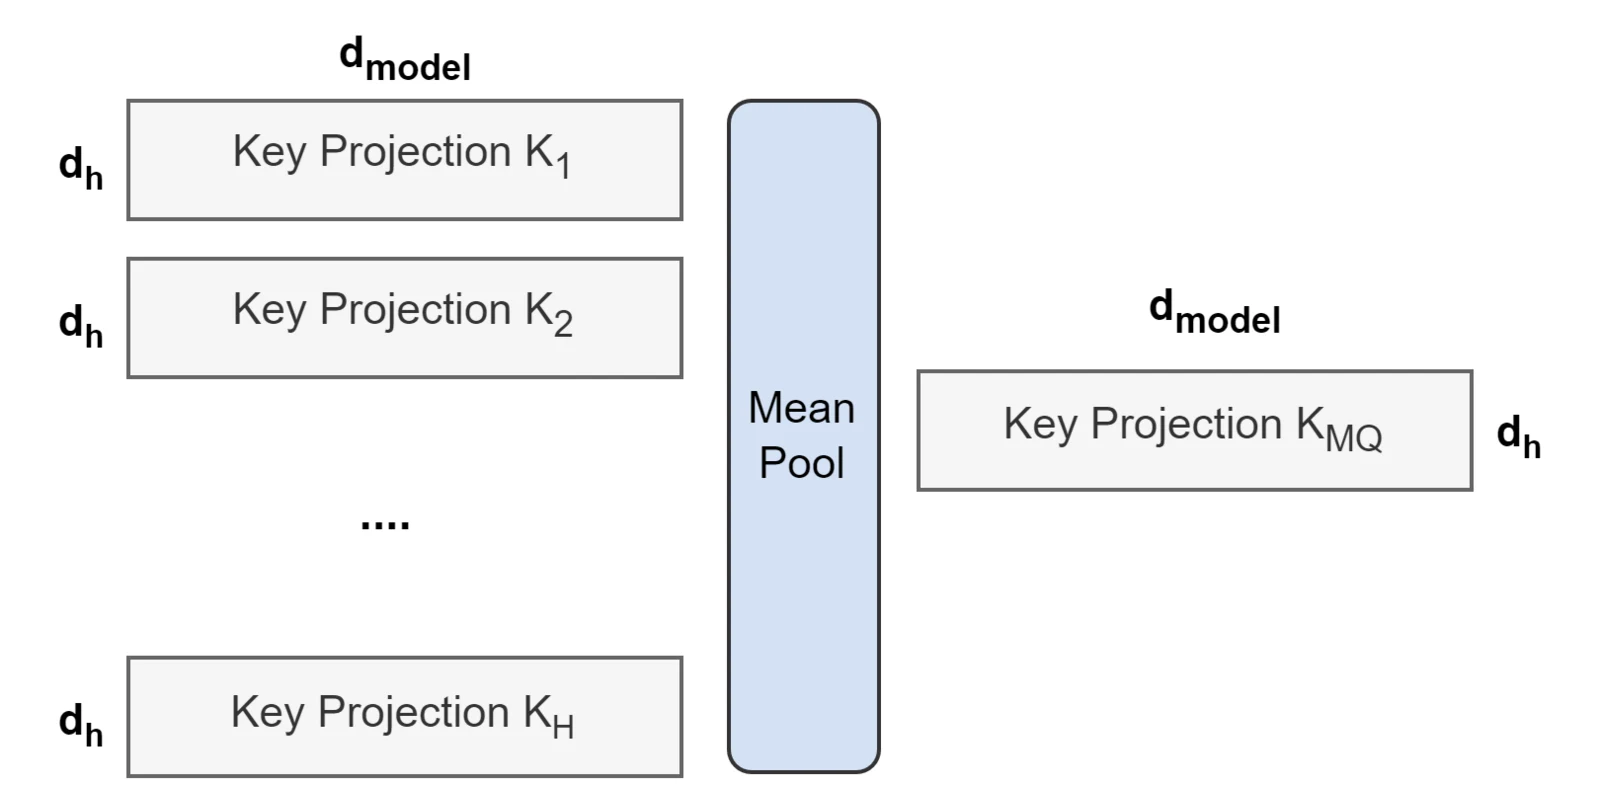
图片来源:GQA 论文 arXiv:2305.13245(EMNLP 2023 Findings)图 1。
图中灰色方块表示被多个 query 头复用的同一份 KV:MHA 是一对一(最左侧),MQA 是全局共享(最右侧),GQA 是分组共享(中间两种粒度)。GQA 的机制与实测可参考站内文章 GQA 完全拆解:分组查询注意力,用 1/8 的 KV 缓存保住 MHA 的质量;沿量化方向把 KV 压到 2–4 bit 的做法,可参考 KIVI 完全拆解:非对称 2-bit KV Cache 量化,为什么 Key 按通道、Value 按 token 与 KVQuant 完全拆解:预旋转逐通道量化、敏感度加权非均匀码本与稀疏离群值,3-bit KV Cache 如何近无损(NeurIPS 2024)。
两条路线在服务层的收益结构不同:GQA 与 KV 量化让每个请求的 KV 更小,显存与带宽同时受益,decode 阶段的收益最大;前缀共享让重复的 prefill 计算更少,TTFT 受益最大,且收益随前缀长度超线性增长。一个成熟的服务系统通常两条都用:先把每个 token 的 KV 压小,再让同一份小 KV 被尽可能多的请求读。
八、踩坑清单
把全文的机制收敛成一份实现层面的检查表。每一条都对应前面某节的机制,也对应真实系统里的一个 bug 类别。
关于引用计数
- 命中的第一步是”摘除”,不是”计数”。
ref_cnt == 0的块可能还在空闲队列里等着被复用,加引用之前必须先把它摘出来,否则分配器会把它发给别人。(§2.3) ref_cnt归零不等于可以立即复用。 是否进空闲队列头部(LIFO,立刻复用)还是尾部(FIFO/LRU,等着被命中),取决于块是否已被缓存——这个分支决定了前缀缓存的淘汰质量。(§2.3)- 别把
ref_cnt放在请求侧。 共享是多对一的,计数必须放在被共享的那一侧。(§2.2)
关于写时复制
- 只有”唯一持有者 + 未发布哈希”的块可直接写(
ref_cnt == 1 and block_hash is None)。哈希一旦发布,内容就冻结了。(§3.3) - 拷贝是块粒度,不是字节粒度。 触发频率与序列长度无关,但拷贝本身要融合成一次 kernel 启动。(§3.2)
- “部分块缓存入口”不拷贝数据,只增加指向同一块的哈希键;因此淘汰时必须把这个块的所有哈希键一起删干净。(§3.3)
关于淘汰
- 分配器从不碰
ref_cnt > 0的块——靠”不在空闲队列里”的结构性保证,而不是运行时判断。(§4.1) ref_cnt > 0的块可以被”除名”,但不能被回收。 外部淘汰请求只能删哈希表条目。(§4.2)- 前缀树只淘汰叶子。 内部节点被删会导致整棵子树路径断裂;最后一个孩子被删掉后父节点才可能成为新叶子。(§4.3)
- 加锁沿着”命中节点到根”的整条路径,任何中间节点被淘汰都会让命中失效。(§4.4)
protected_size_是扇出强度的仪表盘:它越大,说明同时被共享的 KV 越多,可用于缓存的池子越小,命中率会下滑。(§4.4)
关于正确性前提
- 哈希必须覆盖所有影响 KV 内容的维度:LoRA ID、cache salt、多模态特征、prompt embedding。漏掉任何一个,都会产生静默的错误输出。(§6.2)
- 哈希是链式的(父哈希 + 本块 token),保证”哈希相同即前缀相同”,从而不漏掉扇出机会。(§6.2)
- 全部命中时最后一个 token 必须重算(要拿 logits),并且由于块对齐要求,实际上常常要重算整个尾部块。(§6.1)
关于集群尺度
- “按缓存派发”和”按负载派发”必须动态取舍:被缓存覆盖的部分比未命中部分更长时选命中优先,否则选负载优先去培养新缓存点。(§5.2)
- 全局前缀树的记录是近似,“节点属于哪张卡”不等于”KV 真的还在那张卡上”,必须靠局部调度的分块预填充兜底。(§5.3)
关于”提前发布”与索引有效期
- 提前发布正在计算的前缀,必须把已算完的部分的页归属交给树(把树路径上的页索引写回请求的行),否则同一批页会被请求和树双重持有、双重释放。(§6.4)
- 提前发布时要重新匹配一次,因为插入可能让树节点发生分裂,旧节点的路径索引已经失效。(§6.4)
- 最后一个不满的页永远不进树——它还会被写,一旦进树就是”可命中但内容会变”的不一致状态。(§6.4)
- 命中拿到的页索引只在锁内有效:解锁之后发生任何分配或淘汰,那份索引就是悬垂指针,必须在此之前写进请求自己的行。(§4.4)
- 换锁要用”收据”:解锁必须用加锁时的同一组参数,
TreeLock(node, receipt)这种记账方式能避免树结构变化导致的漏减。(§6.4)
小结
前缀共享在概念上很简单——同样的一段 KV 别算两遍——但真正把它做对,考验的是系统的记账能力。一份被 个请求同时引用的 KV,在系统里同时扮演三个角色:别人的内存(要被引用计数保护)、某个哈希的缓存(要被淘汰策略管理)、候选的淘汰对象(要参与容量竞争)。扇出的那一刻,这三种身份同时被触碰,任何一处顺序错了都会产生静默错误或者显存泄漏。
三条主线可以带走:
第一条是引用计数与写时复制的组合。 ref_cnt 回答”谁拥有”,is_block_writable 回答”谁能写”,两者合起来定义了共享与私有的边界。这条边界的位置是块对齐的自然结果,而且它保证了写时复制的触发频率与序列长度无关——这是整个机制能高效运行的深层原因。边界之外的量还得靠实验确定:PagedAttention 论文在 beam search 场景实测到 37.6%–55.2% 的块被共享省下,这个数字既是收益的上限,也是引用计数必须同时承载的最大并发度。
第二条是前缀树与锁的组合。 SGLang 的 lock_ref 沿着路径加锁、只淘汰叶子的设计,把”哪些 KV 正在被使用”编码进了树的结构本身:共享度高的节点因为总有孩子而活得久,锁住的路径整条退出淘汰集合。这是数据结构层面的保护,比手工维护优先级更不容易出错。
第三条是集群尺度的取舍。 当共享的 KV 不在手边,“命中”就变成了一个路由问题。Preble 的 E2 用一个不等式(未命中长度 vs 命中长度)统一了 exploit 与 explore,实测在五类真实负载上取得 1.5×–14.5× 的平均延迟改善,并明确承认它的收益完全来自扇出场景、无共享时与普通系统无异。
最后回到开头那个问题:同前缀请求同时涌入时,到底会不会炸? 答案是,只要引用计数、写时复制与淘汰保护三者各自正确且顺序正确,扇出不但不会炸,还是前缀缓存收益最高的时刻——因为一个前缀在被最多人共享的时候,恰好也是它被复用次数最多、单位计算成本最低的时候。
参考资料
- Efficient Memory Management for Large Language Model Serving with PagedAttention(SOSP 2023,PagedAttention 原始论文,§4.3 并行采样与写时复制、§6.3–6.4 内存节省与共享前缀实测)
- Preble: Efficient Distributed Prompt Scheduling for LLM Serving(分布式提示调度、E2 算法与生产负载研究)
- FlashInfer: Efficient and Customizable Attention Engine for LLM Inference Serving(MLSys 2025,块稀疏 KV 表示与 ping-pong 流水线)
- vLLM V1 KVCacheBlock 与空闲队列实现(
ref_cnt、FreeKVCacheBlockQueue、链式块哈希与 extra keys) - vLLM V1 BlockPool 实现(
touch、free_blocks、is_block_writable、cache_partial_block、evict_blocks) - SGLang RadixCache 实现(
TreeNode.lock_ref、evict、inc_lock_ref/dec_lock_ref) - SGLang TreeLock 与 base prefix cache 接口(命中结果结构与锁的收据语义)
- SGLang beam search fork 原语(share-on-fork KV:alias、reparent 与孤儿槽位回收)
- GQA: Training Generalized Multi-Query Transformer Models from Multi-Head Checkpoints(KV 头共享与 KV Cache 回收,扇出之外的另一条 KV 压缩路线)
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



