


BalanceRoute 完全拆解:大规模 LLM 数据并行服务如何在线负载均衡
问题:副本相同,负载为什么仍会失衡
大模型推理扩到几十乃至上百张加速卡时,常见做法不是只选一种并行方式,而是把多种并行叠在一起:先用张量并行(TP)或专家并行(EP)把一份过大的模型切进一个设备组,再复制出多组模型副本,用数据并行(DP)承接更多请求。直觉上,副本完全相同,只要轮询分流就应该足够均匀;真正进入逐 token 解码后,这个直觉会失效。
BalanceRoute 来自论文 Tackling the Data-Parallel Load Balancing Bottleneck in LLM Serving: Practical Online Routing at Scale,由香港科技大学与华为团队在 2026 年提出,官方仓库标明论文已被 NeurIPS 2026 接收。它研究的不是“哪个模型更适合回答请求”,也不是 MoE 门控器把 token 发给哪个专家,而是一个更靠近服务运行时的问题:Prefill 完成后,一个请求应该固定送到哪个 Decode 数据并行 worker?
这里的 worker 不是一张孤立的卡,而是能完成一份模型推理的逻辑执行单元;内部可以继续包含 TP 或 EP。论文所针对的部署里,Decode 各 worker 的逐步执行受集体通信与同步屏障约束。一次迭代的完成时间由最慢、负载最重的 worker 决定,其他 worker 即使提前算完也只能等待。
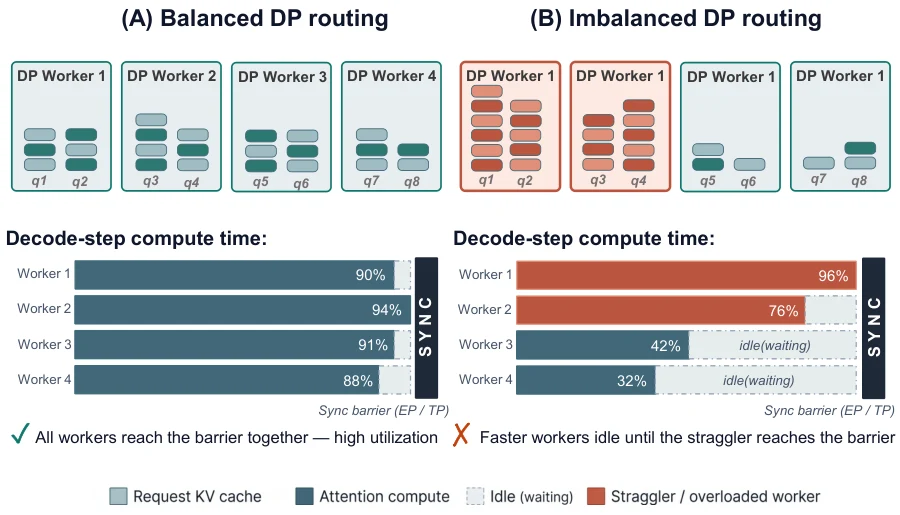
图 1 来源:BalanceRoute 论文 Figure 1。上半部分中,各 worker 的工作量接近,几乎同时到达 barrier;下半部分中,最重的 worker 把整步时延拉长,空白区域就是其他加速器的等待时间。这种浪费会在每一个 decode step 重复,而不是只在请求入场时付一次。
四个让通用负载均衡失灵的性质
第一,请求分配具有粘性。Prefill 生成的 KV Cache 会随输出不断增长;若在生成中途迁移请求,需要移动整份 KV Cache,还要处理页表、连接状态与流式输出的一致性。因此生产系统通常在请求进入 Decode 时做一次选择,此后直到完成都不迁移。
第二,“一个请求”不是固定大小的作业。设请求 的 prompt 长度为 ,它已经生成了 个 token,那么下一步注意力需要读取的 KV 规模近似正比于 。请求在执行期间每一步都会变重,而最终输出长度 在入场时未知。
第三,完成事件会突然释放大量负载。两个当前 KV 规模相同的请求,可能一个再生成 3 个 token 就结束,另一个还要运行 1000 步。只看当前队列长度或当前 token 总量,无法看出这种差异。
第四,路由器没有离线求最优解的时间。论文的生产设置中,一个 decode step 约为 60 ms,路由器要在亚 100 ms 的窗口内处理数十个 worker、数百个候选请求,还必须留出网络、序列化和运行时调度的余量。
Round-Robin 只平衡“请求个数”;Join-Shortest-Queue(JSQ)只平衡“活动请求数”;Power-of-Two-Choices(P2C)虽然减少了全局查询成本,却仍取决于选了什么负载指标。它们都没有显式表达同步屏障最关键的非线性:填平轻载 worker 有收益,但一旦把它推成新的最重 worker,代价会被整个集群放大。
需要同时说明适用边界:如果多个副本完全异步、彼此没有逐步 barrier,那么一个副本变慢不会直接让所有副本原地等待,主要问题会退化为各自队列的响应时间与吞吐差异。BalanceRoute 最有价值的场景,是论文定义的 barrier-synchronized DP Decode,尤其是长上下文、大有效 batch、每步成本由 KV 读取带宽主导的部署。
从排队模型看数据并行路由
论文把 Decode 时间离散为步骤 。一共有 个数据并行 worker,每个 worker 最多同时容纳 个活动请求。请求 在 Prefill 完成后,于步骤 进入等待池;路由器在 时把它分配给某个 worker 。分配完成后不可抢占,也不可迁移。
请求负载不是一个标量,而是一条随时间增长的曲线
请求 的完整工作负载可写成:
其中 是输出 token 数, 是第 个 decode step 的 KV 工作量。对标准自回归注意力,论文采用近似:
是 Prefill 后已有的 token 数。这个式子刻画了因果注意力的基本成本:第一个输出 token 要读 个历史位置,第二个要读 个,之后逐步增长。它不是精确的 GPU 时间模型,因为 kernel 固定开销、页大小、GQA 头数和内存访问效率都会改变常数,但在同一模型与硬件上,KV token 总量是足够稳定的负载代理。
在步骤 ,worker 的活动集合为:
它的瞬时负载是所有活动请求当前 KV 工作量之和:
若每步执行时间可近似为 ,其中 表示单位 KV 工作量对应的带宽时间, 是 kernel launch、同步等固定开销,那么 barrier 下的整步时间就是:
因此调度器真正需要压低的是最大负载,而不是只压低总负载或平均请求数。总负载由已经到达的工作决定,路由器很难改变;它能改变的是这些负载在 worker 间的形状。
用“补齐到最高水位的空洞”定义失衡
令当前最大负载为:
论文定义总失衡:
把每个 worker 的负载柱画出来, 正是所有较矮柱子补到最高柱子所需填入的面积。这个定义有三个优点:
- 当所有 worker 一样重时,;
- 总负载不变时,降低最大值必然降低 ;
- 它直接对应 barrier 等待:第 个 worker 相对最慢 worker 的空等工作量是 ,对所有 worker 求和就是 。
论文实验表格使用的“平均 imbalance”是每步 的轨迹均值,而算法推导用的是上面的总缺口 。二者并不相同,但都刻画负载柱之间的垂直展开;阅读实验时不能把表中 token 数直接代回 F-score 公式。
为什么规模越大,朴素方法往往越吃亏
即使每个 worker 的负载来自同一分布,最大值也是一个次序统计量。worker 数 增大时,抽到更极端重载 worker 的概率上升,而 barrier 永远由这个最大值决定。平均负载没有同比增加,最大值与平均值的差却会变大,所以失衡造成的空闲比例可能随集群规模放大。
这也解释了一个看似反常的现象:扩容增加了总算力,却可能让每张卡的有效利用率更差。路由算法若只在小规模上比较,很容易低估这个问题;BalanceRoute 特别把 的趋势作为验证重点。
BalanceRoute 的系统架构
BalanceRoute 没有侵入式修改推理引擎,而是在客户端与 vllm-ascend 实例之间加入一个有状态 Python 代理。论文部署采用 Prefill–Decode 分离:Prefill tier 计算 prompt KV,Decode tier 负责后续自回归生成,两者通过 MooncakeConnector 传输 KV。
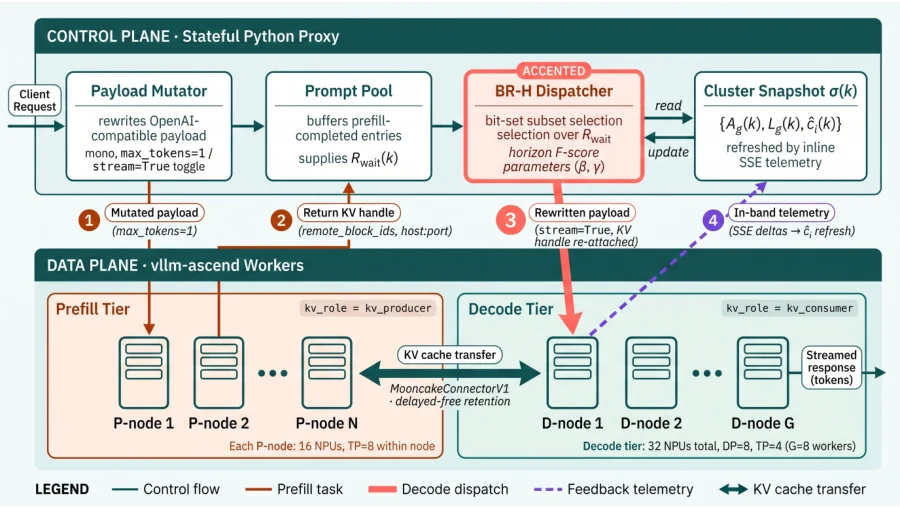
图 2 来源:BalanceRoute 论文 Figure 2。从左到右看,代理先把请求送到 kv_producer 角色的 Prefill 实例;Prefill 完成的请求进入 Prompt Pool;BR-H 根据所有 Decode worker 的快照批量选择目标;kv_consumer 拉取对应 KV;流式 token 再经代理回给客户端。红色虚线表示遥测反馈,它让代理的预测状态与实际执行进度重新对齐。
这个架构围绕三个设计原则展开。
集中状态,而不是无状态转发
BR-H 要比较不同 worker 在未来 步的负载包络,还要从等待池里挑一个请求子集。只知道“当前连接数”的无状态四层负载均衡器无法完成这些计算。代理因此维护三类核心状态:
DecodeInstanceState[g]:镜像第 个 Decode worker 的活动请求、已生成 token 数和 KV token 总量,使 可以增量更新;PromptPool:保存已经完成 Prefill、尚未进入 Decode 的请求及其 KV 交接元数据;PrefillerBudget[i]:定期从 Prometheus 指标读取 Prefill 实例的 KV 占用,防止生产端缓存因“延迟释放”而被塞满。
集中式状态是算法成立的条件,同时也是故障域。后文会讨论高可用和状态漂移问题。
在引擎之上集成,而不是改动二进制
代理通过 OpenAI 兼容请求的 payload mutation 驱动两阶段生命周期。Prefill probe 把原请求临时改为非流式、只生成 1 个 token,并设置远端 Decode 所需的 KV transfer 参数。响应返回真实 prompt_tokens 和生产端 KV handle 后,代理把条目放入 Prompt Pool。
当路由器选中目标 Decode worker,代理恢复原始 max_tokens、采样参数与流式设置,重新附上 KV handle。Decode consumer 拉取 KV,首个输出 chunk 表明交接完成,代理此时才释放 Prefill 端预算。这种方法复用了标准 API 与 MooncakeConnector,不要求修改生产引擎;论文只在实验时打了一个轻量 monkey patch,用来记录真实 step cost,诊断补丁不参与线上路由。
用 SSE 形成低成本反馈闭环
标准 OpenAI API 不直接暴露每个请求当前已经解码多少步。代理在转发 Server-Sent Events(SSE)流时顺手解析 chunk:看到内容增量就把 加一,看到结束标记就从活动集合删除请求。预测器不需要每 token 重算,而是每隔 步刷新;普通 chunk 的关键路径只增加整数更新与标记检查。
这是一种很实用的“带内遥测”:控制状态从本来就要经过代理的数据流中恢复,不增加新的引擎 RPC。但它也要求代理正确处理断连、重试、重复 chunk 与乱序事件,否则镜像状态会悄悄漂移。
四个协程把控制面拆开
论文附录给出的实现由四类事件驱动协程协作:Prefill dispatcher 选择未饱和 Prefill 实例;Decode dispatcher 在“等待池非空”或“Decode 槽位释放”时唤醒并运行路由算法;metrics poller 更新 Prefill KV 预算;pool reaper 清理超过 TTL 的等待项并释放生产端资源。
每个 vllm-ascend worker 前都有独立的持久 HTTP 连接池,避免每次调度重建 TCP。取消请求也由旁路协程监听:无论请求仍在池内,还是已派发但尚未输出第一个 token,都必须同时释放池槽位或 Decode 槽位。这里的资源回收并非外围细节,因为一次“幽灵请求”就会永久污染集中式路由器的负载视图。
在线路由算法如何工作
BalanceRoute 包含两个层次:BR-0 不依赖输出长度预测,只优化当前步;BR-H 加入一个很短的固定前视窗口。两者共享同一套 F-score 思想与两阶段分配框架。
BR-0:从失衡变化量推导 F-score
假设当前最大负载是 ,worker 的负载是 。它距离最高水位还有一段“安全余量”:
现在从等待池选择一个请求子集 ,其入场时的总 KV 工作量为:
把 放到 后,只有这个 worker 的负载增加。新的最大负载是:
最大值的增量等于超出安全余量的部分:
这里 。总负载则增加 。代入失衡定义,可得:
BalanceRoute 把失衡减少量定义成 F-score:
这个公式的关键不是复杂,而是它在 处发生折线转折。
当 时,请求没有制造新峰值:
每填入一个单位的工作量,总失衡就减少一个单位。此时应该尽量把轻载 worker 的“凹槽”填满。
当 时,worker 反而成为新峰值:
越过最高水位后,每多放一个单位,最大负载上升 1;因为有 个 worker, 项增加 ,总负载只增加 1,净失衡恶化 。集群越大,溢出惩罚越陡。
举一个 的例子。某 worker 距最高水位还有 token:
- 放入 900 token,,是纯收益;
- 放入 1000 token,,正好填平;
- 放入 1100 token,,仍比不放更均衡,但边际收益已经急剧下降;
- 放入 1200 token,,这次 admission 会让当前步更不均衡。
JSQ 看见的可能只是“这个 worker 少一个请求”,而 F-score 看见的是“这个请求会不会越过全局峰值,以及越过后要让多少 worker 等它”。
两阶段分配:把算力花在最敏感的最后几个槽位
若对所有等待请求与所有 worker 做全局组合优化,候选数很快爆炸。BR-0 用一个阈值 把过程拆成两段。令剩余总槽位为:
当空闲槽位很多时,Stage 1 先选择 free capacity 最大的 worker;并列时选当前负载更小者。然后在等待请求中选单请求 F-score 最高的一项。这个阶段每次只做贪心单项选择,因为早期错误仍有许多后续槽位可以修正。
当 时进入 Stage 2。剩下的每个槽位都可能决定谁成为 straggler,于是算法把有空位的 worker 放进优先队列,排序键同时考虑剩余容量与安全余量。对每个取出的 worker,只查看等待队列头部至多 个候选,选择使 F-score 最大、且数量不超过剩余槽位的子集。
若最优 F-score 不大于 0,算法仍放入单个相对最好的请求。这是 starvation guard:如果完全服从瞬时失衡目标,一个很长的 prompt 可能永远无法入场。保护规则接受一次局部变差,换取全局可服务性。
其逻辑可压缩为下面的伪代码:
while free_slots > greedy_threshold: g = worker_with_most_capacity(tie_break=lowest_load) i = argmax_request F(g, {i}) admit(i, g)
priority_queue = workers_with_free_slots()while priority_queue and waiting_pool: g = priority_queue.pop() candidates = waiting_pool.head(R_max) Q = argmax_subset F(g, Q) if F(g, Q) <= 0: Q = best_single_request(g) admit(Q, g)BR-H:预测短期“谁会离场”,而不是猜完整输出长度
BR-0 的盲点是只看当前快照。假设 worker A 当前比 B 轻 500 token,但 A 上的请求都还会运行很久,而 B 上有几个请求马上结束;只按当前余量填 A,几十步后可能得到相反结果。
BR-H 采用固定窗口 ,先预测各 worker 在 的负载。令 表示 worker 在未来第 步相对负载包络的安全余量, 是这 个余量组成的向量;折扣向量为:
控制对远期预测的信任。BR-H 的 F-score 是:
第一项是在整个窗口内填补轻载 worker 的累计收益, 控制收益强度;第二项累加每个未来步骤的溢出惩罚, 控制对预测误差与 barrier 代价的权衡。 越小,越强调眼前可靠状态; 越大,越不愿意制造预测峰值。
当 、、 时,向量退化成单个当前步,BR-H 正好还原 BR-0。这不是两个互不相关的启发式,而是一族从无预测到短前视的路由器。
预测接口只回答一个有限问题
BR-H 不要求准确猜出请求最终会生成 2173 还是 2416 个 token。对活动请求 ,它只需要估计未来 步内的期望存活贡献:
是剩余输出长度, 表示可用请求特征, 是已生成长度。这个目标可拆成“是否会在窗口内结束”与“若会结束,平均还剩几步”:
是未来 步内结束的概率, 是在确实会结束这一条件下的剩余步数均值。若结束概率接近 0,估计自然回落到保守值 ;若接近 1,才采用较短的条件均值。
论文实现给出两种低成本估计器。Survival 直接查询历史输出长度的经验累积分布,不需要请求特征;ExactMatch 为重复 prompt 或模板维护按 prompt hash 分桶的经验分布,匹配失败时退回 Survival。它们都比预测完整重尾输出长度更稳健,也让 BR-H 在看不懂新请求时能够平滑退化,而不是被一个高方差回归值牵着走。
为什么它能够扩展到大规模集群
“把组合优化交给 Python 代理”听起来很容易失控。BalanceRoute 能在毫秒级运行,依赖的不是更快的通用整数规划器,而是三个结构化约束。
只在容量稀缺时求子集
Stage 1 覆盖绝大多数空闲槽位,只做 worker 选择与单请求打分。Stage 2 才处理组合问题,而且候选窗口被 截断。论文真实系统设置 时,每个 worker 最多枚举 个子集,开销很小。
官方仓库的初始开源版本为了复现实验,把默认候选窗口扩为 ,并对不超过 16 个候选做精确枚举。仓库 README 明确说明,这一版包含核心路由器、CPU 模拟器和合成 benchmark;终止预测器、服务集成与论文完整评测代码计划在会前补全。因此,“论文部署已实现”和“当前公开仓库能直接部署”不是一回事,现阶段仓库更适合验证算法与指标。
子集身份最终压缩成 prompt 长度之和
对固定 worker,F-score 并不关心子集 里每个请求的 ID,只依赖:
这让子集选择可以规约为“哪些总和可达”。设候选 prompt 长度都是整数,对每个子集基数 维护一个 bitset dp[j];第 位为 1 表示恰好选 个请求能得到总和 。处理长度 时执行:
dp[j] |= dp[j - 1] << s_i从大到小更新 就是标准 0/1 背包。BR-0 的 F-score 只有一个折点 ,只需在可达总和中检查折点两侧最近值即可得到精确最优。BR-H 最多有 个折点,可以对所有可达和求值,或在每个不同的未来 margin 附近探测。
若 bitset 长度上界为 、机器字宽为 ,每个 worker 的主要复杂度约为:
它把对候选个数的指数依赖,换成了对 token 总和范围的伪多项式依赖。生产设置中 prompt 有明确最大长度,这个交换是可控的。
未来负载只计算一次,admission 后增量修正
BR-H 在一个调度轮开始时计算全部 worker 的未来负载矩阵、逐步最大包络和 margin。之后每接纳一个请求,只需把它的 prompt 长度增量加到目标 worker 的投影列,并更新包络;不必从头遍历所有活动请求。
官方实现还预先按 margin 排序,保存折扣权重的前缀和。给定候选总和 后,用二分查找定位哪些未来步骤满足 ,即可用前缀和计算所有激活的折线惩罚,而非逐个扫描 个步骤。这样单次 F-score 求值的成本从 降到近似 。
实测调度开销与 Decode 步预算之间仍有数量级差距
在 、 的 DeepSeek-V3 671B 部署中,BR-H 每轮调度的 P50 为 1.20 ms,均值 1.34 ms,P99 为 2.77 ms;Qwen3-30B-A3B 上 P50 为 1.03 ms,P99 为 2.52 ms。对比约 60 ms 的引擎 step,调度器中位开销约低 50 倍,P99 也低约 22 倍。Stage 2 占总开销约 69%,说明优化重点确实在组合选择,而不是状态读取。
不过这组数据不能直接外推到数百个 worker、数千个候选或更大的 。算法快,是因为候选窗口、短 horizon 和增量状态共同限定了问题规模;放开任何一个边界都要重新测量。
实验设计与结果解读
硬件、模型和工作负载
论文在昇腾集群上做端到端验证。主配置运行 DeepSeek-V3 671B W8A8:4 个 Prefill 节点,每节点 16 张 Atlas 910C、TP=8;1 个 Decode 节点含 32 张 NPU,DP=8、TP=4,即 个 Decode worker。规模实验还包括 的 48-NPU 配置与 的 144-NPU 配置。另一组调度开销测试使用 Qwen3-30B-A3B 与 Atlas 910B。
两条 trace 都在接近饱和的重载下回放:
- Proprietary Data:8000 个生产请求,平均 prompt 3197 token,平均输出 1185 token,输出长度呈重尾分布;
- Azure-2024:来自公开 Azure LLM Inference Trace 的 conversation split,筛选输出长度大于 1000 token 的 10000 个请求,平均 prompt 4652 token,平均输出 1052 token。
筛掉短请求是一个重要口径。它有助于隔离 Decode 失衡最明显的长作业区间,但也意味着实验结论不能直接解释短问答、低并发或 Prefill 主导的线上混合流量。
基线包括 Random、Round-Robin、P2C 和 vllm-ascend 默认的 JSQ。评价指标有三个:逐步最大与最小 KV 负载差的轨迹均值、TPOT P95,以及输出 token/s。论文只报告 Decode 阶段指标,因为路由策略不改变 Prefill 计算。
轨迹先于汇总数字:真正被压掉的是垂直展开
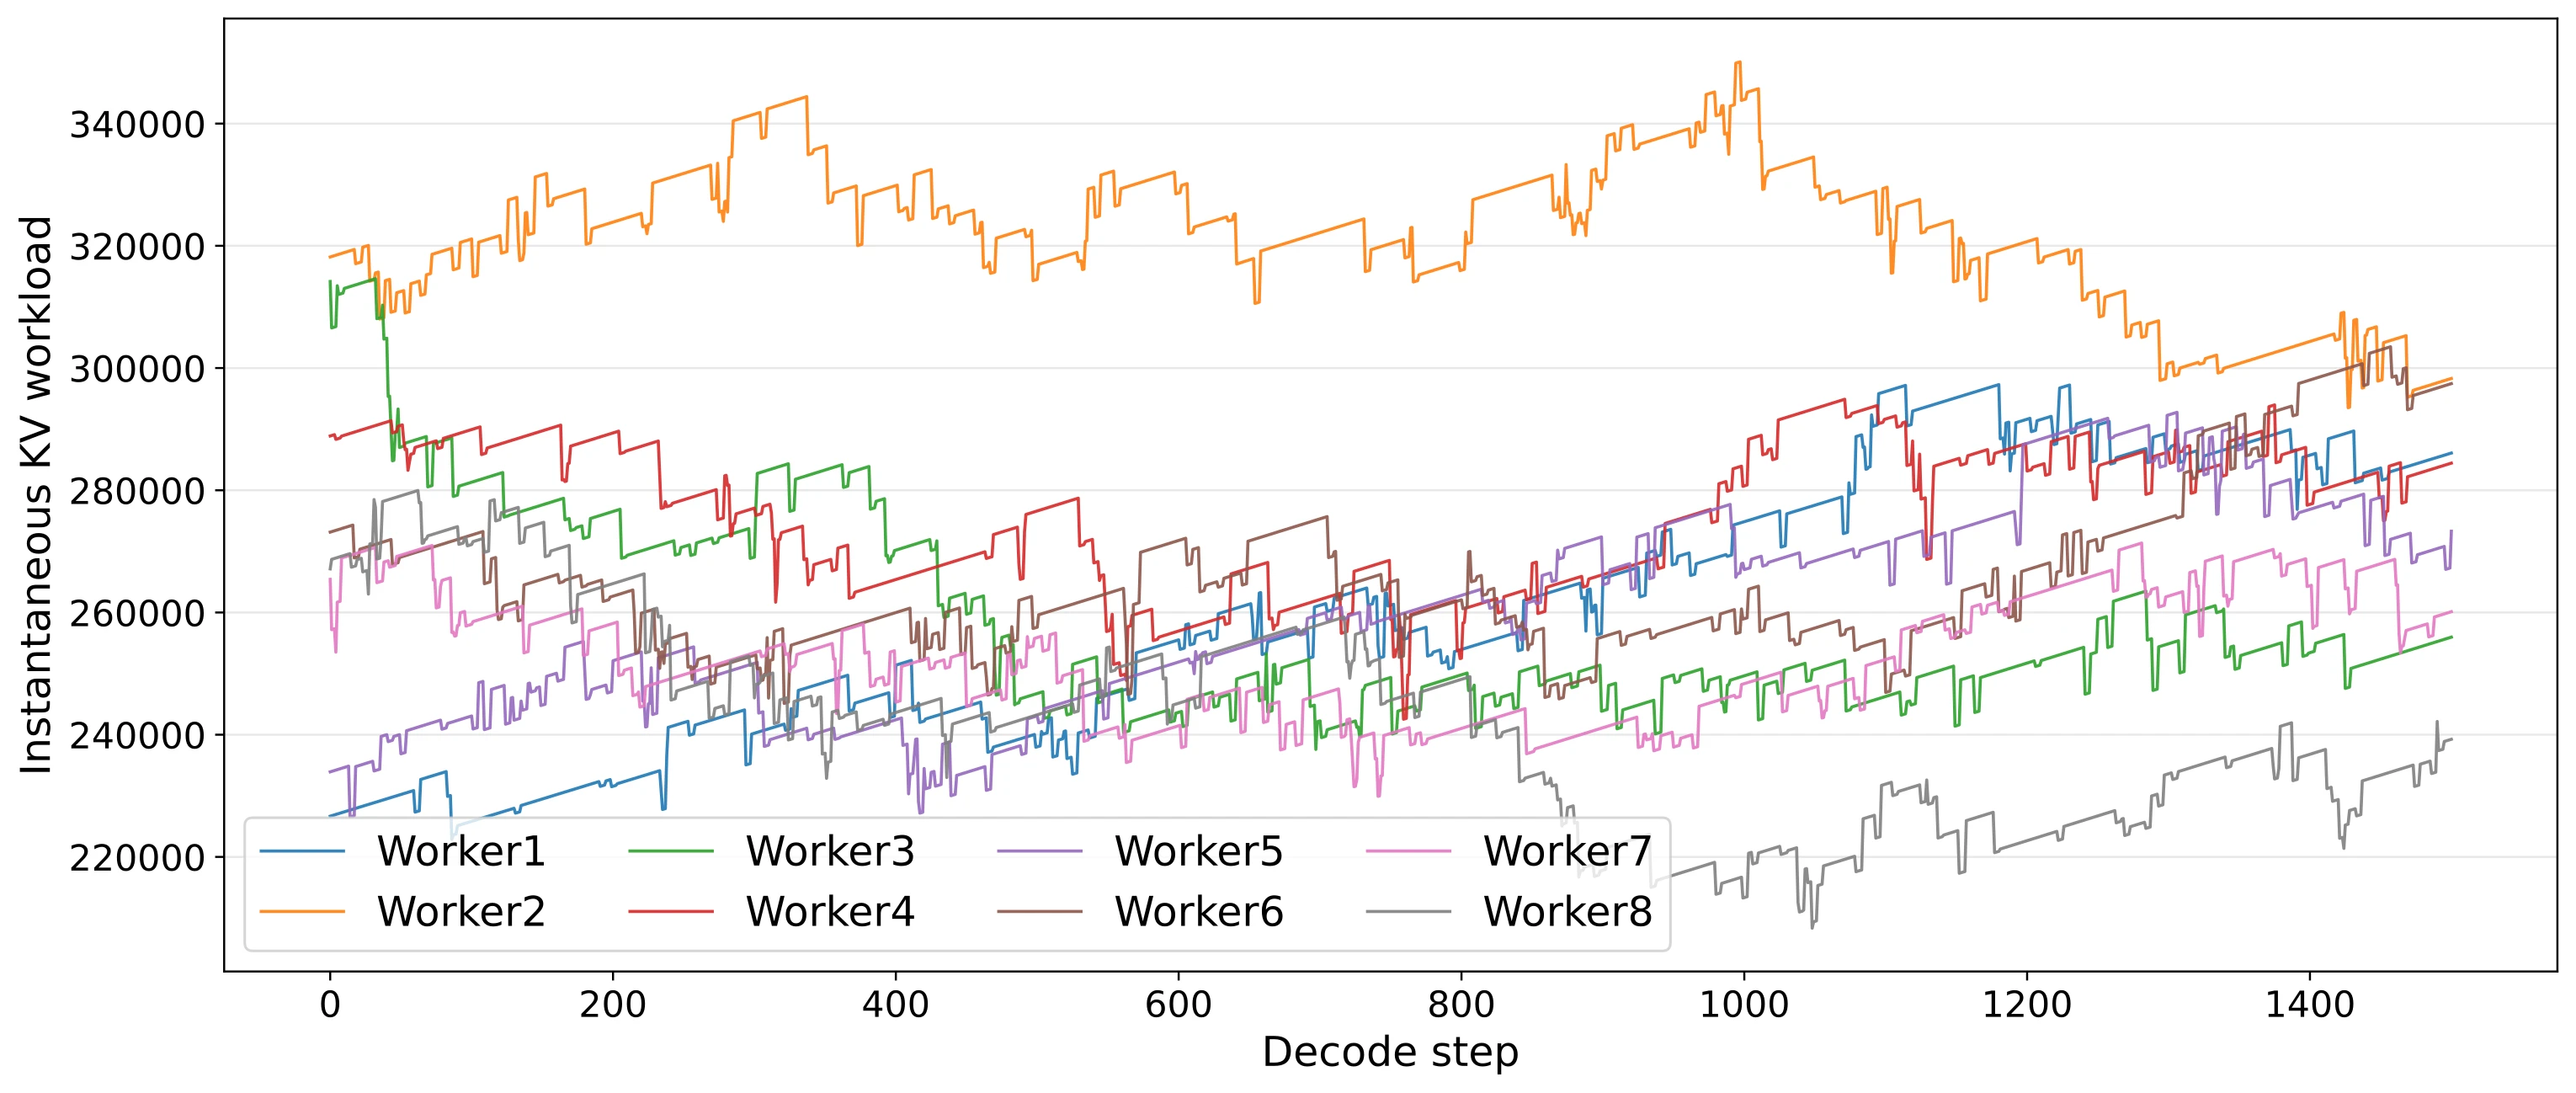
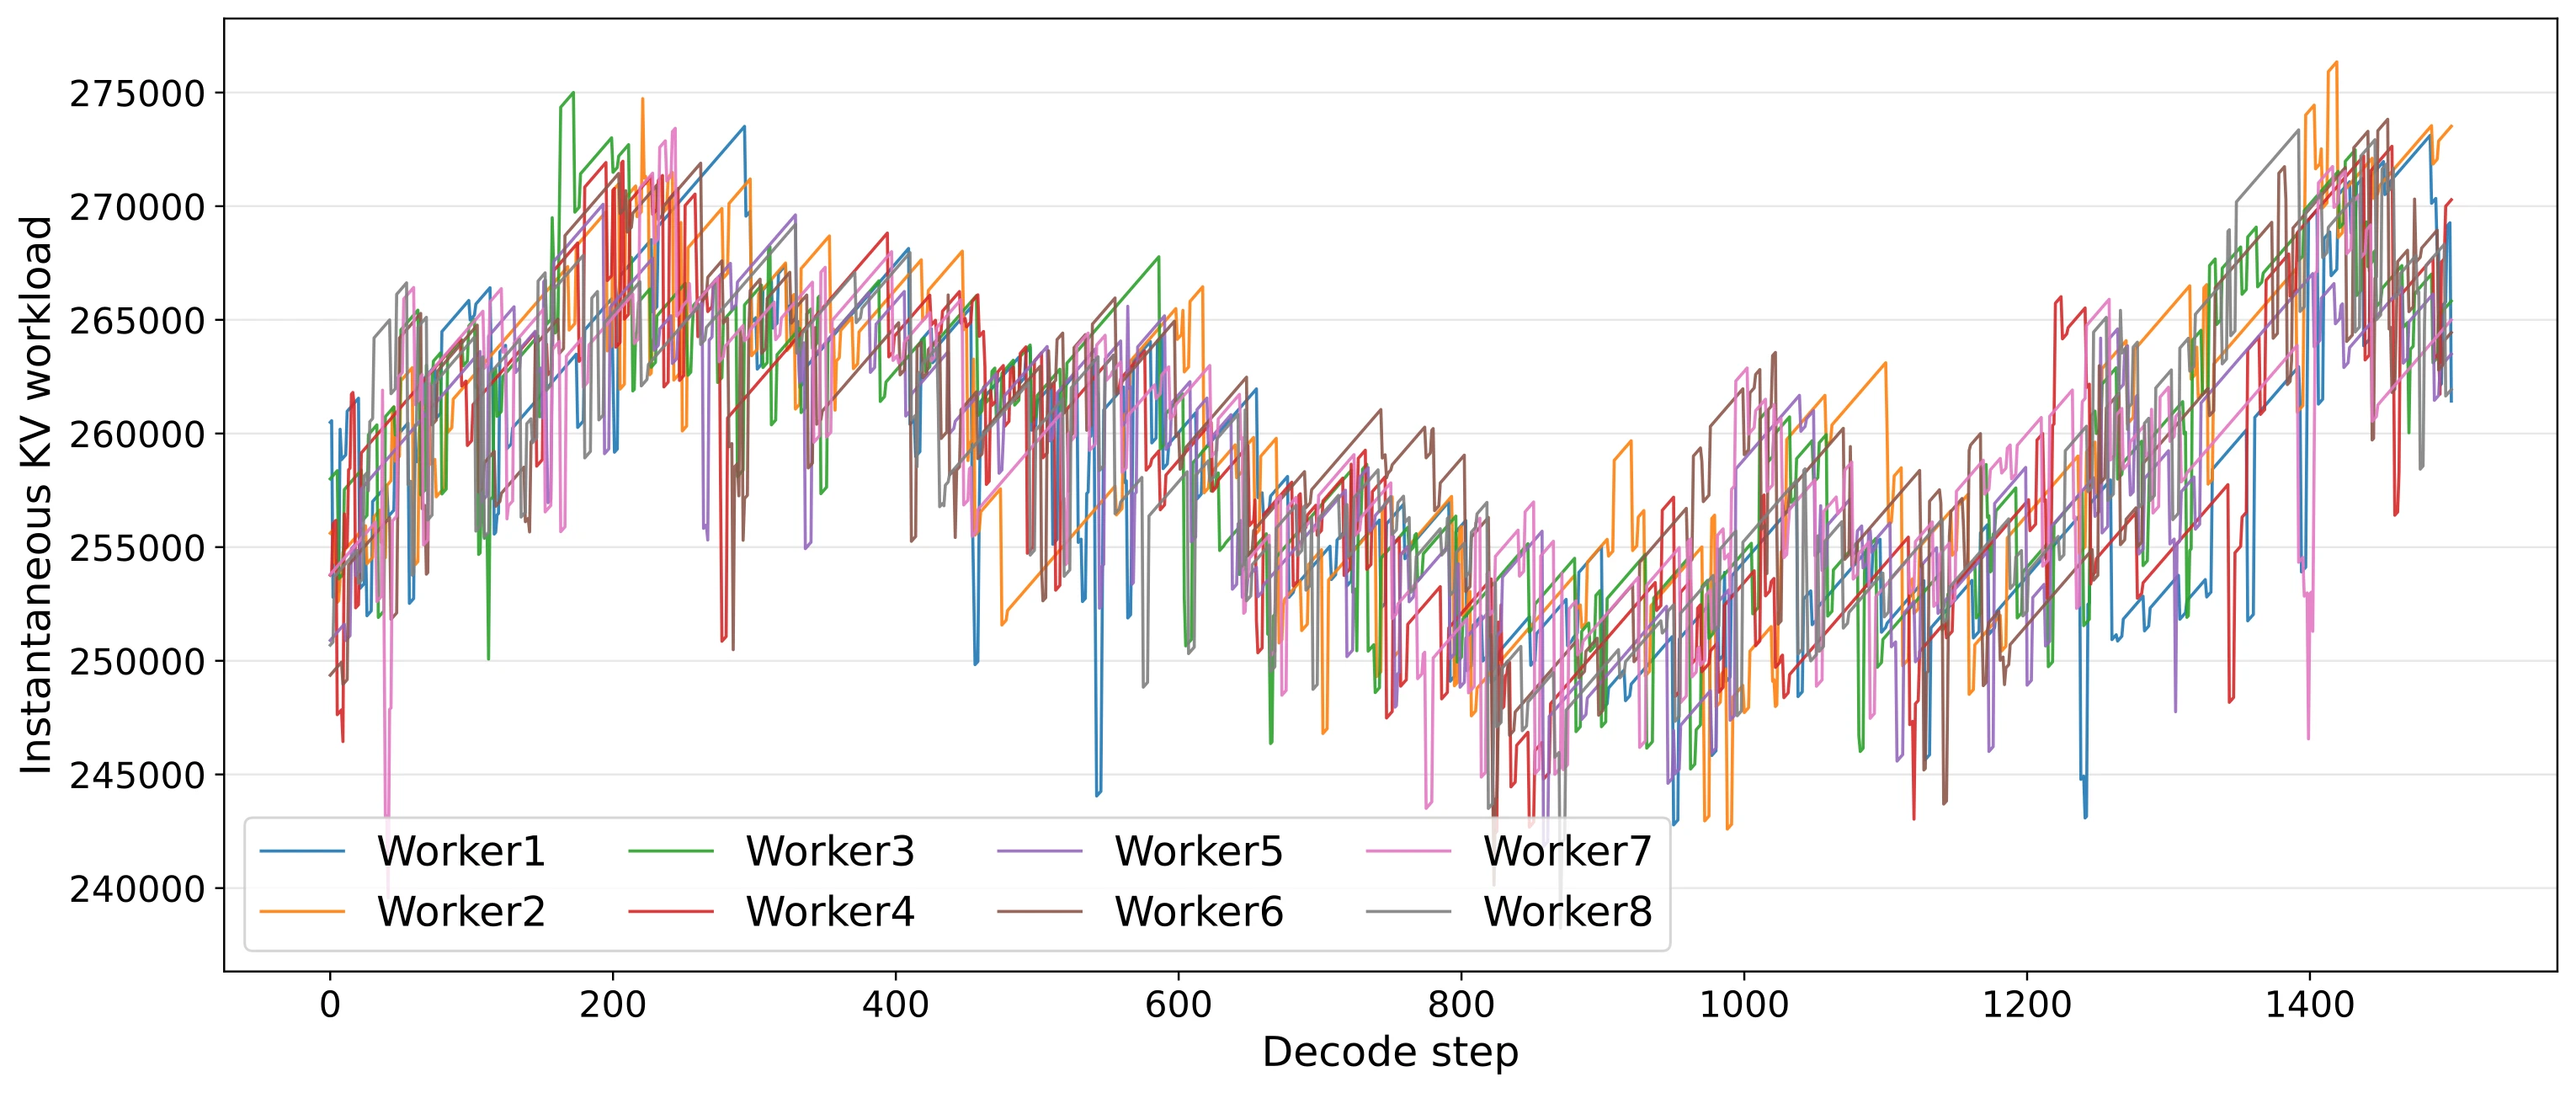
两图分别来自 BalanceRoute 论文 Figure 3 的 Random 与 BR-H ExactMatch 面板。横轴是同一段 1500-step Decode 轨迹,纵轴是各 worker 的 KV-cache workload。Random 下 8 条曲线长期分叉;BR-H 下曲线仍有局部尖峰,却明显聚拢。算法不是让每一步绝对相等,而是阻止小偏差通过粘性分配长期累积成新的 straggler。
主结果:无预测版本已经拿到大部分收益
下面保留论文 主表中最能说明机制的几行:
| 方法 | 私有 trace 失衡 | 私有 TPOT P95 | 私有吞吐 | Azure 失衡 | Azure TPOT P95 | Azure 吞吐 |
|---|---|---|---|---|---|---|
| Round-Robin | 254798 | 83.2 ms | 847 tok/s | 110049 | 89.1 ms | 771 tok/s |
| JSQ | 215110 | 83.2 ms | 843 tok/s | 104737 | 89.3 ms | 785 tok/s |
| BR-0 | 51927 | 79.3 ms | 943 tok/s | 54051 | 83.3 ms | 854 tok/s |
| BR-H,ExactMatch | 36277 | 78.8 ms | 977 tok/s | 38496 | 82.3 ms | 909 tok/s |
| BR-H,Oracle | 23577 | 78.0 ms | 1029 tok/s | 35301 | 77.3 ms | 957 tok/s |
BR-0 相比最强基线 JSQ,在私有 trace 上把平均失衡降低 4.1 倍、吞吐提升 11.8%;Azure 上失衡降低 1.94 倍、吞吐提升 8.8%。这说明主要收益并不依赖复杂预测器,而来自正确建模 safe margin 与 overflow 的非对称性。
ExactMatch 的吞吐分别达到 977 和 909 tok/s,相比最强基线提升 15.4% 与 14.5%。Oracle 仍然更高,代表短期存活预测若进一步改善,理论上还有空间。但 Oracle 使用 trace 真值,不能当成可部署结果;它的作用是给“预测信息本身值多少钱”提供上界参考。
吞吐提升也没有以尾延迟恶化为代价:部署版 BR-H 在两个数据集上都得到所有方法中最低的 TPOT P95。原因并非额外优化了单请求 kernel,而是减少了 barrier 等待,让整批请求的 token 间隔共同缩短。
扩展到 16 个 worker 时,路由差异被放大
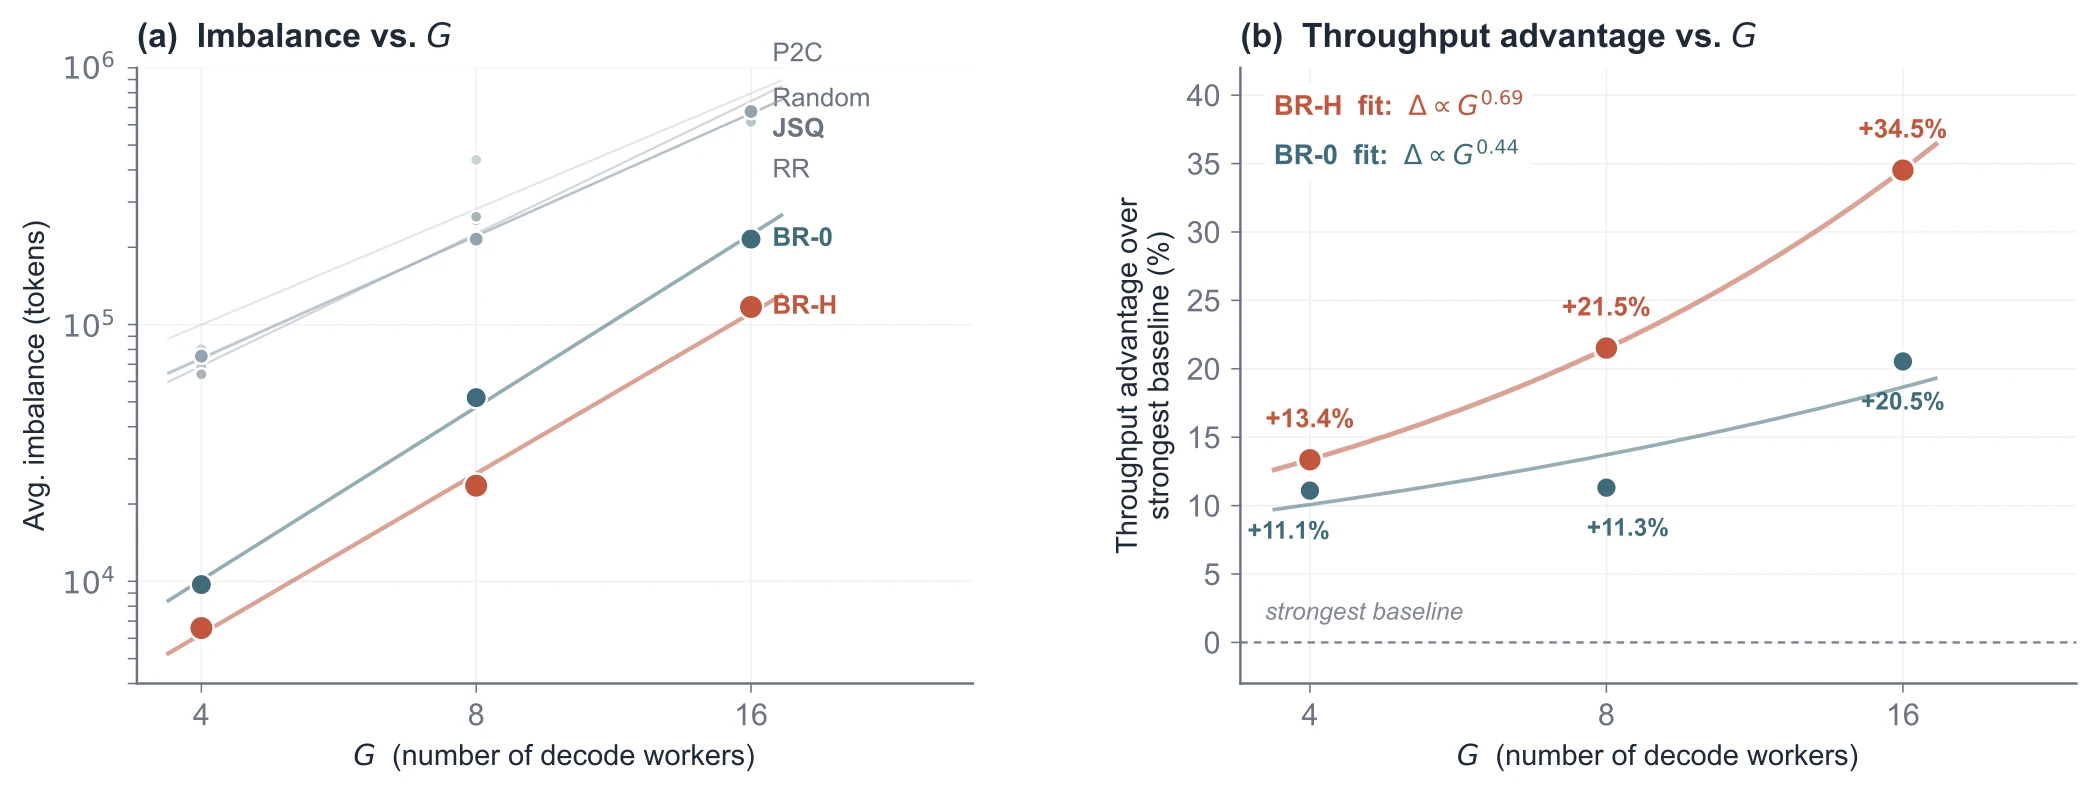
图 5 来源:BalanceRoute 论文 Figure 4。实验保持每个 worker 的 offered load 大致不变,并把到达率随 成比例放大。BR-H 此处使用 Oracle,是为了隔离路由器规模效应与预测器质量。
当 时,BR-H 相比最强基线吞吐高 13.4%; 时高 21.5%; 时扩大到 34.5%。BR-0 的对应优势约为 11%、11% 和 20.5%。这与 F-score 推导一致:跨过安全余量后,每单位溢出的失衡代价是 ,集群越大,避免新峰值越重要。
时 BR-H 的吞吐为 1247.4 tok/s,没有随 worker 数从 8 翻到 16 而翻倍。论文解释,这个配置从 4P1D 变成 5P1D,Decode worker 数翻倍却只增加一个 Prefill 节点,Prefill 与 Decode 的资源比例从 变为 。所以该图适合比较同一 下不同路由器,不适合把绝对吞吐当作理想线性扩展曲线。
参数不需要精确到唯一点,但不是完全免调
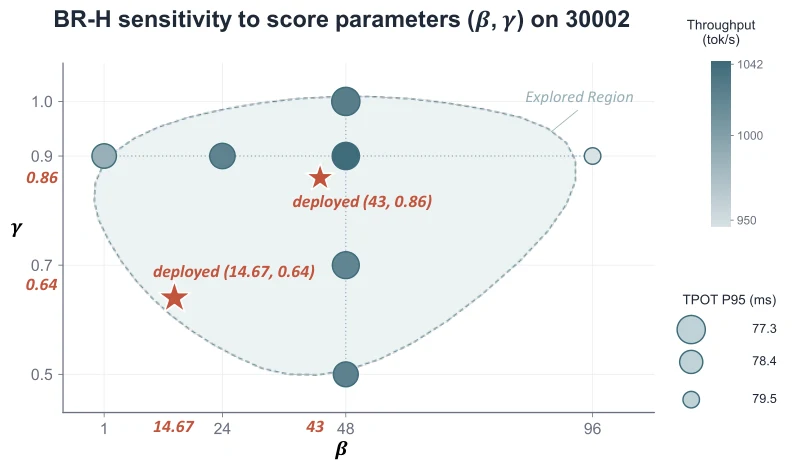
图 6 来源:BalanceRoute 论文 Figure 13。圆点是 、Oracle 条件下七组 交叉扫描,颜色越深表示吞吐越高,点越大表示 TPOT P95 越低;星号是论文采用的两个部署工作点。
扫描中吞吐范围为 945–1042 tok/s,TPOT P95 为 77.3–79.5 ms,所有配置都显著优于最强基线。说明算法的收益并不依赖某个极窄参数点。不过 与 仍有明确语义:预测噪声越大,通常越应缩短有效 horizon,也就是减小 ;worker 数越多或 barrier 惩罚越重,越需要认真校准 overflow 权重 。不能把论文在特定 NPU、模型和 trace 上的 原样当作通用默认值。
与常见路由策略的关系
BalanceRoute 与已有调度方法处在不同层级。把这些层级混在一起,会误以为它只是“另一个最短队列”。
| 方法 | 主要观测量 | 决策层级 | 没有显式表达的因素 |
|---|---|---|---|
| Round-Robin | 上次选到哪个 worker | 请求入场 | 请求大小、KV 增长、完成时间、barrier |
| JSQ | 活动请求数或队列长度 | 请求入场 | 每个请求的 token 工作量与峰值代价 |
| P2C | 随机两个 worker 的局部负载 | 请求入场 | 全局包络与最后几个槽位的组合效应 |
| Least Token Load | 当前 token 总量 | 请求入场 | 未来完成事件与越过最大值后的集群级惩罚 |
| BR-0 | 当前 KV 工作量、槽位、等待池 | 每轮批量 admission | 请求未来何时离场 |
| BR-H | 当前状态加短期存活贡献 | 每轮批量 admission | horizon 之外的未知到达与长期行为 |
与连续批处理的关系
连续批处理决定单个 worker 内部“每个 step 哪些请求在跑”,BalanceRoute 决定 Prefill 完成的请求“进入哪个 worker”。前者消除请求级整批等待,后者减少跨 worker 的同步空洞。二者互补;没有连续批处理,worker 内部 padding 和空槽浪费可能先成为主瓶颈。连续批处理的基础机制可参考本站 连续批处理完全拆解。
与 PagedAttention 的关系
PagedAttention 解决 KV Cache 的内存碎片、块分配与共享问题,让 worker 能容纳更灵活的大 batch;BalanceRoute 把 KV token 总量当作负载代理,决定这些 KV 页应该在哪个 worker 上增长。分页不会自动消除跨 worker 失衡,路由也不会替代页级内存管理。相关机制可参考 PagedAttention 完全拆解。
与 P/D 分离和缓存感知路由的关系
BalanceRoute 建立在 P/D 分离之上:Prefill 完成后的 KV 先留在 producer,直到 Decode 路由器选择 consumer。这样 admission 可以晚绑定,但也引入 Prompt Pool 等待与跨层 KV 传输。DistServe 关心 Prefill 与 Decode 的资源分配、放置与 goodput,BalanceRoute 进一步解决 Decode tier 内部的 DP worker 失衡,可与 DistServe 完全拆解 对照阅读。
前缀缓存感知路由会把请求送到已有共享前缀的 worker,目标是省掉 Prefill 或 KV 构建;BalanceRoute 的目标是压低 Decode barrier 最大负载。两个目标可能冲突:缓存命中最高的 worker 也许正是当前 straggler。生产路由器最终需要联合代价函数,比较“省下多少 Prefill/KV 传输”与“增加多少未来 Decode 空等”,而不是串行执行两个互不知情的贪心规则。
与模型路由、TokenRouter 和 MoE 门控的关系
模型路由决定请求应由哪个能力/成本档位的模型回答;TokenRouter 可以在生成过程中按 token 改变模型路径;MoE 门控决定一个 token 激活哪些专家。BalanceRoute 假设目标模型与 worker 能力同构,解决同一个模型副本之间的负载布局。它们都叫 routing,但被路由的对象、状态迁移成本和正确性约束完全不同,不能直接横向比较吞吐数字。
工程落地:状态、故障与参数选择
BalanceRoute 的公式很短,真正上线时最难的部分却是确保公式看到的状态可信。一个稳妥的落地顺序如下。
第一步:先证明 KV token 真的是瓶颈代理
在目标模型、硬件与典型 batch 上测量单步时间 与最大 worker KV token 数 的关系。若线性模型:
具有稳定斜率,且 在高负载区占主要部分,BalanceRoute 的目标函数才贴近真实成本。若耗时主要来自固定 kernel 开销、MoE 专家热点、网络拥塞或异构频率抖动,仅按 KV token 平衡可能把“数学上平的负载”映射成“硬件上不平的时间”。此时应把负载代理扩展为测得的 step-time 模型,而不是盲目沿用 token 数。
第二步:先上 BR-0,建立无需预测的安全基线
BR-0 只需要 prompt token 数、每个 worker 的活动集合与并发上限。初始部署可以影子运行:实际仍由原路由器派发,BalanceRoute 只记录自己会如何选择,再离线比较预测的 、真实 step time 与原策略。
上线前至少验证四个不变量:同一请求不能被两个 worker 接纳;活动计数永不超过 ;结束或取消最终必然释放槽位;任何状态异常都能回退到 Round-Robin 或 P2C。只有这些闭环稳定后,短期预测才有加入价值。
BR-0 的 不是自由参数,它在严格推导里应取 worker 数 。官方代码也在 horizon=0 时强制使用 ,避免把 BR-H 的经验参数误带入无预测版本。
第三步:把镜像状态当作可校验缓存
SSE 解析得到的是控制面的镜像,不是真实引擎状态本身。工程上应同时维护:
- 单调 request epoch,阻止重试响应覆盖新状态;
- admission ID 与 worker ID 的幂等映射,重复回调只处理一次;
- 定期全量 reconciliation,用引擎指标纠正丢失的结束事件;
- heartbeat 与 TTL,代理或 worker 故障时回收悬挂条目;
- 负载快照版本号,路由计算结束后若版本变化过大则重新求值。
多副本代理会带来更难的问题:每个代理若只看到自己转发的请求,就无法形成全局包络;共享数据库又可能把毫秒级调度变成网络一致性问题。可行的方案包括单 leader 加热备、按模型或 Decode fleet 分片的 owner,以及将只读状态复制、写入 admission 串行化。论文实现选择单个有状态代理,尚未验证这些高可用设计。
第四步:再引入 BR-H,并从保守 horizon 开始
不宜按“能预测多远”选择,而应按“多远的信息还能改变 admission 排序”选择。horizon 越长,完成事件信号更多,但未来到达不可见、预测误差和计算量也同步增加。论文使用 ;换到不同 TPOT、流量和模型后,应换算成实际时间窗口再评估,而不是固定 80 步。
Survival 估计器适合无强特征、分布相对稳定的流量;ExactMatch 只在 prompt 重复或模板稳定时有额外价值。需要持续监控 prompt key 命中率、结束概率校准误差、预测与 Oracle 离线差距,以及 BR-H 相对 BR-0 的净收益。分布漂移时,降低 或直接退回 BR-0 比继续相信失真的远期预测更安全。
第五步:同时预算等待池与 KV 传输
Prompt Pool 给 Stage 2 提供组合选择空间,却会推迟 KV consumer 的确定时间。等待过久会增加 TTFT/TPOT,还会让 Prefill producer 长时间占着待交接 KV。系统需要三道边界:池内请求 TTL、Prefill KV utilization back-pressure,以及每个 Decode worker 的 in-flight KV transfer 上限。
论文还提供 BR-0 pool-bypass 路径:Prefill 一完成就按单步 score 选择 worker,用“正在运行 + 已派发但尚未运行”的虚拟负载防止过量发送,并让 KV transfer 与当前计算重叠。它牺牲了批量子集选择的空间,换取更早传输和更低端到端延迟。选择 pool 还是 bypass,本质上是在路由质量与 admission 等待之间做系统级权衡。
需要持续观测的指标
只看总吞吐会掩盖公平性与故障。生产仪表盘至少应包括:
- 每步 、总缺口 与 barrier idle 比例;
- 每个 worker 的活动请求数、KV token 数、step time 与通信时间;
- Prompt Pool 深度、等待时间分位数、TTL 超时与 starvation guard 触发率;
- KV transfer 排队、传输耗时、重试与重算次数;
- 路由 P50/P95/P99、Stage 1/2 分解与快照重算率;
- 请求级 TTFT、TPOT、端到端完成时间,以及不同长度桶之间的公平性。
当 token 失衡下降而 barrier idle 不降时,问题大概率不在 F-score,而在负载代理与真实硬件耗时脱节;当吞吐上升而池等待尾部恶化时,则说明 admission 的组合收益被晚绑定传输吃掉。把这两类问题分开诊断,比继续微调 更有效。
局限与适用边界
第一,论文的大规模结果来自 Atlas 910C、DeepSeek-V3 W8A8 与特定 vllm-ascend/MooncakeConnector 栈。算法本身与硬件无关,但“KV token 近似 step cost”的斜率、最优 horizon、路由预算和跨层传输代价都依赖硬件与 kernel。CUDA GPU、不同注意力后端或异构 worker 需要重新标定。
第二,主实验刻意选择接近饱和、输出超过 1000 token 的 Decode 主导负载。在低利用率下,大多数 worker 没有排队,复杂路由的收益很小;在短 prompt、短输出或 Prefill 主导场景,P/D 配比与 TTFT 可能比 Decode barrier 更关键。
第三, 把请求成本约化成上下文长度,忽略了分页粒度、量化 KV、稀疏注意力、不同采样路径和 MoE 专家偏斜。对全注意力、同构请求它很合理;若不同请求触发不同多模态编码器、不同 LoRA、不同稀疏模式或不同专家热点,就需要多维负载模型。
第四,BR-H 的规模扩展图使用 Oracle 剩余长度,真实预测器只在 主配置上验证。随着 增大,错误地预测一个 worker 即将释放负载,可能影响更大的全局包络。论文把“预测噪声如何随规模相互作用”留作后续问题,因此不能把 Oracle 的 增益视为部署版的既成结果。
第五,论文说明受 144-NPU 集群成本与可用性限制,生产规模实验没有做大量独立重复回放。trace replay 保证各方法面对相同请求,但单次端到端运行仍可能受到网络、温度、频率与后台任务扰动。表中的百分点应理解为这套配置下的测量,而非跨平台置信区间。
第六,集中式代理是控制面单点。它需要持有所有活动请求状态、解析所有流式输出并参与 KV 生命周期。若代理进程暂停或状态丢失,影响可能覆盖整个 fleet。算法论文证明了集中视角的价值,但高可用、水平扩展与控制面卸载仍需额外系统设计。
第七,BalanceRoute 默认 admission 后不迁移。对超长异常请求,starvation guard 只能保证它最终入场,不能阻止它长期成为 straggler。若底层支持廉价的远端 KV 访问、异步迁移或分层缓存,路由器可以把“是否迁移”纳入动作空间;但那已经是另一类动态重配置问题。
最后,优化平均 barrier 失衡不自动等于满足每个租户的 SLO。等待池中的大请求、低优先级请求与重试请求需要独立的 aging、优先级和配额规则。F-score 负责摆放工作量,公平性策略负责决定谁有资格进入候选集,两者应该明确分层。
小结
BalanceRoute 的核心贡献不是再发明一种“选最空 worker”的启发式,而是把同步屏障下的边际代价写成了可实时求解的折线函数:安全余量以内,每增加一个 token 都在填平空洞;一旦越过当前最大值,每增加一个 token 会给其余 个 worker 制造等待。
BR-0 只利用当前 KV 负载,已经在论文的两个重载 trace 上显著超过 JSQ;BR-H 再用固定短 horizon 判断哪些活动请求即将离场,不必预测完整重尾输出长度。两阶段 admission、有限候选窗口、可达和结构与增量包络更新,把原本难以在线求解的组合路由压进约 1–3 ms。
这套方法最重要的工程启发有三点:负载指标必须贴近真正的 barrier 时间;最后几个稀缺槽位比前面的大量空槽更值得精细优化;预测器只应提供决策真正消费的最小信息。它适合 P/D 分离、长上下文、高并发、同步耦合的 Decode fleet,并不是所有多副本服务的通用替代品。
参考资料
- Tackling the Data-Parallel Load Balancing Bottleneck in LLM Serving: Practical Online Routing at Scale
- BalanceRoute 官方代码仓库
- vLLM Router:Load Balancing Policies
- vLLM:MooncakeConnector Usage Guide
- Mooncake 官方项目
- DistServe: Disaggregating Prefill and Decoding for Goodput-optimized Large Language Model Serving
- Efficient Memory Management for Large Language Model Serving with PagedAttention
- Microsoft Azure Public Dataset
- vLLM Ascend 官方仓库
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



