


llama.cpp 源码完全拆解(十):多模态输入——mtmd 如何把一张图片变成模型看得懂的 token,并塞进一个 slot
本篇在这条路线上接在哪
前面九篇按仓库地形依次拆过 llama.cpp:整体架构(ggml 后端、llama_model/llama_context 的职责划分)、ggml 计算图与内存分配、GGUF 装载与 mmap、llama_context 与 KV Cache/slot 组织、采样与 GBNF 语法、图构建与注意力、后端与 kernel、server-context 调度、投机解码。
这一篇处理一个此前刻意绕开的模块:多模态输入。llama.cpp 里负责这件事的并不是 llama_* 主接口,而是仓库根目录下的 tools/mtmd/(Multi-modal tooling)。它把一张图或一段音频切成模型能吃的 token,在文本流里占位,再交给 llama_decode 与视觉编码器各自接力。
读完这篇应该能回答下面几个问题,也是源码里最容易卡住的几处:
- 为什么 llama.cpp 要把多模态放在
tools/而不是 core? - 一张任意分辨率的图,是怎么被拆成若干「切片(slice)」再拼回一条 token 序列的?
mtmd_encode与mtmd_decode到底做了什么,为什么它们不能和llama_decode的顺序颠倒?- 一个 server slot 里既有文本 KV 又有图片 embedding,显存预算怎么算?为什么
-np调大以后长图请求会直接报错? - 和 vLLM/SGLang 的「placeholder + 嵌入回填」相比,llama.cpp 的差别在哪里,代价是什么?
为什么多模态不放在 core
打开 tools/mtmd/ 会看到一个很干净的头文件 mtmd.h,它只暴露少数几个 API:
struct mtmd_context;struct mtmd_bitmap;struct mtmd_image_tokens;struct mtmd_input_chunk;struct mtmd_input_chunks;
mtmd_context * mtmd_init_from_file(const char * mmproj_fname, const llama_model * text_model, mtmd_context_params params);struct mtmd_image_tokens * mtmd_encode(mtmd_context * ctx, const mtmd_bitmap * image);int32_t mtmd_decode(mtmd_context * ctx, struct llama_context * lctx, const mtmd_image_tokens * image_tokens);int32_t mtmd_tokenize(mtmd_context * ctx, struct mtmd_input_chunks * output, const mtmd_input_text * text, const mtmd_bitmap ** bitmaps, size_t n_bitmaps);这个接口设计背后有两个约束。
第一,视觉编码器是另一个 GGUF 文件。llama.cpp 加载语言模型时只认 llama_model,而多模态需要额外加载 mmproj(multimodal projector)权重。如果把这段逻辑塞进 libllama,core 就要依赖 clip 的算子集合(ggml 里的卷积、im2col、layer norm 等),而这些算子和纯语言推理的图构建逻辑是两套东西,混在一起会让 llama-graph.cpp 变得臃肿。放在 tools/ 下,mtmd 就是一个独立小库,只有 tools/server 和 examples 按需链接它。
第二,token 化策略需要可变。不同模型(Qwen2-VL、InternVL、Gemma3、Llava-OV)切图方式、占位 token 的 id、图像前缀都不一样。mtmd 用「clip_ctx 子类 + mtmd_context 里的 image_tokens_type 分支」把这种差异隔离在一层,core 完全不感知。
下图是 tools/mtmd 的目录结构,可以对照着读源码:
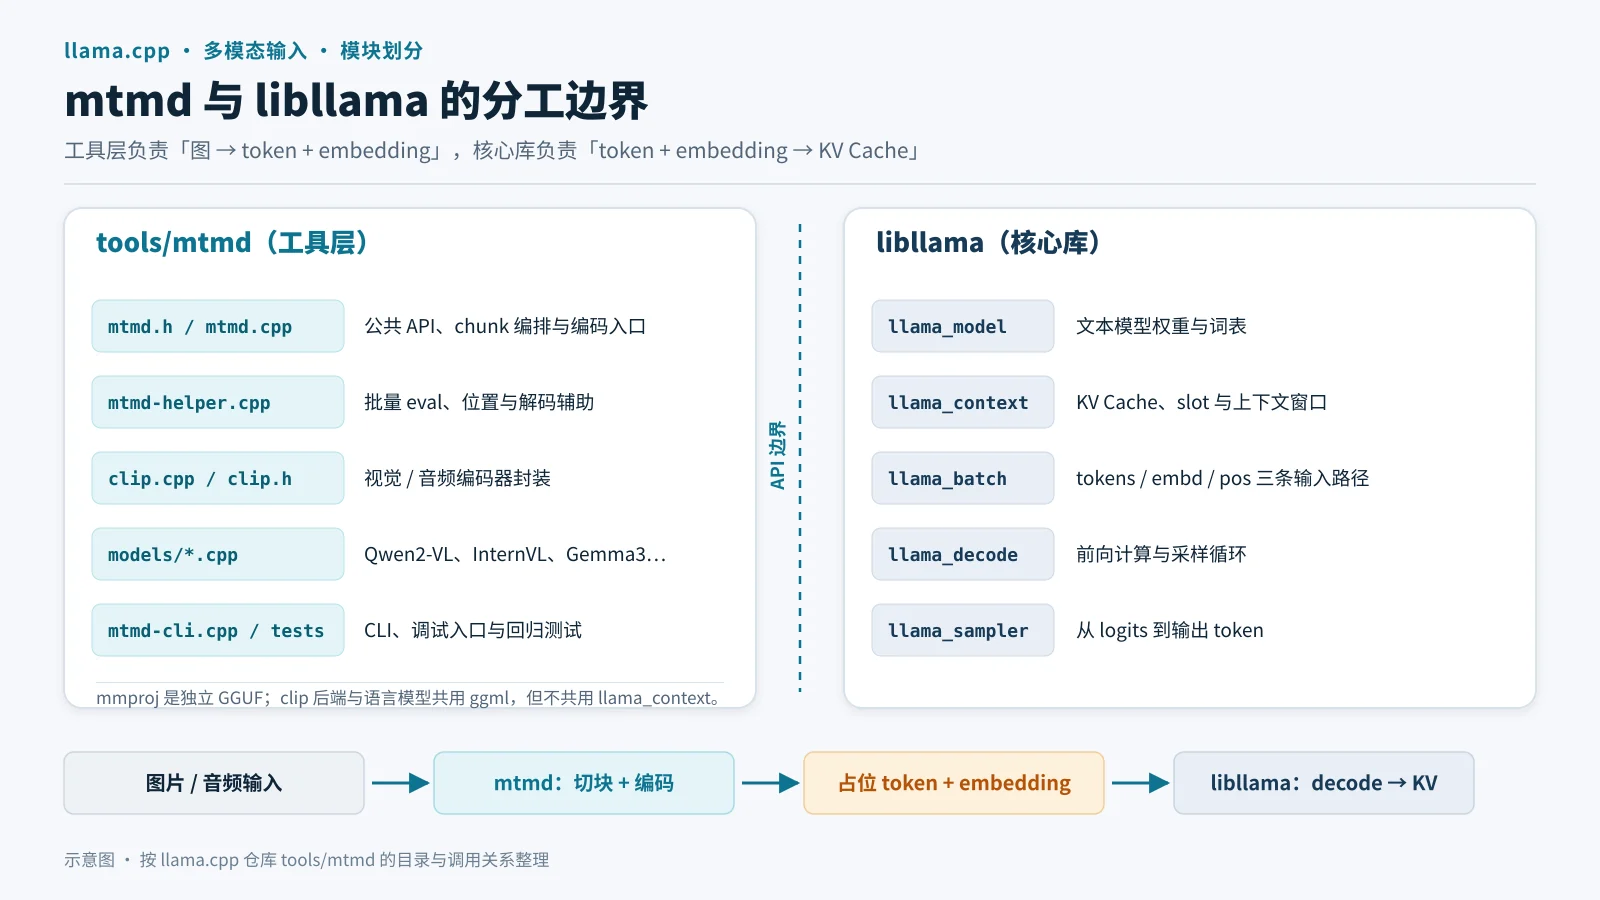
图:mtmd 工具层与 libllama 的边界。mtmd 负责「图 → token + embedding」,libllama 负责「token + embedding → KV Cache」。
从一张图到若干 slice:mtmd 的图像预处理
mtmd_bitmap 是对原始像素的简单封装:宽、高、通道数(RGB 或灰度)、一串 uint8_t 数据。真正把图变形的算法不在 mtmd.cpp,而在 clip.cpp 与各模型专属的 clip-*.cpp。总体流程分三步。
第一步:按模型规则切 slice
以 Qwen2-VL 为例,图像被按固定尺寸切成小块,每个 patch 是 28×28 像素(对应 ViT 里 4×4 的 patch 乘上 2× 下采样的 merge 倍数)。切片算法会先按长宽比决定切成几行几列,再对每个 slice 做一次 resize。代码上大致如下(简化自 clip-impl.h 的 image_preprocess):
// 以 Qwen2-VL 为例,每张 slice 128x128 个 pixel 单位const int patch = 28;const int max_grid = 32; // 32x32=1024 个 slice 的上限double h = img->nx, w = img->ny;int grid_h = ceil(h / (patch * 0.5)); // 粗略估计,随后被 clampint grid_w = ceil(w / (patch * 0.5));if (grid_h * grid_w > max_grid * max_grid) { // 按长边缩放,使 slice 总数不超过 1024 ...}这里值得解释三个设计点。
- 为什么要切 slice,而不是一次 resize 成固定尺寸? 因为多模态模型对分辨率的感知取决于 token 数量。切得多,模型看到更细的细节(适合读表格、小字),但 token 也更多。切得少则省 token。Qwen2-VL 的设计允许「动态分辨率」,mtmd 只是忠实地按这种设计输出 slice 数。
- 为什么
max_grid是 1024? 这是模型侧的约束:Qwen2-VL 在训练时见过的最大 patch 数对应 1024 个 slice,超过就超出位置编码外推能力。mtmd 在切图时直接 clamp,避免模型收到训练分布外的输入。 - 为什么补齐行数列数? 切图后
grid_h × grid_w通常不是整齐排列的,拼接时用空白 slice 补齐成矩形,否则位置编码会乱。这解释了为什么不同宽高比的图算出来的 token 数往往比你手算的多一点。
第二步:每个 slice 归一化并转成灰度/ RGB 浮点
这一步在 clip.cpp 里完成:把 uint8_t 像素转成 float,减均值除以标准差(不同模型均值方差不同,如 CLIP 系列是 (0.48145466, 0.4578275, 0.40821073)),再按模型要求排成 [batch, channel, height, width] 或 [batch, height, width, channel]。这一步只是预处理,真正耗时的是下一步。
第三步:每个 slice 送进视觉编码器
mtmd_encode 的循环结构在 mtmd.cpp 里:
struct mtmd_image_tokens * mtmd_encode(mtmd_context * ctx, const mtmd_bitmap * image) { mtmd_image_tokens * image_tokens = mtmd_tokenize_image_tokens(ctx, image); // 切 slice、算占位 token 数 // 对每个 slice 单独建一次 clip 图,并复用同一份 compute buffer for (auto & slice : image_tokens->slices) { clip_image_f32_batch batch; clip_image_f32 * img_f32 = clip_image_preprocess(ctx->ctx_v, slice); batch.add(img_f32); clip_image_encode(ctx->ctx_v, params.n_threads, batch, embd_buf.data()); // 把 embd_buf 拷进 image_tokens->data } return image_tokens;}注意这里的 ctx_v 是 clip_ctx,clip_image_encode 内部调用 ggml_backend_graph_compute,与语言模型用的是同一类 ggml 后端,但不是同一个 llama_context。
下图展示了 Qwen2-VL 的切片与 token 序列拼装关系:
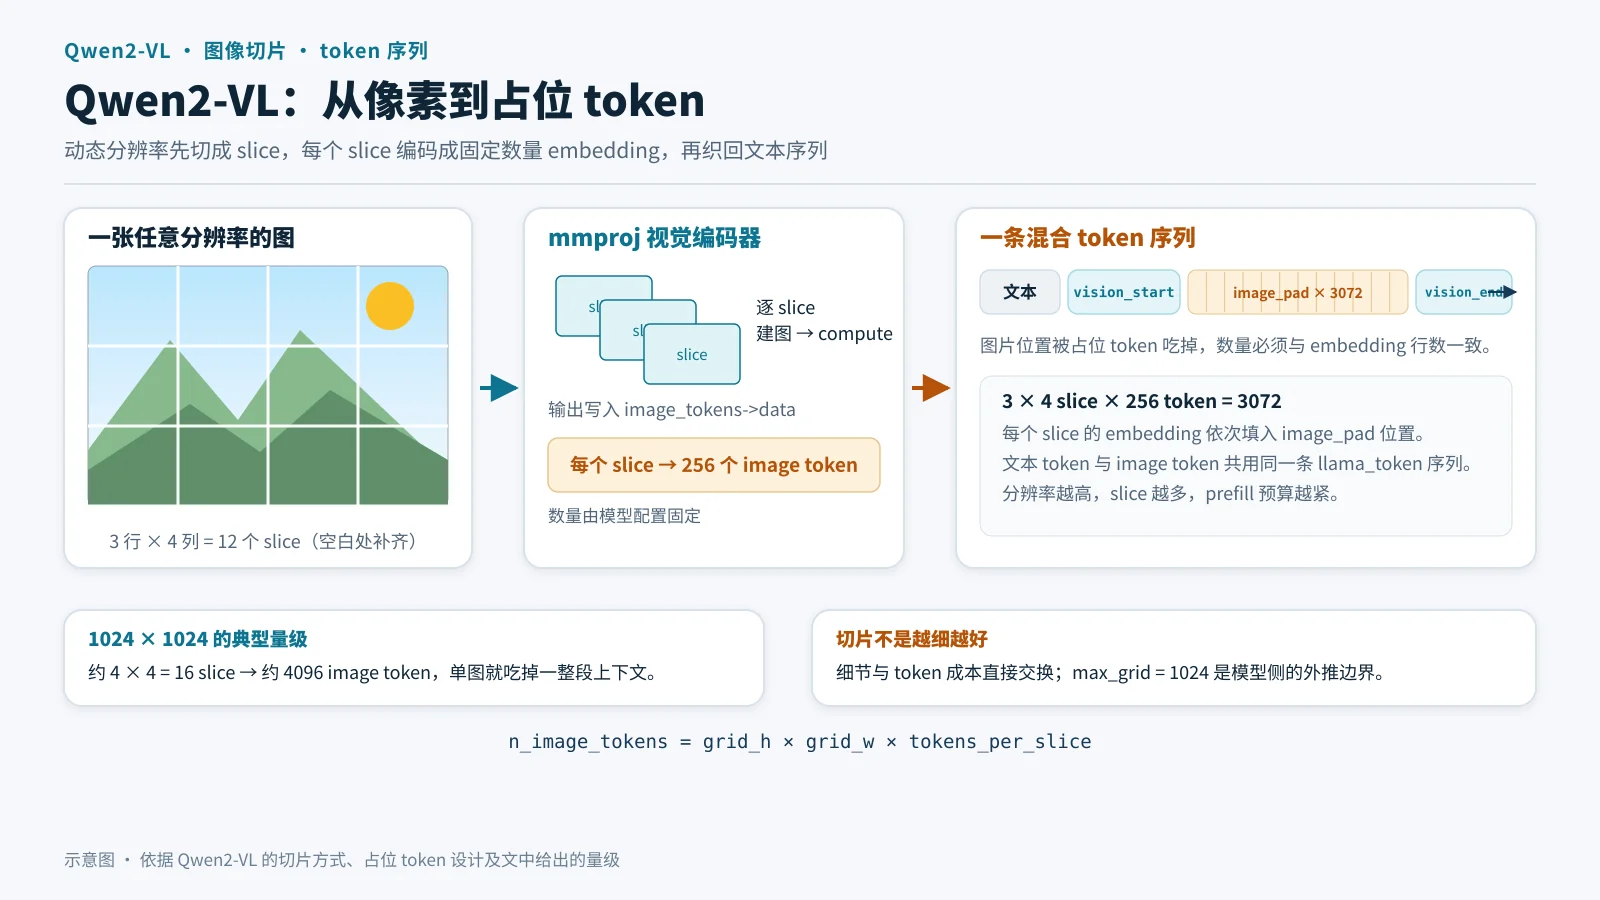
图:一张图被切成 3×4 个 slice,每个 slice 输出固定数量的 embedding,随后与文本 token 一起组成一条混合序列。
mtmd_tokenize:把文本、图片、音频按出现顺序编织
mtmd_tokenize 的职责是把用户输入(可能是一个 mtmd_input_text 加若干 mtmd_bitmap)拆成有序的 chunk 列表。这里的关键概念是 mtmd_input_chunk:它要么是纯文本 chunk,要么是图片 chunk,要么是音频 chunk。chunk 列表的先后顺序就是原始输入里媒体标记出现的位置。
enum class mtmd_input_chunk_type { MTMD_INPUT_CHUNK_TYPE_TEXT, MTMD_INPUT_CHUNK_TYPE_IMAGE, MTMD_INPUT_CHUNK_TYPE_AUDIO,};
struct mtmd_input_chunk { mtmd_input_chunk_type type; std::vector<llama_token> tokens; mtmd_image_tokens * image_tokens;};调用方通常在文本里用占位符 mtmd_default_marker()(默认是 <__media__>)标记图片位置。tokenizer 会把文本按这个占位符切开,切出来的每一段做分词,遇到占位符就插入一个图片 chunk。伪代码如下:
function tokenize(text, bitmaps): chunks = [] segments = split(text, marker) # 按 <__media__> 切 for i, seg in enumerate(segments): text_tokens = llama_tokenize(seg) # 追加模型要求的图像前缀 token(如 <|vision_start|>) text_tokens = prepend_vision_prefix(text_tokens) push_text_chunk(chunks, text_tokens) if i < len(bitmaps): push_image_chunk(chunks, encode(bitmaps[i])) return chunks这里的「图像前缀」和「后缀」由具体模型的 clip_* 提供,例如:
| 模型族 | 图像 token 前缀/后缀 | 占位 token 生成方式 |
|---|---|---|
| Qwen2-VL / Qwen2.5-VL | `< | vision_start |
| InternVL | <img> … </img> 与 <IMG_CONTEXT> | 按 slice 数 × 256 个 <IMG_CONTEXT> |
| Gemma3 | <start_of_image> | 固定 256 个 image token |
| Llava | <image> + <image_pad> | <image_pad> 数量等于图像 patch 数 |
这一层差异对理解模型行为很重要:同一个「图片在文本里的位置」占用的 token 数完全不同。Qwen2-VL 用 token 数量控制分辨率精度(比如 512 个 image token 就是低分辨率模式,4096 个就是高清模式),Gemma3 则固定 256 个。这直接决定了 prefill 成本。
embedding 怎么进入前向:mtmd_decode 与 llama_decode 的边界
这是最容易误解的地方。多模态「嵌入回填」有两种实现路径:
- token 替换:把图像占位 token 当作普通 token,在
llama_decode的嵌入查表之后,用编码器输出覆盖掉这些位置的 embedding。 - encoder-decoder 拼接:先单独跑视觉编码器,再把视觉 embedding 和文本 embedding 拼起来送进语言模型。
llama.cpp 走的是第一条。mtmd_decode 的实际工作就是在语言模型的输入批里,把占位 token 的位置替换成 image_tokens->data。它使用的是 llama_set_input_embeddings 与 mtmd_decode_use_mamba 两个分支:对 Transformer 类模型,调用 llama_set_input_embeddings 打开自定义嵌入模式;对 Mamba 类模型(如 Falcon-H1、Nemotron-H),走 mtmd_decode 中专门处理 SSM 状态的分支。
tools/server 中的调用顺序大致是:
// 1. 单独跑视觉编码器mtmd_image_tokens * img = mtmd_encode(mtmd_ctx, bitmap);// 2. 构造含占位 token 的文本序列mtmd_input_chunks chunks;mtmd_tokenize(mtmd_ctx, &chunks, &input_text, &bitmap, 1);// 3. 把 chunks 交给聊天解析器,生成 llama_token 序列 + 记录每段 media 的位置// 4. llama_decode 时,在 pos_id 处用 mtmd_decode 写入 embedding下图是这一顺序的时序:
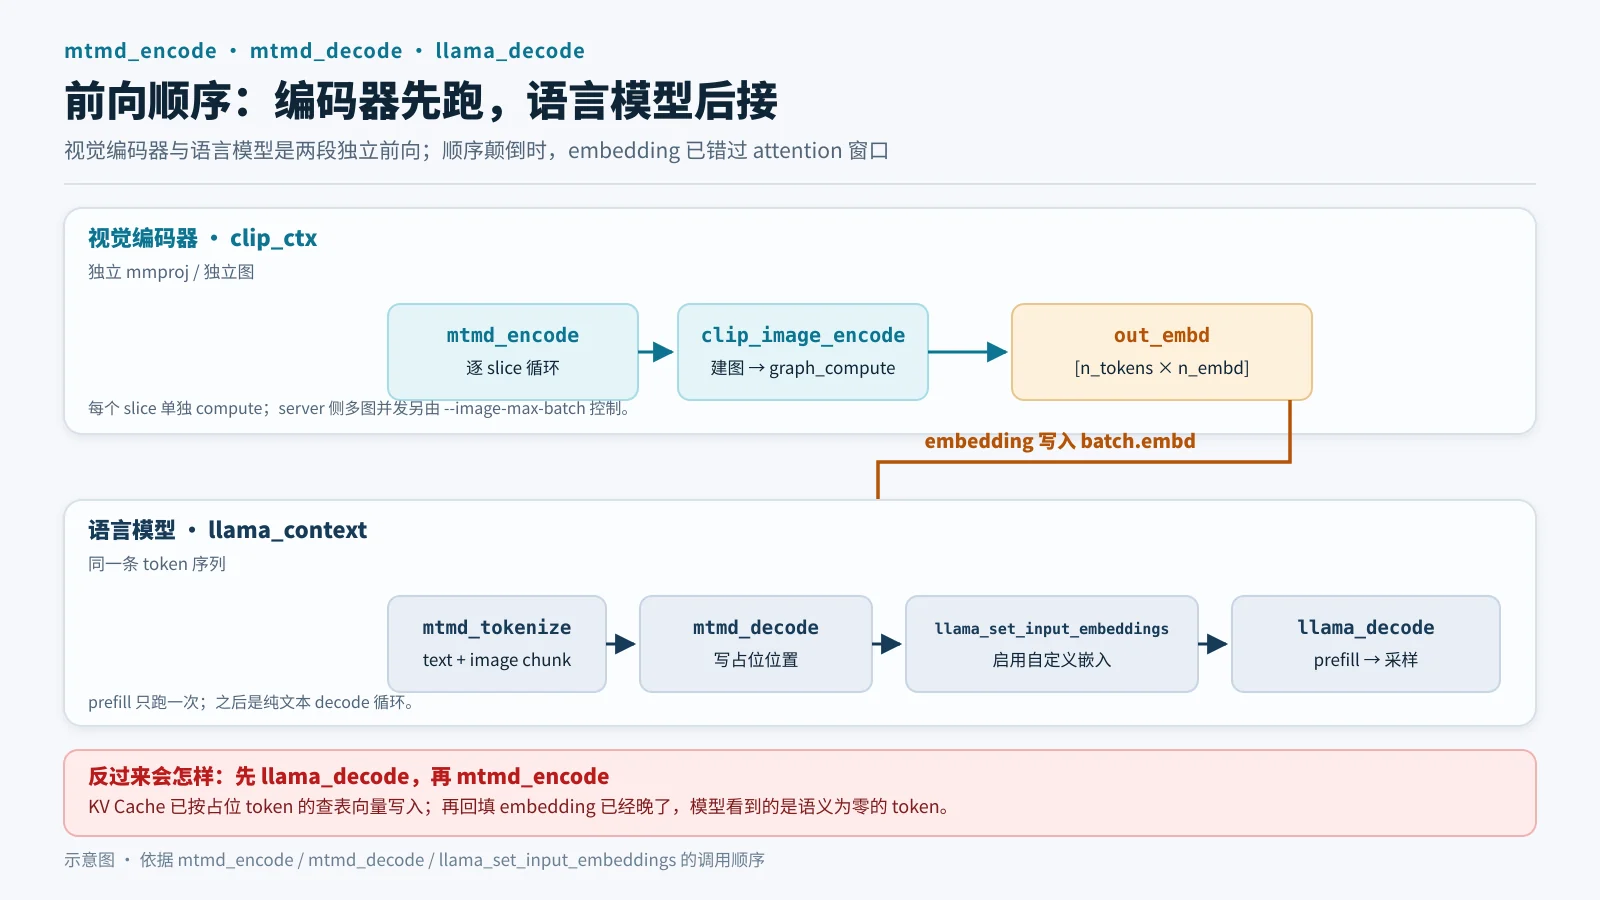
图:视觉编码器与语言模型是两段独立的前向;llama_set_input_embeddings 之后,语言模型才意识到占位 token 的真实含义。
为什么不能反过来
如果把 mtmd_encode 放在 llama_decode 之后,视觉 embedding 写入的位置已经过了 attention 的计算窗口,KV Cache 里存的还是占位 token 的 embedding。结果就是模型「看到」了一串语义为零的 token。这也是 server 端 mtmd 集成时日志里会出现 failed to encode image 后紧跟 invalid sequence 的原因:编码失败时占位 token 仍在,但没有对应的 embedding 数据。
llama_set_input_embeddings 的副作用
在 llama.cpp 的近几版源码里,llama_set_input_embeddings 会改变 llama_context 内 output_ids 的映射逻辑,以及 batch 里 embd 字段的取值路径。打开它以后,llama_decode 会忽略 tokens 数组里的 token id,转而使用 embd(连续的行内 embedding)。这意味着:
- 同一个
llama_context里可以混批,有些位置走 token 查表,有些位置走已有 embedding。 - 每个图片 chunk 在 token 序列中「吃」掉的 token 数量必须精确等于
image_tokens->n_tokens,否则embd行数与tokens长度对不上,llama_decode会直接返回LLAMA_ERR_INVALID_BATCH。
这个约束就是 server 里「token 数要和 image token 数一致」检查的来源。
一个 slot 的 token 预算:为什么 -np 和长图互相打架
llama-server 用 n_parallel(-np)个 slot 来组织并发请求,每个 slot 共享一块 n_ctx 大小的上下文(具体来说,n_ctx 在 server 里常常是按 n_ctx / n_parallel 切给每个 slot 的,或者直接由 --ctx-size 指定总量后再切)。在纯文本场景里,一个 slot 的 token 上限就是它拿到的 n_ctx / n_parallel。加入图片后,这个预算会迅速收紧:
slot_token_budget = ctx_per_slot - text_tokens - image_tokens(Qwen2-VL: 一个 slice ≈ 256 token;Gemma3: 固定 256) - chat template 模板 token关键在「slice ≈ 256 token」这句话。一张 1024×1024 的图按 Qwen2-VL 默认配置大约切成 4×4=16 个 slice,每个 slice 约 256 个 image token,一张图就吃掉约 4096 token。如果 -c 8192 -np 4,每个 slot 只有 2048 token,连一张图都放不下。server 会给出类似下面这样的报错:
error: image tokens exceed slot context size这也是为什么社区里跑多模态 server 时,建议把 -c 调大、-np 调小,或者用 Qwen2-VL 的 min_pixels/max_pixels 参数限制图像分辨率。
下面把三类模型的典型 token 占用放在一起:
| 输入 | Qwen2-VL(默认) | InternVL2 | Gemma3 |
|---|---|---|---|
| 一张 448×448 图 | 约 1024–1280 image token | 256 image token | 256 image token |
| 一张 1024×1024 图 | 约 4096–5120 image token | 1024 image token | 256 image token |
| 是否支持动态分辨率 | 支持 | 部分支持(tile) | 不支持 |
| KV Cache 与视觉编码器是否分离 | 分离 | 分离 | 分离 |
表中的数字随模型版本与 config 略有浮动,但在做容量规划时这些量级足够用。
多模态请求在 server 里的生命周期
把 tools/server 的多模态路径串起来,一个带图的请求大致经历如下阶段:
- HTTP 层解析:
/v1/chat/completions或/completion收到image_url/ base64 图像,解码成mtmd_bitmap。 - tokenize:
mtmd_tokenize把文本与图切成 chunks,并用mtmd_input_chunk记录每段图的 token 数。 - 编码:
mtmd_encode对每个图跑视觉编码器,产出 embedding。这一步在 prefill 阶段之前完成,可以和其他请求的编码并发(如果 server 开了多线程编码)。 - 组装输入:把 chunk 列表展开成
llama_token序列,记录每个 image chunk 的起止位置。 - prefill:一次性
llama_decode这批 token,同时使用llama_set_input_embeddings让图像位置取 embedding。 - decode:逐 token 采样、输出。后续 decode step 不再涉及图片,纯文本 KV 增长。
下图把这一路画成状态图:
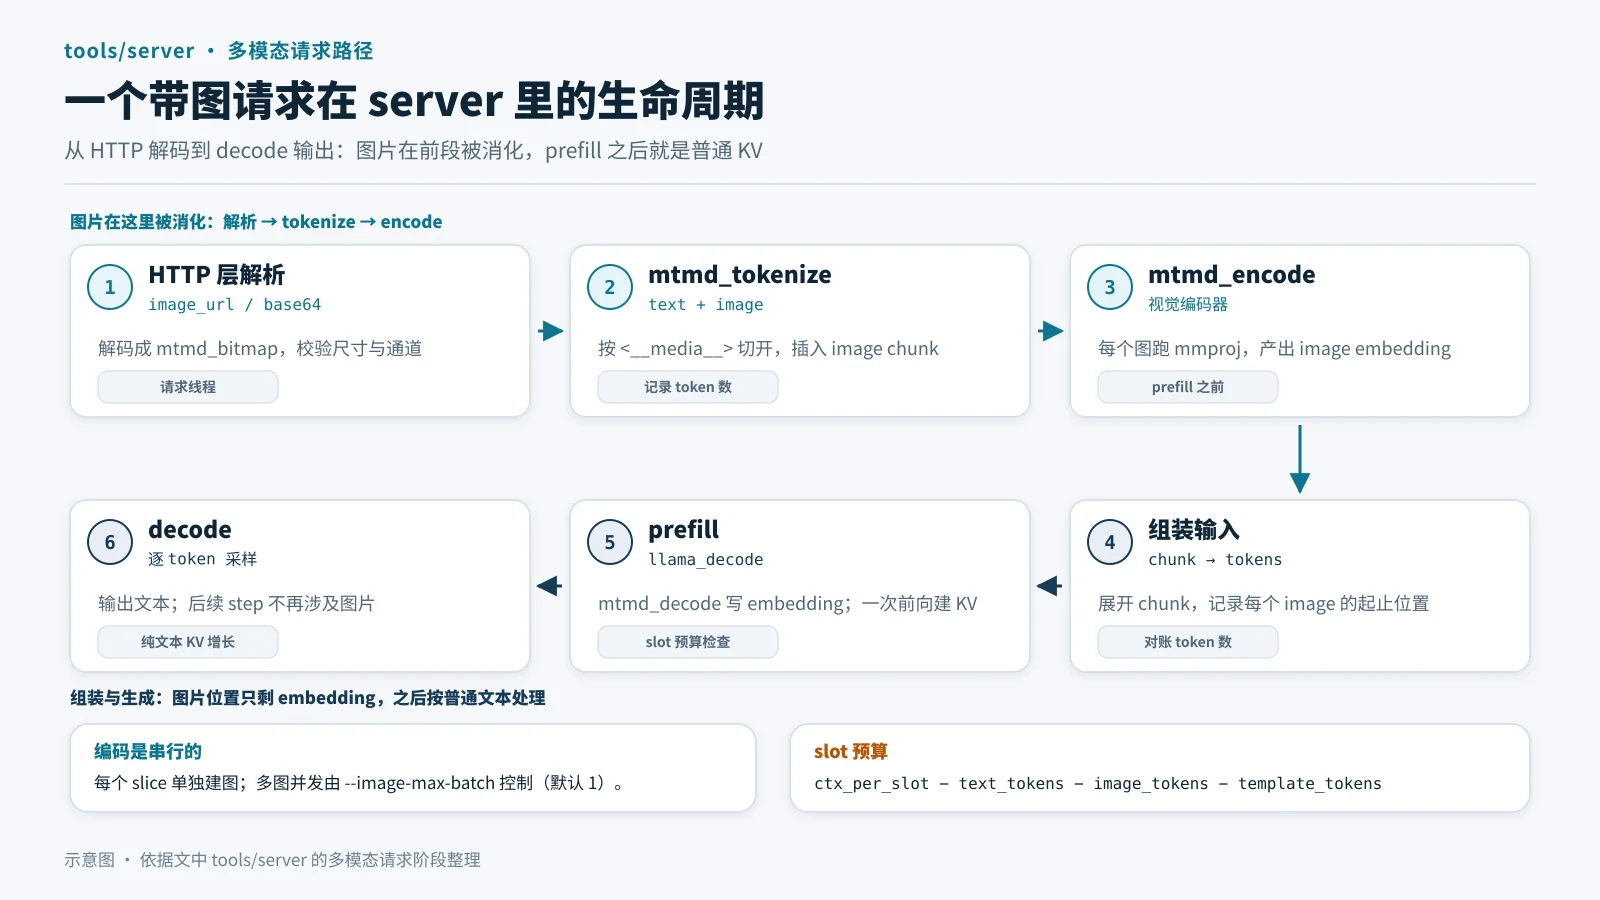
图:从 HTTP 解码到 decode 输出,图片只在前两步被「消化」,之后它就是普通 KV。
这里有一个值得注意的工程细节:视觉编码器是串行运行的。在 mtmd_encode 里,每个 slice 都会单独建图、单独 compute,而不是把所有 slice 合成一个大 batch。这看似低效,实则是因为不同 slice 的尺寸必须一致、拼接后要维持 [n_slice, C, H, W] 的规整形状;如果你在 mmproj 里找不到 clip_image_f32_batch 的批量接口,原因就在这里。对一次多图请求,server 还会在多线程里并行调用 mtmd_encode,但这取决于 --image-max-batch 参数,默认是 1。
与 vLLM/SGLang 的差异
把 llama.cpp 的做法和 vLLM、SGLang 的「placeholder + 嵌入回填」放在一起看:
| 维度 | llama.cpp(mtmd) | vLLM / SGLang |
|---|---|---|
| 视觉编码器在哪里 | 独立 GGUF,由 mtmd 在 CPU/GPU 后端跑 | 与语言模型同一进程,常与语言模型共用同一套调度 |
| 图像 token 生成 | 预处理时切 slice,然后固定数量占位 | 预处理时算 placeholder range,运行期填充 |
| 编码与语言模型调度关系 | 编码先于 prefill,单请求串行 | 编码可以与 prefill 重叠,调度器统一排序 |
| 支持 Mamba/SSM 模型 | 有专门分支 | 视版本而定 |
| 显存规划 | 按 n_ctx / n_parallel 硬切 | 动态 KV 块分配 |
这个差异导致的一个现实结果:llama.cpp 的视觉编码器更像是「一个单独的推理任务」,而 vLLM/SGLang 的多模态是「一个批处理任务的一部分」。前者代码简单、易于在端侧运行(llama-mtmd-cli 可以在 Mac 上直接跑),后者吞吐高、适合云端。可以把 vLLM 源码完全拆解(十三):多模态输入 和 SGLang 源码完全拆解(十四):多模态输入 对照着读,能看到同一思路的两种工程取舍。
小结
llama.cpp 的多模态实现可以用三句话概括:
- 切:
clip.cpp按模型规则把图切成 slice,每个 slice 输出固定数量的 image token。 - 编:
mtmd_encode独立跑视觉编码器,得到每个 slice 的 embedding。 - 填:
mtmd_decode通过llama_set_input_embeddings把 embedding 填回占位 token 的位置,然后llama_decode像处理普通文本一样完成 prefill。
这个设计牺牲了调度灵活性(视觉编码器不能和 prefill 重叠),换来的是极低的实现复杂度和端侧友好性。理解这一点,再去看 tools/server/mtmd 的集成代码,就会发现大部分逻辑都只是「token 数对账」和「显存预算检查」。
下一篇将回到 llama.cpp 的 core 侧,讨论 llama_context 在多模态与 speculative decoding 同时开启时的 KV 复用限制。
参考资料
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



