


统一多模态生成架构:Chameleon、Emu3、Transfusion 与 Janus 如何用一个模型既读图又画图
多模态模型通常被分成两半:一半负责“看懂”,即视觉编码器加投影层再把图像特征送进语言模型;另一半负责“画出”,即扩散模型或自回归图像生成器。这两半往往连参数都不共享。于是出现一个自然的问题:能不能用同一个 Transformer、同一套参数,既理解图像又生成图像?统一多模态模型要回答的就是这个问题。
本文讨论四条有代表性的统一架构路线:Chameleon 的早期融合离散词表、Emu3 的纯下一 token 预测、Transfusion 在同一 Transformer 里混合语言建模与扩散,以及 Janus 把理解与生成的视觉编码解耦。重点不在榜单分数,而在每种路线如何把“图像”塞进 Transformer、用什么目标函数训练、推理时每一步算什么,以及这些选择带来的成本与失效边界。
问题定义:统一多模态到底难在哪
“用一个模型既读图又画图”听起来只是把两个任务拼在一起,实际却要同时解决四个层面的冲突。
第一层是表征冲突。理解任务希望视觉特征尽量抽象:物体类别、属性、关系、文字含义,这些信息适合由对比学习训练出的语义编码器提供,特征维度高、空间细节被刻意压缩。生成任务希望视觉特征尽量具体:边缘、纹理、光照、局部结构都必须保留,否则解码器无法重建像素。把两者压进同一个表征空间,必然要在“语义判别力”和“重建保真度”之间做取舍。Janus 的消融实验把这件事量化了:同一个 VQ 分词器同时服务理解与生成时,理解侧明显落后;换成语义分词器后理解变好,但即便不追求生成的编码器,仍不如只做理解训练的版本;只有把两条编码路径拆开,两边才同时接近各自的任务专用模型。
第二层是序列构造。语言模型处理的是一条离散 token 序列,图像要么被量化成离散码字,要么被切成连续 patch 向量。无论哪种,都要解决如何把二维网格展平成一维、如何标记图像起止、如何处理不同分辨率、如何让文本 token 与图像 token 共享位置编码。Chameleon 和 Emu3 选择把图像码字直接并入词表,Transfusion 选择在序列里插入连续向量片段并用 BOI/EOI 标记边界,Janus 则在输入端用两套编码器、在 Transformer 内部仍保持一条自回归序列。
第三层是目标函数。文本天然适合下一 token 预测,图像则有两种主流监督:对离散码字做交叉熵,或对连续 latent 做扩散去噪。前者让整个模型只有一个损失、一套采样逻辑,工程上最简洁;后者保留连续表征、避免量化损失,但要在同一个 Transformer 里同时跑两种前向模式。Transfusion 的做法是把两个损失直接相加:
其中语言建模损失按 token 计算,扩散损失按图像计算。
第四层是注意力与推理模式。文本必须因果掩码,否则训练时会看到未来 token;图像 patch 之间通常需要双向注意力,因为一张图的左上角 patch 和右下角 patch 不存在天然的时间顺序。Transfusion 的折中方案是“全局因果、图内双向”:每个 patch 可以看见同一张图里的所有 patch,但只能看见序列中位于它之前的文本和其他图像。这个看似很小的掩码改动,在它的消融里直接把线性 patch 编码下的 FID 从 61.3 降到 20.3,说明图像内部的信息流不是可有可无的细节。
这四层冲突决定了统一模型不可能只有一种正确形态。下面四条路线,本质上是在这四个维度上做了不同的取舍。
先用一个统一的记号把“图像要占多少 token”算清楚。设图像边长为 ,空间下采样倍率为 ,则离散化后的 token 数为:
这个数字后面会反复出现:它同时决定了训练序列长度、推理时的自回归步数、KV 缓存大小,以及图像生成延迟的下界。以 512×512 为例, 时是 1024 个 token, 时是 4096 个 token;仅仅把分词器的下采样倍率缩小一半,序列长度就会翻四倍。统一多模态模型的很多工程问题,根源都在这个平方关系上。
路线一:Chameleon 的早期融合——把图像压进同一个词表
Chameleon 由 Meta 的 Chameleon Team 于 2024 年发表,包含 7B 与 34B 两个规模,训练数据约 10 万亿 token,覆盖纯文本、图文对与交错图文文档。它的核心主张只有一句话:既然文本可以表示成离散 token,图像也可以;只要把图像码字并入同一个词表,就不需要独立的视觉编码器、独立的图像解码器,也不需要跨模态投影层。模型从第一步开始就是混合模态的,所有参数在文本与图像之间完全共享。
图像分词器决定了词表结构
Chameleon 训练了一个基于 Gafni 等人 2022 年方案的图像分词器:512×512 的图像被编码成 1024 个离散码字,码本大小为 8192。文本侧使用一个 65536 词的 BPE 词表,这 8192 个图像码字直接作为词表的一部分加入。因此对模型而言,文本 token 和图像 token 是同一种东西:都是一个整数 ID,都走同一个 embedding 矩阵,都从同一个输出头预测。
这一步带来的直接后果是:512×512 的一张图占 1024 个位置,和一篇中等长度的文本差不多;如果输入是一份图文交错文档,序列就是文本片段与 1024 个图像 token 块的交替拼接。位置编码、注意力掩码、KV 缓存全部沿用文本模型的实现,不需要为图像单独设计跨模态注意力。
代价同样明确。图像 token 的重建质量完全由分词器决定,而 Chameleon 论文自己指出,这个分词器在重建含大量文字的图像时表现较弱,从而给模型的 OCR 类任务设了一个上限。语言模型再强,也无法恢复分词阶段已经丢掉的笔画细节。这是所有“全离散”路线的共同瓶颈,只是 Chameleon 把它写在了明面上。
混合模态训练为什么会不稳定
如果只是换个词表,Chameleon 似乎并不难。真正困难的是训练稳定性。论文报告:模型规模超过 8B、训练 token 超过 1T 之后,损失会在训练中后段突然发散,有时要等到进度走过 20%–30% 才出现。作者把根因定位到 softmax 的平移不变性:
文本与图像两种模态共享全部权重,但两者的 token 分布熵差异很大。为了让自己的预测更准,每个模态都倾向于把输出 logits 的范数推大一点;在 bf16 的有效表示范围内,这种“模态间的范数竞争”起初无害,一旦超出范围就会变成数值发散。文本模型里也有类似现象,被称为 logit drift,但单模态下不会有两个分布同时推高范数。
Chameleon 的对策分三层。第一层是 QK-Norm:在注意力内部对 query 和 key 做层归一化,直接限制 softmax 输入的增长;没有它,7B 模型大约在 20% 训练进度处发散。第二层是归一化位置重排,把 LayerNorm 放到残差分支内部,即先归一化再过注意力与 FFN;34B 模型必须用这一招,因为 SwiGLU 的乘法结构会让 FFN 输出范数增长得更快。第三层是 z-loss,对输出 softmax 的配分函数 加正则项:
它约束的是最后那个 softmax 的 logit 平移,QK-Norm 管不到这里。7B 模型还需要 dropout 才能稳住,34B 用归一化重排后反而不能与 dropout 同用。这套组合拳说明:早期融合的难点不在架构创意,而在让两种熵结构不同的数据在同一组参数上长期共存。
推理:一条自回归循环,但每一步都要看 token
训练统一之后,推理仍然是标准的下一 token 预测:采样一个 token,追加到序列,再前向一次。但 Chameleon 的推理实现比纯文本模型复杂,因为“当前生成的是文本还是图像”会改变后续控制流。
论文列出了三个具体的工程问题。其一是逐步的数据依赖:解码形式取决于当前 token 属于文本还是图像,因此每一步都要把采样结果从 GPU 拷回 CPU 做判断,形成阻塞式同步。其二是模态约束:如果只想生成图像,就必须在采样时屏蔽非图像词表的 logits;反过来,纯文本生成也要屏蔽图像码字。其三是固定长度块:文本是变长的,图像 token 块却固定为 1024 个,流式输出时图像必须按块组织,不能像文本那样逐 token 吐给前端。
Chameleon 的推理管线用 token masking 把分支从 GPU 上移走,并在非流式场景下把整块图像 token 融合生成,以减少逐步条件判断。这些优化并没有改变算法,但揭示了一个常被忽略的事实:统一词表把模型结构变简单了,却把服务层的控制逻辑变复杂了。文本模型的采样器只需要处理一个词表;混合模态采样器还要处理模态边界、固定块长度和流式图像的组装。
从成本上看,一张 512×512 图像对应 1024 次自回归解码。若把这 1024 个 token 与前面的文本上下文一起放进 4k 上下文窗口,单请求的序列长度会迅速逼近上限;而在 34B 规模上,每一步都要对不断增长的 KV 缓存做注意力。Chameleon 的架构证明了全离散路线可行,但它也把“图像生成的延迟与 KV 压力”原封不动地继承了下来。
路线二:Emu3——下一 token 预测就是全部
Emu3 由北京智源研究院的 BAAI 团队于 2024 年 9 月发布,是一个 8B 参数、从零训练的单 Transformer。它的立场比 Chameleon 更激进:不仅理解与生成共用一个模型,视频也一并纳入,而且完全不要扩散、不要 CLIP、不要任何外部文本编码器。所有模态——文本、图像、视频——都被转成离散 token,训练目标只有一个交叉熵,推理时只有一个采样循环。
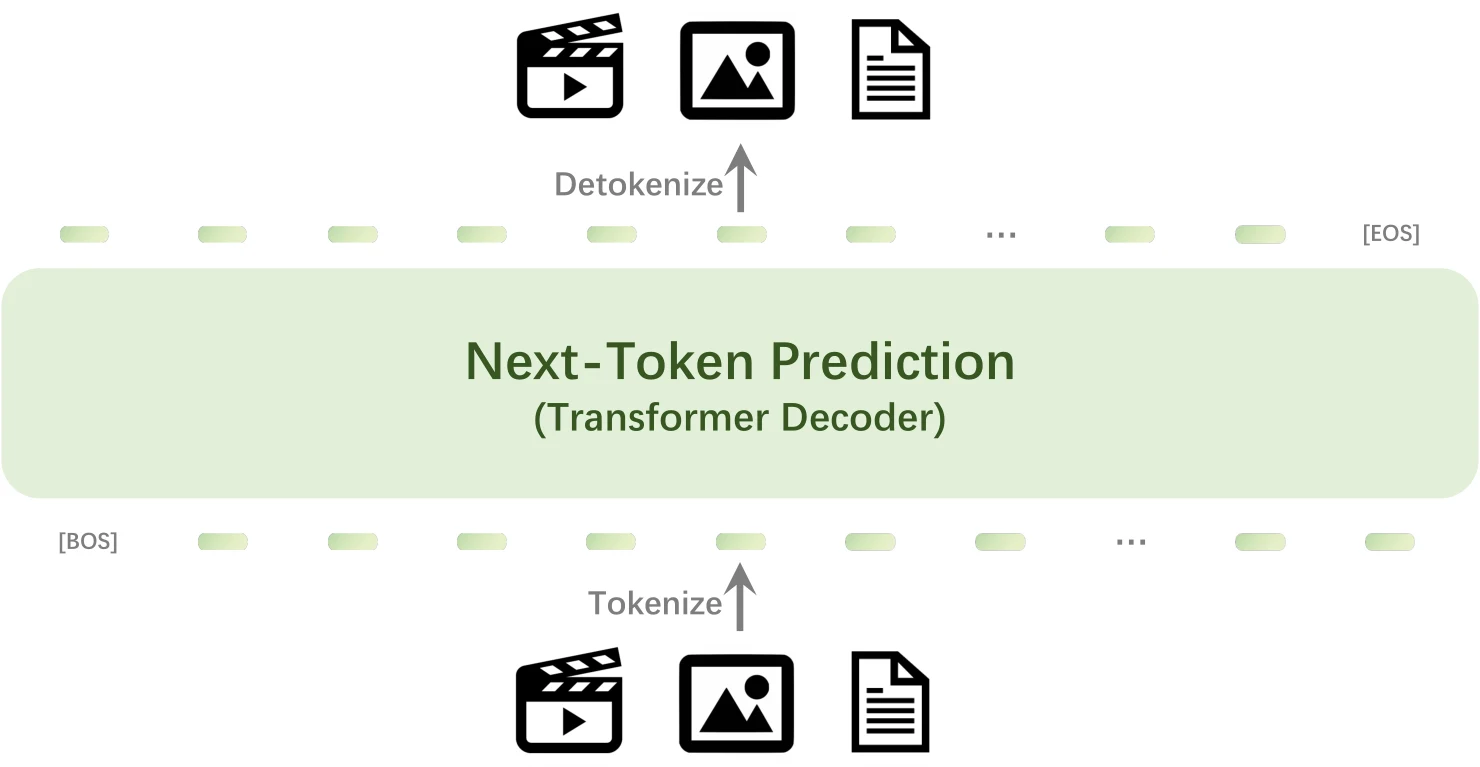
上图是 Emu3 论文的总览图。左侧是原始的多模态输入,中间是统一的视觉分词器把图像与视频压成离散码字,右侧是一条 Transformer 同时承担感知、生成与视频预测。这张图最值得注意的地方是“没有旁路”:文本条件不是通过外部编码器经交叉注意力注入,而是与视觉 token 拼在同一条序列里,由同一个模型自己读取。
视觉分词器:空间 8 倍、时间 4 倍
Emu3 的分词器基于 SBER-MoVQGAN 改造,加入两层带 3D 卷积核的时间残差层。它的压缩率是空间 8×8、时间 4×:一个 512×512 的图像编码成 个 token,一段 的视频片段同样编码成 4096 个 token,码本大小 32768。MoVQGAN 使用 VQ 量化层配合 L2、LPIPS 感知损失与 GAN 损失训练,使重建结果在感知层面更接近原图。
这里的空间下采样倍率 比 Chameleon 的 16 更激进。把前面的公式代入:
同一张 512×512 图像,Chameleon 是 1024 个 token,Emu3 是 4096 个。Emu3 的模型上下文长度扩展到 131072,正是为了容纳视频:一段 4 帧、空间 512×512 的片段就要 4096 个 token,再长的视频只能靠分帧与续写。更大的 token 数带来更细的空间结构,也直接抬高了自回归生成的成本。
文档格式:五个特殊 token 把多模态拼成“文档”
Emu3 没有设计专门的多模态数据加载器,而是把所有样本都组织成文档格式:
[BOS] {caption text} [SOV] {meta text} [SOT] {vision tokens} [EOV] [EOS]其中 [SOV] 标记视觉输入开始,[SOT] 标记视觉 token 开始,[EOV] 标记视觉输入结束,[EOL] 与 [EOF] 分别表示行结束与帧结束。meta text 是一段纯文本,写明图像的分辨率;视频则还写明帧率与时长。这种做法把分辨率、帧率这些原本需要额外条件向量的信息,变成了序列里的普通 token,模型只要读到它们就知道该生成多大的画面。
理解与生成在数据格式上的区别只是字段顺序:把 caption 移到 [EOV] 之后,样本就变成了“看图说话”的理解训练;把 caption 放在前面,就是“按描述画图”的生成训练。同一个模型、同一个损失,靠数据排列切换任务。
训练细节:视觉 token 降权与两阶段上下文
Emu3 在标准交叉熵上只做了一个调整:视觉 token 的损失权重设为 0.5。原因很直接,视觉 token 数量远超文本 token(4096 对几十),若等权重计算,模型会把绝大部分学习信号花在重建图像上,文本能力被稀释。降权后的损失可以写成:
预训练分两个阶段:第一阶段只用文本与图像,上下文 5120;第二阶段引入视频,上下文扩到 131072。训练时用张量并行、上下文并行与数据并行组合,并在 packing 时保证整张图像不被截断。后训练阶段,Emu3 先做质量微调,只对视觉 token 计算损失,并把分辨率从 512 提升到 720;再做 DPO,用 8–10 次采样构造偏好对,直接存下构造时的 token 序列,避免重新分词造成差异。
推理:一个循环内的 CFG
Emu3 的图像生成就是逐 token 自回归采样。它仍使用无分类器引导,但实现方式与扩散模型完全不同:在同一个 token 位置上分别计算条件与无条件的下一 token 分布,再按引导系数组合:
论文给出的推理设置是 Top-k 取 16384、Top-p 取 1.0、引导系数 5.0–5.5。由于条件本身就是序列前缀,所谓“无条件”只是把描述文本替换成空串,模型结构不需要为引导做任何改造。代价是每一步都要跑两遍前向,或者至少维护两套 logits;这与扩散模型里 CFG 让前向翻倍是同一笔账。
视频生成则证明了这条路线的外推能力:用前一段视频作为上下文,模型可以按 token 续写后续帧;训练时插入的 [EOF] 帧标记与空间 [EOL] 行标记,让模型知道在什么位置结束当前帧、进入下一帧。理解侧同理,图像 token 先出现,caption 在后,模型读完整段视觉序列后开始预测文本。
Emu3 的意义不在于它是否全面超越扩散模型,而在于它把“统一”推到了极限:没有外部编码器、没有混合目标、没有特殊注意力掩码。所有复杂度都被集中到一个问题上——视觉分词器是否足够好。分词器好,模型就能用一个标准的语言模型把所有模态串起来;分词器差,整个体系的上限就被锁死。
路线三:Transfusion——一个 Transformer,两种损失
Transfusion 是 Meta 于 2024 年 8 月提出的训练方案,论文把模型做到 7B、2T 多模态 token 规模。它没有在“离散还是连续”之间二选一,而是让同一个 Transformer 同时接受两种输入:文本 token 走离散 embedding,图像 patch 走连续向量;训练时文本用下一 token 预测,图像用扩散去噪。两条损失直接相加,参数完全共享。
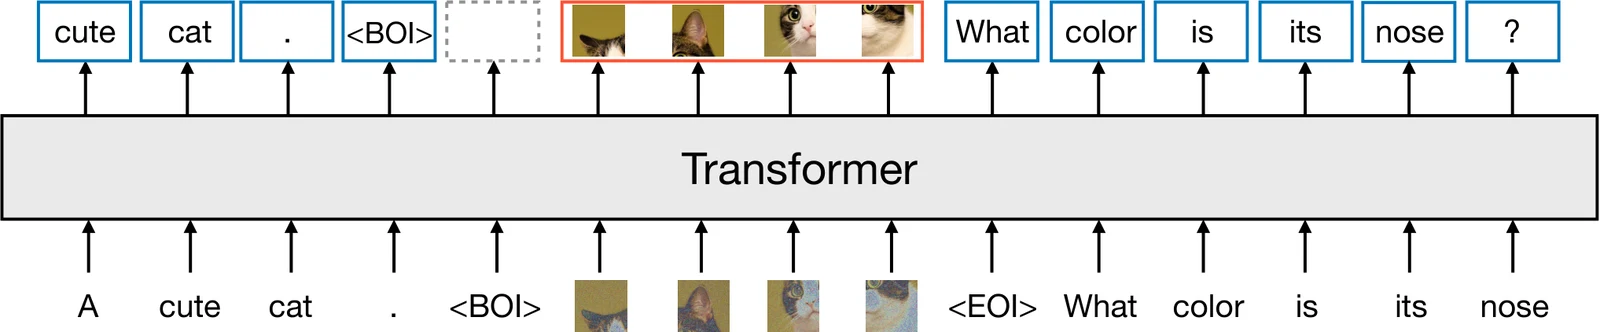
上图是 Transfusion 的整体结构。文本 token 经 embedding 进入 Transformer,图像经 VAE 编码成 latent,再切成 patch 向量;序列两端用 BOI/EOI 标记图像边界。模型主体仍然是一个标准的 Llama 风格 Transformer,只有模态相关的输入输出层是独立的。这种“主体共享、端口分离”的设计,让统一模型不必牺牲文本侧的语言建模能力。
图像如何进入序列:VAE 加 patch 化
Transfusion 使用一个 86M 参数的 VAE,把 256×256 的图像压成 的 latent;每个 8 维 latent 像素对应原图 8×8 的区域。随后把 latent 切成 的 patch,每个 patch 经线性层或 U-Net 下采样块压成一个 Transformer 向量。以 为例:
一张 256×256 图像只占 256 个序列位置,相当于把有效下采样倍率做到 16。若用 或 ,每个图像的 patch 数进一步降到 64 或 16;论文指出,配合 U-Net 编解码块,即使每张图只有 16 个 patch,生成质量也只有很小的损失,而服务成本可以降低到原来的 。
这里与 Chameleon、Emu3 的关键差别是:patch 向量是连续的,没有量化层,也没有码本。图像信息不经过“最近邻查表”这一步,因此不存在码本容量不足导致的细节丢失;代价是模型必须学会在连续空间里做扩散,而不能只做分类。
注意力:全局因果,图内双向
Transfusion 的序列里,文本 token 与图像 patch 混排。它的注意力规则是:整个序列按因果方向处理,但同一张图像内部的 patch 之间允许双向注意力。也就是说,第 个图像 patch 可以看见同一张图的所有 patch,但只能看见序列中位于这张图之前的文本和其他图像。
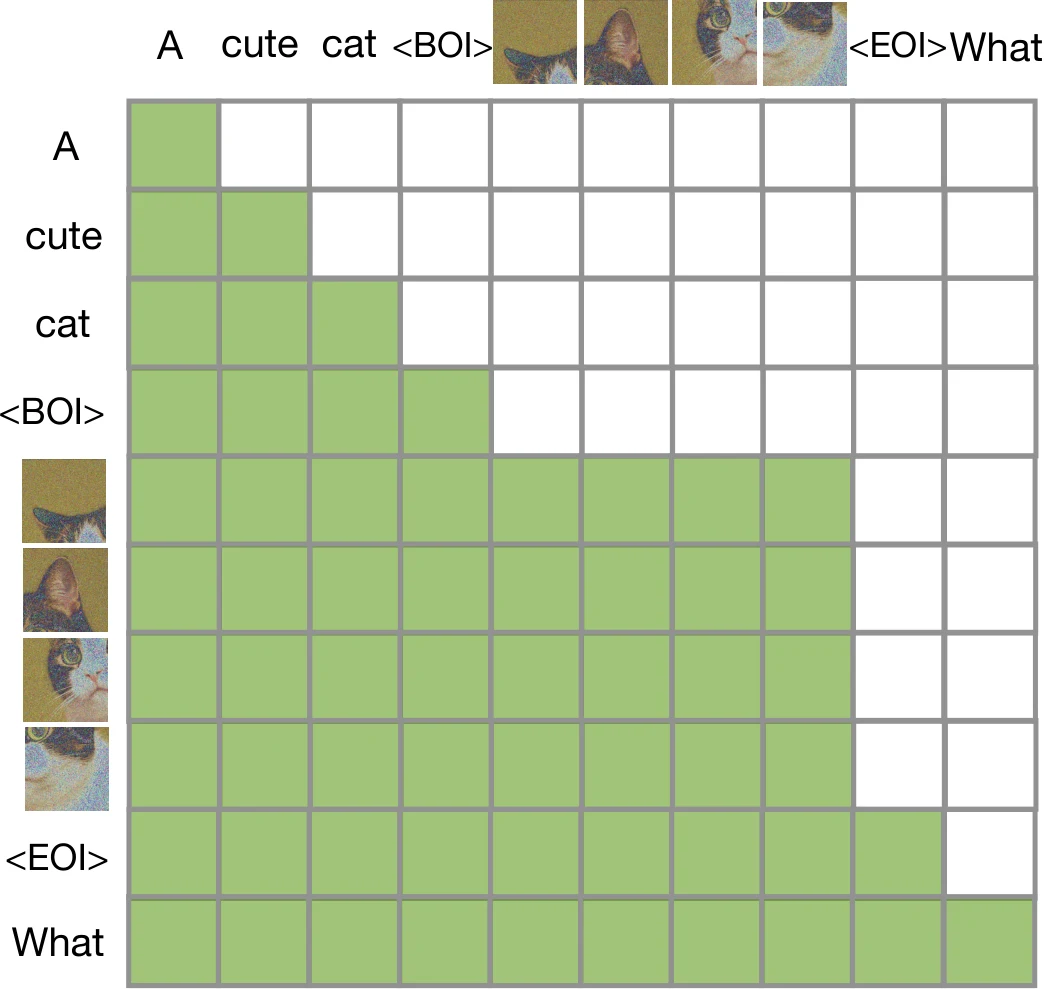
上图是论文给出的掩码示意。对角线附近是文本的严格因果区;两个图像块内部各自是一块全连接区域,块与块之间仍保持先后顺序。这个设计看起来只是放宽了一点掩码,实际效果很大:在线性 patch 编码下,只允许因果注意力时 FID 是 61.3,允许图内双向后降到 20.3。原因不难理解——扩散去噪要求每个 patch 都能利用整张图的上下文,如果只许看左上方已经出现的 patch,右侧和下方的结构就缺少约束。
训练目标:加噪后再 patch 化
Transfusion 的扩散损失有一个容易忽略的顺序细节:先对整张 latent 图像加噪得到 ,再把 patch 化送进 Transformer。也就是说,模型看到的是带噪图像的 patch 向量,而不是先 patch 化再加噪。图像级的扩散损失为:
其中条件 来自序列中位于图像之前的文本与其他图像。由于图像块内部的注意力是双向的,同一个图像的所有 patch 可以在一次前向里同时预测噪声;这一点与标准扩散模型一致,也是它比逐 token 自回归生成更并行的地方。
训练时文本与图像按 1:1 token 比例混合,80% 的图文对把 caption 放在图像之前,20% 放在之后,以便模型同时学会“看图说话”和“按描述画图”。语言损失与扩散损失按系数 加权求和,论文的主实验把两个损失直接相加。一个副作用是:位于图像之后的文本 token,在训练时条件于带噪图像;这迫使模型学会从不完整的视觉信息里继续推理,也解释了为什么图像加噪方式会成为一项独立的消融变量。
推理:在语言模式与扩散模式之间切换
Transfusion 的解码算法与训练目标一一对应。默认处于语言模式,按标准语言模型逐 token 采样;一旦采样到 BOI,就切换到扩散模式:根据目标图像尺寸在序列末尾追加 个纯噪声 patch,然后做 步去噪。每一步,模型预测当前噪声并更新这 个 patch;更新后的 patch 覆盖序列中的旧值,下一步再以新的 为条件。去噪结束后追加 EOI,切回语言模式,继续生成文本。
这个循环有两个工程含义。第一,图像生成不是逐 token 串行的,而是 步、每步全图并行;当 很大时,单步计算量高,但步数远少于 。第二,模型在去噪过程中不能访问历史时间步的图像状态,只能看见当前这一步的带噪图像;它依赖的是同一 Transformer 里已经缓存的文本前缀和先前图像。若使用 CFG,条件与无条件两路要各跑一遍,计算量翻倍。
与 Chameleon 的受控对比很能说明两条路线的差异。Transfusion 在文本到图像任务上,用不到三分之一的计算量就超过了 Chameleon 的离散方案;在固定 FLOPs 下,FID 大约低一倍。论文把原因归结为量化信息瓶颈:Chameleon 必须先决定每个 patch 属于哪个码字,再让语言模型预测码字;Transfusion 跳过了这一步,直接把连续 latent 作为预测目标。这个对比不是“谁的模型更大”,而是“表征是否在中途被迫离散化”。
消融给出的三条设计约束
第一,图内双向注意力不是可选项。没有它,线性 patch 编码的 FID 会从 20.3 恶化到 61.3;U-Net 编解码块因为内部自带双向注意力,受影响较小,但这恰好说明双向信息流本身是必要的,只是换了个位置实现。
第二,patch 大小是显式的质量与成本旋钮。线性编码下,patch 从 2×2 增大到 8×8,每张图的序列元素从 256 降到 16,FID 从 20.3 恶化到 43.5;U-Net 编码下同样的压缩只带来很小的质量变化。换句话说,想把服务成本压到 ,不能只改 patch 大小,还要让编解码层承担起局部建模。
第三,文本性能会随图像 patch 变少而下降。论文观察到 patch 越大,文本困惑度越高,因为模型要用更少的视觉位置表达同样多的信息,参数被图像侧占用。统一模型不是免费共享:图像侧压缩得越狠,语言侧就越难维持原有水平。
Transfusion 的定位因此很清楚:它适合“图像质量优先、服务端可以承担扩散采样”的统一模型。它保留了连续表征和扩散的生成质量,代价是推理链路要维护两种模式、CFG 要双倍前向,并且图像 patch 数量仍然决定单步注意力的规模。
路线四:Janus——解耦理解与生成的视觉编码
Janus 由 DeepSeek-AI 联合香港大学、北京大学于 2024 年 10 月发表。它与前三条路线的分歧点不在序列格式,而在视觉编码本身:既然理解需要语义特征、生成需要空间细节,那就不要强迫一个编码器同时满足两者,而是给理解与生成各配一条编码路径,只在 Transformer 这一层保持统一。
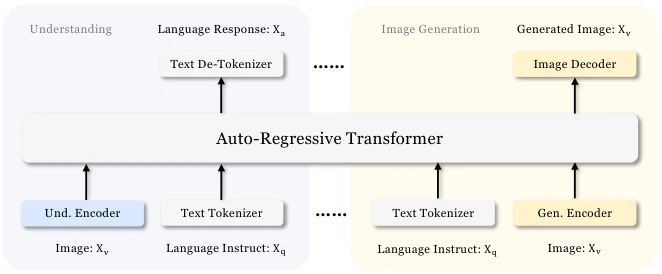
上图是 Janus 的结构示意。理解侧走 SigLIP 编码器加理解适配器,生成侧走 VQ 分词器加生成适配器;两路特征拼接成一条多模态序列后进入同一个语言模型。文本输出用语言模型自带的预测头,图像输出用单独初始化的图像预测头。整个模型没有任何特殊的注意力掩码,仍然是标准自回归框架。
为什么单一编码器会两头不讨好
Janus 的出发点是一个消融实验能直接证明的假设:用同一个视觉编码器服务理解与生成,理解侧一定会吃亏。论文构造了三组对照。第一组用 VQ 分词器同时服务两个任务,结果 COCO-FID 达到 8.72,生成尚可,但 POPE、MMBench、SEED、MMMU 这些理解指标明显偏低。第二组换成一个从 SigLIP 蒸馏来的语义分词器,理解指标大幅上升,生成也没有塌掉,FID 甚至优于第一组。第三组只做理解训练,理解指标又比第二组高出一截,说明第二组的编码器确实在两个任务之间做了妥协。
这三组结果把“表征冲突”从直觉变成了数据:语义分词器给语言模型提供了更合理的预测目标,理解能力明显更强;VQ 分词器保留了细节,却让语言模型很难从中抽取高层语义。但第二组仍不如纯理解训练的第三组,说明一个编码器同时服务两个任务时,理解侧确实被迫让步。Janus 的解法是承认这种冲突无法在编码器内部解决,干脆把冲突移到编码器之外——用两个编码器,让 Transformer 去学习如何同时消费两种特征。
主实验里,理解侧使用 SigLIP-Large-Patch16-384,生成侧使用码本 16384、空间下采样 16 倍的 VQ 分词器。384×384 的图像在两条路径上都下采样 16 倍,各自产生 个位置。模型基于 DeepSeek-LLM 1.3B,最大序列长度 4096。
适配器与预测头:所有跨模态对齐都发生在端口
Janus 的 Transformer 本身完全不知道模态差异。SigLIP 输出的二维特征网格被展平成一维序列,经理解适配器映射到语言模型的输入空间;VQ 码字查表得到码本 embedding,经生成适配器映射到同一空间。两个适配器都是两层 MLP,是唯一需要“翻译”模态的地方。
输出侧同样分离。文本与理解的输出用语言模型原有的预测头;图像生成则用一个随机初始化的图像预测头,预测 VQ 词表上的分布。这个设计避免了理解任务与生成任务在输出词表上的直接冲突,代价是图像预测头与语言模型其余部分必须一起训练,无法复用预训练语言模型的输出层。
整个模型严格遵守自回归框架:输入是一条由文本 token 与图像码字拼接而成的序列,输出是下一个 token 的分布;生成图像就是逐 token 采样码字,再交给 VQ 解码器重建。没有特殊掩码,没有双流注意力,也没有混合损失。
三阶段训练:先对齐端口,再统一预训练
Janus 的训练分三个阶段,每个阶段冻结的模块不同,这个安排本身就体现了“解耦”的思路。
第一阶段只训练端口:视觉编码器与语言模型全部冻结,只更新理解适配器、生成适配器与图像预测头。目的是先把两种视觉特征映射到语言模型能理解的空间里,同时让随机初始化的图像头具备初步的生成能力。第二阶段是统一预训练:解冻语言模型,用纯文本、多模态理解与视觉生成混合数据联合训练;生成部分先用 ImageNet-1k 学习基本的像素依赖,再接通用文生图数据。第三阶段是指令微调:除生成编码器外全部解冻,用指令数据训练对话与指令跟随,并屏蔽系统与用户提示的损失。
这个顺序的关键在于:跨模态对齐被限定在少量可训练参数上,先把端口调好,再放开主干联合训练。如果一开始就全参数放开,随机初始化的适配器与图像头会给主干带来很大的梯度噪声。
消融之后的结论:解耦不损害统一
论文的对照实验里,Janus 1.3B 在理解侧达到 POPE 87.0、MMBench 69.4、SEED 63.7、MMMU 30.5,COCO-FID 为 8.53;联合训练的理解与生成指标都落在两个单任务对照的附近:理解侧个别指标略低、个别略高,生成侧则与纯生成训练基本持平,没有出现单一编码器方案里那种理解能力明显塌陷。这说明在解码视觉编码之后,理解与生成可以在同一个 Transformer 里共存,而不必像单一编码器那样互相拖累。
Janus 的局限也很清楚。第一,它本质上是“两套前端加一个语言模型”,序列仍然是离散码字,所以图像生成的成本结构与 Emu3、Chameleon 一样,都是逐 token 自回归。第二,生成侧的分词器质量仍然是上限,码本 16384、下采样 16 倍意味着每张 384×384 图像只有 576 个码字,细粒度文字的还原能力受限。第三,解耦带来了额外的参数与显存开销:SigLIP 与 VQ 分词器同时常驻,理解侧还要多一份适配器。对于只做理解的部署,这份开销是纯成本;它的价值只在“同一个模型也要画图”时才体现出来。
从架构演进的角度看,Janus 回答的是一个更普遍的问题:统一模型是否必须统一每一个模块?它的答案是否定的。真正需要统一的只是负责推理与生成的 Transformer;输入编码与输出解码可以按任务定制,就像编译器前端与后端可以不同,中间表示才是统一的理由。
四条路线的横向对比
把四条路线放在同一张表里,差异会变得很直观。表中的 token 数是各篇论文的原生设置,输入分辨率不同,不能直接横向比较绝对大小,但可以看出每条路线把成本压在了哪里。
| 路线 | 视觉表征 | 编码器是否共享 | 训练目标 | 注意力模式 | 单图 token 数 | 生成方式 |
|---|---|---|---|---|---|---|
| Chameleon | VQ 码字,码本 8192 | 理解与生成共用 | 下一 token 交叉熵 | 全局因果 | 1024(512×512) | 逐 token 自回归 |
| Emu3 | MoVQGAN 码字,码本 32768 | 理解与生成共用 | 下一 token 交叉熵,视觉 token 权重 0.5 | 全局因果 | 4096(512×512) | 逐 token 自回归,带 CFG |
| Transfusion | VAE 连续 latent patch | 理解与生成共用 | 语言建模损失加扩散损失 | 全局因果,图内双向 | 256(256×256) | 文本自回归,图像扩散去噪 |
| Janus | 理解用 SigLIP,生成用 VQ 码字 | 理解与生成分离 | 下一 token 交叉熵 | 全局因果 | 576(384×384) | 逐 token 自回归,独立图像头 |
这张表最重要的信息不是数字,而是三条设计轴。
第一条轴是表征的离散程度。Chameleon 与 Emu3 把图像完全离散化,整个模型只有一个词表、一个损失、一个采样器;Transfusion 保留连续 latent,换来更好的生成质量,但必须同时实现语言与扩散两套推理逻辑;Janus 在生成侧仍用离散码字,只在理解侧保留连续语义特征。离散程度越低,生成质量的上限越高,服务链路的复杂度也越高。
第二条轴是编码器共享程度。Chameleon、Emu3、Transfusion 都让视觉编码器同时服务理解与生成,区别只在表征是离散还是连续;Janus 明确拆成两条路径。共享编码器的模型参数效率更高、部署更简单,但要在语义与细节之间折中;解耦编码器的模型理解能力更强,代价是额外的编码器参数与显存。
第三条轴是图像生成的并行粒度。三条离散路线都是逐 token 自回归,生成一张图需要与 token 数同阶的解码步数;Transfusion 的图像部分是扩散,步数由采样器决定,与 patch 数解耦,单步内全图并行。这个差别直接决定了延迟曲线:token 越多,自回归路线的步数越多;扩散路线则主要受采样步数与每步计算量影响。
还有一个容易被忽略的差异是“图像在序列中的角色”。在 Chameleon 与 Emu3 里,图像 token 与文本 token 完全同质,模型可以在任意位置开始生成图像,也可以在图像之后继续写文本;Transfusion 用 BOI/EOI 明确划分模态段,图像段内部是扩散、外部是语言;Janus 的生成侧虽然也是码字,但输入端的两套编码器让“图像作为条件”和“图像作为目标”走不同路径。前者更适合交错图文文档,后者更适合单轮的理解或生成请求。
推理成本账:离散图像 token 与扩散步数
统一多模态模型在论文里比的是生成质量,在部署时比的却是另一套指标:首 token 延迟、每 token 时间、单请求显存与吞吐。这四条路线的成本结构差别很大,值得单独算一遍。
离散路线的 KV 缓存账
先看最容易被低估的一项:KV 缓存。以 Emu3 的 8B 配置为例,32 层、32 个注意力头、8 个 KV 头、每头维度 128、fp16 存储。每个 token 在每层需要保存一份 K 和一份 V,因此单 token 的 KV 占用为:
代入 、、、 字节:
一帧 512×512 图像有 4096 个视觉 token,仅这部分 KV 就是:
这还没算文本上下文。若一次请求要生成多张图,或者要在一个长视频上下文里续写,KV 缓存会线性增长,很快就会超过单卡容量。对服务系统而言,这意味着统一多模态模型的 batch size 不能按文本模型的直觉来估:文本请求几千 token 已经算长,图像生成请求动辄几千 token 的 decode,且每个 token 都要保留 KV 直到请求结束。
Chameleon 的 1024 token 图像把这项压力压到四分之一,但它的 34B 模型层数与头数更大,单 token KV 更贵。Janus 的 576 token 图像在三条离散路线里最省,但它的理解侧 SigLIP 序列同样要占位置。可见“分词器压缩率”不是只影响训练序列长度,它直接决定了服务端的并发上限。
自回归步数与扩散步数
第二项是解码步数。离散路线的图像生成需要 次前向,每次只产出一个 token;Transfusion 的图像生成需要 次前向,每次更新全部 个 patch。把单步计算粗略记作与序列长度成正比,则两条路线的图像侧总计算量分别近似为:
前者随 token 数超线性增长,因为每一步都要对不断增长的 KV 做注意力;后者随 patch 数线性增长,步数 通常固定在几十步。若 、,扩散路线在步数上少两个数量级,但每步要处理全部 patch,且通常还要 CFG 双倍前向。真实比较不能只看渐进阶,还要看 kernel 效率、batch 大小与显存带宽;但趋势是明确的:token 数越大,自回归路线的串行瓶颈越突出;patch 数越大,扩散路线的单步计算越重。
这也解释了为什么 Transfusion 要把 U-Net 编解码块加回来,把每张图的 patch 数压到 16。图像侧的 从 256 降到 16,单步注意力规模缩小 16 倍,服务成本按论文估计可降到 。代价是编解码层自己要吃计算量,且质量需要靠额外的归纳偏置补回来。
理解与生成是两种不同的负载
统一模型的服务不能只看生成。理解请求是 prefill:图像 token 一次性并行进入模型,延迟由首 token 时间决定,吞吐由矩阵乘的并行度决定;生成请求是 decode:每个 token 一次前向,延迟由每 token 时间与步数共同决定。两者的最优 batch 策略、显存分配、调度优先级都不同。
在同一个服务实例里混跑两类请求,会带来资源竞争。一个长图像生成请求会长期占用 KV 缓存与 decode 槽位,而理解请求只是短时 prefill;如果调度器按文本模型的“请求数”做公平分配,生成请求会严重拖慢理解请求的尾延迟。合理的做法是按 token 预算与 KV 占用计费,而不是按请求数计费;对生成请求设置步数上限与抢占点,允许在图像块边界做 chunked prefill 式的切分,但图像块内部不能随意中断,否则解码器拿到的码字不完整。
三条离散路线的服务差异
Chameleon 的服务复杂度主要来自模态边界控制:每一步都要判断当前 token 属于哪个模态,采样时要屏蔽非法词表,流式输出要按 1024 token 的固定块组装。这些逻辑在 GPU 上做分支很不友好,所以论文用 token masking 把分支移走,并在非流式场景下融合整块生成。
Emu3 的复杂度主要来自序列长度与 CFG:4096 token 的图像生成本身就是长 decode,CFG 再把前向翻倍;如果同时生成多张图,KV 压力会叠加。它的优势是协议极简,视觉 token 与文本 token 同源,调度器不需要理解图像语义,只需要按普通 token 请求处理。
Janus 的复杂度主要来自双编码器常驻:理解侧 SigLIP 与生成侧 VQ 分词器都要加载,显存占用比同参数量的纯语言模型高;但它的 decode 序列最短,576 token 的图像生成在延迟上更友好。对于以理解为主、偶尔生成的服务,Janus 的编码器开销可能不划算;对于两类请求都重的服务,解耦带来的质量收益才抵得过这份成本。
Transfusion 的服务复杂度最高:同一实例要维护语言模式与扩散模式,图像段要跑多步去噪,CFG 要双路前向,VAE 编解码还要额外的显存与带宽。它的优势是图像质量与并行度;如果业务以高质量文生图为主、文本生成占比低,这套复杂度是值得的。反过来,如果业务主要是图文交错的长文档生成,Transfusion 的模式切换与步数开销会频繁触发,调度器需要把图像段当作独立的计算阶段来管理。
能力边界与设计启示
四条路线都能生成图像,也都能回答关于图像的问题,但它们的失效方式不同。把这些失效方式摆在一起,比比较单一指标更有信息量。
分词器决定了所有离散路线的上限
Chameleon、Emu3、Janus 的生成侧都依赖离散分词器,因此共享同一类瓶颈:码本容量、空间下采样倍率与训练数据分布共同决定了重建质量。Chameleon 论文明确承认其分词器在含大量文字的图像上较弱;Emu3 用 8×8 下采样与 32768 码本换取更细的空间结构,代价是每张图 4096 个 token;Janus 在 384×384 上只用 576 个码字,文字与细小纹理的还原能力更受限。语言模型只能预测已有的码字,无法创造码本里不存在的细节,所以“生成质量的上限”在分词器训练完成时就已经定下了一半。
这与音频生成里的 RVQ 分词器是同一类问题:把连续信号压成离散码字,码率与码本大小决定了信息保真度,语言模型只负责在码字空间里建模。站内音频生成的离散 token 路线详细拆过 RVQ 的残差结构与码本设计,其取舍逻辑可以直接迁移到图像分词器上:增加码本层数能提升重建质量,但会让序列变长或让每帧 token 数增加;降低帧率能缩短序列,但会损失瞬态细节。
连续路线避免了量化损失,但没有消除计算瓶颈
Transfusion 用 VAE 加扩散绕过了离散化,生成质量的上限由 VAE 重建能力与扩散采样共同决定。它避免了“码字不够用”的问题,但仍然要面对扩散的固有成本:多步去噪、CFG 双倍前向、每步全图计算。它把“序列长度”换成了“patch 数”,把“自回归步数”换成了“采样步数”,并没有让计算消失。
这条路线与站内扩散模型从零讲起和潜空间扩散的机制是同一套:VAE 把像素压到 latent,扩散在 latent 上去噪,文本条件通过交叉注意力或序列前缀进入。区别只在于 Transfusion 把去噪网络换成了语言模型主干,让同一个 Transformer 同时承担文本预测与图像去噪。理解了潜空间扩散的推理链路,就很容易理解 Transfusion 的服务成本落在哪里。
统一主干不等于统一所有端口
Janus 的消融给出了最有价值的一条设计原则:如果两个任务对表征的需求冲突,优先拆开端口,而不是强迫一个编码器兼顾。这个原则不限于图像。未来的统一模型如果要接入音频、点云、触觉,同样可以让每种模态拥有自己的编码器,只在 Transformer 层共享推理与生成能力。站内多模态大模型的四种融合机制讨论过双塔、投影连接、交叉注意力与统一词元四条融合路径,Janus 可以看作“统一词元”路线的一个修正版:词元仍然统一,但词元的来源按任务定制。
反过来,Chameleon 与 Emu3 证明了另一条原则:如果分词器足够好,统一词表能带来极低的架构复杂度。整个模型只有一个损失、一个采样器、一套并行策略,研究迭代与工程部署都更简单。它们的问题不是“统一”本身,而是“统一到离散码字”这一步丢失了太多信息。两条原则并不矛盾:一个说的是“主干要统一”,一个说的是“端口可以分离”。
交错图文生成是比单轮文生图更难的任务
四条路线都展示了交错图文生成的能力,但真正的难点不在单张图的质量,而在长序列里保持一致性。模型要记住前面出现过的物体、风格与空间关系,要在图像块与文本段之间反复切换,还要在上下文里维持指代关系。Chameleon 用 4k 上下文与固定 1024 token 图像块,Emu3 用 131072 上下文容纳视频,Transfusion 用 BOI/EOI 划分模态段,Janus 则依赖语言模型的 4096 序列长度。上下文越长,KV 缓存与注意力成本越高;图像块越大,单请求占用越重。这让“交错生成”在服务端更像长上下文推理问题,而不是单纯的图像生成问题。
站内Visual Autoregressive Modeling从另一个方向处理了图像 token 的顺序:先粗后细的下一尺度预测,让自回归步数从“像素级”降到“尺度级”。如果把 VAR 的尺度金字塔与 Chameleon 的统一词表结合,理论上可以在保持离散路线简单性的同时减少自回归步数;这也是统一多模态架构后续值得关注的方向之一。
对部署与选型的启示
如果目标是多模态理解为主、偶尔生成,Janus 式的解耦更合适:理解侧保留强语义编码器,生成侧用轻量 VQ 头,主干共享但不牺牲理解质量。代价是双编码器常驻显存。
如果目标是研究统一建模、快速验证交错图文能力,Chameleon 或 Emu3 式的全离散路线更合适:实现简单,能直接复用语言模型的训练与推理栈,图像生成就是普通 decode。需要接受分词器带来的质量上限与长 decode 的延迟。
如果目标是高质量文生图,同时保留文本生成能力,Transfusion 式的混合目标更合适:连续表征避免了量化损失,扩散保证图像质量。需要承担双模式推理、CFG 双倍前向与 VAE 编解码的工程复杂度。
如果目标是视频或多模态时序生成,Emu3 的 token 文档格式提供了最直接的扩展方式:帧标记与行标记让视频变成一条长 token 序列。但要先算清楚 token 预算:一段几秒的 512×512 视频就是几千个 token,长视频必须靠分段、缓存与续写策略,不能指望单请求塞进无限上下文。
最后是一条服务侧的原则:不要把图像 token 当成“另一种文本 token”来做容量规划。文本请求的 decode 通常几百到几千步,图像生成请求的 decode 是几千步且每步都带着完整的图像前缀 KV;如果调度器按文本请求的经验设置并发数,显存会在第一批图像请求进来时爆掉。合理的做法是按 KV 预算分配并发、在图像块边界做调度切分、对生成请求单独设置超时与抢占策略。统一模型把算法统一了,服务系统反而需要更细的区分。
参考资料
- Chameleon: Mixed-Modal Early-Fusion Foundation Models(arXiv:2405.09818)
- Emu3: Next-Token Prediction is All You Need(arXiv:2409.18869)
- Transfusion: Predict the Next Token and Diffuse Images with One Multi-Modal Model(arXiv:2408.11039)
- Janus: Decoupling Visual Encoding for Unified Multimodal Understanding and Generation(arXiv:2410.13848)
- Janus-Pro: Unified Multimodal Understanding and Generation with Data and Model Scaling(arXiv:2501.17811)
- Autoregressive Model Beats Diffusion: Llama for Scalable Image Generation(LlamaGen,arXiv:2406.06525)
- Make-A-Scene: Scene-Based Text-to-Image Generation with Human Priors(Gafni 等,arXiv:2203.13131)
- MoVQGAN 官方实现(ai-forever/MoVQGAN)
- Chameleon 官方代码库(facebookresearch/chameleon)
- Emu3 官方代码库(baaivision/Emu3)
- Janus 官方代码库(deepseek-ai/Janus)
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



