


开放词表目标检测架构入门:文本怎样变成检测器的类别条件——从 GLIP、OWL-ViT 到 Grounding DINO
背景:检测器为什么只认识训练时的那张类目表
目标检测要回答两个问题:画面里有什么(分类),它在哪里(定位)。在深度学习普及之后,回答这两个问题的方式被固化成一个流程:主干网络把图像变成特征图,检测头在特征图的每个位置上预测若干个候选框,分类分支在事先定好的类目表上做 softmax,回归分支修正框的坐标。这个流水线在 COCO 的 80 类、LVIS 的 1200 类上被反复打磨,精度早已远超早期方法,但它继承了一个前提:类目表是闭集(closed-set)。训练时见过哪些类别,部署时才能输出哪些类别。
闭集假设在真实系统里很快会遇到麻烦。一个电商平台每天上新商品品类的速度远快于重新标注、重新训练的周期;一个安防系统想临时查「蓝色安全帽」,模型却只认识训练数据里的「安全帽」;一个图像检索系统需要按用户随手输入的名词过滤相册,而名词的组合几乎是无限的。传统做法有两种:一是给新类别收集几千张标注数据做微调,成本高且周期长;二是把检测器当成「类无关的候选框生成器」,先用通用检测器出框,再用 CLIP 之类的图文模型对每个框打分。第二条路线看似绕开了闭集限制,但它把两个独立训练的模型拼在一起,框的质量与打分所依赖的特征不在同一个空间里,误差会叠加。
真正要把「类别」这个变量从权重里解耦出来,需要换一个建模角度:类别不再是一行固定的输出神经元,而是模型输入的一部分。给定一张图和一段描述类别的文本,模型输出的是「文本所指的物体在这张图里的框」。这个任务在 2021 年前后有了统一的名称——开放词表检测(open-vocabulary object detection),有时也叫开放集检测(open-set detection)。它与「短语定位」(phrase grounding)在形式上几乎一致:后者给定一句自然语言描述,要求框出被描述的区域。两者的差别主要在数据与评价口径:开放词表检测通常用类别名或短语作为条件,评测基准是 LVIS 的稀有类;短语定位用完整的句子,评测是 Flickr30k Entities、RefCOCO 之类的数据集。
本文沿三条基础架构路线讲清楚「文本条件如何进入检测器」:以 GLIP 为代表的对齐式路线,把检测改写成区域与短语的匹配问题;以 OWL-ViT 为代表的双分支路线,用图文对齐模型直接给候选框打分;以 Grounding DINO 为代表的深度融合路线,把文本送进检测主干的多层注意力里。三条路线的共同问题是:文本在哪一层、以什么形式、与哪一部分视觉特征交互,以及这个选择如何决定推理成本与失效模式。
检测器的三种基础形态,以及类别表到底存在哪里
要理解文本条件怎么进入检测器,得先看清闭集检测器的类别信息存在哪。三种主流形态的答案并不相同。
两阶段检测器(two-stage detector,代表是 Faster R-CNN 系列)把检测拆成两步。第一步由区域提议网络(Region Proposal Network,RPN)在特征图上给每个位置生成若干候选框,并用一个二分类头判断「这里有没有物体」;第二步对每个候选框做兴趣区域对齐(RoI Align),把框内的特征池化成一个固定长度的向量 ,再送进分类头与回归头。分类头的输出是
其中 是第 类的分类权重向量, 是训练时的类别数。类别表在这里就是矩阵 的每一行。要让检测器认识新类别,最直接的想法是把 换成一段文本的嵌入向量 ,用 作为得分。这正是 ViLD 一类方法的核心操作。问题在于, 是在检测数据上训练出来的特征,它的几何结构服务于那 个类别的线性可分性,而 来自图文对比学习模型的特征空间。两个空间没有对齐过,直接做点积,分数没有意义。ViLD 的解决办法是让区域特征去模仿 CLIP 的图像嵌入——训练时加一个蒸馏损失,把区域特征拉进图文对齐空间。这暗示了一个重要事实:开放词表检测的难点不在「有没有文本嵌入」,而在「区域特征和文本特征是否住在同一个空间」。
一阶段检测器(one-stage detector,代表是 YOLO 系列、RetinaNet)取消了独立的提议阶段。它在特征图的每个位置上预先铺好不同尺度、不同长宽比的锚框(anchor),直接对每个锚框预测类别与偏移量,最后用非极大值抑制(Non-Maximum Suppression,NMS)去掉重复框。它的类别信息同样存在分类卷积核里,只不过这个卷积核在特征图的每个位置共享。一阶段检测器的分类头通常是 卷积,输出通道数等于类别数,本质仍是 的形式。此外它多了一个「前景/背景」的二分问题,靠锚框与真值的交并比(IoU)做标签分配。
基于集合预测的检测器(set prediction detector,代表是 DETR)换掉了锚框和 NMS。它用固定数量的可学习查询向量(object query)作为解码器的输入,每个查询独立输出一个框和一组类别概率,然后通过二分图匹配(bipartite matching)把预测与真值一一配对。DETR 于 2020 年由 Facebook AI Research 提出,论文发表在 ECCV 2020,arXiv 编号 2005.12872。它的匹配代价写成
这里 是查询数(DETR 用 100), 是 个预测的所有排列, 是真值( 表示该槽位没有物体), 是第 个预测在真值类别上的概率, 是框的 L1 损失与广义 IoU 损失的组合。第一项鼓励匹配上的预测把正确类别的概率抬高,第二项鼓励框对齐;乘上指示函数是因为空槽位没有类别、也没有框,不参与这两项。训练损失在匹配完成后计算,形式与匹配代价一致,只是分类项换成对数概率,并对空槽位的项降权,避免大量背景预测淹没梯度。
DETR 的意义不只是去掉 NMS。它把「一个查询对应一个物体」变成了显式的建模假设:查询数量固定,输出是集合,重复框的抑制由匹配机制在训练阶段完成,而不是在推理阶段靠启发式规则。代价是收敛慢——原始 DETR 需要 500 个 epoch,Deformable DETR(arXiv 2010.04159)通过可变形注意力只采样参考点附近的少量位置,把收敛所需 epoch 降到约十分之一,并改善了小物体检测。DINO(arXiv 2203.03605)进一步加入对比去噪训练、混合查询选择与前向两次的框修正,在 ResNet-50 骨干上 12 个 epoch 达到 49.4 AP。
对开放词表检测来说,DETR 的结构有一个关键好处:类别概率不是最后一个固定矩阵乘出来的,而是查询与某种「类别表示」比较得到的。这个比较对象可以是可学习的类别嵌入,也可以换成文本嵌入。DETR 式的查询机制因此成了后续开放集检测器的主干——Grounding DINO 就是 DINO 的开放集改造版本。
把三条路线的差别收拢成一句话:文本条件可以在三个位置插入检测器。位置一,区域特征之后——拿现成的区域特征或 patch 特征与文本嵌入做点积,检测器本身几乎不改;位置二,特征融合层——在骨干或颈部的多层注意力里让图像特征与文本特征互相看见,让视觉表示本身变得「语言感知」;位置三,查询层——用文本参与查询的初始化或解码,让每个查询从一开始就带着类别意图。下面三条路线正好对应这三个位置。
GLIP:把检测改写成区域与短语的匹配
GLIP 的全称是 Grounded Language-Image Pre-training,由 Microsoft Research 在 2021 年提出,arXiv 编号 2112.03857,相关工作发表在 CVPR 2022。它的出发点是一个任务层面的观察:目标检测可以看成一种没有上下文的短语定位(context-free phrase grounding)。短语定位的任务是,给定一句话和一张图,找出句中每个名词短语所指的区域,比如「the woman in the red hat」对应画面左上角那个框。检测器做的事其实一样,只是「句子」被换成了用「.」连接起来的类目名列表,比如 COCO 的 80 类就构成一句「person. bicycle. car. …」;每个类目名就是一个短语,检测就是找出每个短语对应的区域。
这个等价关系一旦成立,训练数据就可以打通:检测数据集是「区域 + 类别短语」,短语定位数据集是「区域 + 句子片段 + 短语」,两者都能表达成「区域特征与短语特征的匹配矩阵」。GLIP 用 2700 万条定位数据预训练,其中 300 万条是人工标注的短语定位数据,2400 万条是从网上抓取、再用公开检测器或标注模型自动生成框的图文对。数据构造的细节不是本文重点,需要记住的是:它让模型在见到 COCO 之前就已经理解了「区域与文字对应」这个概念。
从分类 logits 换成对齐分数
传统检测器在候选框上输出分类 logits, 维,类别固定。GLIP 的做法是把这一步换成一个矩阵乘法。设某个候选区域(或其对应的特征图位置)的视觉特征为 ,输入短语序列经过文本编码器后得到词级特征 , 遍历所有短语的所有词元,记短语 的词元集合为 ,则区域 与短语 的得分是
对短语内所有词元取平均,是因为一个短语可能被分词成多个子词。比如「traffic light」是两个词,「toothbrush」在 BERT 的 WordPiece 分词下会裂成「tooth」与「##brush」两个子词。如果只取其中一个,短语的语义就不完整;取最大值会让模型只盯住最有区分度的那个子词;取平均是最自然的做法——它让得分近似等于「区域特征与短语特征质心」的点积。GLIP 论文明确采用这种口径:训练时对框分类器输出的每个对齐分数逐词计算,推理时把同一短语各词元的概率取平均作为短语的概率。注意这里平均的对象略有区别——训练用的是分数矩阵上的对比损失,短语内各词元在标签上同时为正,平均发生在推理阶段用于把词元级得分压成短语级得分。
矩阵形式更直观。把所有区域的视觉特征堆成 ( 是区域数,即特征图的每个位置都算一个候选位置),文本特征堆成 ( 是全部短语的全部词元数),那么
第 行第 列表示第 个区域与第 个词元的匹配程度。传统检测器的分类矩阵 被 替换掉了——类别信息从权重变成了输入。这也是 GLIP 双编码器结构(dual-encoder)的含义:图像编码器与文本编码器各自独立,只在最后的点积处交互。
对齐损失为什么不能直接用 softmax
如果照搬 CLIP 的对比学习,会对每个区域在所有词元上做 softmax 交叉熵。可检测数据里,绝大多数区域与绝大多数短语都是负匹配,正匹配往往只有一两个,而且一个区域在整张图的上下文里可能同时匹配多个短语(比如一个人穿着红色上衣,可能同时被「person」和「red shirt」匹配到)。softmax 会强迫所有区域的概率质量在词元之间竞争归一,这与检测的数据分布不符。
GLIP 改用二值化的 sigmoid 焦点损失(focal loss),把每个区域与每个词元的组合看成独立的正负二分类。设目标矩阵 , 表示区域 与词元 的短语是正匹配,0 表示不是。标签需要做子词扩展:一个短语若是正匹配,它分词后的所有子词都置为 1;所有「Detect:」、逗号、特殊 token 等附加词元对所有区域都置为 0;另外在序列末尾加一个 [NoObj] token,专门作为「背景」锚点。损失写成
其中 是扩展后的目标矩阵。焦点损失的调节项在正样本比例极低时尤其重要:它把大量简单负样本的损失压低,让梯度集中于难负样本。GLIP 的一个有趣结论是,这个损失对检测与短语定位两个任务通用——检测任务的「句子」没有上下文,短语定位的句子有上下文,但匹配的形式一致。
视觉与文本的融合方式,以及为什么「深融合」必要
只做最后点积的双编码器结构有个结构性缺陷:图像特征在编码时完全不知道文本要问什么,文本特征也完全不知道图里有什么。CLIP 能这么干,是因为它只做图像级别的全局匹配,一张图的 [CLS] token 压缩了整张图的信息,语义足够粗。检测要求区域级、细粒度的理解,区域特征必须「知道」自己要去找的是什么东西。一个在「自行车」语境下应该突出的车架纹理,在「人」的语境下可能被忽略。没有融合,视觉表示不会因文本而改变。
GLIP 的融合不是一次性拼接,而是在颈部深层的跨模态多头注意力(Cross-Modality Multi-Head Attention,X-MHA)里逐层双向融合。设第 层的图像特征为 ,文本特征为 ,则
其中 是让文本特征作为 key/value、图像特征作为 query 得到的「文本引导的视觉修正」, 是反向得到的「视觉引导的文本修正」。两个修正都通过残差加回各自的原始特征,再分别进入 DyHead 模块(图像编码器,Dynamic Head 的动态检测头)与 BERT 层(文本编码器)的下一层。 的作用可以理解为:对每个图像位置,从全部词元里查找与它最相关的语义线索,把这条线索混进视觉特征; 则让每个词元的表示吸收图中实际存在的视觉证据,减少词元在孤立语境下的语义偏差。
两个方向都要,是因为单方向的融合不够。若只做图像向文本取信息,文本表示始终停留在纯语义空间,模型无法通过「调整文本」来降低误匹配——在训练中,错误的负匹配样本不会推动文本往更可区分的子空间移动。若只做文本向图像取信息,视觉表示不会因类别而变化,回到双编码器的老问题。双向融合让两边的表示在同一网络里互相塑造,最后一点积的分数才落在同一个可比较的度量空间里。
图片来源:GLIP 论文(arXiv:2112.03857),左图为把 COCO 80 类写成一句 prompt 后区域与短语的匹配矩阵,中图为跨模态深融合的编码路径。
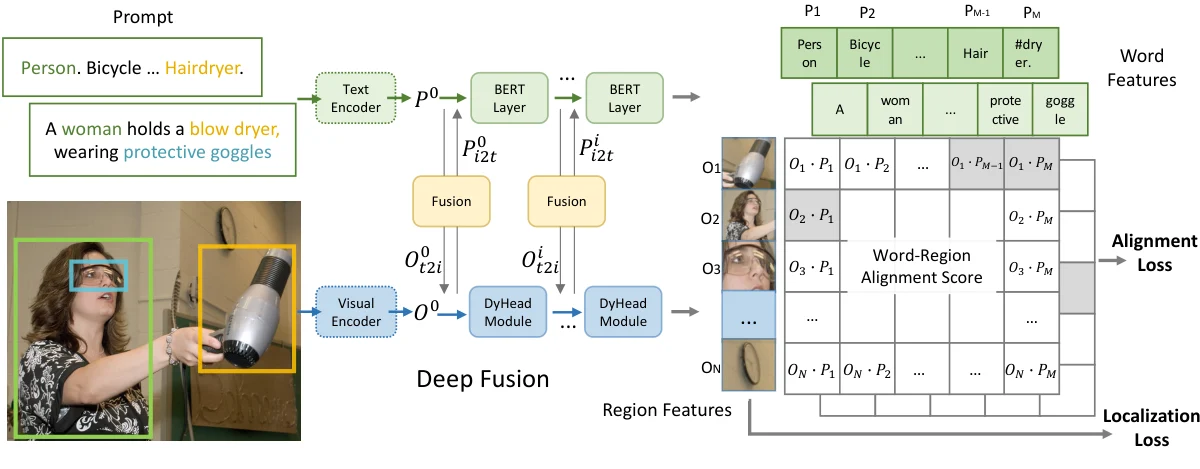
上图左侧是一张检测输入被改写后的样子:图的每一处都与一句由类目名拼成的文本对齐,输出的矩阵每一行对应一个区域,每一列对应一个短语;中间部分是跨模态多头注意力的融合结构,图像特征与文本特征在多个颈部层互相成为对方的 key/value,修正后各自残差回原路;右侧展示检测 logits 被对齐分数替代后,分类头不再需要固定维度。
融合要不要发生在骨干里
GLIP 只融合颈部(neck)与浅层,不在骨干(backbone)里融合,理由是计算代价。融合发生在第 层时,计算量为 量级的注意力;在浅层特征图分辨率高, 是 的量级,一个 640×640 的输入在 P3 层(步长 8)有 个位置,与 80 个类目的 100 来个词元相乘,矩阵大小已经远超后续所有层。GLIP 论文的附录里专门讨论过深融合的计算代价,结论是融合放在颈部与浅层(P3 附近)既保留了「高分辨率特征的融合收益」,又把大部分计算留在了较小的特征图上。这是一个典型的检测系统中「分辨率 × 语义深度」的权衡。
结果与消融:三项技术各自解决了什么
GLIP 的原始论文给出了三组关键数字。第一组是零样本迁移:在没有见过任何 COCO 图像的前提下,GLIP 在 COCO 上达到 49.8 AP,在 LVIS 上达到 26.9 AP。这个数字需要参照系才看得懂——同期的完全监督基线里,ResNet-50 的 Faster R-CNN 是 40.2 AP,ResNet-101 是 42.0 AP,DyHead 配 Swin-Tiny 是 49.7 AP。也就是说,一个完全没见过 COCO 图像的模型,检测精度超过了用 COCO 全量数据训练的 ResNet-50 Faster R-CNN,接近当时最强的监督检测器之一。第二组是微调后的上限:在 COCO 上微调后达到 60.8 AP(val)与 61.5 AP(test-dev),超过当时的最好结果。第三组是数据效率:在 ODinW 的 13 个下游检测任务上,1-shot 的 GLIP 与完全监督的 DyHead 持平,零样本的 GLIP-L 超过 10-shot 的监督 DyHead。
论文的消融把三项核心技术分开验证:统一的对齐损失(把检测的分类损失换成区域-短语对齐损失)、语言感知的深融合、以及在检测数据与定位数据上联合预训练。三个变体的构造方式很能说明问题:变体 A 只替换损失,相当于「一个强零样本检测器」,靠文本编码器的语义泛化;变体 B 在 A 上加深融合,视觉表示变成语言感知的;变体 C 再加定位数据预训练。消融的结论与架构分析一致——只换损失能获得开放词表能力,但要让区域特征真正承载语言语义,必须有深融合;要让模型见到足够多样的短语,必须有定位数据。 三者缺一,性能都掉。
OWL-ViT:从图文对齐模型直接长出检测头
OWL-ViT 的全称是 Simple Open-Vocabulary Object Detection with Vision Transformers,由 Google Research 在 2022 年提出,arXiv 编号 2205.06230,论文发表在 ECCV 2022。它的思路与 GLIP 几乎是反过来的:GLIP 从检测器出发,把分类头换成对齐;OWL-ViT 从已经对齐好的图文模型出发,不加融合层,直接给图像编码器的每个输出 token 挂上分类头与定位头。论文标题里的「简单」(Simple)就是这个意思。
为什么图像级图文模型不能直接做检测
先把问题说清楚。CLIP 一类模型在训练时做的是图像级对比:一张图经图像编码器得到一个全局嵌入,经池化(CLIP 里是取 [CLS] token)把整张图压成一个向量;一段文字经文本编码器得到另一个向量;两者的余弦相似度在 batch 内最大化正对、最小化负对。注意池化的位置:全局嵌入是在编码器末端、由所有 patch token 聚合出来的。一旦池化,patch 级别的信息就消失了,区域与短语的对应关系没有被任何训练信号约束过。
RegionCLIP(arXiv 2112.09106,CVPR 2022)专门指出了这一点:直接把 CLIP 用在区域识别上,性能差,原因是「域偏移」(domain shift)——CLIP 匹配的是整张图与整段描述,区域与文本片段(span)之间的细粒度对齐从未出现过。OWL-ViT 的出发点与此一致,但它的解决路径不是再加一层融合网络,而是让检测微调接管对齐:在检测数据上训练时,每个区域的打分与文本嵌入的相似度对比,本身就提供了区域级的对齐信号。
架构改动:去掉池化,把分类头挂到每个 token
OWL-ViT 的骨干是一个 ViT 或混合结构(ViT 为主干,前端可以是 Transformer 或 ResNet 卷积降采样)。改动只有三处。
第一,去掉注意力池化与最后的线性投影。 图像编码器不再输出一个全局向量,而是输出 个 patch token 的特征 。ViT 本身是按 patch 切块、每块一个 token(加上位置编码)编码的,去掉池化只是不把 token 聚合起来,保留最后一层每个 token 的表示。 是 patch 数,比如 768×768 的输入在 patch 大小为 32 的 ViT-B/32 下是 个 token。
第二,给每个 token 挂一个轻量分类头和一个框回归头。 分类头的作用是把 patch token 的特征映射成可用于与文本嵌入比较的向量;定位头直接从同一个 token 输出四个坐标偏移量。OWL-ViT 的定位头采用「相对 token 位置的框预测」:每个 token 预测一个框,框的参考位置是该 token 对应的图像 patch 位置,模型只学习相对于这个位置的偏移与尺度,做法与区域提议网络相对预定义锚框预测偏移量完全同构。这里有一个细节值得注意——Transformer 后层的 token 表示与原始 patch 之间已经没有严格的空间对应关系,按理说这个位置先验不该有用;但论文的消融显示它既有用又重要:把位置偏置去掉,纯 ViT 模型在 LVIS 上的 AP 掉了接近 3 个点。论文的解释是,位置偏置缩短了训练初期「框该从哪里开始调整」的搜索距离,让回归头更快收敛;对没有卷积归纳偏置的纯 ViT,这个先验的价值最大。
第三,图像侧每个 token 做一次线性投影,文本侧保持原结构。 去掉池化与末端投影后,每个 token 的表示经由一个新的线性层投影成「单对象的图像嵌入」,维度与文本嵌入一致。文本侧不做改动——文本编码器连同它自己的末端投影一起保留,输出的类别嵌入可以直接与图像侧的 token 嵌入做点积。这样,分类就不是「最后一层固定权重乘以特征」,而是「查询嵌入与区域嵌入的内积」,与 GLIP 的形式一致,区别只在于区域嵌入来自 patch token、而非颈部特征图位置。
分类得分写出来很直接。对图像的第 个 token,分类头输出 ;对第 个类别查询(文本嵌入或图像查询),记其向量为 ,则
与 GLIP 的 相比,这个式子的区别在于:OWL-ViT 的两边都已经处在对比学习预先对齐好的空间里,而且图像侧每个 token 都经过了独立的分类头。框的输出则是每个 token 一对四维向量 ,以 token 对应位置为参考解算到原图坐标。推理时,每个 token 对每个查询都有一个框和一个分数;对同一个查询,把所有 token 的框按分数筛选,再用 NMS 去重。
文本条件与图像条件:同一个接口的两种输入
OWL-ViT 的一个扩展值得单独讲:用图像查询做检测(image-conditioned detection)。文本查询是「查这个词所指的物体」,图像查询是「查这个物体」,两者在架构上共享同一个接口:查询在文本编码器下的嵌入是一个 维向量,在图像查询下,把一张查询图像(比如一张书包照片)编码后,取它某个位置的特征(或全局池化特征)作为查询嵌入,送入同一个比较公式。也就是说,查询侧可以是文本、也可以是图像,检测器不需要区分。
这个能力在设计上几乎是「免费」的,因为对齐空间是图文共享的。文本嵌入与图像嵌入在同一空间内可比较,所以用图查图就是直接的邻域搜索。论文的实测很能说明问题:在训练时被留出的 COCO 类别上,one-shot 图像查询的 AP50 从此前方法的 26.0 提升到 41.8,相对提升 72%。论文还给出了一个直观的案例——图中的凤蝶与月神蛾,用文本查询时模型只对了凤蝶,月神蛾没检出来;改用同类的一张图像块作查询,两个物种都能被找到。这说明「查询」这个抽象的设计价值:检测器的接口是「有一个查询、找到与它最像的区域」,查询的来源不影响推理,而图像查询可以表达文本难以描述的东西(比如某种专业零件的具体外形)。
图片来源:OWL-ViT 论文附录(arXiv:2205.06230),中间一列是作为查询的图像块,两侧是在目标图上找到的检测结果与相似度分数。
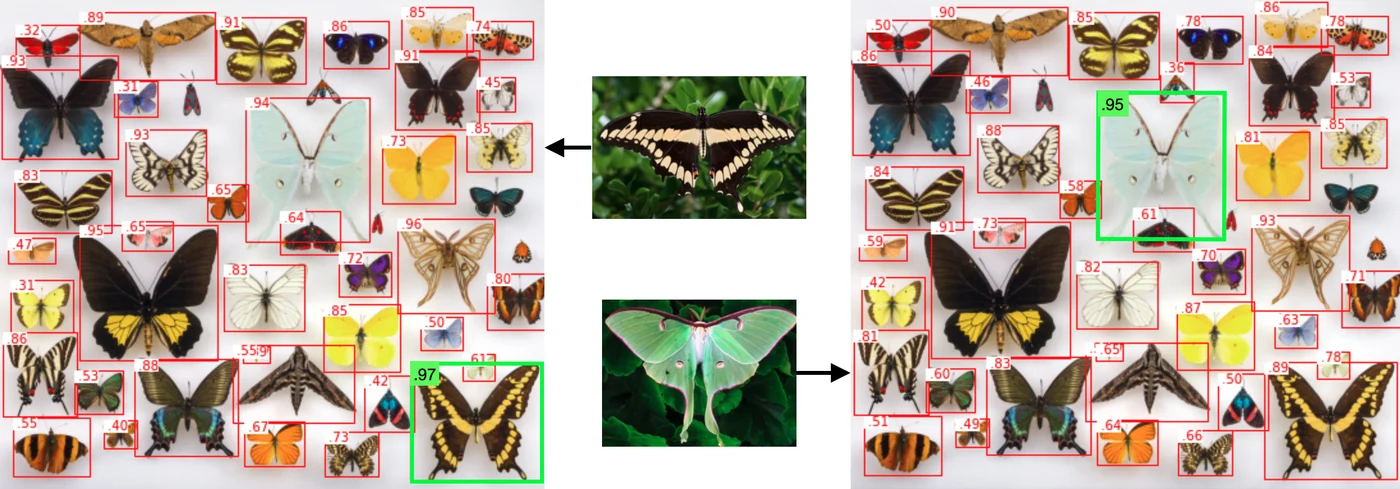
上图展示的就是图像查询检测的用法:给定一张查询图,模型编码的是它的一种特征(这里是图像块),随后在目标图像的 patch 特征中查找最相似的位置。注意结果里的框与相似度数字——查询与目标之间不依赖任何类别名,只依赖特征空间里的相似度。
与 GLIP 路线的本质差异
把两条路线放在一起比较,会看到一个核心分歧:GLIP 认为「区域特征与文本特征不在同一个空间」是一个必须用网络消除的问题,因此用跨模态注意力在视觉编码过程中注入语言;OWL-ViT 认为「对比学习已经在图像级对齐了空间」,区域级的不对齐可以交给检测微调来解决,因此保持骨干纯净、只改接口。
这导致两类模型在不同条件下各有优势。GLIP 的深融合对「需要组合推理」的查询更有效——比如「a cat wearing a hat」,这类查询需要把多个词元的语义与图像局部组合起来,纯双编码器在末端点积时已经来不及建模这种组合。OWL-ViT 的简单结构推理更快,图像编码器只需跑一次,对多个查询的推理只需在文本侧跑编码器,然后对全部 token × 全部查询做一次矩阵乘法;在查询数量较多时,这个成本可以忽略。代价是它对细粒度组合的鲁棒性依赖对比学习的质量——如果查询词与预训练语料里的用法不同,特征会漂移。
检测微调:标签分配与损失
OWL-ViT 的微调需要解决一个与 DETR 相同的问题:每个 token 都预测框,哪个 token 对哪个真值负责?它采用二分图匹配,把预测与真值一一配对,匹配代价由分类分数、框回归误差和 objectness 组成。这里「分类分数」不是与固定类别比较,而是与真值类别的文本嵌入做相似度。匹配完成后的损失包含三部分:
是区域特征与真值类别文本嵌入的 sigmoid 交叉熵(或焦点损失); 是独立的 objectness 二分类损失; 与 分别度量四个坐标的绝对误差与框形状的重叠质量。三个 是平衡系数。objectness 头单独存在的理由是:分类分数只表示「这个区域像不像该类」,它无法表达「这个区域根本不是一个物体」。只靠分类分数,一片与「天空」相似的背景区域也会得到高分。objectness 提供了与类别无关的前景判断,在开放词表场景下尤其必要,因为任意一个查询都可能与某些背景区域产生非零相似度。
选择纯 ViT 做检测主干,在 2022 年时已经不算冒险。ViTDet(Exploring Plain Vision Transformer Backbones for Object Detection,arXiv 2203.16527)证明了不引入卷积层次结构、只用一个简单的特征金字塔把 ViT 的多层特征接出来,就能把纯 ViT 做成强检测器;它的关键观察是,ViT 的全局自注意力本身已经提供了跨尺度所需的上下文,缺的只是一个把单尺度特征图变成多尺度的轻量颈部。OWL-ViT 把这个结论用在了开放词表场景:主干越「语义化」,区域嵌入与文本嵌入越容易落在同一空间。
训练数据的选择对零样本能力有决定性影响。OWL-ViT 在公开检测数据集上微调,并在评测 LVIS 稀有类时把这些类的标注从所有训练集中剔除,从而让「稀有类」真正是零样本。论文报告的最佳模型在 LVIS 上零样本整体 AP 为 34.6,稀有类 AP_rare 为 31.2,后者是衡量零样本能力的主指标。另一个结论对架构选择有参考价值:在相同的整体检测精度下,纯 ViT 的零样本 AP_rare 普遍高于卷积或混合骨干。论文的解释是,ViT 偏向学习语义泛化,卷积偏向学习已知类别的定位——这也解释了为什么 OWL-ViT 坚持用 ViT 做主干,而把卷积只放在前端做降采样。
OWLv2:把自训练当作数据引擎
OWL-ViT 的瓶颈很快暴露:检测训练数据的规模远小于图文预训练数据。OWLv2(Scaling Open-Vocabulary Object Detection,arXiv 2306.09683)的做法是用自训练扩数据:先拿已有的开放词表检测器,在网页图文对上生成伪框标注,再过滤、去重、按类别词表整理,最后用这些伪标注训练新模型。它的三个工程难点是标签空间怎么定(用什么样的类别词表生成伪框)、伪标注怎么过滤(置信度阈值、多模型投票、跨图文对一致性)、训练怎么高效(数据规模上来后,检测训练的计算与存储成为瓶颈)。
这条路线的意义在架构层面:它不改变 OWL-ViT 的模型结构,只改变数据规模。 这本身就是一个判断——当接口设计正确(查询可替换、分类不绑定类目表)时,性能提升可以从数据侧获得,而不必继续加深融合网络。Grounding DINO 则走了另一条路:继续保持 DETR 式集合预测的接口,但把文本融合做进编码器与解码器的每一层。
Grounding DINO:把文本送进检测主干的每一层
Grounding DINO 由 IDEA Research 在 2023 年提出,arXiv 编号 2303.05499,是 DINO 的开放集改造版本。DINO 本身的贡献是让 DETR 式检测器在 12 个 epoch 内收敛并达到强精度:对比去噪训练(contrastive denoising)、混合查询选择(mixed query selection)、前向两次的框修正(look forward twice)。Grounding DINO 把 DINO 的三阶段结构保留下来,在每一阶段插入图文交互,形成一条「特征增强 → 查询选择 → 跨模态解码」的完整链路。
三阶段融合的整体结构
Grounding DINO 的输入是一张图与一句文本(文本由类目名用「.」连接而成)。图像经 Swin Transformer 骨干得到多尺度特征,文本经 BERT 得到词元特征。之后三步:
- 特征增强器(feature enhancer):在多尺度图像特征与文本特征之间做双向交叉注意力,把语言信息注入视觉特征、把视觉证据注入文本特征。这一层对应 GLIP 的深融合,但作用在骨干输出的多尺度特征上。
- 语言引导的查询选择(language-guided query selection):从增强后的图像特征中选出 900 个 token 作为解码器的初始查询,选择依据是这些 token 与文本特征的最大相似度。
- 跨模态解码器(cross-modality decoder):每一层解码器包含自注意力、图像交叉注意力、文本交叉注意力与 FFN,查询在每一层都能同时读取图像与文本。
这三步的设计逻辑是递进的:特征增强让视觉表示携带语言信息;查询选择让解码器的起点对准文本提到的区域,省掉从零学习「去哪里找」的过程;跨模态解码让每个查询在迭代中不断用文本校正自己的语义。
图片来源:Grounding DINO 论文(arXiv:2303.05499)。第一张图为整体框架,第二张图为 DINO 与 Grounding DINO 的模型结构对比。
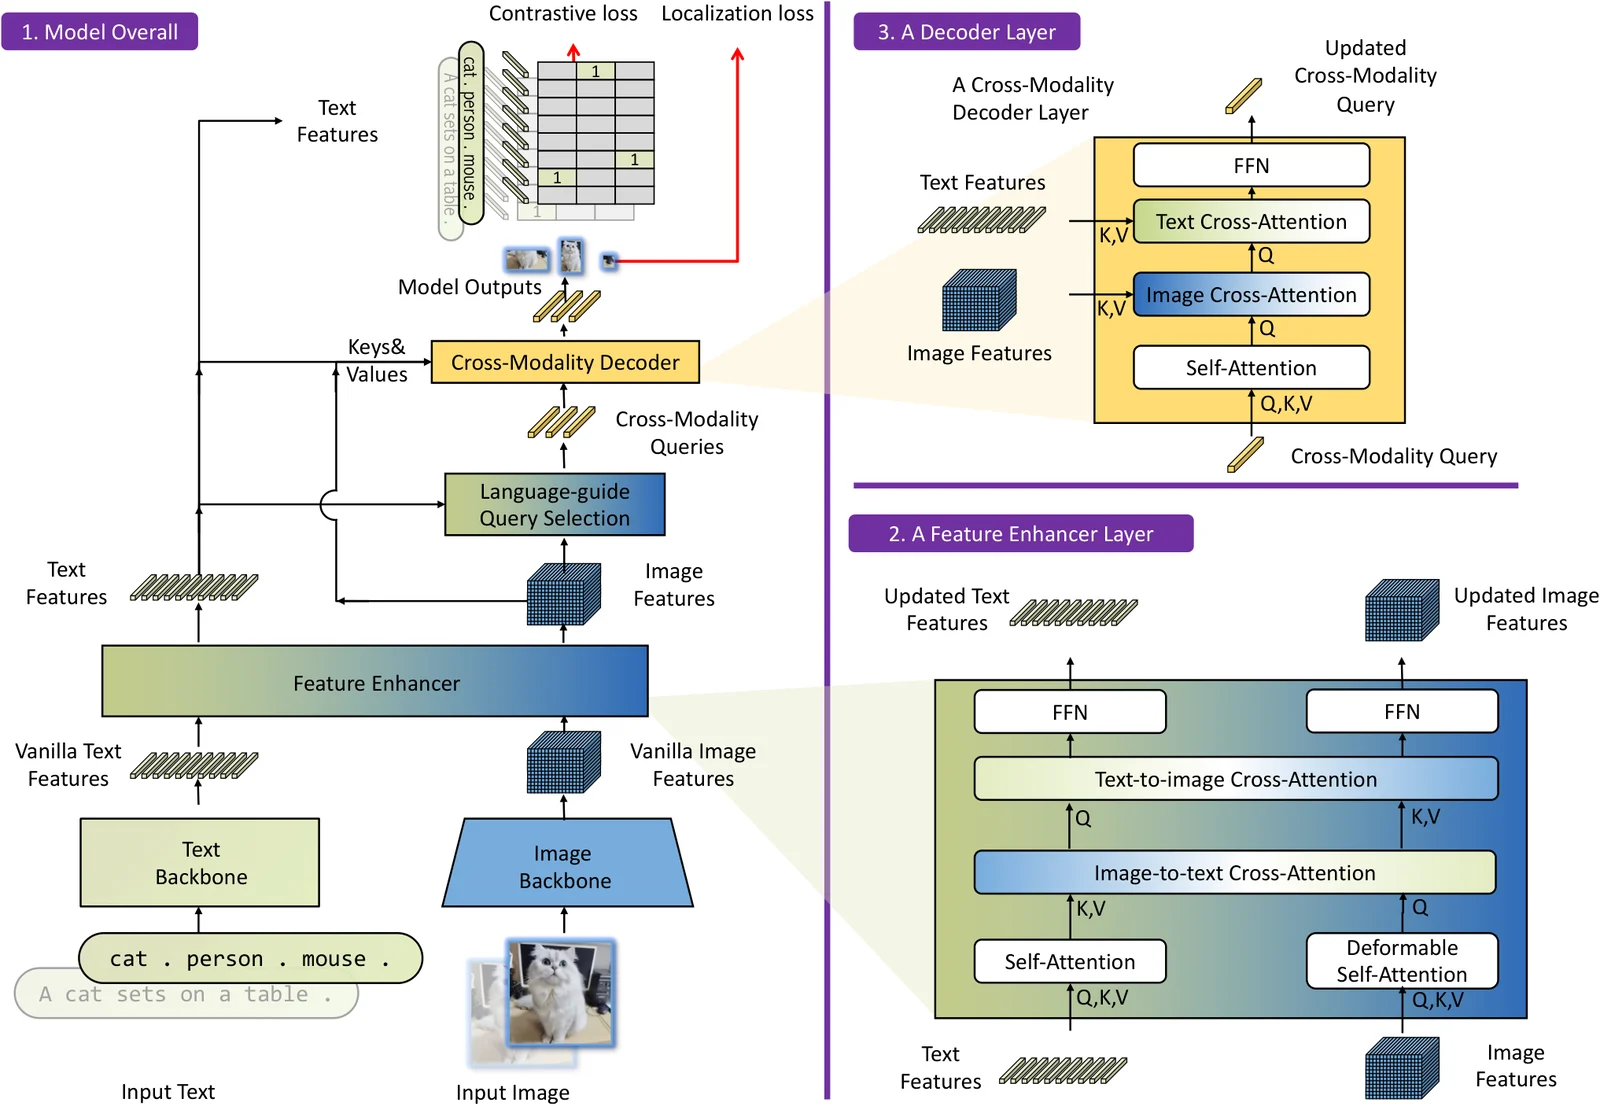
上图从上到下是数据流:文本与图像分别经骨干编码,进入跨模态增强器;增强后的特征一路进入解码器作为 key/value,另一路被用于挑选查询;解码器每层计算跨模态查询、图像交叉注意力与文本交叉注意力,最后输出框与词元级得分。
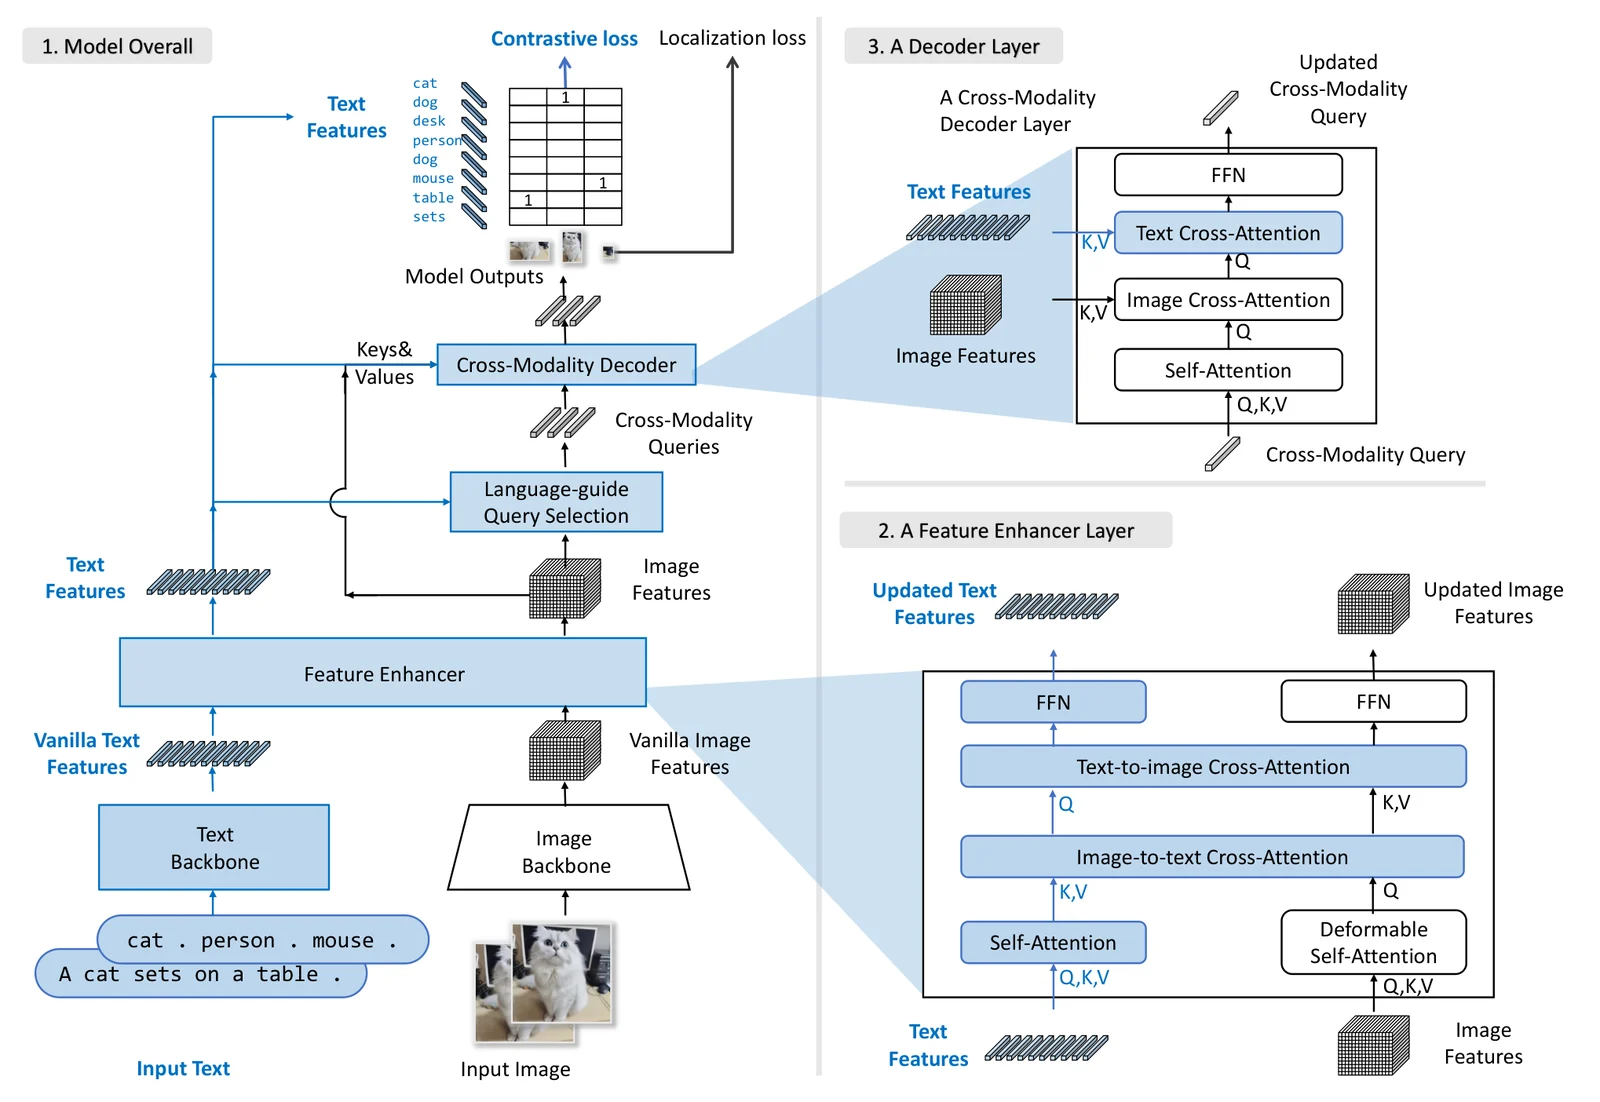
这张对比图把「改造发生在哪」标得很清楚。左侧是 DINO 的结构:骨干、特征增强(只有图像自注意力与图像交叉注意力)、查询选择、解码器。右侧是 Grounding DINO:增强层里多出文本到图像与图像到文本两条交叉注意力;解码层里多出文本交叉注意力,并且分类被替换成「查询与词元的对比损失」。两张图并排看,能直观看出 Grounding DINO 不是在 DINO 外面套一个文本编码器,而是把文本插进了 DINO 原有的每一个计算阶段。
语言引导的查询选择
设增强后的图像特征为 ,文本特征为 。在 Grounding DINO 的典型配置里,, 超过一万(多尺度特征图展开后的 token 数), 小于 256(文本长度上限)。查询选择的公式是
表示沿文本维度取最大值:对每个图像 token,找它与全部文本词元中最相似的那一个,得到一个 维的向量; 取这个向量最大的 个索引; 就是被选中的图像 token 索引集合。取最大值而不是平均值,是因为一个图像 token 只需要与文本中的某一个概念相关;取平均会把多个不相关概念混在一起,稀释信号。
被选中的索引只用于初始化查询的位置部分,而不是内容部分。Grounding DINO 沿用 DINO 的混合查询选择:每个解码查询由内容(content)与位置(positional)两部分组成,位置部分是动态锚框,由被选中图像 token 的编码器输出初始化;内容部分仍是训练得到的可学习嵌入。这个拆分是刻意的——如果内容也直接取自图像 token,查询就丢掉了跨图像样本共享的物体级语义;如果位置也完全可学习,查询就无法对准当前文本提到的区域。两者各取一半,既有位置先验,又保留内容的学习能力。
与 DETR 的纯可学习查询相比,这里多了一个先验:查询的锚框从「文本最可能指的区域」出发。它在开放词表下尤其重要——可学习锚框是在训练类目上收敛的,遇到训练时没见过的查询词,锚框的初始化没有语义依据;语言引导的初始化则跟随当前文本变化。
跨模态解码器与子句级文本表示
解码器的每一层在标准 DETR 解码器的基础上加了一条文本交叉注意力。设第 层查询为 ,则一层的计算顺序大致是
其中三条注意力的 key/value 分别是查询自身、增强后的图像特征、文本特征。图像交叉注意力让查询定位,文本交叉注意力让查询对齐语义。两条注意力都用残差连接,保证即使某一模态的信息在某层不可用,查询也不会被破坏。
文本侧还有一个容易被忽略但影响很大的设计:子句级表示(sub-sentence level representation)。类目名拼接成一句时,句子里的词元会通过 BERT 的自注意力互相影响。比如「cat. dog. person.」这句话里,「dog」的词元会读到「cat」的上下文,如果两个类目在语义上接近(「cat」与「dog」都是宠物),它们的表示会互相污染,导致区域对两个类目的分数都偏高。Grounding DINO 在文本自注意力里加了一个掩码矩阵 :
掩码加在自注意力的 logits 上, 经过 softmax 后权重为 0。判断「同一子句」的依据是标点——Grounding DINO 要求用「.」分隔类目名,模型据此把文本切成子句。这样每个类目的词元只在自身子句内做注意力,表示不受其他类目影响。代价是文本内部的跨类目推理能力被削弱(比如「不是狗而是猫」这类比较关系无法建模),但对「一串独立类目名」这种最常见的用法,收益远大于代价。
损失:分类变成词元级对比
Grounding DINO 的分类不再是一个固定类别的 softmax,而是查询与文本词元的点积。对每个查询 ,计算它与全部文本词元的相似度 ,每个 经过 sigmoid 后作为「第 个框是否对应第 个词元」的概率,再用焦点损失监督。目标标签由匹配结果决定:一个查询匹配到某个真值框后,该真值对应的短语的所有词元置为正,其余词元(包括「.」等分隔符与 [NoObj])置为负。匹配代价由分类代价(负的相似度)与框代价(L1 + GIoU)组成,求解二分图匹配后计算最终损失,并在每个解码层加辅助损失,加速收敛。
用词元级对比替代固定类别 softmax,带来了两个直接后果。第一,类别数量在推理时可以任意变化:增加一个类目只是往文本里加一个子句,模型参数不变,输出维度随之变化。第二,框与词的对应关系是显式监督的:一个框不只学会「这是猫」,还学会「对应文本里 cat 这个词元」。这为「短语定位」这类需要输出文本片段的场景提供了接口——Grounding DINO 在 RefCOCO/+/g 上的指代检测就是直接复用这个能力。
结果与位置
Grounding DINO 的原始论文报告:在完全没有 COCO 训练数据的情况下,COCO minival 零样本 52.5 AP;ODinW 零样本基准 26.1 平均 AP,刷新了当时的记录;在 LVIS 零样本上也显著优于之前的开放集模型。把这三个数字放回本文的路线图里,它说明的是:把文本送进检测器的每一层,收益大于只在末端点积的简单结构,也大于只做一个融合层。代价是结构复杂度与推理开销——文本增强器与跨模态解码器都比纯 DETR 多出若干条注意力。
三条路线怎么选:推理成本账
把三种架构放在同一张表里,差异会集中在几个可量化的维度上。「文本进入位置」是最关键的一列,它决定其余所有性质。表中的数字都取自各论文的原始报告,口径已在上一节分别交代:GLIP 的 49.8 是 COCO 零样本 AP;OWL-ViT 的 31.2 是 LVIS 稀有类零样本 AP_rare;Grounding DINO 的 52.5 是 COCO minival 零样本 AP、26.1 是 ODinW 零样本平均 AP。三者不可直接横比,只能各自与同口径的方法对照。
| 维度 | GLIP(对齐式) | OWL-ViT(双分支) | Grounding DINO(深度融合) |
|---|---|---|---|
| 文本进入位置 | 颈部融合 + 末端点积 | 末端点积(分类头) | 特征增强 + 查询选择 + 解码器逐层 |
| 视觉主干 | Swin-T/L + DyHead | ViT-B/L(含混合前端) | Swin-T/L |
| 区域表示粒度 | 多尺度特征图位置 | patch token | 多尺度 token |
| 框从哪来 | 特征图位置的框预测 + NMS | token 框预测 + NMS | 900 查询 + 集合预测,无 NMS |
| 类别数变化 | 文本长度变化,权重不变 | 文本长度变化,权重不变 | 文本长度变化,查询数不变 |
| 训练数据依赖 | 大规模定位数据预训练 | 图文对比预训练 + 检测微调 | 检测 + 定位数据联合预训练 |
| 典型零样本指标 | COCO 49.8 / LVIS 26.9 AP | LVIS 31.2 AP_rare | COCO 52.5 / ODinW 26.1 AP |
成本结构需要分三段算。图像段是绝对大头:无论哪条路线,视觉主干都要在高分辨率上跑一次。开放词表检测的输入分辨率普遍比分类高,因为小物体需要更多像素;ViT 的注意力成本随 patch 数平方增长,Swin 的窗口注意力随分辨率线性增长,这个差别在 1024 以上的输入上非常明显。文本段成本很低:文本长度通常在 256 个词元以内,BERT-base 量级的编码器在 GPU 上的耗时是毫秒级;但如果每次请求都重新编码同一批类目名,这部分会被放大,工程上通常缓存文本嵌入(按类目列表的哈希做 key)。交互段的差别最大:GLIP 的融合层在颈部, 的注意力里 是颈部特征图位置数,量级在万级;Grounding DINO 的增强器作用在同样的多尺度特征上,且每个解码层多一条文本交叉注意力;OWL-ViT 的交互只是一次 的矩阵乘法, 是查询数,通常只有几十到几百。
还有一项常被忽略的成本:NMS。GLIP 与 OWL-ViT 都保留了 NMS,NMS 的成本与候选框数量相关,在密集小物体场景下会上升,而且它的阈值是一个需要按场景调的启发式。Grounding DINO 继承了 DETR 的无 NMS 设计,输出直接是集合,省掉了这一步,但代价是 900 个查询的解码计算与匹配机制带来的训练复杂度。
具体选型可以按场景归纳。查询集合固定、延迟敏感、类目表经常变化但查询词简单(单词或短名词短语),OWL-ViT 式结构最划算:视觉编码一次,文本编码一次,剩下一次矩阵乘法。查询是复杂短语、需要属性绑定与组合推理(「左边那只叼着球的狗」),GLIP 或 Grounding DINO 的融合更可靠。需要指代检测与短语定位共用一套模型,Grounding DINO 的词元级监督是更自然的选择。数据规模是瓶颈、又不想改模型结构,OWLv2 式的自训练扩数据是成本最低的杠杆。
文本条件在工程上的四个细节
开放词表检测的论文通常把文本侧一笔带过,但实际部署时,文本的处理方式对结果的影响不小于架构选择。以下四点是从三条路线的实现里总结出来的共性问题。
提示词模板与类目名的区别。 把类目名直接送进文本编码器,与套一个模板再送进去,结果不同。CLIP 的零样本分类实验早就发现,模板「a photo of a {}」比裸类目名高若干个百分点,原因是预训练语料里的图文对大多以自然句出现,裸名词的分布与训练分布有偏移。OWL-ViT 的附录里给出了它的模板:「an image of a {}」,把类目名填进花括号。GLIP 与 Grounding DINO 则更接近裸类目名,用「.」连接,因为它们的训练数据本身就是这种形式,模板反而不匹配。模板必须与训练时的文本形式一致,这是选择模板的唯一原则;跨模型套用论文里的模板,收益可能变成损失。
分隔符不是随便选的。 Grounding DINO 要求用「.」分隔类目名,因为子句掩码靠标点切分。GLIP 同样用「.」连接,但它没有子句掩码,分隔符更多是让文本编码器知道短语边界。如果分隔符用错(比如用逗号或空格),Grounding DINO 的子句掩码会把整句当成一个子句,跨类目污染重新出现。这类错误在工程上很隐蔽:模型仍然输出框,只是分数分布变差,很难从日志里看出来。
类别数与查询数的关系。 Grounding DINO 的查询数固定为 900,与类别数无关;GLIP 与 OWL-ViT 的输出是「区域数 × 查询数」的矩阵。类别数从 10 涨到 1000 时,GLIP/OWL-ViT 的得分矩阵线性变大,但计算量增加很小(相对视觉主干);Grounding DINO 的查询数不变,类别数只影响文本长度与注意力里的 key/value 长度。真正的瓶颈在框的筛选:类别数多时,每个类别都可能产生若干候选,后处理的数量会膨胀,需要按分数阈值先过滤,否则 NMS 的输入会失控。
批处理与缓存。 多类别查询共享同一张图时,正确的做法是把文本编码器对全部类目跑一次,而不是每个类目跑一次;图像编码器只跑一次,得分矩阵一次算完。跨请求复用同一组类目时,文本嵌入可以缓存,key 用「模型版本 + 模板 + 类目列表」的哈希。缓存对延迟的影响很大:文本编码器虽然小,但在 CPU 上或小 batch 下,它的固定开销可能占到端到端延迟的两三成。
失效模式与评价口径
开放词表检测的能力边界,最好通过具体的失效模式来理解,而不是只看平均精度。
属性绑定失败。 「red car」这个查询里,颜色与物体是两个概念,区域与整段短语的点积要求模型把两者绑定在同一个区域上。双编码器的末端点积对绑定的建模最弱——它只能检查区域是否同时像「红」和「像车」,无法区分「红色的车」与「车旁边有个红色物体」。GLIP 与 Grounding DINO 的融合层缓解了这个问题,但没有根除。这类失效在商品检索、工业质检这类需要精确组合的场景里尤其突出。
计数与密集场景。 查询机制天生不擅长计数:一个查询输出一个框,两个同类物体需要两个查询都活下来。DETR 式模型用 900 个查询缓解,但密集小物体(货架商品、人群)下仍然容易漏检。GLIP 与 OWL-ViT 的密集框预测加 NMS 在密集场景下的召回更好,但重复框的风险更高。
小物体与分辨率。 开放词表模型的零样本能力在 800 像素输入上训练,部署时如果直接放大到 1536 像素,patch 分布与训练不一致,性能可能下降而非上升;正确做法是按训练分辨率或做多尺度测试。这一点常被忽略:检测的尺度敏感性比分类强得多,因为框的回归头学到的尺度先验与输入分辨率绑定。
提示词漂移与同义词。 「sofa」与「couch」在文本空间里接近但不相同,模型对前者的分数可能明显高于后者。工程上常见的补救是同义词扩展(把一组近义词都写进查询),代价是查询数增加、误检增加。这也是「开放词表」在真实系统里往往要配一层查询改写的原因。
评价口径。 开放词表检测最常用的指标是 LVIS 的 :LVIS 把类别按训练集出现次数分成 frequent、common、rare 三档,评测零样本能力时只看 rare 档,且训练时剔除这些类的标注。这个口径比 COCO 的总体 AP 更严格,因为它隔离了「模型是否真的靠语义泛化」。另一个常用口径是 ODinW(Object Detection in the Wild),它把 13 个不同领域的检测数据集放在一起,用零样本与少样本两种设置评测迁移能力。看论文数字时,必须同时看它用的是哪种口径:COCO 零样本 AP 高,不代表 LVIS 稀有类也好;LVIS 稀有类高,不代表跨域迁移好。这三件事分别考验语义泛化、类别长尾与域适应,是不同的能力。
小结
开放词表检测的核心变化只有一句话:把类别从权重矩阵的一行,变成模型输入里的一段文本。围绕这句话,三条基础路线给出了三种工程答案。
GLIP 从检测器出发,把检测改写成没有上下文的短语定位,用区域-短语对齐损失替换分类损失,再用跨模态注意力做深融合。它证明了「检测数据 + 定位数据」的联合预训练可以产生真正的开放词表能力,也给出了这条路线的基本配方:对齐损失、深融合、大规模定位数据,三者缺一不可。
OWL-ViT 从图文对齐模型出发,去掉池化、把分类头挂到每个 patch token、让文本嵌入直接充当分类器。它的价值在于把接口做得极简:查询可以是文本,也可以是图像,检测器不关心查询从哪来。OWLv2 沿着这条路线,用自训练把检测数据扩到与图文预训练同量级,说明接口正确时数据规模仍是主要杠杆。
Grounding DINO 把文本插进 DETR 式检测器的每一个阶段:特征增强器、语言引导的查询选择、跨模态解码器。它用词元级对比替代固定类别 softmax,用子句掩码隔离不同类目的文本表示,在零样本与指代检测上同时取得强结果。
三条路线共享同一个推理骨架:高分辨率的视觉编码是成本主体,文本编码是廉价但需要缓存的固定开销,交互段的成本由「文本在哪里与视觉相遇」决定。理解这个骨架,比记住任何一篇论文的具体结构更有用——新的开放词表模型几乎都是在这三个位置上做变体。
站内关于图文对齐的基础机制,可参考 CLIP 架构拆解:一段文字和一张图怎么被放进同一个空间;如果把「查询」看成一种提示接口,视觉基础模型的三种提示方式可参考 视觉基础模型的三种提示接口:SAM、SigLIP 与 Depth Anything。扩散模型中的条件注入(cross-attention、zero-conv)与本文的「文本如何进入视觉网络」是同一类问题的不同模态版本,可对照 扩散模型从零讲起(十五):可控生成 阅读。
参考资料
- Grounded Language-Image Pre-training(GLIP)
- Simple Open-Vocabulary Object Detection with Vision Transformers(OWL-ViT)
- Scaling Open-Vocabulary Object Detection(OWLv2)
- Grounding DINO: Marrying DINO with Grounded Pre-Training for Open-Set Object Detection
- End-to-End Object Detection with Transformers(DETR)
- Deformable DETR: Deformable Transformers for End-to-End Object Detection
- DINO: DETR with Improved DeNoising Anchor Boxes for End-to-End Object Detection
- RegionCLIP: Region-based Language-Image Pretraining
- Exploring Plain Vision Transformer Backbones for Object Detection(ViTDet)
- GLIP 官方代码仓库
- Grounding DINO 官方代码仓库
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



