


多模态大模型的四种融合机制:双塔对齐、投影连接、交叉注意力与统一词元
多模态大模型看起来都在做同一件事:把图像和文本放进一个模型里。但只要拆开计算图就会发现,四种主流做法在几乎每一个环节上都不同:图像在哪一层与文本相遇,相遇时用什么算子交换信息,交换后的表示留在哪个空间,最终又由谁输出结果。CLIP 让两个独立的塔在向量空间里对齐,LLaVA 把视觉特征投影成若干 token 塞进语言模型,Flamingo 让语言模型在每一层用交叉注意力去查询视觉特征,Chameleon 则干脆把图像也离散成 token,让一套 Transformer 从头到尾只处理一种序列。
这篇文章沿着一条主线讲:同一张输入图像,分别经过这四种机制处理后,信息流怎么走、计算步骤有哪些、结果是什么形态。为了让机制之间的差异可比较,先建立一套统一的观察框架,再逐个拆解,最后把四条路径放在同一张账本上对照。
先建立比较框架:融合发生在哪一层
多模态融合的三个坐标
讨论融合机制时,容易被“早期融合/晚期融合”这类标签带偏。更有解释力的做法是问三个具体问题。
第一,模态在哪一层相遇。 是在独立的编码器输出之后才相遇,还是在 Transformer 的中间层相遇,还是从一开始就在同一个 token 序列里。相遇层越浅,跨模态交互越充分,但模型对模态差异的建模负担也越大;相遇层越深,各模态可以先用自己的归纳偏置处理,但交互带宽有限。
第二,相遇时用什么算子。 对比学习用的是向量相似度,投影连接用的是拼接加自注意力,交叉注意力用的是跨序列的 Query-Key-Value 查询,统一词元用的是同一个自注意力矩阵。算子的选择直接决定了计算复杂度和可解释性。
第三,融合后的表示属于谁。 CLIP 产出的是两个独立向量,谁也不属于谁;LLaVA 把视觉特征变成语言模型输入序列的一部分,表示的所有权交给语言模型;Flamingo 把视觉特征保留在旁路,语言模型的文本流不被改写;Chameleon 让视觉 token 和文本 token 完全同权,输出可以继续是任一模态。
这三个坐标组合起来,就是四种机制的本质差异。后文的每一节都会反复回到这三个问题。
四种机制的一句话画像
- CLIP(Contrastive Language-Image Pre-training,2021):双塔分别编码图像和文本,用对比损失把匹配的图文对拉近、把不匹配的推远。融合只发生在最后的向量空间,模型本身不生成任何文本。
- LLaVA(Large Language-and-Vision Assistant,2023):视觉编码器输出 patch 特征,经投影层映射到语言模型的词嵌入空间,作为“视觉 token”拼在文本 token 前面,交给 LLM 做自回归生成。融合发生在 LLM 的输入层。
- Flamingo(2022):冻结的视觉编码器加 Perceiver Resampler 把变长视觉输入压成固定数量的视觉 token;在冻结 LLM 的若干层之间插入门控交叉注意力,让文本 token 主动查询视觉 token。融合发生在 LLM 的多个中间层,但文本流本身不被修改。
- Chameleon(2024):用 VQ tokenizer 把图像离散成视觉 token,与文本 token 共享词表和 Transformer,从第一层开始就是一条混合序列。融合发生在最底层,模型可以生成文本,也可以生成图像 token 再解码成图。
这四种机制正好覆盖了“融合深度”从浅到深的四个档位。接下来逐一看它们的计算图。
CLIP:双塔对齐,把“匹配”变成一个向量内积
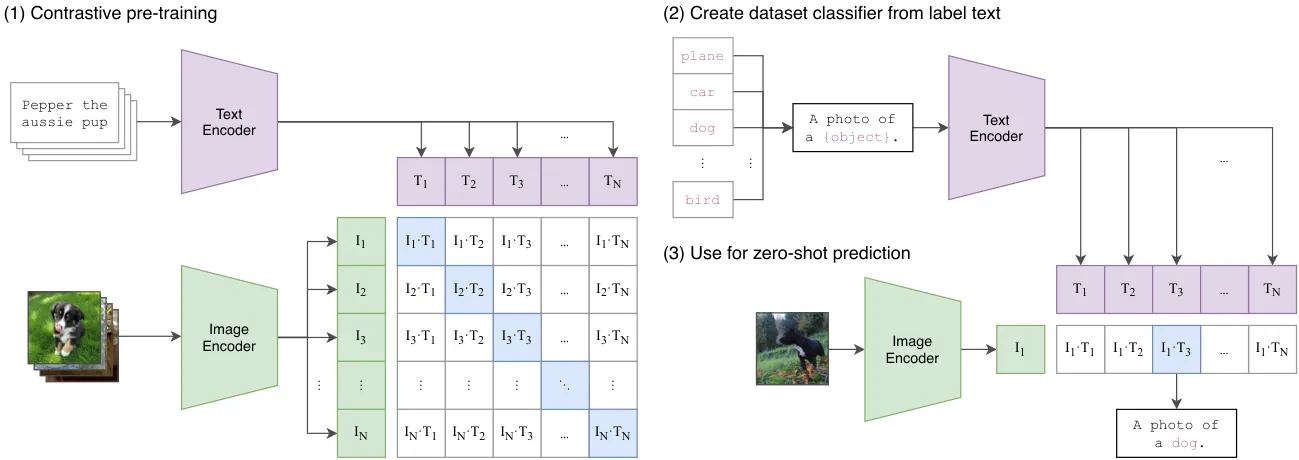
背景:为什么需要双塔
在 CLIP 之前,视觉模型通常是单塔的:一张图进一个 CNN,输出固定类别的 logits。这样的模型被锁在预定义类别上,换一个数据集就要重新训练分类头。要让它理解开放词汇的文本描述,需要一种不依赖固定类别的监督信号。
CLIP 的出发点是把“图像-文本对”本身当作监督。互联网上有大量图文对,虽然噪声很大,但规模足以覆盖开放词汇。问题变成:如何从这种弱监督里学到一个可迁移的表示。对比学习给出了答案:不需要逐对生成描述,只需要判断哪一个文本和哪一个图像匹配。
双塔结构的信息流
CLIP 有两个完全独立的编码器。图像塔通常是 ResNet 或 ViT,输出一个图像向量;文本塔是一个 Transformer,输出一个文本向量。两塔之间没有任何跨模态层,参数不共享,计算也不交互。这是理解 CLIP 的关键:它不是一个“多模态模型”,而是两个单模态模型被一个对比目标绑在一起。
设一个 batch 有 个图文对。图像塔把每张图编码成 ,文本塔把每段文本编码成 。两个向量都做 L2 归一化,然后计算 的相似度矩阵:
其中 是可学习的温度倒数,控制 softmax 的尖锐程度。矩阵的第 行是“第 张图与所有文本的相似度”,第 列是“第 段文本与所有图像的相似度”。
CLIP 的损失是对称的 InfoNCE:行方向做一次交叉熵,把第 个文本当作第 张图的正样本;列方向再做一次,把第 张图当作第 段文本的正样本。两个方向取平均。这样做的原因是:如果只做一个方向,模型可能只学会“图找文”或“文找图”,另一个方向的表示空间不会被约束。对称损失迫使两个方向都成立,等价于要求相似度矩阵的对角线同时是行最大值和列最大值。
为什么温度要可学习
温度 决定 softmax 的分布形状。 太大,所有负样本的权重接近,梯度信号被稀释; 太小,模型只关注最难的负样本,容易不稳定。不同规模的 batch、不同噪声水平的数据集需要不同的尖锐度。CLIP 把 作为可学习参数,并在这个参数上做裁剪,防止它跑到极端值。工程上这相当于让模型自己决定“对比的难度”。
计算步骤拆解
一次 CLIP 前向的计算步骤可以写成:
- 图像预处理:缩放、裁剪到固定分辨率,归一化。
- 图像塔前向:ViT 把图像切成 patch,过若干层自注意力,取 [CLS] token 或池化后的向量。
- 文本预处理:分词、加起始和结束 token、截断到固定长度。
- 文本塔前向:Transformer 编码,取结束 token 位置的隐藏状态。
- 两个向量分别 L2 归一化。
- 计算 相似度矩阵,乘温度。
- 行、列两个方向分别计算交叉熵,取平均,反向传播。
注意第 5 步之后没有“融合层”。两个模态的信息只在相似度矩阵里发生交互,而这个矩阵只用于算损失。推理时,CLIP 甚至不需要同时跑两个塔:可以先把所有文本编码成向量存起来,再逐张图编码、算内积、排序。这就是双塔的工程价值——图像和文本可以离线分离编码。
结果是什么形态
CLIP 的输出是一个 维向量。对于零样本分类,把类别名写成提示模板(如 “a photo of a {class}”),编码成文本向量,与图像向量算余弦相似度,取最高分。对于检索,预先编码一个文本库,图像进来后做最近邻搜索。
这个结果形态决定了 CLIP 的能力边界:它擅长判断“整体语义是否匹配”,不擅长细粒度空间关系、计数、文字识别。因为双塔在编码时看不到对方,图像塔不知道要回答什么问题,文本塔也不知道图里有什么。所有跨模态信息都被压缩进一个向量,细粒度信息在池化时丢失了。
双塔的局限与它仍然重要的原因
CLIP 不能生成文本,不能做视觉问答,不能处理交错的多图输入。但它仍然是今天大多数多模态大模型的第一块积木:LLaVA 的视觉编码器通常就是 CLIP 的 ViT,Flamingo 的视觉编码器也来自类似的对比预训练模型。原因是 CLIP 的视觉表示已经具备很强的开放语义对齐能力,后续机制只需要在这个表示上做“翻译”或“查询”,不需要从零学习视觉语义。
LLaVA:投影连接,把视觉特征翻译成语言模型的输入
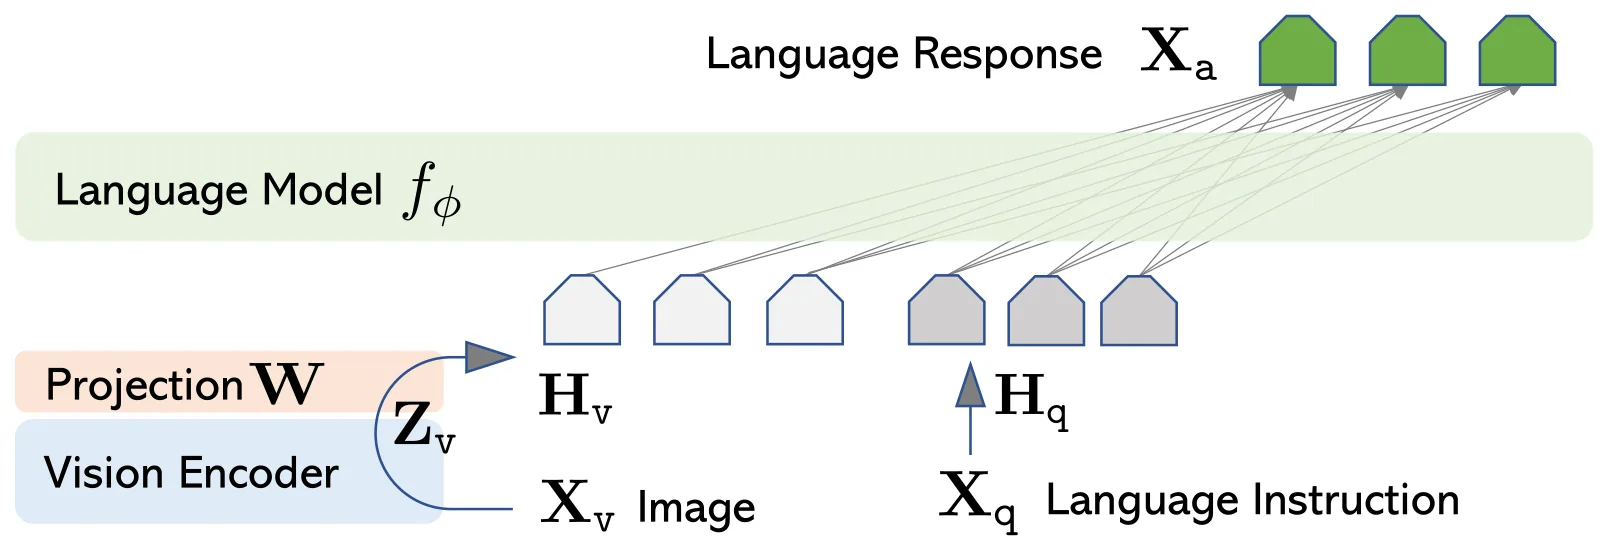
核心思想:视觉 token 化
LLaVA 的做法非常直接:既然语言模型只接受 token 序列,那就把图像也变成一串 token。视觉编码器先输出 patch 特征,投影层把每个 patch 特征映射到语言模型的词嵌入维度,于是图像变成 个“视觉 token”,和文本 token 拼成一条序列,交给 LLM。
这条路径的信息流是单向的:图像 → 视觉编码器 → 投影层 → 视觉 token → 与文本 token 拼接 → LLM 自回归生成。视觉信息在进入 LLM 之前就已经被压成固定数量的 token,之后完全由 LLM 的自注意力机制决定如何使用它们。
投影层到底在做什么
设视觉编码器输出 ,语言模型的词嵌入维度是 。投影层是一个可学习映射 ,把 变成 :
最简单的 是一个线性矩阵。LLaVA 的消融实验比较了线性投影和两层 MLP,发现 MLP 在多数视觉问答基准上更好。直觉是:线性映射只能做全局的线性变换,而 MLP 可以学习非线性的通道组合,把视觉特征中与语言语义相关的维度重新加权。这个差异在需要细粒度属性判断的任务上更明显。
投影层的参数量很小,但它承担了一个关键职责:把视觉特征空间对齐到语言模型的输入分布。如果投影后的向量与词嵌入的尺度、方向差异太大,LLM 会把视觉 token 当成噪声。LLaVA 的两阶段训练就是为这件事服务的。
两阶段训练:先对齐,再指令微调
LLaVA 的训练分两步。
第一阶段是特征对齐。冻结视觉编码器和 LLM,只训练投影层。数据是图文对,目标是让模型根据图像生成对应的描述。这一阶段本质上是在学“视觉特征到语言 token 的翻译词典”,参数量小,训练快。
第二阶段是端到端指令微调。仍然冻结视觉编码器,但解冻 LLM 和投影层,用视觉指令数据训练。数据包括对话、详细描述、复杂推理三类。这一阶段让 LLM 学会把视觉 token 当作上下文来回答问题,而不是只会复述图像内容。
这个两阶段设计的原因是:如果直接从指令数据开始训练,投影层还没对齐,LLM 收到的视觉 token 没有意义,梯度会把 LLM 拉向一个糟糕的局部最优。先对齐再微调,等于先保证输入可读,再教模型怎么用。
计算步骤拆解
一次 LLaVA 前向的步骤:
- 图像预处理,送入视觉编码器(通常是 CLIP ViT)。
- 取视觉编码器的 patch 特征,去掉 [CLS],得到 个 patch 向量。
- 投影层把每个 patch 向量映射到 维。
- 文本分词,得到 个文本 token 的嵌入。
- 把视觉 token 和文本 token 拼接。拼接位置通常在文本开头,或者放在对话中图像出现的位置。
- LLM 对整条序列做自注意力。视觉 token 和文本 token 在同一组注意力矩阵里互相可见。
- 自回归采样,生成回答 token。
第 6 步是 LLaVA 与 CLIP 的本质区别:视觉 token 不是旁路信息,而是输入序列的一部分。LLM 的每一层自注意力都可以让文本 token attend 到视觉 token,也可以让视觉 token attend 到文本 token。融合发生在 LLM 的所有层,但入口只有一个。
结果形态与工程含义
LLaVA 的输出是文本 token 序列。模型不会生成图像,也不会输出视觉向量。它的能力来自 LLM 的语言先验:视觉 token 提供了“看到了什么”,LLM 提供了“怎么用语言组织和推理”。
工程上,LLaVA 式架构对推理系统最友好。视觉编码器可以单独跑,投影层是一个小矩阵乘,之后就是标准的 LLM 前向。推理框架只需要支持“在输入序列的指定位置插入一段 embedding”,不需要改 Transformer 结构。今天 vLLM、SGLang、TensorRT-LLM 的多模态输入链路,处理的正是这类“placeholder token + embedding 回填”的模式:文本里先放占位 token,视觉编码器算完后把对应位置的词嵌入替换成视觉特征。
代价是视觉 token 会占用上下文长度。一张图切成几百个 patch,就相当于几百个 token 的预算。高分辨率图像需要切块、池化或 token 压缩,否则上下文会被图像吃满。
Flamingo:交叉注意力,让语言模型逐层查询视觉旁路
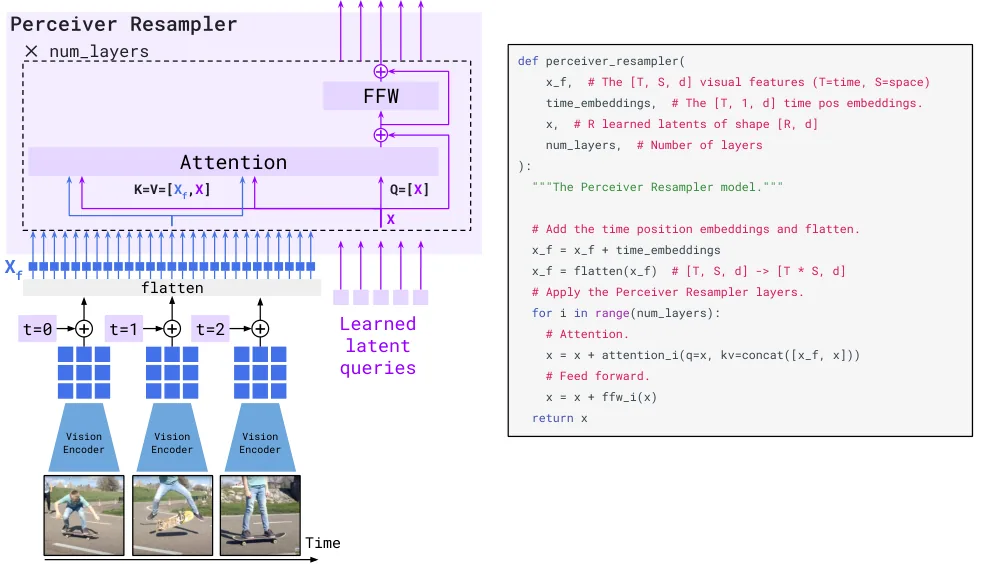
为什么不是所有模型都适合投影连接
LLaVA 式投影连接要求语言模型接受任意长度的视觉 token 前缀。对于已经训练好的纯文本 LLM,这意味着输入分布发生改变:序列里突然出现几百个不属于词表的向量。指令微调可以缓解这个问题,但需要更新 LLM 参数。
Flamingo 的目标不同:它要在一个冻结的 LLM 上加入视觉能力,同时支持交错的多图输入和少样本学习。冻结 LLM 意味着不能靠微调改变它的输入分布,也不能改变它的自注意力结构。于是 Flamingo 选择把视觉信息放在旁路,用新插入的交叉注意力层去读取。
Perceiver Resampler:把变长视觉输入压成固定数量 token
Flamingo 的视觉编码器输出的是变长 patch 特征。不同图像、不同数量、不同分辨率,直接送进交叉注意力会让计算量随图像数量增长。Flamingo 先用 Perceiver Resampler 把任意数量的视觉特征压成固定 个视觉 token。
Resampler 本身是一组可学习的 latent query。它用交叉注意力让这些 query 去读取视觉特征:
其中 是可学习 query, 是视觉编码器输出。输出 就是固定长度的视觉表示。无论输入多少张图、多少 patch,输出都是 个 token。这一步把“视觉输入长度”从计算图里消掉了,后续交叉注意力的成本只与 和文本长度有关。
门控交叉注意力层
Flamingo 在冻结 LLM 的若干层之间插入新的交叉注意力层。文本 token 作为 Query,Resampler 输出的视觉 token 作为 Key 和 Value:
其中 是当前层的文本隐藏状态。为了让新插入的层不破坏冻结 LLM 的原始行为,Flamingo 在交叉注意力的输出上加了一个门控:
初始化为 0,所以训练开始时交叉注意力对 LLM 没有任何影响;随着训练进行,模型逐渐打开门控。这个设计让新增模块以“增量”的方式接入,而不是从第一步就扰动冻结模型。
masked cross-attention:交错图文的关键
Flamingo 支持交错的多图输入,例如“图 A 文本 图 B 文本”。如果文本 token 可以无条件 attend 到所有图像,就会出现信息泄漏:回答“图 A 里是什么”时看到了图 B。Flamingo 用 masked cross-attention 解决:每个文本 token 只能 attend 到它之前出现的图像。
具体做法是构造一个注意力掩码,按图像在序列中的位置划分可见区间。文本 token 的位置决定了它能看见哪些图像 token。这个掩码在训练和推理时都生效,是 Flamingo 能处理交错输入的基础。
计算步骤拆解
一次 Flamingo 前向:
- 对每张图像跑冻结的视觉编码器,得到 patch 特征。
- Perceiver Resampler 把每张图的特征压成 个视觉 token。
- 文本 token 过冻结 LLM 的前若干层。
- 在插入交叉注意力的层,文本隐藏状态作为 Query,视觉 token 作为 Key/Value,计算交叉注意力,门控后加回文本流。
- 继续过后续 LLM 层,重复第 4 步。
- 最终输出文本 token。
注意视觉 token 从不进入文本序列。文本流始终是纯文本 token,视觉信息只在交叉注意力层被“查询”。这意味着冻结 LLM 的词嵌入、自注意力、前馈网络都不需要改变,新增的参数只有 Resampler 和交叉注意力层。
结果形态与代价
Flamingo 的输出仍然是文本。它的优势是少样本能力:给定几张示例图文对,模型可以在不更新参数的情况下完成新任务。这来自交叉注意力的查询机制——示例图像作为视觉上下文留在旁路,文本 token 按需读取。
代价是架构改动。推理系统不能只做“embedding 回填”,而要在 LLM 的指定层插入额外的交叉注意力计算。视觉 token 需要单独缓存,交叉注意力的 Key/Value 也要管理。对于已经高度优化的 LLM 推理内核,这意味着额外的 kernel 和额外的显存。Flamingo 的原始实现面向研究,工程部署不如 LLaVA 式直接。
Chameleon:统一词元,从第一层就是一条混合序列
核心思想:把图像也离散化
前面三种机制都保留了“视觉表示”和“文本表示”的区分:CLIP 是两个向量,LLaVA 是投影后的视觉 token,Flamingo 是旁路视觉 token。Chameleon 取消了这个区分:用 VQ tokenizer 把图像量化成离散 token,视觉 token 和文本 token 共享同一个词表、同一个 Transformer、同一个输出头。
一张图像经过 VQ encoder 变成 个离散码,每个码对应词表里的一个 visual token。文本照常分词。两者拼成一条序列,从第一层开始就一起过自注意力。模型输出时,如果预测的是文本 token,就解码成文字;如果预测的是视觉 token,就交给 VQ decoder 还原成图像。
VQ tokenizer 的角色
VQ tokenizer 是一个独立的图像压缩模型。它把图像编码成连续特征,然后在码本里找最近的码字,得到离散索引。码本大小通常几千到几万。索引直接映射到 Chameleon 词表里的一段保留区间。
这一步的信息损失是明显的:连续视觉特征被压成离散码,细节、纹理、文字都可能丢失。但换来的收益是:图像和文本在表示层面完全同构。Transformer 不需要知道哪个 token 是图像、哪个是文本,它只处理一条离散序列。
早融合的计算图
Chameleon 的前向步骤:
- 图像过 VQ encoder,得到离散视觉 token 序列。
- 文本分词,得到文本 token 序列。
- 按交错顺序拼接成一条序列。
- 整条序列过同一个 Transformer,每一层自注意力对视觉和文本 token 一视同仁。
- 输出头在共享词表上预测下一个 token。
- 如果是文本 token,走文本解码;如果是视觉 token,累积到一定数量后交给 VQ decoder 生成图像。
第 4 步是四种机制里融合最彻底的一步:没有旁路,没有投影,没有额外的交叉注意力。视觉 token 和文本 token 在同一个注意力矩阵里,信息流完全对称。
早融合的代价:训练稳定性与模态竞争
统一词元看起来最美,但训练难度最高。Chameleon 论文报告了两个核心问题。
第一是训练不稳定。混合序列的 logits 尺度在不同模态间差异很大,视觉 token 的预测分布和文本 token 的预测分布互相干扰。Chameleon 用 QK-Norm 约束注意力 logits 的范数,并在输出层做归一化,才让训练稳定下来。
第二是模态竞争。共享参数意味着视觉和文本要争夺模型容量。如果文本数据远多于视觉数据,模型会偏向文本,视觉生成质量下降;反之亦然。Chameleon 需要精心配比数据,并采用分阶段训练。
这两个问题解释了为什么统一词元架构出现得比投影连接晚:它不是“更简单的架构”,而是“更激进的架构”,工程门槛更高。
结果形态
Chameleon 的输出可以是文本,也可以是图像 token 序列。它是四种机制里唯一原生支持图像生成的。但对于纯文本问答,它的表现不一定优于 LLaVA 式投影连接,因为离散化损失了视觉细节,且共享参数让语言能力被视觉任务分摊。
把四条路径放到同一张账本上
信息流对照
| 维度 | CLIP 双塔 | LLaVA 投影 | Flamingo 交叉注意力 | Chameleon 统一词元 |
|---|---|---|---|---|
| 模态相遇层 | 编码器输出后的向量空间 | LLM 输入层 | LLM 多个中间层 | Transformer 第一层 |
| 交互算子 | 余弦相似度 | 拼接 + 自注意力 | 门控交叉注意力 | 共享自注意力 |
| 视觉表示 | 独立图像向量 | 投影后的视觉 token | Resampler 压缩的旁路 token | 离散视觉 token |
| 文本流是否被改写 | 否 | 是,序列变长 | 否,旁路注入 | 是,序列混合 |
| 是否修改 LLM 结构 | 不涉及 LLM | 否 | 是,插入交叉注意力层 | 是,共享词表与输出头 |
| 输出形态 | 向量 | 文本 | 文本 | 文本或图像 |
| 典型训练目标 | 对比损失 | 下一 token 预测 | 下一 token 预测 | 下一 token 预测 |
| 视觉 token 进入 KV Cache | 不适用 | 是 | 否,单独缓存 | 是 |
这张表里最容易被忽略的是最后一行。它决定了推理系统的内存账本:LLaVA 和 Chameleon 的视觉 token 会进入 LLM 的 KV Cache,图像越多、分辨率越高,KV 占用越大;Flamingo 的视觉 token 留在旁路,不进入文本 KV,但交叉注意力有自己的 Key/Value 缓存。CLIP 不涉及生成,自然没有 KV Cache。
同一张图,四种结果
假设输入是一张“桌上有一杯咖啡和一台笔记本电脑”的照片,问题是“杯子在电脑的左边还是右边”。
CLIP 会把整张图压成一个向量,与“杯子在电脑左边”“杯子在电脑右边”两段文本分别算相似度。它能判断哪段描述整体更匹配,但无法确认空间关系,因为空间信息在池化时已经丢失。输出是一个分数,不是答案。
LLaVA 把图像切成 patch,投影成视觉 token,与问题拼接后交给 LLM。LLM 的自注意力可以让“左边”这个词 attend 到图像左侧的 patch,也可以让“杯子” attend 到杯子的 patch。输出是一句自然语言答案。信息流是“视觉 token 作为上下文,语言模型做推理”。
Flamingo 先用 Resampler 把图像压成固定数量 token,然后在 LLM 的交叉注意力层里让问题 token 查询这些视觉 token。输出也是文本。区别在于视觉信息不占用文本序列长度,且模型可以在交叉注意力里选择性地读取与“杯子”“电脑”相关的视觉 token。
Chameleon 把图像离散成 token,与问题拼成一条序列。模型在共享注意力里同时处理视觉和文本 token,输出文本答案。它的信息流与 LLaVA 最接近,但视觉 token 是离散的,且与文本共享全部参数。
训练成本与数据需求
CLIP 需要大规模图文对,但不需要指令数据。它的训练是对比学习,负样本来自 batch 内其他样本,数据效率较高。
LLaVA 需要两阶段数据:第一阶段图文对做对齐,第二阶段视觉指令数据。第二阶段的数据质量决定模型能力,数据量通常比 CLIP 小几个数量级。
Flamingo 需要交错图文数据和大量图文对,训练时要同时优化 Resampler 和交叉注意力层。冻结 LLM 降低了计算量,但交错数据的构造成本高。
Chameleon 需要图文交错数据、纯文本数据、图像生成数据,还要处理模态配比和训练稳定性。它的数据工程最复杂。
推理成本
CLIP 的推理成本最低:两个塔可以分离,图像塔只跑一次,文本塔可以离线预计算。检索场景下,文本库编码一次,之后每张图只跑图像塔。
LLaVA 的成本是视觉编码器加 LLM 前向。视觉 token 增加序列长度,prefill 成本随图像 token 数增长;decode 阶段视觉 token 的 KV 常驻显存。
Flamingo 的成本是视觉编码器加 Resampler 加交叉注意力。交叉注意力在每个插入层都要算,成本与文本长度和视觉 token 数成正比。视觉 token 不进入文本 KV,但交叉注意力的 KV 需要单独管理。
Chameleon 的成本与 LLaVA 类似,但视觉 token 是离散的,词表更大,输出头计算量更高;如果生成图像,还要跑 VQ decoder。
工程落地:四种机制在推理系统里的不同形状
CLIP 式双塔:检索服务
CLIP 的工程形态是向量检索,不是生成服务。典型链路是:离线把所有文本或图像编码成向量,建 ANN 索引;在线只跑一个塔,算内积,取 Top-K。它不需要 KV Cache,不需要调度器,不需要连续批处理。真正的挑战在索引规模、量化压缩和召回率。
LLaVA 式投影:placeholder 与 embedding 回填
LLaVA 式架构是今天推理框架支持最完善的多模态形态。以 vLLM 为例,输入侧把图像替换成占位 token,调度器为占位 token 分配位置;模型执行前,视觉编码器算出 patch 特征,投影层映射到词嵌入维度,再按 placeholder range 回填到输入 embedding 的对应行。之后就是标准 LLM 前向。
这条链路的工程要点有三个。第一,视觉 token 的数量必须在调度前确定,否则无法做 KV 预算。第二,视觉编码器可以独立批处理,也可以和 LLM 分离部署(编码器分离),避免视觉计算阻塞解码。第三,前缀缓存要把图像内容纳入哈希,否则相同图像的不同请求无法复用 KV。
Flamingo 式交叉注意力:旁路缓存与层插入
Flamingo 式架构对推理框架的改动最大。Transformer 层不再是同构的:某些层多了一个交叉注意力子层。视觉 token 需要单独缓存,交叉注意力的 Key/Value 也要按请求管理。连续批处理时,不同请求的视觉 token 数量可能不同,交叉注意力的批处理需要额外的掩码和索引。
这也是为什么生产系统里很少直接部署 Flamingo 式架构:它的研究价值在于少样本和交错输入,工程上不如投影连接直接。但它的思想——用旁路交叉注意力注入视觉信息——影响了后来很多模型,尤其是需要保留冻结语言模型能力的场景。
Chameleon 式统一词元:共享词表与多模态采样
Chameleon 式架构的工程形态接近标准 LLM,但有两个额外问题。第一,词表包含视觉 token,采样时需要区分模态:文本 token 走文本 detokenizer,视觉 token 累积到 VQ decoder。第二,图像生成是自回归的,视觉 token 的序列长度可能很长,KV Cache 压力大。
在服务系统里,Chameleon 式模型的调度与 LLM 类似,但输出侧需要多模态后处理。如果只做文本问答,它和 LLaVA 式没有本质区别;如果要生成图像,就需要把视觉 token 流从文本流里分离出来,交给独立的解码器。
选择哪一种:由任务和信息流决定
四种机制不是替代关系,而是四个不同的设计点。
如果任务是检索、零样本分类、图文匹配,CLIP 式双塔最合适。它的表示可以离线预计算,工程成本最低,缺点是细粒度推理弱。
如果任务是视觉问答、图像描述、文档理解,LLaVA 式投影连接最合适。它复用现成的 LLM,推理链路简单,生态支持最好。缺点是视觉 token 占用上下文,高分辨率需要压缩。
如果任务需要交错多图、少样本学习、冻结语言模型,Flamingo 式交叉注意力最合适。它把视觉信息放在旁路,不改变文本流,适合多图上下文。缺点是架构改动大,推理系统支持少。
如果任务需要图像生成、图文交错生成、真正的统一模态建模,Chameleon 式统一词元最合适。它从第一层就融合,输出可以是任一模态。缺点是训练难度高,离散化损失细节,工程复杂度最高。
回到开头的那三个坐标:相遇层越浅,融合越彻底,但训练和工程成本越高;相遇层越深,各模态越独立,系统越容易拆分部署。四种机制正好排成一条从“深”到“浅”的谱系。理解这条谱系,比记住四个模型名字更有用。
参考资料
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



