


扩散模型从零讲起(一):从 DDPM 的加噪/去噪到 DiT 与 Flow Matching
写在前面:为什么要从头讲扩散模型
自回归语言模型(Autoregressive, AR)生成文本的方式很像人写字:一个 token 一个 token 往后接,每步都依赖已写出的全部内容。2022 年之后,图像与视频生成的主流路线换成了另一种范式:扩散模型(Diffusion Model)。它不按”从前到后”的顺序生成,而是先拿出一整张纯噪声图,再反复”去噪”,让图像一步步从模糊变清晰。这套机制更早就被尝试搬到语言模型上;2025 年 LLaDA、Dream 等模型的发布,让扩散语言模型(Diffusion Large Language Model,dLLM)重新成为焦点——它一次性去噪一整块 token,天然可以并行解码,这也让推理优化领域多了一种打破自回归串行依赖的思路。
这条路线牵涉的知识跨度很大:概率论里的马尔可夫链与高斯分布、变分下界、score matching、常微分方程、transformer 的结构改造,再加上扩散语言模型特有的掩码离散扩散与块并行采样。如果一篇文章就把它们全部塞进去,读者只会记住一堆公式,记不住每个公式为什么长这样。因此这里按”数学机制 → 语言模型化 → 工程与服务”拆成三篇:
- 本篇:扩散模型的数学骨架。从 DDPM 的加噪/去噪过程出发,推导所有关键公式(为什么训练目标可以化简成预测噪声、为什么 可以一步采样得到、闭式后验怎么来),再讲 DDIM 如何把采样变成确定性轨迹、score matching 如何把”去噪”等价为”估计分数”、Flow Matching 如何用更直的轨迹减少采样步数;最后讲 DiT 如何把 U-Net 换成 transformer 主干,以及 adaLN-Zero 这个被后续生成模型广泛沿用、也为 dLLM 架构提供参考的设计。
- 第二篇:dLLM 如何把图像扩散的机制”离散化”——掩码扩散过程、吸收态、块并行解码、KV 缓存,以及 Dream、LLaDA 这类模型的结构。
- 第三篇:dLLM 的推理系统视角——并行解码的调度、缓存复用、与服务框架的结合,以及本站已有扩散相关文章之间的关系。
本篇的目标很明确:读完你能独立写出 DDPM 的训练损失、能解释 DDIM 的 估计公式从哪来、能说清楚 DiT 里 adaLN-Zero 的 分别在做什么、能讲明白 Flow Matching 为什么可以用更少的步数采样。这些是后续两篇的全部地基。
动机:自回归生成的根本瓶颈在哪
在动手推导之前,先要把扩散模型要解决的问题摆清楚,不然公式推导很容易变成”为了推导而推导”。
自回归生成的两个代价
一个 70B 参数的稠密语言模型生成一个 token,需要把它全部 700 亿参数都读一遍。这个事实的数学形式是:每生成一个 token,至少要从显存搬运与参数量同量级的数据。按 HBM 带宽估算,如果 GPU 每秒能搬运 字节,每 token 只读权重不读 KV 的话,理论 token 吞吐上限约为 (按 BF16 每参数 2 字节计)。以 70B 和 H100 约 3.35 TB/s 的 HBM 带宽为例,这个上限约为每秒 24 个 token()——想让它更快,就必须靠批处理把同一次权重读取摊到很多请求上,而批处理本身又受 KV 缓存显存占用限制。
自回归的第二个代价是串行依赖。第 个 token 的输入包含第 个 token,因此不能在第 个 token 确定之前开始算第 个 token。GPU 的算力主要来自大规模并行,而解码阶段每一步只有一个位置真正”新”,这就是为什么 decode 阶段的硬件利用率远低于 prefill 阶段——prefill 一次处理几千个 prompt token,decode 一步只出一格。
围绕串行依赖,推理侧已经发展出一整套拆解方法:投机解码(speculative decoding)用一个小模型并行猜多个 token 再用大模型一次验证;lookahead decoding 用 Jacobi 不动点迭代同时推进多个位置。它们本质上都还是”生成 token 序列,只是把验证并行化了”。
扩散模型提供的是另一种生成过程
扩散模型的思路完全不同:它把”生成”看作”从噪声分布出发,沿一条随机或确定性的轨迹,把样本逐渐搬运到数据分布上”。这个搬运过程可以同时作用于整张图或整块 token——每一步对所有位置都做一次前向,而不是一次只前进一格。对图像来说,这天然适配 GPU 的大规模并行;对语言模型来说,它意味着一次前向就可能确定一整块 token,代价是块内的 token 之间”互相看见”的依赖关系需要用额外机制(如块内逐步去噪、置信度选择)来处理。
理解这一切,必须先把”扩散过程”本身讲清楚。下面按时间顺序从 2020 年的 DDPM 讲起。
第一层:DDPM——两条高斯链,一个可学习的方向
DDPM(Denoising Diffusion Probabilistic Models)由 Jonathan Ho、Ajay Jain、Pieter Abbeel 在 2020 年发表,是让扩散模型真正走向主流的关键论文。它的结构出奇地简单:定义两条以高斯噪声为中介的概率链——一条从真实数据”加噪”到纯噪声的前向链,一条从纯噪声”去噪”回数据分布的反向链。前向链没有可学习参数,全部写死为一个固定调度;反向链由神经网络参数化,训练目标是让反向链去逼近前向链每一层的”真实逆过程”。
前向过程:一个固定参数的马尔可夫链
给定一个数据样本 ,前向过程在每个时间步加入一小份方差为 的高斯噪声:
这里 是一个预先给定的噪声日程(noise schedule),取值在 之间,典型从 线性增长到 ,共 步。每一步都有两个动作:
- 缩放:把上一时刻的值乘以 ,这样经过很多步以后,方差不会因为不断累加而爆炸;
- 加噪:再叠加方差为 的独立高斯噪声。
这两个动作合在一起保持了每个时刻的方差在一个稳定量级——这也是为什么 是”加噪量”而不是”加噪率”,缩放项需要与它配套。
这个过程的整体是马尔可夫链,联合分布为 。链的终止时刻 大到使 与原始数据 在信息上已经没关系:设计目标是让 足够接近标准正态分布 ,这样采样时可以从一个容易采样的分布 直接出发。
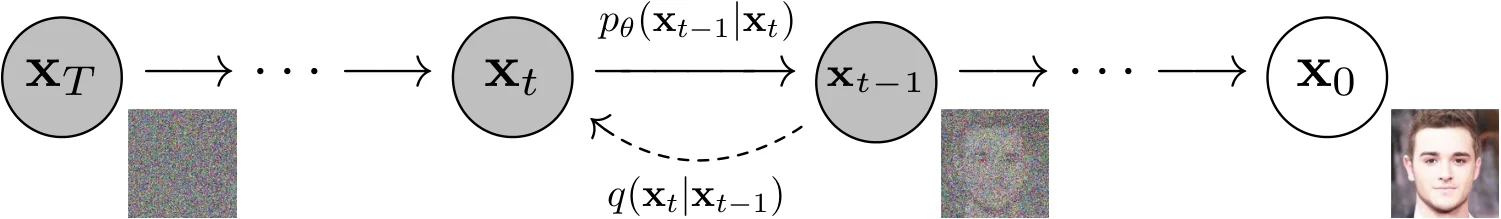
上图是 DDPM 论文中的概率图模型示意。上方一行是前向链 ,箭头上的转移分布是固定的加噪分布 ;下方一行是反向链 ,箭头上的转移分布是神经网络 要学的东西。注意两条链的箭头方向相反——前向链是我们用来定义”训练目标”的工具,实际采样只走反向链。
一步到位: 可以只依赖 直接采样
前向链如果每步都只依赖前一步,那要得到 就要迭代 1000 次。DDPM 最重要的一个代数技巧就是:任意时刻 可以直接从 采样,不需要中间步骤。推导如下。
记 ,。先看一步:
这是把前向转移写成”缩放 + 噪声”的形式。再展开一步:
关键观察:最后两项是两个独立高斯随机变量的和。两个独立高斯 与 的和是 。因此:
也就是说可以合并成单个噪声 , 也是标准高斯。归纳到第 步,得到闭式:
即
这个公式是整篇后续所有推导的基础,值得记住它的三个含义:
- 信噪比(Signal-to-Noise Ratio,SNR)就是 。 越大, 越小,数据信号越弱、噪声越强; 时 , 就是原样本。
- 训练时可以”随机取时刻、直接造出 “,不需要跑完整条链。这让训练非常廉价:每个样本随机抽一个 ,按上式构造 ,就够了。
- 是 与噪声的线性组合,这个线性形式正是 DDPM 能够把目标化简成”预测噪声”的原因。
噪声日程:线性 vs. 余弦
的选择不是无关紧要的数字调参。论文用的是线性日程 从 线性增长到 。后来的工作发现线性日程的尾部”信号衰减过快但噪声不足”,容易让中间某几段的信噪比过低,生成质量受影响。改进版 DDPM(Nichol & Dhariwal 2021)提出了余弦日程:
其中 是一个很小的偏移量,避免 接近 0 时 下降太快。余弦日程的直观设计是让 的变化速率在整条链上更均匀,从而让信噪比在各时间段分布更均衡。
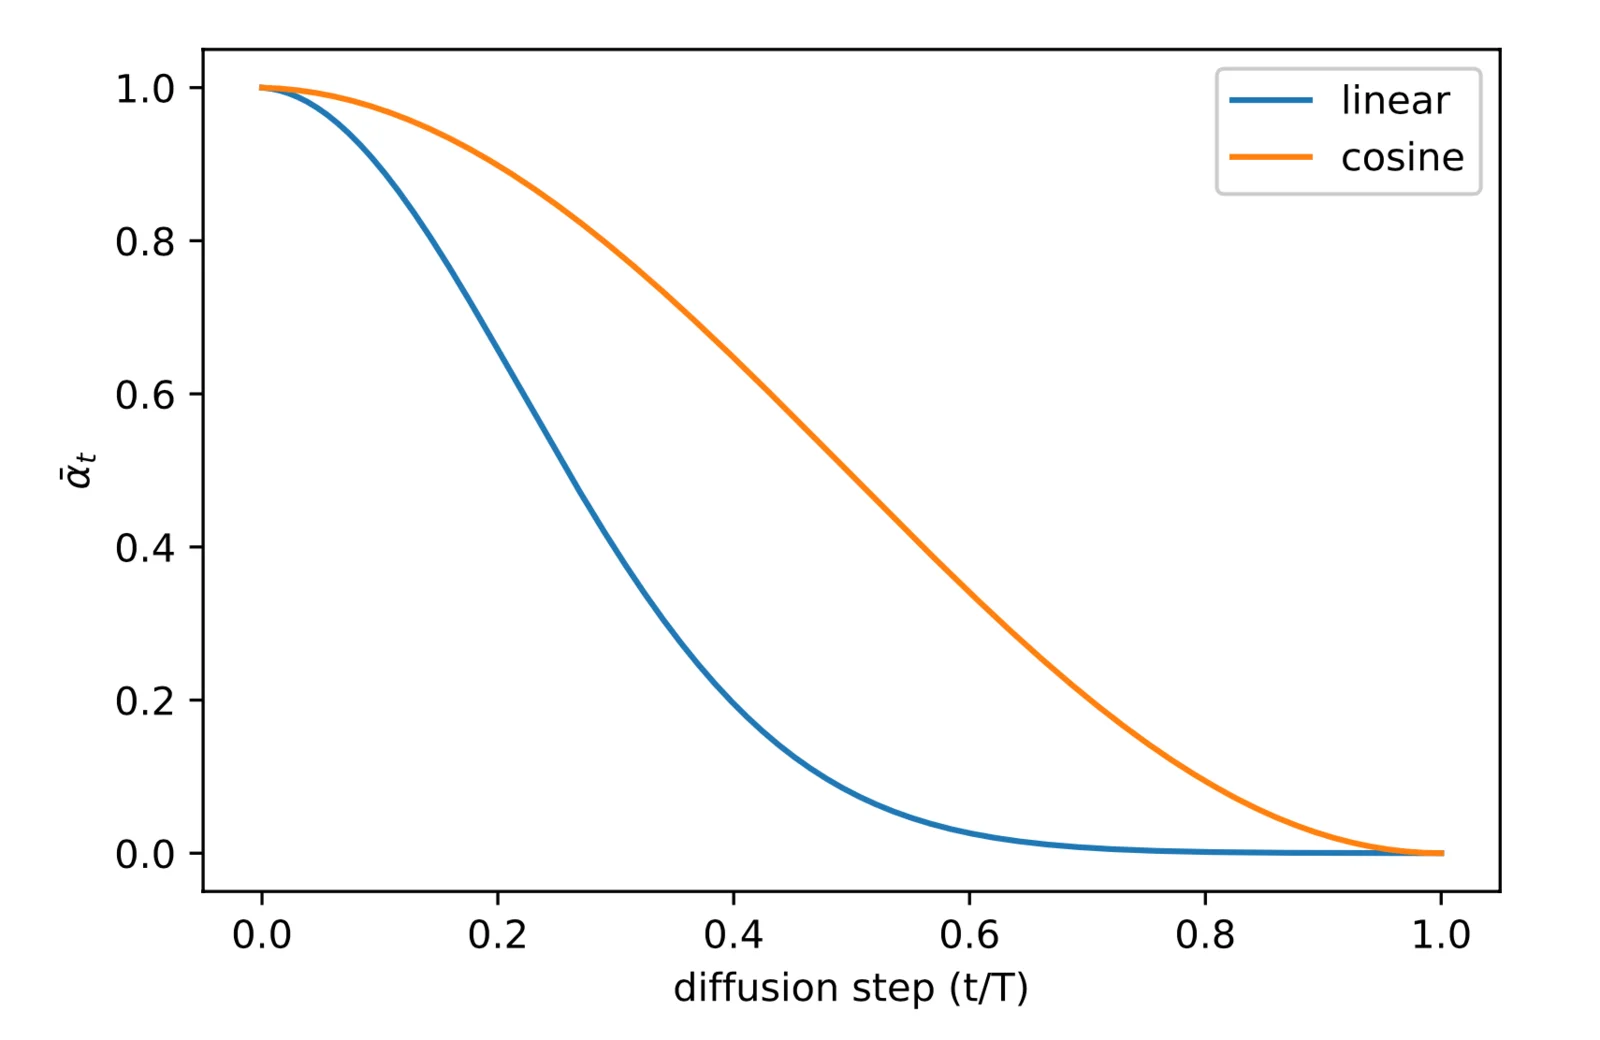
上图(来自 Lilian Weng 的扩散模型综述)对比了两种日程。横轴是扩散步数占总步数的比例,纵轴是 。线性日程(深色)在中段下降很陡,意味着在很短的一段步数里信号从有到无,前后两段则变化缓慢;余弦日程(浅色)的下降更平缓。这个差异直接影响反向链每一层的”难度”:如果某一段步数里去噪难度分布不均,模型在某些时间步会训练不足。这也是后续很多工作(包括 dLLM 的离散噪声日程设计)必须专门处理噪声调度的原因。
反向过程:训练一个”逆向的马尔可夫链”
采样从 开始,逐步反向,每步都希望近似真实的后验 。但真实后验需要知道数据分布,没法直接算,所以用一个带参数的分布 来近似:
其中均值 由神经网络预测,方差 论文采用两种固定形式之一: 或 。为什么方差可以固定?因为论文通过实验发现:固定方差与学习方差的生成质量接近,而固定方差能省掉模型的一路输出,更容易训练,并且样本质量对反向方差的选取并不敏感(改进版 DDPM 随后把它做成可学习的分段常数,但这已经是后续优化)。这个工程选择很有代表性:在扩散模型里,往往把困难的部分(生成分布的复杂结构)交给均值预测,把方差这类”二阶”信息当作调参量固定下来。
反向链的每一步都从 和预测的 (或预测的噪声 )出发:
这个式子看起来像”先减去预测的噪声,再除回去缩放”,正是前向加噪的逆运算:每步先用网络的噪声估计把 里的噪声成分减掉,再除以 还原上一时刻的尺度,最后按固定的方差注入一份新的噪声。
变分下界:训练目标的出处
为什么模型要学”预测噪声”?这要从变分推断讲起。我们想最大化 的对数似然,直接算不可行,因此用变分下界(ELBO,Evidence Lower Bound):
把分子写成 ,分母写成 ,就可以把它拆成三项,对应论文中的 :
- :链末端两项的 KL,衡量”前向链的终点与标准正态差多远”。它与 无关,可以直接忽略。
- :每个中间步的 KL,这是训练的主体。
- :终点 的似然项。
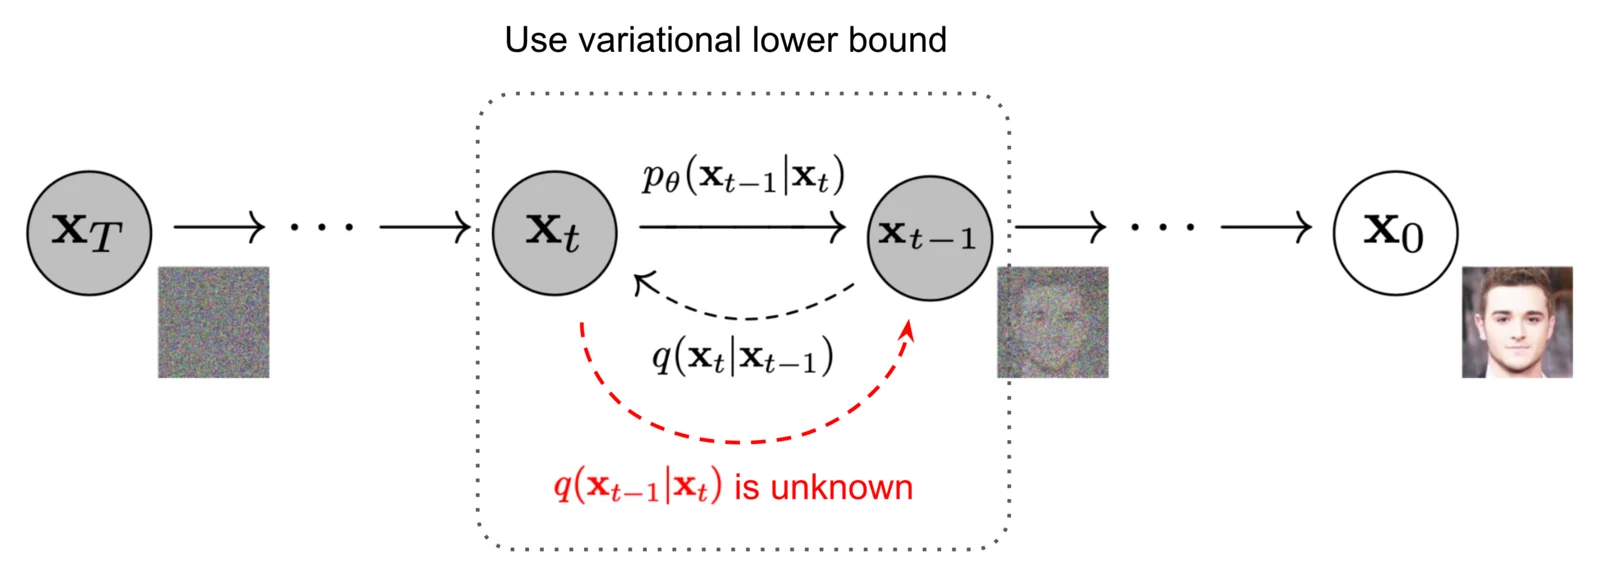
上图(Lilian Weng 扩散模型综述中的示意图)把这个分解画成逐层配对的 KL:整条链按时间展开,每个时间步算一个 KL 项。可以看到, 的每一项都在比较”反向分布 “和”真实后验 “这两者——因为给定了起点 和终点数据 时,真实的中间分布是能解析算出来的。
闭式后验: 为什么可以写出来
已知 与 的转移关系,且已知 与 的闭式关系,应用贝叶斯公式:
三个因子都是高斯,两个高斯的乘积仍是高斯(指数部分相加后配方),所以后验仍是高斯。把指数部分展开、按 配方,得到:
这三行是 DDPM 的正中心。 的两个系数来自对高斯指数配方:它把 与 按各自的”信号/噪声”占比加权,权重分母都是 。把它重写成”从 出发、减去噪声估计”的形式,会得到论文中反向步骤里那个熟悉的系数:
推导路径:把 代入 ,消去 ,即得上式。也就是说,知道噪声 就等于知道 ,二者一一对应。
为什么预测的是噪声而不是
既然从 可以算出 、从 也可以算出 ,为什么论文选择让网络预测 ?论文给出的解释是通过实验比较:预测 能获得最好的样本质量,而直接预测 在早期训练中更稳定但后期质量略差。从直觉上理解: 的主要成分在 较大时就是噪声本身,网络看到的主输入也是噪声;让它预测”我加进去的那份噪声”等于让它先抵消掉输入里最大的干扰成分,因此相当于一种预条件化(preconditioning),使不同时刻的预测难度更均衡。
后来 EDM 论文(Karras et al., 2022)系统地分析了这个问题:预测 、预测 、预测速度 三者本质上是同一个目标的不同参数化方式,它们对网络有效学习的”目标幅度”不同,在高噪声端的差异尤其显著。EDM 给出了一个理论框架,把这些参数化统一起来,并推荐在网络不同噪声区间混合使用。这个视角在后面的 Flow Matching 一节会再次出现。
简化损失:从加权 KL 到去噪回归
把 展开(两个方差固定的高斯之间的 KL 只取决于均值差),得到:
再把 与 都写成” 加系数乘预测量”的形式,差异只剩预测项之差:
前面的系数随时间步变化。DDPM 做了一个大胆的近似:把这个系数丢掉,对所有时间步取等权,得到最终损失:
去掉权重在效果上是把 小的损失项相对压低:原系数 在 小时最大( 附近接近 0.5),丢掉它等于降低”极低噪声去噪”在总损失中的占比。论文给出的解释是: 小的项训练的是”从一点点噪声里恢复细节”,难度较低;把它们降权,能让网络把容量集中到 大、更难的去噪任务上。论文实验也确认,这种重加权反而提升了样本质量——这说明 ELBO 的逐项权重并不是训练扩散模型的最优选择,“难度均衡”比”严格优化似然下界”更影响生成质量。
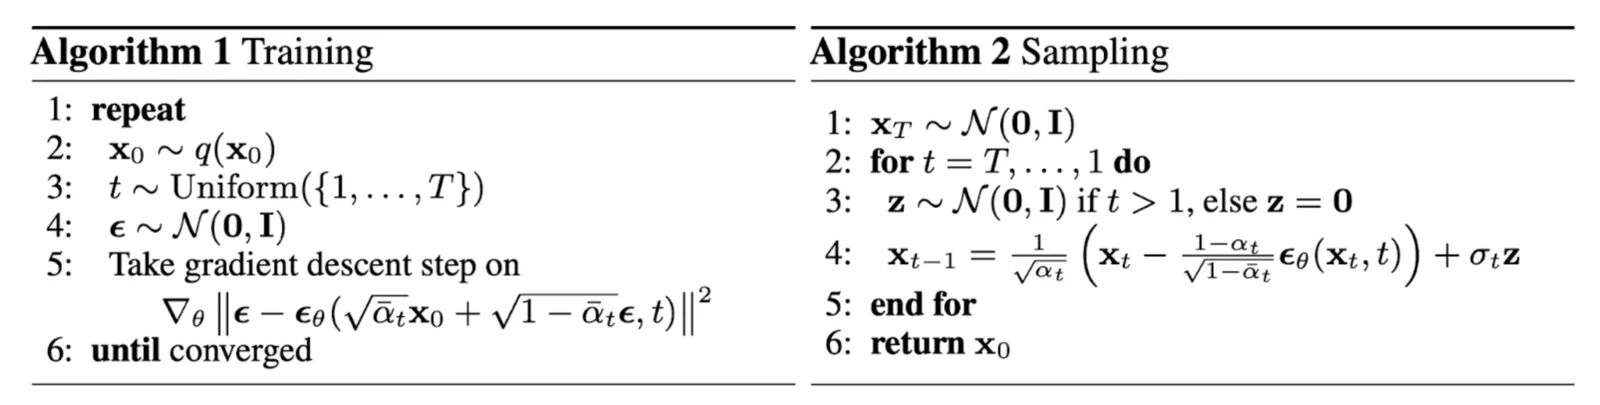
上图是 DDPM 论文 Algorithm 1 与 Algorithm 2 的伪代码(Lilian Weng 综述转载),值得逐行读一遍。左列是训练算法:每轮采样一个数据样本 、一个随机时间步 、一个噪声 ,构造 ,对 和 做一次前向,最小化 ——注意这里连 都不用预测,损失只在噪声空间里算。右列是采样算法:从 开始,对 循环,先前向得 ,再按公式更新 ;当 时把 吃掉(即只保留预测的均值),最后输出 。
训练循环里”随机取 “这一点很关键:它意味着一次优化步里网络只被要求在某一时刻做好去噪,而不是一次性学会整条反向链。整条反向链的能力通过在所有 上平均训练自然涌现。
小结:DDPM 的骨架
到这里,DDPM 的全部机制已经串起来:
- 固定一个加噪日程,前向链有闭式 ,训练时一步就能构造出任意时刻的 ;
- 反向链用网络预测噪声 ,由此推出去噪方向;
- 训练目标是简单的噪声回归 MSE,它是 ELBO 的损失项经过”重加权”后的近似;
- 采样从 出发,按固定公式迭代 次。
DDPM 的代价也很明显:采样需要 1000 步网络前向,每步都跑一次 U-Net,生成一张图往往需要几秒到几十秒。这个”慢”是后面 DDIM 与 Flow Matching 要解决的首要问题;而在 dLLM 里,它变成了”块内需要多次去噪前向”的开销,同样需要在服务层面处理。
第二层:从 EDM 的加噪视角看 DDPM——噪声水平的统一表达
在讲 DDIM 与 Flow Matching 之前,需要先换一个视角重新写 DDPM 的前向过程。图像扩散社区在 2022 年 EDM 论文(Elucidating the Design Space of Diffusion-Based Generative Models,Karras et al.)之后,普遍采用下面的记号:
即”数据加一份标准差为 的高斯噪声”(VE 风格,方差爆炸)。对 取一个具体函数,例如从 增长到 ,就得到一个完整的扩散日程。DDPM 的写法把”缩放数据”与”加噪声”捆在一起,而 EDM 的写法把它们拆开:数据部分保持原样,只控制噪声幅度,便于分析不同噪声水平下的网络行为。
DDPM 的方差保持(VP)形式
对比两个写法,DDPM 的 可以改写成:
也就是说,DDPM 等价于”先把数据加噪到 ,再把整个样本乘一个常数”。这个缩放乘以常数不改变方向,只是改变幅度。EDM 把这种”每次加噪都重新缩放到单位范围”的做法称为 VP(variance preserving),它与”方差爆炸”(VE,variance exploding)形成对比:VE 就是直接 、不缩放数据, 可以从 0 增长到几十甚至上百(EDM 用的正是 VE 日程)。VP 的优点是在整个链上输入幅度稳定,缺点是数据信号被 缩放,高噪声端数据几乎不可见;VE 的优点是数据部分始终以原尺度保留、噪声显式可控,缺点是 的方差随时间变化很大,网络在不同时刻看到的输入幅度差异明显。两者并不是谁更好,而是对”信号与噪声如何分配”的不同约定。
为什么要关心这个区分?因为:
- 训练鲁棒的噪声目标。在 VP 里,网络输入与 的幅度都保持在一个量级;而 VE 的高噪声端输入幅度动态范围很大,这时用不同的参数化(预测 或预测速度)能让网络目标幅度保持均衡、训练更稳健,这是 EDM 在 VE 日程下选择参数化方式的原因。
- 采样时间步的设计。EDM 发现可以用一个不”均匀”的时间步网格,在噪声端多放几个点,对每个网格点用不同的步长;这个思想直接影响了后续 dLLM 的噪声日程设计。
- Flow Matching 采用的是一个更自由的写法——,其中 可以任选,不必像 VP 那样满足""的约束。VP 与 VE 是这个写法的两个特例。
EDM 的噪声日程与时间步网格
EDM 不只换记号,还给出了一套具体的 VE 日程。定义噪声标准差随归一化时间 的变化:
这里 对应最大噪声 、 对应最小噪声 (EDM 的时间轴与 DDPM 相反)。论文的典型取值是 、、。为什么要引入 这个指数?如果 , 随 线性增长,那么在低噪声端( 从 0.002 到 1)会占用过多时间步,而真正难的高噪声端反而采样点稀疏。取 相当于对 做一次”幂次重参数化”,把更多时间步分配给低噪声端,使 在对数尺度上分布更均匀。
采样时的离散时间步也按同样的幂次公式取:
这套”在 空间等距取点”的做法,后来成为扩散模型采样器的标准工程实践:采样器真正关心的是相邻两步的噪声比 ,而不是线性时间 的间隔。dLLM 的块内去噪步数安排也遵循同样的原则——重要的不是”均匀切分时间”,而是”均匀切分噪声水平”,让每一步的去噪难度相近。
EDM 的”重参数化”:用数据与噪声的加权表示
EDM 提出一个很有用的表示:把任意时刻的 同时看作两部分的加权组合
并且同时预测 和 (或者它们的线性组合”速度” )。速度参数化(velocity parameterization)定义为
它的巧妙之处在于:给定 ,只要知道 ,就能同时解出 与 ——因为 与 构成一个可逆的二元线性方程组。于是”预测 “天然地同时覆盖了”预测噪声”和”预测数据”两种任务。EDM 的核心建议是让网络在高噪声端预测 、在低噪声端预测速度或噪声(三者在不同噪声区间对网络的有效目标幅度不同),并通过一个加权函数把损失 、“数据误差” 等统一表达。这一节不必展开 EDM 全部细节,只需记住:DDPM 的”预测噪声”不是一个唯一正确的选择,而是一族等价参数化之一;后面 Flow Matching 的”预测速度场”是同一家族里的另一个成员。
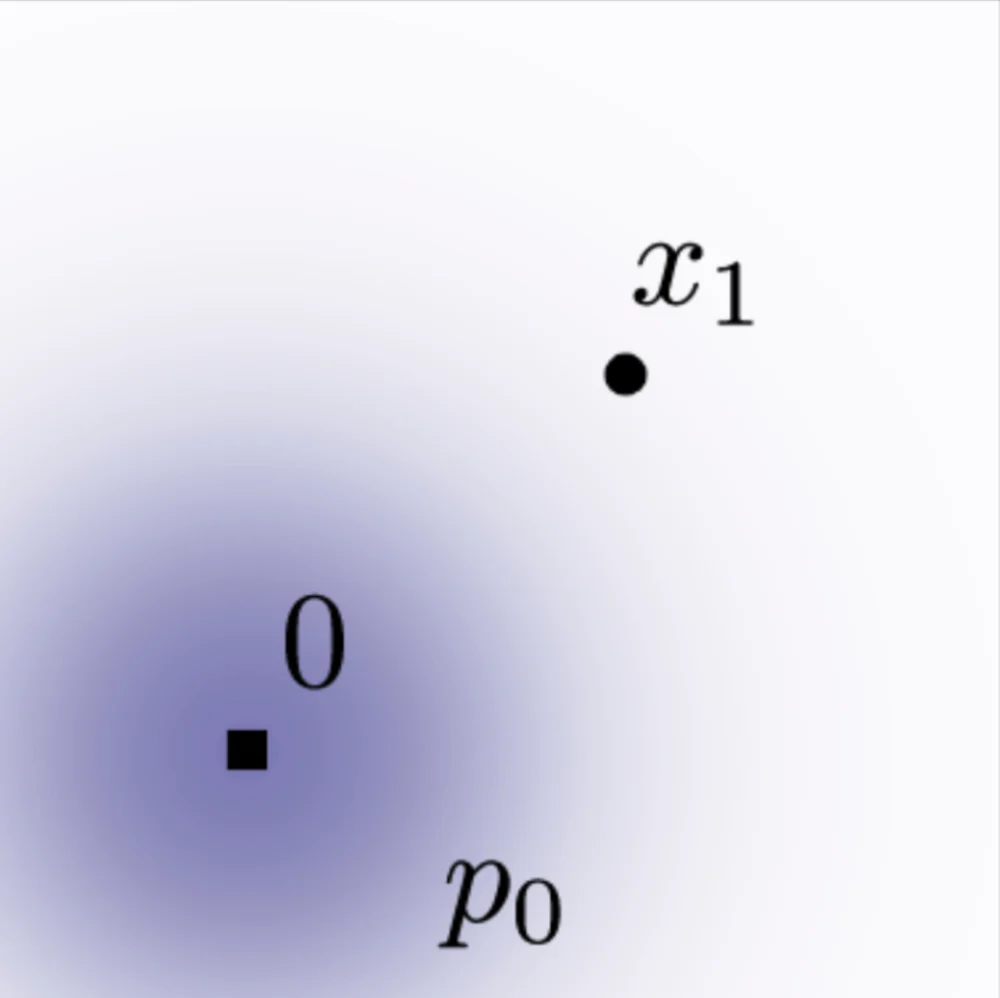
上图是 Flow Matching 论文用于教学说明的二维参考速度场可视化,每个箭头表示该位置的目标速度方向。它想传达的直觉与 EDM 一节相通:扩散模型的训练核心不是”生成图像”,而是”对空间中每个点给出一个正确的运动方向”。只要方向场学得对,从任意噪声点出发沿方向积分,样本自然会被搬运到数据分布上。速度场视角的好处是它把”噪声日程、采样步数、参数化”这些看起来毫不相干的设计决策统一成一件事:设计一条从噪声分布到数据分布的路径,并让网络输出沿这条路径的速度。
第三层:DDIM——把概率采样变成确定性轨迹
DDPM 的采样是概率性的:每一步都要注入新的噪声 ,因此它其实是在”随机地”沿反向链行走。DDIM(Denoising Diffusion Implicit Models,Song、Meng、Ermon,2020)指出了一个关键事实:反向链其实可以被重写成一条确定性轨迹,且不需要重新训练模型。
动机:为什么不想要随机性
三个实际原因:
- 效率。随机采样每一步都在重新抽噪声,相邻状态之间没有固定路径可循;确定性轨迹则是一条光滑曲线,可以用更少、更大的步长来近似,这是 DDIM 能把 20-50 个时间步当作”粗网格”来用的根本(相对 DDPM 的 1000 步)。
- 可逆性。确定性 ODE 可以从样本反推回起始噪声(所谓”反转”),这对图像编辑、语义插值、以及后续 latent 空间的组合操作有用。
- 语义一致性。给定同一个起点噪声,确定性采样每次生成的样本相同,方便对比实验。
DDIM 的推导:只用后验的”方向”,不用后验的”噪声”
回顾 DDPM 的后验 ,它的均值 已经把 与 的信息都放进去了。DDIM 论文注意到:后验的方差 决定了随机性,而真正决定”从 到 方向”的是均值中的两项。DDIM 提出一族新的反向分布:
其中 是自由参数,可以取 (完全确定性),也可以取 的平方根(等价于 DDPM)。当 时,反向过程变成:
把 和 的估计代入(),化简后得到 DDIM 采样公式:
理解这个公式最好的方式:每一步先”预测出 “(第一项),再把 按 时刻的噪声比例”重新加噪”回 状态(第二项)。整个 DDIM 采样就是”预测 → 用 的噪声重新混入”这个动作反复执行。这个形式看起来像是”用同一个模型做了 次 估计”,只是每一步估计用到的输入噪声逐渐减小。
更一般地,DDIM 引入了步长序列 , 可以远小于 。在相邻两个大时间步 与 之间,公式变为:
当 时,最后一项消失,且第二个系数变为 ,与上式一致。这个公式清楚地体现了 DDIM 能”跳步”的原因:它不要求相邻步之间是马尔可夫链上的真实相邻转移,只需要对 做一次估计,再按新的目标时刻重新混合噪声。因此 与 的采样,走的是”通过同一族中间状态的不同密度采样”,而不是”跳过某些真实转移”。
DDIM 的训练:为什么”免费”
为什么 DDIM 不需要重新训练?因为它的训练目标与 DDPM 完全一致:还是在预测 (或等价地预测 )。DDIM 只是把采样方式换掉了,模型学到的 仍然是”给定任意 与 ,估计其中含有的噪声”。由于训练时 覆盖所有步数,模型自然能够处理任意 的输入。所以 DDIM 是”免费的加速”,这也是它在 2021-2022 年被广泛采用的原因。
但这个”免费”是有边界的:步数压得太低(比如 10 步以内),模型在中间某个 上从未被足够密集地训练过,预测质量就会下降。后来的工作(如 DPM-Solver、UniPC)用 ODE 求解器的二阶/高阶方法来利用轨迹的曲率信息,使得在 10-20 步内仍能保持质量。这些方法的本质是:确定性轨迹是一条光滑曲线,可以用数值积分器逼近,而不必每步都用 Euler 法。
从 DDIM 到”速度场”
到这里我们已经有了三个层层递进的视角:
- DDPM:随机反向马尔可夫链,需要 步;
- DDIM:确定性轨迹,可以用更少的步数,模型不变;
- 下一步:用 ODE 的语言描述”轨迹”,并让它更”直”。
第三种视角正是 Flow Matching 的出发点。
第四层:Score Matching——为什么”去噪”等于”估计梯度”
在引入 Flow Matching 之前,还有一个桥梁概念必须讲清楚:score。它解释了为什么 DDPM 的训练目标可以写成”预测噪声”,也解释了为什么扩散模型的采样可以写成”沿分数梯度的上升”。
分数的定义
对一个概率密度函数 ,它的分数(score)定义为对数密度的梯度:
分数是一个向量场:在每个点 上,它指向”使密度增大最快的方向”。如果把数据分布想象成一座山,分数就是从山上每个点指向山顶的向量。沿着分数走,就能被”推向”高密度区域。
关键恒等式:加噪后的分数由噪声估计直接给出
设 是加噪分布。一个重要的代数结果是:
推导分两步:第一步把 写成对 的边缘化;第二步把梯度移进积分号,并把”对 的加权”识别为条件分布 下的期望。而每个条件因子是高斯 ,其对 的梯度是 。代入即得 。在 DDPM 的参数下取 ,即把上式中的 暂时换成 、 换成 ,于是:
这个公式的意义是:去噪器预测的 其实就是分数(差一个常数因子)。让网络回归噪声 ,等于让它在隐式地学习加噪分布的分数场;而 DDPM 的反向步骤则等价于沿分数场做一次带噪声的梯度上升。这就是所谓”denoising score matching”的核心,也是 DDPM 能被推广到 score-based 生成模型(如 Noise Conditional Score Network,NCSN)的原因。
为什么分数视角很有用
- 采样 = 解 ODE。既然分数是一个向量场,那么从噪声出发沿分数场走一条路径,就是在”解一个常微分方程”。这给 DDIM 一个很自然的 ODE 解释:它对应分数场驱动的概率流 ODE(probability flow ODE)。两者的关系不是”严格等价”,而是同一条思路的两种离散化——DDIM 在 DDPM 的离散时间框架内做跳步近似,而概率流 ODE 的推导建立在连续时间、方差恒定的加噪上;在合适的连续性极限下二者一致,但实际使用时各自的步长与误差分析不同。
- 训练目标统一。score matching 告诉我们,可以用”预测噪声”、“预测数据”或”预测速度”来训练,只要它们与分数之间能相互转换。这让不同论文的公式可以互相对照。
- Flow Matching 得以简化。Flow Matching 正是把”分数场驱动的扩散 ODE”推广为”任意速度场”,并证明可以直接回归速度场而无需经过 ELBO 的繁琐推导。下面进入 Flow Matching。
第五层:Flow Matching——用更直的轨迹换更少的步数
Flow Matching(Lipman et al., 2022;同年 Rectified Flow 由 Liu et al. 独立提出)把扩散模型从”概率分布的 KL 变分”重新表述成”回归一个速度场”。它的出现直接改变了图像生成的主流训练方式,也让扩散语言模型在离散化时的”路径设计”有了更简单的选择。
从连续归一化流说起
连续归一化流(CNF)是一类用常微分方程定义的生成模型:
从简单分布(如 )出发,沿速度场 积分到 ,得到目标分布 。问题在于:如何训练 ,使得积分结果恰好是数据分布?经典方法是最大似然,需要计算雅可比行列式的迹 ,计算成本极高。扩散模型的隐式概率流 ODE 也属于这一类,其速度场可以由分数推出。
Flow Matching 的洞见:不需要从”生成分布等于数据分布”的条件出发做最大似然,只需要构造一个已知的”条件路径”,然后回归它的速度场即可。
条件速度场:先构造”已知”的轨迹
Flow Matching 定义了一系列条件路径:
在每个条件路径(固定了一对 )上,对 求导,就得到该路径上的条件速度:
例如如果取 、,那么 : 时是纯噪声、 时是数据,条件速度是 ,即”从噪声指向数据”的直线方向,生成时正好从 积分到 。如果取 、,则 ,轨迹是单位圆上从噪声到数据的四分之一圆弧——这是”点落在单位圆周上”时的自然选择。
训练:直接回归条件速度
Flow Matching 的训练目标是:
这个目标完全避免了 KL 和 ELBO:不需要比较分布,只需要让网络输出的速度向量与”当前这条条件轨迹在该点的切向”对齐。训练时同样可以随机取 、一步构造 ,与 DDPM 一样便宜。
为什么条件速度场等价于边际速度场
一个很关键的定理(Flow Matching 论文的核心):对所有条件路径回归条件速度场,其最优解就是边际速度场,即能生成真实数据分布的那个速度场。证明大意是:条件速度的期望等于边际速度,而平方误差的期望以条件期望为最优解。所以训练条件目标不会引入偏差。
Flow Matching 与扩散的关系
Flow Matching 与扩散模型并不是两套完全不同的东西,而是同一族”连续时间概率流”的不同路径设计:
- 若取 为 DDPM 的 (注意 DDPM 的 是数据端,时间轴与 Flow Matching 的约定相反,对齐后等价),条件速度就对应 DDPM 的反向链速度;
- Flow Matching 允许 任意选取(例如线性、cosine、sigmoid),因此可以针对具体任务设计”直”或”弯”的路径;
- 当轨迹是直线时(),理论上可以用很少的步数甚至一步近似采样,这是 Flow Matching 与 rectified flow 追求的目标。
关键性质:轨迹的”直”、求解器与采样步数
Flow Matching 采样是从噪声出发、沿 积分到数据的过程(约定 为噪声端、 为数据端,采样从 积到 )。若轨迹可以近似为直线,那么用 Euler 法一步就能从噪声端走到数据端;越”弯”的轨迹需要越多的中间步。
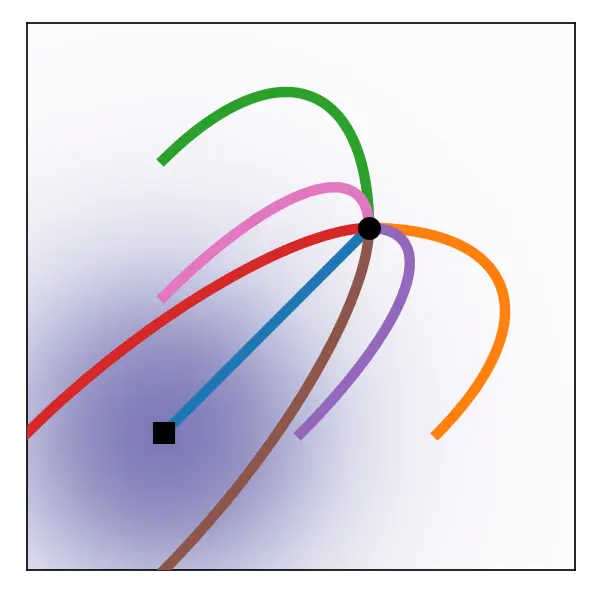
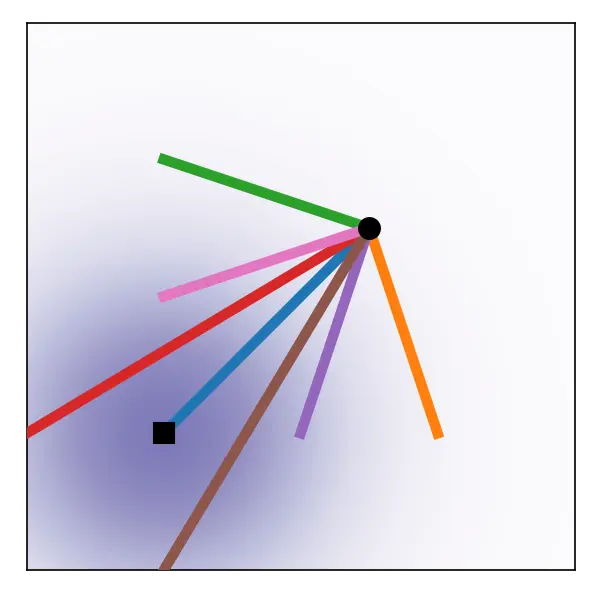
上图是 Flow Matching 论文 Figure 3 的二维采样路径:左图是扩散模型的条件速度场路径,粒子路径弯曲、且会越过终点再折返;右图是最优传输(Optimal Transport,OT)路径,粒子沿直线匀速移动。扩散路径的”弯”与”折返”正是采样需要很多步数值积分的根源,直线轨迹意味着:沿轨迹积分时,每一步的方向变化更小,因此大步长近似误差更小。论文用中点法(midpoint scheme)求解 ODE,比较了达到相同误差所需的前向次数(NFE):在使用 OT 路径的 Flow Matching 下,达到同一误差阈值所需的前向次数约为扩散路径模型的 60% 左右。这正是 Flow Matching 能把采样步数压到很低的原因,也是它对 dLLM 推理的重要启示——如果语言 token 的”去噪块”能被设计成更”直”的轨迹,块内重复前向的次数就能减少。
一句话对比:DDPM 与 Flow Matching 的训练目标
| 方面 | DDPM | Flow Matching |
|---|---|---|
| 训练损失 | 噪声回归 MSE(ELBO 的近似) | 条件速度回归 MSE(无需 ELBO) |
| 采样 | 反向马尔可夫链,随机 | ODE 积分,确定性(也可加噪) |
| 步数 | 1000 步,DDIM 可压到 20-50 | 可设计更直路径,几十步甚至更少 |
| 噪声日程 | 固定为 日程 | 自由设计 |
| 与分数的关系 | = 分数 | 速度 可转换为分数 |
第六层:DiT——用 transformer 替换 U-Net 主干
DDPM 时代的图像扩散几乎都用 U-Net 作为去噪网络。U-Net 的特色是”下采样 + 上采样 + 跳跃连接”,擅长在多个空间尺度上建模,这种多尺度结构对图像的细节和全局结构都友好。2022 年底的 DiT(Diffusion Transformers,Peebles & Xie 2023)做了一件当时看似激进的事:保留 latent diffusion 的两段式(VAE 编码 + 在 latent 上扩散),但把去噪主干从 U-Net 换成标准 Vision Transformer。这份论文的重要性不只在于图像质量,更在于它为扩散语言模型提供了一个直接可用的架构模板。
背景:latent diffusion 与 U-Net 的分工
Latent Diffusion(Rombach et al., 2022,即 Stable Diffusion 的基座)把扩散过程从像素空间搬到 latent 空间:先用一个预训练的 VAE 把 图像压缩成 的 latent,然后在 latent 上训练扩散模型。这样做的好处是去噪网络处理的序列长度显著缩短(从像素级上百万维到 latent 级几万维),网络容量可以更集中地用在”语义结构”上,而不是”像素细节”上。
在 DiT 之前,latent 上的去噪网络也都是 U-Net 及其变体。U-Net 的设计里有几个隐含假设:
- 输入是带空间局部性的二维特征图,卷积与池化天然利用局部性;
- 下采样-上采样结构天然提供多尺度视野;
- 跳跃连接补足了下采样丢失的细节。
但 transformer 在序列建模上的优势(全局注意力、易扩展、易与预训练组件结合)越来越明显,而且 ViT 的”patchify”设计能很自然地处理二维 latent。DiT 的问题就是:如果把 U-Net 换成 ViT,怎么处理条件输入(时间步 、类别标签 )?
ViT 处理 latent 的条件输入:三种设计方案
DiT 的整体流程很直接:以论文在 类条件 ImageNet 上使用的 DiT-XL/2 为例,VAE 把图像压成 的 latent,latent 被切成 的 patch(共 个位置),每个 patch 展平后线性映射成 维 token,加上位置编码,得到 个 token 的序列;transformer 处理这些 token;输出 token 被 unpatchify 回 的预测。条件信息 和 必须引入到网络中,论文比较了三类方案:
- 条件作为额外 token(in-context conditioning):把 和 的嵌入当作两个额外的 token 拼到序列前面,直接交给注意力处理。好处是无需修改 block 结构,坏处是条件信息与图像 token 在注意力里平等地混合,条件信号的权重随着序列变长会被稀释,而且需要额外学习。
- 交叉注意力(cross-attention):在每个 transformer block 里加一层交叉注意力,让图像 token 查询条件嵌入。这是 Stable Diffusion 用于文本条件的标准做法;坏处是多了一层注意力,计算与参数开销都增加,而且论文实验发现这条路线在训练早期收敛慢。
- adaLN-Zero:把条件嵌入用一个 MLP 映射成 6 个向量,对每个 block 的 LayerNorm 参数做”自适应缩放偏移”——每个 block 的 LayerNorm 在归一化后乘一个 、加一个 ,而这两个参数由条件 与 生成的”调制向量”决定;此外每个 block 的最后有一个残差门控系数 ,初始化为 0,使每个 block 在训练开始时是”恒等映射”。
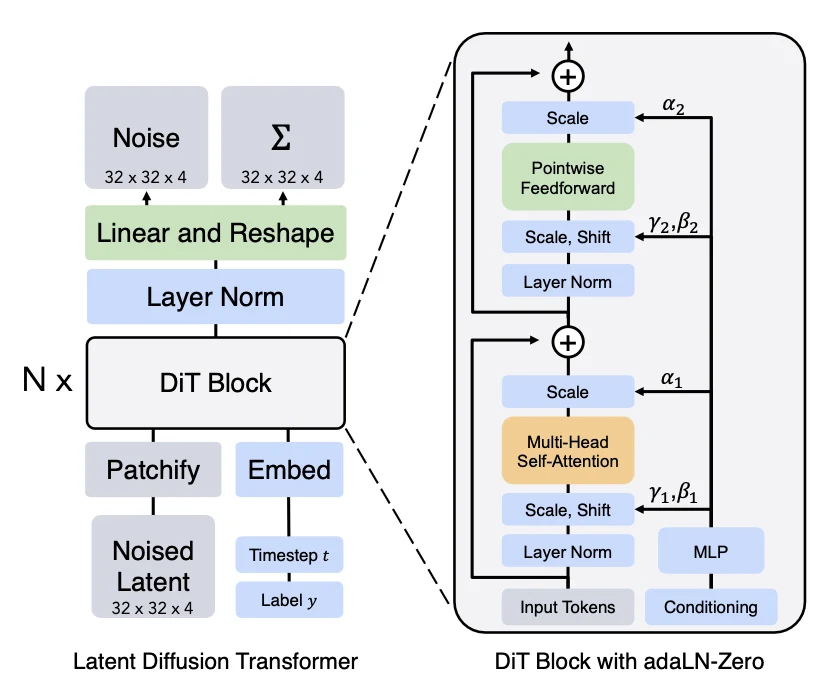
上图是 DiT 论文 Figure 3 中的架构示意(这张图取自 Lilian Weng 的综述转载)。左侧是输入:时间步 与类别标签 分别嵌入后相加,得到条件嵌入;右侧是带 adaLN-Zero 的 DiT block:条件嵌入经 MLP 产生 个调制向量,其中前两组分别作用于 LayerNorm 的缩放与偏移,然后在自注意力与 MLP 之后各有一组,再乘上门控系数 。图下方的”Latent Diffusion Transformer / DiT Block with adaLN-Zero”标注正对应这个逐 block 的调制结构。
adaLN-Zero 的数学形式
对一层 transformer 的每个 block,标准 LayerNorm 是 ,其中 是可学习参数。adaLN-Zero 把 与 从”每个 block 自己学”改为”由条件嵌入生成”:
再加三个额外的参数 用于第二个 LN,以及最后的门控 :
初始化为 ,这就是名字里”Zero”的来源。初始化时残差分支输出为 0,整个 block 是恒等映射;训练开始后 逐渐被学成非零值。论文的解释是:这种初始化让训练早期整个网络等价于”什么都不做”,梯度只在调制路径上流动,网络可以缓慢地学习”什么时候打开哪一层”,从而训练更稳定、收敛更快。
为什么是”逐 block 调制”而不是”条件 token”
adaLN-Zero 的收益在两处:
- 计算效率。每个 block 用一个共享条件嵌入产生调制向量,不增加注意力层的开销;对比交叉注意力,每层都要做一次额外的注意力。
- 条件信号强度可调。调制向量直接作用在每一层的归一化上,控制”该层的特征幅度”,条件不会被长序列稀释;而条件 token 方式中,条件与图像 token 的混合比例由注意力自己学,训练早期难以稳定。
论文的对比实验也支持这个判断:adaLN-Zero 在训练全程的 FID 都优于交叉注意力与条件 token 方案。这种”条件控制每一层的归一化”设计后来被大量沿用:Flux、SD3 等图像生成模型采用类似的调制。对 dLLM 来说,去噪进度与条件同样是全局信号,但注入方式因模型而异:LLaDA 等模型使用的是标准 transformer 主干,把时间步与掩码信息以嵌入或输入构造的方式引入;另一些模型则沿用 adaLN 式调制。这个差异属于第二篇要展开的架构比较。
位置编码与分辨率外推
DiT 的初始版本使用固定的二维正弦位置编码,每个 patch 位置有一个固定的嵌入向量。这一设计的副作用是:模型在训练分辨率之外的表现变差,因为训练时见过的位置编码在更高分辨率下”坐标间隔”变了,模型没有在对应位置上学过。这个问题后来被 rotary position embedding(RoPE)与插值方案大量修正——在二维图像中把 RoPE 的”频率”按坐标轴分别应用,使得相同结构在不同分辨率下位置编码的关系保持连续。
对扩散语言模型来说,另一个必须处理的变化是位置编码的物理含义:图像里位置编码对应二维坐标,而语言是变长的一维序列,dLLM 的块并行解码又会让”块内位置”与”块间位置”的编码关系变得复杂。位置编码如何做到对长度不敏感、如何在块之间保持连续,直接关系到模型能否在长上下文里稳定地做块生成。这个问题的工程细节,与本站讨论过的 RoPE 系列话题同源(例如 答疑特辑:秩与 SVD、RoPE 旋转矩阵、投机解码原理与 AI 芯片全景 中对旋转矩阵的讲解),在第二篇进入 dLLM 时会再次用到。
规模化的关键数据
DiT 论文的核心发现是模型计算量(FLOPs)与生成质量的强相关性。论文用四个尺寸(S/B/L/XL)× 三种 patch 划分(8/4/2)的网格系统扫描,发现:
- 在相同的总 FLOPs 下,不同配置(如 DiT-S/2 与 DiT-B/4)的 FID 接近;
- Gflops 与 FID 呈强负相关;
- 最大的 DiT-XL/2 在 类条件 ImageNet 上达到 2.27 FID,这是当时该设定下的最佳结果(论文报告的 Gflops 下)。
这里要强调的不是”榜单成绩”,而是设计含义:在 DiT 论文的计算量扫描范围内,DiT 的 FID 随模型 Gflops 增长而平滑下降,相同 FLOPs 的不同配置(如 DiT-S/2 与 DiT-B/4)表现接近;而此前的 U-Net 模型在同等计算量下没有表现出同样清晰、可预测的扩展趋势。这直接解释了为什么后续图像与视频生成模型几乎全部转向 transformer 主干,也解释了为什么 dLLM 的架构设计可以借用同一套”深 transformer + 全局条件调制”的模板。
训练与推理开销
DiT 的训练成本主要取决于去噪步数与模型的 token 数。以 类条件 ImageNet 为例,论文使用 的全局批大小、 万次训练步数,学习率 、不使用权重衰减,训练过程中以固定概率把类别条件置空以支持 CFG。推理时,每一步去噪都要跑一次完整 DiT。因此推理成本约等于”采样步数 × 单次 DiT 前向”。这个成本结构在后续被两个方向优化:一是减少采样步数(DDIM/DPM-Solver/Flow Matching 的直轨迹),二是让每一步前向更便宜(更小的模型、更少的 token、蒸馏)。
这两条路径在 dLLM 里会以新的形式重现:dLLM 的块内每一步去噪也要跑一次完整模型前向,因此”块大小 × 块内步数”直接决定了每个 token 的推理成本;而并行解码的收益,必须超过块内重复前向的开销才划算。理解 DiT 的成本结构,是理解 dLLM 推理系统的前提。
工程实现:一个最小 DDPM 的训练与采样循环
公式讲完之后,用一段可运行的代码把整条链路串起来,能暴露很多论文里一句话带过的工程细节。
import torchimport torch.nn.functional as F
T = 1000betas = torch.linspace(1e-4, 0.02, T)alphas = 1.0 - betasalpha_bars = torch.cumprod(alphas, dim=0)
def extract(arr, t, shape): # 把标量日程按 batch 中的 t 取出,并广播到与 x 同形状 out = arr.gather(0, t).reshape(t.shape[0], *([1] * (len(shape) - 1))) return out
def q_sample(x0, t, eps): ab = extract(alpha_bars_dev, t, x0.shape) return ab.sqrt() * x0 + (1 - ab).sqrt() * eps
def train_step(model, x0): alpha_bars_dev = alpha_bars.to(x0.device) t = torch.randint(0, T, (x0.shape[0],), device=x0.device) eps = torch.randn_like(x0) x_t = q_sample(x0, t, eps) eps_hat = model(x_t, t) # 网络被要求预测"加进去的噪声" return F.mse_loss(eps_hat, eps)
@torch.no_grad()def sample(model, shape, device): alphas_dev = alphas.to(device) alpha_bars_dev = alpha_bars.to(device) betas_dev = betas.to(device) x = torch.randn(shape, device=device) # x_T ~ N(0, I) for t in reversed(range(T)): t_batch = torch.full((shape[0],), t, device=device, dtype=torch.long) eps_hat = model(x, t_batch) alpha = extract(alphas_dev, t_batch, x.shape) alpha_bar = extract(alpha_bars_dev, t_batch, x.shape) mean = (x - (1 - alpha).sqrt() * eps_hat / (1 - alpha_bar).sqrt()) / alpha.sqrt() if t > 0: sigma = betas_dev[t].sqrt() z = torch.randn_like(x) x = mean + sigma * z else: x = mean return x这段代码里有几个值得解释的工程点:
t必须作为网络输入,不是隐变量。同一个网络要在所有时间步上做不同的去噪任务,必须知道当前噪声水平。常见的时间嵌入方式是把 映射成正弦位置编码,再过 MLP,DiT 用的是频率嵌入加 MLP 再进 adaLN。q_sample的数值范围。alpha_bars在 很大时接近 0,(1-alpha_bars).sqrt()接近 1,因此 的幅度会接近标准噪声;但在 很小时, 是一个接近 0 的小量,float16 只有 10 位尾数,会把 舍入到 1 附近,导致 变成 0 或严重失真,低噪声端的训练信号因此被破坏。所以这类日程量通常以 float32 计算并保存为常量表,只在模型前向内部使用混合精度。- 损失不需要加权。DDPM 的
L_simple对每个t等权,代码里直接对 batch 内所有t求平均。如果要复现”改进版 DDPM”的加权 ELBO,需要按 给每个样本加权。 - 采样时
t=0不加噪声。最后一步的输出是均值本身,不再加 ;这与训练时 附近”噪声几乎为零”的行为一致。 - EMA 权重。实际训练几乎都会维护一份模型权重的指数滑动平均(EMA),采样时用 EMA 权重。原因是扩散模型的训练损失在后期下降很慢,原始权重的采样质量波动大,而 EMA 能显著平滑生成效果。
具体数字:噪声日程在做什么
以线性日程 计算,几个关键时间步的 与信噪比:
| 时间步 | 信噪比 | 等效噪声标准差 | |
|---|---|---|---|
| 100 | 0.897 | 8.7 | 0.34 |
| 250 | 0.524 | 1.10 | 0.95 |
| 500 | 0.0786 | 0.085 | 3.42 |
| 750 | 0.00335 | 0.00336 | 17.2 |
这张表能直观地说明”为什么 DDPM 在 附近最难学”:此时信噪比只有 0.085,信号已经被噪声压过,但还没有完全消失;模型既不能忽略输入,也不能完全依赖输入,必须利用数据分布的先验来”猜”出合理的 。到了 ,信噪比降到 0.003,输入几乎全是噪声,模型只能依赖条件与先验;而在 ,信噪比约 1.1,输入中数据与噪声各占一半, 估计的任务是”清理掉一半的干扰”。
这张表也解释了 DDIM 的步长序列怎么选。噪声水平在低噪声端变化最快( 从 250 走到 500, 就从 0.95 涨到 3.42),而高噪声端的 已经很大、相对变化平缓。数值积分器对”变化最快”的区段最敏感,所以常用的 DDIM 步长安排在低噪声端更密、高噪声端更疏——这与直觉上”噪声大的地方随便跳”正好相反。
条件生成:classifier-free guidance 在做什么
DiT 的类条件生成需要”给定类别 生成对应图像”。扩散模型的条件生成最常用的技术是 classifier-free guidance(CFG,Ho & Salimans 2022),它不训练额外的分类器,而是把”有条件”与”无条件”两种预测混合起来。
公式与直觉
训练时以一定概率(常见做法是 10% 左右)把条件 替换为空条件 ,让同一个网络同时学会”有条件去噪”和”无条件去噪”。采样时,对同一个 跑两次(或者在同一个 batch 里同时带条件与空条件):
是引导强度(guidance scale), 等价于普通条件采样, 会放大”条件方向”的差异。直觉上, 是”条件 让噪声预测偏离无条件预测的方向”,把这段差异乘以 再叠加回去,相当于沿着”更符合条件”的方向外推。 越大,生成结果越贴近条件,但样本多样性下降、过饱和与伪影增加; 太小则条件约束不足。DiT 论文报告最佳 FID(2.27)时使用 ,而论文展示的高引导样本往往用 生成——这也说明 不是越大越好: 附近在”贴合类别”与”样本多样性”之间更平衡, 更强调条件一致性。
CFG 的分数解释:为什么它等价于”强化条件概率”
从上面 score matching 的视角看,CFG 有一个很清晰的解释。由贝叶斯公式:
左侧是”条件后验的分数”,右侧是”条件分布的分数”减去”无条件分布的分数”。而扩散模型输出的 正是分数的负缩放,因此上式两端可以直接用噪声预测差来表达——这正是 CFG 公式括号内那一项的来历。乘上 相当于把”条件与无条件的分数差”放大,即沿着 的方向走得更远,得到的样本对条件 的依赖更强。
这个解释也说明了 CFG 的失效边界:当 很大时,外推会把分数场推出训练分布覆盖的范围,模型在那些点上的预测不再可信,样本会出现饱和、纹理异常等伪影。图像生成中常见的 范围大致是 1.5 到 7,超过这个范围质量下降明显。
为什么它改变了推理成本结构
CFG 的代价是每次去噪要算两份预测。工程上通常把”有条件”与”无条件”拼成一个 batch 一起前向,这样权重读取只发生一次,GPU 利用率反而更高;但它仍然让单步计算量翻倍。这个”成对计算”模式在 dLLM 服务里也有直接对应:当同一条推理请求需要同时跑多个”条件版本”(例如同一输入按不同约束或不同引导强度生成),能否把它们拼进同一个 batch 一起前向,决定了一次权重读取能摊到多少份计算上——这正是第二篇之后要讨论的 dLLM 调度问题之一。
到这里,连续扩散模型的全部关键组件都齐了:加噪日程、噪声预测、DDIM/Flow Matching 采样、DiT 主干、adaLN 条件注入、CFG 引导与工程实现。接下来把这些迁移到离散的语言 token 上。
从连续到离散:这套机制如何迁移到语言模型
图像扩散处理的是连续值像素(或 latent 向量),加噪是加高斯噪声。语言 token 是离散的,不能加高斯噪声,也没有”部分噪声”的概念。这就引出了 dLLM 的核心问题:离散空间里,什么是”噪声”、什么是”去噪”、什么是”时间步”?
这个问题的答案有几种路线,最主流的是”掩码扩散”(masked diffusion):把”加噪”定义为”把 token 替换为特殊的 MASK 符号”,把”去噪”定义为”把 MASK 替换回正确 token”。给定混合了 MASK 与真实 token 的序列,模型学习”在每个 MASK 位置应该放什么 token”。当全部位置都是 MASK 时,状态就等价于”最大噪声”。这个机制的细节——吸收态马尔可夫链、时间步的离散化、块内并行与块间自回归的组合、以及配套的 KV 缓存结构——留到下一篇展开。
在本篇的框架下,可以先把 dLLM 看成三步迁移:
- 状态空间:从 的连续向量变为词表上的离散 token 序列;
- 噪声过程:从高斯加噪变为”逐步将 token 替换为 MASK”,噪声日程是”每步替换多少比例”;
- 去噪网络:从 DiT/U-Net 变为 transformer,输入是被部分掩码的序列、输出每个位置在原词表上的分布;时间步通过全局条件注入(常沿用 adaLN 的调制思路)。
值得提前指出的一个结构差异:图像扩散中,所有像素在每个时间步都同时被加噪;而语言扩散中,被掩码的位置在每一步变化,且模型输出的分布要”同时”服务于所有位置。这直接导致两个工程后果——注意力掩码与 KV 缓存如何按”被掩码位置”组织,以及如何选择哪些 MASK 在这一步”确定下来”。这些是 dLLM 推理优化最核心的问题。
小结与下一篇
本篇把扩散模型从 DDPM 到 Flow Matching 的数学主线走了一遍,关键结论如下:
- DDPM:前向链有闭式 ,反向链用网络预测噪声,训练损失是 ELBO 的加权噪声回归近似;采样需要 步随机迭代。
- 闭式后验: 是高斯,给出反向步骤的解析形式;这也解释了为什么”预测噪声”等价于”预测 ”。
- EDM 视角:把扩散看成”数据 + 噪声”的加权组合,预测噪声只是众多等价参数化之一;设计噪声日程与时间步网格是核心。
- DDIM:在不重新训练的前提下,把随机反向链改成确定性轨迹,允许跳步,把采样压缩到几十步;本质是”预测 再按新时刻重新混入噪声”。
- Score matching:加噪分布的分数与噪声估计直接相关,扩散采样等价于沿分数场做 ODE 积分;这给后续速度场方法提供桥梁。
- Flow Matching:构造条件路径、直接回归条件速度,无需 ELBO;直线路径可以让采样步数更低。
- DiT:用 ViT 主干替换 U-Net,用 adaLN-Zero 把全局条件(时间步、类别)以调制方式逐层注入,在论文扫描的范围内扩展趋势清晰;它也为 dLLM 的模型架构提供了重要参照。
- 迁移到语言:连续加噪换成掩码替换,模型输出从连续噪声变为词表分布,注意力与缓存要按掩码位置组织。
下一篇文章将进入 dLLM 的具体机制:掩码离散扩散的前向/反向过程如何定义、吸收态是什么、块并行解码(半自回归)如何把”整块同时去噪”与”块间依赖”结合起来、KV 缓存如何为被掩码的位置保留位置、以及 Dream、LLaDA 等模型在结构上的差异。本站已有几篇从推理优化角度拆解扩散模型的文章——例如 TEAM 完全拆解:时空一致性引导专家激活,MoE 扩散语言模型推理加速 2.2 倍、DFlash 块扩散解码:以并行扩散替代自回归草稿,实现无损 6 倍推理加速、动作条件世界模型完全拆解:当视频生成模型学会同时输出动作,它们都建立在本文的连续扩散机制之上,适合在读完本篇后按需要延伸。
参考资料
- Denoising Diffusion Probabilistic Models (DDPM)
- Denoising Diffusion Implicit Models (DDIM)
- Elucidating the Design Space of Diffusion-Based Generative Models (EDM)
- Flow Matching for Generative Modeling
- Scalable Diffusion Models with Transformers (DiT)
- High-Resolution Image Synthesis with Latent Diffusion Models
- Improved Denoising Diffusion Probabilistic Models
- What are Diffusion Models? — Lilian Weng 综述博客
- Score-Based Generative Modeling through Stochastic Differential Equations
- Flow Straight and Fast: Learning to Generate and Transfer Data with Rectified Flow
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



