


视觉基础模型的三种提示接口:SAM、SigLIP 与 Depth Anything 如何把「任务」变成「输入」
从「一任务一模型」到「一个模型多种问法」
2020 年之后,多模态模型的技术叙事几乎都围绕文本与图像如何对齐展开:CLIP 把图片和一个句子放进同一个嵌入空间,BLIP 系列学会给图片写描述,LLaVA 把视觉特征塞进语言模型的前端,扩散模型学会按提示词画图。这些工作共享一个前提——视觉系统最终服务于文本。文本是 prompt,图像是条件,理解与生成都在文本接口上进行。
视觉任务本身还有另一条演化线,它不经过文本,也不需要生成:给定一张图,输出一个掩码、一张深度图、一组对应关系、一个检测框。这类任务的输出空间是像素、几何量或者二维结构,文本不是它们的自然表示。过去十年里,这条线一直由一堆互相独立的专用模型组成——分割是 Mask R-CNN,深度是单目深度估计网络,姿态是关键点回归,检测是 Faster R-CNN 或 DETR。每个任务一个模型、一套标注、一条训练流水线。
2023 年之后,这条线也被基础模型化了。同一套 ViT 主干、同一种预训练范式,被改造成能接受不同「问法」的通用视觉模型。Promptable segmentation(可提示分割)是其中最典型的一种:模型不再为每个任务重新训练,而是在推理时接收点、框、掩码、文本这些提示,返回对应的分割结果。SAM 与 SAM 2 是这条线的代表;SigLIP 走另一条路——把视觉编码器本身训练成通用的、可与语言对齐的特征源,供检索、检测、VLM 前端复用;Depth Anything 展示了第三条路:用大规模无标注图像把单目深度估计做成一个零样本可迁移的任务。
这篇文章只讲这三条路线的模型原理与架构:提示接口如何定义,图像编码器与提示编码器如何分工,掩码解码器为什么长成那个形状,推理时每一步在算什么。训练数据配方与训练策略不在讨论范围内,只在影响推理结构时用一句话交代。
先排除一个容易混淆的定位问题:这三类模型与 LLM、ViT、VLM 不在同一层。ViT 是主干,VLM 是把视觉接入语言模型的系统,而这里讨论的是视觉任务本身的基础模型——它们的输出不是 token,而是像素级或几何级的量。看清它们的接口设计,也就看清了为什么视觉侧的基础模型与语言侧长得不一样。
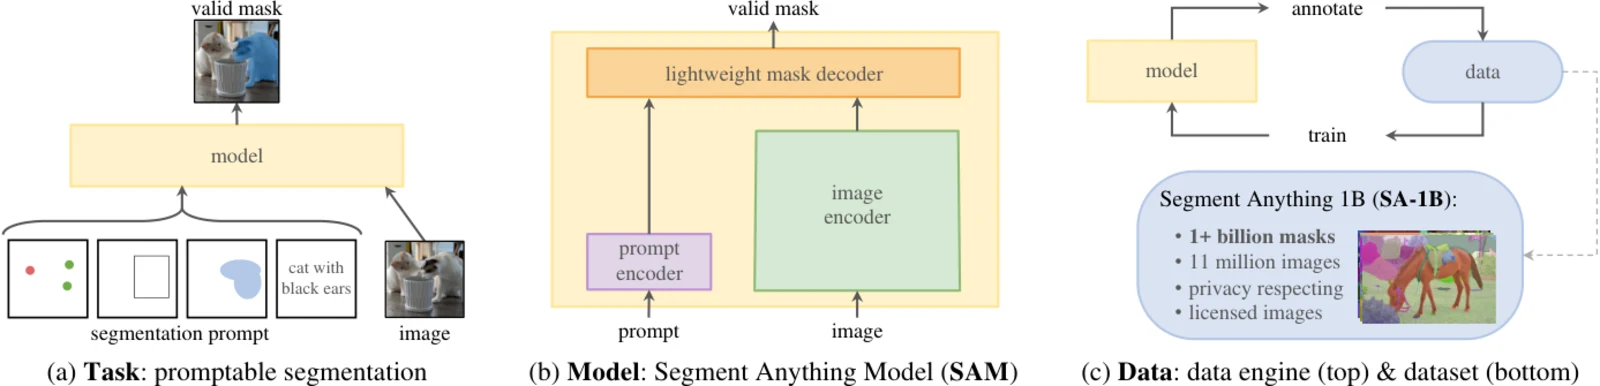
上图是 SAM 论文的概览图:左侧演示一个提示(点、框、文本)如何同时产生多个有效掩码,右侧是数据引擎的三阶段循环。它把这一路线的两个核心要素摆在了一起——提示接口决定模型怎么被调用,数据引擎决定模型见过多少种「问法」。
(图源:Segment Anything 论文 teaser,Meta AI,2023)
一、Promptable Segmentation:把任务编码成提示
1.1 分割任务的输入输出与三类子任务
在经典定义里,分割的输入是一张图像 ,输出是一个与图像同尺寸的二值掩码 。不同子任务的区别只在于「要分出什么」:
- 语义分割:给每个像素一个类别标签,输出 的类别图;
- 实例分割:分出每个物体实例,输出一组掩码,每个掩码对应一个实例;
- 交互式分割:用户在图上点几下或画一个框,模型把框内的目标抠出来。
传统做法把三者当成不同的学习问题。Mask R-CNN 用检测框加掩码分支把实例分割做成两阶段回归,交互式分割则依赖 GrabCut 这类图割算法或者基于点击的专用网络。这些方案把「模型结构」与「任务结构」硬绑在一起:任务变了,结构就得改,标注也要重做。
Promptable segmentation 的转置点在于:把「要分什么」从模型的结构里挪到推理时的输入里。用户给一个点,模型就分那个点所在的物体;给一个框,模型就分框内的物体;给一段文本「黄色的校车」,模型就分符合描述的物体。模型结构不变,变的只是提示的类型与数量。
这个转置有代价:模型必须被训练成能理解这些提示的语义,而不是被动执行一个固定任务。提示本身也要被编码成向量,与图像特征一起进入解码器。这引出了 SAM 的三段式分工。
1.2 SAM 的三段式拆分与摊销
SAM,即 Segment Anything Model,由 Meta AI 在 2023 年 4 月发布,论文为 Segment Anything,同年发表于 ICCV。它的结构清晰地分成三块:
- 图像编码器(image encoder):重量级 ViT,把图像编码成特征图;
- 提示编码器(prompt encoder):把点、框、掩码、文本编码成提示向量;
- 掩码解码器(mask decoder):轻量 Transformer 解码器,融合图像特征与提示向量,输出掩码。
这个分工的核心动机是摊销(amortization):图像编码器很贵,但一张图只需编码一次;提示编码器与掩码解码器很便宜,可以针对同一份图像特征反复执行不同提示。这正是「可提示」在工程上可行的原因——如果每次提示都要重新编码整张图,交互式分割的延迟会彻底不可接受。
用延迟账来算:ViT-H 编码器有 632M 参数,在 A100 上编码一张 1024×1024 图像大约要几十毫秒;掩码解码器只有约 4M 参数,单次提示解码在毫秒级。用户在图上追加一个点,只需重跑解码器。这个「一次编码、多次解码」的结构,是后来 SAM 2、MobileSAM、EfficientSAM 所有加速工作的共同出发点。
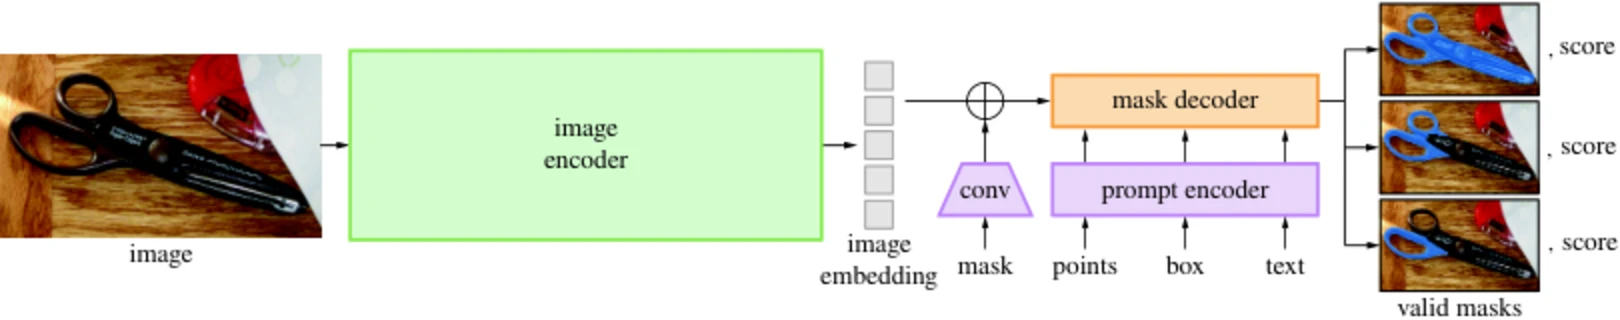
上图的三个子画面分别对应三段:左端是图像进入编码器得到 embedding,中间是点、框、文本进入提示编码器,右端是掩码解码器同时输出掩码与质量分数。注意图中「image embedding」只出现一次,而提示与解码部分可以在同一份 embedding 上反复执行——摊销结构在图上就是一条单向箭头。
(图源:Segment Anything 论文 Figure 4,Meta AI,2023)
1.3 图像编码器:ViT-H 与窗口注意力
SAM 的图像编码器是一个 ViT-H/16:patch 大小 16×16,宽度 1280,24 个 Transformer block,约 632M 参数。输入被缩放到 1024×1024,patch 数 ,每个维度 64 个 patch,共 4096 个 token。输出再经过一个 1×1 卷积降维到 256 通道,并重排成 的特征图。
如果按标准 ViT 的做法做全局自注意力,4096 个 token 的注意力矩阵规模是 ,单层就要处理约 1600 万个注意力元素,显存与计算都难接受。SAM 的处理方式与 Swin 类似:大部分 block 使用窗口注意力,窗口大小为 14×14(共 196 个 token),只在少数 block 上做全局注意力。论文中的配置是 24 个 block 里每隔一定间隔插入全局注意力,让信息能够在窗口之间流动。
这里有一个与推理直接相关的细节:图像分辨率的固定性。SAM 强制把输入缩放到 1024×1024,长宽比失真由预处理承担。这个选择简化了位置编码与窗口划分(64×64 的网格可以整齐地切成 14×14 窗口,再加 padding),但代价是小目标在缩放后可能只剩几个像素,边界质量下降。后续工作把这一点当作主要改进方向之一。
1.4 提示编码:点、框、掩码、文本四条通路
SAM 支持四类提示:点、框、掩码、文本。前三类是几何提示,第四类是语义提示。它们的编码路径各不相同。
点提示。每个点带有坐标 与标签(前景或背景)。编码方式是位置编码加标签嵌入:坐标经过正弦位置编码映射成向量,标签经过一张可学习的嵌入表映射成另一个向量,两者相加。位置编码的公式与 Transformer 中的形式一致:
其中 先被归一化到 , 是嵌入维度(SAM 中为 256), 是维度索引。归一化很重要:位置编码的波长随维度指数增长,如果直接用像素坐标,高频维度会在不同的图像分辨率下重复折叠,模型就无法建立稳定的「位置—编码」对应。归一化把坐标压在同一个尺度上,同一相对位置在任何分辨率下都得到同一编码。
前景与背景的标签嵌入则回答「这个点要不要」。同一个位置,点一下是「要这个物体」,点两下(一正一负)可能表示「要这个、不要那个」。标签嵌入让模型区分这两种语义,而不是只看坐标。
框提示。一个框由左上与右下两个角点确定。SAM 的处理是把两个角点当作两个特殊位置提示,各自做位置编码,再加上一个可学习的「角点类型嵌入」——左上角与右下角各一张嵌入表。也就是说,框不是被编码成一个整体向量,而是拆成两个带类型标记的点,与点提示共享同一套编码通路。这个设计的好处是框提示与点提示可以在同一序列里混合,用户既可以给框再加一个修正点,也可以给多个框。
掩码提示。用户可以直接给一个粗糙掩码,让模型在此基础上细化。编码方式是:把掩码下采样到 ,经过几层卷积得到 的特征图,再与图像 embedding 逐元素相加。这里的关键设计是掩码提示与图像特征空间对齐,加在编码器输出的特征图上,而不是当作独立 token 序列。掩码本身就是空间信息,用卷积保留空间结构比打成序列更自然,也避免了解码器再去学习「token 对应哪个像素」的映射。
文本提示。SAM 原版用 CLIP 的文本编码器处理文本提示,但论文的主要能力集中在几何提示上:模型被训练成「给定位置,精确划分边界」,而不是「根据语义找位置」。后续的 Grounded SAM 把开放词汇检测器与 SAM 拼起来,先用检测器根据文本找到框,再把框喂给 SAM 做精细分割。这个拼法本身说明一个架构事实:语义定位与边界细化是两种能力,前者依赖语言对齐的模型,后者是 SAM 的强项。把两者串成流水线,比要求单个模型同时具备两种能力更现实。
1.5 掩码解码器:两层 block、三类 token 与上采样点积
掩码解码器是 SAM 里最值得细看的部分。它的输入有三组:
- 图像特征 ;
- 提示 token 序列 ,包含点/框编码后的稀疏提示;
- 掩码提示特征(如果有)。
输出是对应每个候选的掩码与 IoU 预测。解码器只有两层 Transformer block,每层做两件事:先让 token 对图像特征做交叉注意力(token 作 query,图像特征作 key/value),再让 token 之间做自注意力。顺序很重要:先看图像,再看彼此。每个输出 token 先吸收局部图像信息,再在 token 之间协调,避免在还没有视觉证据时就互相影响。
解码器里有两类可学习 token:
- IoU token:一个可学习向量,经过解码器后由一个线性头输出标量,预测当前掩码与真值的 IoU。它的作用是让模型对多个候选排序。
- mask token:若干个可学习向量(默认 3 个),每个最终通过一个小的上采样网络映射成一张掩码。
第二层 block 结束后,所有 mask token 共享一条转置卷积上采样路径: 特征先放大到 ,再与图像特征做点积,得到最终掩码。用点积而不是再过一层卷积,是因为点积就是「特征与掩码嵌入的相似度」,与分割的语义直接对应:
其中 是第 个 mask token 上采样后在像素 处的向量, 是图像特征在 处的向量, 是逐像素 sigmoid,输出每个像素属于该掩码的概率。这个形式把「分割」写成了「特征空间里的内积阈值」,与度量学习是同一套语言。
整个解码器的参数量很小,这是刻意选择。轻量解码器意味着可以针对每个提示快速重跑,也意味着模型的主要容量放在图像编码器里——图像理解贵、提示理解便宜,资源分配与任务结构匹配。
1.6 歧义感知的多掩码与 IoU 头
SAM 的训练数据里有大量「一个提示可能对应多个合理掩码」的样本。用户在衣服上点一个点,这个点可能指向整件衣服、衣服上的图案、或者穿着衣服的人。如果只输出一个掩码,模型必须在这三者中选一个,而这个选择没有唯一正确答案。
SAM 的解法是输出多个掩码(默认 3 个)并各自给出 IoU 预测,让下游按场景选择。推理时表现为:模型返回 3 个 mask 与 3 个 score,调用方可以取分数最高的,也可以按面积、位置等规则挑选。歧义感知的输出结构承认了一个事实——提示本身不含足够信息唯一确定目标,消歧的一部分责任应交给下游。
这与语言模型里的 top-k 采样有相似的结构直觉:输入不足以唯一确定输出时,输出一个分布比输出一个点更诚实。区别在于 SAM 的候选是离散可枚举的,每个还附带一个质量分数,下游可以用阈值直接过滤。
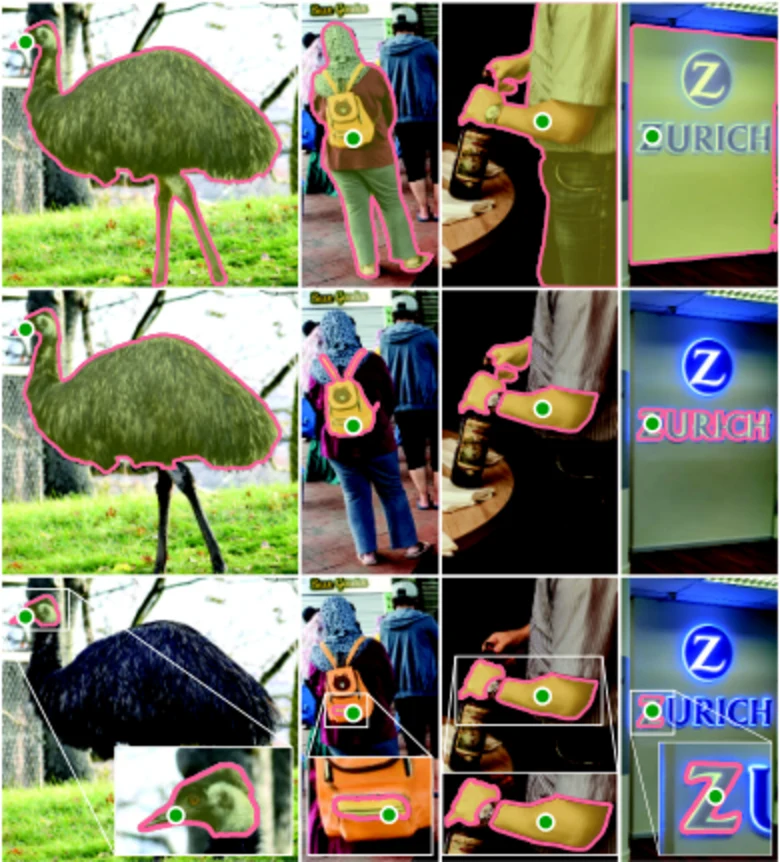
上图是论文中歧义场景的示例:同一个提示在不同粒度上都能给出「合理」的掩码,三个候选分别覆盖整体、部件与更小的子部件。这类样本决定了模型必须保留多输出头,而不是在训练时强行回归到单一答案。
(图源:Segment Anything 论文歧义示例,Meta AI,2023)
1.7 SAM 2:把记忆变成提示的一部分
SAM 在图像上可提示,视频分割则面临新问题:目标在帧间移动,用户不可能每帧点一次。SAM 2(SAM 2: Segment Anything in Images and Videos,2024 年 7 月)把「过去帧的掩码」当作一种提示,让模型在视频里追踪目标。
架构改动集中在三点:
- 记忆库(memory bank):保存过去若干帧的掩码与特征;
- 记忆注意力(memory attention):当前帧的图像特征先与记忆特征做交叉注意力,把历史信息注入;
- 流式处理:帧按顺序处理,每帧输出的掩码又成为下一帧的提示。
三者组合后,「视频分割」变成「带记忆的图像分割」:每帧解码仍是一次提示解码,只是提示里多了一份来自历史的掩码与特征。图像编码器仍然是每帧一次,但记忆的读取与写入远比重跑整段视频便宜。
SAM 2 还换了图像编码器,改用 Hiera 结构的层次化 ViT。层次化设计在浅层保留高分辨率特征,对掩码边界有利,同时用更强的下采样控制计算量。这个选择与视频场景直接相关:帧数多,单帧编码成本必须压下来,否则整个流式管线的吞吐会被编码器吃掉。
记忆带来一个新的成本维度:记忆库越大,追踪越稳,显存与注意力计算也越贵。工程上常见的做法是限制记忆帧数,并对远距离帧做特征压缩。这与 LLM 的 KV 缓存管理在结构上同构——都是在「保留历史」与「控制成本」之间划一条线。
1.8 一次调用的完整链路与成本分解
把结构串起来,SAM 的一次推理调用大致是:
输入:图像 I,提示 P(点 / 框 / 掩码 / 文本)1. 预处理:缩放 I 到 1024×1024,归一化2. 图像编码:F_I = ViT(I) // 64×64×256,一次,可缓存3. 提示编码: - 点 / 框 → 位置编码 + 类型嵌入 → 稀疏 token - 掩码 → 卷积下采样 → 与 F_I 相加 - 文本 → CLIP 文本编码器 → token4. 解码:T = [IoU token, mask token × 3, 稀疏提示 token] 两层 block:交叉注意力(F_I) → 自注意力 mask token → 4× 转置卷积 → 与 F_I 点积 → 3 张掩码 IoU token → 线性头 → 3 个分数5. 输出:3 张候选掩码 + 3 个质量分数链路里有一个值得利用的性质:步骤 2 与步骤 3–5 的耦合很松。图像特征可以缓存,同一张图的多个提示可以并发解码。在生产环境里,这意味着编码可以放在 GPU 上做一次,解码可以放在更便宜的算力上反复执行。SAM 的部署优化大多围绕这个性质展开——缓存编码结果、把解码批处理、把提示的校验与坐标变换放在 CPU 侧。
成本分解也很清楚:单次交互的端到端延迟 = 一次编码 + 次解码 + 传输与调度开销。当 变大(用户在图上反复点击),编码被摊薄,系统吞吐趋近于解码吞吐。这个模型解释了为什么「首点延迟」和「后续点击延迟」在产品上要分开度量:前者由编码器决定,后者由解码器与调度决定。
二、SigLIP:把视觉编码器训练成语言对齐的通用特征源
2.1 CLIP 的 softmax 对比损失与它的结构性代价
SAM 的提示接口解决「几何提示如何进入模型」,SigLIP 解决另一个问题:视觉特征如何与语言语义对齐,并且对齐得足够便宜。
CLIP(Learning Transferable Visual Models From Natural Language Supervision,2021 年)用双塔对比学习:图像塔与文本塔各自编码,在一个 batch 内做 InfoNCE。对 batch 中 个图文对,图像 与文本 的相似度记为 ,损失为:
其中 是温度系数,、 是归一化后的图像与文本嵌入。这个损失要求 batch 内所有负样本参与归一化,工程后果有两个:batch 必须足够大才有足够多负样本;归一化需要整个 batch 的相似度矩阵,多设备训练时必须跨设备同步。
为了数值稳定,softmax 还要减去每行的最大值;在分布式实现里,这意味着额外的通信与一次全局遍历。memory 方面, 的相似度矩阵在 达到十万量级时非常可观,batch 规模的扩张因此被实现成本限制住。
2.2 sigmoid 损失:把对比学习拆成逐对二分类
SigLIP(Sigmoid Loss for Language Image Pre-Training,2023 年,ICCV 2023)的改动很小但很关键:把 softmax 换成对每个图文对独立的 sigmoid 二分类。对图文对 ,定义标签 当 ,否则 ,损失为:
其中 是 sigmoid, 是可学习的温度(实现中参数化为 ), 是可学习的偏置。偏置的作用是补偿正负样本比例失衡:一个 batch 里正样本只有 个,负样本有 个,初始阶段负样本的梯度会压倒正样本,模型会把所有相似度往下压。论文把 初始化为 , 初始化为 ,让训练起点接近「正样本匹配、负样本不匹配」的先验,避免起步阶段的大幅震荡。
这个损失不再需要 batch 内全局归一化,每个图文对的损失独立计算,因此不需要跨设备同步整个相似度矩阵。论文的收益表述是:相同计算量下,SigLIP 用更小的 batch 就能达到与 CLIP 相当或更好的零样本精度,且实现上更省内存。
从推理角度看,这个改动没有改变模型结构,只改变了训练目标。它的下游影响很大:SigLIP 的视觉塔在相同规模下通常更容易训好,因此后续大量 VLM 选择 SigLIP 作为视觉编码器。
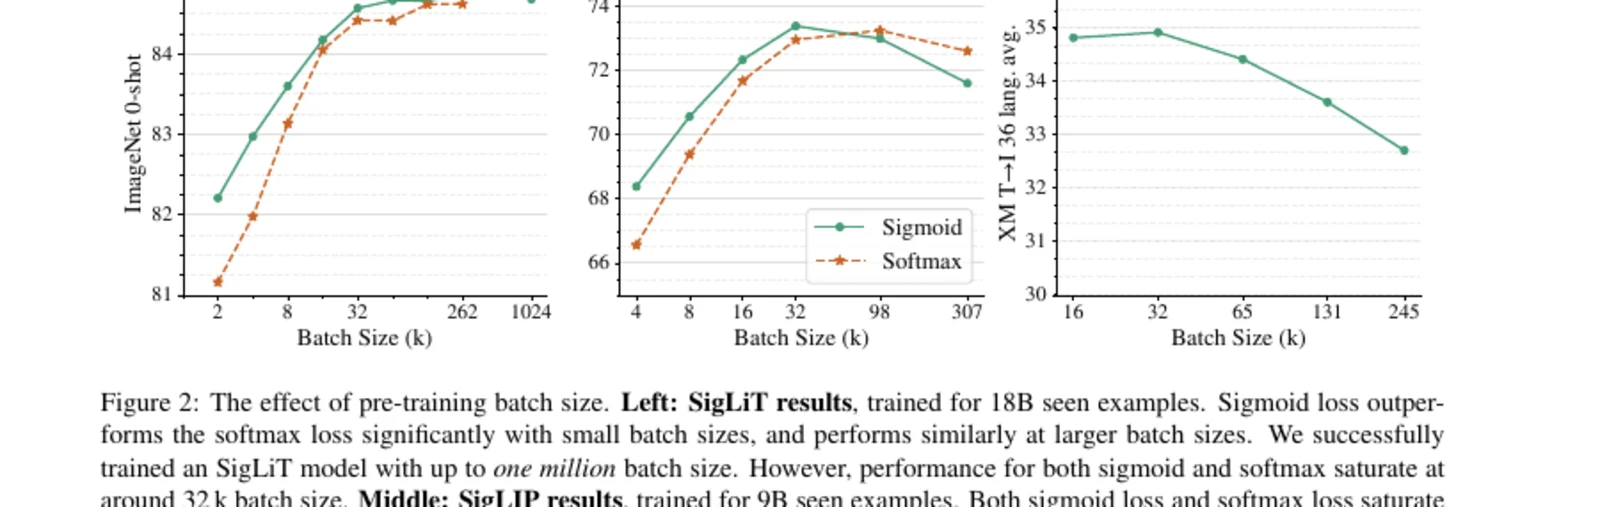
上图是论文中 batch 规模与迁移精度的关系:小 batch 区间 sigmoid 损失明显优于 softmax,batch 增大后两者收敛到相近水平。曲线也说明了一个工程事实——sigmoid 损失把「batch 规模」从损失函数的定义里解耦了,batch 小不再直接损害训练目标的结构。
(图源:SigLIP 论文 Figure 2,Google DeepMind,2023)
2.3 双塔结构与池化、投影的细节
SigLIP 的架构是标准双塔:
- 图像塔:ViT,把图像切成 patch,经若干 Transformer block,取出池化特征,再投影到共享嵌入空间;
- 文本塔:Transformer,把文本 token 编码,池化后投影到同一空间。
几个实现细节值得点出。图像塔的池化通常取 [CLS] token 或者对 patch token 做注意力池化;文本塔则在序列末尾追加一个 [EOS] token,用它的输出作为句向量。两塔的输出各自经过一个线性投影(有时带 LayerNorm),再做 L2 归一化,最后计算点积。归一化的作用是把相似度限制在 ,让温度参数的尺度在不同 batch、不同模型规模之间保持一致。
不同规模的 SigLIP 使用不同的图像塔:SigLIP-B 用 ViT-B/16,SigLIP-L 用 ViT-L/16。后续的 SigLIP 2 与 SoViT 变体引入 NaFlex(native resolution, flexible sequence length)设计,允许模型处理不同长宽比与分辨率的输入而不强制缩放,代价是序列长度可变,需要注意注意力成本随分辨率平方增长。
SigLIP 在系统中的角色要单独强调:它本身不输出掩码、不输出深度,只输出特征向量。但在视觉流水线里,这个向量是许多下游任务的起点——检测头、检索索引、VLM 的视觉前端都吃它。因此 SigLIP 的推理成本直接决定整条流水线的成本基线。
一个具体的成本结构:SigLIP-L/16 处理 384×384 图像,序列长度 ,经过 24 层 ViT-L,前向 FLOPs 在 量级(具体取决于实现与精度)。若下游 VLM 的输入分辨率是 896×896,patch 数变成 3136,编码成本上升约 5.4 倍。这就是高分辨率 VLM 的视觉编码阶段往往成为整条推理链路瓶颈之一的原因。站内拆解 VLM 视觉前端如何消费这些特征的系列文章可参考 多模态大模型的四种融合机制,以及 vLLM 的多模态输入链路。
2.4 语言对齐特征的三种用法
SigLIP 的输出是一个 维向量(常见 或 ),可以在三种位置被使用。
零样本分类与检索。图像特征与一组文本特征做点积,取最大相似度对应的文本作为类别。这条路径不需要任何下游训练,把 SigLIP 当分类器用。推理成本是「一次图像编码 + 次文本编码」,文本特征可以预计算并缓存,在线成本只剩图像编码与点积。
作为检测或分割模型的特征骨干。把 SigLIP 的 patch 特征图取出来,接一个轻量检测头或分割头,就得到开放词汇检测器。这条路径依赖 SigLIP 的 patch 特征保留了空间结构—— 的网格可以被下游头像 CNN 特征图一样消费。Grounded SAM 一类流水线正是按这个思路把语言定位与 SAM 的边界细化接起来。
作为 VLM 的视觉前端。把 patch 特征经投影层映射到语言模型的嵌入空间,与文本 token 拼接后送入 LLM。投影层通常是两层 MLP 或一个线性层。这条路径是当前主流 VLM 的标准做法,其成本结构在 SGLang 多模态输入拆解 里有更细的账。
三种用法共享同一个视觉编码器,但接口不同:检索要全局向量,检测要 patch 网格,VLM 要与文本 embedding 同维的 token 序列。SigLIP 的设计让三种接口都能从同一个编码器导出,这正是「基础模型」在视觉侧的含义——不是某个任务做得好,而是同一份特征可以被多种任务读取。
2.5 SigLIP 2 的演进方向
SigLIP 2(2025 年)在保持 sigmoid 损失框架的前提下改了几处结构:加入 caption 预训练与自蒸馏,把定位与稠密预测能力显式纳入训练目标;图像塔转向 SoViT 变体并支持 NaFlex,使同一模型可以处理从 224 到更高分辨率的输入;文本塔支持多语言。这些改动的共同指向是「一个编码器服务更多下游」,与本文的主题一致。
对推理系统而言,SigLIP 2 带来的主要变化是输入尺寸的弹性。固定分辨率时代的成本估算是「分辨率 → 序列长度 → FLOPs」的简单映射;NaFlex 之后,序列长度由实际 patch 数决定,调度器需要按请求动态估算成本,批处理时也要处理变长序列。这会让视觉编码阶段的 batch 组队策略更像 LLM 的变长序列调度。
三、Depth Anything:把单目深度变成零样本任务
3.1 监督信号才是瓶颈
单目深度估计的输入是一张 RGB 图,输出一张与图像同尺寸的深度图,每个像素对应一个深度值。难点不在网络结构,而在监督信号:真实深度需要激光雷达或结构光采集,成本高、覆盖场景有限。早期方法要么依赖合成数据,要么依赖立体匹配生成伪标签,规模都被数据采集卡住。
Depth Anything(Depth Anything: Unleashing the Power of Large-Scale Unlabeled Data,2024 年 1 月,CVPR 2024)的主张是:用大规模无标注图像加上强预训练编码器,把单目深度估计做成零样本可迁移的任务。它的做法不是发明新结构,而是把「数据规模」与「编码器容量」两个杠杆拉到最大——论文使用了约 6200 万张无标注图像。
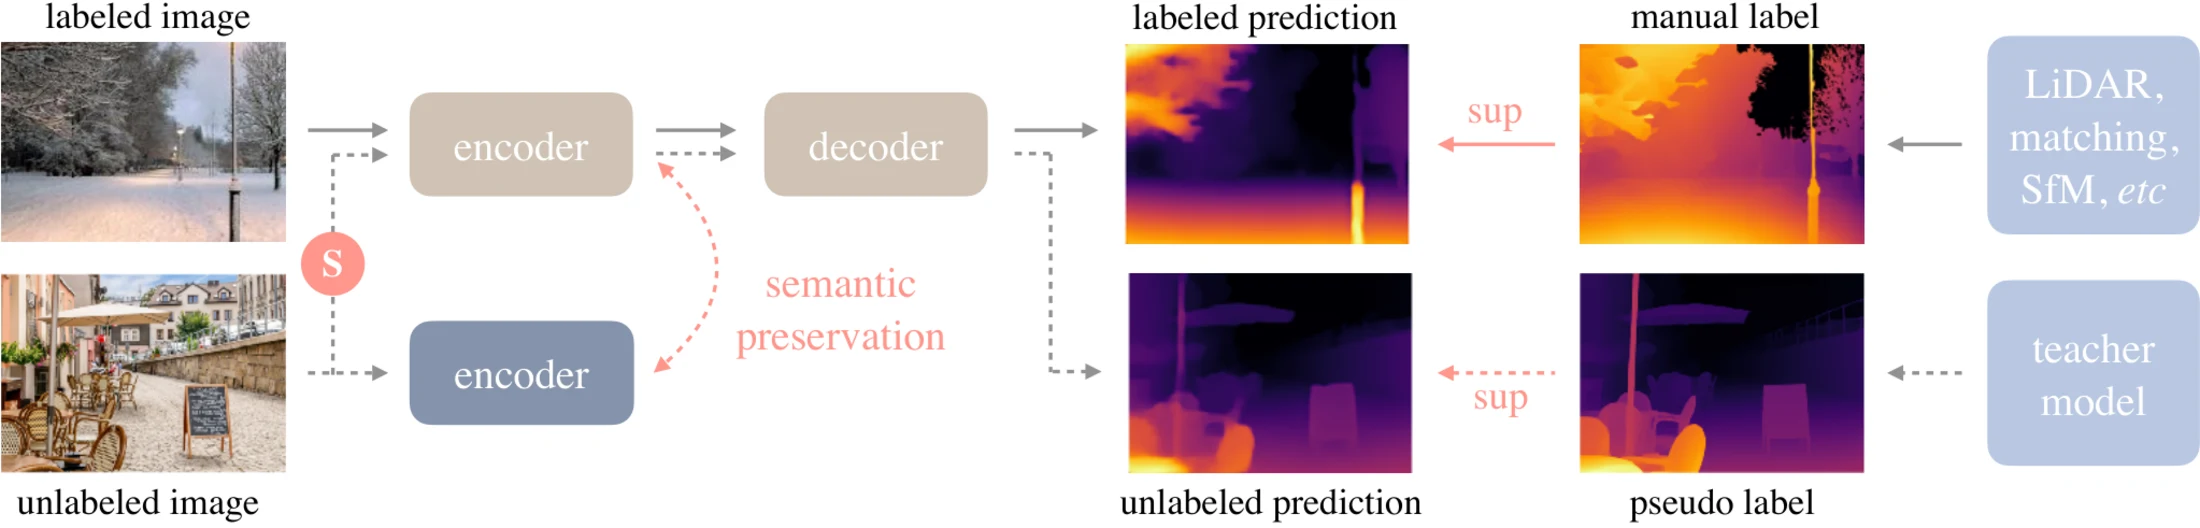
上图是论文的训练管线示意:实线表示标注数据(立体或 SfM 生成的深度)流动,虚线表示无标注数据(预测得到伪标签)流动。左半边「labeled image → labeled prediction → manual label」与右半边「unlabeled image → unlabeled prediction → pseudo label」是两条并行的监督通路,最终一起进入编码器—解码器的监督。这条管线解释了为什么「无标注数据」能进入深度任务:伪标签把无标注图像变成可训练的样本,规模瓶颈由此松动。
(图源:Depth Anything 论文 Figure 2,2024)
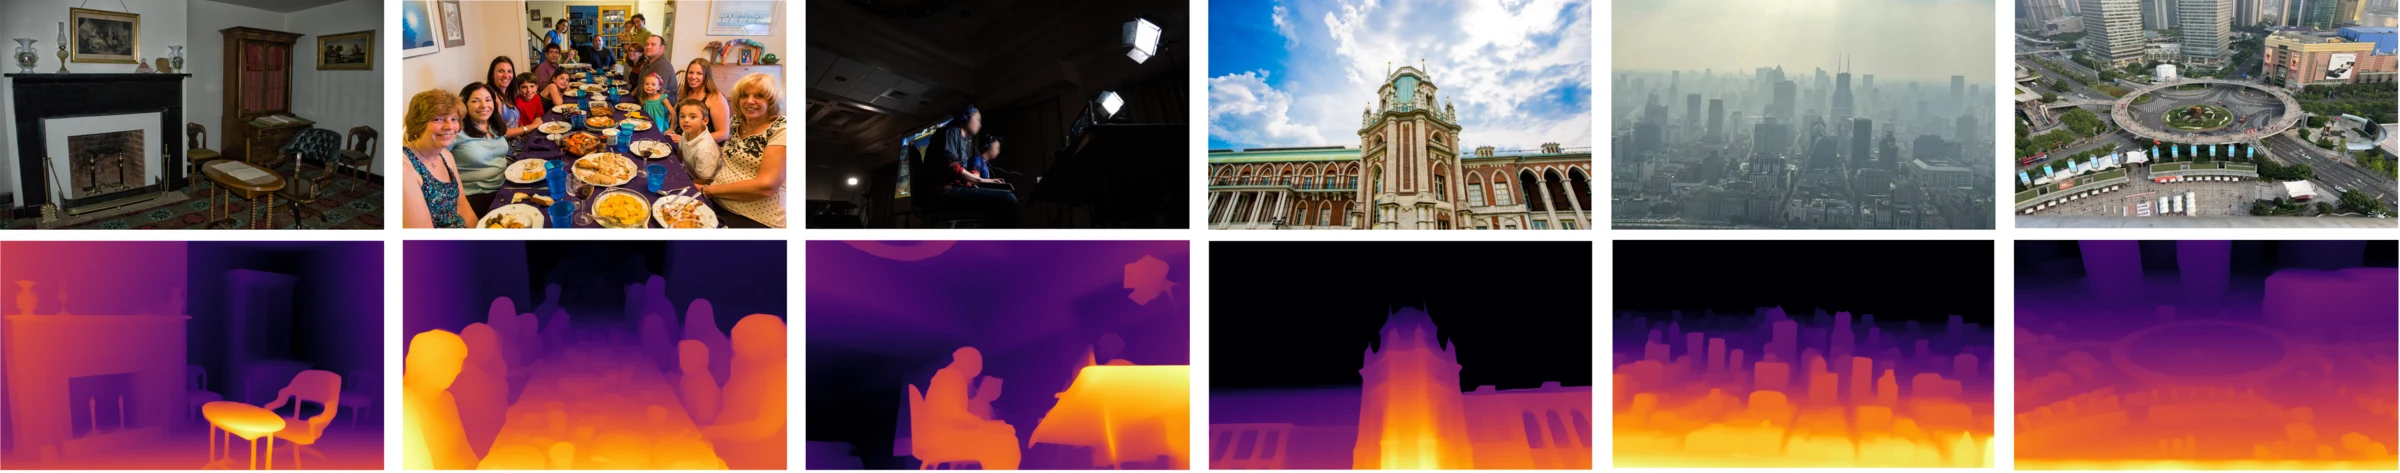
上图展示了模型在多个未见场景上的深度预测:室内、室外、低光照与复杂结构都在同一套参数下给出相对合理的深度。这类定性结果说明的是泛化边界,而不是精度上限——单目深度的绝对尺度始终需要外部信息校准。
(图源:Depth Anything 论文 Figure 1,2024)
3.2 DINOv2 编码器加 DPT 解码器
Depth Anything 的结构非常简洁:
- 编码器:DINOv2 的 ViT(ViT-S/B/L/G),这是一个自监督预训练的视觉模型,本身不含任何深度信息;
- 解码器:DPT(Dense Prediction Transformer)风格的解码器,把 ViT 的多层特征取出,重组并逐级上采样,融合成深度图。
DPT 解码器的关键设计是多尺度特征融合。ViT 的每一层输出都保留下来,各自重组成二维特征图(把 token 序列按 patch 网格 reshape,再插值到目标尺度),然后从深到浅逐级上采样、拼接、卷积。浅层特征分辨率高、语义弱,深层特征分辨率低、语义强,融合后的特征同时具备边界细节与语义一致性。推理成本主要来自 ViT 编码器,解码器是轻量的,所以一次深度预测的成本约等于一次 ViT 前向。
这里可以对照 扩散模型从零讲起(四) 里讲过的 VAE 解码:两者都在做「低分辨率特征 → 高分辨率像素」的映射,但 DPT 不做生成式重建,而是直接回归几何量,因此不需要采样循环,延迟结构完全不同。
3.3 语义先验为什么对深度有用
Depth Anything 论文里有一个重要观察:DINOv2 的语义特征对深度估计有直接帮助。原因是单目深度本质上是从语义与场景结构推断几何——模型需要知道「这是天空」「这是地面」「这是建筑立面」,才能从纹理、遮挡与透视关系里推断相对深度。DINOv2 的特征已经编码了这些语义信息,接一个深度头比从零训练编码器更容易泛化。
这个观察在推理层面有一个直接后果:深度模型的泛化能力来自视觉编码器的泛化能力。换更强的自监督编码器,零样本表现会跟着提升。Depth Anything V2 沿这条线走:用更大的合成数据与更强教师模型蒸馏,在架构基本不变的情况下提升零样本精度,并用更小的模型覆盖不同延迟预算。
蒸馏在这里的作用与 LLM 中的用法不同:LLM 蒸馏通常压的是生成分布,深度蒸馏压的是几何输出与中间特征,目标函数是逐像素回归加特征对齐,学生模型学的是「怎么从图像看到几何」,而不是「怎么说」。这个区别决定了深度蒸馏可以在没有真值深度的图像上做——教师给出伪深度,学生在同一张图上对齐,数据规模可以继续放大。
3.4 相对深度、尺度歧义与部署校准
「零样本可迁移」不等于「无条件可靠」。Depth Anything 输出的是相对深度(relative depth),不是绝对米制深度。模型预测像素间的深度排序与相对比例,要转成绝对深度需要额外的尺度校准——用已知相机内参、或者一小段带标注的数据拟合尺度与偏移。这是部署时最常见的坑:直接把相对深度当米制深度用,会在测距、避障这类任务上产生系统性偏差。
训练侧使用的损失也是尺度不变的,形式大致是「对预测与真值做最小二乘的尺度与平移对齐,再算逐像素误差」:
其中 是预测视差(深度的倒数), 是真值视差, 是有效像素集合, 与 是按当前图逐次求解的尺度与平移。这个损失直接把「绝对尺度」从监督里剔除,只在图像内部约束相对结构,与模型推理时的相对深度输出一致。理解了这一点,就理解了为什么部署必须补一层校准。
另一个边界是尺度歧义:单张图没有绝对尺度线索,一张桌子的照片与一栋大楼的照片可以产生相似的深度图。模型能做的是在图像内部保持一致的相对关系,跨图像的绝对尺度必须由外部信息提供。这与 SAM 的歧义感知多掩码在结构上同源——模型输出的是一个有条件的分布,而不是无条件的确定值。
四、三条路线的共同结构
把 SAM、SigLIP、Depth Anything 放在一起看,会发现它们在架构上有共同的三段式:
- 共享的视觉编码器(ViT 或层次化 ViT),把图像变成特征;
- 轻量的任务接口(提示编码器、投影头、深度解码器),把「任务」翻译成对特征的读取方式;
- 输出头(掩码解码、相似度计算、深度回归),把特征映射到任务输出空间。
共同点是编码器重、接口轻。编码器承载绝大部分参数与计算,接口只做特征的选择与映射。这种资源分配让同一个编码器被多个任务接口复用,每个接口的成本都很低。
差异在接口形态:
| 模型 | 任务接口 | 输出空间 | 编码器复用方式 |
|---|---|---|---|
| SAM | 点/框/掩码提示编码 | 像素掩码 | 一次编码、多次提示解码 |
| SigLIP | 与文本塔共享的投影 | 嵌入向量 | 同一特征供检索/检测/VLM 复用 |
| Depth Anything | DPT 解码器 | 深度图 | 换更强编码器即提升零样本精度 |
这张表说明了「视觉基础模型」的具体含义:不是模型能做所有任务,而是模型的特征可以被多种任务接口读取。基础模型提供特征,任务接口提供读法。
还有一个共性值得点出:三者的输出都带有「条件性」。SAM 的多掩码依赖提示的粒度,SigLIP 的相似度依赖文本塔的措辞,Depth Anything 的深度依赖图像内部的相对结构。系统集成时如果把输出当成无条件的确定值,就会在边界场景里出问题。视觉基础模型的输出更像「在给定条件下最有解释力的答案」,而不是「世界的唯一真相」。
五、部署视角:三类模型在推理链路里的位置
实际系统里,三类模型的部署方式差别很大。
SAM 类模型的部署关键是图像编码的缓存与批处理。交互式分割场景里同一张图会被反复提示,编码结果必须缓存。缓存键通常是图像哈希,缓存值包括特征图与掩码提示特征。解码器可以并发处理多个提示,GPU 上的实际负载是「一次编码 + 次解码」。SAM 2 的视频场景多一层记忆管理:记忆库大小直接决定显存占用,长视频需要在记忆容量与追踪精度之间取舍。
SigLIP 类模型的部署关键是文本特征预计算与图像编码批处理。检索场景里文本查询动态、图像库静态,最优策略是预先算好所有图像嵌入并建索引,在线只算文本嵌入。VLM 场景相反:图像与文本都动态,视觉编码与语言模型前向串行执行,视觉编码延迟直接加到端到端延迟上。
Depth Anything 类模型的部署关键是分辨率与精度的权衡。深度图分辨率越高,patch 数越多,编码成本越高。许多部署场景只需要低分辨率深度,可以把输入降到 518×518 或更低,用精度换延迟。
三类模型的共同点是:编码器是成本中心,接口是调度单位。理解这一点,就能理解为什么视觉基础模型的推理优化集中在编码器加速(量化、蒸馏、稀疏化)与接口调度(缓存、批处理、并发)上,而不是在解码器上做文章。
六、小结
SAM、SigLIP 与 Depth Anything 代表了视觉基础模型的三条设计路线:
- SAM 把任务编码成提示,用「一次编码、多次解码」的摊销结构支持交互式分割,并用多掩码输出容纳提示的歧义;
- SigLIP 把视觉特征训练成语言对齐的通用特征源,让同一份特征服务检索、检测与 VLM;
- Depth Anything 把单目深度估计做成零样本任务,用大规模无标注数据与强编码器换泛化,并把绝对尺度留给下游校准。
共同结构是「重编码器 + 轻接口」:编码器承载图像理解,接口把任务翻译成对特征的读取方式。这与语言模型「重主干 + 轻采样头」在资源分配上同构,但输出空间完全不同——语言模型输出 token 分布,视觉基础模型输出像素、几何量或嵌入。
理解了这三条路线,再看多模态大模型,会更容易看清 ViT 与 VLM 在系统中的位置:ViT 是编码器,VLM 是把编码器特征接入语言模型的系统,而视觉基础模型是让编码器特征本身变得可复用的那一层。三者的关系是分层,不是替代。
参考资料
- Segment Anything — Kirillov et al., ICCV 2023
- SAM 2: Segment Anything in Images and Videos — Ravi et al., 2024
- Sigmoid Loss for Language Image Pre-Training — Zhai et al., ICCV 2023
- Learning Transferable Visual Models From Natural Language Supervision — Radford et al., 2021
- Depth Anything: Unleashing the Power of Large-Scale Unlabeled Data — Yang et al., CVPR 2024
- DINOv2: Learning Robust Visual Features without Supervision — Oquab et al., 2023
- Vision Transformers for Dense Prediction — Ranftl et al., ICCV 2021
- Swin Transformer: Hierarchical Vision Transformer using Shifted Windows — Liu et al., ICCV 2021
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



