


StyleGAN 系列架构入门:从映射网络、风格调制到等变卷积的三代演进
为什么还要单独拆解 StyleGAN
当前文本到图像模型的主流是扩散路线,但有一类生成器至今仍是「无条件图像生成」和「潜空间编辑」的重要基线:StyleGAN 系列。它由 NVIDIA 的 Tero Karras 等人从 2018 年的 StyleGAN 起,连续迭代出 2020 年的 StyleGAN2(CVPR 2020)和 2021 年的 StyleGAN3(NeurIPS 2021)。
这套架构的价值不在某个单独的算子,而在于它把「生成一张图」拆成了三层可分离的东西:一个与图像内容解耦的风格向量、一组逐层的风格调制运算、一个用卷积堆出来的多分辨率合成主干。理解这套分层之后,再看扩散模型里的 cross-attention 条件注入、MMDiT 的调制设计,以及各种「潜码加解码器」的架构,很多设计动机就能对上号。
扩散模型的基础机制可参考 扩散模型从零讲起(四):潜空间扩散与条件生成,主干演进可参考 扩散模型从零讲起(九):架构演进;另一条「先分词再生成」的视觉自回归路线见 VAR 完全拆解,离散码本的构造见 图像离散分词器完全拆解。本文围绕三个问题展开:
- 生成器如何从随机潜码出发,逐级把分辨率翻倍到 1024;
- 训练完成之后,一次推理究竟要算多少,代价落在哪些层;
- 三代相对前一代各修掉了哪一个具体缺陷。
从原始 GAN 说起
GAN 的目标与它在高分辨率上的困难
原始 GAN 用生成器 把随机向量 映射成图像,用判别器 判断真假,二者交替优化:
固定 时,最优判别器为 ,代回目标可化成两个分布之间的 Jensen–Shannon 散度。这个推导说明:理想情况下生成器要在整个数据分布上匹配 ,而不只是「生成几张看起来像的图」。这也是 GAN 的核心难点所在——JS 散度在分布支撑不重叠时几乎不提供梯度,训练因此非常脆弱。
在 32×32 的人脸上,这套结构还能工作;分辨率升到 256 以上,问题集中暴露:
- 语义与细节共用同一个输入。 从输入层进入后经过逐层上采样,所有层的「信息源」是同一个向量。发丝形状、背景颗粒这类随机细节,与性别、年龄、姿态这类语义属性纠缠在同一个 512 维向量里,改动其中一维往往同时改变两类东西。
- 判别器逼出高频伪影。判别器对高频差异最敏感,生成器于是倾向在所有位置均匀铺上「像纹理的高频」,而不是把细节放到该出现的位置。
- 模式崩塌。生成器找到一组能骗过判别器的样本后,会收缩到这组样本附近,数据分布的其他模式再也采不到。
渐进式生长:ProGAN 的解法与遗留问题
在 StyleGAN 之前,NVIDIA 自己的 Progressive GAN(ProGAN,ICLR 2018)已经解决了「高分辨率训不动」的问题:先训练 4×4,再逐级加入 8×8、16×16,直到 1024×1024;新加入的层用 fade-in 的权重 平滑接入:
从 0 线性升到 1,避免新层一上来就破坏已学好的低分辨率结构。这个办法把 1024 分辨率的训练变得可行,但也留下两个副作用:
- 生成器的层数与分辨率进度绑定,网络结构在训练过程中不断变化,工程实现复杂;
- 生成器和判别器的「阶段」必须同步,判别器在每个分辨率上都要重新适应,容易产生相位类伪影(例如牙齿始终朝向镜头,不随头部姿态旋转)。
StyleGAN 保留了渐进式生长的训练安排,但把「生成器长什么样」这件事重新设计了一遍。它真正的贡献是第二个问题:能不能让风格信息和随机细节各走各的路。
核心观察
StyleGAN 论文的核心观察可以概括成一句话:一张人脸可以拆成「尺度上的语义」与「与语义无关的随机变化」两部分。粗糙层决定姿态、脸型、发型轮廓;中间层决定五官的精细形状;细层决定肤色、毛孔、光照的细微差别。随机变化(雀斑、发丝走向、背景散景)独立于前两者,且在每一层都有不同尺度的表现。
如果生成器能给每一层单独喂「这一层该长什么样」的风格,同时再给每层单独喂一张与风格无关的噪声图,那么语义控制与随机细节就能在结构上分开。这就是第一代 StyleGAN 的全部设计出发点。
第一代 StyleGAN:映射网络、AdaIN 与噪声
整体结构
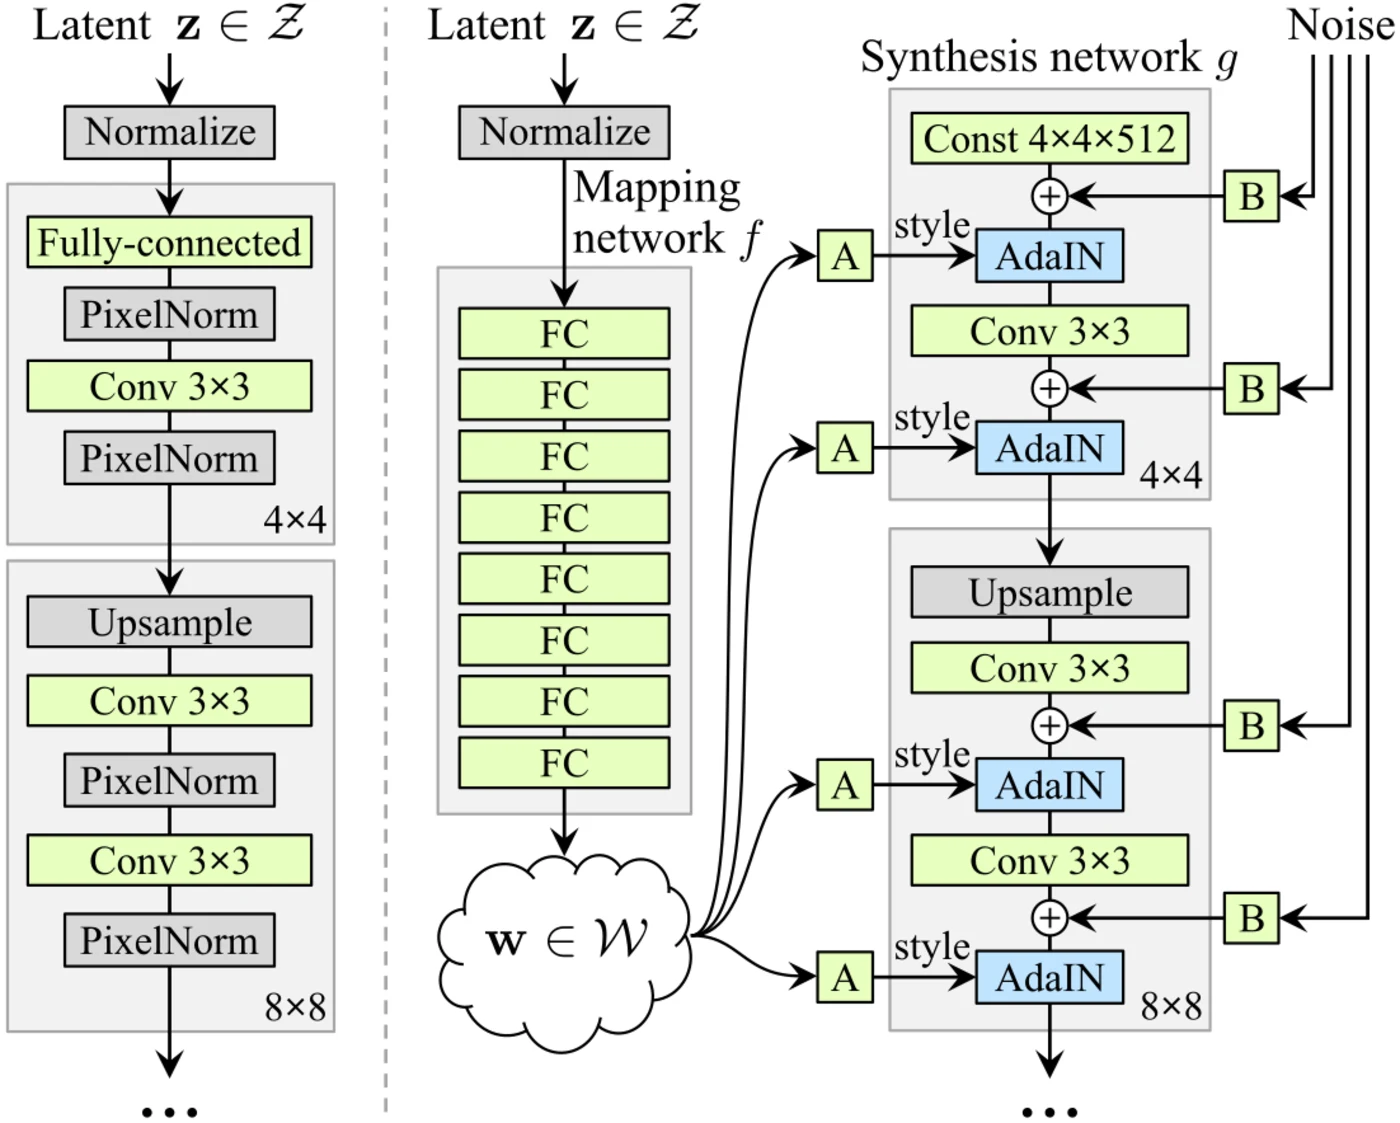
上图是论文 Figure 1 的对照:左侧(a)是传统生成器,潜码 只在输入层出现一次;右侧(b)是 StyleGAN, 先经映射网络 变成 ,再经每层各自的仿射变换 得到风格 ,通过 AdaIN 注入每个卷积层;同时每层还有一个独立噪声输入,经可学习逐通道缩放 后加到特征上。
具体配置如下:
- 映射网络:8 层全连接,输入输出都是 512 维,激活用 LeakyReLU;输入先做 PixelNorm;
- 合成网络:18 个卷积层,分辨率 4×4 到 1024×1024,每个分辨率 2 层;输入是一个可学习的 4×4×512 常量张量,而不是潜码;
- 输出:最后一层经 1×1 卷积转成 RGB;
- 参数量:生成器约 26.2M,对比传统生成器的 23.1M,多出来的部分是映射网络与逐层仿射变换。
「常量输入」这个设计容易被忽略,但它是整条链路的前提。传统生成器把 放进输入层,等于强迫 承担所有尺度的信息;StyleGAN 把输入固定成一个学出来的常量,等于告诉网络「空间位置由卷积结构决定,内容由每层的风格决定」。若输入仍随 变化,第一层之后的特征就同时携带语义与位置信息,后面的逐层风格注入很难再把两者分开。
映射网络:为什么先过一个 8 层 MLP
采样自标准高斯,分布是各向同性、无结构的;而真实人脸的属性分布在潜空间里高度相关:年龄与皱纹相关、性别与发际线相关、光照与肤色相关。若直接用 ,生成器必须在同一个向量里学会「把这些相关属性铺平成可独立控制的方向」,而每一层共享同一个 ,这个任务几乎无法完成。
映射网络做的事情是:用一个可学习的非线性变换 ,把 的分布「整形」成更适合控制的结构。论文用两个指标量化这种结构:
- 感知路径长度(Perceptual Path Length,PPL):在潜空间里取两个端点,沿直线插值 从 0 到 1 分成若干小段,测量每小段对应图像的感知距离(LPIPS),再对步长归一化后求和。直觉上,PPL 越小,说明潜空间里「走一小步,图像变化也小」,潜空间越平滑、越不纠缠。
- 线性可分性(Linear Separability):用训练好的分类器给生成图像打属性标签(如「是否戴眼镜」),再看该属性在潜空间里能否用一个线性超平面分开。可分性越高,说明属性方向越接近线性,编辑越容易。
论文的消融结果很明确:把映射网络的层数从 1 增到 8,PPL 持续下降,线性可分性上升;再加深收益就不明显了。8 层是一个在效果与成本之间的折中点。这里要强调:映射网络只在推理时增加 8 次 512×512 的矩阵乘,计算量相比 1024 分辨率的卷积可以忽略,但它改变了训练的整个几何结构。
一个常被忽略的细节:映射网络输出的 并不服从标准高斯,而是服从一个被网络「拉平」后的分布。因此在 里做插值、求均值、做截断,都与在 里做同样操作不等价。后面 StyleGAN2 的路径长度正则化,本质上就是在修「 空间里步长与图像变化不匹配」的问题。
AdaIN:把风格变成一组统计量
到每一层的注入方式是自适应实例归一化(Adaptive Instance Normalization,AdaIN)。对第 个特征图 :
其中:
- 、 是该特征图在空间维度上的均值与标准差,逐样本、逐通道计算;
- 、 是第 个通道的缩放与偏置,由 经一个可学习的仿射变换 得到,即 ;
- 除法中的 通常加一个很小的 防止除零。
这个式子的作用可以分两步看。第一步 是实例归一化:把每个特征图的「亮度」和「对比度」抹平,只保留空间结构。第二步用 重新缩放和平移: 决定这一层特征的整体强度(例如这一层应该有多少高频能量), 决定整体偏移(例如偏亮还是偏暗)。
为什么用 AdaIN,而不是把 拼接到特征上?因为拼接会让 的每个分量直接进入后续卷积的感受野,任何一点改动都会通过卷积扩散到全图,局部控制无从谈起。AdaIN 只改变归一化后的统计量,空间结构(哪些位置有什么)仍由卷积与上游特征决定,因此风格的改动表现为「整体质感变化」,而不是「内容位移」。这正是「风格」与「内容」分离在算子层面的实现。
从归一化家族的位置看,AdaIN 与 BatchNorm、InstanceNorm、条件 BatchNorm 的关系可以这样理解:
| 方法 | 统计量来源 | 仿射参数来源 | 控制粒度 |
|---|---|---|---|
| BatchNorm | 跨样本、跨空间 | 可学习常量 | 无外部条件 |
| InstanceNorm | 单样本、跨空间 | 可学习常量 | 无外部条件 |
| 条件 BatchNorm | 跨样本、跨空间 | 外部条件 | 粗粒度 |
| AdaIN | 单样本、跨空间 | 外部风格向量 | 每层独立 |
关键差别在最后一行:AdaIN 的统计量是逐样本算的,因此同一批里不同样本互不影响;仿射参数是逐层给的,所以不同分辨率可以拿到不同的风格。这两点让它适合「一个潜码控制一张图、不同层控制不同尺度」。
噪声注入:把随机细节从风格里拿出去
AdaIN 只能表达「这一层整体应该多强」,无法表达「这一层的某个像素应该和旁边不同」。而雀斑、发丝、毛孔这类细节,恰恰是逐像素随机的,且与 无关。StyleGAN 为此给每个卷积层配了一张独立的单通道高斯噪声图:
其中 是当前层分辨率的噪声图,每个元素独立采样自 ; 是一个可学习的逐通道缩放向量,初始化为 0。
初始化为 0 是一个重要的工程决策:训练初期噪声完全不起作用,网络先专注学大结构;随着训练推进, 逐渐长大,网络才开始利用高频随机性。若一开始就让噪声满强度加入,低分辨率层会被噪声淹没,语义结构学不出来。
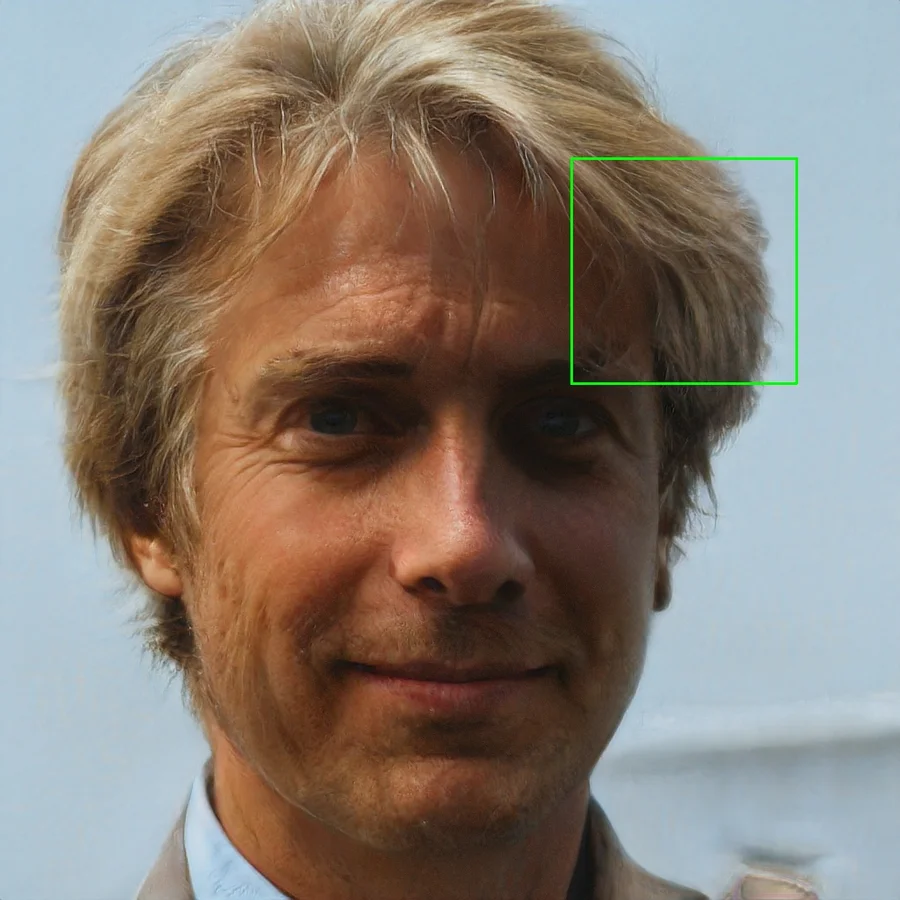
上图来自论文 Figure 4:同一张人脸在相同 、不同噪声实现下,整体结构完全一致,但发丝、皮肤纹理、背景颗粒发生变化;最右侧的标准差图显示,变化集中在高频细节区域,而不是五官轮廓。这个实验直接证明了「噪声通道只影响随机细节、不影响语义」的设计目标达成了。
论文还做了噪声位置的消融:把噪声只加在粗层(4²–32²)、只加在细层(64²–1024²)、或全部关闭,比较 FID 与视觉多样性。结论是细层噪声对纹理贡献最大,粗层噪声主要影响大尺度随机性(如背景布局);完全去掉噪声会让图像显得过于平滑、缺乏真实感。另一个消融把每层噪声改为所有层共享同一张噪声图,结果多样性下降——说明「每层独立采样」确实让不同尺度获得了独立的随机自由度。
4×4 常量输入与 18 层合成网络
合成网络的第一层输入不是噪声,也不是 ,而是一个形状为 的可学习常量。这个张量在所有样本、所有分辨率下都相同,相当于一个「位置编码 + 基础特征」的混合体。它经过 18 个卷积层与 8 次上采样,逐级放大到 1024×1024。
每个分辨率有两个 3×3 卷积。上采样采用最近邻插值,再跟一个可学习的可分离滤波(水平、垂直各一个 2 抽头滤波器),而不是直接双线性插值。这样做的原因是:双线性插值的核是固定的,网络无法根据数据调整上采样行为;可学习滤波让每一级的上采样都能选择适合该尺度的平滑程度。
等化学习率与运行时权重缩放
高分辨率 GAN 的另一个隐性问题是权重尺度与优化器的耦合。常规初始化会让不同层的权重范数差异很大,而 Adam 的更新量是按参数的梯度尺度自适应的,结果是一些层学得飞快、另一些层几乎不动。StyleGAN 采用等化学习率(equalized learning rate):
- 所有权重都从标准正态 初始化,不按 fan-in 缩放;
- 每次前向时,把权重乘以一个固定的运行时系数 ,其中 是该层的输入维度(或卷积的 fan-in);
- 这样每一层的实际权重尺度都被拉回到相近的量级,Adam 的更新步长在层与层之间更均衡。
这个技巧与后面的权重解调是配套的。解调的分母 依赖于权重的整体尺度;如果权重尺度在训练中漂移,解调后的输出方差也会漂移,风格强度就不稳定。等化学习率把权重尺度钉在可控范围内,让解调的方差分析能够成立。工程实现上,这意味着不能简单地把权重导出成一份固定张量——推理引擎要么在加载时把 折进权重,要么在每层保留一次缩放,二者在数值上等价,但前者更适合部署。
渐进式生长与 fade-in
StyleGAN 沿用 ProGAN 的训练日程:从 4×4 开始,每次翻倍分辨率时新增两层,并用 做 fade-in。区别在于 StyleGAN 的所有层始终存在,只是新层在 fade-in 之前输出被乘上接近 0 的权重。这让网络结构在训练期间保持不变,工程上更好实现,也让判别器不必频繁切换输入分辨率。
需要说明的是,StyleGAN2 后来完全去掉了渐进式生长,改用残差结构与更好的网络设计(见下一节)。因此「渐进式生长」只属于第一代;读 StyleGAN 论文时不要把这一条当成整个系列的固定特征。
混合正则化:让相邻层不要串味
如果所有层都用同一个 ,网络会学出一种「偷懒」的解法:某些层放弃自己的风格输入,转而依赖上游层已经编码好的信息。这样虽然能生成图,但逐层控制就失效了。
混合正则化(style mixing)在训练时以一定比例(论文实验中最优为 90%)的样本使用两个潜码 :在随机选定的交叉层之前用 的风格,之后切换到 。伪代码如下:
for each training image: z1, z2 = sample_latent(), sample_latent() w1, w2 = mapping(z1), mapping(z2) crossover = random_layer_index() for layer in synthesis_layers: style = w1 if layer < crossover else w2 x = adain(conv(x), affine(style)) x = x + noise_scale * noise(layer)这样做的效果是:网络无法假设「后面的层知道前面用了什么风格」,每一层都必须独立地从自己的风格输入中提取信息。论文的测试把训练好的网络在推理时随机混合 1 到 4 个潜码与交叉点,混合正则化训练出的模型对这种情况的 FID 明显更稳;不做混合正则化的模型在多层混合时质量急剧下降。
截断技巧:质量与多样性的旋钮
在 空间里,训练样本覆盖的区域并不是以原点为中心的各向同性分布。采样到分布边缘的 时,生成器可能输出扭曲的脸。截断技巧把采样点往均值拉:
其中 是训练集上 的均值(通常用大量样本估计), 是截断强度。 表示不截断,多样性最大; 表示永远用均值,输出几乎固定;论文展示常用 。
为什么往均值拉能提升质量?因为生成器在训练中见到的 大多集中在均值附近,边缘区域的密度低、监督信号少,生成质量自然差。截断把采样限制在高密度区域,代价是丢失极端属性(例如特别夸张的表情、罕见发型)。这也是 StyleGAN 长期被诟病「生成的人脸偏平均」的原因之一:质量与多样性在这个旋钮上直接对立。
StyleGAN 还有一个更细的用法:截断可以只作用于低分辨率层(4²–32²),高分辨率层仍用未截断的 。因为低分辨率层决定整体结构,最容易出扭曲;高分辨率层决定细节,保留完整变化能让皮肤纹理、发丝更自然。论文 Figure 2 的展示图正是用 只作用于 4²–32² 的设置。
损失与正则化:R1 与懒正则
StyleGAN 的对抗损失对 CelebA-HQ 用 WGAN-GP,对 FFHQ 用带 R1 正则的非饱和损失。R1 惩罚判别器在真实样本上的梯度范数:
其中 是权重(StyleGAN 系列常用 10)。它的作用是限制判别器在真实样本附近过于陡峭,防止判别器把「真实流形」学成一条尖锐的曲线,从而给生成器提供稳定梯度。
懒正则(lazy regularization)是 StyleGAN2 引入的工程优化:R1 与路径长度正则不需要每个训练步都算,而是每 步( 由训练代码配置)单独跑一次正则 pass。这样主训练步只做前向与反向,正则项带来的额外开销被摊薄,训练速度提升而效果几乎不变。论文报告在 1024² 分辨率下,StyleGAN2 的 config e 训练速度为 61 img/s,相比第一代 StyleGAN 的 37 img/s 提升约 40%,其中一部分就来自懒正则与权重解调带来的数据流简化。
第一代 StyleGAN 在 FFHQ 上的生成器参数量为 26.2M,训练约一周(8 张 Tesla V100);FFHQ 数据集包含 70,000 张 1024×1024 的人脸图。论文的消融表显示,从传统生成器基线(FFHQ FID 5.34)逐步加入映射与风格(4.85)、去掉传统输入(4.88)、加入噪声(4.42)、加入混合正则(4.40),FID 最终降到 4.40。这些数字的意义不在于绝对值,而在于每一步改动都对应一个可解释的机制。
第二代 StyleGAN2:去掉归一化伪影,修好潜码外推
第一代在 1024 分辨率下仍有两类被论文明确列为缺陷的问题:
- 水滴状伪影:AdaIN 对每个特征图做归一化,等价于强行把每层的方差拉到固定值。卷积与非线性会让某些位置的响应异常放大,归一化又把这个异常「摊平」成一个局部亮斑,形成类似水滴的斑点。这些斑点在单张图里不一定显眼,但看生成器内部激活图时非常明显。
- 潜码外推失效:在 里沿某个属性方向做线性插值,一旦走出训练分布覆盖的范围,图像就会崩坏(出现空洞、色块、结构断裂)。这说明 的几何与图像空间的几何并不匹配。
StyleGAN2 的四处改动,分别针对这两个问题。
权重解调:把归一化从特征搬到卷积核上
作者先问了一个问题:AdaIN 的归一化到底在做什么?答案是「控制每层特征的标准差」。既然如此,能不能不归一化特征,而是直接让风格缩放卷积权重,使得卷积输出的标准差符合风格要求?
对第 层的卷积权重 ( 为输出通道, 为输入通道, 为空间位置),先做调制:
其中 是由 经仿射变换得到的第 个输出通道的缩放系数。然后做解调:
分母对所有输入通道与空间位置求和,但不对输出通道 求和——每个输出通道有自己的归一化因子。 是防止除零的小常数(官方实现取 )。
推导一下为什么这样能保持方差。设输入特征 的每个元素近似独立、均值 0、方差 1,卷积输出为 。若 各元素独立,则
而解调后的权重满足 。于是输出方差被稳定在 1 附近,效果与 AdaIN 的「归一化后再缩放」等价,但没有对特征图本身做除法,因此不会把局部异常摊成水滴状亮斑。
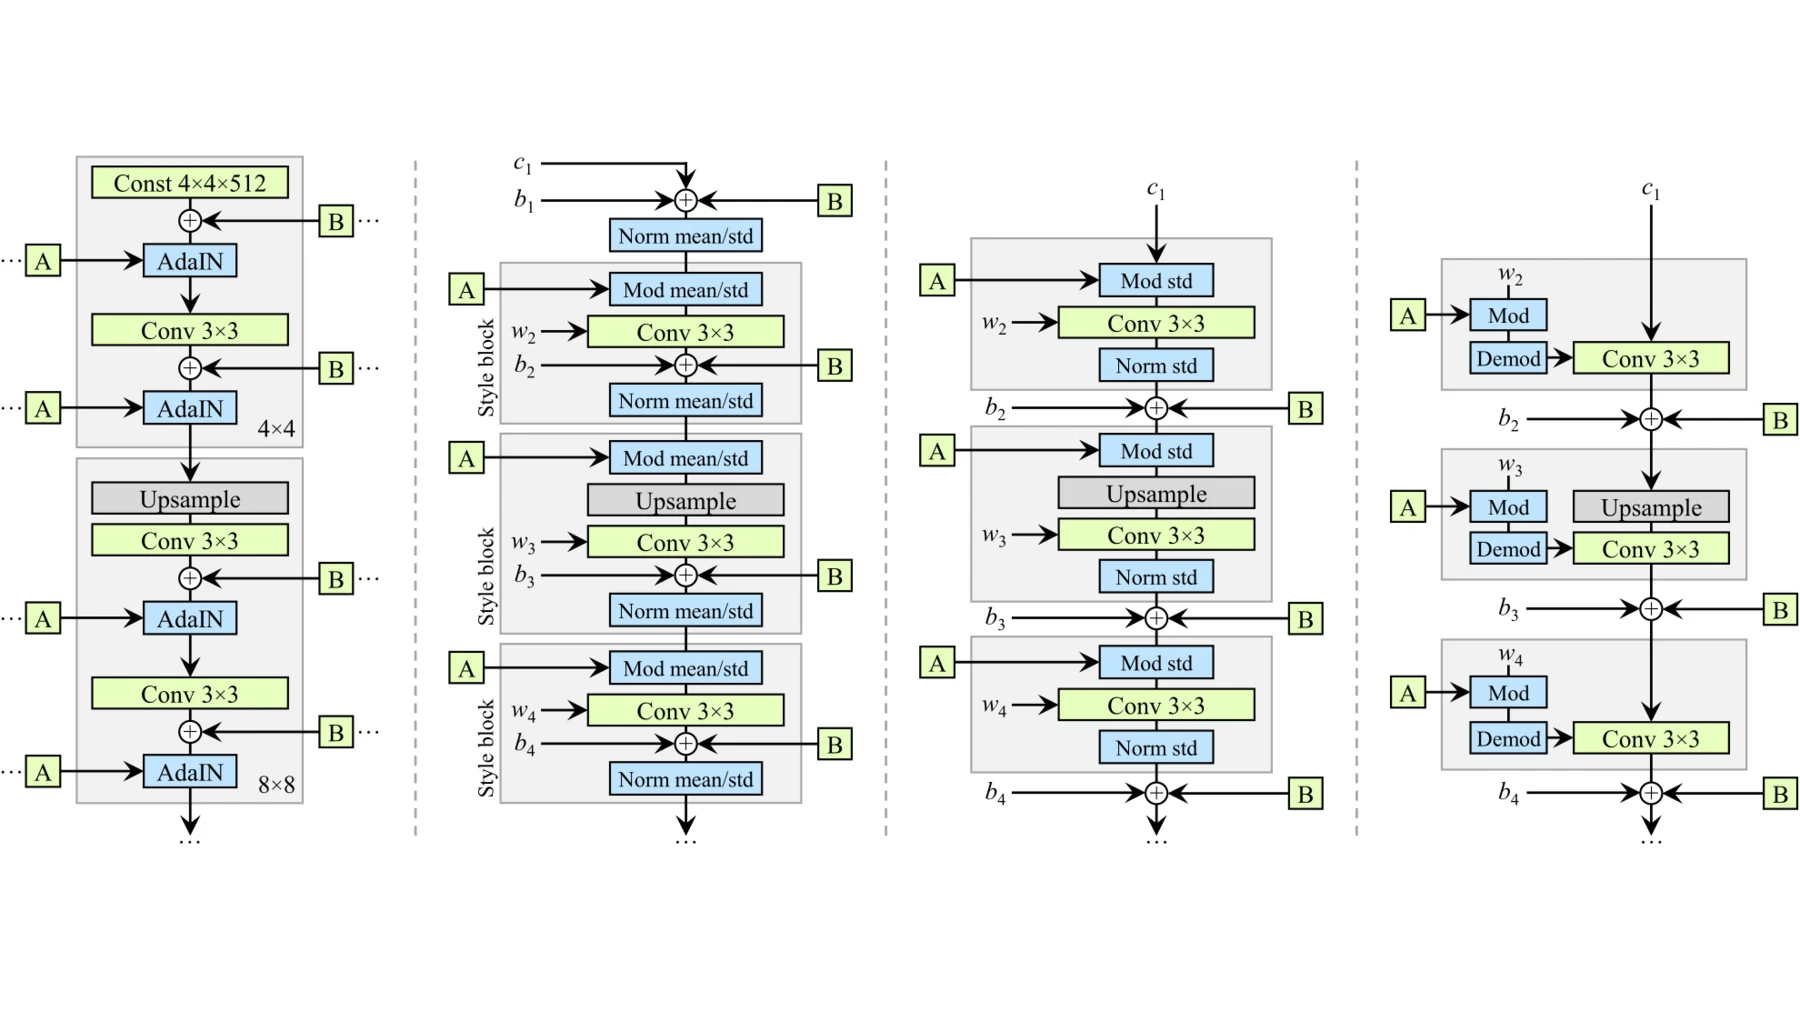
上图是论文 Figure 2 的四联图:(a)原始 StyleGAN 的 AdaIN 数据流;(b)同一结构的详细展开,明确标出噪声广播 与仿射变换 的位置;(c)修订后的结构,噪声与偏置被移到风格作用范围之外;(d)权重解调的具体位置——风格不再作用于特征,而是作用于卷积核。
这个改动还带来一个推理侧的好处:调制与解调可以在推理前折叠进权重。因为 只依赖 ,对固定的一张图,每一层的 可以在前向开始时一次算好,之后就是普通卷积;如果同一 要生成多张不同噪声的图,权重只需解调一次。官方实现里还有「把风格块烘焙成单个卷积」的优化,进一步减少逐层开销。
去掉渐进式生长
StyleGAN2 的第二个大改动是彻底移除渐进式生长,理由是它带来相位伪影:生成器和判别器在不同分辨率阶段反复切换,网络会把某些结构「钉」在固定像素位置,而不是跟随语义。论文 Figure 6 给出的例子是牙齿——人脸转动时牙齿仍朝向镜头。
去掉渐进式生长后,网络必须一次性学会所有分辨率。论文比较了三种替代结构:
- MSG-GAN:生成器输出一组 mipmap,判别器在多分辨率上分别判断;
- 输入/输出 skip:生成器把低分辨率特征上采样后加到高分辨率层,判别器对应地下采样;
- 残差网络:生成器与判别器都用残差块,上/下采样配 1×1 卷积调整通道。
实验结论是:skip 生成器 + 残差判别器的组合在 FID 与 PPL 上最好。原因可以这样理解:skip 连接让低分辨率学到的全局结构可以直接影响高分辨率输出,相当于把渐进式生长的「由粗到细」信息通路保留下来;残差判别器则让判别器在不同尺度上都能稳定回传梯度。最终 StyleGAN2(config f)使用更大的网络(通道数加宽),在 FFHQ 上把 FID 从第一代的 4.40 降到 2.84,PPL 从 212.1 降到 145.0。
需要说明的是,PPL 在这里不是「越小越好」的绝对指标:PPL 太低意味着潜空间过于平滑,可能损失细节变化。论文的表格同时给出 Precision 与 Recall:StyleGAN2 config f 在 FFHQ 上 Precision 0.689、Recall 0.492,相比第一代(0.721、0.399)精度略降、召回明显提升。这说明它覆盖了更多数据模式,而不是只把少数模式做得更精致。
分辨率利用率与容量问题
去掉渐进式生长之后,论文用 Figure 8 追踪了一个更基本的问题:每个分辨率层对最终图像的贡献到底有多大。做法是从生成器里取各层输出的标准差,对 1024 个随机 求平均,再归一化到 100%,画成随训练进度变化的曲线。
结果很有意思:训练初期,1024² 与 512² 的高分辨率层贡献接近 0,图像几乎只由 4²–64² 的低分辨率层决定;随着训练推进,高分辨率层的贡献缓慢上升,但即使训练结束,config e(与第一代同规模)的高分辨率层贡献仍然很小。论文把这一现象诊断为容量问题:生成器在高分辨率段只有 32、16 个通道,根本没有足够容量去刻画细节,于是把细节任务推回给了低分辨率层。
config f 因此把高分辨率段的通道数加宽(并调整了各层通道配置),参数与计算量上升,但 FID 从 config e 的 3.31 降到 2.84,PPL 从 124.5 升到 145.0。这一组数字说明两件事:一是 FID 与 PPL 并不总是同向变化,二是「架构改对」之后,容量仍然是限制生成质量的关键因素。对部署的启示是:不能只看生成器总参数量,要看高分辨率段分到了多少通道——那里才是纹理细节的实际承载者,也是推理计算量最集中的地方。
路径长度正则化
针对潜码外推问题,StyleGAN2 加了一个正则项,直接约束「 走一小步,图像变化多少」:
其中:
- 是生成图像;
- 是生成器输出对潜码的雅可比矩阵;
- 是该雅可比的 Frobenius 范数,衡量「 的单位变化引起多大的图像变化」;
- 是一个滑动平均的基准值,在训练中逐步更新,避免网络把所有步长都压到 0。
这个正则的直觉是: 空间里各个方向的步长应该产生大致相同的图像变化量。若某个方向的雅可比特别大,说明该方向「一步走太远」,插值时容易跨出训练分布;把它拉回到平均值附近,潜空间就变得平滑,插值与外推都更稳。论文报告这个正则让 PPL 从 212.1 降到 122.5(config d),同时让生成器更容易被反演——因为潜空间到图像空间的映射更接近等距,优化反演时不容易卡在局部极小。
投影反演与潜空间编辑
有了更平滑的 ,StyleGAN2 把「用真实图像反推潜码」做成了标准流程:
- 初始化一个 (通常用 或随机采样);
- 固定生成器,优化 使 与目标图像的 LPIPS 距离最小;
- 加一个噪声正则项,防止优化把噪声通道当成「作弊手段」去拟合高频细节;
- 得到 后,沿某个属性方向 做 ,重新生成。
这条「编码—编辑—解码」的链路,与扩散模型的 DDIM 反演加编辑在思路上可以直接对照(见 扩散模型从零讲起(十四):图像编辑与反演)。区别在于:扩散反演有显式的加噪/去噪路径,StyleGAN 的反演是一个逐样本的优化问题,成本取决于迭代次数(常见 100–300 步),每一步都要前向与反向穿过生成器。因此在批量编辑场景里,StyleGAN 的编辑成本并不低,优势主要在「单次生成极快」。
第三代 StyleGAN3:等变卷积与无 alias 生成
纹理粘连:一个被忽视的几何问题
StyleGAN2 生成的图像在整体质量上已经很好,但论文作者发现一个统计性缺陷:生成器学到的是纹理的绝对像素坐标,而不是纹理相对语义表面的位置。把图像平移几个像素再生成,纹理不会跟着移动;把脸旋转,发丝、皮肤纹理仍停留在原来的像素网格上。论文称之为 texture sticking(纹理粘连)。
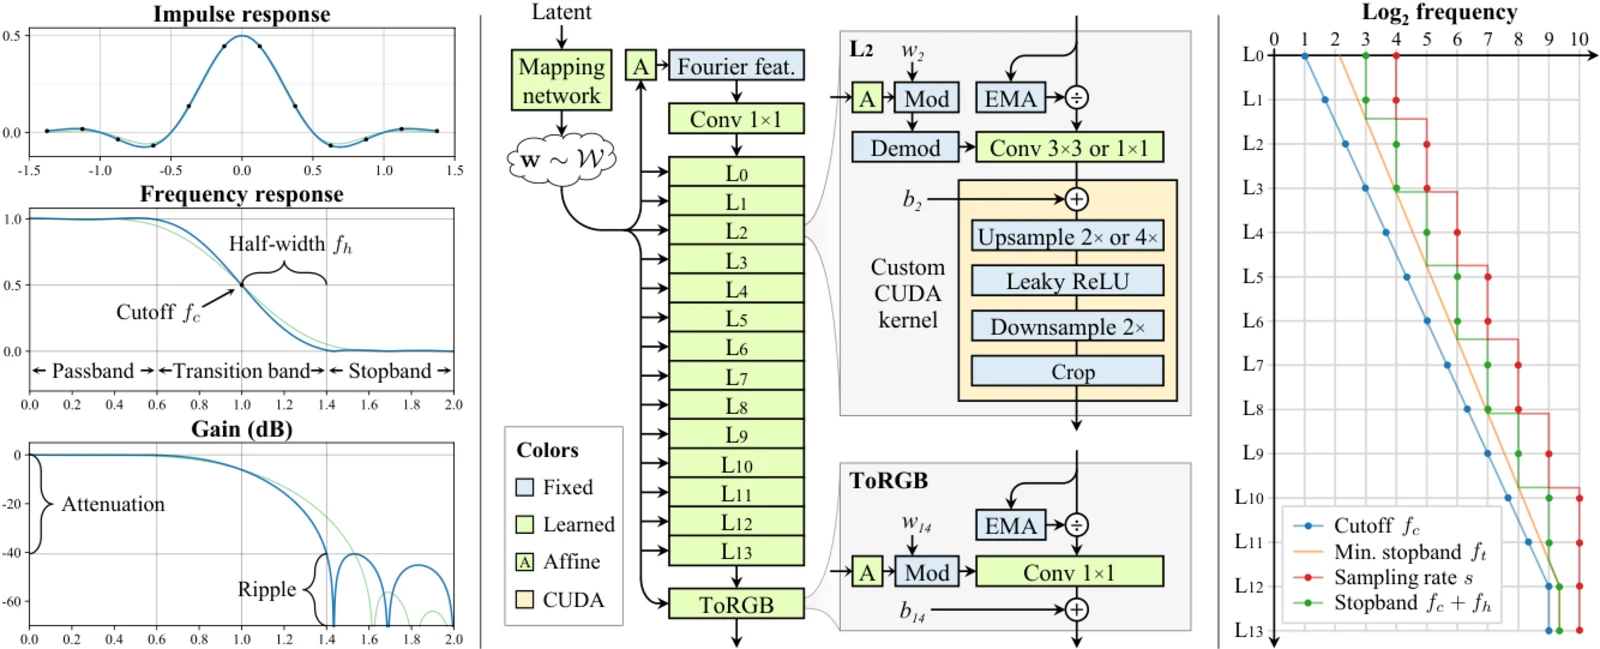
上图来自论文 Figure 4:(a)是滤波器设计的一维示意,横轴为归一化频率,标出通带、过渡带与阻带,以及 Kaiser 窗参数;(b)是 StyleGAN3 的 alias-free 生成器结构,每一层由「上采样—非线性—下采样」的滤波组合构成;(c)是可变层配置,不同分辨率可以使用不同的滤波参数。
连续信号视角:离散特征图只是采样
StyleGAN3 的论证从一个信号处理事实出发:卷积网络里的特征图是连续信号在整数网格上的采样,而不是信号本身。若把离散特征 看成对连续信号 的采样,则
其中 是理想插值滤波器, 是采样率(可以理解为画布边长),。这个式子的含义是:离散点之间「本来应该是什么」,由带限插值决定。
一旦网络里有上采样、下采样或逐点非线性,采样率就发生变化;如果滤波器不是理想的低通,高频分量会折叠回低频,产生 aliasing(混叠)。在图像上的表现就是:纹理的高频细节依附于像素网格,而不是依附于物体表面。StyleGAN3 的核心贡献,是把生成器的每一步都改成「在连续域里合法」的操作:
- 所有上采样与下采样都使用足够强的低通滤波(Kaiser 窗 sinc,窗口 );
- 逐点非线性(LeakyReLU)之前先上采样、之后先下采样,避免非线性在低采样率下制造高频(称为 filtered nonlinearity);
- 边界处理不再用零填充,而是用反射或循环填充,避免边界突变产生高频;
- 噪声输入被移除,因为逐像素独立噪声本身就是「最不连续」的信号,会破坏等变性;
- 风格向量先经过傅里叶特征编码,再送入仿射变换,让网络更容易表达旋转对称的调制。
滤波器的参数也不是随手选的。论文采用临界采样,把截止频率设在带限处 ,过渡带半宽取 ,并用 Kaiser 窗控制阻带衰减。这样做的目标是让阻带衰减超过 100 dB,把混叠压到可忽略的程度。
混叠的定量条件
把上面的直觉写成可计算的判据。设某层特征的采样率为 (单位是「每单位长度采样多少个点」),则它能表示的最高频率为 Nyquist 频率 。任何超过 的分量在采样时都会折叠:
也就是说,频率 的高频分量会被「镜像」到 区间里,变成看起来像低频的纹理。上采样与下采样改变 ,逐点非线性则制造新的高频:若输入含频率 ,LeakyReLU 这类分段线性函数会产生 的谐波;下采样前若没有把这些谐波滤掉,它们就会折叠回来。
这解释了为什么 StyleGAN3 的三个改动必须一起做:
- 上/下采样用强低通滤波:把 以上的分量压到 100 dB 以下,确保采样后没有可折叠的内容;
- filtered nonlinearity:在低采样率上不做非线性,而是先上采样到更高采样率、做 LeakyReLU、再下采样回原采样率,使谐波在生成后立刻被滤除;
- 边界处理:零填充会在图像边缘制造一个「从有到无」的阶跃,阶跃含有全频带分量;改用反射或循环填充,边缘的连续性就不会引入额外高频。
滤波器长度 是另一个可调参数。论文的消融给出: 时训练时间约为基准的 0.84 倍,但阻带衰减不足,EQ-T 与 FID 都变差; 是基准; 时训练时间为 1.18 倍,等变性指标略好。这说明滤波强度与计算量之间有一个明确的折中, 是作者选定的工作点。
等变性的度量与结果
StyleGAN3 定义了两种等变性指标:
- EQ-T(translation equivariance):对输入做平移,测量输出图像的最大变化;越高说明平移等变性越好;
- EQ-R(rotation equivariance):对输入做旋转,测量输出图像的最大变化;越高说明旋转等变性越好。
在 FFHQ-U(70,000 张 1024² 人脸)上,论文报告 StyleGAN2 的 FID 为 3.79,StyleGAN3-T 为 3.67,StyleGAN3-R 为 3.66;EQ-T 从 StyleGAN2 的 15.89 提升到 61.69(T)与 64.78(R);EQ-R 从 10.79 提升到 13.95(T)与 40.48(R)。也就是说,第三代在 FID 基本持平的前提下,把平移等变性提升到约 4 倍,旋转等变性在 R 配置下提升到约 4 倍。
这里的关键取舍是:等变性不是免费的。StyleGAN3 的滤波器核更大( 时训练时间约为 的 1.18 倍),部分配置的上采样倍率更高( 时训练时间约为 2.31 倍)。论文还专门写了一个融合「上采样—LeakyReLU—下采样」的自定义 CUDA kernel,把这段序列的训练速度提升约 10 倍,否则标准框架里的多次张量搬运会把收益吃掉。这一段对推理侧同样有参考价值:等变滤波的计算模式是「小核 + 密集逐元素运算」,适合融合成一个 kernel,避免中间特征反复读写显存。
一次采样到底要算多少
前向链路
给定一个 ,完整推理链路是:
z (512) -> mapping: 8 × FC(512,512) + LeakyReLU # 约 4M MACs -> for each of 18 layers: affine(w) -> (s, b) # 18 × 512×512 -> synthesis: 18 × (conv 3×3 + demod + noise) # 主要计算量 -> toRGB: 1×1 conv映射网络与逐层仿射的计算量可以忽略,真正的成本在合成网络。按 StyleGAN2 的通道配置估算(每级分辨率 2 层,通道从 512 逐级降到 16),每个高分辨率层的乘加量约为
以 1024²、32→16 通道为例: GMACs,即约 9.66 GFLOPs。256² 到 1024² 的 8 个层每层都在 4.8 GMACs 左右,低分辨率层加起来不到 6 GMACs,整条合成网络约 55 GMACs(约 110 GFLOPs)。权重约 30M 参数,fp16 下约 60 MB,显存压力主要来自中间激活,而不是权重。
与扩散模型对比:一张 1024² 的扩散生成通常要 20–50 步去噪,每一步都要过一遍完整的主干网络(U-Net 或 DiT),单步计算量与 StyleGAN 的一次前向同量级甚至更高。于是同样的硬件上,StyleGAN 的采样成本大致是扩散模型的 1/20 到 1/50。这就是它在「无条件批量生成」「实时换脸预览」这类场景仍然有生命力的原因。
部署时的几个实际问题
- 固定 batch 与动态 batch:StyleGAN 的合成网络对分辨率与 batch 都敏感,部署时通常固定分辨率(如 1024²)与较小 batch(1–4),用 CUDA Graph 或 TensorRT 把逐层 kernel 启动开销压掉。
- 自定义算子:官方实现依赖
upfirdn2d、bias_act等自定义 CUDA 算子;转 ONNX/TensorRT 时需要把它们替换成等价的标准算子,或者自己写 plugin。StyleGAN3 的滤波卷积更是如此,直接导出往往失败。 - fp16 数值范围:解调分母含平方和,fp16 在通道数很大时可能溢出;官方实现用 fp32 计算解调系数再转 fp16,部署时要保留这个细节。
- 截断与风格混合是推理期操作:它们不改变权重,只改变输入 的组合方式,因此可以在服务端按请求动态执行。风格混合需要每层单独的 ,意味着映射网络要跑两次(或缓存两个 ),成本仍然很小。
条件生成:StyleGAN 的原生短板
StyleGAN 本身是无条件生成器, 不接收文本。要把文本塞进去,常见做法是:
- 用 CLIP 等图文模型给「图像与文本的匹配度」打分;
- 固定生成器,优化 使匹配度最大化;
- 每一步都要前向 + 反向穿过生成器,通常需要上百步。
这条路径的生成质量受 CLIP 打分器限制,且每次请求都要做优化,延迟远高于无条件采样。相比之下,扩散模型把文本条件直接注入去噪网络,一次前向就能处理任意提示词,这是扩散成为文本到图像主流的结构性原因。StyleGAN 的定位因此更清楚:它是无条件图像先验与潜空间编辑的强基线,而不是通用文生图引擎。
核心实现
下面用 PyTorch 写出三代共有的关键部件,省略 equalized learning rate、上采样滤波等工程细节,只保留机制。
映射网络与风格仿射
class MappingNetwork(nn.Module): def __init__(self, z_dim=512, w_dim=512, n_layers=8): super().__init__() layers = [] for i in range(n_layers): layers += [nn.Linear(z_dim if i == 0 else w_dim, w_dim), nn.LeakyReLU(0.2)] self.net = nn.Sequential(*layers)
def forward(self, z): # PixelNorm:每个样本归一化到单位 RMS z = z / torch.sqrt((z ** 2).mean(dim=1, keepdim=True) + 1e-8) return self.net(z)每个风格块有自己的仿射层,把 512 维 映射成该层通道数维的缩放与偏置:
class StyleAffine(nn.Module): def __init__(self, w_dim, channels): super().__init__() self.linear = nn.Linear(w_dim, channels * 2) nn.init.ones_(self.linear.weight) # 官方实现的 style 初始化 nn.init.zeros_(self.linear.bias)
def forward(self, w): s, b = self.linear(w).chunk(2, dim=1) return s + 1, b # 缩放初始为 1AdaIN(第一代)
def adain(x, style_s, style_b, eps=1e-8): # x: [N, C, H, W],style: [N, C] mean = x.mean(dim=(2, 3), keepdim=True) std = x.std(dim=(2, 3), keepdim=True, unbiased=False) x_norm = (x - mean) / (std + eps) return x_norm * style_s[:, :, None, None] + style_b[:, :, None, None]调制卷积与解调(第二代)
class ModulatedConv2d(nn.Module): def __init__(self, in_ch, out_ch, kernel=3, demodulate=True): super().__init__() self.weight = nn.Parameter(torch.randn(out_ch, in_ch, kernel, kernel)) self.demodulate = demodulate
def forward(self, x, style): N, C, H, W = x.shape # 1) 调制:每个样本、每个输出通道一组缩放 w = self.weight[None] * style[:, :, None, None, None] # [N,out,in,k,k] if self.demodulate: # 2) 解调:对 (in, k, k) 求平方和,逐输出通道归一化 denom = torch.rsqrt(w.pow(2).sum(dim=(2, 3, 4), keepdim=True) + 1e-8) w = w * denom # 3) 分组卷积:把 batch 与输出通道合并,避免逐样本循环 x = x.reshape(1, N * C, H, W) w = w.reshape(N * self.weight.shape[0], C, self.weight.shape[2], self.weight.shape[3]) out = F.conv2d(x, w, padding=1, groups=N) return out.reshape(N, -1, H, W)这段代码的关键在最后一步:由于每个样本的卷积核不同,标准 conv2d 不能直接批量处理,官方实现用分组卷积把 batch 维折叠进通道维。这也解释了为什么推理时「批量生成不同 的图」比「同一 生成多张噪声不同的图」更贵——前者每张图都要各自的调制权重。
噪声注入与风格混合
def add_noise(x, noise_scale, noise): # noise: [1, 1, H, W],noise_scale: [1, C, 1, 1] return x + noise_scale * noise
def mix_styles(w1, w2, crossover_layer): # 训练时随机选择交叉层;推理时可指定层做尺度控制 return [w1 if i < crossover_layer else w2 for i in range(18)]三代对照
| 版本 | 风格注入 | 噪声注入 | 关键修复 | 单次推理代价 |
|---|---|---|---|---|
| StyleGAN | AdaIN(归一化特征) | 每层独立噪声 × 逐通道标量 | 语义与细节分离 | 低,一次前向 |
| StyleGAN2 | 调制卷积 + 解调 | 卷积输出加噪声 | 水滴伪影、潜码外推 | 低,调制可折叠 |
| StyleGAN3 | 带限等变卷积 + 傅里叶特征 | 去掉噪声输入 | 纹理粘连、平移/旋转等变 | 较高,约 1.2–2 倍 |
三代不是简单的替代关系。StyleGAN2 的调制卷积是工程上最常用的一代:大量超分、修复、人脸编辑模型都直接复用它;StyleGAN3 更适合需要几何一致性的场景(视频、动画、3D 资产),代价是推理更贵、训练更依赖自定义 kernel。
与其他生成路线的成本对照
把 StyleGAN 放回生成模型的大图里,最容易看清它的定位。下面的表只比较数量级,具体数字随模型规模与分辨率变化很大:
| 路线 | 单图前向次数 | 每步计算特征 | 1024² 单图总量级 | 原生条件注入 |
|---|---|---|---|---|
| StyleGAN2 | 1 | 18 层卷积,约 55 GMACs | 约 FLOPs | 无,需外挂优化 |
| 扩散模型 | 20–50 | 每步过完整主干 | 约 – FLOPs | cross-attention,强 |
| 视觉自回归(VAR) | 10 个尺度 | 每尺度一次带上下文前向 | 约 – FLOPs | 可接文本 token |
| 掩码生成(MaskGIT) | 8–16 轮 | 每轮全图 token 预测 | 约 – FLOPs | 可接文本条件 |
这张表能解释一个常见困惑:为什么 StyleGAN 的采样这么快,却没有成为文生图的主流。原因不在速度,而在条件接口。扩散模型把文本条件放进每一步的去噪计算,任意提示词都能以一次采样完成;StyleGAN 的 空间没有「文本」这个输入维度,要接文本就得在推理时做梯度优化,把速度优势又还了回去。
另一条对照是质量与多样性。GAN 的对抗目标倾向于覆盖分布的「高密度区域」,Recall 往往低于扩散;扩散的似然目标覆盖更全,但采样步数多、单步成本高。视觉自回归与掩码生成介于两者之间:它们用离散 token 把生成变成分类问题,条件注入自然,但需要分词器与多轮解码。三条路线各自的机制可参考 图像离散分词器完全拆解、MaskGIT 与 Muse 拆解 与 VAR 完全拆解;音频侧用 GAN 做声码器的对照可以看 GAN 声码器拆解。
局限与边界
- 模式覆盖:GAN 的对抗训练本质上是在拟合分布的支撑,Recall 指标长期低于同等规模的扩散模型;对长尾属性(罕见姿态、遮挡、复杂背景)覆盖不足。
- 训练稳定性:需要仔细调判别器容量、R1 权重、学习率与数据增强(ADA);同一套超参换数据集往往要重新调。
- 无原生条件接口:文本、布局、参考图等条件都需要外挂优化或额外的条件分支,不像扩散模型那样可以把条件直接塞进去噪网络。
- 反演成本:潜空间编辑依赖逐样本优化,批量场景下并不便宜;StyleGAN2 的平滑化改善了反演,但没有消除优化过程。
- 评估偏差:FID 基于 InceptionV3 特征,对纹理敏感、对结构不敏感;PPL 与 FID 也不总是一致。看论文数字时要同时看 Precision/Recall 与人工评估。
小结
StyleGAN 系列把无条件图像生成拆成三层:映射网络把 变成语义更解耦的 ,AdaIN/调制卷积把 逐层注入为统计量,噪声通道负责与 无关的随机细节。三代分别修掉了三类缺陷:
- 第一代用映射网络 + AdaIN + 噪声,解决了「语义与随机细节纠缠」;
- 第二代用权重解调替代 AdaIN,消除了归一化伪影,并用路径长度正则修好潜码外推;
- 第三代把生成器改造成带限等变卷积,消除了纹理粘连,使生成器对平移与旋转等变。
推理侧的核心事实是:StyleGAN 训练完成后只需一次前向,1024² 单图约 55 GMACs,比多步扩散便宜一到两个数量级;代价是训练难、模式覆盖有限、缺少原生条件接口。理解这套分层与权衡,也能更清楚地看到扩散模型在条件生成与模式覆盖上究竟补上了哪一块。
参考资料
- A Style-Based Generator Architecture for Generative Adversarial Networks(StyleGAN,CVPR 2019)
- Analyzing and Improving the Image Quality of StyleGAN(StyleGAN2,CVPR 2020)
- Alias-Free Generative Adversarial Networks(StyleGAN3,NeurIPS 2021)
- Progressive Growing of GANs for Improved Quality, Stability, and Variation(ProGAN,ICLR 2018)
- Arbitrary Style Transfer in Real-time with Adaptive Instance Normalization(AdaIN)
- NVlabs/stylegan2-ada-pytorch 官方实现
- NVlabs/stylegan3 官方实现
- NVlabs/ffhq-dataset 数据集说明
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



