


语音到语音翻译模型架构入门:从直接谱图翻译、UnitY 两遍解码到 SeamlessM4T 的统一翻译
一个「同传」请求里到底有几段模型
一个人对着手机说一句西班牙语,另一端听到的是一句英语语音。这个动作看起来和打开字幕翻译没什么区别,但真要把它做成一个服务,链条比文本翻译长得多:先要把声音转成可计算的形式,再决定中间经过什么表示,最后把表示还原成一段能被耳朵接受的波形。每一段都有独立的模型、独立的解码循环和独立的延迟,语音到语音翻译(Speech-to-Speech Translation,下文简称 S2ST)的架构史,本质上就是中间表示该怎么选、要选几段、每段用什么解码器的问题。
传统的做法叫级联(cascade):自动语音识别(ASR)把源语音转成源文本,机器翻译(MT)把源文本翻成目标文本,文本到语音合成(TTS)把目标文本合成为目标语音。三段模型各自独立训练、各自可以做到很强,但有三处结构性代价。第一是误差叠加:ASR 每错一个词,MT 拿到的就是错的上文,TTS 又只能照着错的文本念,错误在三段之间会被放大而不是抵消。第二是延迟相加:三段串行,任何一段慢,整条链路都慢,做流式同传时要让三段的边界都精确对齐才行。第三是副语言信息在中间被丢掉:源说话人的音色、语速、停顿、情绪,以及那些本来不该翻译的专有名词发音,一旦被压成文本 token 就基本无法恢复。
端到端直接 S2ST(direct S2ST)的核心动机就是绕开中间文本。Google 团队在 2019 年发表的 Translatotron(Jia 等人,Interspeech 2019,arXiv:1904.06037)是这条路线的起点:它直接把源语谱图映射成目标语谱图,不需要任何文本表示,顺带还能保留源说话人的音色。随后同一团队的 Translatotron 2(Jia 等人,2021 年,arXiv:2107.08661)把架构改成「编码器 → 文本解码器 → 声学合成器」,并把音色保留这件事做成了默认行为。Meta(当时 Facebook AI)的 UnitY(Inaguma 等人,2022 年,arXiv:2212.08055)换了一条中间表示——离散声学单元——用两遍解码把「先翻成文本、再生成单元」拆开。再往后是 SeamlessM4T(Seamless Communication 团队,2023 年,arXiv:2308.11596)以及扩展版 SeamlessM4T v2 / SeamlessExpressive / SeamlessStreaming(2023 年 12 月,arXiv:2312.05187),把这些组件做成一个覆盖接近一百种语言的统一模型,并让其中的解码器可以真正边听边译。
这些工作层层叠加,但基础架构只有三类:直接谱图翻译、文本—单元两遍解码、统一多任务的两遍解码加同时翻译策略。下面沿着时间顺序把三类逐一拆开,重点放在「为什么这样设计」和「推理时每一段要付什么代价」上。文中的每张架构图都截自对应论文的官方图,便于对照。
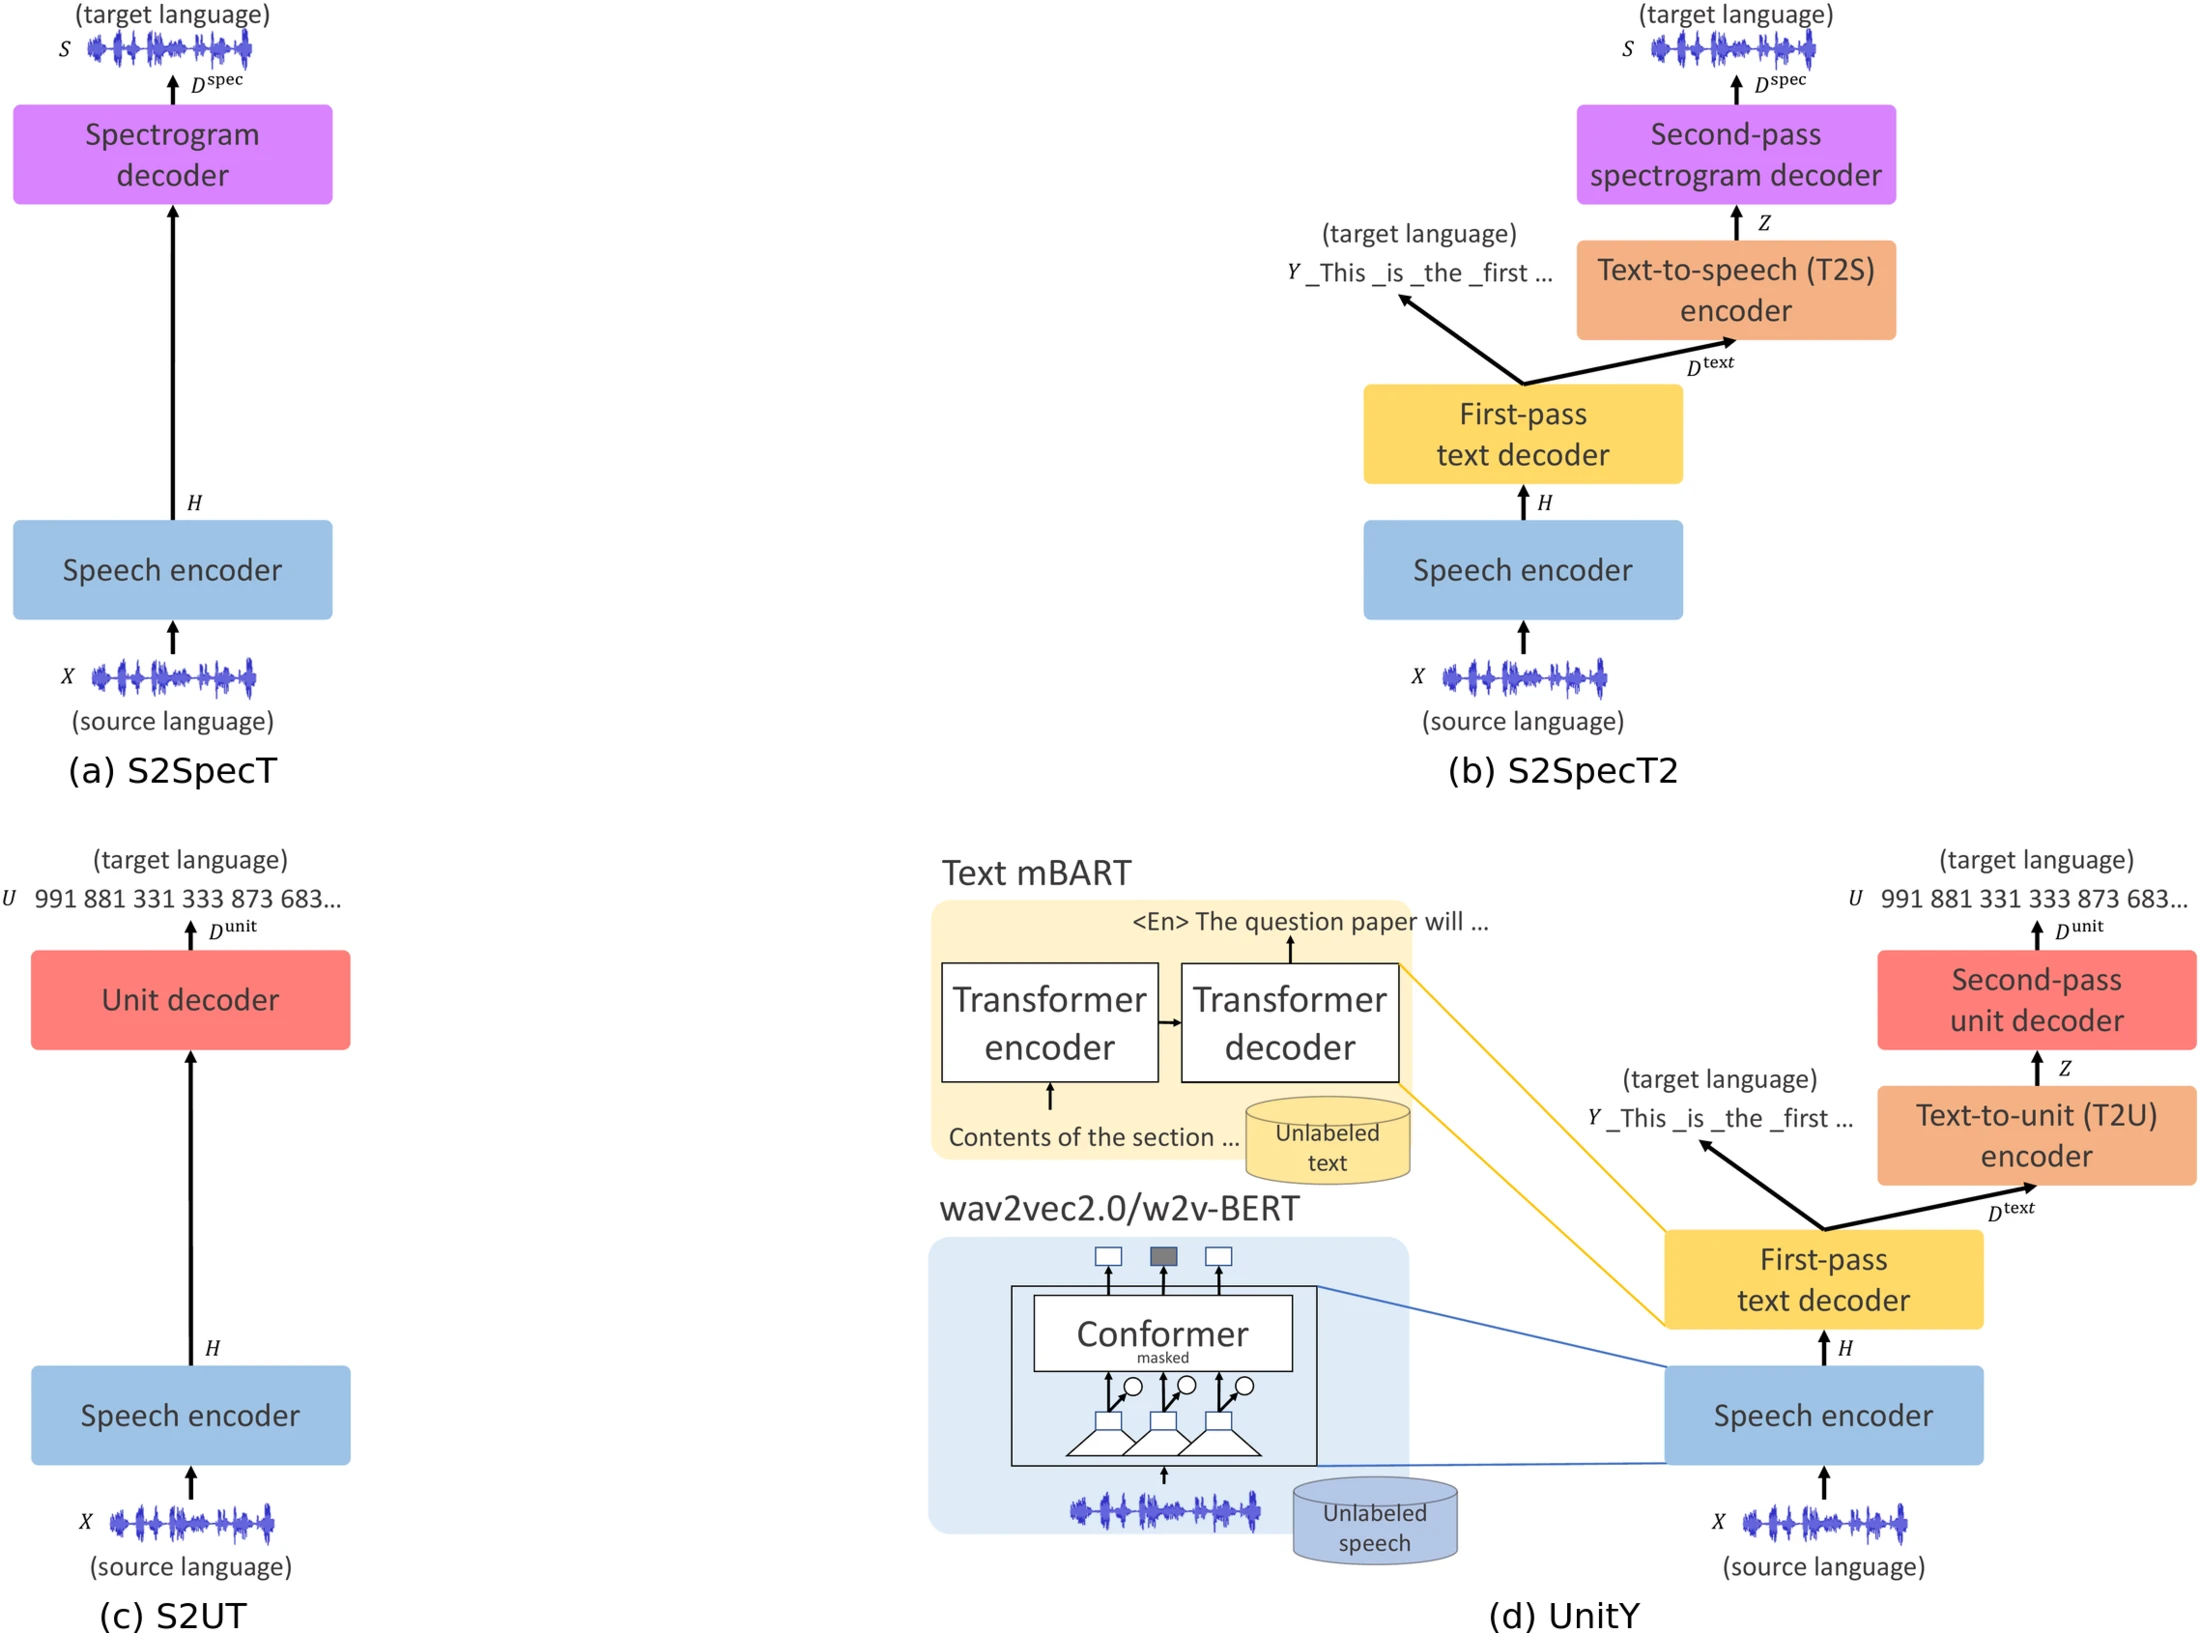
上面这张图出自 UnitY 论文的 Figure 2(Inaguma 等人,2022),它其实是一张「直接 S2ST 的架构地图」。四个面板按 (a) 到 (d) 排列(2×2),分别是:S2SpecT,一遍解码直接产出目标语谱图;S2SpecT2,先出文本、再用一个文本到谱图(T2S)编码器续接第二遍谱图解码;S2UT,先出文本、再用文本到单元(T2U)模型产出离散单元;UnitY,也是两遍,但第二遍改成用轻量的 T2U 编码器把第一遍的解码器状态接过来,只解码离散单元。四张图的结构差得很小,差别全部集中在「第二遍拿到什么输入、输出什么表示」这一点上,而这一点恰恰是后面几个模型性能差异的主要来源。读这篇文章时可以把这张图放在手边对照。
Translatotron:把谱图当语言
架构:一个编码器,三个解码器
Translatotron 的输入是 80 维 log-mel 谱图,以三帧堆叠成 240 维的帧特征;编码器是 8 层双向 LSTM,输出隐状态序列。主解码器是一个 Tacotron 2 风格的自回归网络:带 pre-net、自回归 LSTM 堆栈和 post-net,用 4 头加性注意力从编码器隐状态里抽取上下文,每个解码步输出两帧(reduction factor 为 2)1025 维线性幅度谱,最后交给 Griffin-Lim 算法或 WaveRNN 神经声码器合成波形。
关键在于另外两个辅助解码器。它们各自带独立的单头注意力,从编码器的中间层输出中预测源语言的音素序列和目标语言的音素序列,只在训练时产生损失,推理时完全不参与。作者的解释是:编码器浅层更容易编码源内容,深层则倾向于编码与目标相关的内容,所以让辅助解码器接中间层。这个设计带来一个非常实际的收益:注意力对齐被监督住了。
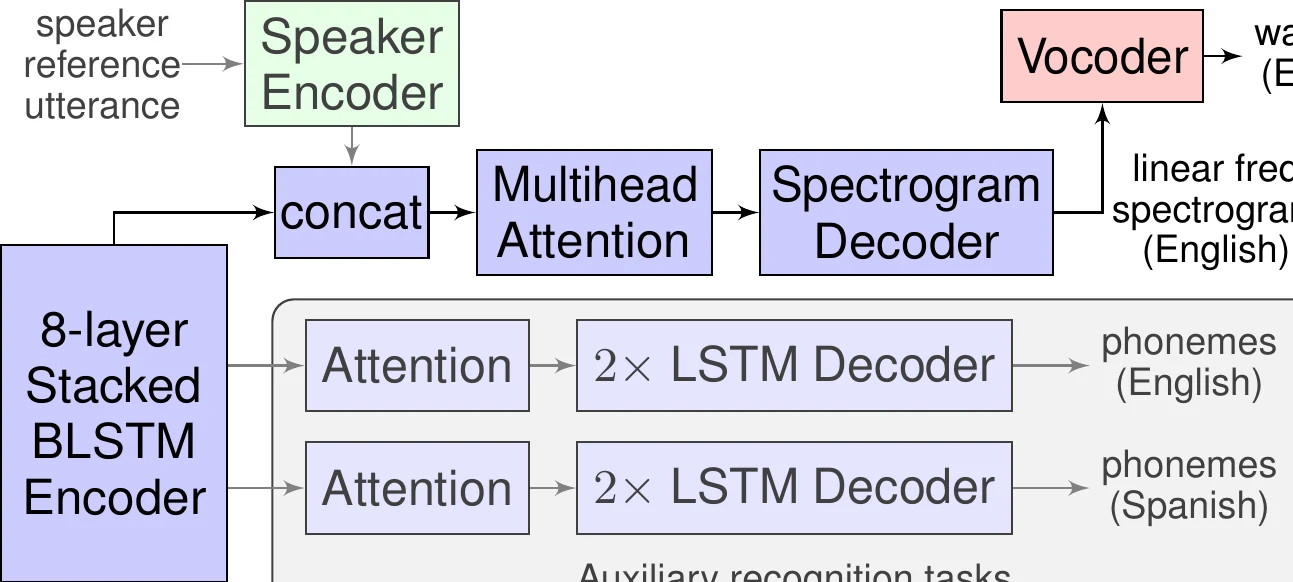
上图是 Translatotron 论文的 Figure 1(原图配色较浅,这里按原样使用)。中间的蓝色部分是主路径:源谱图进编码器,经过多头注意力驱动自回归谱图解码器,再交给声码器(红色)输出波形。上方浅色的两个方框就是两个辅助音素解码器,它们的输出箭头只指向损失函数,在推理阶段被整个移除。左侧浅色的方形是可选的说话人编码器:一个在说话人验证任务上预训练的 d-vector 模型(用 85.1 万说话人、8 种语言训练),从一段参考语音里算出 256 维说话人嵌入,再经一层线性投影压到 16 维,作为解码器的额外条件输入。
为什么辅助解码器如此关键?论文给出了直接的对照实验:在西班牙语到英语的对话数据集上,不加任何辅助损失时,BLEU 只有 0.4,模型能正确合成一些常见词和短语(例如把「hola」译成「hello」),但不能稳定翻译整句,生成的语音听起来像目标语言但内容随机。这正是一个「注意力没有学会对齐」的症状:自回归解码器面对一段长谱图和另一段长谱图,中间没有任何单调或语义上的约束,注意力很容易漂。只加源音素损失,BLEU 升到 42.2;只加目标音素损失,42.6;两者同时加,42.7。也就是说,辅助任务主要起的是正则化和对齐引导的作用,而不是提供更强的翻译能力。
谱图作为语言:为什么难
把谱图当作「语言」来建模,难点集中在两点。
第一是长度。一句 3 秒的西班牙语,按 50 帧/秒的 hop 计算约 150 帧,经过 reduction factor 2 后约 75 个解码步;对应的英语词可能只有 10 个左右。自回归谱图解码器要学习的对齐是「150 帧到 75 个频谱帧」的映射,中间没有任何离散的、有明确边界的语言单位可供参考,这和文本翻译里「词对齐」的直觉完全不同。
第二是数据。谱图到谱图的平行数据极难获取,因为需要既会说两种语言、又愿意录大量平行语料的人。Translatotron 的做法是用 TTS 合成目标侧:对话语料用 Tacotron 2 加 Griffin-Lim 合成单女声,Fisher 语料用 Parallel WaveNet。这样一来训练数据容易扩,但也引入了 TTS 本身的质量上限,这是后面几篇论文都在处理的问题。
结果与它留下的问题
在 Fisher 西班牙语到英语任务上,Translatotron 的最佳配置(双辅助损失加编码器预训练)拿到 4-reference BLEU 31.1,而 ST→TTS 级联基线为 41.4;对话数据集上是 42.7 对 48.7。也就是说,它在 Fisher 上约为级联的四分之三,在较简单的对话集上接近九成,作者自己也把它定位成可行性验证。
不过它暴露了三个后续工作必须解决的问题,后面每一篇都至少对应其中一个。
其一,辅助任务只作用于训练,推理时并不产生任何中间语言信号,主解码器仍然要自己去学从源谱图到目标谱图的完整翻译,能力上限受限。其二,一个自回归解码器同时承担翻译与声学生成,长序列上的注意力鲁棒性差,论文自己也提到过自回归 TTS 常见的过生成问题(重复念、拖长停顿)。其三,训练目标里没有强制「源侧与目标侧是同一说话人的平行句」,训练数据的目标侧又都是同一个合成女声,因此「保留源说话人音色」这件事只能靠说话人编码器做条件输入,而这个编码器在推理时完全可以换成任意说话人的参考音频——换句话说,它具备任意音色克隆的能力,这在生产部署上是风险。
Translatotron 2:文本解码器做导航,合成器不做注意力
Translatotron 2 的架构改变看着不大,但每一处都对应上面三个问题中的一个。
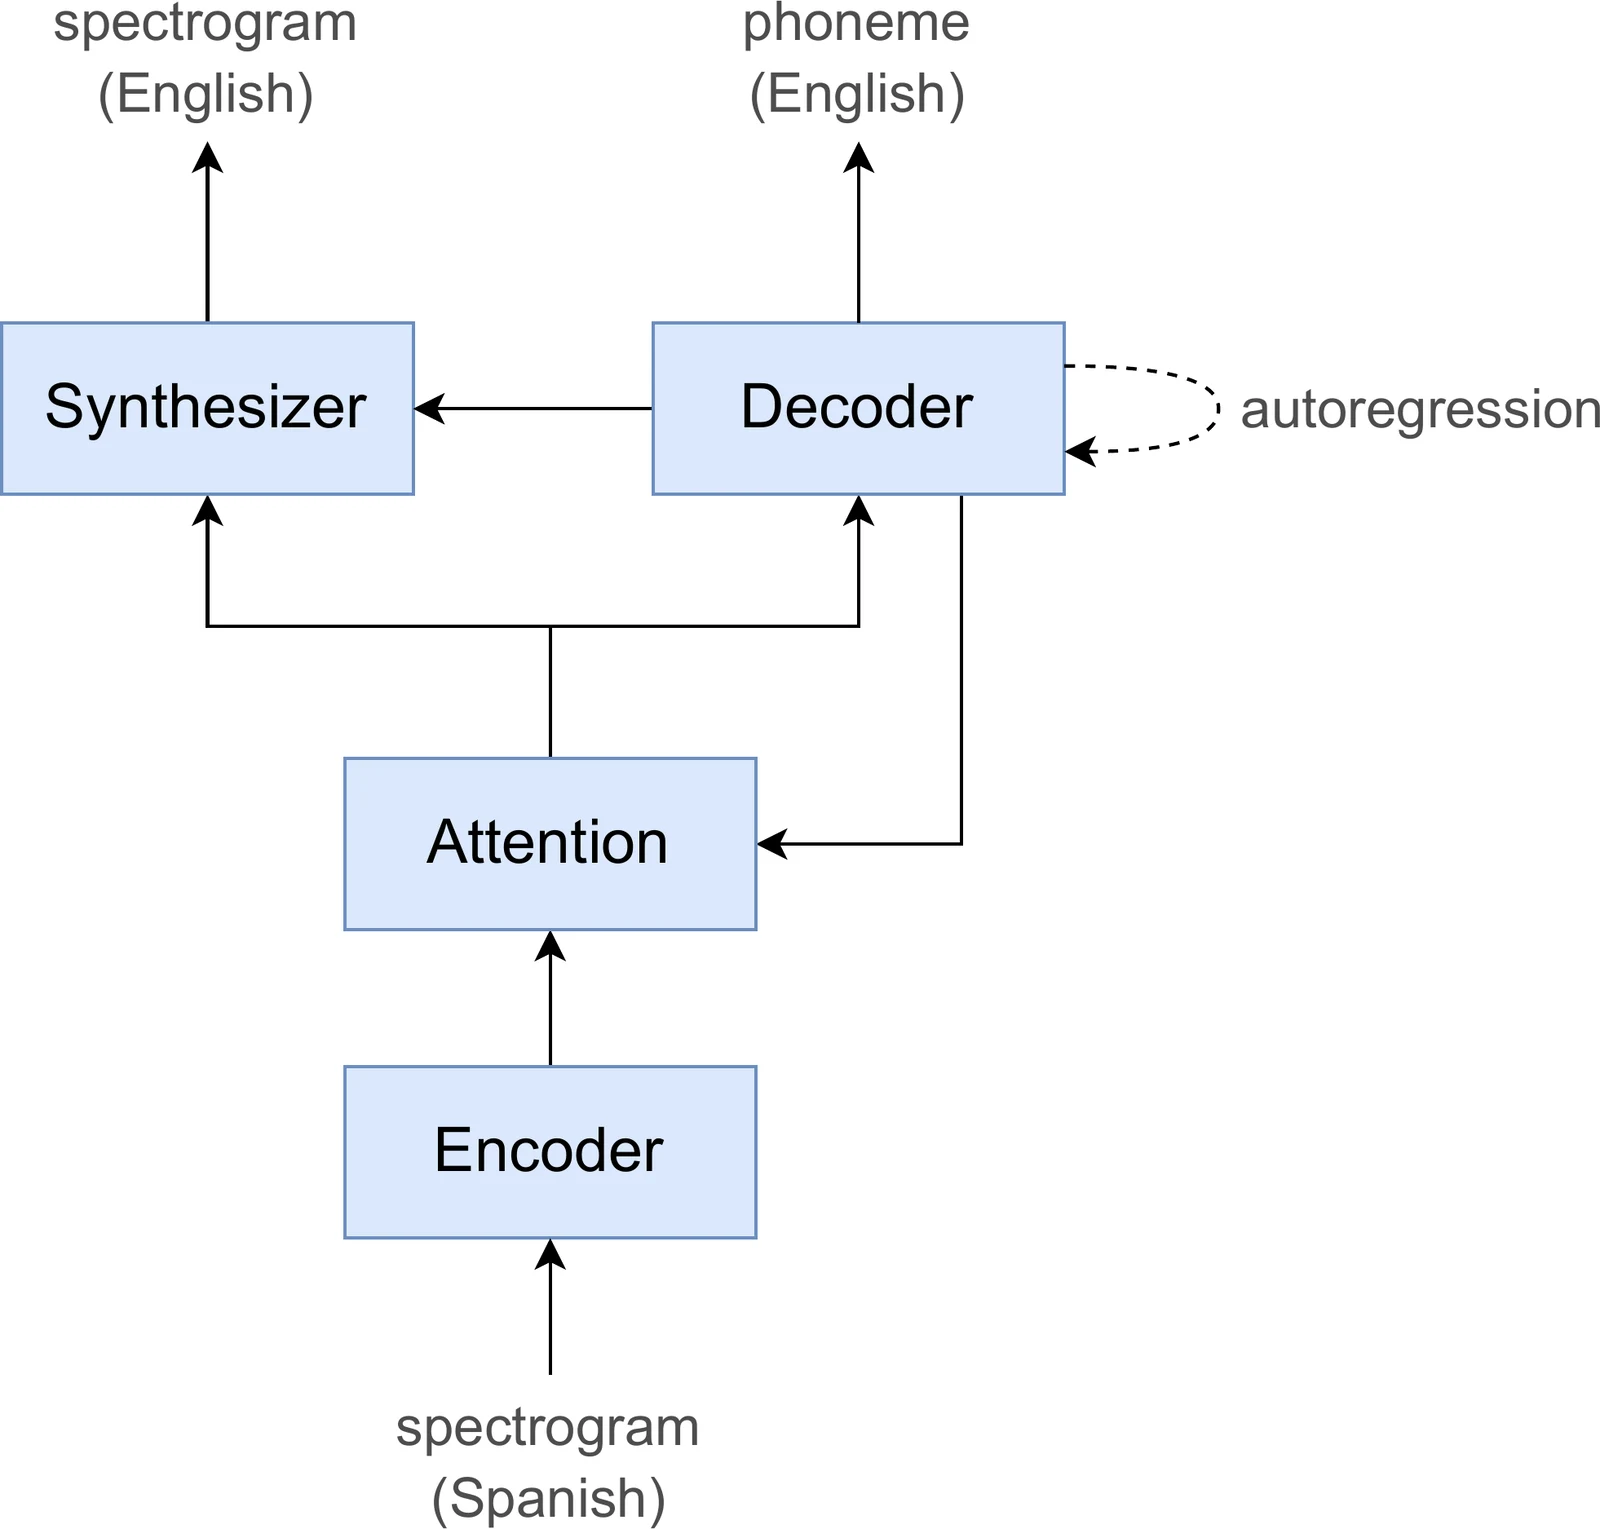
上图是 Translatotron 2 论文的 Figure 1a。从左到右:源语谱图(西班牙语)进入 Conformer 编码器得到隐状态 ;一个 LSTM 文本解码器通过多头注意力读取 ,产出一个音素或子词序列(英语);再往右,合成器(Synthesizer)拿到两样东西——文本解码器的隐状态与注意力输出——去生成目标语谱图。注意整张图里只有一个注意力模块,它被文本解码器和合成器共用。
为什么只保留一个注意力
如果直接照搬 Translatotron 的「谱图到谱图」思路,注意力要处理的 Q 是目标侧的谱图帧、K 是源侧的谱图帧,两边都是上千帧的长序列,对齐关系既稀疏又难学。Translatotron 2 的解法是把注意力的 query 交给文本解码器:Q 来自一个短得多的、带明确语言单位的序列,K/V 来自源谱图的编码器输出。于是注意力学的是「源谱图帧 → 目标音素」的跨模态对齐,这比「长谱图 → 长谱图」容易得多。论文在 3.4 节明确说这是「significantly easier to learn」的。
同时,注意力的输出被送给合成器当作上下文。这意味着合成器不需要自己再对齐一次,它只需要在音素粒度上把源语音的声学信息「搬运」过来。多个头的注意力使这一步可以保留细粒度的副语言信息——论文举的例子是说话人轮换(speaker turns):同一个输入里先是一个人说话、再换一个人,模型能把两人的音色分别保留到输出中对应位置。
合成器:时长预测 + 上采样,不做注意力
合成器的内部结构见下图(Figure 1b)。它借鉴的是 Non-Attentive Tacotron(NAT)的思路:先给每个音素预测一个时长,再按时长把表示上采样到谱图帧率,然后用一个「RNN + 卷积」结构逐帧生成谱图,最后过一层残差卷积做细化。
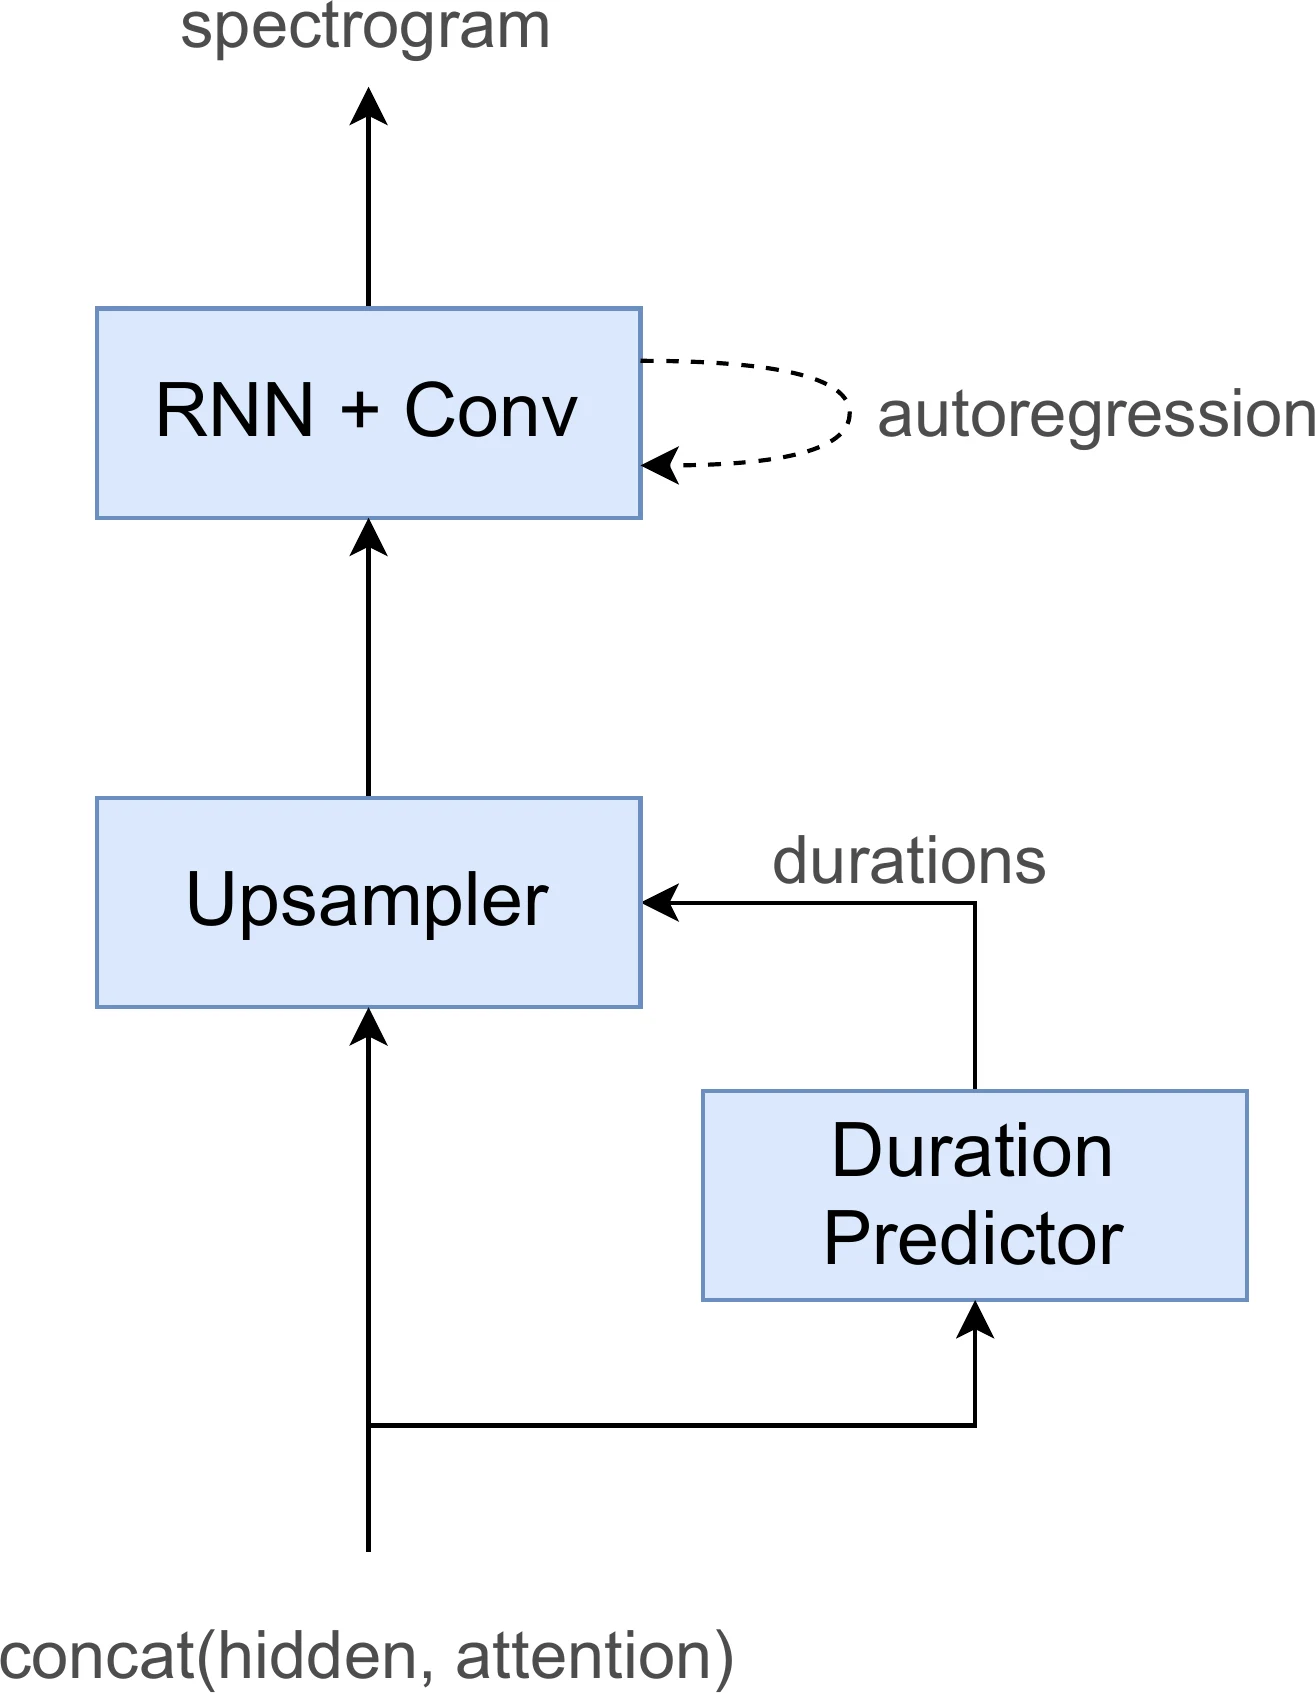
这一步对推理的影响很大。自回归 TTS 的典型故障是「过生成」:注意力在某一帧卡住,同一段声音被反复念,或者停在长停顿里出不来。Translatotron 受此困扰,而 Translatotron 2 的合成器根本没有注意力,它每一帧的输出长度由时长预测器给出,所以过生成在结构上就不太可能发生。论文用「未对齐时长比例」(Unaligned Duration Ratio,UDR,阈值 1 秒)来量化这个问题:Translatotron 2 在 Fisher 上为 0.07%,在对话数据集上为 0.16%,而原版 Translatotron 分别为 0.48% 和 0.69%,前者下降了约 7 倍和 4 倍。这个指标恰好是流式合成时最要紧的东西——如果模型在某处卡住,流式播放就会断音。
代价是时长模型的精度有限,且论文没有逐音素的时长标注(只有整句总时长的 L2 损失),因此训练时的时长监督比较弱,合成质量更多依赖注意力搬运过来的声学上下文。
音色保留:把克隆能力挪到训练时
Translatotron 2 的音色保留方法是个很简洁的推理工程决策:只在训练数据准备阶段使用跨语言音色克隆 TTS,推理路径上不放任何说话人编码器。
训练数据的目标侧是用一个零样本跨语言 TTS(改进版的 PnG NAT,加一个在 LibriTTS 上训练的说话人编码器)合成的,源侧与目标侧是同一个说话人的声音。模型在训练时学会「目标语音的音色应该跟源语音一致」这条规律,但推理时它没有任何可以用来指定其他说话人音色的接口。论文的说法是:这把「强大的音色转移能力」限制在了训练时(或数据准备时),避免生产部署中被用来生成任意人声的伪造音频。这比 Translatotron 那种「解码器可以吃任意参考音频」的设计在滥用风险上小得多。
这个设计带来一个额外约束:训练集的目标侧必须是「以源说话人音色合成」的句子,因此目标侧音质上限受限于这个克隆 TTS 本身。论文也承认,音色相似度评测的结果只能接近合成目标的上限。要让音色相似度继续往上,只能换更好的克隆 TTS 或直接用真人录制的平行数据。
说话人轮换:ConcatAug
单句训练数据里通常只有一个说话人,模型也就学不会「一个输入里有两个人」的情况。论文的做法是把训练集里两句话随机拼起来当一条新样本,源谱图、目标谱图、目标音素序列都拼,这就是 ConcatAug。这既增加了训练集中的说话人多样性,也让模型见到「语音中段音色突变」这种条件。
有意思的是,ConcatAug 在小数据集上还有额外收益:Fisher 上 BLEU 从 42.4 升到 42.9,而在对话数据集上略微下降(55.6→55.1)。论文的解释是提升样本多样性、增加声学条件复杂度,对小数据集帮助更大。
结果:和级联基本打平
Translatotron 2 在所有报告指标上都明显优于原版 Translatotron,其中翻译质量提升最显著——论文用同一套 ASR 重训并重评基线后,Fisher 从 26.9 升到 42.4(提升 15.5 BLEU),对话集从 50.4 升到 55.6(提升 5.2 BLEU),与级联系统的差距从 16.4 / 8.4 BLEU 缩小到 0.4 / 3.7 BLEU。语音自然度 MOS 与级联系统持平或接近(对话集 4.21 对级联的 4.31,注意二者用的声码器不同),UDR 大幅下降。音色保留一项,在插入 ConcatAug 训练后,说话人相似度评测能区分出「前段/后段对应哪个源说话人」,说明模型确实学到了轮换时的音色分离。
不过有一个隐含的代价需要点出来:这个架构的第二遍是声学谱图的自回归合成,解码步数是谱图帧数(约 150 帧/句),而且每帧都要经过一个 RNN 结构和卷积,比离散单元的序列长得多。在单机 CPU 上跑时,合成器往往是总延迟的最大项,这一点在 UnitY 那篇论文的解码效率实验里被量化得很清楚。
UnitY:先翻文本,再出单元
UnitY 的出发点在论文引言里有一句话总结得很好:从文本到离散声学单元的长度比大约是 1:25,而第二遍如果直接生成谱图,序列还要再长一个量级。既然第二遍才是耗时大头,那就把它换成一个短很多的目标。
什么是离散声学单元
离散声学单元(discrete acoustic units)是从自监督语音表示(HuBERT、wav2vec 2.0、XLS-R)里聚类出来的一组原型。通常做法是取某一层的连续表示,用 k-means 在大量无标注语音上聚类出 个中心(文献里常用 500 或 1000 个,SeamlessM4T 用了 1 万),每个帧映射到最近中心的索引,就得到一个 50 Hz 的 token 序列。这些单元保留了发音层面的信息但不是文字,所以生成单元比生成谱图短得多,也能被一个类似 TTS 的单元声码器还原为波形。UnitY 论文直接使用了 HuBERT 单元,目标语言侧用 u-mBART 做预训练。
架构:T2U 编码器是连接器
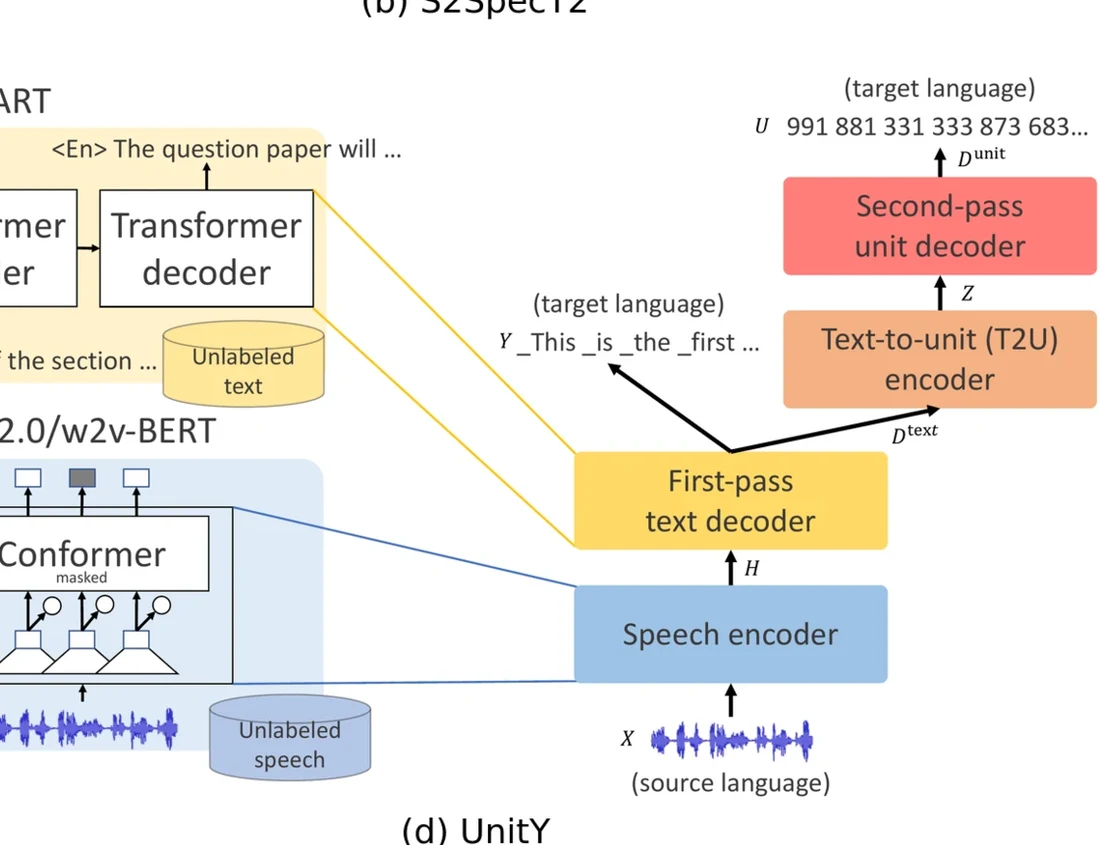
上图是把前面那张架构地图里最右边一格(UnitY)单独放大。图中最上层是目标语言方向的输出示意,左侧是源语言语音编码器,往右依次是第一遍文本解码器、T2U 编码器与第二遍单元解码器,右侧的单元序列 说明第二遍输出的是离散 token 而不是谱图。具体的张量流向如下。左侧是 wav2vec 2.0 或 w2v-BERT 编码器加 Conformer 堆叠的语音编码器,输出 ;中间的文本解码器通过多头交叉注意力读 ,自回归产出子词序列 。真正独特的部分是文本解码器与单元解码器之间的 T2U 编码器:它接收的输入不是文本 token 的嵌入,而是第一遍解码器在投影到 logits 之前的连续隐状态 ,序列长度与文本相同;T2U 编码器是一个双向 Transformer,把这个序列转成 ;再往右,第二遍的单元解码器以 为上下文,自回归产出离散单元序列 。
为什么需要这个 T2U 编码器,而不是直接把文本解码器输出喂给单元解码器?可以看 UnitY 论文的消融(Table 3):去掉 T2U 编码器后,UnitY 在 CVSS-C 上语音侧 ASR-BLEU 从 33.2 掉到 30.7,文本侧几乎不变(38.3 到 38.1)。这说明文本解码器的隐状态虽然已经含有语义,但它的表示空间是沿着文本 token 展开的,而单元解码器需要的表示空间更接近语音,需要一个专门的桥梁来做一次转译。论文在 2.1 节提到一个细节:他们在单元解码器上额外加了一路对语音编码器 的交叉注意力,期望它能补回第一遍丢掉的信息,但实验结果表明没有提升,说明文本解码器的隐状态经由多路交叉注意力已经带走了足够的源语声学信息。
单元解码器训练目标是标准的自回归交叉熵,加权重 的文本翻译损失后总目标为
其中 是以离散单元为目标的自回归交叉熵, 是第一遍文本解码器的翻译损失。注意单元解码器在这版设计里只看 ,不看 ,两遍之间的时间对齐仅通过 T2U 编码器的同长度关系来维护——论文专门说明这是有意为之,并且不指望第二遍去纠正第一遍的翻译错误。这一点让第一遍成为整条链路的语义瓶颈,反过来也决定了搜参优先级。
深浅两层解码器
UnitY 论文里一个不起眼但影响很大的选择是所谓「deep-shallow two-pass decoders」:第一遍文本解码器层数更多、更宽,第二遍单元解码器层数更少。理由是两遍的建模难度不一样:第一遍要做跨语言、跨模态的翻译,第二遍则是按已知文本照抄出单元序列,更难的是第一遍。把参数倾斜给第一遍,同时第二遍又短,整体算力反而下降。
两遍的搜索策略
推理时 UnitY 做两次 beam search:第一遍用 beam size 搜索文本假设 ,从对应的解码器状态出发,第二遍用 beam size 搜索单元序列 。作者的经验是 ,因为第一遍的候选多样性远大于第二遍;他们把第二遍默认设为 1(贪心),而第一遍默认 10。这是一个很实用的推理工程观察:计算预算应该优先堆在不确定性高的那遍,而单元解码器的输出几乎是确定的,加宽 beam 只会白白增加解码步。
结果
在 CVSS-C 上,与 S2UT(单遍文本加单元)相比,UnitY 平均提升 1.6 ASR-BLEU,作者把这块增益直接归功于「两遍解码」;在多领域西班牙语到英语上,用 t-mBART 预训练文本解码器后,UnitY 比用 u-mBART 预训练的 S2UT 在英语到西语方向与西语到英语方向上分别提升 1.3 和 2.5 ASR-BLEU。解码效率方面,在 Intel Xeon Gold 6230 CPU 上、计入声码器时间,UnitY 相比 S2SpecT2 和 S2UT 分别快 2.51 倍和 2.83 倍,FLOPs 分别约为后两者的 1/1.65 与 1/3.19。关键还是序列长度:S2SpecT 的解码输出是谱图帧(数百到上千步),S2UT 和 UnitY 是单元(约 25 倍文本长度),UnitY 又把文本侧算力倾斜给了第一遍的短序列搜索。
这套「先文本、后单元」的分工看起来像是把级联重新装了一遍,但两者区别很大:级联的三段是独立训练的,TTS 与翻译模块之间没有共享的中间表示,翻译一旦产出文本就与声学完全脱钩;而 UnitY 的 T2U 编码器吃的是带声学上下文的文本解码器隐状态,第二遍保留了第一遍所对齐的那部分源语声学信息。这算是两遍直接模型和级联之间最微妙的差别。
SeamlessM4T:把组件拼成一个多语言多任务模型
UnitY 的贡献是局部结构,SeamlessM4T 的贡献是把这些结构扩展成一个多语言、多任务、预训练组件充分复用的大模型。
四个积木
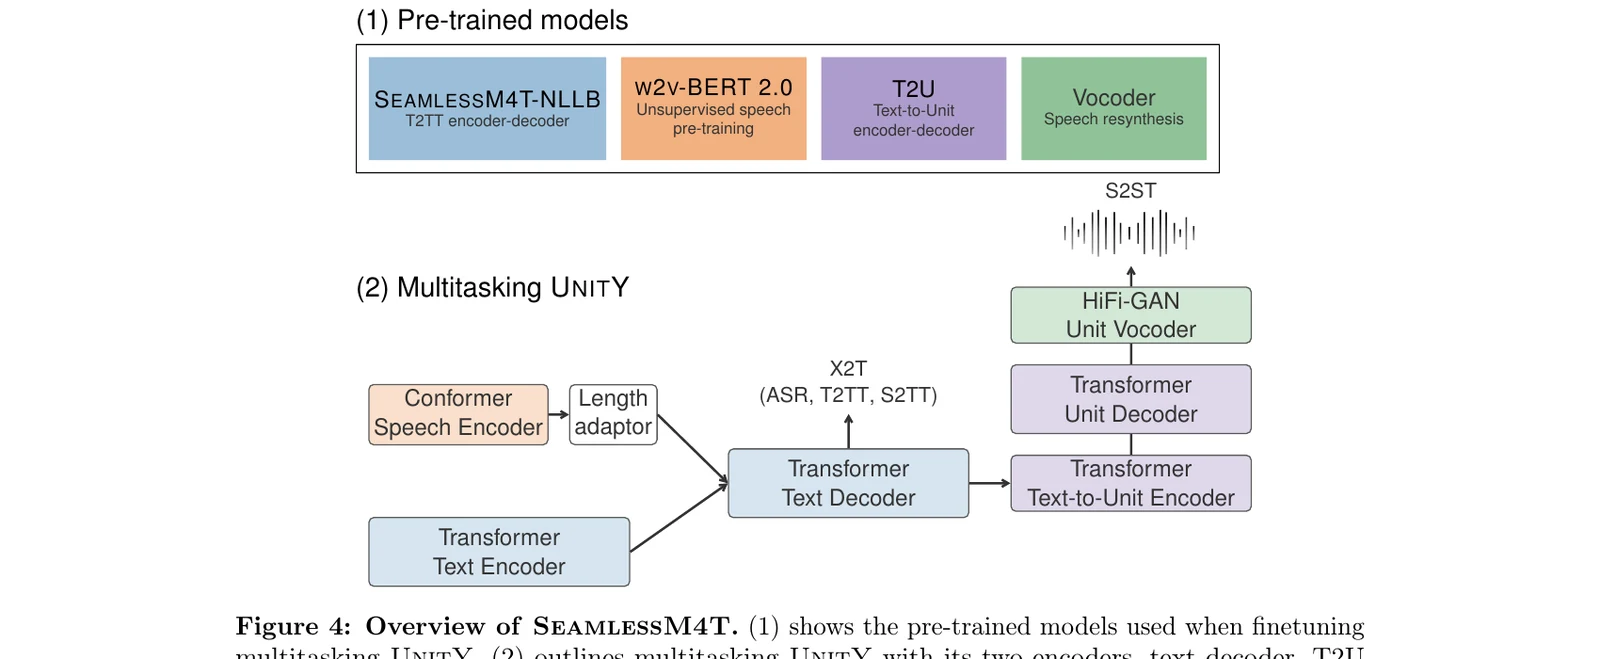
上图截自 SeamlessM4T 论文的 Figure 4。上半部分标「(1) Pre-trained models」的是四个可复用的组件:SeamlessM4T-NLLB(一个在 NLLB 数据上训练的文本到文本翻译模型)、w2v-BERT 2.0(无监督语音预训练模型)、T2U(文本到单元模型)、HiFi-GAN 单元声码器。下半部分「(2) Multitasking UnitY」就是它们组合后的运行时结构:Conformer 语音编码器接长度适配器,再与 NLLB 文本编码器一路汇入同一个 Transformer 文本解码器;文本解码器之后是 T2U 编码器与单元解码器,最后是单元声码器。注意这里的文本解码器只有一个,语音输入和文本输入共享它。
这个「两个编码器、一个解码器」的设计让同一个模型可以处理多种任务:语音到文本翻译(S2TT)、语音到语音翻译(S2ST)、文本到文本翻译(T2TT)、自动语音识别(ASR),甚至零样本的文本到语音(T2ST)。推理时选择哪个编码器输入,就是选择哪个任务。
分阶段训练与知识蒸馏
处理语音或文本输入、输出文本的 X2T 模型训练分两阶段。Stage 1 只在英文侧数据上训练(含语音到英文文本与英文 ASR),Stage 2 加入英文到其他语言的 S2TT 与非英文 ASR。为什么要先只训英文?论文的解释是:多语言联合训练时,目标侧的梯度会干扰源侧声学表示的学习,先集中到一个目标语言可以把这块表示稳住,之后再放开。这个观察对做多语言模型的团队有参考意义——分阶段而不是一开始就全语言混训。
文本侧的知识主要来自 NLLB 的文本到文本翻译模型,具体方式是对每个文本解码步做 token 级知识蒸馏:
这里 是目标文本已经生成的前缀, 与 分别是同一个句子的源文本与源语音, 是目标序列长度。左边分布来自文本模型(teacher),右边是语音翻译模型(student), 度量的是语音路径对下一步词的预测与文本路径对下一步词的预测之间的 KL 散度,训练时把它与 S2TT 损失、T2TT 损失加权求和。直觉上:语音编码器不需要从零学会在语言上等同于文本编码器,它只要沿着文本模型已经掌握的目标分布去走即可。这个损失在推理时完全不存在,只在训练阶段给梯度。
语音编码器与长度适配
语音侧的编码器是 w2v-BERT 2.0,约 6 亿参数、24 层 Conformer,用 100 万小时无标注语音训练。它的训练目标同时包含对比学习(产物是 GVQ 码本)和两个掩码预测任务——一个预测 GVQ 码,一个预测随机投影量化(RPQ)的码。三个损失加权为
其中 、、 分别是对比损失、GVQ 掩码预测损失、RPQ 掩码预测损失的权重,取值为 1.0、0.5、0.5。这个配置比原版 w2v-BERT 多一路 RPQ 掩码预测,作用类似多一个 teacher 来约束表示。
编码器之后接一个长度适配器(length adapter),是 M-adaptor 的改进版:M-adaptor 原本对 Q、K、V 各用一个独立的池化模块,这里改成共享一个池化模块以提高效率。它把编码器输出的 50 Hz 序列按固定比例下采样,把每帧对应的文本 token 长度压到与原文本编码器接近的量级,再送进共享的文本解码器。这个下采样率的选择是一个取舍:下采样越激进,解码步骤越少、延迟越低,但能保留的声学细节越少;对于要同时兼顾 ASR 与翻译的任务,通常把语音序列压到略长于文本序列,既不浪费解码步,又不至于丢音。
离散单元的生成与声码器
SeamlessM4T 的单元从 XLS-R-1B 第 35 层的连续表示通过 k-means 聚类得到,论文比较了候选码本大小 1000、2000、5000、10000, 时单元到语音的重合成 WER 最低。这一点值得注意:单元码本越大,每个单元携带的发音信息越细,但也意味着单元序列的「词表」更大、训练更难拟合。另一个细节是,他们试过用 w2v-BERT 2.0 作为单元来源,但效果不如 XLS-R,原因是 w2v-BERT 2.0 的对比加掩码目标更偏向语义,而单元声码器需要的是声学信息。
单元到波形由单元声码器完成,SeamlessM4T 用的是带语言嵌入的多语言 HiFi-GAN:每个目标语言有一个语言嵌入,用一个语言辨识分类器作辅助损失,帮助模型在多语言混合训练时把各语言的声学特性分开。声码器的推理时长只与单元数成正比,而单元数是文本长度的约 25 倍,这是 UnitY 那条链条上第二个需要算入延迟的地方。
第三阶段:把 T2U 训起来
Stage 3 才开始加 T2U 组件。论文把原始 UnitY 的浅 T2U(一个浅编码器加单元解码器)替换成 6 层 Transformer 编码器与解码器,并对整个 T2U 做预训练,而不是像 UnitY 那样从零训练。他们给出两个动机:X2T 的预训练给出了更强的语音编码器与文本解码器;T2U 的预训练与加深(论文写的是一个 6 层的 Transformer 编码器—解码器)让多语言单元生成不再互相干扰。换句话说,原版 UnitY 在单语言的西班牙语到英语上可行的浅 T2U,在多语言的 SeamlessM4T 里需要更大的容量。
SeamlessM4T v2 / UnitY2:第二遍改成非自回归
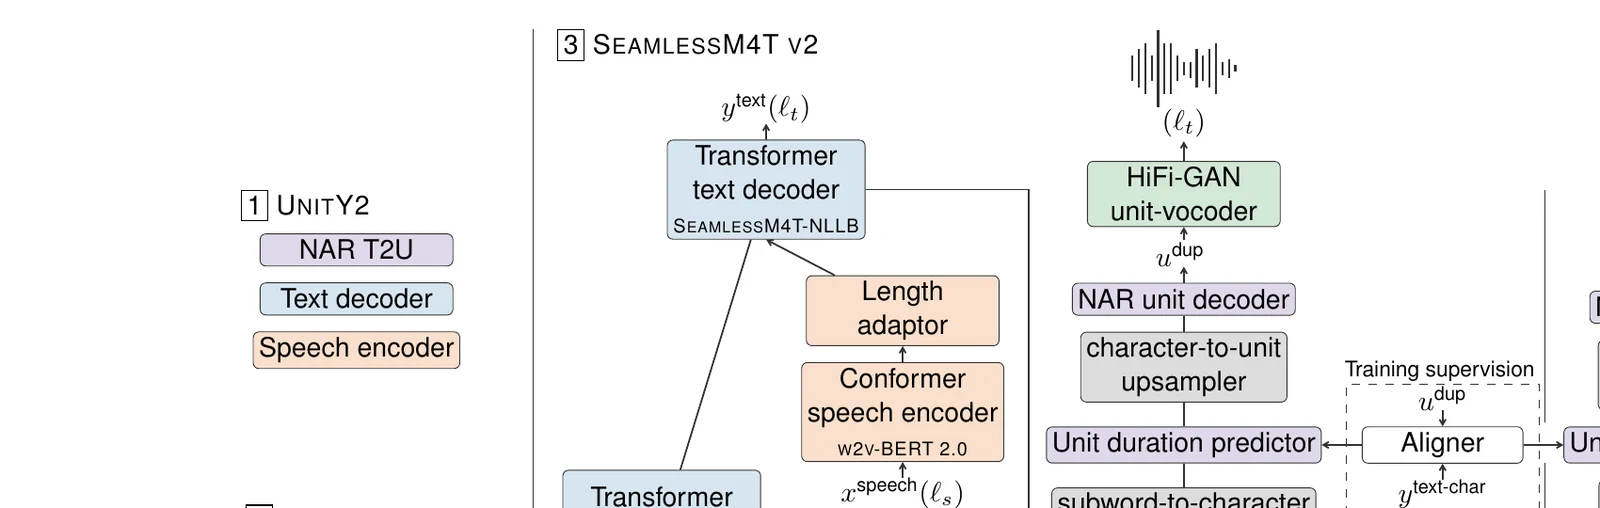
上图截自 Seamless 论文的 Figure 3 Panel (1)。与 UnitY 相比,最明显的改动是第二遍:NAR T2U 只有一个 NAR 单元解码器,它的输入是经过「子词到字符上采样」与「字符到单元上采样」(时长预测器)之后的表示,旁边还有一个只在训练时参与的对齐器。单元声码器把预测出的未压缩单元序列还原成波形。
为什么自回归单元解码器不够好
UnitY 的第二遍是自回归的,其输出序列是单元序列,而单元序列的长度约是文本子词序列的 25 倍。Seamless 论文给出的问题是:T2U 模型在假标注(pseudo-labeling)时会出现幻觉或截断。幻觉指生成了原文本里没有的单元,截断指单元序列没生成完就停了。作者把原因归结为文本子词与单元之间的长度严重不对齐:25 倍的差距让自回归模型很难在同一遍里维护语义边界,模型一旦在某个句子上开始重复单元或提前结束,整条声码器链路就跟着错。
非自回归怎么生成不同长度的序列
非自回归解码的核心前提是:模型必须知道每个输入位置要输出多少个输出 token,即时长。UnitY2 借鉴了 FastSpeech 2 的结构(时长预测器加长度调节),但把监督它的时长从文本的「字符级」推到「单元级」,并分两步上采样。
第一步是子词到字符:对每个子词表示 ,按该子词包含的字符数 复制,并在复制的每个位置上加上字符嵌入与字符级位置编码:
这里 是字符嵌入表, 是第 个字符的 id, 是字符级位置编码, 是模型维度。第二步是字符到单元:对每个字符表示 ,用时长预测器 预测它对应的重复单元个数 ,再按此复制并加上单元级位置编码:
其中 是可学习的缩放系数, 是单元级位置编码, 落在第 个字符展开出的单元区间内。两者之间的关系是:第一个上采样器决定的 是输入文本里已知的,不需要预测;第二个上采样器的 才是需要预测的——每个字符展开出的单元数虽然因语言和语速而异,但它的取值集中、方差远小于整句总时长,所以预测器难度大幅降低。
论文强调 UnitY2 预测的是带重复的、未压缩的单元序列,而不是把连续重复的单元压成一个。这看起来奇怪:未压缩序列更长,推理不是更慢吗?但论文的理由是:如果压缩,模型还要再学一个「哪些单元重复」的规则,这本身就是一段难学的隐式对齐;而未压缩的序列可以完全由时长预测器决定,只需要一个字符级 CTC 对齐。由于解码是非自回归的,序列加长不影响解码步数,只是声码器的输入变长——而声码器本来就是逐单元累积的,长一点问题不大。
时长从哪来:无监督的对齐器
时长预测器需要每个字符对应多少个单元,这在多语言场景下无法靠强制对齐工具(例如 MFA)来获得,因为很多低资源语言根本没有可用的声学模型。UnitY2 的解法是训练一个无监督的多语言字符—单元对齐器(RAD-TTS 风格)。它有两个编码器分别编码字符序列与单元序列,算出距离 ,再经过一个有对齐先验的 softmax 得到软对齐矩阵:
与 分别是字符编码器与单元编码器的输出, 是一个 Beta-binomial 先验,鼓励对齐路径接近对角线(语音与文本在时间上大体单调对应)。训练 8k 步后关闭该先验,让对齐器自己学得更精细。然后用单调对齐搜索(MAS)从软对齐里取出硬对齐 。对齐器的训练目标是对所有合法单调路径边缘化后的对数似然 (用 CTC 损失有效实现),再加一个二值化损失 ,它等价于两种对齐之间的 KL 散度。时长预测器以对齐器给出的时长为目标值做对数域的 MSE 回归。
这套结构对推理意味着什么?推理时不需要对齐器。对齐器只在训练阶段用来生成时长标签给时长预测器,推理时只走字符到单元的时长预测这一条路。
非自回归解码的多模态问题与跳步训练
非自回归模型的根本困难是「多模态输出」:给定同一段文本,单元序列并不是一个确定性序列,相邻单元的联合分布高度依赖,而 NAR 模型假设各位置条件独立,训练时会倾向于输出「平均」的最可能序列,丢失多样性,也容易出现重复单元。
UnitY2 用的是 Glancing Transformer(GLAT)这一族方法,即训练时随机把一部分目标位置的输入换成真值 token,降低学习难度;推理时则以全零输入一次前向。论文的改进是 span-based glancing:如果直接在单元层随机掩码,相邻单元高度局部相关(同样的单元经常连续重复),掩码掉一个单位等于什么都没遮住。所以他们在字符层选位置:给定预测准确率 ,按 采样要遮的字符位置,再通过 映射到对应的单元位置,把这些位置的单元嵌入换成真值。这样一次遮掉的是若干个连续单元,模型必须依赖更长的上文来推理。
另一个效率细节:GLAT 传统做法是每一步再跑一遍前向,用这一遍的准确率估计 。UnitY2 改成从过去 步记录里的准确率估计 ,不额外前向。这让训练成本基本回到一次前向。
第二遍的总损失为
其中 是单元交叉熵, 是时长回归, 是单元解码器中间层的字符级 CTC 损失(加速收敛),后两项来自对齐器。
教师与学生、以及推理时的形式
UnitY2 训练了两个 T2U:一个教师用于给 T2U 数据打假标注(输入字符、12 编码层加 12 解码层),一个学生用于初始化 UnitY2 里的 T2U(输入子词、6 加 6 层)。论文特意强调,非自回归的教师模型「几乎不会幻觉」,因为时长建模与序列生成是解耦的——这是把 T2U 改成 NAR 的额外好处:假标注数据质量上升,从而 S2ST 训练本身更可靠。
对推理服务来说,UnitY2 的第二遍从「逐单元自回归」变成「一次前向产出整段单元加一次时长预测」,在 GPU 上这是相当可观的节省,而且更关键的一点是:它把第二遍的输出时序完全外化成时长预测。这一点后来被 SeamlessStreaming 直接利用。
SeamlessExpressive 与 SeamlessStreaming:从能翻到翻得像、边说边翻
Seamless 系列论文在 v2 的 UnitY2 之上又派生出两个模型,它们不改变主干架构,而是对解码器的行为做了两种约束:一个要求你保留韵律,一个要求你提前开口。
SeamlessExpressive:两个组件级联,把韵律当成条件
表达性翻译在 Seamless 里的做法是拆成两个模块级联:
- Prosody UnitY2:是一个基于 UnitY2 的翻译模型,但文本解码器额外学习「停顿」标签(来自训练数据里人工标注的 pause tag),并且在翻译时额外接收一个表达性嵌入(expressivity embedding)作为条件。这个嵌入由 PRETSSEL 的编码器产生,PRETSSEL 本身是一个在表达性语音上预训练的韵律与风格表示模型;论文的做法是用 PRETSSEL 参数初始化表达性编码器,然后与翻译模型联合训练。
- PRETSSEL 的 textless 声学模型:在拿到单元序列与单元时长后,从单元生成 mel 谱,再交给声码器。
结构上可以理解成:翻译负责语义,韵律作为额外条件从源语音中提取出来,进入翻译的每一步。这种条件注入与 TTS 里把说话人嵌入拼进解码器输入的做法在机制上同源:让一个外部嵌入在每一步影响输出分布,只是这里的嵌入来自源语音的韵律编码器,而且与翻译模型联合训练。代价是需要额外的编码器和联合训练,推理时多一次 PRETSSEL 编码;覆盖范围也有限,论文只报告了英文到五种语言(以及反向)的表达性翻译。
为什么韵律不能靠 UnitY 的架构自然保留?因为单元是从自监督语音表示里聚类出来的,它们主要保留发音信息,音高、能量、语速这些在聚类中几乎被平均掉了。Prosody UnitY2 的改进只是在文本层加了停顿标签,以及通过条件嵌入让单元序列的分布略微更接近源语音的节奏;真正的韵律细节要靠 PRETSSEL 的声学模型补回来。
SeamlessStreaming:EMMA 决定什么时候开口
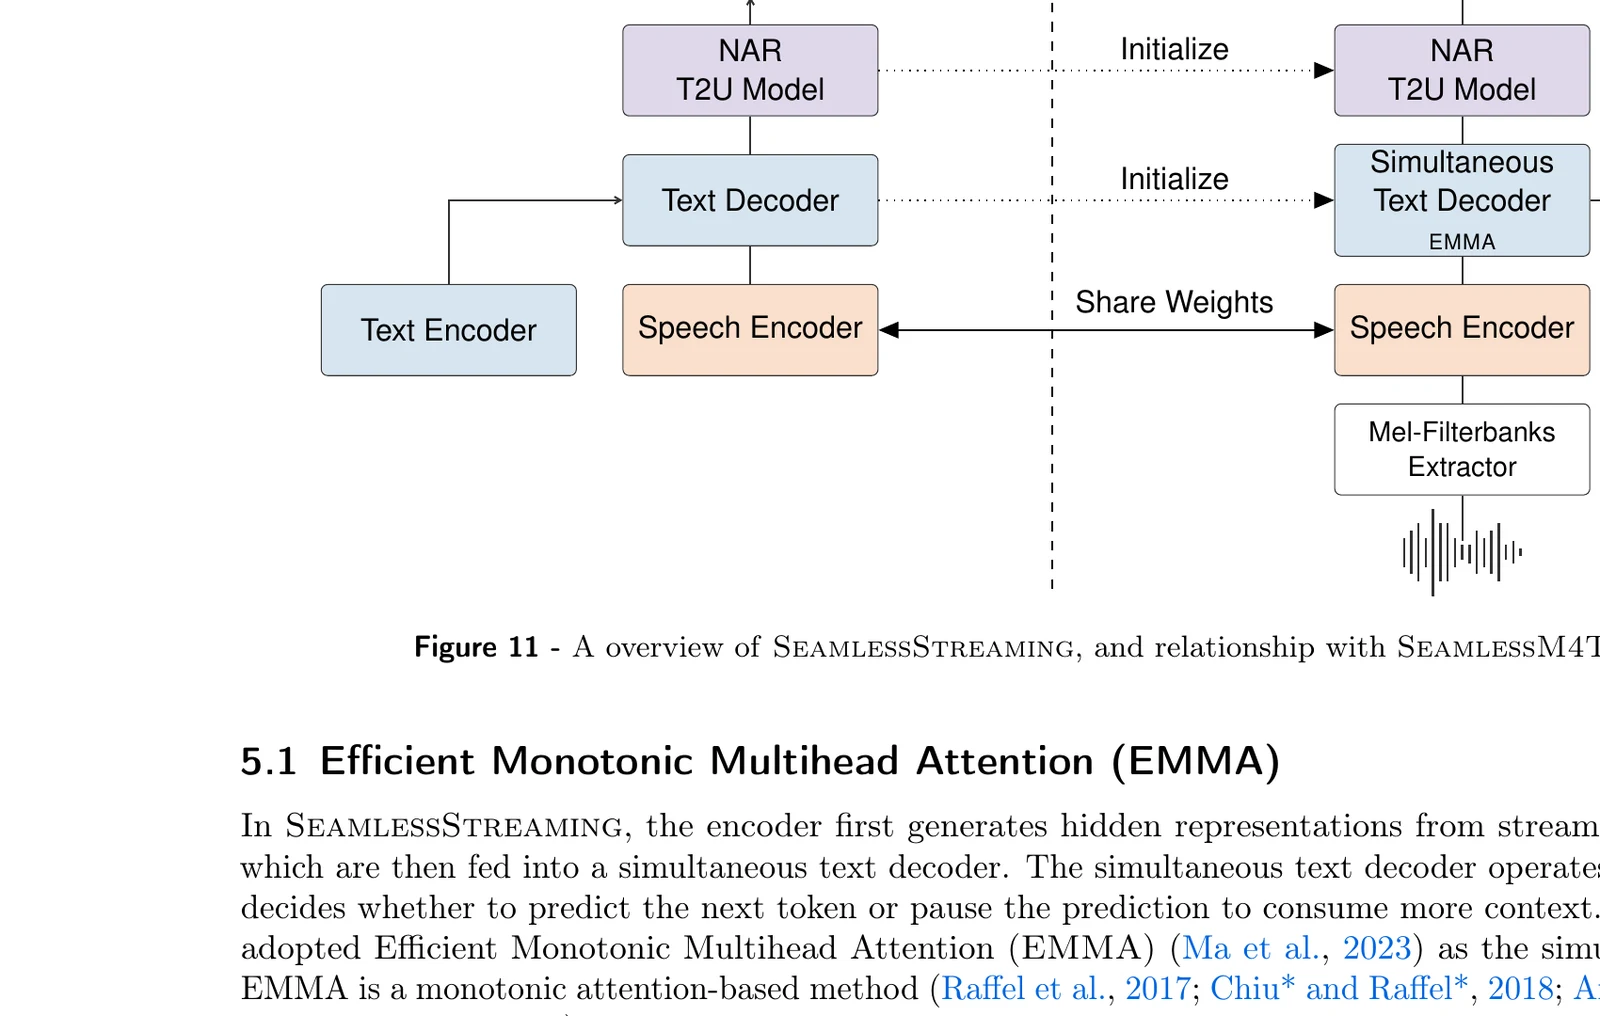
上图是 Seamless 论文的 Figure 11。左边是 SeamlessM4T v2:文本解码器、NAR T2U、HiFi-GAN 单元声码器。右边是 SeamlessStreaming:它与左图共享文本编码器与语音编码器的权重,初始化文本解码器与 NAR T2U 的权重,然后把文本解码器换成带 EMMA 的同时解码器。关键区别在于:左边是完整的离线模型,右边每次只拿一段源语音就推进一次解码,不等待句子结束。
EMMA(Efficient Monotonic Multihead Attention,Ma 等人,2023,arXiv:2312.04515)是这里的同时翻译策略。它把「什么时候该继续翻译、什么时候该等待更多输入」做成每个注意力头上独立可学的概率。对每个注意力头,在解码步 (已输出前 个词)与源位置 之间,计算一个步进概率:
是上一步的解码器状态, 是第 个源编码器状态, 与 是两个能量投影网络, 是可学习偏置(初始化为负值,使得训练一开始行为接近离线策略), 是温度,用来让输出更接近 0 或 1。 表示「在看到源位置 时,是否已经可以输出第 个词」的概率。把「输出第 个词时恰好读了 个源帧」的概率记为 ,按单调注意力的定义:
直观理解: 是上一步停在源位置 的概率,要走到 ,必须在 之后、 之前的每个位置都没有跳(概率因子 ),最后在第 处跳。
这个递推式计算不是局部的,但 EMMA 把它整理成一个闭合、数值稳定的并行形式:
不必逐项理解每个算子的符号,重要的是一点:它用累积乘加上三角掩码表达了这个递推,所以在训练时可以按整行一次性算完。早期单调注意力需要一个分母,导致数值不稳定且有偏;EMMA 去掉了分母,因此训练更稳。
之后把 转成注意力权重:
其中 是原始注意力能量。训练时只用无限回溯(infinite lookback)变体,因此需要加两类正则防止模型退化为离线策略。第一类是期望延迟损失:
是输出第 个词时期望已读的源帧数,即延迟的期望; 是该延迟值的代价函数。第二类是对齐方差损失:
是 在分布 下的方差。前者约束平均延迟,后者鼓励注意力集中,避免模型对每个位置都保留一点概率而学得模棱两可。最终损失为 。
推理时,EMMA 的规则可以用一段伪代码说清:
输入:流式语音分块,阈值 t_EMMA,最小单元块长 L_unit状态:文本假设前缀 y,解码器状态 s,未合成单元计数 k
while 未遇到结束符: 接收一块新语音,更新编码器 h_<=j repeat: p = min over heads of stepwise_probability(h_j, s_{i-1}) if p < t_EMMA: break # 所有头都还不想跳,等待更多输入 解码出下一个文本 token,更新 s,k += 1 if k > 0: 用 NAR T2U 从新增的 k 个文本状态生成单元块 if 单元块长度 >= L_unit: 声码器合成,追加到输出音频,k = 0这是原论文 Algorithm 1 的要点,省略了语言标签与索引细节。这里有两个设计特别值得注意。第一,p 取所有头的最小值:只要有一个头认为还不能跳,就暂停,整体上更保守——这符合同时翻译里宁可等一会儿也不要翻错的原则。第二,t_EMMA 是运行时调节质量与延迟折中的旋钮:阈值越小越保守,延迟越大;阈值越大越激进,可能翻译质量下降或出现截断。论文报告在 Fleurs 上 0.4 到 0.7 的阈值范围内,X→eng 的 BLEU 从 19.8 升到 20.3,同时平均延迟从 1.59 秒升到 1.84 秒,这是一条清晰的折中曲线。
另外,为什么 SeamlessStreaming 能直接用 NAR T2U?这是 UnitY2 改成非自回归带来的直接收益:文本解码器每推进一步,就有一组已定稿的文本状态;把这些状态送进 T2U 的 NAR 解码器,一次性产出对应单元块,不需要等整句结束。如果第二遍仍是自回归的,就必须先确定整句边界才能开始解码单元,否则时长预测无从谈起。
流式微调的两阶段
SeamlessStreaming 不是从零训练,而是分两阶段在 SeamlessM4T v2 上微调。Stage 1 只训练同时文本解码器(带 EMMA 的步进概率网络),冻结语音编码器,文本解码器的生成部分从 v2 初始化,步进概率网络随机初始化并加负偏置使其从离线策略起步。Stage 2 冻结语音到文本部分,只微调 T2U 组件。这样每个阶段只动一小块参数,既能保住 v2 的语言覆盖与语义质量,又不用重新训练整个大模型。这两阶段流程本质上是一种增量适配:不改主干,只改何时开口的那部分控制逻辑。
三条路线放在一起看
把几种模型放到同一张表里,差异会更清晰。下表是从各论文中整理的关键结构对照:
| 模型 | 中间表示 | 第二遍解码 | 声码器 | 主要延迟位置 |
|---|---|---|---|---|
| Translatotron (2019) | 无(直接谱图) | 自回归谱图帧 | Griffin-Lim 或 WaveRNN | 谱图解码步数 |
| Translatotron 2 (2021) | 音素(文本解码器产出) | 时长预测加非注意力谱图合成 | Griffin-Lim 或 WaveRNN | 谱图合成时长 |
| UnitY (2022) | 子词文本加离散单元 | 自回归单元解码 | 单元 HiFi-GAN | 第一遍 beam 搜索加单元解码 |
| SeamlessM4T (2023) | 子词文本加离散单元 | 自回归单元解码(深 T2U) | 多语言单元 HiFi-GAN | 第一遍加单元解码 |
| SeamlessM4T v2 (2023) | 子词、字符、未压缩单元 | 非自回归单元解码(时长预测) | 多语言单元 HiFi-GAN | 第一遍解码 |
| SeamlessStreaming (2023) | 同上 | EMMA 同时解码加 NAR T2U | 多语言单元 HiFi-GAN | 由 t_EMMA 控制 |
可以从中抽出一条贯穿全系列的规律:S2ST 的总延迟几乎总是由解码步数最多、又串行执行的那一段决定。Translatotron 的问题在谱图帧长;Translatotron 2 把注意力换成时长后缩短了合成路径但仍是逐帧;UnitY 把目标换成单元,序列短了 6 倍左右,但第二遍仍是自回归;SeamlessM4T v2 把第二遍变成一次前向,串行瓶颈重新回到第一遍文本解码;SeamlessStreaming 则直接把第一遍也拆成小块,用 EMMA 控制何时推进。
推理服务里要算的几笔账
如果要把这套链路真正部署成服务,下面几项开销需要逐项估算。
第一遍文本解码。这是当前所有 Seamless 系模型的瓶颈,因为它是语言模型形式的自回归解码,步数等于目标文本 token 数。对一句 10 个词的目标文本,通常 15 到 25 个子词,第一遍解码约 20 步,每步要做一次完整的 Transformer 前向。编码器的 K/V 在这个阶段可以复用,这正是标准 KV 缓存的作用;站内关于 KV 缓存与 PagedAttention 的文章可以作为理解这套复用的基础,可参考 PagedAttention 完全拆解:操作系统分页思想如何拯救 LLM 推理的内存利用率。
单元序列的长度。单元序列约为文本的 25 倍,声码器要处理的数量级是几百到上千个单元。多语言 HiFi-GAN 声码器的层数是固定的卷积堆叠,单次推理时长与单元数近似线性;但对于 NAR T2U 来说,单元序列与声码器是可以边算边合成的:只要一段单元块已经定稿(即文本状态已定稿),后面就是一次前向加一次声码器调用,两者都可以按块流水。SeamlessStreaming 的最小单元块长 就是控制这个流水粒度:块太小声码器调用频繁、开销高;块太大会让音频输出更成段地出现。
单元声码器的逐块衔接。HiFi-GAN 是卷积声码器,相邻块的边界容易在波形上留下不连续点。原论文的流式推理用了最小块长,并在官方开源实现与 SimulEval 管线里处理边界,这里不展开实现细节,但需要记住:流式的质量不只看翻译,还要看声码器的块边界处理,否则用户听到的是「翻得好,但听起来一顿一顿」。
长度适配与单元数预测的误差。UnitY2 的时长预测器误差会逐字符累积。如果一个句子的预测总时长偏短,声码器得到的是不完整的单元,听众会觉得语速太快、某些词被吞;偏长则会有拖长音。因为时长预测器是一个回归模型,部署时应做整体校准:若整句单元数与训练数据的统计均值偏移超过某个阈值,可以把时长整体按比例缩放。这类校准不需要重新训练,只是推理侧的后处理。
单元码本大小与声码器容量。 在 SeamlessM4T 里是最好的,但这意味着单元嵌入矩阵是一个 10000 乘 的查表,声码器要带着语言嵌入处理 36 种目标语言。如果要做更小的部署(例如边缘设备),通常会选择小码本( 到 )加更充分的声码器设计,代价是单元序列更长。这属于单元声码器本身的工程权衡,这也与站内 音频生成的离散 token 路线:RVQ 编解码器与 codec 语言模型的架构拆解 中讨论的单元/码本规模权衡相互印证。
这套架构走到哪里就为止了
把上述几种设计放到一起,可以看到它们共享一个共同前提:必须有一个中间语义表示,或是文本(UnitY 与 Seamless),或是音素(Translatotron 2),或是离散单元(UnitY2 与 Seamless)。Translatotron 那种谱图直接到谱图的路线几乎被放弃了,原因不是它的想法不好,而是直接谱图解码的计算与鲁棒性代价在长序列上太明显。即使 Translatotron 2 回到了文本作为中间表示,它也是把文本理解为音素序列,而不是自然语言意义上的词;这就是为什么后来 Seamless 系列的 T2U 输入要用子词甚至字符级序列,它实际上是在向语言单位靠拢。
几个尚未被很好解决的问题:
- 副语言信息的保留仍然依赖专门的旁支。SeamlessExpressive 的韵律保留需要额外的 PRETSSEL 编码器与联合训练;单元本身丢掉了音高与能量。能不能在单元序列里就编码韵律,是一个开放问题。
- 低资源语言的对齐器。UnitY2 靠无监督字符—单元对齐器,但它的训练需要该语言有大量无标注单元序列与文本;低资源语言的对齐质量仍然是翻译质量的瓶颈。
- 同时翻译的端到端评估。EMMA 的策略是在文本层控制的,但语音输出还要经过单元生成与声码器,最终音频的结束偏移并不完全由 EMMA 的延迟指标决定。质量与延迟的曲线在语音输出上比文本输出更复杂。
- 音色与身份的伦理边界。Translatotron 2 把音色克隆限制在训练时,但 Seamless 系列默认保留源说话人音色,这与伪造音色的风险只隔了一层使用约束。生产部署时,音色保留能力和反滥用措施需要一起考虑。
小结
S2ST 的基础架构只有一条主线:把源语音到目标语音拆成源语音到中间表示与中间表示到目标语音两段,再在每段里选择表示类型、解码方式与对齐方式。Translatotron 证明了直接谱图翻译可行,但对齐难学、合成器鲁棒性差;Translatotron 2 用文本(音素)解码器来导航注意力,把合成器改成时长驱动的非注意力结构,同时把音色克隆移出推理路径;UnitY 把第二遍目标换成离散单元,并用一个 T2U 编码器把第一遍的连续状态接到第二遍;SeamlessM4T 把这些组件拼成多语言多任务模型,用冻结的文本知识通过蒸馏引导语音路径;SeamlessM4T v2 把第二遍改成非自回归,靠时长预测器与外化对齐器解决长度失配;SeamlessStreaming 在此基础上加上 EMMA,把第一遍也切成小块,做到真正的边听边说。
对推理工程而言,这套链路最值得记住的三件事是:解码步数决定延迟,把任意一段从逐 token 换成一次前向都能大幅降低延迟;时长预测是连接语义表示与波形的最关键组件,它决定第二遍能否并行;对齐是有成本的,无监督对齐器只在训练时使用,但其质量决定时长预测器的上限,而后者决定推理的稳定性。
参考资料
- Direct speech-to-speech translation with a sequence-to-sequence model(Translatotron,arXiv:1904.06037)
- Translatotron 2: High-quality direct speech-to-speech translation with voice preservation(arXiv:2107.08661)
- UnitY: Two-pass Direct Speech-to-speech Translation with Discrete Units(arXiv:2212.08055)
- SeamlessM4T: Massively Multilingual & Multimodal Machine Translation(arXiv:2308.11596)
- Seamless: Multilingual Expressive and Streaming Speech Translation(arXiv:2312.05187)
- Efficient Monotonic Multihead Attention(arXiv:2312.04515)
- FastSpeech 2: Fast and High-Quality End-to-End Text to Speech(arXiv:2006.04558)
- BigVGAN: A Universal Neural Vocoder with Large-Scale Training(arXiv:2206.04658)
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



