


音频生成的离散 token 路线:RVQ 编解码器与 codec 语言模型的架构拆解
这一篇要解决的问题
音频生成本身有一条与图像、视频完全不同的技术分岔。图像的潜空间扩散走的是”把像素压成连续潜变量,再用连续扩散去噪”的路线,前面已经用多篇篇幅拆过;而语音与音乐还有另一条路线,它把声音直接量化成离散 token,然后把生成问题交给一个标准的自回归语言模型。VALL-E、MusicGen、AudioLM、Moshi 都属于这条路线。
这条路线的每一个环节都可以单独写成一篇。这里先回答最基础的一组问题:一段 24 kHz 的波形,凭什么能变成几千个 token?残差向量量化(RVQ)如何在”码本有限”和”重建保真”之间做取舍?有了 token 之后,VALL-E 和 MusicGen 的 Transformer 到底在预测什么?最后,这套结构落到推理侧,序列有多长、KV 缓存要存多少,以及流式化到底难在哪里。
地基一:把波形压缩成 token 的两条轴
要在 token 空间里做生成,第一步得先把波形变成 token。这一步的代价直接决定后面所有设计。
一段波形在计算机里就是每秒上万个采样点。以 24 kHz、16 bit 单声道为例,一秒音频是 24000 个采样点、48 KB 数据。如果直接按采样值建语言模型,每个时间步要预测 65536 个可能值中的哪一个,而且序列长度是每秒 24000 步。这两个数字任何一个都足以让生成模型失去可行性:序列太长,注意力成本按长度的平方增长;词表太大,输出投影层的参数量和计算量都跟着爆炸。
所以所有这条路线的系统都先做同一件事:把波形压成低帧率的离散表示。压缩分成两个互相独立的方向。
- 时间方向:用卷积编码器把连续多个采样点合成为一个时间步。常见的下采样倍数是 320 或 640,对应 24 kHz 下每秒 75 个时间步,或 32 kHz 下每秒 50 个时间步。
- 数值方向:每个时间步的向量不是连续的浮点数,而是从一张有限的码本里查出来的整数索引。
两个方向叠加,一段 10 秒的语音就从约 24 万个采样值变成了几千个 token。以 VALL-E 的配置为例,一个 10 秒波形经编码器后得到 的离散矩阵,也就是每秒 75 个时间步、每个时间步 8 个码本索引。后面几节要讲的架构,全部建立在这个矩阵的形状上。
地基二:向量量化与残差向量量化
压完时间维度之后,每个时间步还是一个连续向量。向量量化(Vector Quantization, VQ)负责把连续向量变成索引。
为什么是向量而不是标量
标量量化(比如 PCM 音频的 16 bit 线性量化)对每个数值独立处理,不利用各维之间的相关性。向量量化把一整组数值当作一个点,用”最近邻查表”的方式整体替换:码本里有 个向量 ,输入向量 被替换成
码本大小 决定每个索引需要多少个比特: 时是 10 bit, 时是 11 bit。编码只存索引,解码时按索引查回向量,重建误差就是 。
码本大小在这里有一个直接的代价:码本本身是学习出来的参数。 越大,表达能力越强,但同时每个码本要存的参数量、查表时要比较的次数都线性增长,而且码本利用会稀疏化,很多条目长期不被选中,训练上更难稳住。这正是后面所有音频编解码器的共同约束。
一层量化不够:残差向量量化的思路
一层量化有一个根本问题:重建误差 里还留着信息。如果只量化一次,想提高保真度就只能加大码本;但码本的增长是指数的(每多 1 bit 就多一倍条目),收益很快就会饱和。
残差向量量化(Residual Vector Quantization, RVQ)的做法是把这个误差继续量化。设第 级码本为 ,则
最后重建出的向量是各级量化的和:
每一级只需要量化上一级剩下的残差,所以 级、每级 个条目的总码本容量是 ,而总比特数只有 。以 SoundStream 的配置为例,、、帧率 50 Hz,则码率为 bit/s,也就是 2 kbps。用固定的 1 个 10 bit 码本要达到同样的码率,就需要帧率 200 Hz,时间分辨率会差四倍。
RVQ 还有两个对后续生成很关键的性质。
第一,码本之间是层级依赖的。 第 1 级量化的是原始向量,它独立于其他级;第 2 级量化的是第 1 级的残差,以此类推。这意味着第 1 级码本承载了最多的信息,后面每一级的贡献逐级递减。VALL-E 的论文里直接把这一点写出来:第一个量化器在重建中扮演最核心的角色,其余各级的影响逐渐减弱。MusicGen 的”粗粒度优先”模式正是直接利用这一层级结构设计的。
第二,RVQ 天然支持可变码率。 因为重建向量是各级之和,只取前 级也能解码出一个近似结果,只是细节更少。于是同一个编解码器模型可以在训练时随机选择使用前几级,一次训练就覆盖 1.5、3、6、12、24 kbps 等多档码率;推理时按需要选级数即可。EnCodec 论文正是这么做的:训练时随机选 4 的倍数个码本,对应 24 kHz 下 1.5 kbps 到 24 kbps 的几档带宽。
量化的梯度问题
训练时最容易出问题的是梯度。 是不可导的,编码器得到的梯度会在量化这一步断掉。工程上普遍采用两个补丁:
- 直通估计器(Straight-Through Estimator, STE):反向传播时假装量化是恒等映射,把解码器端的梯度原样传回编码器。前向用真实量化值,反向用近似梯度。
- 承诺损失(commitment loss):对编码器输出和它被量化后的结果之间的均方误差加一项正则,且梯度只传向编码器一侧。这一项的作用是把编码器输出往码本条目附近”拉”,防止编码器输出漂移到码本覆盖之外、导致量化误差失控。
EnCodec 还用了码本条目的指数滑动平均更新(衰减系数 0.99),并对长期不被使用的条目用当前 batch 里采样的向量替换。这条技巧解决的是”死码本”:如果某些条目永远不被选中,它们就永远不会更新,码本容量被浪费。
第一层:SoundStream 与 EnCodec——可用的音频编解码器
上面是量化的数学骨架。把它做成一个能在单核 CPU 上实时运行的编解码器,是 SoundStream 和 EnCodec 解决的问题。
SoundStream 由 Google 于 2021 年提出,它把全卷积编码器/解码器、残差向量量化与对抗加重建的联合训练拼成了一套完整的端到端神经音频编解码器,是后续这条技术路线的主要参照。EnCodec 由 Meta 于 2022 年提出,在架构与工程实现上做了细致打磨,成为后续大量音频生成模型实际使用的 tokenizer。
编码器与解码器的结构
EnCodec 的编码器是一串残差卷积块,每个残差块由两层 3×1 卷积加一条跳跃连接构成,每当发生下采样,通道数翻倍。卷积块之后接两层 LSTM 做序列建模,再接一层 kernel size 为 7 的一维卷积输出 维向量。关键参数是每一级下采样的步长:EnCodec 使用 (2, 4, 5, 8) 这组步长,乘积为 320。24 kHz 输入 320 倍下采样后是 75 Hz,48 kHz 输入是 150 Hz。
这组步长的设计不是随意的。下采样倍数的乘积直接决定帧率,帧率越低 token 越少,但太低会丢失瞬态信息(比如辅音爆破和鼓点),所以它是在”序列长度”和”重建保真”之间取的折中。解码器是完全对称的结构,把步长逆序换成转置卷积。
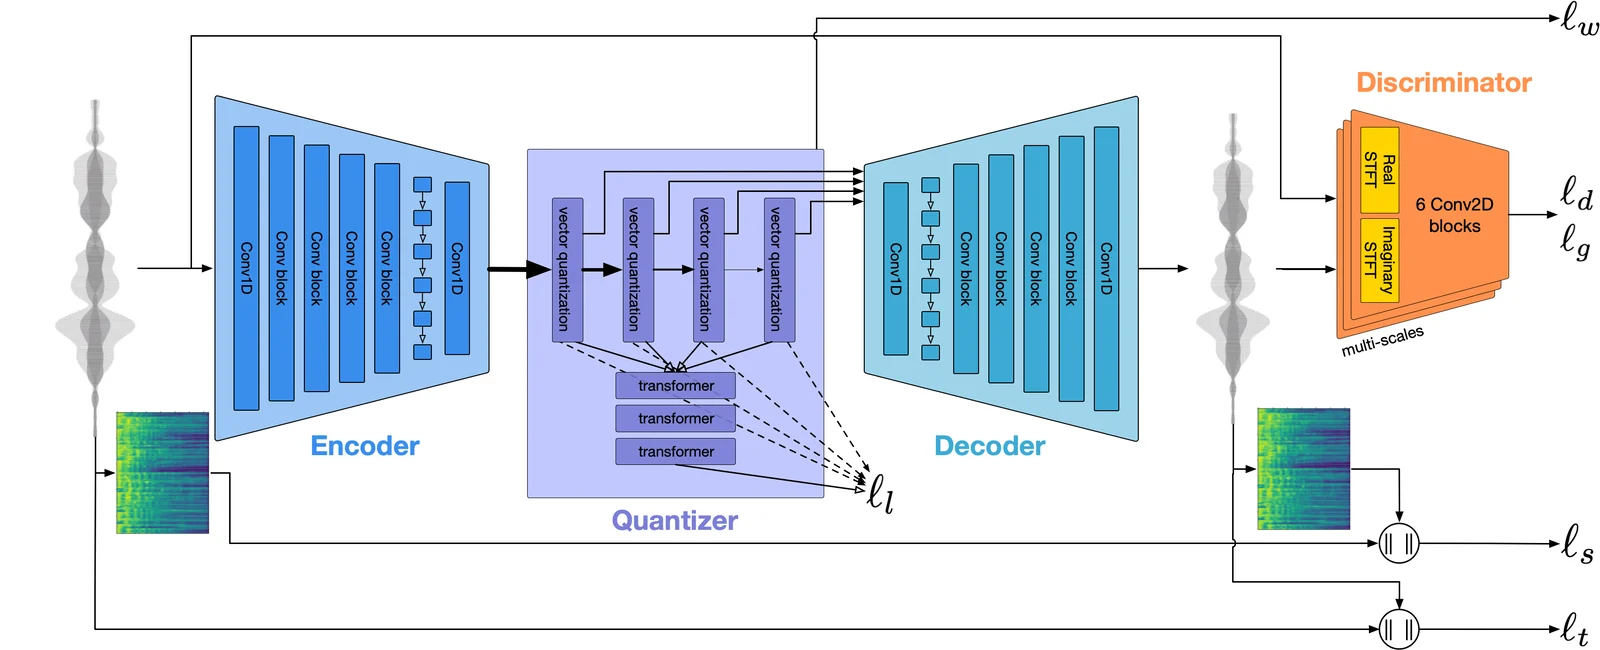
上图是 EnCodec 论文中的总体结构。左侧是编码器,把波形压成低帧率向量;中间是量化器,用 RVQ 把连续向量换成多级索引;右侧的解码器把各级码本向量求和后还原成波形。图下方的箭头是训练信号:重建损失(时域 与频域 )约束输出接近输入,判别器损失 与 负责感知质量,承诺损失 只作用于编码器。可选的一路还有一个小 Transformer 语言模型 ,它在上面的离散索引上做熵编码,把实际存储带宽进一步压低——这一点在本节末尾单独展开。
对抗损失为什么必需
只用重建损失训练的解码器,输出会偏”平均”:所有不确定的高频细节都被抹平,听起来发闷、发糊。原因是均方误差在感知上并不成立,它惩罚的是逐点差异,而不是听感上的差异。
EnCodec 的做法是引入多尺度 STFT 判别器(MS-STFT discriminator):在多个不同窗口的复数 STFT 上分别判别”真实还是生成”,每个子网络先在时频图上做 2D 卷积,再沿频率轴下采样、沿时间轴用 1、2、4 的空洞率加宽感受野。判别器输出的是一种感知损失,逼着解码器在多个时间尺度上都生成与真实音频一致的谱结构。
这一套训练信号的选择是编解码器质量的核心。EnCodec 论文在 24 kHz 流式设置下报告的主观分数(MUSHRA,满分 100)里,6.0 kbps 的模型在干净语音上达到约 83,在两组音乐集上分别是约 92 和 91;作为对比,传统 Opus 在 6 kbps 下只有 30 左右,12 kbps 也只有 77 左右,Lyra-v2 在 6 kbps 下约 66。这组数字说明,在同样的比特率下,能被语言模型直接消费的离散 token 本身就必须是靠学习得到的高质量表示,而不是简单丢弃精度的标量量化。
这组数字还指向一个更实用的观察:6 kbps 已经接近”干净语音”的可用区间(83 分),而 3 kbps 掉到 67 分。下游模型选择几级码本时,这个区间基本就是”质量够用”与”省序列长度”的分界线。
一套编码器,多个码率
如前所述,EnCodec 的所有模型码本条目数为 1024(10 bit),码本数最多 32 个(48 kHz 模型为 16 个)。因为选择前 级就能解码,一个训练好的模型支持多档带宽。这对下游生成模型很有用:同一个 tokenizer 既能服务于”需要 6 kbps 音质”的语音合成,也能服务于”只要 1.5 kbps、省序列长度”的场景,只是 token 的序列形状(级数)不同。
额外的熵编码:带宽再压一半
EnCodec 还训练了一个小 Transformer 语言模型做熵编码,结构是 5 层、8 个注意力头、200 通道。它在时间步之间对每组离散索引建模,把不容易出现的组合用更少的比特编码。论文报告的效果是明显的:名义 6.0 kbps 的模型平均实际带宽降到 4.1 kbps,12.0 kbps 降到 8.9 kbps。
这段设计的工程含义值得单独点出来。常规自回归模型解码时,每个时间步的 logits 是”在已知前缀下,本步 token 的分布”。熵编码用的恰恰是同一个分布,只不过它的用途从”采样下一个 token”变成了”用最少的比特编码已经已知的 token”。生成模型的输出头和压缩用的算术编码器之间,在这里是同一个东西。VALL-E 之后的 codec 语言模型在推理时,同样要把这个分布原样算出来,只是它不再关心 logits 的编码效率,而是直接在 logits 上采样。两件事共用同一份前向计算,这是离散 token 路线在系统上最干净的地方之一。
第二层:AudioLM 的两级 token 表示——语义与声学
有了可用的编解码器,下一个问题是:直接在这些声学 token 上训练语言模型,能不能生成结构良好的长音频?AudioLM 给出的答案是不能,它的问题拆解方式值得单独讲一节。
AudioLM 由 Google 于 2022 年提出。它观察到同一个音频可以用两种 token 表示,两者的性质互补。
语义 token:来自自监督模型,结构与发音都在里面
语义 token 由 w2v-BERT 这种自监督语音模型提取。w2v-BERT 在大量无标注语音上用掩码语言建模训练,输出 1024 维的实值特征,帧率为 25 Hz(每 40 ms 一个)。把每帧特征用 k-means 聚类成 1024 个类别,就得到语义 token 序列:每秒 25 个 token,每 token 10 bit,码率约 250 bit/s。
这类 token 的信息重心在内容:音素身份、局部时长、音节结构、语速、语调轮廓。用它重建波形基本会失败,因为它丢弃了说话人音色和录音环境。但它恰好是语言模型最擅长的东西——一段语义 token 序列几乎可以当作离散文本读,语言模型学”哪些音素该跟在哪些音素后面”的难度和学文本接龙接近。
声学 token:来自 SoundStream,音色与细节都在里面
声学 token 直接来自神经编解码器。AudioLM 自己训练了一个 SoundStream,16 kHz 输入下用 (2, 4, 5, 8) 的步长做 320 倍下采样,得到 50 Hz 的帧率;每帧用 12 级 RVQ,每级码本 1024,总码率 6 kbps,也就是每秒 600 个符号。它也用 4 级、2 kbps 的版本做过对照,但最终配置选的是 12 级——原因在论文里写得很清楚:级数越多重建质量越好,第三阶段把码率从 2 kbps 提到 6 kbps 后音质显著提升。
声学 token 保留了说话人音色、录音混响、背景噪声、呼吸声这些细节,所以重建质量高。但它的序列很长(50 Hz × 12 级 = 每秒 600 个符号),而且这些符号之间的依赖非常局部:RVQ 的层级结构决定了同一帧的 4 级符号之间高度相关,相邻帧的谱细节却又没有”语义”层面的规律,模型很难从中学会全局结构。
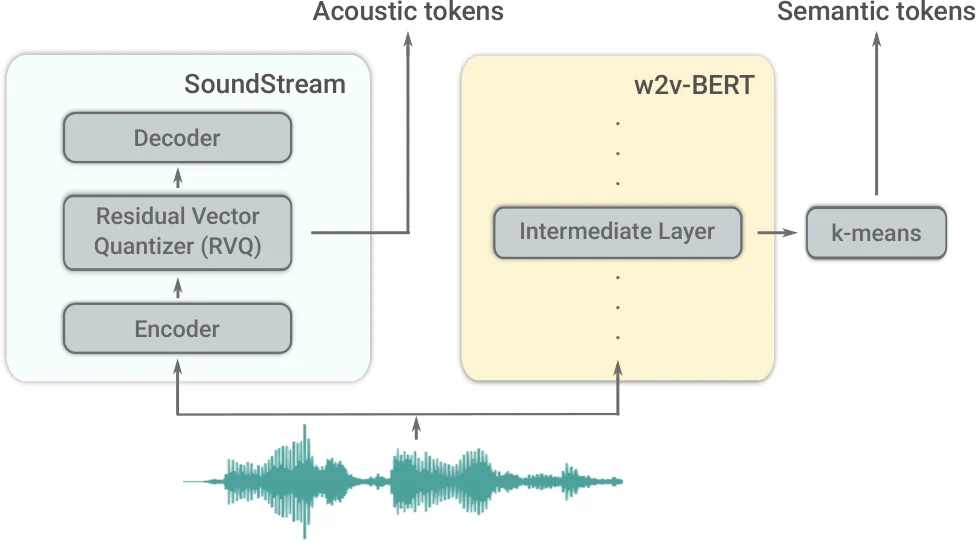
上图对比了两种 token 的来源。左侧 SoundStream 把波形编码为 50 Hz 的嵌入,再经由 RVQ 的多层量化器得到声学 token;右侧 w2v-BERT 从波形得到 25 Hz 的实值特征,再经 k-means 归为语义 token。注意两者的帧率比是 2:1 这一细节,它决定了后面三级模型之间的对齐关系。
为什么要分成两个阶段
AudioLM 的解决方案是把两种 token 各自交给适合它的模型,串联成一个三阶段的生成流程。
第一阶段:语义建模。 用自回归 Transformer 在语义 token(25 Hz)上做续写,目标是长程一致性——语义合理、语法通顺、话题不跑偏。因为语义 token 只有每秒 25 个,序列长度是声学 token 的一半以上,这一阶段的计算负担相对可控,也才有余力关注长时间跨度。
第二阶段:粗声学建模。 给定语义 token,预测每一帧里 RVQ 前 级的声学 token。AudioLM 的默认配置是 、,所以这一阶段预测每帧的前 4 级,对应 2 kbps。由于声学帧率是语义帧率的两倍,每个语义 token 对应 2 帧,也就是 个粗声学符号。
第三阶段:细声学建模。 给定粗声学 token,预测剩余的 级,每语义 token 对应 个细声学符号,把码率补到 6 kbps。
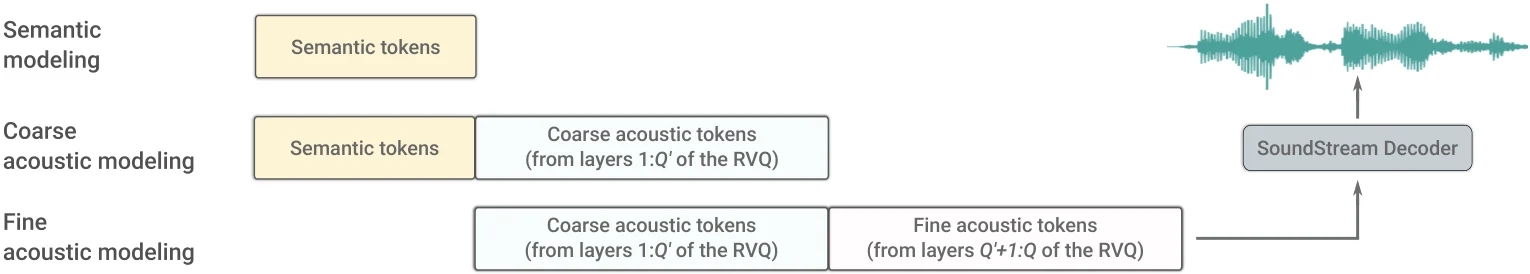
上图是 AudioLM 的三阶段结构。从左到右数据流是:语义 token 先被第一级自回归模型续写,产出的语义序列作为条件输入给粗声学建模;粗声学 token 再作为条件输入给细声学建模。三个阶段都是自回归的,但它们预测的对象不同、序列长度不同,这种”按信息重要性分阶段”的思路和后面 VALL-E 的 AR/NAR 组合如出一辙。
三个阶段用的是完全相同的 Transformer 结构:12 层、16 个注意力头、1024 维嵌入、4096 维前馈层、dropout 0.1,并采用 T5 风格的相对位置编码,每阶段约 0.3B 参数。训练时的随机裁剪长度分别是 30 秒、10 秒、3 秒,对应三个阶段的输入序列长度逐级缩短——这是分层设计在工程上的另一个好处:越靠后的阶段序列越短,算力需求越低。
这个设计换来了什么
这个分层背后有一个清晰的取舍。如果把所有符号塞进同一个模型,“结构”和”细节”混在一起学,模型需要同时处理非常长时间跨度的语义规律和非常短时间跨度的谱细节,注意力被大量低信息局部依赖占据。
把它拆成两级的好处是:每一级模型只需要专注一个时间尺度。代价是三级串联,误差会级联——第二阶段的输入是第一阶段生成的语义 token,如果语义层出现错误,声学层无法纠正它,只能在错误的语义上尽力合成。工程上能做的补救是每个阶段都以”前缀 + 生成的 token”整体为条件,让后级可以从前缀里”回看”真实数据。
一个附加效果是零样本续写:给定一段 3 秒的未见说话人语音作为前缀,AudioLM 能续写出保持说话人音色、语速和录音环境一致的语音。这不是训练时专门设计的,而是”以声学 token 作为条件下文”的副产物——前缀本身就是这段说话人在这个环境下的 token 分布,模型在续写时自然会延续它。
第三层:VALL-E——把语音合成写成续写任务
AudioLM 证明了离散 token 路线能生成连贯语音,但它没有显式的文本控制:要合成指定内容,只能依赖前缀里已有的语音。VALL-E 把这条路线接到了最直接的生成任务上。
VALL-E 由 Microsoft 于 2023 年提出。它的核心主张非常简洁:语音合成可以写成条件语言建模。输入是音素序列,输出是声学 token 序列,而”音色”这个最难控制的需求,通过一个 3 秒的声学提示交给模型,由上下文学习来完成,不需要任何说话人嵌入。
数据流
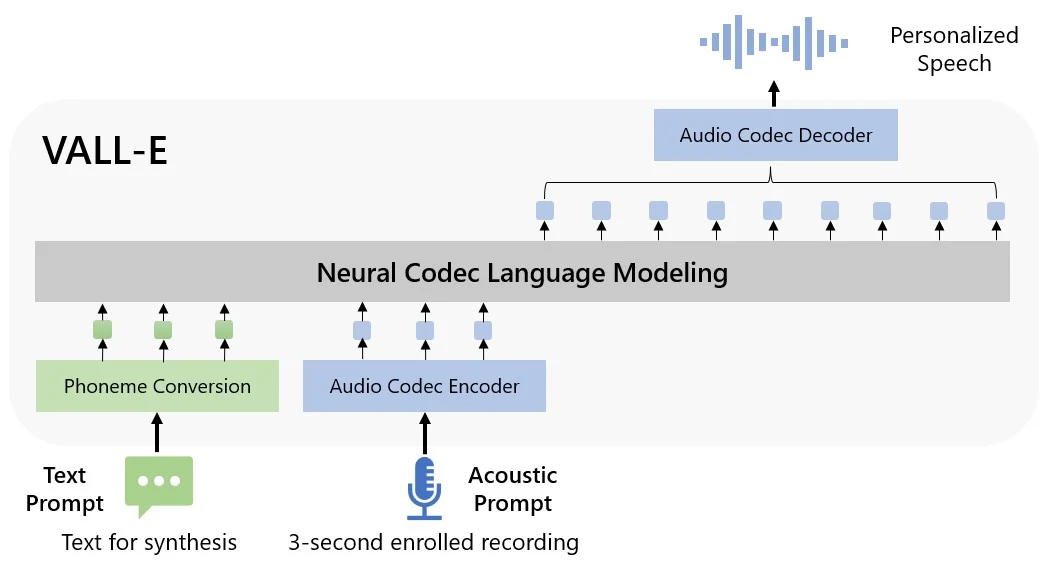
上图是 VALL-E 的总体结构。底部是两条输入端:左边是待合成文本经过音素转换得到的音素序列,右边是 3 秒参考录音经编码器得到的声学提示。两条输入都送入中间的”神经网络编解码语言建模”,输出离散 token 序列,最后交给编解码器解码器还原为个性化语音。
旧式流程是”音素 → mel 频谱 → 波形”,需要专门的声学模型和声码器,零样本音色迁移要靠说话人嵌入、微调或者复杂的网络设计。VALL-E 把中间层换成了”音素 → 离散编解码码 → 波形”:中间的离散码由预训练的 EnCodec 提供,解码器也是 EnCodec 自带的,于是”声学模型 + 声码器”两大块被一个现成的编解码器统一了。
token 的形态
VALL-E 用的是 EnCodec 在 24 kHz、帧率 75 Hz、8 级 RVQ、每级 1024 条目的配置,对应约 6 kbps。一段 10 秒的波形因此变成 的矩阵:750 个时间步,每步 8 个索引。
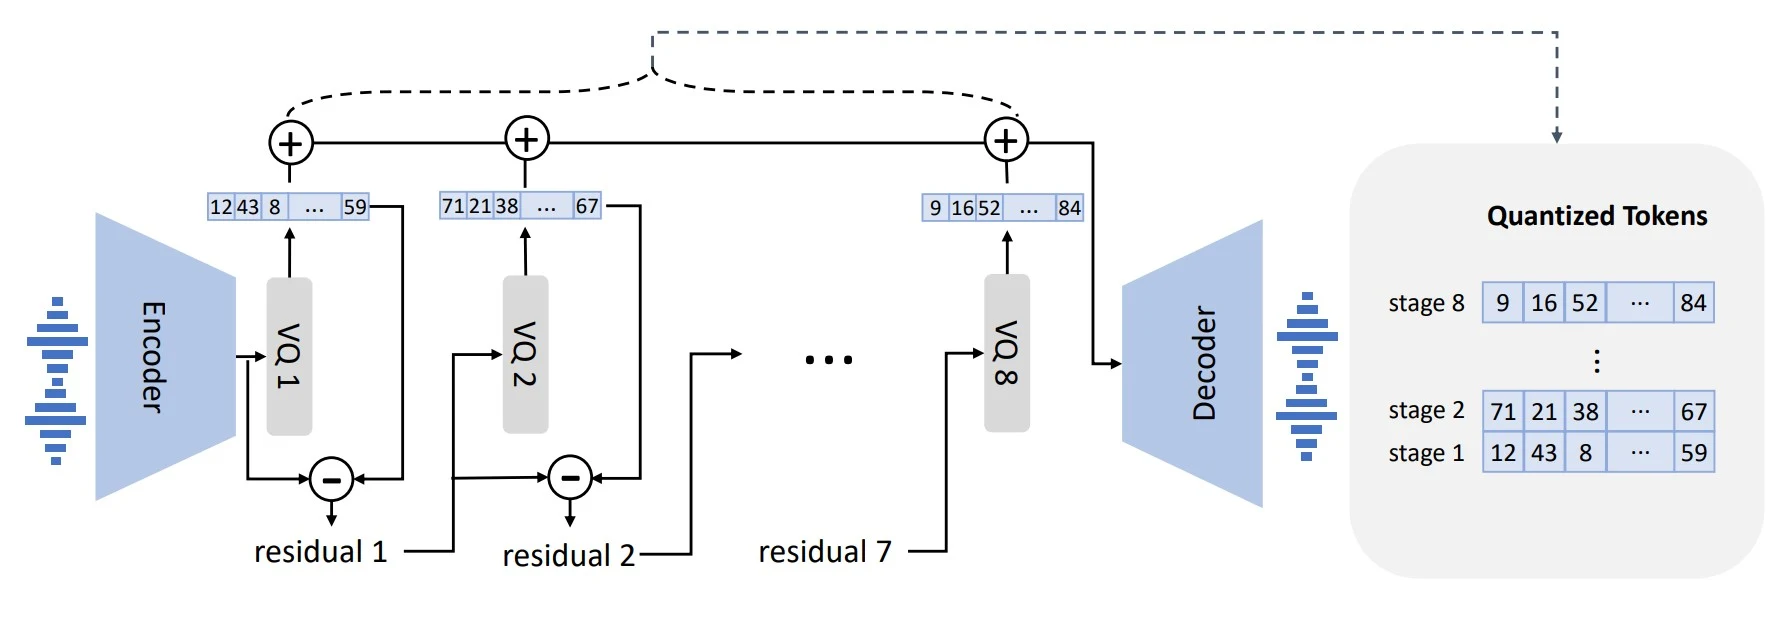
上图说明了 RVQ 在 VALL-E 中的层级含义:stage 1 的量化结果最重要,stage 2 在 stage 1 的残差上继续量化,越往后级越次要。这个次序直接决定了模型的选择:第一级的全部序列都用自回归预测,后面七级用非自回归预测。因为第一级承载了最多的声学信息,必须逐帧决定;后七级信息量逐级递减,一次性并行预测就够,而且能省下七倍的自回归步数。
AR 与 NAR 的分工
VALL-E 把完整分布拆成
符号逐个解释: 是待生成的 码矩阵, 是音素序列; 是声学提示(3 秒参考录音编码后的码矩阵), 是它第一级的序列; 是待生成矩阵的第 级整条序列。第一项是 AR 模型,以音素、参考第一级码和已生成的第一级码为条件,逐帧预测第一级;后面七项是 NAR 模型,每一级都以音素、参考码以及所有更靠前的级为条件。
论文给出的取舍理由是:
- 第一级为什么必须自回归:生成语音的语速要和参考录音一致,而不同说话人的语速差异很大,训练一个长度预测器很难泛化。自回归模型在生成过程中自然决定”什么时候结束”,不需要预先预测序列长度。这是一个工程上的理由,不是理论上的:AR 模型的灵活性正是来自它能自己决定长度。
- 后面七级为什么可以非自回归:它们的序列长度已经由第一级确定,不需要再预测长度;而且它们的信息只是”给第一级补充细节”,级间条件已足够,并行预测的损失可以被接受。NAR 把后面七级的复杂度从 降到 (相对自回归的串行步数),这相当于在总步数上直接省掉七倍。
NAR 阶段的具体实现值得补一笔,因为它决定了这七次前向怎么组织。模型并不是”一次前向同时吐出七级”,而是按级分阶段:训练时每一步随机采样一个目标级 ,把第 1 到第 级的嵌入相加作为输入,让模型预测第 级;推理时从 到 依次跑七次前向。每次前向都是对 个位置的全并行,位置之间不互相注意(非因果自注意力),所以没有增量缓存。模型还用了级嵌入加 AdaLN 来区分当前预测的是哪一级,并让第 级的输出预测层与第 级的声学嵌入层共享参数——这是一个很省参数的设计,也让级与级之间的表示空间保持一致。
声学提示承担音色
音色迁移完全没有单独模块。在训练中,模型被喂入”同一句话的随机 3 秒片段”作为声学提示,其余部分作为被预测的目标;训练数据扩充到 6 万小时英语语音。模型在大量”同一说话人、同一录音条件”的样本对上,学到的不是”说话人 ID 到特征”的映射,而是”前文的 token 分布该怎样延续”:给定 3 秒参考,模型通过自注意力读到的第一级码的统计特征(音高轮廓、共振峰位置、平均语速),会在生成时保持一致。
这解释了为什么 3 秒提示能保留情绪和录音环境:提示里包含的不只是音色,还有那 3 秒里语气、背景噪声、混响的 token 表达,模型把它们当作条件一起延续。
实现上有两个容易被忽略的细节。其一,AR 阶段不做前缀区分。 参考第一级码与待生成第一级码在训练时被直接拼接成一条序列,不加任何分隔 token;推理时前缀给定,模型只预测其后的部分。音素序列与码序列各在末尾挂一个 <EOS>,位置编码分别计算。这样做的好处是推理时前缀的 KV 缓存可以直接预填(prefill),生成阶段只做增量解码,和文本 LLM 的 prompt 处理完全一致。其二,NAR 阶段把参考码当作”声学提示”喂回。 因为 NAR 是非自回归的,同一级内的 token 彼此不可见,光靠第一级结果会丢失音色细节,所以参考码矩阵 被整体作为条件输入,逼模型在”参考音色”的约束下并行生成每一级。
VALL-E 的两级模型使用完全相同的 Transformer:12 层、16 个注意力头、1024 维嵌入、4096 维前馈、dropout 0.1。AR 阶段在 6 万小时数据上训练,单条波形平均长度约 60 秒,训练时随机裁剪到 10 到 20 秒。
第四层:MusicGen——延迟交织与单阶段码本预测
VALL-E 解决的是”多级码本怎么办”的一种答案:第一级 AR,其余 NAR。MusicGen 给的是另一种答案:把多个码本的全部组合重新排列成一个单阶段序列,用一个 Transformer 一起预测。
MusicGen 由 Meta 于 2023 年提出,目标是 32 kHz 音乐生成。它使用的 tokenizer 是一个 5 层非因果 EnCodec,32 kHz、步长 640,帧率 50 Hz,4 级 RVQ,每级 2048 条目。
问题:多流序列的三种排法
音频在 RVQ 之后是 条并行的 token 流,每条流的长度是帧数 。要把这 个符号交给语言模型,就必须规定一种排列顺序。三种最自然的排法各有问题。
- 扁平化(flattening):把每帧的 个符号当成一个整体,按帧排成一条长序列。这是精确的分解,但每个自回归步只能产出一个符号,一帧要 步,序列长度直接变成 。
- 并行(parallel):一个时间步同时预测该帧的所有 级。序列长度回到 ,但帧内 级之间的条件关系被打破——同一帧内符号的依赖并不独立,这是一个有偏的近似。
- 延迟(delay):让不同级错开一步,第 级比第 1 级晚 帧,于是每个时间步可以同时预测”不同帧的不同级”,既保证了帧内级间条件,又不增加时间步数。这个思路在 AudioLM 之后的并行流建模里已经出现(MusicGen 论文引用的是 Kharitonov et al. 2022),MusicGen 把它纳入一个统一框架并做了系统消融。
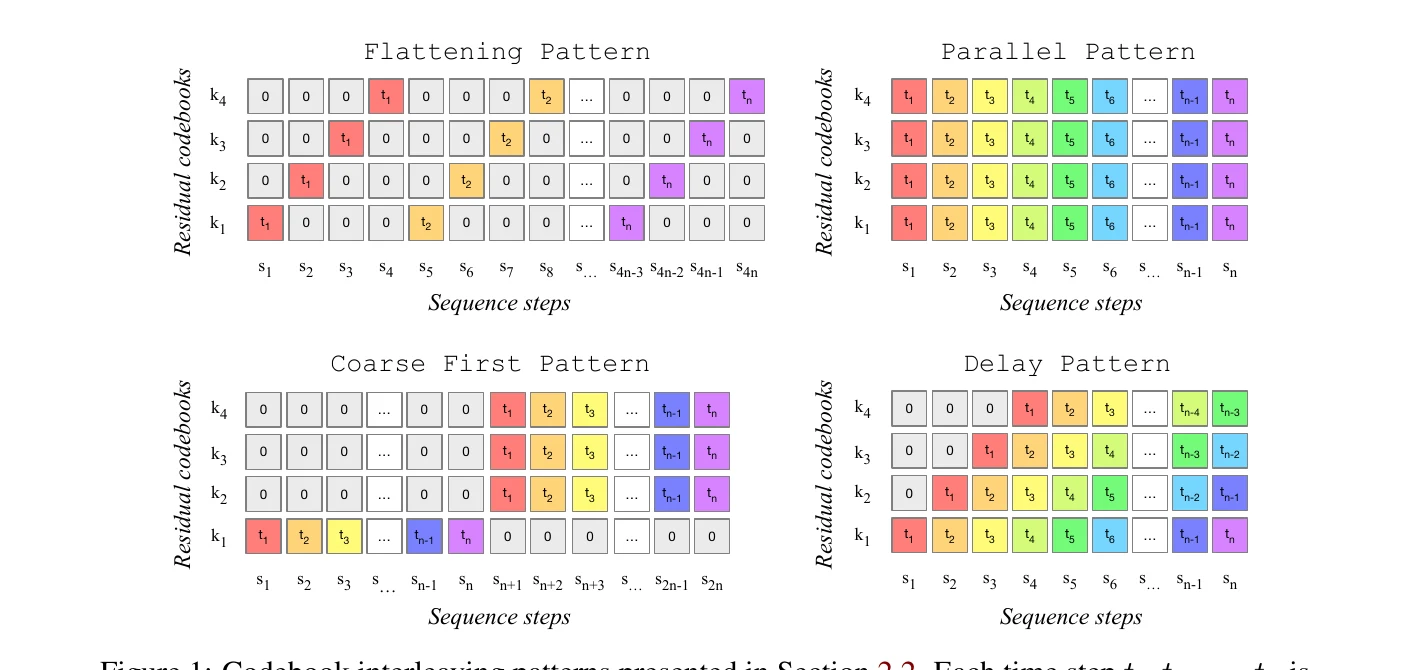
上图是 MusicGen 论文的 Figure 1,展示了四种模式如何把”每帧 4 级”重新排列。四个面板分别对应扁平化、并行、粗粒度优先和延迟。每个小方块是一个 (时间步, 码本级) 组合,横向是一帧内的 4 级 、、、,纵向是序列步 ;0 是填充在空位上的特殊 token。扁平化把每帧 4 个符号排成 4 步;并行把 4 个码本压进同一步;延迟让各级错开、逐步补齐;粗粒度优先则是”第一步只出第一级,后续步骤补其他级”。
把延迟模式落到代码就是下面这段模式生成逻辑。它回答了一个实现上必须明确的问题:第 步到底该预测哪些位置。
K = 4 # 码本级数T = 500 # 帧数(50 Hz 下 10 秒)empty = 0 # 填充 token
def delay_pattern(K, T): # 第 s 步预测的位置集合 P_s,s 从 0 到 T+K-2 steps = [] for s in range(T + K - 1): positions = [] # 本步要"产出"的 (帧, 级) inputs = [] # 本步要"喂入"的 (帧, 级),含填充 for k in range(K): t = s - k # 第 k 级相对第 1 级延迟 k 帧 if t >= 0: inputs.append((t, k)) if t < T: positions.append((t, k)) else: inputs.append(None) # 该级尚未开始,用 empty 占位 steps.append((inputs, positions)) return steps这段逻辑值得逐行读。输入侧,第 级在第 步读的是第 帧( 从 0 开始计),如果 就读填充。输出侧,只有当 落在合法帧范围内时才真正产出一个 token,所以最后 步只有输入、没有输出,序列在逐步”排空”。
由此可以推出延迟模式的三个性质,它们就是它在工程上的全部价值:
- 总步数是 ,而不是 。500 帧、4 级时是 503 步,比扁平化的 2000 步少约四分之三。
- 级间条件完整保留:第 级在第 步预测时,第 级已经在第 步被预测过,所以它作为上文可见。这正是延迟优于并行的根本原因——并行把同一帧的多级塞进同一步,级间在生成时互相不可见。
- 帧间条件损失了一小部分:第 级在第 步产出第 帧的值时,第 1 级已经生成到了第 帧。也就是说高级码本看到的是”第 1 级多往后看了 帧”的上下文。这是一个近似,不是精确分解——论文也承认分解不精确,只是它换来的训练与推理加速对长序列非常划算。
统一的数学定义
MusicGen 论文把这个问题形式化为”码本交织模式”。设所有 (时间步, 码本级) 对的集合为
其中 是音频时长、 是帧率、 是码本级数。一个模式是 的一个划分 :每个 是第 个生成步同时预测的位置集合, 表示序列起点。第 步的所有位置以 的全部内容为条件并行预测:
其中 表示第 帧第 级的符号。这个定义把三种模式统一到了一起:扁平化对应 只含一个位置,并行对应 含一整帧的 个位置,延迟对应 含”不同帧的同一个级”。
论文还指出,任何”每个码本级在每个 里最多出现一次”的模式都是合法的——这意味着同一步可以同时预测不同帧,只要每个级在一步里不重复。延迟模式正是利用这一点:它在第 步预测第 帧的第 级,于是每一步都在”多帧、多级”之间分摊。
输出头怎么处理多级
因为同一步可能预测多个位置,Transformer 的输出头要按”被预测位置所属的级”选择对应的线性层:从 维隐层投影到该级的码本大小 。论文的实现里,如果 里某级存在,就用该级的专属线性层产生 logits;不存在的位置用填充 token。这一点在实现上的意义是:同一个主干网络同时被训练成多个并列的分类器,每个分类器对应一级码本。
实测:哪种模式最好
这里论文给出的结论和直觉略有出入,值得准确记录。MusicGen 在 30 秒音频上比较了各种模式:
- 扁平化得分最好(延迟、部分延迟与其接近,并行最差)。
- 延迟和部分扁平化(只对前几级扁平、其余级延迟或并行)得分相近。
- 并行明显更差。
也就是说,在训练充分的前提下,精确的扁平化分解确实是质量上限,延迟模式用”牺牲一点分解精确性”换回了”自回归步数减到约 “,而质量损失在可接受范围内。这比”延迟一定更好”的说法更准确:它是工程上的折中,而不是理论上的最优。
MusicGen 在报告里给出的主观分是 84.8,最好的基线是 80.5;消融还显示模型规模与质量正相关(300M、1.5B、3.3B 三档,参数最大的模型得分最高),文本编码器则分别试了 T5、FLAN-T5 和 CLAP 三种。这些是生成质量层面的选择,与本文的架构主线关系不大,但有一个实现细节影响推理:条件信号在文本条件下通过 cross-attention 注入,在旋律条件下则改用前缀拼接——两种注入方式对推理时的缓存策略要求不同,下一节会用到这一点。
第五层:推理账——K 个码本带来的序列、缓存与流式
前面四层都在讲”token 怎么来、模型怎么预测”。到了部署阶段,离散 token 路线和文本 LLM 的差别就集中体现出来:同一段时间轴对应多个 token 流,而每个流都要独立占一份上下文。
序列长度
一个直观的对照:
| 模型 / 配置 | 音频时长 | 帧率 | 码本级数 | 自回归步数 | 每秒符号数 |
|---|---|---|---|---|---|
| AudioLM 语义阶段 | 10 s | 25 Hz | 1 | 250 | 25 |
| VALL-E | 10 s | 75 Hz | 8 | 750(AR)+ 7 次并行(NAR) | 600 |
| MusicGen(扁平化) | 10 s | 50 Hz | 4 | 500 × 4 = 2000 | 200 |
| MusicGen(延迟) | 10 s | 50 Hz | 4 | 500 + 4 − 1 = 503 | 200 |
| Moshi / Mimi(时间轴) | 1 s | 12.5 Hz | 8 | 12.5 时间步 × 8 深度级 | 100 |
从表里可以看到两点。第一,帧率是决定时间轴长度的第一杠杆。 VALL-E 的 75 Hz 对 10 秒是 750 步,而 Moshi 的 12.5 Hz 对同样的 10 秒只有 125 步,差了 6 倍。第二,码本级数不改变”每秒符号数”,但改变”自回归步数”,两者是不同的成本。
码本级数如何进入缓存:一条长序列,还是 K 条时间轴
理解这一点是理解这条路线推理账的关键。
先看 VALL-E 的 AR 阶段。它只预测第一级,所以序列的 750 步就是 750 个位置,注意力和 KV 缓存与一段 750 token 的文本几乎一样。这是 AR/NAR 分离最直接的好处:上下文长度没有乘以 8,缓存也就没有乘以 8。
再看延迟模式。自回归步数约等于帧数 (准确说是 ),但每一步要同时读取 个符号。如果把这 级当成 条彼此独立的注意力序列并行缓存,缓存里就要存 份位置与隐藏状态,规模是单一序列的 倍。Moshi 论文把这个成本写得很直接:用 Mimi 的 8 级码本、12.5 Hz 帧率,生成 1 秒音频折算成 100 个序列步;生成 5 分钟音频就是 3 万步——“以每秒 100 个 token 的速率生成,与流式推理不兼容”。作为对照,一段英语语音每秒只有 3 到 4 个文本 token。
注意这里有两种不同的乘法,不能混为一谈。第一种是”序列变长”:扁平化把 级铺成一条 的长序列,注意力成本按 增长。第二种是”缓存变宽”:延迟模式保持了 步的时间轴,但每一步的输入宽度是 个符号,KV 缓存按 增长。两者总字节数可能相近,但对注意力核、批处理与流式切分的含义完全不同——长序列意味着单次注意力的分数矩阵更大,宽输入意味着每一步的投影与采样更重。后面三种架构的差别,很大程度上就是在这两种乘法之间做选择。
这个对比揭示了这条路线的固有成本结构:音频 token 的序列密度比文本高一个数量级以上,而且一个时间步里有多个级。 所有后续的架构改进,本质上都在拆解这个乘法:更低的帧率(Mimi 的 12.5 Hz 是对 75 Hz 的 6 倍压缩)、把多级压成一步(延迟)、把后续级改成非自回归(VALL-E)、在时间轴上把生成拆成块(Moshi 的 Inner Monologue 与多流并行)。
三种缓存组织
落到 KV 缓存的具体形态,三种架构各有做法。
- VALL-E 的 AR/NAR 分离:AR 阶段有 750 步的第一级序列,KV 缓存与普通 LLM 一致;NAR 阶段每一级都是一次并行前向,序列长度虽然也是 750,但不需要增量缓存,只有一次全量前向。NAR 前向的注意力成本是 ,而不是每步增量 ;但因为只有 7 次(每级一次),总成本是 量级,在 750 步的尺度上完全可以接受。要注意 NAR 的输入并不只有 750 个位置——音素提示与 3 秒声学提示(约 225 帧)会拼接在其前面,实际序列长度比 750 更长,这一点在估算显存时要算进去。
- MusicGen 的延迟模式:每个自回归步输入 个符号,KV 缓存长度 = 步数 × (输入宽度 + 输出宽度)。序列短(50 Hz)是它能用延迟模式的关键前提:50 Hz、2 分钟音乐是 6000 步,与 4 级码本的乘积是 24000 个符号,但在延迟模式下每一步只有 4 个输入、4 个输出,缓存长度按步数生长,而不是按符号数。文本条件走 cross-attention,其 key/value 在所有层上可以只算一次并复用——条件是静态的,不随生成步变化;旋律条件走前缀拼接,代价是它被计入序列长度,每一步都要为这段前缀承担注意力开销。同一个模型、两种条件注入方式,缓存策略并不相同,这是实现在选择注入方式时容易忽略的一笔账。
- Moshi 的 RQ-Transformer:这是最具代表性的设计,下一节展开。
把这三笔账写成数字会更直观。以 VALL-E 的 AR 阶段为例,12 层、1024 维、FP16(每对 key/value 元素占 4 字节,公式中的因子 2 计的是 key 与 value 各一份),一条 10 秒序列是 750 个位置,KV 缓存为
一条序列约 35 MiB,32 条并发的显存占用约 1.1 GiB,和同规模的文本 LLM 处在同一量级。但如果把 8 个码本全部按扁平化铺开,位置数变成 6000,同样的模型结构需要约 282 MiB 一条,32 条并发就是 9 GiB——还没算注意力分数矩阵和激活值。这就是 VALL-E 的 AR/NAR 分离在系统层面的真实收益:它不只是省了自回归步数,还把 KV 缓存压回了一个可批处理的规模。
流式:12.5 Hz 与因果编解码器
流式交互要求模型在收到音频的同一时刻就能输出音频,这对编解码器本身的因果性提出要求。Mimi 是 Moshi 自研的编解码器,它的结构里做了两件关键的事:
- 编码器是因果的、带 Transformer:Mimi 在卷积编码器里插入 Transformer,因果设计使编码、解码都能分块流式运行。
- 帧长与总步长都是 80 ms:收到第一个 80 ms 音频帧就能产出第一个 12.5 Hz 的潜时间步,并解码出 80 ms 输出音频。正因为这一条,“每 80 ms 产一帧”的流式节奏与编解码器的内部步长是对齐的。
Mimi 的码本配置是:24 kHz 输出、12.5 Hz 帧率、码本大小 2048、8 级 RVQ。其中一项专门的修改是”分裂残差向量量化”(split RVQ):第一级量化器单独作为一条语义支路,用蒸馏的方式对齐一个非因果自监督模型(WavLM)的输出,专门承载语义 token;其余 7 级走常规的残差量化,承担声学重建。两部分的输出相加后交给解码器。
这个改动解决的是极低帧率下的一个两难。12.5 Hz 意味着每 80 ms 只有一个潜时间步,8 级码本是唯一能提供足够细节的通道;但如果全部量化级都只服务于重建,模型会丢失语音可懂度所依赖的语义结构——在没有文本条件时,纯声学 token 生成的语言模型很难产出可懂的语音。把第一级”征用”为语义通道、用蒸馏约束它,既保留了流式因果性(蒸馏源 WavLM 是非因果的,但蒸馏出来的目标向量可以被因果编码器预测),又能让解码器照常把各级相加重建波形。
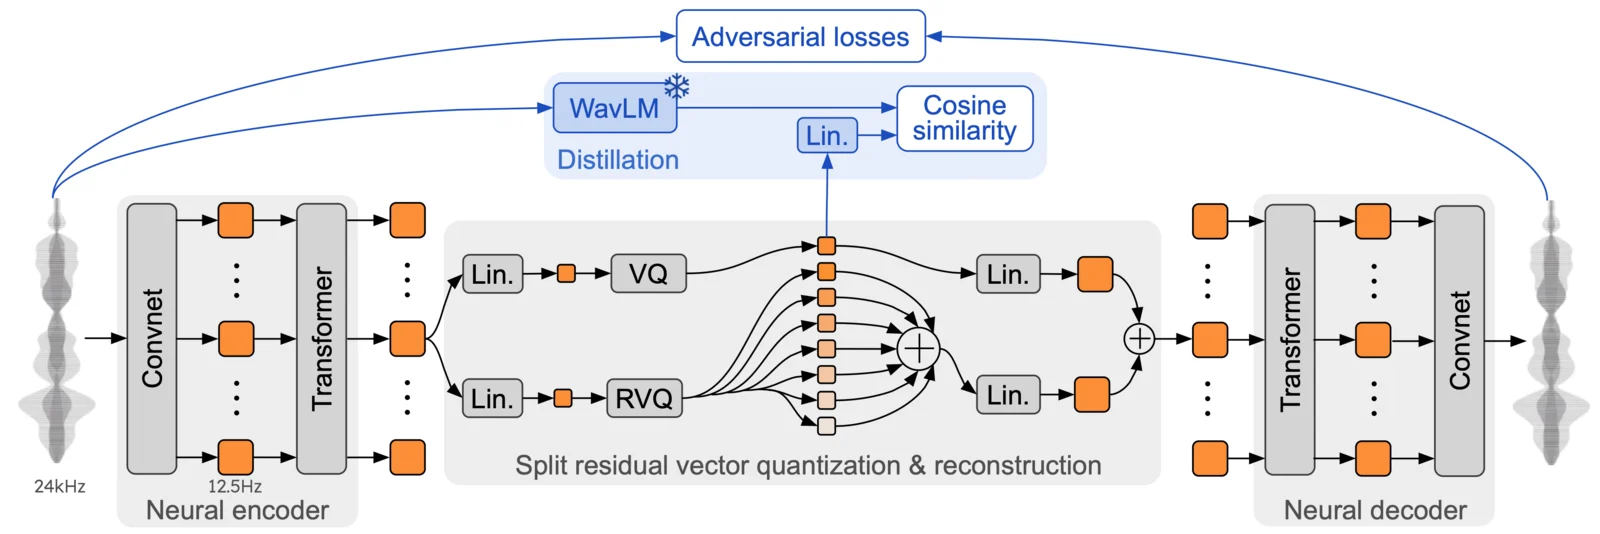
上图是 Mimi 的编码器与训练结构。信号从 24 kHz 波形进入神经编码器,压缩到 12.5 Hz 的帧率;中间是分裂残差向量量化,把每帧拆成多级码本;右侧是神经解码器重建 24 kHz 波形。图中标注的 cosine similarity 与 distillation 正是”分裂”的动机:语义支路通过余弦相似度蒸馏对齐 WavLM 的非因果表示,声学支路负责重建;最终输出由两条支路的量化结果相加后经解码器得到。
第六层:这条路线后来走到了哪
前面五层把主干讲完了:编解码器把波形压成低帧率多级码本,语言模型在这些码本符号上做条件生成,不同架构用 AR/NAR 分离、码本交织、并行 RQ 等办法处理多级码本的成本。这一节看三个方向性进展,它们各自回答了一个前面留下的问题。
Moshi:把文本流插进来做 Inner Monologue
Moshi 由 Kyutai 于 2024 年提出。它把问题推向全双工对话:用户和模型同时说话,模型要在听的同时说。这要求模型同时处理两条音频流(用户输入、模型输出),而且延迟要低。
Moshi 的做法是”我思故我说”(Inner Monologue):在音频 token 之前先预测一段时间对齐的文本 token,对应模型正在说的内容。文本 token 序列每秒只有 3 到 4 个(对应英语语速),比音频 token 稀疏得多,但它极大提高了生成语音的语言质量,同时顺带给了模型流式语音识别与语音合成的能力——因为文本流本身就是转写。
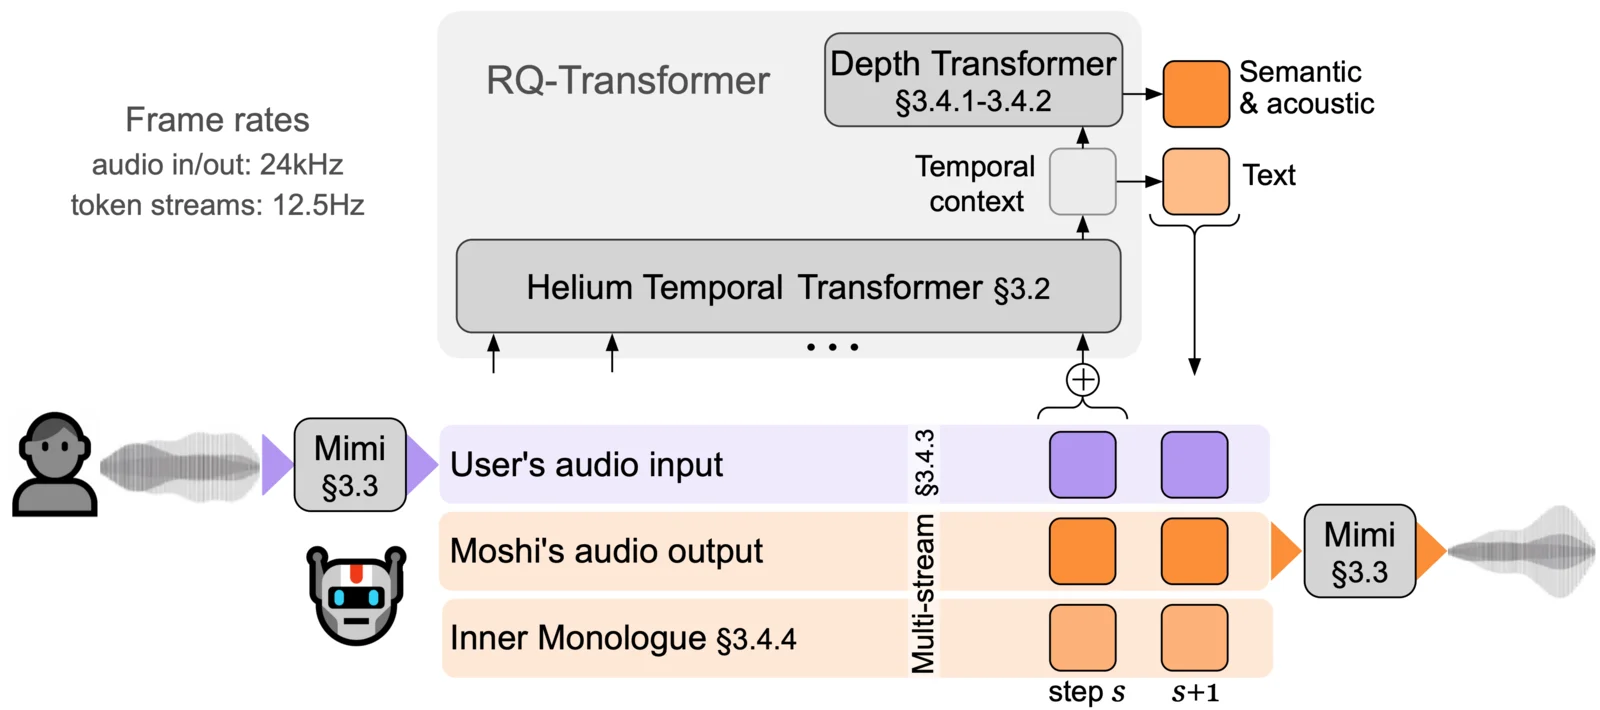
上图是 Moshi 的总体架构。左侧的 24 kHz 音频输入/输出经过 Mimi 编码为 12.5 Hz 的 token 流;中间是共享的 Helium 文本主干,负责文本流与时间上下文;右侧的 RQ-Transformer 是一个深度 Transformer,逐级处理 8 个码本。图里有两组流:文本 token 流和音频 token 流,音频流中又分”用户输入的音频”和”Moshi 输出的音频”。下方的 、 表示时间上下文按 80 ms 步推进。
这个设计的核心是”主干 + 分支”的堆叠:主干(Helium)一次同时预测文本流与第一级音频码,RQ-Transformer 再以主干输出为条件,依次预测第 2 到第 8 级。论文报告的理论延迟 160 ms,实际约 200 ms,第一段是 Mimi 的 80 ms 帧长加上模型前向与解码的开销。
Moshi 还有一项对”离散 token 路线”本身很关键的观察:在它的时间步定义下,一秒音频是 12.5 帧,每帧的音频符号数是 8 级;但文本流每秒只贡献 3 到 4 个 token。两个流的时间轴完全相同(都是 80 ms 一步),文本流的序列密度却只有音频的几十分之一。Inner Monologue 的做法是把文本 token 放进同一个时间轴上,让它们只占一个”位置”而不是一个”级”,于是生成时文本的 KV 缓存几乎不增加负担,却给模型提供了远比音频符号更紧凑的语言约束。论文报告了这一做法对生成语音的语言质量有显著改善,同时保留了流式识别与合成的能力。
另一个实现细节是 RQ-Transformer 的缓存结构。它不是把 8 级码本当作 8 条独立序列并行缓存,而是把每一级放在单独的”深度层”上:第 1 级与主干共享时间轴,第 2 级接受第 1 级的输出作为条件并在同一时间轴上展开,以此类推。这样每一级的 KV 缓存长度等于时间轴长度,总缓存是 份时间轴,而不是 倍长度的单一序列;而且由于每一级的序列都很短(12.5 Hz 时 5 分钟也只有 3750 帧),这 8 份缓存的绝对规模仍然可控。这比”把 8 级扁平化铺成 3 万步”的朴素做法要稳定得多。代价是每一级都要单独前向一次,计算量大约与级数成正比。
三条路线的设计空间:堆叠、并行头与延迟
到这里,处理多级码本的全部办法可以摊成一张三维的设计空间,每一维对应一个代价项。
| 组织方式 | 每帧前向次数 | 级间条件 | 缓存形态 | 代表 |
|---|---|---|---|---|
| 扁平化 | 完整 | 一条长序列,长度 | MusicGen 的 flattening 模式 | |
| 并行头 | 1 | 丢失帧内级间条件 | 一条序列,长度 | MusicGen 的 parallel 模式 |
| 延迟交织 | 1 | 保留帧内级间条件,帧间有 帧错位 | 一条序列,长度 | MusicGen 的 delay 模式 |
| RQ 堆叠 | 完整,且按深度分层 | 条时间轴,各长 | Moshi 的 RQ-Transformer | |
| AR/NAR 分离 | 1(AR) + 1(NAR) | 第一级完整,后续级并行 | AR 一条时间轴,NAR 一次全量前向 | VALL-E |
这张表里没有”最优”的格子,选哪一格取决于三个约束:延迟(每帧前向次数越多,流式输出越慢)、质量(级间条件越完整,重建越接近原音)、缓存(序列越长,并发越难)。
MusicGen 的消融给了这张表一个实测锚点,但结论比”哪种最好”更细:扁平化得分最好,延迟与部分扁平化接近,并行明显更差;同时延迟模式只用了 1500 步,扁平化则是 6000 步(30 秒、4 级)。 也就是说,延迟用四分之一的步数拿到了接近扁平化的质量,这是它在工程上被广泛采用的真正理由。
这组结果的含义很清楚。并行省下的前向次数,是用帧内级间条件换来的;而在音乐这种级间强相关的信号上,这笔交易不划算——同一帧的 4 级码本之间存在系统性依赖,并行让它们互相不可见,模型只能靠时间上下文去猜。延迟模式是另一种交易:它保留了帧内条件,只把帧间的对齐放松了 帧;由于帧率高达 50 Hz, 帧不过是几十毫秒的时间错位,在音乐结构上几乎不可察觉,代价却从 步降到了 步。
RQ 堆叠是第三种交易:它把”级”变成”深度”,每级前向一次,但每级的时间轴都短,而且第 级只需要在它自己的层级上展开,不需要把前面的级重新读一遍。它保住了完整的级间条件,代价是计算量随级数线性增长。Moshi 之所以敢选它,是因为流式对话要求每 80 ms 产出一帧、并同时维持 8 级码本的完整条件——在这个约束下,宁可每帧多做几次前向,也不能让级间条件断裂;而 12.5 Hz 的极低帧率把”每帧多做几次”这个乘数压到了可以实时承受的范围内。
VALL-E 的 AR/NAR 分离则把”级”拆成”粗”与”细”:第一级走完整自回归,后面七级并行。它适合语音这种”音色和内容主要由第一级承载、细节级相对独立”的信号。三种组织方式之所以都能成立,是因为不同模态的级间相关性不同——这是选择架构时最应该先问的问题。
编解码器的选择成了系统级问题
这一点值得单独展开,这里先给出结论:编解码器的选择不再是”音质够不够”的问题,而是”生成模型能不能在预算内跑起来”的问题。
DAC(Descript Audio Codec)是这个方向的代表。MusicGen 把它和 EnCodec 做过对照:DAC 在 44.1 kHz 下用 9 级码本、帧率 86 Hz,量化在更低维的空间里进行以提高码本利用率。同一篇论文的消融结论相当微妙——在域内测试集上,DAC 版的 FAD 与 KL 都更差;在 MusicCaps 上,DAC 版的 FAD 反而更好,但 KL 与主观评分更差。这组结果说明两件事:第一,编解码器的质量指标与生成模型的质量指标并不一一对应,tokenizer 换了,FAD 的排序都可能翻转;第二,DAC 的帧率更高、级数更多,序列代价明显上升,这一点在音质指标里根本看不到。
两边的差别不是”谁更先进”,而是同一个预算在两处花:多花的比特用于重建保真,还是用于更短的序列。编解码器的选择因此是一个多维权衡——帧率、级数、码本大小、语义保留程度,每一项都直接映射到生成模型成本账上的一行。
这条路线天然的流式优势
把前面几节串起来,会发现离散 token 路线在流式推理上有一个文本 LLM 没有的特性:它天生就是”块产出”的。
文本 LLM 每步产出一个 token,自回归步数与”可用的输出单位”一一对应。音频路线则不同:在延迟模式或 RQ 堆叠下,一个时间步就能产出一整帧的多个级,帧本身又是等长的 80 ms(或 20 ms 音频片段)。这意味着模型可以在产出一帧的瞬间,就把这一帧交给解码器输出声音,而不必等整段说完。VALL-E 的 AR 阶段则是一个反例:它每一步只产出第一级的一个符号,后续级要等第一级全部完成才能批量计算,所以它适合离线合成,不适合实时对话——这也是 Moshi 必须重新设计 RQ-Transformer 的根本原因。
这个区别对服务端有直接影响:块产出意味着请求可以按帧切片、与用户输入交错调度,而不必像文本流式那样以 token 为单位做极短周期的调度。代价是块内的所有级必须一起算完才能解码,块与块之间不能细粒度抢占,所以调度粒度从”token”变成了”帧”。
小结
离散 token 路线的结构可以收成一句话:用一个学习出来的”音频字典”把波形压成低帧率、多级的整数序列,再用语言模型在这个序列上做条件生成。
几个关键的设计决策及其理由:
- RVQ 而不是单层 VQ:每一级量化上一级的残差,用 比特获得 的码本组合空间;第一级最重要、后续递减的层级结构,被下游模型(VALL-E 的 AR/NAR 分离、MusicGen 的粗粒度优先)直接利用。
- 编解码器需要对抗损失:逐点误差在感知上不成立,多尺度判别器提供的是”听感一致”的训练信号。
- 语义与声学分层(AudioLM):长程结构交给稀疏的语义 token,细节交给密集的声学 token,代价是三级级联的误差传播。
- 多级码本的三种组织(VALL-E、MusicGen、RQ-Transformer):AR/NAR 分离、交织模式、堆叠预测。三者都是在”自回归步数”与”级间条件”之间做取舍。
- 流式的前提是低频帧与因果编解码器(Mimi):12.5 Hz、80 ms 帧长、分裂 RVQ,把”每秒 100 个 token”这个数字压到与实时交互相容的区间。
推理侧最该记住的账是:序列长度 ≈ 帧率 × 时长,缓存规模 ≈ 级数 × 时间轴(取决于组织方式),而这两项的乘积才是这条路线真正的成本。
这条路线与本站其他多模态生成的内容可以对照来看:连续扩散那条路侧重的是”怎么把噪声变成数据”,本系列的连续扩散文章以 扩散模型从零讲起(十):音频扩散 收尾,讲的是 mel 与潜空间上的波形生成;而离散 token 这条路的重点变成”怎么用语言模型直接预测音频符号”,两者在推理账上的差别(序列长度、缓存结构、是否适合流式)是最值得并排比较的部分。语音合成的另一套主干结构,可以参考 CosyVoice 2 架构拆解,它用 LLM 生成语义 token、再用流匹配补声学细节,正好处在两条路线之间。
参考资料
- SoundStream: An End-to-End Neural Audio Codec(Google, 2021)
- High Fidelity Neural Audio Compression(EnCodec)(Meta, 2022)
- AudioLM: a Language Modeling Approach to Audio Generation(Google, 2022)
- Neural Codec Language Models are Zero-Shot Text to Speech Synthesizers(VALL-E)(Microsoft, 2023)
- Simple and Controllable Music Generation(MusicGen)(Meta, 2023)
- Moshi: a speech-text foundation model for real-time dialogue(Kyutai, 2024)
- EnCodec 官方代码仓库
- Moshi 官方代码仓库
- Descript Audio Codec 仓库
- 扩散模型从零讲起(十):音频扩散——波形、mel 与潜空间,语音生成的推理账(本站,与离散 token 路线对照阅读)
- CosyVoice 2 架构拆解:一条语音是怎么边想边说的(本站,LLM 主干 + 流匹配的另一套流式 TTS 结构)
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



