


语音识别的三种基础架构:log-mel 前端、CTC、RNN-T 与 Whisper
声音与文字之间隔着什么
语音识别(Automatic Speech Recognition,ASR)要解决的问题可以写得很简单:给定一段波形 ,输出它对应的文字序列 。但这句话里藏着一个别的序列任务很少遇到的麻烦——输入和输出的长度不在一个量级,而且没有任何逐帧对齐标注。
一段 16 kHz、16 bit 采样的语音,每秒产生 16000 个采样点,占 32 KB。人说话的速度大约是每秒 3 到 5 个汉字或英文单词,对应到子词(subword)粒度也就每秒几个 token。也就是说,输入序列比输出序列长三个数量级。没有人会告诉你「第 8000 个采样点对应『今』这个字」;即使有转写文本,文本里也不带时间戳。
这三件事——超长输入、短输出、无对齐——共同决定了语音识别模型的基本形状。直接对 16000 长度的波形做自注意力,序列长度平方的代价无法承受;即便承受得起,模型也很难从原始采样点里直接学出稳定的声学结构。于是所有实用系统都做了同一件事:先用一个固定的信号处理前端把波形压成每秒约 100 帧的声学特征,再把「帧序列到 token 序列」的映射交给神经网络。
前端之上,历史上有三种截然不同的建模思路,它们至今仍是几乎所有语音识别系统的骨架:
- CTC(Connectionist Temporal Classification):让模型对每一帧独立预测一个字符或 blank,把所有可能的帧级路径通过一个多对一的折叠函数映射到目标文本,用动态规划把「对齐」这个隐变量求和消掉。
- RNN-T(Recurrent Neural Transducer):在 CTC 的帧同步框架上再接一个预测网络,让「下一帧该不该出字」取决于已经出过的字,把语言模型直接融进声学模型。
- 注意力编码器-解码器(Attention Encoder-Decoder):彻底放弃帧同步,把识别写成一个序列到序列的生成任务,解码器用交叉注意力自由地从整段编码结果里取信息。OpenAI 的 Whisper 是这条路线上最广为人知的实现。
三种架构共享前半段(log-mel 前端与声学编码器),分歧出现在「编码器输出之后怎么变成文本」。把这三条路线的分岔点讲清楚,也就把语音识别的推理链路讲清楚了。
log-mel 前端:把 16000 个采样点变成 100 帧
前端的目标不是「提取特征」这么含糊的说法,而是三个具体的约束:把序列缩短两个数量级、保留区分音素所需的信息、让特征分布对信道和说话人变化不那么敏感。log-mel 频谱是这三条约束下的一个折中解。
分帧与短时傅里叶变换
语音信号在几十毫秒的尺度上可以近似看作平稳的。前端因此把波形切成互相重叠的小段:常见的配置是 25 ms 窗长、10 ms 帧移。在 16 kHz 采样下,一帧 400 个采样点,帧移 160 个采样点,于是每秒正好 100 帧。30 秒音频得到 3000 帧,这就是 Whisper 输入端那个固定的 3000 维长度的来源。
每一帧先乘一个窗函数(Hann 或 Hamming),再做离散傅里叶变换。窗函数的作用是抑制分帧造成的频谱泄漏:直接把一段信号截断再变换,相当于乘了一个矩形窗,矩形窗的旁瓣衰减很差,一个强频率成分会在邻近频点上留下拖尾。加窗让帧两端的样本平滑归零,旁瓣被压低。
短时傅里叶变换写成
其中 是帧序号, 是帧移(160), 是窗长(400,实际 FFT 点数通常取 512 以方便计算), 是窗函数, 是频点索引。 是复数,取模平方得到功率谱 。16 kHz 采样下奈奎斯特频率是 8000 Hz,512 点 FFT 的频率分辨率是 31.25 Hz,对语音识别足够——音素之间的差别主要体现在频谱包络的宏观形状,而不是 30 Hz 级别的精细结构。
mel 滤波器组
功率谱有 257 个频点(512 点 FFT 的正频率部分),直接送进网络维度偏高,而且高频段的信息密度远低于低频段。mel 滤波器组解决这两件事:它用一组三角形滤波器把频率轴重新划分,低频密、高频疏。
mel 刻度与频率的换算常用 HTK 版本:
反变换是 。这个公式的形状值得看一眼:在 Hz 时,,mel 与频率近似线性;在 Hz 时转为对数增长。结果是 0 到 1000 Hz 之间分配到的滤波器数量和 1000 到 8000 Hz 差不多,符合人耳对低频更敏感的听觉特性。
实现上,在 mel 轴上等间距取 个中心点,相邻三个中心点构成一个三角形滤波器,第 个滤波器的响应是
其中 是第 个中心点(换算回 Hz 后的频点位置)。每个滤波器对功率谱加权求和,得到 维输出。 是经典语音识别与 Whisper 前几代的配置,Whisper large-v3 改用 128 维; 越大,保留的高频细节越多,但输入维度也越大。
对数压缩与归一化
滤波器组输出后接对数:
是防止对零取对数的下限。对数压缩有两个作用。其一是动态范围:语音的能量跨越好几个数量级,清音和爆破音的功率可能比元音低三四十 dB,取对数把乘性关系变成加性关系,模型更容易处理。其二是统计性质:对数谱的分布比原始功率谱更接近高斯,后续的归一化和线性层工作得更稳。
Whisper 的具体实现还多做了一步动态范围裁剪:取整段 log-mel 的最大值,把低于「最大值减 8」的部分截到该下限,再整体做 的平移缩放。这相当于把 80 dB 的动态范围压到可训练的范围,同时保留相对能量关系。
归一化的做法因系统而异。Kaldi 时代的经典流水线用倒谱均值方差归一化(CMVN),在整句或整段上减均值除标准差,抵消信道差异;Whisper 直接用训练集统计出的全局均值和标准差,简洁但在信道偏移大的数据上不如 CMVN 稳。无论哪种,目的都是让声学模型的输入分布不要随录音设备漂移。
为什么不用 MFCC
mel 频谱之前还有一步可选:对 log-mel 做离散余弦变换(DCT),取前 13 维左右,得到 MFCC(Mel-Frequency Cepstral Coefficients)。MFCC 在 GMM-HMM 时代是标准配置,因为 DCT 去相关之后可以用对角协方差的高斯模型建模。
神经网络时代 MFCC 的优势消失了:网络自己就能学出比 DCT 更合适的线性组合,不需要人为去相关。反过来,DCT 截断会丢掉一部分频谱细节,而这些细节对区分辅音是有用的。所以现代端到端系统几乎都直接吃 log-mel,把「要不要再变换」交给第一层卷积或线性层。
前端的成本
前端看起来步骤多,实际计算量相对模型可以忽略。30 秒音频、512 点 FFT、3000 帧,FFT 总量约 次复数运算,滤波器组乘法约 次。相比后面上万亿次浮点的 Transformer 前向,这是千分之一量级的开销。真正需要在意的是它在 CPU 上做——如果推理服务把前端放在 Python 里逐帧循环,这段开销会从「可忽略」变成「瓶颈」,这也是各类工程实现(如 faster-whisper、whisper.cpp)都把重采样和 mel 计算换成手写 kernel 的原因。
CTC:把对齐问题从损失函数里消掉
CTC 由 Alex Graves 等人在 2006 年的 ICML 论文中提出。它要回答的问题是:在只给定「这段音频对应这句文本」的情况下,模型怎么知道自己该在第几帧输出哪个字?
对齐是隐变量
假设编码器把音频压成 帧,目标文本有 个 token,通常 。一种朴素的做法是要求 ,逐帧监督,但语音里大量的静音、拖长音的元音、语速变化会让这个假设彻底失效。
CTC 的解法是引入一个额外的符号 blank(记作 ),允许模型在任意帧输出 blank,然后定义一个多对一的折叠函数 ,把长度为 的帧级路径映射回长度为 的文本:
- 先合并连续重复的符号;
- 再删掉所有 blank。
例如路径 a a ∅ a ∅ ∅ b b ∅ 先合并成 a ∅ a ∅ b ∅,再删 blank 得到 a a b。折叠函数把指数多条路径映射到同一段文本,CTC 不要求模型选其中某一条,而是把所有合法路径的概率加起来作为这段文本的概率。
条件独立假设与路径概率
CTC 在每一帧上独立地做一次分类,路径 的概率是逐帧概率的乘积:
其中 是模型在第 帧输出符号 的概率, 取值于词表 加上 blank 共 类。目标文本的概率就是对所有折叠到它的路径求和:
这个求和看似不可计算——路径数量随 指数增长。CTC 的关键贡献是发现这个求和可以用前向-后向动态规划在 时间内算出来,和 HMM 的 Baum-Welch 是同一套结构。
扩展标签序列与前向递推
把目标文本 改写成在首尾和每两个 token 之间插入 blank 的扩展序列:
长度为 。之所以要插入 blank,是因为折叠函数会合并连续重复符号:如果文本里有两个相邻的 a,路径上必须有一个 blank 把它们隔开,否则 a a 会被错误合并成一个。扩展序列让「重复 token」和「跨帧延续同一 token」在路径上有了不同的走法。
定义前向变量 为「前 帧走完、当前停在扩展序列第 个位置的所有路径概率之和」。递推式是
三项分别对应三种转移:停在同一位置(这一帧继续输出同一符号)、从前一个位置前进(新输出一个符号)、从再前一个位置跳过中间位置。第三项前面的指示函数是唯一需要小心的地方:只有当当前符号不是 blank、且和前两个位置上的符号不同时,才允许跳过中间那个 blank。如果当前符号和前两个位置相同(也就是文本里出现了连续重复),跳过 blank 会把两个 token 合并成一个,必须禁止。
最终的序列概率是
两项分别对应最后停在末尾 blank、或停在最后一个 token 上。训练时损失就是 ,反向传播时用后向变量 计算每个位置的分担,形式与前向对称:
有了前后向变量,任意一帧、任意一个扩展位置被路径经过的概率是 ,这就是 CTC 里「帧级对齐」的全部信息。
推理:一次前向加一次折叠
CTC 的推理非常直接:编码器加分类头跑一遍,得到 的概率矩阵;每帧取 argmax 得到一条路径;用折叠函数去掉重复和 blank,得到文本。这就是贪心解码,复杂度 ,没有任何自回归步骤。
如果追求更高精度,可以在帧级概率上做前缀束搜索(prefix beam search),维护若干候选前缀,按「在该前缀上追加符号或延续 blank」的概率增量扩展。因为 CTC 假设帧间条件独立,前缀搜索的合并逻辑比自回归解码简单得多;但反过来,这个条件独立假设也正是它的软肋。
前缀束搜索
贪心解码在每一帧只看当前最大概率,遇到同音字或噪声帧就会锁死错误。前缀束搜索(prefix beam search)在帧级概率之上维护若干候选前缀,关键是把「同一个前缀的两类状态」分开记账:
- :到第 帧为止,折叠后得到前缀 、且当前帧停在 blank 上的路径概率和;
- :折叠后得到前缀 、且当前帧停在非 blank 符号上的路径概率和。
递推时对每个候选前缀 和每个符号 做三种扩展:
第一行处理「继续输出当前前缀的最后一个符号」,第二行处理「追加新符号」,第三行处理「这一帧输出 blank」。注意第二行只从 出发:如果上一帧刚输出过同符号,继续输出同一符号会被折叠合并,不算新增;若要真正追加一个重复符号,必须先经过一个 blank。
每帧结束后把所有前缀的概率按 排序,保留前 个。 取 8 到 32 时,CTC 的精度通常能提升几个百分点;但束搜索本身不引入语言知识,进一步的提升要靠外部 LM 重打分。
条件独立假设的代价
把每帧的决策独立开来,意味着模型无法利用「上一帧已经输出了什么」来调整这一帧的判断。对于同音字、语法约束、专有名词这类需要上下文才能消歧的场景,CTC 的声学模型几乎无能为力,必须外挂一个语言模型(n-gram 或神经 LM)在束搜索里做插值:
是 LM 权重, 是长度奖励。这三个超参数在部署时通常要针对具体领域重新调,是 CTC 方案在工程上的一个隐性成本。
另外两个限制也来自帧同步本身。其一是输出长度:折叠只会缩短路径,所以 token 数不可能超过帧数 ;对每秒 5 个 token 的语速和每秒 100 帧的特征,这远不是瓶颈,但在极快语速配合低帧率特征时需要留意。其二是「尖峰」输出:CTC 训练出的模型倾向于把整条路径的概率压在少数几条路径上,逐帧后验呈现明显的尖峰,blank 在大量帧上占据主导。尖峰本身不是问题,但它说明模型在帧级上做得非常「果断」,一旦某个辅音被吞掉,后面的搜索很难纠正。
CTC 最适合的是帧同步、低延迟、算力受限的场景:唤醒词、命令词、嵌入式设备、实时字幕的第一级声学模型。它的推理账是三种架构里最便宜的——一次前向,没有解码循环。
RNN-T:给声学模型接上一个预测网络
CTC 的软肋是标签历史。Alex Graves 在 2012 年的论文《Sequence Transduction with Recurrent Neural Networks》里给出了一个修补方案,后来被称为 RNN Transducer(RNN-T)。它的结构和 CTC 同源,但在「什么时候该出字」这件事上引入了对已输出标签的依赖。
三个网络
RNN-T 由三部分组成:
- 编码器(encoder):把声学特征编码成 ,。结构可以是 LSTM、Conformer 或任意流式友好的编码器。
- 预测网络(prediction network):把已经输出的前 个标签 编码成 。它本质上是一个语言模型,但只建模标签序列本身,不看音频。
- 联合网络(joint network):把两者组合,输出在位置 上「下一个符号是什么」的分布:
符号 同样取遍词表加一个 blank。两个编码向量的维度不同, 和 先把它们投影到同一个隐空间,相加后过 ,再由 映射到输出维度。加法而不是拼接,是原始论文的做法,参数量更省;后续实现里也有用拼接或门控的变体。
输出格与对齐
RNN-T 的解码过程可以画成一个 的格:横轴是时间帧,纵轴是已输出标签数。每个格点 有两个出边:
- 输出 blank:,时间前进,标签不变;
- 输出标签 :,时间不变,标签前进。
一条从 到 的路径就是一次完整的「对齐 + 转写」。与 CTC 不同,这条路径上的每一步都依赖路径本身已经走过的部分——因为 是沿纵轴累积的。序列概率是所有这些路径概率之和:
同样可以用前向-后向在格上做动态规划,复杂度 。前向变量 表示到达格点 的所有路径概率和:
两项分别是从上方(blank 边)和左侧(标签边)过来的贡献;边界条件是 ,纵轴 只能走 blank,横轴 只能走标签边。训练损失仍是 。
格上的路径长什么样
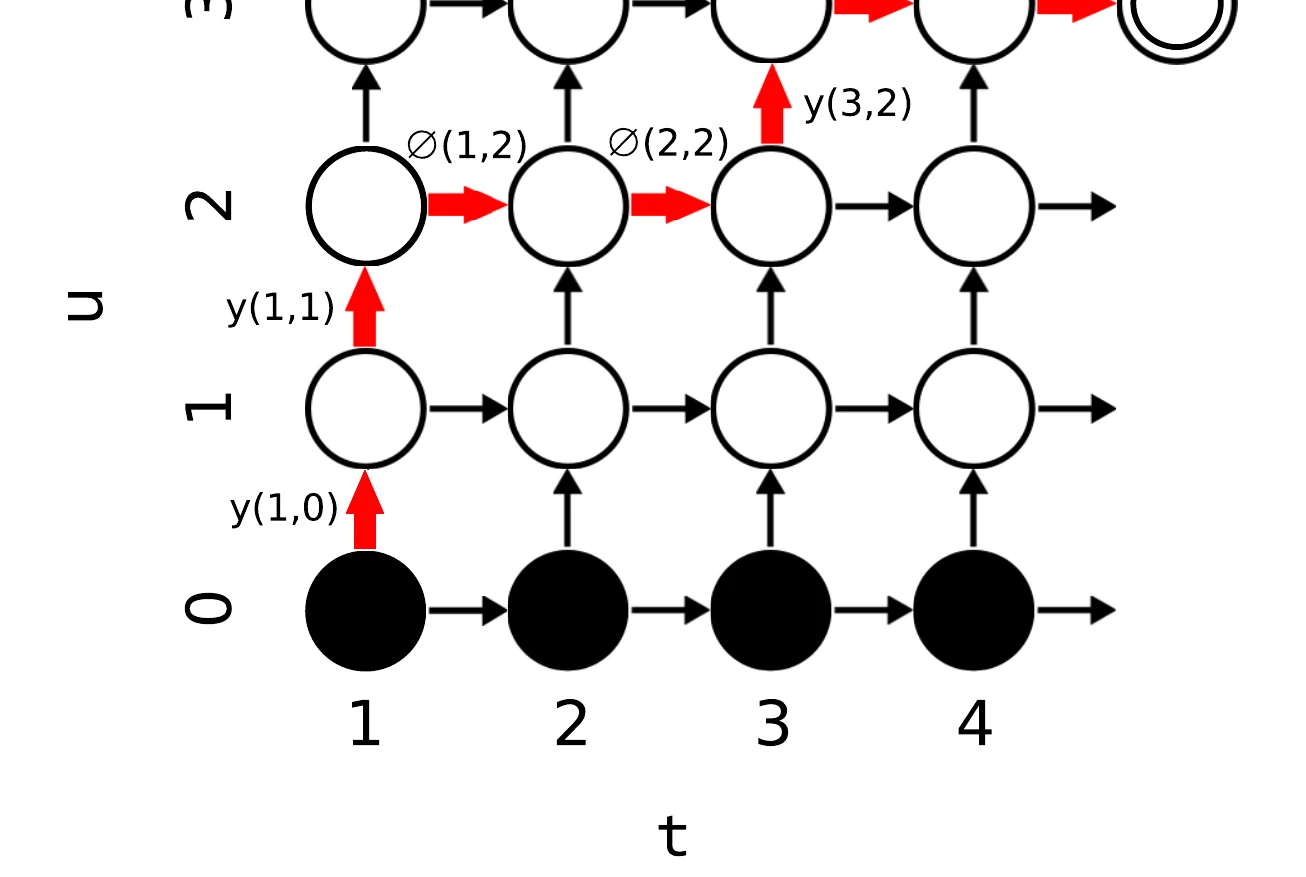
上图是 Graves 2012 年论文里的输出格示意图。纵轴是标签(右侧数字对应已输出的 token 序号),横轴是时间帧,每个节点旁边标注的 就是联合网络在该位置的输出分布。图中那条从左上走到右下的折线是一条可行路径:向右走一格表示该帧输出 blank(只推进时间),向下走一格表示输出一个标签(只推进标签,不消耗新的帧)。可以看到,模型可以在同一帧上连着输出多个标签——这正是 CTC 做不到的:CTC 的折叠要求每个符号占用不同的帧,而 RNN-T 的标签边不消耗时间。
这张图也解释了为什么 RNN-T 的「对齐」比 CTC 更丰富。CTC 的路径是一维的,对齐只反映「这一帧属于哪个符号」;RNN-T 的路径是二维的,同一条最优路径上的标签边位置直接给出了「第 个词在第 帧附近被说出」的信息,训练完成后可以直接从这里抽取时间戳,不需要另跑强制对齐。
为什么它比 CTC 强
差别在联合网络的两个输入。CTC 的分类头只看 ,同一帧的预测与历史无关;RNN-T 的预测是 ,已经输出的标签通过 参与决策。效果上,模型学到的不是「这一帧像什么音」,而是「在这一帧、已经说了这些字的条件下,下一个字应该是什么」。语言模型被内化了,不需要外挂 n-gram 再做插值。
代价是解码不能再逐帧 argmax。给定 的分布,仍然可以贪心:若 blank 概率最大就 ,否则输出该标签并 。但贪心会锁死错误,实用系统用束搜索(beam search)在格上维护若干候选,按 的增量扩展,配合 beam 宽度和 blank 惩罚。
贪心解码与流式吐字
RNN-T 的贪心解码可以写成很短的循环:
t = 1, u = 0, y = []while t <= T: k = argmax_k p(k | t, u) if k == blank: t += 1 else: y.append(k); u += 1它和 CTC 的贪心有一个本质区别:CTC 的 t += 1 每帧固定发生一次,输出只取决于这一帧;RNN-T 的 t 是否前进取决于当前 (t, u) 上的判断,而 u 又反过来影响下一个判断。同一帧上可以连出多个字,也可以一直出 blank,直到预测网络认为「该说话了」。
流式部署正是利用这一点:编码器按块前进,每编码完一块就进入上面的循环,循环在某帧输出 blank 且没有更多输入时挂起,等下一块到来再继续。预测网络的状态(沿纵轴的 及其内部隐状态)很小,可以常驻;编码器的卷积缓存和注意力 KV 按块滚动。实际系统的首字延迟由三部分相加:编码器的前瞻帧数(通常 200 到 500 毫秒)、块内格搜索的时间、以及后端的去重与标点处理。这也是为什么流式 RNN-T 的延迟通常报「几百毫秒」而不是 CTC 那种「一个 chunk」。
计算量的另一面
联合网络要在每个格点上算一次 维 softmax。训练时这是 次前向,计算量远大于 CTC 的 次;推理时束搜索会剪枝,实际只访问格点的一小部分,但每次访问仍要做一次投影和 softmax。对每秒 100 帧、每秒 5 个标签的配置,朴素地遍历整个格是 次,束宽 8 时乘以 8,仍在毫秒级;真正的开销在编码器。
Conformer:为流式识别设计的编码器
RNN-T 的编码器在现代系统里几乎都换成了 Conformer。它由 Google 在 2020 年提出(arXiv:2005.08100),核心观察是:语音既有局部结构(共振峰、爆破、协同发音发生在几十毫秒内),又有全局依赖(上下文、语速、韵律)。纯 Transformer 擅长后者,纯卷积擅长前者,Conformer 把两者放进同一个 block。
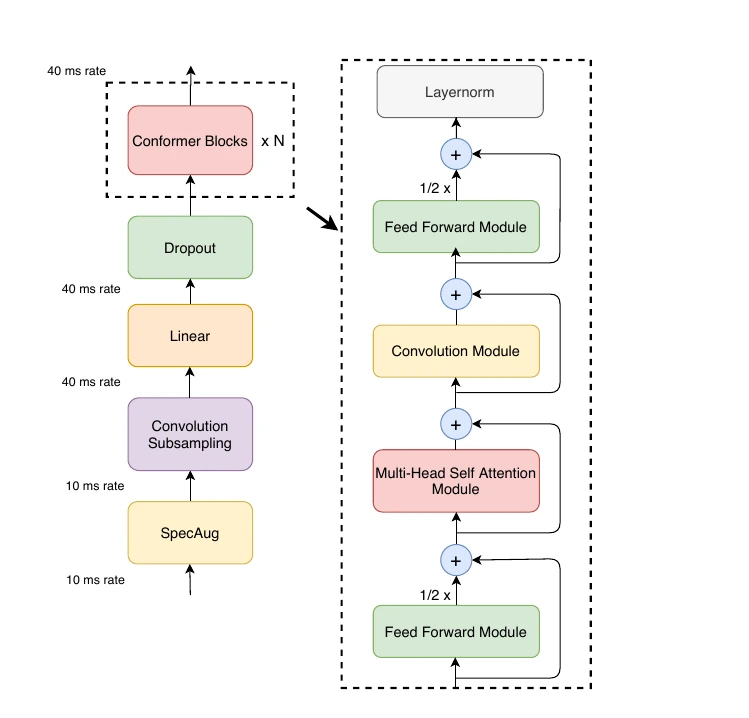
上图来自 Conformer 论文(arXiv:2005.08100)的 Figure 1,是 block 结构。一个 block 的计算顺序是:
- 半层前馈(feed-forward),带残差;
- 多头自注意力(multi-head self-attention),带残差;
- 卷积模块(convolution module),带残差;
- 再一个半层前馈,带残差;
- LayerNorm。
两个前馈各用一半的扩张系数,整体呈「三明治」形状,论文称之为 macaron 结构:注意力在中间,前馈在外层。这种排布让卷积模块夹在注意力和第二个前馈之间,局部特征先被注意力做一次全局混合,再被卷积做一次局部平滑,最后再进前馈。
卷积模块的内部是:逐点卷积把通道扩张,门控线性单元(GLU)做一次门控,深度可分离卷积在时间轴上做局部建模,BatchNorm 归一化,Swish 激活,再逐点卷积把通道压回原维度。深度卷积的核通常取 15 到 32,覆盖几十到几百毫秒的上下文。自注意力使用相对位置编码,避免绝对位置在流式场景下的漂移。
流式部署时,Conformer 的自注意力要改成带左右上下文的块注意力:当前块只能看左边固定长度的历史帧和右边有限的前瞻帧。卷积模块则要缓存跨块的边界状态,否则每个块的卷积核在块边界处会看到零填充,产生不连续。这两处改造决定了流式 RNN-T 的实际延迟:前瞻帧数乘以帧移,就是模型必须等到的未来音频长度。
Whisper:把识别写成序列到序列
CTC 和 RNN-T 都把识别约束成帧同步的决策,Whisper 走了另一条路:把它当作一个标准的编码器-解码器生成任务,解码器像语言模型一样逐个吐 token,每一步通过交叉注意力从整段音频编码里取信息。Whisper 由 OpenAI 在 2022 年发表(arXiv:2212.04356),训练数据规模和任务形式让它成为目前最常用的通用语音识别模型。
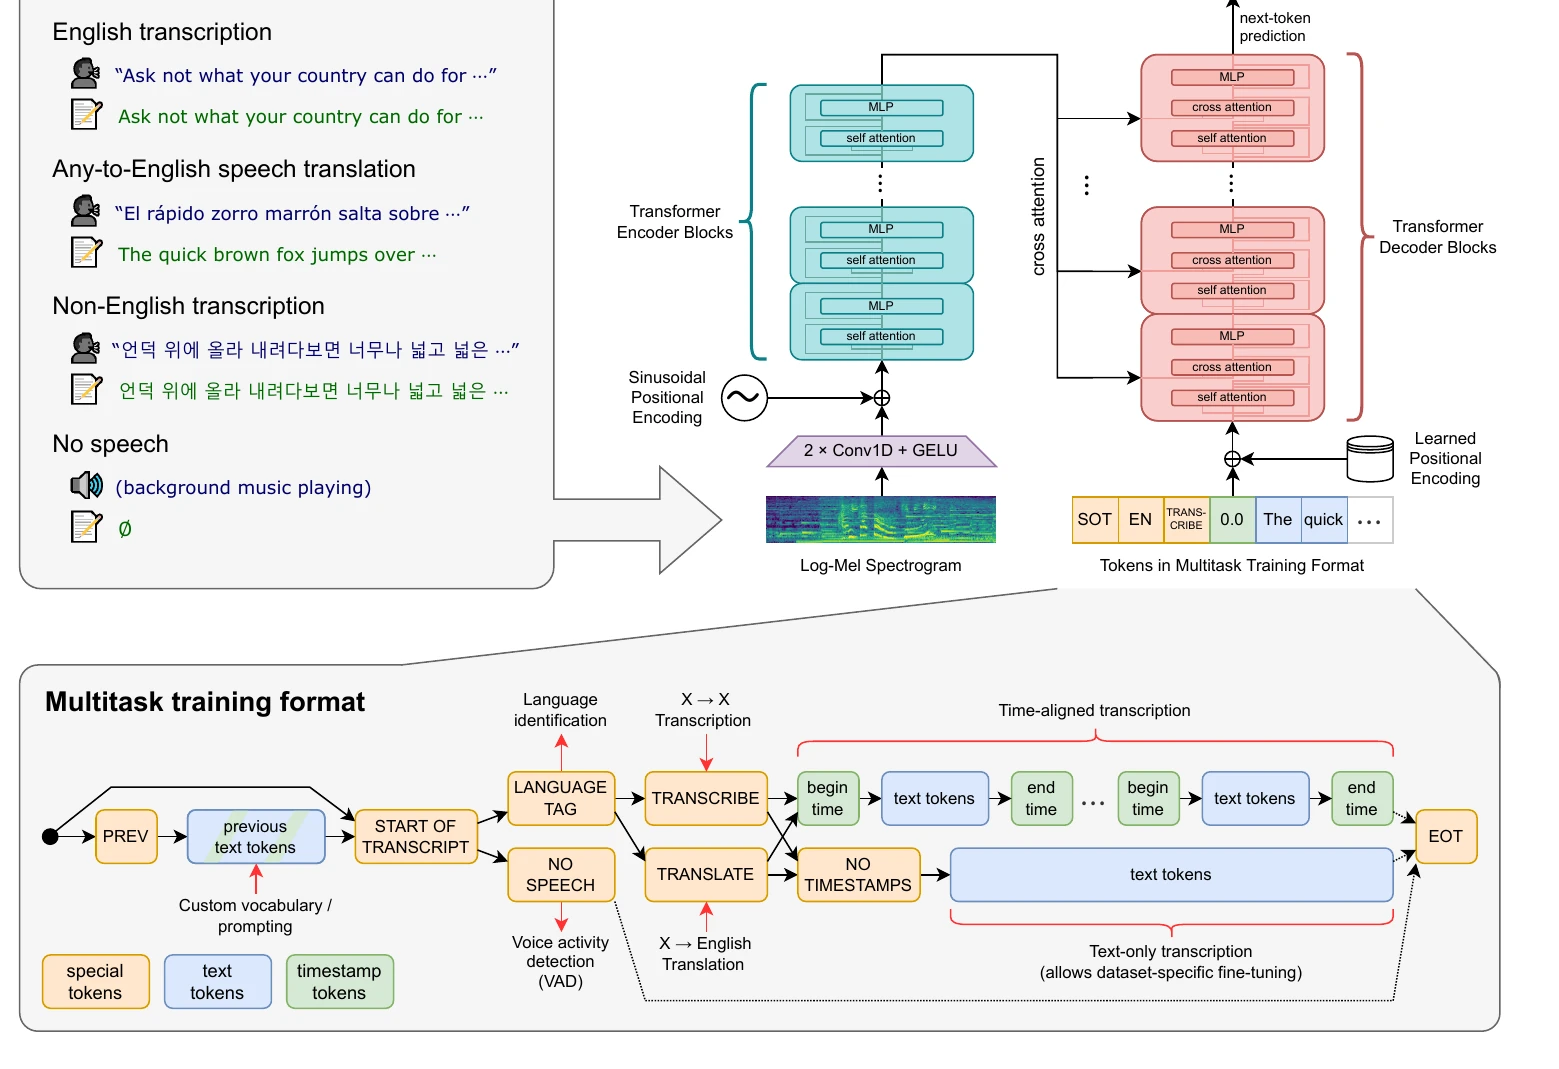
上图来自 Whisper 论文(arXiv:2212.04356)的 Figure 1,是架构总览,从左到右依次是 log-mel 频谱、编码器、解码器和多任务 token 格式。下面按数据流走一遍。
编码器
输入是 80 维 log-mel、3000 帧(30 秒)。注意此处用的是 80 维,Whisper large-v3 才改为 128 维。编码器前两层是卷积:
- 第一层:卷积核 3、步长 1、GELU 激活,把通道从 80 映射到模型维度;
- 第二层:卷积核 3、步长 2、GELU 激活,把时间长度从 3000 减半到 1500。
步长 2 的下采样把帧率从 100 Hz 降到 50 Hz,序列长度减半,自注意力的平方成本降到四分之一。1500 帧之后接正弦位置编码(sinusoidal positional encoding),再堆若干层 Transformer encoder block,每层是自注意力加前馈,双向可见。
Whisper 发布时给出五个尺寸,编码器和解码器层数相同:
| 模型 | 层数 | 模型维度 | 注意力头数 | 参数量 |
|---|---|---|---|---|
| tiny | 4 | 384 | 6 | 39M |
| base | 6 | 512 | 8 | 74M |
| small | 12 | 768 | 12 | 244M |
| medium | 24 | 1024 | 16 | 769M |
| large | 32 | 1280 | 20 | 1550M |
largest 版本的编码器是 32 层、1280 维、20 头,对 1500 个位置做全注意力。这部分是固定成本:无论音频里有没有语音、要转写多少字,编码器的计算量都一样。
解码器与交叉注意力
解码器是因果自注意力加交叉注意力。因果自注意力处理已经生成的 token,交叉注意力以解码器当前层的隐状态为 query,以编码器输出为 key 和 value,因此不受因果掩码限制——每一步都能看到全部 1500 帧编码结果。
交叉注意力是整条链路里唯一连接音频与文本的地方,它的成本结构值得单独算。设解码器序列长度为 、模型维度为 、编码器长度为 ,每层交叉注意力的计算量约为 ,是解码器自注意力()的 倍。当 只有几十个 token 时,交叉注意力显然是大头。好消息是编码器的 key/value 在整个解码过程中不变,可以预先算好并缓存一次,之后每步只做 query 投影和注意力加权;坏消息是这 1500 个位置的 KV 本身占内存,32 层、20 头、1280 维,按 fp16 算约 字节,约 250 MB,是解码阶段显存占用的一个重要部分。
多任务 token 格式
Whisper 把多种语音任务编码成同一个 token 序列,这是它区别于传统 ASR 的第二个设计。解码器的开头不是文本,而是一段控制 token:
<|startoftranscript|> <|zh|> <|transcribe|> <|notimestamps|> 今天天气不错 <|endoftext|>四个位置分别表示:序列起始、语言标识(99 种语言加若干特殊项)、任务(转写或翻译成英文)、时间戳模式(是否输出时间戳)。训练时这些 token 也是监督目标的一部分,所以模型在推理时必须先「声明」自己要做什么,再开始输出文本。多语言、多任务、带不带时间戳,全部由这一段前缀控制,模型结构本身不需要任何改动。
这也解释了 Whisper 的一个工程特点:语言不是自动检测出来的独立模块,模型在前几个解码步里对语言 token 的分布就是它的语言判断。实践中常用的做法是先跑一次只解码前缀的短前向,取语言 token 的 argmax 或概率,再决定后续解码的语言条件;OpenAI 官方实现里的 detect_language 走的就是这条路。
时间戳 token
Whisper 的词表里还有 1501 个时间戳 token,从 <|0.00|> 到 <|30.00|>,粒度为 0.02 秒。它们不是附加在文本旁边的元数据,而是和文本 token 在同一个序列里被预测。一个带时间戳的输出长这样:
<|0.00|> 今天 <|1.20|> 天气 <|1.60|> 不错 <|2.40|> <|2.40|>规则是:时间戳成对出现,一对表示一个片段的起止;起止可以相等,表示零长度片段,用来跳过一段没有语音的区域。时间戳必须单调不减,并且不能超过 30 秒;解码时可以限制采样只在时间戳 token 或文本 token 里选,保证格式合法。这套机制让 Whisper 在单窗口内就能给出词级时间信息,不需要外挂强制对齐器——虽然后来的 WhisperX 仍然选择用独立的音素对齐模型来获得更准的词级时间戳。
解码流程与失败回退
Whisper 的解码不是简单的贪心,而是一套带质量检查的回退流程,这是它能在多样音频上稳定工作的关键工程细节:
- 以温度 0 做贪心解码(或用束搜索),得到候选结果;
- 计算三个指标:平均对数概率、压缩率(文本被 gzip 压缩后的长度比,用来检测重复循环)、无语音概率;
- 如果平均对数概率低于阈值(默认 -1.0)、压缩率高于阈值(默认 2.4),或检测到无语音而模型仍输出了文本,就提高温度重试;
- 温度按 0、0.2、0.4…1.0 递增,每一步都重新解码,直到结果通过检查或用完温度表。
压缩率这个指标很朴素但有效:模型陷入重复循环时(比如反复输出同一句话),文本的压缩率会显著升高,gzip 长度比超过 2.4 基本可以判定为退化。平均对数概率则捕捉「模型自己也不确定」的情况。无语音概率来自序列起始位置的分类分布,配合外部的语音活动检测(VAD)可以进一步减少静音段上的幻觉。
解码器的 KV 缓存与批处理吞吐
自回归解码的每一步都要重新算注意力,如果每步都重算历史 token 的 key/value,成本会随序列长度平方增长。Whisper 的实现因此维护两份缓存:一份是解码器自注意力的 KV,随生成的 token 逐步追加;另一份是交叉注意力的 KV,在编码器输出上算一次,整个窗口内复用。
按 large 模型估算:解码器 32 层、20 头、1280 维,每个 token 每层自注意力的 KV 是 个 fp16 数,约 5 KB;448 个 token 全部生成完,单条序列的自注意力 KV 约 MB。批大小 32 时这部分就是 2.2 GB。交叉注意力的 KV 更大:每层 1500 个位置, MB 每条序列,批 32 时 7.7 GB。这是 Whisper 服务端显存占用的主要来源,也是实际部署里批大小往往卡在个位数的原因。
由此可以理解两个工程优化方向。第一是降精度:KV 与权重换成 int8,显存直接减半,faster-whisper 的 int8 路径就是这一思路。第二是缩窗口:既然交叉注意力 KV 正比于窗口内的编码帧数,把长音频切得更碎、每次只编码必要的片段,就能把这份固定开销降下来;代价是切点处理和上下文丢失,需要 VAD 与重叠窗口来补偿。批处理则主要摊薄权重读取——解码器每步都要读 3.1 GB 权重,批 32 时同样的读取服务 32 条序列,单条的权重带宽成本降到三十二分之一,而 KV 显存随批线性增长。吞吐与显存之间的这条曲线,是 Whisper 服务调优的核心。
长音频
Whisper 的模型窗口固定 30 秒,更长的音频要在外面切窗。官方实现的策略是按 30 秒切块,块之间不重叠,解码时把上一块末尾的文本作为下一块的前缀条件(condition_on_previous_text),并用时间戳判断上一块是否在句中断开。这个做法简单,但有两个已知问题:错误会沿着前缀条件向后传播;切块边界落在词中间时,模型可能重复或吞掉半个词。
工程上的改进大多围绕这两点。WhisperX 先用 VAD 把音频切成语音段,保证切点落在静音处,再对每段独立解码,最后用音素对齐模型把词级时间戳对齐回原始时间轴;faster-whisper 用 CTranslate2 重写了推理,支持 int8 量化和批处理,在相同精度下把速度提高数倍;distil-whisper 把编码器和解码器层数减半再蒸馏,在分布外数据上把错误率控制在接近原模型的水平,速度提升约 5 到 6 倍,代价是只保留英语、且对噪声和口音的鲁棒性略有下降。
三条路线的推理账与选型
把三种架构放在同一张表里,差别一目了然:
| 维度 | CTC | RNN-T | Whisper 式编码器-解码器 |
|---|---|---|---|
| 对齐方式 | 帧同步,blank 折叠 | 帧同步,格上路径 | 自由解码,交叉注意力 |
| 帧间条件独立 | 是 | 否(依赖标签历史) | 否(自回归) |
| 语言模型 | 需外挂,束搜索插值 | 内化在预测网络 | 内化在解码器 |
| 推理循环 | 一次前向 + 折叠 | 一次前向 + 格上束搜索 | 逐 token 自回归 |
| 流式能力 | 天然支持 | 支持,需分块编码 | 不天然,需切窗近似 |
| 单帧计算 | 最低 | 中(联合网络) | 最高(解码器) |
| 典型代表 | DeepSpeech、wav2vec 2.0 的 CTC 头 | Conformer-Transducer、NeMo | Whisper |
三种架构的延迟构成完全不同,值得分开算。
CTC 的账最简单:一次编码器前向加上一次逐帧 argmax。以 30 秒音频、1500 帧编码、256 维隐状态的小模型为例,编码器 FLOPs 在 量级,单卡几毫秒;前端在 CPU 上约几毫秒。端到端延迟基本由「攒够多少帧才能出字」决定——帧同步模型可以在每个 chunk 结束时立刻输出该 chunk 的字符,chunk 取 200 到 400 毫秒时,理论延迟就是 chunk 长度。
RNN-T 的账多两项:编码器的分块前向,以及格上的束搜索。分块编码的延迟等于前瞻帧数乘以帧移;束搜索在每个 chunk 上展开,束宽 8 到 16 时,每帧的联合网络计算是 ,对 5 万词表仍然可观,实际实现会对词表做子采样或只在候选集上算 softmax。RNN-T 的优势是它能在音频还在到达时就吐字,端到端延迟可以做到几百毫秒,适合实时字幕和电话场景。
Whisper 的账最重,但结构不同:编码器是固定成本,30 秒窗口一次前向约 到 FLOPs;解码器是可变成本,每 token 的计算量小,但需要把 1550M 参数的权重从显存里读一遍。以 fp16 计权重约 3.1 GB,HBM 带宽 2 TB/s 时,单 token 的下界就是 1.5 毫秒左右;一段 30 秒音频若输出 150 个 token,解码就要 200 毫秒以上,且随输出长度线性增长。这解释了为什么 Whisper 的批处理收益主要来自解码阶段:把多条音频的解码步拼成一个 batch,权重读取被摊薄,吞吐可以显著提高,而编码器部分靠批处理提升有限。
选型上没有普适答案,只有约束下的取舍:
- 算力受限、要求极低延迟、领域固定:CTC 小模型,配领域语言模型。命令词、唤醒词、嵌入式字幕都属于这一类。
- 实时交互、需要较强语言建模、又要流式:RNN-T 或 Conformer-Transducer。它的训练和解码都比 CTC 复杂,但一旦调好,是实时场景里最平衡的选择。
- 离线转写、多语言、需要翻译和时间戳、算力充足:Whisper。它的多任务前缀和内置时间戳让工程链路短很多,代价是固定 30 秒窗口和较重的解码成本。
还有一类混合做法值得一提:用 CTC 做粗对齐或流式首遍解码,再用注意力解码器做二遍重打分(two-pass rescoring)。这样首遍保证延迟,二遍用更强的模型修正错误,是工业级识别系统里常见的结构。
站在更长的技术脉络上看,语音识别与语音合成是同一枚硬币的两面:本文讲的是「波形到 token」,而文本到波形的方向可以延伸阅读语音合成的声学模型:Tacotron 2 与 FastSpeech 2与CosyVoice 2 架构拆解;声码器如何把频谱还原成波形,可以参考GAN 声码器拆解;如果关心音频在离散 token 空间里的另一种表示,RVQ 音频编解码器给出了与 log-mel 完全不同的前端。
小结
语音识别的三种基础架构,本质上是对同一个隐变量——帧与 token 之间的对齐——给出的三种处理方式。
CTC 用 blank 和折叠函数把对齐变成一个可以动态规划求和的边缘化问题,换来了最简单的推理:一次前向、逐帧 argmax、折叠输出。代价是帧间条件独立,语言建模必须外挂。
RNN-T 保留了帧同步的骨架,但在联合网络里加入标签历史,让「何时出字」依赖已经说出的内容。它把语言模型内化,代价是格上的束搜索和更大的训练计算量。Conformer 作为它的现代编码器,用卷积补局部、用注意力补全局,并通过块注意力和卷积状态缓存获得流式能力。
Whisper 放弃了帧同步,把识别写成以音频编码为条件的自回归生成,用多任务 token 前缀统一了语言识别、翻译和时间戳,用交叉注意力在每一步自由读取整段音频。它的结构最接近通用的序列到序列模型,工程链路最短,但固定窗口、逐 token 解码和较重的解码成本也随之而来。
对推理系统而言,这三条路线的差别最终落在三个数字上:编码器的一次性成本、解码循环的步数、以及每一步要搬运多少权重。CTC 只有第一项,RNN-T 多一个受束宽约束的搜索,Whisper 则把大头放在第三项。理解了这三笔账,选型就不再是「哪个模型效果最好」,而是「哪个成本结构匹配当前场景的延迟和吞吐约束」。
参考资料
- Connectionist Temporal Classification: Labelling Unsegmented Sequence Data with Recurrent Neural Networks
- Sequence Transduction with Recurrent Neural Networks
- Conformer: Convolution-augmented Transformer for Speech Recognition
- Robust Speech Recognition via Large-Scale Weak Supervision
- openai/whisper 官方仓库
- SYSTRAN/faster-whisper
- WhisperX: Time-Accurate Speech Transcription of Long-Form Audio
- Distil-Whisper: Robust Knowledge Distillation via Large-Scale Pseudo Labelling
- wav2vec 2.0: A Framework for Self-Supervised Learning of Speech Representations
- ESPnet: End-to-End Speech Processing Toolkit
- NVIDIA NeMo: Conformer-Transducer 实现
- Sequence Modeling with CTC(Distill 教程)
- librosa 音频特征文档
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



