


SGLang 前端语言完全拆解:sgl.gen、fork/join 与 RadixAttention 的编程模型
为什么推理框架里会有一门“语言”
如果把今天主流的大模型推理框架摊在桌面上看,会发现它们绝大多数是“单次补全”的形态:客户端发来一段 prompt,服务端用一个 OpenAI 兼容接口把 token 流回去。KV Cache、连续批处理、分页管理这些机制,都工作在这“一个请求”的内部。而 SGLang 在 2023 年底以论文《SGLang: Efficient Execution of Structured Language Model Programs》公开时(正式版发表于 NeurIPS 2024),提出的却是另一种组织方式:请求不再由客户端一句一句发,而是由一段写在 Python 里的程序描述出来,程序可以多次生成、可以分叉并行、可以在中间插入任意 Python 代码,框架再把整段程序“编译”成一条批处理友好的请求流。
这套设计后来拆成了两层:一边是本文要讲的前端语言(仓库里的 python/sglang/lang/),一边是生产运行时 SGLang Runtime(python/sglang/srt/,本站已在 SGLang 源码完全拆解(一):整体架构、进程拓扑与请求数据流 中画过地图)。今天线上部署的 SGLang 很少再直接用前端语言写业务,但理解它有两个非常现实的价值:
- 它是 SGLang 整个系统最初的问题定义。RadixAttention、压缩有限状态机、frontend-backend 分离,都是为了“执行一段程序”而设计的。读懂了程序怎么被表达,后面调度器为什么这样切分批次、缓存为什么按前缀树组织,才有解释。
- 很多框架今天都在重新发明它。vLLM 的
AsyncLLM链式调用、各家 Agent 框架里的并行采样、LLM-as-Judge 的多路打分,本质都是“在请求内部做控制流”。前端语言是这个问题最早、最完整的一次系统化回答。
本文只讲前端语言,不展开 srt/ 的调度细节。顺序是:先看它要表达什么(问题定义),再看表达式怎么被写成对象(IR),然后看这些对象怎么被解释执行(interpreter 与 stream executor),接着看 fork/join 如何配合 RadixAttention 成为真正的亮点,最后看它怎样落到 HTTP 后端,以及它在今天的位置。
问题定义:一个请求里藏着一条数据流
考虑一个很常见但 OpenAI 接口表达起来很别扭的负载:一篇作文按五个维度打分。论文里的例子是 branch-solve-merge:先用一次生成把作文拆成若干要点,再对每个要点并行生成一段分析,最后把全部分析合并做一次总结。
用 OpenAI 兼容接口写这段逻辑,客户端只能串行地发请求:
# 伪代码:纯 OpenAI 接口下的多路打分points = chat(model, prompt + "列出作文要点")analyses = []for p in points: analyses.append(chat(model, prompt + "分析要点:" + p))report = chat(model, prompt + "合并以下分析:" + "\n".join(analyses))这套写法有两个结构性问题。
第一,并行度被客户端吃掉。for 循环里每个 chat 都是同步阻塞的;就算客户端改成并发,服务端也只能看到 N 个彼此独立的请求,它们共享的 prompt 前缀在服务端未必能被复用——是否复用取决于服务端的缓存策略,而客户端并不知道该在哪一步把它们“对齐”。第二,KV 复用只能靠字符串巧合。所有分析请求都以同一段作文开头,理论上这段作文的 KV 可以只算一次;但在服务端看来,这些只是 N 条“前缀相似”的请求,能命中多少取决于批处理时机与缓存命中率,客户端控制不了。
更麻烦的是更复杂的场景:Agent 循环、ReAct、tool use、多轮对话中每轮依赖上一轮的输出、条件分支决定下一步走哪条路。这些结构在客户端拼接字符串时,往往被表示成一长串“如果……就再发一次请求”的命令式代码,框架完全看不到它们的整体结构。
SGLang 前端语言的出发点,就是把这些结构显式地写进程序,再交给运行时去执行:
import sglang as sgl
@sgl.functiondef multi_dimension_judge(s, essay): s += sgl.system("You are a helpful assistant.") s += sgl.user(essay) s += sgl.assistant(sgl.gen("score", regex=r"[-+]?[0-9]*\.?[0-9]+"))sgl.gen 不是一次调用,而是一个生成点的声明。程序执行时,解释器遇到它就向后端发一次请求、等结果、把结果写进变量;遇到普通字符串就直接拼进上下文;遇到 if s["action"] == "Search" 这种语句,就用上一轮的真实输出做 Python 控制流判断。于是“多轮、分支、并行、依赖”都变成了程序结构,而不再只是客户端循环。
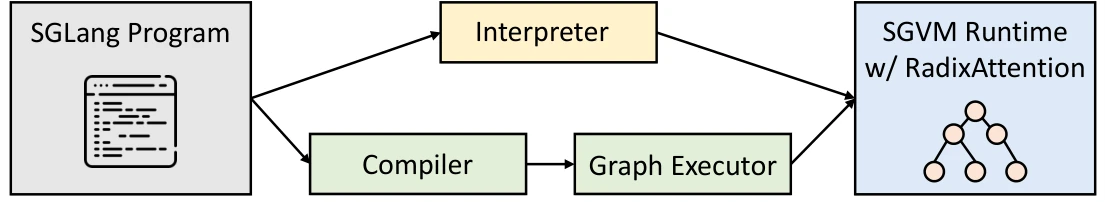
图源:SGLang 论文 Figure 3 系统总览。左侧是用户用 Python 写的 SGLang 程序,右侧是带 RadixAttention 与压缩状态机的运行时。论文的核心主张是:程序结构应当被前端显式表达,运行时才有机会做跨生成的复用。
要理解这门语言,关键不是 sgl 的 API 列表,而是三个问题:一个 sgl.gen 在内存里是什么?一段程序怎么被“跑”起来?fork 之后,多个分支为什么能在服务端共享同一段 KV?
表达式即对象:IR 是什么样子
python/sglang/lang/ir.py 定义了这门语言的全部“名词”。它很短,核心只有十来个类,但每一个都对应一种控制流能力。
最底层是 SglExpr,所有表达式节点的基类:
class SglExpr: node_ct = 0
def __init__(self): self.node_id = SglExpr.node_ct self.prev_node = None self.pid = None SglExpr.node_ct += 1node_id 是全局自增的节点编号,prev_node 指向前一个节点,pid 用来标记节点属于哪次程序(在 tracer 里被赋值)。这三个字段合在一起,让表达式可以组成一条链表、并在追踪时还原出执行顺序。
派生类分成几组。第一组是“内容”:
SglConstantText:普通字符串,直接拼进上下文;SglArgument:程序参数(函数实参),可以当字符串用,但明确禁止放进 f-string,因为它需要在追踪时被替换成占位;SglImage/SglVideo:多模态占位;SglGen:生成点,内部持有name和一个SglSamplingParams;SglSelect:在给定候选里选一个,专门用于有限集合的决策。
第二组是“结构”:
SglRoleBegin/SglRoleEnd:标记对话角色(system/user/assistant),配合 chat template 插入对应的前缀与后缀;SglExprList:顺序组合,s += a + b会产生它;SglVariable:把一个生成结果绑定到变量名,variables[name] = SglVariable(name, source=...);SglVarScopeBegin/SglVarScopeEnd:把一段已生成文本当作变量使用(tool use 中常用)。
第三组是“并行与控制”:
SglFork:在当前文本位置分出若干子执行器;SglGetForkItem:取某个分支;SglConcateAndAppend:join 时把分支的 KV 接到主执行器;SglCommitLazy:把 lazy 操作提交给后端;SglSeparateReasoning:把推理模型的“思考内容”和“最终答案”拆到两个变量里。
把生成参数单独抽成 SglSamplingParams 是刻意的设计。它是一个 dataclass,带有一堆 to_xxx_kwargs() 方法:
def to_srt_kwargs(self): return { "max_new_tokens": self.max_new_tokens, "min_new_tokens": self.min_new_tokens, "n": self.n, "stop": self.stop, "stop_token_ids": self.stop_token_ids, "stop_regex": self.stop_regex, "temperature": self.temperature, "top_p": self.top_p, "top_k": self.top_k, "min_p": self.min_p, "frequency_penalty": self.frequency_penalty, "presence_penalty": self.presence_penalty, "ignore_eos": self.ignore_eos, "regex": self.regex, "json_schema": self.json_schema, }注意 to_openai_kwargs() 里注释的那句“OpenAI does not support top_k, so we drop it here”。同一个 IR 对象,根据后端能力翻译成不同参数集:对 SGLang Runtime 可以传 min_p、top_k、regex、json_schema;对 OpenAI 兼容接口,只保留双方都支持的字段,正则约束直接告警丢弃。这就是“后端抽象”在参数层面的样子。
# ir.py 节选:SglFunction 的 run()def run(self, *args, max_new_tokens: int = 128, ..., stream: bool = False, backend=None, use_thread: bool = True, **kwargs): from sglang.lang.interpreter import run_program default_sampling_para = SglSamplingParams( max_new_tokens=max_new_tokens, n=n, stop=stop, ... ) backend = backend or global_config.default_backend return run_program(self, backend, args, kwargs, default_sampling_para, stream, use_thread=use_thread)@sgl.function 装饰器会把普通 Python 函数包成 SglFunction。它在初始化时用 inspect.getfullargspec 检查“第一个参数必须叫 s”,把其余参数作为 arg_names 记录起来;bind() 则把一部分参数预先绑定在对象上(比如把模型名或系统提示词固定住)。所以 SglFunction 本质上是“一段程序 + 一份默认采样参数 + 若干已绑定实参”的容器,真正执行在 run() 里交给解释器。
约束与类型:gen 的三种受限输出
SglSamplingParams 里有三个字段不参与普通采样,而是描述“输出必须长成什么样”:regex、json_schema,以及隐含的 dtype。sgl.gen 在构造 IR 时就把它们收进来:
def gen(name=None, max_tokens=None, ..., dtype=None, choices=None, choices_method=None, regex=None, json_schema=None): if choices: return SglSelect(name, choices, 0.0 if temperature is None else temperature, token_length_normalized if choices_method is None else choices_method) if regex is not None: try: re.compile(regex) except re.error as e: raise e return SglGen(name, ..., dtype, regex, json_schema)这段代码有三个值得注意的决定。
第一,choices 被提升为 SglSelect,而不是“带枚举约束的 gen”。两者在语义上不同:gen 返回自由文本,select 返回候选之一并附带各候选的打分元信息;把 select 单列成 IR 节点,后续才能针对候选集合做批量 logprob 比较。
第二,regex 在前端构造时就用 re.compile 做了一次语法校验。这只能拦住“正则本身写错”,并不能保证它能被后端的 FSM 编译器接受(例如某些后向引用、复杂环结构)。真正的编译发生在服务端的压缩 FSM 路径里;前端这一层只是尽早失败,避免把坏正则送进调度器。
第三,dtype 不是直接传给后端的字段,而是一个便捷入口。RuntimeEndpoint._handle_dtype_to_regex 在发请求前把它翻译成正则,并补上 stop:
if sampling_params.dtype in ["int", int]: dtype_regex = REGEX_INT # r"[-+]?[0-9]+[]*" sampling_params.stop.extend([" ", ""])elif sampling_params.dtype in ["float", float]: dtype_regex = REGEX_FLOAT # r"[-+]?[0-9]*\.?[0-9]+[]*" sampling_params.stop.extend([" ", ""])elif sampling_params.dtype in ["str", str]: dtype_regex = REGEX_STRelif sampling_params.dtype in ["bool", bool]: dtype_regex = REGEX_BOOLif dtype_regex and sampling_params.regex is not None: warnings.warn("Both dtype and regex are set. Only dtype will be used. ...")sampling_params.regex = dtype_regexint 与 float 额外加 " "、" " 作为 stop,是因为正则本身允许尾随空白;不加 stop,模型可能一直生成空格直到 max_tokens。dtype 与 regex 同时给出时,dtype 覆盖 regex 并告警——这避免了“两个约束同时生效”带来的 FSM 乘积爆炸,也说明 dtype 只是常见场景的语法糖。
json_schema 则原样透传,不在前端做任何解析:JSON Schema 到 FSM 的编译完全在运行时完成。这正是前端与运行时职责划分的缩影:前端负责把意图表达成参数,运行时负责把它变成可执行的约束。
解释执行:StreamExecutor 是带队列的后台线程
python/sglang/lang/interpreter.py 是前端语言的核心,接近 1100 行。它解决的问题是:Python 函数体里写的是普通语句,我们怎么在保持 Python 控制流的同时,把每个 sgl.gen 变成一次真实请求?
答案是把函数体当作解释器来跑,而把生成点放到一个后台线程上顺序执行。
入口是 run_program:
def run_program(program, backend, func_args, func_kwargs, default_sampling_para, stream, sync=False, use_thread=True): if hasattr(backend, "endpoint"): backend = backend.endpoint func_kwargs.update(program.bind_arguments) stream_executor = StreamExecutor( backend, func_kwargs, default_sampling_para, chat_template=None, stream=stream, num_api_spec_tokens=program.num_api_spec_tokens, use_thread=use_thread, ) state = ProgramState(stream_executor)
if stream: t = threading.Thread(target=run_internal, args=(state, program, func_args, func_kwargs, sync)) t.start() return state else: run_internal(state, program, func_args, func_kwargs, sync) return staterun_internal 只做一件事:把 state 作为 s 参数传给用户的函数,然后等函数体返回:
def run_internal(state, program, func_args, func_kwargs, sync): try: state.ret_value = program.func(state, *func_args, **func_kwargs) finally: state.stream_executor.end() if sync: state.stream_executor.sync()所以“程序”其实就是在 ProgramState 上直接运行的用户函数。ProgramState 提供的重载运算符,是整个机制的枢纽:
def __iadd__(self, other): if other is None: raise ValueError("Tried to append None to state.") self.stream_executor.submit(other) return self
def __getitem__(self, name): return self.get_var(name)s += sgl.gen("x") 并不会立即阻塞等待生成,而是把表达式 submit 到执行器。s["x"] 才会阻塞并取回变量值。这一“提交—取值”的分离非常关键:它让“一次生成”变成了“一个放到队列里的任务”,为后面的批处理与并行留下了空间。
StreamExecutor.submit 就是入队:
def submit(self, expr: SglExpr): self._init_var_event(expr) if self.use_thread: self.queue.put(expr) else: self._execute(expr)
def sync(self): if self.use_thread: self.queue.join()
def get_var(self, name): if name in self.variable_event: self.variable_event[name].wait() return self.variables[name]StreamExecutor 在构造时启动一个后台线程 _thread_worker_func,它就是经典的“从队列里取任务,执行,task_done”循环:
def _thread_worker_func(self): error = None while True: expr = self.queue.get() if expr is None: self.queue.task_done() break try: self._execute(expr) except Exception as e: warnings.warn(f"Error in stream_executor: {get_exception_traceback()}") error = e break self.queue.task_done() if self.stream_text_event: self.stream_text_event.set()这个设计解决了两个问题。第一,顺序保证:程序里的语句按顺序入队,后台线程按顺序执行,所以 s += a; s += b 中 b 一定在 a 之后被拼进去。第二,异步取值:get_var 等到对应表达式的 threading.Event 被置位才返回。程序可以先把多个 gen 提交到队列、然后在需要时再读值。这正是 fork 能并行工作的底层原因:多个执行器各自排队,各自等待,互不阻塞。
错误处理也值得注意。后台线程捕获异常后不会把异常直接抛回用户线程,而是设置 error_、把队列里剩余任务的 task_done 补上,并把所有 variable_event 置位,避免 get_var 永远等下去。用户线程随后在 state.error() 里拿到异常。这种“事件必须全部置位”的清理逻辑,是任何基于事件等待的异步执行器都必须处理的死角;否则一个生成失败就会把整个程序挂死。
_execute 是分发器,按类型把表达式交给不同的处理函数:
SglConstantText→_execute_fill,直接拼文本(并处理 API 投机执行时的缓存文本);SglGen→_execute_gen,调后端生成;SglSelect→_execute_select;SglRoleBegin/End→ 插入 chat template 的前缀/后缀并拼出消息结构;SglVariable→ 从源执行器取变量值;SglConcateAndAppend→ fork/join 的收尾;SglSeparateReasoning→ 调用推理内容解析器。
_execute_gen 里的非流式分支最值得逐行读:
def _execute_gen(self, expr: SglGen): sampling_params = self._resolve_sampling_params(expr.sampling_params) name = expr.name if not self.stream: if self.num_api_spec_tokens is None: comp, meta_info = self.backend.generate(self, sampling_params=sampling_params) if isinstance(comp, list): self.text_ += comp[0] else: self.text_ += comp self.variables[name] = comp self.meta_info[name] = meta_info self.variable_event[name].set()有两个细节值得单独说。n > 1 时后端返回的是一个列表,_execute_gen 只把第一个候选拼进 text_,变量里保存的则是完整列表。这是语言设计里的一个有意取舍:同一个生成点最多只有一条能进入上下文,多候选的用途是“读取后由 Python 代码挑选”,而不是“都拼进去”。
这里没有“参数合并”之外的逻辑,参数合并本身发生在 _resolve_sampling_params 里。它的逻辑是:以 run() 传入的默认参数为底,把 sgl.gen() 里显式给出的值覆盖上去;再把 chat template 的 stop_str 追加到 stop 列表:
clone = copy.deepcopy(self.default_sampling_para)for item in ["max_new_tokens", "temperature", "top_p", "top_k", "min_p", ...]: value = getattr(sampling_params, item, None) if value is not None: setattr(clone, item, value)
if self.chat_template.stop_str: if clone.stop == (): clone.stop = [] elif isinstance(clone.stop, str): clone.stop = [clone.stop] clone.stop += self.chat_template.stop_str这套“默认值 + 覆盖值”的约定意味着 sgl.gen() 可以不写任何参数,也可以只覆盖它关心的那几个。写程序时,全局采样策略放在 run() 上,局部差异放在 gen() 上,读起来语义清楚。
流式分支则把后端的生成器逐块写入 variables[name],每次更新都会 set 对应的 stream_var_event,供 text_iter 消费。所以流式输出不是另一种机制,而是“变量从一次性写入变成多次写入”。
流式输出:事件驱动的增量读取
当 run(stream=True) 时,StreamExecutor 会额外创建两组事件:stream_text_event 与 stream_var_event。_execute_gen 的流式分支对后端生成器逐块消费:
generator = self.backend.generate_stream(self, sampling_params=sampling_params)self.variables[name] = ""self.stream_var_event[name].set()for comp, meta_info in generator: self.text_ += comp self.variables[name] += comp self.meta_info[name] = meta_info self.stream_var_event[name].set() self.stream_text_event.set()self.variable_event[name].set()self.stream_var_event[name].set()ProgramState.text_iter 则从事件上“等增量”:
def text_iter(self, var_name=None): if self.stream_executor.stream: prev = 0 event = self.stream_executor.stream_text_event while True: event.wait() event.clear() out = str(self.stream_executor.text_[prev:]) prev += len(out) if out: yield out if self.stream_executor.is_finished: break这里有个容易忽略的细节:prev 记录的是已产出的字符偏移,而不是 token 数。前端语言维护的 text_ 是解码后的字符串,所以流式切分天然按字符走;token 边界由后端负责。text_async_iter 是同一逻辑的 asyncio 版本,用 loop.run_in_executor(None, event.wait) 把阻塞等待丢到线程池,并对 output_token_logprobs 等增量元信息做跨块合并(_merge_stream_meta_info)。
也正因为流式模式依赖“字符增量 + 事件”,它和 API 投机执行互斥:_execute_gen 的流式分支里有 assert self.num_api_spec_tokens is None。投机执行要把整段草稿拿回来再切,而流式要求立刻吐字,两者在语义上无法同时成立。
上下文不是字符串,而是文本加角色
一个容易被误读的点:self.text_ 只是“完整文本”,并不足以直接发请求。请求需要区分 system/user/assistant 角色,需要 chat template 的前缀/后缀,还可能需要图像占位。
_execute_role_begin 和 _execute_role_end 做了这件事:
def _execute_role_begin(self, expr: SglRoleBegin): assert self.cur_role is None, "Nested roles are not allowed." if len(self.messages_) == 0 and expr.role != "system": default_system = self.chat_template.default_system_prompt if default_system: self._execute_role_begin(SglRoleBegin("system")) self._execute_fill(default_system) self._execute_role_end(SglRoleEnd("system")) self.cur_role = expr.role prefix, _ = self.chat_template.get_prefix_and_suffix(expr.role, self.messages_) self._execute_fill(prefix, prefix=True) self.cur_role_begin_pos = len(self.text_)要点有三个:
- 不能嵌套角色。
assert self.cur_role is None是一条明确的语法约束,防止system(assistant(...))这种无意义结构。 - 自动插入默认 system。如果第一个角色不是 system,且模板有默认系统提示,就自动补一个。
- 记录角色起始位置。
cur_role_begin_pos是角色正文的起点,用于结束时截出这条消息的纯文本。
_execute_role_end 在结束时剥出这段文本、补上后缀、组装成 OpenAI 格式的消息项。有图像时组装成多模态消息:
new_text = self.text_[self.cur_role_begin_pos:].lstrip()_, suffix = self.chat_template.get_prefix_and_suffix(expr.role, self.messages_)self._execute_fill(suffix)if self.cur_images: last_msg = {"role": expr.role, "content": [{"type": "text", "text": new_text}]} ... self.messages_.append(last_msg) self.cur_images = []else: self.messages_.append({"role": expr.role, "content": new_text})所以前端语言维护了两份上下文:text_(连续字符串,用于 completion 接口和拼接)与 messages_(结构化对话,用于 chat 接口和多模态)。后端据此决定是发 prompt 还是发 messages。
ChatTemplate 本身也很朴素:
@dataclassclass ChatTemplate: name: str default_system_prompt: str role_prefix_and_suffix: Dict[str, Tuple[str, str]] stop_str: List[str] = () image_token: str = "<image>" audio_token: str = "<audio>" style: ChatTemplateStyle = ChatTemplateStyle.PLAIN
def get_prefix_and_suffix(self, role, hist_messages): prefix, suffix = self.role_prefix_and_suffix.get(role, ("", "")) if self.style == ChatTemplateStyle.LLAMA2: ... return prefix, suffixstyle 只区分 PLAIN 与 LLAMA2。LLAMA2 风格需要处理“system 消息要合并进第一条 user”这一特例,get_prefix_and_suffix 里两个 if 就是在处理它。模板在 chat_template.py 里有几十种注册(default、claude、chatml、vicuna、llama3、deepseek 等),并通过 get_chat_template_by_model_path 按模型路径匹配。
fork/join:前端语言与 RadixAttention 的接口
到目前为止,前端语言还只是一个“方便的请求编排器”。真正让它和 SGLang 运行时绑在一起的,是 fork。
@sgl.functiondef tip_suggestion(s): s += sgl.assistant("Here are two tips for staying healthy: 1. Balanced Diet. 2. Regular Exercise.\n\n") forks = s.fork(2) for i, f in enumerate(forks): f += sgl.assistant(f"Now, expand tip {i+1} into a paragraph:\n" + sgl.gen("detailed_tip", max_tokens=256, stop="\n\n")) s += sgl.assistant("Tip 1:" + forks[0]["detailed_tip"] + "\n") s += sgl.assistant("Tip 2:" + forks[1]["detailed_tip"] + "\n") s += sgl.assistant("To summarize the above two tips, I can say:\n" + sgl.gen("summary", max_tokens=512))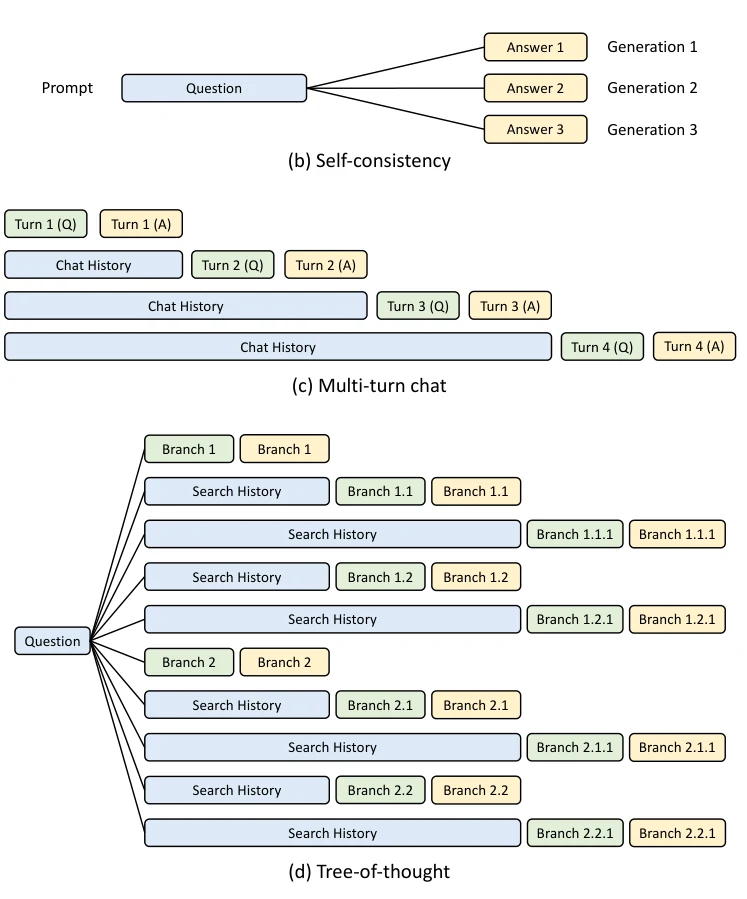
图源:SGLang 论文 Figure 2。蓝色表示可共享的 prompt 前缀,绿色表示不可共享的后缀,黄色表示不可共享的模型输出。fork 的价值就在于把“分叉点之前的蓝色部分”变成多条请求共同命中同一棵 Radix 树。
前端层面,fork(2) 做了什么?
def fork(self, size: int = 1, position_ids_offset=None): if size > 1 and str(self.text_): self.submit(SglCommitLazy()) self.sync() exes = [StreamExecutor(self.backend, self.arguments, self.default_sampling_para, self.chat_template, self.stream) for _ in range(size)] for i in range(size): exes[i].variables = dict(self.variables) exes[i].text_ = str(self.text_) exes[i].messages_ = list(self.messages_) exes[i].cur_role = self.cur_role exes[i].cur_role_begin_pos = self.cur_role_begin_pos exes[i].fork_start_text_pos = len(self.text_) exes[i].images_ = list(self.images_) return exes四步:
- 提交 lazy 操作:如果当前文本非空,先把现有上下文
commit给后端。对 API 后端,这是“把已拼好的前缀真正发一次,让服务端缓存起来”的时机;对 RuntimeEndpoint,这是把前缀 token 化并让调度器记账。 - 同步:等待队列里已有的表达式执行完,保证分叉点处在稳定的文本状态。
- 复制执行器:每个分支一个新的
StreamExecutor,各自带独立的后台线程和队列。变量、文本、消息、当前角色全部深拷贝一份,sid(执行器 ID)却各不相同。 - 记录分叉起点:
fork_start_text_pos让每个分支知道自己只对分叉之后的文本“负责”。
之后的写法非常自然:每个分支 f += ... 各自提交,主执行器可以继续 s += ... 或者等分支结果。因为每个分支都有自己的线程和队列,它们对后端的请求是并发的;而主执行器读分支变量时,会通过 SglVariable 从源执行器的 variables 里取值:
def _execute_variable(self, expr: SglVariable): src_executor = expr.source_stream_executor value = src_executor.get_var(expr.name) self._execute_fill(value)(当前快照里 SglVariable 类只保存 name 与 source,source_stream_executor 是解释器在执行上下文里附加的引用,不属于 IR 节点本身。)
ProgramStateGroup 负责组织多个分支:
class ProgramStateGroup: def __init__(self, states, src_state=None): self.states = states self.src_state = src_state
def join(self, mode: str = "gather_variable"): if mode == "gather_variable": src_vars = self.src_state.stream_executor.variables src_var_set = set(src_vars.keys()) for child_state in self.states: child_state.stream_executor.sync() child_vars = child_state.stream_executor.variables new_vars = set(child_vars.keys()) - src_var_set for k in new_vars: if k in src_vars: src_vars[k].append(child_vars[k]) else: src_vars[k] = [child_vars[k]] elif mode == "concate_and_append": self.src_state += SglConcateAndAppend(self.states) self.src_state.stream_executor.sync() for s in self.states: s.stream_executor.end()join() 的默认模式 gather_variable 只做变量收集:每个分支先 sync,再把“主执行器此前没有的变量名”收上来;不同分支产生同名变量时,主执行器里会聚成一个列表。主执行器已有的同名变量不会被覆盖,这是为了避免分支结果悄悄改写主程序状态。这适合“分叉收集答案”这一类:并行生成多个草稿,然后主程序拿它们做比较。
但真正体现 SGLang 设计思想的是第二种模式 concate_and_append:它把各分支的 KV Cache 拼接进主执行器。这就不仅仅是“多路生成”,而是“多路前缀编码后合并上下文”。
def _execute_concatenate_and_append_kv_cache(self, expr: SglConcateAndAppend): self_len = len(self.text_) for s in expr.states: s.stream_executor.submit(SglCommitLazy()) for s in expr.states: s.stream_executor.sync() assert s.stream_executor.fork_start_text_pos == self_len self.text_ += s.stream_executor.text_[s.stream_executor.fork_start_text_pos:] src_rids = [s.stream_executor.sid for s in expr.states] self.backend.concatenate_and_append(src_rids, self.sid)这段代码有三个关键约束:
- 每个分支先
commit,把自身尚未提交的文本确认给服务端; assert fork_start_text_pos == self_len保证所有分支都是从同一个位置分出去的,且主执行器在分叉之后没有再追加过文本——否则拼接后会语义错位;- 拼接文本后调用
backend.concatenate_and_append(src_rids, dst_rid)让服务端真正把 KV 拼接。
用一段简短的例子能看到它的威力:
@sgl.functiondef parallel_encoding(s, question, contexts): s += sgl.user("Please memorize these statements.\n") forks = s.fork(len(contexts)) forks += lambda i: f"Statement {i}: " + contexts[i] + "\n" forks.join(mode="concate_and_append") s += sgl.assistant("Question: " + question + "\nAnswer:" + sgl.gen("answer"))三段互不相关的事实被分别编码到不同分支里,最后“拼接”成一段完整上下文再回答。在普通客户端写法下,这等价于把三句话拼成一个 prompt;但在 SGLang 里,这三段可以并行编码、KV 可以并行计算后拼接,并且由于分叉点的公共前缀是同一份,RadixAttention 只需要为它计算一次。这正是论文里“共享前缀 + 独立后缀 + 拼接回填”的编程模型。
一次 parallel_encoding 的时序
把上面的机制串起来,parallel_encoding 从入口到回答的时序大致如下:
主线程 StreamExecutor(主) StreamExecutor(分支)s += user(...) -> submit(RoleBegin/Text/RoleEnd) -> 队列执行,拼 role 前缀s.fork(2) -> submit(CommitLazy) -> 发 max_new_tokens=0 请求 -> sync() -> 等待队列清空 -> 复制 text_/messages_/variables -> 新建 2 个执行器,各自启动后台线程forks += lambda i -> (主线程直接返回) 分支 i 收到 Text + Gen,入队forks.join(concate) -> submit(SglConcateAndAppend) 分支各自 submit(CommitLazy) -> sync() -> 提交前缀并等待 -> 逐个 sync 分支,断言 fork_start==len -> 把分支新文本接进主 text_ -> backend.concatenate_and_append(rids, sid)s += assistant(question)-> submit(RoleBegin/Text/Gen) -> 主队列继续执行s["answer"] -> 等待 variable_event这里最容易被忽略的是主线程并没有“等待两个分支跑完再继续”。forks += ... 做完后,主线程已经可以去提交后续语句;真正阻塞发生在 s["answer"] 或 join() 的 sync()。如果程序写成“先 fork、主线程自己再做几次 gen、最后才读分支”,主线程与分支会同时对后端发请求,服务端的连续批处理才有机会把它们放进同一个批次。反之,如果程序每 fork 一次就立刻读一个分支结果,那么并发度就被 Python 控制流限制住了。
追踪:fork/join 之前,先在“假后端”上跑一次
上面所有解释执行都依赖真实后端。但有一件事需要在不产生任何 token 的情况下完成:找出程序最长的公共前缀,把它预先送进 RadixAttention 缓存。这在批量运行时收益非常可观——同一批程序的指令前缀可能长达几千 token,却只在每个程序里各算一次。
这就是 python/sglang/lang/tracer.py 的职责。核心是 extract_prefix_by_tracing:
def extract_prefix_by_tracing(program, backend): dummy_arguments = {name: SglArgument(name, None) for name in program.arg_names} arguments = dummy_arguments arguments.update(program.bind_arguments)
tracer = TracerProgramState(backend, arguments, only_trace_prefix=True) try: with TracingScope(tracer): tracer.ret_value = program.func(tracer, **arguments) except (StopTracing, TypeError, AttributeError): pass
prefix = "" for expr in tracer.flatten_nodes(): if isinstance(expr, SglConstantText): prefix += expr.value else: break return prefix它的思路是:
- 用
SglArgument(name, None)把每个参数替换成占位对象; - 用
TracerProgramState代替StreamExecutor来运行程序; - 追踪器不调用后端,遇到
gen就记一个SglVariable节点然后继续; only_trace_prefix=True时,一旦遇到无法静态确定的结构(fork、未知变量等)就抛StopTracing,停止追踪;- 最后把所有连续的
SglConstantText拼起来,遇到第一个非文本节点就停。
结果就是“程序开头那一段纯文本前缀”。run_program_batch 在批量运行时调用 cache_program:
def cache_program(program, backend): from sglang.lang.tracer import extract_prefix_by_tracing prefix = extract_prefix_by_tracing(program, backend) if prefix and len(prefix) > 64: backend.cache_prefix(prefix)阈值 64 个字是经验值:太短的前缀大概率在缓存里已存在,送一次没意义。批量入口里,若 global_config.enable_precache_with_tracing 开启且批大小 > 1,就会在开跑之前做这件事:
if global_config.enable_precache_with_tracing and len(batch_arguments) > 1: cache_program(program, backend)追踪器也支持完整追踪(trace_program)用于调试与可视化。它把所有节点按 prev_node 串成一条链表,flatten_nodes() 依次展开 SglExprList 并返回节点列表,SglExpr.print_graph_dfs() 则把图打印成类似 LLVM IR 的文本:
%0 = Constant('You are a helpful assistant.')%1 = Gen('score')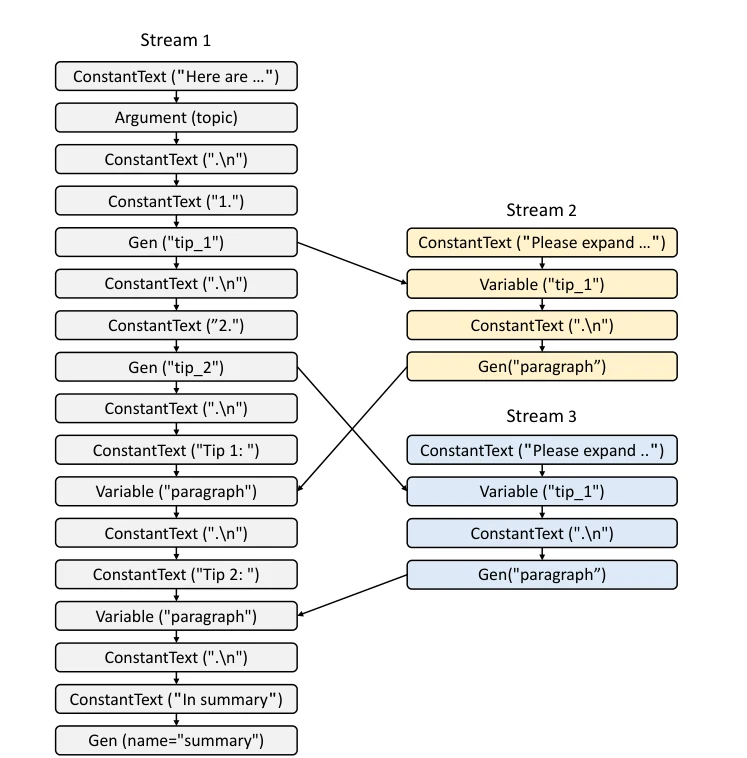
图源:SGLang 论文 Figure 5。论文用计算图表示一段程序:三条 stream 对应三次函数调用,stream 之间有数据依赖,也有共享前缀。追踪器的 prev_node 链就是这张图的前端内存表示。
值得注意的是追踪器的 TracingScope 机制。SglFunction 的 __call__ 会检查当前是否处于追踪作用域:
def __call__(self, *args, **kwargs): from sglang.lang.tracer import TracingScope tracing_scope = TracingScope.get_current_scope() if tracing_scope is None: return self.run(*args, **kwargs) else: kwargs["backend"] = tracing_scope.tracer_state.backend return self.trace(*args, **kwargs)也就是说,当用户程序内部调用另一个 @sgl.function 函数时,如果外层正在追踪,内层也会被追踪而不是真实执行。这让“多个函数拼成一个大程序”成为可能,也是论文里 branch-solve-merge 那种嵌套结构能被整体分析的原因。
fork 的服务端一侧:为什么需要 concate_and_append 接口
前端在走 KV 拼接之前还有一道开关。_execute 在处理 SglConcateAndAppend 时先检查全局配置 enable_parallel_encoding 与后端能力标记 support_concate_and_append:
elif isinstance(other, SglConcateAndAppend): if (global_config.enable_parallel_encoding and self.backend.support_concate_and_append): self._execute_concatenate_and_append_kv_cache(other) else: self._execute_concatenate_and_append_text(other)任一条件不满足,就退化为“只拼文本”(_execute_concatenate_and_append_text),语义上与把分支文本拼成一个新 prompt 完全等价。这层降级让同一段程序既能跑在本地 SGLang Server 上,也能跑在任何 OpenAI 兼容 API 上,只是后者享受不到并行编码的收益。
打开开关后,前端调用 backend.concatenate_and_append(src_rids, dst_rid),RuntimeEndpoint 把它翻成一个 HTTP 请求:
def concatenate_and_append(self, src_rids: List[str], dst_rid: str): res = http_request(self.base_url + "/concate_and_append_request", json={"src_rids": src_rids, "dst_rid": dst_rid}, ...)BaseBackend 里对应的方法只是一个默认 raise NotImplementedError,而 OpenAI 后端也没有覆盖它——support_concate_and_append 默认是 False,只有 RuntimeEndpoint 构造时把它设成 True。这就解释了一个常被忽略的边界:
- 如果后端是本地 SGLang Runtime,fork +
concate_and_append可以真的把多分支 KV 拼接成一条序列; - 如果后端是OpenAI 兼容 API,
join("concate_and_append")无法在服务端实现,只能退化为变量收集/文本拼接。
前端把这种差异表达为一个能力标记而不是“后端类型判断”,所以任何新后端只要实现了拼接接口、把标记置为 True,就能自动获得 KV 拼接路径,不需要前端修改。
这个设计边界也很自然:KV 拼接必须发生在 KV 的所有者手里,也就是同一个调度器与 KV 池。跨 API 根本拿不到 KV,更不可能拼。
commit_lazy_operations 同理。RuntimeEndpoint 的做法是发一个 max_new_tokens: 0 的 /generate 请求:
def commit_lazy_operations(self, s: StreamExecutor): data = {"text": s.text_, "sampling_params": {"max_new_tokens": 0}} self._add_images(s, data) res = http_request(self.base_url + "/generate", json=data, ...)也就是说,commit 不是“提交一个待执行的生成”,而是“让服务端把这段前缀编码并缓存起来,不要生成任何 token”。cache_prefix(prefix_str) 也是同一手法。这和 RadixAttention 的前缀树天然契合:只要前缀存在树里,后续任何以它为前缀的请求都能命中。
这里需要注意一个源码阅读时容易困惑的点:在较新的 main 分支快照中,srt/entrypoints 里并没有直接可见的 /concate_and_append_request 路由实现,RuntimeEndpoint 仍然按旧协议发送这个请求。这说明前端语言的 fork/join KV 拼接路径与生产运行时之间的契约,主要保留在历史设计与协议层,而不是当前主干的活跃代码里。阅读时以“协议约定 + 后端能力标记”为准:前端看到的只是一个能力开关,服务端是否在今天的所有部署中完整保留了这条路由,需要对照当前版本的 srt/ 核实。
采样参数、约束、选择与推理内容:IR 的几处细节
SglSelect 是前端语言中一个很特别的结构:它不生成自由文本,而是在给定候选集合里做一次“受限选择”。它的实现放在 choices.py 里,有三种策略:
TokenLengthNormalized(默认):计算每个候选被模型生成时的平均 token logprob,再按 token 长度归一化;选择平均 logprob 最高的候选。GreedyTokenSelection:逐 token 比较各候选的 logprob,取第一个出现唯一最大值的候选。UnconditionalLikelihoodNormalized:用“无条件 logprob”(没有上下文时的概率)对条件 logprob 做归一化,减掉候选本身更常见的偏差。
以 TokenLengthNormalized 为例:
class TokenLengthNormalized(ChoicesSamplingMethod): def __call__(self, *, choices, normalized_prompt_logprobs, ...): best_choice = choices[np.argmax(normalized_prompt_logprobs)] meta_info = {...} return ChoicesDecision(decision=best_choice, meta_info=meta_info)为什么按 token 长度归一化?因为候选的字符长度差异极大,而 logprob 是每个 token 的概率取对数后求和,越长的候选自然 logprob 越低。不归一化,系统就偏向短词。归一化后,比较的是“平均每个 token 有多可能”。
RuntimeEndpoint.select 里还有一个硬性约束:temperature 必须接近 0(代码里是 assert temperature <= 1e-5)。SglSelect 是“给出候选、要求确定性地选一个”的语义,与自由生成不同;候选集合必须按 token 精确对齐才能比较 logprob,采样温度一旦非零,候选之间的比较就失去了“模型偏好多强”的直观意义。把温度限定到 0,问题就从“带随机性的生成”收敛成“单次前向的输入概率读取”。
RuntimeEndpoint.select 的实现值得一看,因为它揭示了“选择”在服务端要做几次前向:
def select(self, s, choices, temperature, choices_method): assert temperature <= 1e-5 # Cache common prefix data = {"text": s.text_, "sampling_params": {"max_new_tokens": 0}} obj = self._generate_http_request(s, data) prompt_len = obj["meta_info"]["prompt_tokens"] logprob_start_len = max(prompt_len - 2, 0) # For token healing
data = {"text": [s.text_ + c for c in choices], "sampling_params": {"max_new_tokens": 0, "temperature": 0}, "return_logprob": True, "return_text_in_logprobs": True, "logprob_start_len": logprob_start_len} obj = self._generate_http_request(s, data) ...三次交互:先用 max_new_tokens=0 把公共前缀提交进缓存;然后一次性把“前缀 + 每个候选”作为批量请求,只取输入 logprob;再按需(requires_unconditional_logprobs 为真时)发一批只含候选本身的请求,拿到无条件 logprob。logprob_start_len = prompt_len - 2 是为了覆盖“token healing”——前缀末尾与候选开头在分词时可能连成一个新 token,必须从末尾两个 token 开始重新计算。
这一实现也暴露了前端语言设计里一个很重要的问题:select 的三种策略都建立在输入侧 logprob 上,而不是输出侧采样。RuntimeEndpoint.select 用 max_new_tokens: 0 加 return_logprob 一次性读取整批候选的 token 级概率,前端不需要生成任何一个 token 就能决策。代价是它依赖后端能在同一个请求里返回输入 logprob——这正是 OpenAI 兼容接口难以稳定提供的部分。
OpenAI.select 把这种差异写得很直白:对 chat 模型直接 raise NotImplementedError,建议改用 instruct 模型;对 instruct 模型,它完全绕开了 choices_method,改用逐 token 的 logit bias 强制候选走同一条路径:
# Build logit biaslogit_bias = {}for i in range(n_choices): if valid[i]: logit_bias[token_ids[i][step]] = 100ret = self.client.completions.create(model=self.model_name, prompt=prompt_tokens, logit_bias=logit_bias, max_tokens=1, temperature=temperature)每一步只让所有“仍然有效”的候选下一 token 都有资格被选中,然后比较实际选中的 token 是哪一个,给命中的候选加一分,未命中的淘汰。第几步之后只剩一个候选就停。这是一个巧妙的“用采样模拟 argmax”的构造,但它与 TokenLengthNormalized、GreedyTokenSelection 的语义其实并不等价——后者比较的是概率大小,前者比较的是“模型是否愿意生成这个 token”。这也是源码里 choices_method is not used by the OpenAI backend 注释的来源。
于是前端语言把选择行为限定在一个能在本地 Runtime 上精确计算的语义上,同时允许 API 后端以更粗糙但兼容的方式上线。使用者如果对选择结果的精确性有要求,就应当用本地 Runtime 而不是远程 API。
SglSeparateReasoning 处理的是推理模型特有的一类输出:思考内容(reasoning)与最终答案。用户在 sgl.gen 上包一层:
s += sgl.assistant(sgl.separate_reasoning(sgl.gen("answer"), model_type="deepseek-r1"))执行时 _execute_separate_reasoning 会调用运行时解析器 ReasoningParser,按模型类型把 answer 中解析出 reasoning_content,写入 answer_reasoning_content,并把原变量只保留答案部分。变量命名通过 process_name_for_reasoning(name) = f"{name}_reasoning_content" 固定,便于后续引用。这是一个有趣的案例:同一个表达式节点,因模型而异的表现,被收敛到 IR 的一层来统一处理,而不是让用户手动拆分字符串。
拆成两个变量之后,s["answer"] 只拿到最终答案,而 s["answer_reasoning_content"] 拿到思考链。对下游需要把推理过程展示给用户、或只把答案喂进下一步生成的应用,这就省掉了一整套字符串解析代码。
var_scope 则用于 tool use 一类结构。测试里有一个很典型的写法:
@sgl.functiondef tool_use(s, lhs, rhs): s += "Answer: The answer is calculate(" + sgl.gen("expression", stop=")") + ") = " with s.var_scope("answer"): s += calculate(s["expression"])SglVarScopeBegin 只做一件事:把当前 len(self.text_) 记进 variables[name]。SglVarScopeEnd 再取这段区间:
def _execute_var_scope_begin(self, expr: SglVarScopeBegin): self.variables[expr.name] = int(len(self.text_))
def _execute_var_scope_end(self, expr: SglVarScopeEnd): self.variables[expr.name] = self.text_[self.variables[expr.name]:] self.variable_event[expr.name].set()所以 with 块里发生的所有事情——外部工具计算、字符串拼接、甚至另一次 gen——都会被捕获为变量 answer。这让“工具返回值进入上下文”不需要额外的表达式类型:它只是一段文本,作用域只是一个起止标记。反过来说,var_scope 也是同步点:块内一旦读取 s["expression"],就必须等生成完成,Python 控制流才能继续。这是前端语言“看起来是普通 Python,实际会在读变量处阻塞”的最直观例子。
批量运行:把 N 个程序交给服务端的正确方式
前端语言提供了 run_batch,它在服务端侧是把 N 个程序变成 N 个并发请求:
def run_program_batch(program, backend, batch_arguments, default_sampling_para, num_threads, progress_bar, generator_style=False): if global_config.enable_precache_with_tracing and len(batch_arguments) > 1: cache_program(program, backend) if num_threads == "auto": num_threads = max(96, multiprocessing.cpu_count() * 16) num_threads = min(num_threads, len(batch_arguments)) ... with ThreadPoolExecutor(num_threads) as executor: futures = [] for arguments in batch_arguments: futures.append(executor.submit(run_program, program, backend, (), arguments, default_sampling_para, False, True)) rets = [f.result() for f in futures] rets[-1].sync() return rets有意思的是 num_threads:默认是 max(96, cpu_count*16)。这不是因为生成本身能在本地并行,而是因为每次 run() 都在等一个 HTTP 返回,等待期间线程大部分时间在阻塞。真正负责并发的其实是服务端:SGLang 的调度器会把 N 个 program 的请求视作独立请求,做连续批处理,同时 RadixAttention 让共享前缀只需要计算一次。
generator_style=True 是较新版本加入的形态:按块提交,逐块产出结果,避免一次性把几万个任务塞进线程池导致阻塞:
chunk_size = 200for chunk_start in range(0, len(batch_arguments), chunk_size): chunk_futures = [] for i in range(chunk_start, chunk_end): future = executor.submit(run_program, ...) chunk_futures.append(future) for future in chunk_futures: yield future.result()这是一个工程化的细节:ThreadPoolExecutor 的提交队列是有界的,一味提交会让主线程卡在 submit() 里,反而拿不到已完成的产出。按块提交解决了这个问题。
从程序到 API:后端抽象与多后端支持
python/sglang/lang/backend/ 里有一组后端实现,每个都继承 BaseBackend:
runtime_endpoint.py:本地/远程 SGLang Server,直接走/generate;openai.py:OpenAI 及兼容服务,走 Chat Completions;litellm.py:LiteLLM 统一的 100+ 提供商;anthropic.py、vertexai.py、crusoe.py:各家云与 API。
BaseBackend 默认所有可选能力关闭:
class BaseBackend: def __init__(self): self.support_concate_and_append = False self.chat_template = get_chat_template("default")
def cache_prefix(self, prefix_str: str): pass def commit_lazy_operations(self, s): pass def fork_program(self, src, dst, position_ids_offset=None): pass def concatenate_and_append(self, src_rids, dst_rid): raise NotImplementedError()前端只调用这些“公共能力”,具体实现决定能用多少:
RuntimeEndpoint打开support_concate_and_append,实现cache_prefix、commit_lazy_operations、select;OpenAI没有 KV 接口,cache_prefix、concate_and_append都是继承的空实现或不支持;OpenAI提供了“API 投机执行”(num_api_spec_tokens),这部分是前端语言的一个有趣变体。
API 投机执行的前提很直接:远程 API 每发一次请求都有网络延迟与计费。如果程序里连续多个 gen 会立即被消费(例如 s += sgl.gen("a"); s += sgl.gen("b") 的常见写法),那么可以把连续若干个生成合并到一次请求里,让模型先多生成一段,再在客户端按 stop 标记切分。_spec_gen 就是这么做的:
def _spec_gen(self, sampling_params): stop = sampling_params.stop max_new_tokens = sampling_params.max_new_tokens meta_info = {}
def regen(): sampling_params.max_new_tokens = max(sampling_params.max_new_tokens, self.num_api_spec_tokens) sampling_params.stop = None self.speculated_text, meta_info = self.backend.generate( self, sampling_params=sampling_params)
def find_stop(): ... if stop is None: if len(self.speculated_text) < max_new_tokens: regen() comp = self.speculated_text[:max_new_tokens] self.speculated_text = self.speculated_text[max_new_tokens:] elif isinstance(stop, (str, list, tuple)): if self.speculated_text == "": regen() stop_pos = find_stop() ...这段逻辑本质上是“提前打草稿”:请求时强制生成更长一段、不设 stop,然后在本地按 stop 位置切分,剩下的部分留给后续 gen 消费。一个本地计数器 speculated_text 缓存了未消费的投机文本;_execute_fill 遇到 speculated_text.startswith(value) 就扣掉这段前缀,否则整个清空。如果程序结构与预期一致(例如常见 “先想后答” 模板),一次 API 调用能满足多次 gen,延迟和费用都降下来;如果结构变了(find_stop 失败或后续填入的文本不匹配),则退化为真实请求。
这也是前端语言比普通客户端库更强的地方:因为程序结构是显式的,投机执行可以在中间代码里安全地判断“下一段文本是否与草稿匹配”。
设计边界与常见误读
前端语言不长,但它和运行时之间的边界很容易被误读。以下几个点值得在阅读源码时反复确认。
第一,fork 不切分 GPU 批次。 它只在客户端复制执行器、让多个请求并发发出;这些请求能不能进同一个 GPU batch、能不能共享 KV,完全由服务端的调度器与 RadixAttention 决定。把 fork 理解成“在 GPU 上并行”是错的,它只是“在客户端制造并发请求”。真正的批内并行属于 SGLang 源码完全拆解(三):Scheduler 的范围。
第二,join("concate_and_append") 有严格的位置约束。 _execute_concatenate_and_append_kv_cache 里的 assert exe.fork_start_text_pos == self_len 要求主执行器在分叉之后不能再追加文本,所有分支也必须从同一位置分出。如果主程序在 fork 后先写了几句再 join,断言会直接失败。这不是实现偷懒,而是 KV 拼接的语义要求:拼接的是“同一前缀之后的多个后缀”,前缀必须严格一致。
第三,gather_variable 不合并 KV。 默认 join 只把变量收成列表,服务端各分支的 KV 仍然各自独立,随后可能被 RadixCache 按 LRU 驱逐。想保留分支的 KV,必须走 concate_and_append 并确保后端支持;否则“分叉收集”只节省了并行时间,不节省显存。
第四,追踪只认“顶层连续常量文本”。 extract_prefix_by_tracing 遇到 SglConstantText 就累加,遇到第一个非文本节点就停;遇到 fork、变量、函数调用都会 StopTracing。因此 sgl.user(f"...{arg}...") 这种 f-string 在追踪时无法确定内容,前缀只能截到 f-string 之前。SglArgument.__format__ 直接抛 TypeError,就是为了在追踪阶段显式阻止这种写法,而不是悄悄算错前缀。
第五,前端没有优化 pass。 它不会做常量折叠、死代码消除、循环展开,也不会把 Python 控制流改写成数据流图。所谓“编译”只是把表达式线性化、按顺序提交;真正的执行顺序仍由 Python 解释器决定。这也意味着程序里的 if、for、函数调用都是急切求值的:一旦条件依赖某个 gen 的结果,读变量处就会阻塞,后续分支只能等它。前端语言提供的是“结构化表达 + 并发提交”,不是“自动并行化编译器”。
第六,cache_prefix 是尽力而为。 它发一个 max_new_tokens=0 的请求,让服务端编码并插入 Radix 树;但如果缓存容量不足、前缀被驱逐,或者请求落到了另一个 TP/DP rank,命中并不保证。追踪得到的前缀只是“值得预热的候选”,不是“一定命中的承诺”。
第七,不要把 lang/ 的行为外推到 srt/。 前端语言里的 sid、rid、concate_and_append 是早期协议概念;生产运行时的请求 ID、KV 池、调度单位都已演化。读 lang/ 时以“编程模型”为主,读 srt/ 时以“当前源码”为主,两者不能互相替代。
前端语言在今天的位置
在今天生产环境的 SGLang 中,sgl.gen 这一套前端语言已不是主流用法。今天线上入口是 OpenAI 兼容协议,srt/ 里调度、KV 池、注意力后端都已按“单请求”模型重构。论文里的前端语言,实际上转化成了三样东西:
- 设计遗产:RadixAttention 的“按前缀共享 KV”这一核心思想,和压缩 FSM 的语法约束,都被生产运行时继承下来。本站 SGLang 源码完全拆解(五):KV 内存池与 RadixCache 的所有权闭环 和 SGLang 源码完全拆解(十):Sampling、Grammar 与结构化输出 两篇能直接看到这两条线。
- 可选项:
sgl作为sglang包的一部分依然导出,本地仍可用RuntimeEndpoint驱动 SGLang Server;它对“编排型”编程仍是一个方便的 DSL,尤其是 fork +gather_variable。 - 参照系:今天许多推理服务以“请求级 API”交付,但 LLM 应用层越来越像“请求内部有控制流”。前端语言的结构化表达——生成点、角色、分叉、约束、变量作用域——为理解这套系统的各种机制提供了最好的一课。
如果要把它与现代的 LLM 应用开发方式对照:LangGraph、DSPy、各 Agent 框架都在试图把控制流从“手写的字符串拼接”里抽出来,变成可分析的结构。SGLang 的独特之处在于,它不只是在框架之外组织控制流,而是把控制流直接映射到服务端的 KV 复用上。fork 分出去的不是“几个线程”,而是“几个共享同一前缀的请求”;join 合回来的不是“拼接的字符串”,而是“可以拼接的 KV”。这个“从程序结构到 KV 结构”的映射,是前端语言真正要传达的东西。
小结与后续路线
前端语言可以浓缩成一个数据流:sgl.gen(...) 声明生成点 → s += 提交到 StreamExecutor 的队列 → 后台线程按顺序调用后端 → 结果写入变量并置位事件 → s["name"] 阻塞取值。s.fork() 在这一流程上再复制一份执行器,让多个分支各自排队、共享同一份前缀;join("concate_and_append") 在 KV 层面把分支拼回主干,前提是后端支持 KV 拼接。追踪器用“假后端”找出可静态确定的最长前缀,在批量运行前送进缓存。
这篇文章只讲前端语言本身。下一步可以继续看这套机制如何在生产运行时里落地:srt/ 的请求对象、调度器、KV 池与注意力后端,以及它们如何用 OpenAI 兼容接口补齐“结构化输出”的能力——这些在 SGLang 源码完全拆解(十四):多模态输入 与 SGLang 源码完全拆解(六):Overlap Scheduler 已有直接承接。理解前端语言,再回看这些章节,会发现 SGLang 的系统设计其实一直围绕一个想法:程序结构决定 KV 结构,KV 结构决定服务能力。
参考资料
- SGLang 论文:SGLang: Efficient Execution of Structured Language Model Programs
- SGLang GitHub 仓库:sgl-project/sglang
- SGLang 前端语言文档:SGLang Frontend Language
- 源码路径(仓库
python/sglang/lang/):api.py、ir.py、interpreter.py、tracer.py、chat_template.py、choices.py、backend/base_backend.py、backend/runtime_endpoint.py、backend/openai.py
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



