


SGLang 源码完全拆解(八):Attention Backend——统一 metadata 如何落到不同注意力 Kernel
接上一篇:走到 ModelRunner 之后还剩下什么
上一章沿着 ScheduleBatch → ForwardBatch → TpModelWorker → ModelRunner 走完了「调度计划如何变成设备执行」的前半段:ForwardBatch.init_new 把一轮调度决策兑换成执行契约,TpModelWorker 决定在部署拓扑的哪一段发起前向,ModelRunner._forward_raw 在 decode 整图重放、prefill 分段图和 eager 三条路径之间分派。但那份契约里有一批字段当时只做了索引式介绍:out_cache_loc、seq_lens、req_pool_indices、extend_prefix_lens……它们既不是简单的循环边界,也不直接喂给任何一层 nn.Linear。这批字段真正的去处,是本章的主角:注意力后端(attention backend)。
注意力后端是模型前向里唯一「懂 KV 缓存布局、懂 kernel 接口、又懂本轮批次形状」的组件。它把 ForwardBatch 里那些元数据编译成具体 kernel 能吃的分页 KV 索引与 mask 参数,然后在每一个注意力层被调用一次,选择并执行真正的注意力 kernel。本章要回答四个问题:
AttentionBackend抽象类规定了哪些职责,为什么这些职责不能上移到ModelRunner、也不能下放到RadixAttention层;- 后端如何注册、如何按 prefill 与 decode 分别选择、如何被组合包装(hybrid、TBO、线性注意力混合模型);
- 统一元数据具体怎么编译——从
ForwardBatch的分页位置到 FlashInfer 的kv_indptr/kv_indices/kv_last_page_len、Triton 的 split-KV 缓冲、FlashMLA 的块表与调度元数据; - 注意力层在整条模型前向里的执行边界在哪里,以及后端必须配合 CUDA Graph 做的三件事。
为什么需要独立的注意力后端层
一个在线服务框架面对的第一个现实是:注意力 kernel 生态是碎片化的。FlashInfer 的分页 wrapper、FlashAttention-3 的 varlen 接口、Triton 手写 kernel、FlashMLA 的 CUTLASS 实现、以及各家平台库(ROCm 的 AITER、昇腾的 Ascend、Intel 的 AMX),它们的参数量级、内存布局假设、支持的 mask 形式、是否支持分页,全都不一样。如果模型代码里直接写死某一种 kernel 调用,要做的改动就不仅是「换一个函数」:模型层需要知道分页表怎么放、swa 窗口是几、本轮是 prefill 还是 decode、KV 缓存量化 scale 挂在哪个对象上。这会污染全部模型实现。
第二个现实是:这些元数据在每轮迭代里都必须重建,但重建逻辑又极其依赖后端。同一个 ForwardBatch 在 FlashInfer 眼里是一组 begin_forward 的 plan 参数,在 FlashMLA 眼里是一张 64 token 对齐的块表加一份 tile 调度元数据,在 Triton 眼里是一组 kv_indptr/qo_indptr 加 split-KV 的临时缓冲。框架不可能维护 N 份特化代码散落在模型里,所以它把「每个后端的私有知识」收进一个对象:既拥有每轮元数据,又拥有执行 kernel 的方法。
第三个现实与 CUDA Graph 有关。要捕获一张静态图,kernel 的参数地址在捕获时就固定下来;而分页索引、序列长度这些内容每轮都在变。谁来负责「哪些张量按固定形状预分配、哪些内容在重放前刷新、哪些操作不能进捕获区域」,答案只能是后端本身——因为它最清楚自己的 kernel 读了哪些张量。
这三条约束共同决定了这一层的形状:一个实现统一契约的 AttentionBackend 对象,向上消费 ForwardBatch,向下吞掉所有 kernel 差异。FlashInfer 论文的系统图恰好刻画了这个位置:编译期要知道注意力变体规格、任务信息和 KV 缓存布局,运行期还要把序列长度信息送进调度器,最终才能落到具体 kernel。
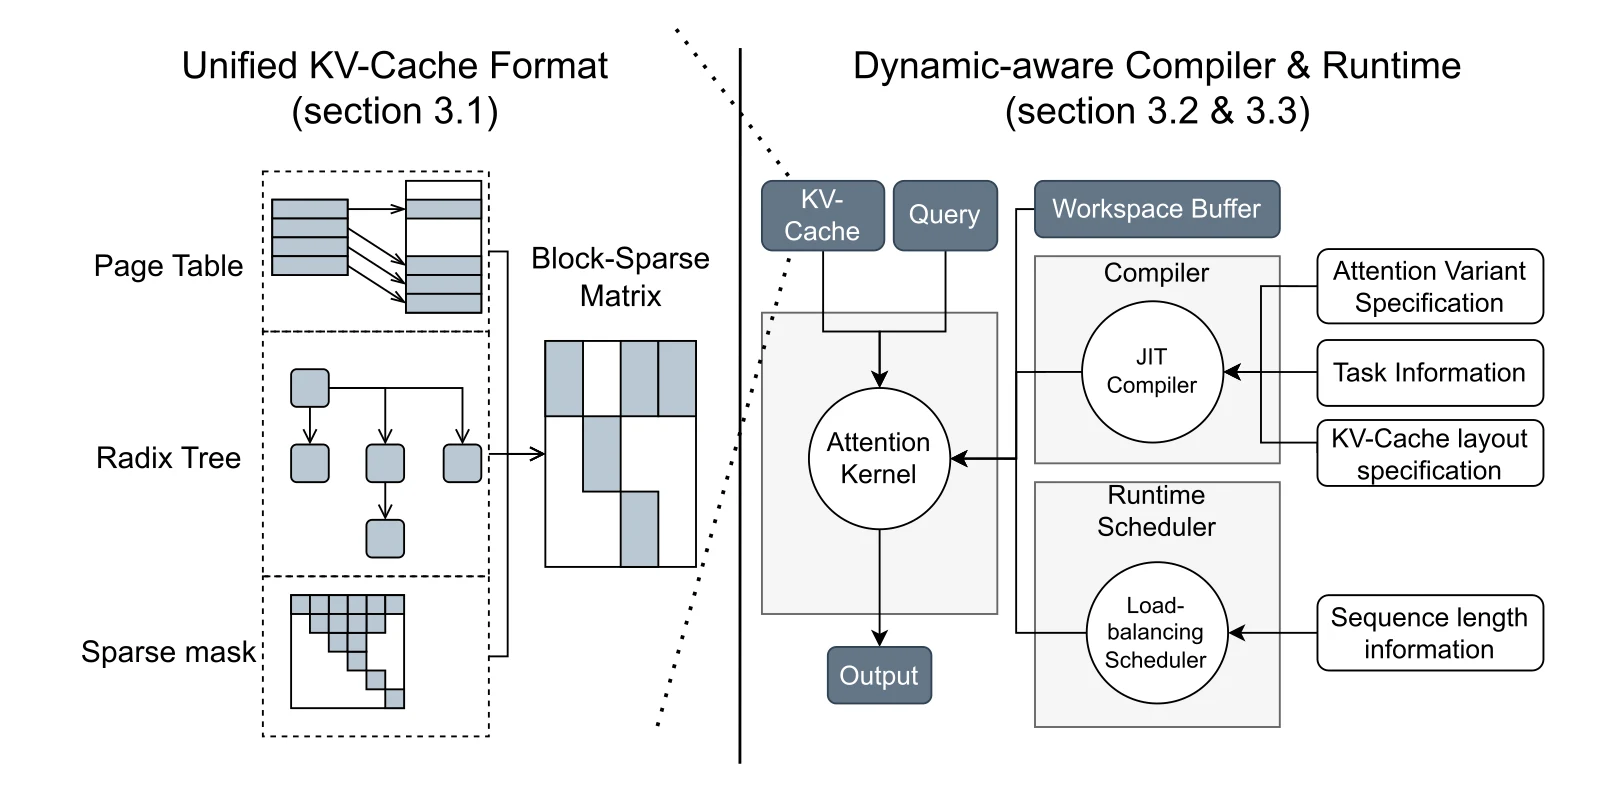
图源:FlashInfer 论文(arXiv:2501.01005) Figure 1。这张图讲的是 FlashInfer 自身,但层次划分与 SGLang 后端的职责完全同构:上层是「这一轮要算什么」的规格与布局,中间是「怎么安排」的调度,下层才是 kernel。SGLang 的后端对象同时覆盖了中间与下层——init_forward_metadata 承担规格到调度参数的翻译,forward_* 承担最终 kernel 调用。
AttentionBackend 契约:一份四问接口
python/sglang/srt/layers/attention/base_attn_backend.py 定义的 AttentionBackend 是整层的契约。它没有庞大接口,问题只有四组:本轮元数据怎么准备、一次前向怎么执行、CUDA Graph 状态谁持有、以及辅助能力(verify mask、KV 索引翻译)如何暴露。
元数据准备:一次编译、多态入口
后端最核心的方法族是 init_forward_metadata 系列。当前源码把它拆成三个层次:
class AttentionBackend(ABC): def init_forward_metadata(self, forward_batch: ForwardBatch): """Eager entry point. Default = _out_graph(fb) + _in_graph(fb).""" self.init_forward_metadata_out_graph(forward_batch) self.init_forward_metadata_in_graph(forward_batch)
def init_forward_metadata_out_graph(self, forward_batch, in_capture=False): """Per-iter metadata prep — runs outside ``with graph.capture():``."""
def init_forward_metadata_in_graph(self, forward_batch): """Graph-recordable static-shape GPU op. Default is no-op."""这套拆分的动机是 CUDA Graph 与动态 shape 的冲突。元数据准备里既有「必须读主机侧动态信息」的操作,也有「纯静态形状的 GPU 小算子」:前者不能进捕获区域(capture 期间一旦出现 .item()/.cpu()/动态形状的 torch.empty(),重放就会失效或报错),后者放进去反而省掉每次重放前的重复执行。于是契约按执行位置切开:out_graph 方法承载所有主机侧、动态形状、不可捕获的逻辑;in_graph 方法承载纯静态 GPU 算子,在 with graph.capture(): 内被录进图,重放时自动执行。源码在 in_graph 的注释里直接写明了 lint 约束——禁止调用 .item()、.cpu()、.tolist() 与动态形状分配。
类注释里有一条重要记录:legacy 的 init_forward_metadata_capture_cuda_graph 与 init_forward_metadata_replay_cuda_graph 已从 ABC 中彻底移除。旧版后端各写一套捕获/重放钩子,导致捕获分支与重放分支的漂移极其难查;新契约把两者合并成同一个 out_graph(fb, in_capture),只在 body 确实分叉的后端里通过 in_capture 参数区分。这是一次典型的「用调用时机表达状态,而不是用方法名表达状态」的接口收敛。
前向执行:四种模式的分派
执行入口是 forward(q, k, v, layer, forward_batch, save_kv_cache=True)。它是一个模板方法,按本轮 ForwardMode 分派:
def forward(self, q, k, v, layer, forward_batch, save_kv_cache=True, **kwargs): if forward_batch.forward_mode.is_idle(): return q.new_empty(q.shape[0], layer.tp_q_head_num * layer.v_head_dim) elif forward_batch.forward_mode.is_decode(): return self.forward_decode(q, k, v, layer, forward_batch, save_kv_cache=save_kv_cache, **kwargs) elif forward_batch.forward_mode.is_mixed() and is_npu(): return self.forward_mixed(...) else: return self.forward_extend(q, k, v, layer, forward_batch, save_kv_cache=save_kv_cache, **kwargs)四个分支各有一条设计理由:
- idle 分支不执行任何 kernel。上一章讲过 idle 批次是重叠调度与投机解码产生的空转轮次:GPU 上这批「没有真实 token」的请求仍然要参与 collective,但注意力层没有有效输入。此时唯一正确的行为是返回一个形状正确的空输出继续往下走,而不是让 kernel 收到零长度张量。返回缓冲的形状由
tp_q_head_num与v_head_dim乘出来,与真实路径严格一致。 - decode 与 extend 是两个不同方法,不是同一个方法加参数。因为两者需要的 kernel 结构根本不同:decode 每请求一个查询 token、要读整段历史 KV,主流方案是分页 decode kernel 加 KV 切分(split-KV);extend 是变长多 token 查询,主流方案是变长 prefill kernel 加因果 mask 或显式 mask。让一个方法内
if decode分支,只会让每个后端的主逻辑被揉成一团。 is_mixed()是 NPU 专用分支。昇腾平台的硬件路径需要混合模式单独处理,CUDA 平台走不到这里。
forward_decode、forward_extend、forward_mixed 在基类里都是 NotImplementedError,由具体后端实现。基类只固定「什么时候调用谁」,不假设「怎么算」。
CUDA Graph 状态与填充值
后端必须实现 init_cuda_graph_state(max_bs, max_num_tokens):按最大批次预分配那些内容每轮变化、但地址必须固定的缓冲(例如 FlashInfer 的 cuda_graph_kv_indices、Triton 的按 bs 切分的 kv_indptr 视图)。与之配套的 get_cuda_graph_seq_len_fill_value() 决定捕获时序列长度张量填什么值——FlashInfer 与 Triton 的实现都返回 1。这个 1 不是随手选的:捕获阶段 kernel 会真实读一遍 seq_lens,填 0 会让某些 kernel 进入零长度退化路径、甚至触发除零;填一个小的合法值可以让捕获走完整流程,真正的内容在重放前由 out_graph 阶段刷新。
辅助能力:不强迫所有后端实现全部功能
基类还声明了一批能力标志,它们的价值在于让上层可以问而不必猜:
| 声明 | 含义 | 谁在用 |
|---|---|---|
verify_mask | 投机解码验证阶段留给草稿阶段原位填充的 mask | HybridAttnBackend 转发给对应的验证执行者 |
kv_index_translator | 本后端是否通过统一 KV 索引翻译器读 KV | 未设置的后端不能服务统一内存池,由 server args 白名单兜底 |
needs_cpu_seq_lens | 是否需要主机侧序列长度 | HybridAttnBackend 把它们 OR 起来,避免不服务的路径也强制 D2H |
extend_dummy_seqs_capped_by_req_pool | 预分配的 extend 元数据是否按请求池尺寸封顶 | 约束 dummy extend 批次的 batch size 上界 |
use_captured_forward_metadata_for_breakable_cuda_graph | 元数据张量地址是否会被捕获的图跨断点引用 | 上一章的 Breakable CUDA Graph 路径 |
supports_ragged_verify_graph | 是否支持 ragged 验证布局进图 | 投机解码的捕获分支 |
prefer_eager_mixed_prefill_under_dp_attention | 某些后端在 DP 注意力下把混合 prefill 留在 eager | DP attention 的性能回归规避 |
attn_backend_list / forward_metadata | 包装器的子后端枚举与可快照的每轮元数据 | 元数据 glue graph 的快照/恢复 |
还有一个容易被忽略的小枚举 SharedReadEnds。它声明「本后端何时读完调度器共享的数据」:
class SharedReadEnds(Enum): PRE_REPLAY = 1 # init_forward_metadata_out_graph 之后读完 IN_REPLAY = 2 # init_forward_metadata_in_graph 之后读完 POST_REPLAY = 3 # 未实现元数据快照 UNKNOWN = 4 # 未审计 -> 保守的整前向栅栏默认实现给 decode 与 target_verify 返回 IN_REPLAY,其余模式返回 UNKNOWN(保守取整前向栅栏)。这个声明服务于重叠调度:CPU 侧在准备下一轮调度时需要知道「上一轮的后端元数据构建是否已经读完共享张量」,晚读的部分要求更宽的屏障。把「读过哪些共享数据」显式声明出来,比让每个调用点猜一张全局保守锁便宜得多。这类微小的枚举正是「后端不仅执行 kernel、还参与时序正确性证明」的证据。
注册表、选择与包装:三段式装配
契约回答了「后端长什么样」,装配逻辑回答「一个具体服务实例用哪些后端」。这条装配链在源码里分成三段:注册(有哪些后端)、解析(这一轮配置选谁)、构建与包装(怎么把它们组起来)。
注册:一个装饰器与一张字典
attention_registry.py 的注册表简单到极致:
ATTENTION_BACKENDS = {}
def register_attention_backend(name): def decorator(fn): ATTENTION_BACKENDS[name] = fn return fn return decorator
@register_attention_backend("flashinfer")def create_flashinfer_backend(runner): if not runner.use_mla_backend: from ...flashinfer_backend import FlashInferAttnBackend return FlashInferAttnBackend(runner, init_new_workspace=runner.init_new_workspace) else: from ...flashinfer_mla_backend import FlashInferMLAAttnBackend return FlashInferMLAAttnBackend(runner)两个细节值得展开。第一,工厂函数内部做延迟导入:flashinfer 这个条目在导入注册表模块时就被登记,但只有真正被选中时才 import 对应模块。这让一台不装 FlashInfer 的机器照样能启动别的后端,也让 SSM(Mamba)这类特殊模型不去加载与它无关的注意力依赖。第二,工厂内部按 use_mla_backend 二次分派——MLA 模型的 KV 是压缩潜向量而非标准 K/V 头,同一名字 flashinfer 在 MLA 模型上落到完全不同的实现类。
当前注册表覆盖的后端可以按用途分组:
- 通用 CUDA 后端:
flashinfer(分页/ragged 双 wrapper)、fa3/fa4(FlashAttention-3/4)、triton(自研 Triton kernel)、trtllm_mha(TensorRT-LLM 的 MHA kernel)、hpc_ops、torch_native(参考实现)、flex_attention(torch 的 FlexAttention); - MLA 专用后端:
flashmla、trtllm_mla、tokenspeed_mla、cutedsl_mla、flashinfer_mla;注册表里多条 MLA 条目各有取向,例如trtllm_mla的工厂会在「解码上下文并行加投机解码」的组合上直接拒绝启动并提示换cutedsl_mla或tokenspeed_mla——它不转发跨 rank 合并所需的 rank-local LSE; - 稀疏注意力后端:
dsa(DeepSeek Sparse Attention,旧的nsa名字以 DeprecationWarning 转发到dsa)、qsa(Qwen 系稀疏注意力)、dsv4(DeepSeek-V4 压缩注意力,NPU/HIP/CUDA 三个平台分支); - 平台后端:
aiter(ROCm)、ascend(昇腾)、intel_amx(Intel CPU)、wave。
设计取舍很清楚:后端颗粒度是「一套 kernel 家族」,不是「一个 kernel」。同一家族里 prefill 与 decode 用不同 kernel 是常态,家族内部怎么切由自己决定;注册表只保证「这个名字能被解析到、能被构建」这一件事。
解析:prefill 与 decode 可以是两个不同后端
装配链第二步在 attention_backend_setup.py。resolve_attention_backend_strs 返回一对字符串而不是一个:
class ResolvedAttentionBackendStr(msgspec.Struct, frozen=True, kw_only=True): prefill: str decode: str is_draft_override: bool = False
def resolve_attention_backend_strs(*, model_runner) -> ResolvedAttentionBackendStr: if model_runner.is_draft_worker and model_runner.draft_attention_backend: # 草稿 worker 有独立后端,目标与草稿共存于同一进程 return ResolvedAttentionBackendStr(prefill=..., decode=..., is_draft_override=True) prefill, decode = attention_backends() return ResolvedAttentionBackendStr(prefill=prefill, decode=decode)「prefill 与 decode 用不同后端」是这一层最有信息量的设计。prefill 是计算密集的变长多 token 计算,追求矩阵乘利用率;decode 是带宽密集的逐 token 计算,追求 KV 读取效率与切分调度。同一个模型家族里,最优 kernel 往往不同——例如 MLA decode 上 flashmla/trtllm_mla 的块表路径显著优于通用分页 kernel,而 prefill 上 FlashInfer 的 ragged wrapper 通常更合适。允许两者分开配置,服务就能取各自最优解,而不必被单一后端的最短板限制。
草稿 worker 的覆盖逻辑则揭示了另一个约束:投机解码的草稿模型与目标模型共用一个进程,所以草稿的后端不能从进程级配置读——它必须挂在 ModelRunner.draft_attention_backend 上,由草稿侧自己的参数决定。
构建:单后端、双后端、包装器
build_attention_backends 是装配的终点,分支序列本身就是一份设计文档:
def build_attention_backends(*, model_runner) -> AttentionBackends: if model_runner.model_config.attention_arch == AttentionArch.SSM: mamba_backend = Mamba2AttnBackend(model_runner) # 纯 SSM:没有注意力 return AttentionBackends(attn_backend=mamba_backend, ...)
if get_disagg().enable_pdmux: # PD 复用:一个 prefill 后端 + sm_group_num 组 decode 后端实例 attn_backend = _build_resolved_backend(..., init_new_workspace=True) decode_attn_backend_group = [_build_resolved_backend(..., init_new_workspace=False) for _ in range(get_disagg().sm_group_num)] elif get_exec().overlap.enable_two_batch_overlap and not model_runner.is_draft_worker: attn_backend = TboAttnBackend.init_new( lambda: _build_resolved_backend(..., init_new_workspace=False)) else: attn_backend = _build_resolved_backend(..., init_new_workspace=False)四个分支对应四种部署形态:
- 纯 SSM 模型(如 Mamba2 架构)根本没有 softmax 注意力层,直接返回
Mamba2AttnBackend,prefill/decode 字符串都记作mamba2; - PDmux(prefill/decode 复用同一组 GPU 的多流模式)为每个流组构建一个独立的 decode 后端实例,只有第一个分到新 workspace——多实例共享显存但必须各自持有元数据;
- 双批次重叠(TBO)把批次切给两个子后端(
TboAttnBackend持有children=[child0, child1]),两份子批次在各自动的 metadata 上并行推进,再回写合并; - 默认路径:单个后端实例。
构建入口 _build_resolved_backend 处理 prefill ≠ decode 的情形——它把这对比作「两个完整注意力后端」再套一层 HybridAttnBackend:
class HybridAttnBackend(AttentionBackend): """Support different backends for prefill and decode."""
def _select_backend(self, forward_mode: ForwardMode) -> AttentionBackend: if forward_mode.is_decode_or_idle(): return self.decode_backend elif forward_mode.is_target_verify(): return (self.decode_backend if self.spec_attn_is_decode else self.prefill_backend) else: return self.prefill_backend路由规则里唯一的非平凡点在 target_verify:投机解码的验证阶段既像 prefill(多 token 查询)又像 decode(要按 KV 长程读取),所以它跟着 --speculative-attention-mode 的取值路由——该参数声明「验证在这个框架里按哪类负载对待」。这不是猜测,而是配置与后端能力的显式对齐。
HybridAttnBackend 还要处理一批「问哪一半」的转发:init_cuda_graph_state 默认只初始化 decode 侧,只有 DLLM 或「验证走 prefill」的组合才追加初始化 prefill 侧;verify_mask 从验证执行者转发;needs_cpu_seq_lens 按实际会服务的模式 OR。这些转发看起来琐碎,但每一条都避免了一类真实 bug——比如若把不服务验证的 prefill 后端的 needs_cpu_seq_lens 也算进去,每轮 decode 都会被强制多一次 D2H 同步。
包装器:混合模型与线性注意力
attn_backend_wrapper 是最后一道包装,处理的是「同一个模型里既有 softmax 注意力层、又有别的层」的混合架构。当前源码里的分支包括:
- 混合 GDN(Gated DeltaNet,如 Qwen 系混合模型)与混合 KDA/Lightning/Mamba2:完整注意力层用选定的全注意力后端,线性注意力层用对应的线性后端,二者由
HybridLinearAttnBackend组合;shared的混合层路由与 mamba 状态管理都在这一层; - MiniMax 稀疏注意力:完整层与稀疏层各持一个后端,由
MiniMaxHybridAttnBackend按sparse_layer_ids分发; - Inkling 短卷积混合、Dots3 等特定模型族:各自把「侧车(sidecar)状态元数据」挂进包装对象。
包装器存在的意义是让基座注意力后端对混合架构保持无知。FlashInfer、Triton 的实现不需要知道「这个模型第 12 层是线性注意力」;包装对象在层与后端之间按层号分流,保持内核侧代码对所有模型族通用。
装配完成后,ModelRunner.init_attention_backends 还会做两件收尾:把解析出的 per-mode 字符串盖章到后端对象(prefill_attention_backend_str / decode_attention_backend_str,供模型侧按模式查询),以及让 kv_index_translator.bind_and_verify_backends([attn_backend, decode_attn_backend]) 校验每个后端都能通过翻译器读统一内存池。注释里还记录了一条顺序约束:configure_aux_hidden_state_capture(EAGLE/DFLASH 的辅助隐状态捕获配置)必须在本函数里、CUDA Graph 捕获之前完成——否则捕获出的图不含辅助隐状态输出路径,投机解码会在图里拿到空张量。
统一元数据的编译:从 ForwardBatch 到 KV 索引与 mask
装配讲完了「谁在跑」,接下来是核心机制:「跑之前做了什么」。以 FlashInfer 后端为主线,因为它的元数据构造最完整地展示了「分页 KV + 变长批次」这套通用翻译。
一个具体的问题:kernel 只认识张量,批次是 Python 对象
注意力 kernel 的输入是纯张量:查询张量、KV 缓存张量、一串描述「每行查询该读哪些 KV 页」的索引。而 ForwardBatch 是另一套语言:req_pool_indices 是批内第 个请求在请求池里的槽号,req_to_token 是「请求槽 × 逻辑位置 → KV 位置」的二维映射,seq_lens 是本轮每请求的有效长度。后端的元数据构造就是这两套语言之间的编译器。
编译出来的第一层结构是分页读地址。FlashInfer 的 decode 元数据由三件套构成,源码里它们的初始化是一个通用小函数:
def _init_kv_indices(...): # 结构示意,合并自 FlashInferIndicesUpdaterDecode bs = len(paged_kernel_lens) kv_indptr[1 : bs + 1] = torch.cumsum(paged_kernel_lens, dim=0) kv_indptr = kv_indptr[: bs + 1] if wrapper.is_cuda_graph_enabled: kv_indices = wrapper._paged_kv_indices_buf # 直接写进图输入缓冲 else: kv_indices = torch.empty(paged_kernel_lens_sum, dtype=torch.int32, device="cuda") translator.pack_read_stream(plan, req_pool_indices=..., seq_lens=paged_kernel_lens, indptr=kv_indptr, out=kv_indices, kv_start_idx=kv_start_idx, kind=read_kind)三个张量各司其职:
kv_indptr:长度 的前缀和数组,第 项是前 个请求的 KV 页总数。它是 CSR(压缩稀疏行)格式的行指针——第 个请求的页列表切片在kv_indices[kv_indptr[i]:kv_indptr[i+1]]。用前缀和而不是「每请求一个等长列表」,是因为请求长度不同,二维张量会浪费(padding)或非法(锯齿);kv_indices:长度等于本轮 KV 页总数的扁平列表,内容是该请求读到的物理页号。注意它不是「逻辑页号」,而是经过翻译器落到真实内存池的物理页号;kv_index_translator的存在正是为了让「逻辑页 → 物理页」的翻译可以按内存池形态(统一池、SWA 池、卸载池)变化,而 kernel 侧不必知道;kv_last_page_len:每个请求最后一页有几个有效 token。分页存储的最后一页通常填不满,decode kernel 必须知道「读到最后一页的哪个位置为止」。
最后 wrapper.begin_forward(kv_indptr, kv_indices, kv_last_page_len, num_qo_heads, num_kv_heads, head_dim, page_size=1, ...) 把三件套交给 FlashInfer 的 plan():这一步在主机侧完成工作划分与负载均衡计算,把 kernel 启动参数固化到 wrapper 内部。真正的 wrapper.forward(q, kv_cache, sm_scale, logits_soft_cap, k_scale, v_scale) 才是逐层执行。
分页 KV 的读地址结构可以用 FlashInfer 论文的块稀疏表(BSR)图来对照理解:当页表按 分组时,「每行 4 个查询读 1 个 KV 块的块级视图」正好是 kv_indptr/kv_indices 逻辑的块粒度版本。
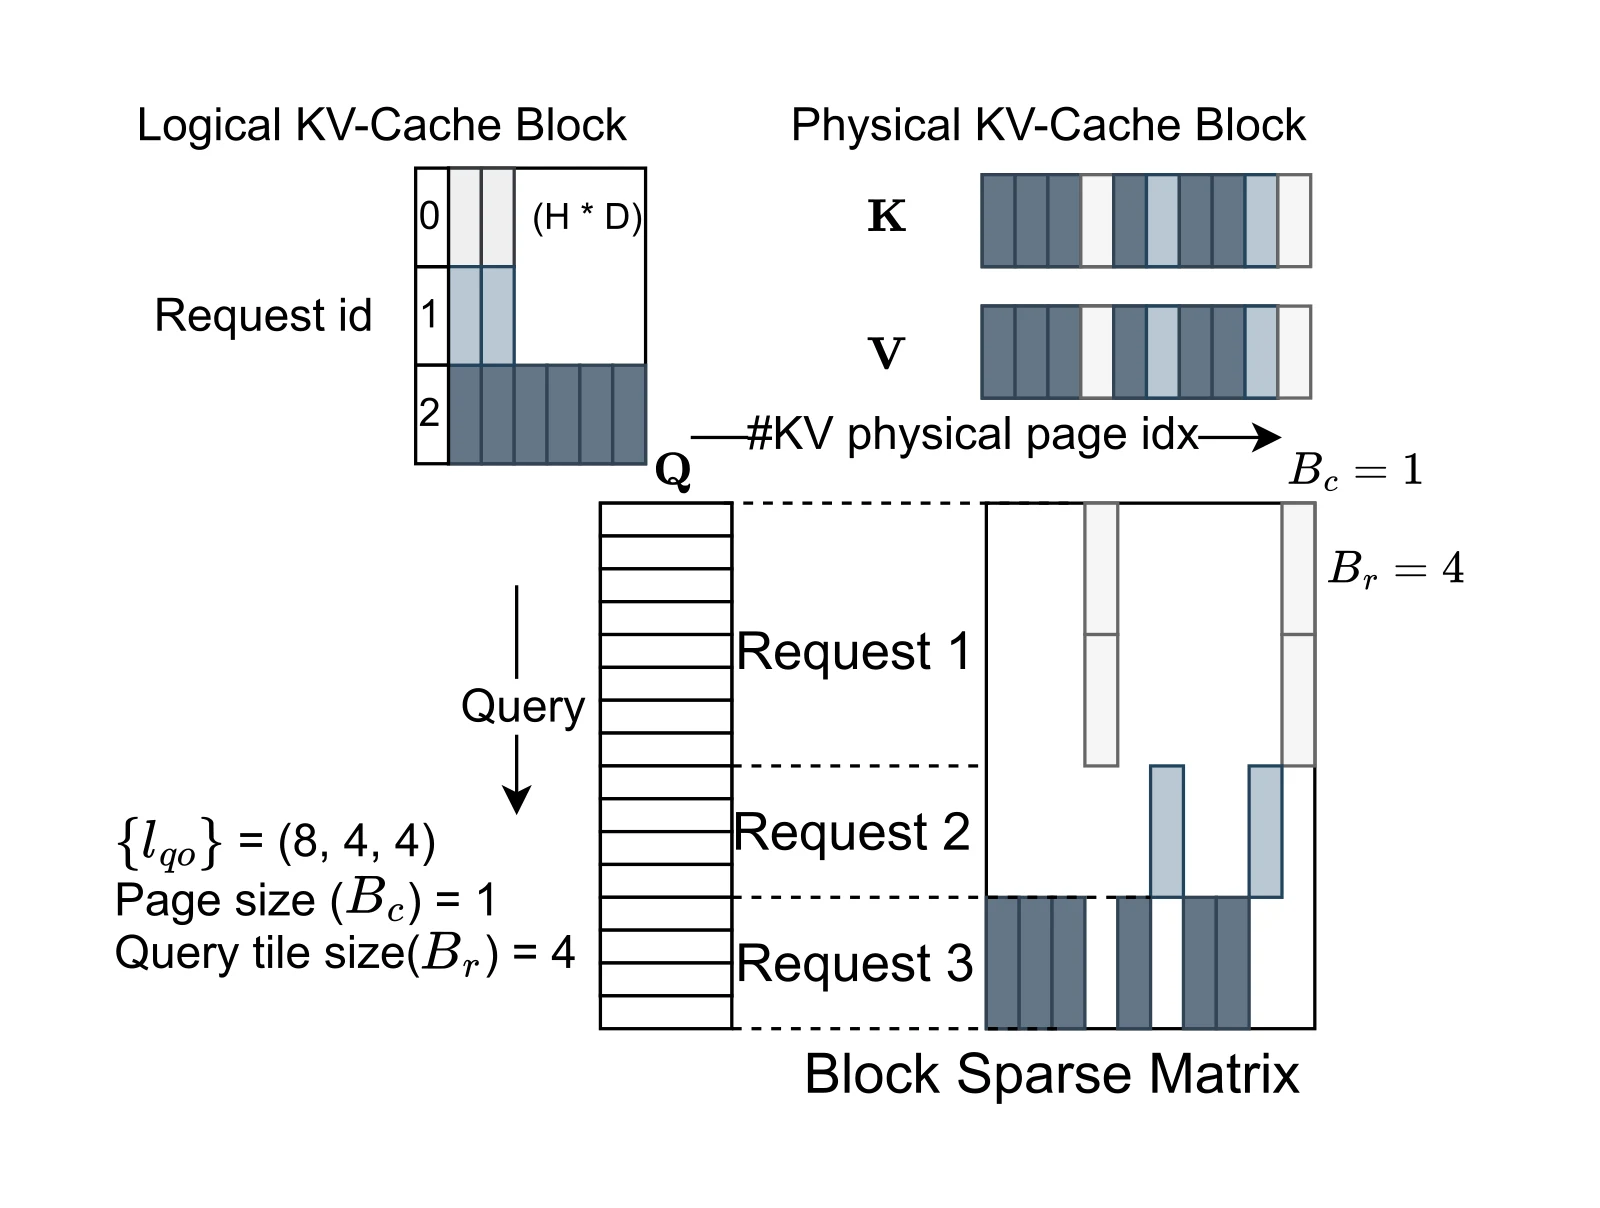
图源:FlashInfer 论文(arXiv:2501.01005) Figure 2。SGLang 后端构造的是逐 token 粒度的 CSR 页表(等价于 的极端情形);当某层使用块稀疏注意力时,同样的翻译思路会提升到块粒度。
为什么逐层执行、元数据却每轮只建一次
回到 ModelRunner 的一轮循环:init_forward_metadata(fb) 在模型前向之前被调用一次;随后模型里的 个注意力层各自调用 backend.forward(...),每次从 self.forward_metadata 里取出当轮对象。这个「一次编译、 次执行」的划分是必须的:元数据构造要读 seq_lens_cpu、做前缀和、可能触发主机侧同步,成本随层数乘起来会很可观;而逐层执行里唯一必须逐层变化的量是 layer_id(选 KV 缓冲)与层的形状参数。
也正因为元数据是批次级对象,FlashInfer 后端才需要 _get_wrapper_idx(layer) 这层间接:一个批次里可能有多类注意力层——全注意力和滑窗层需要不同的 wrapper(页表里 KV 长度上限不同),交叉注意力层又需要别的配置。源码用两种 dispatch 原因区分:
class WrapperDispatch(Enum): SLIDING_WINDOW = ... CROSS_ATTENTION = ...
def _get_wrapper_idx(self, layer: RadixAttention): if self.num_wrappers == 1: return 0 if self.dispatch_reason == WrapperDispatch.SLIDING_WINDOW: return layer.sliding_window_size == -1 if self.dispatch_reason == WrapperDispatch.CROSS_ATTENTION: return layer.is_cross_attention即:批次级元数据对象里放一组 wrapper,逐层执行时按层的属性选索引。滑窗层的 KV 读取被限制在窗口内,cross-attention 层(编码器-解码器模型)读的是编码器侧 KV,这两类层若共用同一份页表就会读到错误数据。把「哪些层需要分开的元数据」做成批次级枚举、把「这一层属于哪一类」做成层级布尔判断,是这套设计里最小的实现方案。
这里有一个容易被忽略的工程细节,直接写在后端构造的注释里:FlashInfer 把 num_qo_heads 烘焙进 plan,任何「跑得比 plan 时假设的头数更多」的层都会被静默算错。因此 plan 时采用「按批内最大头数过度规划」的策略——过度规划是安全的,欠规划不是。GQA/MQA 模型里不同层查询头数可能不同,这个细节决定了后端必须按最坏情况准备。
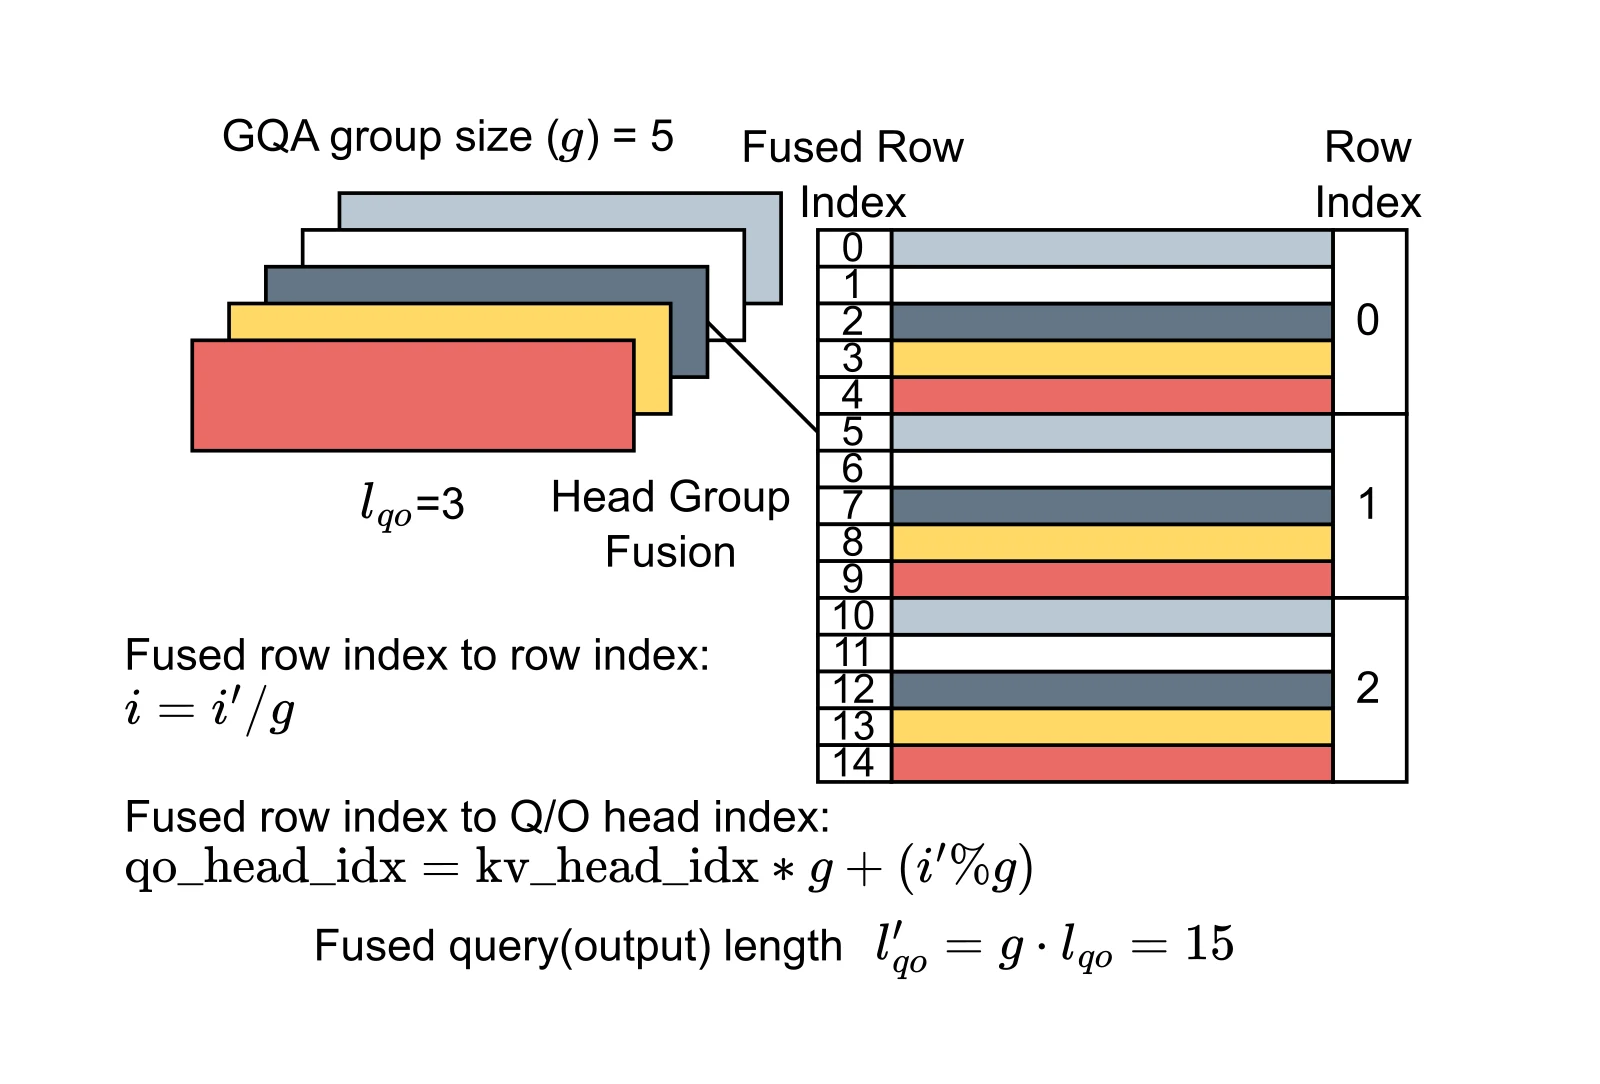
图源:FlashInfer 论文(arXiv:2501.01005) Figure 11。GQA 里多个查询头共享一组 KV 头,kernel 侧可以把头组融合进同一维做并行;而框架侧必须保证 plan 的头数参数不小于任何一层的实际头数。
extend 的两种形态:ragged 直算与 paged + merge
prefill/extend 的元数据构造比 decode 多一层选择。源码先决定本轮走哪条路径:
use_ragged = (not self.enable_deterministic and not is_in_tc_piecewise_cuda_graph() and not self.use_paged)extend_no_prefix = not any(forward_batch.extend_prefix_lens_cpu)- ragged 直算:当批次里所有请求都没有命中缓存前缀(
extend_no_prefix为真)时,整个批次是一次干净的变长 prefill——所有 token 都是「新的」,直接调用 ragged wrapper:forward(q, k, v, causal=..., sm_scale=..., logits_soft_cap=...),KV 也在这次调用里由save_kv_cache写入页表。 - paged + merge:当有请求命中了前缀缓存,本轮 extend 的每个请求分成两段——已缓存在页表里的前缀段( 个 token)与需要新计算的后缀段( 个 token)。前缀段的 KV 在内存池里(分页),后缀段的 KV 在本次计算的 k/v 张量里(连续)。FlashInfer 的做法是分别算两段、再合并注意力状态:
其中 是未归一化的注意力输出、 是对应的 log-sum-exp 统计量。合并两个 online-softmax 状态的标准形式是:
源码里对应的调用是:
o1, s1 = self.prefill_wrapper_ragged.forward_return_lse(q, k, v, causal=..., ...)o2, s2 = prefill_wrapper_paged.forward_return_lse(q, kv_cache, causal=False, ...)o, _ = _safe_merge_state(o1, s1, o2, s2)三个设计点:其一,ragged 段传 causal=True(段内因果),paged 段传 causal=False(前缀段全部可见,因果性已经由「前缀在时间上更早」这一事实保证);其二,forward_return_lse 返回统计量而不是只返回结果,是为了让合并是数值精确的在线 softmax 合并,而不是近似加权;其三,_safe_merge_state 的「safe」有实义——源码在前面计算了「合并阶段最多能安全处理多少个头」的上界(按 head_dim 与元素大小推算的 _merge_state_max_safe_num_heads),超限时走分块合并,避免 merge kernel 的寄存器压力爆掉。
mask 从哪里来:因果位、滑窗、验证掩码
「构造 KV 索引与 mask」里的 mask 部分同样属于后端。与一些实现「每轮物化一张完整注意力掩码张量」的做法不同,SGLang 的 mask 有三种形态,按需要才升级:
第一形态是因果位。 绝大多数 extend/decode 的可见性完全由位置决定,所以后端根本不构造掩码张量,只把 causal 布尔值传给 kernel——kernel 内部按查询位置与 KV 长度推导逐格可见性。前面 extend 合并路径里 ragged 段传 causal=True、paged 前缀段传 causal=False 就是这一形态的用法:前缀段在时间上必然早于所有查询,因果性自然成立,无需逐格掩码。
第二形态是滑窗。 层带 sliding_window_size 时,后端的处理是把 window_left=layer.sliding_window_size 作为参数交给 kernel,由 kernel 裁剪可见范围。但滑窗与「paged 前缀 + ragged 后缀」合流时,单纯参数不够了:前缀段在页表里的绝对位置与查询的绝对位置之间需要逐格判断「是否落在窗口内」。FlashInfer 后端为此实现了 _build_swa_prefix_custom_mask——对每个请求,令查询的绝对位置为 prefix_len .. prefix_len + extend_len、KV 的绝对位置为 kv_start .. prefix_len,逐格保留 的位置;只有当存在越窗格子时才真正构造掩码(全在窗内时返回 None 走快路径)。注意这段代码先把三组长度张量转成主机列表做判断——这是后端里少见的显式主机侧分析,也说明掩码构造的成本只有在必要时才值得付。
第三形态是投机解码的验证掩码。 树式草稿(EAGLE 系)的验证阶段,可见性与树结构有关,无法用因果位或滑窗表达,必须显式给出。源码里两个对象配合完成:
class VerifyMask(msgspec.Struct, frozen=True): """The target-verify mask.""" buffer: torch.Tensor # 草稿阶段原地写入的掩码缓冲 mode: TreeMaskMode max_bs: int is_read: bool = True
def fits(self, bs: int) -> bool: ...
def tree_mask_numel(mode, bs, num_draft_tokens, max_context_len) -> int: if mode == TreeMaskMode.QLEN_ONLY: per_req = num_draft_tokens * num_draft_tokens # KB 级 elif mode == TreeMaskMode.FULL_MASK: per_req = num_draft_tokens * (max_context_len + num_draft_tokens) # 长上下文下上百 MB设计要点:掩码由草稿阶段通过 build_tree_kernel_efficient 原地写入缓冲,目标验证轮直接读取——这让验证 worker 省掉一次 seq_lens_sum 的 D2H 同步;缓冲尺寸按 max_bs 一次性分配,fits() 在批次超界时提前暴露;mode 与缓冲必须成套传递(注释原话:只拿缓冲不拿布局,kernel 会写出读方不认识的形状);结构体是 frozen 的,扩容只能整体替换,防止 max_bs 与缓冲脱节。掩码长度则通过 mask_indptr 表达——每请求的掩码格数是 num_tokens_per_req × (seq_lens + num_tokens_per_req),前缀和之后交给 kernel 做 CSR 切片,与 KV 页表的 kv_indptr 完全同构。
为什么不做成「统一物化」?回顾三种形态的成本:因果位零成本;滑窗在必要时才构造、且按需裁剪;验证掩码必须显式但由草稿阶段顺路写好。如果统一成「每轮构造完整掩码」,decode 这种 的场景会白白付出 的内存与构造时间,长上下文下完全不可接受。掩码的形态选择本身就是一种优化,这也是后端契约把 mask 参数(causal、window_left、custom_mask/mask_indptr)全部暴露在逐层调用签名上的原因。
其他后端的元数据:同一个契约,不同物化
Triton 后端的 ForwardMetadata 是一个 dataclass,字段列表本身就是它的执行计划:
class ForwardMetadata: attn_logits: torch.Tensor # (bs, num_head, max_kv_splits, v_head_dim) 部分结果 attn_lse: torch.Tensor # (bs, num_head, max_kv_splits) 部分统计量 max_extend_len: int num_kv_splits: torch.Tensor # 每请求的实际切分数 kv_indptr / kv_indices # decode/verify 用分页页表 qo_indptr # extend 的查询 CSR custom_mask / mask_indptr # 验证阶段的显式 mask window_kv_indptr / window_kv_indices / window_num_kv_splits # 滑窗层专用 ...它与 FlashInfer 的差异在把 decode 的 KV 切分暴露到了元数据层。Triton decode kernel 采用 split-KV:把每个请求的长 KV 切成 num_kv_splits[i] 段并行归约,每段产出部分结果 attn_logits 与部分统计 attn_lse,最后由 reduction kernel 合并。切分数由 get_num_kv_splits 按序列长度动态选择:序列越长切得越多,用更多并行度对抗单序列的长尾。FlashInfer 的等价机制藏在它自己的 plan() 内部(fixed_split_size/disable_split_kv 参数),而 Triton 后端把它显式为框架可见的元数据字段——这解释了为什么 Triton 后端需要为「lean decode」维护额外的持久化网格部分结果缓冲(lean_Mp/lean_Lp/lean_Op/lean_locks)。
FlashInfer 论文的负载均衡调度图说明了这类「切分 + 均匀分发」的一般问题:变长序列在 CTA 粒度上的工作负载极不均匀,调度器需要按序列长度信息把工作量摊平,且必须与 CUDA Graph 的静态配置兼容。
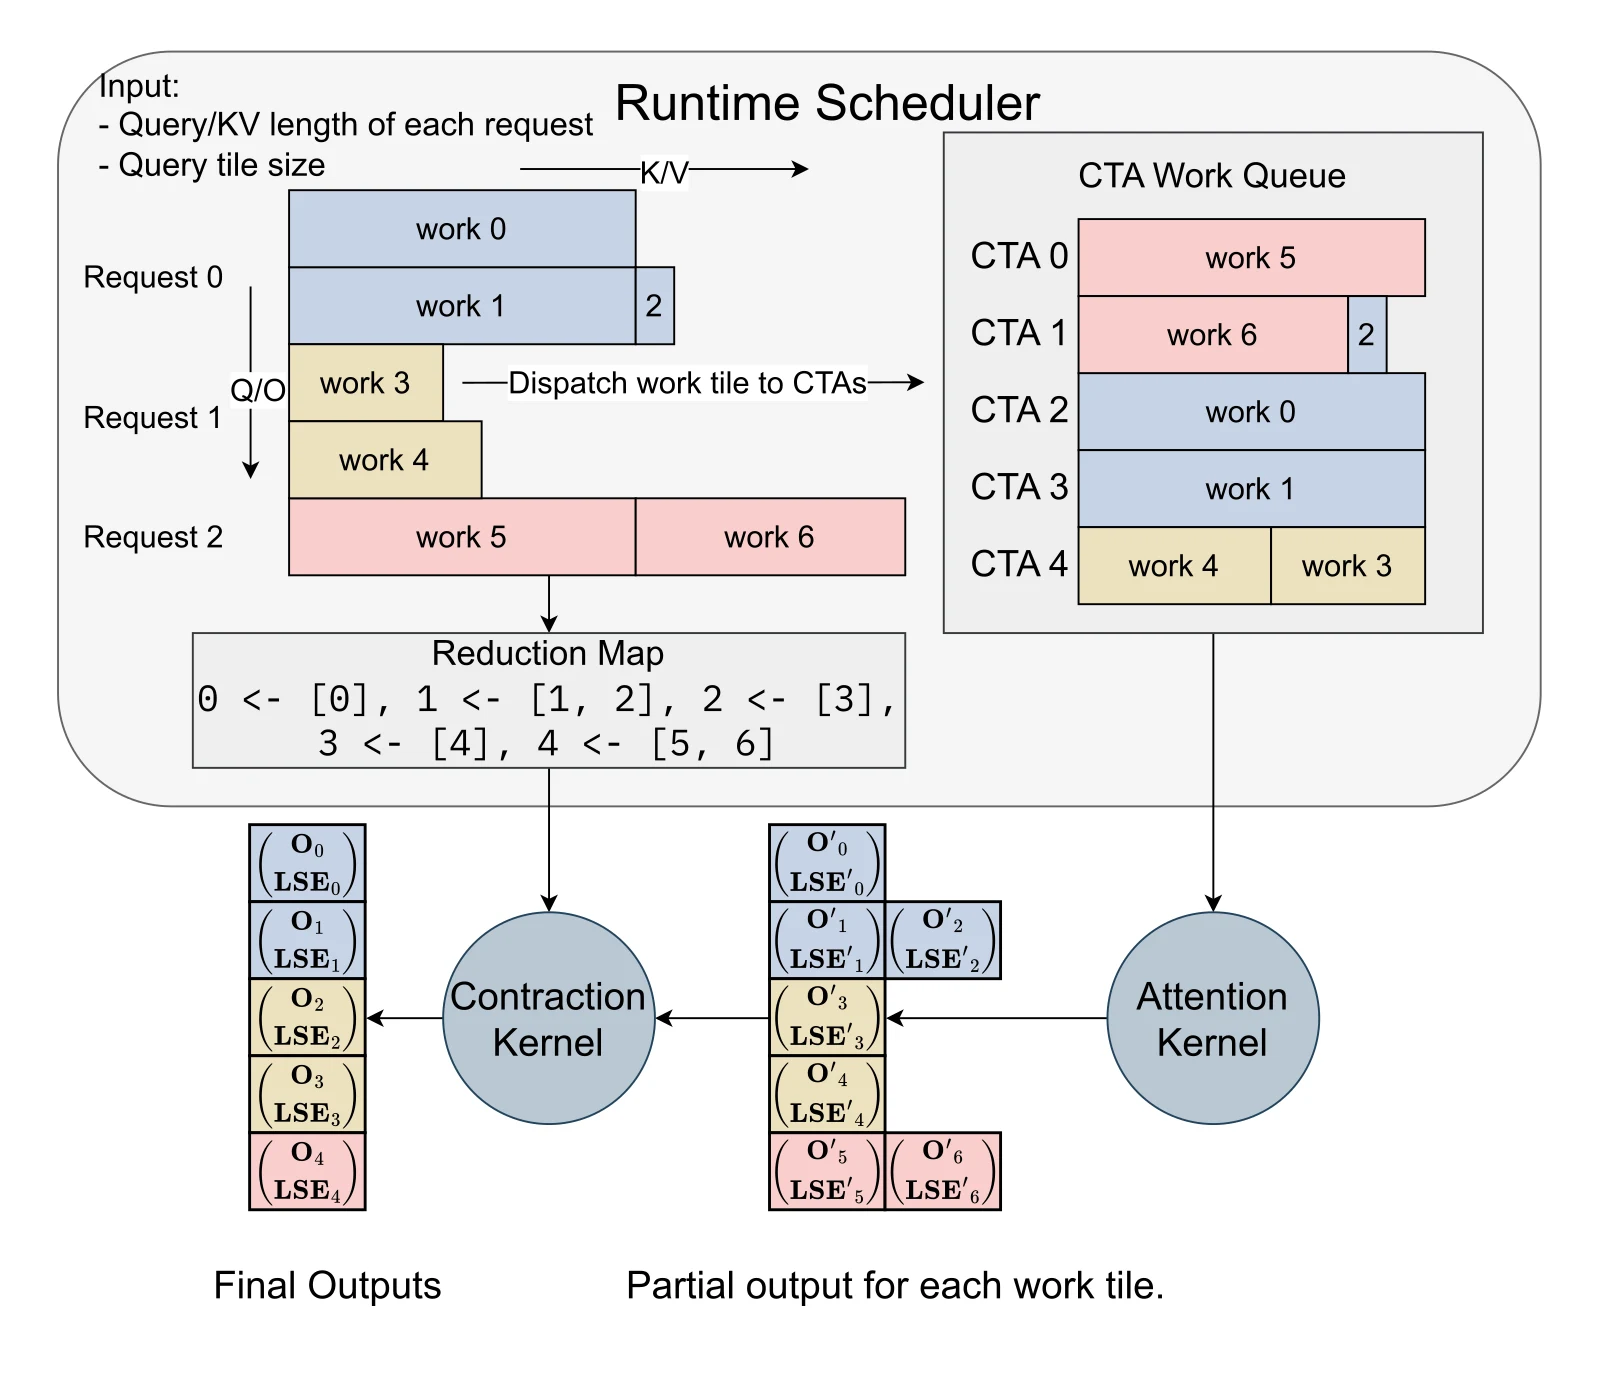
图源:FlashInfer 论文(arXiv:2501.01005) Figure 6。SGLang 的 Triton 后端用 num_kv_splits 做序列内切分,FlashMLA 用 get_mla_metadata 产出的 tile 调度元数据做跨序列分发,FlashInfer 在自己的 plan 阶段完成同类摊平——三者是同一问题的三种解法。
FlashMLA 后端(MLA 模型的 decode 主力,继承自 FlashInferMLAAttnBackend)的元数据是三件不同的东西:
mla_metadata, num_splits = get_mla_metadata( forward_batch.seq_lens.to(torch.int32), self.num_q_heads, 1, is_fp8_kvcache=self.is_fp8_kvcache,)self.forward_metadata = FlashMLADecodeMetadata(mla_metadata, num_splits, block_kv_indices)- 块表
block_kv_indices:形状是(批次, 每序列的块数),块大小固定 64 token。构造路径有两条——统一内存池下用kv_index_translator.copy_page_table(plan, out=block_kv_indices)从逻辑视图直接拷贝;否则用create_flashmla_kv_indices_triton[(bs, 块数)]从req_to_token与req_pool_indices现场生成。第二条路径正是上一节「请求槽映射表 → 物理页表」翻译的 Triton 版本; tile_scheduler_metadata与num_splits:由get_mla_metadata产出,是 kernel 内部的 tile 级调度计划——把「哪些块的 KV 归哪个 CTA、跨序列怎么摊平、每个序列切几份」预先算好,kernel 只按表执行。它和 FlashInfer 的plan()是同一思想:把调度计算移出 kernel 主循环,换取主循环里的纯数据搬运;seq_lens_k(仅 draft-extend 模式):KV 侧的有效长度,与查询窗口长度分开。
调用形态很直白:flash_mla_with_kvcache(q, k_cache, block_table, cache_seqlens, tile_scheduler_metadata=..., num_splits=...)。MLA 的 KV 是压缩潜向量(每个 token 只有几百字节),块表是它最主要的寻址结构;这也是为什么 MLA 的 decode 路径不套用通用分页三件套——潜向量的宽行形态让「页级 indptr」反而不如固定 64-token 块表划算。
一个有趣的细节:FlashMLA 后端的 init_forward_metadata 只处理 decode/verify/draft-extend 三类模式,其余模式回落到父类(super().init_forward_metadata(forward_batch),即 FlashInfer MLA 的通用实现)。也就是说,同一后端对象内部也允许「decode 用专用 kernel、extend 用通用 kernel」的组合——与 HybridAttnBackend 的跨后端组合是同一种思想,只是粒度退到了类内部。
同一契约的四种实现对照
把上面拆过的实现放进一张表,可以更清楚地看到「统一契约」到底统一了什么、又放行了什么:
| 后端 | decode 路径 | extend 路径 | KV 寻址 | 元数据对象 | 典型适用 |
|---|---|---|---|---|---|
flashinfer | 分页 decode + plan 内切分 | ragged / paged + merge | kv_indptr/kv_indices/kv_last_page_len | DecodeMetadata / PrefillMetadata(含 wrapper 组) | 通用 CUDA,默认首选 |
fa3 / fa4 | varlen decode | varlen prefill(FA3 模板) | varlen 连续 + 页表 | FA 自有调度结构 | SM90 默认候选 / Blackwell |
triton | split-KV decode(num_kv_splits + 部分缓冲) | 变长 extend(qo_indptr) | 显式 CSR + 滑窗副本 | ForwardMetadata(一个平坦 dataclass) | 可移植、可调试、ROCm 共路径 |
flashmla | MLA 专用 decode + tile 调度 | 回落父类 | 64-token 块表 + seq_lens_k | FlashMLADecodeMetadata | MLA 模型 decode 主力 |
FlashAttention 系列后端(fa3/fa4)在注册表里的准入条件值得单独讲:
@register_attention_backend("fa3")def create_flashattention_v3_backend(runner): major, minor = get_device_capability() assert (major == 8 and not runner.use_mla_backend) or major == 9, \ "FlashAttention v3 Backend requires SM>=80 and SM<=90. Please use `--attention-backend flashinfer`." from ...flashattention_backend import FlashAttentionBackend return FlashAttentionBackend(runner)fa3 的断言把硬件与模型架构两个维度写进了准入条件:SM80 以上、SM90 以内,且非 MLA 模型。fa4 条目复用同一个 FlashAttentionBackend 类但传 fa_impl_ver=4——同一后端类按实现版本参数化,适配 Blackwell 的新指令集。FlashAttention-3 之所以在 Hopper 上强,核心是 warp 特化与 pingpong 调度让 softmax 与 GEMM 在相邻 warpgroups 之间交替重叠:
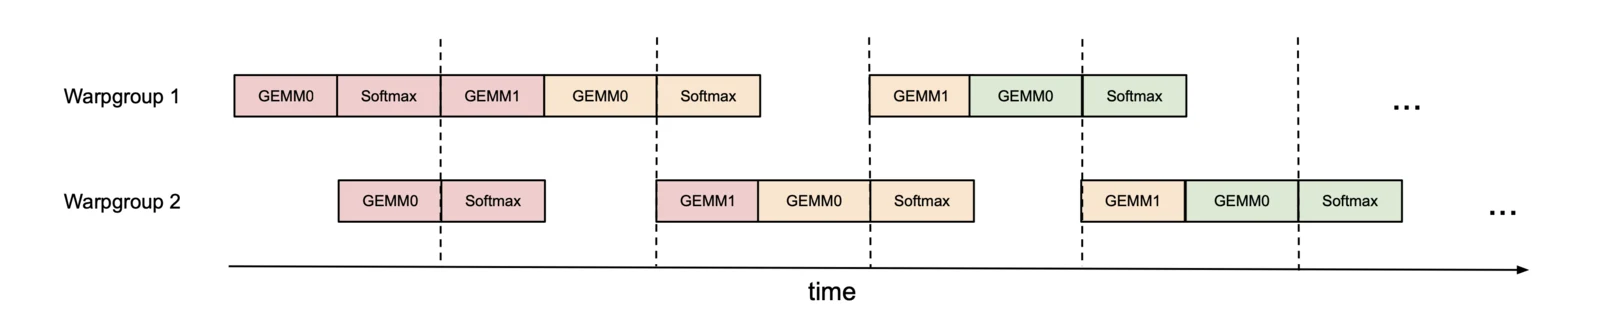
图源:FlashAttention-3 论文(arXiv:2407.08608) Figure 1。一个 warpgroup 做 softmax 时另一个做 GEMM,角色随迭代互换。这类 kernel 的启动参数与调度假设都与 FlashInfer 完全不同,但在 SGLang 里它们共享同一个 AttentionBackend 契约——这就是契约层存在的全部意义。FlashAttention 的完整拆解可参考站内的 FlashAttention 完全拆解(一):IO 感知与分块注意力算法 与 FlashAttention 完全拆解(三):Warp 特化异步流水线与 FP8 低精度。
torch_native 是另一类极端:它用 PyTorch 原生算子拼出注意力(含对分页与滑窗的朴素处理),性能远不及专用 kernel,但作为正确性参考实现无可替代——新后端出数值问题时,第一步永远是切到 torch_native 对比输出。aiter(ROCm)与 ascend(昇腾)则说明这套契约不止服务 NVIDIA:平台后端只需实现同样的方法族,装配链、包装器、CUDA Graph 协作逻辑全部复用(NPU 的 forward_mixed 分支就是契约里预留的平台入口)。
层与后端的边界:RadixAttention 与 ForwardContext
后端契约的另一面是「谁在调用它」。注意力层的实现类是 RadixAttention,构造参数记录了它与后端的全部接口面:
class RadixAttention(nn.Module): def __init__(self, num_heads, head_dim, scaling, num_kv_heads, layer_id, logit_cap=0.0, v_head_dim=-1, sliding_window_size=-1, is_cross_attention=False, pos_encoding_mode="NONE", attn_type=AttentionType.DECODER, ...): ... self.tp_q_head_num = num_heads self.tp_k_head_num = num_kv_heads self.head_dim = head_dim self.layer_id = layer_id self.logit_cap = logit_cap self.sliding_window_size = sliding_window_size or -1这些字段正是后端执行时逐层读取的属性:layer_id 选 KV 缓冲与 metadata 索引、sliding_window_size 决定 wrapper 分派与 window_left、logit_cap 传给 kernel 的 logits_soft_cap、tp_*_head_num 参与视图重整与 plan 头数上界、layer.k_scale/v_scale 决定 KV 写入时的量化缩放。
主路径的调用只有一行:
return get_attn_backend().forward(q, k, v, self, forward_batch, save_kv_cache, **kwargs)注意 get_attn_backend() 是从上下文取,而不是 self.attn_backend。forward_context.py 里 ForwardContext 是一个冻结的 dataclass:
@dataclass(frozen=True, slots=True)class ForwardContext: attn_backend: AttentionBackendModelRunner._forward_raw 在每次前向开始时发布一份新上下文;需要「这次调用换一个后端」的路径(PDmux 的按流后端、冻结 KV 的 MTP 草稿循环、TBO 的逐子批次执行)用 dataclasses.replace 造一个覆盖版本,再用 forward_context() 上下文管理器圈住作用域。为什么不干脆让模型持有后端引用?因为模型模块在多层嵌套里、还可能被 torch.compile 追踪,模块属性是静态结构;而后端的切换需求(按子批次、按流)是调用期的。把一个冻结上下文按前向调用发布,既保证了「模型读到的后端就是这次前向该用的后端」,又让覆盖是局部、可恢复的。文件头注释还说明了线程模型:_current 是普通模块级全局而非 thread-local,因为每个 worker 进程里前向在单线程上同步执行——这是一个被明确论证过的简化。
save_kv_cache 参数是层与后端的另一条边界。层把当前计算的 k/v 张量交给后端,由后端决定什么时候、以什么缩放写进哪种内存池:
# FlashInfer forward_decode 内if k is not None and save_kv_cache: self.token_to_kv_pool.set_kv_buffer( layer, KVWriteLoc.for_layer(forward_batch, layer, swa_loc=self.forward_metadata.swa_out_cache_loc), k, v, *self._kv_write_scales(layer), )写 KV 必须放在后端有三个原因:其一,写目标是双空间的——当层是滑窗层且服务启用了 SWA 专用池时,新 KV 同时写全量池与滑动窗口池,KVWriteLoc 负责按层选择写入位置,而这个知识只存在于元数据里;其二,缩放参数(k_scale/v_scale)挂在层上但解量化路径由后端的 kernel 决定,写与读必须用同一套缩放语义;其三,save_kv_cache=False 是合法路径(例如 cross-attention 的编码器层、以及从池里直接取 KV 的路径),后端需要有能力跳过写入而照样计算。
层里还藏着两条特化路径,它们展示了稀疏注意力时代这一层的扩展方向。其一是 unified_sparse_attention_with_output:当模型的稀疏注意力层带索引器(indexer)输入(idx_q/idx_k/idx_v)时,注意力层不再只返回一个输出张量,而是返回 (idx_out, attn_out) 两个——索引器的中间得分与注意力输出在同一个融合 op 里产出。其二是输出缓冲的 dtype 规则(_new_attention_output):输出 dtype 跟随 v(模型 dtype),且 FP8 的 q/v 被显式提升回 bf16——因为「FP8 的 KV 缓存」不意味着「FP8 的注意力输出」,用 fp8 dtype 分配输出缓冲会引发一次静默的精度截断。稀疏注意力后端的完整机制可参考站内的 NSA 原生稀疏注意力(二):Triton Kernel 设计与 27B 模型实验,那里拆过 DSA 在 SGLang 中的工程落地。
与 CUDA Graph 的协作:后端必须配合的三件事
上一章讲过 ModelRunner 如何在 decode 整图重放、prefill 分段图和 eager 三条路径间分派。注意力后端在这三条路径里都有明确的配合义务,这些义务是「后端为什么必须是一个有状态对象」的直接原因。
第一件:预分配地址固定、内容可变的缓冲
CUDA Graph 捕获后,图内 kernel 引用的张量地址被冻结。分页索引每轮都变,所以正确的做法是预分配足够大的缓冲,每轮只刷新内容。FlashInfer 的 init_cuda_graph_state 就干这件事:
def init_cuda_graph_state(self, max_bs, max_num_tokens, kv_indices_buf=None): self.cuda_graph_kv_indices = [torch.zeros(最大页数, dtype=torch.int32, device=...)] self.cuda_graph_kv_indices += [x.clone() for _ in range(self.num_wrappers - 1)] # wrapper 组里每个 wrapper 一份,避免共享导致互相踩踏
def _create_decode_wrappers(self, bs, num_tokens): return [DecodeWrappers(int_workspace_buffer=..., page_size=1, paged_kv_indptr_buffer=self.kv_indptr[i][: num_tokens + 1], paged_kv_indices_buffer=self.cuda_graph_kv_indices[i], paged_kv_last_page_len_buffer=self.kv_last_page_len[:num_tokens], ...)]要点有三:缓冲按 max_bs/max_num_tokens 上界分配,重放时按当前真实 bs 取切片视图([:num_tokens+1]),切片与原缓冲共享地址;每个 wrapper 一份独立缓冲,因为滑窗层与全注意力层若共用一个 kv_indices 缓冲,捕获出的两个 kernel 会互相覆盖;缓冲初始化为 0(第 0 项按约定归零),因为捕获阶段会真实执行一遍。
捕获时哪些内容应该清零还有一条具体规则:捕获阶段把 cuda_graph_swa_out_cache_loc[:n] 清零、重放阶段才 copy 真实值。原因是捕获时还没有真实批次,缓冲里残留的旧页号会被录进图并被 kernel 读到(用于写 KV 的定位),必须清成一个安全值。
第二件:分离「捕获时算一次」与「每次重放前刷新」
init_forward_metadata_out_graph(fb, in_capture) 的 in_capture 参数就为此存在。捕获时(in_capture=True)需要额外做几类事:
- 调用
_prepare_cuda_graph_metadata(bs, num_tokens, forward_mode, spec_info)为这个bs建好 wrapper 组并存入decode_cuda_graph_metadata[bs]; - 把
begin_forward换成无同步版本。源码在捕获时执行:
if in_capture and forward_mode.is_decode_or_idle(): for w in self.decode_cuda_graph_metadata[bs]: w.begin_forward = partial(fast_decode_plan, w)fast_decode_plan 的意义:标准的 FlashInfer plan() 需要读主机侧的序列长度信息,会触发多次 D2H 同步;而在重放路径上,这些信息其实已经在捕获时确定(或由重放前的 host 侧调用提供),每次重放再同步一遍会把 CPU 卡在正在执行的图后面。注释里对 DFLASH target-verify 那条分支写得更直白:换成 sync-free 的 plan 可以「删除每次重放的三个阻塞式 .to("cpu") 读取」。这是 CUDA Graph 与主机侧调度耦合处最典型的性能陷阱——图本身没有同步,但准备元数据的代码有。
- 把 SWA 写目标缓冲绑定到元数据上(
self.forward_metadata.swa_out_cache_loc = self.cuda_graph_swa_out_cache_loc[:n]),保证图内 kernel 引用的地址稳定。
第三件:声明元数据是否被图跨断点引用
上一章的 Breakable CUDA Graph(BCG)需要把 eager 段插进捕获过程,此时一个后端可能把自己的元数据张量交给 kernel 跨图断点使用。契约为此留了两个钩子与一组标志:
use_captured_forward_metadata_for_breakable_cuda_graph: bool = Falseprefill_cuda_graph_max_batch_size: Optional[int] = None
def init_forward_metadata_for_breakable_cuda_graph_capture(self, forward_batch): """Create forward metadata whose tensor addresses will be graph-captured.""" raise NotImplementedError()
def prepare_forward_metadata_for_breakable_cuda_graph_replay( self, capture_metadata, forward_batch, *, static_forward_batch=None) -> None: """Refresh captured metadata for the current batch before BCG replay.""" raise NotImplementedError()语义是:选择加入(opt-in)的后端在捕获阶段创建元数据对象(地址被录进图),在每次重放前原位刷新其动态字段。选择不加入的后端则每次重放前重建元数据(地址本来就不进图)。前者省掉每轮的对象构造,代价是后端必须保证「所有被 kernel 读的字段都在刷新范围内」;后者更简单但更贵。把这个选择交给后端自己声明,是因为只有后端知道自己的元数据张量有哪些会被 kernel 跨断点读到。
与之配套的还有 SharedReadEnds 声明(前面讲过的 PRE_REPLAY/IN_REPLAY/UNKNOWN):BCG 在发布「重放前事件」之前,需要知道后端是否已经读完调度器共享的数据,才能安全地让 CPU 侧继续准备下一轮。没有这个声明,BCG 就只能对每个后端都套整前向的粗粒度栅栏,流水线收益归零。
一次 decode 前向的完整时序
把本章所有线索收拢成一条端到端时序,以 FlashInfer 后端、单 TP rank、开启 CUDA Graph 的 decode 为例:
ModelRunner 每轮: 1. 构造/复用 ForwardBatch(上一章) 2. backend.init_forward_metadata_out_graph(fb, in_capture=False) - 按 forward_mode 进入 decode 分支 - indices_updater_decode.update(seq_lens, ..., decode_wrappers=..., plan=kv_loc_plan) - 构造 kv_indptr(前缀和) - pack_read_stream 把「请求槽 × 逻辑位置」翻译为物理页号写入 kv_indices - 刷新 kv_last_page_len - wrapper.begin_forward(...) (重放路径下为 fast_decode_plan,无 D2H) - self.forward_metadata = DecodeMetadata(decode_wrappers, swa_out_cache_loc=...) 3. backend.init_forward_metadata_in_graph(fb) (默认 no-op,或静态形状小算子) 4. 发布 ForwardContext(attn_backend=self.attn_backend) 5. 模型前向 → 第 L 层 RadixAttention.forward - k/v 视图整形 - get_attn_backend().forward(q, k, v, self, fb, save_kv_cache=True) - forward_decode(...) - set_kv_buffer(KVWriteLoc.for_layer(...)) 写新 KV - decode_wrapper = metadata.decode_wrappers[self._get_wrapper_idx(layer)] - decode_wrapper.forward(q, kv_cache, sm_scale, logits_soft_cap, k_scale, v_scale) - 返回 o.view(-1, tp_q_head_num * v_head_dim) 6. logits → sampler(后续章节)第 2 步与第 5 步的划分是本章最重要的结构:元数据构造只做一次、覆盖整批所有层;kernel 执行做 次、每次只看当前层的属性。任何「把逐层逻辑塞进元数据构造」或「把批次逻辑塞进逐层执行」的改动,都会破坏这个划分并带来难以定位的性能与正确性问题。
还需要强调一点:seq_lens、seq_lens_cpu、seq_lens_sum 三个字段在后端里的用法完全不同。seq_lens 是设备张量,进 kernel;seq_lens_cpu 是主机镜像,用于需要主机侧判断的地方(例如 FlashMLA 的 eager_max_k = seq_lens_cpu.max().item() 来决定块表大小);seq_lens_sum 是 KV 页总数,用来预分配页表缓冲的尺寸。后端契约里的 needs_cpu_seq_lens 标志之所以重要,就是因为它控制了 seq_lens_cpu 这个主机镜像是否必须每轮同步——只有真正会读它的后端才应该为此付 D2H 的代价。
与 vLLM 的对照
本系列已经用大量篇幅拆过 vLLM 的注意力后端(vLLM 源码完全拆解(六):Attention Backend 如何统一 FlashAttention 与 FlashInfer)。两者解决同一问题,但组织方式不同,对照能看清哪些是本质约束、哪些是工程口味。
| 问题 | vLLM V1 | SGLang |
|---|---|---|
| 后端选择 | AttentionBackendEnum + 平台默认,按 AttentionGroup 分组 | 字符串名 + 注册表 + Resolved(prefill, decode) 对 |
| prefill/decode 分离 | 由 AttentionGroup 与 per-layer 后端组合表达 | HybridAttnBackend 显式持两个完整后端并按模式路由 |
| 元数据准备 | AttentionMetadataBuilder 按后端族实现 | AttentionBackend.init_forward_metadata_* 三方法契约 |
| CUDA Graph | 图输入缓冲 + AttentionMetadataBuilder 的捕获/重放钩子 | out_graph/in_graph 拆分 + use_captured_forward_metadata_for_breakable_cuda_graph |
| 层侧调用 | 注意力层从全局后端注册表取当前后端 | 层从 ForwardContext 取当前后端(可调用期覆盖) |
| KV 写入 | 后端决定写页表 | KVWriteLoc.for_layer + 双池(全量/SWA)写入 |
两处最有价值的差异。第一,vLLM 用「元数据构建器」分离构造与执行,SGLang 用「同一个后端对象的两个方法族」。vLLM 的 builder 是一个独立类,与 backend 分开注册;SGLang 把构造与执行放进同一个对象,靠 forward_metadata 字段传递结果。前者让「同一后端换一个 builder」可行,后者让「后端私有状态」更容易被整体捕获/快照(BCG 的快照逻辑就依赖 forward_metadata 是后端的一个可读属性)。第二,SGLang 用 ForwardContext 做调用期后端覆盖,vLLM 侧等价能力通过 per-layer 后端与组内分派表达。当同一进程里要按子批次/流切换后端(TBO、PDmux)时,调用期上下文比静态分组更直接。
共同的本质约束有两条:其一,元数据必须是批次级、每轮重建,因为它是「本轮这批请求读哪些 KV 页」的答案,无法跨轮复用;其二,层侧的接口必须窄——只传 q/k/v、层描述、批次描述,不传任何 HTTP、文本或调度队列状态。这两个约束是框架级注意力抽象的由来,与具体实现无关。
工程取舍与调试建议
读这一层源码时,有几个坑值得提前标注。
第一个坑:num_qo_heads 的过度规划。 FlashInfer 把查询头数烘焙进 plan,源码的处理是「按批内最大头数规划」。如果自定义后端或改了层头数配置,一定要确认 plan 用的是最大值而非某一层的值——欠规划的错误是静默的数值错误,不会抛异常。这也解释了为什么 HybridAttnBackend 需要在初始化时就把两侧后端的 head 上界对齐。
第二个坑:in_capture 语义的漂移。 新契约把捕获与重放合并进 out_graph(fb, in_capture),只有在 body 确实分叉时才读这个参数。新增后端时若在 in_graph 里写了会触发 .item() 的分析代码,问题不会在捕获时报错,而是在重放时表现为「第一轮正确、第二轮开始数值漂移」——因为被录进图的是一次性分析结果。源码注释里那句 lint 约束就是为此写的。
第三个坑:SWA 双池的写入位置。 当服务用 SWA 专用 KV 池时,新 KV 的写目标由 KVWriteLoc.for_layer 决定;读目标则由元数据里的 swa_out_cache_loc / window_kv_indptr 决定。写错池的表现是「长上下文质量正常但滑窗层读到陈旧 KV」,短测试很难发现。调试时可以临时关闭 SWA 池,对比输出是否一致。
第四个坑:SharedReadEnds 与重叠调度的耦合。 自定义后端若不覆写 shared_read_ends 而默认走 UNKNOWN,BCG 会退回粗粒度栅栏,功能正确但流水被打断;若声明了 PRE_REPLAY 却实际把共享张量的读保留到了模型前向,就会在重叠调度下读到被改写的数据。声明与实现必须一致,这是这一层唯一要求「作者自证」的地方。
调试顺序建议:先用 --attention-backend torch_native 建立正确性基准,然后换到目标后端复现同一输入;出现数值差异时依次检查——plan 的头数参数、KV 缩放是否两边一致、滑窗层的窗口参数、以及 seq_lens_cpu 是否真的等于设备侧 seq_lens(这两者不一致是混合了缓存命中的批次里最常见的一类错误)。
小结
注意力后端层可以压缩成四句话。
契约有四个面:init_forward_metadata 三方法族(eager 包装、out_graph 主机侧准备、in_graph 图内静态算子)负责每轮一次元数据编译;forward 模板方法按 ForwardMode 把执行分派给 forward_decode/forward_extend(idle 分支不执行 kernel、返回形状正确的空缓冲);init_cuda_graph_state 与 get_cuda_graph_seq_len_fill_value 负责 CUDA Graph 的地址稳定与捕获填充值;verify_mask、kv_index_translator、needs_cpu_seq_lens、SharedReadEnds 等声明让上层「问而不猜」。
装配有三段:注册表是一个装饰器加一张字典,工厂内延迟导入并按 MLA/非 MLA 二次分派;解析产出 (prefill, decode) 字符串对,允许两个阶段使用不同后端(草稿 worker 走独立覆盖);构建阶段按部署形态分出 SSM、PDmux 多流组、TBO 双子后端与默认单实例,prefill ≠ decode 时套 HybridAttnBackend 按模式路由,混合架构模型再套 attn_backend_wrapper 分流线性注意力层。
元数据编译的本质是语言翻译:把 ForwardBatch 里的请求槽与逻辑位置翻译成 kernel 能吃的物理页索引——FlashInfer 用 kv_indptr/kv_indices/kv_last_page_len 三件套加 plan/forward 分离;Triton 用 ForwardMetadata 把 split-KV 切分显式化;FlashMLA 用 64-token 块表与 get_mla_metadata 的 tile 调度把调度计算移出主循环。extend 阶段按前缀命中与否在 ragged 直算与 paged+merge(在线 softmax 状态合并)之间选择。
与图和调度的耦合全部落在后端身上:预分配地址固定、内容可刷新的缓冲;in_capture 时把 plan 换成无同步版本、绑定 SWA 写目标;用 use_captured_forward_metadata_for_breakable_cuda_graph 声明元数据是否进图、用 SharedReadEnds 声明共享数据的读取终点。这些声明合起来回答了一个问题:为了让 GPU 图与 CPU 调度正确重叠,后端必须证明自己何时读完哪些数据。
下一篇沿路线图继续向下进入「CUDA Graph 与编译路径」:解码整图的捕获与重放、prefill 分段图(BCG)如何把 eager 断点插进捕获过程、torch.compile 分段编译与图捕获如何协同,以及静态形状约束如何向调度器反馈(批次尺寸分桶、显存账本)。本章只讲了后端在其中的配合义务,下一篇会补齐图机制本身。
参考资料
- SGLang 官方 GitHub 仓库
- SGLang: Efficient Execution of Structured Language Model Programs(arXiv)
- AttentionBackend 抽象类源码(固定提交)
- 注意力后端注册表源码(固定提交)
- 后端装配链源码(固定提交)
- FlashInferAttnBackend 源码(固定提交)
- TritonAttnBackend 源码(固定提交)
- FlashMLABackend 源码(固定提交)
- HybridAttnBackend 源码(固定提交)
- TboAttnBackend 源码(固定提交)
- RadixAttention 注意力层源码(固定提交)
- ForwardContext 源码(固定提交)
- FlashInfer: Efficient and Customizable Attention Engine for LLM Inference Serving(arXiv)
- FlashAttention-3: Fast and Accurate Attention with Asynchrony and Low-precision(arXiv)
- FlashInfer 官方文档
- FlashInfer 完全拆解:把分页 KV、动态批处理与定制注意力编译成服务级 Kernel
- vLLM 源码完全拆解(六):Attention Backend 如何统一 FlashAttention 与 FlashInfer
- vLLM 源码完全拆解(七):PagedAttention Kernel 如何遍历分页 KV 并完成稳定 Softmax
- SGLang 源码完全拆解(五):KV 内存池与 RadixCache 的所有权闭环
- SGLang 源码完全拆解(七):ForwardBatch、TpModelWorker 与 ModelRunner
- CUDA Graph 完全拆解:从逐次 Kernel Launch 到可重放推理执行图
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



