


JSSA 完全拆解:联合 query-key 子空间打分与 gather-free 内核,训练无关的 token 级稀疏解码
这份工作想解决什么
长上下文自回归解码的瓶颈,在于每生成一个 token,都要把不断增长的 KV cache 完整读一遍。以 full attention 为例,解码第 步时,当前 query 要对整个上下文打分,再把所有对应的 value 读回来——访存量随序列长度线性增长。而在 远大于 1 的解码阶段,注意力是典型的访存带宽受限算子:算术强度极低,绝大部分时间花在把 K、V 从 HBM 搬进 SM,而不是花在乘加运算上。于是”少读一点 KV”就成了加速长上下文解码最直接的杠杆。
稀疏注意力正是从这条杠杆出发:每一步只选上下文的一部分参与计算。现有做法在粒度上分成两派。块级/页级方法(QUEST、SeerAttention-R 一类)天然对齐分页 KV cache 布局与 block-sparse 内核,代价是一次选中一页,页内那些其实无关的 token 也会被一起读进来。token 级方法(SparQ、TokenSelect、Loki、FASA 一类)逐个位置挑选,粒度最细,理论上能表达更精细的稀疏模式——但这种灵活性一直没有稳定地转化成”更高的精度”或”更低的延迟”。
JSSA(Joint Subspace Sparse Attention,联合子空间稀疏注意力)就是冲着这两件事来的。论文由 Jiwon Song、Yoongon Kim、Jae-Joon Kim 完成,2026 年 10 月 13 日提交到 arXiv(编号 2610.19026,cs.CL 分类),是一篇训练无关(training-free)的方法:不改任何模型参数,只在推理侧做一次廉价校准。
一句话概括它的核心主张:token 级稀疏之所以没兑现潜力,卡在两个具体环节——打分基选错了目标,以及选出 token 之后 gather 的开销把加速吃掉了。JSSA 分别给出了两个对应答案:
- 联合 query-key 子空间:不再像 Loki 那样只重建 key,而是直接最小化 双线性打分的误差。这个目标非凸,作者求出一个上界,上界有闭式谱解——取归一化后 query 与 key 二阶矩之和的前 个特征向量,构成打分基。
- gather-free 索引注意力内核:在 GQA 布局下,每个 KV head 选出各自不同的 token 集合,用一个 Triton kernel 原地读取散落的 KV,不必先把它们拷贝到连续缓冲区。
论文给出的结果口径是:在 NVIDIA B200 单卡上,128K 上下文时解码吞吐最高达到 full KV 的 6.43 倍;在约 700B 参数规模上,事后(post-hoc)校准的 JSSA 在推理准确率上与模型原生的 DSA 相当,解码吞吐达到 DSA 的 96%–99%,且完全不需要训练。
两个动机:为什么 token 级稀疏”卡住了”
论文的第 2 节把问题拆得很清楚,值得原样复述,因为后面所有设计都从这两个观察长出来。
动机一:低维打分需要一个正确的目标。 token 级选择要为每一个候选 token 打分,这与页级方法不同——页级方法在序列轴上降本(一页一个分数),token 级方法保留了每一个位置作为候选,因此只能在通道维上降本,用一个低维子空间来近似全维打分。降维的方式有两种:
- 离散通道选择:只保留原始通道里的若干维,FASA 走这条路(选原始 RoPE 通道)。
- 任意低秩投影:把打分向量投到一个任意的低秩子空间,Loki 走这条路(在 key 重建子空间里打分)。
论文指出,离散通道选择其实是正交投影的一个受限形式——保留原始通道等价于取标准基向量。所以任意投影理论上更灵活。但”更灵活”不等于”排序更准”:子空间必须用一个能保住 query-key 交互的目标来选。论文用实验说明了这个差别:在 LLaMA-3.1-8B-Instruct 上比较 Loki 与 FASA 的 LongBench 精度随通道预算的变化,FASA 的离散通道选择在每一个评测 rank 上都优于 Loki 的 key 重建投影,预算越紧差距越大。这个对比直接指向了 JSSA 的取舍:打分子空间应该保住 query-key 的交互,而不是只保住 key 的表示。
动机二:gather 开销限制了 token 级的加速上限。 即使选择准确,token 级稀疏还面临一个独立的系统问题:细粒度选择会产生不规则索引集,它们映射不到常规注意力内核支持的布局上。于是典型实现会把选中的 KV 条目先 gather 到一个连续缓冲区,再调用一个 dense 注意力内核。论文在 LLaMA-3.1-8B-Instruct、128K 上下文下对比了”先 gather 再 attend”与”KV 已经在连续缓冲区里、直接对同样选中的 token 做缩减注意力”两种情形:稀疏化确实大幅降低了总延迟,但 gather 本身的耗时与缩减后的注意力计算相当,在 batch size 16 时占残差延迟的一半以上。也就是说,把选中的 KV 物理地搬一遍,会吃掉 token 级稀疏带来的相当一部分收益。
这两条观察合起来给出了两个互补的要求:一个能保住 token 排序的低维打分子空间,以及一个能直接访问选中 KV 条目的注意力内核。
JSSA 的整体结构
JSSA 的执行流程可以概括成图 1 的样子:在每一个解码步、对每一个 KV head,用隶属于它的那些 query head 的均值 query 去和一个低维投影 key cache 打分,选出 top- 的 token 位置;这些 query head 共享这个 per-KV-head 的索引集;最终的注意力计算仍然使用原始全维度的 q、k、v。
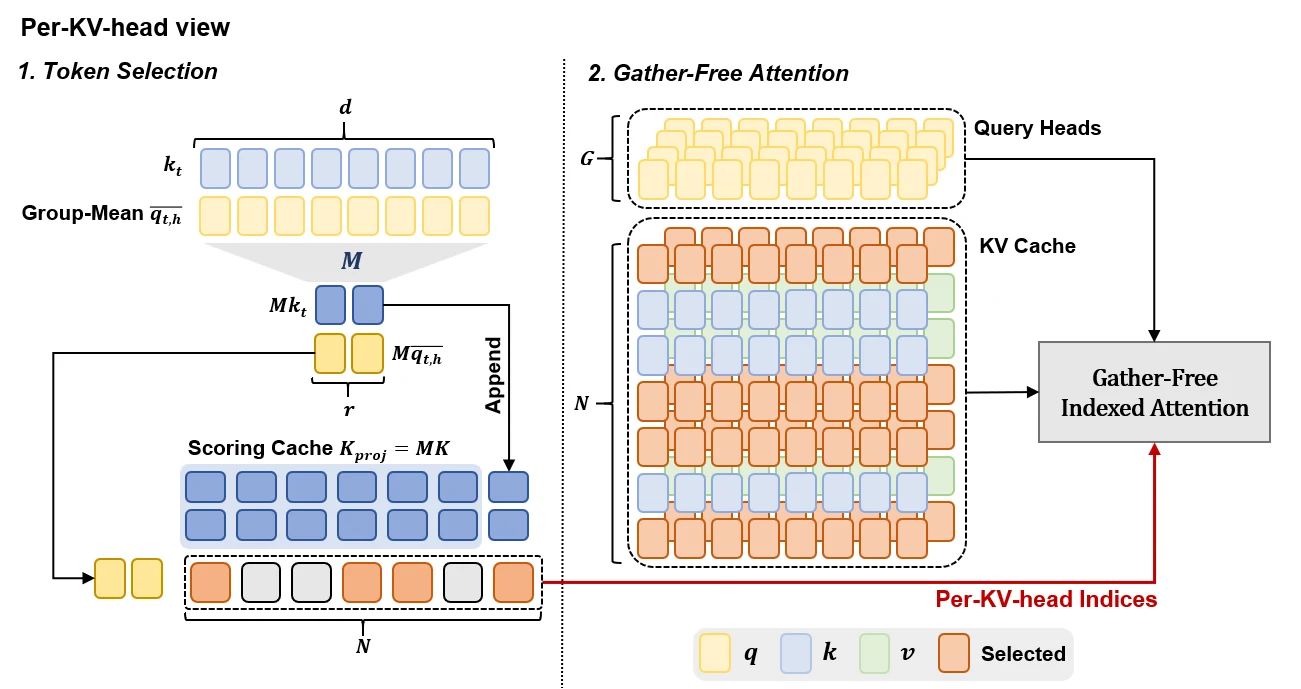
图 1:JSSA 单步解码流程。来源:论文 Figure 1。
围绕这条主链路,JSSA 有三个部件,分别对应三个小节:
- 联合 query-key 子空间(第 3.2 节):为每一层、每一个 KV head 学一组正交基 ,满足 。注意这里query 和 key 用的是同一组基,这一点和 KQ-SVD 那类非对称的 query/key 分解不同。
- gather-free 索引注意力(第 3.3 节):一个 Triton 内核,每层启动一次,内部自行解析每个 head 的索引集,把 query head 映射到它所属 KV head 选出的索引上,就地访问对应的 K、V。
- 投影打分缓存(第 3.4 节):额外维护一份只用于打分的低维 key cache(),最终注意力仍然读原始全维 KV。
这里先交代一个关键的设计分层,它贯穿全文:打分行低维、注意力行全维。打分缓存只服务于 token 选择,选完之后真正的注意力仍然吃原始 BF16 的 K、V。这意味着低维投影带来的近似误差只会影响”选哪些 token”,而不会直接污染注意力输出的数值。这条分层也是 JSSA 与 EigenAttention、KVTC 这类”在降维空间里直接算注意力”的工作的根本区别——后者替换或压缩了最终注意力消费的表示,JSSA 不碰它。
原理详解(一):联合 query-key 子空间
这一节是全文技术含量最高的部分,值得逐式拆开。
打分误差的定义
GQA 下,一个 KV head 关联 个 query head。token 选择用的是这些 query head 的均值 query:
设 是 rank- 的正交投影算子。投影后的分数是
而真实的双线性分数是 。两者的差就是投影丢掉的成分:
这个式子很直观:误差完全来自”被投影算子 扣掉的那部分空间”。如果 或 有任何分量落在被扣掉的方向上,这个分量就会造成打分偏差。
为什么不能只重建 key
Loki 的目标是让低维表示能重建 key,也就是最小化 。这个目标只关心 key 自身的重构保真度,完全不看 query。问题是 token 排序由双线性分数 决定,而不是由 本身决定。一个在 key 重建意义下很好的子空间,可能恰好把 query 能量最集中的那些方向扣掉了,于是打分排序大乱。反过来,FASA 的离散通道选择(等价于从标准基里挑几个方向)保住了原始通道,虽然没有”优化”任何目标,但因为原始通道通常已经承载了主要能量,反而在实践中更稳。
JSSA 的结论是:目标应该直接写成打分误差的期望平方。这样它天然是 query-key 交互驱动的,而不是 key 表示驱动的。
乘积边缘分布:校准目标为什么要这样定义
这里有一个容易被忽略但很重要的细节。校准阶段收集到的 和 是同一序列位置上的配对激活,但运行时 selector 的使用方式是:每一个解码 query 要和上下文里的每一个 key 比较,而不是只和同位置的 key 比较。所以校准目标不能定义在同位置配对上,而要定义在独立抽样上——即 query 边缘分布与 key 边缘分布的乘积分布 上。
记校准得到的 group-mean query 与 key 的经验边缘分布为两个 矩阵。上面这个构造(论文附录 B.1 的”乘积边缘分布”公式)保证了目标测度的是”推理时可能被比较的 query-key 组合”上的投影打分误差。同时,因为是乘积分布, 与 在构造上独立,所以对任意函数有
这个因式分解是后面推导上界的关键工具。论文特别澄清:它不主张同位置观测到的 query 与 key 激活在经验上是独立的,只是一个用于构造校准目标的分布假设。
迹归一化:防止 key 边缘主导
设二阶矩矩阵
论文对两个边缘分别做单位迹归一化:
为什么要归一化?论文给出了实测数据:在 LLaMA-3.1-8B-Instruct 上,group-mean query 与 key 的平均迹比约为 0.019(这个量级由论文附录给出),也就是说未归一化的 比 大将近两个数量级。如果不做归一化,求和式会被 key 项压倒,解出来的基就会退化成”像 key 重建一样的子空间”——正是 JSSA 想避免的东西。单位迹归一化给 query 与 key 边缘相等的总权重,同时保留各自的内部谱结构。
效果是可测的。论文表 9 报告了归一化对 oracle top- 召回的影响:在 LLaMA-3.1-8B-Instruct 上,token 预算 256 时召回从 70.05% 提到 71.34%(+1.29 点),预算 2048 时从 74.92% 提到 75.94%(+1.02 点)。绝对增益不大,但它的作用是”防止边缘代理目标被更大的 key 二阶矩主导,从而保住它本来想表达的联合 query-key 性质”——这也解释了为什么这个看似微不足道的归一化必须写进方法里。
精确目标与它的上界
归一化之后,精确的选择目标是
把它读一遍: 把两个边缘投影到被扣掉的补空间上, 与 是被投影掉的那部分二阶矩,迹就是”误差在这个补空间里的期望平方”的度量。当 越接近能覆盖 query-key 主要能量的子空间,这个迹越小。
这个目标非凸,也没有通用的闭式解。论文的做法是求一个可处理的上界。对任意正交投影算子 ,定义
则有
推导思路(附录 B.3):因为 是半正定对称的,用它诱导的半范数下有 Cauchy–Schwarz;取期望并用乘积边缘分布的因式分解,得到两个边缘误差项的乘积;再用 AM–GM 把乘积放缩成平方。中间的细节在于取期望那一步依赖因式分解
也就是”误差的平方期望 = 两个边缘误差的乘积”。
这个上界有个非常重要的性质:推导不需要 与 可交换。论文实测了两者的归一化对易子比值,在 LLaMA-3.1-8B 上平均为 0.0504、中位数为 0.0241(见附录 B.3),说明”共享特征基”这个特例在经验上不成立。这一点决定了 JSSA 不能简单地”对某个矩阵做特征分解然后假装同时对角化了两个矩阵”,而必须走”求和后再分解”的代理路线。
闭式谱解
代理目标 的最优解有闭式形式:
其中 表示取矩阵 的 top- 特征向量,按列排成 的矩阵。也就是说:把归一化后的 query 二阶矩与 key 二阶矩相加,做一次特征分解,取前 个特征向量作为打分基的行。基的转置就是 的列——即 个基向量。
论文特别注明边界:这个上界提供了可处理代理,但不保证紧致性,也不保证全局最优。这是一句诚实的免责声明,后面用实验补上了”它够用”的证据。
直接优化精确目标:为什么没必要
既然代理只是个上界,自然的疑问是:从 出发,再对精确目标做梯度优化,能不能拿到更好的基?论文做了这个实验并给出了否定的答案,而且做得相当彻底(附录 B.4):
- 在 Stiefel 流形上做 retraction 梯度下降,行正交约束用 QR retraction 维持:,走 1600 步,无动量。
- 对 LLaMA-3.1-8B-Instruct 的全部 256 个 layer–KV-head 基并行优化,每个 layer–KV-head 有独立的目标与基。
- 学习率扫了三个数量级。
结果(论文表 10、表 11):直接把精确目标降下去的幅度在 时最多 0.005, 时最多 0.05;精炼后的子空间与谱初始化几乎重合—— 时重叠度至少 0.998841, 时至少 0.989120。换算到真正的目标函数上,oracle top- 召回基本不变:LLaMA-3.1-8B 在 、预算 256 时从 48.76% 到 48.74%,预算 2048 时 53.81% 到 53.81%;、预算 256 时 71.34% 到 71.36%,预算 2048 时 75.94% 到 75.95%;Gemma4-26B-A4B-It 在 的五个 global-attention 层上,召回 79.85% 与 83.33% 都一动不动,子空间重叠度正好 1.000000。整体召回变化不超过 0.02 个百分点。这里的”子空间重叠”定义为主角之间平均的余弦平方,即两个子空间完全相同的时候取 1。
论文还做了一个”对照组”,用来证明这不是优化过程卡住了:用同样的欧氏梯度更新加 QR retraction,从随机初始化出发,在同一预算内的确能把目标降下去;但它的最终目标仍比谱初始化差一大截,而且与谱子空间的重叠度只有 0.242()和 0.287()。论文的解释是:谱解已经落在一个平坦、低目标的区域里,从泛型初始化出发在同样的优化预算内很难走到那里。这个论断和”上界不紧”的免责声明是相容的——上界可能不紧,但它的解恰好落在一个很不错的盆地里。
工程含义很明确:校准被压缩成”累积二阶矩 + 每层每 KV head 一次特征分解”,不需要任何迭代优化。
原理详解(二):gather-free 索引注意力
gather 到底贵在哪
要理解 JSSA 这个内核为什么值得单独写一节,得先看清 gather-then-attend 的开销结构。细粒度选择产生的是不规则的索引集:选中的 2048 个位置在 128K 的上下文里散布各处。而常规注意力内核吃的是连续内存块。于是实现上只有两条路:
- 先物化:把选中的 K、V 拷贝到一个连续 staging buffer,再跑 dense kernel。这就是 gather-then-attend。
- 按 head 分别启动:为每个 KV head 单独启动一次稀疏注意力内核,各自处理自己的索引集。启动次数变成 head 数量级,内核启动与调度开销随 head 数线性增长。
论文图 2(b) 的数据说明了第一条路的成本:在 LLaMA-3.1-8B-Instruct、128K 上下文下,把”gather-then-attend”和”KV 已在连续缓冲区时对同样选中 token 做缩减注意力”相比,gather 的开销与缩减后的注意力计算本身相当,并且在 batch size 16 时占残差延迟的一半以上。注意这里”残差延迟”指稀疏化之后剩下的那部分延迟——原本指望靠稀疏省下来的时间,有一大半被搬数据的动作吃回去了。
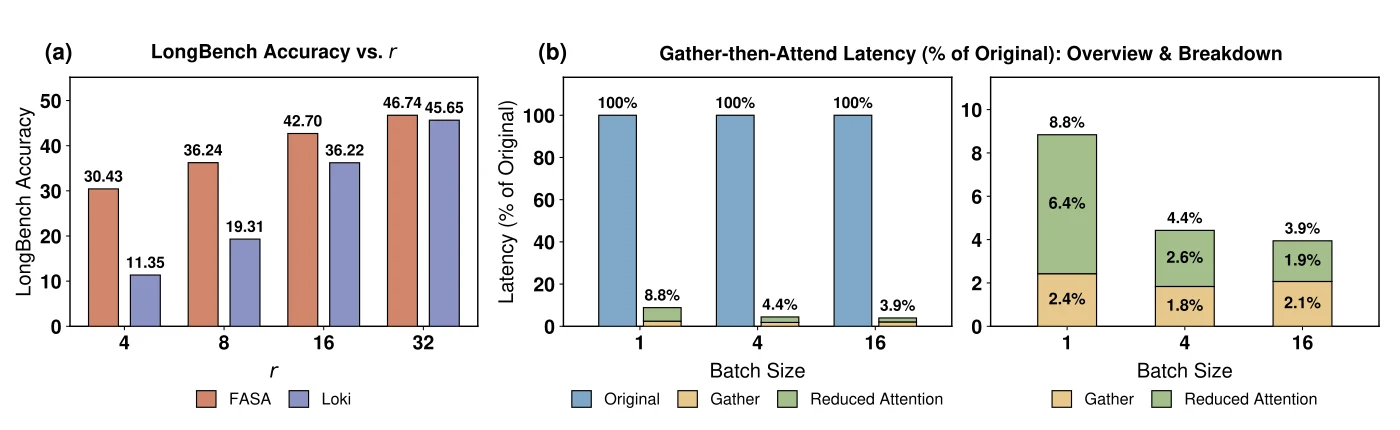
图 2:低维打分目标与 gather 开销两个动机的实测。来源:论文 Figure 2。
不规则索引本身不是障碍
论文在第 3.3 节给了一个很关键的观察,纠正了一个常见直觉:不规则索引本身并不是障碍。原因是单个 token 的 key 或 value 切片在 head 维度上本来就是连续的,所以对这个切片的一次索引读取仍然是一个突发(burst)大小的内存事务。不规则性增加的是事务的数量,而不是降低每个事务的质量——换句话说,散落的 2048 次读仍然是 2048 次高效的 burst 读,只是地址不连续而已。真正的问题不在索引,而在缓存布局。
GQA 布局下的真正难点:per-KV-head 选不同集合
GQA 的 KV cache 布局里,每个 KV head 占据一个独立分区。而每个 KV head 的 query 组不一样,用均值 query 打分后自然会选出不同的 token 集合。这就带来一个矛盾:
- 如果把这一个层里所有 KV head 的选择坍缩成一组共享索引,好处是访问模式规整、实现简单;代价是精度下降。论文附录 E.3 给出了实测:在 RULER 上,用 TokenSelect 那种”软投票”把各 head 偏好聚合成单一 token 集,在 32K 上下文时与 per-KV-head 选择几乎持平,但到了 128K,per-KV-head 选择稳定更好——LLaMA-3.1-8B-Instruct 领先 5.29 点,Ministral-3-8B-Instruct-2512 领先 0.99 点,Qwen3-14B 领先 1.32 点。软投票已经比朴素的等权共享强,但它仍然把不同 KV head 的偏好强行合并了。结论是:保留 per-KV-head 的不同选择,在长上下文下变得重要。
- 如果坚持保留 per-KV-head 的选择,就得面对上面说的两条实现路径:要么物化(gather 贵),要么逐 head 启动(启动贵)。
Triton 内核的三个设计点
JSSA 的答案是写一个 Triton indexed-attention 内核,论文称其为”据我们所知第一个在标准 GQA KV cache 布局下支持 per-KV-head 不同选择的 gather-free token 级注意力内核”。它的做法是:
- 每层只启动一次,而不是每个 KV head 启动一次。启动开销与 head 数解耦。
- 内部自行解析 per-head 索引集:内核在内部把每个 query head 映射到它所属 KV head 选出的那组索引上。
- 就地访问对应的 K、V,不做 staging buffer,也不做连续化拷贝。
这样同时避开了 gather-then-attend 需要的 staging buffer,以及逐 KV head 启动内核对调度器的压力。
有一个必须讲清楚的边界条件:token 打分仍然要扫描全部候选,只有注意力计算本身访问被选中的位置。也就是说 JSSA 并没有让打分变稀疏,它让注意力访存变稀疏。这个边界很关键,因为打分阶段的开销在大 batch 下会成为新的瓶颈(后面的组件级延迟拆解会量化它)。
MLA 为什么没有这个问题
对 MLA(Multi-head Latent Attention)模型,论文指出这个困难不存在:MLA 里每个 token 对每一层只贡献一个共享的 latent 向量,所以 token 选择天然产生单一索引集,正是 FlashMLA 已发布的稀疏内核所针对的场景。因此 JSSA 在 MLA 上直接用 FlashMLA 的稀疏注意力内核执行(Li et al., 2025),不需要自己的 gather-free 内核。
这解释了一个设计取舍:JSSA 把自研内核的工程量集中投在了 GQA 这条更难的路径上,因为 MLA 这条路已经有成熟内核可用。
投影打分缓存与校准成本
缓存尺寸:一个可控的百分比
JSSA 额外维护 作为只用于 token 选择的辅助缓存。对 GQA 模型,论文选 使得 FP8 的投影 key cache 最多占原始 BF16 KV cache 的 6.25%:LLaMA-3.1-8B-Instruct、Qwen3-8B、Qwen3-14B、Ministral-3-8B-Instruct-2512 用 ;Gemma4-26B-A4B-It 的 global-attention 层用 。
6.25% 这个数字和 1.5625% 的关系值得算一下: 相对于典型 head dim,配合 FP8(每元素 1 字节)对 BF16(每元素 2 字节)的减半,正好落到原始 KV cache 的 6.25% 这个量级; 的情形则是 1.5625% 这一档在论文中出现的位置。换句话说,这份辅助缓存的内存代价是”个位数百分比”,而不是”和 KV cache 同量级”。
对 MLA 模型,JSSA 用 128 维打分表示,由 64 维 latent 加 64 维 RoPE 组成——这个构造有个明确目的:与 DSA 的 lightning indexer 总维度对齐,从而让后面的大规模对比是一个”等容量”比较(附录 C 里再次强调:两者总维度都是 128,但构造不同——JSSA 是 64 latent + 64 RoPE,原生 DSA 是学出来的 128 维 indexer head)。
FP8 打分缓存的影响可以忽略
打分缓存全程用 FP8 存储,而最终稀疏注意力用原始全维 BF16 KV。论文附录 E.2 隔离了打分缓存量化的影响:在 LLaMA-3.1-8B-Instruct、Qwen3-14B、Ministral-3-8B-Instruct-2512 上以默认 比较 FP8 与 BF16 投影 key cache,其他配置(投影基、token 预算、最终注意力计算)全部固定。LongBench 平均精度(KV 预算 256)的绝对差是:LLaMA 0.18 点、Qwen3-14B 0.01 点、Ministral 0.05 点——几乎完全一致,同时内存占用减半。
这里体现出”打分缓存只是辅助”这一分层的价值:既然它只决定”选哪些 token”,量化误差的作用路径是间接的(先影响选择、再由选择影响输出),因此对 FP8 的容忍度远高于”直接拿低精度表示去算注意力”的方案。
校准:一次前向 + 一次特征分解
校准流程(附录 A.4)可以逐步骤说明:
- 不改任何模型参数。
- 校准语料用 LongAlign。因为单个样本只到约 64K token,直接用无法让投影基见到 128K 上下文的注意力模式,所以论文先过滤出至少 8K token 的文档,按语料顺序拼接连续文档直到至少 150K token,再中心裁剪到 131072 token。
- 用五个文档为间隔的起始偏移构造 8 条校准序列(拼接窗口可能跨越五个以上文档,因此序列可能重叠)。
- 对每条序列跑一次 dense prefill,为每一层、每一个 KV head 分别累积 group-mean query 与 key 的二阶矩。
- 用闭式解为每层每 KV head 算出一组投影基。对 Gemma4,只对 global-attention 层做校准,local 滑窗层保持不变。
- 全程不用梯度优化、不训练模型、不使用下游评测数据。
校准成本(论文表 7,NVIDIA B200 单卡,端到端墙钟时间):LLaMA-3.1-8B 203 秒、Qwen3-14B 295 秒、Ministral-3-8B 129 秒、Gemma4-26B 365 秒、GLM-4.7-Flash 247 秒。所有被测模型都在 129–365 秒内完成,不需要迭代优化,也不需要模型训练。用一次前向加一次特征分解换来一个训练无关的稀疏解码路径,这个一次性成本相对于训练原生稀疏注意力(例如 DSA 需要的继续预训练)是数量级级别的差距。
校准长度必须覆盖部署上下文
论文附录 A.5 把”校准语料”和”校准长度”的影响分开测了,结论不对称:
- 对语料不敏感:在 LongAlign、NarrativeQA、LooGLE 上校准,基在 32K 与 128K 评测下的 PG-19 困惑度几乎完全相同。LongBench 上精度随语料变化不超过 0.10 点(表 8:JSSA 用 LongAlign 打包 128K 是 49.16,用 Qasper 是 49.13)。
- 对长度敏感:32K 校准的基在 128K 评测时明显退化——困惑度 16.05–18.31,而 128K 校准的基是 11.31–11.48。
论文的结论直接落在工程建议上:校准应覆盖接近最大部署上下文长度的序列。这与动机部分的逻辑是一致的:二阶矩统计的是”哪些方向承载 query-key 能量”,而这个分布随上下文长度变化;用短上下文统计出来的方向在长上下文部署时不再匹配。
顺带一个对照数据(表 8):FASA 对输入构造方式远比 JSSA 敏感——把打包序列换成原始样本,LongAlign 校准下精度改善 2.75 点,Qasper 下改善 2.51 点;而只换语料、不换构造,影响小得多。这说明 FASA 在打包校准下的退化不是特定语料造成的。论文据此为每个方法固定了一套校准构造:JSSA 用打包的 128K LongAlign 序列(让校准覆盖部署上下文范围),FASA 用原始 LongAlign 样本,Loki 因为对两种构造都不敏感所以用打包版。
实验设置:三类注意力架构的覆盖
评测覆盖三类注意力架构,这一点比具体分数更值得注意,因为 token 级稀疏在架构上的可迁移性恰恰是它长期被质疑的地方:
| 模型 | 注意力架构 | 评测 |
|---|---|---|
| LLaMA-3.1-8B-Instruct | 标准 GQA | LongBench / RULER / PG-19 |
| Qwen3-14B | 标准 GQA | LongBench / RULER / PG-19 |
| Ministral-3-8B-Instruct-2512 | 标准 GQA | LongBench / RULER / PG-19 |
| Qwen3-8B | 标准 GQA | 推理 / 吞吐 |
| Gemma4-26B-A4B-It | 混合局部/全局 GQA | 推理 / 吞吐 |
| GLM-4.7-Flash | MLA | 推理 / 吞吐 |
表:模型与评测覆盖(据论文 Table 5 整理)。
两个细节值得展开:
- Gemma4 是混合架构:只有 global-attention 层被稀疏化,local 层保留模型原生的滑窗注意力。所以 JSSA 在 Gemma4 上的加速只来自部分层,这也解释了为什么它的加速比不如其它模型激进。滑窗本身也是一种 KV 有界化手段,可参考 SWA 滑窗注意力完全拆解 里对滑窗与 sink 的讨论。
- MLA 上的 token 选择只产生一组索引:因为 MLA 的每层每 token 只贡献一个共享 latent 向量,选择天然是层级的而非 per-KV-head 的,执行直接用 FlashMLA 的稀疏内核。
对比基线分两类实现方式:Loki、FASA、QUEST 被接进与 JSSA 相同的 vLLM 服务栈,SqueezedAttention、SnapKV、SeerAttention-R、TriAttention 则从各自的官方代码集成到 Hugging Face Transformers。论文对 Loki 还有一个额外的控制实验:让 Loki 复用 JSSA 的投影打分缓存、top- 选择流水线与 gather-free 后端,只把投影目标换成它的 key 重建目标,从而把”投影目标”这一个变量隔离出来。
MLA 上的基线只有 FASA——因为多数现有基线对 MLA 的共享 latent cache 没有直接映射,强行适配要在打分表示与选择语义上引入额外设计选择。FASA 被施加在全部 64 个 RoPE 通道上,这已经用掉了 JSSA 与 DSA 那 128 维打分表示的一半。
测量协议(附录 A.7):单张 NVIDIA B200、张量并行度 1、启用 CUDA graph capture,每次运行从目标上下文生成 128 个新 token;每个配置先跑一次热身,再做三次测量取平均聚合解码吞吐。计时包含投影分数计算、top- 选择、稀疏注意力与其余解码期模型执行;不含模型加载、JSSA 校准、内核编译与热身。原始全维 KV cache 用 BF16,投影打分缓存用 FP8。
实验:长上下文理解与语言建模
LongBench:token 预算 256 下的平均精度
| 模型 | FKV | QUEST | SqueezedAttn. | SnapKV | FASA | Loki | JSSA |
|---|---|---|---|---|---|---|---|
| LLaMA-3.1-8B-Instruct | 48.35 | 46.94 | 47.95 | 43.53 | 46.74 | 45.65 | 49.16 |
| Qwen3-14B | 50.49 | 48.44 | 48.58 | 45.27 | 47.93 | 49.54 | 49.82 |
| Ministral-3-8B-Instruct-2512 | 47.90 | 46.48 | 47.91 | 44.82 | 46.04 | 48.07 | 47.79 |
表:LongBench 平均精度,KV 预算 256 token。FASA、Loki、JSSA 使用 32 维打分表示。数据来源:论文 Table 1。
这张表里有几个值得读的点:
- JSSA 在三个模型上都拿到了最好的(或接近最好的)稀疏结果,与 full-KV 的差距在 0.67 分以内;在 LLaMA-3.1-8B-Instruct 上甚至高于 full-KV(49.16 对 48.35)。稀疏化偶尔”提分”并不神秘——被丢掉的 token 里确实可能包含干扰项,但更重要的是它说明没有出现大幅塌陷。
- 没有任何一个竞争基线在三种架构上一致最强。Loki 在 Ministral 上表现不错(48.07),在 LLaMA 上就只有 45.65;QUEST 稳定但都略低于 JSSA;SnapKV 是最弱的一档。这种”架构依赖的强弱翻转”正是论文反复强调的问题:稀疏方法的表现与模型结构强耦合。
- Loki 的对照实验价值在这里体现:Loki 与 JSSA 共享同一套打分缓存、选择流水线与执行后端,唯一的差别是投影目标(key 重建 vs 联合打分)。LLaMA 上 3.51 分的差距、Qwen3-14B 上 0.28 分的差距,可以直接归因到投影目标本身。
RULER:32K 到 128K 的固定密度预算
RULER 的测法是把 KV 预算按比例固定:32K 上下文用 512 个 token,64K 用 1024 个,128K 用 2048 个。也就是说上下文翻倍时预算也翻倍,相对密度保持不变(约 1.5%–2%)。这种测法专门暴露”选择质量随长度退化”的问题。
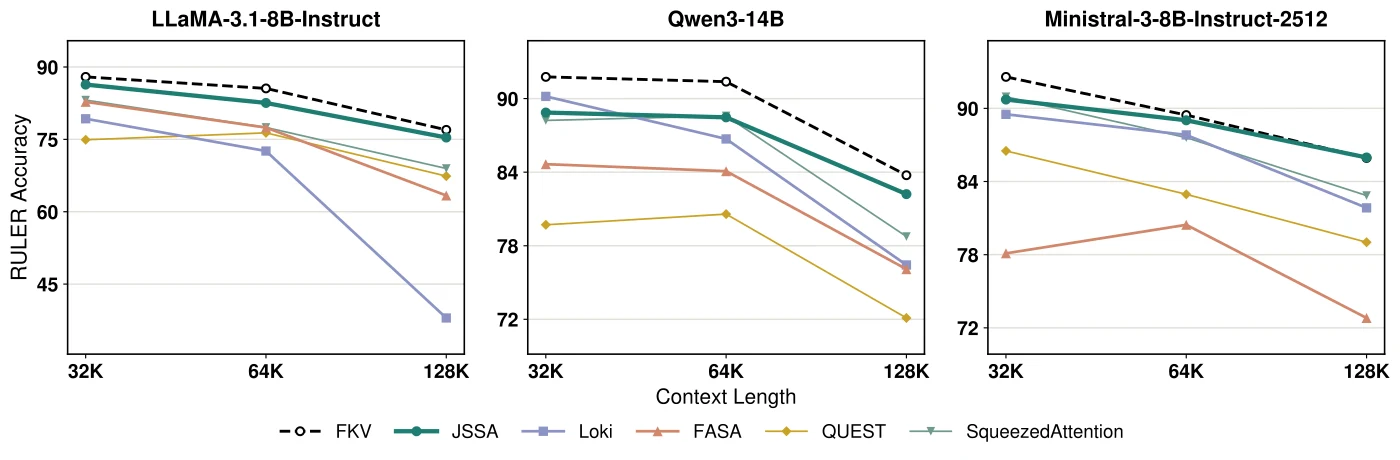
图 3:32K–128K 的 RULER 平均精度。来源:论文 Figure 3。
JSSA 在三个模型上的 RULER 精度(per-KV-head 选择,来自论文 Table 15):
| 模型 | 32K | 64K | 128K |
|---|---|---|---|
| LLaMA-3.1-8B-Instruct | 86.35 | 82.55 | 75.38 |
| Ministral-3-8B-Instruct-2512 | 90.72 | 89.02 | 85.97 |
| Qwen3-14B | 88.86 | 88.47 | 82.21 |
论文的结论是:JSSA 整体上最贴近 full-KV,并在 128K 取得最高的稀疏精度;竞争方法在长上下文退化更陡(例如 Loki 在 LLaMA-3.1-8B-Instruct 上),或表现出模型特异的弱点;在 Ministral-3-8B-Instruct-2512 上,JSSA 在 128K 与 full-KV 持平,在 32K 与 64K 时差距在 2 点以内。
PG-19:语言建模的困惑度
| 模型 | 上下文 | FKV | QUEST | FASA | Loki | JSSA |
|---|---|---|---|---|---|---|
| LLaMA-3.1-8B-Instruct | 32K | 11.07 | 35.10 | 23.12 | 50.15 | 11.27 |
| 64K | 10.14 | 21.68 | 14.76 | 41.45 | 10.14 | |
| 128K | 10.38 | 25.50 | 56.59 | 56.29 | 11.49 | |
| Qwen3-14B | 32K | 11.24 | 16.38 | 16.89 | 14.89 | 11.49 |
| 64K | 10.93 | 14.51 | 19.34 | 13.49 | 11.01 | |
| 128K | 10.41 | 13.29 | 15.05 | 14.61 | 10.53 | |
| Ministral-3-8B-Instruct-2512 | 32K | 9.78 | 13.87 | 24.13 | 10.43 | 10.45 |
| 64K | 8.96 | 12.46 | 16.20 | 9.55 | 9.64 | |
| 128K | 8.37 | 10.93 | 10.88 | 9.46 | 9.05 |
表:PG-19 困惑度,越低越好,上下文长度与 RULER 用同一套固定密度预算。数据来源:论文 Table 2。
这张表的对比度比 LongBench 剧烈得多:JSSA 在三个模型、三个长度上最多只差 full-KV 1.11 个困惑度点,而竞争方法极不稳定——Loki 在 LLaMA 上崩得很厉害(32K 时 50.15)却在 Ministral 上表现不错;FASA 的困惑度在 LLaMA 128K 时飙升到 56.59。对语言建模这种”每步都在用整个上下文”的任务,token 级选择的排序质量是唯一防线,一旦选错就没有补救机会。
实验:推理任务上的生成长度膨胀
推理场景把稀疏注意力的另一类失败模式放大了:生成长度膨胀。推理模型在解题时会反复回看早期的推导步骤,一旦这些步骤对应的 KV 被稀疏选择漏掉,模型会”想不起来”自己前面写了什么,于是重复推理、绕圈、生成长度暴涨——即使最终答案碰巧对了,这种膨胀在服务侧也是实打实的成本。
| 模型 | 方法 | AIME 2025 | MATH-500 | GPQA-Diamond |
|---|---|---|---|---|
| Qwen3-8B | FKV | 69.58 (1.00) | 94.53 (1.00) | 57.95 (1.00) |
| TriAttention | 20.00 (1.75) | 86.20 (1.70) | 40.40 (4.13) | |
| QUEST | 62.92 (1.29) | 93.50 (1.21) | 58.14 (1.03) | |
| SeerAttention-R | 42.08 (1.54) | 91.80 (1.35) | 55.93 (1.43) | |
| FASA | 60.42 (1.30) | 93.58 (1.17) | 57.45 (1.06) | |
| JSSA | 68.33 (1.07) | 94.23 (1.09) | 57.39 (1.02) | |
| Gemma4-26B-A4B-It | FKV | 90.00 (1.00) | 97.15 (1.00) | 80.87 (1.00) |
| TriAttention | 22.50 (2.29) | 83.95 (2.37) | 43.94 (3.06) | |
| QUEST | 50.42 (1.96) | 93.65 (1.65) | 71.40 (2.02) | |
| FASA | 73.75 (1.38) | 97.08 (1.14) | 80.56 (1.18) | |
| JSSA | 86.67 (1.17) | 97.08 (1.13) | 81.94 (1.12) | |
| GLM-4.7-Flash | FKV | 90.42 (1.00) | 96.80 (1.00) | 75.44 (1.00) |
| FASA | 65.00 (2.24) | 95.65 (1.90) | 69.38 (2.30) | |
| JSSA | 91.67 (1.17) | 96.88 (1.10) | 77.53 (1.38) |
表:KV 预算 1024 下的推理表现,条目为 pass@1 精度,括号内是相对 full-KV 的生成长度比。更高精度、更低长度比更好。数据来源:论文 Table 3。
读这张表的正确方式是把两个数一起看:
- TriAttention 的塌陷是最刺眼的:Qwen3-8B 上 AIME 只剩 20.00 但生成长度涨了 1.75 倍,Gemma4 上 GPQA-Diamond 从 80.87 掉到 43.94、长度涨到 3.06 倍。这是典型的”越选不对越啰嗦”的恶性循环——它是 KV 驱逐类方法(永久丢弃 token),在推理任务上尤其致命。
- JSSA 的长度比控制得最好:在 Qwen3-8B 与 Gemma4-26B-A4B-It 上限制在 2%–17% 的膨胀区间内,而 TriAttention、QUEST、SeerAttention-R 的膨胀显著更长。精度上,多数基准距离 full-KV 在 1.3 点以内。
- 在 Gemma4 与 GLM-4.7-Flash 上,JSSA 有时追平甚至超过 full-KV:Gemma4 的 AIME 2025 上,JSSA 与 FASA 差 12.92 点(86.67 对 73.75);GLM-4.7-Flash 上 JSSA 在三个基准(AIME 2025、MATH-500、GPQA-Diamond)上都匹配或超过了 full-KV 精度。这是 token 级选择在推理轨迹上”选择性丢掉噪声”的正向证据。
论文附录 E.5 还给出了 512、1024、2048 三档预算的完整结果,主表用的是中间的 1024。
吞吐:从 32K 到 128K
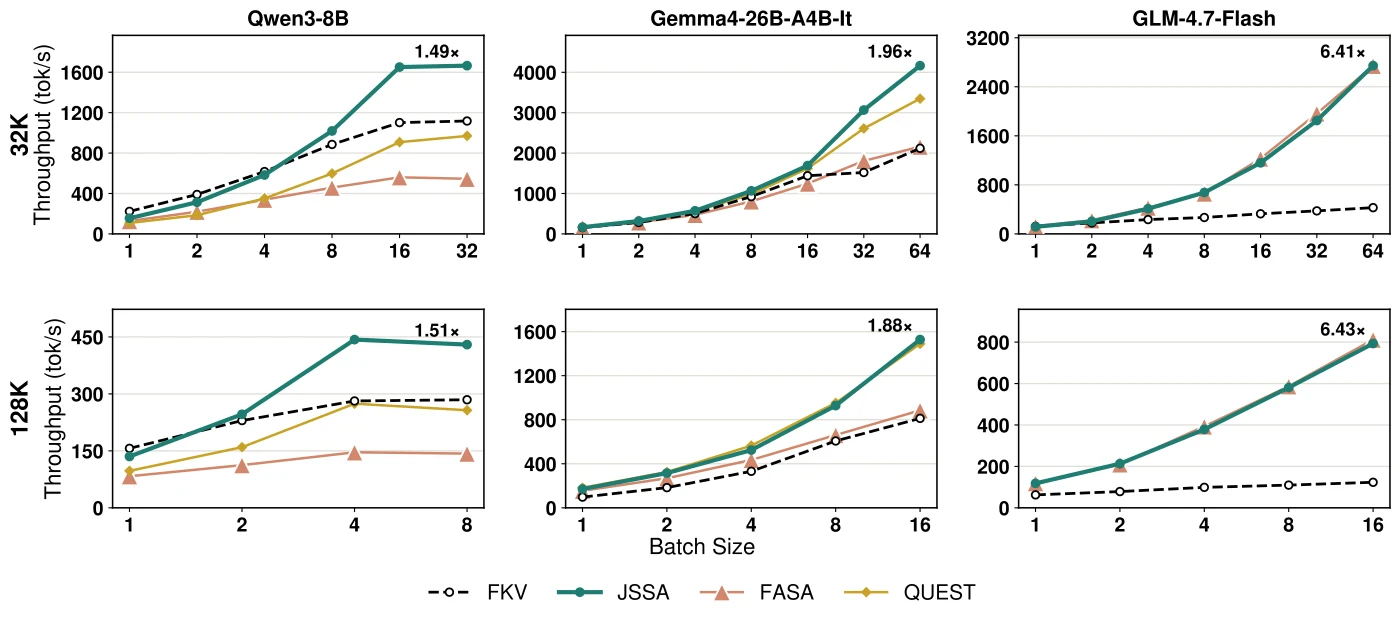
图 4:端到端解码吞吐。来源:论文 Figure 4。
吞吐实验全部在单张 B200 上做(Qwen3-8B、Gemma4-26B-A4B-It、GLM-4.7-Flash),所有稀疏方法统一 KV 预算。关键数字:
- 128K 上下文下,JSSA 相对 full-KV 的吞吐最高为:Qwen3-8B 1.51×、Gemma4-26B-A4B-It 1.88×、GLM-4.7-Flash 6.43×。
- 32K 上下文下对应为 1.49×、1.96×、6.41×。
- JSSA 的优势总体上随上下文增长而增大——因为 KV cache 流量在解码时间中的占比随长度上升;但在短上下文、小 batch 的组合下,打分与 top- 选择本身的开销会抵消一部分访存减少的收益,这在 Qwen3-8B 上尤其明显(附录 D 明确指出这一点)。
- GLM-4.7-Flash 上 JSSA 与 FASA 吞吐相当,但推理精度显著更高——说明联合打分目标几乎没有带来额外开销。
- 加速幅度与注意力架构强相关:Gemma4 的结果是在只稀疏化 global-attention 层的前提下取得的,而 GLM-4.7-Flash 更大的收益来自”对共享 latent cache 做稀疏 FlashMLA 执行”。
组件级拆解:时间花在哪
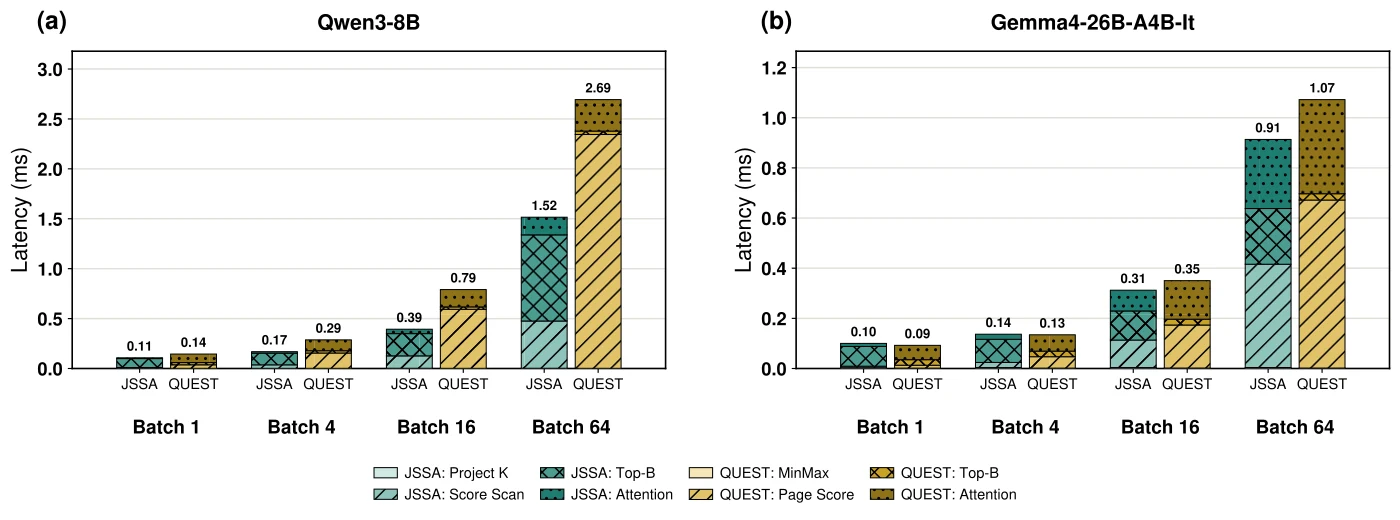
图 9:128K 上下文下的组件级延迟拆解。来源:论文 Figure 9。
论文附录 E.1 把流水线拆成四段:打分准备、候选打分、top- 选择、稀疏注意力。三个观察:
- key 投影开销可以忽略:对 JSSA 而言,把新生成的 key 投影到低维是整条流水线里最便宜的一步,最多占 3.2%,大 batch 时不到 1%。这印证了”打分缓存只服务于选择”的分层没有引入新的瓶颈。
- top- 选择在小 batch 时主导,而全上下文分数扫描随 batch 增大越来越重要。原因不难理解:注意力访存部分被稀疏化之后,剩下的”对全部候选打分”这一段是唯一还与上下文长度成正比的工作量,它与 batch 同向放大。
- JSSA 比 QUEST 快,而且优势随 batch 增大:Qwen3-8B 上,batch 64 时流水线延迟从 QUEST 的 2.69 ms 降到 1.52 ms;Gemma4 上小 batch 时两者相当,大 batch 时 JSSA 领先,batch 64 时是 0.91 ms 对 1.07 ms。原因是 QUEST 的页打分成本随 batch 增长更快,而 JSSA 受益于紧凑的投影缓存与规整的分数扫描内核。
大模型验证:事后校准对齐原生 DSA
这一节是全文最有分量的实验设计:把事后(post-hoc)校准的稀疏注意力,与训练期原生引入的稀疏注意力放在同一量级上比较。
两个模型家族、约 700B 参数规模,都自带 DeepSeek Sparse Attention(DSA):
- DeepSeek:同一个模型谱系里的两个 checkpoint。DeepSeek-V3.1-Terminus 用 full attention;DeepSeek-V3.2-Exp 通过继续预训练从 Terminus 引入原生 DSA,DSA 是它唯一的架构改动。JSSA 被事后施加在 Terminus 上,因此比较是”事后校准 vs 训练原生”。
- GLM-5.2:独立开发的 MLA 模型,自带 DSA。它的原生调度是只在部分注意力层调用 DSA indexer,并在相邻层复用选出的索引集以降低索引开销。JSSA 遵循同一套原生调度:只在 indexer 被调用的地方做选择,并把索引共享给相邻层。GLM-5.2 没有对应的 full-attention checkpoint,所以只比 JSSA 与原生 DSA。
关于”等容量”的说明:JSSA 与原生 DSA 的打分表示总维度都是 128,但构造不同——JSSA 是 64 维 latent 加 64 维 RoPE,原生 DSA 是学出来的 128 维 lightning indexer head(DSA 的索引器与稀疏 MLA 实现可以看 DSA 稀疏注意力完全拆解)。两者都在每个注意力层选 2048 个 token。
| 模型 | 方法 | AIME 2025 | GPQA-Diamond |
|---|---|---|---|
| DeepSeek-V3.1-Terminus | FKV | 86.67 | 81.57 |
| DeepSeek-V3.1-Terminus | JSSA | 87.50 | 80.30 |
| DeepSeek-V3.2-Exp | 原生 DSA | 87.50 | 78.54 |
| GLM-5.2 | JSSA | 83.33 | 90.91 |
| GLM-5.2 | 原生 DSA | 82.50 | 90.91 |
表:大规模推理精度。JSSA 事后施加,不训练模型。数据来源:论文 Table 4。
论文对自己结果的解读很克制:在两个模型家族上,JSSA、FKV 与原生 DSA 的精度都落在很窄的区间内;JSSA 在 AIME 2025 上与原生 DSA 持平,在 GLM-5.2 的 GPQA-Diamond 上两者完全相同。考虑到数值差异很小、评测本身存在方差,论文把它解释为”精度与模型原生 DSA 相当”,而不是”某一方有稳定优势”。这种措辞是应该被继承的——把 0.83 点或 1.76 点的差异说成”超过”是过度解读。
吞吐方面:在 DeepSeek 上测得的全部上下文长度与 batch size 组合里,JSSA 达到原生 DSA 解码吞吐的 96.1%–99.2%,且不需要继续训练。实验用 8 张 B200、张量并行度 8。
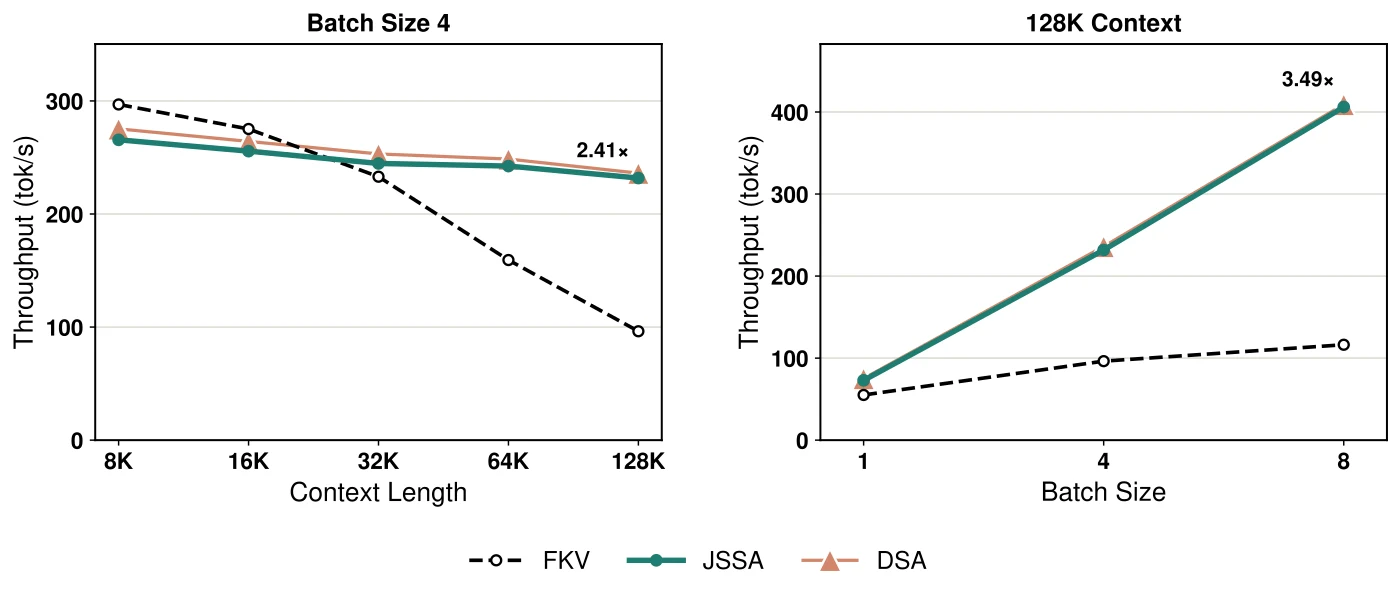
图 7:DeepSeek 上的端到端解码吞吐。来源:论文 Figure 7。
图 7 的两个标注给出了相对 full-KV 的加速:在 batch size 4 时,JSSA 相对 FKV 的吞吐随上下文增长而提升,最高到 2.41×;在 128K 上下文跨 batch size 扫描时,最高到 3.49×。把这个结果和”96.1%–99.2% of DSA”放在一起看,可以读出两层信息:原生 DSA 依然是这条路线上的吞吐上界;而 JSSA 用一个”一次前向加一次特征分解”的校准流程,把自己推到了距离这个上界不到 4% 的位置。
消融:每一项设计是否真的必要
投影 rank:低维打分的容量曲线
JSSA 的投影 rank 默认取 (Gemma4 的 global 层取 )。论文扫了从 4 到 32 的完整区间,把 JSSA 与 FASA、Loki 放在一起比较:JSSA 在每一个 rank 上都最好,而且增益在最紧的预算下最大——说明联合 query-key 目标在打分容量被压得很小的时候,比”重建 key”或”选原始通道”更有效地利用了有限维度。这与动机部分是同一个逻辑的延伸:容量越紧,目标选得对不对就越决定成败。
校准的鲁棒性:语料无所谓,长度有所谓
校准消融把两个变量分开:
- 语料:在 LongAlign、NarrativeQA、LooGLE 上分别校准,32K 与 128K 评测下的困惑度几乎完全一致——JSSA 对校准语料基本不敏感。
- 长度:校准序列的长度会直接影响 128K 评测表现。用 32K 校准的基,在 128K 评测时困惑度落在 16.05–18.31;而用 128K 校准的基是 11.31–11.48。
结论是工程性的:校准序列要覆盖接近最大部署上下文长度的范围。这条约束不苛刻(校准只是一次前向),但它必须被写进部署流程,否则稀疏选择的排序质量会在长上下文上悄悄退化——而且退化不会报错,只会变慢变差。
gather-free:这是不是真的有用
论文用完全相同的选中 token 集合做对照,把”先物化再算”与”原地索引算”对比,隔离出 gather 本身的代价:
- 在 128K 上下文、LLaMA-3.1-8B-Instruct 上,gather-free 执行把注意力阶段的加速比相对 full-KV 大致翻倍(batch size 4 与 16 上都是这个量级)。
- 在 Gemma4-26B-A4B-It 上,gather-free 相对 gather-then-attend 提高了端到端吞吐,并且增益随 batch size 增大。
这条消融和动机部分的图 2(b) 是同一个论点的两端:既然 gather 能占到残差延迟的一半以上,把它消掉就应该带来可观的端到端改善——实验证实了这一点。对做 kernel 的人来说这条结论是可以独立复用的:token 级稀疏的真正瓶颈往往不在”读得散”,而在”搬得勤”。
per-KV-head 选择 vs 层内共享索引
RULER 上的对照(论文 Table 15)已经在前文引过,这里补上完整读法:
| 模型 | 选择粒度 | 32K | 64K | 128K |
|---|---|---|---|---|
| LLaMA-3.1-8B-Instruct | per-KV-head | 86.35 | 82.55 | 75.38 |
| head-shared 软投票 | 86.03 | 80.82 | 70.09 | |
| Ministral-3-8B-Instruct-2512 | per-KV-head | 90.72 | 89.02 | 85.97 |
| head-shared 软投票 | 90.67 | 87.24 | 84.98 | |
| Qwen3-14B | per-KV-head | 88.86 | 88.47 | 82.21 |
| head-shared 软投票 | 89.11 | 88.82 | 80.89 |
表:per-KV-head 选择与 head-shared 软投票的 RULER 精度对比。数据来源:论文 Table 15。
规律很清楚:32K 时两者几乎没差别(差 0.32 点以内,Qwen3-14B 上共享索引甚至略好),64K 与 128K 时 per-KV-head 稳定领先。这解释了为什么 JSSA 值得为 per-KV-head 选择写一个专门的内核:收益只在长上下文显现,而长上下文正是这个方法的目标场景。
打分缓存精度:FP8 够用
如前文所述,FP8 与 BF16 投影缓存的 LongBench 平均精度差最多 0.18 点,内存占用减半。这条消融的价值在于确认了”打分与注意力分层”的可靠性边界:辅助缓存可以被压到很低的精度而不影响选择质量。
oracle 召回:选择质量本身
论文附录 B.5 用oracle top- 召回直接度量”选中集合和全维注意力分数给出的真值 top- 有多接近”:
| 模型 | JSSA | Loki | FASA | |
|---|---|---|---|---|
| LLaMA-3.1-8B-Instruct() | 256 | 71.34% | 35.97% | 48.90% |
| 2048 | 75.94% | 51.84% | 53.31% | |
| Gemma4-26B-A4B-It() | 256 | 79.85% | 67.79% | 44.60% |
| 2048 | 83.33% | 77.08% | 49.90% |
表:oracle top- 召回。数据来源:论文 Table 12。
JSSA 在两个模型、两档预算上都取得最高召回,相对 Loki 领先 6.25–35.37 个百分点,相对 FASA 领先 22.44–35.25 个百分点。召回这个指标比下游精度更”干净”:它直接说明联合 query-key 基保留了全维注意力诱导出的 token 排序,而不是靠下游任务的平均效应掩盖选择错误。
非对称分解(KQ-SVD)能不能替代共享子空间
这一条消融回答了一个自然的替选方案:KQ-SVD 那类非对称的 query/key 分解(各用一套低维变换)本来是为 KV cache 压缩提出的、目标也是保住注意力分数,那它能不能直接拿来当 token 打分的投影?论文把它的分解适配到 JSSA 的打分流水线上(只用于给候选 token 打分,原始全维 KV、token 预算、选择粒度、执行路径都不变),做了一次受控比较:
- RULER 上它有几个设置相当能打,包括在 LLaMA-3.1-8B-Instruct 与 Ministral-3-8B-Instruct-2512 上贴近 JSSA;但跨架构与上下文长度的一致性较差,在 Qwen3-14B 上差距尤其大。
- 推理任务上,激进稀疏下它的退化更严重:token 预算 512 时 AIME 2025 只有 0.83%(Qwen3-8B)与 26.67%(Gemma4),而 JSSA 是 64.58% 与 88.75%;GPQA-Diamond 上落后 JSSA 14.14 与 24.87 个百分点。预算升到 2048 后它的精度明显恢复,在若干设置下变得有竞争力。
论文的结论放在”共享正交子空间 vs 非对称分解”这个轴上是对的:非对称分解可提供有用的 token 分数,但在激进稀疏下远不如 JSSA 的共享正交子空间稳健。
直接优化精确目标:收益可以忽略
这一条已在前文详述(1600 步 Stiefel 流形优化、学习率跨三个数量级、256 个基并行),结论是精确目标最多降 0.005–0.05,oracle 召回变化不超过 0.02 个百分点,子空间重叠度在 0.989 以上。它解释了为什么 JSSA 的校准可以如此廉价——闭式谱解已经落在低目标盆地里。
局限与需要留意的地方
把论文自己承认的边界与从数据可以读出的边界放在一起:
- token 打分仍然要扫全部候选。稀疏化只发生在注意力访存这一侧,打分阶段的工作量依旧与上下文长度成正比。后果是:在短上下文 + 小 batch 的区间,打分与 top- 选择可能抵消掉一部分收益(Qwen3-8B 的吞吐曲线上表现明显);在大 batch 下,全上下文分数扫描在流水线中的占比会持续上升,成为下一段值得优化的瓶颈。组件级拆解给出的数据也印证了这一点:小 batch 时 top- 选择主导,大 batch 时分数扫描变重。
- 校准长度必须覆盖部署上下文。32K 校准的基在 128K 评测下困惑度从 11.31–11.48 恶化到 16.05–18.31。这不是”可选的最佳实践”,而是正确性相关的前置条件。
- 精度是”接近”而不是”等于”。LongBench 上差距在 0.67 点内、RULER 上最贴近 full-KV、PG-19 上最多 1.11 个困惑度点,但推理任务上仍能看到差距(例如 Gemma4 的 AIME 2025,JSSA 86.67 对 full-KV 90.00,长度比 1.17)。
- per-KV-head 选择没有现成内核可用。论文的做法是自己写 Triton kernel;这也意味着把它移植到别的框架需要同样的工程量。MLA 路径则依赖 FlashMLA 已发布的稀疏内核,因此 MLA 上的可用性绑定在 FlashMLA 的覆盖范围上。
- 与原生 DSA 的比较跨了两个 checkpoint。DeepSeek 侧是”Terminus 上的事后 JSSA”对”V3.2-Exp 的原生 DSA”,两者同源但不是同一个模型;GLM-5.2 侧根本没有 full-attention checkpoint 可对照。数值差异又很小,论文自己也强调应读作”精度相当”而非稳定优势。
- 所有层、所有 head 共用同一个 token 预算。论文对每个稀疏层、每个 head 施加相同的预算,没有做层间或 head 间的自适应分配。考虑到不同层对上下文的依赖程度差异很大(这也是 LongCat 的层级索引、HySparse 的层间 Oracle 一类工作关注的点,见 HySparse 混合稀疏注意力(一)),预算分配是一个明确留白。
- 不保留 sink、不强制近期窗口。JSSA 不做任何位置特判——既不预留 attention sink,也不强制保留最近 token 窗口。这一点和 StreamingLLM 那条”4 个 sink + 滑窗”的路线在哲学上相反:JSSA 认为打分基学对了就不需要手工兜底。反过来说,如果某个模型的注意力结构严重依赖 sink,JSSA 也没有为它准备退化路径。
- 训练无关既是优点也是上限。不需要继续预训练,意味着它可以直接施加在任何已有 checkpoint 上;但也意味着模型无法为这个稀疏模式做适配——原生 DSA 那 0.4%–3.9% 的吞吐差距,本质上是”模型与稀疏模式协同训练”带来的结构性优势。
小结
JSSA 把 token 级稀疏解码的两个老问题各自拆成一句可执行的设计原则:
- 打分基要保 query-key 交互,而不是保 key 表示。做法是最小化双线性打分误差,求出一个非凸目标的可处理上界,上界有闭式谱解——归一化后 query 与 key 二阶矩之和的前 个特征向量。迹归一化是必要条件(否则 key 边缘的迹比 query 大近两个数量级,基会退化成 key 重建),上界不紧但解已经落在低目标盆地(1600 步精确优化只能改动 0.005–0.05 的目标、召回变化不足 0.02 点)。
- token 级稀疏的瓶颈在”搬”而不在”散”。单个 token 的 KV 切片在 head 维本就连续,散落索引增加的只是事务数量;真正的开销是把选中条目物化成连续缓冲区。解法是 per-KV-head 索引集的 gather-free Triton 内核,每层启动一次、内部解析每个 head 的索引。
工程口径上:校准是”5–8 条长序列的一次 dense prefill + 每层每 KV head 一次特征分解”,在 B200 上 129–365 秒完成,不训练模型;FP8 打分缓存最多占原始 BF16 KV cache 的 6.25%;精度在 GQA、混合局部/全局 GQA 与 MLA 三类架构上都贴近 full-KV;单卡 B200 上 128K 上下文吞吐最高 6.43×;约 700B 规模上事后校准即可与原生 DSA 精度相当,吞吐达到其 96.1%–99.2%。
对做推理系统的人来说,这篇工作最可迁移的两条经验不是具体的某组特征向量,而是:“选择质量”和”选择之后的执行”是两个必须分别设计的问题——前者要有一个直接对齐最终用途(打分排序)的目标,后者要盯着数据搬运而不是数据布局;以及低维表示只服务选择、不参与最终计算这个分层,让量化与近似误差的影响路径变得可控。
参考资料
- JSSA: Joint Subspace Sparse Attention for Efficient Long-Context Decoding
- JSSA 论文全文(arXiv HTML 版)
- Loki: Low-rank Keys for Efficient Sparse Attention
- Quest: Query-Aware Sparsity for Efficient Long-Context LLM Inference
- SnapKV: LLM Knows What You are Looking for Before Generation
- H2O: Heavy-Hitter Oracle for Efficient Generative Inference of Large Language Models
- Native Sparse Attention: Hardware-Aligned and Natively Trainable Sparse Attention
- LongBench: A Bilingual, Multitask Benchmark for Long Context Understanding
- RULER: What’s the Real Context Size of Your Long-Context Language Models?
- Efficient Streaming Language Models with Attention Sinks
- MInference 1.0: Accelerating Pre-filling for Long-Context LLMs via Dynamic Sparse Attention
- KIVI: A Tuning-Free Asymmetric 2bit Quantization for KV Cache
- DeepSeek-V2: A Strong, Economical, and Efficient Mixture-of-Experts Language Model(MLA 的出处)
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



