


DLite 完全拆解:面向智能体的无历史投机解码,如何省掉草稿端长上下文
智能体投机解码的隐藏成本
一次代码修复任务可能反复经历这样的循环:模型读取仓库信息,生成工具调用,等待测试返回,再带着测试日志继续生成。对于下一轮请求,历史里又多了上一轮的代码、工具参数和执行结果。生成阶段也许只有几十个 token,输入却已经增长到数万 token。
投机解码通常让一个较小的草稿模型先猜一段,再让目标模型一次验证多个位置,以减少目标模型串行前向的次数。问题是,许多草稿模型也要理解越来越长的历史,并维护自己的一套 KV Cache。目标模型和草稿模型分别保存历史,分别为新增 token 更新缓存;跨轮复用前缀时,还要照顾两边的状态。这些工作可能吞掉原本期待得到的加速。
DLite 是上海交通大学等团队于 2026 年 10 月 16 日提交的工作,论文题为 DLite: History-free Speculative Decoding for Agentic AI。它把草稿模型的职责缩小为:利用目标模型已经算好的上下文表示,完成当前附近几个位置的预测。这里的 History-Free 指草稿端不显式维护历史 KV,目标模型仍然读取完整上下文,并保留原有缓存。
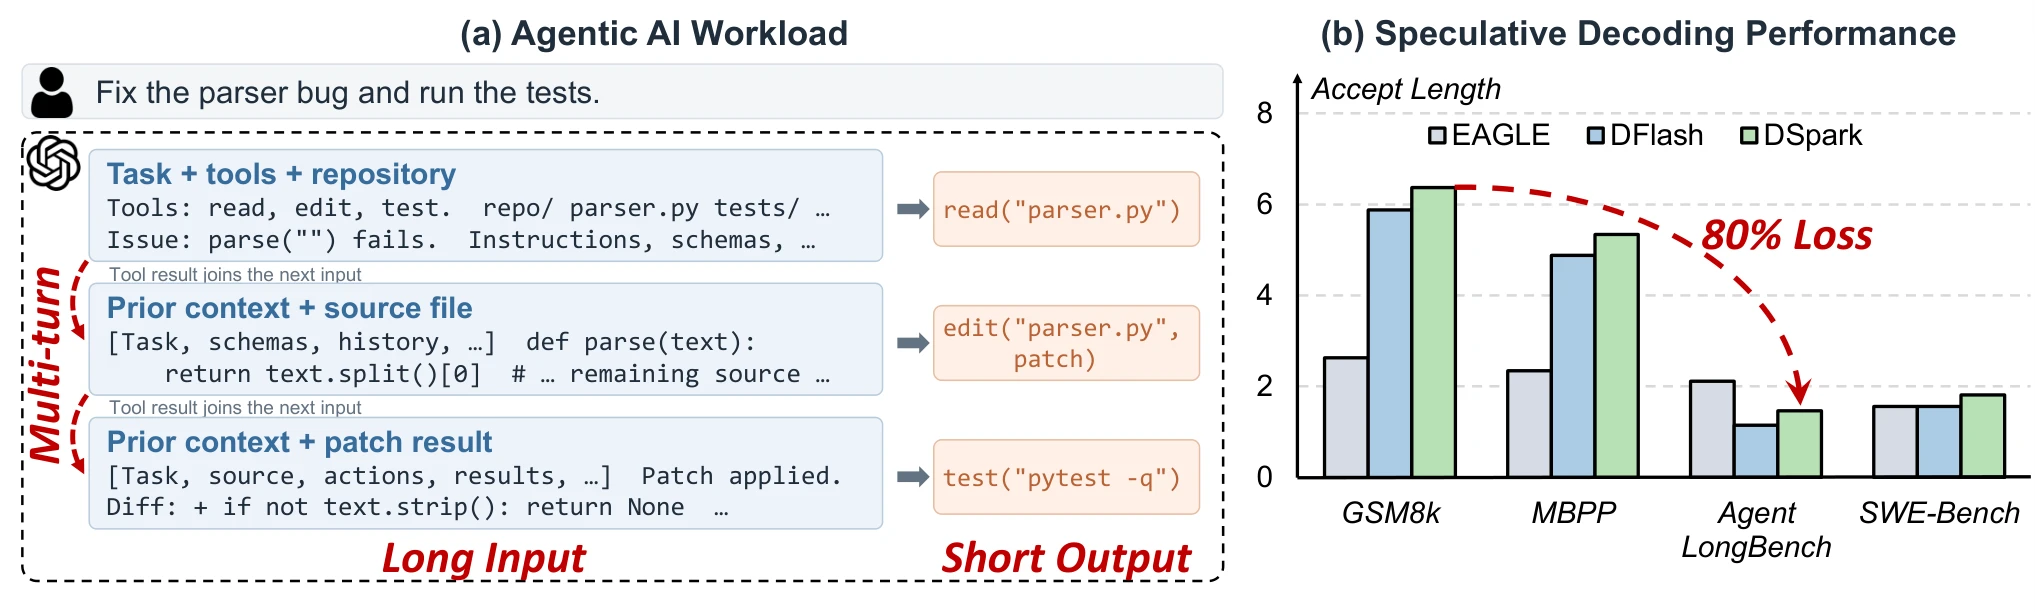
图 1,来源:DLite 论文 Figure 1。左侧概括长输入、短输出和多轮交互,右侧比较常规任务与智能体任务中的接受长度。图中的退化是特定模型与工作负载下的观测,不应理解成所有智能体请求都会下降同一个比例。
理解 DLite,需要同时记两笔账。第一笔是预测质量:一次验证到底能够推进多少个 token。第二笔是执行开销:为了得到这些候选,草稿端额外做了多少计算、访存和状态维护。接受长度再高,如果生成草稿太慢,整体仍然可能变慢;草稿计算再轻,如果候选不断被拒绝,也很难省掉目标模型调用。
论文在部分智能体任务中观察到已有方法的接受长度降到约 1—2,并指出在其使用 SGLang 评测的一项 MTP 实现中,草稿 KV 更新和维护约占端到端推理延迟的 10%—20%。后一个数字是特定实现的瓶颈证据,不能直接当作 DLite 在所有模型上能够消除的固定比例。
先拆开一次投机轮次的时间
设每轮最多提出 个草稿 token, 是从头连续接受的草稿数量,因而 。遇到第一个拒绝位置后,目标模型产生纠正 token;如果全部候选都被接受,则可再产生一个额外 token。在这种常见实现下,一轮通常推进 个 token,平均推进长度为 。报告接受长度时必须说明是否计入这个目标 token。
把目标模型正常生成一个 token 的时间记为 ,草稿耗时记为 ,批量验证耗时记为 ,其余状态更新与调度开销记为 ,则平均每个输出 token 的时间可粗略写成:
相对正常自回归解码的加速比近似为:
这个模型把每轮开销摊给实际提交的输出 token,忽略了不同轮次之间的波动,适合解释瓶颈,不是完整的服务时延预测器。验证必须处理多个候选位置,因此 通常大于单 token 前向时间;但在小批量、权重读取占比较高的场景中,它又可能明显小于逐个生成相同数量 token 的总时间。
由此可见, 不等于加速 6 倍。比如仅作算例,若 ms,,每轮草稿、验证和维护一共 20 ms,得到的是约 2 倍加速。所有数字都是说明公式的假设值,并非 DLite 实测。
已有路线可以按串行计算放在哪里来区分。EAGLE 让较轻的特征预测器逐步生成候选;DFlash 并行预测多个位置,减少草稿串行步数;DSpark 用并行主体与轻量顺序模块折中。DLite 沿着半自回归路线继续改造,重点去掉草稿端不断增长的历史状态,并让块内纠正在隐藏空间完成。
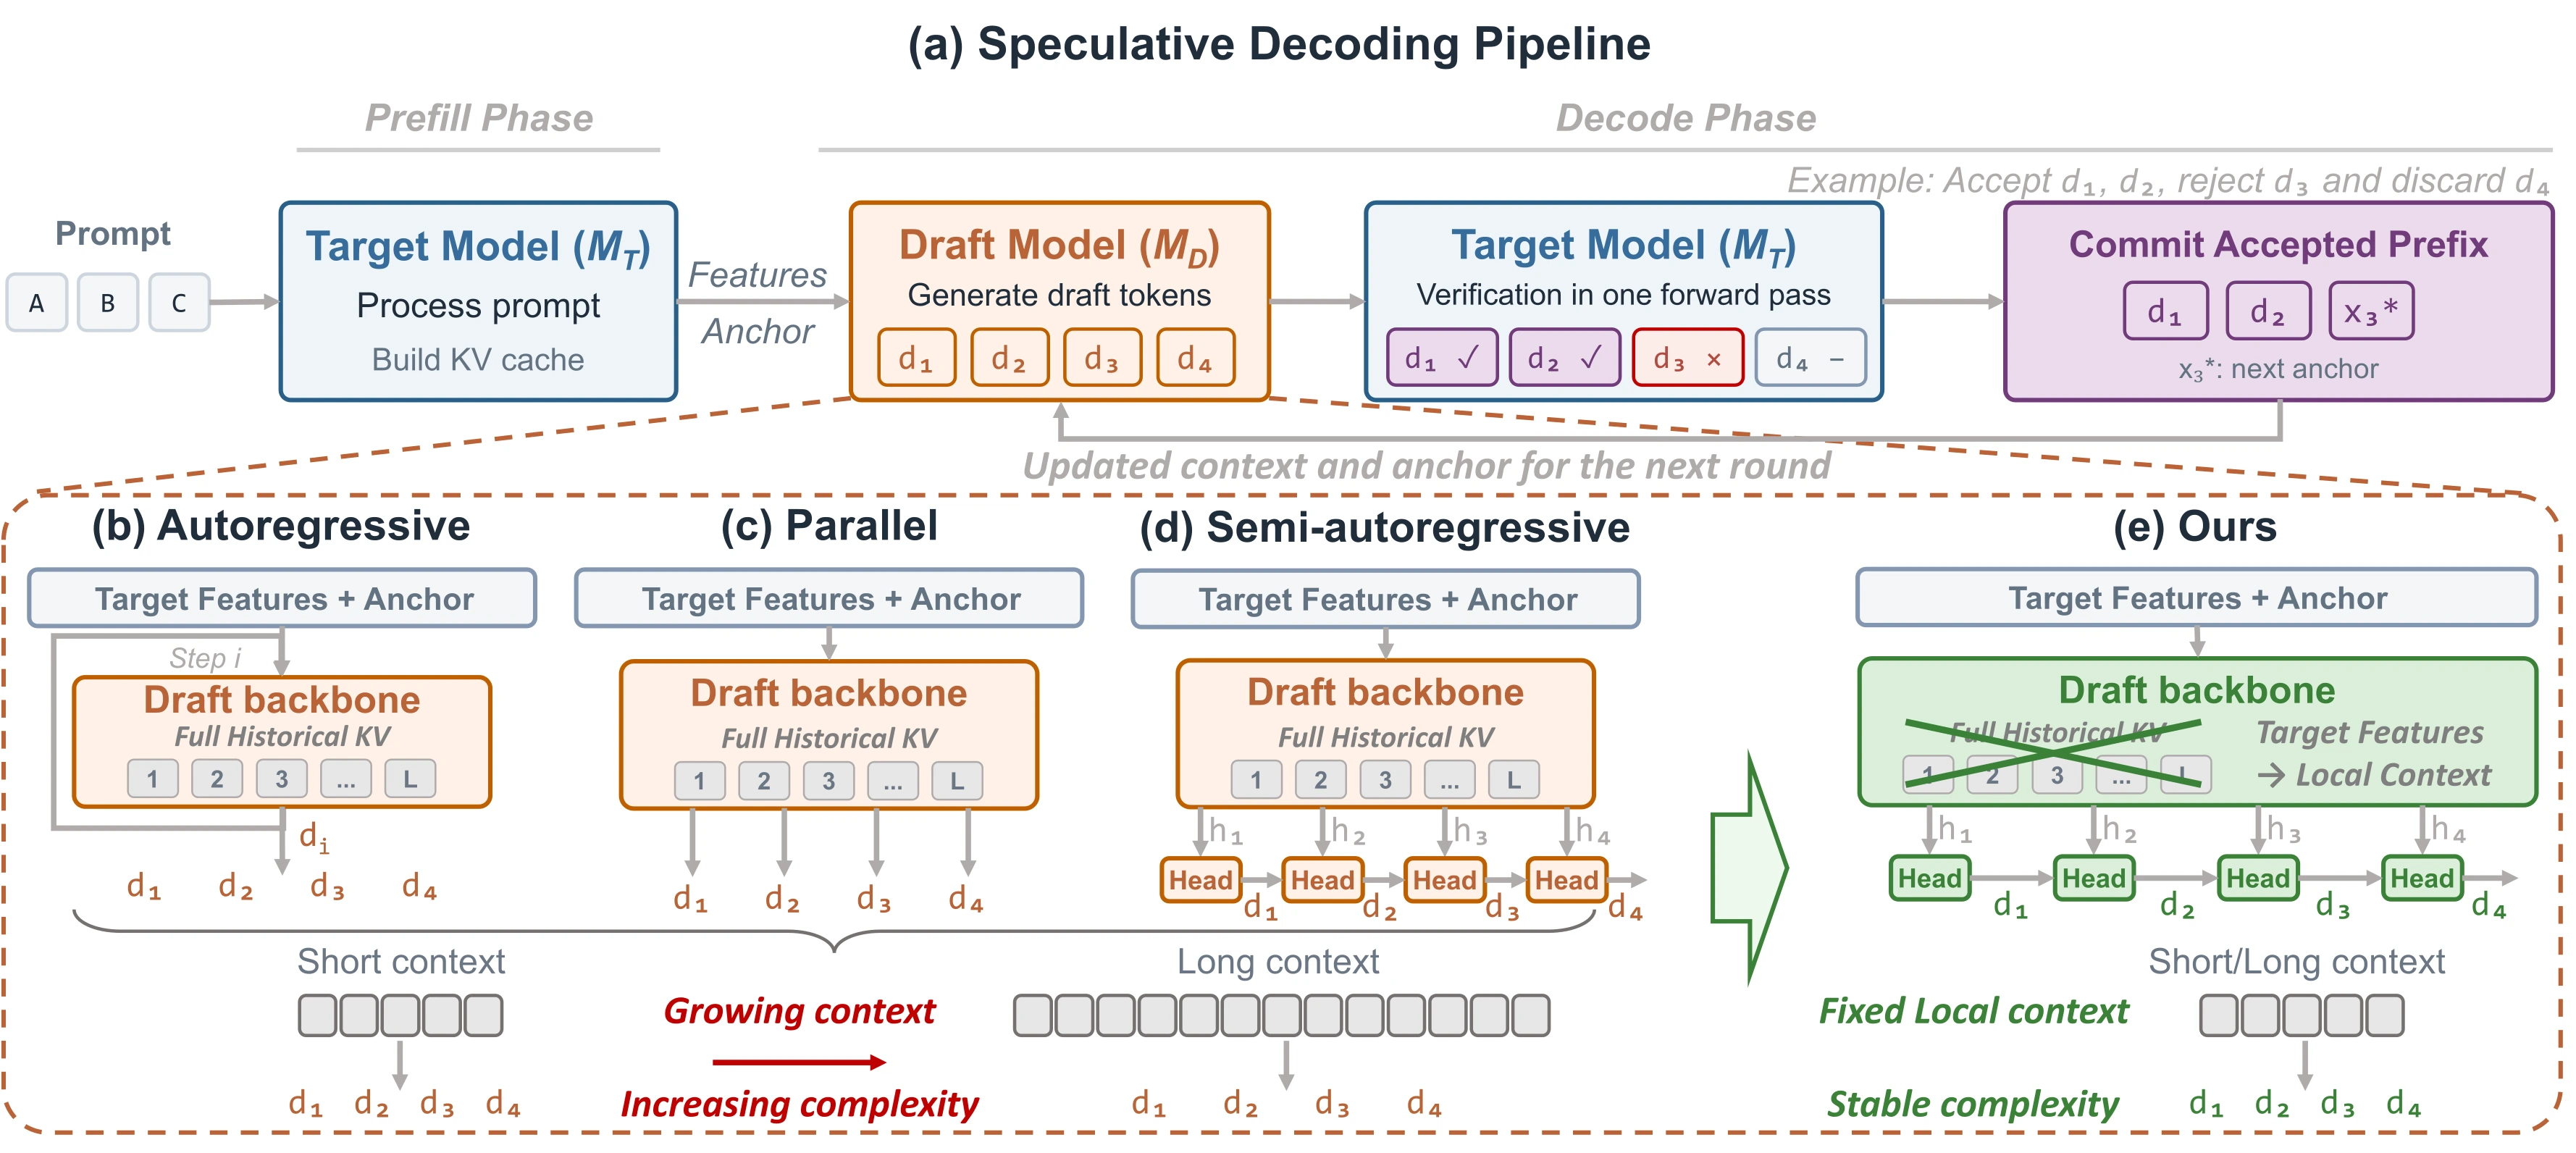
图 2,来源:DLite 论文 Figure 2。图中先给出 draft-and-verify 公共流程,再比较自回归、并行、半自回归与 DLite。观察重点是历史上下文由谁处理,以及块内 token 的依赖在哪个模块恢复;“并行”描述的是草稿主干,不代表验证之后可以跳过前缀接受规则。
History-Free 到底省掉了什么
历史并没有消失,而是由目标模型编码
把已有序列记为 。目标模型在位置 的第 层隐藏状态 ,已经通过前面的因果注意力计算吸收了历史信息。DLite 选择若干层的当前隐藏状态,把它们作为草稿主干的上下文输入。这不等价于把目标模型的全部 KV 缓存交给草稿模型:KV 保存的是许多历史位置的键和值,DLite 取的是当前枢轴位置上若干深度的表示。
如果选择 个目标层,每个表示宽度为 ,那么上下文特征可以组织为 的张量。目标模型的层深、各层表示的含义不同,因此还要加上层来源标识:
这里 是与层 对应的可学习向量,和隐藏状态同宽。它告诉草稿模型“这份特征来自哪一层”;它与表示 token 在序列中位置的 RoPE 分工不同。官方实现还会对相加后的特征做归一化。
为什么不只使用最后一层?最后一层更直接服务于下一个 token 的预测,中间层可能保留对多个后续位置有用的互补表示。但层数也不能无止境增加,因为草稿模型仍然要读取和处理这些输入。论文的 Qwen3-8B 设计空间实验中,选 7、14、36 个目标层特征,对应平均接受长度约为 3.14、3.30、3.27;更多层并未继续改善。这些数值来自同一小规模配置比较,不是最终模型的整套任务均值。
“当前隐藏状态”也不是完整历史的无损摘要。单个有限维表示不可能在所有任务上保留全部细节。DLite 的经验判断是:预测紧邻当前位置的短块时,这些表示已足够有用;遗漏的信息会影响候选接受率,最终输出仍由目标模型验证。它没有证明任意长历史都可以无损压进固定大小的特征。
沿序列维拼接,保留各层的独立身份
多个目标层特征可以有两种组织方式。沿特征维拼接会把 个 维向量合成一个 维向量,通常还需要投影回草稿宽度。沿序列维拼接则保留 个独立的 维输入槽位,让注意力分别读取。
DLite 采用后者。可以把这些槽位理解成“同一个历史边界上的多个深度视角”,而不是 个不同历史 token。层标识使注意力能够区分来源,序列维组织避免在输入处就把这些视角混成一个向量。论文比较中,沿序列维组织的平均接受长度为 3.30,沿特征维为 3.04;这一结果支持其具体配置选择,但并不能推出所有特征融合任务都该使用相同方式。
本轮临时 K/V 仍然需要计算
“没有草稿历史 KV”容易被误读成“草稿注意力不用 K/V”。草稿主干仍然要为锚点与占位计算 Q,并为上下文特征和局部输入计算 K、V;区别在于,这些中间结果服务于当前短块,不会随着历史 token 数持续累积为一套长期缓存。
设草稿模型有 层,KV 头数为 ,每头宽度为 ,历史长度为 ,每个元素占 字节。常规草稿端的历史 KV 容量约为:
系数 2 对应 K 与 V。这个估计忽略分页、对齐和元数据,主要说明容量随 线性增长。DLite 移除了这一增长项;当前选层特征约占 字节,本轮主干激活和循环状态也需要空间,但其尺寸由固定配置决定。目标模型自己的历史 KV、草稿权重以及运行时工作区依旧存在。
因此,DLite 减少的是一套重复的历史表示与维护责任。若主要显存消耗来自目标模型,它不会仅凭这项改动就把总缓存变成常数。
从目标隐藏状态到并行草稿表示
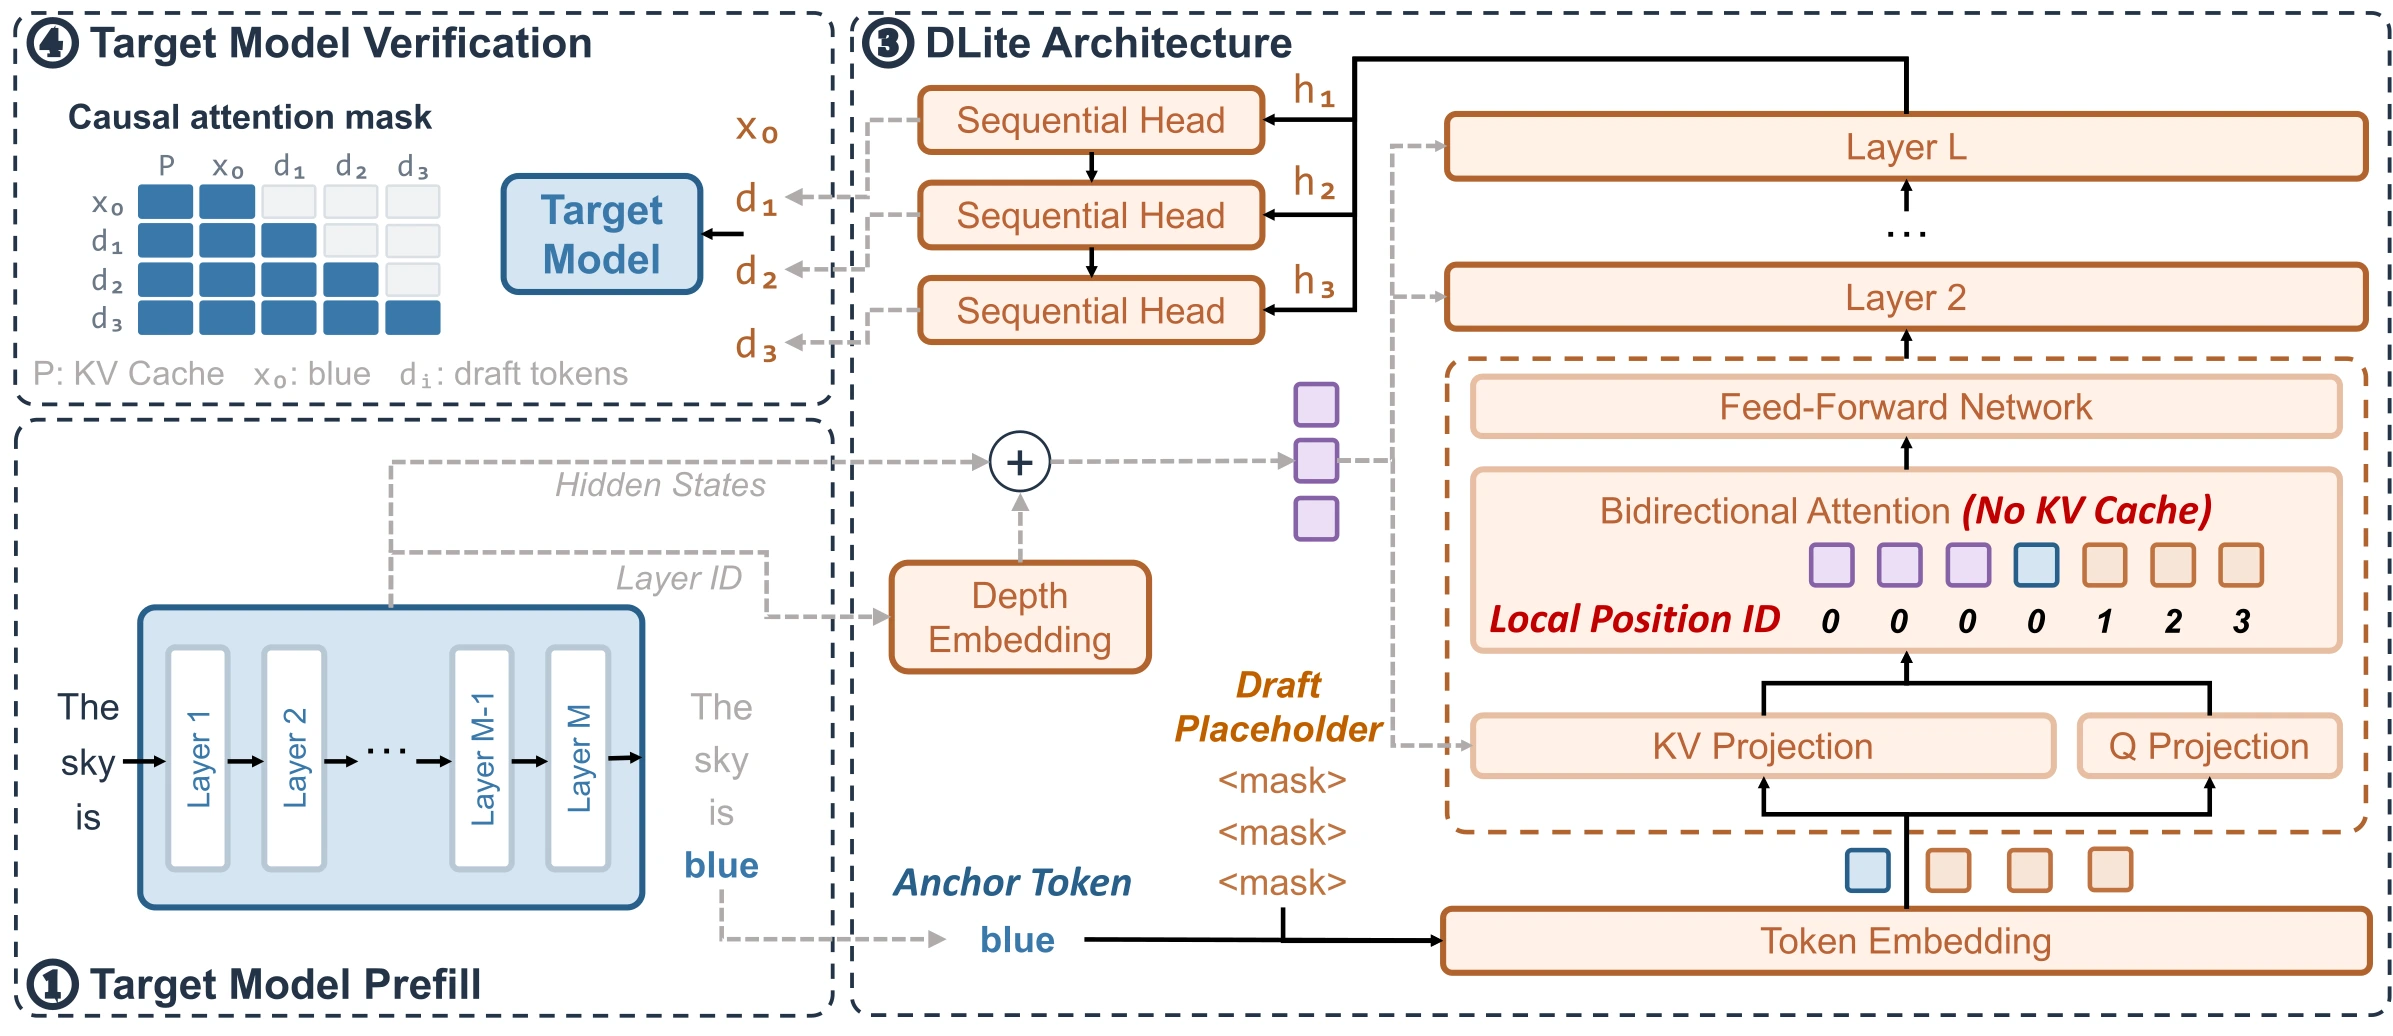
图 3,来源:DLite 论文 Figure 3。左下方目标模型先处理完整提示,输出上下文隐藏状态和一个锚点 token;中间的 Depth Embedding 标识隐藏状态来源;右侧主干并行生成各草稿位置的表示;顺序头逐个生成候选,最后交给左上方目标模型按因果掩码验证。
锚点是已经确定、尚待目标前向处理的输入
假设目标模型读完 “The sky is”,预测下一个 token 是 “blue”。图中的 “blue” 是锚点。目标特征来自已处理上下文末尾的枢轴位置,而锚点提供最新、明确的 token 信息。草稿模型在这个条件上继续预测后续位置。
这个时间关系很关键:能够从目标分布选出一个 token,不等于已经计算过这个 token 自身的隐藏状态。若把锚点 embedding 与“锚点经过目标模型后的隐藏状态”混为一谈,就会在解释实现时偷偷多算一次目标前向。DLite 可以利用上一段处理结果中的枢轴特征,加上新确定锚点的 embedding,直接开始下一轮草稿。
草稿输入由上下文特征、锚点或固定长度局部 token 组,以及若干待预测占位组成。占位用于标记未来预测槽位,不能当成未来真实 token。主干在短块内执行非因果注意力,因此各占位可以同时计算;这些位置彼此读取的是待计算的表示,而不是尚未生成的真实答案,不构成读取未来真值。
局部位置编码切断草稿端的全局位置增长
常规草稿模型往往跟着全局序列位置前进。上下文从 4K 增长到 64K 时,草稿端面对的位置范围也在变化。DLite 把长距离位置关系留给目标模型处理,草稿只使用相对本轮锚点附近的局部坐标。
图 3 采用简化布局:目标特征和锚点处于局部位置 0,后续占位依次是 1、2、3。多个目标层特征可以具有相同的局部位置,因为它们是同一边界的不同深度表示,层来源由 Depth Embedding 区分。
官方代码的 build_block_position_ids 允许一个固定长度的局部 token 组,并用有效组起点作为坐标原点。因此具体配置不一定恰好对应图中所有上下文槽位都为 0;不变的是,坐标跨度由局部组和块长决定,不随完整历史增长。目标模型验证时仍使用真实全局位置,不能拿草稿的局部坐标替换目标模型的 RoPE 位置。
局部坐标减少了草稿模型直接处理超大位置编号的负担,但目标特征本身仍可能随历史长度、任务内容和目标模型行为发生变化。固定草稿输入尺寸并不意味着任意长上下文上的接受率恒定。
主干并行输出的是表示,还不是有因果联系的完整候选
设主干为每个待预测位置生成向量 。这些向量包含由目标模型传来的历史信息和当前局部条件,但并行计算时,第二个位置尚不知道第一个位置最终会采样出什么 token。
例如一个代码片段的第一个候选可能是 if,也可能是 return;第二个位置的合理分布会随之改变。如果只对每个 独立做词表投影,就很容易得到各位置单独看合理、连起来却不一致的候选。目标模型验证只接受连续前缀,块内越早发生这种不一致,后面的计算越容易浪费。这就是顺序头存在的原因。
轻量顺序头:只补块内依赖
把条件分布拆成历史与本块前缀
设当前块的第 个候选为 ,锚点为 ,先前历史为 。目标模型真正需要的分布是:
并行主干的 已经通过目标特征间接获得 的信息,也知道锚点 ;它缺少的是实际生成的 。顺序模块因此只需编码短短的块内前缀,无须重新对整段历史做一次注意力。
论文使用低秩 RNN 风格的顺序头。把其状态记为 ,状态宽度 明显小于主干宽度 。状态会递归吸收上一个 token,然后与当前并行特征融合,得到当前候选分布。前一个位置选到 if 还是 return,现在可以沿这条短状态链影响后续位置。
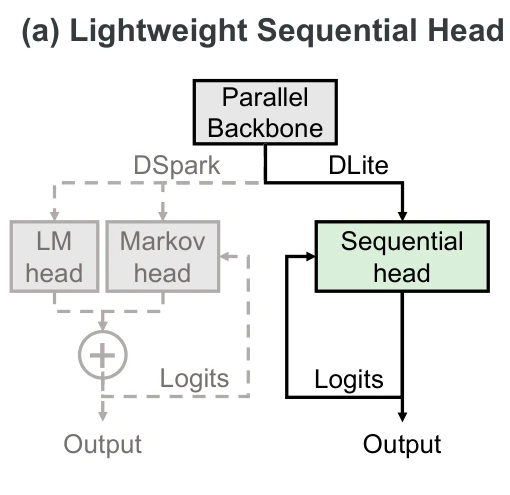
图 4,来源:DLite 论文 Figure 4(a),保留左侧架构子图。灰色路径先经过 LM head 得到词表空间的预测,再与顺序模块结合;DLite 的黑色路径直接把主干隐藏表示交给顺序头,最后输出 logits。图中的区别是计算路径,并不意味着 DLite 不再需要预测词表概率。
官方顺序头具体算了什么
在官方顺序头实现中,前一个 token 首先映射到 维 embedding。令 ,其低秩 embedding 为 ,则主要计算可整理成:
方括号加分号表示向量拼接。 把两个 维输入映射成两个 维输出; 经过 sigmoid 得到保留门 , 经双曲正切形成新状态候选; 表示逐元素乘法。门控决定保留多少旧状态、接纳多少新信息。 把状态和 维主干特征压成 维向量 ,再由 投影到大小为 的词表,产生 logits 。
从 logits 经过温度缩放和 softmax,得到草稿分布 ,再选出 ,进入下一位置。状态通常在当前块开始时初始化;配置允许时,还可用锚点之前的一个 token 做固定长度预热。这仍然只涉及局部前缀,不会把 RNN 状态跨整段对话永久累积。
这里的“低秩”对应狭窄的 维计算通道,不应理解成每一步都显式执行一次 SVD。主要串行矩阵计算大致包含 的状态更新、 的特征融合和 的词表投影;主干的多层计算则已经提前并行完成。
避免的是昂贵的中间词表投影
若主干每个位置先做一次 的完整投影,再把词表结果交给顺序模块纠正,就需要为所有位置支付约 的中间投影成本,还可能产生很大的临时 logits 张量。DLite 先在隐藏空间补依赖,最终用 的投影输出分布。
以论文 8B 配置的 、 为例,两者宽度之比是 8。对同一个词表,单看线性层乘法规模, 约为 的八分之一。但这只是一个矩阵维度比值,不能写成顺序头或完整推理必然加速 8 倍:状态更新、访存、kernel 启动和目标验证都还占时间。
顺序头仍然要逐个采样候选,所以 DLite 属于半自回归草稿。低秩词表投影也仍可能成为串行开销,尤其是在词表较大、草稿块较长时。它缩小了每个串行步骤所做的工作,没有消除自回归依赖本身。
论文最终给 4B/8B 目标分别使用 ;在 8B 的配置探索中,从 增到完整宽度 4096,平均接受长度仅从 3.30 增到 3.33,说明把串行模块做得更宽未必划算。
DLite 的专用草稿权重通过配套的两阶段蒸馏获得,实际推理只加载目标模型与最终草稿模型,中间教师不进入服务路径。
目标模型怎样验证,为什么草稿近似不等于输出近似
一次因果前向评估整条候选
草稿给出 后,目标模型把锚点与候选连成 ,在原有历史 KV 上执行一次因果前向。锚点位置输出预测 的分布, 位置输出预测 的分布,依此类推;最后一个候选位置还能输出下一个 token 的分布。
这些位置可以在一次前向里并行计算,是因为候选已经作为已知输入给定。因果掩码保证每个位置只读取它前面的候选,不会读取后面的位置。目标模型看到的仍然是完整历史加当前候选前缀,草稿端的局部注意力方式不会改变这一验证条件。
遇到第一个失败位置后,只能提交前面的连续候选。假设四个位置的比较结果是“通过、通过、失败、通过”,可接受的草稿前缀长度为 2;第四个位置建立在已经失败的第三个候选上,不能跳过去单独提交。官方实现用布尔比较结果的 cumprod 计算这种连续前缀。
贪心模式与随机模式要分别说明
温度为 0 时,目标模型取最大 logit 对应的 token。候选只要与这个选择一致就接受,首个不一致位置使用目标模型给出的 token 纠正。在目标前向、数值精度和规则相同的条件下,这会沿着目标模型的贪心路径生成。
正温度时,可以使用经典的投机拒绝采样。对已经走到的某个候选位置,设目标条件分布为 ,草稿实际采样分布为 ,且 ,则接受概率为:
这里 必须是产生这个候选时真实使用的条件分布,包含顺序头和此前块内 token 的影响。不能拿主干尚未纠正的分布代替,也不能在采样之后更改温度却沿用原始概率。
如果拒绝,则从归一化的正残差中补采样:
、 都是词表 token。接受分支对 token 贡献的概率质量为 ,拒绝后补回的质量为 ,两者相加恰好是 。因此,草稿分布可以近似,经过正确验证和补采样后,输出的条件分布仍能保持为目标分布。
这解释了为什么固定大小的目标特征即使漏掉某些历史信息,也主要伤害效率:草稿会更容易被拒绝,但不会因此绕过目标模型。前提是验证算法被正确实现,且所有影响目标分布的约束、惩罚和采样变换都进入验证流程。
官方实现还提供 match 模式:草稿候选取贪心值,目标端按指定温度采样,比较两者的连续匹配前缀,并在首个不匹配处采用目标采样结果。它不是上面的概率比接受规则,不能用 解释它的接受率。正温度下,对固定候选,每个位置的匹配概率取决于目标给它分配的概率;拒绝采样则通过分布重叠利用更多草稿概率质量。两条路径都需要正确处理首个失败后的条件前缀,不能仅凭参数名断言行为相同。
分布重叠怎样影响平均推进量
对拒绝采样,把所有候选 token 的接受概率求平均,可以得到单步接受概率:
其中绝对差之和的一半,是目标分布与草稿分布的总变差距离。其直觉是,两边分布重合得越多,越有机会接受草稿。主干提供历史条件,顺序头补块内条件,两者都在帮助草稿把概率放到目标模型也支持的 token 上。
但一个候选能不能提交,还取决于它之前所有候选是否通过。因此精确的平均推进长度关系是:
这个等式来自非负整数随机变量的尾概率求和。若仅为估算,把每个位置在前缀成功条件下的接受概率近似为同一个 ,才可以进一步得到 。真实任务中的位置差异和上下文变化不会自动满足这种近似。
早期候选的质量因此特别重要。第一步失败会让后面整块候选失去提交机会;在已经很可靠的远端位置继续增加计算,收益可能小于修复前几个位置的不一致。
一轮执行后,缓存、锚点与隐藏状态怎样对齐
下面按官方生成循环追踪状态。设目标模型已经处理了 个 token,对应 KV 长度为 ;又由末尾 logits 选出了锚点 。此时 已确定,但还没有写入目标 KV。
- 从已处理边界取多层隐藏状态,加入层来源标识;结合 与占位输入,构造固定大小的草稿问题。
- 草稿主干并行计算所有位置的隐藏表示,低秩顺序头产生候选 ,同时保留必要的采样 logits。
- 目标模型处理 ,临时 KV 长度最多增长到 。
- 验证得到连续通过的草稿数 ,把目标 KV 裁剪到 ,只保留锚点与接受候选对应的状态。
- 从最后一个有效输入位置的目标 logits 产生纠正或额外 token,作为下一轮锚点;同时从该位置取多层隐藏状态。
第五步的特征取自验证输出中的索引 ,对应输入 中最后一个有效位置。若没有草稿通过,索引 0 对应 ;若两个通过,索引 2 对应 。失败候选及其后缀虽然已经计算过隐藏状态,却不能被选作下一轮条件。
下面的伪代码只表达状态关系,未包含批处理、停止条件和随机验证细节:
cache, pivot_features, anchor = target_prefill(prompt)
while output_budget_remaining: U = parallel_backbone(pivot_features, anchor, placeholders) proposals, draft_logits = sequential_head(U, anchor)
old_length = cache.length out = target_forward([anchor] + proposals, cache) A, next_anchor = verify(out.logits, proposals, draft_logits)
cache.crop(old_length + A + 1) emit(proposals[:A], next_anchor) pivot_features = select_target_layers(out.hidden_states, index=A) anchor = next_anchor首个锚点由 prefill 阶段输出,之后每轮新增的是 个接受候选和一个新锚点,所以平均推进量正是前面的 。新锚点在下一轮才进入目标前向,因此生成 token 的逻辑进度可以比已处理 KV 边界领先一个位置。这个流水关系也解释了为什么直接用“输出总长度”裁剪 KV 很容易多保留一个尚未处理的位置。
少了一套回滚,但目标模型回滚仍然存在
传统草稿可能需要在验证后同步接受 token、修正草稿缓存长度、维护跨轮前缀。DLite 每轮重新构造局部条件,不必更新一套历史草稿 KV;循环头状态也只服务于当前块。
目标模型仍然必须撤销未接受候选的 KV。若改成分页缓存,撤销通常体现为恢复有效长度、回收或重新管理尾部物理块,而不是简单删除一段 Python 张量;这部分可结合 PagedAttention 的块管理与写时复制理解。无历史草稿简化了同步对象数量,没有取消投机执行本身的提交边界。
草稿块长与验证块长不是一个参数
论文实验统一提出 7 个草稿候选。公开 8B 配置里的 block_size 则为 8,因为包含 1 个锚点和 7 个预测位置。比较参数时必须先明确计数方式。
生成接口还有 verify_block_size,表示本次实际交给目标模型的、包含锚点的窗口长度。当前代码即使缩小验证窗口,草稿端仍先预测完整配置块,再丢弃未送去验证的尾部候选。因此,它可以减少目标验证工作,但不会按相同比例减少本轮草稿工作。要做真正按负载自适应的草稿与验证,仍需要把块长选择接入执行和调度路径。
多轮服务中,省下的状态与新增的接口
目标前缀命中,不等于草稿条件已就绪
智能体调用工具期间,目标模型可以暂停生成;工具结果返回后,把新增结果加入完整上下文,再由目标模型处理。DLite 随后只需要新的边界特征与锚点,无须对整段新增历史再做一次草稿模型 prefill。
但是,如果服务系统只缓存目标 KV,没有保存选定目标层的边界隐藏状态,那么下一轮即使前缀全部命中,也未必立即具备 DLite 所需输入。KV 是注意力的键和值,不能直接当作残差流隐藏状态使用。工程上可在缓存边界额外保存少量所需特征,或安排必要的边界重算;采用哪一种,需要与目标模型的前缀复用方式协调。
这部分是从数据依赖推导出的集成要求,不能当作当前公开 API 已经实现的功能。与 SGLang 的分层 KV 缓存结合时,除了 KV 命中与加载,还要定义边界特征的有效期、位置和模型版本归属。
固定的条件特征,不代表提取过程零成本
DLite 最终只保留固定大小的枢轴特征,但公开生成路径使用 output_hidden_states=True,再从返回的多层隐藏状态中选择当前位置。这在功能上直接,在长 prefill 上可能暂时产生按层、按序列保存的较大激活集合。
因此,“草稿历史缓存不随长度增长”与“整个实现的峰值内存不随长度增长”是两回事。服务化时可以研究只保留所需层、只导出边界位置的特征,避免为了少量输入长时间保存整段中间激活;能否做到、节省多少,需要在具体目标模型执行器里验证。
如果目标模型和草稿模型跨设备放置,还要传递这些特征。传输体积虽不随历史长度线性增长,但固定的同步、链路延迟和设备调度仍可能进入每轮关键路径。同设备运行时,也要关注特征采集、布局转换及生命周期,不应把“复用”当作完全免费的操作。
连续批处理仍然面对不同请求的接受长度差异
不同请求本轮可能分别接受 0、2、5 个候选。成熟服务系统需要允许它们以各自进度更新 KV、输出与下一轮元数据。公开 spec_generate 的匹配分支对批内接受长度取最小值,因此这一直接实现并未展示每个请求独立推进的完整服务调度;其随机拒绝采样分支还明确限制 batch size 为 1。
这不否定论文报告的并发结果,但意味着应区分论文实验实现、当前发布的 Python 推理路径,以及未来集成到服务框架后的执行方式。官方仓库仍把 SGLang 与 vLLM 集成列为路线图。部署时仍需处理请求加入和退出、分页 KV、批内不同长度、结构化约束以及 GPU 执行形状等问题。
性能数据应该用来验证哪些机制
论文的主要服务实验使用 NVIDIA H800,目标模型为 Qwen3-4B 和 Qwen3-8B,草稿主干为 5 层,提出 7 个候选。下表只选 Qwen3-8B 的少量结果,分别对应长输入、智能体任务和不同的瓶颈;数据来自 DLite 论文 Tables 2—3。加速比的参照均为对应的正常自回归解码。
| 工作负载 | DSpark 接受长度 | DLite 接受长度 | DSpark 加速比 | DLite 加速比 |
|---|---|---|---|---|
| LongBench v2 多文档问答 | 2.52 | 2.86 | 1.98× | 2.32× |
| LongBench v2 长对话历史 | 4.01 | 4.77 | 3.02× | 3.96× |
| AgentLongBench | 2.09 | 2.79 | 1.68× | 2.31× |
| SWE-Bench | 1.94 | 3.19 | 1.60× | 2.74× |
这些结果支持两个有限的判断。首先,去掉草稿历史 KV 后,借助目标表示仍能生成有用候选,并且在这些长上下文任务中提高了接受长度。其次,接受长度的改善可以转化为解码加速,但两者没有一一对应关系,执行路径本身也在影响分母。
SWE-Bench 一行里,DLite 相对 DSpark 的速度比为 ,即生成速率约高 71%;换成完成同样解码工作的时间,约减少 。不能把“速度提升约 70%”改写成“耗时减少约 70%”,也不能把正常自回归参照下的 2.74 倍与相对 DSpark 的 1.71 倍混用。
通用任务表中的 6.48 是 Qwen3-8B 在 GSM8K 上的平均接受长度,不是长上下文的加速倍数。另一个边界是并发:论文 Table 4 中,Qwen3-8B 的 Alpaca 吞吐加速从并发 1 时的 2.67 倍降至并发 64 时的 1.63 倍。这符合目标模型批量计算已经更充分、投机额外工作变得更难摊薄的系统直觉,不能只拿单请求数字预测满载服务收益。
智能体基准不都等于完整工具任务耗时
论文附录给出的设置比任务名称更重要:SWE-Bench 使用 50 个约 40K—64K 输入 token 的提示,AgentLongBench 使用 50 个约 55.5K—74.1K 的提示;记忆任务按问题构造独立长上下文提示。BFCL 使用 41 个长上下文多轮会话,聚合输入超过 32K token 的模型调用,并排除工具执行时间。
因此,这些评测同时包含长上下文提示和实际多轮 harness,不能一律解释成完整智能体任务从开始到结束的墙钟加速,更不能把推理速度当作代码修复成功率的提升。
公开代码还明确把 prefill 放在解码墙钟计时之前。论文称“端到端解码加速”时,应保留“解码”这一范围;对于整个请求和智能体工作流,还要计入目标 prefill、排队和工具执行。没有这些时间分解,就无法判断最终体验能改善多少。
复现入口与实际适用边界
先匹配目标模型、草稿权重和代码版本
官方权重集合提供与具体目标模型配套的 DLite 草稿。它依赖目标模型的层数、隐藏宽度、所选层与词表,不是任意小模型都可以代替的通用草稿器。升级目标权重、改目标架构或更换量化实现后,至少需要重新核对接受率与数值行为。
官方 API 的基本调用方式如下;这是接口示例,不是新的性能测试结果:
from dlite import DLiteEngine
engine = DLiteEngine.from_pretrained( target_model="/models/Qwen3-8B", draft_model="/models/Qwen3-8B-DLite", attention_backend="auto",)
result = engine.generate( "Explain how speculative verification handles a rejected token.", max_new_tokens=128, temperature=0.0, compile_sequential_head=False,)print(result.text)print(result.stats["accept_lengths"])print(result.stats["decode_wall_time"])auto 在可用时选择 FlashAttention 2,否则使用 SDPA;这只是注意力实现选择,不会自动完成连续批处理、前缀缓存或跨请求调度。accept_lengths 记录每轮接受草稿数加 1,不能直接拿来当每步草稿命中率。
当前发布状态还有一个具体的版本兼容问题:截至 2026 年 10 月 19 日核对的代码提交 d564f199,DLiteDraftModel 将 anchor_group_size 列为配置必填项;而核对的 Qwen3-8B-DLite 配置快照未包含该字段。按这两个版本的静态接口检查,加载会触发缺字段校验。因此,复现应先选择相互兼容的代码与权重配置,不能把上述 API 片段理解成已验证可直接运行的完整环境,也不能凭空填写一个与权重语义可能不符的值。
此外,当前公开循环把 target_total_time 记为整个解码墙钟,把 draft_total_time 置零,代码注释也说明该路径没有拆分目标与草稿事件。这两个字段不能用来反推出草稿耗时占比。需要时间分解时,应使用独立的事件计时或 GPU 性能分析工具,同时保留未经拆分的总时间作为参照。
哪些请求更可能受益
较适合的条件包括:目标历史很长,常规草稿维护历史代价较高;生成仍有足够长度,能够重复摊薄投机轮次;并发尚未让目标模型完全进入计算饱和状态;目标模型执行器可以低成本提供必要边界特征。这些条件共同作用,不能仅凭“智能体”这个应用名称决定是否启用。
相反,若一次请求主要花在长 prefill 上、只输出几个 token,或者工具调用等待占绝大多数时间,解码加速对整个任务的影响就会受限。设原始总耗时中可被加速的解码比例为 ,解码获得 倍加速,其他部分保持不变,则整个流程的加速比为:
分母前一项代表未改变的耗时比例,后一项代表加速后的解码耗时比例。例如假设解码仅占 30%,即使解码快 3 倍,总流程也只有 倍。这是时间占比算例,并非论文测量值。
对于较高并发,还要比较启用投机前后的实际吞吐、排队时间和尾延迟。更多验证位置会占用目标计算预算,顺序头也仍在串行输出词表概率;固定草稿输入尺寸只是减少一个增长源,不会使投机额外计算自动消失。块长、验证窗口和服务负载仍然需要一起调节。
DLite 提供的关键架构选择是把全局历史建模交给目标模型,把草稿限制为接收边界特征、预测局部短块和恢复块内依赖。这个选择同时改变了表示来源、位置范围和缓存所有权;它能否转化为实际服务收益,最终取决于验证的推进量与整条执行路径的成本。
参考资料
- DLite: History-free Speculative Decoding for Agentic AI,论文与提交记录。
- DLite 论文 HTML:架构、Tables 1—5 与附录评测设置。
- DLite 官方仓库:推理入口、权重列表与服务框架集成路线图。
- DLite 推理实现快照:局部位置、验证循环与缓存裁剪。
- DLiteSequentialHead:低秩循环状态与词表投影。
- DLite 采样实现:match 与 rejection 验证路径。
- DLite 官方 Hugging Face 模型集合。
- Fast Inference from Transformers via Speculative Decoding,精确投机采样原始论文。
- DSpark: Confidence-Scheduled Speculative Decoding with Semi-Autoregressive Generation。
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



