


GLM-5.3 推理全链路(十七):一条请求的精度账本——算子边界上的 dtype、scale 与舍入
这一篇补的是同一张时间线上的另一层
前十六篇把 GLM-5.3 的一条请求拆到了算子与通信的粒度:哪个阶段跑了哪些 kernel,哪一处触发了 AllReduce、AllGather 或 DeepEP 的 dispatch/combine,每一步的字节数和毫秒数落在哪里。这些篇目回答的是”做了什么”。但同一条时间线上还有一层没有被单独摊开:每个算子边界上,数据是什么数值类型,缩放因子在哪里生成、在哪里被消费,舍入发生在哪一步。
这一层不是实现细节的注脚。GLM-5.3 的权重以 FP8 发布,KV Cache 以 FP8 存储,MoE 的跨卡 dispatch 用 FP8 传输,而残差流、归一化、路由打分、采样又各自停在不同的精度上。一条请求从 token id 到最终文本,dtype 在 BF16、FP8 E4M3、FP32、INT32、UINT8 之间切换几十次。每一次切换都对应一个真实的 kernel 或一次真实的通信,也都对应一笔可以被算出来的字节账与误差账。把这一层讲清楚,才能回答几个在部署现场经常被问到的问题:为什么有些算子明明可以量化却没有量化,为什么通信不跟着 GEMM 一起降到 FP8,为什么索引器的 Top-K 对精度比主注意力更敏感,以及为什么”FP8 权重”并不等于”整条链路都是 FP8”。
这一篇按请求的时间顺序走,但每一站只问三件事:输入是什么 dtype,scale 从哪里来,输出被舍入成什么。 站点的顺序与前十六篇一致,读者可以把每一节对回对应的算子篇目。
先把 GLM-5.3 的数值常量摆出来
GLM-5.3 的模型结构复用 deepseek_v2.py,超参数在第十六篇已经列全。这里只保留与数值格式相关的部分:
| 项目 | 值 | 数值含义 |
|---|---|---|
| 权重格式 | FP8 E4M3,blockwise 128×128 | 每 128×128 权重块一组 FP32 scale |
| 激活格式 | FP8 E4M3,per-token-group 128 | 每个 token 的每 128 个通道一组 FP32 scale |
| 残差流 | BF16 | 6144 维,跨层保持 |
| KV Cache | FP8 E4M3 + BF16 RoPE 分量 | 每 token 656 字节 |
| 索引器 K 缓存 | FP8 E4M3,128 维一组 | 每 token 每层 132 字节 |
| 路由门控 | BF16 权重,FP32 累加打分 | 在 modules_to_not_convert 中显式排除 |
| 采样 | 概率 FP32,保存 BF16 | 温度、Top-K/Top-P 比较在 FP32 上 |
| 词表 | 154,880 | 嵌入与 LM Head 不参与 FP8 量化 |
E4M3 这个名字拆开看:1 位符号、4 位指数、3 位尾数,能表示的最大值是 448,最小正规数约 。3 位尾数意味着相邻可表示数之间的相对间隔约为 ,也就是 6.25%。单看这个数字,FP8 似乎粗得无法用于 744B 模型;真正让它可用的是 scale:每个块独立选一个缩放因子,把该块的动态范围映射到 E4M3 的 ,于是 6.25% 是”相对于块内最大值”的误差,而不是相对于整个张量。块越小,块内数值越同质,scale 越贴合,误差越小;代价是 scale 本身的存储与读取开销,以及 kernel 必须按块组织。
GLM-5.3 选了 128 作为块宽,这个数字不是随手定的。128 个 FP8 字节正好是 4 个 32 字节 sector,也是一次 Tensor Core MMA 在 K 维上的常见步长;一组 FP32 scale 占 4 字节,摊到 128 个元素上只有 3.1% 的额外字节。再小一半(64),scale 开销翻倍到 6.25%,而精度收益在 6144 维的激活上已经不明显;再大一倍(256),一个离群值会拖累更多通道。128 是字节效率与数值同质性之间的折中。
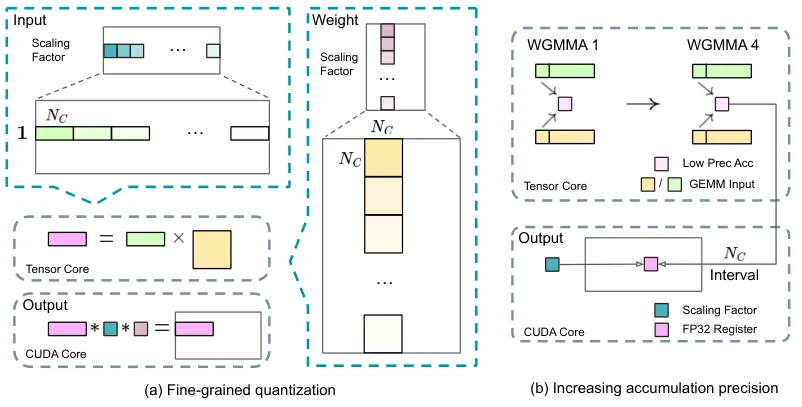
这张图把两条常被混为一谈的精度手段并排放在一起。左图是量的那一侧:scale 因子按更细的粒度分组,组内共享一个缩放因子,这就是 GLM-5.3 权重 128×128 块、激活 128 通道组的来源。右图是算的那一侧:Tensor Core 的低精度乘积累加器并不直接跨整个 K 维连续累加,而是分成若干区间,每段结束就把部分和回写到高精度累加器;GLM-5.3 的 FP8 GEMM 输出为 BF16、累加在 FP32,走的正是这条路径。两块一起看,才能理解为什么 FP8 的 6.25% 是乘法的误差上界,而不是最终结果的误差上界。
第 0 站:嵌入查表为什么停在 BF16
请求进入模型后的第一个算子不是 GEMM,而是嵌入查表。embed_tokens 是一张 的表,按 token id 取一行。这一步的输出是后续 78 层共享的残差流起点,dtype 为 BF16。
嵌入层不量化有两个原因。第一,查表不是乘加,没有 Tensor Core 可以加速,量化它不会带来算力收益,只会增加一次反量化。第二,嵌入向量是残差流的”种子”,它在后续每一层都会被读到;如果起点就带 6% 的相对误差,这个误差会进入每一个子层的输入,而残差流本身没有机会通过重新缩放把它洗掉。权重矩阵量化之所以可行,是因为每一层的 GEMM 都会重新计算激活的 scale;嵌入表没有这样的”重算”机会。
前 3 层是稠密 MLP,从第 4 层开始才是 MoE。稠密层的结构与 MoE 的共享专家相同:RMSNorm → 门控/上投影 → SwiGLU → 下投影。它们的 GEMM 同样走 FP8 blockwise,数值路径与后文的专家计算一致,只是没有路由与 dispatch。真正需要单独讲的是每一层开头的那次归一化,因为它是整条链路里 dtype 切换最频繁的地方。
第 1 站:RMSNorm 的两个出口
每个 Decoder 层的第一个算子是把残差加回去再做 RMSNorm:
其中 是 BF16 的残差流,, 是防止除零的小常数, 是可学习的逐通道缩放。求和与开方在 FP32 上完成,归一化后的结果乘回 ,输出仍然是 BF16。这一步看起来只是”归一化”,但它同时决定了下一层 GEMM 的输入格式。
SGLang 的 RMSNorm 有两个出口。若模型的量化配置是静态 per-tensor,归一化会与量化融合成一个 kernel:残差相加、RMSNorm、乘以固定的 FP8 scale,一次 launch 直接产出下游线性层要的 FP8 张量。这条路径在第十六篇的 launch 账本里被记为”norm + quant”一次。但 GLM-5.3 的权重是 blockwise 128×128,激活的 scale 必须按每个 token 的每个 128 通道组动态计算,不能用一个常数。于是归一化之后还要单独跑一次 per_token_group_quant_fp8:
# 简化后的形状:x 为 [num_tokens, 6144]# 每行切成 48 组,每组独立求 amax,再映射到 E4M3x_fp8, x_scale = per_token_group_quant_fp8(x, group_size=128)对一行 6144 维的激活,输出是 6144 个 FP8 字节加 48 个 FP32 scale,共 6336 字节;若不量化,BF16 是 12288 字节。量化在这里的首要收益不是算力,而是把下一层 GEMM 的输入字节减半,让权重读取与激活读取的带宽账更平衡。
每一组的 scale 计算是:
是 E4M3 的最大可表示值。除以它之后,组内最大值刚好落在量程边缘,其余值按比例缩小。反量化时乘以 即可还原量纲。量化误差的上界可以直接由 E4M3 的位宽推出来:3 位尾数意味着在 区间内相邻可表示数相差 ,相对误差不超过 ;这是”最坏情况”,对组内均匀分布的随机数值,均方误差约为 ,量级在 1.8% 左右。块宽 128 的意义就是让这个上界只对 128 个元素成立,而不会被整行里某个 outlier 撑大。E4M3 的位布局、次正规数与 NaF 的细节可参考站内 浮点数与数值稳定性:从 IEEE 754 到 FP8 的 LLM 精度世界。
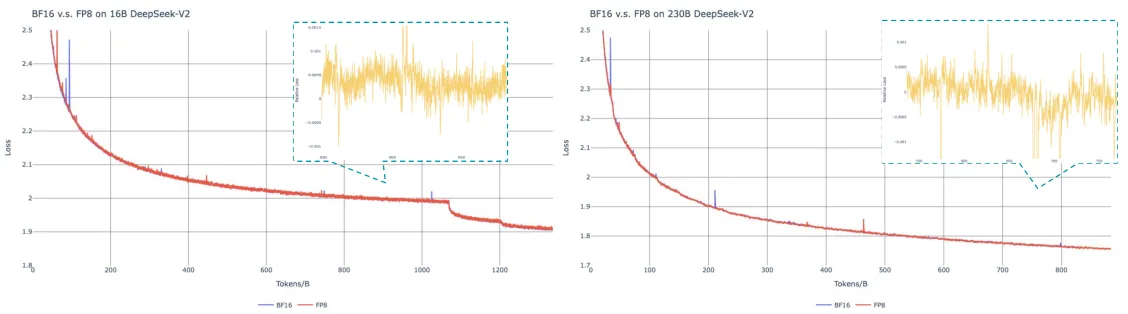
这条对比曲线是前面误差推导的实证注脚。6.25% 是单次量化的最坏情况界,但真实训练与推理里误差会在大量元素、大量 step 上相互抵消;只要 scale 的粒度足够细,FP8 的损失曲线就能贴着 BF16 走。GLM-5.3 把 128 作为块宽,本质上是在”让每条曲线贴住 BF16”和”让 scale 元数据别太贵”之间选了一个工程上可持续的点。
这里有一个容易忽略的点:scale 是按组存的,不是按 token 存的。同一个 token 的不同通道组可以有完全不同的 scale,这正是 blockwise 量化能容忍通道间动态范围差异的原因。若改成 per-token 单 scale,一个 100 倍的离群通道会把其余 6143 个通道压到 E4M3 的低指数区,尾数位迅速耗尽。
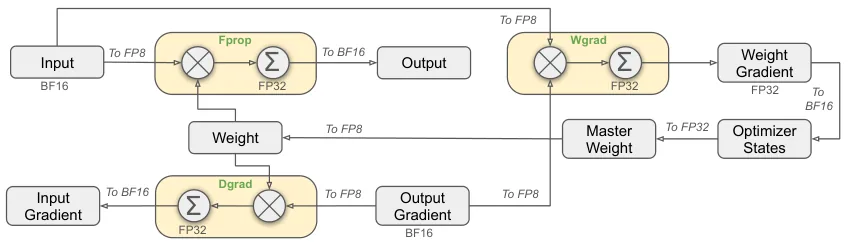
这张图来自 FP8 训练的框架流程,但同样说明了推理链路上的一个重要事实:权重以 FP8 发布,并不等于整条链路只有一个精度口径。图中 BF16 权重在进入矩阵乘前转成 FP8,主权重与优化器状态停在 FP32,梯度保持 BF16。GLM-5.3 推理时的 dtype 切换与这套路径同构:FP8 只在 GEMM 与 dispatch 的边界上出现,残差流、归一化、门控与采样各自停在 BF16 或 FP32,站与站之间的舍入点就是这张图里那些”To BF16”的箭头。
第 2 站:QKV 投影与 MLA 潜向量
归一化后的 FP8 激活进入注意力的投影矩阵。GLM-5.3 用的是 MLA,投影不是一组 ,而是两级低秩分解:
- Q 路径: 的 A 投影,接 RMSNorm,再 的上投影;
- KV 路径: 的 A 投影,其中 512 维是 KV 潜向量、64 维是共享的 RoPE 分量;潜向量再上投影出每头的 K NoPE 与 V。
每个投影都是 w8a8_block_fp8_matmul:左矩阵是按 128 组量化的 FP8 激活,右矩阵是按 128×128 块量化的 FP8 权重,累加在 FP32 上完成,输出 BF16。这里出现了整条链路的第一个”精度重置点”:GEMM 的 FP32 累加结果被舍入回 BF16,才进入下一级。为什么不在 FP32 里继续往下传?因为下一级仍是 GEMM,输入会被重新量化成 FP8;保留 FP32 只会让中间张量的字节翻倍,而 6% 的 FP8 误差已经由 scale 决定,FP32 中间值并不能把它变小。
Q 路径里的 RMSNorm 作用在 2048 维的低秩结果上,同样是 FP32 计算、BF16 输出,然后再量化进上投影。KV 路径的 64 维 RoPE 分量是一个例外:它在投影后要与位置编码做旋转,旋转是乘加,若在 FP8 上做会引入与位置相关的额外误差,因此这 64 维在写入 KV Cache 时保持 BF16。后文会看到,这正是 656 字节里那 128 字节的来源。
MLA 在解码时还会做”矩阵吸收”:把 KV 上投影的左半部分折进 Q,把右半部分折进输出投影,使得每个头只需与 512 维潜向量和 64 维 RoPE 做点积,而不必显式还原每头的 K/V。吸收后的权重 w_kc 在 SGLang 里可以是 BF16,也可以是 FP8。若走 FP8 路径,解码时先对潜向量做一次 per_token_group_quant_mla_deep_gemm_masked_fp8,再用 grouped_gemm_nt_f8f8bf16_masked 计算 64 个头的小矩阵乘;若走 BF16 路径,就是一次 torch.bmm。两条路径的 launch 数相同(量化 + 矩阵乘,或直接矩阵乘),差别在字节与误差:FP8 把吸收权重的读取量减半,但潜向量的 512 维本来就要从 KV Cache 读出,误差会叠加在已经量化的 KV 上。
第 3 站:两次 RMSNorm 与 FP32 兜底
MLA 路径里有两个容易被忽略的归一化:q_a_layernorm 作用在 2048 维的 Q 低秩结果上,kv_a_layernorm 作用在 512 维的 KV 潜向量上。GLM-5.3 的模型卡里,quantization_config.modules_to_not_convert 明确列出了 79 个 kv_a_layernorm 与 79 个 q_a_layernorm(78 个 Transformer 层加 1 个 MTP 层的参数各一份),以及 model.norm、model.embed_tokens、lm_head。
为什么归一化层被排除在 FP8 之外?从数值上看,RMSNorm 的输出是乘性缩放加逐通道增益 ,它的动态范围完全取决于输入行的 。不同 token 的 RMS 可能相差一个数量级以上,而这一维度没有任何可以利用的块结构;更重要的是, 是训练时学出来的逐通道系数,某些通道的 值可能很小、某些很大,若 被量化到 128 宽度的块里,小 通道会直接掉进 E4M3 的次正规区,相对误差远超 6%。归一化层参数量极小(每层 2048 + 512 个元素),量化收益几乎为零,误差风险却很高,所以模型发布方直接把它列为不量化模块。
与这两个 norm 一样被排除的还有 76 个 MoE 路由门控(mlp.gate)。路由打分的输入是 6144 维 hidden,输出是 256 个专家的 logit。若门控矩阵被量化,256 个 logit 之间的相对顺序可能改变,Top-8 选出的专家就不是训练时选的那些,模型的语义行为会发生比”数值误差”严重得多的变化。路由是离散决策,任何量化都必须保证排名不变;而排名不变的最稳妥方式,就是让门控矩阵留在 BF16 上,打分在 FP32 累加。
这组”不量化名单”本身就是一个精度设计决策。把 config.json 里的 541 个条目按类型数一遍,构成是这样的:
| 类别 | 数量 | 位置 | 不量化的原因 |
|---|---|---|---|
| 输入 / 注意力后归一化 | 79 + 79 | 每层残差流入口与 MLP 入口 | 残差流的缩放通路 |
q_a_layernorm / kv_a_layernorm | 79 + 79 | MLA 低秩投影之后 | 潜向量与 query 的缩放通路 |
MoE 门控 mlp.gate | 76 | 75 层 MoE + MTP 层 | 离散 Top-8 决策 |
路由偏置 e_score_correction_bias | 76 | 与门控同层 | 参与 expert 选择,必须保持 FP32 值 |
索引器 indexers_proj | 21 | 21 个 full 层 | 决定 Top-K 的头权重 |
索引器 indexer.k_norm(含 bias) | 21 + 21 | 21 个 full 层 | 索引 K 的缩放通路 |
MTP 层 hnorm / enorm / eh_proj / shared_head.norm | 4 | 第 78 层(MTP) | 草稿层的输入、输出与融合通路 |
model.norm / embed_tokens / lm_head | 3 | 模型两端 | 残差流的起点与终点 |
全部 541 个条目都在两类位置之一:缩放通路(归一化、索引器的投影与归一化)或离散决策通路(门控、路由偏置、索引器的头权重)。没有一条是普通的线性变换层。这张表比任何文字解释都更直接地说明了 GLM-5.3 的量化策略:FP8 只接手”算得最多、又可以用块 scale 局部兜住误差”的矩阵乘,凡是决定”选谁、按什么比例缩放”的地方一律留高精度。
索引器的 indexers_proj 不在 FP8 名单里,这一点尤其值得注意——它正是 wk_weights_proj 那类头权重投影。头权重 是 32 个头的投票权重,它们之间的相对比例决定了哪个头在打分中占主导;若这 32 个值被量化到同一块里,一个头被压到 6% 的误差就足以改变 Top-K 的排序。索引器的点积 kernel 可以全程 FP8,但生成这组权重的投影必须留在 BF16。
第 4 站:索引器——FP8 与排名稳定性
DSA 的闪电索引器是整条链路里对精度最敏感的地方,也是理解得越深越觉得”它凭什么是 FP8”的地方。索引器的打分函数是:
是索引头数, 是索引头维度, 是当前 token 的索引 query, 是历史 token 的索引 key, 是由 query 动态生成的头权重。对每个 decode token、每个 full 层、每个历史位置,都要算这个 32×128 的点积加权和。
这个函数有三个与精度直接相关的性质:
第一,ReLU 把负贡献截断为零。这意味着 logit 的下界恒为 0,量级永远非负;对 FP8 来说,非负数的符号位恒为 0,有效动态范围只剩 4 位指数与 3 位尾数。ReLU 不是为量化设计的,但它恰好让打分结果落在一段不跨越零点的区间里。
第二,它是排序,不是注意力。索引器输出的不是概率,而是 2048 个下标。只要 Top-2048 的排名正确,后续主注意力读到的 KV 就正确;排名有细微差错,也只是选错个别边缘位置的 KV。这是索引器可以用 FP8 的根本原因:离散选择对绝对精度不敏感,只对排名的稳定性敏感。
第三,FP8 的 query 量化把 scale 折进了权重。vLLM 做这一步时,先在 fused_indexer_q_rope_quant 里让 query 完成 RoPE 然后量化成 FP8,scale 取向上取整到 2 的幂(E8M0 形式):
scale_raw = tl.maximum(amax, 1e-10) * (1.0 / fp8_max)q_scale = tl.math.exp2(tl.ceil(tl.log2(scale_raw)))向上取整而不是四舍五入,保证 一定成立、不溢出;代价是 E4M3 的有效量程最多用掉到一半,尾数精度相应折损一位。之所以选 E8M0,是因为 scale 本身只需存 8 位指数,且乘除在硬件上退化为指数加减;这也是 DeepGEMM 在 Blackwell 上让 TMA 直接搬运 scale 的前提。
query 被量化时除掉了 ,FP8 点积的结果比真实值小 倍。这个因子没有被乘回那个巨大的 logits 张量( 量级),而是提前折进一维的头权重:
weight * q_scale * softmax_scale * head_scale这是”把小张量的修饰搬到大张量的修饰上”的典型手法。它同时说明索引器打分 kernel 的输入有三个精度口径:FP8 的 query、FP8 的 key、FP32/FP16 的权重,以及一个 E8M0 的 query scale 与一个 per-block 的 key scale。三者相乘的还原发生在打分 kernel 内部,输出 logits。
key 侧的精度口径取决于硬件。Hopper 上,SGLang 的 flashmla_sparse_q8 后端把 key 统一量化成 FP8 并配一个 per-block scale;Blackwell 上 trtllm 后端配合 DeepGEMM 的 fp8_fp4_mqa_logits,key 可以是 FP8 也可以是 FP4,scale 同样是块级。两种后端都把 key 的量化误差限制在 128 维块内,即索引器缓存的 132 字节里那 4 字节 scale 对应的范围。
logits 出来之后还要过一个精度决策:Top-K 选在 BF16 上还是 FP32 上。vLLM 在 SM100 上默认让 deep_select 内核直接吃 BF16 logits,省掉一次 FP32 拷贝;开 DCP(decode context parallel)时必须升到 FP32 再合并,因为不同 rank 各自算出的 logits 要做跨 rank 的 Top-K 归并,BF16 的舍入可能让两个 rank 对同一位置给出不同分数,归并结果不稳定。BF16 有约 8 位有效位,对”排名”已经足够,但跨 rank 的归并需要的是两次计算给出同一个数,这是精度之外的一致性要求。
索引器的 Top-K 还有一处跨 rank 一致性约束。TP 模式下索引器是复制在所有 rank 上的,各 rank 的 FP8 累加顺序可能微差,Top-K 下标可能不同;一旦不同,稀疏注意力读的 KV 页就分叉。SGLang 用 topk_indices 的 rank-0 广播解决这个问题:
def _broadcast_indexer_topk_from_rank0_impl(topk_indices): group.broadcast(topk_indices, src=0)这个广播发生在 FP8 打完分之后、主注意力读取之前,是把一个”精度问题”转化成”通信问题”的典型处理:与其纠结各 rank 的 1 ULP 差异,不如直接让一个 rank 说了算。
第 5 站:KV Cache——656 字节里只有 512 字节是 FP8
MLA 的 KV Cache 存储的不是每头的 K/V,而是 576 维的紧凑表示:512 维的潜向量 加 64 维的 RoPE key。GLM-5.3 在 vLLM 后端下有两种物理格式,字节数不同,本质差别是 RoPE 分量的精度:
| 格式 | NoPE 512 维 | RoPE 64 维 | 附加 | 每 token 每层 |
|---|---|---|---|---|
fp8_e4m3 | FP8,512 B | FP8,64 B | per-tensor scale 不计入 | 576 B |
fp8_ds_mla | FP8,512 B | BF16,128 B | 4 个 FP32 block scale,16 B | 656 B |
fp8_ds_mla 多出来的 80 字节,全部用在那个 64 维的 RoPE key 上:128 字节 BF16 对 64 字节 FP8,多一倍;再加 512 维潜向量的 4 个 FP32 块 scale(512/128 = 4 组,每组 4 字节),共 16 字节。合计 。
RoPE 分量为什么必须留在 BF16?这 64 维在写入缓存之前已经旋转过一次,读到时要再与 query 的 RoPE 部分做点积。位置编码的旋转角随位置线性增长,两个位置越远,旋转角差越大,key 向量在 64 维空间里的方向变化越剧烈。若这 64 维被量化,E4M3 的 6% 相对误差会变成方向误差,而对位置敏感正是 RoPE 的全部意义。另外,FlashMLA 这类 MLA 内核的计算约定是:潜向量与 RoPE 分量拼接后,潜向量部分按 FP8 解码,RoPE 部分直接按 BF16 读;这是 DeepSeek 官方 MLA kernel 的既有口径,fp8_ds_mla 就是把这条口径原样固化成了一种缓存布局。
这里有一个部署时容易被误读的地方:--kv-cache-dtype fp8_e4m3 并不能保证缓存一定是 576 字节。SGLang 的 --dsa-decode-backend flashmla_kv 与 vLLM 的 fp8_ds_mla 后端各自有一张字节地址表,实际每 token 字节数取决于后端而不是 dtype 字面值。1M 请求、78 层下,两种格式的差是 GB,这个差别足以改变一条请求能不能单卡放下。
主注意力的计算精度则是另一回事。索引器选出 2048 个位置后,稀疏 MLA 内核会按页 gather 这些 KV,在 FP8 上做点积,softmax 在 FP32 上完成,输出再按块 scale 还原。按 FlashAttention 完全拆解(一):IO 感知与分块注意力算法 里的在线 softmax 记号,分母 与累加项 都是 FP32,每处理一个 KV 块更新一次;这也是为什么 MLA 的稀疏内核在 FP8 计算之外仍要保留一份 FP32 的 状态。softmax 的归一化必须落在 FP32 上:FP8 的 P 值在 1/2048 到 1 之间跨三个数量级,低概率项的尾数在 E4M3 上只剩 0~1 位,若在 FP8 上归一化,这些小分量会直接变成 0 或 1/448 的整数倍。FlashMLA 的 sparse 内核在这里用的口径是”FP8 量化的 P 与 V,FP32 的 softmax 分母”——分母 是累加值,跨 2048 个位置累加,必须在 FP32 上。
第 6 站:o_proj、残差流与 AllReduce 为什么停在 BF16
顺带说明 576 字节的 fp8_e4m3 版本:它把 RoPE 也量化了,而且整份缓存共用一个 per-tensor scale。不同请求、不同位置的 RoPE key 幅度并不相同,一个全局标量只能贴合其中一个量级;fp8_ds_mla 把 RoPE 留在 BF16,等于用每 token 80 字节换掉了这个不可控项。两种格式的选择因此不是简单的”精度换内存”,而是”要不要为位置敏感的 64 维单独保留一条精度通道”。
主注意力的输出经过 o_proj 回到 6144 维,并加到残差流上:
残差流是 BF16。这一条看似只是”惯例”,其实是整个精度账本里最重要的一个选择。
残差流要在 78 层里被反复读取与累加。若残差流也量化成 FP8,每一层的加法都会重新舍入;E4M3 的 6% 相对误差不是”整体偏 6%“,而是每个分量各自独立偏最多 6%。78 次累加后,误差不会按 缓慢增长为单个 6%,而是沿着残差方向不断叠加新误差:残差流中原本很小的分量(例如某个通道的残差只占主信号的千分之一)在 FP8 上的表示精度取决于 E4M3 的指数位,小的数值会被压缩到极少的可表示阶梯上,细节丢失不可逆。BF16 的 8 位指数与 7 位尾数保证了残差流能跨 78 层而保持足够的相对精度;而每次子层的输出(attention 与 MLP 的结果)本来就只占残差的一小部分,这部分输出走 FP8 是可接受的。
这也解释了 AllReduce 为什么以 BF16 传输。TP 模式下,残差流或注意力的行并行输出需要跨卡求和。若在 FP8 上做 AllReduce,加法本身会引入舍入:每个 rank 送来的是块量化的 FP8 值,求和前必须反量化到同一 scale;不同 rank 的 scale 不同,合并后每个元素的误差取决于它所在的块,而且是8 张卡各自误差的叠加。Ring AllReduce 的每一步都是加法,8 卡三阶段下来,一个 token 的残差会经历多次舍入。BF16 传输的字节是 FP8 的两倍,但对 6144 维一小步来说,2.75 倍 ring 系数下的额外字节(每层约 1.5KB 差异)远小于为了在 FP8 上安全求和所需的元数据(scale 对齐、块边界处理)与精度损失。通信侧的取舍不是”越低精度越快”,而是”求和需要精度”。 这与 MoE 的 dispatch/combine 不对称是同一个逻辑的两面:dispatch 是搬运,每行数据原样送给一个专家,不需要跨 rank 相加,所以可以 FP8;combine 是8 份专家输出的求和,所以必须 BF16。
第 7 站:MoE——被排除在 FP8 之外的门控与 dispatch 的量化
MoE 层是 GLM-5.3 里 FP8 用量最大的地方。每层 256 个路由专家,每个专家三个矩阵 ,都是 128×128 块量化的 FP8;75 个 MoE 层的专家参数占了 744B 中的绝大部分。一次前向里,激活路径是这样的:
- hidden(BF16)进入门控 (BF16),打分用 sigmoid,结果与
e_score_correction_bias(FP32)相加,按组取 Top-8; - Top-8 权重归一化(
norm_topk_prob: true,除以 Top-8 之和),再乘routed_scaling_factor = 2.5; - hidden 按 128 一组量化成 FP8,连同 48 个 scale 一起 dispatch 到持有对应专家的 rank;
- 专家用 FP8 grouped GEMM 算 ,FP32 累加,输出 BF16;
- combine 把 8 个专家的输出按路由权重求和,BF16 传输、BF16 相加。
门控打分在 FP32 上完成(moe_router_dtype: "float32"),这和前面”门控不量化”是同一条原则的两级:权重留在 BF16,累加放在 FP32。路由输出是 256 个 logit,经过 sigmoid 后落在 内;Top-8 的排序依赖 logit 的相对大小,而 sigmoid 本身会压缩差距,FP32 累加确保了在 FP8 GEMM 有误差的情况下,门控这一步不会再把排名搞乱。
routed_scaling_factor = 2.5 是另一个与精度相关的细节。Top-8 权重之和被归一化为 1,再乘 2.5,使 MoE 的贡献在量级上与注意力、残差匹配。如果后续把这 2.5 折进专家权重里预乘,量化 scale 就会整体放大 2.5 倍,E4M3 的最大值 448 仍能容纳(权重通常远小于 1),但块的 scale 计算会被这个常数”污染”,动态范围利用率降低。保持乘法在路由输出上、不进入权重块,是量化友好的一种拆法。
dispatch 的量化有一个额外口径:scale 的布局。DeepGEMM 要求 scale 按列主序存放(形状 [组数, 行数]),并为 Blackwell 路径转成 UE8M0 且对齐 TMA:
hidden_states = sglang_per_token_group_quant_fp8( hidden_states, 128, column_major_scales=deep_gemm_wrapper.DEEPGEMM_SCALE_UE8M0, scale_tma_aligned=deep_gemm_wrapper.DEEPGEMM_SCALE_UE8M0, scale_ue8m0=deep_gemm_wrapper.DEEPGEMM_SCALE_UE8M0,)48 个 FP32 scale 是 192 字节,占一行 6144 字节负载的 3%;换成 UE8M0 的 8 位打包,48 字节,占比 0.8%。这个 2.2% 的差异在 1M 上下文、75 层、8 张卡的 dispatch 总量上不小,但更关键的收益在 kernel:scale 作为 MMA 描述符的一部分被硬件直接消费,反量化被并入矩阵乘,不再需要 kernel 内的逐元素乘。FP8 的收益从来不只是字节减半,而是反量化从软件路径消失。
combine 侧则固定为 BF16,SGLang 的 DeepEP 接口没有提供 combine 的量化通道,原因前面已经说过:8 份输出求和是跨 rank 的加法,不是搬运。若强行量化,需要回传每份的 scale,并在求和时做二次舍入,误差会叠加在 8 份上而不是只在一份上。
第 8 站:LM Head、logits 采集与采样
78 层走完后,model.norm(RMSNorm,BF16,FP32 累加)输出最后一层 hidden,进入 lm_head。lm_head 与 embed_tokens 一样在 modules_to_not_convert 里——输出投影的 154,880 行不能量化,原因与嵌入相同:它是残差流的终点,任何逐块量化都会让不同词表块的 logit 处在不同 scale 上,而 softmax 要跨整个词表比较。
纯 TP 模式下,LM Head 按词表切分,每个 rank 算 个 logits,然后一次 AllGather 拼成完整词表。这一步的 dtype 是 BF16:gather 的负载是 卡 字节(单 token),约 1.2MB;若压成 FP8 只有 0.6MB,但采样前需要完整的 BF16 logits 做 softmax 与温度缩放,反量化又要一次全拷贝。vLLM 的 batch-invariant 讨论里有一句结论值得记住:logits 采集本身必须是确定性的,否则同一请求在不同 TP 布局下会得到不同的采样结果;BF16 的逐 bit 一致比 FP8 的”省一半字节”更重要。
采样侧的精度口径是:
- 温度缩放 在 FP32 上做;
- Top-K / Top-P 过滤与采样均在 FP32 上做,阈值比较需要单调的排序;
- 结构化输出的 bitmask 在 logits 上做加法(
-inf掩码),在 FP32 上加; - 概率来自
softmax,通常 FP32 → BF16 存储,采样时再升回 FP32; - logprobs 输出保留原始 log 值,若请求了
return_logprob,额外算log_softmax。
投机解码时,验证段每个位置都要做一次接受判定,接受率由 的比较决定;这个比较对精度很敏感——两边的概率若分别以 BF16 存储,比值在接近 1 时容易因舍入而误判”接受/拒绝”。因此 vLLM 的拒绝采样实现通常在 FP32 上完成比值与随机数比较,最后才把接受的 token 写回。
把 dtype 切点连成一条线
把上面八站汇总,一条请求在 GLM-5.3 前向里的 dtype 时间线是这样的:
token id (INT64/UINT32) → embed_tokens (BF16 查表) → 78 × [ RMSNorm (BF16 入, FP32 算, BF16 出) → per_token_group_quant_fp8 (BF16 → FP8 + 48×FP32 scale) → QKV/MLA 投影 w8a8_block_fp8 (FP8×FP8, FP32 累加, 输出 BF16) → q_a_layernorm / kv_a_layernorm (BF16 入, FP32 算, BF16 出) → kv write: latent FP8 + rope BF16 → KV Cache → indexer: q RoPE+FP8 quant (E8M0) , k FP8 → FP32 logits → Top-K INT32 → sparse MLA: FP8 KV × FP8 Q, FP32 softmax, BF16 输出 → o_proj (FP8 块量化, BF16 输出) → [AllReduce BF16] 或 [attn DP AllGather/ReduceScatter BF16] → RMSNorm → MoE gate (BF16, FP32 累加, FP32 sigmoid) → dispatch: 128-group FP8 + scale (UE8M0 on Blackwell) → expert grouped GEMM (FP8×FP8, FP32 累加, BF16 出) → combine (BF16, 8 份求和) → AllReduce BF16 ] → model.norm (FP32 算, BF16 出) → lm_head (BF16, vocab-parallel) → AllGather logits (BF16) → sampler (FP32 温度/Top-K/Top-P/softmax, BF16 概率存) → token id (INT32)这条线里 dtype 切换一次,就对应至少一次 kernel launch 或一次集合通信。FP8 的收益路径很窄但很深:它只覆盖线性变换与 MoE 专家的矩阵乘,而这两者恰好是一层 decoder 里参数与带宽占比最大的部分;BF16 的保留路径很宽但很薄:残差流、归一化、门控、logits、通信求和,每一处的字节都不多,但每一处出错都会让整条链路的结果漂移。GLM-5.3 的 541 个不量化模块,正是这条”薄而宽”的路径在 checkpoint 里的显式声明。
从部署角度看,这条时间线能回答三个常见的排障问题:
为什么某些层开启 FP8 后 KL 散度明显变大? 大概率是路由门控或归一化被错误地纳入了量化。检查模型加载时 modules_to_not_convert 是否被框架正确读取——如果某个框架忽略了 mlp.gate,路由的 Top-8 会整体换人,KL 散度会从 1e-3 跳到 1e-1 量级。
为什么索引器的 Top-K 在跨卡间不一致? 索引器 query 的 E8M0 scale 是逐 token 的,FP8 点积在 FP32 上累加,但不同 rank 的累加顺序可能不同;这在大数相近时会造成排名并列与舍入差异。SGLang 的 SGLANG_DSA_TOPK_BROADCAST 是现成的开关,代价是一次 [tokens, 2048] INT32 的广播。
为什么把 KV 换成 fp8_e4m3 反而变慢了? 若后端是 fp8_ds_mla 语义的内核,它会按 656 字节布局读取,而 fp8_e4m3 缓存只有 576 字节,读到的 RoPE 段会错位。字节数少不代表更快,布局与内核口径必须匹配。
小结
GLM-5.3 的推理链路不是一个”全 FP8”系统,而是一套在 FP8 与 BF16/FP32 之间反复切换的精度分工。它遵循三条可归纳的原则:
- 连续变换进入 FP8,离散决策留在 BF16/FP32。线性层、专家 GEMM 走块量化,路由、归一化、Top-K、采样留在高精度——因为后者关心的是排名与选择,不是数值本身。
- 搬运可以量化,求和不可以。dispatch 是逐行搬运,FP8 安全;combine 与 AllReduce 是跨 rank 加法,BF16 才能保住结果。KV 的 RoPE 分量留在 BF16 也是同一条原则:它不是被搬运的数值,而是要被反复用于旋转比较的方向。
- scale 的位置与格式和 kernel 绑定。128 块宽对应 Tensor Core 与 TMA 的访存粒度,E8M0 与列主序对应 DeepGEMM 的 scale 描述符;改其中任何一个,都要同步改内核。
前十六篇把一条请求拆成了阶段、算子、通信和字节;这一篇补上的是那些字节以什么格式存在、在哪个边界上被舍入、scale 在谁手里。两者合起来,才是一条完整的时间线。
参考资料
- zai-org/GLM-5.3 模型卡(744B-A40B、FP8 blockwise,配置与 deployment)
- GLM-5.3 config.json(
quantization_config、modules_to_not_convert、moe_router_dtype) - GLM-5: from Vibe Coding to Agentic Engineering(GLM-5 技术报告,arXiv:2602.15763)
- DeepSeek-V3.2: Pushing the Frontier of Open Large Language Models(DSA、MLA 与索引器分数函数,arXiv:2512.02556)
- SGLang 源码:deepseek_v2.py(MLA、DSA、MoE 前向与量化分支)
- SGLang 源码:dsa_indexer.py(索引器 Top-K 与 rank-0 广播)
- SGLang 源码:fp8_kernel.py(per-token-group FP8 量化与 blockwise w8a8 matmul)
- FlashMLA:MLA 解码内核与 FP8 KV 布局
- DeepGEMM:FP8 GEMM 与 UE8M0 块 scale
- FlashInfer:稀疏 MLA 后端(
fp8_e4m3576 字节缓存格式) - vLLM 源码:deepseek_v32(GLM-5.3 共用的 DSA 模型实现与
fp8_ds_mla缓存) - DeepEP:MoE dispatch/combine 通信库
- DeepSeek-V3 Technical Report(FP8 混合精度框架、细粒度量化与 128 元素间隔的累加精度提升,arXiv:2412.19437,Fig. 6/7/10 为本文配图来源)
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



