


Ring Attention 完全拆解:分块注意力、在线 Softmax 与 KV 绕环的通信账
2023 年 10 月,UC Berkeley 的 Hao Liu、Matei Zaharia 与 Pieter Abbeel 在 arXiv 上公开了 Ring Attention with Blockwise Transformers for Near-Infinite Context。这篇论文要解决的问题可以用一句话概括:一张卡装不下一条足够长的序列。它不是让注意力算得更快,而是让序列本身被切开、放到多台机器的环上,并且声称切分不引入近似、不增加额外的通信与计算开销。
这个说法容易被误读。Ring Attention 并不减少总通信量,也没有改变注意力的渐进复杂度;它改变的是每个设备需要常驻的激活规模,以及通信与计算在时间轴上的相对位置。理解这一点,才能真正理解它的收益边界:为什么它在长上下文预填充里有效,为什么在逐 token 解码里通常不是首选,以及为什么因果掩码会把一个漂亮的环撕出一道负载不均的口子。
本文从一层 Transformer 的显存账开始,依次拆开分块注意力的在线 Softmax、KV 块绕环的调度、通信与计算重叠的算术条件、因果掩码下的负载失衡,以及预填充与解码两种负载下的收益边界,最后落到工程复现要点。
长上下文的第一道墙:单卡装不下序列
先看一组最朴素的数字。设隐藏维度 、批大小 、序列长度 。哪怕模型只有一层,且只保存这一层注意力的输出,bf16 下的激活也是
一层就接近 200 GiB,而当时主流的加速器 HBM 不到 100 GB。论文里给的说法更直接:处理一亿 token、批大小为 1,即使隐藏维度只有 1024,也需要超过 1000 GB 的显存。这个数字之所以比单层估算还大,是因为它把多层激活、块内临时量以及反向传播要保存的内容都算了进去。
在 Ring Attention 之前,主流手段是分块计算注意力。FlashAttention 一类工作把 的分数矩阵拆成小块,在 SRAM 里完成 Softmax 与加权求和,不再把完整的注意力矩阵写回 HBM;Blockwise Parallel Transformer(BPT)进一步把前馈网络也按块计算,把 FFN 的最大激活从 压到 。这些手段把单层的峰值激活降到了 ,但它们没有解决一个更根本的问题:每个设备仍然要持有整条序列的激活。
原因在于自注意力的全连接性:第 层的每个 token 都要和第 层之前的所有 token 交互。如果只把序列切开、让每台设备各算一段,而设备之间不交换任何信息,那么每段 token 只能看到段内上下文,结果就不再是原来的注意力。要保留精确性,就必须让每个查询块都能访问全部键值块;而只要一台设备要访问全部 KV,它就必然要能把整条序列的 KV 放进显存,或者至少能按需取回。
这就是 Ring Attention 的切入点:把「查询块」固定在各设备上,让「键值块」沿环流动。每台设备只需要常驻一个查询块、当前正在处理的一个 KV 块、以及用于接收下一块的双缓冲,显存与序列总长度解耦,只与块大小有关。
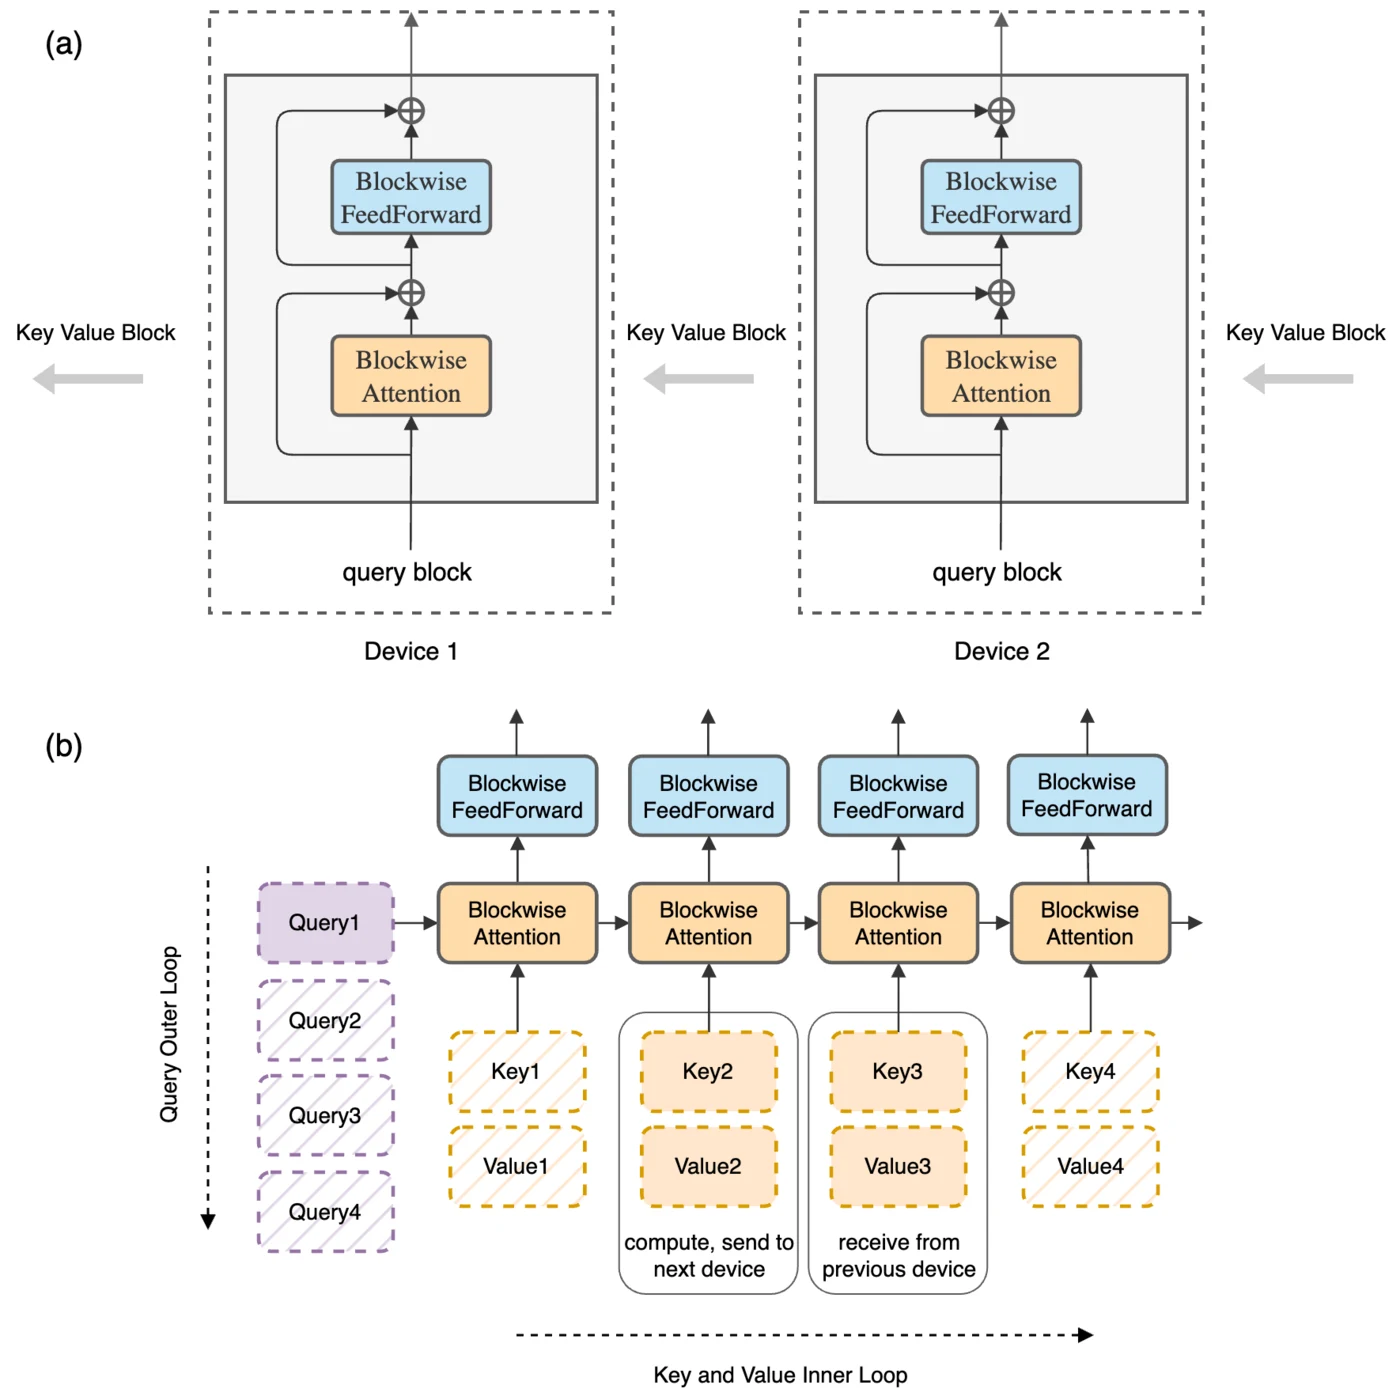
图 1 来自 Ring Attention 论文 的 Figure 2。上半部分画的是环:每台主机持有一个查询块,键值块沿环依次传递;下半部分把同一件事展开成矩阵视角——每台主机负责查询块外层循环的一次迭代,键值块则在内层循环里横向轮转。黄色方块是分块注意力,青色方块是前馈网络。这里有一个容易被忽略的细节:前馈网络只作用在本地的查询块上,完全不需要通信;真正需要跨设备协作的只有内层循环的键值块访问。
把一层 Transformer 的显存账算清楚
论文用一张表对比了四种实现的每层最大激活。设 为批大小, 为隐藏维度, 为头数, 为序列长度, 为块大小(与 无关),bf16 精度。
| 层类型 | 自注意力 | 前馈网络 | 合计 |
|---|---|---|---|
| 原始 Transformer | |||
| 高效注意力 | |||
| 高效注意力 + 分块 FFN | |||
| Ring Attention |
表的最后一行是这篇文章的核心。它不是说 Ring Attention 的注意力只需要六个块,而是说每台设备常驻的峰值激活只由六个块构成:
- 一个块存本地的查询 ;
- 一个块存当前正在计算的键 ;
- 一个块存当前正在计算的值 ;
- 一个块存从上一台设备接收、尚未开始计算的 ;
- 一个块存对应的 ,用于双缓冲;
- 一个块存本块查询的注意力输出,形状与查询块相同。
六个块,每块 个元素。论文按 计;如果换算成 bf16 的字节数,还要再乘 2,即 字节。两种口径都不影响关键结论:显存与 无关,只与 线性相关。
论文把最小序列长度取为 :一台设备常驻六个块,序列至少要有六个块的规模,切分与环才有意义。这是一个经验下界,不是严格的显存盈亏平衡点;严格的比较还取决于基线实现与模型形状。基于这个下界,论文给出了让通信完全被计算掩盖所需的最小块大小 ,以及对应的最小序列长度 。
| 硬件与互联 | 单机 FLOPS (TF) | HBM (GB) | 单向带宽 (GB/s) | 最小块大小 | 最小序列长度 |
|---|---|---|---|---|---|
| A100 NVLink | 312 | 80 | 300 | 1.0K | 6.2K |
| A100 InfiniBand | 312 | 80 | 12.5 | 24.5K | 149.5K |
| TPU v3 | 123 | 16 | 112 | 1.1K | 6.6K |
| TPU v4 | 275 | 32 | 268 | 1.0K | 6.2K |
| TPU v5e | 196 | 16 | 186 | 1.1K | 6.3K |
这张表透露了一个常被忽略的事实:Ring Attention 是否划算,首先由互联带宽决定,而不是由模型结构决定。在 NVLink 机器上,块大小一千 token 左右就能把通信藏进计算;同样的代码搬到 12.5 GB/s 的 InfiniBand 集群,块大小要两万四千 token、单机序列要十五万 token 才够本。对短序列做 Ring Attention 不但没有收益,反而会因为环上的串行步数而变慢。
在线 Softmax:让分块结果可以拼接
环上的调度之所以成立,靠的是一条纯数学性质:分块注意力的结果可以按任意顺序增量合并。这条性质不是 Ring Attention 发明的,它正是 FlashAttention 在线 Softmax 的核心;Ring Attention 只是把它从「一个 kernel 内的循环」搬到了「多台设备之间的循环」。
先把记号固定下来。设单头维度为 ,查询块 的形状是 ,键值块 同样是 。为书写简洁,本节按单头推导;所有头并行执行同样的运算,合并逻辑与结果形式都不变。查询块对第 个键值块的未归一化分数为
如果只看这一块,行级 Softmax 的结果是
其中 与 都是长度为 的列向量,分别记录每一行的最大值与指数和。这一块的局部输出为
注意 是未除以分母的加权和。真正的注意力输出是 ,但分母要等所有块合并完之后才能确定。
当第 块到达时,设备手里已经有一个三元组 ,它概括了此前所有块的结果。合并新块的三元组 需要三步。第一步取新的全局最大值:
第二步把旧的指数和与新的指数和都重新缩放到 的尺度上:
第三步对未归一化的输出做同样的缩放并相加:
最后,遍历完所有块后,输出为
这套公式看起来只是把 Softmax 拆开算,但它的意义在于:合并操作只依赖每个块的三个统计量,而不依赖块内具体的分数矩阵。设备不需要保存 的中间结果,也不需要知道其他块的内容;它只需要在每一轮把当前块压缩成 ,再与手里的运行状态合并。
块内计算与块间合并的分工,可以借图 1 的时序理解:黄色方块内部完成的是块内 Softmax 与局部输出,块与块之间的箭头对应三元组合并。图里没有画出的,是合并时那个指数缩放因子;它才是数值稳定性的关键。
可以把合并操作写成一个二元算子:
其中 。这个算子满足结合律,单位元是 。结合律并不显然,但可以直接验证:无论先把前两块合并、再并入第三块,还是先把后两块合并、再并入第一块,最终的最大值都是三者的最大值,指数和与加权和都等价于「以全局最大值为基准的一次性求和」。差别只在于中间结果被缩放的次数不同,最终的 完全相同。
结合律是 Ring Attention 的许可证。它意味着内层循环对键值块的访问顺序可以任意重排:正序、逆序、从中间开始、沿环轮转,数学结果都一样。于是「每台设备只持有自己那一块 KV」不再致命——只要让块依次经过每台设备,每台设备都能在自己的查询块上完成一次合法的增量合并。
需要强调的是,这里交换的是求和顺序,不是近似。浮点加法不满足结合律,所以不同顺序得到的末位比特可能不同;这也是分布式注意力难以做到逐比特确定的原因之一。但从数学定义上看,结果与全量注意力等价,没有丢弃任何键值块,也没有对分数做阈值截断。
一个常见的误解是「分块之后每块各自 Softmax,再把结果平均」。那样做是错的:每块的局部 Softmax 分母只覆盖块内 token,直接平均会改变权重分布。正确的做法是保留未归一化的分子与分母,最后统一相除。上面的三元组正是为此而生。
用伪代码表示单个设备的块内计算与合并,大致如下:
# 输入: q_block (c x d), 当前 kv_block 的 k, v (c x d)# 初始状态: m 全为 -inf, l 全为 0, acc 全为 0s = q_block @ k.T / sqrt(d) # c x cm_blk = rowmax(s) # cp = exp(s - m_blk[:, None]) # c x cl_blk = rowsum(p) # ca_blk = p @ v # c x d
m_new = maximum(m, m_blk)alpha = exp(m - m_new)beta = exp(m_blk - m_new)l = alpha * l + beta * l_blkacc = alpha[:, None] * acc + beta[:, None] * a_blkm = m_new# 所有块处理完后out = acc / l[:, None]这段伪代码与 FlashAttention 前向的块内循环几乎一样,唯一的区别是:FlashAttention 的循环在一个 kernel 内完成,所有块都在同一块 HBM 里;Ring Attention 的循环跨越设备,块必须通过网络到达。数学没变,工程约束完全变了。
预填充与解码:环最适合哪一段
在讨论因果掩码之前,需要先把推理的两个阶段与环的结构对齐,因为后面的所有结论都依赖这个对齐。
| 维度 | 预填充(prefill) | 解码(decode) |
|---|---|---|
| 查询长度 | 等于 prompt 长度 ,一次性处理 | 每个请求 1 个 token |
| 计算特征 | 矩阵乘主导,计算密集 | 带宽密集,每 token 要读全部 KV |
| 主要瓶颈 | 显存容量与 计算 | KV 读取带宽 |
| 延迟指标 | TTFT(首 token 延迟) | TPOT(每 token 延迟) |
Ring Attention 在预填充里有天然的位置:整个 prompt 就是一批查询,按块切开后每台设备都能拿到长度约为 的查询块,块内计算量是 ,其中 。只要 ,KV 传输就能被算力掩盖,显存也从 降到 。
在解码里情况完全不同。解码的每个 token 只有一行查询,块内计算量是 ,而每次仍要传输 字节的键值块;计算与传输的比值被摊薄了 倍,传输稳稳地落在关键路径上。更关键的是,解码的每台设备仍要读到自己负责的全部历史 KV;问题在于如何更便宜地读它们,而不是如何把激活摊开。把 KV 分到更多设备上并不能减少单台设备需要读取的 KV 总量,只会增加每台设备等待 KV 到齐的时间。所以 Ring Attention 在解码里几乎总是负收益,除非把它和更大的批或更长的一次性处理结合,让查询侧重新变厚。
这个对齐也解释了论文附录里的推理算例为什么成立:它描述的是一个批大小为 1 的长上下文服务,查询侧 token 数就是整个上下文长度;论文给出的重叠条件是 ,对应单机带宽约为算力的两倍,并假定一个很高的 MFU。在实际在线服务里,这个算例更接近「一次非常长的预填充」,而不是「逐 token 解码」。
KV 绕环:通信与计算的重叠
现在讲调度。论文的算法可以压缩成三层循环:
- 初始化:把输入序列切成 块,每台主机拿一块,各自在本地算出 。
- 按层循环:对每一层 Transformer,先做注意力内层循环,再做本地前馈。
- 内层循环:从第 1 轮到第 轮,所有主机并发地做两件事——用本地查询块与手里的键值块做一次增量注意力,同时把这块键值块发给下一台主机、从上一台主机接收一块新的。
第 0 轮不算通信,因为每台主机手里本来就有自己那块 。之后每轮交换一次, 轮之后,每台主机正好见过全部 块。用下标描述:第 轮时,主机 手里拿着的是主机 的键值块。 时就是它自己, 时是下一台主机的块。
论文的 JAX 实现里,这个下标直接写成 (lax.axis_index(axis_name) - idx) % axis_size。交换本身用一次全环置换完成:
k, v = map( lambda x: lax.ppermute(x, axis_name, perm=[(i, (i + 1) % axis_size) for i in range(axis_size)]), (k, v),)ppermute 是一次置换式的集合通信:每个 rank 把自己的数据发给置换指定的另一个 rank,同时从另一个 rank 接收对应数据。在环上,它就是「把数据传给下一位」。scan 沿轮次推进时,前一轮的 k, v 由 ppermute 更新后传给下一轮,块内注意力则在更新之前用当前块完成合并。这段代码和上面的轮次调度,构成了 Ring Attention 前向的全部骨架;其余部分都是把块内注意力接到已有的分块注意力函数上。
还有一个设计选择值得说明:为什么让 KV 绕环,而不是让 Q 绕环。每台设备的输出必须留在本地,因为它对应本地查询块的最终结果;如果让查询块绕环、KV 固定,那么每一轮都会在远端产生一份「别的查询块的部分输出」,最终还得把这些部分输出收集回它们的归属设备,否则就要在环上再做一次归约。让 KV 流动则相反:部分输出天然落在查询块所在的设备上,环上只搬运只读的键值块,不需要回传任何结果。这是 Ring Attention 能用单向环完成精确注意力的关键。
为什么要重叠,而不是先收齐再算
如果先把所有 块 KV 收齐,再一次性做注意力,显存会退回 量级,环就失去了意义。所以必须在「每收到一块就算一块」的前提下,让传输与计算同时进行。
论文把这个条件写得很干净。单看注意力本身:一个尺寸为 的查询块与一个同尺寸的键值块做分块注意力,需要
需要传输的数据是键块与值块各 个 bf16 元素,共
设单机算力为 、单向带宽为 ,则计算时间约为 ,传输时间约为 。要让传输被计算掩盖,需要
原文默认查询块与键值块等大,都用 (在这一点上它按「块对」而不是「单块注意力的某一侧」记账,但约分结果相同)。如果把查询块的长度记作 、键值块的长度记作 ,条件是 ,即 。这个改写很重要:决定能否重叠的是查询侧一次处理多少 token,而不是 KV 块有多大。预填充时 可以与 同量级;解码时 ,条件立刻失效。后面的推理一节会反复用到这一点。
论文特意说明,这个推导忽略了 Q/K/V 投影和前馈网络,因为它们只增加计算、不增加设备间通信,所以得到的条件是偏紧的。这也解释了为什么真实实现里实际需要的块大小可能比 略小。
这个条件还有一个容易被忽视的前提:它假设带宽 是实际可达的单向带宽。对 NVLink 而言,论文按 300 GB/s 计,也就是 A100 NVLink 的单向带宽;但如果代码里用的是双向共享的链路,或经过 NCCL 的多跳路径,实际单向带宽会明显低于标称值, 相应变大。论文给出的「最小块大小」因此更接近理想条件下限,而不是工程保证。
换算成时间轴
以 A100 NVLink 为例: TFLOPS,单向带宽 GB/s,于是 。取 、批大小为 1,一块尺寸为 的查询与 KV 做注意力,计算量约为 FLOPs:
| 块大小 | 计算 FLOPs | 计算时间 @312 TF | 传输字节 | 传输时间 @300 GB/s |
|---|---|---|---|---|
| 512 | 256 KiB | |||
| 1024 | 512 KiB | |||
| 2048 | 1 MiB | |||
| 4096 | 2 MiB |
表格里的时间都按峰值算力与峰值带宽计,是理想值。 时两者几乎相等, 时计算时间是传输的两倍,通信可以完全藏在计算背后; 时传输是计算的两倍,每轮都在等数据。实际实现里还有一个隐藏的放大项:ppermute 只替换键值块,但每轮还要处理块拼接、掩码和 kernel 启动,这些都落在通信与计算之间的间隙里。论文的 JAX 实现把环上的块大小与 SRAM 内细分的查询/键值 chunk 分开,原因就在这里。
反过来看 InfiniBand: GB/s,,块大小需要两万四千 token 才能重叠。这就是为什么论文在 32 张 InfiniBand A100 上的实验里,序列长度必须拉到非常长才有意义——论文报告 7B 模型可达 4096K 上下文,但那是全集群的序列;折成单机,每台设备处理 128K,块大小自然远大于两万四千。
对 TPU 而言, 同样落在数千量级:TPU v4 为 ,TPU v5e 为 。这也解释了为什么论文的 JAX 实现主要面向 SPMD 风格的多主机部署,而在 GPU 上则需要更留意块大小与互联带宽的匹配。
每层的通信量
在 台设备上做一次前向,每层的键值块要在环上转完整一圈,每台设备要把手里的 KV 块发出 次(每轮一次,累计经过 个块)。单机发出的字节数是
全集群的发送总量为 。由于 (块大小乘以设备数等于序列长度),可以写成
即总通信量随序列长度线性增长,随设备数线性增长。这与 Ring Attention 的显存收益形成对照:显存与 无关,通信与 有关。当 很大时,环上的总流量并不小,只是它和计算并行、不落在关键路径上。这也是后面讨论「什么时候不用 Ring Attention」的出发点。
一个容易被忽略的边界:环是串行的
轮交换意味着环上存在一条串行的依赖链:第 轮开始时,主机 必须已经收到第 轮的块。这条链的长度是 ,每一环都依赖上一环,不能像数据并行那样让不同 rank 独立推进。即使每轮的传输都被计算完全掩盖,总时间仍然是 个「计算或传输中较慢者」的累加,而不是一次并行完成。设备越多,单轮计算越短,但轮数越多;两头相抵,上下文可以线性变长,而单次前向的墙钟时间不会随设备数下降。
实践中,这要求各设备在同一个环上的计算时间尽量一致。块大小不一、专家负载不均、或者某一台设备的降频,都会在环上被放大为全局延迟。这一点在因果掩码的场景下会被推到极致,下一节展开。
(训练时的反向传播需要在同一个环上再走一遍,并让 随键值块一起流动;这属于训练系统的话题,本文聚焦推理侧的机制与边界,不展开。)
因果掩码与负载不均
上面所有推导都默认注意力是双向的:每个查询块都要和每个键值块算。真实的自回归语言模型使用因果掩码:位置 的查询只能看到位置 的键。这条约束把「对称的环」变成了一块三角形。
三角形里的空转
设序列被切成 块,块 负责查询位置在 的那一段。因果掩码下,块 的查询只能访问块 到块 的键。于是每台设备真正需要计算的 KV 块数是 ,但它仍然必须参与全部 轮交换:
| 主机 | 分到的查询块 | 有效计算的 KV 块数 | 仍需参与的交换轮数 |
|---|---|---|---|
| host 0 | 1 | ||
| host 1 | 2 | ||
| host 2 | 3 | ||
| host | |||
| host |
平均下来每台设备有效计算 块,而最忙的那台要算 块。环是全网同步的:所有主机必须同时完成本轮、同时进入下一轮;已经算完自己那份有效块的主机不能提前退出,因为它手里的键值块还要继续往后传。于是空转设备只能干等,或者接收并丢弃自己不再需要的块。
从总时间看,环的轮数由最忙的设备决定:它需要完成 块增量计算,而每轮推进一块,所以至少要 轮;其余设备在这 轮里大部分时间闲置。稳态利用率约为 ,设备越多越接近 50%——投入的设备越多,上下文能拉得越长,但被闲置的那一半算力并不会因为设备变多而消失。这不是一个可以靠调参绕开的工程细节,而是因果三角形的结构决定的:整个矩阵里只有一半的条目是有效的,而这一半的有效工作天然集中在序列后半段的查询上。
论文的算法本身没有针对这一点做特殊处理:它在所有主机上都跑 轮,对落在因果掩码之外的块,要么跳过计算,要么照常计算但只得到被掩码成 后全零的贡献。后一种做法会在显存与带宽上白白消耗一半;前一种做法节省了计算,但键值块仍要沿环传递。
一个可以手算的缓解:折返分配查询
因果三角形里,块 的工作量是 个 KV 块。最自然的补救是让每台设备同时负责一段前部序列和一段后部序列,使两边的工作量相加接近常数。设设备总数为 ,把每个块再对半切成两个半块,一共 个半块,让设备 负责半块 与半块 。
半块 覆盖原块 的一半,能看到的 KV 块数约为 。把它代入两个半块:
式中的 与 相互抵消,剩下只与 有关的常数;忽略半块边界上的取整,每台设备承担的工作量与 无关。设备 0 拿到最靠前的半块(只看 1 个块)和最靠后的半块(看 个块),设备 拿到中间偏后的两段,两边一平均,负载被抹平。
折返分配的代价是掩码逻辑变复杂:设备手里的两个半块处于序列的不同位置,每一轮收到的 KV 块对两个半块的因果有效性不同。此外,块与轮的对应关系不再是简单的 ,接收方需要根据自己负责的两个半块算出不同的访问下标。工程上通常把两段的处理拆成两个交错的子循环。
其他两种思路
- 按条纹分配 KV。把 KV 块按「条纹」方式分配给设备,而不是整块分配,让每个设备在一轮里拿到的是来自不同块的相同相位切片。这样每轮的计算量更整齐,代价是键值块的布局不再连续,块内注意力 kernel 需要处理跨块拼接,掩码也要按条纹位置重算。
- 改变划分粒度。把整条序列划分为更小的块,让环上每个 rank 在每轮处理多个小块的组合,以平均化空转。这与 的重叠条件直接冲突:块越小,单轮计算越难覆盖传输。
这些思路的共同点是:因果掩码下的负载不均是一个调度问题,而不是数值问题。在线 Softmax 依然有效,结果依然精确,变的只是每台设备在哪一轮、处理哪一段。对推理侧的长上下文预填充,这类重新分配同样适用,因为预填充的查询块本身也受因果掩码约束。
对推理侧的含义
对推理中的长上下文预填充来说,因果掩码同样存在,但负载分布不同。预填充时查询是整个 prompt,本身也是被切开的对象;如果按块把 prompt 分给各设备,块 的查询同样只能看到前缀,所以三角形负载不均的结构照旧出现。不同之处在于预填充的查询总量是固定的、一次性完成的,调度层可以在发送 prompt 之前就把块与设备的对应关系重新安排一遍,而不必等训练循环开始。
但推理还有一个额外约束:生成阶段的每个新 token 都要看到全部历史,而这部分通常是逐 token 解码,查询长度只有 1。在长度 1 的查询上,块内注意力的计算量是 (不是 ),而传输量仍是 字节, 条件完全无法满足——传输时间远大于计算时间。这就是 Ring Attention 在逐 token 解码里通常不作为首选的算术原因。论文正文主要讨论的是训练,并在附录里说明 Ring Attention 同样可用于推理:用环把 KV 缓存分到多台设备上,从而支持远超单卡容量的上下文。论文给的推理算例(32 张 TPU v5e 上服务 LLaMA 7B)默认的负载是批大小 1 的长上下文服务,此时查询侧的 token 数按整个上下文计,而不是逐 token 追加。
对推理系统的实际部署而言,更常见的组合是:预填充阶段用序列并行把长 prompt 切开,解码阶段让每台设备持有自己那段 KV 并回到分页注意力。两种做法可以并存:预填充在环上完成并留下分布式 KV,解码时由各设备分别读取本地那段,或者通过 KV 传输(P/D 分离)把 KV 集中到解码节点。相关交接机制可参考 GLM-5.3 的 PD 分离拆解。
推理侧的适用性与工程复现要点
结论:预填充有效,解码不划算
基于前面的算术,可以给出一个相对明确的判断:
| 阶段 | 查询长度 | 单块计算 FLOPs | 单块传输字节 | 重叠条件 | 判断 |
|---|---|---|---|---|---|
| 预填充 | (与 同量级) | 长 prompt 分块后可行 | |||
| 解码 | 1 | 不可能满足 |
预填充阶段,如果每台设备分到的查询长度 不小于 ,通信就能被计算掩盖;解码阶段,,传输时间永远大于计算时间,环上的每一步都在等数据。GQA 与 MLA 会缩小键值的实际维度:GQA 让多个查询头共享一组 KV 头,MLA 把 KV 压成低秩潜向量,两者都直接减小 这一项。它们能缓解解码的带宽压力,但改变不了「查询长度为 1、没有 倍的算术强度可摊销」这一结构。
论文附录 C 给出了一个具体的推理算例:在 32 张 TPU v5e 上用常规方式服务 LLaMA 7B,批大小为 1,按注意力头切分到各设备时,受 KV 缓存激活大小限制,最多只能服务 256K 上下文;若用 Ring Attention 让 KV 在环上轮转,可按设备数扩展 32 倍。论文把推理侧的重叠条件写成 ,即 。TPU v5e 的标称算力为 196 TFLOPS、单向互联带宽为 186 GB/s,;若把有效算力按 40% MFU 折算(约 78 TFLOPS),,条件成立。论文自己把 40% 的 MFU 称为「不合理地高」,也就是说,这个算例给出的边界相当乐观。
对这个算例需要保持一点审慎。重叠条件里的 是推理实际能达到的算力,而不是芯片标称的全精度峰值:解码式或单查询的行不能把矩阵单元喂满,有效 会远低于标称值。 越低, 越容易满足,所以「环能重叠」本身不难;难的是在重叠之外,还要让每台设备真正忙于有意义的计算。换句话说,条件成立说明重叠是可能的,而不是说明一定能重叠。
实现层的几个坑
如果要在自己的栈里复现 Ring Attention,以下几点比算法本身更容易出问题。
块大小必须与互联带宽匹配。在 NVLink 机器上取 左右是合理的;在以太网/InfiniBand 上, 必须比 大得多,但这又会导致单块显存上升、跨机传输的报文变大、以及流水线变粗。论文的 JAX 实现用 key_chunk_size 与 query_chunk_size 把块再细分到 SRAM 友好的粒度,粗粒度的环交换与细粒度的块内计算是两层不同的切分,不应混为一谈。
环的拓扑与硬件拓扑要对齐。论文说它的分析同时适用于 GPU 的 all-to-all 拓扑与 TPU 的 torus 拓扑,因为它只依赖相邻两台主机之间的通信。但在 GPU 集群上,「相邻」是按 rank 编号定义的,而 rank 编号到物理链路的映射由 NCCL 与网络拓扑决定。如果环的顺序与物理拓扑不匹配,通信会穿过非预期的交换机层级,带宽会掉一个数量级。典型做法是按 NVLink 域内的拓扑顺序给 rank 编号,或者对环的排列做显式配置。
因果掩码的空转要提前设计。如果直接照搬论文算法,因果场景下总轮数由序列最末的那一块决定,前部查询的设备在大部分轮里都在空转。做长上下文预填充时,可以在调度层重新分配查询块(折返式),或者把多段序列交错地分给同一台设备,让每台设备在空转轮里处理另一段序列的有效块。后者的代价是内存与掩码表要同时管理多段,但不需要改变环的同步协议。
数值稳定性依赖运行最大值。三元组合并中每一轮都要做 的缩放。如果某些块的最大值远大于后续块,旧的累加量会在一轮轮的缩放中逐步变小,最后虽然数学上仍等价,但浮点误差会累积。实践上通常用 fp32 保存 ,只在输出时转回 bf16。论文的 JAX 实现里,如果查询是 fp32,就把 升到 fp32 计算分数;如果查询是 bf16,则分子和分母都按查询的 dtype 累加,在 bf16 下需要格外注意这一点。
块与 chunk 是两层切分。环上的块大小决定了显存与通信的粒度,而一个块内部的查询/键值 chunk 大小决定了 SRAM 内的 tile。前者要满足 ,后者要满足 FlashAttention 对 tile 与 warp 划分的约束;把两者混为一谈,会出现「块大小调大了、块内 tile 没变」的现象——通信确实被掩盖,但块内 kernel 的寄存器压力或共享内存用量反而成了另一个瓶颈。
与现有注意力 kernel 的对接。分块注意力本身最好直接复用已经优化过的 FlashAttention 内核,而不是自己重写。论文的 JAX 实现就是调用已有的 _blockwise_attention_fwd 来更新三元组,环的逻辑只是一个外层 scan。工程上的正确姿势是:把 FlashAttention 的「块内计算」当作黑盒,只把它的返回值扩展成三元组,再在最外层加一次 ppermute。
最后一轮交换是多余的。论文的伪代码写的是 轮交换,但仓库里的 scan 对 arange(0, axis_size) 迭代 次,每轮末尾都执行一次 ppermute;最后一轮计算完后仍会把键值块传出去,接收方也会接收,但不再使用。这不影响正确性,只多一次可以省掉的交换。复现时如果把轮数改成 ,要注意块的初始位置与因果掩码下标的对应关系,别把「最后一轮不交换」误写成「第一轮不交换」。
与 FlashAttention、上下文并行的关系
Ring Attention 和 FlashAttention 是正交的。FlashAttention 解决的是「一次注意力里怎么少读写 HBM」,Ring Attention 解决的是「一条序列怎么分摊到多台设备」。两者可以叠加:Ring Attention 的每个块内部完全可以跑 FlashAttention,事实上论文的实现就是这样。
但它与另一种常见方案——上下文并行——的关系更微妙。上下文并行(context parallel)按序列维切分 KV,每个设备持有一段 KV,在计算时通过集合通信交换 KV 或注意力结果;FlashAttention-2 之后的许多实现都把 Ring Attention 作为上下文并行的一种具体形式。区别在于通信的组织方式:Ring Attention 用点对点环交换,把通信与计算逐块重叠;另一种做法是一次性 AllGather 全部 KV,实现简单但显存压力大、通信集中。前者适合超长序列与高带宽互联,后者在短序列或低带宽网络上更简单且往往更快。
在推理框架里,上下文并行往往以实现为「类环」的形式出现在预填充阶段:把长 prompt 切段,各 rank 轮流共享 KV 块,最后汇总输出。相关机制在上下文并行与 KV 收集的拆解中已有讨论,可参考 DeepInfer 上下文并行的拆解。
机制验证:扩展性与精确性
论文的规模实验主要以训练为负载,这里只取其中与机制直接相关的两点,不展开训练配置与成本。
上下文随设备数线性扩展。在 8×A100 NVLink 上,7B 模型的最大上下文从 BPT 的 32K 提到 256K,正好是 8 倍;在 32×A100 InfiniBand 上从 128K 提到 4096K,是 32 倍;在 TPU v4-1024 上从 16K 提到 8192K,是 512 倍。倍数与设备数同量级,说明「每台设备只常驻一个块」的显存账在真实规模上成立,而不是只在推导里成立。少数配置低于设备数,通常与每台设备分到的序列更短、可用块大小更小有关,论文没有逐项解释。
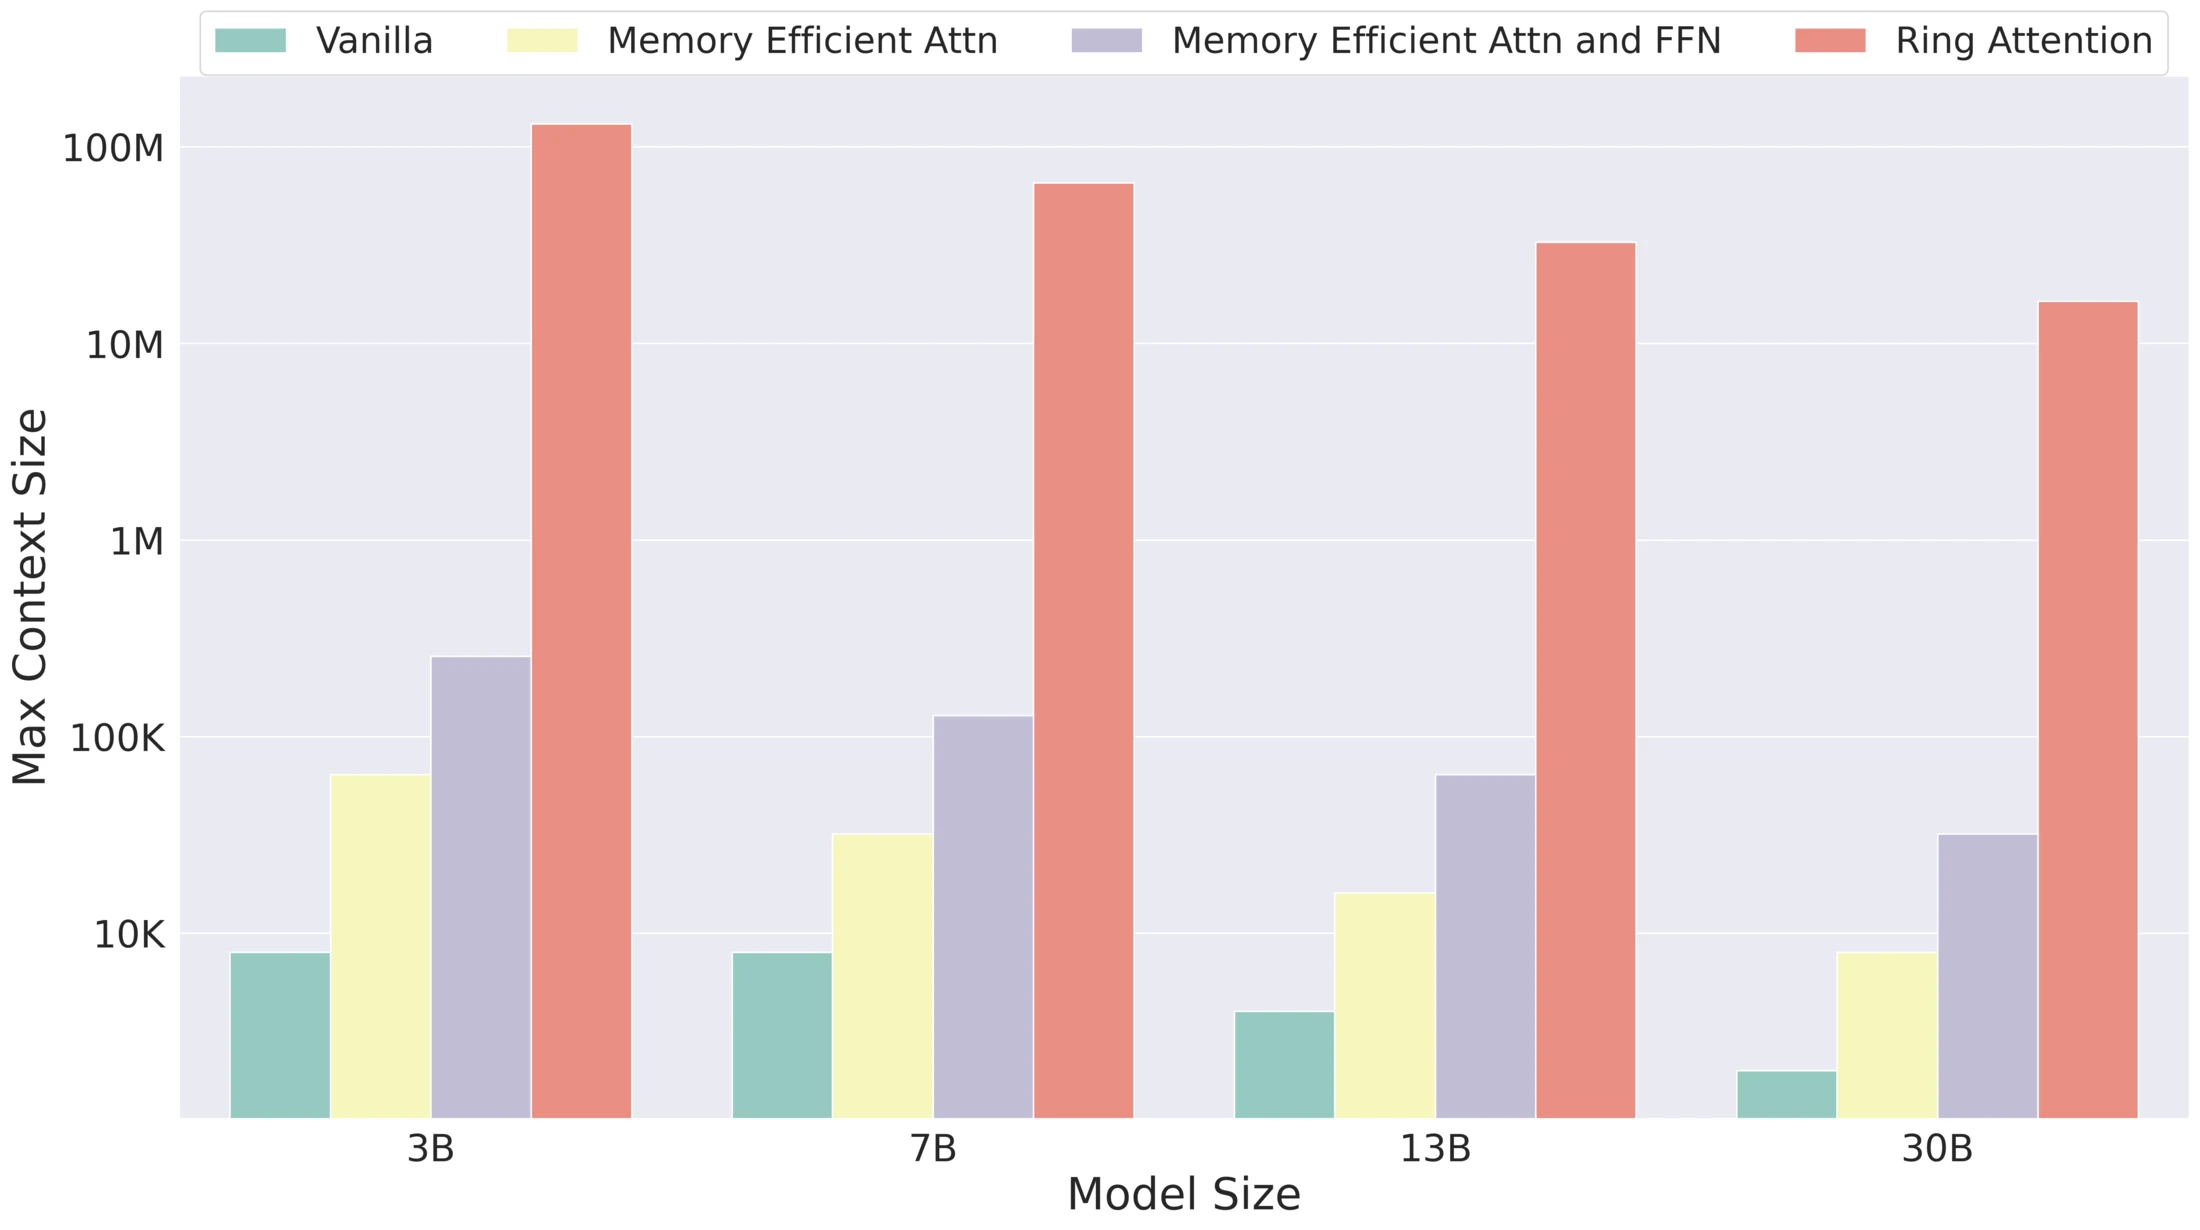
图 2 来自 Ring Attention 论文 的 Figure 1,硬件是 TPU v4-1024。纵轴是可支持的最大上下文长度,四条曲线对应不同模型规模;Ring Attention 的曲线在高位保持平坦,基线的曲线在各自的上限附近提前终止,因为再增大序列就会超出显存。
结果仍然是精确注意力。论文把 LLaMA-13B 扩展到 512K 上下文,在长程行检索任务上评估:模型在跨越不同长度时保持了较高的检索准确率,而同期可比的短上下文模型(GPT-3.5-turbo-16K、Vicuna-16B-16K、Claude-2-100K)在各自窗口内表现接近,但无法覆盖更长的长度。这个结果的意义不在于某个分数,而在于它验证了环上的分块合并没有引入近似:如果在线 Softmax 的合并有系统性偏差,长程检索会最先暴露。
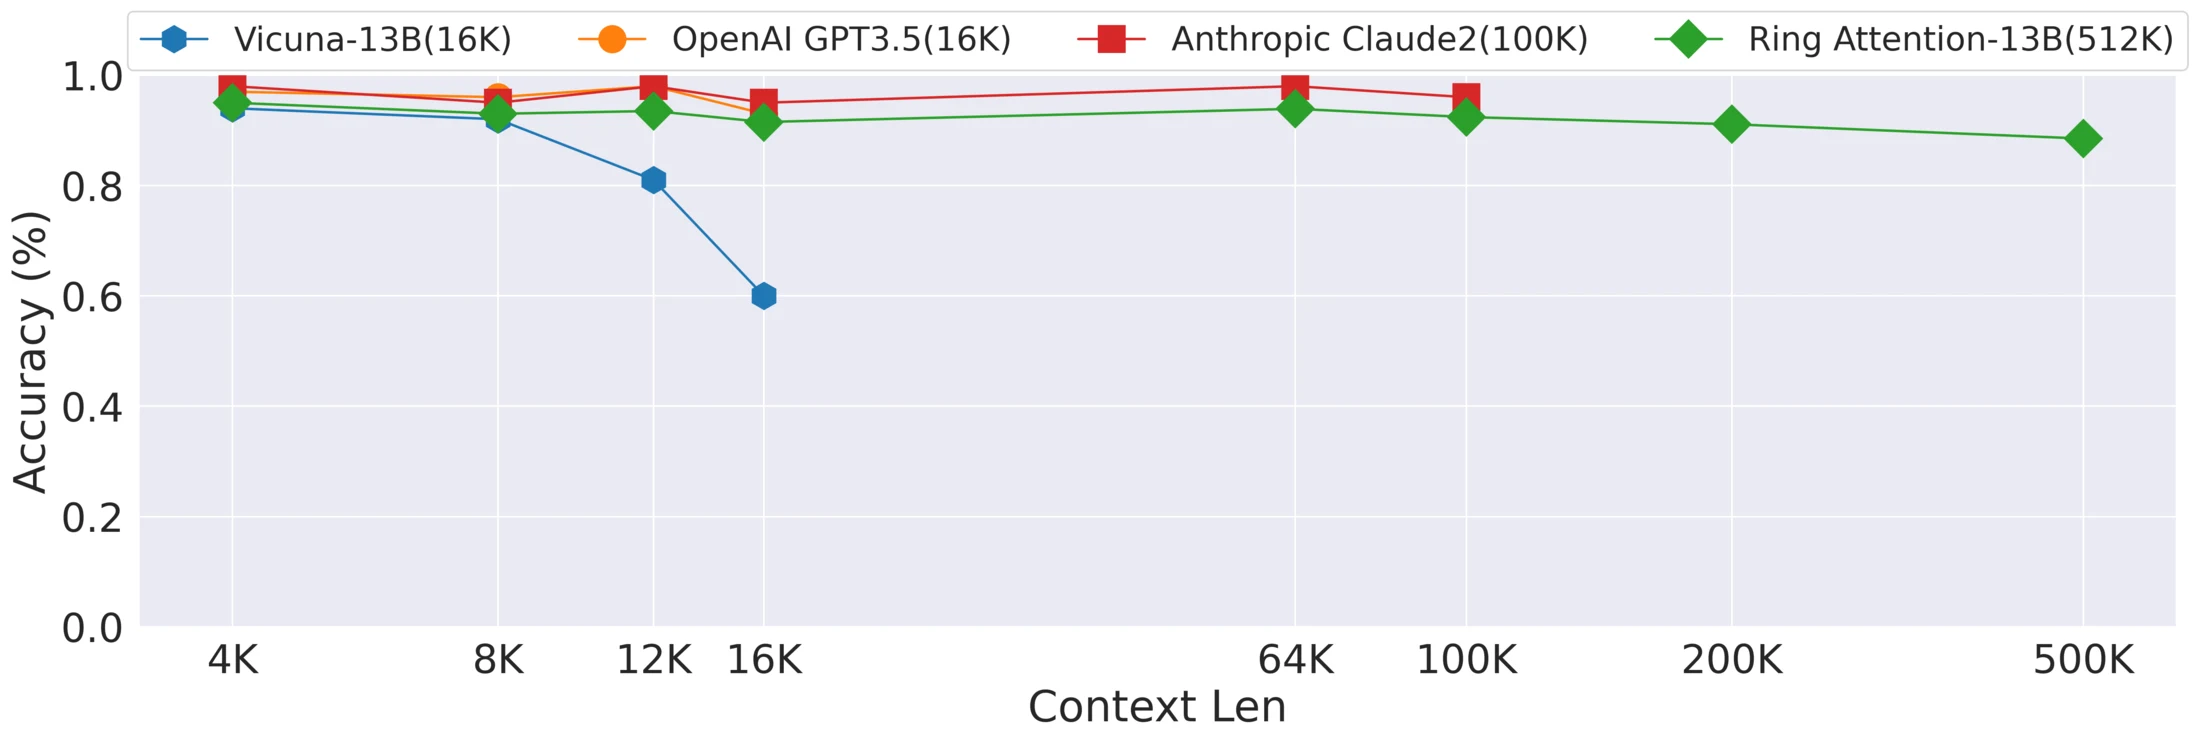
图 3 来自 Ring Attention 论文 的 Figure 3。横轴是上下文长度,纵轴是检索准确率;曲线在超出各模型有效上下文之后的下降反映外推能力的衰减,而不是 Ring Attention 的近似误差。
需要说明的是,论文没有报告推理吞吐、TTFT 或逐 token 延迟,也没有在推理框架里与分页注意力做端到端对比。因此这些数据能证明显存与数值路径成立,但不能替代服务侧的压测;是否采用 Ring Attention,仍要回到 与因果负载这两个条件上判断。
与相邻方案的分界
把 Ring Attention 放进当下的长上下文技术图景里,可以更清楚地看出它的位置。
和稀疏注意力。稀疏注意力(滑窗、块稀疏、索引器 Top-K)减少的是「要读多少 KV」;Ring Attention 减少的是「每台设备要存多少激活」。两者可以叠加,而且常常必须叠加:百万上下文下,即使把显存摊到几十张卡上,全注意力的计算量仍然不可接受,实际系统通常先用稀疏或混合注意力把计算压下来,再用序列并行把剩余部分摊到多卡。本站关于 滑窗注意力 与 DSA 索引器 的拆解,讲的是这条轴上的优化。
和 Star Attention 这类两阶段近似。Star Attention 在上下文阶段完全不通信,代价是块间不可见;查询阶段再对全部块做一次全局注意力。它与 Ring Attention 走的是相反方向:Ring Attention 在每个阶段都保持精确,用通信换精确性;Star Attention 用近似换通信。在带宽充裕的集群上,Ring Attention 的精确性有价值;在带宽受限、只能做粗粒度分布式推理的环境里,近似换来的无通信可能是更现实的选择,可参考 Star Attention 完全拆解。
和 KV 分页与 PD 分离。PagedAttention 解决的是「KV 存在哪、怎么复用」;PD 分离解决的是「预填充和解码的负载形状不同,要分开部署」。Ring Attention 解决的是「一条超长序列的预填充怎么在一组设备上完成」。三者是不同层面的问题,一个成熟的长上下文服务往往同时使用:预填充用环做序列并行,KV 以分页形式写入,然后通过 KV 传输交给解码节点。本站 PagedAttention 拆解 与 GLM-5.3 的 PD 分离链路 分别覆盖了这两块。
复杂度与通信量核算
把所有账放到一张表里,便于横向比较。
设序列长度 、设备数 、块大小 、单头维度 、批大小 、隐藏维度 。表中的计算量与发送量按单头计;实际总量还要乘以头数 ,但两列的比值不变。
| 指标 | 单设备全量注意力 | Ring Attention |
|---|---|---|
| 单设备峰值激活 | (分块注意力 + 分块 FFN) | (与 无关) |
| 单设备计算量 | ,总量不变 | |
| 单设备发送量 | 0 | 字节 |
| 集群总发送量 | 0 | 字节 |
| 环上串行轮数 | 0 | |
| 稳态利用率(因果) | — | 约 |
两列对比揭示了 Ring Attention 的本质:它用通信换显存,并且让通信与计算在时间上重叠。显存从 降到 ,代价是集群层面多了一笔 字节的通信量。这笔通信量是否可以「免费」,取决于 与块大小的关系,以及环的拓扑是否与硬件匹配。
另一个容易被忽略的量是串行轮数。 轮意味着即使通信完全重叠,总时间仍然是 轮的累加,而不能像数据并行那样被更多设备同时分走。设备越多,每台设备的计算越少,但轮数越多。这两个效应相互抵消,使总时间大致保持在 的量级,与设备数无关——这正是「线性扩展上下文而非线性扩展吞吐」的含义。
局限与后续方向
几件事需要说清楚,避免把 Ring Attention 当成「长上下文的一切」。
它不减少总计算量。无论怎么调度,全注意力的 计算仍然要做。Ring Attention 只是让这批计算分布到多张卡上,并把显存压下来。上下文再长,单次请求的 FLOPs 仍然随时间爆炸,真正的长上下文系统往往同时依赖稀疏注意力、滑窗、跨层 KV 复用等手段。
它依赖高带宽互联。 条件决定了它适用的硬件档次。在 InfiniBand 一档的集群上,块大小要放大两个数量级才能重叠,而对存储、掩码与 kernel 的细粒度管理都随之变难。
它不适合短序列与解码。块内计算不足以覆盖传输的场合,收益为负;而逐 token 解码恰好是这种最不利的形状。实践中它通常只出现在预填充阶段,或者只在序列长度远超单机容量、又没有更便宜的切分手段时使用。
因果负载不均需要额外调度。这不是数学上的缺陷,而是调度上的结构性问题;解决它需要重新划分查询/键值的归属,而不是简单改参数。
围绕这些局限,后续出现了多种变体:在因果场景下重新分配查询的折返式调度、按条纹重新分配 KV、把序列并行与张量并行/专家并行组合成多层并行拓扑、以及在推理阶段把环仅用于预填充并配合 KV 传输。这些变体的共同目标都是让「环」这个结构在具体负载下更划算。
小结
Ring Attention 的全部思想可以压缩成三句话:
- 把查询块固定、让键值块绕环流动,每台设备只需要常驻六个块,显存与序列长度解耦;
- 靠在线 Softmax 的三元组合并,让分块结果可以按任意顺序增量合并,从而让环上的轮转在数学上成立;
- 靠查询块长度 的算术条件(等大块时即 ),让 KV 传输被块内注意力计算掩盖,从而实现「无额外通信开销」的扩张。
它的边界也同样清晰:因果掩码带来约一半的空转,解码阶段因查询长度为 1 而不可能重叠,InfiniBand 一档的网络上块大小要放到两万四千 token 量级才划算。这些边界不是实现瑕疵,而是这个结构为「把序列摊开」付出的固定代价:它换取的是上下文长度随设备数线性扩展,代价是计算不再随设备数线性扩展。
对推理系统而言,Ring Attention 更像是一个长 prompt 预填充的分配手段,而不是解码阶段的主力。理解它的显存账、通信账与环形依赖,才能在真正需要它的时候正确地接入,在不需要它的时候果断回到分页注意力与 KV 缓存。
参考资料
- Ring Attention with Blockwise Transformers for Near-Infinite Context,Hao Liu, Matei Zaharia, Pieter Abbeel,2023
- Ring Attention 官方代码库
- FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness,Dao 等,2022
- Blockwise Parallel Transformer for Large Context Models,Liu 与 Abbeel,2023
- FlashAttention-2: Faster Attention with Better Parallelism and Work Partitioning,Dao,2023
- JAX 文档:
lax.ppermute - 本站延伸:Star Attention 完全拆解(一)、DeepInfer 上下文并行的拆解、FlashAttention 完全拆解(一)
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



