


音源分离与语音增强架构入门:从 Conv-TasNet 的波形掩码到 Demucs 的双流分离,以及实时降噪的推理账
写在前面:两个听起来相反、底层却是同一类问题的任务
先把两个任务并排放在一起看。
音源分离(Music Source Separation)的输入是一段混音,输出是若干条独立的音轨:鼓、贝斯、人声、其他。它不是”去掉噪声”,而是把叠加在一起的多个信号各自还原出来,并且每一条都要能单独拿去混音。
语音增强(Speech Enhancement)的输入是一段带噪语音,输出是一条干净语音。它关注的对象只有人声,其余一切——风扇、键盘、街道、混响——都是要被压掉的干扰。
从信号模型上看,两者是同一个方程的不同退化形式。设麦克风收到的是 ,那么
其中 是第 个源, 是不属于任何目标源的加性噪声。音源分离要求把 个 全部估出来,语音增强只要求估出其中一个(人声),并把剩下的全部归入 。所以语音增强可以看作 、且不关心其他分量的一条特例;反过来,分离系统只要把非人声分量求和,就能当增强器用,只是它会把音乐也当成”要保留的源”。
这个统一视角决定了两类系统的架构高度相似:都要先做某种时频或可学习变换,再在变换域里估计一个掩码或一组滤波器,最后变换回波形。差异主要在于允许看到多长的上下文、是否接受多通道输入、推理是否可以流式。这三点也是本文反复回到的主线。
先建立一个可计算的信号模型:叠加、延迟、混响与麦克风阵列
上面的方程 是理想化写法。真实的录音链路至少有三种偏差,它们直接决定了系统要处理什么、网络要输出什么。
第一种是传播延迟与幅度衰减。第 个源到达麦克风的时间是 ,幅度乘以一个衰减因子 。这个延迟项对波形域网络没有任何好处——网络学到的只是”信号被平移了”,而目标源的 与 对齐时,网络反而要做出反相的补偿。工程上的做法是在训练与推理时都做对齐:按峰值能量滑窗找到最佳对齐偏移,把整段输出平移回去。这一步看起来琐碎,但缺了它,波形域模型的训练损失会把大量容量浪费在学”延迟”上。
第二种是房间混响。设房间冲激响应为 ,那么麦克风收到的是
混响对语音增强是双重麻烦:它既让当前帧的语音被数十毫秒之前的同类语音”污染”(这属于语音失真,不是噪声),又拉长了系统要考虑的上下文。一个只关注几十毫秒的因果系统,无法区分”这是刚才那个人声音的尾音”还是”另一个人开口了”。所以对混响场景,要么把上下文拉长到数百毫秒,要么在任务定义上放弃去混响、只做降噪。
第三种是多通道。如果麦克风不止一只, 的每个通道之间都存在与源方位相关的时差和幅度差(ITD 与 ILD)。这意味着空间信息可以被显式利用:在时频点上,声源方向表现为通道间的相位差 ,而噪声(通常来自更宽的方向分布)相位差杂乱。于是”谁是目标、谁是干扰”的问题,可以部分绕开声学内容识别,直接由几何关系回答。这也解释了为什么降噪产品里阵列麦克风是硬需求,以及为什么窄带阵列算法的推理延迟通常只有几毫秒。
把这三点合起来,可以得到一个更严谨的结论:分离与增强系统本质上都是”把输入映射到若干目标分量,并且要求映射对初始相位不敏感”。这个”相位不敏感”的要求会反复出现,它是波形域模型与频谱域模型分歧的根源,也是后文 Demucs 的”shift trick”之所以有效的理论基础。
时频域两条路:幅值掩码与相位问题
在波形域端到端模型出现之前,主流做法是纯时频域:先做短时傅里叶变换(STFT),得到复数谱 , 是时间帧序号(frame index), 是频率 bin(frequency bin),令网络预测每条源的幅值掩码 ,再用
合成源谱,最后用逆 STFT(iSTFT)回到波形。这里 是混合信号的相位,直接沿用——这就是所谓的”相位复用”(phase reuse)。
为什么很多系统只估幅值?因为相位难以学习:混合谱的相位是两个源相位矢量叠加的结果,它不是任何一个源的真实相位,而且当两条源幅值接近而相位相反时,混合相位几乎不含目标源的信息(相消)。在时频点上,相位是”圆上的一点”,用普通回归损失去拟合会有绕卷(wrapping)问题——预测 359 度与 1 度只差 2 度,但欧氏损失却把它们当成了相距 358 度。
这带来一个直接后果:幅值掩码的系统在”重建波形”这一步会失真,尤其是对打击类乐器这种瞬态强、相位敏感的源。前文提到的”鼓和贝斯在频谱域模型下 attack 声音发空”就是这条路径的典型症状。后来的研究给出了三种绕开办法:
- 复数掩码(complex mask):网络输出一个复数 ,既改幅值也改相位;
- 复数可学习滤波:不只是逐点乘,而是对每个频带内的时频点做跨帧的线性组合,能”修补”被局部挖掉的频点与相位——这是 DeepFilterNet 的核心,见后文;
- 完全在波形域工作:不显式定义相位,让网络的端到端损失自己学出相位关系——这是 Conv-TasNet 与 Demucs 的路线。
一个值得记住的对照实验来自 Conv-TasNet 论文:作者把输出听感与 PESQ 做了对比。在 WSJ0-2mix 上,Conv-TasNet 的 MOS 为 4.03(干净语音为 4.23,IRM 理想掩码为 3.51),显著高于理想掩码;但它的 PESQ 只有 3.24,反而低于理想掩码 IRM 的 3.74。原因在于 PESQ 是一种基于幅值谱的预测指标,对波形域方法重叠加窗、微相位变化不友好。也就是说,人工指标(PESQ、SDR)测到的排序,不一定等于听感排序,这就是为什么所有严肃的分离论文都附 MOS 主观评测。
波形域掩码:Conv-TasNet 把一个”学习用的滤波器组”装进了网络
Conv-TasNet(Conv-TasNet: Surpassing Ideal Time-Frequency Magnitude Masking for Speech Separation,Luo 与 Mesgarani,2019 年发表于 IEEE/ACM Transactions on Audio, Speech, and Language Processing)的思路是:既然 STFT 的固定正余弦基与混合信号并不匹配,为什么不让网络自己学一组基函数?
编码器:一维卷积就是可学习的 STFT
编码器对输入波形段 做一维卷积:
这里 的每一列(长度 )就是一个基函数, 是基函数个数, 是”编码表示”。把它和 STFT 对照:STFT 用的是固定长度与固定形状的正余弦窗,窗长、窗移与频点数都是人工选定的;Conv-TasNet 的 (窗长)与 (帧移)同样是超参数,但窗的形状由梯度和重建损失决定。
这个设计的妙处在于基函数会自己变成一种滤波器的频谱形状。论文图 2 把编码器基函数的频谱按相似度排开,可以看到频率与相位调谐的多样性——它们不像正余弦那样整齐,却覆盖了信号本身最常出现的时间-频率模式。这意味着”掩码”这一步不需要对抗 STFT 的泄漏,因为表示本身就是为了被掩码切割而学出来的。
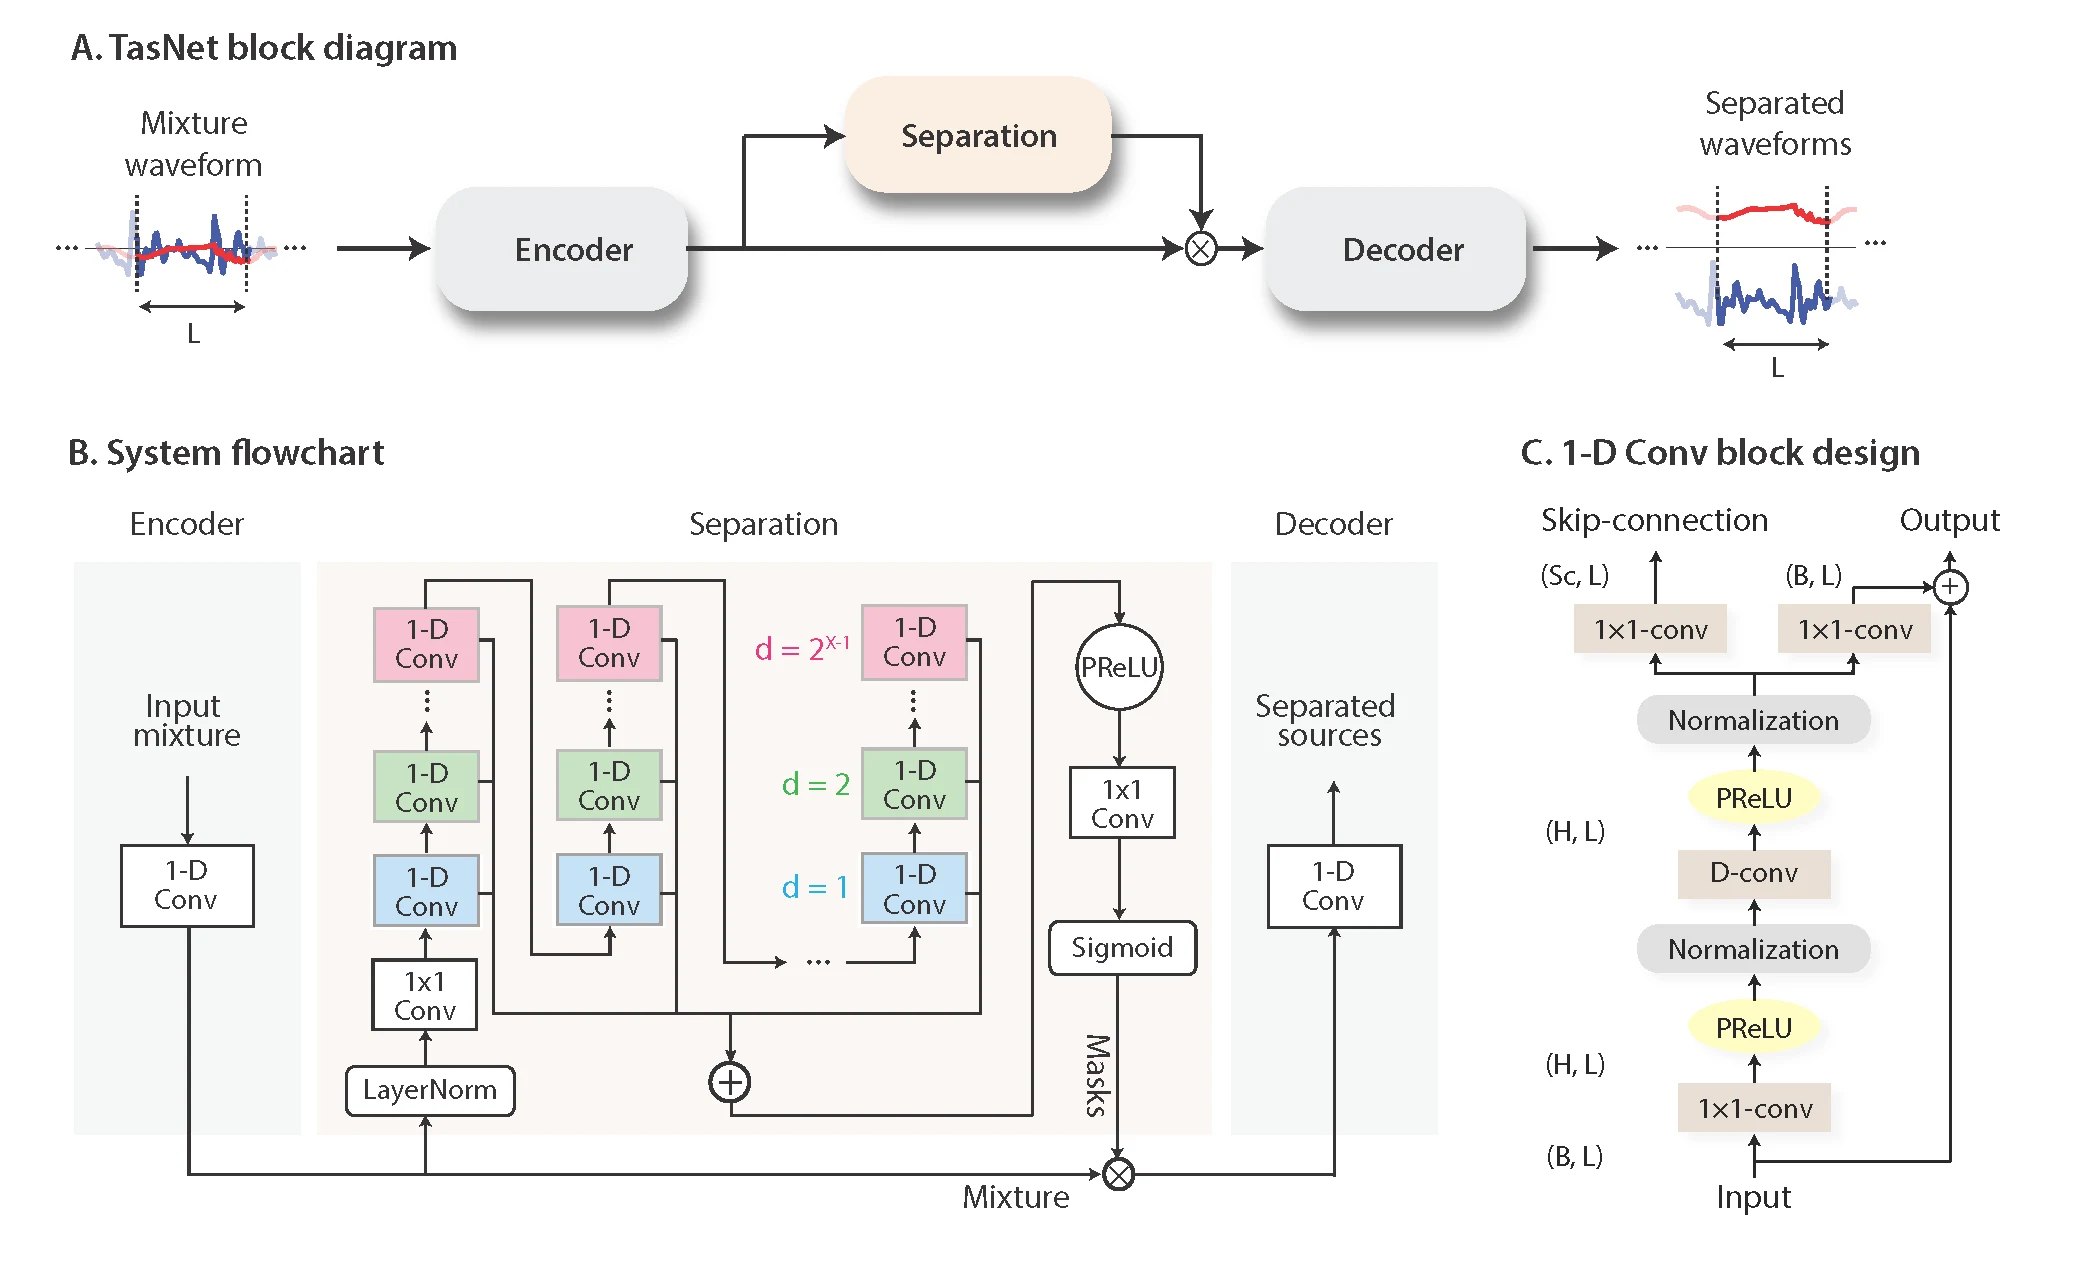
上图截自 Conv-TasNet 论文图 1,三部分分别对应编码器、分离模块与解码器;右下角的 1×1 卷积块是卷积块内部的基本单元:先做逐点卷积(pointwise),再做深度可分离卷积(depthwise separable convolution),每一步后跟非线性与归一化,两条 1×1 卷积分别承担残差路径与跳连路径。论文给出的参数账是:普通卷积核参数为 ,可分离卷积只有 ,当 时参数规模大约缩小 倍。这就是为什么一个声称超过全部理想掩码的模型只需要约 5.1M 参数。
掩码与解码
得到编码表示 后,分离模块对每条源输出一个 的掩码 ,掩码后的表示为 ,再经解码器的转置卷积 回到波形。如果所有掩码之和为常数,就得到”能量守恒”式的分解;由于 线性地由 决定,解码器只需把 维表示推回 维时间样本。
深度可分离卷积与空洞卷积
分离模块是一叠”时间卷积网络”块。每个块内部先把通道数压到瓶颈 ,再用核长 、空洞率 ( 是块在组内的序号)做一次深度卷积,然后 1×1 卷积回到通道数 ,最后用两条 1×1 卷积分别进入残差路径与跳连路径。若每组的块数为 、组数为 ,则感受野约为
这个式子解释了论文表 2 中若干条经验规律:感受野在 1.28 秒时,加深网络(增加 )比加宽(增加 )更划算;把窗长从 40 ms 降到 16 ms 反而更好,因为更短的窗意味着在同样的时间跨度里有更多帧,让模型在更快的时间尺度上区分两个说话人的交替。这个”变短反而更好”的结论,是理解后面 Demucs 为何采用 ms 短窗、高通道数路线的关键对照。
因果性:归一化方式决定了延迟
Conv-TasNet 有两个版本:非因果(gLN,全局层归一化)与因果(cLN,累积层归一化)。cLN 的公式是
其中 是截至第 帧的帧数, 与 是对前 帧所有特征值求的均值与方差, 是可训练参数。直观地说,它把每一帧的统计量换成”截至此刻的历史统计量”,于是任意时刻都只用到过去的信息,可以逐帧流式输出。代价是论文表 2 展示的:同配置的因果版本在 WSJ0-2mix 上从 15.3 dB 降到 10.6 dB(SI-SNRi)。注意,这个 4.7 dB 的损失要分给两件事:卷积只能看因果窗口,以及归一化只能用累积统计。
处理速度是另一个亮点(论文表 8):在 Intel Core i7-5820K 上,因果 Conv-TasNet 每帧处理时间(TPF)是 0.4 ms,而帧长 2 ms——比实时快约 5 倍;LSTM 版本的 TPF 是 4.3 ms,基本贴着帧长,难以实时。差距来自两点:卷积可以并行,LSTM 必须顺序推进;以及卷积版本对起始点不敏感,不需要为不同的起始样本做额外对齐。
两条路径的中间形态:DPRNN 把长序列切成块再在两个方向建模
Conv-TasNet 的弱点很明确:所有帧都经过同一组空洞卷积,没有任何”片段之间互相检索”的机制。当序列长到几十秒、源之间的对应关系跨越很远的帧时(例如一段音乐里的人声,可能在 10 秒前和 10 秒后旋律一致),全局建模能力不足。
Dual-Path RNN(DPRNN,Dual-path RNN: efficient long sequence modeling for time-domain single-channel speech separation,Luo 等,2020 年发表于 ICASSP)给出的方案是把序列切成段,在段内和段间两个维度各做一次 RNN:
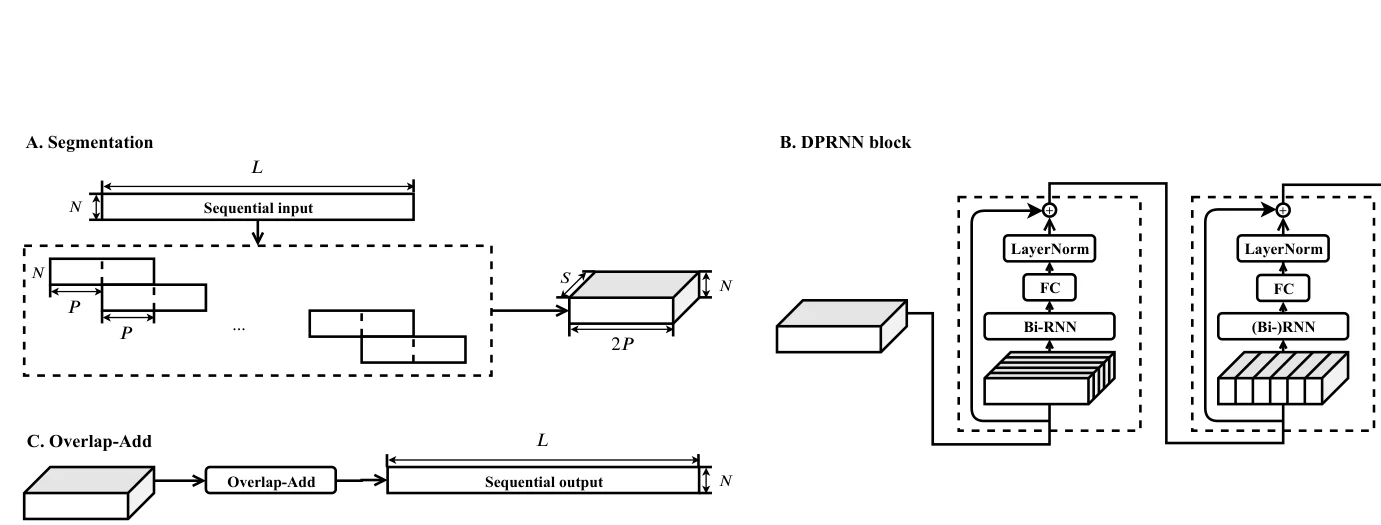
上图截自 DPRNN 论文图 1,三个部分分别是分段(A)、DPRNN 块内部(B)与重叠相加(C)。设编码表示被切成 段、每段 帧,得到三维张量 。段内 RNN 在 这一维上对每一段独立做双向 RNN——它捕捉局部时频结构,比如相邻几个频点的音高走向;段间 RNN 在 这一维上做,它看到的是”每个频点在各段上的值”,捕捉全局依赖。两者交替,就形成了一个不显式构造注意力、却具备全局信息交换能力的结构。
为什么这样做比直接对 做一层双向 RNN 好?直接做的话,序列长度是 ,双向 LSTM 的隐状态维度乘以这个长度就是显存的主体,长序列直接内存爆掉;而 DPRNN 的复杂度是两块相对独立的 与 ,并且段内部分可以按段并行。更重要的是它把局部与全局拆到了两层,使模型不必在一层里同时处理 16 kHz 级别的时间分辨率与秒级关联。
DPRNN 在 WSJ0-2mix 上的收益很直观:同样是 2.6M 参数,DPRNN-TasNet 的 SI-SNRi 为 18.8 dB、SDRi 为 19.0 dB,而 5.1M 参数的 Conv-TasNet 是 15.3/15.6 dB;把段长继续压缩、编码器窗长降到 2 个采样点时性能仍在上升,因为序列被切成段后,总帧数再多也只是让段间 RNN 变长,而不是让单个 RNN 的输入长度爆炸。论文的结论是:DPRNN 用比 TCN 小 49% 的模型换来了更高的分离质量。
此处的要点不是具体分数,而是架构路线:DPRNN 把”分段 + 双维度循环”这个模式引入,后来被大量语音分离系统采用;而音乐分离(Demucs 一代)则在 2019 年选择了另一条路——纯波形域的 U-Net。两条路线的分歧点在于:语音关注”两个人交替说话时谁在说”,音乐关注”多个乐器同时发声时各自的音色”,前者的核心是时序上的归属,后者的核心是频域上的分离。
Demucs:当分离问题被搬到音乐上,为什么波形域 U-Net 更合适
Demucs(Music Source Separation in the Waveform Domain,Défossez 等,2019 年发表于 arXiv,作者是法国 Facebook AI Research 团队)一上来就明确地指出了 Conv-TasNet 直接搬到音乐分离上的问题:它能达到 5.73 dB 的平均 SDR,但音频样本存在显著的听感伪影,人声与 “other” 这类复杂源的分数明显落后于频谱域模型。原因在于音乐的四条源(鼓、贝斯、其他、人声)的频谱重叠比语音两源分离严重得多,掩码式的”逐点乘一个系数”在处理这种重叠时损失了大量瞬态细节。
Demucs 的架构与 Conv-TasNet 完全不同:
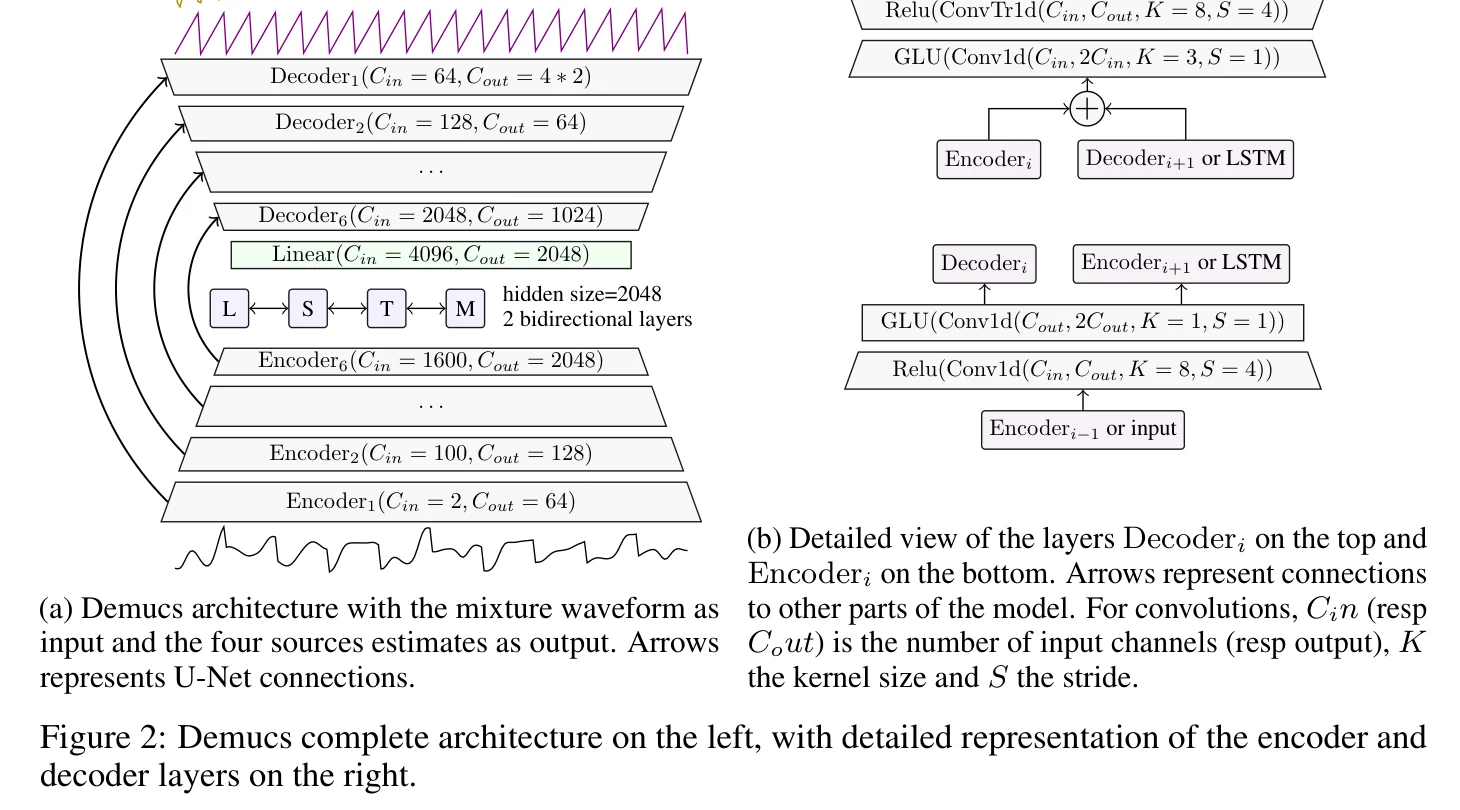
上图截自 Demucs 论文图 2。左半部分是整体:输入是立体声(双声道)混合波形,编码器 6 层逐级下采样,在第 6 层后接一个 2 层双向 LSTM(隐层 2048),再接线性层回到 1024 通道,然后解码器 6 层逐级上采样,最后一层线性地输出 4 条源 × 2 声道共 8 个通道,直接是波形。右半部分展示单层的内部结构:编码层的典型结构是”核长 8、步长 4 的空洞卷积 → ReLU → 核长 1 卷积 → GLU”,解码层对称,并在同索引处通过 U-Net 跳连把编码器的特征接回来。
几个设计选择对应的原因
- 步长 4 + 核长 8 而不是显式下采样:Wave-U-Net 采用线性插值下采样再卷积,Demucs 改用带步长的卷积直接承担下采样;同时用转置卷积代替”线性插值 + 步长 1 卷积”来上采样,论文指出在达到相同感受野的前提下,转置卷积的运算量与显存约少 4 倍,从而允许把通道数堆到 2048。这一步是典型的”用结构换容量”。
- 通道数很大(2048):论文的消融表明,通道扩张的贡献非常大,论文表 3 的对比是 32 通道 6.08 SDR、48 通道 6.20、64 通道 6.28;代价是模型体积从 254 MB 涨到 1014 MB。
- GLU 门控:把卷积输出切成两半,一半过 sigmoid 作为门控,一半作为内容,乘起来。它给每个通道一个”何时让信息通过”的开关,比 ReLU 的单侧截断表达力更强。
- U-Net 跳连:让解码器直接看到编码器某一层的原始信号细节。论文明确解释了它的另一个作用——把输入相位直接传到输出,不需要额外学习相位。
- 不用 BatchNorm:早期实验发现 batch norm 对分离性能有害,“某一帧的内容是噪声还是人声”应该由该帧及其上下文的统计决定,而不是一个 batch 的统计。
- 线性层输出全部源:最终层一次性输出所有源的波形,没有 per-source 归一化。这一点与 Conv-TasNet 的”每源一个掩码”形成鲜明对比——它意味着解码器不是”从一个共享表示里切片”,而是”由共享表示直接合成每条源”。
shift trick:模型不是时间等变的,用平均补偿
Demucs 论文发现自己的模型并不是天然时间等变的:把输入平移若干样本,输出会随之产生不同的伪影与失真。这在波形域模型里很常见——带步长的卷积对相位敏感的瞬态信号天然有网格效应。论文的做法很朴素:随机采样 个平移量 ,分别预测,再把预测反平移平均:
代价是推理时间乘以 。论文在 V100 上报告的实测是:分离 1 分钟 44.1 kHz 音频约 0.8 秒,加 shift trick 后约 8 秒,仍比实时快 7 倍以上。这个技巧之所以有效,是因为模型对平移的误差是零均值的:不同平移下的伪影不相关,平均后互相抵消。它也从另一个侧面说明了波形域路线的一个工程现实——你需要额外的推理开销来弥补模型的结构性缺陷。
为什么不做相位修复,而直接回归波形
Demucs 的关键论证是:在分离任务中,原始相位是可以拿到的(U-Net 跳连把输入相位直接送到输出),所以 L1/L2 波形损失是完全合法的。这一点与无条件生成完全不同——图像或音频生成任务中没有参考相位,L1/L2 才会因为相位不一致而失效。这条论证说明了波形域分离系统能”胜过”频谱域模型的根本原因:它不是绕过相位,而是用跳连把相位直接复制过去。
从 Demucs 到 Hybrid Demucs:波形与频谱并行
第一代 Demucs 在整体 SDR 上超过了频谱域模型(MusDB test SDR 6.28 dB,对比 D3Net 的 6.01 dB),但在”人声”与”other”两条源上仍不如最好的频谱域模型。原因在于波形域模型对某些源的频带细节抓不住,而频谱域模型擅长把某个频带上的能量平滑地”分配”给各条源。
Hybrid Demucs(Hybrid Spectrogram and Waveform Source Separation,Défossez,2021 年发表于 MDX Workshop)的做法是两条流水线并行:
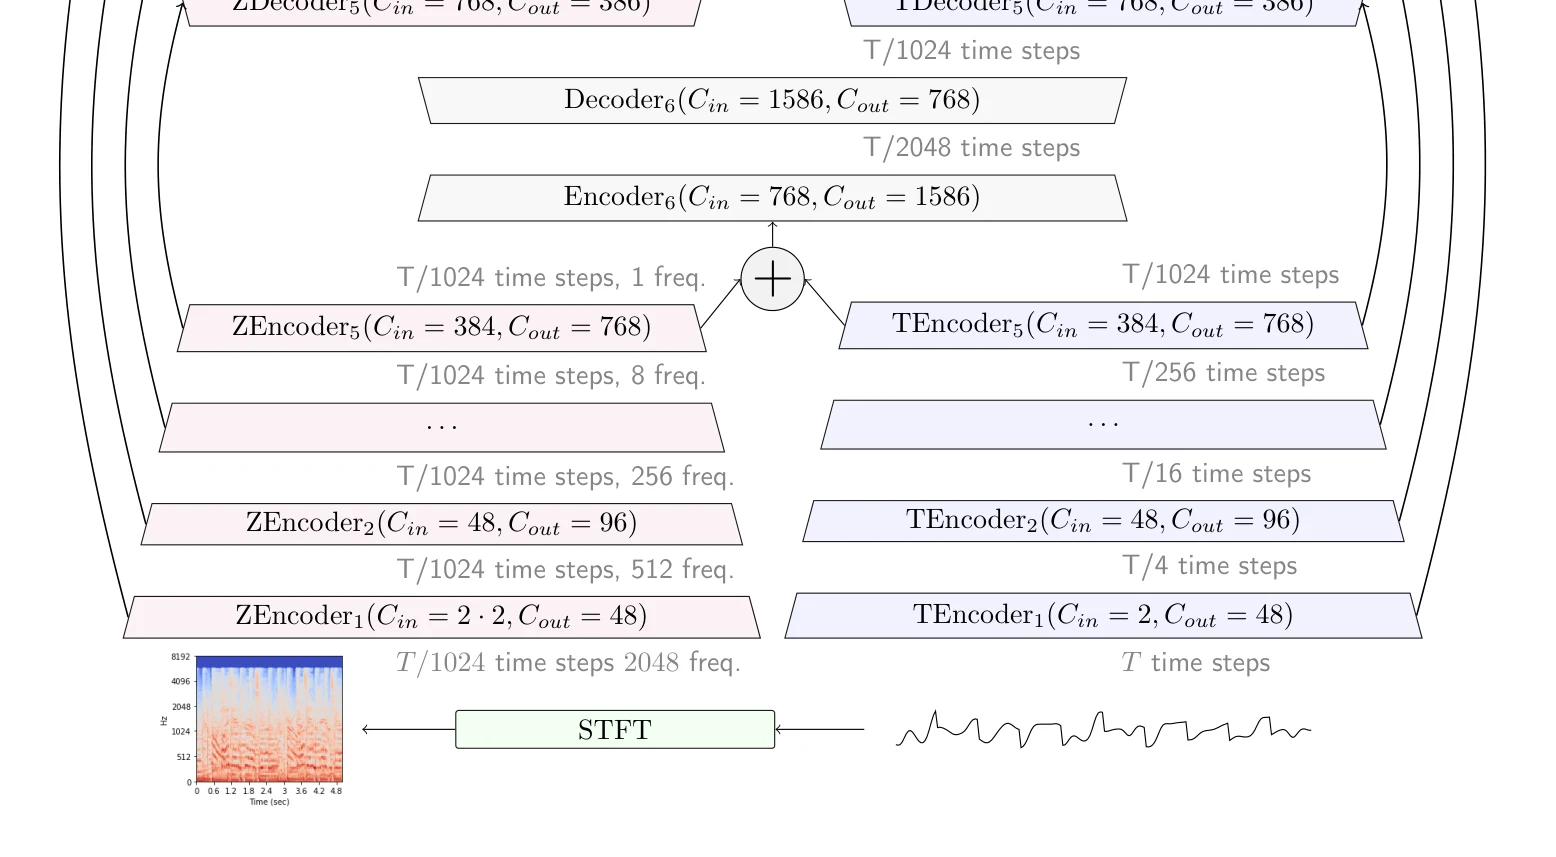
上图截自 Hybrid Demucs 论文图 1。输入波形分成两路:上行是”时间域编码器”(TEncoder,步长 4,6 层),下行是先做 STFT、按频率维度做卷积的”频谱编码器”(ZEncoder,每层把频率 bin 数除以 4,从 2048 降到 8,再到 1)。两路在第五层之后维度对齐(都是 T/1024 × 1 频率),可以把特征相加;然后是一个共享的 LSTM 层,接对称的双分支解码器。解码后,时间域分支输出波形,频谱域分支输出复数谱再经 iSTFT 变成波形,两者求和得到最终输出。
几个值得留意的机制:
- 频率维度的嵌入:与时间轴不同,音乐信号沿频率轴并不是平移等变的——每种乐器有特定的音域、人声有明确共振峰。论文借鉴 Isik 等人的做法,在第二层编码器之前注入一个频率位置的嵌入,并让它平滑(相邻频率有相近的嵌入),相当于告诉网络”这里大概是什么频段”。
- 共享的 LSTM:两路分支在合并后共用中间层,保证”时间域与频谱域对同一段音频的判断是一致的”,而不是两套各自独立的判断最后简单相加。
- 压缩残差分支:在编码器的空洞卷积之后引入含空洞卷积、受限 span 的 LSTM 与局部注意力的残差分支,增加信息回流的路径。
- 解码同步:推理时两分支输出后求和,loss 也在波形域计算,而且频谱分支与波形分支必须在训练中同步更新——论文特别指出,如果在推理时只对频谱分支做更多次的 Wiener 滤波迭代,SDR 会大幅下降,因为波形分支无法同步适应。
Hybrid Demucs 在 MusDB 上的平均 SDR 是 7.68 dB(对比第一代 Demucs 的 6.28 dB),四段源中鼓(8.24)与贝斯(8.76)显著领先,人声(8.13)与 other(5.59)也已大幅提升;论文同时报告它在 2021 年的 MDX 竞赛上仅用 MusDB 训练就拿到了第一(7.32 dB nSDR),而参赛的纯频谱域系统在人声段上仍然更强。这背后有一个成本问题:双分支运行意味着 STFT/iSTFT 加两套编码器的双重计算,一次前向的峰值显存和延迟都明显高于原版。工程上,Hybrid Demucs 的模型体积与推理成本大约增加一倍。
实时降噪的另一条路:DeepFilterNet 用”跨帧复数滤波”替代逐点掩码
前面的方法都在回答”如何把多条源分开”;而实时降噪面对的问题完全不同:延迟预算只有几毫秒,算力预算往往只有几百 MFLOPs(手机、助听器、耳机的 DSP)。在这个尺度上,一个 2048 通道的 U-Net 完全不可用,甚至连一个中等规模的 ViT 都放不下。DeepFilterNet(DeepFilterNet: A Low Complexity Speech Enhancement Framework for Full-Band Audio based on Deep Filtering,Schröter 等,2022 年发表于 ICASSP)给出了一个把”感知”和”计算”同时纳入设计的方案。
为什么低延迟下掩码会失效:频带内多个谐波
STFT 的频率分辨率与窗长成反比。要 5 ms 延迟,窗长就只能取 240 个采样点(48 kHz 下),频率分辨率约为 250 Hz。而人声的基频可能在 100–300 Hz,单次谐波间隔只有 100 Hz 量级——一个频带里可能同时装着人声谐波和噪声。此时逐点掩码只有”整条一起放大或压低”一个动作,无法”在人声中保住谐波、在谐波之间压掉噪声”——因为这两种成分落在同一个频点里。
复数掩码(CRM)稍微好一些,它能改相位,但仍然是逐点乘法:它没法从相邻帧借用信息。而语音谐波在相邻帧间有很强的相位连续性——时间上的正弦成分会在相邻帧表现为几乎固定的相位差。于是就有了 deep filtering:
这里 是第 帧、第 个频点的复数谱, 是复数系数, 是滤波器阶数, 是可选的”前瞻”(look-ahead)偏移。这个式子与普通掩码唯一的区别是:它不是把单个谱点乘一个数,而是把同一频带相邻 帧的谱点做线性组合。从信号处理角度,这正是固定频带的 FIR 滤波——但在频带很窄、窗长很短的场景下,它反而能重建谐波的周期性结构。论文的核心实验(图 3)表明:在 5 ms 到 20 ms 之间的所有 FFT 尺寸上,DF 的 SI-SDR 都高于 CRM,而 CRM 在窗长 ≤ 20 ms 时性能明显下滑——因为分辨率不够,CRM 无法处理带内谐波。
两级结构:先改包络,再修谐波
DeepFilterNet 把增强拆成两级:
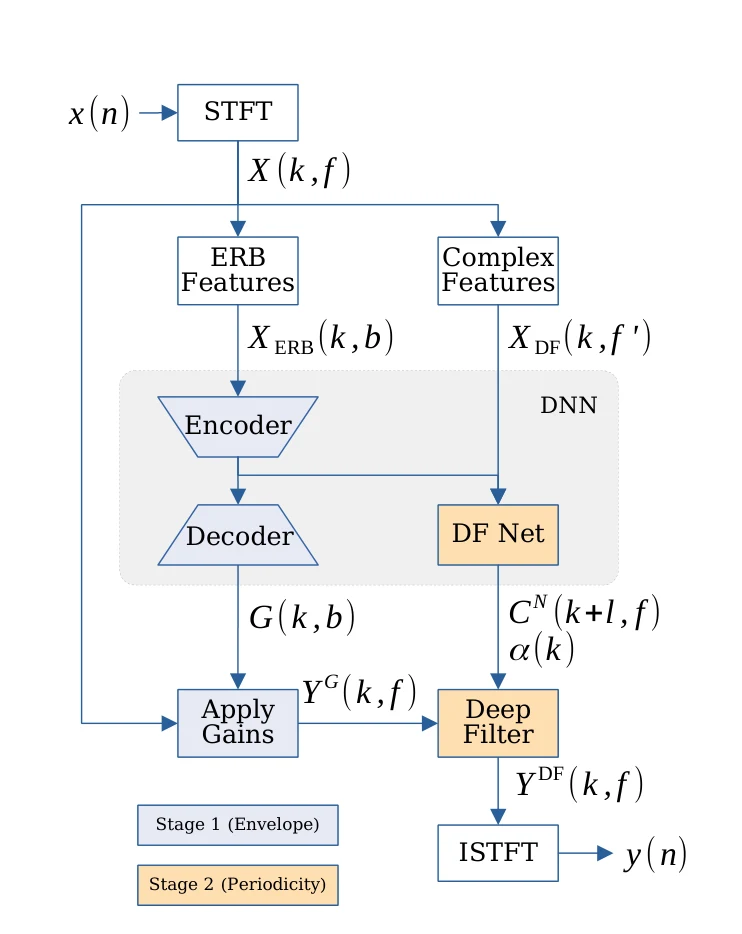
上图截自 DeepFilterNet 论文图 1。第一阶段(Stage 1,蓝色):DNN 编码器/解码器输出 ERB 尺度的增益 , 是 ERB 频带(默认 32 个),带宽随频率按听觉感知规律增长。ERB 尺度与人体耳蜗的频率分辨率一致,因此在这个维度上做包络估计既省算力(输入维度从 2048 个频点降到 32 个频带)又符合”包络平滑”的物理事实。增益经逆 ERB 滤波回到频点维度,逐点作用于混合谱。
第二阶段(Stage 2,黄色):仅对低于 kHz 的频带(周期成分的能量主要在这里)估计复数滤波器系数 ,做深度滤波。最后用学习得到加权因子 合并两阶段输出:
是逐帧可学习的门控:在周期成分强的帧(有声)更偏向深度滤波结果,在无声段(停顿、噪声)更偏向包络增益结果。这个”混合”设计还带来一个实用好处——可设置噪声抑制上限:论文明确把这一项当作”降噪量上限”来用:系统只会按设定的强度减少噪声,而不会把环境声完全抹掉,这对需要保持环境感知的可穿戴设备尤其重要。
让延迟与计算都可控的几个工程手段
- 延迟公式:总延迟为 。论文用 240 点窗(5 ms)、、 得到 5 ms 的最小延迟;第一级卷积层的 look-ahead 通过时间对齐前移,使其不再额外增加总延迟。
- 只做可分离卷积:卷积块是核长 (3×2) 的深度可分离卷积 + BN + ReLU,通道默认 64。这一层结构便于推理框架做算子融合,也保证计算量小。
- 只做部分频率的深度滤波: 设为 5 kHz,只在高频下界做,直接削减计算。论文的复杂度表显示:完整模型 1.8 M 参数、0.35 GMACs/s,而关掉第二级只有 0.9 M 参数、0.25 GMACs/s——但 WB-PESQ 从 2.81 掉到 2.57,SI-SDR 从 16.63 掉到 13.81,说明第二级贡献不可忽略。
- ERB 特征归一化:输入用对数功率谱结合指数滑动均值归一化,输出增益也做同样的归一化——训练/推理时保持同一尺度。
与已有复杂模型对比时真正重要的一面
论文表 1 在 VCTK/DEMAND 测试集上报告:DeepFilterNet 的 WB-PESQ 为 2.81,与 DCCRN+(2.84,3.3M 参数 + 深度滤波)相当;但计算量只有 0.35 GMACs/s,而 DCCRN 是 14.36 GMACs/s(约 40 倍差距),PercepNet 8.0M 参数、0.80 GMACs/s 且 PESQ 只有 2.73。这里的关键不在于分数高低,而在于”在实时预算内能跑起来”本身就是一种架构约束——这是从离线分离转向在线降噪时最重要的变化。
把前面几条线串起来:推理侧的账要算清
四类结构放在一起,各自在”成本-质量-延迟”这条轴上占据不同位置。下面把它们按一次请求的分解方式列出来。
计算与显存的主体在哪里
| 系统 | 时间分辨率 | 主体计算 | 关键成本来源 | 可流式 |
|---|---|---|---|---|
| Conv-TasNet(非因果) | 2 ms 窗(L=16 @ 8 kHz) | 3 组 × 8 个 TCN 块、约 5.1M 参数 | 感受野由空洞率决定;越深越慢 | 否(因果版可,约 10 dB) |
| Conv-TasNet(因果) | 同上 | 同上 + 增量归一化 | 逐帧推进无法整段并行 | 是 |
| DPRNN | 段内 帧 × 段 | 两组双向 LSTM | 双向 LSTM 无法流式;段长决定显存 | 否 |
| Demucs | 44.1 kHz、双声道 | 6 级编码 + 2 层双向 LSTM(2048)+ 6 级解码 | 2048 通道、大核长卷积;模型 ~1 GB | 否(需整段) |
| Hybrid Demucs | 同时两路 | 时间编码 + 频谱编码 + 共享 LSTM + 两路解码 | 双路计算 + STFT/iSTFT | 否 |
| DeepFilterNet | 5 ms 窗、50% 重叠 | 可分离卷积 + 小 RNN | 1.8M 参数、0.35 GMACs/s | 是 |
几条可以概括的规律:
- 双向 LSTM / 双向 RNN 是不可流式的硬边界。一旦有了”从结尾往前的路径”,就必须等整段输入到齐。Conv-TasNet 用卷积替换 LSTM,表面上是”更快”,深层原因是”可以并行处理帧、无需等后文”。
- 通道数与模型体积呈线性关系,但感受野与深度呈超线性关系。Demucs 用 2048 通道换表达能力,代价是约 1 GB 显存(论文表 3 中 64 通道未量化 1014 MB);DiffQ 量化到 120 MB 后 SDR 保持 6.28 dB 不变——这说明把模型压进设备的成本,可以靠”事后量化”解决,不必在结构层面为体积让步。
- 多源分离的”推理时间”是线性乘以源数还是共享? 在 Demucs 中,所有源在最后一层同时输出,推理成本与源数基本无关;在 Conv-TasNet 中,掩码是并行的,但每条源多一次解码卷积。这个差异让音乐分离更适合”一次全解”,而语音分离更适合”只解一个目标”。
分离器当降噪器用,会付出什么
把音乐分离系统用来降噪,最直观的问题是人声源的”残留”:人声分离会把所有类人声的成分(唱歌、说话、甚至有些乐器)都归入人声,因此它能很好地保护语音,但对”人声与目标源之外的一切”没有任何取舍判断。真正对语音做增强的系统必须在结构上”以目标语音为中心”,这也是 DeepFilterNet 把 只放在低频的原因——高频的非周期噪声对人声识别帮助不大,压掉它更划算。
分离质量怎么量:SDR 的分解与”排列歧义”
在所有音频分离论文里,出现频率最高的三个字母是 SDR。它来自 BSS Eval 这套盲源分离评测框架,定义并不只是”信噪比”那么简单。设真实源为 ,估计为 ,BSS Eval 先把 投影到由 张成的空间上:
然后定义
这个式子的含义是:把估计信号中”与真实源同向的成分”算作有效信号,其余全部算作误差。进一步的分解把误差拆成三块:干扰(来自其他源)、噪声(与所有源都不相关的成分)、伪影(由算法引入、与任何源都不相关的失真)。三者分别给出 SIR、SNR、SAR。这个分解解释了为什么 Demucs 的论文要报告”bleeding”(串源)与”artifact”(伪影)两个主观维度——它们分别对应 SIR 与 SAR 在人耳上的表现。
对波形域方法,还有一个更常用的变体 SI-SDR(scale-invariant SDR):
它对整体幅度缩放不敏感:即使系统输出被整体放大或缩小,只要形状对,分数就不变。这对训练早期的稳定性很重要,因为波形域模型的初始输出幅度往往与目标差一个数量级。
排列歧义:为什么训练需要 PIT,评测需要匈牙利匹配
分离系统输出的是”一堆源”,而训练标签是”一组源”,两者之间没有天然的对应关系。如果模型把源 1 的输出给了源 2 的位置,逐点损失会给出巨大惩罚,但听感上完全正确。这就是排列歧义(permutation ambiguity)。
训练时的标准解法是 uPIT(utterance-level permutation invariant training):对每条源枚举所有分配方式,取损失最小的那个排列回传梯度。对 只有 2 种排列, 有 24 种;再往上枚举成本就不可忽略,于是有”按帧排列”与”按段排列”的折中。
评测时同样要处理:对估计与真值做匈牙利匹配(或对 直接取两种排列中较好的那个),再计算 SDR。这一点在实际工程中尤其容易出错:如果你自己写评测脚本,忘了匹配,就会得到一个明显偏低的分数,然后误以为模型变差了。
客观指标与主观听感的背离
前文已经出现过一次背离:Conv-TasNet 的 PESQ 低于理想掩码,但 MOS 高于理想掩码。这类背离有系统的原因:
- PESQ 基于幅值谱,对相位细节不敏感,对波形域方法常常低估;
- SDR 对伪影敏感,但伪影的听感严重程度与 SDR 的下降幅度并不线性;
- DNSMOS 等神经网络指标是在特定数据集上拟合人类评分,跨数据集、跨语言会漂移。
工程上更稳妥的评测组合是:客观指标用于快速筛选(SDR/SI-SDR 排序、PESQ 看趋势),主观 MOS 用于最终验收,并且至少抽听失败样本——尤其是瞬态(鼓点、爆破音)与长静音段,这两处最容易暴露伪影。
流式推理:延迟、上下文与状态的三角约束
离线分离可以看完整段音频,流式系统不行。把前面几类模型放进流式场景,会遇到三个相互拉扯的约束。
约束一:感受野 vs 延迟
因果 Conv-TasNet 的感受野公式与延迟直接相关:要覆盖 1.5 秒的上下文,就得堆足够的空洞卷积层,而每层都要等前一层的输出。论文的因果版本感受野 1.53 秒,对应的最小算法延迟大约是”帧长 + 感受野推进所需的历史”——这也是为什么它在实时场景下用的是 2 ms 窗与 5 ms 级的帧处理预算,而不是离线版本更宽的感受野。
约束二:状态缓存 vs 精度
流式 LSTM 需要缓存隐状态 ;流式卷积需要缓存边界帧;流式归一化必须用累积统计(cLN)。这些缓存本身不大(一个 128 维隐状态 × 层数),但状态在长静音后会漂移:如果一段 30 秒的静音里没有有效语音,累积统计会被这段噪声主导,重新出现语音时归一化尺度偏小,输出电平随之跳变。工程上的做法是在静音段(由 VAD 判定)冻结或缓慢重置状态,代价是切换瞬间可能出现一次轻微的响度跳变。
约束三:分块与重叠相加
为了并行,流式系统常把输入按块处理(如 1 秒块),块与块之间做重叠相加。块边界处的伪影是这一类系统的典型缺陷:如果模型不具备平移等变性,块边界的位置会直接改变输出。这正是 Demucs 的 shift trick 想解决的问题,也是流式系统里”块长必须是帧移整数倍”这一实现约束的来源。
一个更隐蔽的问题是分块后的批次形状:把 10 秒音频切成 10 个 1 秒块后,如果把它们当作 batch 一起送进模型,模型看到的是”10 个互不相关的短音频”,段间 RNN/LSTM 的状态在块之间断开,全局建模失效。想同时获得吞吐与上下文,只能让每块携带前一块的状态,或者改造成”块内并行、块间串行”的两级调度。
一个可落地的延迟预算
以 DeepFilterNet 的 5 ms 配置为例:STFT 窗 240 点(5 ms)、50% 重叠 → 帧移 2.5 ms;DNN look-ahead 2 帧、DF look-ahead 1 帧 → 总延迟 ms 量级(论文给出的是 的公式,具体数值随帧移定义)。这个量级对视频会议完全够用(人耳对 20 ms 以内的音频延迟基本无感),但对”助听器 + 唇读”这类场景已经临界面部动作同步的感知阈值。
对音乐分离,延迟预算通常宽得多:Demucs 在 V100 上分离 1 分钟音频约 0.8 秒,即使加 shift trick 也只有 8 秒。这意味着离线音乐分离可以把算力全部花在质量上,完全不需要为流式妥协;反过来,把离线模型硬塞进实时链路,往往要先砍掉最贵的部分(大通道数、双向 LSTM),质量随之下降。
工程链路:降噪不是孤立的一步
真实产品里的语音前端是一条流水线,降噪只是其中一环。把顺序放错,再好的模型也救不回来。
典型顺序与原因
- 回声消除(AEC)先于降噪。扬声器播放的声音会被麦克风收回,形成回声;AEC 需要以播放信号为参考做自适应滤波。如果先降噪,降噪模型会把回声当成”噪声”压掉一部分,但同时也会改变信号的相位与统计特性,让 AEC 的参考对齐变差。
- 波束成形(多麦克风)在降噪之前。阵列的空间滤波先把非目标方向的能量压掉,降噪模型面对的信噪比更高、动态范围更小,任务更容易。
- 降噪模型处理单通道(或波束成形后的单通道)。
- 自动增益控制(AGC)与后置均衡放在最后。降噪输出的响度会随噪声水平波动,AGC 负责把电平拉回目标范围;如果 AGC 在前,降噪模型看到的动态范围会被压缩,反而更难学。
这个顺序也解释了为什么”降噪模型”的评测通常要绑定具体的采样率、麦克风数量与前端处理链——同一个模型在 16 kHz 单麦与 48 kHz 阵列上的表现可能差出一个量级。
采样率的取舍
语音识别的声学模型通常工作在 16 kHz,而通话/会议链路常是 48 kHz 全带。对降噪模型来说,48 kHz 意味着 3 倍的频点数与更短的帧移(同样的窗长对应更细的时间分辨率),计算量显著上升。DeepFilterNet 只对 5 kHz 以下做深度滤波,就是这层取舍的直接体现:高频的周期结构对人耳定位与音色有帮助,但对”听懂”贡献有限。反过来,如果下游是音乐播放或人声修复,高频的细节就不能随便丢。
量化与端侧部署
Demucs 论文给出了一个很有说服力的数据点:64 通道模型未量化时 1014 MB、SDR 6.28 dB;用 DiffQ 量化后 120 MB、SDR 仍是 6.28 dB。也就是说,分离模型的体积可以被压到原来的 1/8 而不掉点。这类”训练后量化”能在端侧落地的原因在于:分离网络的权重分布相对平滑,对逐通道量化友好;而它不能无痛推广到所有结构——带大量小通道卷积的模型(如某些轻量 U-Net)在 4-bit 下会明显掉点。
对实时降噪,更常见的做法是算子融合 + 定点推理:把 Conv-BN-ReLU 融成一个算子,把可分离卷积与逐点卷积合并调度,再用 int8 推理。DeepFilterNet 论文强调”只用标准层”就是为了让这套融合工具链能直接工作——自定义算子(如复数运算)在端侧框架里往往没有高效实现。
站内知识的位置
音频这条线上,本站已经覆盖了几个相邻环节,按处理顺序串起来看会更清楚:
- 把声音压成离散 token 的编解码器与 codec 语言模型,可参考 音频生成的离散 token 路线:RVQ 编解码器与 codec 语言模型的架构拆解;
- 把 mel 谱还原成波形的生成器,可参考 从频谱到波形的 GAN 声码器:Parallel WaveGAN、HiFi-GAN、BigVGAN 与 StyleTTS 2 的生成器设计;
- 语音识别的前端与三种基础架构,可参考 语音识别的三种基础架构:log-mel 前端、CTC、RNN-T 与 Whisper;
- 音频扩散与流式语音合成中的延迟账,可参考 扩散模型从零讲起(十):音频扩散——波形、mel 与潜空间,语音生成的推理账 与 CosyVoice 2 架构拆解:一条语音是怎么边想边说的;
- 全双工语音对话里”边听边说”的双流结构,可参考 Moshi 全双工语音模型架构拆解。
一个值得记住的连接点是:分离与增强解决的是”输入端的信号质量”,而 TTS/ASR 解决的是”输入端之后的任务”。当降噪模型的输出直接喂给 ASR 时,优化的目标不该只是 SDR,而应该是下游的 WER——这也是为什么近年来越来越多的系统把 ASR 损失接进降噪训练,或者直接用 ASR 模型的特征做蒸馏目标。
小结
音源分离与语音增强的共同骨架是”变换 → 估计 → 反变换”,但四个关键决策把不同系统分到了完全不同的位置:
- 变换是固定的还是学出来的。STFT 给出可解释的时频面,但分辨率固定;一维卷积编码器让基函数跟着数据走,代价是失去了频点的物理含义,调试时更难定位问题。
- 估计的是逐点掩码还是跨帧滤波。逐点掩码在频带内存在多个谐波时无能为力;跨帧复数滤波(DeepFilterNet 的 deep filtering)用同频带的相邻帧做线性组合,在 5–20 ms 短窗下仍能重建谐波。
- 上下文是双向的还是因果的。双向 LSTM 与双向 RNN 换来更好的全局建模,但彻底排除流式;因果卷积 + 累积归一化可以流式,代价是论文实测的几个 dB。
- 波形域还是频谱域。波形域能直接复用输入相位(U-Net 跳连),在音乐分离上整体更优;频谱域在”人声/other”这类频带细节上更强,Hybrid Demucs 因此把两者并联。
从推理工程的角度再压一遍:分离系统的成本主要不在 FLOPs,而在上下文长度与状态管理;实时降噪的成本主要不在模型大小,而在延迟预算与算子融合;而两者的共同敌人是”块边界”与”排列歧义”——前者破坏平移等变性,后者让评测与训练都多一层匹配。把这四点想清楚,再去看任何一个新的分离/降噪模型,都能快速判断它在这条成本-质量-延迟曲线的哪个位置。
参考资料
- Conv-TasNet: Surpassing Ideal Time-Frequency Magnitude Masking for Speech Separation
- Dual-path RNN: efficient long sequence modeling for time-domain single-channel speech separation
- Music Source Separation in the Waveform Domain
- Hybrid Spectrogram and Waveform Source Separation
- DeepFilterNet: A Low Complexity Speech Enhancement Framework for Full-Band Audio based on Deep Filtering
- DeepFilterNet 官方仓库
- Demucs 官方仓库
- ICASSP 2021 Deep Noise Suppression Challenge
- BSS Eval: A Toolbox for Performance Measurement in Blind Audio Source Separation
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



