


Moshi 全双工语音模型架构拆解:两路 token 流、Inner Monologue 与毫秒级边听边说
背景:语音对话为什么被拆成了一条流水线
过去十年的语音助手几乎都长成同一个形状:语音活动检测(VAD)判断用户是否在说话,自动语音识别(ASR)把音频转成文字,语言模型在文字上生成回复,再把文字交给语音合成(TTS)读出来。每个模块单独看都足够成熟,拼在一起却出现三个结构性问题,而这三个问题都不是「换个更好的模型」能解决的。
第一笔账是延迟。四个模块串行执行,每个模块都要等上一级交出完整结果才能开工:VAD 要攒够一小段语音才能判定说话开始,ASR 要等一句话说完才敢给出稳定转写,语言模型要等完整 prompt 才能生成第一个 token,TTS 要等第一个句子写完才能合成。各级延迟逐层叠加,再加上排队和网络,端到端通常落在数秒量级。对话中几百毫秒的停顿与两三秒的停顿是两种完全不同的体验:前者是交谈,后者是轮流念稿。
第二笔账是信息瓶颈。对话的中转站是文本,而文本丢掉了大量改变语义的信息:语气、重音、语速、笑声、叹气、犹豫、背景里的非语音声音。同样一句「真的吗」,升调是惊讶,降调是怀疑,文本转写完全一样。把语音对话压成文本再展开,等于强制模型在一个有损投影上做决策,输出侧再怎么合成也补不回输入侧丢掉的东西。
第三笔账是轮次切分。流水线必须把连续的对话切成「用户说话」和「助手说话」两段,VAD 就是那把剪刀。可真实对话里两个人会重叠、会打断、会插入「嗯」「对」这类反馈音,剪刀一旦落下,这些现象要么被当成噪声丢掉,要么被错误地并入某一方。系统因此只能做「一问一答」,做不了「边听边说」。
Moshi 是 Kyutai 在 2024 年 9 月发布并开源的语音-文本基础模型,论文标题是 Moshi: a speech-text foundation model for real-time dialogue(arXiv:2410.00037)。它的出发点是把上述三个问题一次性绕开:不再拼接模块,而是把对话本身建模成一个两路并行、逐帧推进的 token 序列,让同一个 Transformer 在每个 80ms 的时间片上同时处理「用户正在说什么」和「自己正在说什么」。论文报告的理论延迟是 160ms,实测约 200ms。
这篇文章只讲架构与推理机制:Mimi 编解码器如何把波形变成 12.5Hz 的离散 token,RQ-Transformer 如何把每秒上百个 token 的生成压回到每秒 12.5 步,acoustic delay 与 Inner Monologue 各自解决什么问题,以及这套结构在流式推理时每一步到底算什么。
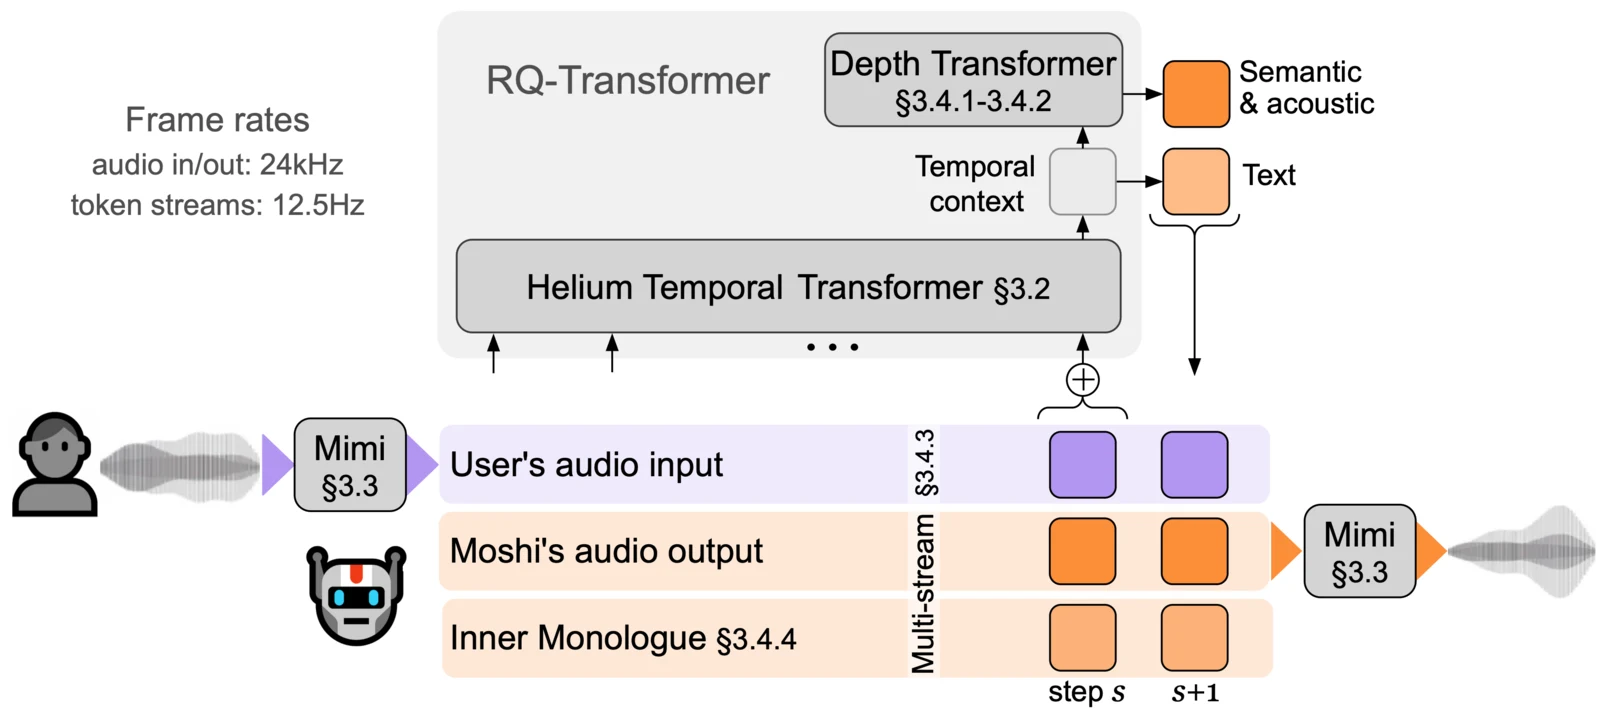
上图是论文的总览:左侧 24kHz 的音频进出,经 Mimi 压成 12.5Hz 的离散 token;中间是 Helium 的 Temporal Transformer 主干;右侧每一列是一个时间步,包含用户的 8 个音频 token、Moshi 的 8 个音频 token,以及 Inner Monologue 引入的 1 个文本 token。图源:Moshi 论文 Figure 1。
把对话写成两路 token 流
自回归语言模型只接受离散 token。要把语音塞进这套框架,第一步是把连续波形离散化,这件事由神经音频编解码器完成:编码器把 80ms 波形压成一个隐向量,残差向量量化(RVQ)把它拆成若干个码本索引,解码器再从这些索引重建波形。这一步的选择直接决定后面所有事情的时间粒度——如果编解码器每秒输出 100 帧,语言模型每秒就要串行生成 100 步,流式推理根本无从谈起。
Moshi 的时间粒度由 Mimi 定为 12.5Hz,也就是每 80ms 一个 token 时间片。在这个粒度上,一次对话被写成两路音频流:用户的一路记为 ,Moshi 自己的一路记为 ,其中 是时间片下标, 是码本层号,。再加上一路只属于 Moshi 的文本流 (Inner Monologue 使用),模型在每个时间片上要处理 个子序列。
关键在于这两路音频流是同时建模的。传统系统里,用户说话时助手处于「关闭」状态,助手说话时用户处于「关闭」状态;Moshi 的联合序列里,两路在每一个时间片都各有一套 token,无论谁在说、谁在听、是否重叠。模型因此不需要知道「轮次」这个概念:轮次不是输入,而是模型从两路流的统计规律里自己学出来的行为。
如果把 17 个子序列按时间拉平成一个序列,每秒就是 个 token,模型每秒要做两百多次串行前向。这正是下一节 RQ-Transformer 要解决的问题:把「深度」上的 17 个 token 交给一个小模型在一步内解决,把「时间」上的推进留给大模型。
Mimi:把 24kHz 波形压成 12.5Hz 的语义-声学 token
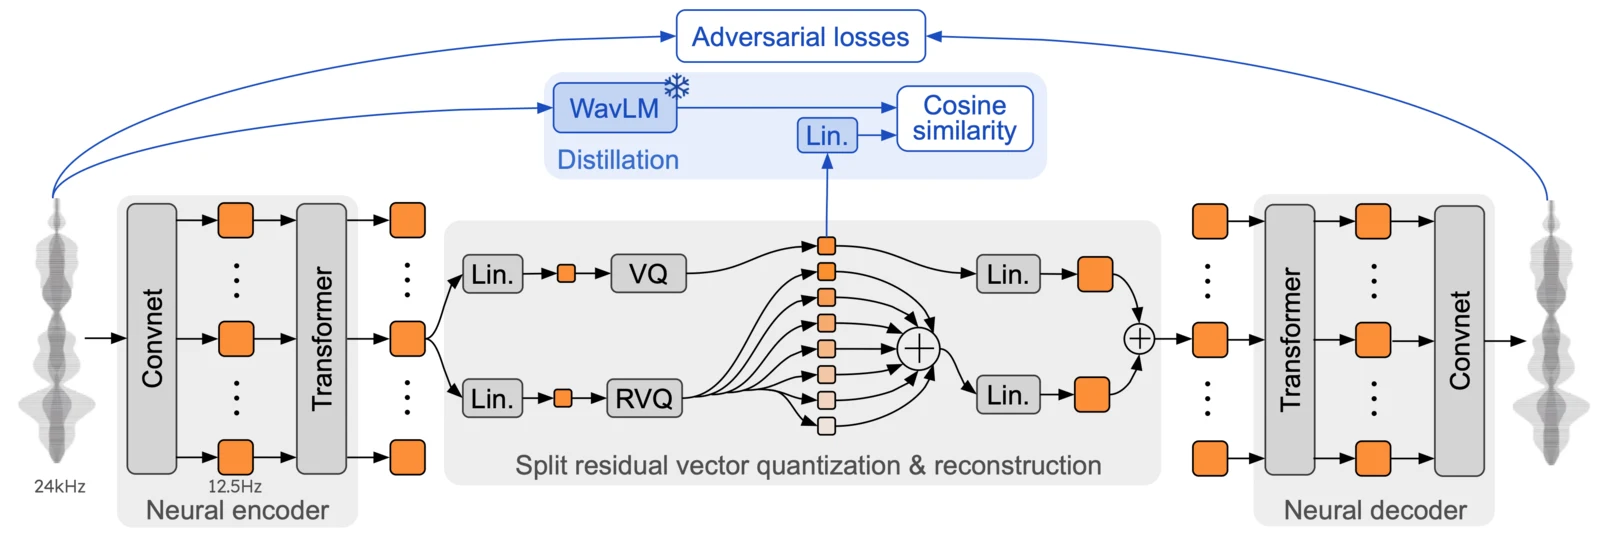
上图是 Mimi 的结构:下半部分是推理时的编码-量化-解码路径,上半部分(蓝色)是训练时从 WavLM 蒸馏语义信息到第一层量化器的路径。图源:Moshi 论文 Figure 2。
结构:SEANet 自编码器加 Transformer 瓶颈
Mimi 的骨架沿用 SoundStream 与 EnCodec 的路线:一个 SEANet 卷积编码器把单声道 24kHz 波形映射成 的隐表示,一个残差向量量化器把每个时间片的隐向量拆成多层码本索引,一个 SEANet 解码器把量化后的隐向量还原成波形。单靠卷积,感受野有限,语义信息难以在瓶颈处聚拢;Mimi 因此在量化器前后各加了一个 Transformer:8 层、8 个注意力头、RoPE 位置编码、模型维度 512、有限上下文 250 帧(20 秒)。
这两个 Transformer 的作用不同。量化前的 Transformer 把局部声学特征整合成携带更长上下文信息的隐向量,让第一层量化器有机会编码「语义」;量化后的 Transformer 在解码前重新展开时间结构,弥补量化带来的细节损失。论文的消融显示,在解码器侧加 Transformer 对重建质量(MUSHRA)有明显提升。
量化:8 层码本、每帧 88 比特、1.1kbps
Mimi 用 个量化器,每个码本 2048 项(11 比特)。隐维度是 512,但在进入 RVQ 前投影到 256 维,量化后再投影回 512 维交给解码器。每帧 比特,乘以 12.5Hz 得到 1.1kbps 的码率。作为参照,16kHz 单声道 16 比特 PCM 是 256kbps,Mimi 压了约 230 倍。
RVQ 是逐层残差分解:第一层量化器量化隐向量本身,第二层量化第一层的残差,依此类推。层号越小,承载的信息越粗、越接近语义;层号越大,越是补齐波形细节。Mimi 还使用了 quantizer dropout:训练时随机丢弃后面的层,使同一个解码器能适配不同码率——这一点对部署有用,弱网或低算力场景可以只传前几层。
帧率为什么是 12.5Hz
帧率是这套架构里最先被锁死的参数,因为它同时决定三件事。
第一是最小延迟量子。语言模型只能按帧推进,一帧 80ms 意味着任何输出至少要以 80ms 为粒度,模型不可能比这更快地「改口」。第二是序列长度。12.5Hz 下,一分钟对话是 750 个时间片;如果沿用 EnCodec 24kHz 常见的 75Hz 帧率,同样的对话就是 4500 个时间片,Temporal Transformer 的上下文与 KV 缓存都会膨胀六倍,而且每秒要做 75 次大模型前向,单步预算从 80ms 压到 13ms,实时性几乎不可能。第三是每帧的信息预算。12.5Hz 配 8 层码本、每层 11 比特,相当于每秒 1100 比特的语音描述,这个预算刚好够保留可懂度与音色,又不至于让语言模型的输出空间大到难以学习。
把帧率从 75Hz 降到 12.5Hz,靠的不是简单加大卷积步长——那样会丢太多细节。Mimi 用的是「大步长 + Transformer 瓶颈」的组合:把 24kHz 波形按 80ms 步长切帧,相当于把采样点数降低 1920 倍,再让瓶颈处的 Transformer 在 20 秒感受野内重新整合信息,把被卷积丢掉的上下文补回来。这也是为什么 Mimi 的参数量与计算量比纯卷积编解码器高,但换来的是低帧率下仍然可用的重建质量。
从语音结构上看,80ms 也接近音素的时间尺度:英语音素的典型时长在几十毫秒量级,一帧大致对应一个音素或半个音素。语义 token 以这个粒度对齐,正好落在「音素级区分」所需的精度上;再细,语言模型学不到额外的语言结构;再粗,连续音素会被合并,语义层失去区分度。
语义与声学的分裂式量化
普通 RVQ 的所有层都是声学导向的:它们优化的是重建误差,因此第一层学到的往往是波形层面最显著的结构,而不是语言学层面最有区分度的信息。已有工作发现,纯声学 token 上的语言模型很难生成语义连贯的语音,因为 token 序列里缺少稳定的音素级结构。
Mimi 的做法是把第一层单独拿出来,用自监督语音模型 WavLM 的表示做蒸馏:
- WavLM 输入 16kHz 波形,输出 1024 维、50Hz 的帧级表示;
- Mimi 输入 24kHz 波形,输出 512 维、12.5Hz 的隐向量;
- 训练时把 Mimi 量化前的隐向量投影到 1024 维,重采样到 50Hz,与 WavLM 表示计算余弦相似度损失,反向传播只作用于编码器和第一层量化器。
于是第一层码本被迫编码 WavLM 所携带的音素、韵律等语义信息,后七层继续负责声学细节。这种结构被称为 split RVQ:一个 tokenizer 同时提供语义 token 与声学 token,语言模型只需要一套 token 序列就能兼顾「说得对」与「像人声」。
论文的 ABX 音素区分度实验说明了蒸馏的必要性:不加蒸馏时,第一层 token 的音素区分能力很差,与普通声学 token 相当;加入蒸馏后,语义 token 的 ABX 错误率显著下降。换言之,语义能力不是从重建目标里自然长出来的,而是被外部自监督表示「灌」进去的。
训练目标与流式约束
Mimi 的重建目标沿用 EnCodec 的组合:多尺度 mel 频谱重建损失,加上多尺度 STFT 判别器的对抗损失。论文还试验了纯对抗训练(只保留特征损失与判别器损失)作为对照。这些损失只影响编解码器的音质,不影响语言模型的接口。
流式约束是硬性的:Mimi 的初始帧长与整体步长都等于 80ms,给定第一帧 80ms 音频就能输出第一个隐时间片,并立刻解码出 80ms 输出音频。卷积与 Transformer 都做成因果的,Transformer 的上下文上限是 250 帧(20 秒),意味着编解码器本身只需要保留 20 秒历史,不会随对话无限增长。这让 Mimi 可以真正嵌进实时回路,而不是等整段音频结束再编码。
一个容易被忽略的推论是:Mimi 的重建质量构成了 Moshi 音质的上限。1.1kbps 的码率意味着模型再强,输出也要经过这个有损瓶颈。论文在量化实验中也观察到,模型量化对语音音质的损伤比对文本能力的损伤更明显——音频 token 的分布对数值扰动更敏感。这是全双工架构固有的代价,后面在局限性里还会展开。
RQ-Transformer:把「深度」交给小模型,「时间」留给大模型
问题:17 个子序列不能串行展开
在进入架构之前,先把问题定量化。Mimi 每秒输出 12.5 帧,每帧 8 个音频 token,用户与 Moshi 各一路,再加上 1 个文本 token,一个时间片共有 17 个 token。若把联合序列按 token 逐个串行建模,模型每秒钟要做 212 次前向;要生成 5 分钟音频就是 6 万多个时间步。更致命的是,每多一个 token 就多一次同步,流式推理的延迟会被深度方向的串行完全吃掉。
这里有一个结构上的观察:同一时间片内的 17 个 token 之间是有依赖的(文字决定语义,语义决定声学细节),但它们的依赖是短程的,只发生在这一帧之内;真正需要大模型长上下文推理的是跨时间片的依赖。把这两种依赖交给同一个模型处理,是浪费。
两层 Transformer 的分工
RQ-Transformer 最早由 Lee 等人在 2022 年提出,用于在 VQ-GAN 类图像的层次码本上建模;此后 Yang 等人与 Zhu 等人把它用于音频 token。Moshi 采用的是它的两模型形式:
记 为第 个时间片第 个子序列的 token,。Temporal Transformer 负责时间维:
Temporal Transformer 只看到「过去的时间片」,且每个时间片只输入一次——它接收的是上一个时间片的 17 个 token,输出一个 维上下文向量 。它的步数是 ,不是 ,这是整个设计的第一条关键约束。
Depth Transformer 负责帧内深度维。给定 与已经生成的同帧前 个 token,它输出第 个子序列的 logits:
第一个子序列()不需要 Depth Transformer,直接由一个独立的线性层从 映射出 logits:。论文对两层各自的训练目标写作:
也就是说,第 个 token 的条件分布是「所有过去帧 + 同帧已经生成的前 个 token」。这套分解的步数账本如下:
| 模型 | 每个 80ms 时间片的步数 | 参数量级 | 看到的历史 |
|---|---|---|---|
| Temporal Transformer | 1 | 7B 量级(Helium 初值) | 过去若干个时间片 |
| Depth Transformer | 最多 | 1B 以下(1024 维、6 层) | 仅本帧的 与前序 token |
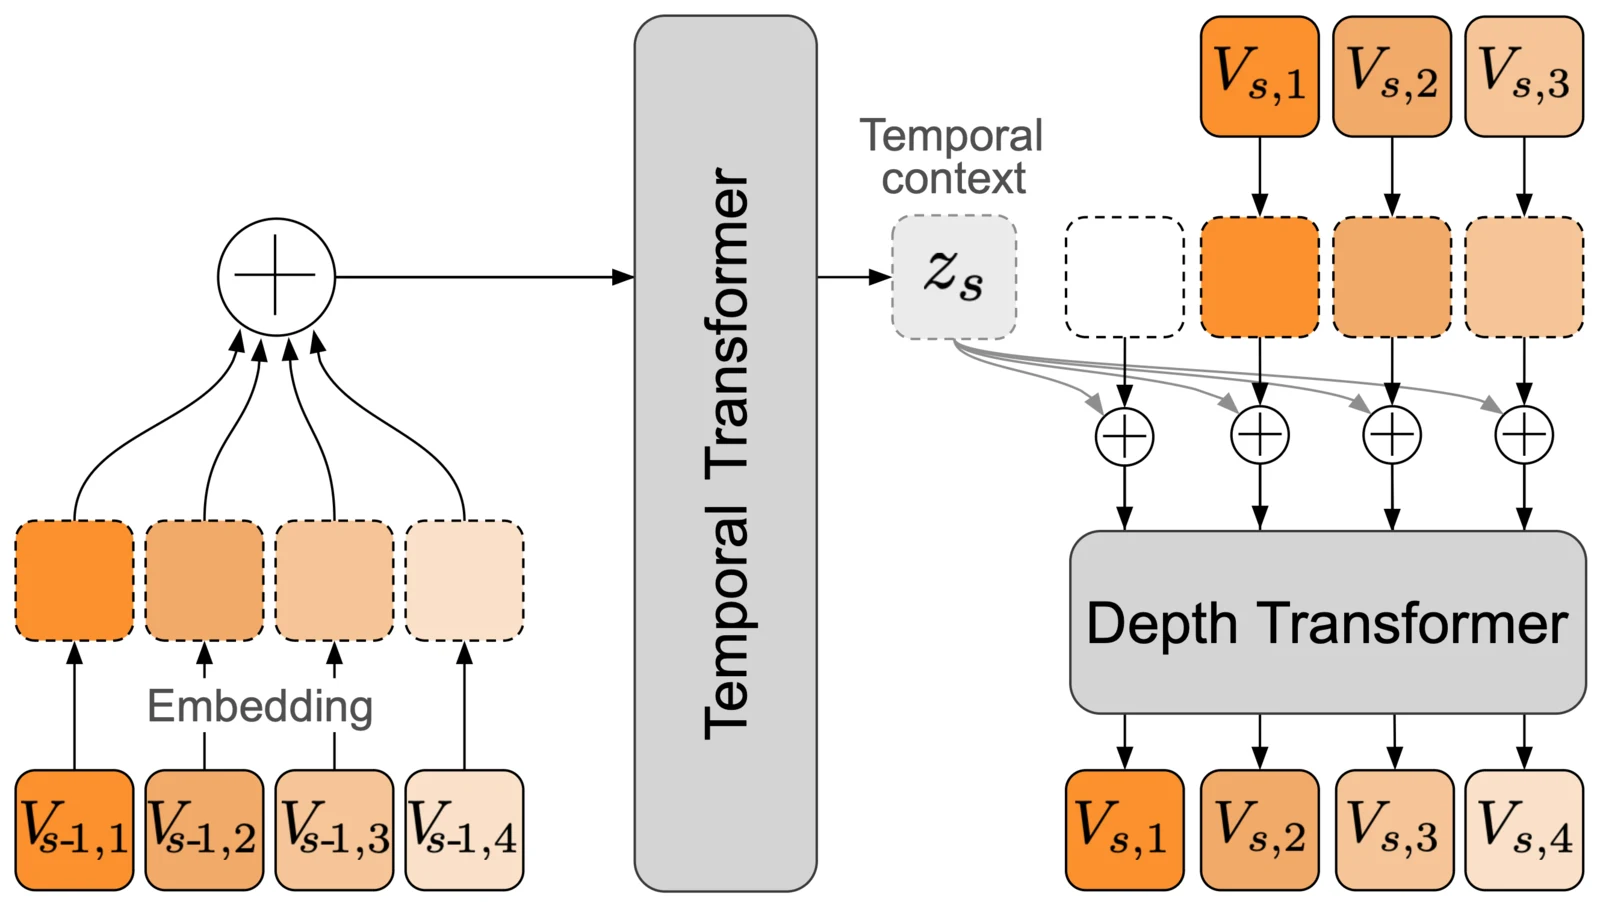
上图给出了 RQ-Transformer 的数据流:上方大模型沿时间轴推进,产出每个时间片的上下文向量;下方小模型在同一时间片内沿深度方向逐层生成。论文配图用 示意,Moshi 里 。图源:Moshi 论文 Figure 3。
为什么每帧只跑一次大模型就够
把两层分开之后,计算量发生了质变。每次前向的代价大致可以写成:
其中 与 分别是两层单步前向的代价。Temporal Transformer 是 32 层、4096 维、32 头的大模型;Depth Transformer 只有 6 层、1024 维、16 头。后者的单步代价大约比前者小两个数量级,因此即使帧内要跑 16 步, 仍然远小于 之外的那部分开销。若不做分解,把 17 个 token 全部喂给大模型,大模型每帧的步数就从 1 变成 17,代价是 17 倍。
第二层收益是 KV 缓存。大模型只需要维护时间维的长上下文 KV,每帧新增一次;小模型的 KV 只在帧内有效,每帧结束即可丢弃,缓存宽度只有 个位置。这是全双工实时推理能在单卡上跑起来的结构前提之一:长上下文成本集中在一个每帧只走一步的模型上,而且因为每帧是批处理(17 个 token 共享一次 Temporal 前向的成本被摊销),GPU 的利用率也比逐 token 串行高。
每层独立参数与语义损失加权
Moshi 相对此前音频 RQ-Transformer(如 Yang 等人、Zhu 等人的工作)做了两处改动,都在论文的消融实验里验证过:
第一,Depth Transformer 的每层参数独立。早期版本让所有码本层共享参数,但不同层的性质差异很大:第 1 层是语义 token,码本结构接近语言 token;后面几层是声学残余,分布更像连续信号的量化残差。强行共享参数会让各层的损失相互冲突。Moshi 对每个 使用独立的线性层、投影与全连接参数。由于 Depth Transformer 本身很小,这一改动几乎不增加训练与推理时间。
第二,语义 token 的损失加权到 100。训练损失是:
是文本 token,与加权后的音频 token 总损失等权; 对语义 token 取 100,对其余声学 token 取 1。这个数字来自早期训练的观察:各层损失彼此竞争,语义层的梯度容易占比过小而学不好,而语义层恰恰是决定可懂度的关键层。加大它的权重,让模型优先把语义层预测准,再做声学细节。
Temporal Transformer 的输入是上一时间片 个 token 各自查表后相加的嵌入,而不是拼接后再压缩——这与多路输入共享一个 4096 维空间的做法一致,参数量不随 线性增长。Depth Transformer 的输入是 与上一深度 token 嵌入之和。
RQ-Transformer 不是免费的:为什么论文仍需消融
一个自然的疑问是:既然两层分解明显省算力,为什么早期的音频工作并没有全部采用它。论文的消融给出了答案:
- 与阶梯延迟配合时,RQ-Transformer 收益有限。论文先复现了 MusicGen 那样的 阶梯延迟:此时各层 token 已经被时间错开,同一时间片里的层间依赖本来就很弱,共享参数的大模型也能应付,分解带来的提升不大。也就是说,RQ-Transformer 的价值取决于「帧内依赖有多强」,而这一强度又由延迟设计决定。
- 与统一延迟配合时,收益明显。当所有声学层都被推迟同样 步,帧内各层依赖更强,这时候把帧内推理交给独立参数的 Depth Transformer 才有明显收益。
- 语义损失权重与深度参数化各自都有贡献。在 RQ-Transformer 之上,把语义层损失权重提到 100、让每层参数独立,又各自带来一截提升;论文报告这两项与延迟设计、Inner Monologue 一起,构成影响生成语音长度的主要因素。
这组结论的含义是:RQ-Transformer、acoustic delay、语义蒸馏、语义损失加权、Inner Monologue 不是五个独立的小技巧,而是彼此耦合的一组设计——每一个都在替另一个打配合。单独看任何一个都是普通做法,组合起来才让「12.5Hz、两路、7B、80ms 单步」这个目标变得可行。
双流与 acoustic delay:让两路 token 在时间上错开
两路音频如何并进同一个模型
单流音频模型只处理一路 token,要把它扩展成对话,最直接的做法是把两路拼进联合序列。论文对两路音频 (Moshi 自己)与 (对方)同时施加同一种「声学延迟」再拼接,最终得到 个子序列。当 时,联合序列的形状是:
这一项由 Inner Monologue 提供,不用时可以省掉,变成 的纯音频配置。这个式子里有一个不对称的结构:两路的语义 token()都是本帧的,而声学 token()都取自 步之前。也就是说,模型在每个时间片看到的输入里,最新的是两路各自的语义层,声学层永远是过去几帧的。
acoustic delay 为什么必须有
先看它的来源。早期做法是把 ,即码本 8 层在同一步里全部是同一个时间片的 token。论文发现这样训练不稳定、生成质量差。原因和 Copet 等人 2023 年在 MusicGen 上观察到的一致:同一时间片的 8 个码本 token 在统计上高度相关(第 2 层几乎是第 1 层的函数),让模型去建模「已知第 1 层、预测第 2 层」时,条件分布极其尖锐,近似模型很容易崩溃。它们的解法是给每个码本层加不同的延迟——MusicGen 用的是 的阶梯延迟,第 层比第 1 层晚 步。
Moshi 在实时约束下重新考虑了这件事。 的最深层延迟 7 步,就是 560ms,对全双工对话来说太昂贵。论文的消融对比了几种延迟模式:
- :零延迟,Mimi 在 12.5Hz 下的最小可能延迟,80ms;
- 统一延迟 1 步():增加 80ms,即 160ms;
- 统一延迟 2 步:增加 160ms,即 240ms。
结论是 的收益最大:额外 80ms 换来生成稳定性的显著提升; 还能再改善一点,但边际收益递减,而延迟代价翻倍。最终 Moshi 的主对话模型采用 。这个选择是延迟与质量之间的显式折中,而不是「越大越好」。
为什么两路也共享同一个延迟
把 acoustic delay 作用于两路,并非简单地复用同一条规则。这样做的效果是让两路的声学层在时间上对齐:Moshi 自己的声学 token 和对方的声学 token 都来自同一步 ,模型在同一时间片比较的是「同一时刻、同一粗细级别」的两路信号,而不是一路最新、一路过时。语义层保持本帧,则让模型能第一时间捕捉对话的语义走向——对方刚说出的话的语义,以及自己已经决定要说什么的语义,都在第 1 层体现。
在推理时,这个结构带来一个重要的解耦:对方那一路的 token 是输入,不需要采样。模型在每个时间片对 与 (Moshi 自己的 9 个 token)做采样,而 (对方那一路)直接填入来自用户音频编码的结果。这意味着对方说话时模型并不是「听录音」,而是每 80ms 一次地、在生成自己输出的同时把对方的实时编码注入上下文。
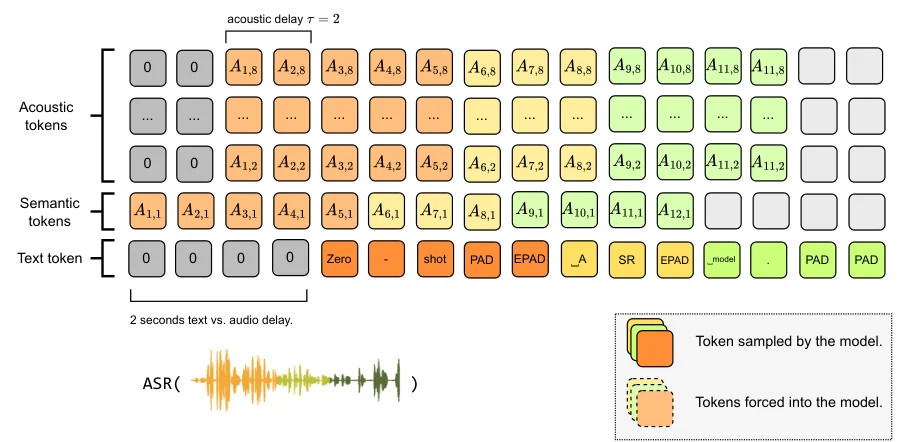
上图展示同一套联合序列如何通过改变文本与音频之间的延迟,变成流式 ASR 或流式 TTS:「虚线以下」的 token 由模型采样,「虚线以上」的 token 由外部强制填入;灰色与白色分别代表不同来源的 token。图源:Moshi 论文 Figure 8(ASR 配置)。
重叠、打断与「反馈音」
把两路放在同一个时间片上,全双工就自然成立了:模型在每个时间片既能看到对方在说什么,也能决定自己是否继续、停下、插入「嗯」或笑。对话里常见的重叠发言(Overlap)在传统系统里是异常,在这里只是两路同时有活跃 token。论文用 dGSLM 那套轮次指标(Inter-Pausal Units 之间的重叠时长、停顿 Gap 等)来量化生成对话的互动节奏,报告 Moshi 在 Fisher 数据上生成的对话,其轮次统计与真实对话处于同一量级。
这套机制也让「打断」不需要任何专门的逻辑:当模型正在生成语音时,对方的语义 token 一直在输入,如果对方给出了强信号(例如新的问题),模型会自然转向回应。代价是模型必须在持续生成的同时保持对输入的注意力,这比「一问一答」要求模型有更强的在对话流中追踪主题的能力——这也是 Moshi 需要先有 7B 文本主干和大量对话数据的原因。
Inner Monologue:先说「想说的话」,再说「怎么把它说出来」
纯音频对话的瓶颈
在纯音频配置下,Moshi 已经在对话上可用,但论文观察到两个问题:生成语音的语言质量不稳定,内容容易出现事实性偏差或语无伦次;弱模型还会「坍缩」——生成一段后陷入沉默或重复。原因不难理解:7B 模型的语言推理能力是在文本上学到的,而这些能力储存在文本表示空间里;让它的输出端直接从语义音频 token 里挑一个「听起来对」的 token,等于逼迫模型在一个它并不擅长的空间里做语言决策。
如果引入一个外部 TTS,又会回到级联的老路:延迟、信息损失、以及额外的模块。Inner Monologue 的动机是:在不偏离语音到语音的前提下,把文本能力「接」进生成过程。
做法:预测时间对齐的文本 token
Inner Monologue 在联合序列里插入第 1 个子序列 ,它是对 Moshi 自己输出语音的时间对齐文本。构造方式如下:
- 用 Whisper 转写 Moshi 的语音,得到带词级时间戳的文本(词 的起始时间除以 12.5Hz 得到起始帧索引 );
- 第 个词分词后得到 个文本 token ;
- 把整个序列初始化为 PAD,然后对每个词执行:
也就是词从它开始的帧起依次排入,词与词之间填充 PAD,词开始前的最后一帧放一个 EPAD(end-of-padding)标记。EPAD 的作用是把「一个词结束了」和「下一个词是什么」拆成两个决策:模型先决定是否结束当前词,再决定下一个词。论文报告英文对话语音中约 65% 的文本位置是 PAD——这与人的说话速率相符:一秒 12.5 帧、一帧两三个词字母都塞不下,大部分帧里没有新字。
为什么它能改善质量
训练时,模型在每个时间片必须先正确预测 ,再在它的条件下生成语义与声学 token。这相当于给语音生成加了一层「中间表示」:把「说什么」的语言决策收敛到文本空间里完成,再由文本条件引导音频 token 的产生。语义层与声学层因此不再需要承担语言推理,只需要把已经决定好的文字「说出来」。
这个机制的收益在消融里非常明确:论文报告,启用 Inner Monologue 是对生成语音的质量与长度「最显著」的改善项——它同时提升了内容正确性与语音可懂度,并显著降低了模型坍缩成沉默的概率(论文用转写长度作为强指标来衡量这一点)。论文用外部语言模型给生成的对话打分,报告 Moshi 的语言质量与「ASR + 文本模型 + TTS」的级联方案相当,而后者需要多个模型且延迟高得多。
一个延迟参数,三种任务
Inner Monologue 的文本流与音频流之间的相对延迟是可以调的。把它当成一个连续变量:
- 文本与音频同步:正常的全双工对话,模型同时产生「自己说的是什么」的文字和音频;
- 文本领先音频(论文的流式 TTS 配置,音频延迟 2 秒):文本先定,音频后补,这就是一个流式语音合成系统;
- 音频领先文本(ASR 配置,文本延迟 2 秒):音频已经产生,文本只作为对音频的滞后转写,同时把音频 token 强制填入真实输入,只采样文本——这就是一个流式语音识别系统,并自带词级时间戳。
论文强调,这三种模式对应的损失、架构与训练数据完全相同,只改一个延迟超参数。在流式 TTS 评测里,模型在 LibriSpeech test-clean 上报告 4.7% 的 WER,好于 VALL-E 的 5.9%,但逊于 NaturalSpeech 3 的 1.81%;关键在于它只需要 2 秒的前瞻,而后两者需要完整序列。ASR 模式报告 5.7% WER。论文自己把这些结果定位为「展示同一框架的灵活性」,而不是要竞争 SOTA。
为什么文本必须「时间对齐」而不是「顺序对齐」
一个容易忽略的细节是:Inner Monologue 的文本流不是把转写按顺序塞进序列就完了,而是严格按 Whisper 的词级时间戳对齐到帧。这个对齐不是装饰,它承担了三项功能。
第一,给音频 token 提供逐帧的「目标文字」。 若文本按顺序填充、不管时间,模型学到的只是「这一段文本整体对应这一段音频」,语义层与声学层之间没有逐帧的约束,文本对音频 token 的指导就变成模糊的。按时间对齐之后,每一帧的语义与声学 token 都能找到一个确定的上文——要么是某个词里的一两个子词,要么是 PAD。
第二,PAD/EPAD 把「说什么」拆成两个决策。 帧内大多时候是 PAD(论文报告英文对话里约 65%),EPAD 只在词与词的交界出现。这样模型在每一帧先决定「当前词是否已经说完」(选 EPAD 还是继续),再决定「下一个词是什么」。词边界本身就是语音里最容易出错的地方,把它变成独立决策,模型不需要在一次采样里同时完成「判断词是否结束」和「从整个词表里挑下一个词」。
第三,对齐让延迟成为一个连续可调的量。 文本流相对于音频流可以整体提前或滞后任意帧数:滞后 2 秒就是流式 ASR,提前 2 秒就是流式 TTS。如果文本没有逐帧对齐,这种平移就没有意义,因为不存在「同一帧的文本」可供平移。
这个构造依赖 Whisper 的时间戳质量。Whisper 的词级时间戳本身是模型对齐的产物,存在误差;论文用 whisper-timestamped 工具加 medium 模型提高可靠度,并对 Fisher 数据里长沉默后的时间戳另作处理。训练数据的时间对齐噪声,是全双工模型里一个不显眼但真实存在的误差源。
从架构角度看,Inner Monologue 的更深层意义是:它把「文本作为对话中转」从一种结构约束(级联流水线)变成了一种可选的内部表示。用的时候能拿到文本的好处,不用的时候模型仍然是端到端的语音到语音模型,不受文本缺失(例如非语言声音、情感)的影响。
一次 80ms 的推理步:流式状态下到底在算什么
把前面的部件放到一起,Moshi 的流式推理循环可以逐步写出来。假设对话已经进行到第 个时间片:
- 编码输入:从麦克风取 80ms 音频,Mimi 编码器因果地输出用户的 8 个音频 token(1 个语义 + 7 个声学)。
- 组联合输入:Temporal Transformer 的输入是上一个时间片的 17 路 token——Moshi 上一帧的文本 token、Moshi 上一帧的语义与声学 token、用户上一帧的语义与声学 token——各自查表后求和成一个嵌入。
- Temporal Transformer 前向一步:上一帧求和后的嵌入进入 32 层大模型,产出本帧的上下文向量 ,同时把本步的 KV 追加到长上下文缓存。这一步的 KV 长度随对话时长增长,是唯一的长期内存成本;Moshi 的上下文上限是 3000 步,约 4 分钟对话。
- Depth Transformer 帧内生成:从 (文本或 Moshi 语义层)开始,逐步生成到 (Moshi 最后一层声学),每层用独立参数。用户那一路 不生成,直接填入真实 token。
- 解码输出:把 Moshi 自己的 8 个音频 token 交给 Mimi 解码器,因果地输出 80ms 音频,推给扬声器。
- 回到第 1 步。
延迟的构成正是论文报告的 160ms 理论值:80ms 的输入帧(等待凑满一帧音频)+ 80ms 的输出帧(编码+一步推理+解码)。实测约 200ms,多出的部分是编码器、解码器与推理本身的执行时间。这个数字之所以能压到 200ms 量级,正是 Mimi 的 80ms 帧长、RQ-Transformer 每帧一次大模型前向、以及延迟 这三件事共同作用的结果;任何一环换成更粗的粒度,延迟都会成倍上升。
把这条链路与级联系统放在一起对账,差别不只在总延迟数字上,更在延迟的构成上:
| 环节 | 级联系统的典型停留 | Moshi 对应环节 |
|---|---|---|
| 说话开始检测 | 累积数百毫秒语音才能判定 | 不需要,每 80ms 直接编码 |
| 端点检测 | 等待数百毫秒静音确认说话结束 | 不需要,没有轮次边界 |
| ASR 稳定化 | 等待足够的右上下文 | 无独立 ASR 阶段 |
| 语言模型首 token | 数百毫秒(含排队与预填充) | 不存在独立的首 token 阶段 |
| TTS 首块 | 等待第一个文本片段并合成 | 无独立 TTS 阶段 |
| 合计 | 常落在 1 秒以上 | 160ms 理论 / 200ms 实测 |
表中的级联数值只是量级示意,具体系统差异很大;真正的结构性差别是「端点检测」这一项。级联系统可以把 ASR、LLM、TTS 部分流水化——流式 ASR 出部分结果、流式 TTS 分块合成——但端点检测必须等静音,这是对话轮次模型强加的等待,无法靠工程优化消掉。Moshi 去掉的不只是几个模块,而是「必须先确认你说话结束」这个前提:它在每个 80ms 都既可以继续听,也可以开口,延迟因此不再取决于对话结构,只取决于帧长与一步推理的时间。
从系统角度看,这个循环的瓶颈不在吞吐,而在单步延迟。每个时间片只有一次大模型前向,批大小的意义是「同时托管的对话数」;每个对话的 KV 按步增长,显存与可并发数之间存在直接换算关系,这与常规推理服务里 PagedAttention 面对的 KV 显存账本是同一个问题,只是这里的时间片固定、无需分页抢占。为了在更多设备上落地,论文还做了训练后量化:激活在 bf16 下动态 8-bit 对称量化,权重用分块的非对称量化。以文本侧 MMLU 衡量,Helium 在块大小 32 的 W4A8 下只掉约 1 个百分点(52.97 对 bf16 的 54.3);而 Moshi 在同样的 4-bit 配方下掉 5 到 10 个点,8-bit 权重则掉约 2 点——在线演示因此选择 8-bit 权重。这里的差距恰恰反映了全双工模型比纯文本模型对数值误差更敏感,音频输出对量化扰动尤其脆弱。这种按块缩放的权重非对称量化,机制上与 AWQ 讨论的逐通道缩放有相似的动机:用更细的量化粒度保住少数敏感的部分。
工程取舍与局限
把 Moshi 的架构放在一起看,它的优点和代价都很清楚。
优点来自「一个模型负责整条链路」。延迟是确定的 160ms / 200ms,不随对话轮次累积;文本中转造成的信息损失被绕开,非语言信息直接在两路 token 里流动;轮次、重叠、打断不需要显式检测。Inner Monologue 又保住了一个关键收益——可以从模型里流式地取出文本,这让流式 ASR 与流式 TTS 作为「副产品」出现。
代价同样是结构性的。第一,Mimi 的 1.1kbps 码率是硬上限,模型再强也逃不出这个瓶颈,音质与说话人的自然度受编解码器制约。第二,音质与内容对量化的敏感度不同,压缩 Moshi 时折衷更困难,论文自己也认为语音模型量化的文献远少于 LLM 量化。第三,7B 参数的单步前向要在 80ms 内完成,硬件门槛高,多设备、移动端部署需要更小的变体或更强的压缩。第四,两路共用一个时间片意味着时间片越长,模型对细粒度时序的感知越粗;12.5Hz 对语音足够,但对更快的声学事件(例如瞬态噪声、短促的插入音)可能不足。
训练侧只需交代一句背景:Moshi 的 Temporal Transformer 由 Helium 文本主干初始化,随后在约 700 万小时音频与 Fisher 双声道对话数据上继续训练,其中物理分离的双流监督是整条链路里最稀缺的部分。
与站内已有工作的关系:Mimi 的 RVQ 与 codec 语言模型属于离散音频生成的同一家族,相关机制在 音频生成的离散 token 路线 里详细展开;Inner Monologue 的「文本先行」思路,与流式语音合成中把语义 token 与声学 token 分层预测的做法有共同的动机,可对照 CosyVoice 2 架构拆解 和 语音合成的声学模型 阅读;而 RQ-Transformer 的两层结构,把「深度」交给小模型、把「时间」留给大模型的思路,与视觉侧的 Visual Autoregressive Modeling 把层次码本改成逐尺度预测是同一类问题的两种回答。
小结
Moshi 的核心是把「语音对话」重新表述为一个可实时流式生成的联合 token 序列问题,并用三个部件把它实现:
- Mimi 定义了时间粒度与 token 语义:12.5Hz、8 层码本、1.1kbps,第一层通过 WavLM 蒸馏携带语义,后七层补足声学细节;
- RQ-Transformer 解决了「每秒两百多个 token 无法流式串行」的计算问题:大模型每帧一步管时间维长上下文,小模型帧内 16 步管深度维码本,配以每层独立参数与语义损失加权;
- 双流 + acoustic delay + Inner Monologue 解决了「如何边听边说」与「如何说对」:两路音频在每帧各占一套 token,延迟 1 步换取生成稳定性,文本流作为可选内部表示接入语言能力。
最终得到的是一个 160ms 理论延迟、约 200ms 实测延迟的全双工语音模型。它不代表语音对话的终点——码率瓶颈、量化敏感与算力门槛都是真实的限制——但它给出了一条与级联流水线完全不同的架构路线:把对话从一个被切成轮次的文本序列,改写成一个两路同时流动的、以毫秒为粒度的 token 流。
参考资料
- Moshi: a speech-text foundation model for real-time dialogue(arXiv:2410.00037)
- Moshi 论文 HTML 全文(含全部插图)
- kyutai-labs/moshi 官方开源仓库
- kyutai-labs/mimi 音频编解码器实现
- Kyutai 官方 Moshi 论文 PDF
- Lee et al., Autoregressive Image Generation using Residual Quantization(RQ-Transformer 原始工作)
- Copet et al., Simple and Controllable Music Generation(MusicGen,阶梯码本延迟)
- Défossez et al., High Fidelity Neural Audio Compression(EnCodec)
- Chen et al., WavLM: Large-Scale Self-Supervised Pre-Training for Full Stack Speech Processing
- Nguyen et al., Generative Spoken Dialogue Language Modeling(dGSLM)
正文插图均取自 Moshi 论文官方图(Figure 1、Figure 2、Figure 3、Figure 8),经本地转换为 WebP 后引用。
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



