


语音转换基础架构:从 CycleGAN-VC 的循环一致性到 kNN-VC 的逐帧近邻替换
语音转换要做的事情可以用一句话描述:拿一段 A 说的语音,保留它说的内容和语气,只把说话人换成 B。这听起来像“换一个音色”,但原始波形里音色和内容是完全混在一起的——同一个音素被不同的人发出来,基频、声道共振、发音时长都在变,而且手上通常没有 A 和 B 说同一句话的配对录音来做监督。
本文按“在哪里动手”来梳理语音转换的几种基础架构:在梅尔频谱上用 GAN 做映射的 CycleGAN-VC 与 StarGAN-VC,用信息瓶颈强行分开内容与音色的 AutoVC,用逐帧近邻替换代替学习映射的 kNN-VC,以及把它们推到零样本语音克隆的 FreeVC、AGAIN-VC 与 Seed-TTS 一类系统。每一节的落点都是同一个问题:模型凭什么知道“这一部分是内容、那一部分是音色”。
问题定义:变的是音色,不变的是内容
先把术语固定下来。输入是一段语音 ,说话人身份是 ;模型要输出 ,满足三个约束:
- 说话人一致: 听起来必须像目标说话人 ,而不是像 。
- 内容保留: 说出的话与 相同——音素序列、词、停顿、重音都要对得上。
- 非文本信息尽量保留:语速、情绪、口音习惯、语种不该被随机改成目标说话人的习惯。这条最容易在追求“像目标说话人”的过程中被牺牲,也是区分系统好坏的关键。
常见的语音转换任务按数据条件与说话人规模可以分成几类:
| 条件 | 含义 | 典型方法 |
|---|---|---|
| 平行数据 | A、B 说同一句话的配对录音 | 早期依赖动态时间规整的帧对齐方法 |
| 非平行数据 | 只需 A、B 各自的录音,不要求说同一句话 | CycleGAN-VC、AutoVC |
| 多对多 | 任意两个说话人之间都能互换 | StarGAN-VC 的条件标签 |
| 零样本 | 目标说话人只给几秒到几分钟参考语音,模型事先没见过 | AutoVC、FreeVC、kNN-VC、Seed-TTS |
| 无文本 | 推理时不需要转录文本 | FreeVC、kNN-VC |
“平行数据”听起来最省事,实际最麻烦:即使让两个人读同一句话,录音起点、语速、停顿也不一致,还得做自动时间对齐(动态时间规整,DTW),对齐错了会直接污染训练样本。非平行数据才是真实场景,也正因为没有配对,模型必须自己找到“哪些信息该随说话人变、哪些不变”。
表征分层:语音转换在哪个层面动手
语音转换模型“动刀”的层次决定了它的结构和质量上限。按从粗到细排列:
- 文本层:把语音转成文字,再用目标说话人的 TTS 读出来。内容保证 100%,但韵律、情绪几乎全部丢失,语速被目标说话人的习惯覆盖。这更像“复读”而不是“转换”。
- 离散语义 token 层:用自监督模型(HuBERT、Wav2Vec2、WavLM 等)的离散单元或语音编解码器的 codec token 表示内容,再交给目标说话人的生成模型合成。Seed-TTS 一类零样本克隆系统走这条路线,音色由生成模型里的说话人条件控制。代价是语义 token 已丢掉部分细节,生成阶段得重新“长”出音色。
- 自监督连续特征层:WavLM、Wav2Vec2 中间某几层的连续特征与音色关联很弱、与内容关联很强。kNN-VC 直接把这一层当作工作平面。
- 梅尔频谱层:保留完整的声学细节,但音色与内容仍然纠缠,需要在频谱上做显式分离或映射。CycleGAN-VC、StarGAN-VC、AutoVC、AGAIN-VC 都工作在这一层(或其倒谱版本),输出再交给声码器还原成波形。
- 波形层:直接从 A 的波形生成 B 的波形,信息最全,但要处理相位和周期结构,建模难度最大。
一个语音转换系统通常由三到四块拼起来:
源语音 x ──► 表征提取(梅尔频谱 / 倒谱 / 自监督模型) │ ▼ 转换模块(把内容从音色里剥出来,再注入目标音色) │ ▼ 生成/合成模块(声码器,或逐帧特征替换后的声码器) │ ▼目标语音 y目标说话人参考语音 y_ref ──► 说话人编码器 s_y ──► 注入转换模块后面每一节都在拆这三个问题:内容怎么和音色分开、音色怎么被注入、缺掉的那一部分细节怎么补回来。
CycleGAN-VC:用循环一致性绕开配对数据
CycleGAN-VC 由 Takuhiro Kaneko 等人在 2017 年提出,论文为 Parallel-Data-Free Voice Conversion Using Cycle-Consistent Adversarial Networks,后续在 2019 年的 CycleGAN-VC2 上做了改进。它把图像领域的 CycleGAN 直接搬到语音的梅尔倒谱序列上。
非平行数据下的困境:平行数据时,A 和 B 同一句话的帧可以直接对齐,学一个帧到帧的映射就够了。非平行时,映射关系没有监督信号——模型完全可以把内容也改掉,只要生成的声音“像 B”就能骗过判别器。这是一个典型的“无穷多个映射都能让判别器满意”的问题:从源语音到目标分布的映射有无数种,其中很多种会破坏内容。
核心思想:双向映射 + 循环一致性。 设 把说话人 A 的语音变到说话人 B, 做反向。对一句源语音 ,先正向变到 B、再反向变回来,结果应该和原始输入相同:
这个约束迫使正向映射“只改音色”,因为任何内容改动在反向映射里都很难被原样恢复。反方向同理。这一约束不需要配对数据,只需要两个说话人各自独立的语料。
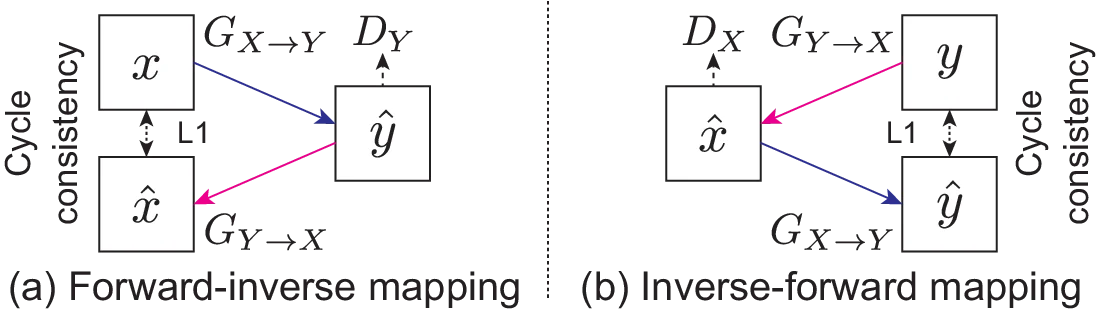
上图是论文中的训练过程示意,(a) 是正向再反向的循环路径,(b) 是反向再正向的循环路径。每条路径两端都接判别器 、,而跨越两个方向的箭头就是 循环损失。图中的思路很直白:判别器只为“这条语音像不像该说话人”打分,而循环损失负责把“说过的话”钉住。
上图省掉了一些细节,完整的训练目标由三项组成:
符号含义:、 分别是 A 侧、B 侧的语音特征序列; 是判断“输入是否来自 B 侧真实语音”的判别器; 是逐元素绝对差之和(L1 距离)。完整目标为
其中 、 是两项正则的权重。
为什么还需要身份损失。 循环一致性只约束“改得回来”,并不保证映射保留语言信息——一个能来回转换却把所有辅音都模糊掉的映射,同样可以满足循环约束。身份损失 于是补了一刀:把本来就属于 B 的语音喂给 ,输出应该仍是它自己。这条约束要求生成器在“接收本域输入”时什么也不做,从而抑制它把内容也一起改掉。论文加入身份损失的动机正是:只靠循环一致性与对抗,映射仍可能改变音素细节;要求生成器对本域输入保持恒等,可以把“音色之外什么都不改”变成一条更直接的约束。
结构细节。 生成器使用门控卷积(Gated CNN)堆叠:每层输出由一个线性投影与一个由 sigmoid 控制的“门”逐元素相乘,即
其中 是第 层特征,、 是两个卷积核,、 是偏置, 是 sigmoid, 是逐元素乘。选择门控卷积而不是 RNN,是因为语音有“清音/浊音”“音素/词”这类层级结构,RNN 适合建模序列但难以并行;门控卷积的“门”让网络按前一层状态选择性地传递信息,又能整段序列一次算完。
判别器是全卷积结构、逐位置判断真假:输入一段连续的帧,输出一组“这些位置是否真实”的分数,而不是只给整句一个标量。这样判别器只能盯着局部纹理是否像该说话人的音色,不容易把“内容对不对”和“音色像不像”混为一谈。
数据与特征。论文在 Voice Conversion Challenge 2016(VCC 2016)数据上实验——五位女声、五位男声的专业美式英语录音,取一对女声(SF1、SM1 一侧)为源、另一对(TF2、TM3)为目标,每位说话人 216 句、约 13 分钟。为了模拟非平行场景,训练集被切成互不重叠的两半,一半给源、一半给目标,因此训练时看不到任何配对句子。语音下采样到 16 kHz,每 5 ms 用 WORLD 分析系统提取 24 维梅尔倒谱系数(MCEP)、对数基频与非周期性,只在 MCEP 域学习映射;基频用对数域高斯归一化变换单独转换,非周期性原样保留。这意味着语音先被显式地拆成“语调”和“音色/内容”两部分:转换只动后者,前者的轮廓跟着源语音走。实现上,判别器用二维 CNN 关注频谱纹理,生成器里的上采样用像素重排(pixel shuffle)减少方块伪影;对抗损失采用最小二乘 GAN 以稳定训练,,身份损失 只在训练前期启用。
这一处同样回答了“文本层为什么不够”:WORLD 显式给出基频与包络,让语调轮廓可以在转换中被原样保留;而如果把语音先转成文字再合成,基频轮廓就会被目标说话人的习惯覆盖。
局限:循环一致性是一个间接约束——它只保证“改得能改回来”,并不保证生成语音的内容不漂移。实践中,这类频谱映射方法在长句、分布外音素和快速韵律变化上容易“平淡化”,部分内容细节被抹平;CycleGAN-VC 也不例外。它的两两配对训练方式也难以扩展到几十个说话人的“多对多”场景。
StarGAN-VC:一个生成器加条件标签,做多对多
CycleGAN-VC 做多对多要“每两个说话人一个模型”,参数和训练成本随说话人数量平方增长。2018 年提出的 StarGAN-VC 沿用 StarGAN 的“星型”结构,把多对多收敛成一个生成器 + 条件标签的组合。
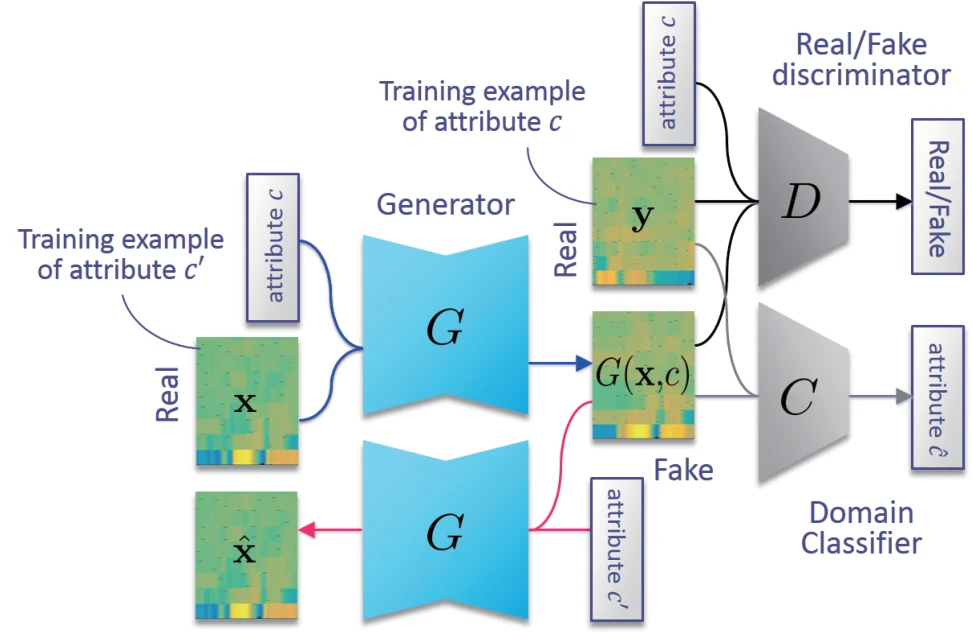
上图是论文中的 StarGAN-VC 训练概念图。中心是同一个生成器:同一条语音配上不同的目标属性标签 、,就会生成不同说话人下的版本(图中“Training example of attribute c”与 两路);判别器 接收“语音 + 标签”二元组,判断这条语音在该标签下是否真实——真实语音配错标签会被判假;域分类器 则从语音反推属性,用来要求生成结果的标签与输入的目标标签一致。
生成器定义为 :输入语音特征序列 与目标说话人标签 ,输出目标说话人下的语音。 是独热向量(若还有其它属性,如性别、情绪,可以拼接成多个独热向量),在解码器的每一层沿通道和时间维度平铺后拼接进去,因此生成器只需要改“条件”,不需要为每个说话人换一套参数。
训练目标由四项组成:
负责“生成结果落在目标说话人的数据分布里”, 负责“生成结果的说话人标签就是 ”——后者用域分类器 充当“可微分的标签一致性检查”,比对抗更稳定。再叠加循环损失与身份损失:
循环损失要求“先转成 、再转回原本的 ”能还原输入,身份损失要求“输入本来就属于 ”时生成器不改动它。总目标为
频谱增益的重建方式需要展开。 训练好的生成器输出的是“目标说话人下的梅尔倒谱 ”。如果直接用它重建波形,那么频谱包络里的全部细节(包括源语音的音高信息)都得由生成器重新生成。StarGAN-VC 采用另一种做法:把输入语音 用原说话人的标签 再生成一遍得到 ,然后用 与 逐帧相除得到一组“频谱增益函数”,再把增益乘到源语音的原始频谱包络上重建波形。这样做的意义是:差值 只编码“从源说话人到目标说话人的相对变化”,而源语音自身的基频轮廓、非周期性可以原样保留。音色的改变被压成了一次“包络滤波”,比让生成器自己造出整段频谱更不容易丢失内容。
实验设置:论文在 VCC 2018 的 22050 Hz 数据上实验,选出两女(VCC2SF1、VCC2SF2)两男(VCC2SM1、VCC2SM2)四位说话人, 是四维独热向量,共 12 种源-目标组合。语音每 5 ms 用 WORLD 提取频谱包络、log 基频和非周期性;从频谱包络上取 36 维梅尔倒谱作为生成器的输入输出。基频轮廓用对数域高斯归一化变换单独转换:先把源说话人的对数基频按均值和方差标准化,再套到目标说话人的均值和方差上——也就是说,语调的“整体高低”随说话人平移,而轮廓的变化形状(哪几个字重读、句末升还是降)被保留下来,非周期性则原样使用。生成器是纯卷积结构、没有全连接层,因此能接受任意长度的整段输入。
与 CycleGAN-VC 的关系:两者都在梅尔频谱上工作,区别在约束的组织方式——CycleGAN-VC 用两个生成器和两个判别器做两两映射;StarGAN-VC 用一个生成器、一个判别器、一个分类器,把“多对多”变成一个带标签条件的生成问题。StarGAN-VC 还通过频谱增益重建显式保留了源语音的基频轮廓,这是对“内容不变”的一项结构层面约束。
AutoVC:用信息瓶颈把内容与音色强行分开
2019 年的 AutoVC 换了一条完全不同的路线:不再靠对抗或循环,而是设计一个信息瓶颈的自编码器,让内容编码器的输出维度远小于说话人编码器,迫使内容编码器“不得不丢掉音色”。
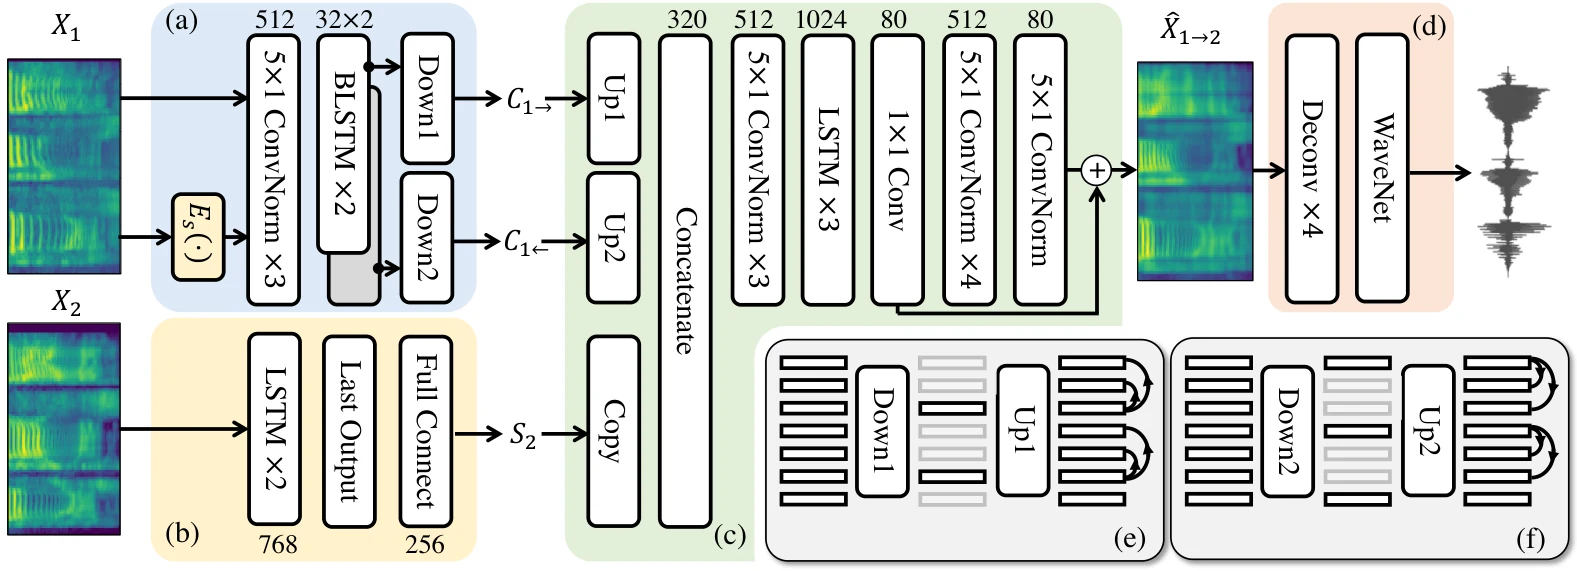
上图是论文中 AutoVC 各模块的详细结构。(a) 是内容编码器:输入 80 维梅尔频谱与说话人嵌入拼接,经过三层 5×1 卷积后进入两层双向 LSTM(每个方向 32 维),再把正向、反向输出按 32 倍降采样;图中标出 、 两条低维内容编码。(b) 是说话人编码器:两层 768 维 LSTM,只取最后一帧的输出,经全连接压到 256 维。(c) 是解码器:把 64 维内容编码上采样回原始时间分辨率,和说话人向量拼接后进入三层 512 维卷积与三层 1024 维 LSTM,输出 80 维梅尔频谱的初值。(d) 是频谱逆变换器(声码器)。
三项损失。 AutoVC 的训练只用一个自编码器损失,没有任何对抗项:
符号含义: 是源说话人 的一句语音的梅尔频谱; 是它的内容编码; 是同一说话人另一句语音 的说话人编码; 是重构结果; 是第二项损失的权重(论文取 1)。这里有一个容易看漏的细节:内容编码器的输入拼接的是源语音自身的说话人嵌入 ,而解码器在重构时拿到的说话人条件是来自另一段语音的 。前者给内容编码器一个“把音色减掉”的参照,后者让训练时的条件与推理时一致——转换时目标说话人的向量本来就来自任意一段目标语音,而不是正在被转换的这一句。
瓶颈为什么能把音色挤出去。 第一项要求“重构得准”,第二项要求“重构结果再编码一次,内容编码要和原来一致”。两项合起来,迫使 的容量全部用在“重构需要、且跨说话人稳定的信息”上。如果瓶颈很宽,内容编码器可以直接把整段频谱抄进去,重构完美但内容编码里混着音色;如果瓶颈很窄,内容信息也丢光,重构变差;合适的瓶颈宽度只容得下与说话人无关的内容信息。
论文给出了一个形式化命题(定理 1)来支撑这个直觉:若语音 是关于说话人 的平稳、 阶马尔可夫过程,令 为给定说话人后语音的最优编码长度,瓶颈维度 ( 为帧数),则存在内容编码器与解码器,使当 时重构误差趋于零,且转换结果的条件分布收敛到“目标说话人说出源内容”的理想分布。 这一项的意义是“随序列变长允许的冗余”:序列越长,瓶颈需要略微放宽才能保证重构,但放宽的量亚线性增长。证明的思路是反证法:如果转换结果质量低、而自重构质量高,两者就可被区分,与损失最小时两者不可区分矛盾。
零样本能力:转音时只需要目标说话人的语音经 得到的 256 维向量,不需要在目标说话人上训练。这使 AutoVC 成为最早具备“零样本语音转换”能力的架构之一。
实现细节:说话人编码器用 GE2E 损失在 VoxCeleb1 + LibriSpeech 的 3549 个说话人上预训练;内容编码用 32 倍时间降采样(正向保留 0、32、64…帧,反向保留 31、63、95…帧),既降通道维度又降时间维度;重构时还会额外加一项“初值重构”损失来加速收敛;声码器是 WaveNet。
局限:低维瓶颈会顺带丢掉音色以外的一些细节,如气息声、口音的细微纹理;非平行训练下内容保真度也不如后来基于自监督表征的方法。但 AutoVC 把“零样本语音转换”变成了一个可训练的架构问题,也把“用信息瓶颈代替对抗”这条路线系统化了。
AGAIN-VC:用归一化统计量注入音色
AutoVC 依赖“维度瓶颈”,维度选不对就会在“音色泄漏”和“内容损失”之间来回摆。AGAIN-VC(Activation Guidance and Adaptive Instance Normalization,2020 年)换了一个更轻量的分离手段:用归一化层的统计量来表示音色。
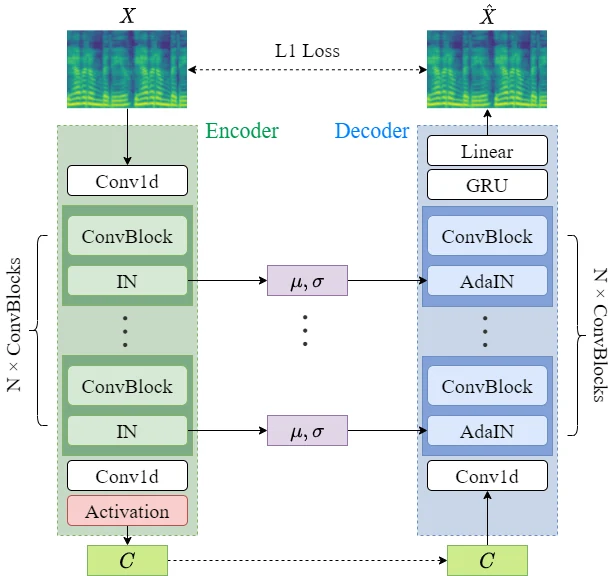
上图是 AGAIN-VC 的结构示意。左侧编码器每一层后都接一个实例归一化(IN)层,IN 把每个通道的均值 与标准差 减掉、除掉,得到“去掉全局风格”的表示(也就是内容候选)。这些 、 没有丢掉——它们通过 U-Net 的跳跃连接直接送到解码器对应层的 AdaIN 层。转换时把目标说话人的 、 填进去,解码器就把内容表示“重新染色”成目标音色。
记输入梅尔频谱 ( 为频率维、 为帧数),逐通道统计量为
是待转换的内容表示, 是为防止除零加的小常数。这里的核心观察是:、 是时间无关的,因此天然无法表示随时间变化的内容;而音色恰恰是说话人身份带来的、跨时间稳定的偏移。于是“把统计量当作音色、把归一化结果当作内容”不是一种近似,而是一种把两者的时间尺度差异作为分离依据的设计。
激活引导(AG) 进一步收紧:实例归一化之后的内容表示会经过一个 sigmoid 激活再送进解码器。sigmoid 把取值范围压缩到 ,相当于再套一层信息瓶颈,让内容表示无法携带足够多信息来“顺便”把音色也编码进去。模型因此必须从解码器的 、 里获取音色,而 、 又不随时间变化,无法编码内容——两条信息路径被推到了各自的轨道上。论文对比了 ReLU、ELU、Tanh 与 sigmoid:ReLU 过于粗暴、损失内容,sigmoid 的约束最为合适。
一个可量化的验证方式:在内容表示上训练一个说话人分类器,看它能把说话人猜得多准。分类器准确率越低,说明内容表示里残留的音色越少;同时重构误差不能升太多。论文用“说话人分类准确率 vs 重构误差”的权衡曲线来比较不同的瓶颈方案:在相同通道规模下,使用 sigmoid 引导的点整体下移、略微右移——说话人分类准确率大幅下降,重构误差只小幅上升,权衡曲线因此整体改善。
AGAIN-VC 的实现非常轻:VCTK 的 109 位英文说话人中取 80 位训练、其余留作评测,语音统一到 22050 Hz 并裁掉首尾静音,按 1024 窗长、256 跳长、80 个梅尔频带提取梅尔频谱(与 MelGAN 的配置一致),每段取 128 帧(约 1.5 秒)。模型是单编码器 + U-Net 解码器,训练损失只有重建项 ,用 Adam、初始学习率 0.0005、批大小 32,训练 10 万步;输出接预训练的 MelGAN 声码器。
与 AutoVC 和 FreeVC 相比,它有两个结构性优势。其一是无需说话人编码器:AutoVC 靠 GE2E 预训练的说话人编码器产出一个 256 维向量,这个向量训练自说话人验证任务,转换质量受制于“验证用的嵌入是否适合合成”;AGAIN-VC 的音色直接取自编码器里已经存在的 、,没有额外模块,也没有“验证嵌入适不适合合成”的错位。其二是没有离散化:VQ 类方法(例如 VQVC+)靠矢量量化把内容压成离散码本,音色泄漏确实压下去了,但离散化的粗粒度会损伤内容——论文明确指出这是 VQVC+ 的主要短板,而 AGAIN-VC 的连续表示 + 激活瓶颈避开这一点。
自监督表征:音色天然“薄”的那一层
2019 到 2020 年前后,Wav2Vec2、HuBERT、WavLM 这类自监督语音模型改变了语音转换的做法。它们在大规模未标注语音上做掩码预测或对比学习,得到的中间层特征与音素内容高度相关,而说话人身份的信息主要残留在浅层卷积与深层特征里。换句话说,内容与音色的分离被交给了预训练模型,而不是从头用瓶颈或对抗去学。
用 WavLM/Wav2Vec2 的中间层作为内容表征、用 ECAPA-TDNN、x-vector 之类的说话人模型作为音色表征,剩下的工作就变成一个“翻译”问题:把内容特征映射到目标音色的声学特征,再交给声码器合成。FreeVC(FreeVC: Towards High-Quality Text-Free One-Shot Voice Conversion,2022 年)就是这一路线的代表。
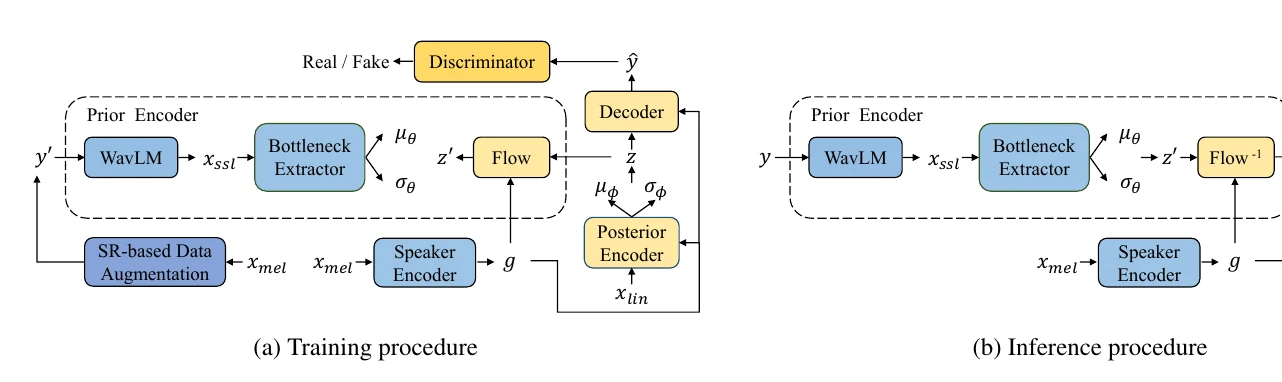
上图是 FreeVC 的训练流程(a)与推理流程(b)。(a) 训练时,源语音 先经过 SR 数据增强得到 (变声后音色变了、内容不变),再从 提取 WavLM 的 SSL 特征 ,经瓶颈提取器压到 维后进入先验编码器;同时 经梅尔频谱得到后验编码器的目标分布,两边约束同一个潜变量。说话人编码器从 提取嵌入 。(b) 推理时直接用源波形 走同一条前向路径,潜变量经 flow 逆变换与解码器输出目标梅尔频谱,再合成波形。图中还有 (线性频谱)与判别器,分别对应 VITS 的重构与对抗部分。
FreeVC 的三个关键设计:
- 继承 VITS 主干。VITS 本来是一个“文本 → 梅尔频谱 → 波形”的端到端 TTS,里面有先验编码器(文本 → 分布)、后验编码器(梅尔 → 分布)、归一化流、解码器、判别器。FreeVC 把“文本”换成“源语音经 WavLM 得到的 SSL 特征”,结构与训练损失(重构 + KL + 对抗 + 特征匹配)基本沿用。这样它天然继承了 VITS 的高质量合成能力,而不是在梅尔频谱上从零学一个映射。
- 瓶颈提取器。WavLM 的 SSL 特征维度是 1024,其中既含内容也含音色。FreeVC 用一个“瓶颈提取器”把它压到 192 维再使用。论文里说“这个巨大的维度差构成信息瓶颈”——但关键不只是降维,更重要的是配合下面的 SR 增强。
- SR 数据增强。这是 FreeVC 最巧的一处。VITS 的后验编码器从原始梅尔频谱取目标,那么先验编码器只需要“复制”输入梅尔就能完美重构,音色会在训练中被原样灌进内容表征。FreeVC 的对策是先做频谱缩放:把梅尔频谱在频率轴上按比例 拉伸或压缩,再在顶部补齐或裁掉,使它保持原形状,然后用声码器还原成波形 。 时相当于“把音色压低”(基频与共振峰整体下移), 时“把音色拉高”,两者的内容都与原语音一致。训练时用 走先验路径、用 经后验编码器提供目标,模型被迫在两个“内容相同、音色不同”的波形之间保留共同的内容、放弃差异的音色。缩放比 在 0.85 到 1.15 之间,这一做法不需要任何复杂的信号处理知识,也不用对说话人做标注。
- 说话人编码器可选。FreeVC 可以用预训练说话人验证模型,也可以从零与主干联合训练一个 LSTM 说话人编码器。论文主张:只要内容表征足够“干净”,联合训练的说话人编码器自己能学会建模缺失的音色信息。
FreeVC 的“无文本”是实打实的好处:推理时不需要 ASR 转录,因此可以处理没有文字稿的语音,速度也更快;对比依赖 PPG(音素后验图)的文字级方法,它不会因为 ASR 识别错字而把“转录错误”带进转换结果。论文在 VCTK 的 107 个说话人上训练,LibriTTS test-clean 上对比 VQMIVC、BNE-PPG-VC、YourTTS 等基线,单卡 3090 训练到 900k 步。
可以对照本站此前对 声纹识别与语音克隆基础架构 的讲解来理解这一层:说话人编码器输出的是一个固定维度的音色向量,语音转换只需要“重新注入”它,而不是重新学一遍说话人判别。与 AutoVC 的“编码器拼接解码”相比,FreeVC 的分离来自预训练表征本身 + 数据增强,而非依赖瓶颈维度恰好选得对。
kNN-VC:不训练映射,只做逐帧近邻替换
如果说前面几类方法是“学一个转换函数”,那 Voice Conversion With Just Nearest Neighbors(kNN-VC,2023 年发表,作者团队来自 Stellenbosch 大学)几乎是把问题反过来:不训练任何映射,直接在自监督特征的逐帧结构上做替换。
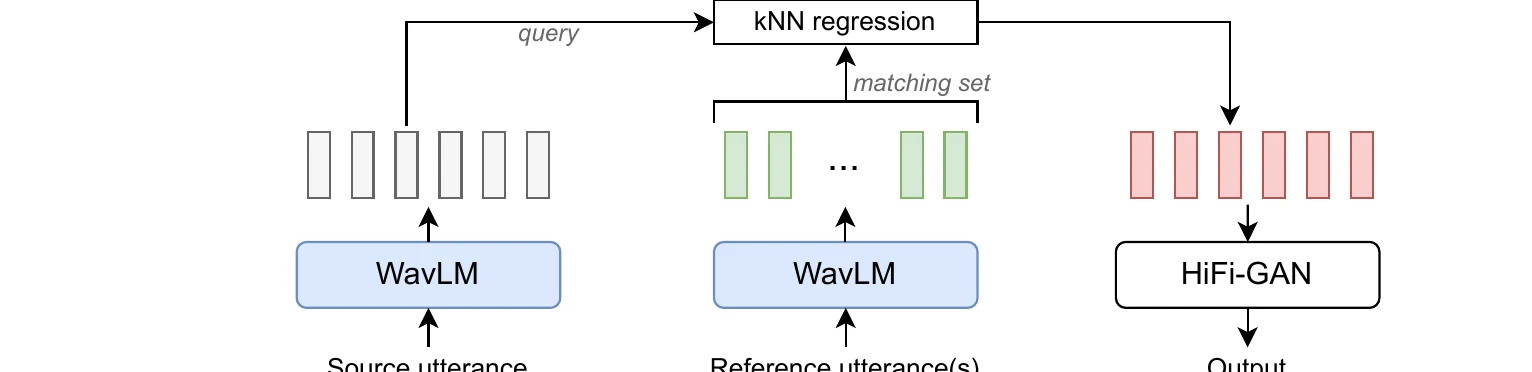
上图是论文的 kNN-VC 总览。源语音(Source utterance)与参考语音(Reference utterance(s))都经过同一个 WavLM 编码器,得到两条逐帧特征序列。源序列称为“查询序列”(query),参考语音的特征被混合成一个大“向量袋”(matching set)。对查询序列的每一帧,在匹配集里找 个最近邻,取平均后得到转换特征,最后用 HiFi-GAN 声码器合成波形(Output)。
流程只有四步:
- 用 WavLM-Large 抽取源语音与参考语音的逐帧特征。
- 把目标说话人所有参考语音的特征帧混成一个袋子,作为近邻匹配集。
- 对源语音的每一帧,用余弦距离找最近邻,取 个近邻特征的平均,作为该帧的新特征:
其中 是源语音第 帧特征, 是目标说话人参考语音的全部特征帧, 返回在 中与 余弦距离最小的 个下标, 是替换后的特征。论文在全部实验中取 、均匀权重、余弦距离。
- 用目标说话人的 HiFi-GAN 声码器把替换后的特征序列合成波形。
为什么这样能成。 这个设计依赖三个事实:(i) 自监督特征在同一音素上跨说话人高度相似,因此“最近邻”匹配的是内容;(ii) 匹配集来自目标说话人,所以内容相同、上下文相同的位置上,取到的就是“目标说话人怎么发这个音”——音色在参考语音这一侧被“拷贝”过来;(iii) 声码器负责把近邻特征还原成波形,它本身不是区分说话人的模块(它的训练只发生在声学层面),所以音色的来源是参考语音的特征帧,而不是声码器。整个系统里没有任何“内容/音色分离”的显式模块,分离反而是自监督编码器“顺手提供”的性质。
一个关键选择:取第 6 层而不是更深的层。 论文初试时用的是靠后的层(第 22、24 层及最后几层平均),它们在音素识别上更好,按直觉应该更适合做内容匹配。但实测下来,靠后的层在基频、能量与说话人的重建上都变差,转换结果听起来更“平”。最终选的是 WavLM-Large 的第 6 层——与说话人识别相关性较高的那一层,它能同时保住音色相似度和源语音的韵律信息。这是一个容易被忽略的反直觉结论:做语音转换时,不是“越抽象的内容越好”,而是要让近邻匹配既能对齐内容、又能携带足够的韵律。第 6 层对 16 kHz 音频每 20 ms 出一帧特征。
预匹配声码器训练(prematching) 解决一个训练/推理不匹配问题。推理时声码器的输入是“近邻替换后的特征”,相邻帧的特征可能来自参考语音里完全不同的时刻、不同的音素上下文,因此上下文不连贯;而训练时声码器看到的是同一段语音的连续特征,上下文是连贯的。直接拿这样一个声码器去合成,转换语音会出现可闻的杂音、清晰度下降。论文的做法是:把声码器训练集里每一句语音的特征也按同样规则做一次“kNN 替换”——这句话每帧的近邻取自同一说话人的其它语音,而不是源语音;训练数据由此被改造成与推理时“长得一样”的形态,声码器于是学会在上下文不连贯的条件下工作。论文报告,预匹配训练在清晰度(WER)与说话人相似度(EER)上都带来非平凡的提升,且与参考语音数量无关。
它的特别之处是零样本与“免训练”:只要拿到目标说话人几秒到几分钟的语音建索引,不需要任何按说话人训练,就能转换到新说话人(编码器与声码器都是别人预训练好的,不针对目标说话人重训)。论文报告的参考语音数据量结论很值得记住:
- 用约 8 分钟的参考语音,与只用 5 分钟时的效果相当——超过某个点后,匹配集已经覆盖了源语音里几乎全部的音素与双音素,继续加数据帮助有限。参考语音更多时(≥10 分钟),增大 (20 左右)可能进一步提升质量。
- 数据量降到 30 秒以下时,清晰度和说话人相似度都会下降;到 5–10 秒,匹配集已经很难覆盖源语音需要的音素,复杂一点的基于参数化的基线反而更稳。
也就是说,kNN-VC 的“零样本”是有成本的:目标说话人参考语音越短,覆盖率越差,而覆盖率正是近邻替换能保住内容的根本。在 8 分钟参考语音、消费级 8 GB 显存的 GPU 上推理速度高于实时。
推理账:建索引对参考语音每帧做一次检索,成本与参考长度相关;逐帧查询是每个查询帧对匹配集的最近邻搜索,朴素实现复杂度约为 ( 为源语音帧数, 为参考帧数),可用 ANN 索引(乘积量化、IVF)压低;特征提取与声码器合成是固定成本。对长语音与长参考语音,索引的构建与存储会成为实际瓶颈,这是它与“参数化映射”(一次前向即可)在工程上的本质区别。
离散 token 路线:语义 token + 目标说话人的声学模型
把前面几条路线推到“大模型时代”,就是现在零样本语音克隆的主流做法:用自监督离散单元或 codec token 表示内容,用目标说话人的声学模型(扩散、流匹配或自回归)生成波形。Seed-TTS(Seed-TTS: A Family of High-Quality Versatile Speech Generation Models,字节跳动于 2024 年发布)是其中结构最清晰的代表。
Seed-TTS 的推理管线有四个模块:语音分词器(把参考语音变成 token)、自回归 Transformer(根据文本 token 与参考语音的声学 token 生成语音 token)、扩散 Transformer(在 token 条件下粗到精地生成连续语音表示)、声学声码器(把扩散输出还原成波形)。它天然支持零样本 in-context learning:把参考语音的 token 与文本 token 一起喂入语言模型,模型“接着”参考语音的风格说新内容。
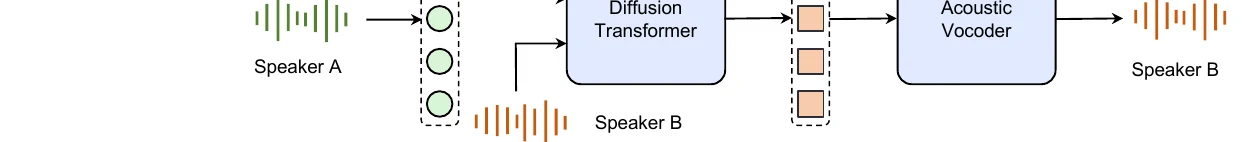
上图是论文给出的 Seed-TTS 零样本语音转换管线。左侧是说话人 A 的源语音,它只经过管线中的扩散模块——因为内容与韵律已经由源语音决定,不需要再经过自回归语言模型;右侧是把说话人 B 作为音色参考注入扩散模块,最终声码器输出“A 说 B 的声音”。
它的关键不在模型本身,而在“怎么让音色只在参考里、不在源 token 里”。Seed-TTS 用了一种自蒸馏式的属性解耦:先让系统把同一句话的“原音色版本” 与“扰动过音色的版本” 合成出来——两者内容、韵律完全一致,只有音色不同;再用这些数据对重训扩散模型。训练时,输入取 的 token,并附上从 提取的音色参考,要求网络重构 的声码器嵌入。由于 与 只有音色不同,网络要还原 就必须忽略 token 里携带的音色,只依赖外部给出的音色参考。于是“音色”被从 token 序列中推开,扩散模块得到了一项真正的音色解耦能力。
这一路线的好处是推理极其统一——转换只是把 TTS 管线的一个模态条件换掉;代价是语义 token 丢掉的内容细节更多,音色完全由声学模型“重新生成”,转换结果可能出现口音、情绪被“标准化”的现象。要在保留内容的同时保住情绪、语速这类非文本信息,就需要在条件里显式加入韵律表示,或者对源语音的特征做更细的保留,这正是各种“解耦”方法的着力点。
几条分离路线的对照
把全文出现过的主要路线放在一张表里,按它们“凭什么知道哪部分是内容、哪部分是音色”归类:
| 方法(年份) | 工作层面 | 内容/音色如何分离 | 音色注入方式 | 数据要求 | 零样本 |
|---|---|---|---|---|---|
| CycleGAN-VC(2017) | 梅尔倒谱 | 循环一致性 + 身份损失 | 目标域的生成器 | 非平行,两说话人 | 否 |
| StarGAN-VC(2018) | 梅尔倒谱 | 星型生成器 + 条件标签 + 分类器 | 目标说话人独热标签 | 非平行,多说话人 | 否 |
| AutoVC(2019) | 梅尔频谱 | 内容编码器低维瓶颈 | 预训练说话人嵌入 | 非平行 | 是 |
| AGAIN-VC(2020) | 梅尔频谱 | 归一化统计量表示音色 + 激活瓶颈 | 目标 、 | 非平行 | 是 |
| FreeVC(2022) | SSL 特征 → 梅尔 | 预训练 SSL 表征 + SR 增强 + 瓶颈 | 说话人嵌入 | 非平行 | 是 |
| kNN-VC(2023) | SSL 连续特征 | 逐帧近邻替换(无显式分离模块) | 匹配集来自目标说话人 | 非平行 | 是(免训练) |
| Seed-TTS 类(2024) | 语义 token + 声学主干 | 自蒸馏属性解耦 | 音色参考的声学条件 | 大规模语音 | 是 |
一条清晰的演进脉络:从“在梅尔频谱上用对抗或瓶颈学映射”转向“在更接近内容的表征上做替换或条件注入”。表征越接近内容,转换越像“使用一个目标音色说话的系统”,工程越简单、越易扩展;代价是丢掉非文本信息的保留能力也随之增加。kNN-VC 更进一步——它连“映射”都不要了,把分离完全寄托在自监督编码器的表示性质上。
推理侧的工程账
语音转换在很多产品里是实时功能(变声、通话克隆、语音助手),推理侧的限制通常落在三处:
- 帧率与延迟。梅尔频谱每 10 ms 一帧;先验/后验编码器和声码器都需要一定数量的上下文帧才能合成稳定。流式转换必须处理“首帧延迟”和“上下文不足”,常见做法是把网络改成因果卷积,或者用 chunk 级声码器。kNN-VC 类的逐帧方法天然无时序依赖(除了声码器),在延迟上更有优势。
- 近邻索引的开销。kNN-VC 的逐帧搜索在参考语音较长时不可忽略,工程上用乘积量化或 IVF 索引加速;短参考语音可以把特征索引常驻显存。
- 声码器决定自然度上限。语音转换的生成阶段只负责“把频谱/特征变成波形”,声码器质量直接决定转换的自然度。HiFi-GAN、BigVGAN 这类高质量声码器是默认选择,本站此前在 从频谱到波形的 GAN 声码器 里对这些生成器的结构做过拆解;若要低延迟,可以选体积更小、生成步数更少的解码器(例如流匹配或扩散的少步版本,本站 扩散模型从零讲起:音频扩散 中讨论过音频潜空间扩散的推理账)。
一个常被忽略的点:语音转换的质量指标不只衡量“像不像目标”,还要衡量“说的对不对”。实践中通常用说话人嵌入的余弦相似度衡量音色、用 ASR 转写后算词错率(WER)衡量内容保真、用主观 MOS 衡量自然度;三者往往相互拉扯——音色越像目标,内容越容易被“标准化”成目标说话人的说话习惯,反过来也一样。
局限与边界
语音转换在基础架构层面还有几个没有彻底解决的问题:
- 跨语种。把中文语音转换成英语说话人的音色,模型需要在保留中文内容的同时套用外语说话人的声道特征,容易产生“带口音”的输出。kNN-VC 的论文展示了德语音频转日语说话人的例子,可懂度尚可,但目标说话人自身的语言习惯也谈不上被保留。
- 非文本信息的取舍。情绪、笑声、咳嗽、叹气这类非语音内容在自监督特征里往往与音色耦合,转换后会变得不像原说话人的情绪表达。这恰恰是哪条路线都无法完全回避的问题:越是把音色从“信号”里剥出来,越是容易把与之共存的非语音线索一起剥掉。
- 安全性。零样本语音克隆把门槛降到了“几秒参考语音”,语音转换因此天然是音视频伪造的技术基础。部署时通常会叠加声纹验证、生成痕迹检测等约束;基础架构本身并不区分合法与非法用途,这一边界不该被架构层面的简化掩盖。
小结
语音转换的核心问题不是“造一个更会说话的模型”,而是在同一个信号里把内容与音色拆开,再只替换后者。CycleGAN-VC 用循环一致性绕开配对数据,StarGAN-VC 把多对多收敛到一个条件生成器,AutoVC 用瓶颈强制分离并首次给出零样本的理论依据,AGAIN-VC 用归一化统计量把音色变成“时间不变的偏移”,FreeVC 借助自监督表征与 SR 增强把分离交给预训练,kNN-VC 更是把转换简化为逐帧近邻替换加目标声码器。往后的零样本克隆系统(Seed-TTS 一类)本质上是在更大规模上继续这套思路,同时尝试把情绪、语速这些被表征丢掉的细节重新找回来。
参考资料
- Parallel-Data-Free Voice Conversion Using Cycle-Consistent Adversarial Networks(CycleGAN-VC)
- StarGAN-VC: Non-parallel many-to-many voice conversion with star generative adversarial networks
- AUTOVC: Zero-Shot Voice Style Transfer with Only Autoencoder Loss
- AGAIN-VC: A One-shot Voice Conversion using Activation Guidance and Adaptive Instance Normalization
- FreeVC: Towards High-Quality Text-Free One-Shot Voice Conversion
- Voice Conversion With Just Nearest Neighbors(kNN-VC)
- Seed-TTS: A Family of High-Quality Versatile Speech Generation Models
- CycleGAN-VC2: Improved CycleGAN-based Non-parallel Voice Conversion
- MaskCycleGAN-VC: Learning Non-parallel Voice Conversion with Filling in Frames
- kNN-VC 项目主页与示例
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



