


扩散模型从零讲起(十):音频扩散——波形、mel 与潜空间,语音生成的推理账
写在前面:这一篇在系列里的位置
扩散模型从零讲起的前九篇,沿着一条从数学到系统的路线推进:第一篇把 DDPM 的两条高斯链、EDM 的噪声视角、DDIM 的确定性轨迹、score matching 与 flow matching,以及 DiT 主干讲成一条线;第二篇把连续扩散搬到离散 token 上,讲透掩码扩散的 ELBO 与块并行解码;第三篇从算法、KV 缓存与调度三层拆解 dLLM 推理系统;第四篇进入潜空间,讲 VAE、条件注入与 MMDiT 双流;第五篇把同样的机制推到视频,处理时空注意力、3D VAE 与少步蒸馏;第六篇专门拆采样器;第七篇讲少步蒸馏;第八篇讲跨步缓存、并行采样与 4-bit 量化;第九篇梳理主干从 U-Net 到 DiT、SiT 与 MMDiT 的结构演进。
到这里,静态图像、视频、文本三个模态的扩散机制都讲过了。剩下一个在生产环境里出现频率极高的模态:音频。语音助手、实时翻译、有声书、音乐生成、游戏配音,背后都有扩散模型或其近亲 flow matching 的身影。音频和图像看起来都是”连续信号”,但把它送进扩散模型时会遇到一批图像里不存在的问题:采样率带来的超长序列、波形与感知质量之间的错位、mel 频谱的相位与对齐问题、实时率(RTF)与流式输出的硬约束。
这一篇按”从零”的方式讲音频扩散:先把声音的物理与信号表示铺清楚,再依次拆波形扩散、mel 扩散、潜空间扩散、flow matching 语音合成,最后落到流式推理与延迟账。下一篇讨论 3D 生成扩散——多视图、稀疏体素与 3D 潜表示如何把扩散推到几何空间。
声音到底是什么:三个可以写进公式的量
在把扩散套到音频上之前,得先明确”被扩散的那个张量”长什么样。声音本身是空气压强的连续变化,驻极体话筒把它转成电压信号,声卡按固定间隔采样,得到一串实数。这串实数有三个维度:采样率、值域、序列长度。
采样率与量化:从 16 kHz 到 24 kHz 的差别
采样率决定了能表示的最高频率,由奈奎斯特(Nyquist)采样定理给出:
其中 是采样率。人耳能听到的上限约 20 kHz,所以”全带宽”音频通常取 44.1 kHz 或 48 kHz。语音通信(电话、语音助手)里说话人基频大致在 80–400 Hz,第一到第三共振峰(formant)集中在 300–3.5 kHz,泛清音的能量拖到 8 kHz 左右。因此语音合成常见两种设置:
- 16 kHz:带宽 8 kHz,覆盖语音清晰度所需的主要信息,波形序列每毫秒 16 个采样点。
- 24 kHz:带宽 12 kHz,能带上更多气声与齿音的高频细节,听感更”近”,是当前主流语音合成模型(如 CosyVoice 系列)的采样率。
采样值本身用定点数或浮点数表示。16-bit 定点把 区间切成 档;模型内部通常直接以 float32 或 float16 处理,训练时归一化到大致 。
序列长度:一个 10 秒音频张量有多少元素
这是音频扩散最疼的地方。一个 10 秒、24 kHz 的单声道波形有
个采样点。对比一下图像:一张 1024×1024 的 RGB 图有 个像素值,但按 DiT 的 patch 划分(),进入注意力的 token 只有 4096 个。而波形扩散如果一步处理全部采样点,一个 10 秒片段就是 24 万个”token”,远超任何 DiT 能承受的注意力长度。
所以音频扩散的第一条设计规律就出现了:必须想办法把序列缩短,或者让模型只在局部作决定。mel 频谱把序列缩短两个数量级;音频编解码器(codec)把序列缩短到约千分之一;波形扩散靠卷积的局部感受野和”全卷积去噪网络”绕过全局注意力。
感知质量与波形误差的不对齐
扩散回归的目标是让预测的噪声尽量接近真实噪声,等价于让生成的 与真实信号在均方误差意义下接近。但音频的感知质量并不与 MSE 对齐:
- 相位:波形里相邻采样点的极性翻转完全改变波形,但人耳几乎听不出相位差异。两个相位不同的波形 MSE 可以很大,听感却一致。
- 高频损失:MSE 倾向于平滑掉能量的尾巴,齿音(、)这类高频主导的片段损失大,却恰恰是清晰度所依赖的。
- 时间对齐:多说话人或长文本里,几毫秒的对齐误差就让 MSE 爆掉,但语音本身听不出差别。
因此实际系统很少直接对波形做扩散+回归终点,而是先转到 mel、或是经过编解码器加对抗训练的潜空间,再用单独的声码器(vocoder)把频谱或潜表示转回波形。这一层”分工”会在后面几节反复出现。
两条表示路线:mel 频谱与神经编解码器
短时傅里叶变换与 mel 刻度
给定一段波形 ,按帧长 、帧移 切窗,乘窗函数后做离散傅里叶变换:
得到复数频谱,帧序号 、频点 。取幅值(或功率)就得到语谱图。典型参数:,,24 kHz 下每帧对应 10.67 ms,每秒约 93.75 帧。
人耳对频率的感知是非线性的:低频分辨率高,高频分辨率低。mel 刻度用一个非线性映射把线性频率 压到 mel 轴上:
在这个刻度上均匀铺三角形滤波器组,再对功率谱做加权求和、取对数,就得到 log-mel 频谱。语音合成里常用的配置是 80 维 mel、帧率 100 Hz(即帧移 10 ms)。Voicebox 明确采用的正是 80 维 log-mel、100 Hz 帧率。
对比序列长度:一个 10 秒片段在波形域是 24 万个采样点,在 100 Hz 帧率、80 维 log-mel 下只有
“帧”这个维度缩短了 240 倍,如果扩散模型把时间维当作序列、每个帧的 80 维当作特征维,那么在注意力里,序列长度只有 1000——这是 DiT 可以轻松驾驭的规模。这就是为什么几乎所有主流扩散 TTS 模型都以 mel 作为扩散空间。
mel 的缺陷也很明确:
- 丢弃相位。只保留幅值意味着从 mel 回不到唯一波形,必须借助声码器(HiFi-GAN、BigVGAN、Vocos 一类)来”猜”相位。
- 感知损失被 log 压缩。取对数后,能量大的片段与能量小的片段在数值上被拉近,回归损失对细节的加权不够细。
- 分辨率受帧移约束。10 ms 一帧,意味着模型输出的”时间分辨率”只到 100 Hz。音节内的短促爆破音可能只有一两帧的信息。
潜空间:VAE 与 RVQ 编解码器
图像领域用 VAE 把像素压到潜空间(第四、九篇已讲),音频领域也是同一逻辑,只是编解码器不同。
波形 VAE(如 Encodec、DAC)在时域上做卷积编码,得到低帧率的连续潜表示,再用解码器重建波形。Encodec 的关键结构是残差向量量化(Residual Vector Quantization,RVQ):把编码器输出按多级叠加量化,每级只编码上一级的残差。
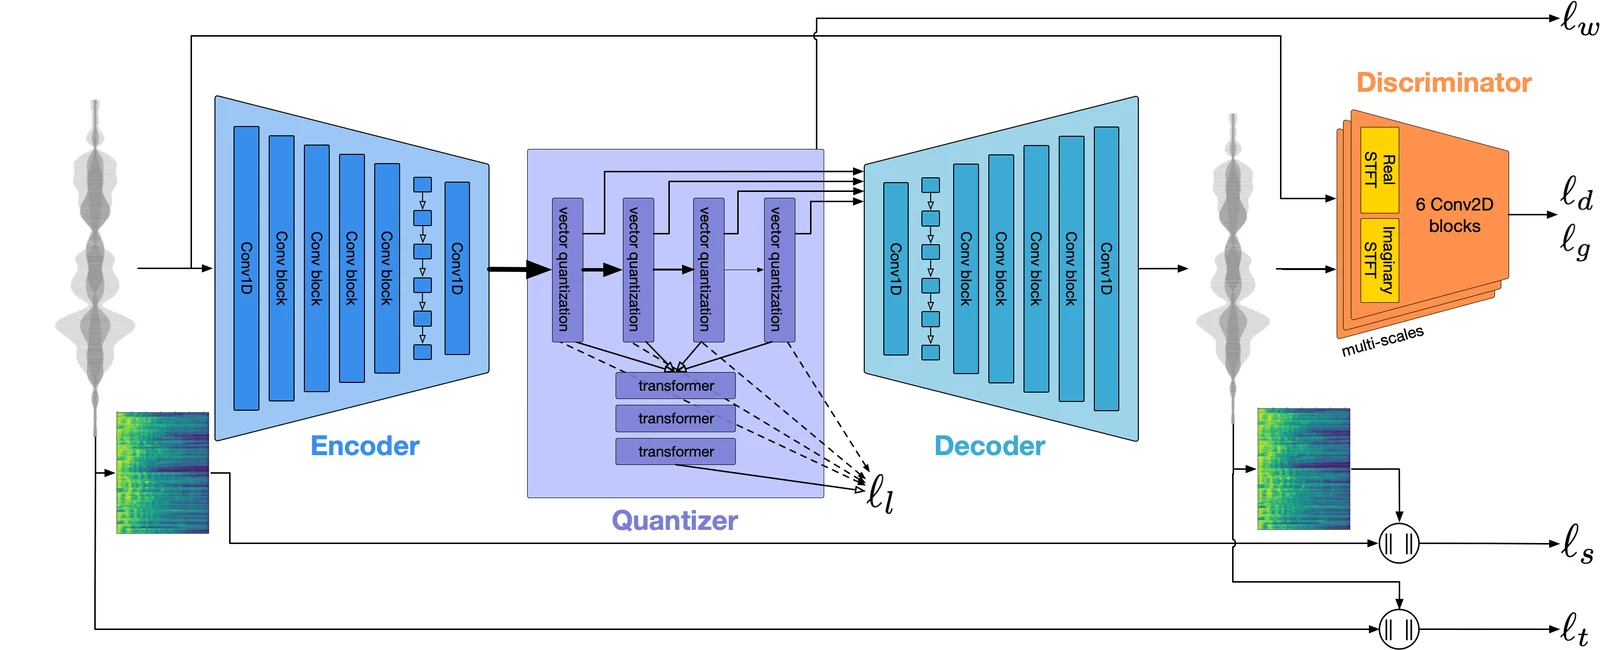
上图出自 EnCodec(Défossez 等,Meta AI,2022),同时画出了 encoder–quantizer–decoder 主干与训练用的多尺度 STFT 判别器。重点看量化器那一段:编码器输出 后并非一步量化,而是第一层量化器给出粗略的码本索引,残差再交给下一层,依次堆叠。推理时可以只保留前 级,序列长度与音频质量之间就有了一个连续可调旋钮。
设编码器输出帧率 (Encodec 在 24 kHz 下为 75 Hz),每帧经 级量化、每级提供 比特( 为码本大小),总比特率为
以 、、 计, bit/s。一个 10 秒音频对应的潜帧数是 750,每帧 8 维码本索引——相对 mel 的 1000 帧、80 维连续值,序列长度相近,但每一维变成离散符号。
连续潜表示同理,只是量化器换成直接输出实数或标量逐维量化。Stable Audio 用卷积自编码器把 44.1 kHz 立体声波形压缩到低帧率潜表示再扩散;CosyVoice 系统的 speech tokenizer 以 ASR 编码器的中间表示为基础,用 FSQ(Finite Scalar Quantization,有限标量量化)逐维取整,得到 25 Hz 的离散语音 token。二者的分工在第六层(流式)里看得最清楚。
三条路线的成本对比
把三种”被扩散的对象”放在一起:
| 表示 | 帧率 | 特征维 | 10 秒序列长 | 是否需声码器 | 典型模型 |
|---|---|---|---|---|---|
| 原始波形(24 kHz) | 24000 Hz | 1 | 240 000 | 否 | DiffWave、WaveGrad |
| log-mel(80 维) | 100 Hz | 80 | 1 000 | 是 | Grad-TTS、NaturalSpeech 2、Voicebox |
| 神经 codec 潜表示 | 25–75 Hz | 8–512 | 250–750 | 视设计而定 | Stable Audio、CosyVoice2 |
差异不是数量级上的细节,而是决定了网络结构和推理延迟的根本形态:波形扩散必须做成”全卷积、局部感受野”的结构;mel 扩散可以做 transformer;潜空间扩散则要把编解码器与扩散主干各自的时间账分开算。
第一层:波形扩散——DiffWave 与 WaveGrad 怎么绕开 24 万 token
问题:波形域扩散的序列灾难
直接在波形上跑扩散是最自然的想法: 就是 10 秒的 24 万个采样点,前向加噪、反向去噪,与 DDPM 完全一致。问题只有一个:注意力不可用。
DiT 的注意力是 的,序列长度到 1000 就已经开始显著吃算力,24 万完全不可行。卷积的复杂度与序列线性相关,但感受野需要覆盖整个片段才能保证局部波形的全局一致性(例如音节间的节奏、句子末尾的降调)。这就逼出了波形扩散的结构选择:用膨胀卷积(dilated convolution)堆叠出等价于长序列的 receptive field,网络不含有任何时间维上的注意力。
DiffWave 的结构
DiffWave 由 Zhifeng Kong 等人在 2020 年提出,核心网络是双向膨胀卷积残差块(bidirectional dilated convolution),结构与 WaveNet 同源。
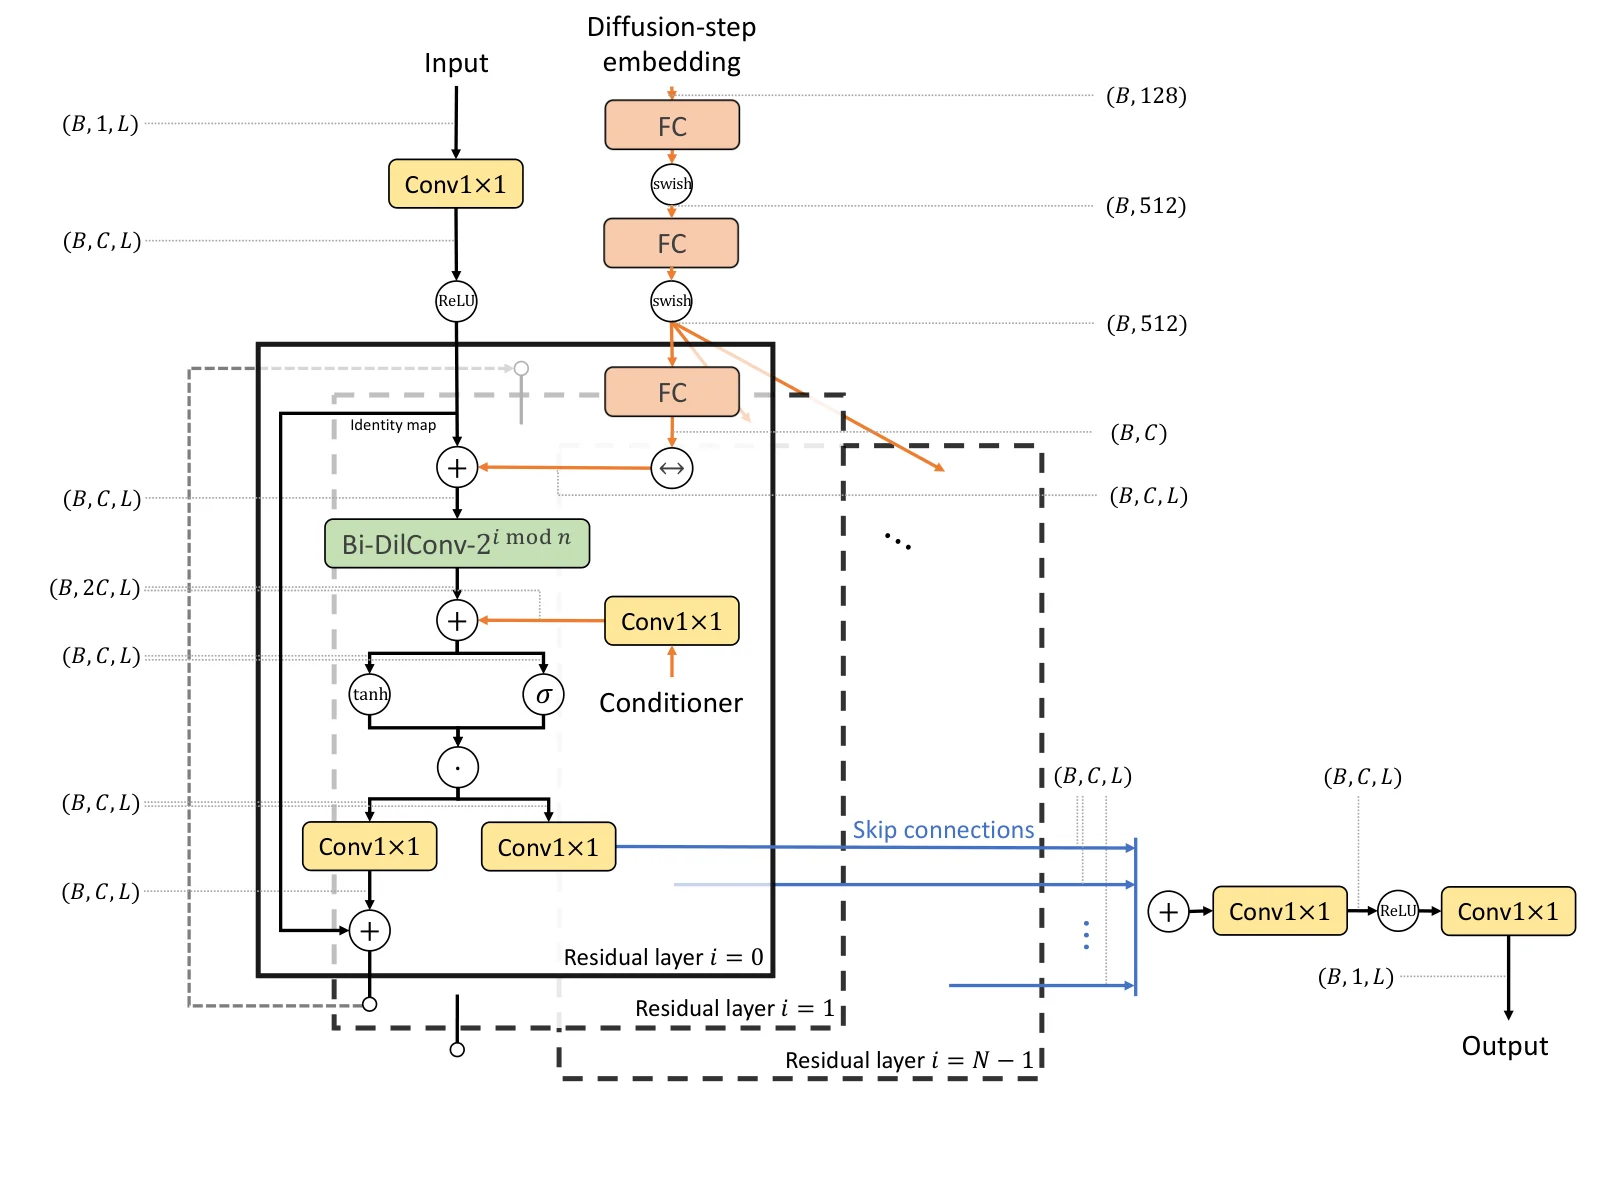
上图是论文的详细架构图。从左上角开始看:
- 扩散步输入 被送入一个小型 embedding,得到 的向量,再经两层全连接投影成 的偏置向量。这一步的作用是把”当前噪声水平”注入每一个残差层。
- 条件输入(spectrogram 或其它语谱特征)经过一个 conditioner 网络,下采样到与波形相同的帧率,输出 的张量。它被拆成缩放 与偏置 两部分,对残差层之间传递的 做仿射调制。这是语音领域常见 FiLM 式条件注入。
- N 个残差层:每一层是门控激活单元(gated activation)加膨胀卷积,膨胀率按 循环递增。以层数 、通道数 64 计,最大膨胀率可达 ,单条路径的感受野即有数万个采样点,足以看到 1 秒以上的上下文。
- 跳跃连接:每一层输出按通道相加,最后经输出投影得到与波形同形状的噪声预测 。
从计算账上看,单层残差约做三次卷积(膨胀卷积、两路 投影),复杂度 与序列长度线性相关。以 、残差通道 、门控卷积 128 通道计,单个残差层约 次乘加,30 层合计每步约 次乘加。这比同等参数量的 transformer 单步便宜,但要乘以步数(推理 6 步,训练 200 步)。
论文报告的小模型只有 2.64M 参数,在 22.05 kHz 上合成语音的 MOS 为 4.37,吞吐比实时快 5 倍以上(V100 GPU,无定制 kernel);完整模型与 WaveNet 声码器 MOS(4.44 vs 4.43)相当。
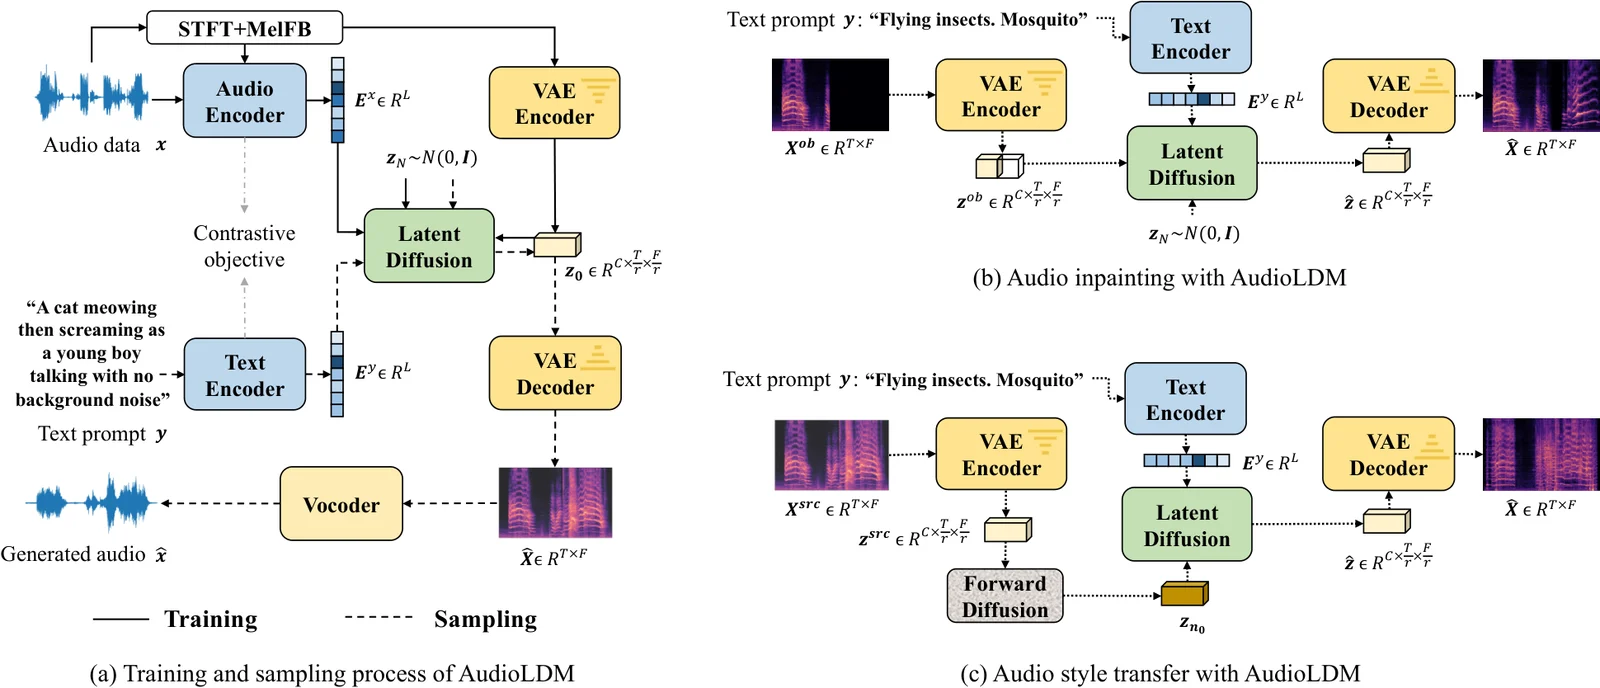
上面这张图来自 AudioLDM(Liu 等,Surrey 与 Imperial,2023),它是”文本到音频”方向里把潜空间扩散从图像搬到声音的代表。图 (a) 是训练与采样:文本提示 经 CLAP 文本编码器得到嵌入,音频 经 mel 编码后得到潜表示 ,扩散在 上运行,噪声 反向去噪得到 ,再经解码器还原为 mel 并交给声码器。图 (b) 演示基于掩码的音频修补(inpainting),图 (c) 是音频风格迁移。它说明了一件事:潜空间扩散让文本、音频、控制信号在同一维度上对齐,这是波形扩散做不到的——波形域里没有任何位置能自然承载”文本语义”。
条件注入与”步数-质量”权衡
DiffWave 的快速采样策略是一个值得拆解的工程点。论文的观察是:训练时使用 步的细粒度噪声日程,但采样时”最有效的去噪步发生在 接近 0 的位置”。于是它把采样步数压缩到 (如 6 步),并对噪声日程做重映射——原前向链的 被重新分配,使得采样步的”步长”在 大的一端迈得更大。这本质上就是少步采样的雏形:不对网络做蒸馏,而是重新分配噪声日程。关于日程重参数化与高阶求解器的取舍,可参考 扩散模型从零讲起(六):采样器完全拆解。
WaveGrad(Chen 等,Google,2020)在思路上与 DiffWave 平行:用基于 score matching 的离散时间扩散,条件输入为 mel 频谱,通过迭代细化从高斯白噪声生成波形;它也强调”6 次迭代即可生成高保真音频”,并且把推理步数视作速度与质量之间的显式旋钮。二者的共同结论很适合作为这一层的收束:波形扩散的可行性建立在不使用注意力、并且步数可以压缩到个位数的前提下。
波形扩散的推理账与局限
波形扩散的推理延迟由三部分决定:
- 每步成本:与 线性、与网络宽度平方相关,因此 10 秒音频的成本是 1 秒的 10 倍。
- 步数:6 步起步,质量不够时加步。
- 输出长度与步数不能完全解耦:长音频要么一次性生成(显存与延迟随长度线性增长),要么切块生成并处理块间连续性。
局限也很明显:波形域里很难直接注入文本级别的全局条件;同一段文本的两次采样在波形细节上差异极大,难以做精细的编辑;以及高频重建质量受限于网络容量。这正是 mel 扩散登场的原因。
第二层:mel 扩散——Grad-TTS 的 SDE 视角与 NaturalSpeech 2
mel 扩散解决的核心问题
把扩散空间从波形换成 80 维 log-mel,序列长度从 24 万降到 1000,模型就可以使用 transformer 或轻量卷积,文本条件也有了自然的位置来挂(文本 token 序列 → 对齐到帧)。代价是:必须再配一个声码器来从 mel 重建波形,而且要处理 mel 的”对齐”问题——不同文本可以以不同速度、不同停顿读出同样的句子,扩散模型需要知道”哪一帧对应哪个音素”。
Grad-TTS:SDE 框架与单调对齐搜索
Grad-TTS(Popov 等,Yandex,2021)是最早把连续时间 SDE 扩散用于 TTS 的代表之一。它由三部分构成:
- 文本编码器:字符序列经卷积 + transformer + 注意力,得到帧级表示 。这里”帧级”意味着文本先被展开成与目标 mel 长度一致的上采样序列。
- 对齐:用单调对齐搜索(Monotonic Alignment Search,MAS)在训练中求一个与文本等长的单调映射 ,决定每帧 mel 来自文本的哪个位置。训练结束后,推理时使用预测的时长(duration predictor)展开文本。
- score-based 解码器:在帧级条件 、对齐 与说话人嵌入的联合条件下,从噪声出发跑逆 SDE 得到 mel。
Grad-TTS 的一个重要贡献是把离散 DDPM 写成连续时间 SDE:
其中 是文本条件展开后的”目标中心”,相当于给前向过程加了一个向文本条件收缩的漂移项。这样一来,前向过程不是简单地冲向纯噪声,而是冲向”以 为中心的高斯分布”,反向过程自然就带有条件信息。这一改写与条件扩散的通用思想一致,只是把条件放在了漂移项里。
MAS 为什么需要单调性:语音阅读是顺序的,一个音素对应一段连续帧,不能跳跃。MAS 因此要求在帧轴上单调前进,可看作一个动态规划问题:
是”第 个音素映射到第 帧”的最优累计分数, 为总帧数。动态规划的状态空间是 ,对每个 batch 都要重算一遍——这是训练成本的一部分,推理时用不上。
NaturalSpeech 2:用 RVQ 潜向量替换离散 token
NaturalSpeech 2(Tan 等,Microsoft,2023)把扩散空间又推了一层:不再对 mel 扩散,而是用神经网络 codec 加残差向量量化(RVQ)得到量化潜向量,在潜向量空间上做扩散。论文给出的结构有三块:
- speech codec:把语音压成 RVQ 潜向量,同时可解码回波形。
- duration / pitch predictor:分别预测时长与音高的连续值,为扩散提供细粒度条件。
- diffusion model:以文本、时长、音高的嵌入为条件,在潜向量空间上从噪声生成潜向量。
在这之上加了一个关键组件:speech prompting。把参考语音的潜向量作为”上下文”拼接进扩散条件,模型由此学会零样本模仿参考音色、节奏和风格。这与 Voicebox 的 infilling 思路在系统结构上相似(见下文),区别是 NaturalSpeech 2 的上下文并非”被掩码的声谱片段”,而是独立的提示。
论文在 44K 小时语音与歌唱数据上训练,评测显示其对未见说话人的质量优于当时基于离散 token 的 TTS 系统。从推理视角看,NaturalSpeech 2 的成本结构变成三段:
其中 是时长/音高预测网络, 是扩散采样步数。因为潜向量的帧率(约 25 Hz 量级)远低于波形,扩散主干的单步成本显著低于波形扩散,但固定开销里多了 codec 解码。
对齐、时长与”谁决定何时说”
Grad-TTS 与 NaturalSpeech 2 在推理时都把”时长”交给独立的预测器,而不是让扩散模型自己决定。这是一个被反复验证的设计决策,原因是:时长是离散的、几乎不可导的决策,而扩散模型擅长连续量。把”说多久”抽出来交给一个分类/回归网络,扩散主干就可以在给定长度的序列上做纯粹的声学建模。Voicebox 的文本引导 infilling 是另一种思路:参考音频 + 掩码位置 + 文本转录共同定义”要生成哪一段”,模型不需要显式预测时长,因为掩码长度就是长度。
第三层:条件生成与零样本音色——Voicebox 的文本引导 infilling
问题:如何在不重新训练的前提下模仿任意说话人
传统 TTS 模型需要为每个说话人训练或微调。零样本 TTS 要解决的问题是:给一段 3 秒参考音频和一段新文本,直接生成参考音色的朗读。扩散模型在这件事上的优势是:它是一个条件生成器,条件可以是任意长的”示例”。
Voicebox 的公式化
Voicebox(Le 等,Meta,2023)把语音生成重新表述为一个文本引导的语音 infilling问题:
其中 是上下文音频(参考语音或其前后片段), 是被掩码的语音片段, 是整句的文本转录。推理时,把整句音谱中除目标片段外的部分全部置为掩码(相当于”已知”目标片段以外的位置),模型就从噪声生成了目标片段:
- 零样本 TTS: = 参考音频 + 空白目标区域, = 目标语音。
- 语音编辑: = 原始音频中不需要修改的部分, = 要重写的片段。
- 跨语言、去噪、风格转换:把对应部分掩码即可。
训练损失就是 flow matching 的目标:用最优传输(OT)路径把噪声 与真实语音 线性插值:
模型以 为输入预测速度场 ,损失为 。这与 扩散模型从零讲起(一):从 DDPM 到 DiT 与 Flow Matching 里的 flow matching 推导完全一致,区别只在于条件包含长上下文音频。
网络方面,Voicebox 的音频模型有 24 层、16 个注意力头、1024 隐藏维与 4096 FFN,总参数约 330M;输入是 80 维 log-mel、100 Hz 帧率。为让不同采样变体能共享注意力表示,它在对称层之间加了 U-Net 式跳跃连接。
infilling 为什么能同时学声学与语言
论文的核心观察是:文本引导 infilling 让模型同时在声学层(音色、音高、语音连续性)与语言层(文本与音频的对应)上训练,而这一点是单纯用纯文本做条件的模型难以获得的。文本转录与上下文音频作为双重条件,逼模型学会”在不看目标语音的情况下推断内容与风格”——这正是 zero-shot 所需的泛化。
从推理工程角度看,Voicebox 把”音色模仿”从参数层挪到了条件层:音色不再是模型权重的一部分,而是输入的一部分。这意味着一个模型可以服务任意说话人,部署时不需要为每个说话人维护一套权重;代价是长参考音频会进入注意力序列。
条件长度带来的推理成本
参考音频越长,注意力序列越长。以 3 秒参考、10 秒目标计,总帧数约 1300,与图像 DiT 的量级相当。成本集中在:
- 参考音频一侧的 K/V 在整段采样中不变,可以像文本编码器那样缓存(第八篇的跨步缓存思路在这里同样适用:缓存的不是注意力残差,而是条件音频的 K/V)。
- 掩码区域与生成区域在每一步都是全序列注意力,没有增量解码,所以不能套用自回归 LLM 的 KV 增量。
- 因此 Voicebox 类模型的推理延迟大致与 相关,长音频零样本合成的开销会显著上升。
第四层:编解码器潜空间——Stable Audio 与 AudioLDM
从 mel 到潜向量的动机
mel 扩散的 1000 帧对 DiT 已经不算长,但高采样率(44.1 kHz)与更长片段会把这个数推上去:44.1 kHz 的 30 秒音乐片段在 86.1 Hz 帧率(Hop 512)下有约 2580 帧,每帧 128 维 mel。再加上音乐对宽频与立体声的要求,mel 空间本身的建模容量也在被推高。
解决办法与图像完全一致:用一个自编码器先压缩。AudioLDM 用 mel 编码器 + VAE 把 mel 压成更短的潜序列,扩散在潜序列上运行;Stable Audio 用时域卷积自编码器把波形压缩成低帧率潜表示,扩散在潜空间运行。AudioLDM 的图(上面的 audioldm-arch)已经展示了训练与采样的完整路径。
CLAP:跨模态文本-音频对齐
AudioLDM 的独特之处是条件的来源:它不是用 T5 之类的纯文本编码器,而是用 CLAP(Contrastive Language-Audio Pretraining)的文本编码器。CLAP 在训练时用对比学习让”文本描述”与”音频片段”在同一个嵌入空间里靠近。用它做条件有几个直接影响:
- 文本编码器与音频空间已经对齐,扩散模型可以专注于”从嵌入生成音频”。
- 可以支持负提示、风格描述等图像文生图里熟悉的操作。
- 代价是 CLAP 编码器的表示能力受限于其训练数据,对细粒度文本(如逐字的朗读内容)不如专门的 TTS 文本编码器。
潜空间扩散的成本分解
潜空间扩散的成本可以拆成三个独立部分,用一个统一式子表达:
其中 在音乐生成里往往是最容易被忽略的部分:把潜序列解码回 44.1 kHz 立体声波形,卷积解码器在长片段上的 FLOPs 与延迟并不小。第九篇里对 VAE 解码是峰值显存的讨论在音频上同样成立——尤其是长音乐片段。
为什么音频潜空间扩散比图像更依赖”解码器质量”
图像的 VAE 解码失败通常是局部伪影;音频的解码失败会变成咔哒声、金属音、相位失真,听觉上极其刺耳。因此音频潜空间扩散必须配一个在训练中已被充分对齐的解码器,且往往加入对抗损失(多尺度 STFT 判别器)来强化高频。这一点在 EnCodec 的设计里可以直接看到:右侧的多尺度判别器正是为这个目的而存在。
第五层:Flow Matching 与 DiT——F5-TTS 的”去对齐”配方
E2 TTS 与 F5-TTS 的共同出发点:不要对齐
Grad-TTS 用 MAS 做对齐,NaturalSpeech 2 用时长预测器,Voicebox 用掩码。E2 TTS(Eskimez 等,Microsoft,2024)提出了一条更激进的路线:完全不做文本-语音对齐。做法是把文本编码后拉长、用填充符(filler token)补齐,使其长度与被掩码的语音序列相同,再直接做基于 flow matching 的 infilling。模型输入同时包含:
- 字符序列 ,以及其转录 与参考音频 组成的提示;
- 被掩码的目标语音区域(用填充符占位);
- 目标时长(可以来自参考音频,或按字速估算)。
因为不做对齐,模型也就没有音素对齐这一步错误,文本表示只需”够用来模仿”。代价是收敛慢、鲁棒性差——E2 TTS 的原始设计在训练早期难以稳定学习。
F5-TTS 的两个修补
F5-TTS(Chen 等,上海交通大学 X-LANCE 实验室,2024)在 E2 TTS 的基础上做了两处关键修改,正好可以作为”从零”路线上的一个技术闭环:
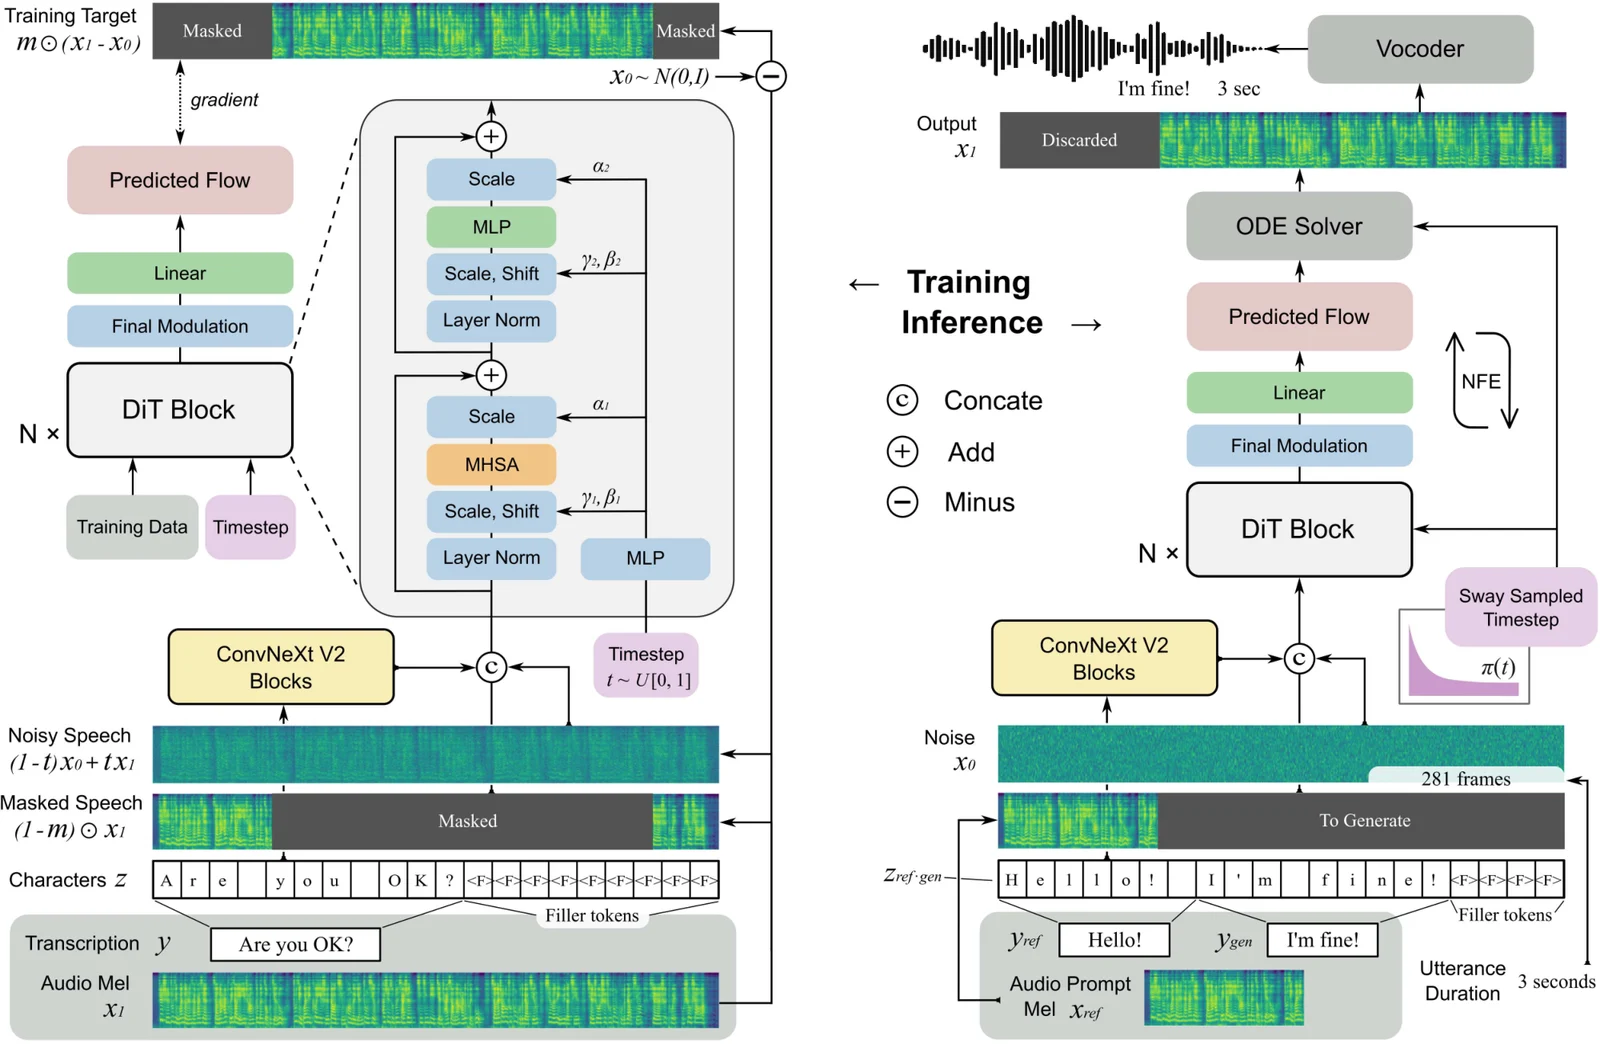
上图是论文的总览。左侧训练流程:目标语音(被掩码部分)与参考语音、转写共同构成提示,被掩码语音 与噪声 按 插值;文本字符序列经过 ConvNeXt 模块精炼后与填充符一起拼接;DiT block 堆叠,配合调制(scale, shift)注入时间步;最终输出预测速度场。右侧推理流程:从文本出发,用 ODE 求解器按 Sway 采样得到噪声日程,迭代得到语音,最后经声码器还原。
修改一:ConvNeXt 精炼文本表示。 字符嵌入序列与语音帧并非等长,直接 pad 会导致文本侧信息过于稀疏、难以与音频对齐。ConvNeXt 模块在短序列上做卷积处理,把字符级表示整理成”可以粗对齐”的帧级特征,同时不引入显式对齐模块。
修改二:推理时的 Sway Sampling。 这是 F5-TTS 最实用的贡献。flow matching 的标准采样是沿 均匀取点,但语音的能量集中区、音素切换点并不均匀分布。Sway Sampling 对时间步做一次非线性重映射:
其中 是均匀采样的时间步, 是系数,函数在 内保持单调。 退化为均匀采样; 取负值时映射把采样点整体”向左”推,即 小的一端(纯噪声侧)采样更密;论文默认使用 。之所以是这个方向,是因为 flow matching 模型在早期步主要勾勒语音的整体轮廓与文本对齐,后期步才补充细粒度细节——把有限的 NFE 花在早期更划算。论文的图 3 给出了该映射的概率密度函数,以及在 small 模型上的对应效果。
关键点在于:这是一个纯推理期的改变,不需要重新训练,因此可以叠加到任何基于 flow matching 的 TTS 模型上。论文报告的 RTF 以 10 秒语音在 RTX 3090 上测量。表 6 中 时的原始数据是:16 NFE 用 Euler 求解器时 RTF 为 0.15、WER 2.53;同样 16 NFE 换 midpoint 求解器,RTF 升到 0.26、WER 降到 2.43;32 NFE 用 Euler 时 RTF 为 0.31、WER 2.42。这三个数据点把 “步数—求解器阶数—延迟” 的三角关系写得很清楚:二阶求解器每步两次求值,NFE 相同的情况下延迟翻倍,但精度更高。
从 RTF 看 F5-TTS 的延迟结构
RTF 的定义是:
为生成耗时, 为音频时长。RTF 小于 1 才能实时;实时对话场景通常要求 RTF 远低于语音播放进度,同时首包延迟(first packet latency)也要小,才能让用户感觉”立刻开口”。
F5-TTS 的 RTF 0.15(16 NFE)意味着每秒钟语音需要约 24 次 DiT 前向。把序列放大 10 倍的处理成本不是线性的:注意力项与 相关,因此在 30 秒的长朗读上 RTF 会显著上升。实际部署中,长音频要么切块、要么用更少步数,两条路与第八篇的缓存与蒸馏直接衔接。
为什么”无对齐”路线在推理侧更有吸引力
从系统视角看,去掉对齐模块有两个直接好处:
- 推理管线更短:没有 MAS 的动态规划、没有独立的时长预测器失败分支,整条路径只剩”文本 → DiT 采样 → 声码器”。
- 条件统一:参考语音、文本、掩码区域都只是序列,可以共享同一套注意力结构,便于批处理后端不同长度请求。
代价是:文本与音频的对齐质量完全由模型隐式学习,对多语言、数字、缩写等复杂文本的鲁棒性依赖训练数据;而显式对齐的模型在发音准确率上更容易调试。两者在生产里其实都在用,选择取决于是否更看重管线简洁还是发音可控。
第六层:流式与分块——CosyVoice 2 的 chunk-aware flow matching
为什么流式对音频扩散是硬需求
对图像扩散,“一次性生成一张图”是默认形态;对语音,交互场景(语音助手、实时翻译、同声传译、数字人)要求边生成边播放。这意味着延迟被拆成两个不同的指标:
- 首包延迟(time to first packet):从请求到达、到第一段音频可以播出的时间。
- RTF / 持续吞吐:在首批音频播出后,后续片段必须以不低于实时的速度持续产出,否则播放会卡断。
一个非流式的语音扩散模型,即使 RTF 只有 0.1,首包延迟依然等于整段音频的生成时间——10 秒语音就要等 1.5 秒,30 秒要等 4.5 秒,这对对话应用不可接受。因此语音方向最终演化出了两类方案:分块自回归 + 流式扩散,以及整段并行 + 播放器缓冲。
两段式结构:LLM 生成语义 token,flow matching 生成声学
CosyVoice 2(Du 等,阿里巴巴,2024)的结构是理解流式扩散 TTS 的最佳样本,因为它在同一个模型里同时支持流式与非流式。
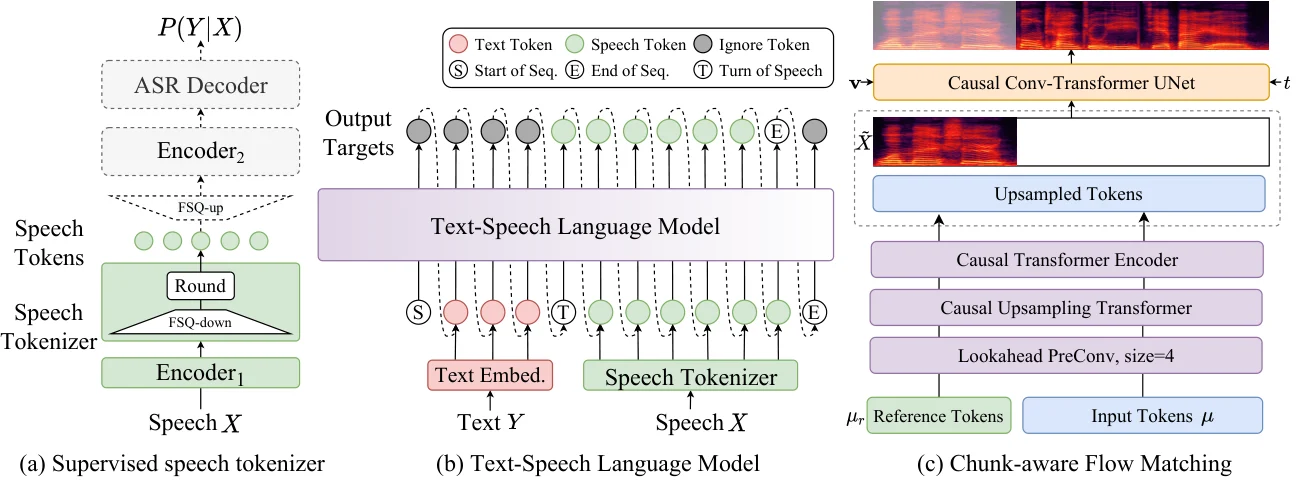
上图分三块:
- (a) 监督式语义 tokenizer:把语音送进 SenseVoice-Large ASR 模型的编码器,中间插入 FSQ 量化模块,得到 25 Hz 的语音 token(每秒 25 个)。与 VQ(向量量化)相比,FSQ 把每一维独立量化到有限档位,码本利用率更高,不需要维护大码本。
- (b) 统一文本-语音语言模型:直接用预训练的 Qwen2.5-0.5B 作为主干,以文本为提示,自回归生成语音 token。它负责”说什么、怎么说”的语义与韵律骨架。
- (c) chunk-aware flow matching:把语音 token 加上参考语音特征,用因果 Conv-Transformer U-Net 做 flow matching,在 上迭代,得到 25 Hz 的 mel 特征。关键设计是分块掩码:把长序列切成块,每一块在扩散时只能看到”已确定的前文与块内加一个前瞻窗口”,块与块之间的因果结构由掩码强制。
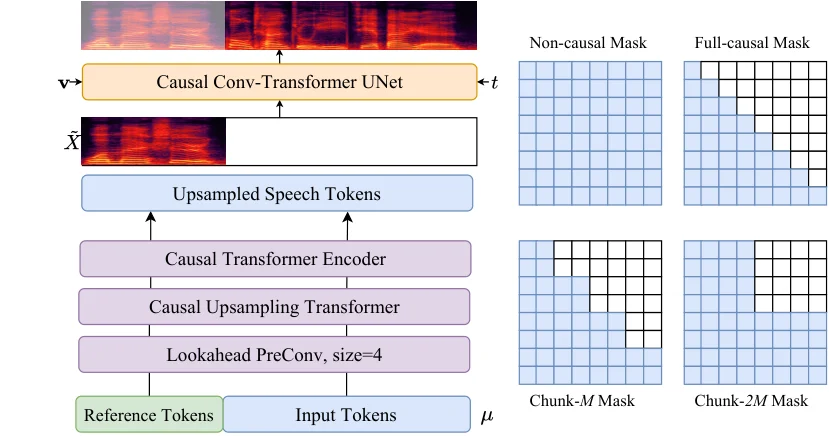
这张细节图把 (c) 展开了:底部是参考语音 token 与输入 token,经过前瞻预卷积(lookahead pre-conv,窗口 4)后进入因果 Transformer 编码器,再经因果上采样 Transformer 把 25 Hz 的 token 特征上采样到 mel 帧率,最后用因果 Conv-Transformer U-Net 在掩码约束下做流匹配。中间的 Chunk-2M mask 表示块级因果约束:生成当前块时,已确定的前文块可见,块内保留一段有限前瞻,块边界之后的 token 全部不可见。前瞻窗口的作用是让块内声学特征不至于在边界处”看不到下一段”,从而减少拼接痕迹。
chunk-aware 为什么能”流式但不掉质量”
chunk-aware flow matching 的核心矛盾与 dLLM 的块并行(掩码离散扩散 与 dLLM 推理系统 两篇)几乎一模一样:既要块内并行以缩短延迟,又要跨块一致以保证音色与韵律连续。CosyVoice 2 用三个手段处理:
- 因果掩码 + 前瞻窗口:块内生成时,注意力只能看已确定块与块内前瞻区,这让训练分布与推理时的分块节奏一致(训练时就按块打掩码),因此流式与离线模式下得到同样的质量——论文用”virtually lossless”形容流式模式相对离线模式的差距。
- 参考语音作为固定前缀:参考 token 与参考 mel 在每一块里都作为条件存在,保证音色跨块一致;它们在整段合成中不变,可以被缓存,是流式推理里最值得复用的一块。
- 统一的双模式推理:非流式时把整段当作一个大块(或去掉块掩码的前半段),流式时按块推进。同一套权重,部署时只需切换掩码形状。
流式扩散 TTS 的延迟账
把 CosyVoice 2 的流式过程按时间轴展开,首包延迟可写成:
之后每个新块的稳态周期为:
其中 为 token 率, 为每块 token 数, 为 flow matching 的 Euler 步数。稳态可用性的条件是这个周期必须小于该块对应的音频时长(否则播放会等待)。注意这里扩散部分的成本只与块内序列长度相关,而不是整句长度——这正是流式的全部意义:把 的扩散拆成 的重复。
流式扩散里最容易被忽略的三件事
- 块间边界音:每个块单独做声码器会引入不连续,必须在块间保留重叠并做交叉淡入,否则会听到周期性咔哒。
- 块内步数与块大小的配比:更小的块让首包更快,但每块都要跑 次前向,固定开销比例上升。存在一个最优点,通常块长与模型规模共同决定。
- 调度粒度:语音服务的请求边界不是 token 而是块,batch 必须在”同一块”上聚合才能做 batch 推理;长请求与短请求的混批会拉长首包延迟,与 dLLM 服务里的块粒度调度是同一类问题。
第七层:声码器——扩散之外但无法回避的一段
为什么每个音频扩散系统都要谈声码器
除了纯波形扩散,所有以 mel 或低帧率潜表示为终点的系统,都必须把中间表示还原成波形。这一步不是扩散模型,但它占了推理延迟和感知质量的很大一块,因此不能当作黑盒跳过。
mel → 波形的本质是一个病态逆问题:mel 只给出了 个幅度约束,而目标波形有 240 000 个采样点,且相位完全未知。求解方式决定了声码器的形态:
- 基于迭代的相位重建(Griffin-Lim):用 STFT 幅值反复迭代估计相位,质量有限、速度慢,但不需要训练。现代系统基本不再用它做最终输出。
- 自回归声码器(WaveNet):逐采样点生成,质量高但速度极慢,已被取代。
- GAN 声码器(HiFi-GAN、BigVGAN、Vocos):一次前向生成整段波形,速度与质量平衡最好,是当前主流。
- 扩散声码器(DiffWave、WaveGrad 当作 vocoder):天然与扩散 TTS 主干同族,但多一次采样循环,延迟更高。
HiFi-GAN 的结构与为什么它快
HiFi-GAN(Jungil Kong 等,2020)的核心是生成器 + 多周期判别器(MPD)+ 多尺度判别器(MSD)。生成器把 mel 上采样到波形长度,上采样由转置卷积完成,每一层后接多感受野融合(Multi-Receptive Field Fusion,MRF)模块——并行堆叠不同卷积核与膨胀率的残差块,再把结果相加。转置卷积的每一步将序列长度乘以下采样率的倒数,因此总上采样倍数等于 (例如 24 kHz / 100 Hz = 240 倍)。这种”一次性并行上采样”是它比自回归声码器快几个数量级的根本原因。
多周期判别器在波形的不同周期(2、3、5、7、11 等)上折叠后做判别,专门抓周期性伪影;多尺度判别器在原始波形与不同下采样率上判别,抓不同频段的纹理。两者共同逼生成器同时照顾低频周期与高频细节。
BigVGAN 与 Vocos:两条不同的改进路线
BigVGAN(Lee 等,NVIDIA,2022)解决的是”通用声码器”问题:一个模型要覆盖未见说话人、未见语言、音乐、环境声。它的关键改动是周期激活函数 Snake:
并对上采样后的激活做抗混叠处理。Snake 在周期信号上比 ReLU 更符合波形的周期性,抗混叠则避免转置卷积在上采样时把高频镜像折叠回可听频段。BigVGAN 还有规模化的版本,把参数量推大并扩大训练数据,质量随规模提升。
Vocos(Siuzdak,2023)走的是另一条路:不做时域上采样卷积,而是用 ConvNeXt 主干直接预测 STFT 的复数谱,再用逆短时傅里叶变换(ISTFT)一次性合成波形。这样做的优点是:
- 网络在低帧率(mel 帧率)上工作,计算量与时域上采样解耦;
- 相位与幅度同时预测,ISTFT 保证重建的频域一致性;
- 生成速度极快,适合作为大批量 TTS 的默认声码器。
代价是:ISTFT 的窗长与帧移固定,长序列的边界处理需要小心;对极高频细节(如 44.1 kHz 的齿音)不如时域 BigVGAN 细腻。
声码器在整体延迟中的位置
把声码器放回 TTS 管线,延迟结构变成:
通常比扩散主干小一个量级,但在流式场景会被切成许多小块,每块都要单独跑一次声码器,固定开销与块边界处理会显著放大它。这解释了为什么 CosyVoice 2 这类系统把声码器也做成因果、可分块的结构,而不是简单套一个离线 HiFi-GAN。
一个常被忽略的耦合:声码器与扩散空间的匹配
声码器是在某个 mel 配置下训练的(80 维、100 Hz、特定窗函数与归一化),扩散模型输出的 mel 必须与这个配置严格一致。工程上最常见的错误有三种:
- mel 归一化不一致:训练声码器时用 log-mel 的均值方差归一化,推理时忘了反归一化,输出会变成嗡嗡声。
- 帧移不一致:扩散模型按 10 ms 帧移生成,声码器按 12.5 ms 训练,音高会整体偏移。
- 频率范围不一致:16 kHz 声码器接 24 kHz 的 mel,最高频段直接缺失,听感发闷。
这类错误不属于扩散理论的范畴,但在真实部署中出现的频率远高于采样器选型错误。
第八层:推理成本与工程——从 RTF 到批处理
一条统一的音频扩散延迟公式
把前面各层的成本合并,音频扩散的端到端延迟可以写成:
其中:
- :文本编码、CLAP 或参考音频编码,一次性的;
- :扩散主干的序列长度(mel 帧数或潜帧数);
- :注意力,约 ;
- :线性层,约 ;
- :采样步数(含 CFG 时的有效前向次数);
- :声码器或 codec 解码。
这个式子的价值在于指出三个不同的优化落点:缩短 (换表示、下采样、分块)、压低 (更好的求解器、蒸馏、sway sampling)、减少每步固定开销(缓存条件 K/V、融合 kernel、低精度)。
批处理与变长 padding 的浪费
音频请求的长度分布很宽:一句问候 2 秒,一段有声书章节 90 秒。把不同长度的请求塞进同一个 batch,必须 pad 到最长者。设 batch 内长度为 ,padding 后的有效计算占比为:
如果 batch 里混入一个 90 秒请求、其余都是 3 秒, 会降到 10% 以下,GPU 的大部分算力都在处理填充。因此音频服务通常按长度分桶(bucketing),把相近时长的请求聚合;这与视频扩散里的分辨率分桶是同一类工程手段。
CFG 在音频里的成本与必要性
classifier-free guidance(CFG)在文生图里几乎是默认配置,在 TTS 里则更微妙。它把条件与无条件两次前向合成一次:
是 guidance 强度。成本上是两倍前向(可以 batch 成一次,但算力仍是两倍),收益是更贴合文本、更清晰的发音。音频里的特殊之处是:
- 过大时会出现音色过亮、气息声放大、甚至爆音;语音的感知甜点通常比图像窄。
- 零样本 TTS 的”条件”包含参考音频与文本两部分,CFG 需要决定对哪一部分做无条件化。常见做法是对文本做 dropout,而参考音频始终保留,从而在”更贴文本”与”保住音色”之间取舍。
- 少步或蒸馏后的模型往往把 CFG 蒸馏进权重(第七篇),推理时不再需要两倍成本。
缓存:哪些能缓存、哪些不能
音频扩散里可以稳定复用的缓存有三类:
- 文本/CLAP 嵌入:同一句文本在多步采样中不变,可以只算一次;在批量服务里同一个 prompt 的嵌入还能跨请求复用。
- 参考音频的 K/V:Voicebox、CosyVoice 这类以参考语音为条件的模型,参考部分的 K/V 在整个采样循环中不变,是流式场景里最值得缓存的部分。
- 跨步激活缓存:与 扩散推理加速 里的 TeaCache/DeepCache 同理,相邻扩散步的中间特征高度相似。但音频对相位与高频的敏感度更高,缓存误差在听感上表现为金属声或”水下声”,阈值必须比图像更保守,实际生产中较少单独依赖它。
不能缓存的是生成区域自身的 K/V:扩散每一步都在修改整段序列的值,不像自回归解码那样有”已确定的前缀”。这一点与 dLLM 的 KV 缓存困境同构,第二篇已经详细讨论过。
低精度与量化
DiT 主干的量化路线与图像 DiT 类似:权重 4-bit、激活 8-bit 或 4-bit,配合低秩分支吸收离群值(SVDQuant 一类)。音频的特殊约束在解码端:声码器对数值扰动非常敏感,尤其是相位预测部分,4-bit 量化容易带来高频噪声。因此常见组合是”扩散主干低精度 + 声码器保持 FP16”,而不是整条管线一起压。
另一个常被低估的固定开销是重采样与格式转换:服务端常以 24 kHz 或 44.1 kHz 浮点处理,客户端可能要求 16 kHz、Opus 编码、单声道;这些转换在长音频上可能占到端到端延迟的 5–15%,却不属于模型的一部分。
与 LLM 推理服务的结构差异
把音频扩散服务与 LLM 服务并排看,会发现两者共享一部分工程直觉,但在关键处不同:
| 维度 | LLM 自回归推理 | 音频扩散推理 |
|---|---|---|
| 序列增长 | 逐 token 增长,KV 可增量缓存 | 整段同时去噪,无增量 KV |
| 批处理 | 连续批处理,请求可随时进出 | 步级同步,同一步内的请求才能合批 |
| 取消 | 停在下个 token 边界 | 停在步边界,已算的步作废 |
| 首包 | 首 token 延迟 | 首块音频延迟(含声码器) |
| 主要成本轴 | KV 带宽与 decode 步数 | 序列长度平方与采样步数 |
| 缓存对象 | 前缀 KV | 条件嵌入、参考音频 K/V |
这张表可以直接回答一个部署问题:不要用 LLM 引擎的调度假设去套音频扩散。二者的同步点、取消粒度与缓存语义都不一样,强行复用会得到看似能跑、但延迟曲线完全不可控的系统。
第九层:音乐与通用音频生成——从语音再往外一步
语音与音乐的差别
语音合成的目标高度结构化:文本、说话人、韵律。音乐与环境声生成的目标开放得多:一段”雨夜城市的环境音”、“80 年代合成器风格的鼓组”、“带钢琴前奏的两分钟流行歌”。AudioLDM 的任务定义是 text-to-audio:给定文本描述,生成对应声音。Stable Audio 则面向长音乐片段与立体声。
从扩散机制看,语音与音乐的差别集中在四点:
- 序列长度:一首歌几分钟,44.1 kHz、低频潜表示下仍有数千帧,长于任何一段语音。
- 立体声:两条声道需要联合建模,潜表示宽度翻倍。
- 全局结构:音乐有段落(前奏、主歌、副歌),需要长程一致性,这对扩散的全局条件能力提出更高要求。
- 无条件化与随机性:音乐生成里”同样的提示生成不同结果”是期望行为,CFG 与随机采样器的选择更自由。
AudioLDM 的”文本→潜→mel→波形”四段管线
回到前面那张 AudioLDM 架构图,它的管线是:
- 文本编码:CLAP 文本编码器把提示映射到嵌入空间。
- 潜扩散:在音频的 mel-VAE 潜空间上从噪声去噪,条件为 CLAP 嵌入。
- mel 解码:冻结的 VAE 解码器把潜表示还原成 mel 声谱图。
- 声码器:HiFi-GAN 把 mel 转成波形。
这四段本身就是一条推理服务链,每段都可以独立优化与缓存。需要单独看的是第 2 段的采样步数:作为通用音频生成器,AudioLDM 不需要像 TTS 那样压到个位数,因为文本到音频没有”必须实时”的硬约束;但在音乐工具类应用(实时编曲、交互作曲)里,步数又会重新成为瓶颈。
长音频的结构性难题
长音频扩散的困难与视频扩散同构:注意力序列太长。语音领域的解法是”分块 + 因果”;音乐领域的解法则是”条件 + 分段”,常见三种:
- 固定长度分段生成:每次生成 30 秒左右,用重叠交叉淡入拼接。简单,但段落间乐句容易断裂。
- 音乐条件扩散:用旋律线、和声、节拍作为条件,让独立生成的片段在同一结构下对齐。
- 潜空间自回归 + 扩散:用自回归的潜 token 模型决定全局结构,扩散只负责片段内的声学细节。这一路线与视频里的”分块自回归生成”如出一辙。
音乐生成里 CFG 与随机性的取舍
音乐里 的甜点通常比语音宽:文本描述较为开放,适度提高 能让生成更贴提示而不至于像语音那样立刻爆掉。同时,音乐工具通常提供”同一提示多次采样、挑选最好的”交互(类似图像里的 seed 滚动),这要求采样器是可复现的——固定噪声与随机种子即可。
第十层:音频扩散与自回归的分工——为什么 2026 年的生产系统是混合的
自回归 LLM 的优势与短板
用离散语音 token + 自回归语言模型做语音合成,在 2024–2026 年成为主流路线之一(如 CosyVoice 的 (b) 段、各种 codec LM)。它的优势:
- 可以直接复用语言模型的基建:大规模预训练、KV 缓存、连续批处理、投机解码。
- 文本与语音 token 在同一序列里,语义与韵律在一个模型里端到端学习。
- 天然支持流式:token 一个一个出,出多少播多少。
短板也清楚:
- 离散量化会损失声学细节,音质依赖 tokenizer 质量;token 序列长、声码器又是个额外负担。
- 误差累积:自回归生成里一个错误 token 会影响后续所有 token,语音里表现为发音错误、跳词、重复(NaturalSpeech 2 的摘要里明确指出,这正是它选择潜扩散的主要动机)。
- 采样是逐 token 串行的,长语音的 RTF 受 LLM decode 速度限制。
扩散的优势与短板
扩散(含 flow matching)的优势:
- 连续表示无量化损失,音质上限高;
- 整段并行去噪,序列内没有串行依赖,长片段的计算可以一次铺满 GPU;
- 条件注入灵活(参考语音、掩码区域、时长、音高都是条件)。
短板:
- 不能直接复用 LLM 的增量 KV 缓存;
- 步数与序列长度共同决定延迟,流式需要专门设计(chunk-aware);
- 文本对齐需要显式模块或隐式学习,可控性不如 token 级模型。
混合结构:LLM 管语义,flow matching 管声学
CosyVoice 2 的 (b)+(c) 结构把两种路线的分工写得最清楚:LLM 负责”说什么、按什么韵律说”,flow matching 负责”用什么嗓子、什么音色说出来”。前者是离散的、语义的、适合自回归;后者是连续的、声学的、适合并行扩散。这种分工在两年的实践里被反复验证:
- 语义 token 序列短(25 Hz),自回归成本低,流式容易;
- 声学扩散的每块序列也短,可以 chunk-aware 流式;
- 两类模型可以独立升级、独立量化、独立部署。
Voicebox、F5-TTS 走的是另一条极端:把语义与声学全部交给一个扩散模型,靠大上下文(参考语音 + 文本)隐式学对齐。这条路线管线更短、在高质量数据下效果很好,但流式化更难、对数据规模的要求更高。
什么时候选哪条路线
从工程决策的视角压缩成一张对照:
| 需求 | 优先选择 |
|---|---|
| 极低首包延迟、实时对话 | LLM 语义 + chunk-aware 扩散,或纯自回归 |
| 高音质、零样本音色模仿、离线批处理 | 扩散/flow matching(Voicebox、F5-TTS 一类) |
| 需要音频编辑(局部改写、修补) | 文本引导 infilling 类扩散模型 |
| 多语言、复杂文本发音可控 | 显式对齐 + 扩散解码,或 LLM 路线 |
| 复用已有 LLM 基建 | 自回归 codec LM |
局限与未解决的问题
音频扩散目前仍有几个没有收敛的点。
一是流式的”块内一致性”。 chunk-aware 方法让块内质量接近离线,但跨块的韵律起伏(比如一句话被切在从句中间)仍偶有断裂;长句、快语速、情绪起伏大的片段最容易暴露。
二是文本可控性。 无对齐路线在多语言混读、数字与缩写、专有名词上的发音错误率仍高于显式对齐模型,而显式对齐又引入了对齐错误这一独立故障源。折中方案(用轻量对齐模块约束扩散)还没有成为标准。
三是声码器与扩散空间的联合优化。 目前多数系统把声码器当冻结组件,扩散模型只能去适应它的 mel 约定;联合训练可以进一步提升质量,但会让管线耦合、部署困难。
四是长音频的全局结构。 音乐与长有声书需要长程一致性,而扩散本身不擅长全局结构;潜空间自回归 + 扩散的混合是目前最被看好的方向,但没有形成统一设计。
五是多模态统一。 图像、视频、音频、文本的扩散正在被尝试放进同一条主干(原生多模态),但音频的序列长度与感知度量与其他模态差异很大,token 预算分配与损失加权都还没有成熟配方。
小结
把这一篇的机制压成几条判断:
- 音频扩散的第一约束是序列长度。 24 kHz 下 10 秒波形有 24 万个采样点,直接注意力不可行;mel(100 Hz × 80 维)把时间维缩短 240 倍,codec 潜表示再进一步降到 25–75 Hz,这是三条表示路线的根本差异。
- 波形扩散靠”无注意力 + 膨胀卷积 + 少步日程重映射”成立。 DiffWave 用双向膨胀卷积把感受野堆到数万采样点,2.64M 参数的小模型即可在 V100 上超过实时 5 倍;WaveGrad 用 6 步细化达到同等质量级别。
- mel 扩散让 transformer 主干变得可行。 Grad-TTS 用 SDE 形式把文本条件写进漂移项,用 MAS 做单调对齐;NaturalSpeech 2 把扩散移到 RVQ 潜向量上,并加入时长与音高预测器。
- 条件可以完全替代训练好的说话人参数。 Voicebox 用文本引导 infilling 把零样本音色从”权重”变成”输入条件”,代价是参考音频进入注意力序列,K/V 必须按条件缓存。
- flow matching + 去对齐是当前最快的 TTS 配方。 F5-TTS 用 ConvNeXt 精炼文本、用推理期 Sway Sampling 重分配时间步,在 RTX 3090 上 16 NFE 达到 RTF 0.15,32 NFE 时 WER 2.42。
- 流式扩散的核心是分块因果。 CosyVoice 2 用 chunk-aware causal flow matching,让流式与离线在同一权重下近似无损,稳态周期只与块长相关,而不与整句长度相关。
- 声码器不是黑盒。 HiFi-GAN 的并行上采样、BigVGAN 的周期激活与抗混叠、Vocos 的频域直出,各自决定了推理延迟与高频质量;声码器与 mel 配置的严格匹配是部署中最常见的故障来源。
- 生产系统是混合的。 LLM 负责语义与韵律(离散、适合自回归、易流式),flow matching 负责声学与音色(连续、适合并行、音质上限高),这是当前最稳定的分工。
附:从最小代码看训练与推理的对应关系
把前面几层的公式压成一段伪代码,可以确认各条路线共享的骨架,以及它们只在”数据表示”与”条件组织”上不同。
# 通用骨架:mel / codec / 波形三种表示只是 tensor 形状不同def train_step(batch): x0 = encode(batch.audio) # (B, L, D) —— mel 帧或潜帧 cond = build_condition(batch) # 文本嵌入、参考音频 K/V、掩码区域 t = sample_t( # flow matching 用 U(0,1);DDPM 用离散 t size=x0.shape[0], device=x0.device) eps = torch.randn_like(x0) xt = (1 - t.view(-1, 1, 1)) * x0 + t.view(-1, 1, 1) * eps # OT 路径 u = eps - x0 # 目标速度 v = model(xt, t, cond) # DiT 或膨胀卷积 loss = ((v - u) ** 2).mean() return loss
@torch.no_grad()def sample(cond, steps=16, sway_s=-1.0): x = torch.randn(cond.target_shape, device=cond.device) ts = torch.linspace(0, 1, steps + 1, device=x.device) ts = ts + sway_s * (np.cos(np.pi / 2 * ts) - 1 + ts) # Sway:s<0 向左偏 for i in range(steps): t0, t1 = ts[i], ts[i + 1] v0 = model(x, t0, cond) x = x + (t1 - t0) * v0 # 一阶 Euler return decode(x)这段骨架里能被替换的三处,正好对应本文的层次划分:
encode/decode:换成 mel-STFT + HiFi-GAN,就得到 Grad-TTS、NaturalSpeech 2、Voicebox 一线的结构;换成时域自编码器,就得到 Stable Audio、CosyVoice 音频侧的结构。build_condition:Voicebox 在这里拼入参考音频与掩码;CosyVoice 2 在这里加入因果块掩码与参考 token;F5-TTS 在这里把文本经 ConvNeXt 拉长并补填充符。model:波形扩散用双向膨胀卷积,mel 与潜空间扩散用 DiT 或 Conv-Transformer UNet。
还有一个容易被忽略的细节:sample 的循环里,条件 cond 每一步都相同。若 model 把条件的 K/V 缓存下来(参考音频、文本嵌入),每步就能省掉这部分投影与前向,这是音频扩散里唯一稳定可得的缓存收益。
下一篇讨论 3D 生成扩散:多视图一致性、稀疏体素潜表示与隐式场,如何把扩散推到几何空间。
参考资料
- Denoising Diffusion Probabilistic Models
- DiffWave: A Versatile Diffusion Model for Audio Synthesis
- WaveGrad: Estimating Gradients for Waveform Generation
- Grad-TTS: A Diffusion Probabilistic Model for Text-to-Speech
- NaturalSpeech 2: Latent Diffusion Models are Natural and Zero-Shot Speech and Singing Synthesizers
- Voicebox: Text-Guided Multilingual Universal Speech Generation at Scale
- E2 TTS: Embarrassingly Easy Fully Non-Autoregressive Zero-Shot TTS
- F5-TTS: A Fairytaler that Fakes Fluent and Faithful Speech with Flow Matching
- CosyVoice 2: Scalable Streaming Speech Synthesis with Large Language Models
- High Fidelity Neural Audio Compression(EnCodec)
- AudioLDM: Text-to-Audio Generation with Latent Diffusion Models
- Stable Audio Open
- HiFi-GAN: Generative Adversarial Networks for Efficient and High Fidelity Speech Synthesis
- BigVGAN: A Universal Neural Vocoder with Large-Scale Training
- Vocos: Closing the gap between time-domain and Fourier-based neural vocoders for high-quality audio synthesis
- Flow Matching for Generative Modeling
- Classifier-Free Diffusion Guidance
- hiFiGAN 官方实现
- F5-TTS 官方仓库
- CosyVoice 官方仓库
- EnCodec 实现(encodec)
- BigVGAN 官方仓库
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
正在获取所在地区…
正在读取天气
音乐
暂未播放



