


EAGLE-2 完全拆解:动态草稿树如何让投机解码上下文感知
EAGLE-2 由北京大学、微软研究院、滑铁卢大学与 Vector Institute 的研究者提出,论文发表于 EMNLP 2024。它接在 EAGLE 之后,解决的不是“草稿模型怎么训练得更准”,而是一个更像推理系统调度的问题:同一个草稿模型在不同上下文里有不同把握,为什么还要每次都长出同一棵固定形状的草稿树?
原始 EAGLE 已经把投机解码从 token 级小模型草稿推进到 feature 级草稿:草稿头预测目标模型倒数第二层特征,再复用目标模型 LM Head 生成候选 token。站内已有 EAGLE 完全拆解:特征级草稿模型如何把投机解码推到 3 倍以上,本文不重复展开 feature uncertainty 与 shifted token 的训练细节,只保留必要背景,重点讲清楚 EAGLE-2 的动态草稿树。
一句话概括:EAGLE-2 发现 EAGLE 草稿模型的 token 置信度可以近似真实接受率,于是用路径置信度乘积估计每个候选节点的全局价值;草稿阶段优先扩展高价值节点,验证前再从整棵候选树里重排出最值得验证的连通子树。它不改目标模型,不放宽接受条件,也不额外训练一个树策略模型,却把固定树变成了上下文感知的推理时调度。
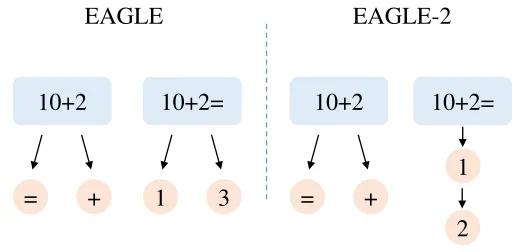
上图来自 EAGLE-2 论文 Figure 4。它用两个很小的算术上下文解释动态树的必要性:当上下文是 “10+2=” 时,下一个 token 大概率是 “1”,再给同一层分配多个候选属于浪费;当上下文是 “10+2” 时,模型还需要判断表达是否继续、是否出现等号,候选分支就应该更宽。静态树把这两种上下文当成同一个难度,EAGLE-2 则把草稿模型自己的置信度当成低成本信号,决定树该往哪里长。
先把投机解码的账本摆清楚
自回归解码每一步只确认一个 token。设当前前缀是 ,目标模型的下一个 token 分布是 。普通解码要做一次目标模型 forward,采样出 ,再把这个 token 追加进前缀,重复下一步。大模型 decode 阶段常常是访存受限:每生成一个 token,都要把庞大的权重和 KV Cache 相关数据流动一遍,batch 小时尤其明显。
投机解码把一轮生成拆成草稿与验证。草稿模型先快速给出 个候选:
其中 是草稿模型生成的第 个候选 token。草稿模型同时记录候选 token 在草稿分布中的概率,记作 。随后目标模型用一次并行 forward 计算这些候选位置上的目标分布 ,再从左到右做接受-拒绝。
对第 个候选 token,标准 speculative sampling 的接受概率是:
这里分子是目标模型给候选 token 的概率,分母是草稿模型给同一个 token 的概率。如果草稿模型低估了某个 token,比例大于 1,接受概率截断为 1;如果草稿模型高估了它,就按比例接受。被拒绝时,从残差分布补采样:
的作用是把草稿模型少覆盖的目标概率质量补回来。这个接受-拒绝规则保证最终输出分布与目标模型自回归采样一致,所以投机解码的“无损”不是经验说法,而是概率分布层面的等价。
但这套规则也带来一个直接后果:投机解码能快多少,关键不只是草稿模型本身多便宜,而是一轮目标模型验证平均能确认多少 token。EAGLE-2 论文使用平均接受长度 衡量这一点。简化地看,若一轮草稿耗时 ,一轮目标模型验证耗时 ,普通目标模型生成一个 token 耗时 ,则速度提升可近似写成:
这个公式不追求精确建模,但足以说明 EAGLE-2 的方向:如果树里放进太多低价值候选, 变大而 不涨;如果树太窄, 上不去。动态草稿树要做的,就是用尽量低的调度成本,把验证预算花在最可能被接受的候选上。
为什么固定草稿树会浪费
原始 EAGLE 使用树形草稿,而不是单链草稿。单链草稿的弱点是前缀依赖太强:只要第一个候选 token 被拒绝,后面所有 token 都失效;第二个 token 被拒绝,后缀也全部失效。树形草稿给每个位置准备多个分支,目标模型验证时用 tree attention mask 保证一个节点只能看见自己的祖先,不能看见兄弟分支。这样每条从根到叶子的路径仍然等价于一条合法的自回归序列。
固定树的直觉并不差。越靠近根的节点越重要,因为任何深层节点都要依赖祖先先被接受;树的左上区域通常比右下区域更值得扩展。因此 EAGLE、Medusa 一类方法会预先设定一个形状:第一层几个候选、第二层几个候选、哪些节点继续长子节点。每次请求都往同一个模板里填 token。
问题在于,位置不是接受率的唯一解释变量。EAGLE-2 在 Alpaca 数据集和 Vicuna 7B 上观察草稿树不同位置的接受率:位置确实有影响,靠前、靠左的节点平均接受率更高;但同一个位置在不同 query 上的接受率方差很大。这意味着“第 3 个节点通常比较好”只能作为先验,不能代表当前上下文。
可以把固定树想成一种离线预算分配:系统提前决定每层怎么花计算。EAGLE-2 要改成在线预算分配:当前上下文已经告诉草稿模型“我对哪些 token 有把握”,推理系统应该利用这个信号。上下文越确定,树越应该沿高置信路径加深;上下文越不确定,树越应该给同一层更多备选。
这也是 EAGLE-2 与简单 early stopping 的区别。早停只回答“还要不要继续草稿”,动态树回答的是“下一层到底扩展哪些节点、最终验证哪些节点”。后者更细,因为树里的每个节点都有自己的祖先路径、位置和置信度。
置信度为什么可以近似接受率
动态树首先需要一个可用的价值信号。理想情况下,系统想知道每个候选 token 的真实接受率 ,也就是目标模型验证时它会通过的概率。但真实接受率只有调用目标模型后才能知道,而投机解码恰恰是为了减少目标模型调用。如果价值估计本身要额外跑目标模型,这个优化就原地失效。
EAGLE-2 的关键观察是:EAGLE 草稿模型的输出置信度与真实接受率高度相关。这里的置信度不是一个额外训练的打分器,而是草稿模型已经会输出的 token 概率。设草稿节点 的草稿概率为 ,即草稿模型认为自己选中这个 token 的概率。论文把样本按置信度区间分桶,再统计每个区间里的真实接受率,得到下面这条近似校准曲线。
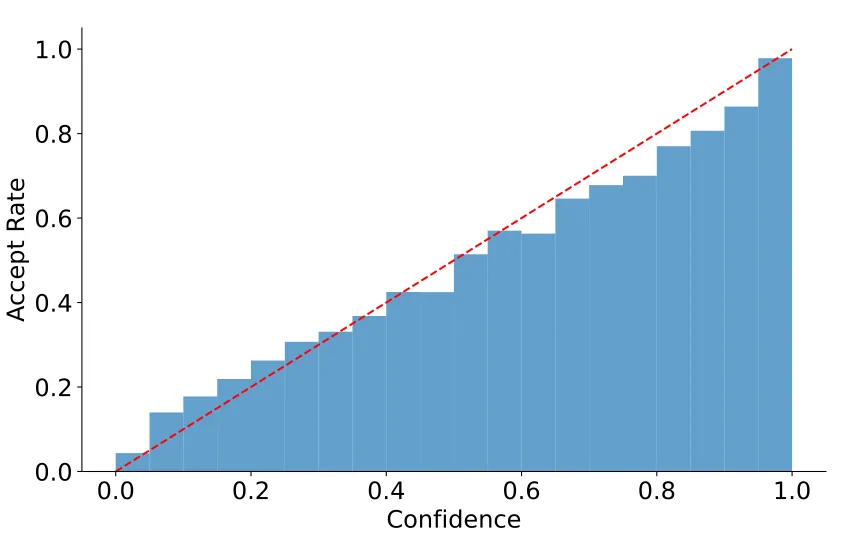
上图来自 EAGLE-2 论文 Figure 6。横轴是草稿模型对候选 token 的 confidence score,纵轴是真实接受率,红色虚线是理想的 。论文报告,置信度低于 0.05 的 token 接受率约为 0.04,置信度高于 0.95 的 token 接受率约为 0.98。也就是说,至少在论文实验设置下,草稿模型说“我很确定”的 token 真的更容易被目标模型接受。
这个结果并非所有草稿模型天然成立。EAGLE 的特殊之处在于它不是一个完全独立的小模型,而是预测目标模型 feature,再复用目标模型 LM Head。草稿 token 分布与目标模型内部表示绑定得更紧,所以置信度更有资格作为接受率代理。普通小模型草稿也可能有类似趋势,但校准程度要具体测;如果小模型与目标模型分布偏差很大,置信度就可能变成“自信地错”。
这里还要区分局部置信度和全局接受价值。一个 token 自身置信度高,不代表它所在路径最终一定能走到那里。深层节点要被使用,前面每个祖先都必须先被接受。因此 EAGLE-2 不直接用单点置信度排序所有节点,而是把路径上的置信度乘起来。
value 公式:把节点放回整条路径里看
设草稿树里有一个节点 。从根节点到它的路径记作 。路径上的每个节点 都有一个真实接受率 。那么 被真正接受的前提是路径上所有节点都被接受,因此它的全局接受概率可以写成:
是节点 的全局价值。它不是“这个 token 看起来多像正确答案”,而是“验证阶段走到并接受这个 token 的概率”。如果路径第一步只有 0.2 的概率被接受,哪怕深层某个 token 局部置信度达到 0.9,它的全局价值也会被祖先拖低。
因为真实接受率 需要目标模型验证后才知道,EAGLE-2 用草稿置信度 近似:
这个乘积有三个工程含义。
第一,它天然惩罚过深路径。由于 ,每往下一层乘一次, 通常都会下降。深度不是免费收益;只有当祖先和当前节点都足够确定时,继续加深才划算。
第二,它把树的宽度和深度放进同一个排序标准。浅层节点少乘几项,可能比深层节点价值更高;深层高置信路径也可能比低置信浅层备选更值得保留。固定树需要人工指定宽深比例,EAGLE-2 让 value 排序在运行时决定。
第三,它不引入额外 forward。 是草稿模型生成 token 时已经算出的概率,路径乘积只是一点 CPU/GPU 侧的轻量 bookkeeping。对推理系统来说,这个信号便宜到可以每轮都用。
扩展阶段:只把最新层最有希望的节点喂回草稿头
动态树生成的第一步是 expansion。假设当前草稿树已经长到某一层,最新层有许多候选节点。朴素做法是把这一层所有节点都送进草稿模型,让每个节点继续展开 top-k 后继。但树的节点数会指数增长,草稿模型再轻也扛不住无限扩展。
EAGLE-2 的做法是:在最新层中选 value 最高的 top- 节点,把这些节点作为下一轮草稿模型输入,让它们继续生成后继。这里的 是扩展预算,不是词表 top-k 采样里的 。它回答的是“这一层有多少个节点值得继续长子节点”。
用伪代码写,可以简化成:
tree = rootwhile depth < max_depth: frontier = nodes_at_latest_layer(tree) expand_nodes = top_k(frontier, key=value) children = draft_model_expand(expand_nodes) attach children to tree update value(child) = value(parent) * confidence(child)关键是 value(child) = value(parent) * confidence(child)。每个新节点的全局价值可以增量计算,不需要重新遍历整条路径。这个细节在真实 serving 系统里很重要,因为 speculative decoding 每轮都在毫秒级路径上,不能把树调度写成重型图算法。
扩展阶段的目标是加深树,但它并不保证最终验证的就是这些被扩展出来的节点。原因很简单:一旦树加深,深层节点 value 会因为乘积变小;某些早先没被扩展的浅层节点,可能仍然比新生成的深层节点更值得验证。这就需要第二步 reranking。
重排阶段:从全树选出最值得验证的连通子树
EAGLE-2 的 reranking 阶段面向目标模型验证。它不只看最新层,而是把当前草稿树中所有候选节点放在一起,按 value 排序,选出 top- 个节点作为最终 draft。 是验证预算,也就是这一轮目标模型 forward 准备验证多少个草稿节点。
这里有一个隐藏约束:被选中的节点必须构成合法树,不能只选子节点不选父节点。假如验证序列里有某个深层 token,但它的祖先 token 没在序列里,那么 tree attention mask 无法表达“这个 token 的前缀是什么”,目标模型也无法计算合法的条件概率。
EAGLE-2 利用了 value 的单调性解决这个问题。因为子节点 value 等于父节点 value 乘上一个不超过 1 的置信度,所以:
如果按 value 从高到低选择 top-,只要一个子节点被选中,它的父节点通常已经更早被选中。论文还提到,在 value 相同的情况下优先选择更浅节点。这样最终 top- 节点天然形成连通树,减少额外修补逻辑。
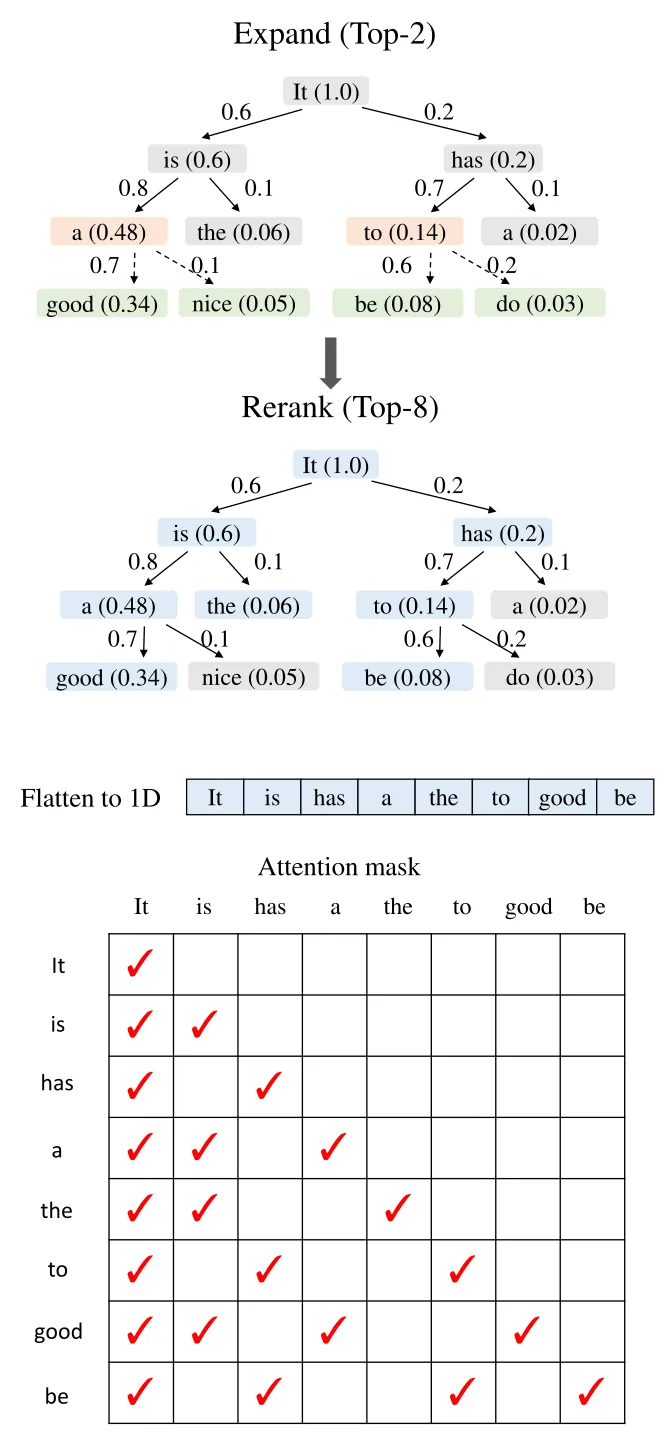
上图来自 EAGLE-2 论文 Figure 7。图里的边上数字是草稿置信度,节点括号里的数字是路径 value。上半部分表示 expansion:每一层只扩展当前最有价值的节点。下半部分表示 reranking:从全树中挑出 value 最高的一批节点,压平成一维序列,再按树结构构造 attention mask。
“压平成一维序列”听起来像实现细节,其实很核心。GPU 上的目标模型 forward 接收的是 batch 内一段 token 序列,而不是抽象树。树形验证要做两件事:一是把树节点排成线性张量,二是构造一个非标准 causal mask,让每个节点只能 attend 到自己的祖先与请求前缀。兄弟节点之间不能互相看见,否则就把互斥分支的信息泄漏进同一次 forward,破坏分布等价。
因此,EAGLE-2 的动态树不是单纯多采样几个 token。它包含草稿模型扩展、节点 value 维护、连通子树选择、线性化、tree attention mask、目标模型验证和 KV 结果提交这一整套系统动作。
无损性为什么没有被动态树破坏
EAGLE-2 动态调整草稿树,但最终输出分布仍然等于目标模型。原因是动态树只改变“提出哪些候选”,不改变“如何接受候选”。只要验证阶段仍然使用标准 speculative sampling 的接受-拒绝规则,草稿分布 只影响候选效率,不改变最终分布。
可以从条件采样角度理解。草稿阶段根据历史前缀、草稿模型参数和置信度策略生成一个候选集合 。目标模型验证时,对于候选路径上的每个 token,仍然用目标分布 和草稿分布 计算接受概率;一旦拒绝,仍然从 中补采样。动态策略只是在 的构造上更聪明,并没有把目标模型概率替换成草稿概率。
这也是 EAGLE-2 与一些“为速度放宽接受条件”的方法不同的地方。放宽条件可能提高接受长度,但会改变采样分布;EAGLE-2 不这么做。论文在比较中明确排除了非贪婪设置下不能保证无损的变体。对工程落地来说,这点很重要:如果服务需要保证与原模型采样语义一致,动态树这类调度优化比改 acceptance rule 更容易被接受。
当然,“分布无损”不等于“每次输出字面相同”。在非贪婪采样下,只要随机数流或候选顺序变化,具体文本可能不同;无损指的是概率分布一致。若使用 greedy decoding,接受-拒绝退化成确定性路径,输出一致性更直观。
速度结果该怎么读
EAGLE-2 论文在 Vicuna、LLaMA2-Chat、LLaMA3-Instruct 三个模型系列上测试,任务覆盖 MT-bench、HumanEval、GSM8K、Alpaca、CNN/Daily Mail 和 Natural Questions。论文摘要给出的核心区间是:EAGLE-2 达到 3.05x 到 4.26x 速度提升,相比 EAGLE-1 快 20% 到 40%。ACL Anthology 页面则概括为最高 5x,约为 EAGLE 的 1.3x。
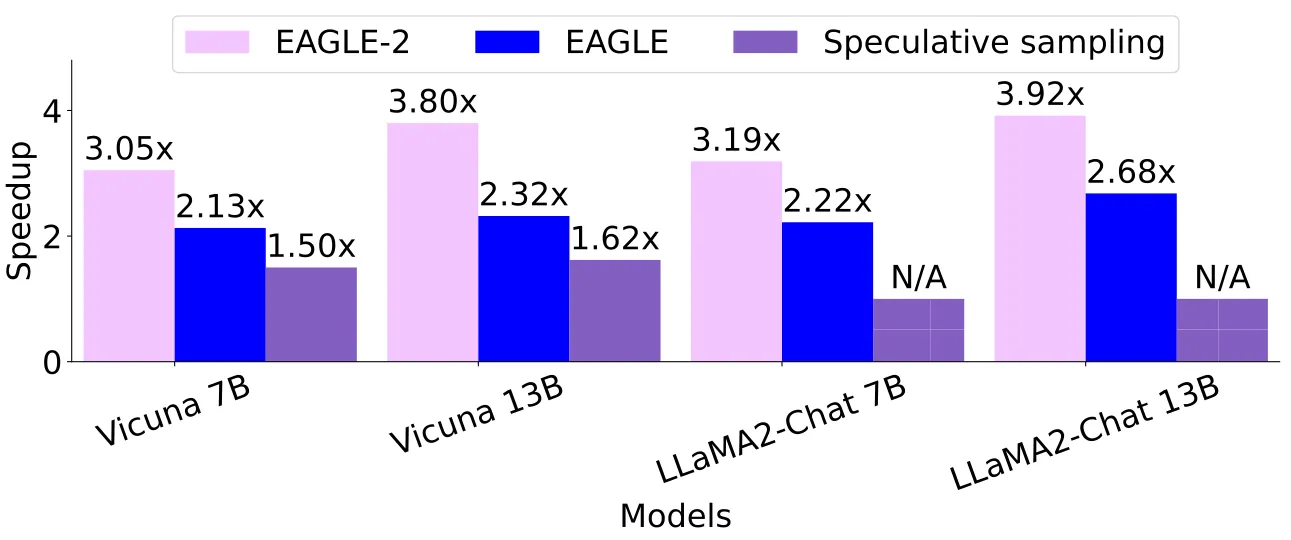
上图来自 EAGLE-2 论文 Figure 1。它展示了 temperature=1、MT-bench 上 EAGLE-2、EAGLE 与标准 speculative sampling 的对比。图里最值得注意的不是某个单点数字,而是三个现象。
第一,EAGLE-2 相比 EAGLE 的提升来自同一草稿模型上的树调度优化。它没有训练一个更强草稿头,因此增益说明固定树确实浪费了一部分验证预算。
第二,模型大小会改变收益。13B 模型上 EAGLE-2 的 speedup 往往高于 7B,因为目标模型本身更重,草稿和调度开销在总耗时中占比更低。投机解码通常更适合“目标模型昂贵、草稿模型便宜”的场景。
第三,temperature=1 仍能保持无损加速,这比只在 greedy decoding 下提速更有工程价值。很多聊天、写作、代码辅助服务不会只跑 temperature=0;如果方法只能在确定性解码下成立,适用面会窄很多。
论文表格还给出平均接受长度 。在多个设置下,EAGLE-2 每轮 draft-verify 能生成约 4 到 5.5 个 token,明显高于标准 speculative sampling 和 Medusa。这个指标比 wall-clock speedup 更接近算法本身,因为 wall-clock 会被 GPU 型号、实现质量、batch 大小、KV 管理策略影响。看一篇投机解码论文时,最好同时看 speedup 和 :前者是端到端结果,后者是草稿与验证机制是否真的有效。
为什么动态树不是越大越好
看到动态树,很容易误以为“多放候选总能更快”。真实情况相反:树太大,会把 verify 阶段拖慢。
目标模型验证虽然能并行处理多个候选 token,但这些候选仍然要经过目标模型层、attention、MLP、LM Head。每多一个候选节点,就多一份 token 计算和临时 KV 写入。对 decode 阶段而言,一次 forward 里的 token 数增加可以摊薄权重读取,但不会让计算完全免费。树里若有很多低价值节点,目标模型花时间验证它们,最后却很少被接受,速度反而下降。
动态树的本质是预算分配,而不是无限扩张。EAGLE-2 论文附录给出实现设置:对于 7B/8B、13B、70B 原模型,总 draft token 数分别设为 60、50、48,草稿树深度为 6,扩展阶段选择 10 个节点。这个配置透露出一个工程事实:大模型越贵,单轮验证预算不一定越大,因为目标模型验证本身也更贵;树大小要和硬件、模型大小、batch 策略一起调。
服务系统里还会多一个全局维度。单请求低延迟时,给当前请求更大的树可能划算;高并发吞吐场景下,一个请求的候选 token 会占用 batch token budget,挤掉其他请求。连续批处理系统需要在“让一个请求更快完成”和“让整批请求吞吐更高”之间平衡。EAGLE-2 的 per-request 动态树解决的是局部预算分配,线上服务还可以在队列压力高时降低 或扩展深度,在低负载时放大草稿树。
与 EAGLE、Medusa、MTP 的关系
EAGLE-2 最容易被误读成“EAGLE 的新草稿模型”。更准确地说,它是 EAGLE 草稿模型上方的一层动态树调度。EAGLE-1 的核心是 feature-level drafting:把草稿预测对象从 token 换成目标模型内部特征。EAGLE-2 的核心是 context-aware tree construction:把固定草稿树换成按置信度和路径价值动态生长的树。
Medusa 同样使用树形验证,但它的候选来自多个 Medusa heads。多头并行很便宜,不过远处 token 的条件化程度有限;EAGLE 保留自回归式草稿扩展,只是用轻量 feature draft head 生成后继。EAGLE-2 的动态树思想理论上也能启发其他树形投机方法,但“置信度是否能当接受率”要重新验证。
DeepSeek-V3 的 MTP 则是模型结构内生的多 token 预测模块,主模型本身带着未来 token 预测能力。站内已有 MTP 完全拆解:多 token 预测如何让 DeepSeek 自带草稿模型。MTP 的优势是与主模型一体化,劣势是依赖模型预先设计;EAGLE-2 更像外接 speculator 与运行时树调度,适合给已有模型加速。
DFlash、DFlow 等块扩散投机解码走的是另一条路线:用扩散式草稿一次提出一段候选,再交给目标模型验证。它们追求更强的草稿并行性。EAGLE-2 仍然站在 causal LM 的树形自回归框架里,优势是验证规则清晰、接入已有 speculative decoding 栈相对直接。
工程实现里的几个难点
第一个难点是 tree attention mask。普通 causal mask 是下三角矩阵,位置 能看见所有 之前的 token。树形验证中,线性序列里排在前面的兄弟节点不一定是当前节点祖先,不能被看见。因此 mask 要按父子关系构造,而不是按线性位置构造。实现错了,轻则接受率异常,重则输出分布被污染。
第二个难点是临时 KV Cache。验证时生成的候选节点很多,但最终只有接受路径上的 token 会进入正式上下文。系统需要把候选 KV 与正式 KV 区分开,接受后提交,拒绝后回收。如果底层使用 PagedAttention 这类块式管理,候选块的申请、引用计数、回收和可能的写时复制都会影响延迟。PagedAttention 的内存管理背景可参考 PagedAttention 完全拆解。
第三个难点是采样参数。temperature、top-p、top-k 越激进,目标分布越分散,草稿模型越难覆盖真实采样路径,接受长度可能下降。EAGLE-2 的无损性不依赖低温采样,但速度收益依赖接受率。工程上不能只用 greedy benchmark 宣称所有聊天场景都有同等收益。
第四个难点是模型适配。EAGLE-2 不额外训练树策略模型,但仍然需要 EAGLE draft head。热门开源模型可以复用官方或社区 speculator;内部模型、频繁迭代模型则要维护目标模型与 draft head 的版本匹配。只要目标模型权重或 tokenizer 明显变化,草稿头的校准关系就需要重新评估。
第五个难点是与 batching 的相互作用。vLLM、SGLang、TensorRT-LLM 这类推理框架都在不同程度支持 speculative decoding 或 EAGLE 系列,但每个框架对 batch 调度、draft worker、verify kernel、KV 提交的实现不同。SGLang 文档中已经把 EAGLE-2/EAGLE-3、MTP、经典 draft model、N-gram 等都放进 speculative decoding 选项;vLLM 也通过 speculators 项目推动 speculator 的训练与存储格式统一。算法论文里的动态树,只是落地链条的一半,另一半是 serving engine 能不能把候选生成、目标验证和请求调度接得足够紧。
一段更贴近实现的流程
把 EAGLE-2 放进一次 decode step,可以写成下面这个流程:
input: prefix tokens target model KV cache EAGLE draft head max_depth, expand_budget k, verify_budget m
1. run draft expansion initialize tree with current prefix root for depth in 1..max_depth: choose top-k frontier nodes by path value use EAGLE draft head to expand these nodes record token, draft probability, parent pointer update path value
2. run reranking sort all candidate nodes by path value choose top-m nodes, preferring shallow nodes on ties flatten selected connected tree into a token list build ancestor-only attention mask
3. run target verification target model computes probabilities for selected nodes apply speculative sampling acceptance rule along candidate paths commit accepted tokens and their KV discard rejected candidate KV
4. continue decoding repeat until EOS or max tokens这段流程能看出 EAGLE-2 的干净之处:它没有把目标模型变复杂,而是把复杂度放在目标模型调用之前的候选组织上。只要最终 verify 接口仍能拿到候选 token、草稿概率和树 mask,目标模型仍然是原来的目标模型。
局限与适用场景
EAGLE-2 最适合 decode 占主要耗时、目标模型较大、请求输出较长、batch 不太饱和的场景。交互式聊天、代码生成、结构化输出、数学推理中的长答案,都可能从较高接受长度中受益。论文也指出代码任务常常速度提升更明显,因为代码模板和局部语法更强,草稿模型更容易猜中。
它不适合把 prefill 当成主要瓶颈的场景。长 prompt、短输出的请求里,系统时间主要花在 prompt prefill,投机解码只加速后续 decode,整体收益会被稀释。对于 RAG、长文总结、超长上下文问答,若输出很短,EAGLE-2 的端到端收益未必好看。
它也不自动解决高吞吐服务的所有问题。投机解码增加了每轮 verify 的 token 数和临时 KV 管理压力。低 QPS 时这是用额外计算换低延迟;高 QPS 时,GPU 可能已经被 batch 填满,额外候选会争抢吞吐预算。线上系统需要根据负载动态调节草稿树大小,甚至在高压时关闭或降低投机强度。
最后,EAGLE-2 的核心假设是草稿置信度足够校准。论文在 EAGLE draft head 上验证了这一点,但迁移到别的 speculator、别的模型族、量化后的 draft head、不同采样策略时,最好重新画一遍“confidence vs acceptance rate”曲线。动态树依赖这个信号;信号失真,树就会把预算投错地方。
小结
EAGLE-2 的价值在于把投机解码里的树形草稿从静态模板变成了运行时调度问题。固定树只知道“哪个位置平均更重要”,动态树则利用当前上下文下的草稿置信度,估计每个节点被接受到的全局概率。
它的机制可以压缩成三步:先用草稿置信度 近似真实接受率;再用路径乘积 衡量节点全局价值;最后在 expansion 阶段优先扩展高价值 frontier,在 reranking 阶段从全树选出高价值连通子树交给目标模型验证。
这套方法最漂亮的地方是边界清楚:它不改目标模型、不放宽接受规则、不额外训练树策略模型,因此无损性仍由标准 speculative sampling 保证。它的工程挑战也同样清楚:tree attention mask、临时 KV Cache、batch 调度和 draft head 校准,任何一个环节做粗糙,论文里的速度提升都会在系统里打折。
从 EAGLE 到 EAGLE-2,路线变化其实很自然。EAGLE 解决“草稿 token 从哪里来”,EAGLE-2 解决“草稿预算花在哪里”。前者是模型侧的表征对齐,后者是推理侧的上下文感知调度。投机解码真正进入生产系统时,这两个问题缺一不可。
参考资料
- EAGLE-2: Faster Inference of Language Models with Dynamic Draft Trees
- EAGLE-2 arXiv:2406.16858
- SafeAILab/EAGLE 官方实现
- EAGLE: Speculative Sampling Requires Rethinking Feature Uncertainty
- Fast Inference from Transformers via Speculative Decoding
- SGLang Speculative Decoding Documentation
- vLLM Speculators Documentation
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
音乐
暂未播放


