


vLLM 源码完全拆解(五):GPUModelRunner 如何把动态请求拼成一次 GPU 前向
从物理 Block ID 走向模型前向
前四篇已经依次建立了 vLLM 的整体模块地图、追踪了 一次请求如何穿过 V1 引擎,拆开了 Scheduler.schedule() 的预算决策,又沿 KVCacheManager 的分配链路 走到 Worker 入口。控制面此时已经回答了两个问题:本轮每个请求算多少 token,以及这些 token 使用哪些物理 KV block。GPU 仍然不能直接执行,因为它还缺一份真正可被模型和 Kernel 消费的输入。
例如,Scheduler 可能给出下面这份计划:请求 A 做 2 个 token,请求 B 做 5 个 token,请求 C 做 3 个 token。A 是 decode,B 是分块 prefill,C 可能刚命中一段前缀。Worker 必须把三条长度不同、历史位置不同、block table 不同的序列变成:
- 一条连续的
input_ids; - 与每个 token 一一对应的
positions; - 标出每个请求在连续 token 流中边界的
query_start_loc; - 从逻辑位置翻译到物理 KV 槽位的
block_table与slot_mapping; - 足以让不同注意力后端构造 Kernel 参数的 metadata。
这项工作由 GPUModelRunner 和它持有的 InputBatch 完成。vLLM 源自 UC Berkeley 团队 2023 年发表于 SOSP 的 PagedAttention 工作;V1 架构在 2024 年开始公开设计,随后把 Scheduler、KV Cache Manager 与 Worker 的职责进一步拆开。本文继续固定在前两篇使用的 vLLM main 分支提交 3b4566c5,避免快速演进的源码让类名和路径彼此错位。
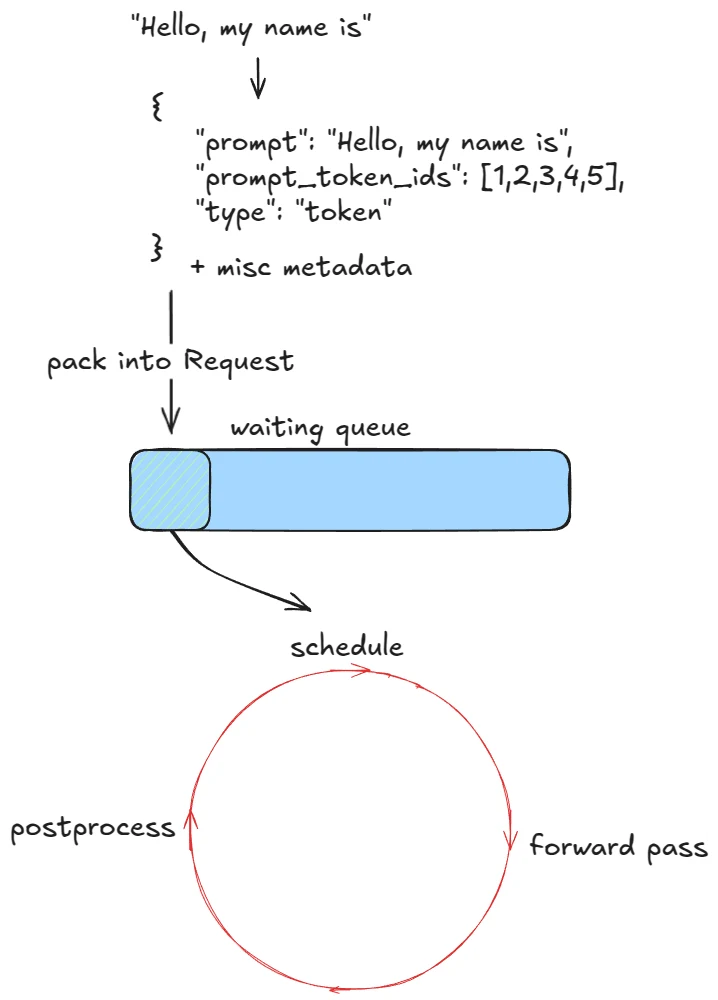
图源:Inside vLLM: Anatomy of a High-Throughput LLM Inference System。红色循环中的 forward pass 并不只是一行 model():在它之前,Worker 还要把调度结果更新到持久批次、构造输入张量和注意力元数据;在它之后,才会选择 hidden state、计算 logits 并采样。
本文聚焦这条热路径:
SchedulerOutput -> GPUModelRunner._update_states() -> InputBatch 持久状态更新、删除与压紧 -> GPUModelRunner._prepare_inputs() -> 扁平 input_ids / positions / query_start_loc -> block table / slot mapping -> CommonAttentionMetadata -> 各 attention backend 的 metadata builder -> model forward注意边界:本文会解释 metadata 中每个关键量为什么存在,以及它怎样被构造;FlashAttention、FlashInfer 或 PagedAttention Kernel 如何读取这些量,将留到后续文章。先把“请求对象怎样变成一次 GPU 前向”讲清,进入 Kernel 时才不会把地址翻译、批次布局和注意力算法混成一团。
GPUModelRunner 的职责边界
GPUModelRunner 位于 Worker 内部,是控制面计划和模型数据面之间的适配层。它不决定谁先运行——那是 Scheduler 的职责;它也不决定哪个请求获得哪个物理 block——那是 KV Cache Manager 的职责。它负责兑现已经作出的计划,并把高层状态翻译成 GPU 可以高效消费的张量。
在固定提交中,execute_model() 的主干可以压缩为:
def execute_model(scheduler_output): update_states(scheduler_output)
num_scheduled = tokens_per_request(input_batch) logits_indices, spec_meta, max_sampled = prepare_inputs( scheduler_output, num_scheduled, )
execution_shape = choose_cuda_graph_or_eager_shape(...) slot_mappings = get_slot_mappings(execution_shape) attn_metadata = build_attention_metadata( slot_mappings=slot_mappings, ..., )
input_ids, positions, model_kwargs = preprocess(...) hidden_states = model(input_ids, positions, **model_kwargs) logits = model.compute_logits(hidden_states[logits_indices]) save_state_for_sampling(logits, ...)真实函数还要兼容流水线并行、多模态 encoder、LoRA、投机解码、混合 KV Cache、远程 KV Connector、CUDA Graph 与 microbatch,因此超过“准备三个张量再调用模型”的朴素想象。第一次读源码时应抓住四个稳定阶段。
阶段一:把差量计划合并到 Worker 状态
Engine Core 不会在每轮发送每个请求的完整 prompt、全部输出 token 和完整 block table。scheduled_new_reqs 为首次进入 Worker 的请求提供完整启动状态;scheduled_cached_reqs 只携带已经驻留请求的变化,例如新增 block IDs、更新后的已计算 token 数和新增 token。finished_req_ids 则通知 Worker 删除状态。
GPUModelRunner._update_states() 把这些差量合并进 CachedRequestState 与 InputBatch。这里的“cached”不是前缀缓存,而是“Worker 已经保留了这个请求的执行状态”。区分这两个概念很重要:前缀缓存复用的是 K/V 内容,Worker request cache 复用的是 Python 与批次元数据。
阶段二:构造本轮紧凑输入
_prepare_inputs() 根据每个请求本轮的 token 数,把二维的“请求 × 历史位置”视图抽取成一维 token 流。它同时计算位置、请求边界、最终序列长度、需要取 logits 的位置和 KV 写入槽位。连续批处理不要求所有序列等长,也不需要把短序列右侧补到最长序列;自定义注意力 Kernel 根据边界 metadata 区分序列。
阶段三:决定执行形状
动态 batch 的真实 token 数不一定正好命中已捕获的 CUDA Graph 形状。Runner 会决定使用 eager、piecewise graph 还是 full graph,并在需要时把 token 数或请求数 padding 到捕获形状。padding 是执行容器的形状要求,不代表虚构 token 可以读写真实请求的 KV;对应槽位必须映射到保留的 padding/null block,相关长度也必须保持合法。
阶段四:前向、选取 hidden state 与采样交接
模型对扁平 token 流产生 hidden states。普通非投机路径并不需要对每个 prefill token 都计算输出 logits,通常用 query_start_loc[1:] - 1 找到每个请求本轮最后一个 token 的 hidden state,再送入 compute_logits()。分块 prefill 尚未覆盖完整 prompt 的请求即使产生了临时 logits,也会通过 discard mask 丢弃,不让它提前生成可见 token。
由此可以得到一句准确的职责描述:GPUModelRunner 不是“模型 forward 的薄包装”,而是本轮执行事务的数据编译器。它把稀疏、变化的请求状态编译成紧凑、地址明确、形状可执行的 GPU 工作集。
InputBatch:动态请求的持久化工作集
如果每一轮都从 SchedulerOutput 重建所有请求的 token 历史、采样参数和 block table,decode 热路径会反复处理几乎相同的数据。连续批处理的常见情况是:上一轮的 256 个请求中只有少量完成,又补入少量新请求,其余请求只是各前进一个 token。InputBatch 正是针对这种高重叠场景设计的持久批次。
它并不是传给模型的一次性 batch。它跨 step 存活,保存请求到行号的映射、每行的完整 token 历史、已计算位置、block table 和采样配置。_prepare_inputs() 再从这份工作集中抽取本轮真正要算的 token。
CachedRequestState 与 InputBatch 为什么同时存在
CachedRequestState 是按 request ID 组织的对象视图,保存:
class CachedRequestState: req_id: str prompt_token_ids: list[int] | None block_ids: tuple[list[int], ...] num_computed_tokens: int output_token_ids: list[int] sampling_params: SamplingParams | None # 还包括多模态、LoRA、M-RoPE、pooling 等状态InputBatch 则是按紧凑 batch row 组织的列式视图。它预分配形如 [max_num_reqs, max_model_len] 的 CPU token 表,以及长度为 max_num_reqs 的计数、采样参数和映射数组。两者用途不同:
| 视图 | 适合的操作 | 代价特征 |
|---|---|---|
dict[req_id, CachedRequestState] | 按 ID 查找、增量追加 token、处理恢复与特性状态 | 灵活,但不适合直接批量搬到 GPU |
InputBatch 的连续数组 | 按 batch row 批量索引、H2D 拷贝、构造 Kernel 输入 | 紧凑,但行移动时所有列必须一起维护 |
这是一种典型的双重表示:对象视图服务控制逻辑,列式视图服务数值热路径。它不是保存两份独立真相;_update_states() 必须保证二者同步。
行号是一种短生命周期地址
InputBatch 维护 _req_ids 与 req_id_to_index:前者把 row 映射回请求,后者把请求映射到 row。行号只在当前批次布局中有效。请求完成或被抢占后,该行可能被新请求复用;condense() 还会把尾部活跃请求移动到前面的空洞。
假设批次行最初是:
row 0 -> Arow 1 -> Brow 2 -> Crow 3 -> DB 完成后,remove_request("B") 清理 row 1;condense() 可以把 D 从 row 3 移到 row 1:
row 0 -> Arow 1 -> Drow 2 -> C移动不能只改 _req_ids。token 历史、num_computed_tokens、采样参数、LoRA mapping、生成器、block table 和投机解码状态都要同步移动。源码的 swap_states() 与 move_row() 很长,原因正是 row 是多列状态的共同主键。漏移动一列不会立即报 Python 类型错误,却可能让请求 D 使用 B 的温度、block IDs 或停止约束。
为什么删除后还要压紧
紧凑前缀 [0, num_reqs) 带来三个收益:
- GPU 只需复制有效的前若干行,不必传递稀疏索引表;
np.repeat(arange(num_reqs), num_scheduled_tokens)可以直接生成 token 到请求的映射;- CUDA Graph 和注意力 metadata 可以用连续 batch 维度描述执行形状。
代价是请求离开时可能发生行移动。vLLM 选择“控制面偶尔搬一行,数值面始终紧凑”,因为 decode 的数值热路径每一步都执行,而完成请求导致的压紧只在批次成员变化时发生。
从 SchedulerOutput 更新 Worker 状态
_update_states() 的执行顺序不是普通的容器维护,而是在跨进程差量协议下维持所有权。可以把它分为“删、改、加、压”四步。
先删除完成和本轮未调度的请求
函数先从 self.requests 与 InputBatch 删除 finished_req_ids。随后计算本轮未调度集合:
unscheduled= 已在 InputBatch 中的请求- 本轮计划执行且不是强制恢复的请求未调度请求可能被抢占,也可能只是本轮没有获得预算。Runner 会把它从 persistent batch 移除,但通常保留 CachedRequestState,因为它未来还可能再次被调度。也就是说:
- 从
InputBatch移除,表示它不参加当前紧凑 GPU 工作集; - 从
self.requests移除,表示 Worker 不再保留这个请求的执行对象。
二者不能混用。若每次未调度都删除完整 request state,恢复时就只能重传全部历史;若已经结束却只移出 batch、不删对象,就会造成状态泄漏。
新请求建立完整状态
对 scheduled_new_reqs,Runner 创建 CachedRequestState,记录 prompt、初始 block IDs、前缀命中后的 num_computed_tokens、采样参数与可选的多模态/LoRA 信息。之后 InputBatch.add_request() 把它展开到连续数组:复制 prompt token,写入计数,安装 block-table row,并登记采样参数。
值得留意的是,命中过前缀的新请求仍然需要完整 prompt token 历史。虽然命中位置之前的 token 本轮不再送进模型,但后续的重复惩罚、logits processor、调试和某些恢复路径仍可能读取历史。num_computed_tokens 决定从哪里继续计算,不等于可以丢掉之前的 token IDs。
驻留请求只合并差量
对 scheduled_cached_reqs,常见路径只做三件事:
req_state.num_computed_tokens = num_computed_tokens
for old_ids, new_ids in zip(req_state.block_ids, new_block_ids): old_ids.extend(new_ids)
input_batch.num_computed_tokens_cpu[row] = num_computed_tokensinput_batch.block_table.append_row(new_block_ids, row)若请求由抢占恢复,旧 block IDs 已经失效,不能 append,而要整体替换。这个分支与上一篇的所有权规则直接衔接:控制面已经把旧块归还池中,Worker 不能保留看似合法但内容属于其他请求的物理 ID。
最后压紧并刷新派生 metadata
所有删除和新增完成后,condense() 填补空洞;attention backend 还可以在 _may_reorder_batch() 中为了执行效率重排请求。最后 refresh_metadata() 更新采样相关张量和变更记录。
顺序的核心约束是:先完成所有会改变 row 的操作,再按稳定后的 row 布局准备本轮输入。若先生成 req_indices,随后再 condense,token 到请求的映射会整体错位。
把变长请求压成一条 Token 流
Transformer 的数学表达常写成 [batch, sequence, hidden],容易让人以为同一批中的序列必须补齐到相同长度。在线推理恰好不适合这么做:一个 decode 请求本轮只算 1 个 token,一个 chunked prefill 请求可能算 1024 个 token。若都 padding 到 1024,decode 行的绝大多数计算都是空转。
vLLM 把本轮所有有效 token 沿第 0 维串联,形成一条“super sequence”。不同请求之间并没有真的互相可见;query_start_loc、序列长度、因果规则与后端 metadata 共同恢复边界。
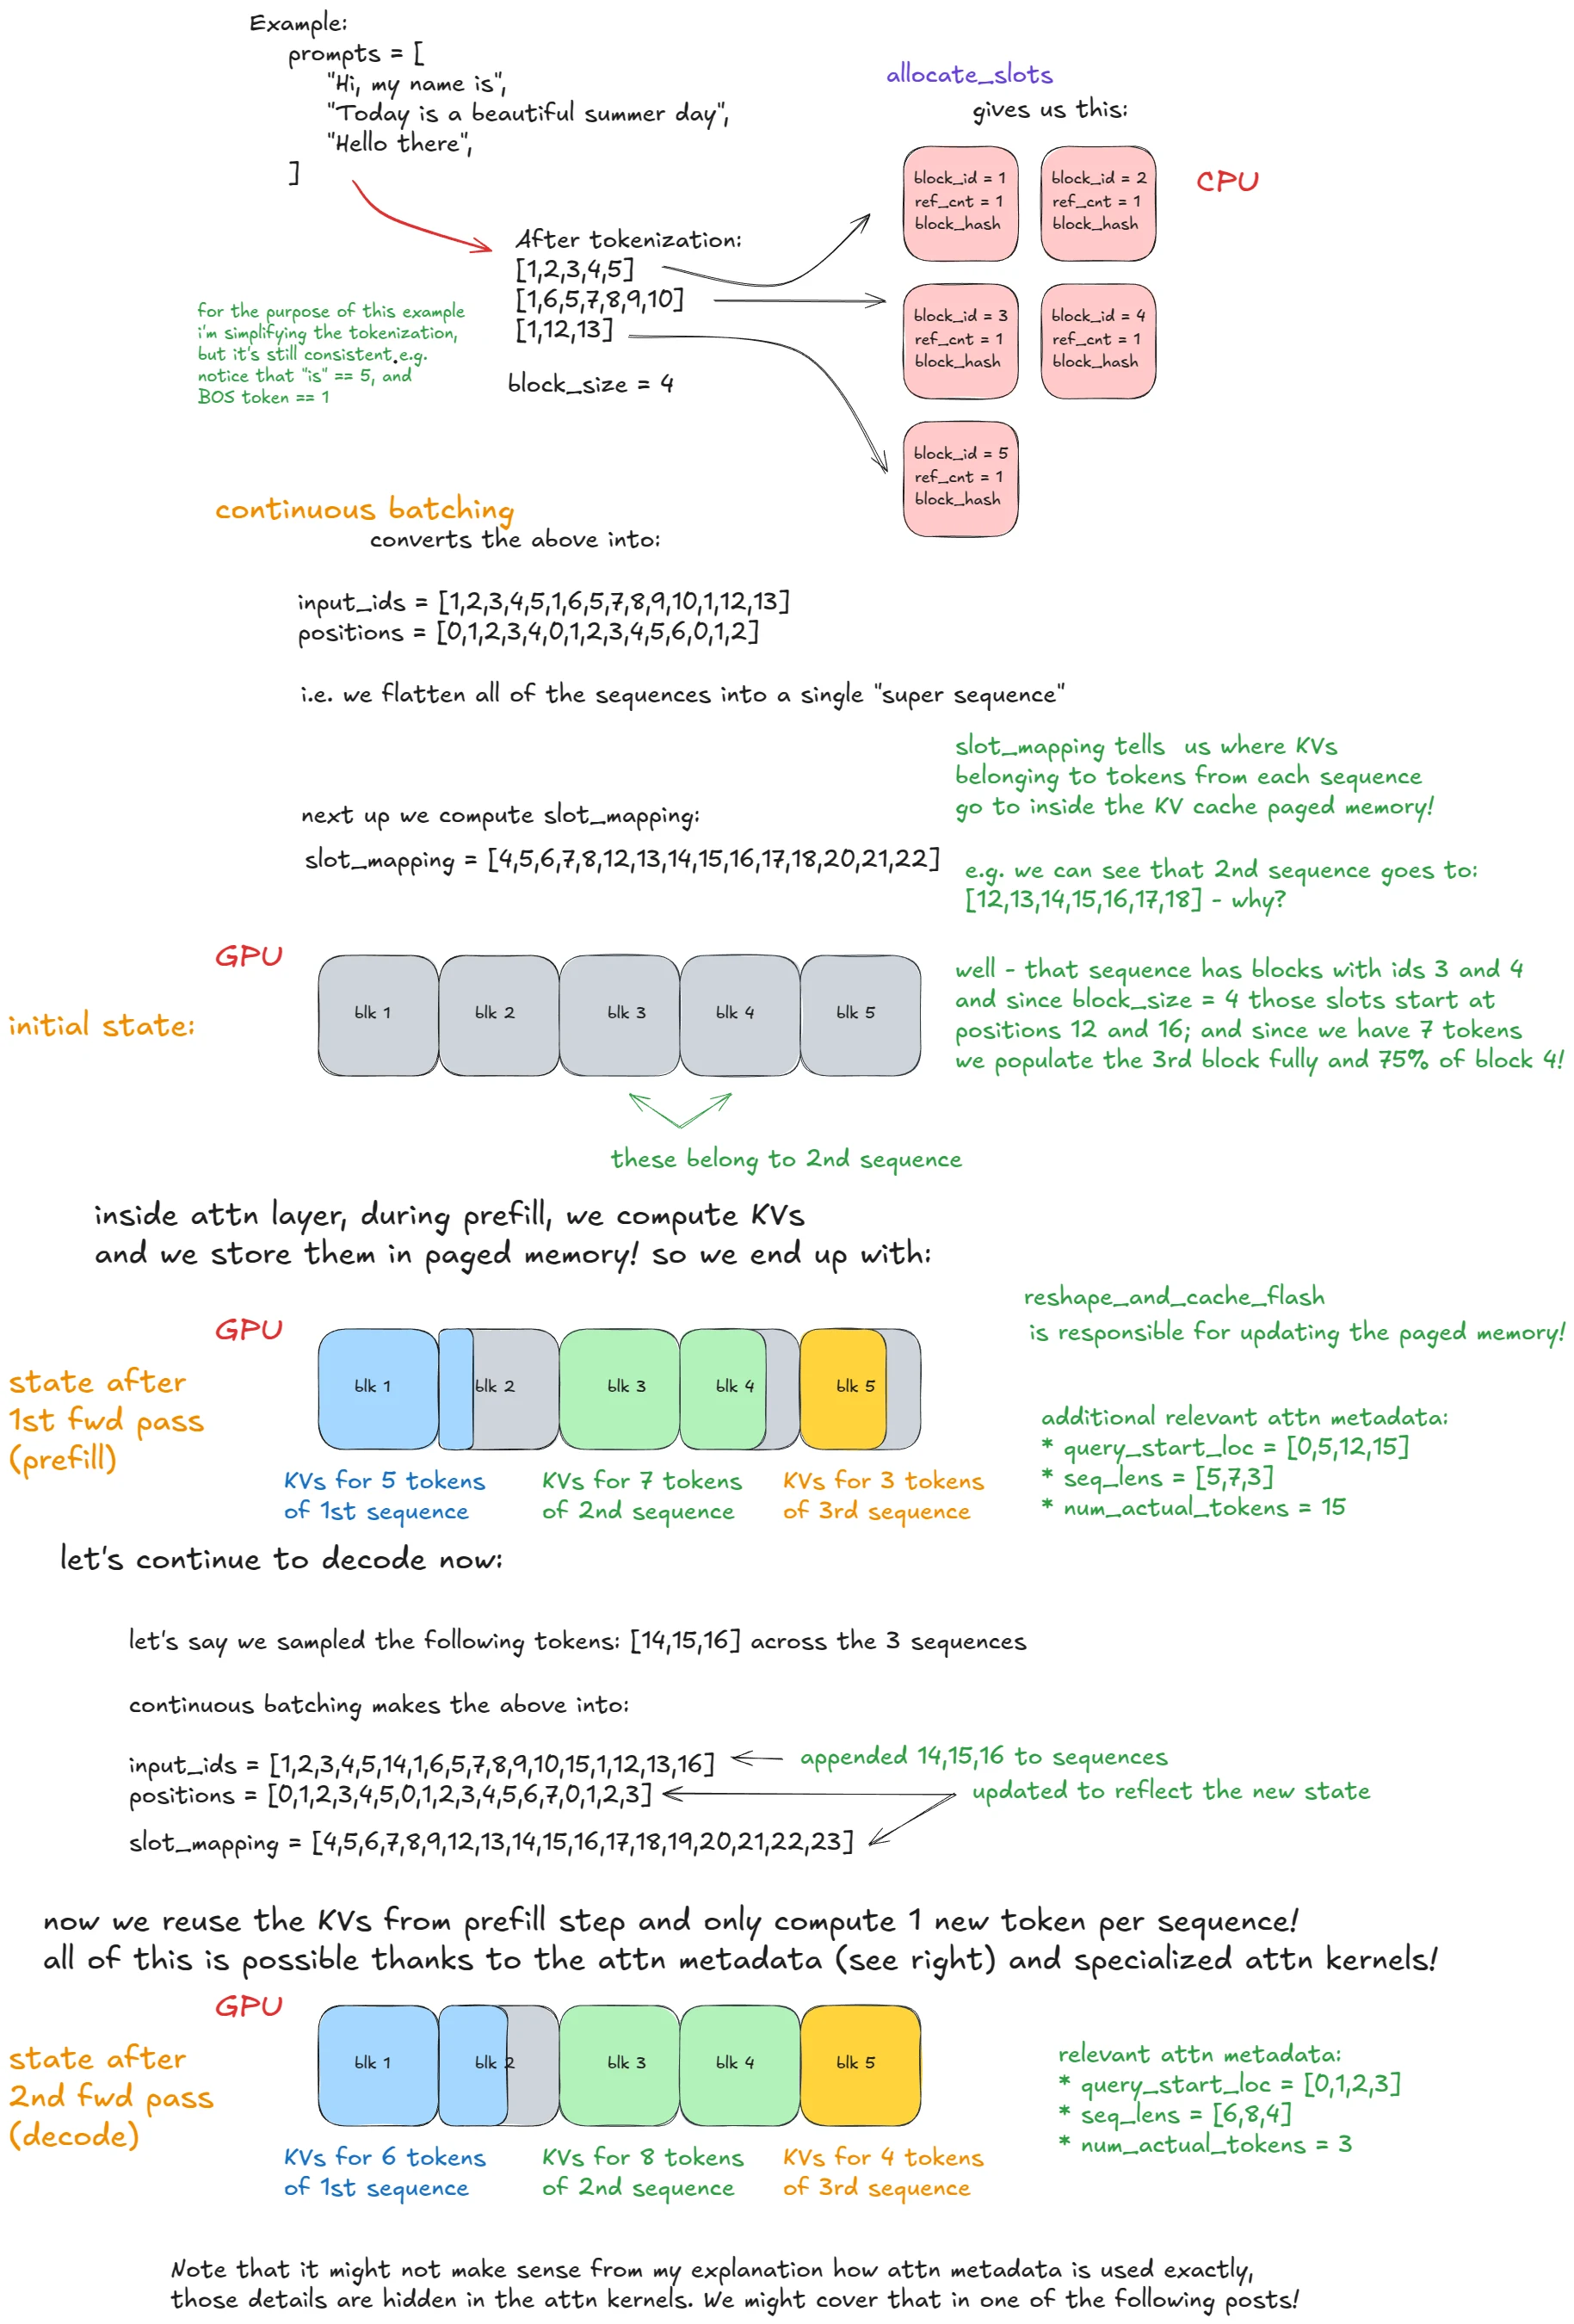
图源:Inside vLLM: Anatomy of a High-Throughput LLM Inference System。图从三个不同长度的 prompt 出发,展示了 input_ids、positions、slot_mapping 与分页 KV Cache 的关系;第二轮 decode 只追加每个请求的新位置,不再重算整段 prompt。
第一步:从每请求 token 数得到边界
设当前紧凑批次共有 个请求,第 个请求本轮被调度 个 token。扁平流的总长度为:
query_start_loc 是长度为 的前缀和数组:
因此请求 在扁平流中占据半开区间 。源码中的 _get_cumsum_and_arange() 同时构造累计和与请求内偏移。对 num_scheduled_tokens=[2,5,3]:
query_start_loc = [0, 2, 7, 10]query_pos = [0, 1, 0, 1, 2, 3, 4, 0, 1, 2]req_indices = [0, 0, 1, 1, 1, 1, 1, 2, 2, 2]三个数组回答不同问题:query_start_loc 让 Kernel 找到每个请求的区间;query_pos 表示 token 在本轮 chunk 内的相对位置;req_indices 表示扁平位置属于哪一个 batch row。
第二步:相对位置加已计算长度得到模型位置
设请求 在本轮开始前已经有 个 token 完成计算。其第 个本轮 token 的模型位置为:
源码的向量化形式正是:
positions = num_computed_tokens[req_indices] + query_posseq_lens = num_computed_tokens + num_scheduled_tokenspositions 是逐 token 数组,长度为 ;seq_lens 是逐请求数组,长度为 。两者不能互换。前者告诉 RoPE 和 KV 写入“当前 token 在整个请求中的绝对位置”,后者告诉注意力后端“算完本轮后,这条序列有效到哪里”。
第三步:从二维 token 历史抽取本轮切片
InputBatch.token_ids_cpu 的形状近似 [max_num_reqs, max_model_len]。第 行保存请求的 token 历史,但模型只需要位置 到 。Runner 将二维下标线性化:
是 max_model_len, 是展平 CPU token 表后的下标。源码用 torch.index_select() 一次性取出这些位置,写进预分配的 pinned CPU buffer,再异步复制到 GPU。这样不需要为每个请求创建一个临时 tensor,也不需要执行 Python 层的逐 token append。
为何不把每条请求的本轮切片先放进 list,再 torch.cat()?因为 decode 每轮都执行,频繁创建小 tensor、分配拼接输出和触发 Python 调度会造成明显的 CPU 开销。预分配 buffer 加索引抽取让内存地址稳定,也为 CUDA Graph 提供固定输入容器。
第四步:只在必要位置计算 logits
普通生成路径中,每个请求只需要本轮最后位置的 logits。因此:
对 [2,5,3],索引是 [1,6,9]。模型仍为全部 10 个 token 计算 hidden state,因为 prefill 的每个位置都要生成 K/V;但 LM head 只处理选中的 hidden states,避免对词表维度做无用的大矩阵乘。
分块 prefill 带来一个细节:某请求的当前 chunk 可能还没覆盖完整 prompt,此时最后位置的 logits 不能作为生成结果。实现为了保持批次形状简单,可能仍计算并采样,再通过 discard_request_mask 丢弃。这里的额外小开销换来统一路径;正确性依赖 discard mask,而不是假设“批中所有请求都到了 decode”。
投机解码则不只取一个位置。验证 个 draft token 需要多个 logits,SpecDecodeMetadata 会构造更丰富的 logits_indices。但底层原则不变:hidden-state 计算覆盖本轮实际 token,词表投影只覆盖需要作决策的位置。
Block Table、Slot Mapping 与注意力元数据
扁平 token 流解决了计算输入布局,却没有回答 K/V 写到哪里。上一篇已经从 Manager 侧得到每个请求的物理 block IDs;这一篇要把它翻译成逐 token 的物理槽位。
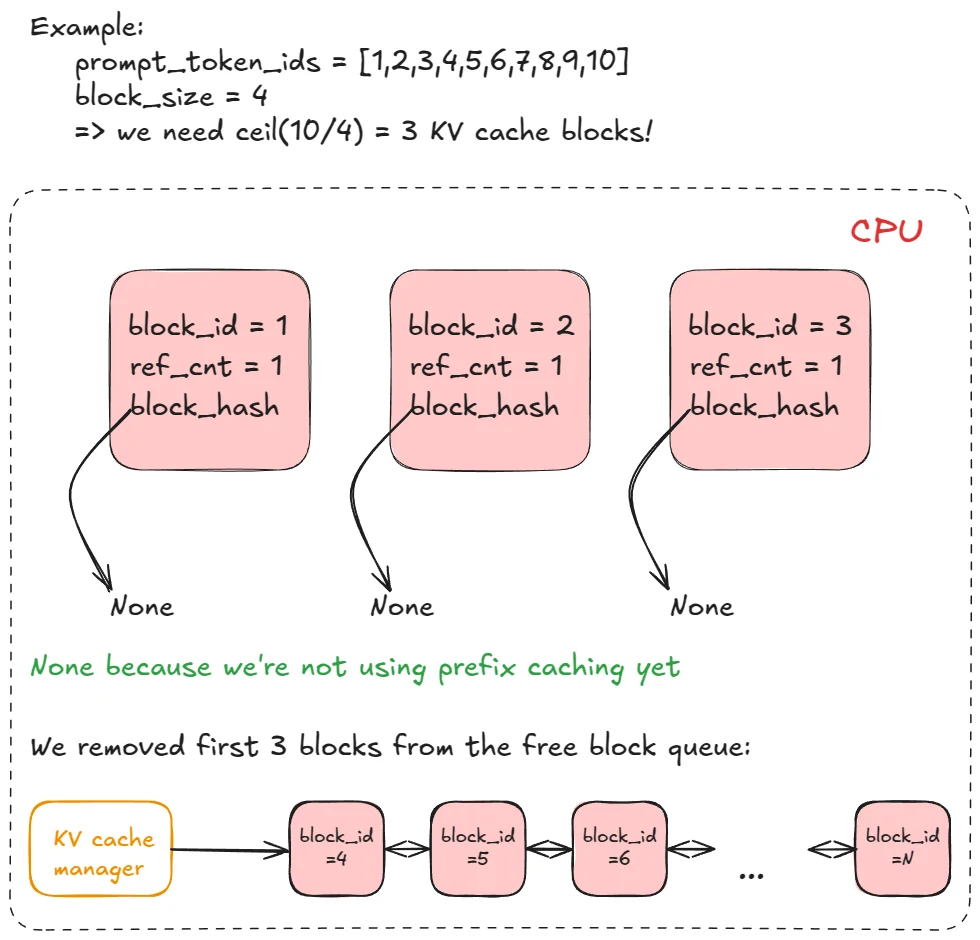
图源:Inside vLLM: Anatomy of a High-Throughput LLM Inference System。Engine Core 管理图中的 block ID 与引用关系;Worker 按相同 ID 寻址真实 KV 张量。InputBatch.block_table 是两个世界的交接面。
Block table 是逐请求的页表
对 block size 为 的普通注意力 cache group,请求位置 所属的逻辑块与块内偏移为:
若该请求 block-table row 的第 项为物理 block ID ,最终物理槽位为:
block table 是二维的“请求 × 逻辑块”映射;slot mapping 是长度为本轮 token 数的一维数组。前者在一个请求跨很多 step 时持续增长,后者每轮按实际 token 重新计算。
BlockTable 同时维护 CPU 镜像与 GPU tensor。新请求使用 add_row() 安装完整 row;驻留请求使用 append_row() 加入新增 block IDs;完成或抢占则 clear_row()。commit_block_table(num_reqs) 只把有效前缀复制到 GPU。
_prepare_inputs() 一进入就先启动这次 H2D 拷贝,然后继续在 CPU 上计算 req_indices、累计和和 token 索引。这个顺序是在做流水重叠:PCIe/NVLink 拷 block table 的同时,CPU 准备其余 metadata。如果把 commit_block_table() 放到所有 Python/NumPy 工作之后,GPU 只能额外等待一段串行拷贝时间。
Slot mapping 为什么用 GPU Kernel 计算
逐 token 的位置和 block table 都已经在 GPU 上,源码用 Triton Kernel 计算 slot mapping。每个 program 负责一个请求,先从 query_start_loc 取本请求的扁平区间,再对其中每个 positions 做页表翻译。
简化后的逻辑是:
for request in batch: start = query_start_loc[request] end = query_start_loc[request + 1]
for flat_idx in [start, end): pos = positions[flat_idx] logical_block = pos // block_size offset = pos % block_size physical_block = block_table[request, logical_block] slot_mapping[flat_idx] = physical_block * block_size + offset真实 Kernel 还处理 decode context parallelism、manager block 与 kernel block 粒度不一致、padding slot 等情况。把计算放在 GPU 上有两个直接原因:避免把 positions 或 block table 再搬回 CPU;避免 Python 对大量 token 做逐项地址翻译。
某些 Mamba/GDN cache group 使用递归状态索引,不使用逐 token KV slot,此时 SlotMappingMode.NONE 会跳过映射。统一接口保留了多 group 结构,但不能假设每组缓存都是传统 K/V 页。
query_start_loc 与 seq_lens 各管什么
这两个数组经常同时出现,却描述不同坐标系:
| 字段 | 例子 | 回答的问题 |
|---|---|---|
query_start_loc | [0, 2, 7, 10] | 本轮扁平 query 中每个请求从哪里开始、到哪里结束 |
seq_lens | [102, 25, 4099] | 加上历史 KV 后,每个请求的完整有效上下文有多长 |
positions | [100,101,20,...] | 每个本轮 token 在自己请求内处于哪个模型位置 |
block_table | 每行若干物理 block IDs | 历史与新增 KV 分布在哪些物理页 |
slot_mapping | 每个本轮 token 一个 slot | 新产生的 K/V 应写到哪个物理槽位 |
仅有 query_start_loc,Kernel 知道 query 的边界,却不知道每条 query 能读取多少历史 K/V;仅有 seq_lens,Kernel 知道上下文长度,却不知道扁平输入中哪些 token 属于同一请求。两者组合才完整描述变长批次。
Common metadata 与 backend metadata 的两级抽象
GPUModelRunner._build_attention_metadata() 先构造 CommonAttentionMetadata。固定提交中的关键字段包括:
CommonAttentionMetadata( query_start_loc=..., seq_lens=..., num_reqs=..., num_actual_tokens=..., max_query_len=..., max_seq_len=..., block_table_tensor=..., slot_mapping=..., causal=True, is_prefilling=..., positions=...,)这不是最终某个 CUDA Kernel 的参数对象,而是后端无关的公共事实。随后每个 attention group 取得自己的 metadata builder:
attn_metadata_i = builder.build( common_prefix_len=cascade_prefix_len, common_attn_metadata=common_metadata,)同一个 cache group 内若多层使用相同后端与缓存规格,可以共享构造结果;混合模型的不同 cache group 则替换各自的 block table、slot mapping 与 encoder length,再调用对应 builder。这个两级结构把“批次是什么样”与“某后端怎样调用 Kernel”分开:ModelRunner 只构造一次公共语义,FlashAttention、FlashInfer 或其他后端负责降到自己的布局。
这也解释了系列为何要把 GPUModelRunner 和 Attention Backend 拆成两篇。本篇的终点是 builder.build() 的输入;下一篇的起点是不同 builder 如何把公共字段转为具体 Kernel 所需的 cu_seqlens、page table、workspace 与调度信息。
一次混合 Prefill/Decode 的完整推演
用一个具体批次把所有数组串起来。设 block size ,当前有三个请求:
| 请求 | 含义 | num_computed_tokens | 本轮调度数 | block table |
|---|---|---|---|---|
| A | 普通 decode | 5 | 1 | [7, 2] |
| B | 新请求的首个 prefill chunk | 0 | 3 | [5] |
| C | 后续 prefill chunk | 8 | 2 | [1, 8, 4] |
为了突出地址关系,token ID 用符号表示。三条请求在 InputBatch.token_ids_cpu 中各有自己的历史行。本轮抽取:
A 取位置 [5] -> [a5]B 取位置 [0,1,2] -> [b0,b1,b2]C 取位置 [8,9] -> [c8,c9]1. 扁平化
num_scheduled_tokens = [1, 3, 2]req_indices = [0, 1, 1, 1, 2, 2]query_pos = [0, 0, 1, 2, 0, 1]query_start_loc = [0, 1, 4, 6]input_ids = [a5, b0, b1, b2, c8, c9]这里没有补齐。A 只占 1 个扁平位置,B 占 3 个,C 占 2 个。
2. 模型位置与完整序列长度
positions = [5, 0, 1, 2, 8, 9]seq_lens = [6, 3, 10]A 的 query 位于模型位置 5,算完后有效长度为 6;C 已经有 8 个历史位置,本轮 query 从位置 8 开始,算完后有效长度为 10。
3. 物理 KV 槽位
A 的位置 5 属于逻辑块 1,block_table[A,1]=2,块内偏移为 1,因此 slot 为 。
B 的三个位置都在逻辑块 0,物理 block 为 5,因此 slots 为 20、21、22。
C 的位置 8、9 属于逻辑块 2,物理 block 为 4,因此 slots 为 16、17。
最终:
slot_mapping = [9, 20, 21, 22, 16, 17]这组数与 input_ids、positions 一一对齐。模型在某层算出六组新 K/V 后,缓存写入 Kernel 不必再追踪 request ID,只需让第 组 K/V 写入 slot_mapping[t]。
4. 注意力读取边界
A 的 query 只属于 A,并可读取 A 的有效历史;B 的三段 query 只在 B 内按因果顺序互相可见;C 的两个 query 可以读取 C 已有的 8 个历史位置,并在本轮内部保持因果关系。它们虽然物理上被串成一条 token 流,但 metadata 不允许跨请求注意。
可以把每条请求的可见 Key 长度写成:
其中 是本轮前已计算长度, 是本轮请求内 query 偏移。A 的唯一 query 可见长度为 6;B 的三个 query 分别为 1、2、3;C 的两个 query 分别为 9、10。实际后端可能用 seq_lens、累计 query 边界和因果标记隐式表达这组关系,而不是显式构造一个巨大的布尔 mask。
5. logits 选择与丢弃
普通路径的 logits_indices=query_start_loc[1:]-1=[0,3,5]。A 的 index 0 可用于产生下一个 token。若 B 的完整 prompt 长度大于 3,index 3 对应的结果必须丢弃,因为 B 仍处于中途 prefill;C 同理,只有当位置 9 已覆盖其当前全部输入时才允许采样。
这个例子揭示了连续批处理的实质:不是把请求强行变成相同长度,而是把有效工作压紧,再用少量结构化 metadata 恢复逻辑边界、历史长度与物理地址。
四类高级路径怎样复用同一骨架
gpu_model_runner.py 篇幅很长,很大一部分来自高级特性的组合。若按功能逐个追分支,很容易失去主线;更有效的读法是观察它们分别修改了持久状态、扁平 token 流、缓存地址还是执行形状。下面四类路径都没有推翻“差量更新—扁平化—地址翻译—构造 metadata—forward”这套骨架。
Chunked Prefill:query 很长,但仍只是一段区间
对长度为 10000 的 prompt,Scheduler 可能本轮只给它 2048 个 token。Worker 不需要保存“这是第几个 prefill chunk”的独立阶段枚举:
num_computed_tokens表示 chunk 起点;num_scheduled_tokens表示 chunk 长度;positions自然成为从起点连续增长的区间;num_computed_tokens < num_prompt_tokens让is_prefilling保持为真;discard_request_mask阻止未完成 prompt 的临时 logits 变成输出。
下一轮起点前移,完全复用相同逻辑。这里尤其不能用“query length 为 1”判断 decode:投机解码或短 extend 都可能让 query 很短,但请求仍处于其他语义阶段。固定提交直接比较已计算长度和 prompt 长度,保留了更可靠的状态依据。
投机解码:一条请求一轮可能产生多个决策位置
普通 decode 每个请求本轮通常输入 1 个 token,并从最后 hidden state 产生 1 组 logits。投机解码把 target model 当验证器,一次输入上轮采样 token 与若干 draft token。于是三个量发生变化:
num_scheduled_tokens不再固定为 1;logits_indices要覆盖多个验证位置;- 结果提交时只接受通过验证的前缀,乐观计数可能回滚。
InputBatch.spec_token_ids 把 draft token 临时接在普通 token 之后,SpecDecodeMetadata 保存请求到验证位置的展开关系。同步路径可在 CPU 状态确认接受数后推进;异步路径为了让下一轮尽早开始,会先按全部接受乐观推进,再依据 GPU 上的有效采样计数修正 num_computed_tokens。
为什么修正不能只改 Python 对象?因为位置、seq length、Mamba state 索引和后续 slot mapping 都可能已经依据乐观值准备。源码为 current row 到 previous row 建立映射,并在 GPU 上校正计数,目的就是避免一次 D2H 同步打断流水。高级分支看似复杂,守住的仍是同一不变量:位置计数必须与实际有效 KV/状态一致。
混合 KV Cache:一条请求不止一张页表
普通全注意力模型只有一个 cache group,block_table 可以近似理解为单张页表。混合模型可能把 full attention、sliding window 与 Mamba 层交错,每组有不同 block size 和 slot 语义。MultiGroupBlockTable 因而保存多张表:
request row group 0 -> full-attention block IDs group 1 -> sliding-window block IDs group 2 -> recurrent-state block IDsRunner 对每组分别 commit_block_table(),并按 SlotMappingMode 决定是否生成逐 token slot。_build_attention_metadata() 以 group 0 构造公共模板,再为其他组替换 block table、slot mapping 和可能不同的 encoder length。
若多个 group 使用相同的 KV spec 和 builder 类型,metadata builder 的结果可以复用,只更新 block table 与 slot mapping;若语义不同,则必须重新 build。这里的缓存不是为了改变结果,而是避免同一批次中为多层反复执行相同 Python metadata 构造。
上一节公式中的 因而只适用于单个 cache group。manager block size 与 Kernel block size不同时,一项 manager block ID 还会展开成多个 kernel block IDs。例如 32-token manager block 面向 16-token Kernel 时:
manager IDs [0, 1, 2] -> kernel IDs [0, 1, 2, 3, 4, 5]不能在 Runner 外部看到 block ID 为 2,就直接假定 Kernel 页号也是 2;必须先经过 map_to_kernel_blocks() 定义的粒度转换。
多模态与流水线并行:输入载荷变化,边界协议不变
多模态请求可能在 token 序列中放置图像占位位置,再由 encoder 输出替换为 embedding。InputBatch 不预先分配一个 [max_num_reqs, max_model_len, hidden_size] 的巨型 embedding 表,而是按请求保存 prompt embeddings;本轮抽取时才把需要的片段写入预分配执行 buffer。
纯文本路径尽量把 input_ids 直接交给模型,让 embedding layer 也进入可编译或可捕获的 forward。只有确实存在多模态 embedding 或外部 prompt embedding 时,Runner 才在模型外构造 inputs_embeds。这个分支体现了一个性能原则:统一 API 不等于强迫所有请求走最昂贵的数据形态。
流水线并行的非首 stage 不消费原始 token embedding,而是接收前一 stage 的 intermediate tensors;非末 stage 也不负责最终 logits 与采样。但每个 stage 仍必须共享本轮请求顺序和位置语义,否则同一批的中间激活会与本地 KV Cache 行错位。Runner 因而在模型前向载荷上分支,在 batch row、positions 和 attention metadata 上保持一致协议。
为什么不显式构造巨大 Attention Mask
朴素实现可以为扁平后的 个 query 和所有历史 Key 构造一个二维布尔 mask,屏蔽跨请求位置和未来位置。这个方案在长上下文中会额外消耗大量显存与带宽,而且 mask 多数元素只是在重复表达“请求边界”和“因果顺序”。
vLLM 传递 query_start_loc、seq_lens、block table 与 causal=True,让注意力后端在 Kernel 内隐式生成合法访问范围。metadata 的规模接近请求数、实际 token 数和 block-table 大小之和,而不是完整注意力矩阵的面积。后端接口的价值不只在兼容不同 Kernel,也在于把紧凑的结构描述保留到真正执行注意力的位置。
热路径中的 CPU/GPU 数据搬运
理解数据搬运,才能解释 InputBatch 为什么同时出现 Python list、NumPy view、CPU tensor、pinned buffer 和 GPU tensor。它们不是随意堆叠的实现细节,而是在解决三个互相冲突的需求:控制面要容易修改,H2D 要异步,CUDA Graph 又要求地址稳定。
大历史留在普通 CPU 内存,小热集放进 pinned buffer
完整 token_ids_cpu_tensor 的形状是 [max_num_reqs, max_model_len]。长上下文和大并发下,这个矩阵可能很大;源码明确不把它整体 pin 住。锁页内存不能被操作系统换出,过度使用会压缩系统可分页内存,并不适合装下所有请求的最大历史容量。
Runner 另有按 max_num_batched_tokens 预分配的本轮输入 buffer。每一步只从大历史表抽取 个有效 token 到较小的 pinned CPU 区,再发起 non-blocking H2D。这个分层可概括为:
完整历史:普通 CPU tensor,容量按请求数 × 最大长度本轮热集:pinned CPU buffer,容量按单轮 token budget执行输入:GPU buffer,地址长期稳定这种设计避免把“模型能支持的最大上下文”直接转化为同等规模的锁页内存,也避免每轮为实际 batch 新建 GPU tensor。
为什么 CPU 侧同时要 tensor 和 NumPy view
许多计数和行移动使用 NumPy 更直接,例如前缀和、np.repeat() 与批量索引;H2D 则需要 PyTorch tensor。tensor.numpy() 生成共享底层存储的 view,使 Python/NumPy 更新后不必再复制一遍才能由 PyTorch 搬到 GPU。
共享存储也意味着必须明确所有权和时序。如果一个异步 H2D 还在读取 pinned buffer,CPU 就不能提前覆写相同区域。源码中的 stream、event 与同步点不是可随意删除的“保守等待”,而是在保护生产者—消费者关系。
先拷 block table,再做 CPU 索引
_prepare_inputs() 的第一项操作是 commit_block_table()。随后才在 CPU 上构造 req_indices、query_pos、token_indices。只要底层 copy 使用 non-blocking 路径,这两段工作就有机会重叠。
类似优化还出现在 input IDs:常规同步调度路径把本轮 pinned buffer 复制到 GPU;异步调度的共同 decode 请求则可以直接复用上一轮留在 GPU 的 sampled token,通过 slice 或 scatter 写入新布局,避免 token 先 D2H 回到调度器、再 H2D 返回 Runner。
这个 fast path 需要 prev_req_id_to_index。批次可能因完成请求而 condense,也可能被后端重排,因此“当前 row 3”不保证仍是“上一轮 row 3”。Runner 先建立 current row 到 previous row 的映射;布局完全一致时做连续 slice copy,发生重排时才上传索引并执行 scatter。
固定地址与动态有效长度如何共存
Runner 预分配 input_ids、positions、query_start_loc、seq_lens 等最大容量 buffer,每轮只更新有效前缀。模型实际执行可能使用大于真实 的捕获形状 :
多出的 个位置必须安全 padding。query_start_loc 的尾部填成相同的累计值,保证伪请求对应空区间;padding slot 指向保留位置;num_actual_tokens 仍记录真实工作量。固定地址让 CUDA Graph 可以重放,动态长度字段让 Kernel 不把 padding 当真实请求。
CUDA Graph 只消除了重复 launch 与图构建开销,并没有取消输入准备。每次重放之前,Runner 仍需把新一轮 token、位置、页表和长度写进同一批 buffer。也因此,InputBatch 的行稳定性、预分配容器和增量更新与 CUDA Graph 是同一套设计的不同侧面。
优化的边界:低批次重叠时可能适得其反
持久批次假设相邻 step 中大部分请求相同。若负载在两组请求之间来回切换,Runner 会不断 remove、add、condense 和刷新采样 metadata,维护成本可能接近重建批次。源码注释直接指出了这一边界。
这不代表持久批次设计错误,而是优化有负载假设。典型自回归在线服务中,请求会停留多个 decode step,重叠率很高;极端交替或强制抢占负载需要从 Scheduler 策略、活跃请求上限和 KV 容量一起定位,而不是只盯 InputBatch 的某个 copy。
正确性不变量与源码调试方法
这条链路的 bug 往往不会表现为“维度不匹配”。更危险的情况是张量形状完全合法,但 row、位置或 block ID 已属于另一个请求,最终得到静默错误输出或偶发非法显存访问。调试应先检查不变量,再分析性能。
八条必须成立的不变量
InputBatch._req_ids[row]与req_id_to_index[req_id]必须互为逆映射。- 同一 row 的 token 历史、计数、采样参数、LoRA 状态与 block table 必须属于同一 request ID。
sum(num_scheduled_tokens)必须等于真实扁平 token 数 。query_start_loc[0]=0,且它单调不减,最后一个有效值等于 。- 每个扁平 token 的
positions必须等于所属请求的已计算长度加请求内偏移。 seq_lens[i]不能超过该请求 block table 可寻址的有效容量,也不能落后于本轮最后位置。- 每个非 padding slot 都必须落在当前请求拥有的物理 block 中;完成或抢占请求的旧 row 不能继续产生 slot。
- 中途 prefill 的 logits 必须被丢弃;只有已经覆盖完整输入的请求可以提交采样结果。
最小可复现实验
先关闭投机解码、多模态、远程 KV、LoRA 和 context parallelism,用单卡构造两个请求:一个短 decode,一个长度超过 max_num_batched_tokens 的 chunked prefill。固定 temperature=0,让输出可重复。每轮只记录下面这些小数组:
req_ids=['A','B']scheduled=[1,3]computed=[8,0]query_start_loc=[0,1,4]positions=[8,0,1,2]seq_lens=[9,3]block_rows={A:[...], B:[...]}slot_mapping=[...]logits_indices=[0,3]discard=[False,True]不要一开始打印完整 token 表或 KV 张量。它们体积大,会扰动热路径,而且很难发现行级错位。先用 request ID、计数和少量 block IDs 重建因果链,在首个异常 step 再扩大日志。
推荐断点顺序
GPUModelRunner._update_states()入口:核对finished_req_ids、new/cached 请求集合与num_scheduled_tokens。InputBatch.add_request():确认新请求落入哪个 row,初始num_computed_tokens与 block IDs 是否正确。InputBatch.condense()之后:重新验证 request ID 到 row 的双向映射。_prepare_inputs()的cu_num_tokens生成处:核对query_start_loc和扁平长度。- token
index_select之后:核对每个请求首尾 token 是否来自正确历史位置。 compute_slot_mapping()之后:手算一个跨 block 边界的位置,比较物理 slot。_build_attention_metadata():核对max_query_len、max_seq_len、is_prefilling和每个 cache group 的 block table。- hidden-state gather 处:确认
logits_indices没有越过请求边界,partial prefill 的 discard mask 已置位。
症状与根因的对应关系
| 症状 | 优先检查 | 常见根因 |
|---|---|---|
| 请求加入/退出后输出突然串线 | row 映射、condense、block-table row | 行移动时漏更新某一列状态 |
| 只在跨 block 边界时出错 | positions、逻辑块下标、slot mapping | block size 或 manager/kernel 粒度换算错误 |
| chunked prefill 提前输出 token | discard mask、prompt 长度、num_computed_tokens | 把短 extend 错判为完整 decode |
| eager 正常、CUDA Graph 异常 | padded query_start_loc、null block、有效 token 数 | padding 行保留陈旧 metadata |
| 批次成员变化时偶发错误 | current-to-previous row 映射 | 异步 sampled token scatter 使用旧行号 |
| 混合注意力模型才出错 | 每个 cache group 的表与 slot mode | 错把一组 metadata 复用于不同缓存语义 |
| 性能在高并发下突然抖动 | H2D 时间、condense 次数、批次重叠率 | pinned copy 未重叠或 persistent batch 频繁重建 |
性能分析要分开看三段
一次 execute_model() 至少应区分:
- preprocess:状态更新、输入准备、metadata 构造与 H2D;
- forward:模型层与注意力 Kernel;
- postprocess/sample:hidden-state gather、LM head、采样与结果拷回。
若 GPU timeline 中 forward 前有明显空洞,先看 CPU 输入准备和拷贝,不要直接优化注意力 Kernel。若 forward 很长而 preprocess 已经被覆盖,再进入后端与 Kernel 分析。可结合 GPU 推理性能分析完全指南 中的 torch.profiler、Nsight Systems 与 Nsight Compute 分层定位;对 CUDA Graph 的建图与重放机制,可参考 CUDA Graph 完全拆解。
系列进度与下一站
至此,vLLM V1 的数据流已经从外部请求走到模型 forward 的入口:
| 篇次 | 已完成主题 | 关键源码坐标 |
|---|---|---|
| 一 | 整体架构与模块全景 | Entrypoint、Engine、Worker、Kernel |
| 二 | 请求穿过 V1 引擎 | add_request()、EngineCore.step()、输出提交 |
| 三 | Scheduler 的批次决策 | token budget、waiting/running、抢占 |
| 四 | KV Cache Manager | prefix lookup、block pool、分配、block table 交接 |
| 五 | GPUModelRunner 与 InputBatch | 持久批次、扁平 token、slot mapping、metadata 入口 |
本篇应留下六条源码关系:
CachedRequestState是按 ID 的对象视图,InputBatch是按 row 的列式执行视图,两者必须同步。- persistent batch 复用跨 step 状态,
SchedulerOutput只传 new/cached/finished 差量。 - 变长请求无需右侧 padding;
query_start_loc在一维 token 流中恢复请求边界。 positions描述模型位置,seq_lens描述完整上下文长度,二者与query_start_loc不可互相替代。- block table 做逻辑块到物理块翻译,slot mapping 再把本轮每个 token 落到具体 KV 槽位。
CommonAttentionMetadata是后端无关事实,metadata builder 才把它降成特定注意力实现的参数。
若准备亲自跟读源码,建议不要从七千多行的 gpu_model_runner.py 文件顶部顺序往下读。更清晰的调用顺序是:先在 execute_model() 中标出 preprocess、forward 与 postprocess 三段;再进入 _update_states(),只追普通 text generation 的 new/cached/finished 三条路径;随后阅读 InputBatch.add_request()、remove_request() 与 condense(),建立 row 生命周期;最后进入 _prepare_inputs(),用文中的 [1,3,2] 例子逐行核对累计和、位置、token 索引与 slot mapping。高级特性分支暂时折叠,等普通路径的数组都能手算后,再分别打开投机解码、混合 KV、多模态和流水线并行。
源码阅读时还应把“对象何时创建”和“buffer 何时改写”分开记录。InputBatch、GPU 输入 buffer 与 block-table tensor 通常在初始化阶段预分配,step 内做的是更新有效区域;CachedRequestState 则随请求加入和结束而创建、删除。看到一个 tensor 写操作时,先判断它是在改变容量、改变形状,还是只改固定容器中的内容。这个区分会直接影响对内存分配、CUDA Graph 地址稳定性和性能火焰图的解释。
下一篇继续留在 vLLM:进入 Attention Backend 接口,拆解 attention group、backend selector、metadata builder 与 layer/KV cache group 的绑定关系,并比较 FlashAttention、FlashInfer 等后端怎样消费同一套公共 metadata。PagedAttention Kernel 的线程组织、合并访存和分块 softmax 会在再下一篇单独展开,不与接口层混写。
参考资料
- vLLM V1 GPUModelRunner 源码(本文固定提交)
- vLLM V1 InputBatch 源码(本文固定提交)
- vLLM V1 BlockTable 与 Slot Mapping 源码(本文固定提交)
- vLLM V1 SchedulerOutput 数据结构(本文固定提交)
- Inside vLLM: Anatomy of a High-Throughput LLM Inference System
- vLLM Architecture Overview
- vLLM CUDA Graphs 设计文档
- vLLM GPUModelRunner API 文档
- PagedAttention 论文:Efficient Memory Management for Large Language Model Serving with PagedAttention
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
音乐
暂未播放


