


面试疑难(二):量化方法速答、scale 手算与 40B 模型显存估算、FPGA/GPU/NPU 编程之辨
这组问题在问什么
上一篇拆了一组考语言底层与源码阅读的连环题;这一篇的五道题换了一条完全不同的考察线——从”读代码”转向”说清楚原理、算得出手算题、跨硬件看问题”。按出场顺序是:
- LLM.int8()、SmoothQuant、GPTQ、AWQ 这些量化方法,能不能各用一句话概括、并说清区别?
- 量化和反量化的公式是什么?
- 16 位量化到 8 位,最大值是 300,scale 怎么算?
- 40B 参数的模型,8 位权重量化之后,权重一共多大?
- FPGA(HLS)和 GPU 或者 NPU 编程实现,有哪些异同?
五道题的递进逻辑相当明显:第一问考”论文摄入量”——读过这么多量化论文,能不能从摘要式记忆里提炼出各自最本质的一句话,而不是把四篇论文的贡献混成一锅粥;第二、三问考”公式敏感度”——不只会抄公式,还要知道每个符号是什么、极端数据下会发生什么、能当场手算;第四问考”数量级感”——系统工程师心里必须时刻有”多少参数 × 多少位宽 = 多少字节”这张表,否则没法做部署决策;第五问考”硬件视野”——天天在 GPU 上写 kernel 的人,是否清楚换成 FPGA 的 HLS 流程、换成 NPU 的算子编程时,问题本身会以什么形态重新出现。
其中四篇量化方法的原理,本站此前各有一篇完整拆解(LLM.int8()、SmoothQuant、GPTQ、AWQ),本文不再重复逐行推导,而是按面试口径把它们压成”一句话 + 关键机制 + 容易答错的地方”,再解决后四道题。前两问以原理阐述为主,第三问起则要落到能当场手算的数字与能现场画出的代码上。
第一问:LLM.int8()、SmoothQuant、GPTQ、AWQ,各用一句话怎么讲
这题最常见的两种答法都拿不到高分:一种是每篇论文背两分钟摘要,四种方法讲完面试官已经忘了开头;另一种是只给结论不解释机制,比如把四种方法都说成”量化后精度掉得少”。这题真正要答的是两个层次:先给一个分类坐标,把四种方法放进坐标里;再逐个用一句话说出”它动了什么、没动什么”。
一个顺手好用的分类坐标是三个轴:
- 量化对象:只量化权重(weight-only),还是权重和激活一起量化(W8A8 全量化)?
- 保护精度的机制:是靠统计定标(calibration)、靠数学等价的变换、靠逐值误差补偿,还是靠保护少量重要通道?
- 代价:是否需要校准数据、是否需要重训、位宽能做到多低。
先看一张总表,再逐个展开:
| 方法 | 出处 | 量化对象 | 典型位宽 | 一句话机制 | 需要校准数据 | 需要重训 |
|---|---|---|---|---|---|---|
| LLM.int8() | 2022 年 NeurIPS(Tim Dettmers 等,后集成进 Hugging Face bitsandbytes) | 权重 + 激活(离群部分走 FP16) | 8 位 | 按特征维度检测激活离群值,把矩阵乘拆成”99% 的 INT8 列 + 1% 的 FP16 列”两块分别算 | 是(离线统计激活范围) | 否 |
| SmoothQuant | 2023 年 ICML(MIT Han Lab 等) | 权重 + 激活 | 8 位(W8A8) | 激活难量化是因为少数通道离群,把激活的数值方差通过数学等价变换迁移到权重上,两边都好量化 | 是(校准集统计通道幅度) | 否 |
| GPTQ | 2023 年 ICLR(Frantar 等,基于 OBQ/OBS 误差补偿思想) | 仅权重 | 4 位、3 位 | 逐列量化权重,每量化一列就用二阶信息(近似 Hessian)更新其余权重,补偿这次量化造成的输出误差 | 是(少量文本) | 否 |
| AWQ | 2024 年 MLSys 最佳论文(Ji Lin 等,MIT Han Lab) | 仅权重 | 4 位 | 约 1% 的显著权重(由激活幅度决定)主导精度,对它们所在通道整体放大再量化,数学等价、不动权重值 | 是(少量文本) | 否 |
四种方法没有谁取代谁:LLM.int8() 与 SmoothQuant 抢的是”激活量化”阵地,GPTQ 与 AWQ 抢的是”低比特权重量化”阵地,后两者还常常叠加使用。下面逐个说。
LLM.int8():把矩阵乘按列拆成 INT8 与 FP16 两块
一句话:LLM.int8() 发现大模型激活里有少量”系统性离群值”,于是按特征维度把矩阵乘拆成绝大多数走 INT8、少数走 FP16 的两块,各算各的再合并,从而在 175B 规模上做到 8 位无损。
它要解决的问题是:普通的 8 位量化在 6.7B 参数以下的模型上工作得很好,一旦模型规模超过 6.7B,量化误差突然爆炸。论文发现原因是激活中出现了离群特征(emergent outlier features):少数几个隐藏维度上的激活值极大(论文以 6.0 为经验阈值),而且这些大值所在的特征维度在所有 token、几乎所有层上都固定——它不是随机噪声,而是模型规模变大后”涌现”出来的系统性结构。因为只是少数列,per-tensor 量化的 scale 会被这些列撑大,把其余 99% 的正常值压到很低的量化精度上。
做法分两步。第一步,按列拆分:对每个矩阵乘,检测激活矩阵中哪些列(即特征维度)含离群值,含离群值的列整体拎出来用 FP16 计算,剩下的绝大多数列做 INT8 矩阵乘,两个结果相加。注意这一步针对的是激活矩阵的列;由于矩阵乘 中 的列维和 的行维是同一个”特征维”,离群只会出现在这一对维度上,所以按列切分是自洽的——W 中与离群列对应的行也会被带走,但 W 本身并没有被”检测”,它只是跟着激活的切分被切开。
第二步,向量级量化(vector-wise quantization):INT8 的那一块,激活按行(即按 token)取一个 scale,权重按列(即按输出通道)取一个 scale。为什么不都用 per-tensor?因为激活的不同 token 之间幅度差异大(尤其离群 token),权重的不同输出通道之间幅度差异大,各自沿自己差异最大的方向定标,精度损失最小。向量级量化的代价是反量化时每个输出元素要乘两个 scale(行 scale 与列 scale),但这一步是 的逐元素操作,和矩阵乘本身的 量级相同,相对开销可控。
两个常被追问的点。其一,为什么低于 8 位不行:LLM.int8() 的核心是”离群列走 FP16”,这只把存储与计算从 16 位降到 8 位,再往下压位宽没有对应机制。其二,拆分有额外开销:每个矩阵乘都要先扫一遍激活找离群列,还要维护两套结果相加,所以它的速度优势主要体现在”省显存、能装下更大的模型”,纯算力上并不总是比 FP16 快。它的历史意义是把”8 位就能跑 175B 模型”变成了开箱即用的事实——在 Hugging Face 生态里只需 load_in_8bit=True 一行接入。
SmoothQuant:把激活的量化难度”数学等价”地搬给权重
一句话:SmoothQuant 观察到激活的离群只集中在少数通道,而这些通道在权重上恰好对应小值,于是用对角缩放把激活的方差迁移一部分到权重上,两边都不再需要逐通道量化,全程 INT8 计算。
它与 LLM.int8() 面对同一个敌人——激活离群值。但 LLM.int8() 的方案是”绕开”(离群部分退回 FP16),SmoothQuant 的方案是”根治”:既然激活难量化是因为少数通道幅度特别大,那能不能让这些通道的幅度变小?答案是能,而且不需要近似——因为矩阵乘有一个数学等价关系:对任意可逆对角矩阵 插入单位阵,
激活按列乘上缩放因子 ,权重按行除以同一个 ,乘积严格相等——这不是近似,是恒等式。于是可以把激活的”方差分布”沿通道迁移一部分到权重上:平滑后的激活 各通道幅度接近,可以放心用 per-tensor 量化;权重 虽然被放大了一些通道,但权重是离线保存的静态数据,本来就要逐通道量化,而且权重的离群远没有激活那么极端,吸收这些方差后依然可量化。迁移多少由一个超参数 控制(论文默认 0.5,0 表示全放权重、1 表示全留激活),实际取值需要在校准数据上扫一下。
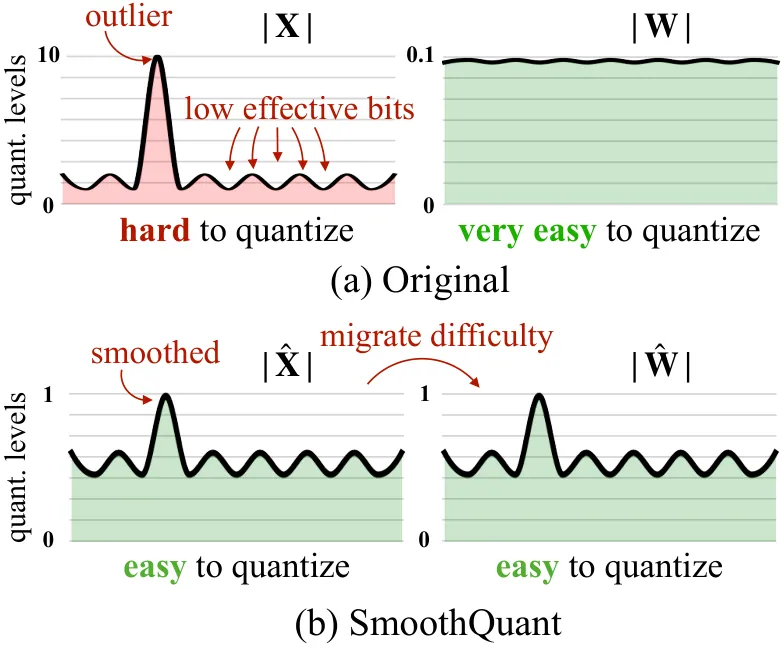
图中上方是未平滑的激活分布:少数离群值把量化范围撑得很大,中间大量正常值只分到很少的量化台阶,有效比特严重浪费;迁移方差后(下方),激活分布收窄,量化台阶对正常值更密。右侧对应的权重在吸收方差后每个通道仍有自己的 scale,离线处理后不受影响。
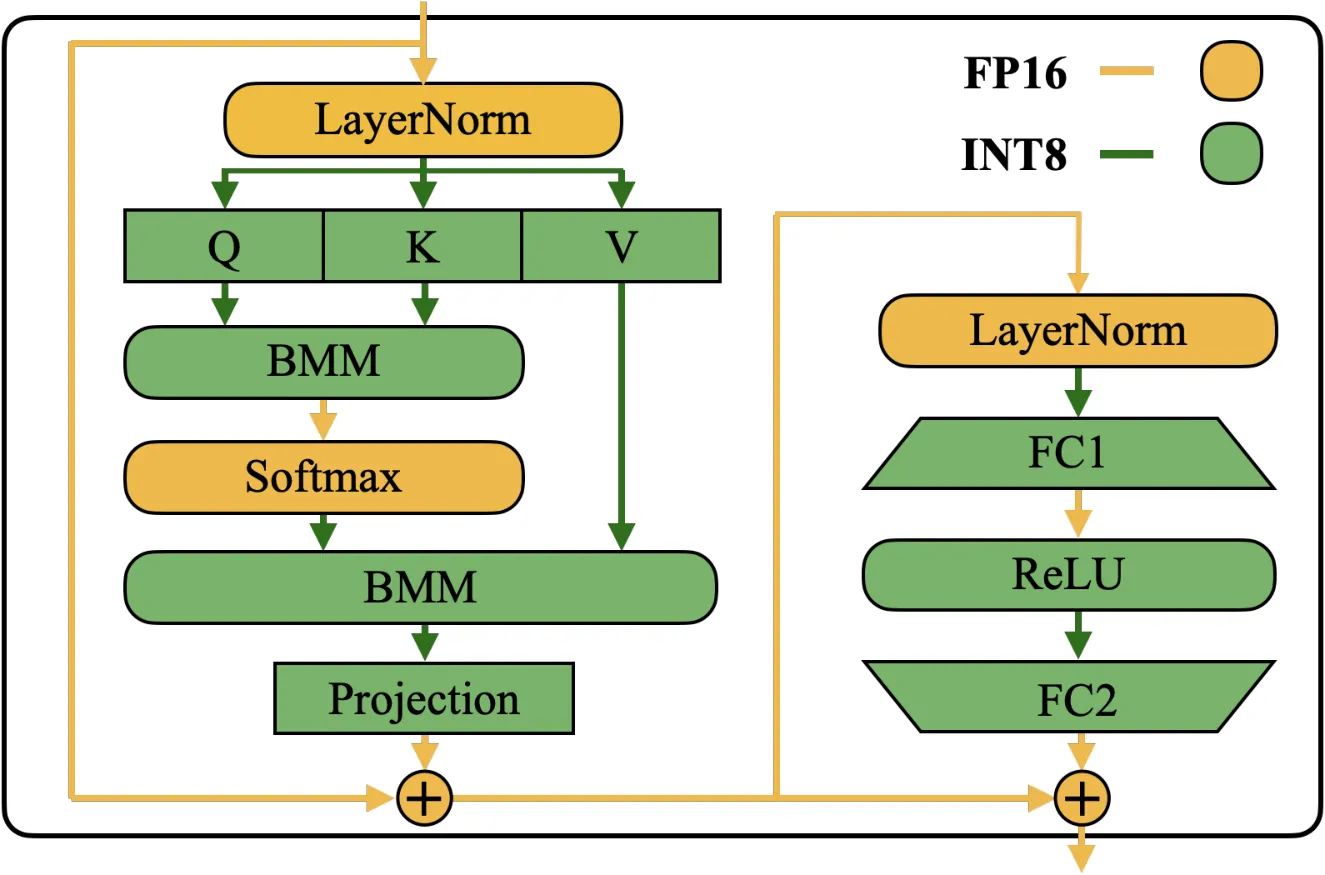
第二张图展示的是”迁移做完之后算力上拿到什么”:Transformer block 里所有计算密集的算子——线性层、注意力里的批量矩阵乘(batched matrix multiplication,BMM)——都换成 INT8 算术,而 LayerNorm、残差、激活函数这类非计算密集算子保留 FP16。这正是 W8A8 路线吸引人的地方:GPU 上 INT8 Tensor Core 的峰值算力是 FP16 的两倍,全程 INT8 意味着把矩阵乘部分真正跑在翻倍的算力上,论文在 A100 上报告相对 FP16 约 1.5 倍的延迟收益,且不损失精度。
容易答错的点:SmoothQuant 不是”把离群值挑出来扔掉或者单独处理”,而是用数学等价变换改变了离群值所在的张量,全程没有精度妥协——这是它和 LLM.int8()(混合精度近似处理)的本质区别。代价是它要求激活也必须量化到 8 位,需要硬件与 kernel 支持 INT8 的激活侧路径,落地比 weight-only 方法麻烦。
GPTQ:量化一个权重,就用二阶信息补偿其余权重
一句话:GPTQ 每次量化一个权重后,都按二阶损失近似(Hessian 信息)更新尚未量化的所有权重,把这次量化造成的输出误差立刻分摊补偿掉,从而让 4 位权重量化几乎无损。
它继承自一条经典脉络:OBS(Optimal Brain Surgeon,最优脑外科医生)理论把”量化/剪枝一个权重对最终输出的伤害”用二阶泰勒展开近似——对权重扰动 ,损失变化约等于
其中 是损失关于权重的 Hessian 的近似,可以只用该层的输入激活 算出来(对回归重建损失而言)。由此得到的关键操作是:量化完第 个权重后,用 的对应列更新所有还没量化的权重,公式形如
即”这次量化犯了多大错,按二阶信息分摊给其他权重去补救”。OBQ 是逐权重做这件事,GPTQ 做了三个工程化改造把它变成能处理 175B 模型的算法:其一,固定量化顺序——OBQ 每个都贪心选影响最小的权重,但实验发现顺序几乎不影响结果,改成任意固定顺序,省掉每次的挑选开销;其二,懒惰批量更新(lazy batch update)——不必每量化一个权重就立刻更新所有剩余权重,攒够一批(如 128 列)再统一做一次矩阵级更新,把逐列的低效矩阵-向量运算换成高效的批量矩阵运算;其三,Cholesky 分解——预先对 做分解,避免反复求解线性方程组,既快又数值稳定。
注意 GPTQ 有两个”只”字:它只量化权重(激活仍跑 FP16),所以它的收益主要在显存与权重读取带宽上;它是训练后量化(post-training quantization, PTQ),只用少量校准文本(论文用几百条)估计 ,不更新权重本身。在 vLLM 这类框架里,GPTQ 的 4 位权重配合 Marlin 等专用 kernel,把 4 位权重读出来反量化后参与 FP16 计算——省下的是约 4 倍的权重存储与读取流量。它为什么能把位宽压到 4 位而激活不行?因为权重是离线静态数据,可以花大量时间、用二阶信息慢慢精修;激活是运行时现算的,只能在线实时量化,没有”补偿”的机会。这一点答得出来,才算真正理解两类量化的分野。
AWQ:不保护所有权重,只放大激活说得算的 1%
一句话:AWQ 发现约 1% 的”显著权重”(显著性由对应激活的幅度决定,而不是权重自身的幅度)主导量化精度,于是不剪枝、不改值,只对它们所在的通道做数学等价的放大后再量化,4 位下达到超越 GPTQ 的效果。
AWQ 的回答先给一个反直觉的观察:若只按权重自身幅度挑重要的通道,会挑错。真正重要的是那些”输入激活幅度大”的通道对应的权重——一个权重再大,如果喂给它的输入常年很小,它对输出也没贡献;反过来,激活大的通道即使权重值不大,也主导着输出。论文把这 1% 的通道称为显著权重(salient weights),并证明保护它们就能保住大部分精度。怎么保护?不能剪枝(信息有损、硬件不规整),不能对部分权重走混合精度(硬件要为此付出不规则代价),正确做法是整体放大再量化:对这 1% 通道所在的整个权重通道乘一个大于 1 的因子 ,再对整个权重张量做 per-channel 量化——被放大的通道在量化后保留了更多相对精度,而数学上乘 可以在上层激活里除回去(对归一化层做等价折叠),不改变前向结果。最优的 不用反向传播,在校准数据上对一组候选值(论文在 0.1 到 1 之间取步长)做网格搜索即可,实现只有几十行。
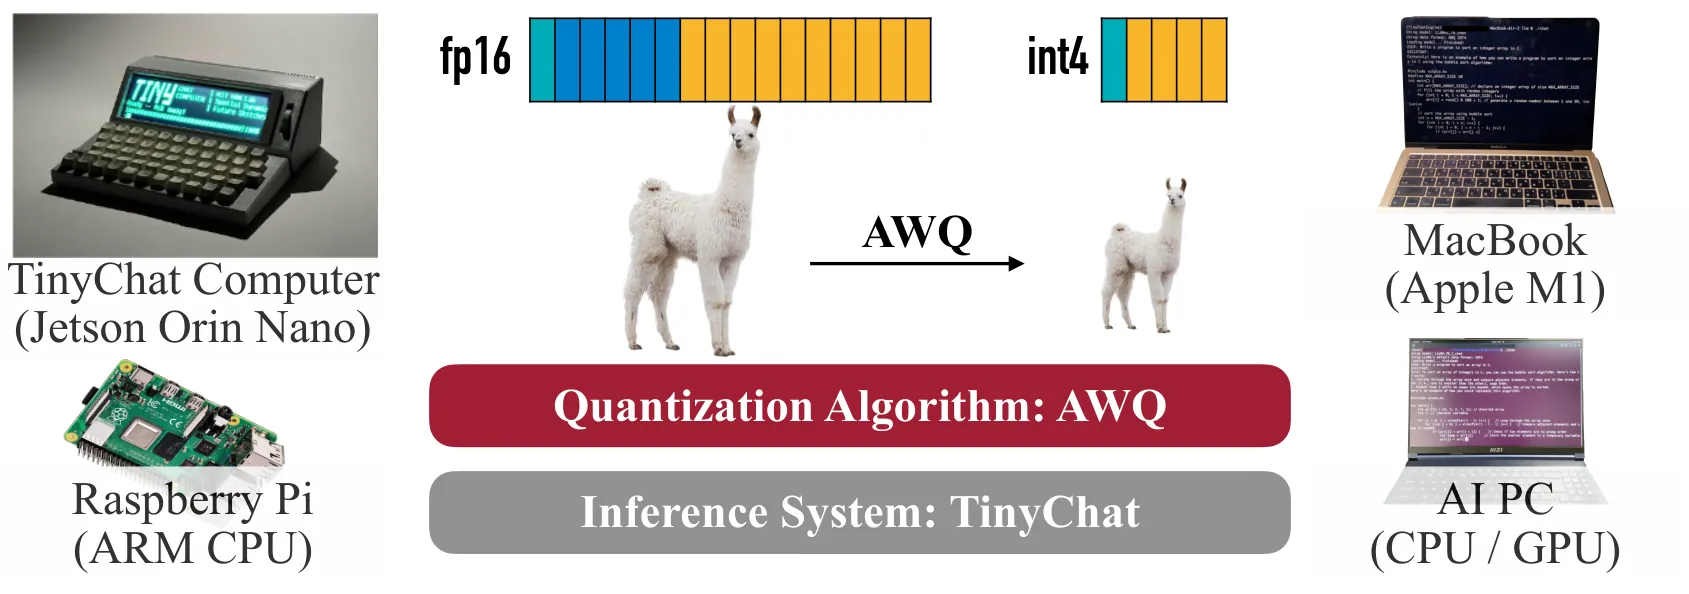
容易和 GPTQ 混淆的地方在于”保护的粒度”:GPTQ 是逐值修正(每个被量化的权重都产生一次全局误差补偿,最终改变了几乎所有权重值),AWQ 是整通道缩放(一个权重都不改,只改变量化前的分布形状)。两者正交,实践中可以叠加——先 AWQ 缩放再 GPTQ 补偿,或者单独用 AWQ。论文在 4 位权重量化上超过 GPTQ,且指令跟随等任务上的优势更大;又因为它只缩放不迭代,速度比 GPTQ 快很多,这也是它后来成为 TinyChat 等端侧部署工具默认方法的原因。
收束:一句话对比与常见误区
如果面试官最后要求”用三句话收掉四种方法”,可以这样答:
- LLM.int8():激活里有离群列,把它们挑出来走 FP16,剩下走 INT8——混合精度拆列;
- SmoothQuant:同样是激活离群,用数学恒等变换把方差搬到权重里,让两边都能干净地 8 位量化——方差迁移;
- GPTQ:量化权重时用二阶信息把误差立刻补偿给其他权重——改值补偿;
- AWQ:只有 1% 的通道重要(激活说了算),把它们放大保护起来——放大不改值。
两个高频误区要主动避开:一是把 SmoothQuant 说成”把离群值移到权重上”,它是把量化难度(方差)迁移且全程数学等价,不存在任何近似取舍;二是把 AWQ 说成”剪掉不重要的权重”或”需要重训/反向传播”,它只做缩放,是 PTQ。
第二问:量化与反量化的公式是什么
这道题的完整答案由三部分组成:一组通用公式、一个对称特例、一套量化粒度。少讲任何一部分,面试官都会顺着往下追。
通用形式:仿射量化(affine quantization)
线性量化做的事情,是把浮点数的一段连续区间均匀映射到整数区间上——8 位就是 256 个均匀间隔的台阶。最一般的映射带一个偏移,叫仿射量化(也叫非对称量化),核心公式只有两个:
第一个是量化(quantize):浮点值 除以尺度 、四舍五入到最近的整数、再加上零点偏移 ,最后截断到整数表示范围 内(INT8 即 );第二个是反量化(dequantize):把整数 还原成浮点估计 。注意 是整数(或经 round 取整),所以 ” 先取整再加 “与""两种写法等价,不同框架的记号差异只在这里,本质是同一个映射。
这套参数从哪来?约束很简单:浮点区间 的两个端点要恰好映射到整数区间的两个端点。解出来就是:
尺度 的物理意义是一个量化台阶代表多大浮点值,也就是网格的间距(step size);零点 的意义是”浮点 0 落在哪个整数刻度上”——反量化时先减掉它,保证 能被精确表示(整数零化到浮点零,这对卷积/矩阵乘里大量出现的 0 填充、padding 极其重要)。
对称特例:为什么是 ±127 而不是 ±128
如果浮点数据本身关于 0 对称(权重通常如此),可以强制 ,得到对称量化(symmetric quantization):
工程实现里 INT8 对称量化几乎都用 而不是 128。原因有两个层面:其一,用 时正负范围完全对称,任何正值都能找到对应的负值刻度;若把 也用进来,负半轴比正半轴多一个刻度,量化本身不再对称。其二,历史约束——早期论文(如 8-bit 推理的经典工作 IAQ)指出,如果保留 ,极端情况下两个 相乘会得到 ,超过 16 位累加器能安全容纳的乘积范围(INT8 乘积最大本应为 ),而 恰好溢出;虽然现代 GPU 的 INT8 矩阵乘都用 INT32 累加器,这个限制不再成立,但 作为惯例被保留了下来。顺带一提:ReLU 之后全为正的激活如果硬用对称量化,负半轴刻度全部浪费,这正是非对称量化(或 SmoothQuant 平滑后数据分布变对称)有意义的原因。
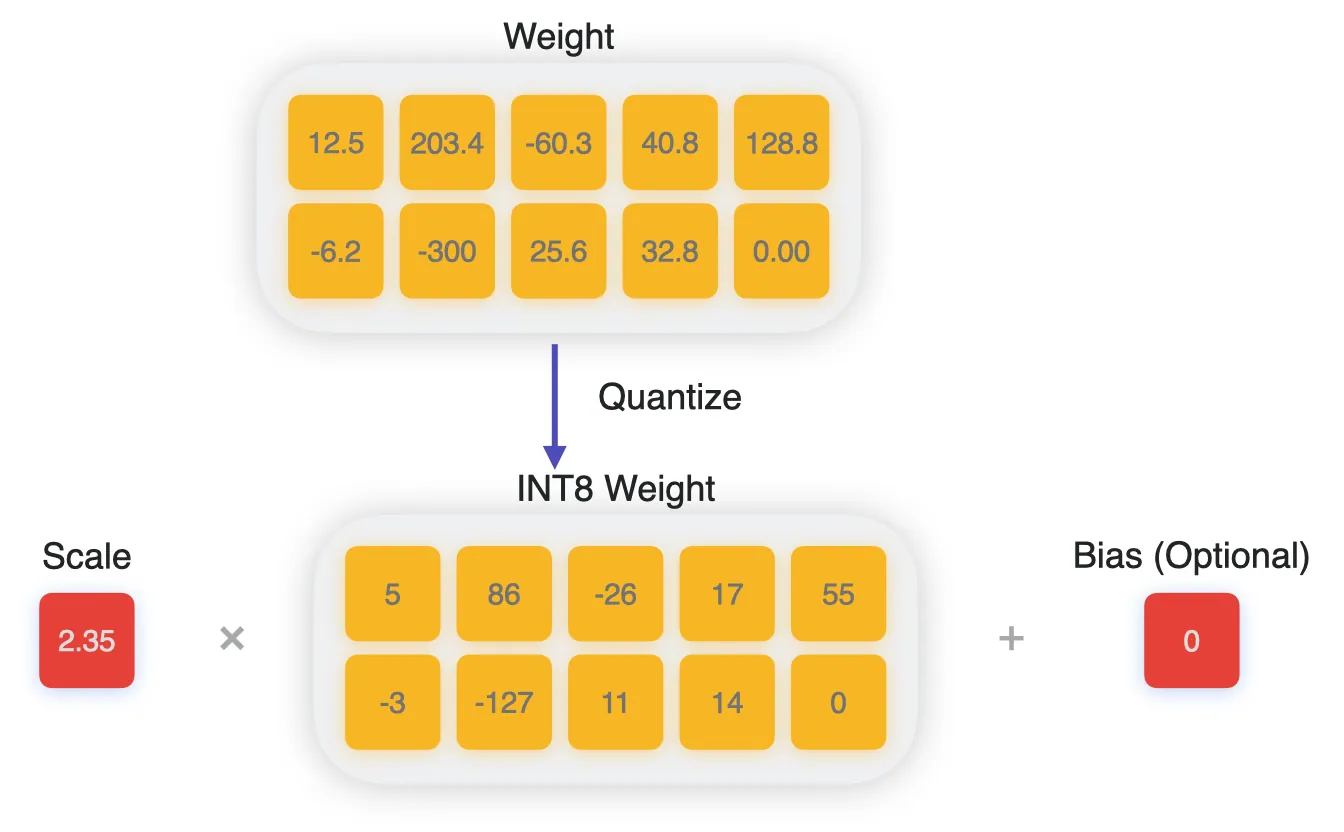
量化是有损的,误差上界就是半步长:真实值 与反量化值 的偏差至多 。这个结论引出一个面试常考点:绝对误差对所有数都一样,相对误差却对小数爆炸。 时误差 微不足道, 时 意味着整个数可能被舍成 0——这就是”量化把小值压没”的机制,也是第一问里 SmoothQuant 要把离群大值收窄的原因。位宽每增加 1 位,台阶数翻倍、误差减半,这是”8 位够用、4 位吃力”的直觉来源。
量化粒度:scale 按多大范围共享
公式里的 、 是对”多大的一块数据”统计的?这个范围就是量化粒度(granularity):
- per-tensor:整层张量共用一个 和一个 。实现最简单,但要求张量内部各通道幅度均匀,否则会被个别大通道拖累;
- per-channel:输出通道维上每个通道各用一组 。权重张量几乎必用——不同输出通道的权重幅度可以差几个数量级,共用 scale 会让小通道精度尽失;
- per-token:激活张量按 token(序列维)逐行定标。解码时不同 token 的激活幅度差异很大,且 scale 可以在线即时统计,是激活量化的主流选择;
- per-group / per-block:沿通道方向每 个元素(如 128 个)一组共享参数,4 位量化常用——GPTQ、AWQ 的 group size 128 就是这种粒度,它在精度与 scale 存储开销之间取平衡。
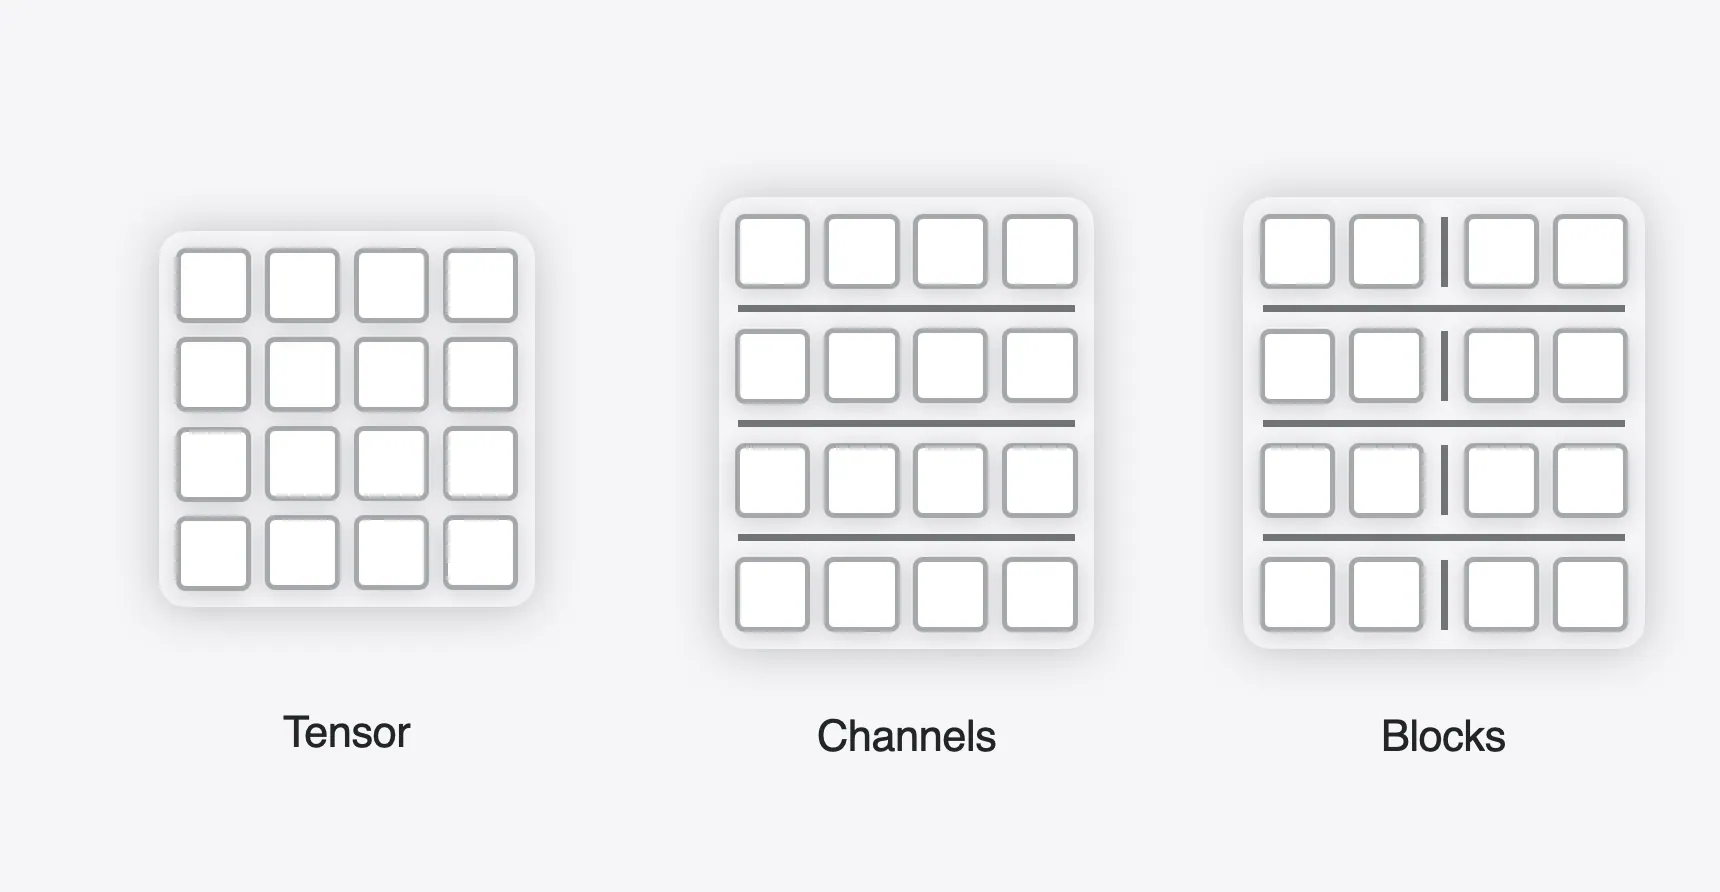
粒度和对称性组合起来,就是实际系统里的常见配方:权重用对称 per-channel(离线定标,无额外开销),激活用对称 per-token 或非对称 per-tensor(在线统计),更低位的分组量化叠加 per-group。能把这套”配方逻辑”讲出来,说明公式不是背的,而是知道每个旋钮在解决什么分布问题。
最后补一句面试官常追问的工程落点:INT8 GEMM 里,两个 INT8 相乘得 INT16,累加到 INT32 再乘 scale 校正——但 通常不是逐元素乘一遍 FP32 那么奢侈,而会被转成定点乘加移位(multiply-shift,把浮点 近似成 )以节省算力;weight-only 的 GPTQ/AWQ 则相反,kernel 把 4 位权重读出来后先反量化成 FP16 再和 FP16 激活相乘,省的是带宽而非算力。两条路线的反量化发生在不同位置,但用的都是上面同一对公式。
第三问:16 位量化到 8 位,最大值 300,scale 怎么算
这是一道手算题,答之前必须先做一件事:问清口径——是对称还是非对称?只给了”最大值 300”,那最小值是多少?范围是 还是 ?quantize 到 INT8()还是 UINT8()?先问口径再动手,本身就是加分行为;如果面试官说”就按最简单的来”,那就是对称量化。
对称情形:
对称量化认为数据分布在 (或只关心绝对值上界 300),于是:
验算:,量化回去正好是 127,反量化 ,完美闭合。对任意 ,量化时取 ,反量化取 。
非对称情形:范围是 时
如果数值全是正的(比如某层激活是 0 到 300),用对称量化会浪费负半轴的 128 个刻度。改非对称,把 映射满整个 :
验算:,,两端都精确落在整数值域上,反量化回去也精确是 300 和 0。比较两种口径:对称时台阶宽 2.36(编码效率只有一半),非对称时台阶宽 1.18(256 个刻度全部用于 0~300),非对称的精度是对称的两倍——这就是为什么全正激活值得用非对称。
把上面的计算写成一小段可验证的代码,面试时甚至可以当场演示:
import numpy as np
x = np.array([300.0, 150.0, 50.0, 1.0, 0.0])
# 对称:范围 [-300, 300],INT8s_sym = 300.0 / 127.0 # 2.3622q_sym = np.clip(np.round(x / s_sym), -127, 127)print("对称 s =", round(s_sym, 4)) # 2.3622print("q =", q_sym) # [127. 64. 21. 0. 0.]print("还原 =", q_sym * s_sym) # [300. 151.18 49.61 0. 0.]
# 非对称:范围 [0, 300],映射到 [-128, 127]x_min, x_max, q_min, q_max = 0.0, 300.0, -128.0, 127.0s_asym = (x_max - x_min) / (q_max - q_min) # 1.1765z = np.round(q_min - x_min / s_asym) # -128q_asym = np.clip(np.round(x / s_asym) + z, q_min, q_max)print("非对称 s =", round(s_asym, 4), " z =", z) # 1.1765 -128print("还原 =", s_asym * (q_asym - z)) # [300. 150.59 49.41 1.18 0.]注意输出里的几个细节,它们就是这道题的”连环追问”素材。其一,取整模式有讲究:对称口径下 算出 ,恰好落在两个整数正中间,numpy 默认的舍入是”半偶”(half-to-even,向偶数取整,得到 64),最终还原 151.18,误差 1.18——正是半步长 ;如果某实现用”半向上”(half-up),就会得到 63、还原 148.82。两套结果都”合法”,差别只来自 round 的约定,量化框架之间微小的数值差异往往就是这么来的。其二,小值的命运取决于台阶宽度:对称口径下 被量化成 0、还原为 0——单个小值被台阶整个”吞掉”,相对误差 100%;非对称口径下台阶只有一半宽, 落到最近的刻度上还原成 1.18,没被吞掉,但相对误差仍有 18%。绝对误差对所有数都是 级别,相对误差却随数值变小而恶化——这正是第二问误差分析的现场版。
常见连环追问
- 为什么用 127 不用 128? 见第二问的对称性分析;如果面试官坚持用 128(即 ),那意味着最大刻度 128 在 INT8 里并不存在,可表示的数值上界实际只有 ,约 0.8% 的刻度被浪费,两种约定在业界都存在,但要自洽。
- scale 用什么精度存? 通常 FP32,也有框架压成 FP16 或转成定点 multiplier + shift,反量化是乘加操作,scale 精度本身会成为误差来源之一。
- 300 是极端离群值怎么办? 这是整道题的题眼:如果 300 是极少数离群点,而大多数值在 1 附近,scale 被离群值撑大后大多数小值都会被压没(上面 变 0 已经演示了)。此时要么截断(clamp 到某个百分位,容忍 300 溢出),要么用第一问的 LLM.int8()/SmoothQuant 思路处理离群——手算题连着论文题,是面试里最常见的”递进钩子”。
- FP16 本身就能表示 300,为什么还要 scale? 因为 8 位定点数的台阶是均匀的(等距网格),而 FP16 的精度随指数变化(大数稀疏、小数稠密),两者表示同一数值范围时,定点数的相对误差在小区间上更差,所以必须靠 scale 把目标范围”卡”进量化网格——scale 选得越贴近真实数据范围,浪费的比特越少。
第四问:40B 参数、8 位权重,权重最终多大
这是一道心算题,答案本身只有一行,但面试官真正想看的是后面两件事:单位换算会不会错、能不能把”权重”放进整个推理显存账本里。
心算:参数 × 位宽 = 容量
40B 参数的意思是 个参数(B 是 billion,10 亿)。每个参数用 8 位存储,就是 1 字节,所以:
如果按比特再算一遍验算: 亿参数 位 亿比特 亿字节 GB。换精度就是一张简单的表,值得背下来当心算基准:
| 参数规模 | FP32(4 字节) | FP16/BF16(2 字节) | INT8/FP8(1 字节) | INT4(0.5 字节) |
|---|---|---|---|---|
| 1B | 4 GB | 2 GB | 1 GB | 0.5 GB |
| 7B | 28 GB | 14 GB | 7 GB | 3.5 GB |
| 40B | 160 GB | 80 GB | 40 GB | 20 GB |
| 70B | 280 GB | 140 GB | 70 GB | 35 GB |
两个容易翻车的细节
其一,GB 与 GiB 的分歧。上面用的是十进制: 字节。如果用二进制的 GiB( 字节),40 GB 是 GiB。工程上口头说”40GB”,写显存分配、算余量时按 GiB 精确计算——这个细节主动说出来,比被追问出来体面得多。
其二,40GB 只是权重这一项。推理时的显存账本至少还有三笔:激活(前向中间张量,与 batch size 和序列长度相关)、KV cache(与层数、KV 头数、序列长度、批大小相关)、以及运行时碎片与 kernel 工作区。KV cache 的估算公式很值得顺手记住:每 token 的 KV 字节数等于
前面的因子 2 是因为 Key 和 Value 各一份。代入两个常见模型:Llama 2 7B(32 层、MHA 每层 32 个 KV 头、头维 128、FP16)每 token 约 0.5 MB,10 万 token 的上下文就要 50 GB 级的 KV;改用 GQA(如 8 个 KV 头)后降到约 1/4。也就是说,40B 参数 + 8 位权重 = 40 GB,一张 80 GB 的卡装权重绰绰有余,但长上下文或大并发下 KV 很快会反超权重成为第一大头——这也是为什么近年的推理优化(GQA/MLA 压缩 KV、KV 量化、KV 复用)如此重要。
部署判断怎么答
把数字落到场景上,这道题就答完整了:40B 模型 8 位权重约 40 GB,FP16 则要 80 GB——单张 80 GB 的 A100/H100 装 FP16 权重就基本见底,几乎没有留给 KV 和激活的空间,所以工程上 40B 级模型要么 INT8/FP8(40 GB,单卡舒适)、要么 4 位量化(20 GB,可以上 24-48 GB 的卡),配合多卡张量并行分摊权重更是常规操作。答题时把”权重、激活、KV”三项列清楚,再给出结论,面试官就能确认答题者不是只会背 40 GB 这个数。
第五问:FPGA(HLS)和 GPU 或者 NPU 编程实现,有哪些异同
这题问的是”编程实现”,但别把它答成产品对比会——面试官想确认的不是”GPU 贵、FPGA 省电”这类结论,而是写程序时脑子里那套映射模型(programming model):代码里的一个循环、一块数组、一次同步,在三种硬件上分别变成了什么。答题框架建议按四个层次展开:执行模型(指令还是数据流)、并行性的来源、存储与同步的语义、开发流程与性能特征。这里的 NPU 按通常口径,指面向张量算子定制的可编程加速器(谷歌 TPU、华为昇腾、寒武纪思元等),它介于”完全通用的 GPU”与”固定功能的专用硬核”之间。
三者最本质的区别:控制流还是数据流
GPU 和 CPU 一样是控制流机器:取指、译码、发射,程序是一串指令,数据被指令”拉”着走。CUDA 程序的并行单位是线程,GPU 一次发射一条指令给一整组线程(SIMT,单指令多线程),靠上千个并发线程掩盖访存延迟。写 CUDA 时思考的是:有多少个线程、每个线程算哪个元素、线程之间怎么同步。
FPGA 是数据流机器:芯片上布的是查找表(LUT)、DSP 乘法器、BRAM 存储块,没有”取指令”这回事——程序被综合成电路之后,每个时钟周期电路自己按连线干活。并行性来自两个方面:一是空间复制,把同一个运算逻辑复制多份同时算不同数据;二是流水线(pipeline),把一次计算拆成多级,数据像流水线一样每周期推进一级。写 FPGA 程序(无论 HDL 还是 HLS)时思考的是:数据以什么节奏流经哪些运算级、每个运算级之间怎么缓冲。
NPU 介于两者之间:它内部通常有面向张量/向量的专用计算阵列与固定的数据流路径,但对外又提供可编程接口。编程风格因厂商而异:谷歌 TPU 走的是”编译器把高层算子图编译成驱动脉动阵列的指令”(一次指令驱动整块阵列,所以常被称为类 CISC 指令集),华为昇腾提供 Ascend C 这类接近 CUDA 的核函数语言,寒武纪有 BANG 语言。共同点是:可编程的灵活度比 GPU 低,但编译器/运行时承担了更多映射工作。
一张对比表先立骨架
| 维度 | GPU(CUDA) | FPGA(HLS) | NPU |
|---|---|---|---|
| 硬件本质 | 大量固定 SIMT 核 + 缓存/共享内存 | 可重构 LUT/DSP/BRAM,逻辑与连线按设计生成 | 张量/向量计算阵列 + 固定数据流,专用缓存 |
| 执行模型 | 指令流,线程级并行(SIMT) | 无指令,空间并行 + 流水线数据流 | 指令或高层图编译,映射到固定阵列 |
| 并行来源 | 线程块/网格,靠并发与延迟隐藏 | 循环展开复制逻辑 + 流水线 II 控制吞吐 | 编译期张量切分到阵列 |
| 存储语义 | 程序员管寄存器/共享内存,全局有缓存与合并访问约束 | 数组综合成 BRAM/寄存器,端口数决定带宽,需显式乒乓缓冲 | 多层片上内存,通常由工具分配 |
| 同步机制 | __syncthreads、原子操作、流 | 无同步指令:时序由静态调度与流水线保证 | 事件/队列或算子间依赖图 |
| 数值支持 | 原生 FP32/FP16/BF16/FP64/INT8 等指令 | 浮点靠 IP 核消耗 DSP,常换自定义定点位宽 | 固定组合(如 FP16/INT8/FP8) |
| 开发流程 | 编译秒级,跑起来迭代 | HLS 综合 + 布局布线小时级,先 C 仿真验证 | 图编译/算子开发,分钟到小时级 |
| 擅长的活 | 通用、吞吐大、生态成熟 | 确定性延迟、定制接口、能效比、算法可重构 | 固定形态算子的最高能效 |
逐个层次展开:写代码的人真正感受到的差异
并行性表达方式完全不同。 CUDA 的默认动作是”拆线程”:一个输出元素一个线程,几千个线程同时跑;循环结构在 CUDA 里反而不是主角,往往退化成线程索引的算术。HLS 的默认动作是”拆循环”:C/C++ 代码里的循环是设计的中心,工具通过三种 pragma 把循环变成硬件——#pragma HLS PIPELINE 把循环迭代重叠成流水线并指定目标间隔 II(initiation interval,每隔几个周期启动一次新迭代),#pragma HLS UNROLL 把循环体复制成多份并行算,#pragma HLS ARRAY_PARTITION 把大数组拆成多个小存储块以提供足够的并行读写端口。程序员在 HLS 里真正干的事,是给工具写设计意图注释并检查综合报告里资源与 II 是否达标。
存储层次的控制粒度不同。 CUDA 里访存优化是”合并访问 + 共享内存分块”,全局缓存是透明的,程序员只控制显式的那一层;GPU 上数组天然放在全局内存里,要用共享内存得手动 __shared__ 声明与搬运。HLS 里数组默认综合成 BRAM,而一块 BRAM 通常只有两个读写端口,如果流水线每周期需要读三个不同位置,就必须用 ARRAY_PARTITION 拆块或者改用寄存器——存储结构直接由源码里的数据访问模式决定,这是 CPU/GPU 程序员最不习惯的一点。NPU 通常把片上存储当作分层缓冲交给编译器分配,程序员能干预的接口因厂商而异。
同步与时序问题换了形态。 CUDA 的线程间同步是显式的:块内 __syncthreads(),块间靠 kernel 边界或原子操作。FPGA/HLS 里没有”同步指令”,因为电路里所有操作天然并行且按连线传播——HLS 工具保证同一流水线内数据的依赖正确,程序员要操心的是另一种问题:吞吐与延迟的取舍(流水线深度、II 是否达到 1)、跨流水线阶段的缓冲(乒乓缓冲 ping-pong buffer、FIFO)。换句话说,GPU 上的 bug 常是”忘了同步/数据竞争”,FPGA 上的 bug 常是”以为代码是按 C 的顺序执行,实际被重排成了并行电路”。NPU 的同步大多由运行时依赖图保证,但显存拷贝与计算的重叠仍需显式管理。
同一个算法,两种写法:用代码看差异
纸上谈兵不如一段代码直观。下面用同一个”3 抽头 FIR 滤波器”(输出 )分别写 HLS 与 CUDA,这是面试时能现场画出来的最小对照:
// HLS(C++):循环是设计的中心,目标是让硬件每周期产出一个输出void fir3(const int x[N], int y[N], int c[TAPS]) {#pragma HLS ARRAY_PARTITION variable=c complete dim=1 int reg[TAPS - 1] = {0, 0}; // 两级延迟寄存器,综合成芯片上的寄存器链#pragma HLS ARRAY_PARTITION variable=reg complete dim=0 for (int i = 0; i < N; i++) {#pragma HLS PIPELINE II=1 // 目标间隔:每 1 个时钟周期启动一次新迭代 int acc = c[0] * x[i]; if (i >= 1) acc += c[1] * reg[0]; if (i >= 2) acc += c[2] * reg[1]; reg[1] = reg[0]; // 历史输入在芯片内部滚动,不重复访存 reg[0] = x[i]; y[i] = acc; }}// CUDA:线程是设计的中心,一个输出元素对应一个线程__global__ void fir3_kernel(const int* x, int* y, int n, const int* c) { int i = blockIdx.x * blockDim.x + threadIdx.x; if (i < n) { int xm1 = (i >= 1) ? x[i - 1] : 0; // 相邻数据从内存取,靠缓存与合并访问 int xm2 = (i >= 2) ? x[i - 2] : 0; y[i] = c[0] * x[i] + c[1] * xm1 + c[2] * xm2; }}两份代码的差距一眼可见:CUDA 版里不存在循环体之间的数据流动,每个线程独立算一个输出,历史输入靠重复读内存获得(现代 GPU 里这些读会命中缓存,代价被隐藏);HLS 版里历史输入被显式做成芯片内的寄存器链 reg,x 每周期只从外存流入一次,之后在芯片内部滚动——数据流是被设计出来的,而不是被缓存命中的。这正是面试官想听到的洞察:GPU 用缓存和并发”容忍”访存模式,FPGA 用定制数据通路”消灭”不必要的访存。代价也对称:CUDA 版换个模型换个形状改改索引就能跑,FPGA 版每换一种数据流形态(输入重排、步长、多路并行)都可能要重新设计存储结构与流水线,再走一遍数十分钟到数小时的综合布局布线。
开发流程:编译器与工具链的节奏差
- GPU:
nvcc编译 kernel 到 SASS 是秒级的事,写错立即能跑出来看结果,迭代以分钟计;性能分析有 profiler 给出占用率、访存吞吐、warp stall 原因,问题定位直接。 - FPGA/HLS:流程是 C 仿真验证算法正确性 → 综合(synthesis)生成 RTL → 逻辑综合与布局布线(place & route)生成位流(bitstream),一次完整跑完通常数十分钟到数小时。所以 HLS 开发者的工作习惯是”先用 C 仿真把算法逻辑磨对,再一次性上板验证”,且非常依赖综合报告(资源占用、时钟频率、II)——一个 pragma 没写对,工具可能悄悄把并行度降到预期值的几分之一。
- NPU:高层图编译(分钟级)把模型映射到计算阵列;算子级开发(如 Ascend C)则更接近”受限的 CUDA”,需要理解厂商的并行粒度与存储层级。
数值上还有一个常见差异值得说:GPU 的浮点指令是现成的(FP32/FP16/BF16/INT8 各取所需),FPGA 上浮点加乘要消耗 DSP 或 LUT 实现的浮点 IP,成本高,所以 HLS 项目里用自定义定点数(fixed-point)代替浮点非常普遍——位宽可以精确到 24.6 位这种任意规格,这是 GPU 给不了的自由度,也是硬件-算法协同设计(量化感知硬件)能发挥的地方。
落到 LLM 推理场景:三者怎么分工
把话题拉回面试者熟悉的地盘(LLM 推理),结论会自然浮出来:主流推理在 GPU 上,因为模型迭代快、张量并行的生态成熟、显存容量大;FPGA 的价值在确定性低延迟、可定制接口(如网络直连、内存解聚)与能效,业界已经出现把 LLM 的 KV 缓存、投机解码、权重存储搬到 FPGA+CXL 内存的探索;NPU 则在固定形态的端侧/边缘推理里以能效取胜。这些方向的细节,本站的 FPGA 加速器系列、TPU 拆解系列 与 Hot Chips 全景文章里有完整展开,此处不重复。
这题怎么答才稳
答题的层次感比内容更重要:先亮框架(执行模型 → 并行来源 → 存储与同步 → 开发流程),再举一个亲手写过的具体例子或伪代码对照,最后落到”没有绝对优劣,只有瓶颈形态与开发成本的不同”上收尾。能说出”HLS 的循环、pragma 与 BRAM 端口”和”CUDA 的线程、barrier 与合并访问”这两个各自世界的核心词汇,并解释二者为什么是不同的抽象,这道题就答透了。
复盘:这组问题在考什么
把五道题串起来看,它们其实是同一个能力的五个侧面:把读过的论文压缩成一句话的抽象力(第一问),对公式符号与误差来源的敏感度(第二问),动手算数值与处理极端情况的严谨度(第三问),参数-位宽-容量的量级直觉(第四问),以及跳出单一硬件、用抽象模型理解异构系统的迁移能力(第五问)。前两道考”读过之后有没有内化”,后三道考”动手时能不能算对”——这正是推理系统工程师日常工作的两种状态:读论文做技术选型,与写代码算显存排 kernel。
回答时的通用技巧也值得记一笔:所有估算题先确认口径再动笔(对称还是非对称、十进制还是二进制、权重还是含 KV),所有论文题先给分类坐标再逐点展开,所有对比题先立维度框架再填内容。口径问清楚了,即使数字算错,也只会被纠正数字而不是被判定”思路不对”。
参考资料
- LLM.int8(): 8-bit Matrix Multiplication for Transformers at Scale(NeurIPS 2022)
- Tim Dettmers:LLM.int8() and Emergent Features 博客(论文作者原理解读)
- SmoothQuant: Accurate and Efficient Post-Training Quantization for Large Language Models(ICML 2023)
- GPTQ: Accurate Post-Training Quantization for Generative Pre-trained Transformers(ICLR 2023)
- AWQ: Activation-aware Weight Quantization for LLM Compression and Acceleration(MLSys 2024 最佳论文)
- Apple Core ML Tools:Quantization Overview 官方文档(量化/反量化公式与粒度图解出处)
- AMD Vitis HLS User Guide(HLS pragma 与综合流程官方文档)
- NVIDIA CUDA C++ Programming Guide(线程层次与编程模型官方文档)
- FPGA HLS Today: Successes, Challenges, and Opportunities(ACM TRETS,HLS 与处理器编译并行化能力对比)
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
音乐
暂未播放


