SmoothQuant 完全拆解:激活量化难度的数学等价迁移,如何实现无损 W8A8 推理
背景:权重能量化,激活为什么不能?
大语言模型的体积增长远超 GPU 显存的发展速度。论文引言里给了这样一组数字:GPT-3 有 175B 参数,以 FP16 存储和运行至少需要 350GB 内存,仅推理就需要 8 张 48GB 的 A6000 或 5 张 80GB 的 A100。模型越做越大,显存和带宽的缺口越来越大,量化成了补上这个缺口的主要手段——权重和激活都量化成 INT8,显存占用减半,而 INT8 GEMM 在 GPU 上的吞吐接近 FP16 的两倍。
这里要区分两条技术路线。权重量化(如之前拆解过的 GPTQ 和 AWQ)只量化权重、激活保持 FP16(W8A16 或 W4A16),推理时把 INT8 权重反量化回 FP16 再和 FP16 激活做矩阵乘。这种方式省的是权重本身的显存和带宽,但矩阵乘仍然跑在 FP16 算力上,计算速度没有本质提升(尤其在小 batch 的解码阶段,权重搬运减半带来的收益主要来自带宽)。权重+激活量化(W8A8)则不同:两个输入都是 INT8,可以直接喂给 GPU 的 INT8 Tensor Core 做整数矩阵乘,计算吞吐真正翻倍——这是 W8A8 的核心价值。
但问题恰恰出在这里。CNN 或 BERT 这类模型可以轻易做 W8A8,而大语言模型一旦超过 6.7B 参数,激活中会出现系统性的离群值(outliers),导致激活量化误差急剧增大、模型精度崩盘。这也是 LLM.int8() 论文的核心发现。SmoothQuant 于 2022 年 11 月由 MIT 韩松团队的 Guangxuan Xiao、Ji Lin 与 NVIDIA 的 Mickael Seznec、Hao Wu、Julien Demouth 合作发布在 arXiv(编号 2211.10438),后发表于 ICML 2023。它的核心主张是:通过一个数学上完全等价的变换,把激活的量化难度”迁移”到权重上,从而让 W8A8 量化对 100B+ 参数模型也无损。
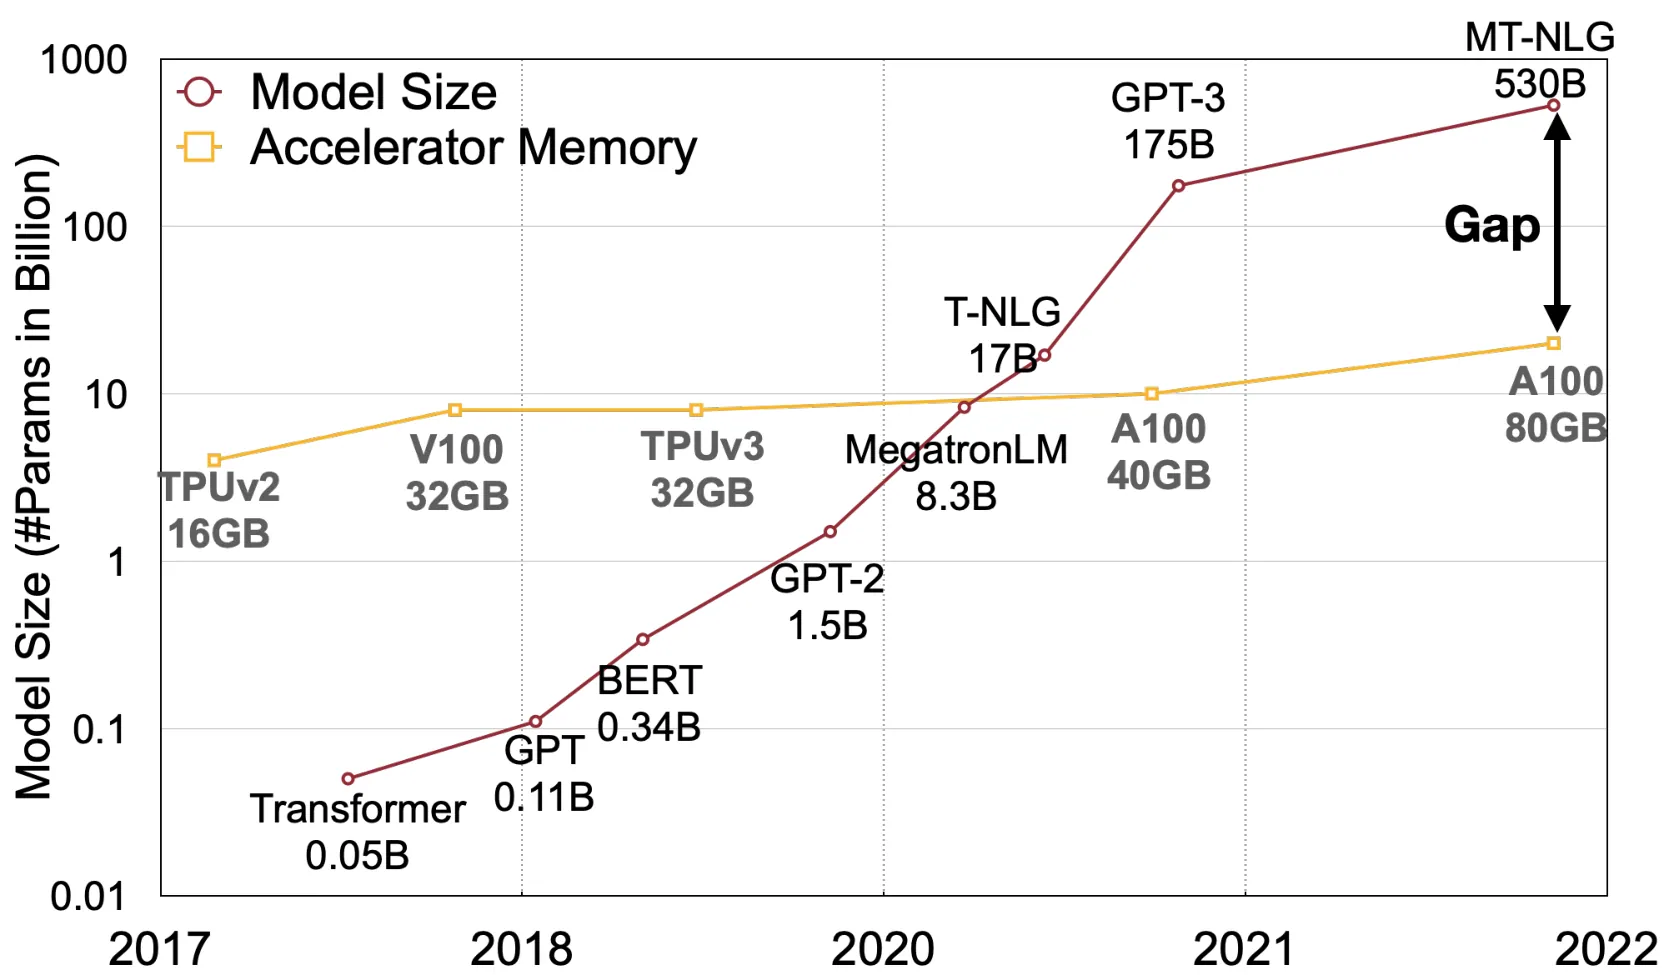
先看这张图:模型参数规模的增长曲线远比 GPU 显存的增长曲线陡峭。图中的红色区域就是”供给与需求的缺口”,量化与模型压缩技术可以缩小这个缺口。注意图中横轴是时间、纵轴是对数尺度,近两年的模型增长几乎垂直向上——这个趋势在 2026 年的今天看更加明显(如今单模型动辄数百 B 甚至 1T+ 参数,HBM 容量却只是从 A100 的 80GB 涨到 B200 的 288GB 量级)。
激活离群值的三个观察
SmoothQuant 论文观察了一个线性层(OPT-13B 中量化误差最大的层)的输入激活与权重的幅值分布,得出三个关键观察:
观察一:激活比权重难量化得多。 权重的分布平坦均匀,量到 INT8 甚至 INT4 都不怎么掉精度(这点之前的 GPTQ 文章里已经验证过);而激活的幅值分布很不均匀。
观察二:离群值把量化范围撑爆了。 激活中离群值的幅值大约是普通值的 100 倍。做 per-tensor 量化时,量化步长(scale)由整个矩阵的最大幅值决定:假设通道 的最大幅值为 ,整个矩阵的最大值为 ,那么该通道的有效量化电平数为:
离群通道把 拉得很大,非离群通道的有效电平数就只剩下 2-3 个——8 bit 的信息量被压缩成 2 bit 的精度,量化误差当然大。直觉上:INT8 把 均分成 256 个区间,绝大多数数值只落在 2-3 个区间里,等于用 2 bit 在表示它们。
观察三:离群值固定在少数通道上,且跨 token 稳定。 离群只出现在很小一部分通道中;一旦某个通道是离群通道,它在所有 token 上都是离群的(下图中的红色通道)。也就是说,给定 token 的各通道之间方差很大,但给定通道跨 token 的方差很小——离群通道始终大,普通通道始终小。
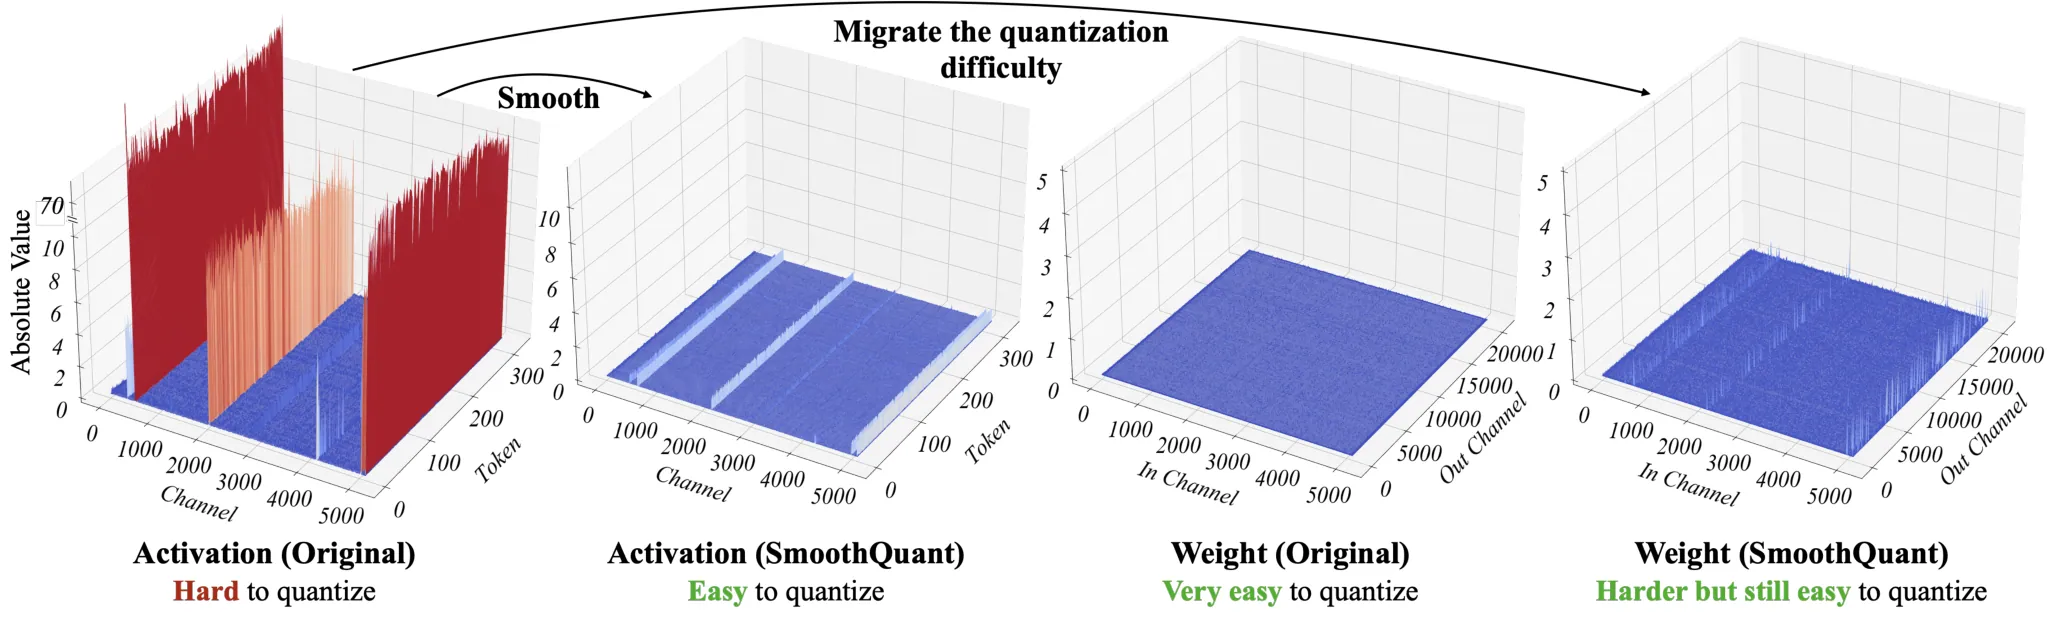
上图左半部分是原始激活和权重:激活矩阵里有一小撮幅值超过 70 的离群通道(红色),绝大多数通道的幅值很小;权重则整体平坦。右半部分是应用 SmoothQuant 之后:激活的离群被压平,权重的分布仍然平坦。论文还给出一个量化事实:per-tensor 激活量化在 OPT 系列上全面崩盘——在 WinoGrande、HellaSwag、PIQA、LAMBADA 四个基准的平均准确率上,OPT-6.7B 从 FP16 的 64.9% 掉到 39.9%,OPT-175B 从 71.6% 掉到 32.3%;per-token 激活量化(每个 token 单独一个 scale)也救不回来(6.7B 上 42.5%);只有 per-channel 激活量化(每通道一个 scale)能保持精度(64.8%)。
为什么 per-channel 激活量化用不上:Tensor Core 的约束
观察三暗示了正确解法:既然离群通道固定,那就每个通道单独用一个量化步长,把离群通道隔离出来。数值上这确实可行——表 1 显示 per-channel 激活量化在 OPT 全系都能保住精度。
但工程上此路不通。INT8 GEMM 靠的是 GPU 上的 Tensor Core MMA(matrix multiply-accumulate)指令,它在硬件里硬编码了”INT8 输入、INT32 累加”的流水线。在这样一条高吞吐的指令序列中间,不能插入低吞吐的转换或缩放指令。缩放只能放在矩阵乘的外维上(dimension of the matrix multiplication),即在 GEMM 之前对整块输入矩阵做一个整体变换,或者在 GEMM 之后对输出做变换。对激活 来说,per-token 的 scale(沿 token 维 )和权重 per-channel 的 scale(沿输出通道维 )属于外维,可以用;而激活的 per-channel scale(沿输入通道维 )是 GEMM 的归约维(inner dimension)——它对应的是 MMA 内部累加循环的中间项,无法在矩阵乘之外应用,除非拆成 次单独缩放,那性能就全完了。
所以困境是:精度上需要 per-channel 激活量化,硬件上只允许 per-token / per-tensor 激活量化。SmoothQuant 的解法不是绕开这个约束,而是让 per-token(甚至 per-tensor)量化也能达到 per-channel 的精度——办法是把激活的通道间方差搬走。
核心思想:量化难度迁移
一句话概括:对每个线性层做一个数学上完全等价的变换,把激活的通道间幅值差异”迁移”到权重上,使变换后的激活分布平坦、可以直接用硬件友好的 per-token/per-tensor 量化,而变换后的权重虽然被放大,但权重本来分布平坦且可以用 per-channel 量化来兜底。
具体做法是引入一个对角平滑矩阵 ,对线性层 做变换:
其中 的每一列被除以对应通道的平滑因子 (离群通道被压平), 的每一行被乘以 (权重吸收被迁移过来的量级)。在 FP16 下这个变换是逐元素完全等价的——,输出 与变换前逐位相等;但量化之后差别巨大: 的离群被压平,per-tensor INT8 量化不再被离群值撑爆,而 虽然出现了离群行,但权重可以做 per-channel 量化(沿输出通道维,正是 GEMM 允许的外维),单行放大无伤大雅。
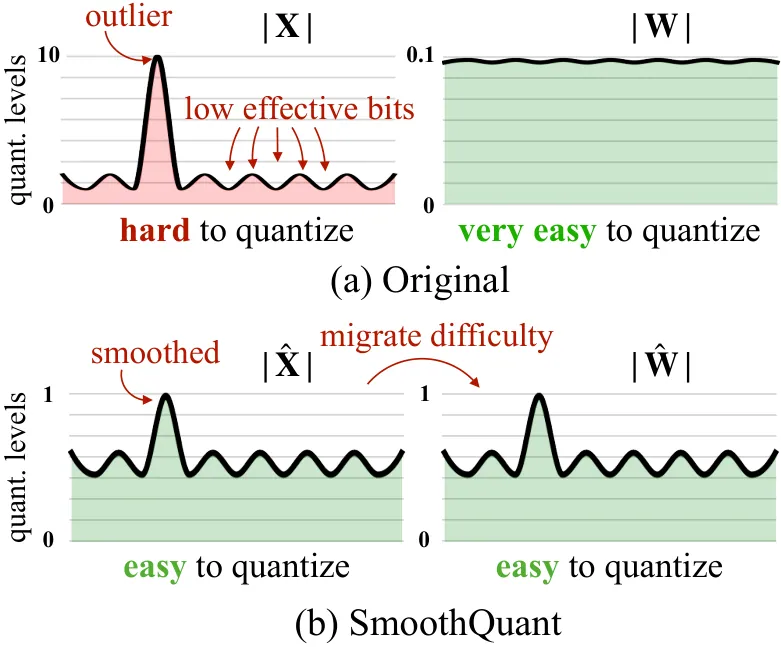
上图是论文的直觉图:上半部分显示原始激活 中一小撮离群值把量化范围(黄色区间)撑得极宽,绝大多数数值只占用极小一部分量化区间;下半部分显示迁移之后,激活 的幅值差异被压平,权重 承担了这部分差异——两边都变得容易量化。
平滑因子怎么选:迁移强度 α
平滑因子 怎么定?论文先分析两个极端:
- 若选 (把激活每通道最大幅值拉齐到 1),激活确实变得极其平坦,但所有量化难度都被推给了权重——权重出现离群行,per-channel 量化也救不回来(权重行数等于激活通道数,离群行会被放大到难以量化),精度大幅下降。
- 若选 (把权重的行拉齐),难度全在激活这边,激活量化误差同样毁掉模型。
于是论文引入超参数迁移强度 α(migration strength),在两者之间插值:
这里 表示激活矩阵的第 个输入通道(第 列), 表示权重矩阵的第 行(对应同一输入通道)。α 的语义非常直观:
- α = 0:,难度全压在激活上(迁移量为零);
- α = 1:,难度全压在权重上(迁移量拉满);
- α = 0.5:,两边各让一半——变换后该通道的激活最大值和权重最大值相等,共享相同的量化难度。
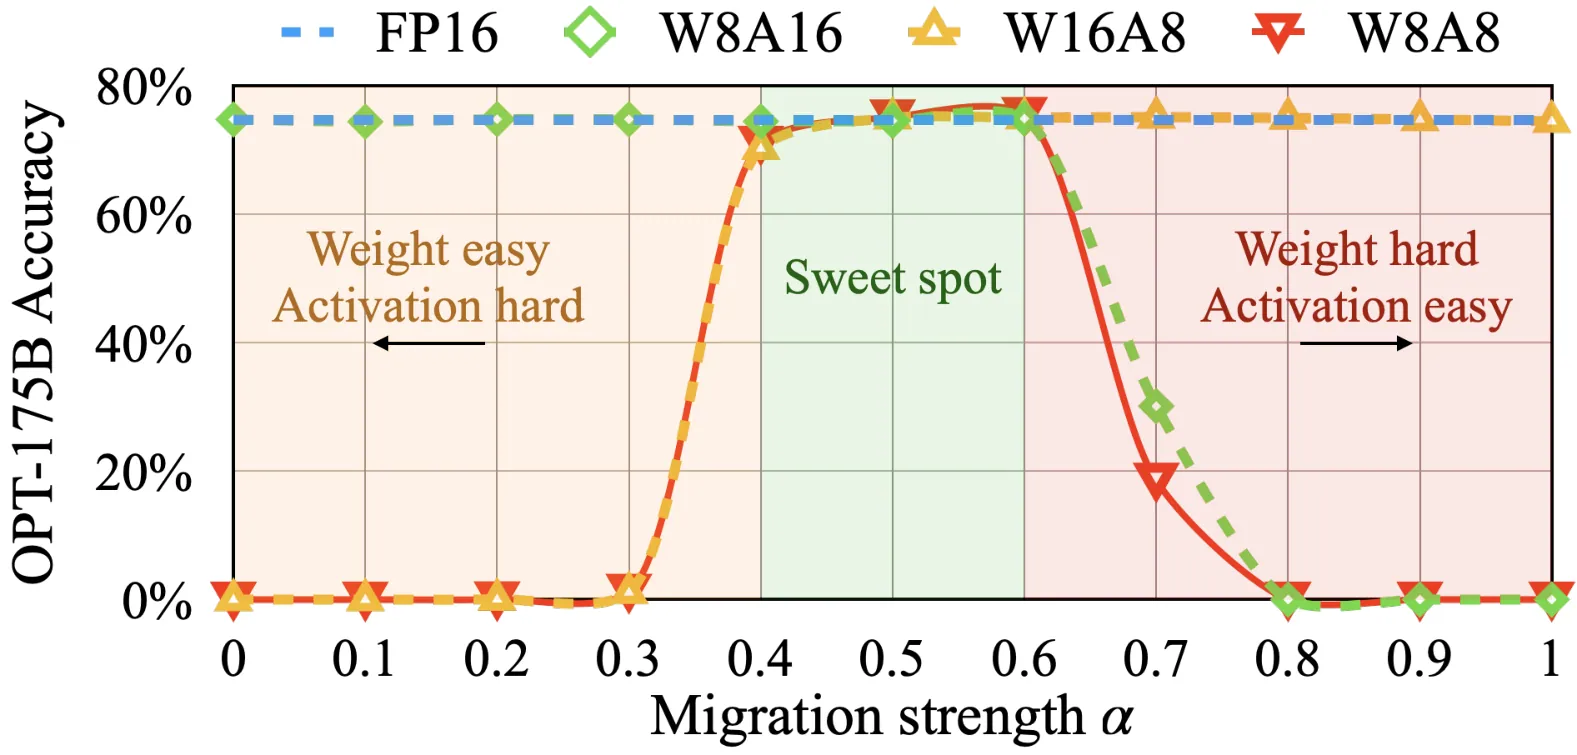
α 的选择依赖校准数据:论文在 Pile 验证集的一个子集上做快速网格搜索。对 OPT 和 BLOOM 全系,α = 0.5 就是甜点(此时权重和激活用同一个量化器,比如都是 per-tensor 静态量化);GLM-130B 的激活离群更严重(论文报告其约 30% 的通道是离群通道),需要把更多难度迁移给权重,取 α = 0.75;LLaMA 系列激活离群问题相对较轻,取 α = 0.8(配合 per-token 激活量化);Llama-2 需要 0.85-0.9,Falcon 用 0.6-0.7,Mistral/Mixtral 用 0.8。直观规律:离群越严重的模型,α 越大。
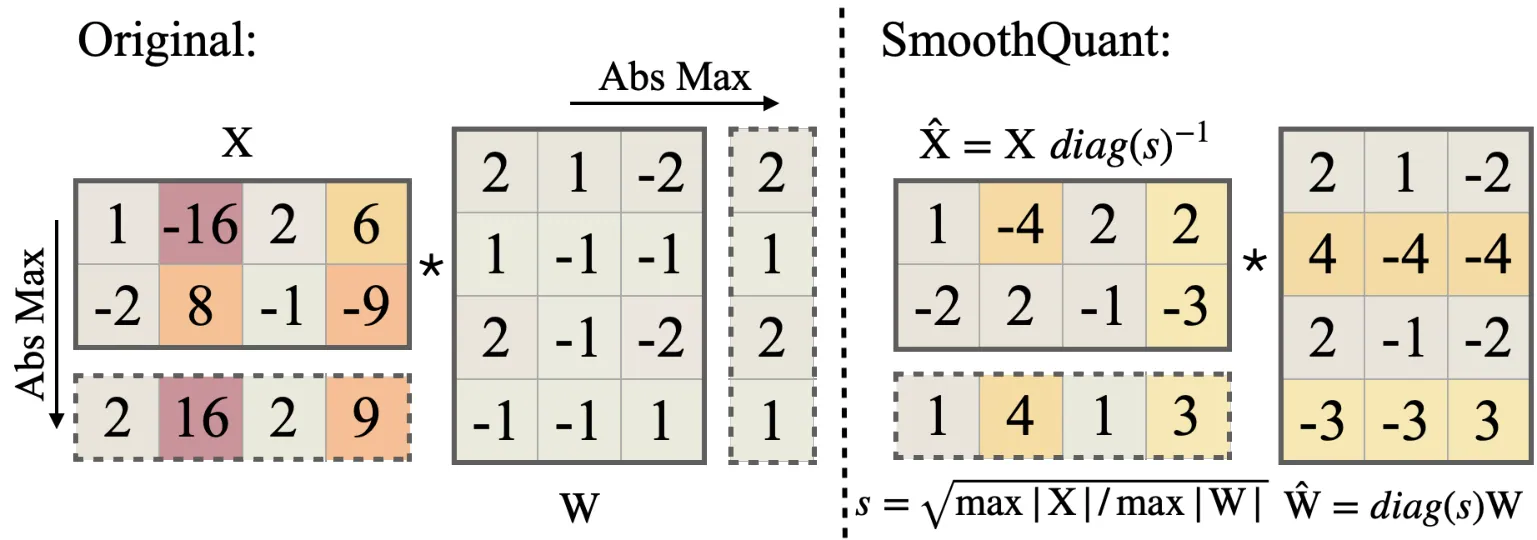
上图展示了 α = 0.5 时的完整流程:校准阶段在少量样本上统计激活与权重的通道最大值,算出 ,然后离线完成 和 的变换;推理时激活已经是平滑的,不需要任何额外的运行时缩放。
为什么变换在运行时是免费的
这是 SmoothQuant 工程上最关键的设计。 看起来引入了两个逐元素缩放( 除以 、 乘以 ),如果推理时真的做这两个操作,每次前向都要多跑两个 elementwise kernel,开销不小。论文的巧妙之处在于把缩放折进相邻层的参数里:
- 折进前一层:线性层的输入 通常来自上一层的输出——前一层若是 LayerNorm,就把 乘进 LayerNorm 的 参数;前一层若是线性层(如 MLP 的第一段),就把 乘进它权重矩阵的对应列。这样本层激活的缩放就被”吸收”了,不产生任何额外运算。
- 折进本层权重: 在离线转换时一次性完成,运行时零开销。
- 残差分支:当输入来自残差相加(如 attention 的输出、Block 的输入)时,无法直接折进前一层参数,就在残差分支上乘一个额外缩放因子(论文引用 Wei et al. 2022 的做法),代价只是一个可以融合进前一个算子的标量乘。
于是推理时整个变换是”免费”的:模型还是原来的算子序列,只是参数变了。这与后来 QuaRot / SpinQuant 的思路形成对比——那些方法用旋转矩阵(正交矩阵,非对角)替代对角缩放,无法折进前一层参数,必须显式做一次矩阵乘,代价更高。SmoothQuant 保持对角缩放,正是为了保住这个”零额外开销”。
量化设置:O1 到 O3,效率递进
SmoothQuant 与具体的量化粒度正交,论文按效率从低到高实现了三个配置:
| 配置 | 权重量化 | 激活量化 | scale 模式 |
|---|---|---|---|
| O1 | per-tensor | per-token | 动态(dynamic) |
| O2 | per-tensor | per-tensor | 动态(dynamic) |
| O3 | per-tensor | per-tensor | 静态(static) |
- 动态:每次前向实时统计输入的 scale,准确但要多跑一次归约(reduce)来求最大值;
- 静态:scale 在校准阶段用 512 条 Pile 随机句子统计后固定下来,推理时零额外开销,最接近真实硬件部署。
一个容易忽略的细节:O1 的 per-token 激活量化在 Transformer 里通常只对注意力的 Q、K、V 投影输入(以及 MLP 输入)有意义,因为 token 维是 BMM 的外维;而对残差流本身,论文的处理是保持 FP16 或在需要处按 token 缩放。论文在 LLaMA 系列上统一使用 per-token 激活量化 + per-channel 权重量化(α = 0.8),这个设置后来成为社区 W8A8 部署的事实标准。
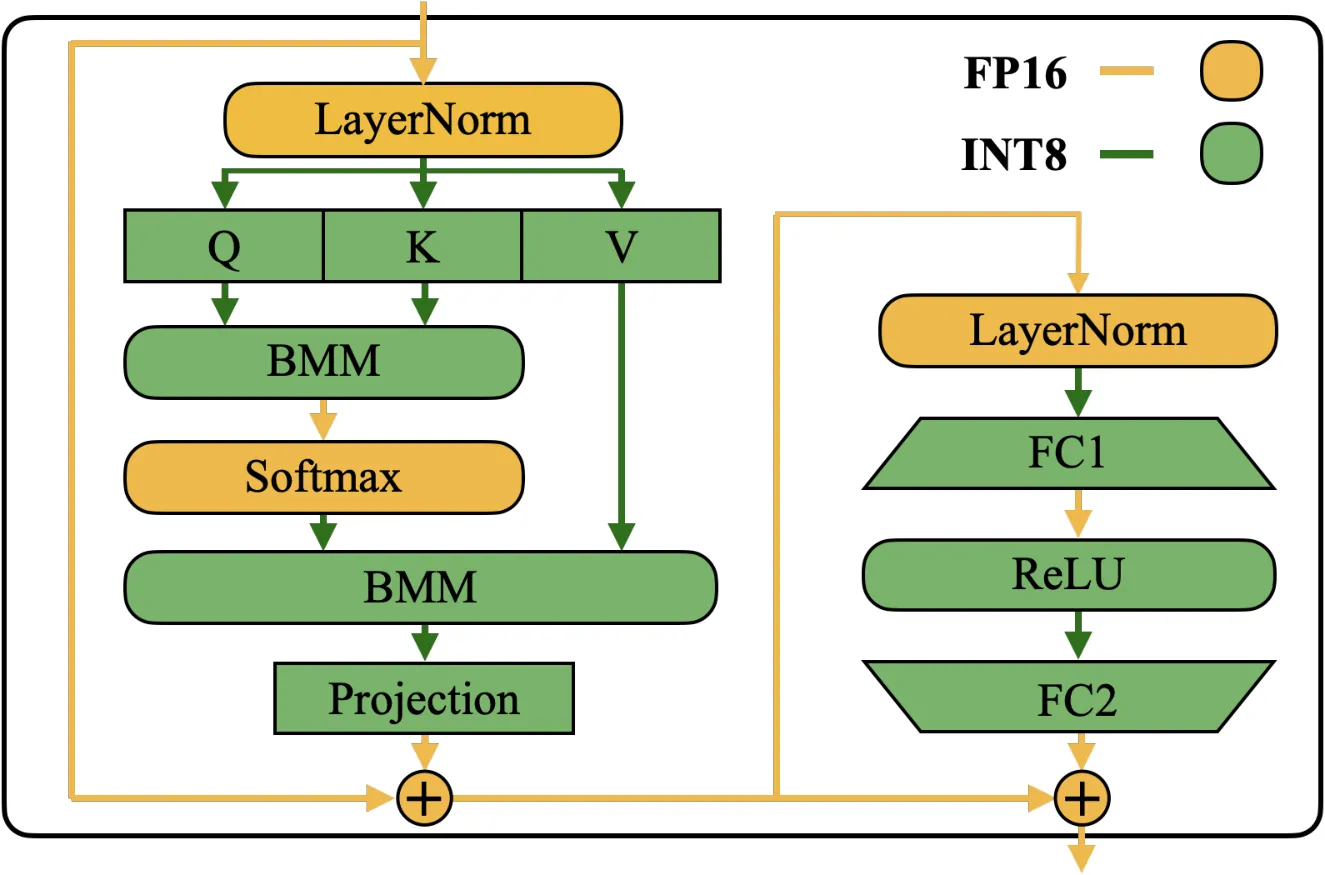
每个 Transformer Block 的精度映射如下图所示:所有计算密集算子都用 INT8——四个线性层(Q/K/V 投影、输出投影、MLP 两段)和注意力里的两个 batched matmul(QKᵀ 与 PV,即论文里的 BMM)全部 W8A8;轻量算子保持 FP16——Softmax、LayerNorm、GELU 这类逐元素算子不参与矩阵乘,量化它们没有计算收益,反而引入误差。这种”重算子 INT8、轻算子 FP16”的划分是论文平衡精度与效率的关键设计。
此外,激活量化还顺带解决了 KV Cache 的内存问题:论文指出,batch size 512、上下文 2048 时 KV Cache 总量约 3TB,是模型权重的 3 倍(引用 Pope et al. 2022)。由于 K、V 缓存就是激活(来自线性投影的输出),激活量化后 KV Cache 的 INT8 存储顺理成章,内存占用再砍一半——这正好和之前拆解过的 QEvict 所讨论的”长上下文下 KV Cache 是主要内存开销”接上了。
实验结果:无损是多大程度上的无损
OPT-175B(Table 3):在 LAMBADA、HellaSwag、PIQA、WinoGrande、OpenBookQA、RTE、COPA 七个 zero-shot 基准的平均准确率与 WikiText-2 困惑度上:
| 方法 | 平均准确率 | WikiText 困惑度 |
|---|---|---|
| FP16 | 66.9% | 10.99 |
| 朴素 W8A8 | 35.5% | 93080(几乎随机) |
| ZeroQuant | 35.8% | 84648 |
| LLM.int8() | 66.7% | 11.10 |
| Outlier Suppression | 36.0% | 96151 |
| SmoothQuant-O1 | 66.5% | 11.11 |
| SmoothQuant-O2 | 66.4% | 11.14 |
| SmoothQuant-O3 | 66.8% | 11.17 |
最激进的 O3(per-tensor 静态)也只比 FP16 平均掉 0.1 个百分点,困惑度从 10.99 到 11.17——这就是”无损”的含义。而三个基线(朴素 W8A8、ZeroQuant、Outlier Suppression)在 OPT-175B 上全部崩成随机水平,说明”直接量化激活”在超大模型上行不通。
其他模型:BLOOM-176B 更容易量化(朴素 W8A8 只掉 4%),SmoothQuant-O1/O2 完全保持 FP16 精度,O3 掉 0.8%——论文把这点下降归因于静态统计量与真实评测样本激活分布之间的差异;GLM-130B 最难,O1 能匹配 FP16,O3 有可感知的下降,所以生产上对这类模型要用动态量化。指令微调模型 OPT-IML-30B 上,SmoothQuant-O3 的 LAMBADA 准确率甚至比 FP16 高(69.77% vs 69.12%),而朴素 W8A8 只有 4.21%。
LLaMA 与后续模型(WikiText-2 困惑度,per-token 激活量化):LLaMA-7B 从 11.51 到 11.56,13B 从 10.05 到 10.08,30B 从 7.53 到 7.56,65B 从 6.17 到 6.20,全部可忽略。Llama-2-70B 3.320→3.359,Falcon-40B 5.228→5.255,Mistral-7B 5.253→5.277,Mixtral-8x7B 3.842→3.893——连 MoE 架构也适用(这正是后来 XFP、DeepSeek FP8 等 MoE 量化方案都引用 SmoothQuant 的原因)。
性能收益(A100-80GB 实测):
- PyTorch 实现(context 阶段):O3 最高 1.51x 加速、1.96x 内存节省;同一实验里 LLM.int8() 在大多数情况下比 FP16 还慢。
- FasterTransformer 实现:最高 1.56x 加速,内存几乎减半。OPT-66B 从 2 张 GPU 减到 1 张,OPT-175B 从 8 张减到 4 张——同样的模型,一半的机器,延迟还更低。
- 解码阶段:每 token 延迟最高降低 1.42x(OPT-30B,batch 16、序列 512:2488ms 降到 1753ms),内存节省最高 1.91x。
- MT-NLG 530B:W8A8 后四个基准平均准确率 73.1% 对 FP16 的 73.1%,分毫不差;服务时从 16 张 A100 减到 8 张(内存 1040GB→527GB),延迟几乎不变——530B 模型第一次可以在单节点内跑起来。
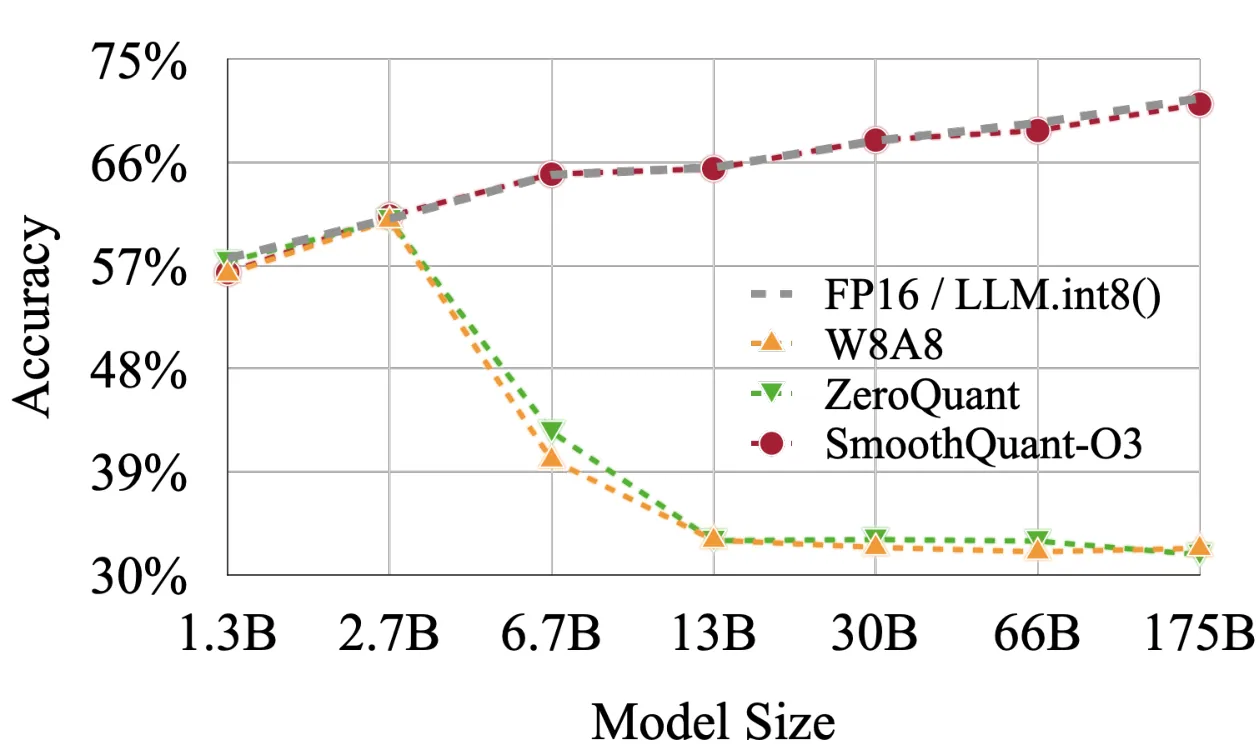
上图的结论与前面表 3 一致:O3 的 INT8 曲线(蓝色虚线)与 FP16(黑色实线)在 OPT-6.7B 到 175B 全规模上几乎重合,而 LLM.int8() 靠混合精度保住精度却拖慢了速度。这个”精度与速度兼得”的对比,正是 SmoothQuant 相对 LLM.int8() 的核心优势。
它为什么能成功:与 LLM.int8() 的本质区别
LLM.int8() 的路线是绕开离群值——把离群通道的激活留在 FP16,只有非离群部分走 INT8 GEMM,最后用 FP16 结果合并。问题在于:离群通道的分布无法提前静态确定,需要运行时对每个 token 动态判定哪些通道是离群通道,这迫使 GEMM 在 INT8 和 FP16 之间来回切换,无法利用硬件上连续高吞吐的 INT8 MMA 流水线,实测多数情况下比纯 FP16 更慢。
SmoothQuant 的路线是消灭离群值——在离线阶段用一个等价的参数变换把离群从激活里永久移除,运行时根本没有”离群值”这个概念,整条流水线是干净的全 INT8。这也是”迁移(migrate)“与”分解(decompose)“两种哲学的分野:前者改造数据分布使其适配硬件,后者改造硬件流水线去迁就数据分布。从结果看,前者在 W8A8 这个约束下完胜,也奠定了后续所有 W8A8 方案的基本范式。
局限与后续演进
SmoothQuant 的局限主要有几点:
- α 依赖人工网格搜索:每个新模型都要在校准集上扫一遍 α(论文里的 α 从 0.5 到 0.9 不等),虽然成本低,但属于经验调参,没有闭式解。
- 静态量化对分布漂移敏感:O3 在 BLOOM-176B 上掉 0.8% 就是例子;在线性层输入分布偏离校准分布的应用场景(如长对话、风格迥异的输入),静态 scale 会放大误差。
- 只解决了”8 bit”这一档:把 W8A8 推到 4 bit 需要更强的技术(论文展望里提到与 GPTQ 结合做 W4A4,Hopper 的 INT4 指令是其后来的硬件前提)。
- 对角缩放能力有限:每通道一个标量无法消除token 内的离群(某个 token 内部个别元素特别大),per-token 动态量化可以缓解但增加开销。
SmoothQuant 之后的演进脉络也值得梳理,它们和已写过的文章能串成一条线:
- AWQ(已拆解):借鉴了”激活感知缩放”的思想,但专注 weight-only INT4 场景——用激活统计找显著权重,再按通道缩放权重,本质是把 SmoothQuant 的”迁移”思想用在 4 bit 权重上。
- QuaRot / SpinQuant:把对角缩放推广为旋转矩阵(Hadamard 旋转),把离群值”打散”到所有通道而不是迁移到权重,从而支持更激进的 W4A4 / W4A8——代价是无法折进前一层参数,要显式做旋转矩阵乘。
- FP8 时代:Hopper 之后的硬件原生支持 FP8 的 E4M3/E5M2,各框架(TensorRT-LLM、vLLM)的 FP8 W8A8 部署沿用了 SmoothQuant 确立的 per-token 激活 + per-channel 权重 + 静态/动态 scale 的范式——DeepGEMM 里拆解的 FP8 缩放设计,和 SmoothQuant 的 O2/O3 是一脉相承的。理解 SmoothQuant,等于理解了现代 W8A8/FP8 推理栈的公共底座。
小结
SmoothQuant 解决的是一个教科书式的两难:激活量化需要 per-channel 精度,硬件只支持 per-token/per-tensor。它的答案不是改进量化器,而是改变数据分布——用一个数学上等价的逐通道缩放变换,把激活的通道间方差迁移给权重,α 控制迁移强度,再通过把缩放折进相邻层参数让整个变换在运行时零成本。最终效果是:OPT-175B、BLOOM-176B、GLM-130B、MT-NLG 530B 这些百亿到五百亿参数的模型,全部可以无损 W8A8 量化,推理加速最高 1.56 倍、内存减半,530B 模型第一次能被塞进一个 8 卡节点。
对理解后续所有量化工作来说,SmoothQuant 是承上启下的一环:向上它接住 LLM.int8() 发现的离群值问题,向下它为 AWQ、FP8 部署乃至 QuaRot 铺平了”用变换适配量化”的思想路径。如果你已经读过 GPTQ(二阶信息)和 AWQ(激活感知缩放),SmoothQuant 正好补上”为什么激活这么难量化、怎么让它变好量化”这关键一环。
参考资料
- SmoothQuant: Accurate and Efficient Post-Training Quantization for Large Language Models(arXiv 2211.10438)
- SmoothQuant 官方项目页(MIT Han Lab)
- SmoothQuant 官方代码仓库(mit-han-lab/smoothquant)
- SmoothQuant 论文 ICML 2023 页面(PMLR v202)
- LLM.int8(): 8-bit Matrix Multiplication for Transformers at Scale(Dettmers et al. 2022)
- ZeroQuant: Efficient and Affordable Post-Training Quantization for Large-Scale Transformers(Yao et al. 2022)
- Outlier Suppression+: Accurate Quantization of Large Language Models by Equivalent and Effective Differentiation(Wei et al. 2022)
- QuaRot: Outlier-Free 4-Bit Inference in Rotated LLMs(Ashkboos et al. 2024)
- 【LLM 量化技术介绍-2】SmoothQuant 原理及量化技术详解(地平线开发者社区)
- 100 亿参数的语言模型跑不动?MIT 华人博士提出 SmoothQuant 量化,内存需求直降一半(新智元)
文章分享
如果这篇文章对你有帮助,欢迎分享给更多人!
评论区
音乐
暂未播放